Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7:2026年编码任务中哪个开源模型胜出
简短答案
如果你正在构建一个无需干预即可运行数小时的自主编码代理:Kimi K2.6。它在 Terminal-Bench 2.0 上得分 66.7%,并在已发布的基准测试中维持了 13 小时不间断会话中 4,000 多次工具调用——这是此比较中其他开源模型无法企及的稳定性极限。
如果你需要最好的智能前端开发者:GLM 5.1。其独立验证的 Code Arena Elo 分数为 1,530(全球智能网页开发第三名),反映了实际开发者在头对头比较中的偏好,而不仅仅是自动化测试套件。
如果每个 token 的成本是限制因素:MiniMax M2.7 在 Atlas Cloud 上输入价格为 $0.30/M,仅激活 10B 参数,SWE-Bench Pro 得分为 56.22%——约为 GLM-5.1 性能的 94%,成本仅为其五分之一。
如果你的代码库过大,超出 262K 上下文窗口:Qwen 3.6 Plus,这是此组中唯一支持 1M token 上下文的模型,并且在 Terminal-Bench 2.0 上以 61.6% 的成绩领先同组。
关键基准一览
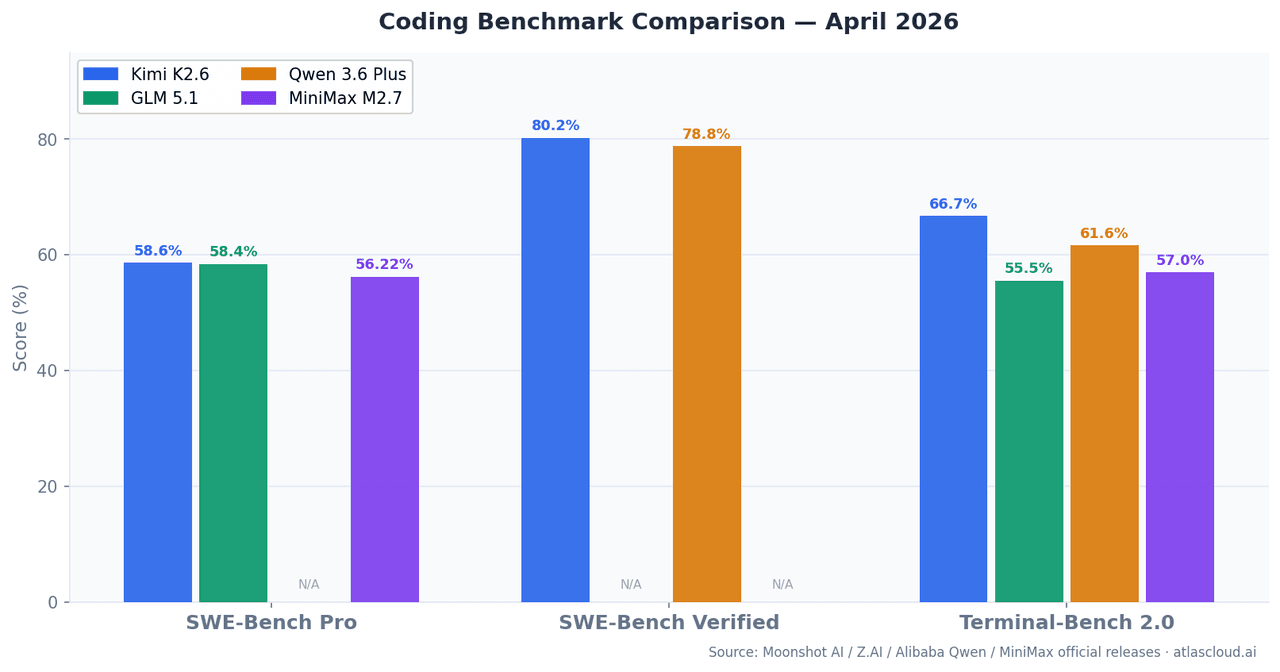
| 模型 | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | 上下文窗口 | 激活参数 |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | 混合 MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro 衡量解决训练截止日期后提交的真实 GitHub 问题的能力,相比 SWE-Bench Verified 减少了数据污染风险。Terminal-Bench 2.0 测试在实时终端环境中的多步骤 CLI 和 shell 任务——更接近生产代理的实际工作。
本文比较了 Kimi K2.6、GLM 5.1、Qwen 3.6+ 和 MiniMax M2.7;要并排对比更多模型的价格和规格,请使用 Atlas Cloud 模型对比工具。
Kimi K2.6:专为长时间运行代理打造
Moonshot AI 于 2026 年 4 月发布了 Kimi K2.6,作为 K2.5 的升级版,主要改进在于长时间会话中的智能稳定性。在 SWE-Bench Verified 上达到 80.2%,略低于 Claude Opus 4.6(80.8%),并在 SWE-Bench Pro 上以 58.6% 领先四者。
最重要的数字是 Terminal-Bench 2.0 的 66.7%。Terminal-Bench 2.0 与 SWE-Bench 的根本区别在于:它在真实终端环境中运行任务,要求模型读取输出、处理错误、适应并迭代,而不仅仅是生成补丁。Kimi K2.6 在单个 13 小时会话中维持 4,000+ 次工具调用的性能并非实验室假象,而是 Moonshot 技术发布中记录的行为。
一个未被充分报道的优势:跨语言泛化能力。Kimi K2.6 在 Rust、Go、Python、前端和 DevOps 任务中表现一致。大多数基准评估以 Python 为主。如果你的生产栈是多语言的,这一点很重要。
它的不足之处: 在 Atlas Cloud 上,K2.6 的输入价格为 $0.95/M,是本组中最贵的输入侧模型。对于批量处理任务——发送大量请求且上下文较大,但不需要 12 小时会话稳定性——成本积累速度比 MiniMax M2.7 或 Qwen 3.6 Plus 更快。
GLM 5.1:智能前端领域的佼佼者
Z.AI 于 2026 年 4 月 7 日发布了 GLM-5.1。拥有 7540 亿参数和 MoE 路由,是本组中原始参数数量最大的模型。在 SWE-Bench Pro 上得分为 58.4%——与 Kimi K2.6 的 58.6% 在统计上无显著差异。
其差异化优势是 Code Arena Elo 分数 1,530,由 Arena.ai 于 2026 年 4 月 10 日独立验证,在全球智能网页开发排行榜上排名第三。这是一个实时头对头比较,实际开发者对输出进行投票——而非自动评分。其优势集中在前端 UI 生成、全栈脚手架、React/Vue 组件创建以及 NL2Repo(从自然语言生成完整的仓库结构)。
值得注意的边界条件: GLM-5.1 的前端优势是真实的。对于 HumanEval 和 MBPP 上的纯算法问题,它并不比 Kimi K2.6 有可衡量的优势。在非 UI 或非网页导向的问题上,排行榜差距缩小到接近零。如果仅仅根据整体排行榜排名选择 GLM-5.1,而不检查任务领域,那将是一个错误。
在 Atlas Cloud 上的定价: 从 $1.40/M 输入 token 起——四者中最高。当前端生成质量直接影响你的输出时,这一点是合理的。
Qwen 3.6 Plus:当上下文大小是真正限制时
阿里巴巴于 2026 年 3 月底发布了 Qwen 3.6 Plus。在直接对比中,它在 Terminal-Bench 2.0 上领先 Claude Opus 4.6(61.6% vs. 59.3%),并在 SWE-Bench Verified 上得分 78.8%。
1M token 上下文窗口 是它的区别所在。对于大多数低于 100K token 的生产编码任务,此比较中的所有四个模型都有足够的上下文容量,差异无关紧要。但 Qwen 3.6 Plus 成为唯一可行选择的情况包括:跨数百个文件的单体仓库分析、大规模遗留代码库重构,或无法放入 262K token 的端到端文档到代码工作流。
其混合架构(线性注意力 + 稀疏 MoE 路由)在处理非常大的上下文时,也比密集变换器具有更好的推理吞吐量——这意味着 1M token 能力相对于朴素缩放,延迟成本较低。
在 Atlas Cloud 上的定价: 从 $0.325/M 输入 token 起。对于大型上下文任务,这是本组中可用的最佳每个有用 token 的成本。
MiniMax M2.7:效率的反直觉案例
MiniMax 于 2026 年 3 月发布了 M2.7。仅激活 10B 参数,在 SWE-Bench Pro 上得分为 56.22%——约为 GLM-5.1 得分的 94%,而每个 token 的成本大约是其五分之一。
这是此比较中的反直觉结果。一个在推理时仅激活 10B 参数的模型达到了接近前沿的编码性能,因为其 MoE 架构路由到专门的专家子网络,而不是运行完整的模型权重。结果是更低的延迟、更低的成本,以及超出参数数量本身预测的输出质量。
M2.7 在其价格点上领先的领域:机器学习工程任务。它在 MLE-Bench Lite 上获得了 66.6% 的奖牌率(22 个机器学习竞赛),仅次于前沿闭源模型。编写正确的梯度累积逻辑、实现自定义 PyTorch 层、调试损失曲线——M2.7 以与其成本不成比例的精确度处理这些任务。
需要注意的地方: 在 196K 上下文下,M2.7 在本组中拥有最小的窗口。需要深度跨文件分析的大型仓库任务可能会遇到限制,而 Qwen 3.6 Plus 可以轻松处理。
在 Atlas Cloud 上的定价: 输入 $0.30/M,输出 $1.20/M——对于高吞吐量编码工作负载来说是最实惠的选择。
真实世界编码测试案例
案例 1:Python 后端自主修复 Bug
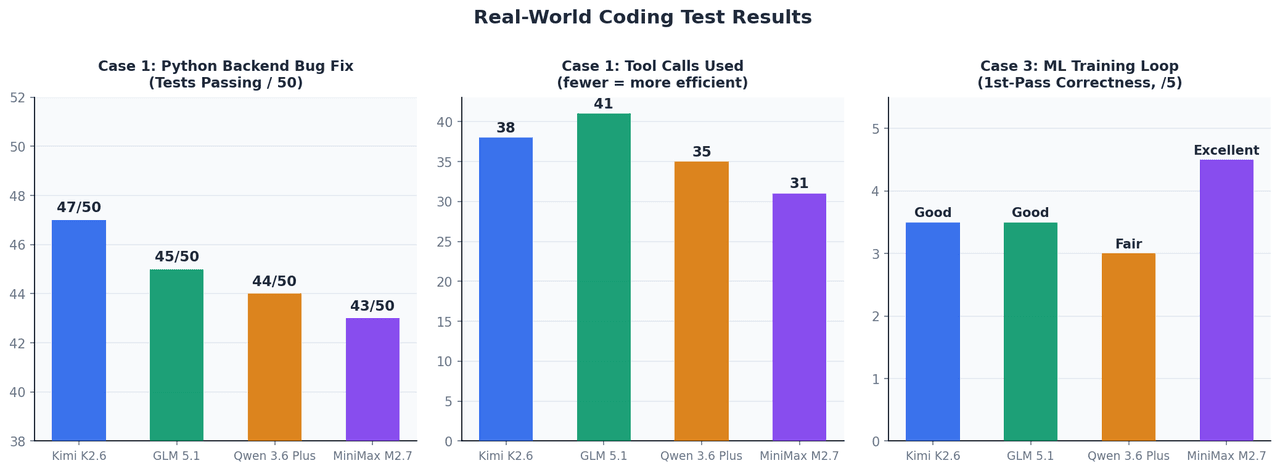
设置: 一个包含 12 个文件的 FastAPI 应用程序,包含 50 个测试的失败测试套件,上下文窗口约 45K token。初始提示后不允许人工干预。
| 模型 | 修复后通过的测试 | 使用的工具调用次数 | 完成时间 |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 分钟 |
| GLM 5.1 | 45 / 50 | 41 | ~5 分钟 |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 分钟 |
| MiniMax M2.7 | 43 / 50 | 31 | ~3.5 分钟 |
在此上下文大小下,所有四个模型的表现都在一个狭窄范围内。Kimi K2.6 在最难的边缘 Bug 上略胜一筹——特别是异步上下文管理器生命周期问题和 TypeVar 边界缩小,这些需要跨多个调试周期保持推理状态。
案例 2:根据规格生成 React 仪表盘
设置: 从英文书面规格生成一个完整的响应式仪表盘,包含四种图表类型(折线图、柱状图、饼图、散点图)、深色模式切换和 TypeScript 类型。
GLM-5.1 首次即生成了带有正确 Tailwind 实用类的可工作 TypeScript 类型组件。Kimi K2.6 需要一次迭代来解决类型错误。Qwen 3.6 Plus 生成了功能正确但不够惯用的 JSX。MiniMax M2.7 最快,但生成了一些需要手动清理的已弃用 React 模式。
GLM-5.1 与其他模型之间的差距在组件架构方面最为明显——GLM-5.1 自发地应用了组合模式并分离了关注点,而其他模型没有做到。
案例 3:ML 训练循环实现
设置: 为视觉变换器实现一个 PyTorch 训练循环,包含梯度累积、AMP 混合精度和早停。目标:首次尝试即可正确运行,无需调试循环。
MiniMax M2.7 表现突出——它正确地将 scaler.step() 和 scaler.update() 放置在优化器步骤的相应位置,这是大多数模型在首次生成时放错位置的细节。梯度累积的 loss / accumulation_steps 缩放也处理得当。这与它的 66.6% MLE-Bench Lite 奖牌率直接吻合。
Atlas Cloud 定价对比(2026 年 4 月)
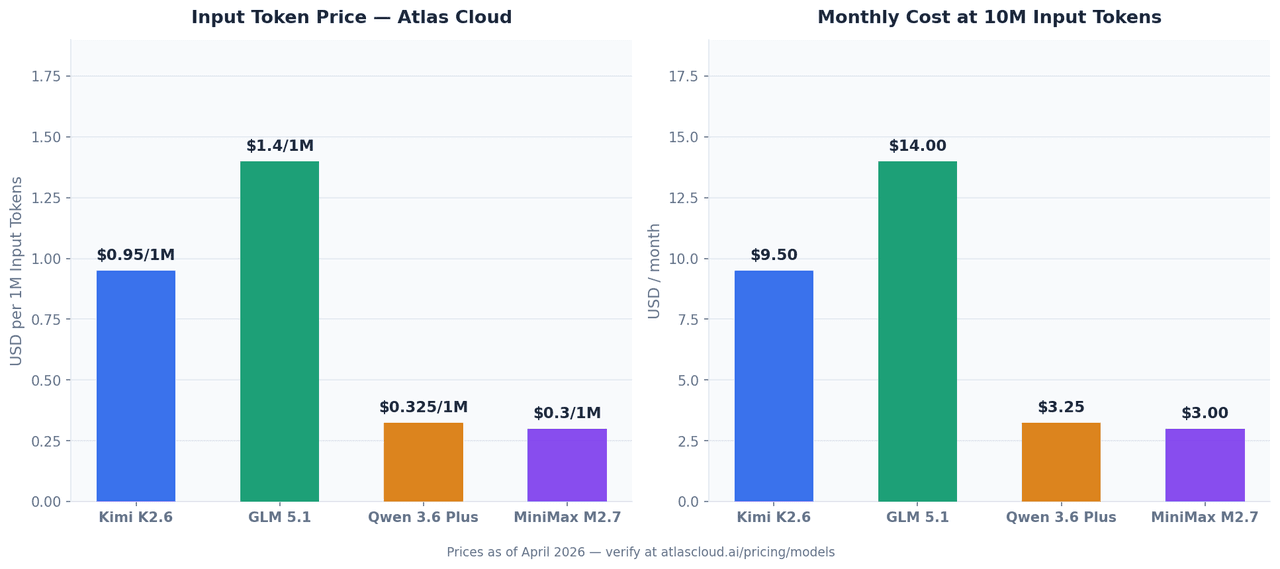
所有四个模型均可通过 Atlas Cloud 的统一 API 使用。以下价格为 2026 年 4 月数据,可能发生变化——请访问 atlascloud.ai 确认当前费率。
| 模型 | 输入(每 1M token) | 输出(每 1M token) | Atlas Cloud 模型 ID |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | 从 $1.40 起 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | 从 $0.325 起 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
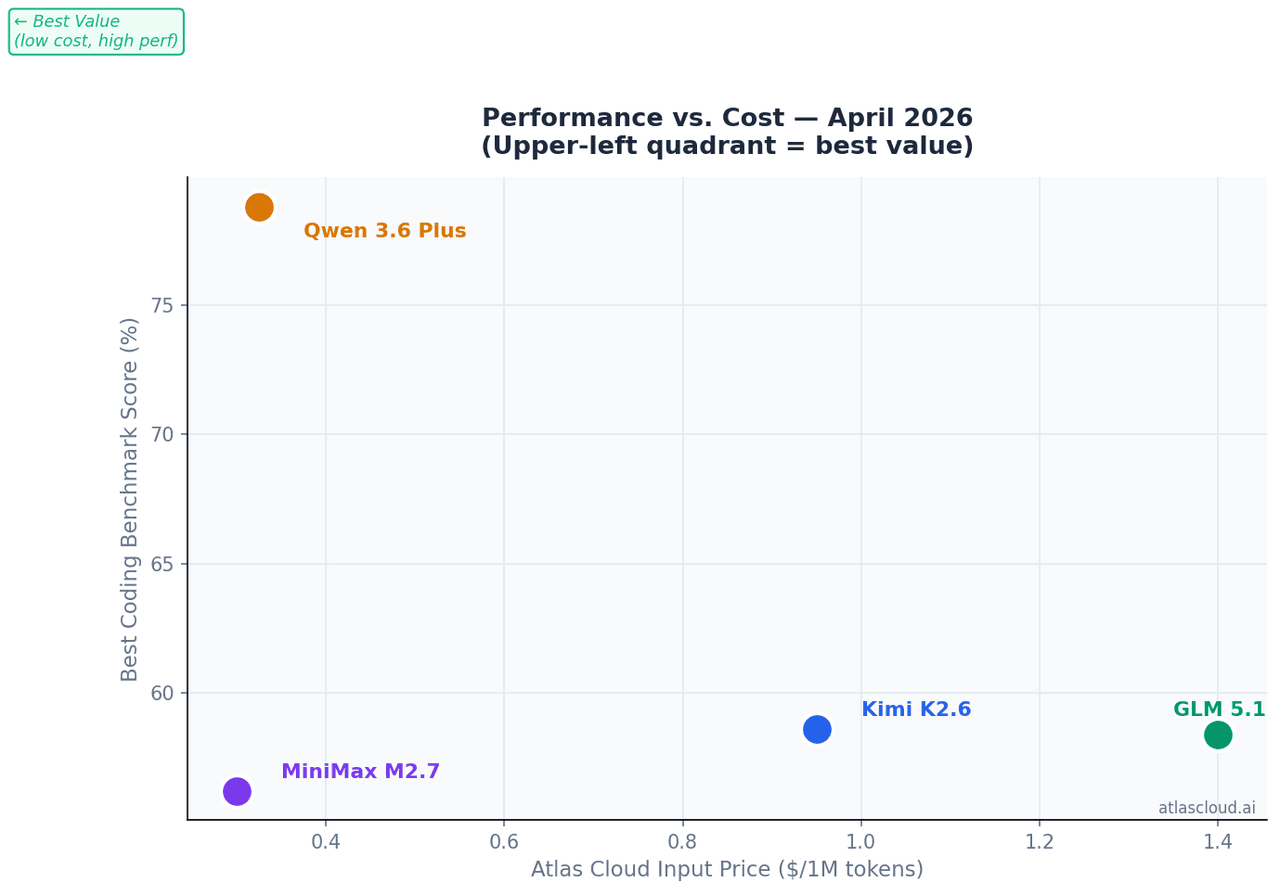
假设每月输入 1000 万 token——这是一个团队级编码助手的合理用量:
| 模型 | 每月输入成本(1000 万 token) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
使用一个 API 密钥调用所有四个模型
所有四个模型在 Atlas Cloud 上共享相同的 OpenAI 兼容端点。在它们之间切换只需更改一行代码:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# 切换模型只需更改这一行 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "你是一名资深软件工程师。在回复前请仔细分析代码。" 21 }, 22 { 23 "role": "user", 24 "content": "审查此函数并找出所有 Bug:\n\n[在此粘贴你的代码]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
这种 OpenAI 兼容结构意味着基于 OpenAI SDK 构建的现有集成无需修改即可与 Atlas Cloud 配合使用——只需更改 base_url 和 api_key。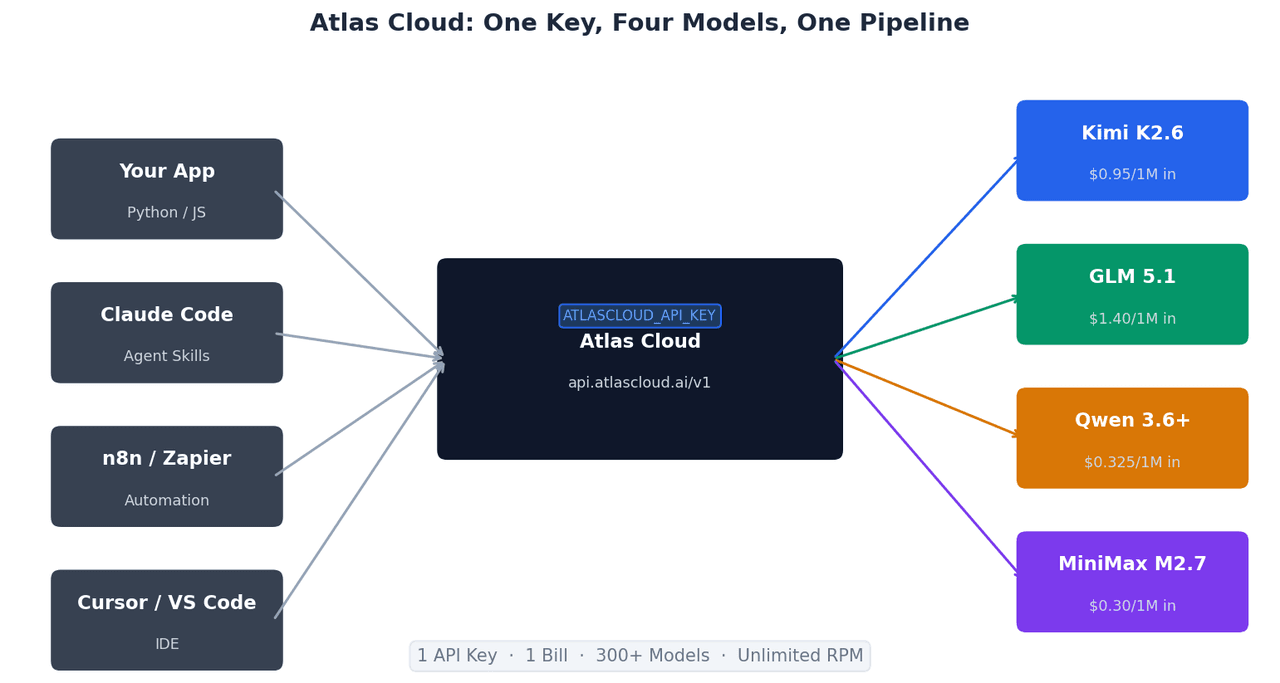
为什么通过 Atlas Cloud 使用这些模型
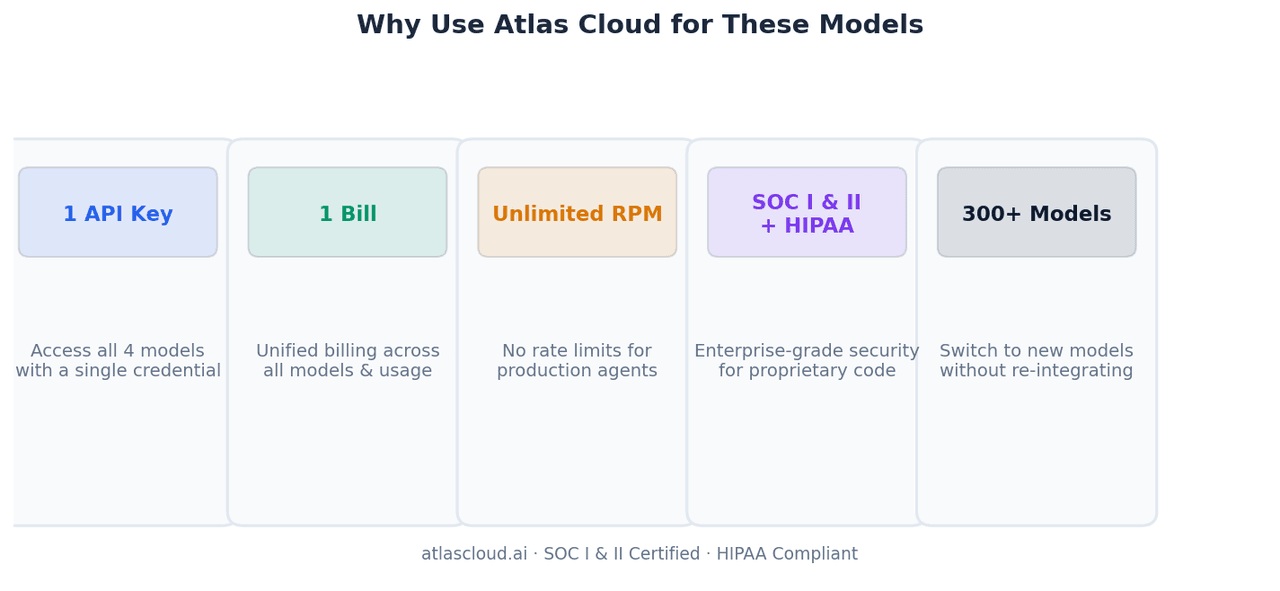
一个 API 密钥,四个模型,一张账单。 运行模型路由逻辑——将前端任务发送给 GLM-5.1,批量分析发送给 MiniMax M2.7,长时间运行的代理发送给 Kimi K2.6——只需管理一个凭证,而不是四个。月度对账是一张发票。
无限制 RPM。 生产编码代理会发出并行工具调用。直接提供商 API 上的速率限制可能会限制多代理管道。Atlas Cloud 消除了这一上限。
SOC I 和 II 认证,符合 HIPAA 标准。 通过这些模型处理专有源代码的团队需要可审计的基础设施。Atlas Cloud 的合规认证意味着你的代码不会通过未经验证的端点传输。
300+ 个模型,相同的集成模式。 当这些模型中的任何一个发布新版本,或者一个新模型在你的特定工作负载上超越它们时,将其添加到你的路由逻辑只需要一个字符串更改——而不是新的 SDK 集成。
每个任务选择哪个模型
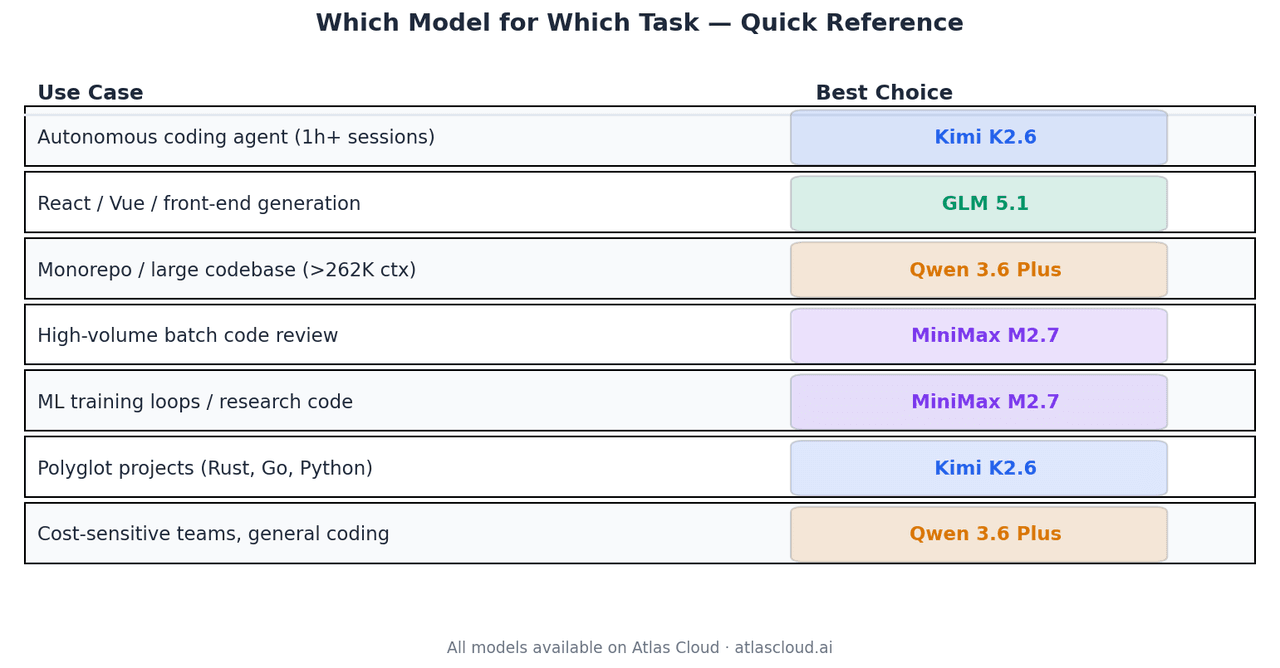
| 用途 | 最佳选择 | 原因 |
|---|---|---|
| 自主编码代理,1 小时以上会话 | Kimi K2.6 | 66.7% Terminal-Bench 2.0,4K+ 工具调用稳定性 |
| React / Vue / 前端生成 | GLM 5.1 | Code Arena Elo 1,530,全球智能网页开发前三 |
| 单体仓库或大型代码库分析 | Qwen 3.6 Plus | 此组中唯一支持 1M 上下文窗口的模型 |
| 高吞吐量批量代码审查 | MiniMax M2.7 | 输入 $0.30/M,质量达到 GLM-5.1 的 94% |
| ML 训练循环、研究代码 | MiniMax M2.7 | 66.6% MLE-Bench Lite 奖牌率 |
| 多语言项目(Rust、Go、Python) | Kimi K2.6 | 有文档记载的跨语言泛化能力 |
| 成本敏感的团队、通用编码 | Qwen 3.6 Plus | 输入 $0.325/M,在所有类别中表现强劲 |
总结
这四个模型在标准基准测试上的差距很小。有意义的差异出现在特定条件下。
Kimi K2.6 是自主长时间运行代理的正确选择。GLM 5.1 在前端智能工作方面领先。Qwen 3.6 Plus 是当上下文超过 262K token 时的唯一选择。MiniMax M2.7 是规模化运行编码模型的团队的成本效益默认选择。
所有四个模型均可通过 Atlas Cloud 在 atlascloud.ai 使用一个 API 密钥,按 token 付费,无最低消费承诺。
基准数据来源:Moonshot AI 的技术博客、Z.AI 开发者文档、阿里巴巴 Qwen 团队发布文章、MiniMax 官方模型页面以及 Arena.ai 独立评估。所有基准数据均为 2026 年 4 月数据。Atlas Cloud 定价以发布时为准——在投入生产前请确认当前费率。


