
 Atlas Cloud nay là nhà bán lại được ủy quyền tại Hoa Kỳ của Dreamina Seedance 2.5 và Seedream 5.0 Pro.Atlas Cloud nay là nhà bán lại được ủy quyền tại Hoa Kỳ của Dreamina Seedance 2.5 và Seedream 5.0 Pro.

Qwen là họ mô hình ngôn ngữ lớn của Alibaba Cloud, và Qwen API mở quyền truy cập toàn bộ dòng mô hình này cho nhà phát triển. Truy cập Qwen3.7 Max hàng đầu để xử lý suy luận và lập trình nâng cao, các mô hình mixture-of-experts hiệu quả ở nhiều quy mô, cùng Qwen3.5 Flash cho phản hồi tức thì với lưu lượng lớn. Trên Atlas Cloud, mọi mô hình đều chạy qua một endpoint duy nhất với mức giá pay-as-you-go minh bạch và quyền truy cập Day-0 vào các bản phát hành mới. Hãy bắt đầu xây dựng ngay hôm nay.
Qwen do Alibaba phát triển. Atlas Cloud (vận hành bởi Atlas Cloud AI LLC) cung cấp quyền truy cập vào mô hình này và không sở hữu mô hình. Mọi thương hiệu đều thuộc về chủ sở hữu tương ứng.
Atlas Cloud cung cấp cho bạn các mô hình sáng tạo tiên tiến nhất trong ngành.
Xem cách từng endpoint Qwen API biến prompt văn bản thành văn bản được tạo ra, từ các trợ lý nhẹ, nhanh đến những mô hình suy luận flagship, để bạn chọn đúng mô hình cho workload của mình.
| Phương thức | Mô tả |
|---|---|
| Qwen3.6 35B A3B (Văn bản sang văn bản) | Mô hình suy luận mới nhất trong dòng sản phẩm, endpoint mixture-of-experts 35B này kích hoạt khoảng 3B tham số trên mỗi token, giúp suy luận sâu vẫn có chi phí hợp lý. Hãy dùng cho các bài toán nhiều bước, logic và phân tích, nơi chất lượng chain-of-thought quan trọng hơn tốc độ thuần túy. |
| Qwen3.6 Plus (Văn bản sang văn bản) | Linh hoạt trên các workflow chat và năng suất, Qwen3.6 Plus kết hợp chất lượng hội thoại mạnh với prompt caching và định giá theo tầng mở rộng vượt 256K tokens. Hãy chọn khi trợ lý cần duy trì mạch lạc trên tài liệu dài hoặc các phiên nhiều lượt kéo dài. |
| Qwen3.5 122B A10B (Văn bản sang văn bản) | Chạy khoảng 10B tham số hoạt động trên mỗi token, mô hình mixture-of-experts 122B này đánh đổi một chút quy mô để có suy luận nhanh hơn và rẻ hơn. Phù hợp cho tạo văn bản tổng quát, tóm tắt và suy luận khi bạn muốn chất lượng của mô hình lớn với chi phí tầm trung. |
| Qwen3.5 35B A3B (Văn bản sang văn bản) | Khi cả thông lượng lẫn ngân sách đều quan trọng, endpoint MoE 35B này chỉ giữ khoảng 3B tham số hoạt động trên mỗi token. Dùng cho chat lưu lượng cao, soạn thảo và phân loại — những tác vụ sẽ lãng phí nếu chạy trên mô hình flagship. |
| Qwen3.5 27B (Văn bản sang văn bản) | Là mô hình dense 27B, Qwen3.5 27B mang lại độ trễ dễ dự đoán và chất lượng ổn định mà không cần định tuyến mixture-of-experts. Phù hợp với các tác vụ tạo nội dung và làm theo chỉ dẫn trực tiếp, vốn hưởng lợi từ một nền tảng gọn nhẹ, đáng tin cậy. |
| Qwen3.5 397B A17B (Văn bản sang văn bản) | Mô hình lớn nhất trong tier 3.5, endpoint mixture-of-experts 397B này kích hoạt khoảng 17B tham số trên mỗi token và bổ sung prompt caching để giảm chi phí cho ngữ cảnh lặp lại. Hãy dùng cho các tác vụ suy luận và tạo nội dung đòi hỏi năng lực sâu nhất của dòng mô hình này. |
| Qwen3.7 Max (Văn bản sang văn bản) | Là flagship, Qwen3.7 Max nhắm đến suy luận nâng cao, lập trình và các tác vụ nhiều bước phức tạp, kèm prompt caching để giảm chi phí trên ngữ cảnh lặp lại. Chọn mô hình này cho các pipeline agentic, bài toán lập trình khó và workload nơi độ chính xác quan trọng hơn giá. |
| Qwen3.5 Plus (Văn bản sang văn bản) | Được thiết kế để hiệu quả, Qwen3.5 Plus vận hành các tác vụ hằng ngày và trợ lý AI, đồng thời hỗ trợ prompt caching và input vượt 256K tokens. Đây là lựa chọn mặc định đáng tin cậy cho trợ lý production cần chất lượng ổn định với chi phí dễ kiểm soát. |
| Qwen3.7 Plus (Văn bản sang văn bản) | Cần năng lực, tốc độ và hiệu quả trong một mô hình? Qwen3.7 Plus cân bằng cả ba, bổ sung prompt caching và áp dụng định giá theo tầng cho prompt vượt 256K tokens. Triển khai cho trợ lý ở quy mô lớn và các workflow nhiều tài liệu nhưng vẫn cần phản hồi nhanh. |
| Qwen3.5 Flash (Văn bản sang văn bản) | Được tối ưu cho phản hồi tức thì và sử dụng quy mô lớn, Qwen3.5 Flash là lựa chọn nhanh nhất và kinh tế nhất trong dòng mô hình. Đưa vào chat lưu lượng cao, autocomplete và các tính năng thời gian thực nơi độ trễ thấp là ưu tiên. |
| Qwen3 VL 235B A22B Thinking (Văn bản sang văn bản) | Endpoint được tinh chỉnh cho suy luận này chạy kiến trúc mixture-of-experts 235B với khoảng 22B tham số hoạt động và một chế độ thinking chuyên dụng. Hãy dùng cho giải quyết vấn đề có cấu trúc và phân tích, nơi suy luận tường minh từng bước mang lại lợi ích. |
| Qwen3-235B-A22B-Instruct-2507 (Văn bản sang văn bản) | Với tổng cộng 235B tham số và khoảng 22B tham số hoạt động trên mỗi token, mô hình MoE được tinh chỉnh theo chỉ dẫn này trong series Qwen3 xử lý tốt tạo văn bản và suy luận trên phạm vi rộng. Bản phát hành 2507 khiến nó trở thành lựa chọn vững chắc cho trợ lý đa mục đích và pipeline nội dung trên Qwen API. |
Qwen API kết hợp tư duy hai chế độ, gọi hàm gốc, ngữ cảnh vượt 256K tokens, hỗ trợ 119 ngôn ngữ và bộ nhớ đệm prompt sau một khóa tương thích OpenAI duy nhất, trải dài từ Qwen3.5 Flash đến Qwen3.7 Max.
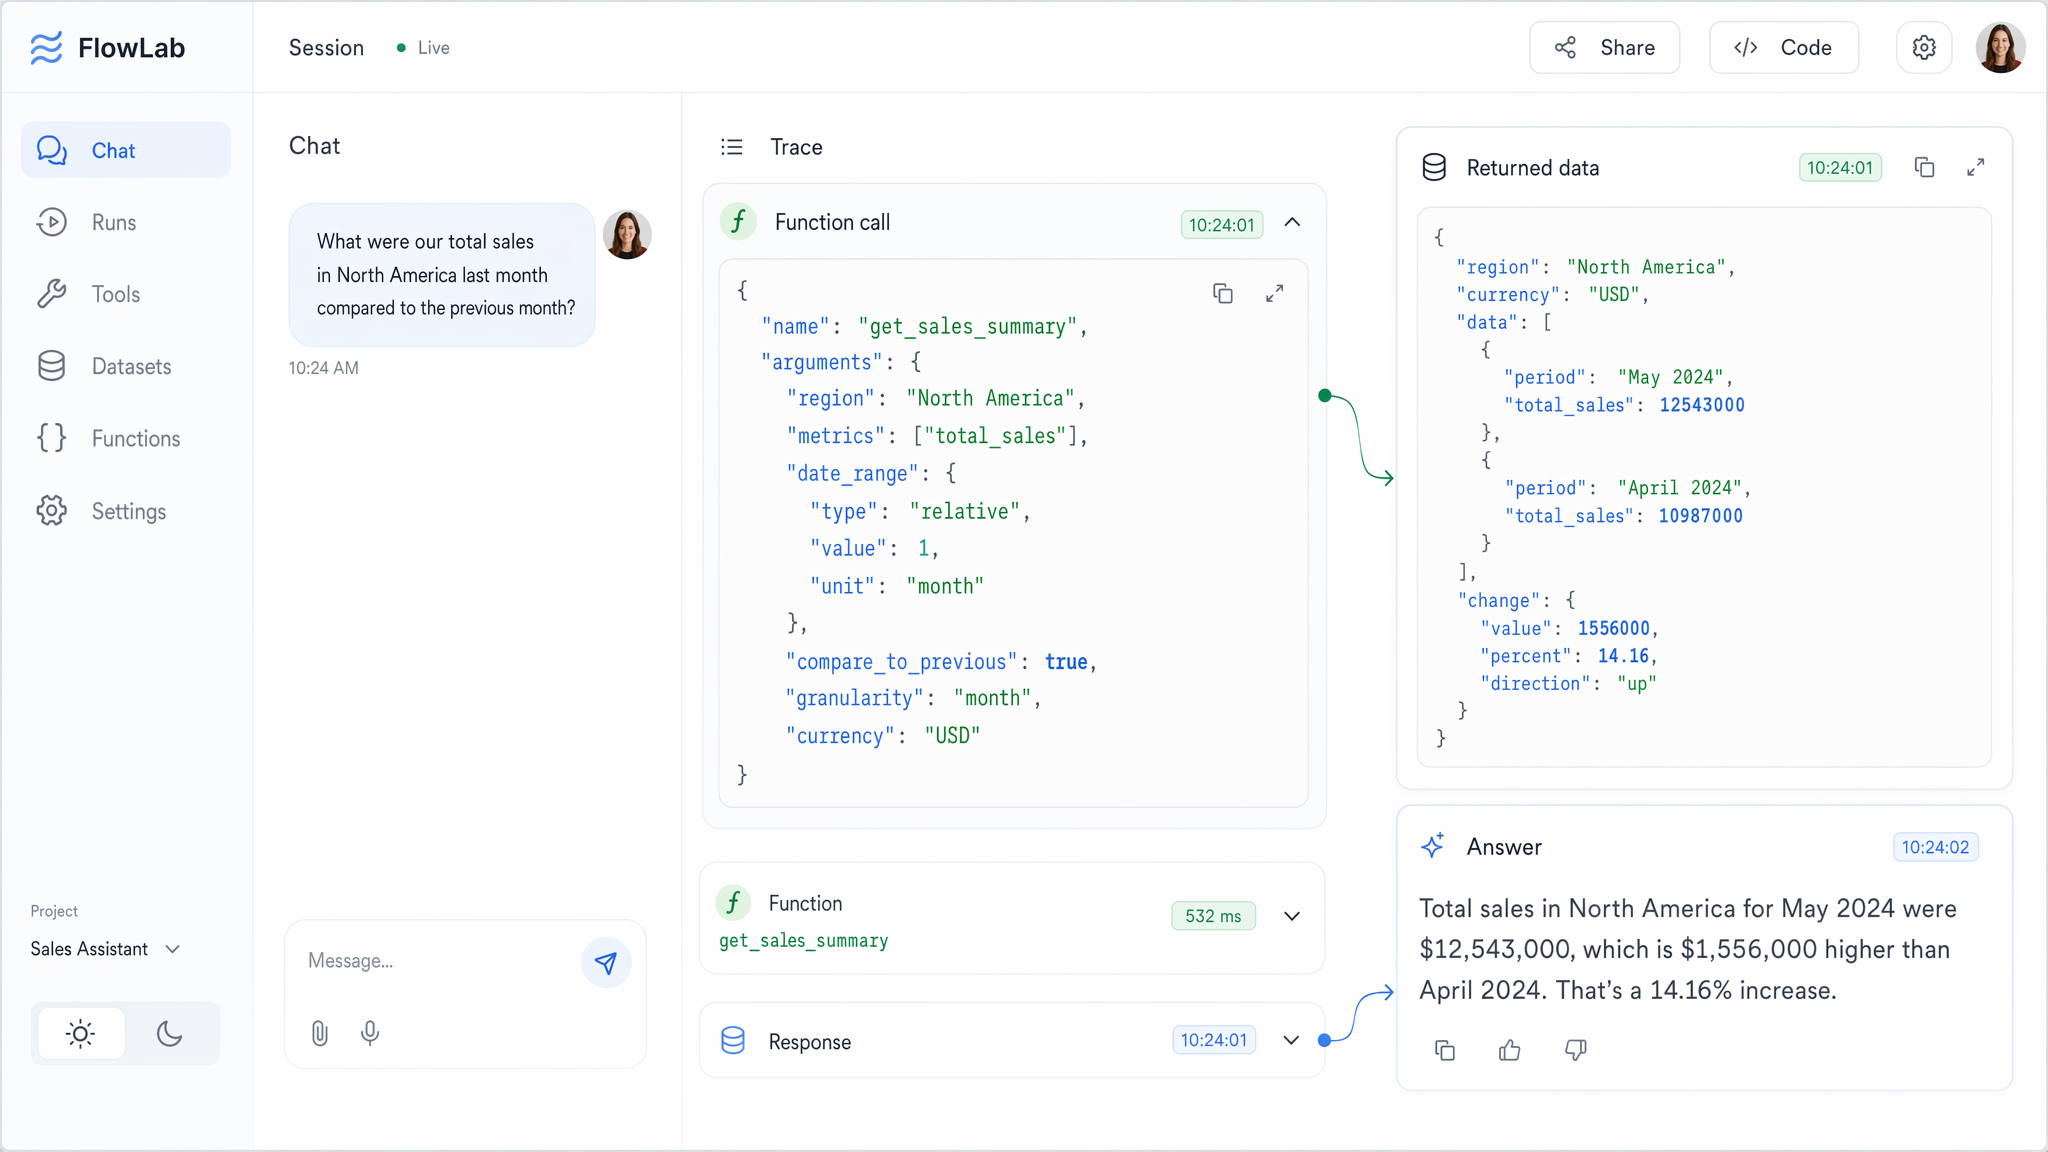
Gọi hàm cho phép các mô hình Qwen phát ra các lệnh gọi công cụ có cấu trúc, kết nối trực tiếp với API, cơ sở dữ liệu và máy chủ MCP của riêng bạn. Mô hình quyết định khi nào cần gọi hàm, định dạng đối số, rồi đưa kết quả trở lại câu trả lời. Kết hợp với endpoint tương thích OpenAI, điều này biến mã SDK hiện có thành các tác nhân tự động, pipeline truy xuất và tự động hóa quy trình làm việc.
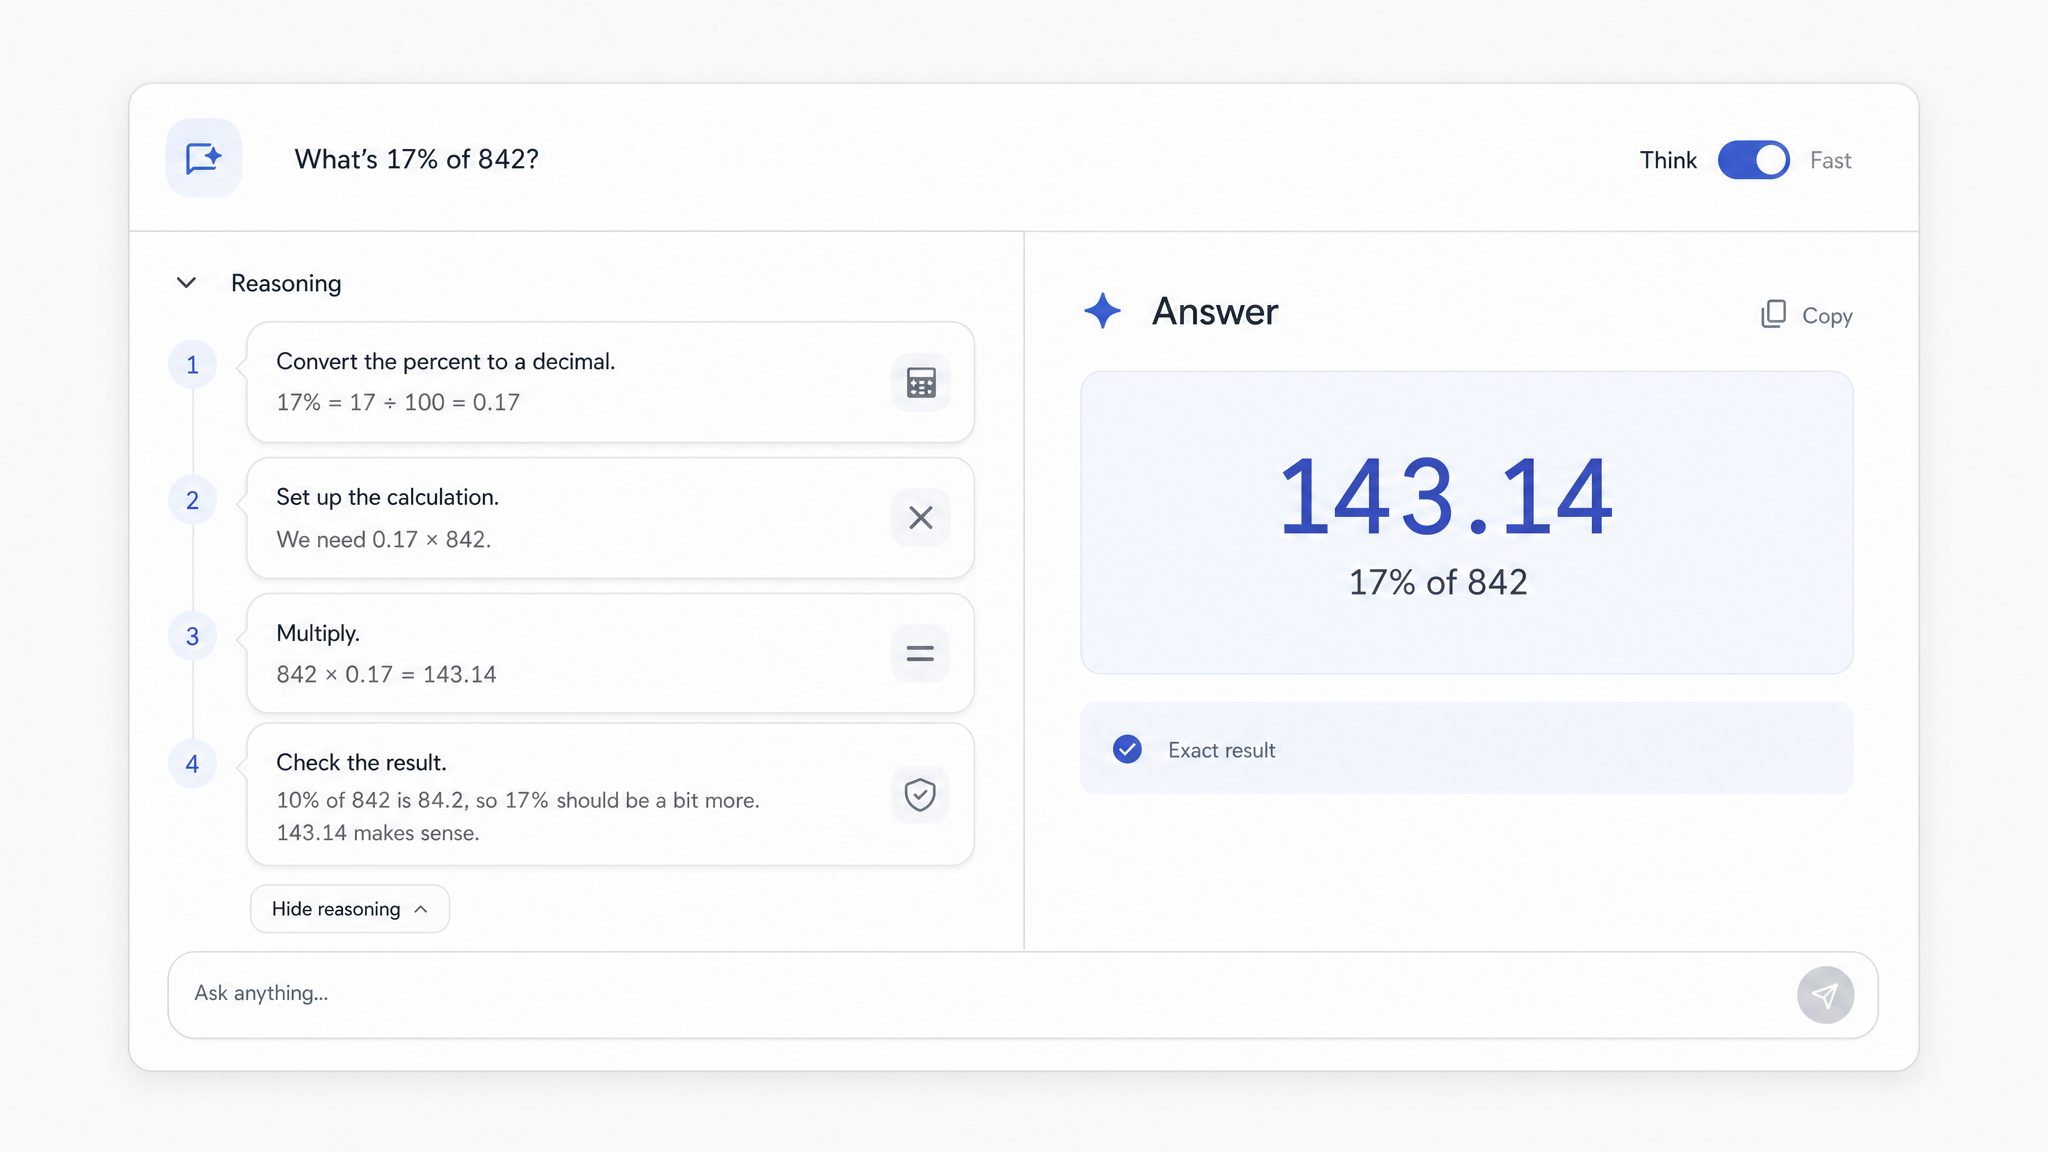
Chuyển một mô hình duy nhất giữa chế độ tư duy có chủ đích cho toán học, logic và lập trình, với chế độ không tư duy nhanh cho hội thoại hằng ngày. Các mô hình suy luận như Qwen3.6 35B A3B và flagship Qwen3.7 Max cung cấp chiều sâu này thông qua một endpoint duy nhất. Khi tác vụ cần suy luận từng bước, bạn bật thinking; khi độ trễ là ưu tiên, bạn tắt nó đi mà không cần đổi mô hình hay khóa.
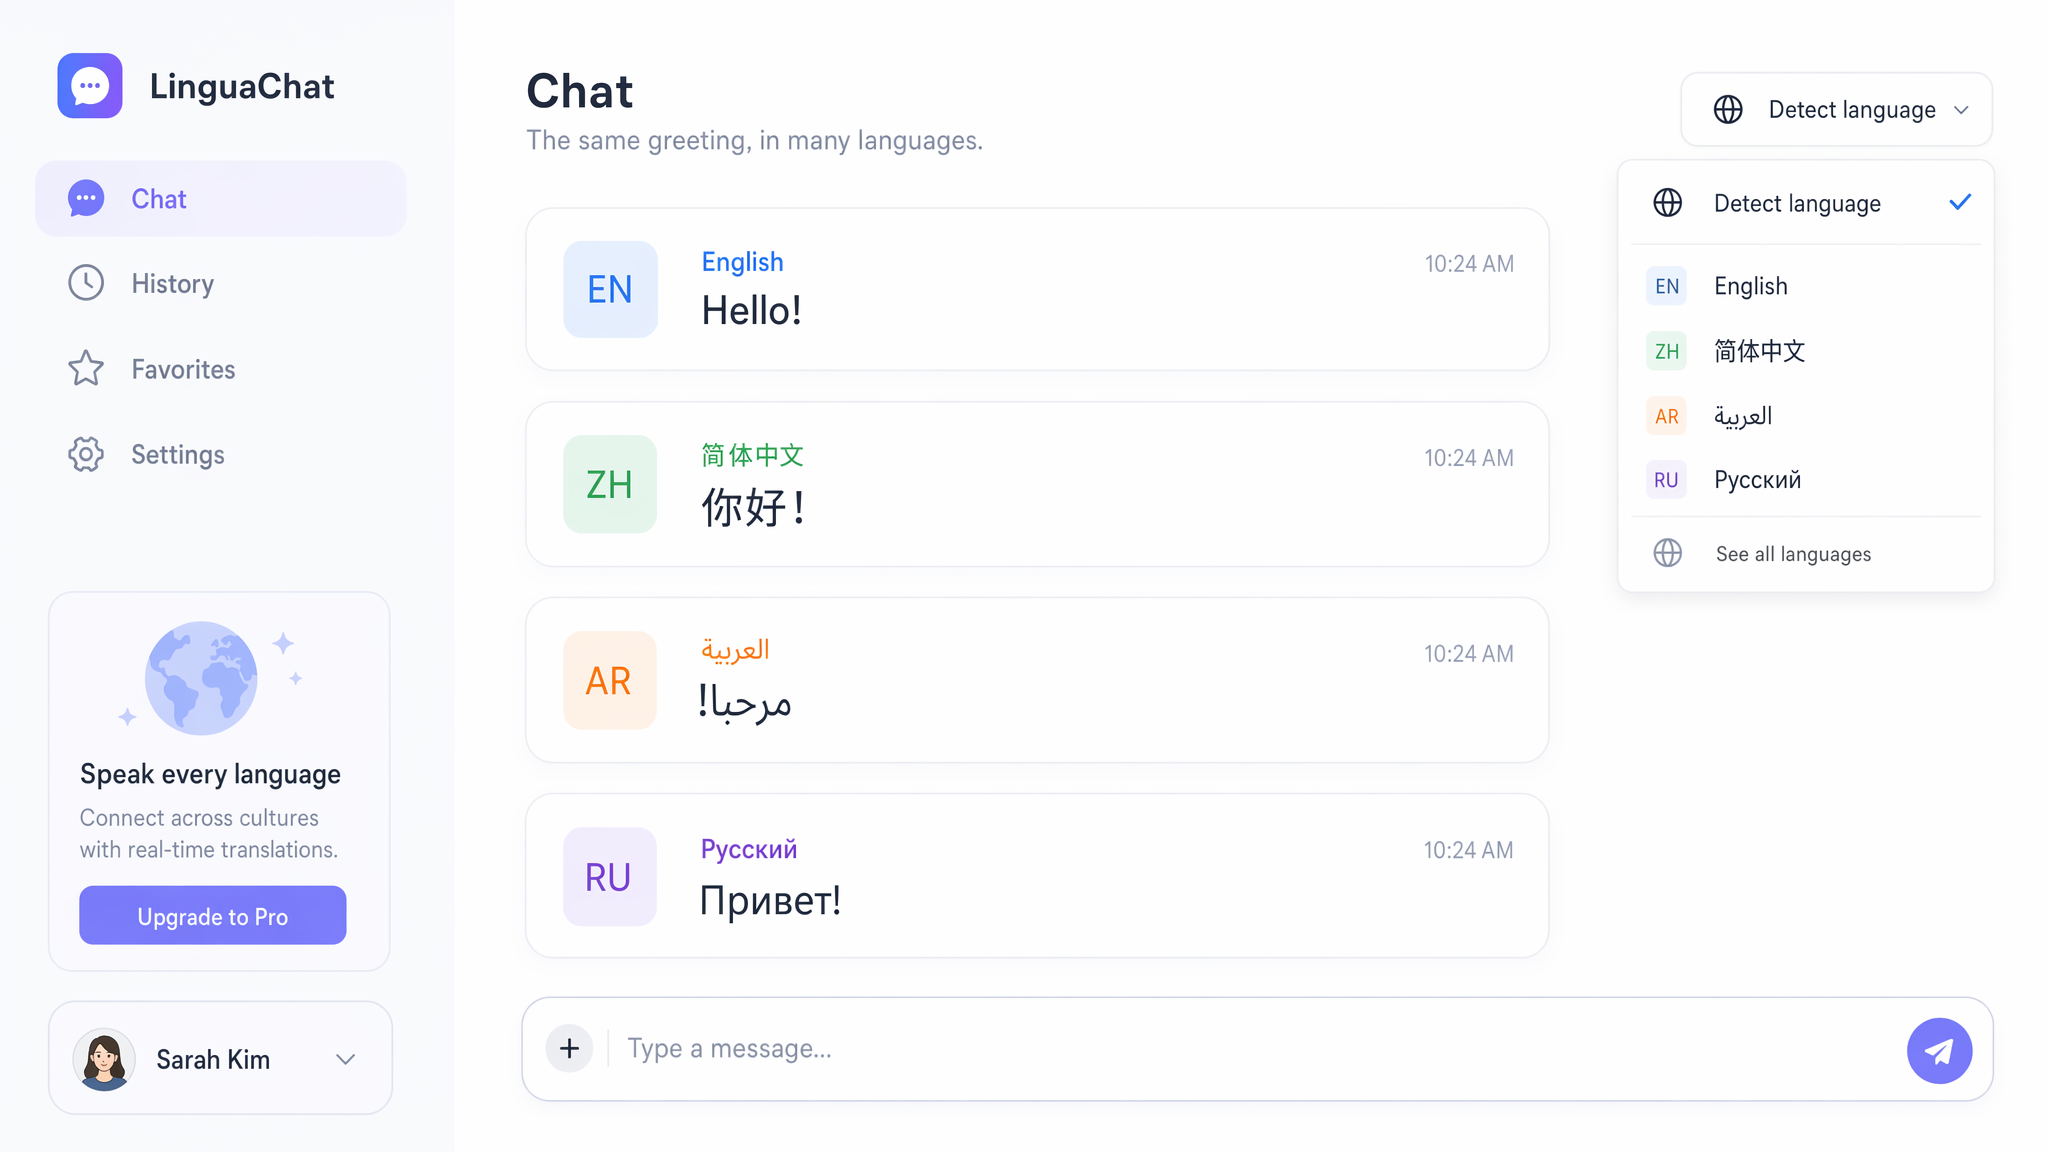
Được huấn luyện trên 119 ngôn ngữ và phương ngữ, Qwen xử lý việc làm theo chỉ dẫn đa ngôn ngữ và dịch thuật với độ trôi chảy tương đương ở tiếng Trung và tiếng Anh. Một prompt duy nhất có thể chuyển đổi giữa các ngôn ngữ mà không cần dịch vụ dịch riêng. Các đội ngũ triển khai sản phẩm cho người dùng toàn cầu dựa vào nó để tạo chat đã bản địa hóa, tìm kiếm liên ngôn ngữ và nội dung đọc tự nhiên ở từng thị trường mục tiêu.
Từ Qwen3.5 Flash có độ trễ thấp đến flagship Qwen3.7 Max, toàn bộ họ mô hình đều dùng chung một khóa tương thích OpenAI. Các thiết kế mixture-of-experts hiệu quả như 397B A17B và 235B A22B chỉ kích hoạt một phần tham số cho mỗi token, và mọi cấp đều dùng cùng một định dạng yêu cầu. Định tuyến các lời gọi đơn giản đến Flash và các tác vụ suy luận khó đến Max mà không cần viết lại dòng mã tích hợp nào.
Ngữ cảnh lặp lại được tính phí theo mức đã lưu trong cache, thấp hơn nhiều so với giá input tiêu chuẩn, nên system prompt và tài liệu dùng chung sẽ tốn ít chi phí hơn ở mỗi lần gọi tiếp theo. Giá vẫn theo mô hình trả theo mức sử dụng và minh bạch, với đơn giá theo token được công bố và không cần thuê bao. Các trợ lý lưu lượng cao, RAG stack và cuộc hội thoại dài hưởng lợi nhiều nhất, vì cùng một tiền tố được gửi đi lặp đi lặp lại.
Đưa cùng một bản mô tả y hệt cho Qwen API và các engine đối thủ, rồi xem từng model biến chính chỉ dẫn đó thành một trang web một file hoạt động được, có thể mở và bấm ngay.
Xây dựng một trang HTML hoàn chỉnh, dạng một file duy nhất, tự chứa toàn bộ (toàn bộ CSS và JavaScript được nhúng inline trong một file .html) để render một "Khung cửa tiệm bánh Pháp lúc khuya" có tính tương tác — một tủ trưng bày bánh tráng miệng boutique vẫn tỏa ánh sáng ấm áp sau giờ đóng cửa. Ràng buộc tuyệt đối: KHÔNG dùng bất kỳ tài nguyên bên ngoài nào — không CDN, không stylesheet hay script liên kết ngoài, không web font, không thẻ `<img>`, không file SVG, không ảnh base64, không dùng emoji làm hình minh họa. Mọi hình ảnh phải được dựng hoàn toàn bằng các phần tử HTML được tạo kiểu bằng CSS: linear/radial/conic gradient xếp lớp, box-shadow chồng lớp và inset, border-radius, blur/backdrop-filter, transform, và chỉ các hình vẽ bằng canvas hoặc DOM. Đây là bài kiểm tra khả năng render vật liệu và ánh sáng giả thực chỉ bằng vector CSS. Bối cảnh: góc nhìn chính diện, ngang tầm mắt, nhìn vào khung kính của tiệm bánh patisserie; các kệ được sắp xếp theo bố cục rule-of-thirds dịu mắt. Trên kệ là một hàng ít nhất bốn món tráng miệng khác nhau, được chế tác tỉ mỉ, mỗi món dựng hoàn toàn từ gradient và shadow: (1) một vòm mousse chocolate-cocoa bóng loáng với lớp mirror-glaze thể hiện highlight phản chiếu mềm và ánh sáng phản xạ; (2) một mille-feuille có nhiều lớp puff-pastry giòn, tách lớp rõ ràng; (3) một tháp macaron nhiều tầng với vỏ hơi lì, phủ đường mịn như sương; (4) một tart chanh đặt trên đĩa xoay quay chậm. Mô phỏng chiều sâu thuyết phục: spotlight vàng ấm từ phía trên (đèn trưng bày của khung cửa) tương phản với ánh đêm xanh lạnh xung quanh, có bóng đổ, rim light ở các cạnh và phản chiếu bóng nhẹ nhàng. Một lớp kính tinh tế nổi phía trước mọi thứ — phản chiếu mờ, vệt loang và những giọt ngưng tụ rải rác — đồng thời có phản chiếu mềm của từng món bánh trên bề mặt kệ bên dưới. Tương tác (tất cả chuyển tiếp bằng CSS/JS mượt, có cảm giác đàn hồi): - DI CHUỘT lên một món bánh: món đó nhấc nhẹ lên, spotlight và bóng đổ đậm hơn, và animation "cắt lớp" dạng cutaway hé lộ cấu trúc bên trong — các lớp kem, ganache, curd và đế biscuit/pastry được vẽ bằng các dải gradient xếp chồng kèm nhãn. - BẤM vào một món bánh để vào chế độ "Tùy chỉnh": một panel thanh lịch xuất hiện với slider và toggle cho phép người dùng thêm và điều chỉnh các chi tiết trang trí theo thời gian thực — hạt đường trang trí (slider mật độ), caramel kéo sợi rưới lên (lượng + độ dày sợi), và lớp mirror-glaze/pectin bóng (slider độ bóng), cùng một lớp drizzle màu đỏ berry làm điểm nhấn. Món bánh phải được vẽ lại trực tiếp khi giá trị thay đổi, với highlight/độ bóng phản hồi theo giá trị độ bóng. Cung cấp điều khiển "Đặt lại" và "Thoát". Lưu trạng thái tùy chỉnh của từng món khi chuyển qua lại giữa chúng. - Điểm nhấn môi trường tùy chọn: đèn ấm nhấp nháy rất nhẹ, hơi nước ngưng tụ trôi lơ đãng, và bàn xoay của tart chanh quay lặp. Phong cách hình ảnh: tinh tế, ấm cúng, quyến rũ với tâm trạng đêm khuya; bảng màu caramel nâu, trắng kem và đỏ berry, nhấn bằng xanh mint, trên nền đêm xanh lạnh sâu. Typography nên mang cảm giác một tiệm patisserie sang trọng — đặt heading và tên món bánh bằng stack serif chỉ dùng CSS, thanh lịch, với letter-spacing rộng rãi; giữ bố cục gọn gàng, có trật tự và responsive để hiển thị đẹp từ mobile đến màn hình rộng. Ưu tiên micro-animation tinh tế, chiều sâu nhiều lớp và độ chân thực vật liệu hơn là sự rườm rà. Bao gồm mọi thứ cần thiết để mở file trực tiếp trong trình duyệt và tương tác ngay. Chỉ xuất toàn bộ tài liệu HTML, không thêm gì khác.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.5 397BA17B on Atlas Cloud
Tạo một file HTML tự chứa duy nhất (toàn bộ CSS và JavaScript inline, tuyệt đối không dùng thư viện bên ngoài, CDN, hình ảnh, font hay network request) để render một game chèo kayak vượt thác thời gian thực, chơi được, có tên "Rapid Run", hoàn toàn trên một phần tử HTML5 Canvas duy nhất, lấp đầy cửa sổ trình duyệt và luôn responsive khi resize. Góc nhìn là camera top-down ngôi thứ ba với phối cảnh hơi hướng về phía trước, nhìn xuống một dòng suối núi alpine được tạo theo thủ tục, cuộn liên tục từ trên xuống dưới và không bao giờ lặp lại: seed level bằng bộ sinh noise/giả ngẫu nhiên để mỗi lượt chơi khắc ra một lòng sông phân nhánh khác nhau, có các luồng hẹp dần, đá tảng giữa dòng, xoáy nước cuộn, thác nhỏ đổ bậc và những dải sóng bọt trắng cuồn cuộn. Người chơi điều khiển một chiếc kayak màu crimson-and-amber nằm gần một phần ba dưới màn hình trong khi dòng sông lao qua; lái bằng phím mũi tên Trái/Phải (hoặc A/D) để nghiêng cạnh và lượn carving, đồng thời cho chuột đóng vai trò mái chèo — kayak nghiêng và kéo về vị trí ngang của chuột, với cú bấm hoặc giữ nút để cắm một nhịp chèo mạnh, giật thuyền vào một đường chạy chặt hơn. Mô phỏng nước như một flow field sống được dẫn bởi nhiều lớp noise cuộn: dòng chảy đẩy kayak xuôi dòng và lệch ngang, nhanh hơn ở tongue và chậm hơn trong eddy, vì vậy người chơi phải đọc mặt nước và chiến đấu để giữ racing line. Phát ra một hệ particle phong phú, thân thiện với GPU — quạt tia nước bắn khỏi mũi thuyền khi đập vào sóng, wake nhiễu động kéo sau đuôi thuyền, mảng bọt nổ tung khi va chạm, và vòng gợn lan ra từ xoáy nước. Đâm vào đá sẽ làm thuyền quay mất kiểm soát với rung lắc mạnh, tạm thời mất điều khiển và camera giật rung. Render theo phong cách minh họa phẳng sắc nét hòa với chút chân thực chất lỏng: mặt nước có gợn động và ánh lấp lánh khúc xạ từ flow field, ánh sáng đỉnh cao nguyên giữa trưa, specular trắng lạnh trên tia nước, và các vực nước sâu chuyển sắc từ xanh ngọc turquoise sang teal đậm như mực. Bảng màu chủ đạo là glacier cyan-blue, với vermilion-orange-yellow của kayak làm điểm nhấn nổi bật; bờ sông phủ đá xám và xanh thông. Bao gồm HUD trên màn hình: quãng đường đã đi, tốc độ hiện tại, thanh stability/health giảm khi va đá và điểm số live; hiển thị màn hình bắt đầu với hướng dẫn điều khiển ngắn, màn hình game-over khi stability cạn với tùy chọn Restart, và tăng dần độ khó (dòng chảy nhanh hơn, chướng ngại dày hơn) càng đi xuống xa hơn. Nhắm tới vòng lặp game 60fps mượt bằng requestAnimationFrame với vật lý delta-time, tất cả được tinh chỉnh để tạo cảm giác thật sự căng thẳng và thỏa mãn, nơi việc chinh phục một đường sạch qua luồng thác đầy bọt phải mang cảm giác xứng đáng.
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.7 Max on Atlas Cloud
Xem Qwen API so sánh như thế nào với các mô hình văn bản chủ lực khác trên Atlas Cloud về độ dài ngữ cảnh, giới hạn đầu ra, loại đầu vào được hỗ trợ và mức giá minh bạch theo từng lệnh gọi.
| Mô hình | Cửa sổ ngữ cảnh | Số token đầu ra tối đa | Loại đầu vào | Giá đầu vào ($/1M) | Giá đầu ra ($/1M) |
|---|---|---|---|---|---|
| Qwen3.7 Max | 1M | 67,072 | Văn bản | $2.50 | $7.50 |
| Qwen3.7 Plus | 1M | 67,072 | Văn bản | $0.40 (≤256K) / $1.20 (>256K) | $1.60 / $4.80 |
| Qwen3.6 35B A3B | 256K | 65,536 | Văn bản, Hình ảnh, Video | $0.248 | $1.485 |
| Qwen3.5 Flash | 1M | 67,072 | Văn bản | $0.10 | $0.40 |
| DeepSeek V4 Pro | 1M | 393,216 | Văn bản | $1.74 | $3.45 |
| Grok 4.5 | 500K | 500,000 | Văn bản | $2.00 | $6.00 |
| GLM 5.2 | 1M | 131,072 | Văn bản | $1.40 | $4.40 |
Bắt đầu trong vài phút — làm theo các bước đơn giản sau để tích hợp và triển khai mô hình qua nền tảng Atlas Cloud.
Đăng ký tại atlascloud.ai và hoàn tất xác minh. Người dùng mới nhận được tín dụng miễn phí để khám phá nền tảng và thử nghiệm mô hình.
Sự kết hợp của các mô hình tiên tiến của Qwen với nền tảng được tăng tốc GPU của Atlas Cloud mang lại hiệu suất, khả năng mở rộng và trải nghiệm nhà phát triển độc đáo.
Độ Trễ Thấp:
Suy luận được tối ưu hóa GPU cho suy luận thời gian thực.
API Thống nhất:
Chạy Qwen, GPT, Gemini và DeepSeek với một tích hợp duy nhất.
Giá cả Minh bạch:
Thanh toán dựa trên token có thể dự đoán với tùy chọn serverless.
Trải nghiệm Nhà phát triển:
SDK, phân tích, công cụ tinh chỉnh và mẫu.
Độ tin cậy:
99,99% khả dụng, RBAC và ghi nhật ký sẵn sàng cho tuân thủ.
Bảo mật và Tuân thủ:
SOC 2 Type II, tuân thủ HIPAA, chủ quyền dữ liệu tại Hoa Kỳ.
Qwen API cho phép nhà phát triển truy cập theo chương trình vào họ mô hình ngôn ngữ lớn Qwen của Alibaba Cloud để tạo văn bản, suy luận, lập trình và xử lý các tác vụ đa ngôn ngữ. Trên Atlas Cloud, bạn có thể truy cập toàn bộ dòng mô hình thông qua một endpoint tương thích với OpenAI, nên chỉ cần một khóa là dùng được mọi mô hình Qwen.
Atlas Cloud cung cấp một danh mục rộng, từ Qwen3.5 Flash nhanh và tiết kiệm, đến các tier Plus linh hoạt và mô hình đầu bảng Qwen3.7 Max được xây dựng cho suy luận và lập trình nâng cao. Các mô hình tập trung vào suy luận như Qwen3.6 35B A3B và các biến thể mixture-of-experts lớn như Qwen3.5 397B A17B cũng sẵn sàng cho các khối lượng công việc nặng hơn.
Bạn chỉ cần vài bước để bắt đầu: tạo tài khoản Atlas Cloud, tạo API key và trỏ client tương thích với OpenAI hiện có của bạn đến Atlas endpoint. Giá được tính theo mức dùng thực tế với đơn giá minh bạch cho từng lệnh gọi, và quyền truy cập Day-0 nghĩa là các bản phát hành Qwen mới sẽ sẵn sàng ngay khi ra mắt. Hãy bắt đầu xây dựng ngay hôm nay.
Có. Qwen API trên Atlas Cloud tuân theo định dạng OpenAI chat completions, nên hầu hết SDK hoạt động chỉ bằng cách thay base URL và key. Bạn có thể giữ nguyên bộ công cụ hiện tại và gọi bất kỳ mô hình Qwen nào mà không cần viết lại phần tích hợp.
Các mô hình Qwen trên Atlas Cloud dùng mô hình giá minh bạch theo mức dùng thực tế, tính phí theo token và không yêu cầu đăng ký thuê bao. Giá bắt đầu từ $0.1 cho mỗi triệu input tokens và $0.4 cho mỗi triệu output tokens với Qwen3.5 Flash, tăng lên $2.5 và $7.5 cho mỗi triệu tokens với mô hình đầu bảng Qwen3.7 Max, giúp bạn điều chỉnh chi phí phù hợp với từng khối lượng công việc.
Các mô hình đầu bảng như Qwen3.7 Max cung cấp cửa sổ ngữ cảnh lên đến một triệu tokens, phù hợp với tài liệu dài, codebase lớn và lịch sử hội thoại kéo dài. Họ mô hình này cũng bao gồm các biến thể văn bản và vision-language như Qwen3-VL, giúp bạn có thêm lựa chọn khi tác vụ không chỉ là prompt thuần văn bản.
Ngoài chat thông thường, các mô hình Qwen hỗ trợ phản hồi streaming, function calling và sử dụng công cụ có cấu trúc thông qua các tham số API tiêu chuẩn. Các mô hình suy luận chuyên biệt như Qwen3.7 Max và Qwen3.6 35B A3B bổ sung khả năng giải quyết vấn đề từng bước cho toán học, lập trình và các tác vụ agentic phức tạp.
Việc lựa chọn phụ thuộc vào sự cân bằng bạn cần giữa tốc độ, chi phí và năng lực. Hãy chọn Qwen3.5 Flash khi độ trễ thấp và lưu lượng lớn là ưu tiên, các tier Plus cho trợ lý hằng ngày và quy trình năng suất, còn Qwen3.7 Max khi tác vụ đòi hỏi khả năng suy luận và lập trình mạnh nhất. Vì mọi mô hình dùng chung một endpoint, việc chuyển đổi giữa chúng chỉ là thay một tham số.
Seedance 2.5 API hiện đã có mặt trên Atlas Cloud! Cung cấp cho các nhà phát triển mô hình video mới nhất của ByteDance. Nó tạo ra tối đa 30 giây video gốc chỉ trong một lần xử lý từ văn bản, một hình ảnh duy nhất hoặc tối đa 50 tài liệu tham khảo đa phương thức, với âm thanh được đồng bộ hóa và văn bản đa ngôn ngữ trong khung hình. Trên Atlas Cloud, bạn có thể truy cập thông qua một khóa duy nhất, với tính nhất quán của chủ thể và vật lý được cải thiện giúp giữ cho các cảnh quay dài luôn mạch lạc.

Wan 3.0 API là thế hệ tiếp theo trong hệ sinh thái video Wan của Alibaba, được xây dựng để đưa khả năng tạo video dài, kiểm soát đa tham chiếu và chất lượng nghe nhìn lên những tầm cao mới. Atlas Cloud đã lưu trữ Wan 2.7, 2.6 và 2.5, và Wan 3.0 hoạt động trên cùng một khóa hợp nhất mà không cần thiết lập riêng. Bắt đầu xây dựng ngay hôm nay. Cuộn xuống phần trưng bày để xem những gì Wan 3.0 có thể tạo ra.
MiniMax H3 là dòng video đa phương thức của MiniMax, hỗ trợ sáng tạo từ văn bản, hình ảnh và nội dung tham chiếu. Trên các route được hỗ trợ, sản phẩm duy trì chủ thể từ nội dung tham chiếu, cung cấp các tỷ lệ khung hình linh hoạt và kết hợp âm thanh được tạo với hình ảnh thông qua H3 Developer, với hồ sơ đầu ra được lựa chọn theo endpoint. Atlas Cloud hợp nhất dòng sản phẩm này dưới một khóa tương thích với OpenAI, cùng mức giá trả theo nhu cầu minh bạch bắt đầu từ mức tiêu chuẩn $0.038 mỗi giây. Hãy bắt đầu xây dựng ngay hôm nay.
Dòng gpt-image-2.5 của OpenAI mang đến cho nhà phát triển lựa chọn giữa Flare và Sunburst cho các quy trình xử lý ảnh trong môi trường production. Kết xuất ở độ phân giải tùy ý lên đến 3840x2160 và chọn một trong năm cấp chất lượng, bao gồm xhigh và max, để đáp ứng các yêu cầu đầu ra cụ thể. Atlas Cloud cung cấp dịch vụ suy luận REST sẵn sàng sử dụng, không cần khởi động nguội, với mức giá tiêu chuẩn từ $0.004 cho mỗi lần tạo. Bắt đầu xây dựng ngay hôm nay.
Seedream 5.0 Pro API cung cấp cho các nhà phát triển mô hình chỉnh sửa hình ảnh có thể kiểm soát của ByteDance trên Atlas Cloud. Nó đặt các chỉnh sửa một cách chính xác bằng các điểm neo và tọa độ, tách hình ảnh thành các lớp có thể chỉnh sửa, kết hợp nhiều tham chiếu và khớp màu sắc cũng như vật liệu chính xác, với văn bản đa ngôn ngữ ở độ phân giải 2K và 3K. Trên Atlas Cloud, bạn có thể truy cập nó chỉ bằng một khóa!
Seedance 2.0 là mô hình video phục vụ môi trường production của ByteDance, giúp tạo cảnh quay chính xác. Biến prompt thành video, tạo chuyển động cho hình ảnh khung hình đầu tiên với tùy chọn hướng dẫn bằng khung hình cuối, hoặc định hình kết quả bằng media tham chiếu và tùy chọn tìm kiếm web. Atlas Cloud hợp nhất các quy trình này trong một API duy nhất, với mức giá pay-as-you-go minh bạch và một key tương thích với OpenAI. Bắt đầu xây dựng ngay hôm nay.
Kling 3.0 API đưa bộ công cụ video hàng đầu của Kuaishou lên Atlas Cloud thông qua một khóa tương thích với OpenAI. Nó bao gồm hai mô hình: Kling 3.0 cho kể chuyện bằng AI Director, đồng bộ khẩu hình đa ngôn ngữ và văn bản trên màn hình chính xác, và Kling 3.0 Omni (O3) để sao chép chủ thể và giọng nói từ một video ngắn hoặc hình ảnh. Cả hai đều tạo ra âm thanh gốc trong cùng một lần xử lý, với đầu ra lên đến 4K. Xây dựng các câu chuyện điện ảnh, tiếp thị toàn cầu, quảng cáo đa ngôn ngữ và nội dung nhân vật theo kỳ trên một cơ sở hạ tầng đáng tin cậy.
Grok Imagine Video cung cấp cho các nhà phát triển quyền truy cập vào dòng sản phẩm video của xAI để tạo, tạo chuyển động, kéo dài và chỉnh sửa các đoạn video. Tạo video dài từ 1 đến 15 giây từ lời nhắc, định hướng nhân vật, vật thể hoặc phong cách bằng tối đa bảy hình ảnh tham chiếu, và làm việc ở độ phân giải 480p hoặc 720p. Atlas Cloud tập hợp các khả năng này thông qua các endpoint tương thích với OpenAI, cùng mức giá minh bạch theo mức sử dụng. Bắt đầu xây dựng ngay hôm nay.
Vidu Q4 là mô hình video chủ lực mới nhất của Vidu, được thiết kế để chuyển hình ảnh thành video và chuyển tham chiếu thành video. Mô hình có thể tạo chuyển động cho một ảnh tĩnh duy nhất và tự động chuyển cảnh, mang đến cho nhà phát triển hai luồng đầu vào phục vụ các quy trình sản phẩm khác nhau. Atlas Cloud cung cấp các API endpoint chuyên dụng với lược đồ tham số được công bố, áp dụng mức giá tiêu chuẩn đã được xác minh là $0.04 mỗi giây. Bắt đầu xây dựng ngay hôm nay.
Gemini Omni 1.1 Flash là dòng mô hình video đa phương thức nguyên bản của Google DeepMind, phục vụ các quy trình sản xuất linh hoạt. Chỉnh sửa cảnh quay hiện có bằng hướng dẫn văn bản, duy trì tính nhất quán hình ảnh với tối đa 10 ảnh tham chiếu và 3 đoạn video, hoặc kéo dài một cảnh thành các phân đoạn có thể nối tiếp, tối đa 40 giây. Truy cập mọi quy trình trên Atlas Cloud với một API key tương thích với OpenAI, mức giá trả theo mức sử dụng và khả dụng ngay từ ngày đầu tiên. Bắt đầu xây dựng ngay hôm nay.
Nano Banana 2.1 là dòng mô hình hình ảnh của Google được xây dựng trên Gemini 3.6 Flash. Mô hình mang đến khả năng tạo và chỉnh sửa ở cấp độ Pro với tốc độ ngang tầm Flash, hỗ trợ chỉnh sửa và kết hợp bằng ngôn ngữ tự nhiên trên 1 đến 14 hình ảnh đầu vào, đồng thời duy trì tính nhất quán cho tối đa 4 nhân vật và 10 vật thể. Thông qua Atlas Cloud, các nhà phát triển có thể truy cập dòng mô hình này bằng một khóa tương thích với OpenAI, thời gian hoạt động ổn định và khả dụng ngay từ Day-0. Bắt đầu xây dựng ngay hôm nay.
Xây dựng bằng Nano Banana 2 API, được hỗ trợ bởi mô hình Gemini 3.1 Flash Image của Google. Nó tạo ra hình ảnh 4K gốc lên đến 4096x2304 với khả năng hiển thị văn bản chính xác và các nhân vật nhất quán trên tối đa 14 hình ảnh tham chiếu cho cả việc tạo và chỉnh sửa. Trên Atlas Cloud, bạn có thể truy cập nó thông qua một API hợp nhất cùng với hơn 300 mô hình, với mức giá từ 0,04 đô la cho mỗi hình ảnh, thời gian hoạt động 99,99% và tín dụng miễn phí để bắt đầu.
Hướng dẫn, bài hướng dẫn và cập nhật sản phẩm giúp bạn khai thác tối đa Atlas Cloud.


