Đoạn code trông như đã hoàn tất. Rồi các bài kiểm thử thất bại, bản sửa lỗi thay đổi một interface, và một yêu cầu khác bắt đầu chạy. Chọn API AI tốt nhất để lập trình nghĩa là tìm ra một model và endpoint hoàn thành đúng loại công việc của bạn trong một mức ngân sách chấp nhận được.
Hãy bắt đầu với Claude, GPT hoặc Gemini làm ứng viên tham chiếu. So sánh DeepSeek, Qwen và Kimi trên cùng các tác vụ nếu bạn muốn có những phương án triển khai và chi tiêu thay thế. Với gỡ lỗi, hãy ưu tiên các bài kiểm thử hồi quy. Với refactor, hãy xem xét diff. Với một coding agent, hãy xác minh toàn bộ vòng lặp công cụ trước khi so sánh giá token.
Nỗi thất vọng này có thể đo lường được. Trong Khảo sát Nhà phát triển Stack Overflow 2025, 66% người trả lời câu hỏi về những điều gây thất vọng cho biết gặp phải các giải pháp AI gần đúng; 45% cho biết phải dành nhiều thời gian hơn để gỡ lỗi code do AI tạo ra. Đây là các câu trả lời khảo sát, không phải đánh giá model năm 2026. (Stack Overflow Developer Survey, 2025)
Những điểm chính
- Chọn API và agent một cách riêng biệt.
- Lập danh sách rút gọn theo tác vụ và các tính năng endpoint cần thiết.
- Lưu lại câu trả lời đầu tiên và đánh giá chúng dựa trên các bài kiểm thử chấp nhận cố định.
- Tính cả các lần thử thất bại và các lần sửa lỗi vào phép tính chi phí của bạn.
Hướng dẫn này cung cấp một danh sách rút gọn, ba tác vụ đánh giá có thể sao chép, và một bảng tính chi phí. Nghiên cứu được kiểm tra vào ngày 21 tháng 9 năm 2026. Tính khả dụng của model, các khả năng được tài liệu hóa, và kết quả đo lường là những loại bằng chứng riêng biệt xuyên suốt bài viết.
API AI tốt nhất để lập trình: Danh sách rút gọn
Hãy bắt đầu với hai ứng viên: một ứng viên phù hợp với ứng dụng hiện có của bạn và một phương án thay thế. Dùng sáu dòng model này để tạo nên cặp ban đầu đó.
Bảng dưới đây đề xuất các bài kiểm thử, mà không khẳng định hiệu năng so sánh. Quyền truy cập phụ thuộc vào tài khoản, khu vực, hạn ngạch và endpoint của bạn; việc một model được liệt kê trong tài liệu không xác nhận rằng thông tin xác thực của bạn có thể gọi được nó.
| Model và ID cụ thể | Đường dẫn truy cập | Tác vụ đáng đánh giá | Ranh giới quyết định chính | Bằng chứng endpoint | Kiểm tra giá |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Thay đổi nhiều file có ràng buộc | Xác minh client và các điều khiển reasoning | Tổng quan model Claude Platform; quyền truy cập tài khoản chưa được kiểm thử | Không có mức giá được nêu |
GPT-6 Astra, gpt-6-astra | OpenAI API | Tác vụ lập trình nhiều điều kiện | Xác minh route và các công cụ | Tài liệu model OpenAI; quyền truy cập tài khoản chưa được kiểm thử | Không có mức giá được nêu |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Tạo và đánh giá tương tác | Xác minh độ trễ và giao thức | Danh mục model Google AI; quyền truy cập tài khoản chưa được kiểm thử | Không có mức giá được nêu |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Route model của Atlas Cloud | Sửa lỗi số; thử nghiệm ngữ cảnh | Giữ riêng phiên bản 0813 | Trang model chính xác đã xác minh; các tính năng runtime chưa được kiểm thử | 21 tháng 9 năm 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Route model Atlas Cloud | Refactor; interface khép kín | Phiên bản chỉ định; không phải bản mới nhất | Trang model chính xác đã xác minh; các tính năng runtime chưa được kiểm thử | 21 tháng 9 năm 2026 |
Kimi K3, moonshotai/kimi-k3 | Route model Atlas Cloud | Cùng ba tác vụ; interface CSV | Xác minh đầu ra và giới hạn hoàn thành | Trang model chính xác đã xác minh; các tính năng runtime chưa được kiểm thử | 21 tháng 9 năm 2026 |
Claude, GPT và Gemini cung cấp các ứng viên tham chiếu hữu ích. Các danh mục model chính thức của họ xác định những phiên bản nêu trên. Hãy dùng một nhà cung cấp mà bạn đã hiểu rõ làm đường cơ sở, rồi kiểm tra xem một phương án thay thế có làm giảm chi phí trên mỗi tác vụ được chấp nhận hay công sức tích hợp hay không. Đừng coi hành vi của một trợ lý tiêu dùng là kết quả API tương ứng.
Danh mục model của OpenAI liệt kê GPT-6 Astra cùng với dòng GPT-5.6. Điều đó xác lập một ứng viên hiện tại, chứ không phải một chiến thắng về lập trình trước các dòng khác. Bảng này cố ý tránh đưa vào các model ID cũ từ những trang so sánh không ghi ngày. (Danh mục model OpenAI, truy cập tháng 9 năm 2026)
DeepSeek xứng đáng có một vị trí như một dòng model riêng để điều tra. Hãy kiểm tra xem nó có sửa được đúng lỗi đó mà không mở rộng phạm vi thay đổi hay không. Hãy chọn một ứng viên khác nếu route được triển khai không thể đáp ứng định dạng phản hồi, hành vi công cụ hoặc giới hạn độ trễ mà bạn yêu cầu, bất kể danh tiếng chung của model.
Đánh giá Qwen theo phiên bản. Triển khai 122B A10B được nêu tên cung cấp một tham chiếu giá cụ thể. Hãy chạy các bài kiểm tra phân tích cú pháp và trình duyệt trước khi đưa ra kết luận về giá trị. Các con số ngữ cảnh từ những bản phát hành Qwen khác không thể gán cho model này.
Kimi là ứng viên cấu hình đã được xử lý. Trang công khai của nó xác định model ID. Việc xem xét cấu hình là khả thi; khả năng tạo thành công vẫn chưa được xác minh. Hãy đánh giá đầu ra hoàn chỉnh của nó dựa trên cùng các ràng buộc như các ứng viên khác.
Atlas Cloud nằm ở lớp truy cập trong so sánh này. Nó không phải là model thứ bảy. Sự liên quan của nó mang tính thực tiễn: bạn có thể xem xét một số trang model ứng viên và so sánh các yêu cầu tích hợp của chúng trước khi cam kết với một workflow.
Với open weights, hãy xác minh giấy phép phát hành chính xác và artifact triển khai. Suy luận được lưu trữ (hosted inference) có các điều khoản dịch vụ và chi phí vận hành riêng; chỉ riêng dòng model không thể xác lập những điều này.
Giải thích về API lập trình, model và agent
Một model tạo ra nội dung để phản hồi đầu vào. Một API định nghĩa cách ứng dụng của bạn gửi đầu vào đó và nhận kết quả. Một coding agent tổ chức công việc xung quanh: đọc file, gọi công cụ, áp dụng chỉnh sửa, chạy kiểm thử và quyết định có tiếp tục hay không.
Ba lớp đó có thể thất bại một cách độc lập. Một model có thể đề xuất một bản vá đúng trong khi agent ghi nó vào sai file. Một API có thể trả về JSON hợp lệ trong khi ứng dụng bỏ qua một lệnh gọi công cụ. Một agent có năng lực có thể bị đình trệ vì endpoint mà nó chọn từ chối một tham số.
Giả sử bạn gửi một handler và yêu cầu một bộ phân tích ID. Một API sinh code cơ bản trả về văn bản chứa code. Chương trình của bạn vẫn cần trích xuất code đó, đặt nó vào một workspace phù hợp và chạy các bài kiểm thử. Một phản hồi HTTP thành công xác lập việc gửi đến, chứ không phải tính đúng đắn.
Một agent chỉ có thể tự động hóa những bước đó nếu bạn cung cấp các công cụ và quyền. Nó cũng cần một điều kiện dừng. Nếu không có, nó có thể liên tục chỉnh sửa một hàm vốn đã chấp nhận được, mở rộng tác vụ, hoặc tiêu tốn thêm các yêu cầu để cố cải thiện một chi tiết không liên quan.
Hãy tách biệt ba khoản ngân sách:
- Đăng ký công cụ: ứng dụng, tích hợp editor hoặc dịch vụ agent mà bạn dùng.
- Sử dụng suy luận: các yêu cầu đến endpoint model đã chọn, theo các điều khoản thanh toán của nó.
- Môi trường thực thi: container, trình chạy kiểm thử, lưu trữ và hạ tầng khác.
Một số sản phẩm gộp sẵn các phần của stack này. Những sản phẩm khác yêu cầu bạn tự mang thông tin xác thực riêng. Hãy kiểm tra gói cụ thể trước khi cho rằng một đăng ký editor bao gồm lưu lượng API tùy ý từ ứng dụng của chính bạn.
Khả năng tương thích giao thức cũng có ranh giới. Một dịch vụ chấp nhận một mảng messages quen thuộc vẫn có thể có hành vi công cụ, sự kiện streaming, giới hạn ngữ cảnh hoặc các điều khiển reasoning khác biệt. Việc sao chép một base URL không thể xác lập sự hỗ trợ cho mọi tính năng trong hệ sinh thái của một nhà cung cấp khác.
Hãy lập bản đồ ứng dụng, agent, endpoint, model, công cụ và kiểm thử. Xác định thành phần bị tính phí và đơn vị vận hành chịu trách nhiệm ở mỗi bước trước khi thay đổi model.
API AI tốt nhất để lập trình: 7 bước kiểm tra lựa chọn
1. Tính đúng đắn chức năng và hành vi hồi quy. Hãy viết các đầu ra mong đợi trước khi yêu cầu code. Một hàm giá xử lý được các số nguyên thông thường nhưng chấp nhận null như số không là vi phạm hợp đồng. Hãy chạy cả các trường hợp biên mới lẫn các bài kiểm thử hiện có của dự án; việc vượt qua một bài kiểm thử mới có thể che giấu một caller bị hỏng ở nơi khác.
2. Phạm vi thay đổi. Hãy so sánh bản vá với yêu cầu. Việc tách một bộ phân tích ID phải giữ nguyên URL, phản hồi thành công và phản hồi lỗi. Một cuộc di trú framework không được yêu cầu sẽ làm tăng công sức đánh giá ngay cả khi bản thay thế biên dịch được. Hãy quyết định trước xem những chỉnh sửa không liên quan có khiến câu trả lời bị loại hay cần sửa lại hay không.
3. Ngữ cảnh hữu ích và dung lượng đầu ra. Yêu cầu của bạn bao gồm hướng dẫn, các file liên quan, định nghĩa công cụ và hội thoại trước đó. Hãy dành đủ chỗ cho câu trả lời nữa. Một cửa sổ ngữ cảnh lớn được quảng cáo không xác lập rằng model sẽ tìm ra bất biến liên quan, hay rằng endpoint của bạn chấp nhận cùng mức tối đa đó.
Hãy kiểm tra chất lượng ngữ cảnh bằng một phụ thuộc thực sự quan trọng. Đưa vào một caller có interface phải giữ ổn định và xác minh rằng model tôn trọng điều đó. Đo lường việc cắt ngắn một cách riêng biệt: một phản hồi kết thúc giữa chừng một hàm không thể được chấp nhận chỉ vì những dòng mở đầu của nó trông có vẻ hứa hẹn.
4. Gọi công cụ và đầu ra có cấu trúc. Hãy xác minh route được triển khai với schema công cụ thực tế của bạn. Kiểm tra các kiểu đối số, trường bị thiếu, định danh công cụ và phản hồi tiếp theo sau một kết quả công cụ. Một model viết ra một đối tượng JSON có vẻ hợp lý chưa chắc đã hoàn thành một vòng gọi công cụ gốc.
5. Thời gian đến một kết quả được chấp nhận. Hãy ghi lại thời lượng của toàn bộ lần thử, bao gồm cả sửa lỗi và kiểm thử. Với một trợ lý tương tác, thời gian đến văn bản hiển thị đầu tiên cũng quan trọng, nhưng nó không thể thay thế thời gian hoàn thành. Một token đầu tiên nhanh chóng, theo sau là một câu trả lời dài không dùng được, vẫn chặn nhà phát triển.
6. Chi phí đầu vào, đầu ra, cache và thử lại. Hãy đọc các hạng mục thanh toán mà endpoint bạn chọn thực sự báo cáo. Tách riêng các lần đọc cache khỏi đầu vào thông thường khi có thể áp dụng. Theo dõi các yêu cầu không thành công và các vòng lặp bị hủy bỏ. Nếu nhà cung cấp không hiển thị chi tiết bạn cần, hãy đánh dấu rõ những giả định còn thiếu của ước tính.
7. Điều kiện tích hợp và xử lý code. Hãy xác nhận rằng editor hoặc ứng dụng của bạn hỗ trợ route, phương thức xác thực và định dạng lỗi. Xem lại các điều khoản xử lý dữ liệu hiện hành của nhà cung cấp trước khi gửi source riêng tư. Open weights mô tả một lựa chọn phân phối model; chúng không xác lập cách một dịch vụ được lưu trữ xử lý các yêu cầu của bạn.
Các benchmark công khai có thể giúp bạn chọn ứng viên, với điều kiện bạn đọc kỹ các điều kiện của chúng. SWE-bench Verified chứa 500 trường hợp được con người lọc. Trang hiện tại của nó cũng mô tả một chế độ xem Bash Only sử dụng cùng môi trường mini-SWE-agent. Những chi tiết này giúp giải thích điều gì đang được so sánh. (SWE-bench, truy cập tháng 9 năm 2026)
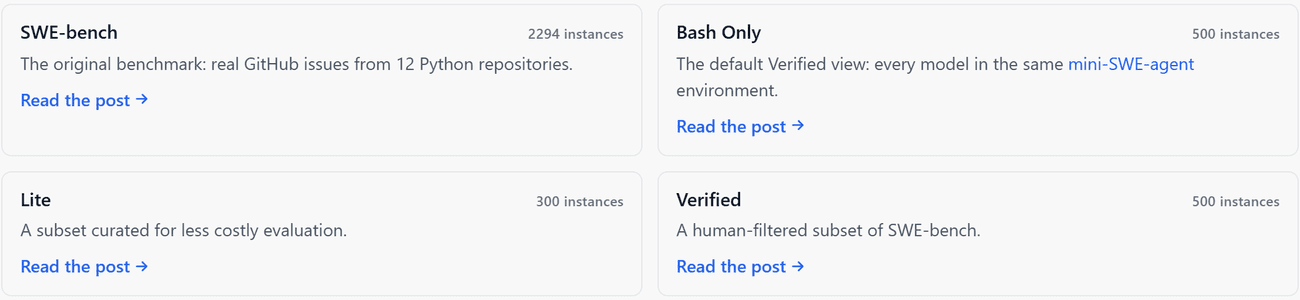 Trang SWE-bench hiển thị kích thước tập dữ liệu Verified và môi trường agent dùng chung
Bằng chứng nguồn: trang benchmark thật, được chụp ngày 21 tháng 9 năm 2026. Tập dữ liệu và các điều kiện thực thi cần đi kèm mọi tuyên bố về hiệu năng.
Kết quả benchmark mô tả một thiết lập cụ thể. Ngôn ngữ, quy tắc nghiệp vụ, quyền và tiêu chuẩn đánh giá của bạn có thể khác. Hãy đưa ra quyết định cuối cùng dựa trên công việc mà bạn có thể kiểm tra.
API AI tốt nhất để lập trình: Chạy ba bài kiểm tra thực tế
Ba ví dụ đánh giá có thể tái lập này phơi bày các kiểu thất bại khác nhau. Hãy cố định các quy tắc chấp nhận của chúng trước khi yêu cầu đầu ra. Hãy đánh giá hàm hoặc trang dựa trên hợp đồng của nó, bất kể chất lượng giải thích.
Với DeepSeek V4 Pro, Qwen3.5 122B A10B và Kimi K3, giao thức dự kiến là ba lần chạy độc lập cho mỗi tác vụ. Nghĩa là 27 lần thử ban đầu. Cho phép tối đa một lần sửa theo phản hồi cho mỗi lần thử, giữ lại câu trả lời đầu tiên, và báo cáo riêng kết quả ban đầu và kết quả sau khi sửa.
Chỉ yêu cầu temperature bằng không ở nơi được hỗ trợ, đồng thời ghi lại thiết lập thực tế được chấp nhận. Dùng mức trần đầu ra yêu cầu là 4.096 token cho A và B, và 8.192 cho C sau khi kiểm tra các giới hạn của endpoint. Các giá trị mặc định và những điều khiển không được hỗ trợ phải được ghi lại. Temperature thấp không đảm bảo các câu trả lời giống hệt nhau.
Trạng thái bằng chứng: quyền truy cập môi trường kiểm thử đã bị chặn bởi màn hình đăng nhập Cloudflare Access. 27 lần thử với các ứng viên không thể được thực thi. Bằng chứng sau đây cho thấy code gốc được thực thi cục bộ và một fixture tham chiếu CSV do tác giả bài viết tạo, không phải kết quả từ model ứng viên. Tỷ lệ vượt qua của model, mức sử dụng token và chi phí tác vụ vẫn chưa được đo lường.
Tác vụ A: sửa việc chọn giá số. Dán nguyên văn prompt này vào một phiên mới:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Các đầu vào chấp nhận cố định là [2,10,3], ["12","3"], một mảng rỗng, các giá trị chỉ toàn không hợp lệ, số không, số âm và các chuỗi chỉ chứa khoảng trắng. Loại bỏ các chuỗi trống sau khi trim. Kiểm tra rằng mảng gốc có đúng các phần tử như cũ theo cùng thứ tự sau lệnh gọi.
Bản gốc dùng hàm sort mặc định của JavaScript và làm biến đổi đầu vào của nó. Do đó tác vụ kiểm tra hai nghĩa vụ riêng biệt: chọn đúng giá trị số nhỏ nhất và tránh thay đổi dữ liệu của caller. Hãy kiểm tra các quy tắc chuyển đổi một cách tường minh vì một giải pháp ngắn dựa trên ép kiểu có thể vô tình chấp nhận boolean hoặc null.
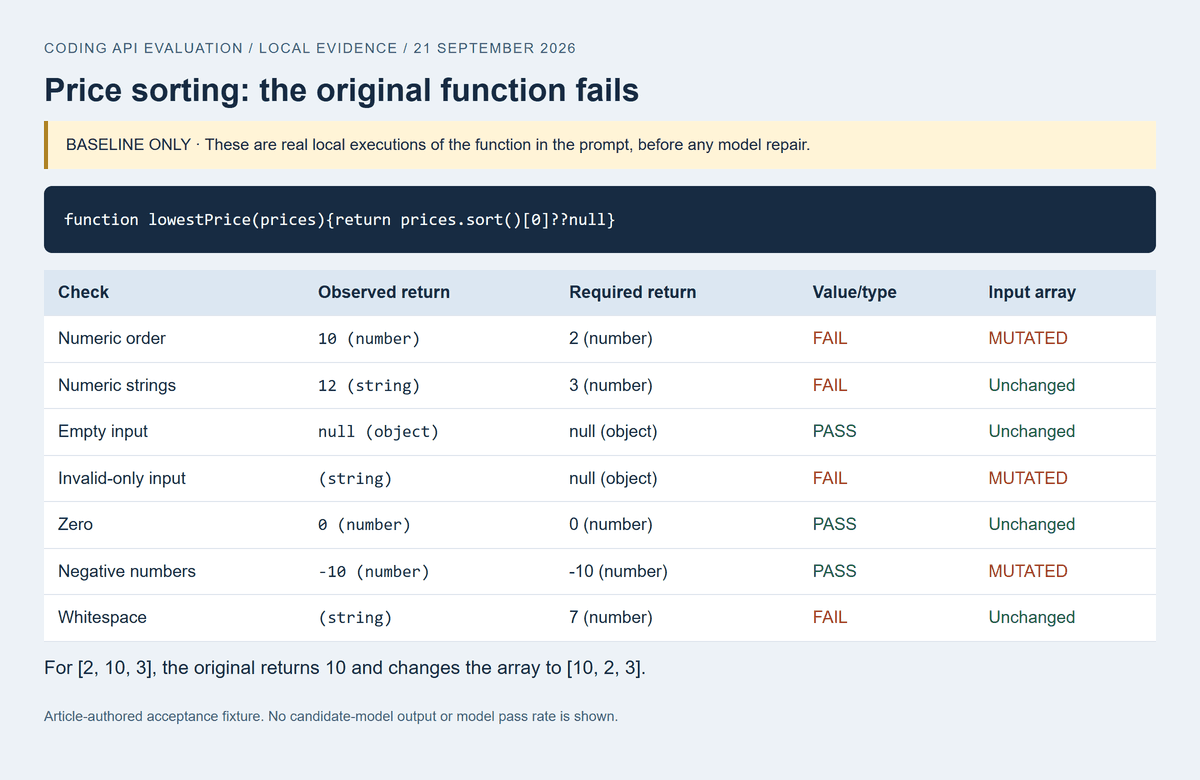 Thực thi cục bộ hàm giá gốc cho thấy việc sắp xếp số không đúng và đầu vào bị biến đổi
Đường cơ sở đã thực thi: hàm gốc trả về 10 cho [2,10,3] và thay đổi mảng thành [10,2,3]. Các chuỗi số cũng không đáp ứng hợp đồng giá trị trả về. Không có bản sửa của model nào được hiển thị.
Tác vụ B: giữ nguyên một interface trong một lần refactor nhỏ. Dùng nguyên văn prompt này:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Chấp nhận "12" và "0012" là 12. Loại bỏ "1e2", "1.0", số âm, số không, khoảng trắng, các đầu vào không phải chuỗi, và các giá trị vượt quá phạm vi số nguyên an toàn của JavaScript. Xác minh đường dẫn đã đăng ký và cả hai phần thân phản hồi. Đầu vào không hợp lệ không được chạm tới findUser.
Tác vụ này kiểm tra xem model có hiểu sự khác biệt giữa chuyển đổi số và ngữ pháp chuỗi được chỉ định hay không. Hãy xem xét diff để tìm các thay đổi không liên quan, rồi gọi handler với các đối tượng request và response được stub. Một helper đúng đi kèm một handler dễ dãi không thay đổi vẫn thất bại.
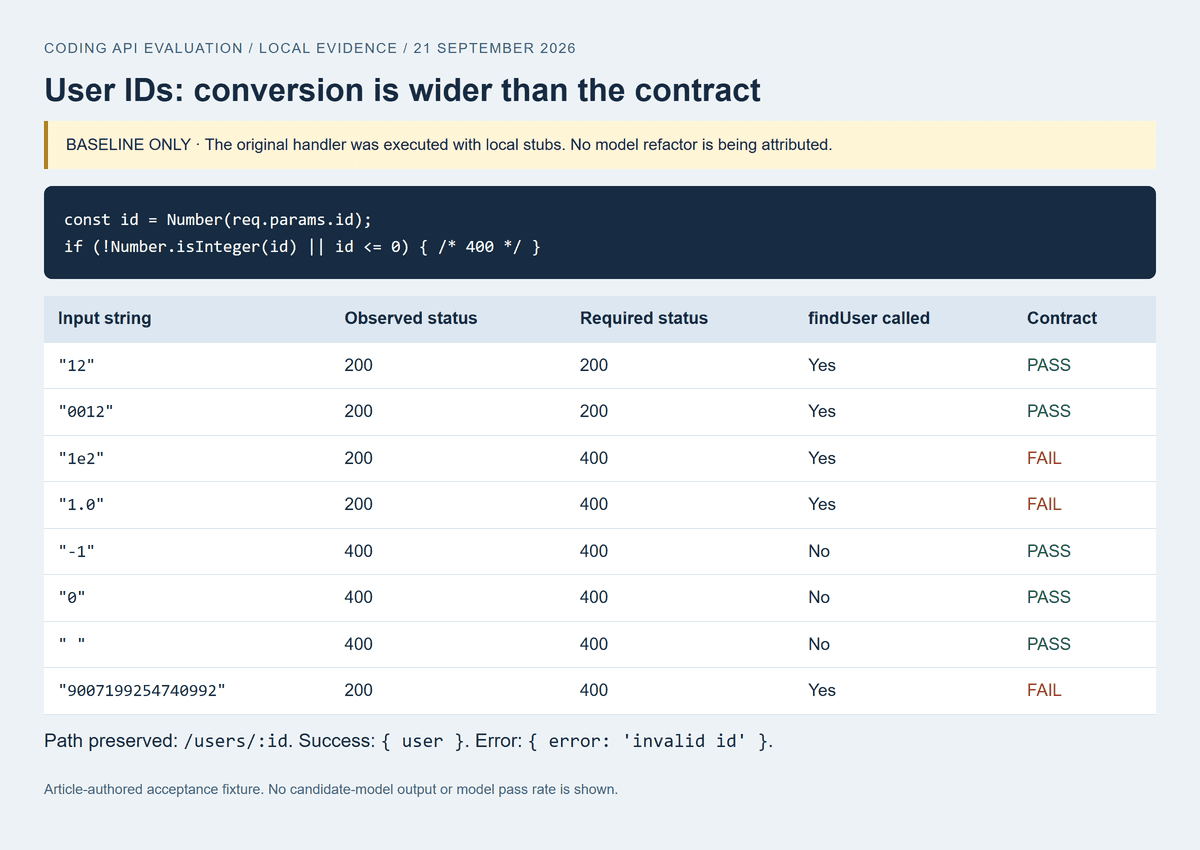 Nhật ký kiểm thử handler gốc cho thấy các chuỗi số không hợp lệ được chấp nhận với trạng thái 200
Đường cơ sở đã thực thi: handler gốc trả về 200 cho "1e2", "1.0" và "9007199254740992", bất chấp yêu cầu phản hồi 400. Các stub cục bộ đã ghi lại các lệnh gọi; đây không phải là một bản refactor do model tạo ra.
Tác vụ C: xây dựng một bản xem trước CSV mà bạn có thể vận hành. Gửi:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Kiểm thử với các bản ghi chính xác này, trước tiên dùng LF rồi đến CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Mong đợi hai cột, ba hàng dữ liệu, dấu phẩy của Alice nằm trong một ô, và dấu ngoặc kép được escape của Bob hiển thị đúng. Giá trị của Eve phải xuất hiện dưới dạng văn bản nguyên văn, không có phần tử image, không thực thi sự kiện, không có yêu cầu mạng. Thêm một hàng có ba trường và xác nhận rằng trang báo cáo sự không khớp một cách rõ ràng.
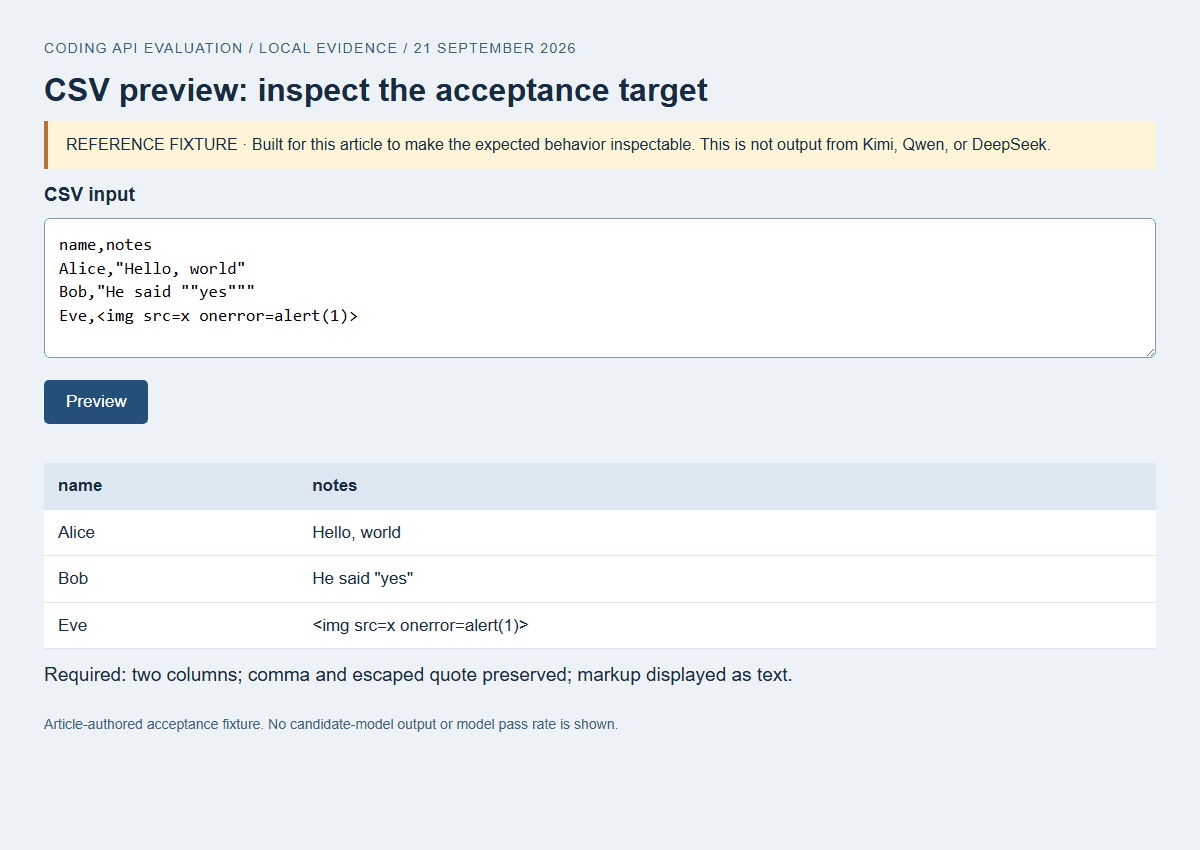 Fixture chấp nhận CSV cho thấy các giá trị được trích dẫn và các yêu cầu về markup nguyên văn
Fixture tham chiếu đã vận hành, được tạo cho bài viết này, không do model ứng viên tạo ra. Các kiểm tra trên trình duyệt đã xác minh việc phân tích LF/CRLF, dấu ngoặc kép được escape, markup nguyên văn, lỗi số trường hiển thị rõ, và không có yêu cầu HTTP. Ảnh chụp màn hình hiển thị trạng thái đầu vào hợp lệ sau khi nhấp vào Preview\.
Hãy lưu đầu ra thô, nhật ký, model ID, ngày, tham số, thời gian, các lần sửa và các chỉnh sửa thủ công. Gửi các assertion thất bại để sửa mà không thay đổi kết quả mong đợi. Giữ lại cả các lần từ chối, cắt ngắn và lỗi cùng với các lần thành công.
API AI tốt nhất để lập trình trong ngân sách hạn chế
Hãy so sánh giá token song song với chất lượng hoàn thành và mức sử dụng. Đầu vào lặp lại có thể chiếm phần lớn chi phí đánh giá code; việc sinh toàn bộ file có thể làm tăng phí đầu ra. Các lần sửa lặp lại làm tăng cả hai.
Danh mục Atlas và các trang chi tiết chính xác đã hiển thị các mức giá USD trên một triệu token sau đây vào ngày 21 tháng 9 năm 2026:
- DeepSeek V4 Pro: $1.68 đầu vào và $3.38 đầu ra. Danh mục V4 Pro 0813 riêng dùng các mức giá khác; đừng thay thế bằng nó.
- Qwen3.5 122B A10B: $0.30 đầu vào và $2.40 đầu ra. Danh mục hiển thị mức giá thông thường là $0.40 và $3.20 với mức giảm 25%, tính đến tháng 9 năm 2026.
- Kimi K3: $3.00 đầu vào và $15.00 đầu ra.
Đây là các mức giá production được hiển thị, không phải hóa đơn từ quá trình đánh giá của bài viết. Các mức giá riêng cho cache và tính áp dụng của chúng chưa được xác nhận. Các ưu đãi khuyến mãi cho DeepSeek và Kimi chưa được xác nhận. Việc không quan sát thấy khuyến mãi không chứng minh rằng không tồn tại ưu đãi nào.
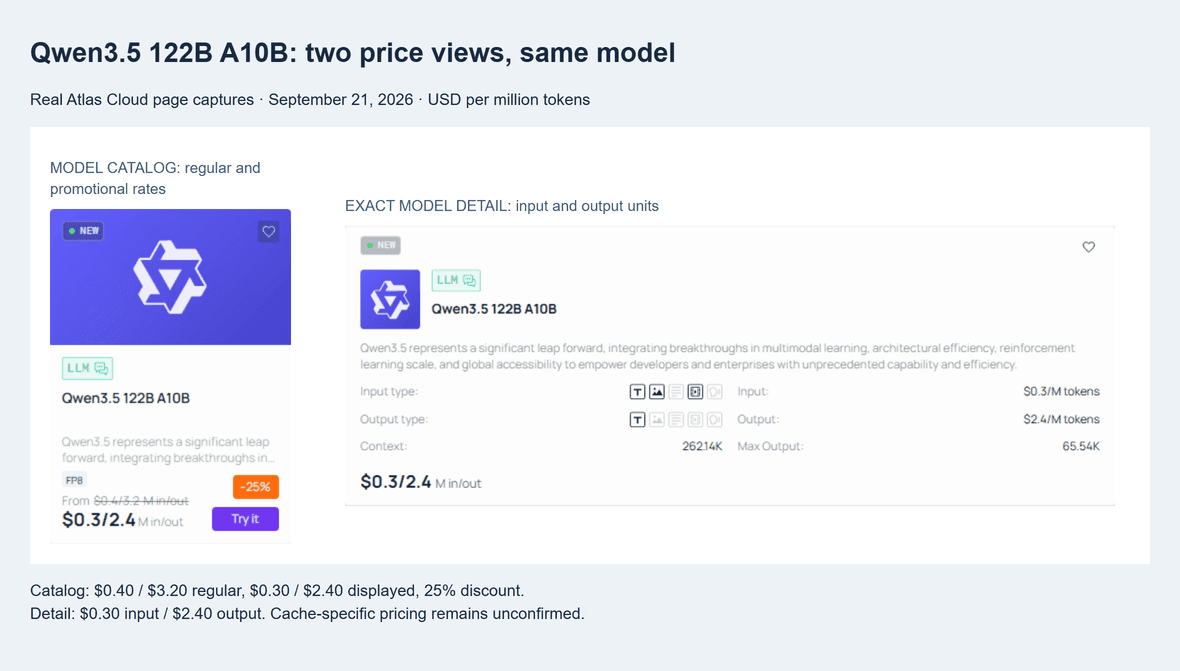 Mức giảm giá trong danh mục của Qwen3.5 122B A10B bên cạnh mức giá đầu vào và đầu ra trong trang chi tiết model chính xác
Kiểm tra chéo giá Qwen, ngày 21 tháng 9 năm 2026: danh mục hiển thị chương trình khuyến mãi 25%; trang chi tiết model chính xác xác nhận $0.30 đầu vào và $2.40 đầu ra trên một triệu token. Các mức giá riêng cho cache vẫn chưa được xác nhận.
Tính phần chi phí model của một tác vụ như sau:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Đừng tính phí các token được cache một lần nữa như đầu vào thông thường nếu bản ghi thanh toán xử lý chúng riêng. Hãy kiểm tra xem mức sử dụng reasoning có được tính vào đầu ra bị tính phí hay không. Nếu không có tác vụ nào vượt qua, hãy báo cáo “không có kết quả thành công”; việc chia cho số không hoặc hiển thị chi phí hoàn thành bằng không sẽ gây hiểu lầm cho người đọc.
Để có một ví dụ số học minh bạch, giả sử 10.000 token đầu vào thông thường và 2.000 token đầu ra theo mức giá Qwen đã hiển thị. Chi phí model ước tính là $0.0078, trước mọi hạng mục áp dụng khác. Đây là một yêu cầu giả định, không phải mức sử dụng token được quan sát hay một hóa đơn thực tế.
Một lần sửa có kích thước tương đương sẽ đưa ước tính lên $0.0156. Các lần sửa thực tế bao gồm ngữ cảnh và đầu ra khác nhau, nên hãy tính từng yêu cầu dựa trên mức sử dụng đã ghi lại của nó.
| Tác vụ | Model | Lần đầu | Sau khi sửa | Mức sử dụng token | Nguồn chi phí | Tổng phí | Tổng thời gian | Thay đổi thủ công |
|---|---|---|---|---|---|---|---|---|
| A, B, C; mỗi tác vụ dự kiến lặp 3 lần | DeepSeek V4 Pro | Chưa đo | Chưa đo | Chưa ghi lại | Không có bản ghi sử dụng | Không rõ | Chưa đo | Không đánh giá |
| A, B, C; mỗi tác vụ dự kiến lặp 3 lần | Qwen3.5 122B A10B | Chưa đo | Chưa đo | Chưa ghi lại | Không có bản ghi sử dụng | Không rõ | Chưa đo | Không đánh giá |
| A, B, C; mỗi tác vụ dự kiến lặp 3 lần | Kimi K3 | Chưa đo | Chưa đo | Chưa ghi lại | Không có bản ghi sử dụng | Không rõ | Chưa đo | Không đánh giá |
Với bảng tính của riêng bạn, hãy mở rộng mỗi hàng thành một hàng cho mỗi model và mỗi lần lặp. Đếm một lần thành công sau khi sửa một lần trong mẫu số tác vụ được chấp nhận. Đưa các lần thử không thành công vào tử số, và giữ riêng các cột chấp nhận lần đầu và chấp nhận cuối cùng.
Hãy theo dõi việc đánh giá của con người và hạ tầng một cách riêng biệt. Việc gỡ rối một bản viết lại không cần thiết có thể xóa sạch khoản tiết kiệm từ suy luận. Hãy so sánh các ứng viên đáp ứng cả yêu cầu chấp nhận lẫn ngân sách thời gian đánh giá của bạn.
API AI tốt nhất để lập trình với Atlas Cloud
Hãy bắt đầu với trang model Kimi K3, xác nhận ID và xem xét các chế độ xem API và Code. Giữ phiên bản đã chọn bên cạnh bản ghi kiểm thử.
Hãy đọc tài liệu giao thức LLM trước khi coi hai route là có thể thay thế cho nhau. Tài liệu xác định Chat Completions là route có độ phủ rộng và hướng người dùng đến supported_apis của từng model. Các điều khiển lấy mẫu và tính năng công cụ cũng phụ thuộc vào sự hỗ trợ được quảng cáo của model.
Có những chi tiết tích hợp cụ thể đáng kiểm tra ở đây. Tài liệu cho biết các yêu cầu Anthropic được chuyển đổi không áp dụng cache_control, và các công cụ do nhà cung cấp lưu trữ không khả dụng trên route được chuyển đổi đó. Những ràng buộc này quan trọng nếu agent hiện có của bạn giả định có caching gốc hoặc một công cụ duyệt web được lưu trữ. Hãy khớp client với route thực tế.
Ví dụ Node.js sau đây minh họa một yêu cầu văn bản. Nó dùng fetch tích hợp sẵn, một biến môi trường cho thông tin xác thực, và model ID Kimi đã được xác minh. Lưu prompt nguyên văn của Tác vụ A thành task-a.txt. Đặt biến môi trường base URL thành base của Atlas API như hiển thị trong tài liệu của nó, kết thúc bằng /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages mang tác vụ; model chọn triển khai; max_tokens yêu cầu một mức trần đầu ra. Bộ đọc phản hồi kiểm tra văn bản đã hoàn thành thông thường trước khi trả về code. Timeout giới hạn thời gian chờ của ví dụ này; nó không xác lập rằng server đã ngừng xử lý hay rằng không có khoản phí nào phát sinh.
Temperature bị lược bỏ vì sự hỗ trợ theo từng model và hành vi được cam kết cần được xác minh. Ví dụ này không tự động thử lại. Hãy xem xét loại lỗi trước khi thêm một chính sách thử lại có giới hạn, và không bao giờ ghi log header authorization. Code xuất bản này không được thực thi với API key trong quá trình sản xuất bài viết.
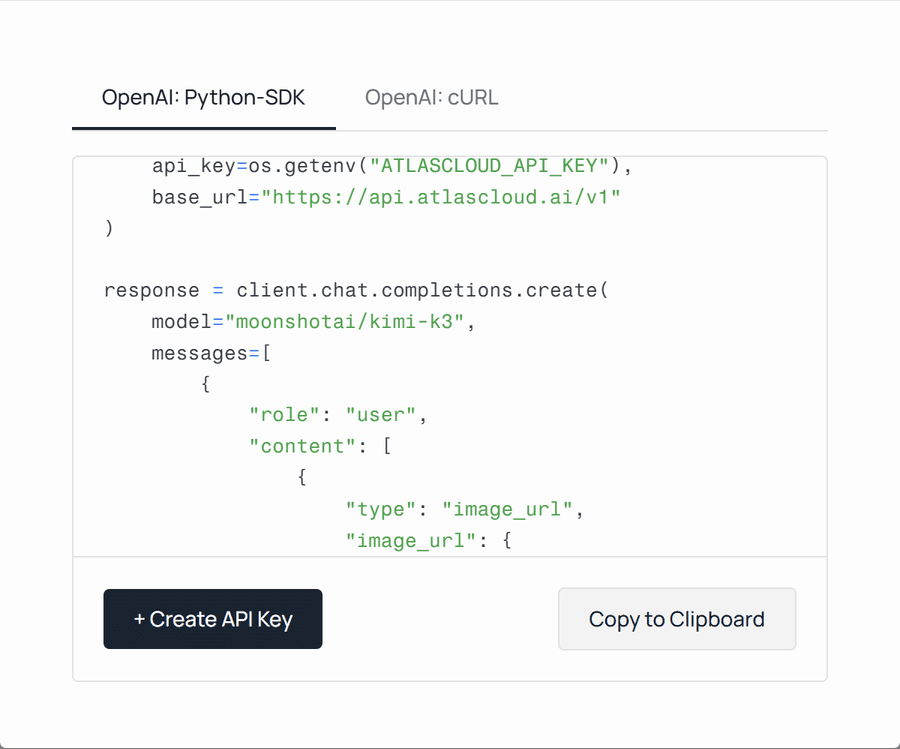 Ví dụ code API Kimi K3 công khai hiển thị endpoint Atlas và định danh model
Hộp thoại Code Kimi K3 công khai, được chụp ngày 21 tháng 9 năm 2026. Đây là bằng chứng cấu hình, không phải một lần chạy lập trình đã hoàn thành. Mẫu trên trang bao gồm đầu vào media; ví dụ trong bài viết chỉ dùng văn bản.
Hãy chạy các kiểm tra chấp nhận của Tác vụ A trên bất kỳ hàm nào được trả về. Trước khi chuyển sang DeepSeek hoặc Qwen, hãy xác minh giao thức và các tham số của nó. Giữ nguyên prompt và kiểm thử trong khi so sánh đầu ra và mức sử dụng; một dạng yêu cầu chung không xác lập hành vi giống hệt nhau.
Trước khi bạn dùng API lập trình trong môi trường production
Trước tiên, hãy chạy code được tạo ra trong một nhánh dùng một lần hoặc một workspace biệt lập. Với tác vụ CSV, hãy dùng một ngữ cảnh trình duyệt cục bộ có chặn các yêu cầu mạng và không truy cập được trạng thái ứng dụng nhạy cảm. Với các tác vụ kho lưu trữ, chỉ cấp cho tiến trình những file và lệnh cần thiết cho việc đánh giá.
Hãy định nghĩa thành công bên ngoài phản hồi của model. Việc một agent nói “tất cả kiểm thử đã vượt qua” phải dẫn bạn đến một nhật ký kiểm thử thực tế, mã thoát và revision đã được kiểm tra. Hãy lưu diff cùng với bằng chứng đó. Nếu không, một lần sửa sau đó có thể thay đổi các file sau thành công bề ngoài và khiến báo cáo trở nên lỗi thời.
Hãy coi timeout và retry là hành vi ứng dụng do bạn sở hữu. Đặt một hạn chót cho yêu cầu và một ngân sách tổng cho tác vụ. Phân tách các lỗi do thông tin xác thực hoặc tham số không hợp lệ khỏi các lỗi truyền tải tạm thời. Lặp lại một yêu cầu không hợp lệ làm lãng phí thời gian; lặp lại một yêu cầu gây ra tác dụng phụ có thể tạo ra công việc trùng lặp.
Khi agent có thể gọi công cụ, hãy phân biệt việc kiểm tra chỉ đọc với các thao tác ghi. Gán định danh thao tác ở nơi thiết kế công cụ của bạn hỗ trợ, và xác nhận trạng thái trước khi lặp lại một thao tác ghi không chắc chắn. Chính sách thử lại của một endpoint model không thể đảm bảo tính idempotent cho các công cụ mà ứng dụng của bạn thực thi sau đó.
Hãy bảo vệ nhật ký một cách có chủ đích như với các file source. Ghi lại model ID, dấu thời gian, trạng thái, thời gian và mức sử dụng mà không thường xuyên sao chép bí mật hoặc toàn bộ kho lưu trữ riêng tư vào telemetry. Giữ mọi bằng chứng đầu ra thô cần thiết ở một vị trí được hạn chế phù hợp, và xác lập thời gian mà nhóm cần lưu giữ nó.
Hãy kiểm tra streaming với client thực tế của bạn. Nó phải xử lý được các sự kiện từng phần, việc kết thúc, lỗi và các bản ghi sử dụng khi có. Xác nhận giới hạn tốc độ cho tài khoản và triển khai thực tế. Một thử nghiệm yên ắng với một người dùng không thể xác lập cách cùng route đó hành xử khi cả một nhóm gửi yêu cầu cùng lúc.
Hãy dùng danh sách kiểm tra phát hành ngắn gọn này:
- Các bài kiểm thử chấp nhận và các bài hồi quy hiện có đều vượt qua trên revision cuối cùng.
- Diff nằm trong ranh giới tác vụ đã được phê duyệt.
- Hành vi timeout, hủy bỏ và thử lại đã được thực hành.
- Các lệnh gọi công cụ và phản hồi có cấu trúc hoạt động trên endpoint đã chọn.
- Nhật ký không chứa thông tin xác thực và code riêng tư không cần thiết.
- Các điều khoản xử lý dữ liệu đáp ứng yêu cầu của nhóm.
- Phương án dự phòng có cấu hình và bản ghi kiểm thử đã được xác minh riêng.
Các kho lưu trữ riêng tư đòi hỏi một quyết định riêng cho từng dịch vụ. Hãy xem lại các điều kiện hiện hành về lưu giữ, sử dụng để huấn luyện, quyền truy cập và hợp đồng với người chịu trách nhiệm về code. Chỉ gửi tài liệu đã được phê duyệt. Đừng suy ra tính bảo mật từ việc trọng số model có sẵn, hay từ một giao thức giống với giao thức bạn đã dùng.
API AI tốt nhất để lập trình: Đưa ra lựa chọn cuối cùng
Hãy đưa ra quyết định qua ba lượt.
Đầu tiên, loại bỏ những ứng viên thiếu một năng lực bắt buộc. Hãy viết ra các điều kiện phải được thỏa mãn: một định dạng đầu ra được chấp nhận, một vòng lặp công cụ hoạt động được, một thỏa thuận xử lý dữ liệu phù hợp, hoặc một hạn chót phản hồi khả thi. Một ứng viên thiếu một điều kiện cần có một quyết định khắc phục riêng trước khi nó thuộc về so sánh cuối cùng.
Thứ hai, so sánh chi phí trên mỗi tác vụ được chấp nhận và thời gian đã trôi qua. Dùng tất cả các lần thử theo cùng một chính sách sửa lỗi. Tách riêng thành công lần đầu với thành công sau khi sửa, và chỉ ra các bản ghi sử dụng còn thiếu. Nếu hai model đều đáp ứng hợp đồng, hãy so sánh gánh nặng đánh giá của chúng cũng như phí model. Các nhà phát triển của bạn sẽ phải sống chung với những bản vá thu được.
Thứ ba, giữ một phương án dự phòng và định nghĩa điều kiện kích hoạt nó. Ví dụ bao gồm endpoint ngừng hoạt động kéo dài, lỗi đầu ra có cấu trúc lặp lại, hoặc chi phí tác vụ vượt quá một mức trần đã chọn. Hãy kiểm thử cấu hình thay thế trước. Việc chuyển model ID dưới áp lực có thể tạo ra vấn đề tích hợp thứ hai nếu các điều khiển hoặc hành vi phản hồi của nó khác biệt.
Ba tác vụ nhỏ trong hướng dẫn này là một bài sàng lọc. Hãy mở rộng bộ kiểm thử bằng công việc đại diện từ codebase của chính bạn trước khi tin cậy một ứng viên cho những thay đổi rộng. Giữ một vài tác vụ nằm ngoài phạm vi tinh chỉnh prompt để bạn có thể kiểm tra xem những cải thiện có chuyển giao được ra ngoài các ví dụ mà bạn đã tối ưu hay không.
API AI tốt nhất để lập trình là sự kết hợp mà bạn có thể giải thích được: nó hoàn thành công việc cần thiết, phơi bày những chi phí bạn có thể theo dõi, và phù hợp với cách ứng dụng của bạn vận hành. Không cần một người thắng chung cuộc để đưa ra quyết định đó.
Hãy mở danh mục model hiện tại, chọn hai ứng viên và lưu lại ID cùng các thiết lập chính xác của chúng. Sau đó dùng cùng tác vụ, cùng các bài kiểm thử và cùng quy tắc dừng cho cả hai.
Câu hỏi thường gặp
API AI tốt nhất để lập trình với ngân sách nhỏ là gì?
Hãy bắt đầu với một ứng viên có mức giá hiển thị phù hợp với khối lượng đầu vào và đầu ra dự kiến của bạn, rồi so sánh chi phí trên mỗi tác vụ được chấp nhận. Các dòng Qwen, DeepSeek và Kimi cung cấp những phiên bản cụ thể để điều tra, mà không khẳng định một người thắng về giá trị đã được kiểm thử. Hãy giới hạn số lần sửa, tái sử dụng ngữ cảnh liên quan một cách có chủ đích, và theo dõi các yêu cầu thất bại. Tính riêng thời gian đánh giá để một hóa đơn suy luận thấp không che giấu một gánh nặng dọn dẹp lớn.
Một đăng ký lập trình có rẻ hơn trả tiền cho token API không?
Điều đó phụ thuộc vào khối lượng công việc của bạn và những gì gói dịch vụ bao gồm. Một đăng ký có thể phù hợp với việc sử dụng tương tác trong ứng dụng được hỗ trợ của nó, trong khi tính phí theo mức sử dụng có thể phù hợp với một dịch vụ tùy chỉnh có lưu lượng thay đổi. Hãy kiểm tra quyền truy cập model, các giới hạn, mức đồng thời, và liệu các lệnh gọi API bên ngoài có được bao gồm hay không. Hãy so sánh cùng một lượng công việc hữu ích trong một khoảng thời gian đại diện; giá niêm yết hàng tháng và giá token đo lường những thứ khác nhau.
Sự khác biệt giữa một model lập trình và một coding agent là gì?
Model tạo ra các phản hồi. Agent quản lý vòng lặp xung quanh những phản hồi đó, bao gồm truy cập file, thực thi công cụ, kiểm thử và các quy tắc dừng. Bạn có thể gọi một model lập trình thông qua API mà không cần xây dựng một agent, ví dụ để đề xuất một hàm cho con người đánh giá. Nếu bạn muốn chỉnh sửa tự động, hãy đánh giá model cùng với agent và các quyền mà nó sẽ thực sự sử dụng.
Tôi nên dùng API AI nào cho việc gỡ lỗi và refactor?
Hãy lập danh sách rút gọn các ứng viên phù hợp với yêu cầu về endpoint và xử lý code của bạn, rồi dùng những lỗi nhỏ và các lần refactor có ràng buộc từ công việc của bạn. Tác vụ A kiểm tra tính đúng đắn và việc biến đổi đầu vào; Tác vụ B kiểm tra việc phân tích cú pháp và giữ nguyên interface. Tiếp theo đó, hãy dùng các bài kiểm thử đại diện từ kho lưu trữ.
Hãy ưu tiên ứng viên đáp ứng các điều kiện chấp nhận của bạn với công sức đánh giá có thể quản lý được, thay vì một ứng viên chỉ đơn thuần tạo ra lời giải thích dài nhất hoặc bản viết lại rộng nhất.
Có API AI miễn phí để lập trình không?
Tín dụng dùng thử, một ứng dụng có gói miễn phí, và trọng số model có thể tải xuống là những ưu đãi khác nhau. Không có ưu đãi nào tự động mang lại cho ứng dụng của bạn khả năng suy luận được lưu trữ không giới hạn. Hãy xác minh điều kiện đủ hiện hành, thời hạn, hạn ngạch và các model được hỗ trợ trước khi lập ngân sách dựa trên quyền truy cập miễn phí. Bài viết này không khẳng định có một khoản miễn phí hiện đang khả dụng.
Nếu bạn tự lưu trữ trọng số, hãy tính đến chi phí tính toán và vận hành ngay cả khi việc tải trọng số xuống không tốn phí.
Tôi có thể gửi code từ kho lưu trữ riêng tư đến một API lập trình không?
Chỉ gửi code mà tổ chức của bạn cho phép bạn chia sẻ theo các điều khoản áp dụng của dịch vụ cụ thể đó. Hãy xem lại các yêu cầu về lưu giữ, sử dụng để huấn luyện, kiểm soát truy cập và hợp đồng cho triển khai đã chọn.
Hãy xóa thông tin xác thực và các file không liên quan, và kiểm tra xem agent của bạn tự động đưa những gì vào prompt và nhật ký. Một model open-weight hay một định dạng API quen thuộc, tự nó, không xác lập rằng một dịch vụ được lưu trữ đáp ứng các yêu cầu bảo mật của nhóm bạn.


