Seedance 2.0 Mini & Fast API với mức giá thấp nhất toàn cầu — giảm đến 68% so với giá chính thức

AI Avatar Generator giúp một tấm ảnh nói theo file âm thanh của bạn

Tải lên một ảnh chân dung và một file âm thanh. Các mô hình audio to video sẽ làm gương mặt chuyển động, khẩu hình và biểu cảm bám theo bản ghi, và video biết nói hoàn chỉnh sẵn sàng để tải về.

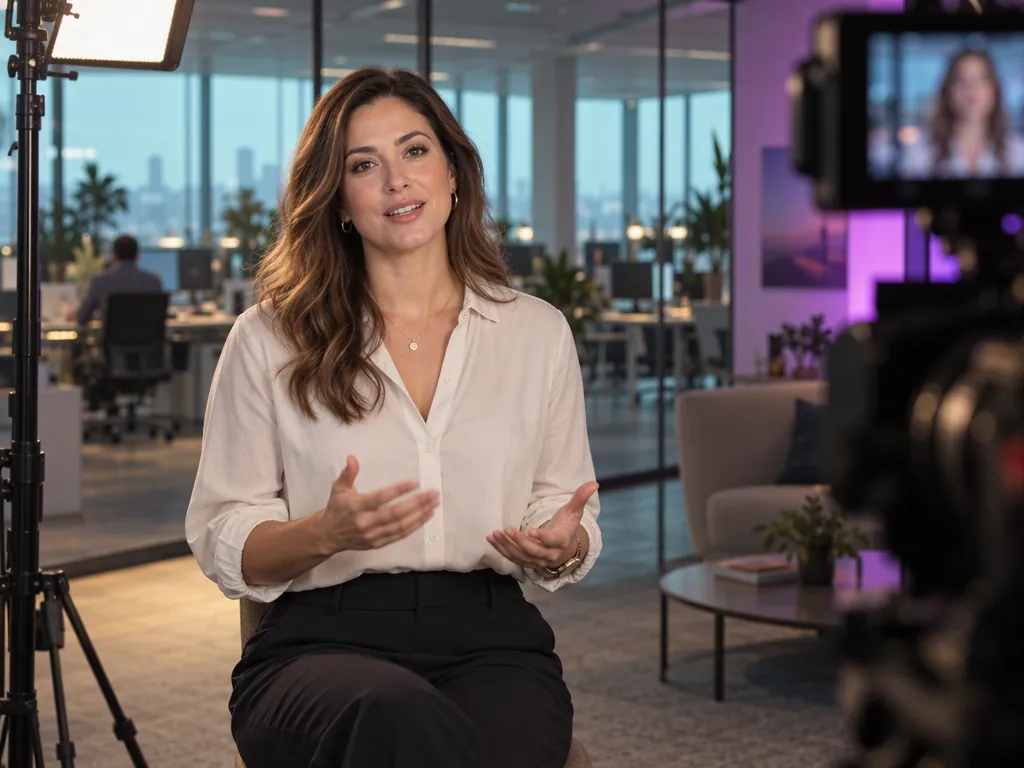
Video avatar AI từ một tấm ảnh chân dung

Clip ngắn giàu biểu cảm hay video giải thích dài mười phút, đều từ đúng hai thứ đầu vào đó.

AI Talking Avatar Generator

Tải lên một ảnh chân dung chụp chính diện và một file MP3 hoặc WAV. Avatar Omni Human 1.5 trả về video người đó đang nói hoặc đang hát theo bản ghi, với khẩu hình, biểu cảm và cử chỉ sinh ra thẳng từ âm thanh. Kết quả xuất ở 720p hoặc 1080p.

Clip dài tối đa 60 giây, và từ 15 giây trở xuống cho hình sắc nét nhất. Thêm một prompt tùy chọn để định hướng bối cảnh, hành động hoặc biểu cảm, prompt này đọc được tiếng Trung, tiếng Anh, tiếng Nhật, tiếng Hàn, tiếng Tây Ban Nha và tiếng Indonesia.

Lip Sync AI cho bản ghi dài

Khi kịch bản là cả một bài giảng chứ không phải một clip mạng xã hội, InfiniteTalk nhận đúng tấm ảnh chân dung đó cùng file âm thanh dài tới 10 phút. Khẩu hình khớp tới từng âm vị suốt cả bản ghi, còn gương mặt, kiểu tóc, trang phục và phông nền giữ nguyên từ đầu đến cuối. Kết quả xuất ở 480p hoặc 720p.

Tạo phần thuyết minh ở tab Audio rồi mang file sang đây, sau đó dùng prompt để chỉnh biểu cảm và tư thế. Một module bài giảng hay một video hướng dẫn sản phẩm ra đời mà không cần đặt máy quay hay tìm người dẫn.

Các mô hình avatar AI tại một nơi

Hai mô hình dựng cho hai độ dài khác nhau. Chọn Avatar Omni Human 1.5 cho clip ngắn giàu biểu cảm, lên tới 1080p, và chọn InfiniteTalk khi bản ghi âm dài.

Tạo video avatar AI trong 3 bước

1

Tải ảnh chân dung lên

Dùng ảnh chụp chính diện, rõ nét, chỉ có một người. Nền trơn và gương mặt không bị che giúp mô hình làm việc tốt nhất.

2

Thêm âm thanh

Đính kèm một file MP3 hoặc WAV: bản ghi âm của bạn, hoặc giọng nói bạn đã tạo ở tab Audio.

3

Tạo rồi tải về

Chọn mô hình và độ phân giải, bấm tạo, rồi tải clip hoàn chỉnh về.

Bạn làm được gì với một avatar biết nói?

Chọn tab gần với công việc của bạn để xem avatar biết nói thay được buổi quay ở khâu nào.

Clip người phát ngôn AI cho mọi thị trường

Một tấm ảnh chân dung, nhiều ngôn ngữ. Bạn thu hoặc tạo kịch bản cho từng ngôn ngữ, chạy cùng một gương mặt qua mô hình, và chiến dịch có một người dẫn đồng nhất ở mọi nơi mà không phải bay ai đi đâu.

Bài giảng talking head không cần studio

Biến một bản ghi bài giảng mười phút thành video bằng InfiniteTalk. Giảng viên xuất hiện trên màn hình suốt cả module, và muốn cập nhật bài học thì chỉ cần đổi file âm thanh, không phải quay lại.

Video giới thiệu sản phẩm bằng avatar AI

Sản phẩm nào cũng có người giới thiệu. Ghép kịch bản trang bán hàng từ tab Audio với một ảnh chân dung đại diện thương hiệu, và video hướng dẫn sẵn sàng cho trang sản phẩm hoặc một quảng cáo kiểu UGC.

Video onboarding cập nhật được mà không cần quay lại

Thu phần trình bày quy định một lần dưới dạng âm thanh rồi giao cho InfiniteTalk một người dẫn cố định, mô hình này giữ khẩu hình khớp suốt bản ghi dài. Khi một quy trình thay đổi, bạn đổi file âm thanh và vẫn gương mặt đó đọc phiên bản mới.

Thêm công cụ AI của Atlas Cloud quanh avatar của bạn

Câu hỏi thường gặp

AI Avatar Generator là một dạng AI audio to video: nó làm một ảnh chân dung tĩnh nói theo đoạn âm thanh bạn đưa vào. Bạn tải lên một tấm ảnh và một file âm thanh, mô hình tạo khẩu hình, biểu cảm và cử chỉ từ chính âm thanh đó, rồi trả về video người ấy đang nói.

Atlas Cloud hỗ trợ Avatar Omni Human 1.5 của ByteDance và InfiniteTalk. Cả hai đều nhận một ảnh chân dung kèm âm thanh, khác nhau chủ yếu ở độ dài clip và độ phân giải.

Avatar Omni Human 1.5 tạo clip dài tối đa 60 giây, và nên để từ 15 giây trở xuống. InfiniteTalk nhận tới 10 phút âm thanh trong một lần chạy.

Avatar Omni Human 1.5 xuất 720p hoặc 1080p. InfiniteTalk xuất 480p hoặc 720p.

Ảnh chân dung chính diện của một người, gương mặt rõ nét. Cả hai mô hình đều dựng cho một người nói trên mỗi clip.

Được. Avatar Omni Human 1.5 dựng cho cả nói lẫn hát, sinh ra cử chỉ và biểu cảm từ âm thanh chứ không phải từ kịch bản.

Avatar Omni Human 1.5 nêu tiếng Trung, tiếng Anh, tiếng Nhật, tiếng Hàn, tiếng Tây Ban Nha và tiếng Indonesia trong số các ngôn ngữ nó làm việc được. Khẩu hình bám theo chính đoạn âm thanh, nên điều quan trọng là ngôn ngữ trong bản ghi.

Được. Tạo phần thuyết minh bằng một mô hình text to speech, tải file về rồi đính kèm làm âm thanh đầu vào ở đây. Avatar khớp khẩu hình với giọng do AI tạo y như với một bản thu thật.

Có. Cả hai mô hình đều gọi được qua API của Atlas Cloud, dùng chung cách xác thực với API ảnh và video. Xem các trang mô hình avatar để bắt đầu xây dựng.

Hướng dẫn làm video avatar AI

Chuẩn bị ảnh chân dung, độ dài âm thanh và thử nghiệm ngôn ngữ.

Bắt đầu từ một tấm ảnh chân dung. Để nó tự cất lời.