Một báo cáo kiểm thử API xanh (pass) có vẻ yên tâm cho đến khi bạn nhận ra rằng mọi assertion chỉ kiểm tra HTTP 200. Phản hồi có thể chứa bản ghi của sai khách hàng và vẫn pass.
Chọn công cụ AI để kiểm thử API dựa trên công việc bạn đã có. Hãy đánh giá Postman Agent Mode nếu nhóm của bạn duy trì các collection, KushoAI nếu đặc tả là điểm khởi đầu, và Keploy nếu bạn cần luồng được tạo hoặc kiểm thử hồi quy được xây dựng từ lưu lượng đã ghi. Hãy xem xét và thực thi các kiểm thử thu được trước khi tin tưởng chúng.
Hướng dẫn này bao gồm hỗ trợ AI để kiểm thử các API thông thường. Kiểm thử độ chính xác của câu trả lời của mô hình AI là một bài toán đánh giá riêng.
Những điểm chính
- Cung cấp hợp đồng (contract), các phụ thuộc yêu cầu (request dependencies), và kỳ vọng nghiệp vụ đã được phê duyệt.
- Kiểm tra xem các assertion có từ chối dữ liệu sai, trường thiếu, và kiểu hỏng (broken types) hay không.
- Chỉ mua sau khi các kiểm thử đã được xem xét chạy lặp lại trong môi trường CI dự định của bạn.
So sánh sản phẩm dưới đây phản ánh tài liệu chính thức được kiểm tra vào ngày 21 tháng 9, 2026. Đây không phải là đánh giá đối đầu (head-to-head benchmark) của ba tài khoản trả phí.
Ví dụ thực hành sử dụng đặc tả Swagger Petstore được ghim (pinned) và tách biệt kỳ vọng hợp đồng, hành vi quan sát được, và các bản sao phản hồi được sửa đổi có chủ đích.
Lần chạy cục bộ của chúng tôi đã vượt qua 5 kiểm thử trực tiếp (live tests) và từ chối cả 3 bản sao phản hồi đã bị thay đổi có chủ đích. Một phép thử thiếu tên riêng biệt vẫn trả về 200, cho thấy tại sao phạm vi của một báo cáo xanh lại quan trọng.
Công cụ AI để kiểm thử API thực sự làm gì
Hỗ trợ AI thường tham gia vào bốn phần của kiểm thử API. Một mô hình đọc đặc tả của bạn, đề xuất các kịch bản, soạn thảo assertion, và giúp giải thích các lỗi. Mỗi phần yêu cầu bằng chứng khác nhau. Một lời giải thích hợp lý cho một lỗi không chứng minh rằng bản sửa đề xuất là đúng.
Để xem xét đặc tả, hãy cung cấp tệp OpenAPI và các quy tắc nghiệp vụ liên quan. Để lập kế hoạch kịch bản, hãy thêm ví dụ về dữ liệu hợp lệ và các ranh giới đã biết. Đối với script thực thi, hãy bao gồm runner, thiết lập xác thực, và quy ước fixture của bạn. Để chẩn đoán, hãy cung cấp yêu cầu, phản hồi, và thông báo lỗi thực tế sau khi loại bỏ thông tin bí mật.
Hãy tách biệt bốn cơ chế này khi đánh giá sản phẩm:
- Tạo bằng LLM: đề xuất kiểm thử từ ngôn ngữ, lược đồ (schemas), và ví dụ. Người đánh giá phải kiểm tra các kết quả đầu ra mong đợi.
- Phát lại lưu lượng (Traffic replay): so sánh hành vi sau này với các tương tác đã ghi lại, thường sử dụng các phản hồi phụ thuộc đã ghi.
- Kiểm thử dựa trên thuộc tính (Property-based testing): xây dựng một cách có hệ thống các đầu vào để thử thách các thuộc tính như tính tuân thủ lược đồ (schema conformance).
- Thực thi kiểm thử: gửi yêu cầu, đánh giá assertion, và trả về báo cáo cùng mã thoát (exit codes).
Một sản phẩm có thể kết hợp nhiều cơ chế. Hãy hỏi cơ chế nào đã tạo ra từng kiểm thử và điều gì xác định kết quả mong đợi của nó. Ghi lại một phản hồi sai có thể bảo tồn chính lỗi đó như một baseline hồi quy. Tạo một tên kiểm thử chỉn chu có thể ngụy trang một kỳ vọng không được hỗ trợ.
Hãy nghĩ về assertion ở ba mức độ. Thứ nhất, máy chủ có phản hồi thành công không? Thứ hai, phần thân (body) có các trường và kiểu đã được tài liệu hóa không? Thứ ba, phần thân này có đại diện cho tài nguyên (resource) và thao tác bạn yêu cầu không?
Đối với tra cứu thú cưng (pet lookup), một đối tượng hợp lệ với ID số nguyên vẫn trượt kiểm tra thứ ba nếu ID đó thuộc về một thú cưng khác. Ngược lại, khớp ID được yêu cầu không chứng minh rằng mọi trường đều thỏa mãn lược đồ. Hãy sử dụng cả hai kiểm tra, và chỉ thêm quy tắc nghiệp vụ khi nhóm có nguồn đã được thống nhất cho chúng.
Đầu ra thực tế bạn muốn là một tài sản kiểm thử có thể bảo trì với một oracle có thể giải thích: lý do rõ ràng tại sao mỗi kết quả nên pass hoặc fail. Hãy đếm các kịch bản hữu ích sau khi xem xét, bao gồm cả những cái bạn từ chối, thay vì ca ngợi độ dài của danh sách được tạo ban đầu.
So sánh công cụ AI để kiểm thử API theo quy trình làm việc
Bắt đầu với artifact mà nhóm của bạn có thể cung cấp ngay hôm nay. Di chuyển một collection đã được thiết lập, tái tạo các quy tắc nghiệp vụ còn thiếu, và thiết lập ghi phụ thuộc là những dự án khác nhau. Một công cụ phù hợp với một điểm khởi đầu có thể tạo thêm việc ở điểm khác.
| Công cụ hoặc cách tiếp cận | Đầu vào hữu ích | Vai trò AI hoặc tự động hóa | Lộ trình thực thi và CI | Đầu ra có thể xem xét | Câu hỏi thử nghiệm chính |
|---|---|---|---|---|---|
| Postman Agent Mode | Collection, yêu cầu, phản hồi, môi trường, đặc tả | Soạn thảo và chỉnh sửa script kiểm thử trong ngữ cảnh workspace | Collection Runner và quy trình CLI tương thích | Assertion JavaScript chuẩn của Postman | Nó có giữ nguyên các biến của bạn và kiểm thử hợp đồng không? |
| KushoAI | OpenAPI, collection Postman, cURL | Tạo kịch bản và bộ kiểm thử; hỗ trợ tinh chỉnh bằng ngôn ngữ tự nhiên | Thực thi trên nền tảng và tích hợp CI được tài liệu hóa; kiểm tra quyền | Kiểm tra các yêu cầu, phụ thuộc, và kết quả mong đợi được tạo | Gói bạn chọn có thể chạy và lưu giữ bộ kiểm thử ở nơi bạn cần không? |
| Keploy | Đặc tả hoặc định nghĩa yêu cầu; cách khác là lưu lượng thực | Tạo bằng AI và một lộ trình ghi/phát lại riêng | Luồng được tạo hoặc kiểm thử đã ghi trong môi trường cục bộ/CI được hỗ trợ | Xem xét định nghĩa kiểm thử, baseline, và mock phụ thuộc | Lộ trình nào bao phủ các chế độ lỗi thực tế của bạn? |
| Runner hiện có cộng với LLM | Ma trận đã được phê duyệt, đặc tả, quy ước fixture | Soạn thảo mã để xem xét | pytest của bạn hoặc runner đã thiết lập khác | Mã được commit vào kho của bạn | Việc xem xét có rẻ hơn so với viết trực tiếp các kiểm thử tương tự không? |
Postman Agent Mode cho các Collection hiện có
Postman là một đánh giá đầu tiên hợp lý khi collection của bạn đã chứa thứ tự yêu cầu hữu ích, biến môi trường, và thiết lập xác thực. Agent Mode có thể sử dụng ngữ cảnh đó để tạo script kiểm thử JavaScript chuẩn. Những script đó có thể đi vào quy trình thực thi collection hiện có thay vì yêu cầu một ngôn ngữ assertion mới.
Một thử nghiệm tập trung sẽ tiết lộ nhiều hơn so với yêu cầu nó kiểm thử mọi thứ. Chọn yêu cầu truy xuất một tài nguyên được tạo trước đó trong collection. Cung cấp lược đồ của nó và yêu cầu xác thực trường bắt buộc, kiểu trường đã được tài liệu hóa, và một assertion kết nối ID được trả về với ID tạo đã lưu.
Sau đó kiểm tra các thay đổi được đề xuất trước khi chấp nhận chúng. Một ví dụ phản hồi có thể chứa một thú cưng tên Milo. So sánh bằng với Milo là có ý nghĩa nếu fixture của bạn đã tạo Milo một cách rõ ràng; nó mong manh nếu generator sao chép tên từ một bản ghi mẫu dùng chung. Cùng một literal có thể là một assertion hợp lệ hoặc một phụ thuộc tình cờ, tùy thuộc vào nguồn của nó.
Kiểm tra phạm vi biến cẩn thận. Một ID được lưu trong biến môi trường phải có sẵn cho yêu cầu sau đó và phải thuộc về lần chạy đó. Các biến dùng chung giữa các lần chạy đồng thời có thể tạo ra lỗi gián đoạn giống như lỗi máy chủ. Hãy yêu cầu generator giải thích cả setup và cleanup cũng như các assertion.
Đối với kiểm thử chấp nhận đầu tiên, hãy chạy collection hai lần trên dữ liệu cô lập, sau đó kiểm tra biểu diễn đã xuất hoặc được đánh phiên bản. Xác nhận rằng một đồng nghiệp có thể xem xét các script đã thay đổi mà không cần lặp lại cuộc trò chuyện với AI. Cũng xác minh rằng CLI, reporter, và gói bạn chọn hỗ trợ lộ trình thực thi bạn định sử dụng.
Không có phần tạo Postman nào được vận hành và trình bày ở đây. Câu hỏi đánh giá hữu ích là liệu ngữ cảnh workspace của nó có giảm công việc xem xét của bạn trên một collection hiện có hay không. Điều đó đòi hỏi collection của riêng bạn và một thử nghiệm cấp tài khoản, không phải kết luận rút ra từ ảnh chụp màn hình sản phẩm.
KushoAI để tạo kiểm thử dựa trên đặc tả
KushoAI chấp nhận đầu vào Swagger/OpenAPI, Postman, và cURL và tài liệu hóa việc tạo kiểm thử, tinh chỉnh bằng ngôn ngữ tự nhiên, và thực thi CI. Điều đó khiến nó trở thành ứng viên khi một nhóm có định nghĩa API hữu ích nhưng còn tồn đọng các kiểm thử chưa viết. Đây là những khả năng do nhà cung cấp mô tả, không phải kết quả phát hiện lỗi được đo lường. (Tài liệu KushoAI, tháng 9 năm 2026)
Chọn đầu vào có ngữ cảnh đáng tin cậy phong phú nhất. Một yêu cầu cURL có thể mô tả một yêu cầu hợp lệ, nhưng nó thường ít nói về các trường tùy chọn, giá trị enum được phép, hoặc lỗi đã được tài liệu hóa. Một tệp OpenAPI thêm cấu trúc; một ma trận kịch bản đã được phê duyệt thêm ý định mà cấu trúc có thể để lại mơ hồ.
Đối với thử nghiệm Petstore, hãy yêu cầu các trường hợp riêng biệt cho một thú cưng hợp lệ, thiếu tên bắt buộc, ID sai kiểu, và bộ lọc trạng thái không hợp lệ. Xem xét liệu công cụ có phân biệt yêu cầu phần thân yêu cầu (request-body) với yêu cầu lược đồ phản hồi (response-schema) hay không. Chúng có thể trông giống nhau trong một ví dụ trong khi áp đặt các nghĩa vụ khác nhau.
Tiếp theo, hãy xem xét một luồng create-read-update được kết nối. Thao tác đọc phải sử dụng ID gắn với setup hiện tại. Thao tác cập nhật phải nhắm đến cùng tài nguyên, và một lần đọc sau đó phải xác minh trường đã thay đổi. Bốn yêu cầu độc lập với tên kiểm thử hấp dẫn không chứng minh rằng chuỗi phụ thuộc hoạt động.
Coi lần tạo đầu tiên như một đề xuất. Giữ các kỳ vọng đã được tài liệu hóa, sửa các script có luồng dữ liệu sai, và đánh dấu các kết quả chưa được đặc tả đầy đủ để đưa ra quyết định về yêu cầu. Nếu công cụ đề xuất nhiều trường hợp thiếu trường tương đương, hãy giữ lại những khác biệt hữu ích thay vì trả tiền để duy trì các bản trùng lặp.
Trước khi mua, hãy yêu cầu thực thi bộ kiểm thử từ pipeline dự định của bạn và kiểm tra artifact lỗi. Xác nhận quyền CI hiện tại, xử lý thông tin xác thực, và các định dạng xuất có sẵn trên gói đã chọn. Đừng cho rằng một thử nghiệm tương tác miễn phí cấp cùng quyền tự động hóa như một triển khai nhóm.
Keploy cho kiểm thử được tạo và phát lại lưu lượng
Tài liệu của Keploy trình bày hai lộ trình khởi đầu riêng biệt. Tạo bằng AI chấp nhận các tài nguyên như OpenAPI, Postman, cURL, hoặc endpoint và xây dựng các luồng API được kết nối. Ghi và phát lại nắm bắt các tương tác API và phụ thuộc của chúng để thực thi sau này với mock. Mô tả luồng AI và mô tả ghi phụ thuộc không nên được coi là các cơ chế giống hệt nhau. (Tài liệu Keploy, tháng 9 năm 2026)
Nếu khó khăn của bạn là tái tạo những gì ứng dụng đã làm với cơ sở dữ liệu hoặc dịch vụ thượng nguồn, hãy đánh giá lộ trình ghi. Ghi lại một hành trình create-read-update nhỏ trong môi trường cô lập, kiểm tra các phụ thuộc đã ghi, và phát lại sau một thay đổi ứng dụng có kiểm soát. Kiểm tra những gì runtime hỗ trợ trước khi lên kế hoạch triển khai lớn hơn.
Nếu khó khăn của bạn là suy ra các trường hợp từ một đặc tả, hãy đánh giá lộ trình tạo một cách riêng biệt. Hỏi các yêu cầu được đề xuất của nó lấy thông tin xác thực như thế nào, mang ID giữa các bước ra sao, và dọn dẹp dữ liệu thế nào. Sự hiện diện của các tính năng ghi ở nơi khác trong sản phẩm không trả lời những câu hỏi đó cho một bộ kiểm thử được tạo.
Các giá trị động cần phán đoán. Dấu thời gian (timestamp) có thể thay đổi một cách hợp lệ; ID tài nguyên có thể kết nối hai yêu cầu và do đó cần so sánh. Việc bỏ qua một cách rộng rãi mọi trường thay đổi có thể che giấu lỗi. Hãy xem xét loại trừ từng trường và giữ lại các so sánh thể hiện mối quan hệ có ý nghĩa.
Cũng kiểm tra baseline trước khi chấp nhận nó. Một bản ghi chứa tổng sai, phản hồi dự phòng tình cờ, hoặc dữ liệu cũ có thể phát lại một cách nhất quán. Tính nhất quán giúp phát hiện thay đổi, nhưng nhóm vẫn quyết định liệu hành vi đã ghi có đúng hay không.
Một bổ sung hữu ích: Schemathesis cung cấp kiểm thử API dựa trên thuộc tính được điều khiển bởi lược đồ. Nó có thể thử thách API bằng các đầu vào được tạo cùng với các ví dụ đã được xem xét. Hãy coi nó như một cơ chế kiểm thử khác, không phải từ đồng nghĩa với một generator kiểm thử LLM. Các phát hiện của nó vẫn cần được diễn giải dựa trên hợp đồng và triển khai.
Công cụ AI miễn phí để kiểm thử API: Giới hạn và chi phí
“Miễn phí” có thể mô tả một client, một hạn mức AI giới hạn, một runner mã nguồn mở, hoặc một bản dùng thử tạm thời. Những ưu đãi này bao gồm các phần khác nhau của quy trình làm việc. Một client miễn phí không chứng minh rằng việc tạo tự động, thực thi theo lịch, hoặc xuất báo cáo cũng miễn phí.
Theo kiểm tra ngày 21 tháng 9, 2026, gói Free của Postman liệt kê 50 AI credits mỗi tháng. Credits là đơn vị tính phí của nó; chúng không có nghĩa là 50 kiểm thử hoặc 50 bộ kiểm thử hoàn chỉnh. Bảng so sánh của nó phân biệt hạn mức AI với thực thi, các tính năng hướng dữ liệu, và xuất kết quả. (Bảng giá Postman, tháng 9 năm 2026)
Phần trình bày giá hiện tại của KushoAI sử dụng Developer Edition và Enterprise. Keploy phân biệt Playground, Pro, và Enterprise, cùng với dịch vụ mã nguồn mở của nó. Hãy sử dụng màn hình mua hàng hiện tại để xác nhận các giới hạn liên quan. Các bài tổng hợp công cụ cũ hơn có thể mô tả tên gói đã ngừng hoặc kết hợp các hạn mức được tính phí riêng.
| Thành phần chi phí | Những gì cần ghi lại trong bản dùng thử | Điều gì có thể làm hóa đơn gây hiểu nhầm |
|---|---|---|
| Số ghế và gói | Người chỉnh sửa, người đánh giá, chu kỳ thanh toán, tính năng bắt buộc | So sánh giá tiêu đề hàng năm với cam kết hàng tháng |
| Tạo bằng AI | Mức sử dụng credit cho cùng một tác vụ đã được phê duyệt, bao gồm thử lại | Giả định một credit bằng một kiểm thử |
| Thực thi | Lần chạy cục bộ, lần chạy được lưu trữ, công việc CI, lịch trình, báo cáo | Coi các lần chạy tương tác là quyền cho mọi lộ trình tự động hóa |
| Mô hình độc lập | Token đầu vào và đầu ra để soạn thảo và xem xét | Bỏ qua việc gửi lại toàn bộ đặc tả nhiều lần |
| Thời gian kỹ thuật | Xem xét, sửa fixture, phân loại lỗi, bảo trì | Tính thời gian tạo ban đầu là tổng thời gian phân phối |
Sử dụng một tác vụ chấp nhận nhỏ để ước tính chi phí. Cho mỗi ứng viên cùng các thao tác và kỳ vọng, sau đó ghi lại có bao nhiêu kịch bản sống sót qua xem xét. Giữ thời gian tạo, thời gian xem xét thủ công, và thời gian thực thi trong các cột riêng biệt. Chờ đợi một mô hình và sửa một assertion nguy hiểm áp đặt các chi phí khác nhau lên nhóm.
Một mẫu số hữu ích là các kịch bản có thể chạy được đã được xem xét mà nhóm bạn sẽ giữ. Nó ngăn một generator với nhiều trường hợp trùng lặp trông rẻ hơn chỉ vì đầu ra của nó dài hơn. Ghi lại các trường hợp không được hỗ trợ mà bạn đã loại bỏ và các yêu cầu vẫn chưa được giải quyết.
Bài viết này không tuyên bố một tỷ lệ tiết kiệm lao động được đo lường hoặc so sánh thông lượng gói trả phí. Những số liệu đó cần một thử nghiệm có kiểm soát với các đầu vào tương đương. Đối với quyết định mua, hãy bao gồm một thay đổi bảo trì thực tế, chẳng hạn như thêm một trường bắt buộc, để ước tính bao quát cả sprint tiếp theo cũng như bản demo đầu tiên.
Công cụ AI để kiểm thử API: Từ OpenAPI đến lần chạy đầu tiên
Sử dụng một phiên bản cục bộ cô lập của dự án Swagger Petstore thật. Ghim commit d57941e8fe959e508796b27469b1e8bba73392dc; đặc tả của nó khai báo OpenAPI 3.0.4 và phiên bản ứng dụng 1.0.29-SNAPSHOT. Đọc tệp đã được ghim thay vì một bản demo công khai được cập nhật độc lập. (Đặc tả Swagger Petstore, tháng 9 năm 2026)
1. Chuẩn bị dịch vụ và ghi lại môi trường. Lấy kho lưu trữ qua trang nguồn đó, checkout bản sửa đổi đã được ghim, và cài đặt JDK và Maven tương thích. README của dự án đưa ra lệnh khởi động này từ thư mục kho lưu trữ:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty sử dụng cổng 8080. Đặt BASE_URL thành origin HTTP loopback của bạn trên cổng đó với /api/v3 được thêm vào. Xác nhận rằng /openapi.json có thể đọc được tương đối với base đó trước khi kiểm thử.
Lần chạy này đã sử dụng Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1, và jsonschema 4.26.0. Hãy ghi lại các phiên bản của bạn. Bản dựng từ nguồn tải xuống các phụ thuộc và Swagger UI, vì vậy chỉ ghim commit ứng dụng không tạo ra một bản dựng hoàn toàn khép kín (hermetic).
2. Nhập đặc tả đã được ghim. Chọn /pet, /pet/{petId}, và /pet/findByStatus. Giữ delete khả dụng để dọn dẹp. Ghi đè vị trí máy chủ công khai của đặc tả bằng base cục bộ của bạn. Kiểm tra cài đặt này trước khi gửi bất kỳ yêu cầu ghi nào.
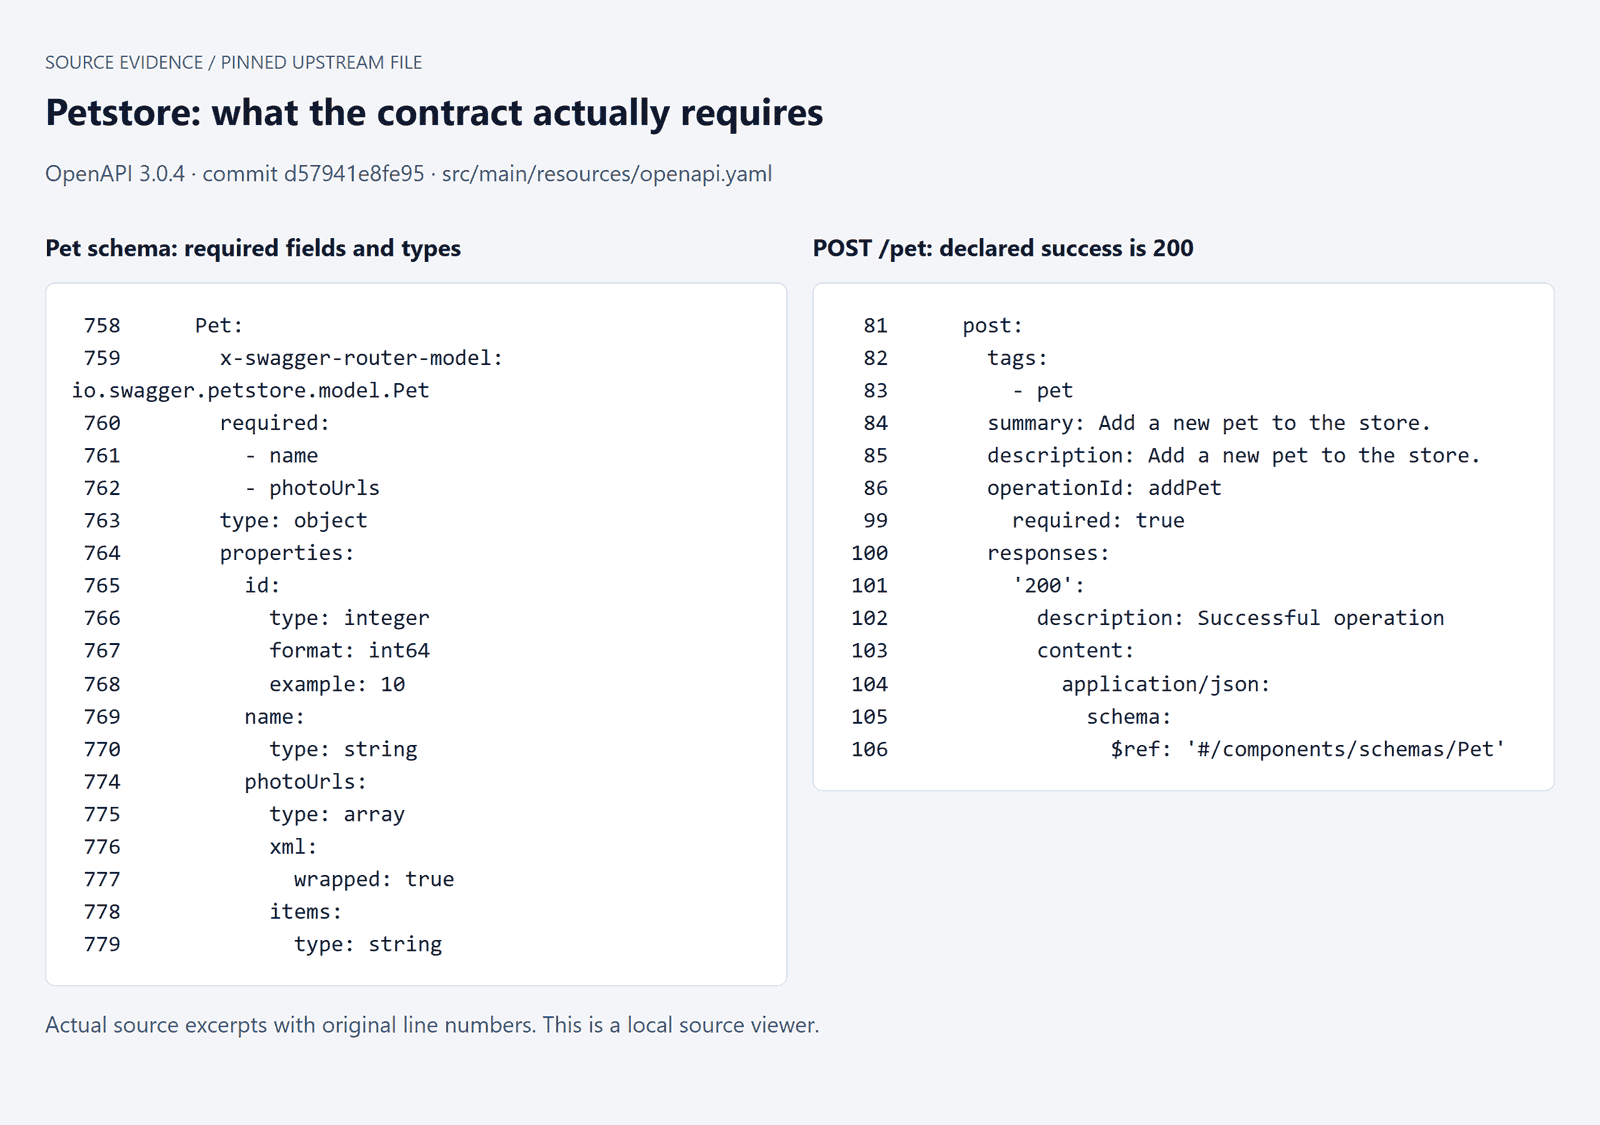 Nguồn OpenAPI Petstore đã được ghim hiển thị các trường bắt buộc và định nghĩa thao tác được chọn
Các đoạn trích nguồn thực được hiển thị cục bộ: Pet yêu cầu name và photoUrls; POST /pet khai báo 200 cho thành công. Số dòng gốc được giữ nguyên.
3. Tạo ma trận trước mã thực thi (Prompt A). Đính kèm đặc tả và dán prompt này vào generator bạn chọn:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Xem xét oracle cho từng kịch bản. Petstore ghi lại một thao tác tạo thành công là 200. Lược đồ Pet của nó yêu cầu name và photoUrls; id có kiểu số nguyên nhưng không nằm trong danh sách bắt buộc đó. Do đó, xác thực trường thiếu và danh tính yêu cầu-phản hồi cần các kiểm tra khác nhau.
| Thao tác | Đầu vào hoặc chuỗi | Bằng chứng kết quả mong đợi | Assertion cần xem xét | Trạng thái thực thi |
|---|---|---|---|---|
| addPet, getPetById | Tạo, sau đó đọc ID hiện tại | 200 đã được tài liệu hóa và lược đồ Pet; kỳ vọng luồng rõ ràng | Xác thực body và so sánh ID được trả về | Đã pass cục bộ |
| updatePet, getPetById | Thay đổi tên và đọc lại | Thao tác cập nhật cộng với ý định fixture đã được phê duyệt | Cùng ID, tên mới, lược đồ hợp lệ | Đã pass cục bộ |
| findPetsByStatus | Truy vấn available sau setup | Enum đã được tài liệu hóa và phản hồi mảng thành công | Tất cả trạng thái được trả về đều khớp; ID đã tạo có mặt | Đã pass cục bộ |
| getPetById | ID đường dẫn không phải số nguyên | 400 invalid-ID đã được tài liệu hóa | Trạng thái chính xác cho trường hợp đã được tài liệu hóa này | Đã pass: 400 |
| findPetsByStatus | Giá trị enum không được tài liệu hóa | 400 invalid-status đã được tài liệu hóa | Trạng thái chính xác, giữ lại bất kỳ sự không khớp nào | Đã pass: 400 |
| addPet | Bỏ qua name bắt buộc | Trường lược đồ bắt buộc; mô tả 400 và 422 không ánh xạ mọi biến thể | Ghi lại hành vi; giải quyết ánh xạ chính xác trước khi gating | Trả về 200 mà không có name; giữ lại sự khác biệt |
5. Tạo và kiểm tra tệp thực thi (Prompt B). Đính kèm ma trận đã được phê duyệt và đặc tả với prompt này:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Thực thi, lưu giữ, và dọn dẹp. Sử dụng ID thú cưng dành riêng cho lần chạy, nắm bắt phản hồi tạo, và truyền ID của nó vào các yêu cầu sau. Xác thực cập nhật thông qua một lần đọc mới. Chỉ một phản hồi cập nhật thành công không chứng minh rằng máy chủ đã lưu giữ thay đổi.
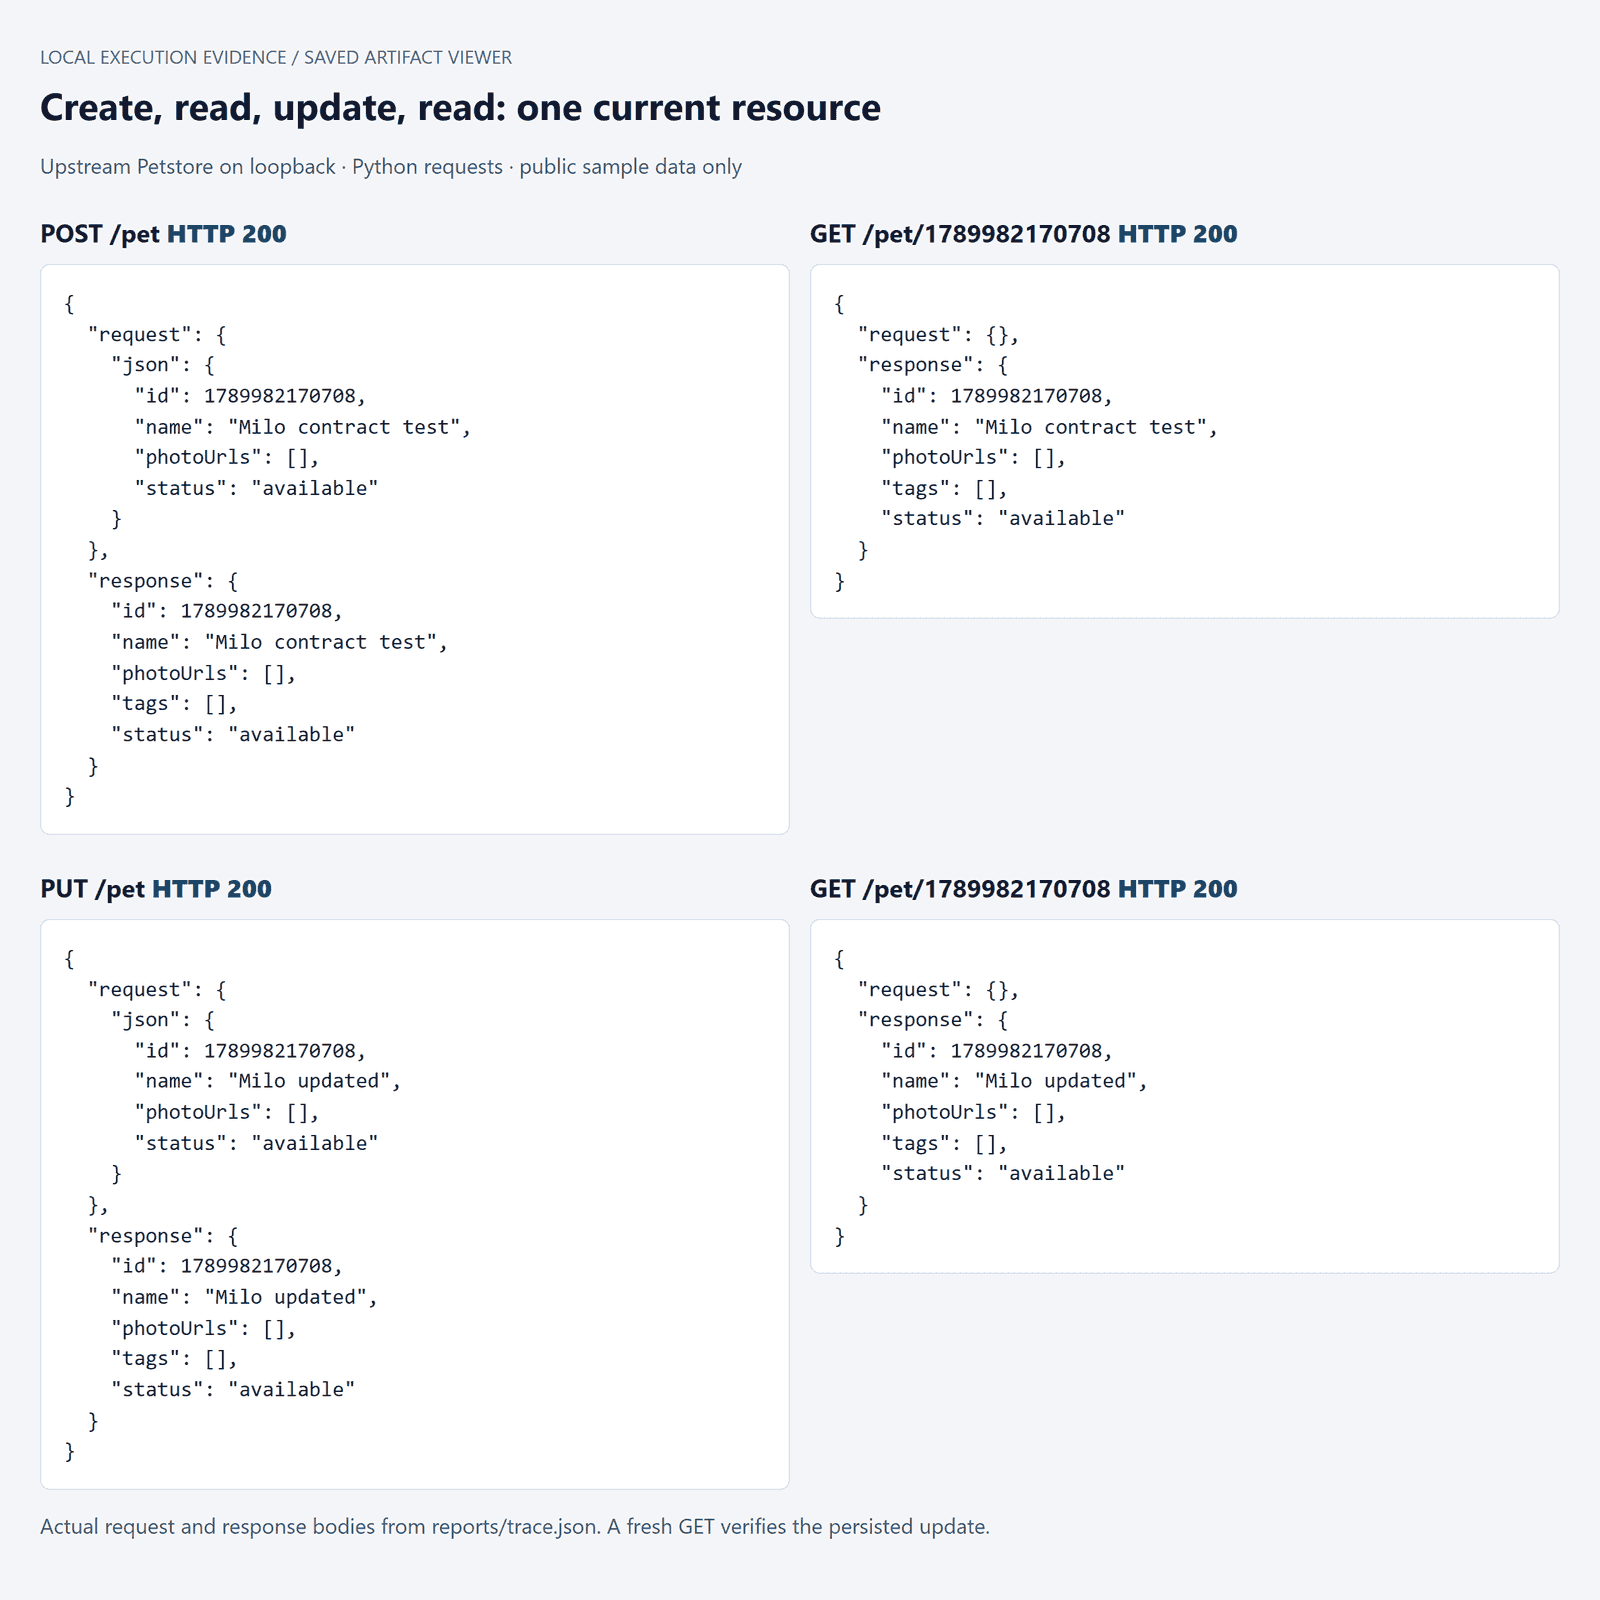 Bằng chứng chuỗi yêu cầu Petstore cục bộ hiển thị tạo, tra cứu, cập nhật và chuyển ID
Các yêu cầu và phản hồi cục bộ đã lưu: cùng ID dành riêng cho lần chạy tồn tại qua create, read, update, và một lần đọc mới. Cả 4 yêu cầu được hiển thị đều trả về 200.
Lưu các phần thân yêu cầu, phản hồi, lỗi assertion, và kết quả dọn dẹp. Hạn chế xóa chỉ với các ID được tạo bởi lần chạy này. Giữ các phản hồi bất ngờ như các phát hiện, bao gồm cả trường hợp triển khai minh họa chấp nhận đầu vào không hợp lệ. Đừng điều chỉnh assertion chỉ để có được ảnh chụp màn hình xanh.
Những gì lần chạy này phát hiện: 5 hàm kiểm thử trực tiếp đã pass, bao gồm các kiểm tra invalid-ID và invalid-status trả về 400. Phép thử thiếu tên riêng biệt trả về 200 và một body không có name. Chúng tôi giữ lại sự khác biệt lược đồ đó bên ngoài bộ kiểm thử xanh; ánh xạ lỗi dự định chính xác của nó vẫn cần được làm rõ. Cả hai bản ghi đã tạo đều được xóa thành công.
Các kiểm thử cục bộ được soạn thảo trong lần chạy bài viết này, độc lập với ba công cụ thương mại. Cả 5 kiểm thử trực tiếp đều được giữ lại; không có cái nào bị xóa hoặc có kỳ vọng bị nới lỏng sau khi thực thi. Thời gian xem xét của con người không được đo lường. Thư mục bằng chứng chứa các tệp kiểm thử, khóa phụ thuộc, phản hồi thô, và hướng dẫn tái tạo.
Cách xác thực công cụ AI để kiểm thử API
Một assertion hữu ích nên từ chối một câu trả lời sai có liên quan. Bạn có thể kiểm thử thuộc tính đó mà không thay đổi dịch vụ đang chạy: lưu một phản hồi thành công thực, sao chép nó, và cố ý sửa đổi từng trường một. Đây là đột biến phản hồi có kiểm soát (controlled response mutations), không phải lỗ hổng sản xuất hay một đánh giá đột biến kiểm thử đầy đủ.
Giữ trạng thái và phần thân gốc cùng nhau. Đầu tiên chạy validator trên phản hồi chưa sửa đổi và xác minh rằng nó chấp nhận baseline. Sau đó tạo ba bản sao độc lập. Thay đổi ID, thay đổi kiểu của name, và xóa name bắt buộc. Mỗi bản sao nên thất bại vì một lý do khớp với thay đổi.
| Baseline đã lưu | Sửa đổi có kiểm soát | Kiểm tra liên quan | Kết quả thực tế |
|---|---|---|---|
| Tra cứu thành công thú cưng hiện tại | Thay thế bằng ID số nguyên khác; giữ trạng thái 200 | ID được trả về bằng ID mong đợi của lần chạy này | Thất bại: ID mong đợi và thực tế khác nhau |
name kiểu chuỗi | Thay thế name bằng một số | Kiểu chuỗi của lược đồ Pet | Thất bại: 42 không phải là chuỗi |
name bắt buộc có mặt | Xóa name | Danh sách bắt buộc của lược đồ Pet | Thất bại: name là bắt buộc |
Ví dụ ID phơi bày một điểm yếu phổ biến. Một validator lược đồ có thể chấp nhận số nguyên sai vì hình dạng vẫn hợp lệ. Assertion mối quan hệ cung cấp ràng buộc còn thiếu. Trong hai ví dụ còn lại, xác thực lược đồ cung cấp các ràng buộc mà kiểm tra chỉ dựa trên trạng thái không thể thấy.
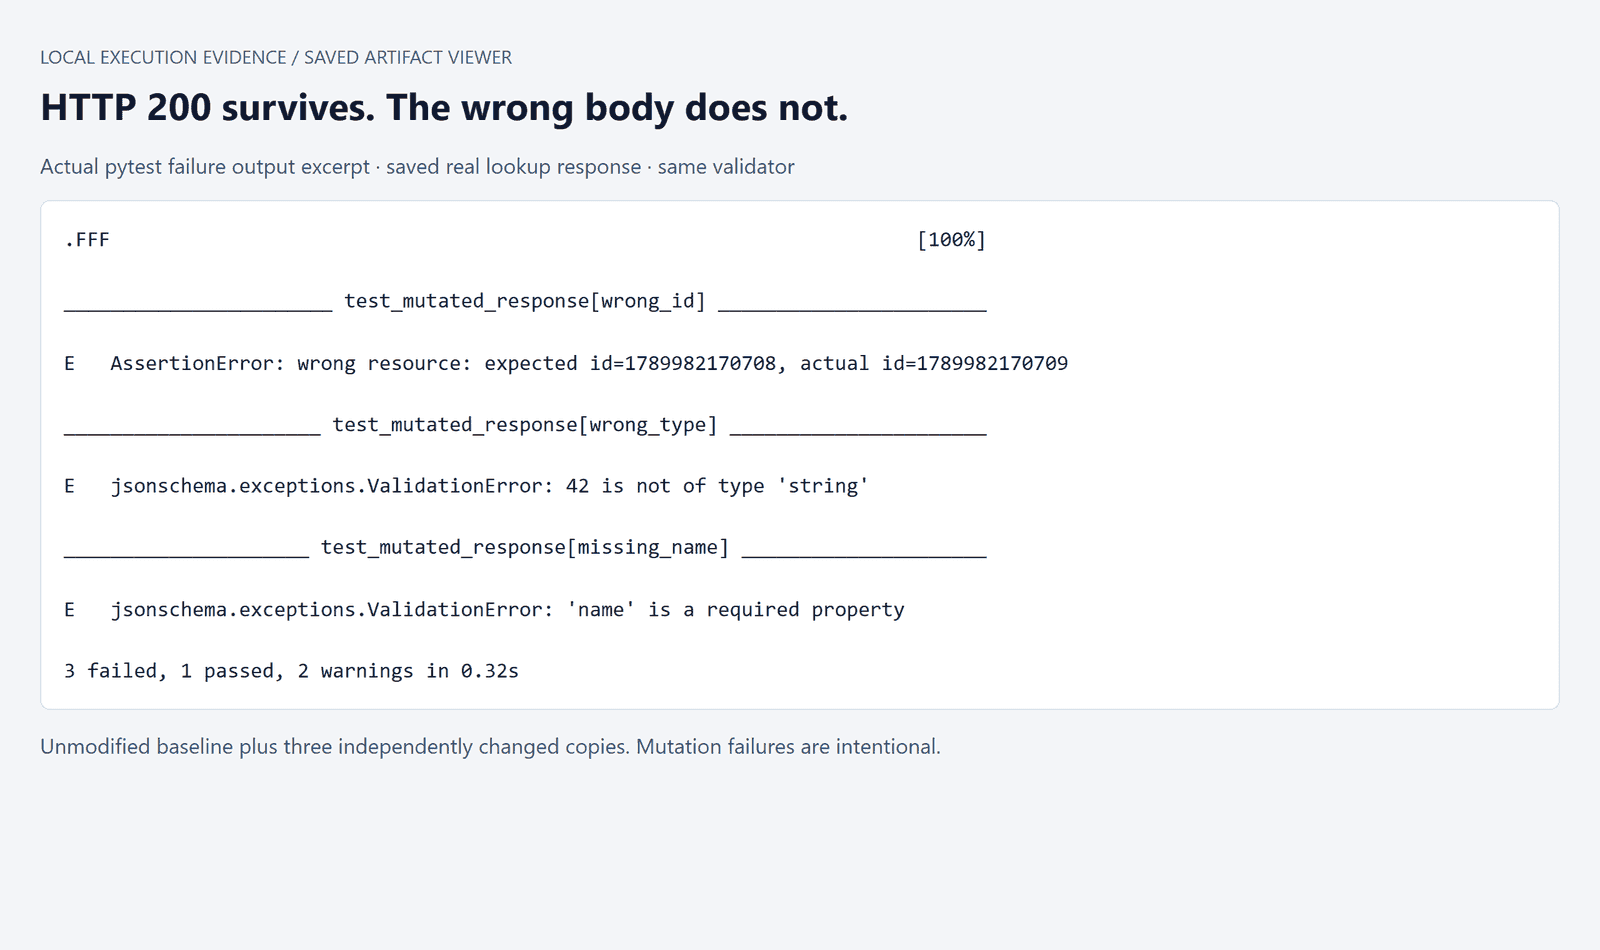 Đầu ra lỗi assertion thực tế cho các đột biến phản hồi Petstore có kiểm soát
Các đoạn trích lỗi pytest thực tế: phản hồi gốc đã pass, và cả 3 đột biến độc lập đều thất bại. Những thất bại này được cố ý tạo ra trong các bản sao đã lưu.
Trong lần chạy này, baseline không thay đổi đã pass và 3 trên 3 bản sao đã sửa đổi đều thất bại. Lần chạy đột biến trả về mã thoát 1, giữ lại tín hiệu thất bại. Validator áp dụng các ràng buộc cấu trúc liên quan của lược đồ Pet và một kiểm tra mối quan hệ ID riêng; minh họa nhỏ này không phải là một validator tuân thủ OpenAPI hoàn chỉnh.
Để có một đánh giá có thể lặp lại, hãy đính kèm tệp kiểm thử và đặc tả đã được ghim vào Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Xem xét các thay đổi “tự chữa lành” (self-healing) được đề xuất với sự cẩn trọng đặc biệt. Thay thế 400 mong đợi bằng 200 có thể che giấu một hồi quy. Một thay đổi hợp đồng hợp pháp cần một tham chiếu yêu cầu và một thay đổi kiểm thử đã được xem xét. Phản hồi quan sát được là bằng chứng để điều tra, không phải sự cho phép tự động để định nghĩa lại tính đúng đắn.
Tách biệt các loại lỗi trước khi yêu cầu AI sửa. Một timeout có thể chỉ ra môi trường không khả dụng. Một lỗi tra cứu có thể đến từ một fixture bị hỏng. Một lỗi import thuộc về mã kiểm thử. Một sự không khớp có thể tái tạo với hợp đồng đã thống nhất có thể thuộc về sản phẩm. Giữ đủ ngữ cảnh để phân biệt chúng.
Báo cáo mẫu số một cách trung thực. Phát hiện ba thay đổi phản hồi được chọn chứng minh độ nhạy với ba thay đổi đó. Nó không thiết lập độ bao phủ endpoint, độ bao phủ mã, độ bao phủ bảo mật, hoặc tỷ lệ phát hiện lỗi tổng quát. Tương tự, một số lượng kiểm thử lớn ít nói lên điều gì về các kịch bản trùng lặp hoặc độ mạnh của các assertion của chúng.
Xác thực và phân quyền xứng đáng có các kiểm thử độc lập trong một ứng dụng phù hợp: thiếu thông tin xác thực, thông tin xác thực hết hạn, và truy cập tài nguyên của người dùng khác. Hành vi minh họa của Petstore không thể chứng minh rằng các kiểm soát truy cập sản xuất của bạn hoạt động.
Công cụ AI để kiểm thử API trong CI/CD
Khi người đánh giá chấp nhận bộ kiểm thử, hãy commit đúng phiên bản đó. Một bản dựng nên thực thi các kỳ vọng đã biết đối với ứng dụng ứng viên. Tạo lại kiểm thử trong mỗi bản dựng tạo thêm một thành phần thay đổi và khiến lỗi khó tái tạo hơn.
Ghim runner, các phụ thuộc, fixture, và đặc tả. Lưu một khóa phụ thuộc cùng với các kiểm thử và giữ lại bản sửa đổi ứng dụng trong báo cáo. Giải quyết bí mật từ môi trường CI, giữ chúng khỏi các tệp được tạo, và kiểm tra rằng nhật ký lỗi không làm lộ chúng.
Với pytest, dạng báo cáo cơ bản rất đơn giản:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Cung cấp BASE_URL thông qua môi trường công việc (job environment). Khởi động dịch vụ cục bộ trong vòng đời công việc, chờ sẵn sàng, sau đó chạy bộ kiểm thử. Luôn thu thập báo cáo và nhật ký dịch vụ, ngay cả khi thất bại. Kết thúc bằng cách dừng dịch vụ của chính công việc và dọn dẹp dữ liệu của nó; tránh các lệnh dọn dẹp toàn bộ tiến trình trên các agent dùng chung.
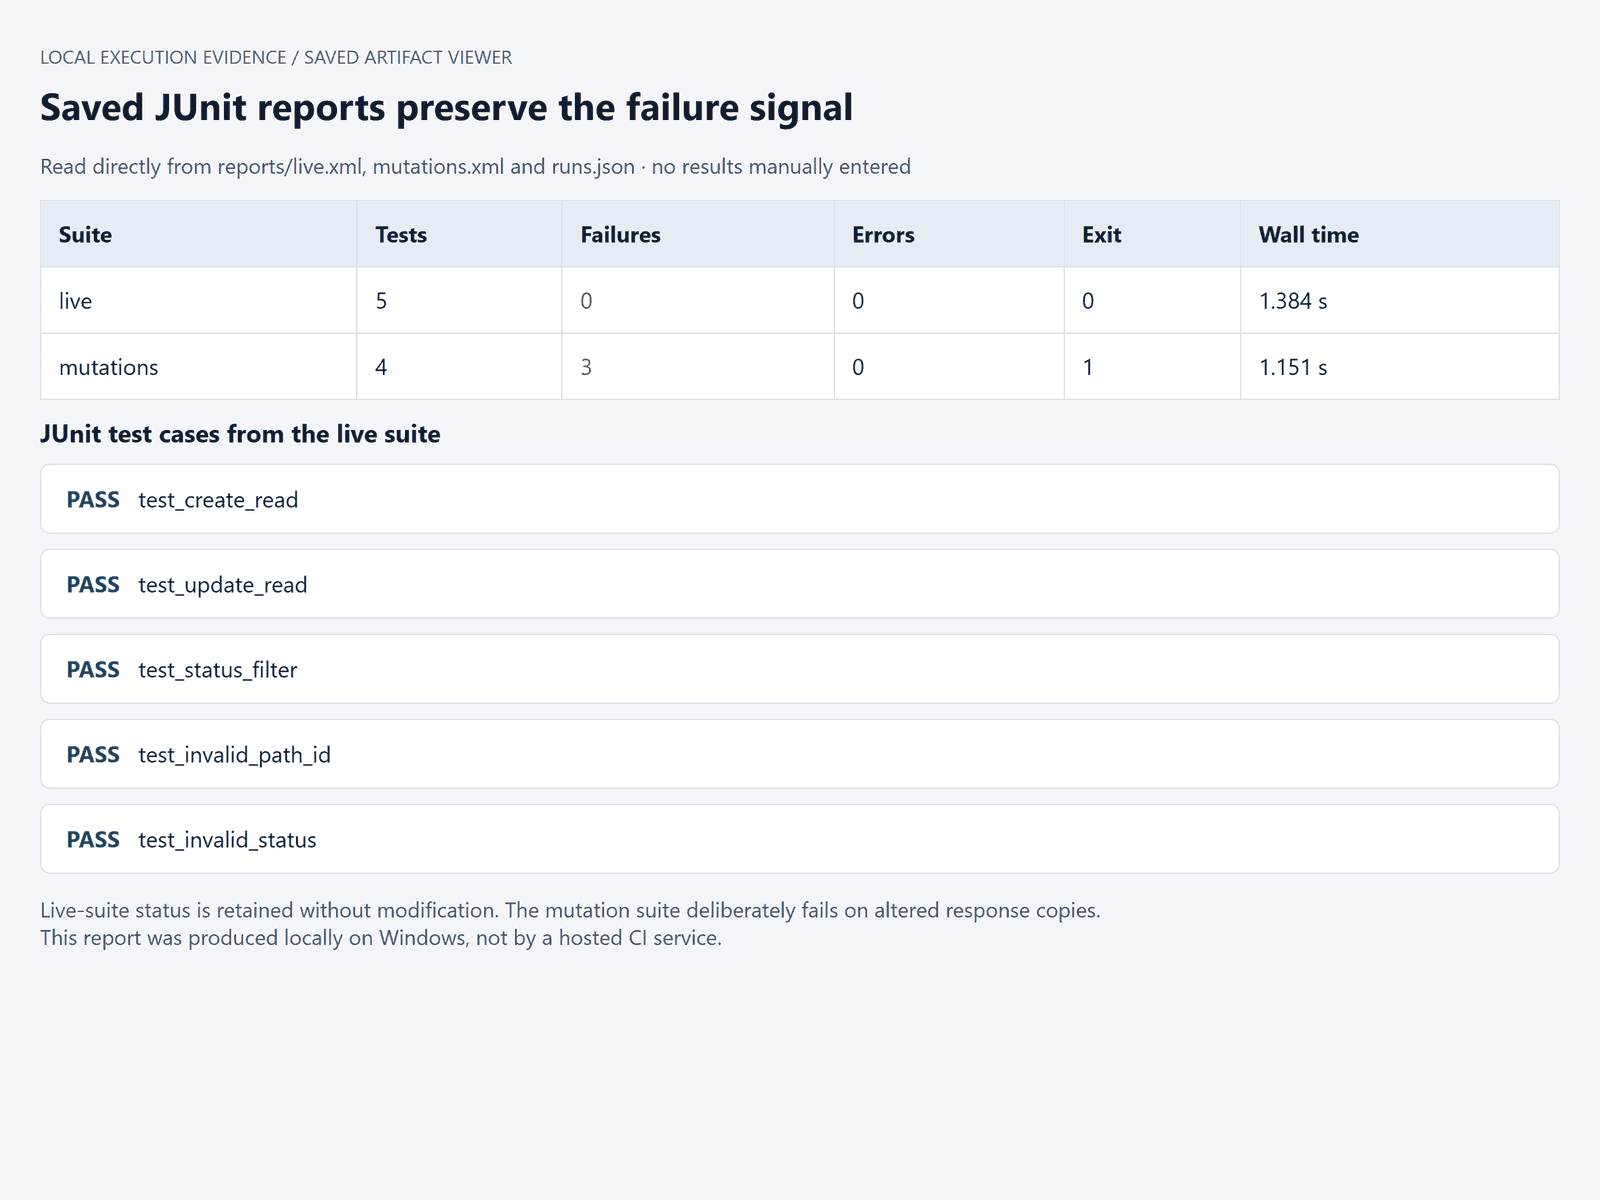 Báo cáo JUnit pytest cục bộ với kết quả kiểm tra hợp đồng trực tiếp và kiểm tra assertion riêng biệtsActual local
Kết quả JUnit: 5 kiểm thử trực tiếp đã pass; bộ kiểm thử bản sao có kiểm soát chứa 1 baseline pass và 3 thất bại có chủ đích. Không có lần chạy CI được lưu trữ nào được tuyên bố.
Thời gian thực đo (wall times), bao gồm khởi động tiến trình Python, là 1.384 giây cho bộ kiểm thử trực tiếp và 1.151 giây cho bộ kiểm thử bản sao có kiểm soát. Những con số này loại trừ việc build/khởi động dịch vụ, cài đặt phụ thuộc, soạn thảo, và xem xét. Các tệp JUnit và nhật ký không rút gọn được lưu riêng.
Kiểm thử đường dẫn thất bại trước khi dựa vào cổng (gate). Một assertion thất bại phải tạo ra mã thoát công việc thất bại. Các lần thử lại nên có giới hạn và được biện minh cho các sự cố hạ tầng tạm thời đã biết; việc thử lại lặp đi lặp lại cuối cùng che giấu lỗi sản phẩm làm cho cổng ít thông tin hơn.
Xử lý các lỗi dọn dẹp một cách rõ ràng. Giữ lỗi assertion chính hiển thị, ghi lại tài nguyên nào còn lại, và để teardown báo cáo vấn đề của riêng nó. Các công việc song song cần định danh hoặc không gian tên riêng. Một kiểm thử pass khi chạy một mình nhưng đọc dữ liệu của công việc khác chưa sẵn sàng để sử dụng không giám sát.
Nếu bạn đã có pytest, bạn có thể chọn mô hình soạn thảo riêng. Atlas Cloud phù hợp với vai trò hẹp hơn này: một lớp mô hình cho quy trình tùy chỉnh mà việc thực thi và báo cáo đã tồn tại. Nó không được trình bày ở đây như một nền tảng kiểm thử API đầy đủ hoặc một backend gốc cho ba sản phẩm trên.
Để đánh giá đó, hãy mở DeepSeek V4.1 Flash, model ID deepseek-ai/deepseek-v4.1-flash, và cung cấp cùng đặc tả công khai và ma trận đã được xem xét được sử dụng cục bộ. Sử dụng Prompt B, sau đó lưu bản nháp được trả về riêng biệt với kiểm thử đã được xem xét. So sánh các giả định của nó với hợp đồng trước khi thực thi bất cứ điều gì.
Nếu được giao diện hiển thị, temperature 0.2 là một cài đặt khởi đầu cho việc soạn thảo, không phải đảm bảo tính xác định. Kiểm tra giới hạn đầu ra có sẵn so với kích thước bộ kiểm thử của bạn. Tham khảo danh mục mô hình hiện tại để biết giá token thay vì lập ngân sách từ một bài viết cũ.
Sự phân chia công việc vẫn rõ ràng: mô hình đề xuất mã, người đánh giá phê duyệt kỳ vọng, và runner tạo ra kết quả. Cổng truy cập môi trường kiểm thử đã ngăn một lần chạy Atlas hoàn chỉnh cho bài viết này, vì vậy đây là một công thức đánh giá chứ không phải kết quả mô hình được đo lường. Bạn có thể đánh giá lộ trình này mà không cần di chuyển một runner kiểm thử đang hoạt động hoặc giao trách nhiệm thực thi của nó cho một mô hình chat.
Chọn công cụ AI để kiểm thử API cho nhóm của bạn
Chọn đánh giá nhỏ nhất có thể thay đổi quyết định của bạn. Sử dụng một quy trình được kết nối, một trường hợp phủ định đã được tài liệu hóa, và một vài phản hồi sai có kiểm soát. Giữ các đầu vào tương đương giữa các ứng viên. Một trải nghiệm onboarding chỉn chu không nên lớn hơn một kiểm thử không thể nhận diện tài nguyên sai.
Đối với một quy trình collection trưởng thành, hãy bắt đầu bằng cách đánh giá các tính năng AI trong workspace đó. Cấu hình môi trường hiện có và các phụ thuộc yêu cầu là ngữ cảnh có giá trị. Đo lường xem các thay đổi được tạo có tiết kiệm công sức xem xét mà không đưa vào các giả định mong manh hay không.
Đối với một nhóm có đặc tả vững chắc và tồn đọng công việc viết, hãy đánh giá tạo dựa trên đặc tả. Chú ý đến điều gì xảy ra khi đặc tả không đầy đủ. Một generator đánh dấu rõ ràng các kỳ vọng còn thiếu dễ xem xét hơn một generator tự tin bịa ra chúng.
Đối với một ứng dụng có lỗi phụ thuộc vào hành vi thượng nguồn, hãy đánh giá ghi và phát lại. Kiểm tra các baseline đã ghi và hỗ trợ phụ thuộc trước khi đầu tư vào các bản ghi lớn. Quyết định trường động nào có thể thay đổi và mối quan hệ nào phải giữ nguyên.
Đối với một nhóm có runner ổn định, hãy đánh giá một mô hình độc lập để soạn thảo và xem xét. Bạn giữ định dạng thực thi bạn đã biết, nhưng bạn cũng sở hữu việc tích hợp, thiết kế fixture, và bảo trì. Bao gồm quyền sở hữu đó trong tính toán chi phí.
Trước khi trả tiền cho công cụ AI để kiểm thử API, hãy yêu cầu năm minh chứng cụ thể:
- Bộ kiểm thử đã được xem xét chạy trên môi trường dự định của bạn.
- Các lỗi có kiểm soát liên quan làm cho các assertion thích hợp thất bại.
- Các kiểm thử và báo cáo hữu ích có thể được giữ lại ở định dạng chấp nhận được.
- Các lần chạy lặp lại, bao gồm thực thi CI, giữ được sự cô lập và tín hiệu thất bại.
- Chi phí tạo, thực thi, và bảo trì phù hợp với ngân sách của nhóm.
Chỉ định một người bảo trì bộ kiểm thử đã được chấp nhận. Một thay đổi đặc tả nên kích hoạt việc xem xét các assertion, fixture, và người tiêu thụ (consumers) bị ảnh hưởng. Giữ bằng chứng lỗi cũ cho đến khi thay đổi được hiểu rõ. Điều đó làm cho bản phát hành tiếp theo dễ đánh giá hơn và cho nhóm một lý do để tin tưởng một báo cáo xanh.
Câu hỏi thường gặp
Tôi nên sử dụng công cụ AI nào để kiểm thử API?
Bắt đầu với các đầu vào hiện có của bạn. Đánh giá Postman Agent Mode cho các collection đã được thiết lập, KushoAI cho tạo dẫn dắt bởi đặc tả, và Keploy cho các lộ trình tạo luồng và ghi riêng biệt của nó. Nếu nhóm của bạn đã duy trì pytest hoặc một runner khác, một mô hình soạn thảo riêng có thể phù hợp. Sử dụng cùng một quy trình nhỏ để đánh giá assertion, thực thi, và công sức xem xét của từng ứng viên.
Có công cụ AI miễn phí để kiểm thử API không?
Có các client miễn phí, công cụ kiểm thử mã nguồn mở, và hạn mức AI giới hạn. Chúng đáp ứng các nhu cầu khác nhau. Gói Free của Postman liệt kê 50 AI credits hàng tháng tính đến ngày 21 tháng 9, 2026; đó không phải là số lượng kiểm thử. Kiểm tra xem các tính năng xuất, tự động hóa, báo cáo, và cộng tác bạn cần có được bao gồm hay không trước khi coi một bản dùng thử tương tác là giải pháp CI miễn phí.
AI có thể tạo kiểm thử API từ đặc tả OpenAPI không?
Có, một generator có thể sử dụng các thao tác, lược đồ, tham số, và định nghĩa phản hồi để đề xuất kiểm thử. Đặc tả vẫn có thể bỏ sót các quy tắc nghiệp vụ hoặc để lại ánh xạ lỗi mơ hồ. Cung cấp các kỳ vọng đã được phê duyệt và xem xét kết quả. Trong ví dụ Petstore đã được ghim, một thao tác tạo thành công được tài liệu hóa là 200, minh họa tại sao các quy ước REST quen thuộc không thể thay thế hợp đồng thực tế.
Làm sao tôi biết các assertion do AI tạo có hữu ích không?
Kiểm tra ba điều: các ràng buộc lược đồ đã được tài liệu hóa, mối quan hệ giữa yêu cầu và phản hồi, và độ nhạy với dữ liệu cố ý không chính xác. Lưu một phản hồi thực, sửa đổi một thuộc tính liên quan, và chạy lại cùng validator. Giữ thông báo lỗi. Điều này cung cấp bằng chứng hẹp, có thể tái tạo về các assertion đó trong khi để lại các câu hỏi về độ bao phủ rộng hơn và bảo mật cho việc kiểm thử riêng.
Tôi có thể chạy kiểm thử API do AI tạo trong CI/CD không?
Có, khi định dạng được tạo, runner, môi trường, và gói hỗ trợ lộ trình đó. Commit các kiểm thử đã được xem xét, cài đặt các phụ thuộc đã được ghim, sử dụng fixture cô lập, và xuất một báo cáo có cấu trúc như JUnit. Xác minh rằng các thất bại trả về mã thoát khác không. Một lần chạy cục bộ thành công chuẩn bị bộ kiểm thử cho CI; nó không chứng minh rằng một pipeline được lưu trữ đã chạy.
AI có thể thay thế kiểm thử API thủ công không?
AI có thể giảm việc soạn thảo lặp đi lặp lại và giúp người đánh giá tìm ra các assertion yếu. Con người vẫn quyết định hành vi dự định, điều tra các lỗi mơ hồ, và khám phá các rủi ro nằm ngoài các ví dụ được cung cấp. Sử dụng công cụ AI để kiểm thử API để tạo ra các tài sản kiểm thử có thể xem xét, sau đó đánh giá chúng bằng bằng chứng có thể tái tạo. Một bộ kiểm thử nhỏ hơn nhưng bắt được những sai lầm có ý nghĩa dễ tin cậy hơn một tập hợp các kiểm tra xanh không được giải thích.


