Hai nhóm có thể báo cáo hàng trăm token mỗi giây cho DeepSeek V4.1 Flash và vẫn đang đo những thứ khác nhau. Một bên có thể muốn nói tốc độ giải mã cho một yêu cầu; bên khác có thể muốn nói đầu ra tổng hợp trên hàng chục yêu cầu đồng thời. Để cải thiện tối ưu hóa thông lượng suy luận DeepSeek V4.1 Flash, trước tiên hãy chọn chỉ số dịch vụ của bạn cần, sau đó benchmark tổ hợp yêu cầu của chính bạn, thay đổi từng biến phục vụ một, và xác minh độ trễ, chất lượng và chi phí cùng nhau. Dòng mô hình hiện bao gồm bản cập nhật Flash-1017 ngày 17 tháng 10, vì vậy hãy ghi lại checkpoint chính xác trước khi so sánh kết quả. Các báo cáo công khai cho thấy những đường tối ưu hữu ích, nhưng không có báo cáo nào thay thế được một bài kiểm thử tương thích trên phần cứng của bạn.
Điểm chính
- Token đầu ra tổng hợp/giây đo dung lượng trên các yêu cầu; tốc độ giải mã mỗi yêu cầu đo trải nghiệm của một người dùng.
- Tái tạo độ dài prompt, giới hạn đầu ra, mức đồng thời, trạng thái nóng và mục tiêu độ trễ của bạn trước khi tinh chỉnh.
- KV cache nén và replay có giới hạn của V4.1 Flash giảm áp lực bộ nhớ, nhưng không đảm bảo tăng tốc đầu-cuối cố định.
- Chỉ so sánh vLLM và SGLang trong cùng điều kiện mô hình, phần cứng, khối lượng công việc và đo lường.
Thông lượng có nghĩa là gì đối với DeepSeek V4.1 Flash?
Thông lượng là một tốc độ, nhưng tử số và ranh giới bài kiểm thử đều quan trọng. Đối với một dịch vụ suy luận, hãy ghi lại ít nhất năm phép đo:
| Chỉ số | Điều nó cho bạn biết | Cách dùng điển hình |
|---|---|---|
| Token đầu ra tổng hợp/giây | Token đầu ra được tạo bởi tất cả yêu cầu đang hoạt động mỗi giây | Lập kế hoạch dung lượng và hiệu quả cụm máy chủ |
| Token giải mã mỗi yêu cầu/giây | Tốc độ tạo được trải nghiệm bởi một yêu cầu riêng lẻ | Độ phản hồi tương tác trong khi tạo |
| Token prefill/giây | Token đầu vào được xử lý mỗi giây | Prompt dài và khối lượng công việc nặng truy xuất |
| Thời gian đến token đầu tiên (TTFT) | Thời gian từ khi yêu cầu đến đến token đầu ra đầu tiên | Độ trễ khởi động được cảm nhận |
| Độ trễ đầu-cuối, p50/p95 | Tổng thời lượng yêu cầu trên phân bố lưu lượng | Mục tiêu cấp dịch vụ và hành vi đuôi |
Một máy chủ có thể tăng thông lượng tổng hợp bằng cách batch nhiều chuỗi hơn trong khi khiến mỗi người dùng chờ lâu hơn giữa các token. Ngược lại, một thiết lập được tinh chỉnh cho mức đồng thời thấp có thể mang lại phản hồi riêng lẻ nhanh nhạy nhưng để accelerator bị sử dụng dưới mức. Không kết quả nào tốt hơn một cách phổ quát. Mục tiêu đúng là một điểm trên đường cong thông lượng-độ trễ đáp ứng mục tiêu cấp dịch vụ của sản phẩm bạn.
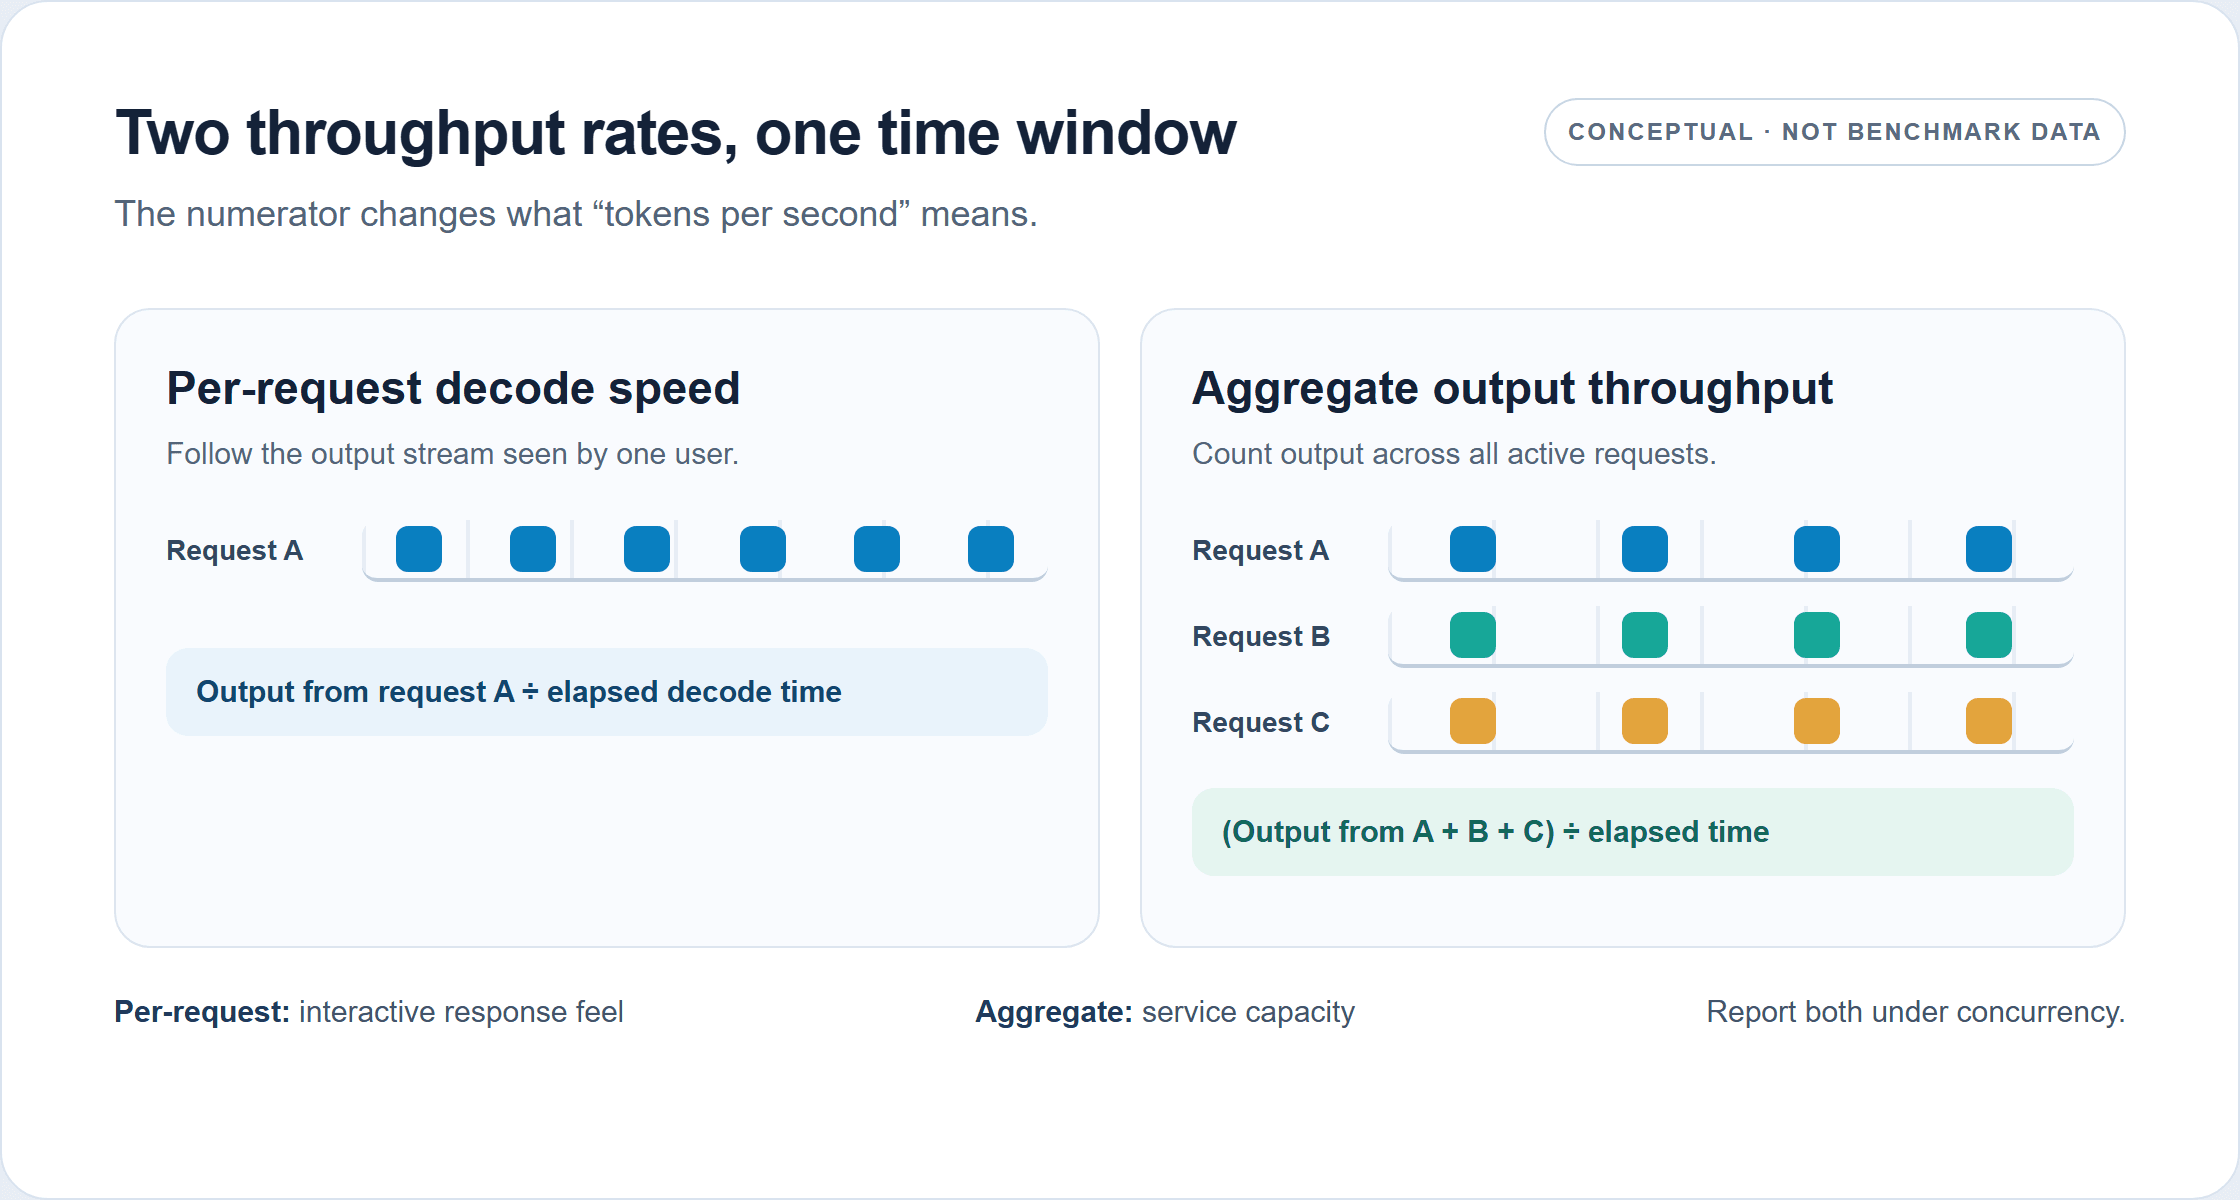
Hai tốc độ này đếm các luồng đầu ra khác nhau. Đây là sơ đồ khái niệm, không phải hiệu năng DeepSeek V4.1 Flash được đo.
Hãy nêu rõ thông lượng có bao gồm prefill, decode hay cả hai. Nêu rõ bạn có chia cho số lượng GPU hay không. Báo cáo token đầu ra thành công thay vì token tối đa được yêu cầu, và công bố các trường hợp hủy hoặc lỗi. Nếu thiếu những chi tiết đó, con số token/giây không thể cho người vận hành biết liệu nó có dự đoán được ứng dụng của họ hay không.
Xây dựng baseline DeepSeek V4.1 Flash có thể tái tạo
Một baseline hữu ích mô phỏng lưu lượng production đủ sát để phơi bày điểm nghẽn của nó. Một prompt ngắn duy nhất là đại diện kém cho một agent liên tục gửi lịch sử hội thoại lớn, và đầu ra cố định 1.024 token bỏ sót các khối lượng công việc dừng sớm hoặc thay đổi rộng.
Cố định khối lượng công việc và cửa sổ đo lường
Tạo các nhóm yêu cầu từ lưu lượng quan sát được. Với mỗi nhóm, giữ nguyên độ dài đầu vào gần đúng, độ dài đầu ra mong đợi, mẫu đến và mọi prefix dùng chung. Bao gồm các lượt tool hoặc reasoning nếu chúng là một phần của đường đi yêu cầu thực tế. Giữ prompt, cài đặt sampling, điều kiện dừng và giới hạn đầu ra cố định giữa các lần chạy.
Chạy cả trường hợp đồng thời thấp và mức đồng thời dịch vụ của bạn dự kiến ở đỉnh. Sau đó thêm các mức đồng thời trung gian để thấy nơi thông lượng ngừng tăng hoặc độ trễ vượt giới hạn. Dùng một cửa sổ đo ổn định sau warm-up, lặp lại từng điểm và báo cáo trung vị cùng khoảng. Một đợt ngắn có thể đo hành vi khởi động thay vì dung lượng dịch vụ ổn định.
Tách các phép đo khởi động nguội khỏi phục vụ nóng. Lần chạy nguội bao gồm tải mô hình, graph capture hoặc nạp cache tùy theo stack; lần chạy nóng mô tả một hệ thống đã sẵn sàng phục vụ. Với khối lượng công việc có prefix caching, đo lưu lượng cache-hit và cache-miss riêng. Đừng gộp chúng thành một giá trị trung bình trừ khi tổ hợp khớp với production.
Lưu hồ sơ benchmark
Lưu một hàng cho mỗi lần chạy với các trường sau: checkpoint hoặc bản sửa đổi mô hình; runtime và commit; mẫu GPU và số lượng; interconnect; độ chính xác và lượng tử hóa; bố trí song song tensor, expert hoặc pipeline; phân bố token đầu vào và đầu ra; mức đồng thời và mẫu đến yêu cầu; trạng thái nóng hoặc nguội; thời lượng chạy; tỷ lệ thành công; thông lượng tổng hợp; tốc độ giải mã mỗi yêu cầu; TTFT; và độ trễ đầu-cuối p50/p95.
Hồ sơ này hữu ích hơn một con số trên bảng xếp hạng vì nó giúp thí nghiệm tiếp theo có thể tái tạo. Đóng băng nó trước khi tinh chỉnh. Nếu khối lượng công việc hoặc checkpoint thay đổi, hãy bắt đầu baseline mới thay vì quy khác biệt cho một cờ phục vụ.
Chẩn đoán Prefill, Decode, KV Cache hoặc Scheduling
Dùng triệu chứng để chọn phép đo tiếp theo, không phải để đoán cách khắc phục. TTFT cao với tốc độ giải mã chấp nhận được chỉ về xử lý đầu vào, xếp hàng, cache miss hoặc chi phí khởi động. Giải mã chậm ở mức đồng thời thấp gợi ý cần xem xét kernel, băng thông bộ nhớ, giao tiếp song song và đường thực thi của mô hình. Thông lượng tổng hợp đi ngang khi mức đồng thời tăng có thể chỉ ra áp lực bộ nhớ, giới hạn scheduler, chi phí giao tiếp hoặc đường tính toán bão hòa. Suy giảm ngữ cảnh dài đòi hỏi đo mức trú ngụ của cache, công việc prefill và di chuyển host-to-device.
| Quan sát | Kiểm tra đầu tiên |
|---|---|
| TTFT tăng theo độ dài prompt | Tốc độ prefill, thời gian xếp hàng, tỷ lệ hit prefix-cache, warm-up graph hoặc biên dịch |
| Tốc độ giải mã thấp ngay cả ở mức đồng thời 1 | Đường mô hình runtime, hỗ trợ kernel, độ chính xác, mức sử dụng GPU, chi phí giao tiếp |
| Token tổng hợp/giây đi ngang khi mức đồng thời tăng | Dung lượng KV-cache, batch hóa của scheduler, băng thông bộ nhớ, cấu trúc liên kết song song |
| Độ trễ p95 tăng mạnh trong khi đầu ra tổng hợp cải thiện | Kích thước batch, chính sách xếp hàng, tổ hợp độ dài yêu cầu, mục tiêu cấp dịch vụ |
| Prompt dài đẩy các yêu cầu đang hoạt động hữu ích ra khỏi cache | Mức trú ngụ KV-cache, cấp phát cache, phân bố ngữ cảnh, lưu lượng bộ nhớ host |
V4.1 Flash có các đặc điểm kiến trúc nhằm giảm bớt một số áp lực này. Báo cáo mô hình mô tả CSA2 với tái sử dụng cache xuyên lớp và cache KV toàn cục FP4, cho dấu chân KV toàn cục được báo cáo là 890 byte mỗi token, khoảng một phần tư dấu chân tương ứng của V4-Flash. SWA Bounded Replay giải quyết một đánh đổi lưu trữ khác: thay vì lưu trạng thái attention cửa sổ trượt, một triển khai có thể tái tạo trạng thái bị thiếu bằng cách replay cửa sổ gần đây. DeepSeek báo cáo KV cache liên tục gần một phần tám dấu chân của V4-Flash cho thiết kế này, với một lượng nhỏ tính toán lại prefill bổ sung. Đây là kết quả kiến trúc và triển khai, không phải lời hứa tăng thông lượng gấp tám lần. (báo cáo kỹ thuật DeepSeek, tháng 9 năm 2026)
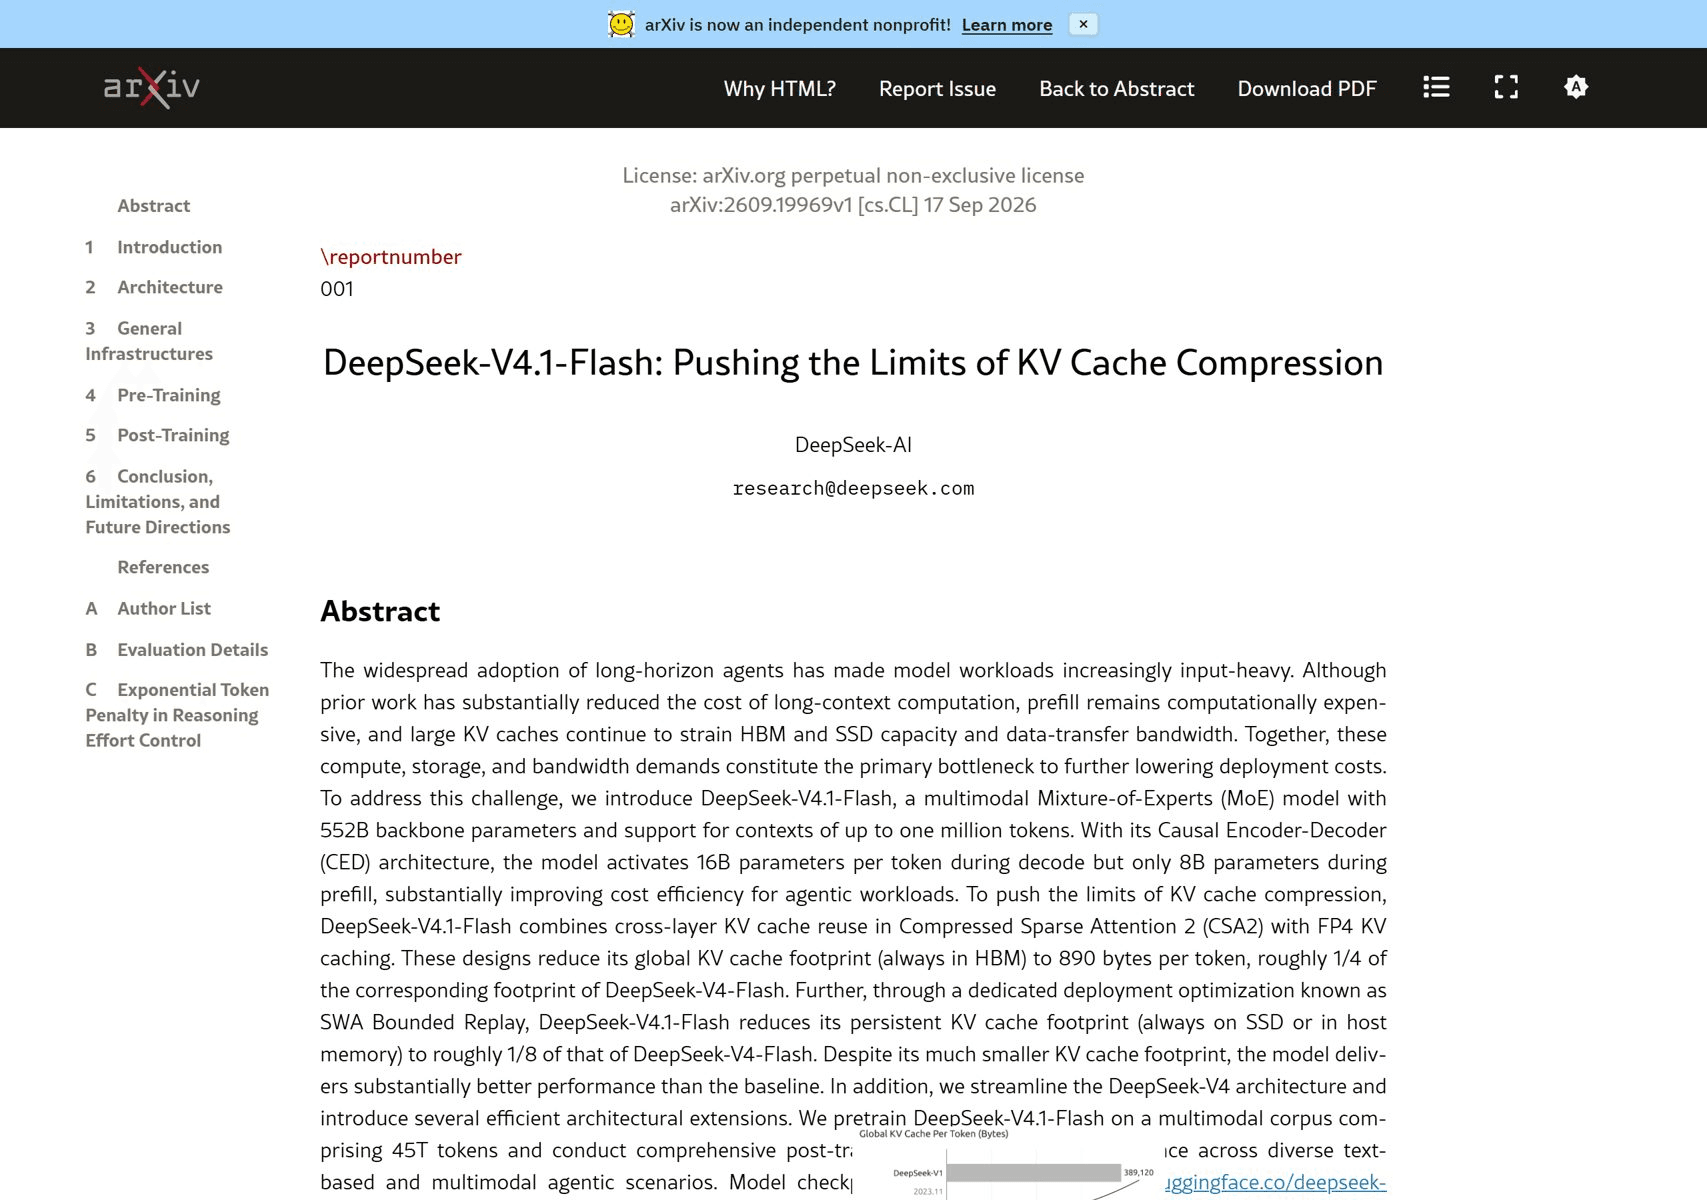
Hình nguồn mô tả dung lượng cache, không phải hệ số nhân thông lượng đầu-cuối cho mọi triển khai.
Khi chẩn đoán chưa rõ, hãy profile một lần chạy đại diện và kiểm tra thời gian xếp hàng, mức sử dụng GPU, mức dùng bộ nhớ và thời gian từng giai đoạn. Thay đổi một biến, chạy lại cùng khối lượng công việc và kiểm tra tính đúng đắn của đầu ra hoặc chất lượng tác vụ. Điều này giữ cho một tăng tốc bề ngoài không che giấu sự suy giảm trong dịch vụ hoặc câu trả lời.
Tinh chỉnh vLLM hoặc SGLang theo cùng mục tiêu
Chọn runtime có đường mô hình hiện tại hỗ trợ checkpoint và phần cứng bạn định triển khai. Xác minh bản phát hành chính xác, kernel, hành vi graph và bố trí song song. Một mô hình được liệt kê là hỗ trợ không có nghĩa mọi lượng tử hóa hoặc cấu trúc liên kết đều được tối ưu như nhau.
vLLM: xác thực đường mô hình theo bản phát hành
Báo cáo tháng 10 của nhóm vLLM mô tả tiến triển trên benchmark AgentX của họ: cải thiện khoảng 1,9× ở kết quả độ trễ thấp và thông lượng khoảng 5,3× trong ràng buộc 150 TPS so với baseline ngày đầu. Công việc bao gồm SWA bounded replay với CUDA graphs và tích hợp kernel riêng cho mô hình. Hãy coi những giá trị đó là bằng chứng rằng stack đã thay đổi đáng kể theo thời gian dưới benchmark đó, không phải hệ số nhân để áp cho cụm khác. ( báo cáo kỹ thuật vLLM, tháng 10 năm 2026)
Với lần chạy của bạn, trước tiên hãy thiết lập bản phát hành được hỗ trợ và cấu hình đã biết là tốt. Sau đó đo riêng hành vi graph capture hoặc replay, batch hóa và song song. Giữ nguyên ràng buộc độ trễ đã dùng để chọn điểm thông lượng cao hơn. Nếu graph capture thay đổi nhu cầu khởi động hoặc bộ nhớ, hãy đưa các chi phí đó vào quyết định triển khai.
SGLang: khớp cấu hình đồng thời của nó
Báo cáo của nhóm SGLang đưa ra một ví dụ rõ ràng bất thường về lý do bối cảnh kiểm thử quan trọng. Trên 8 GPU H200, lần chạy được tối ưu của họ không có speculative decoding tăng từ khoảng 76 lên 168 token/giây mỗi người dùng ở mức đồng thời một, và từ khoảng 96 lên 221 token đầu ra/giây mỗi GPU ở mức đồng thời 64. Nó dùng đầu vào cố định 8.192 token và đầu ra 1.024 token. Kết quả 4×GB300 riêng của họ dùng độ dài prompt, cài đặt song song và DSpark speculative decoding khác. Do đó báo cáo hỗ trợ việc đánh giá các tối ưu hóa của SGLang trên lưu lượng của bạn, không phải xếp hạng nó trực tiếp với các con số AgentX của vLLM. ( báo cáo tối ưu hóa LMSYS/SGLang, tháng 9 năm 2026)
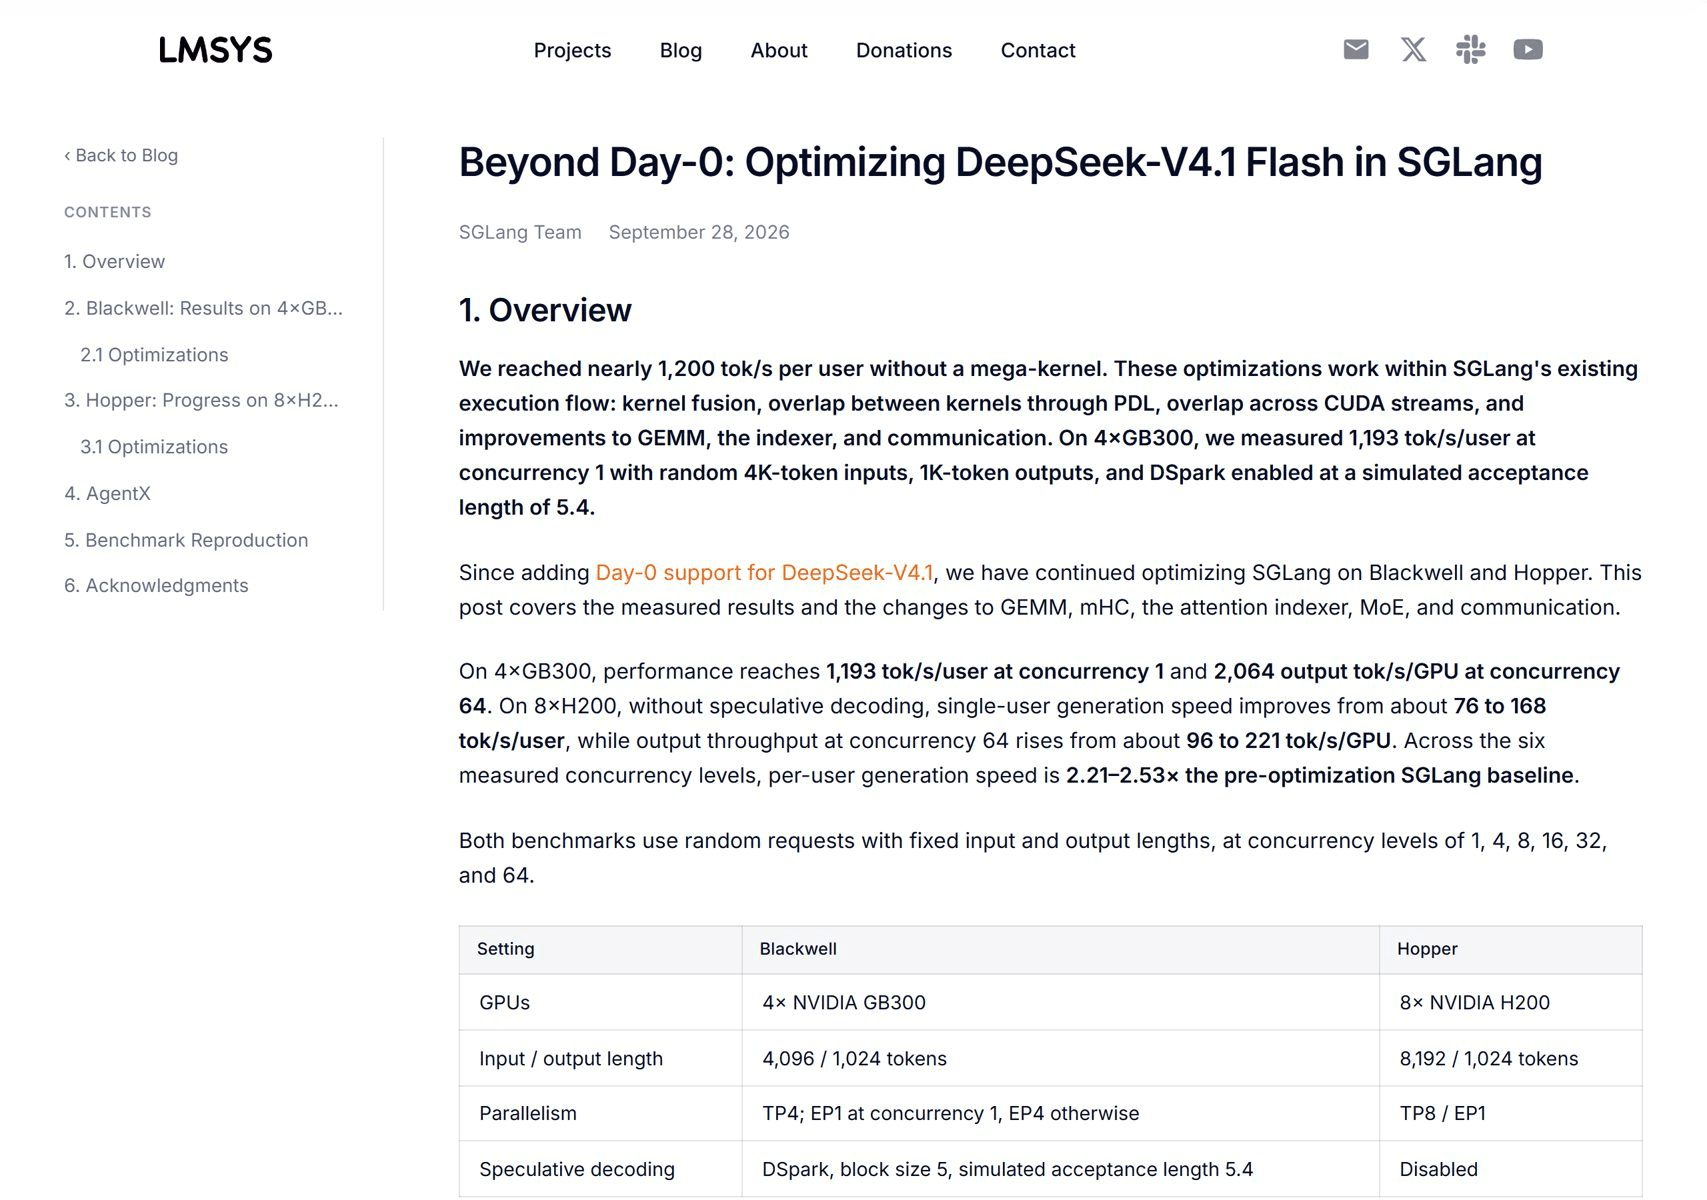
Các báo cáo nguồn dùng khối lượng công việc và phần cứng khác nhau; các con số của họ không nên được đọc như một biểu đồ đối đầu trực tiếp.
Bắt đầu với một runtime và tối ưu đường được hỗ trợ của nó. Chỉ xây dựng so sánh runtime thứ hai nếu bạn có thể giữ cố định checkpoint, phân bổ GPU, phân bố prompt và đầu ra, mức đồng thời, warm-up và mục tiêu cấp dịch vụ. So sánh đó tốn thời gian kỹ thuật, vì vậy trước tiên hãy xác nhận stack hiện tại thực sự là yếu tố giới hạn.
Tối ưu đồng thời và ngữ cảnh dài mà không phá vỡ SLO
Tăng mức đồng thời theo từng bước và ghi lại đầu ra tổng hợp, tốc độ giải mã mỗi yêu cầu, TTFT, độ trễ p95, mức dùng bộ nhớ và lỗi ở mỗi bước. Chỉ giữ điểm thông lượng cao nhất nếu độ trễ và tỷ lệ lỗi của nó vẫn đáp ứng mục tiêu cấp dịch vụ. Nếu yêu cầu xếp hàng trước khi tạo, batch lớn hơn có thể cải thiện mức sử dụng thiết bị nhưng khiến sản phẩm có cảm giác chậm hơn.
Với lưu lượng ngữ cảnh dài, đo phân bố ngữ cảnh đang hoạt động và tỷ lệ hit cache. Cửa sổ ngữ cảnh tối đa được công bố không có nghĩa mọi yêu cầu đều có thể được phục vụ đồng thời ở độ dài đó. KV cache cạnh tranh bộ nhớ với weight, activation, graph pool và buffer runtime. Để dư dung lượng cho độ dài yêu cầu thay đổi và đo việc trục xuất hoặc preemption dưới lưu lượng thực tế.
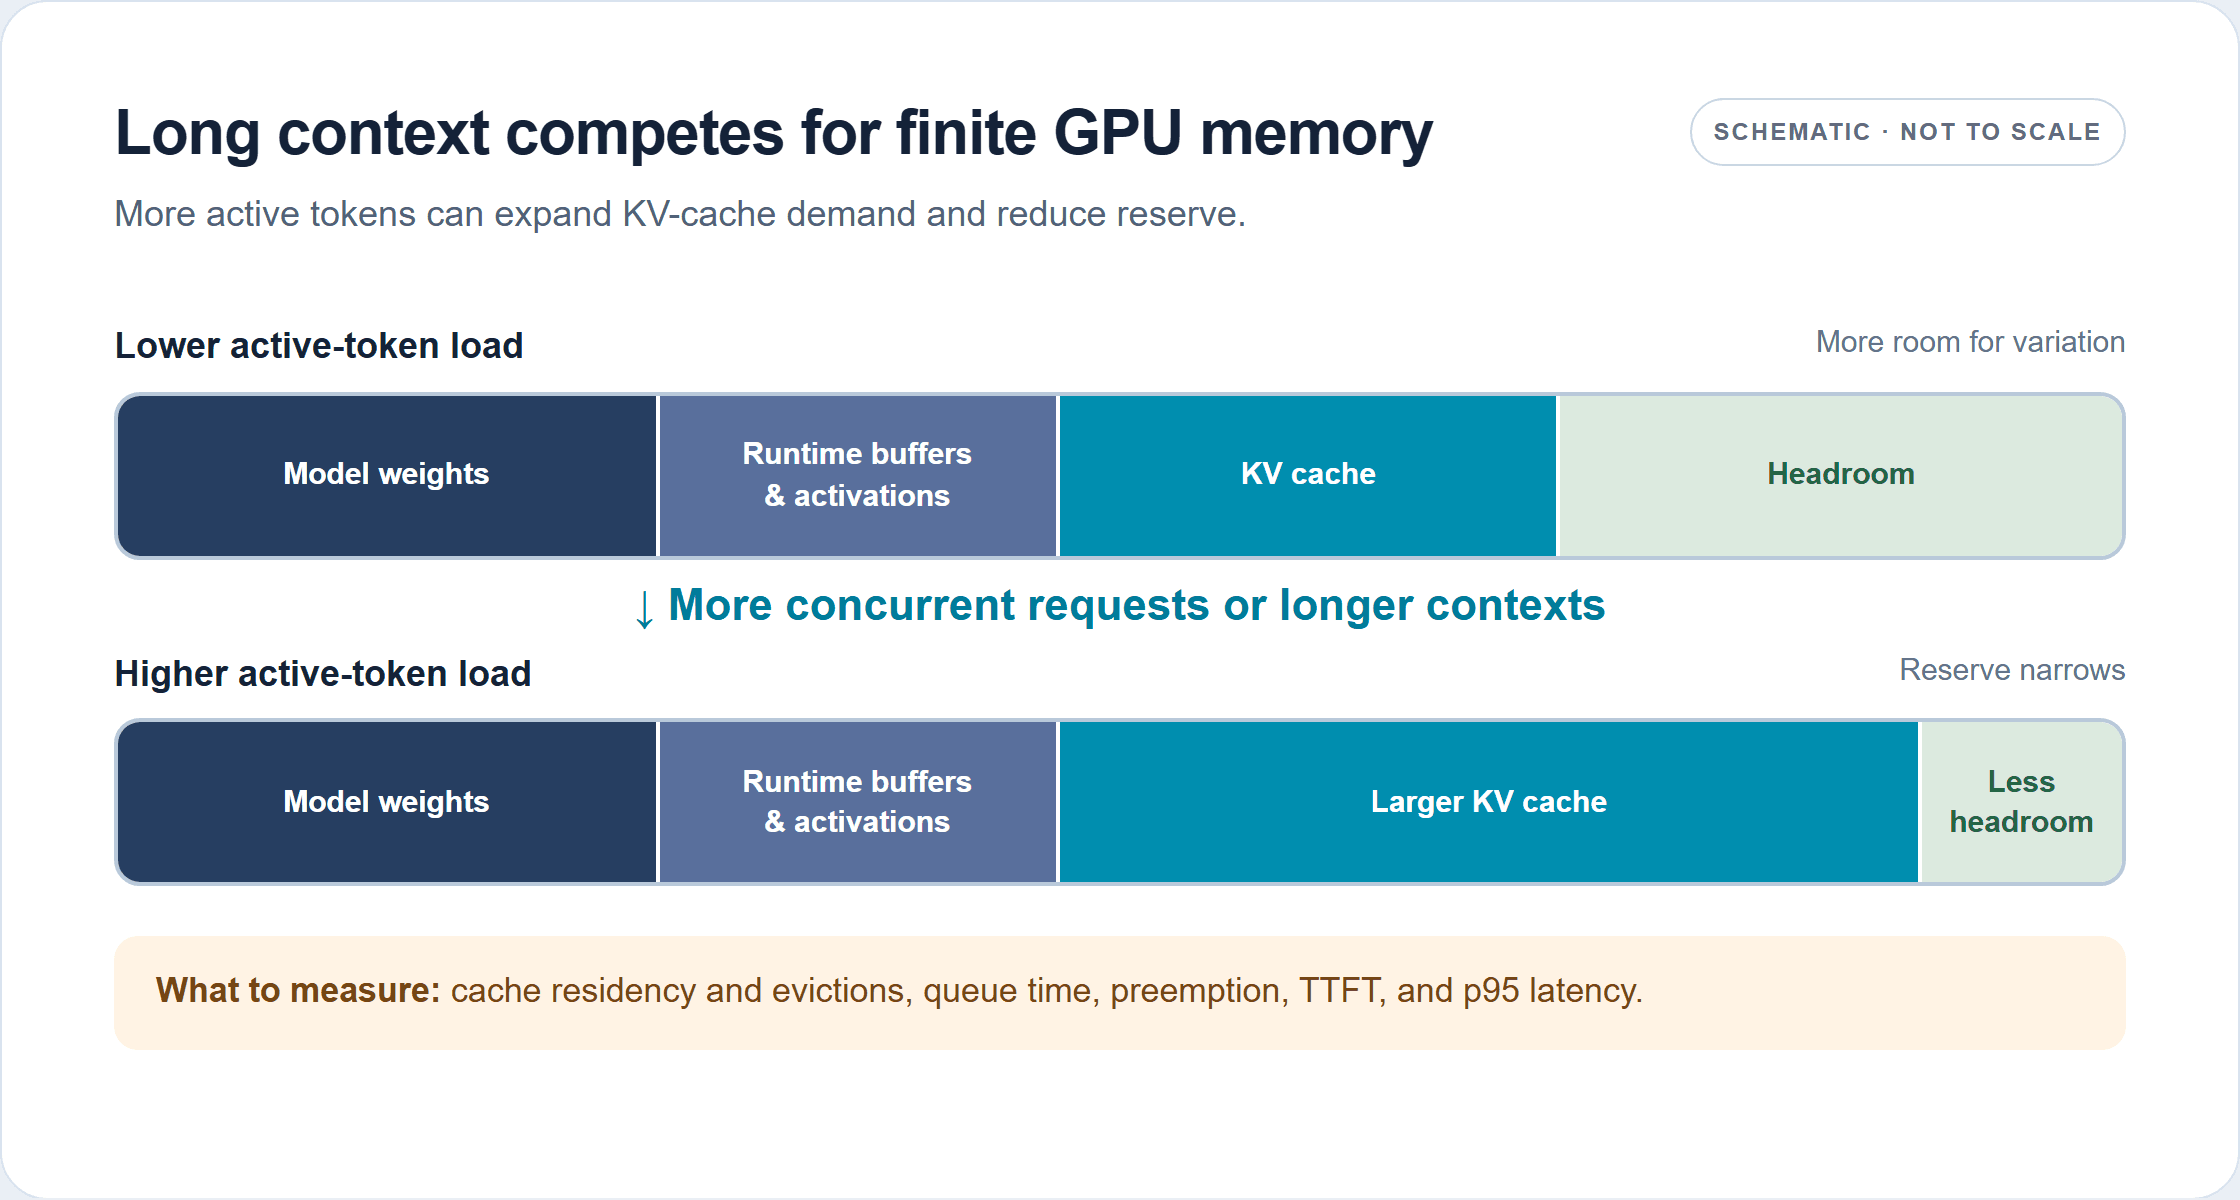
Ngữ cảnh dài hơn hoặc nhiều yêu cầu đồng thời hơn có thể làm tăng nhu cầu KV-cache. Các khối bộ nhớ là sơ đồ và không theo tỷ lệ.
Coi lượng tử hóa, độ chính xác KV-cache, song song tensor, song song expert và tách rời prefill/decode là các thí nghiệm riêng. Chúng có thể thay đổi mức dùng bộ nhớ, giao tiếp, lựa chọn kernel, chất lượng đầu ra và độ trễ. Bố trí tốt nhất phụ thuộc vào loại GPU và interconnect; thêm nhiều GPU có thể làm tăng chi phí giao tiếp hoặc để một số tài nguyên nhàn rỗi. Xác minh chất lượng đầu ra chính xác và các chế độ lỗi sau khi thay đổi độ chính xác hoặc thực thi mô hình.
Trình tự thực tế rất đơn giản: tái tạo baseline, xác định chỉ số không đạt mục tiêu, hình thành một giả thuyết điểm nghẽn, thay đổi một cài đặt và lặp lại. Nếu cài đặt cải thiện một chỉ số nhưng gây hại cho chỉ số khác, hãy quyết định rõ ràng liệu đánh đổi đó có phù hợp với sản phẩm không. Điều này biến tối ưu hóa thành một quyết định có kiểm soát thay vì một đống cờ.
Xác thực Speculative Decoding và mọi tăng tốc được tuyên bố
Speculative decoding có thể giảm công việc tuần tự của mô hình đích khi token nháp được chấp nhận hiệu quả và runtime triển khai xác minh tốt. Lợi ích của nó phụ thuộc vào đường nháp, hành vi chấp nhận, hình dạng batch, phần cứng và tổ hợp prompt/đầu ra. Nó có thể giúp lưu lượng bị giới hạn bởi decode và ít giá trị khi prefill, xếp hàng hoặc giao tiếp chiếm ưu thế.
Chạy thử nghiệm A/B với speculation bật và tắt. Giữ cố định checkpoint mô hình, bộ prompt, giới hạn token, mẫu đến, mức đồng thời, warm-up và cửa sổ đo. Ghi lại số token được chấp nhận mỗi bước xác minh nếu có, cùng với thông lượng tổng hợp, tốc độ mỗi yêu cầu, TTFT, độ trễ p95, mức dùng GPU, lỗi và chất lượng tác vụ. Độ dài chấp nhận mô phỏng trong một benchmark đã công bố là điều kiện kiểm thử, không phải giá trị để giả định cho prompt của bạn.
Một tăng tốc được tuyên bố chỉ hữu ích nếu nó vượt qua ba kiểm tra: cùng mục tiêu cấp dịch vụ, chất lượng câu trả lời chấp nhận được và so sánh chi phí công bằng. Báo cáo đầy đủ bối cảnh với mọi con số bạn công bố. Tránh so sánh số lượng GPU, độ dài prompt, độ dài đầu ra, chế độ độ chính xác, bản sửa đổi mô hình hoặc chỉ số khác nhau như thể chúng là một thí nghiệm có kiểm soát.
Tự vận hành hay dùng API DeepSeek V4.1 Flash được quản lý?
Tự vận hành hợp lý khi lưu lượng đủ ổn định để giữ GPU hữu dụng, nhóm có thể vận hành hạ tầng suy luận và việc kiểm soát phần cứng hoặc thực thi biện minh cho công việc vận hành. Bao gồm toàn bộ chi phí accelerator, dư dung lượng, điện, mạng, lưu trữ, bảo trì và thời gian kỹ thuật. Chỉ một kết quả token/giây đỉnh cao không thiết lập được chi phí thấp hơn cho mỗi tác vụ thành công.
Một API được quản lý hữu ích khi nhóm cần xác thực nhu cầu sản phẩm nhanh chóng, tránh vận hành một cụm phục vụ hoặc so sánh baseline API với triển khai của chính họ. Atlas Cloud liệt kê DeepSeek V4.1 Flash dưới ID mô hình deepseek-ai/deepseek-v4.1-flash với API tương thích OpenAI. Trang mô hình DeepSeek V4.1 Flash hiện hiển thị $0.30 mỗi triệu token đầu vào, $1.20 mỗi triệu token đầu ra và $0.03 mỗi triệu token đọc cache, không có giảm giá nào được hiển thị tính đến tháng 10 năm 2026. Kiểm tra danh sách giá hiện tại trước khi ước tính chi tiêu. Một endpoint được quản lý không loại bỏ nhu cầu đo độ trễ yêu cầu hoặc kinh tế lưu lượng của chính bạn.
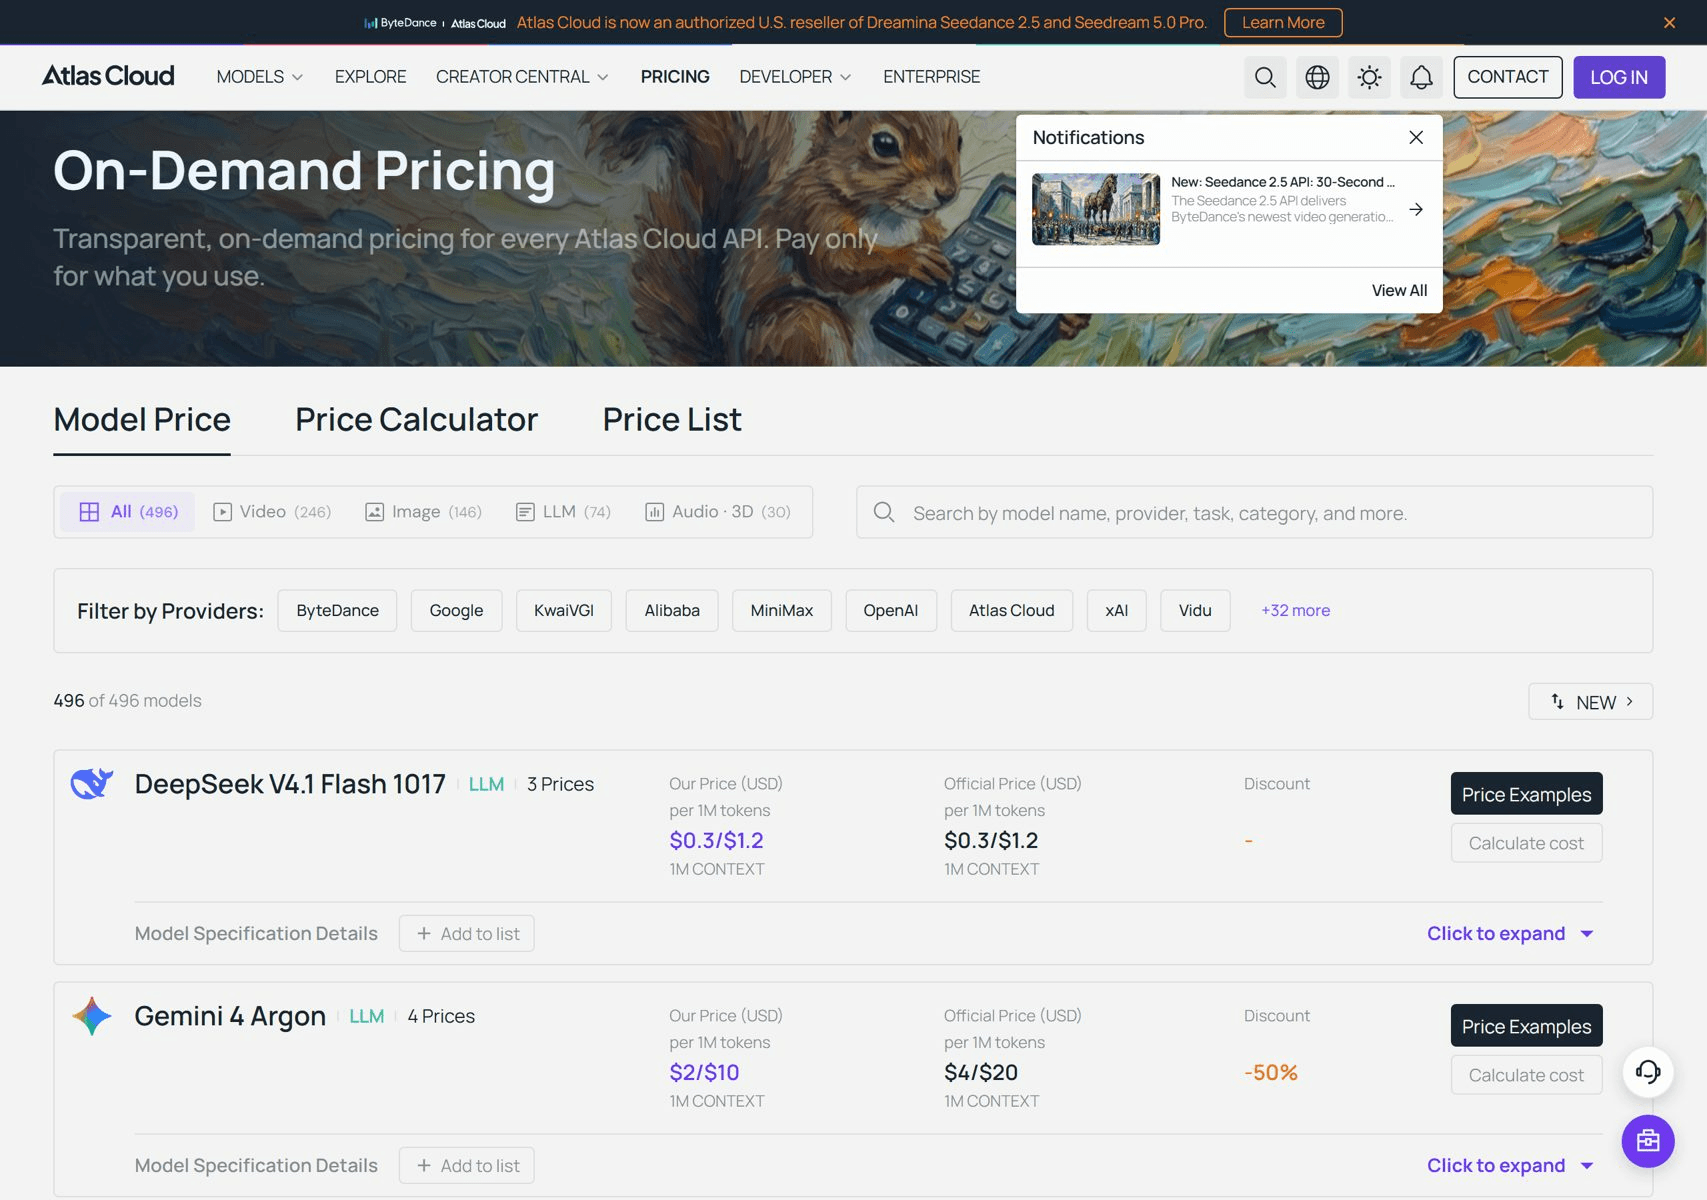
Danh sách này xác định một tùy chọn API được quản lý; đây không phải benchmark phục vụ.
Để có quyết định triển khai công bằng, hãy phát lại cùng các yêu cầu nghiệp vụ trên dịch vụ tự vận hành và endpoint được quản lý. So sánh chi phí cho mỗi tác vụ hoàn thành, phân bố độ trễ, độ tin cậy và thời gian nhân sự cần để duy trì mỗi lựa chọn. Nếu mục tiêu chính của bạn là tối ưu hóa thông lượng suy luận DeepSeek V4.1 Flash, hãy giữ cùng khối lượng công việc và tiêu chí thành công cho cả hai đường.
Câu hỏi thường gặp
Sự khác biệt giữa thông lượng và token mỗi giây mỗi người dùng là gì?
Thông lượng tổng hợp đếm đầu ra trên các yêu cầu đang hoạt động. Token/giây mỗi người dùng đo tốc độ giải mã của một yêu cầu. Batch hóa có thể tăng chỉ số đầu và giảm chỉ số sau, vì vậy hãy báo cáo cả hai cho dịch vụ tương tác.
Tăng mức đồng thời có luôn cải thiện thông lượng không?
Không. Đầu ra tổng hợp có thể tăng cho đến khi tính toán hoặc bộ nhớ bão hòa, rồi đi ngang. Xếp hàng và độ trễ đuôi có thể tiếp tục xấu đi sau điểm đó. Dừng tăng mức đồng thời khi mục tiêu cấp dịch vụ không đạt.
Có thể so sánh trực tiếp các con số benchmark của vLLM và SGLang không?
Chỉ khi bản sửa đổi mô hình, phần cứng, độ dài prompt và đầu ra, mức đồng thời, trạng thái nóng, ranh giới đo lường và ràng buộc độ trễ khớp nhau. Các báo cáo đã công bố dùng thiết lập khác nhau, vì vậy chúng minh họa các đường tối ưu hóa thay vì người thắng runtime trực tiếp.
Khi nào nên dùng API được quản lý thay vì tự vận hành?
Dùng API được quản lý khi tốc độ tích hợp và giảm công việc hạ tầng quan trọng hơn việc sở hữu stack phục vụ. Tự vận hành khi mức sử dụng, chuyên môn vận hành, quyền kiểm soát và một trường hợp tổng chi phí được đo lường biện minh cho việc chạy GPU.





