Cửa sổ ngữ cảnh một triệu token cho bạn biết mô hình có thể nhận bao nhiêu văn bản, không phải mức độ đáng tin cậy mà nó sẽ diễn giải từng điều khoản. Đối với độ chính xác phân tích tài liệu dài của DeepSeek V4.1 Flash, bằng chứng công khai hữu ích nhưng chưa đầy đủ: thẻ mô hình của DeepSeek báo cáo 45.2 exact match trên LongBench-V2 cho mô hình cơ sở V4.1 Flash trong thiết lập 1-shot, trong khi API đã chuyển sang bản dựng 1017 mới hơn. Điểm chuẩn đó là tín hiệu về một thiết lập đánh giá, không phải tỷ lệ đạt cho hợp đồng, báo cáo thường niên hay kho lưu trữ nghiên cứu của bạn.
Câu trả lời thực tế là dùng Flash để truy xuất nhanh và tổng hợp lần đầu, sau đó yêu cầu bằng chứng ở cấp trang và con người xem xét đối với các quyết định quan trọng. Không có nguồn công khai nào được trích dẫn ở đây cung cấp đánh giá có thể tái lập, trên bản dựng hiện tại, cho năm tác vụ tài liệu bên dưới. Kế hoạch kiểm thử là một giao thức sẵn sàng chạy, không phải tuyên bố rằng những lần chạy đó đã diễn ra.
Những điểm chính
- Dòng mô hình này hỗ trợ tối đa 1M token, nhưng giới hạn ngữ cảnh không phải là bảo đảm về độ chính xác.
- Điểm LongBench-V2 45.2 đã công bố là dành cho mô hình cơ sở và thiết lập benchmark 1-shot.
- API của DeepSeek hiện phục vụ V4.1-Flash-1017; ghi chú phát hành của nó không công bố điểm tài liệu dài mới.
- Hãy yêu cầu vị trí bằng chứng, kiểm tra chúng với nguồn, và đo lỗi trên tài liệu của chính bạn.
Cửa sổ 1M token có ý nghĩa gì đối với phân tích tài liệu
Thẻ mô hình của DeepSeek mô tả V4.1 Flash hỗ trợ ngữ cảnh lên đến một triệu token. Tài liệu API hiện xác định mô hình được phục vụ là DeepSeek-V4.1-Flash-1017 và liệt kê độ dài ngữ cảnh 1M. Đó là các thông số về dung lượng. Chúng không chứng minh được mô hình thường xuyên tìm thấy chú thích cuối trang đến mức nào, giữ hai phiên bản tài liệu tách biệt ra sao, hoặc thừa nhận rằng một dữ kiện được yêu cầu là không có. (Thẻ mô hình DeepSeek)
Một token không phải là một trang. Số trang thay đổi theo bảng, chú thích cuối trang, bố cục, ngôn ngữ và chất lượng trích xuất. Một PDF quét có thể cần OCR; một bảng có thể mất nhãn hàng khi chuyển thành văn bản; tiêu đề và các thành phần trang lặp lại có thể tiêu tốn ngữ cảnh mà không giúp gì cho câu hỏi. Lời nhắc và câu trả lời được yêu cầu cũng dùng token. Do đó, mức trần danh nghĩa một triệu token không có nghĩa là mọi tệp một triệu token sẽ đến nguyên vẹn qua mọi giao diện trò chuyện hoặc ứng dụng khách API.
Trước khi kiểm thử, hãy ghi lại định danh mô hình chính xác, ứng dụng khách và phương thức nhập. Kiểm tra xem toàn bộ văn bản đã trích xuất có được gửi đi không, nhà cung cấp có cắt bớt nó không, và yêu cầu có đến đúng phiên bản mô hình mong đợi không. API DeepSeek hiện tại dùng deepseek-flash cho bản dựng Flash mới nhất. Nếu cổng kết nối hoặc SDK của bạn dùng bí danh khác, hãy ghi lại bí danh đó và xác minh định tuyến của nó. Các nhóm thiết lập các lệnh gọi được lưu trữ có thể lặp lại có thể bắt đầu từ nền tảng mô hình của Atlas Cloud, sau đó mở danh sách API DeepSeek V4.1 Flash.
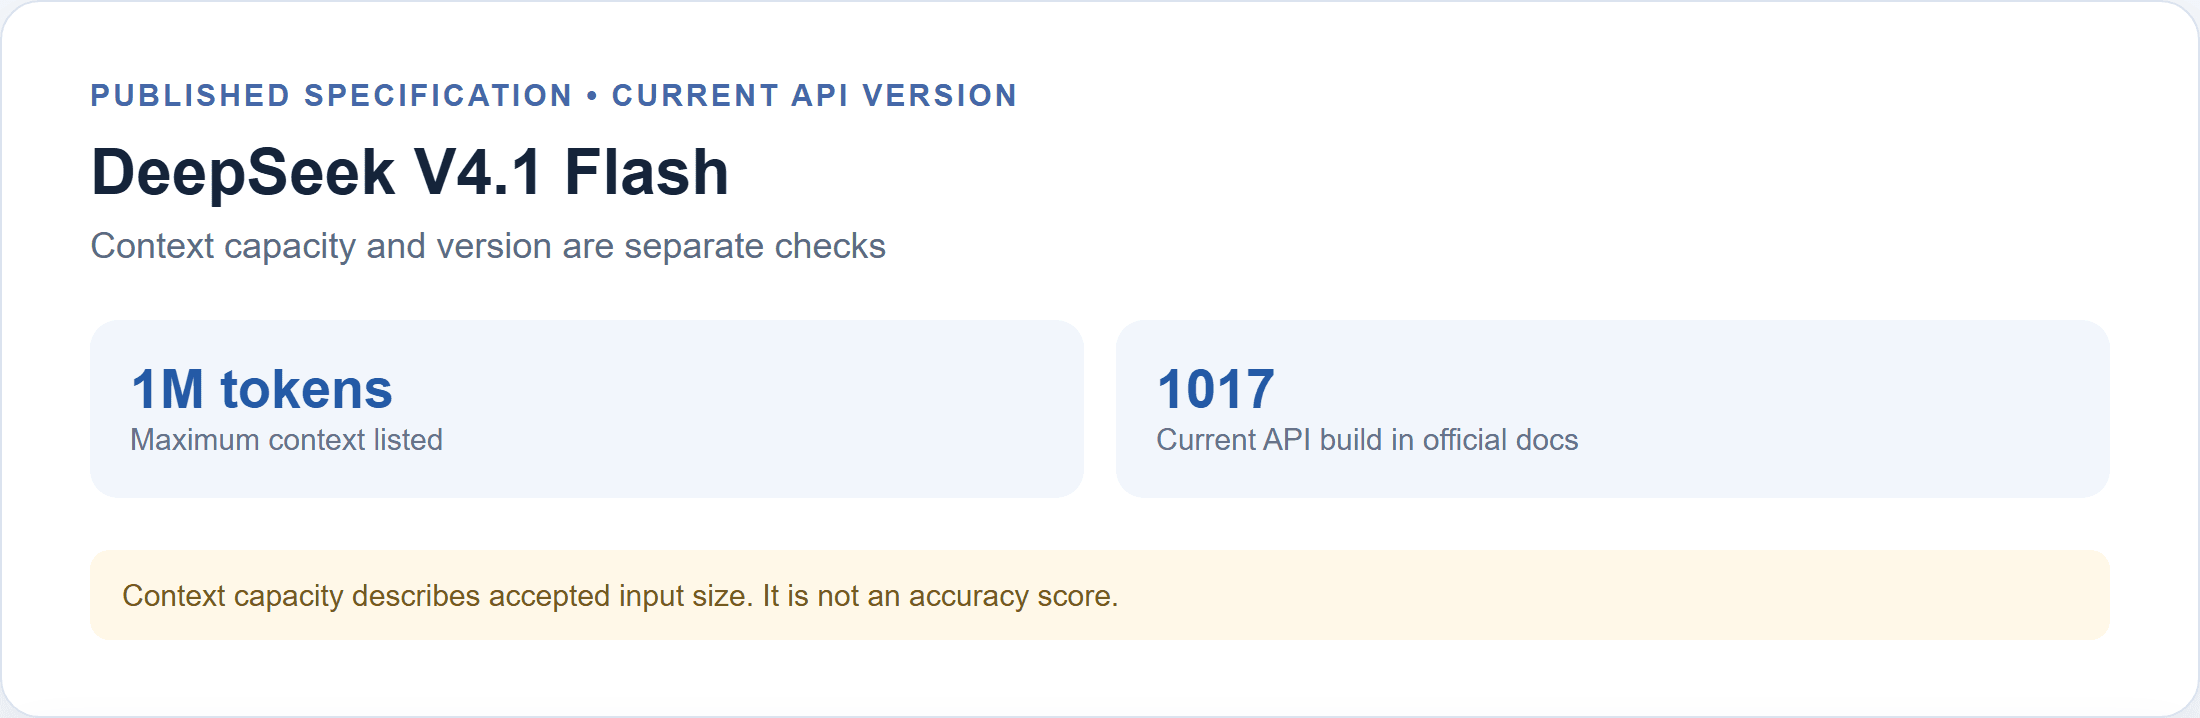
Thông số kỹ thuật đã công bố cho mức tối đa ngữ cảnh 1M; tài liệu API hiện tại xác định bản dựng 1017.
Một lần tải lên hoặc yêu cầu thành công chỉ cho thấy hệ thống đã chấp nhận đầu vào. Để xác lập rằng một chi tiết liên quan đã ảnh hưởng đến câu trả lời, hãy yêu cầu một vị trí chính xác, truy xuất đoạn đó, và xác nhận văn bản xung quanh hỗ trợ cho tuyên bố.
Điểm LongBench-V2 cho thấy và không cho thấy điều gì
Hàng LongBench-V2 trong thẻ mô hình báo cáo điểm exact-match trong thiết lập 1-shot. Bảng của nó ghi kết quả là đánh giá mô hình cơ sở và nói rằng tất cả mô hình cơ sở dùng cùng một khung đánh giá nội bộ. Nó cũng nêu rằng các điểm trong khoảng 0.3 được coi là tương đương. Các giá trị là:
| Mô hình cơ sở trong thẻ mô hình | LongBench-V2 (EM) | Số shot |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
Khoảng cách 0.5 điểm giữa V4-Flash-Base và V4.1-Flash-Base lớn hơn dải tương đương 0.3 mà thẻ nêu, nhưng nó vẫn là một so sánh benchmark hẹp. Con số 45.2 không phải “độ chính xác 45.2% trên các PDF dài”. Đó là điểm exact-match cho một mô hình cơ sở, bộ benchmark, thiết lập lời nhắc và trình đánh giá cụ thể. Nó không trực tiếp chấm điểm một mô hình instruct/API được lưu trữ đang trả lời câu hỏi của bạn bằng một lời nhắc khác.
LongBench-V2 gồm 503 câu hỏi trắc nghiệm thuộc sáu hạng mục, bao gồm hỏi đáp một tài liệu và nhiều tài liệu, đối thoại dài, kho mã, và dữ liệu có cấu trúc. Ngữ cảnh của nó trải từ 8.000 đến 2 triệu từ. Các tác giả benchmark báo cáo độ chính xác trung bình 53,7% đối với chuyên gia trong giới hạn 15 phút, và 50,1% đối với mô hình trả lời trực tiếp tốt nhất trong đánh giá được báo cáo của họ. Độ bao phủ của nó khiến nó trở thành một bài kiểm tra căng thẳng hữu ích, nhưng một con số tổng hợp không thể chẩn đoán thao tác tài liệu nào mạnh hay yếu. (Bài báo LongBench-V2)
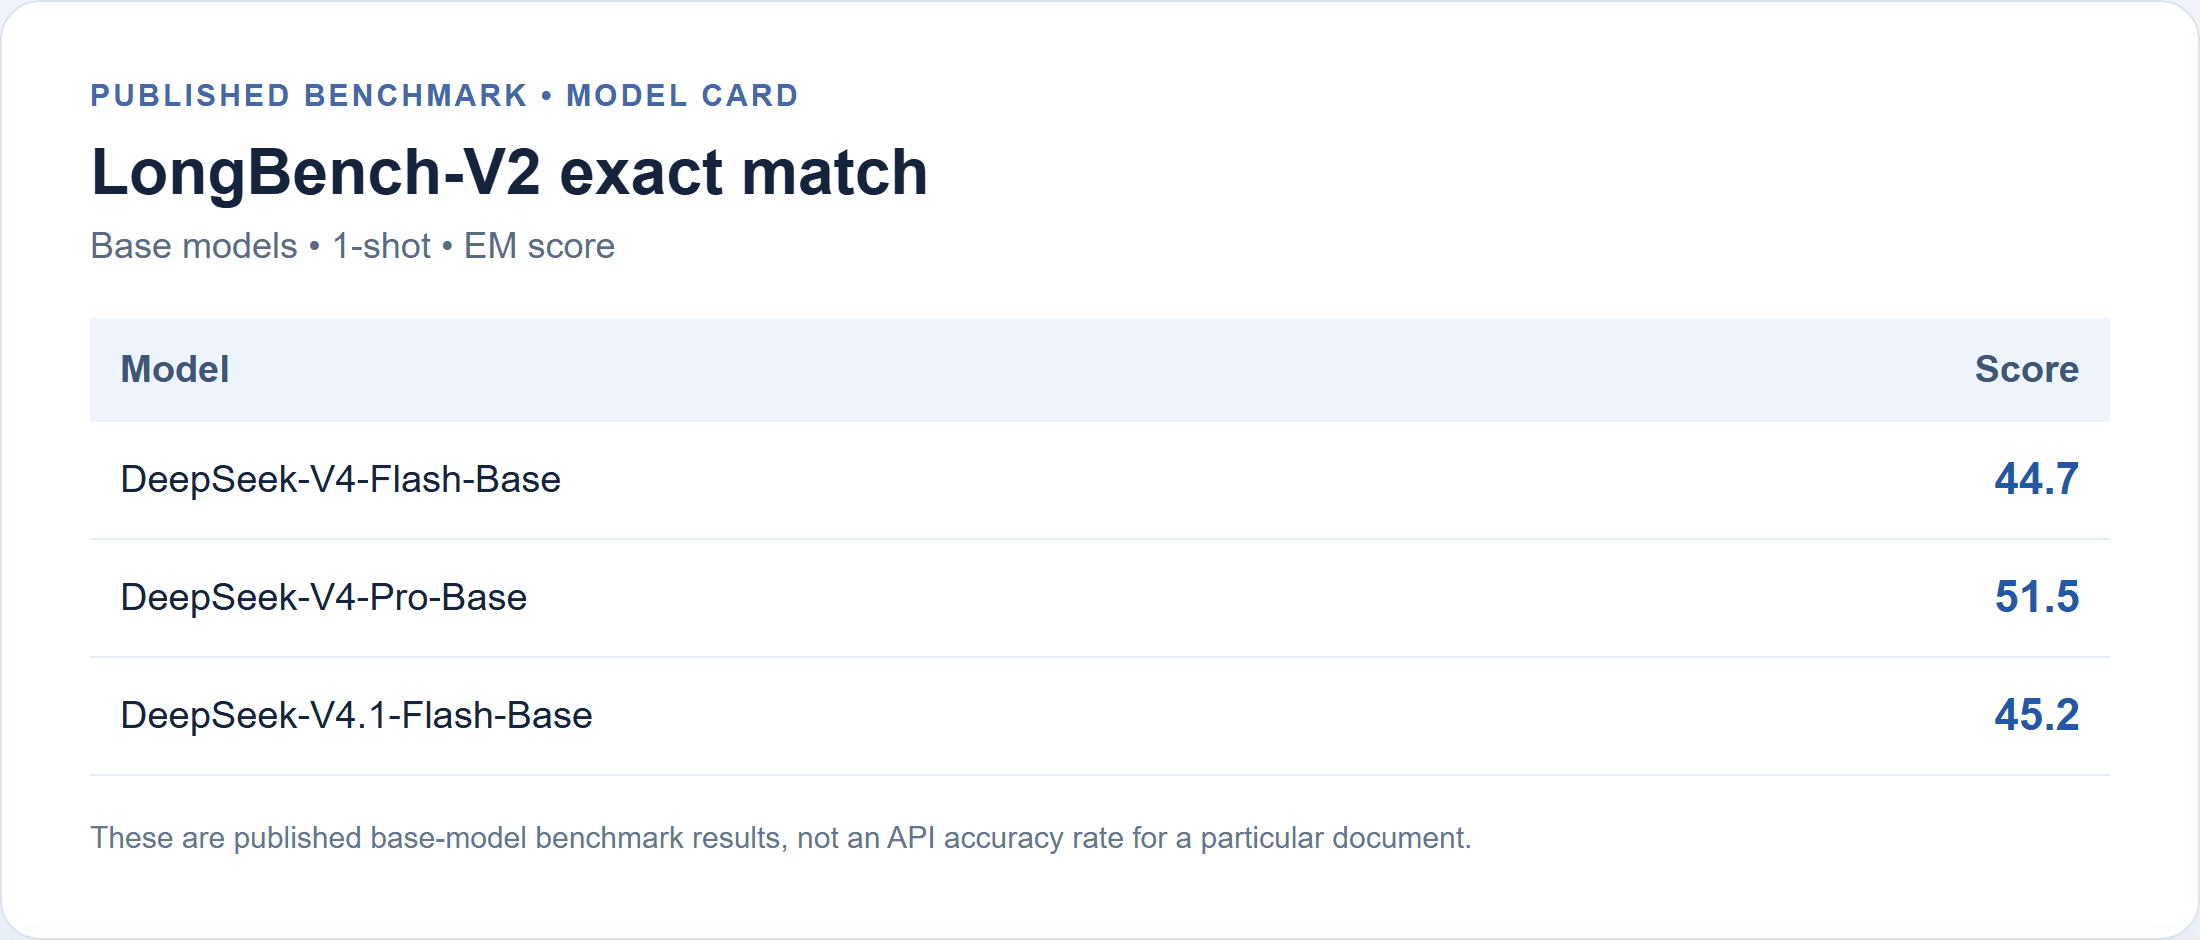
Hàng đã công bố là kết quả mô hình cơ sở, 1-shot. Đây không phải tỷ lệ đạt được đo lường của API.
Có một lưu ý về phiên bản. Ghi chú phát hành ngày 17 tháng 10 của DeepSeek nói rằng API và ứng dụng web đã được nâng cấp lên V4.1-Flash-1017, và tên mô hình API vẫn là deepseek-flash. Ghi chú liệt kê các benchmark tác nhân và suy luận đã cập nhật, nhưng không báo cáo kết quả LongBench-V2 mới. Vì vậy 45.2 vẫn là một tham chiếu công khai hữu ích cho mô hình cơ sở V4.1 Flash, trong khi độ chính xác của bản dựng API hiện tại trên các câu hỏi tài liệu dài vẫn chưa được định lượng trong các nguồn đó. Đừng chuyển những cải thiện benchmark không liên quan sang hỏi đáp tài liệu. (Cập nhật DeepSeek V4.1-Flash-1017)
Cách chạy một bài kiểm tra độ chính xác tài liệu dài công bằng
Một đánh giá hữu ích cần nguồn cố định, đáp án và quy tắc chấm điểm. Hãy bắt đầu với báo cáo thường niên hoặc báo cáo kỹ thuật công khai mà phiên bản và cấu trúc trang có thể chia sẻ. Lưu PDF và văn bản đã trích xuất, ghi lại URL nguồn và ngày truy xuất, đồng thời ghi chú bạn đã dùng trích xuất văn bản gốc hay OCR. Tránh chọn một tài liệu chỉ vì bạn đã biết mô hình xử lý nó tốt.
Trước khi nhắc mô hình, hãy tự viết đáp án từ nguồn. Với mỗi câu hỏi, ghi lại câu trả lời mong đợi và trang hoặc mục chính xác. Điều này ngăn một câu trả lời thuyết phục trở thành tiêu chuẩn chấm điểm. Giữ câu hỏi đủ cụ thể để chấm điểm, đồng thời bảo toàn sự mơ hồ mà người đọc thực sự gặp phải.
Dùng cùng tài liệu, bộ câu hỏi, định danh mô hình, lời nhắc, thiết lập suy luận và định dạng đầu ra cho mỗi lần chạy. Nếu API có các điều khiển temperature hoặc reasoning, hãy ghi lại chúng. Chạy bộ này nhiều hơn một lần nếu bạn muốn ước tính độ biến thiên; một lần chạy là một mẫu, không phải tỷ lệ ổn định. Đừng âm thầm sửa đầu ra trước khi chấm điểm.
Một bộ gọn nhẹ có thể bao phủ năm cơ hội thất bại khác nhau:
| Tác vụ | Dạng câu hỏi ví dụ | Cần xác minh điều gì |
|---|---|---|
| Tra cứu một điểm | “Báo cáo đưa ra ngày nào cho chính sách đã sửa đổi?” | Giá trị chính xác và trang được trích dẫn |
| Liên kết giữa các mục | “Rủi ro ở Mục 2 liên quan thế nào đến kiểm soát ở Mục 7?” | Cả hai đoạn và liệu mối liên hệ được nêu hay được suy ra |
| Xử lý ngoại lệ | “Ai bị loại trừ khỏi phạm vi bảo hiểm đã nêu?” | Chú thích cuối trang, phạm vi và các từ hạn định |
| Xung đột phiên bản | “Giá trị nào áp dụng sau khi sửa đổi, và nó thay thế giá trị nào?” | Ngày, nhãn phiên bản và cả hai vị trí |
| Thông tin bị thiếu | “Báo cáo quy định thời hạn lưu trữ nào cho bản sao của nhà cung cấp?” | Việc thừa nhận nếu tài liệu không nói gì |
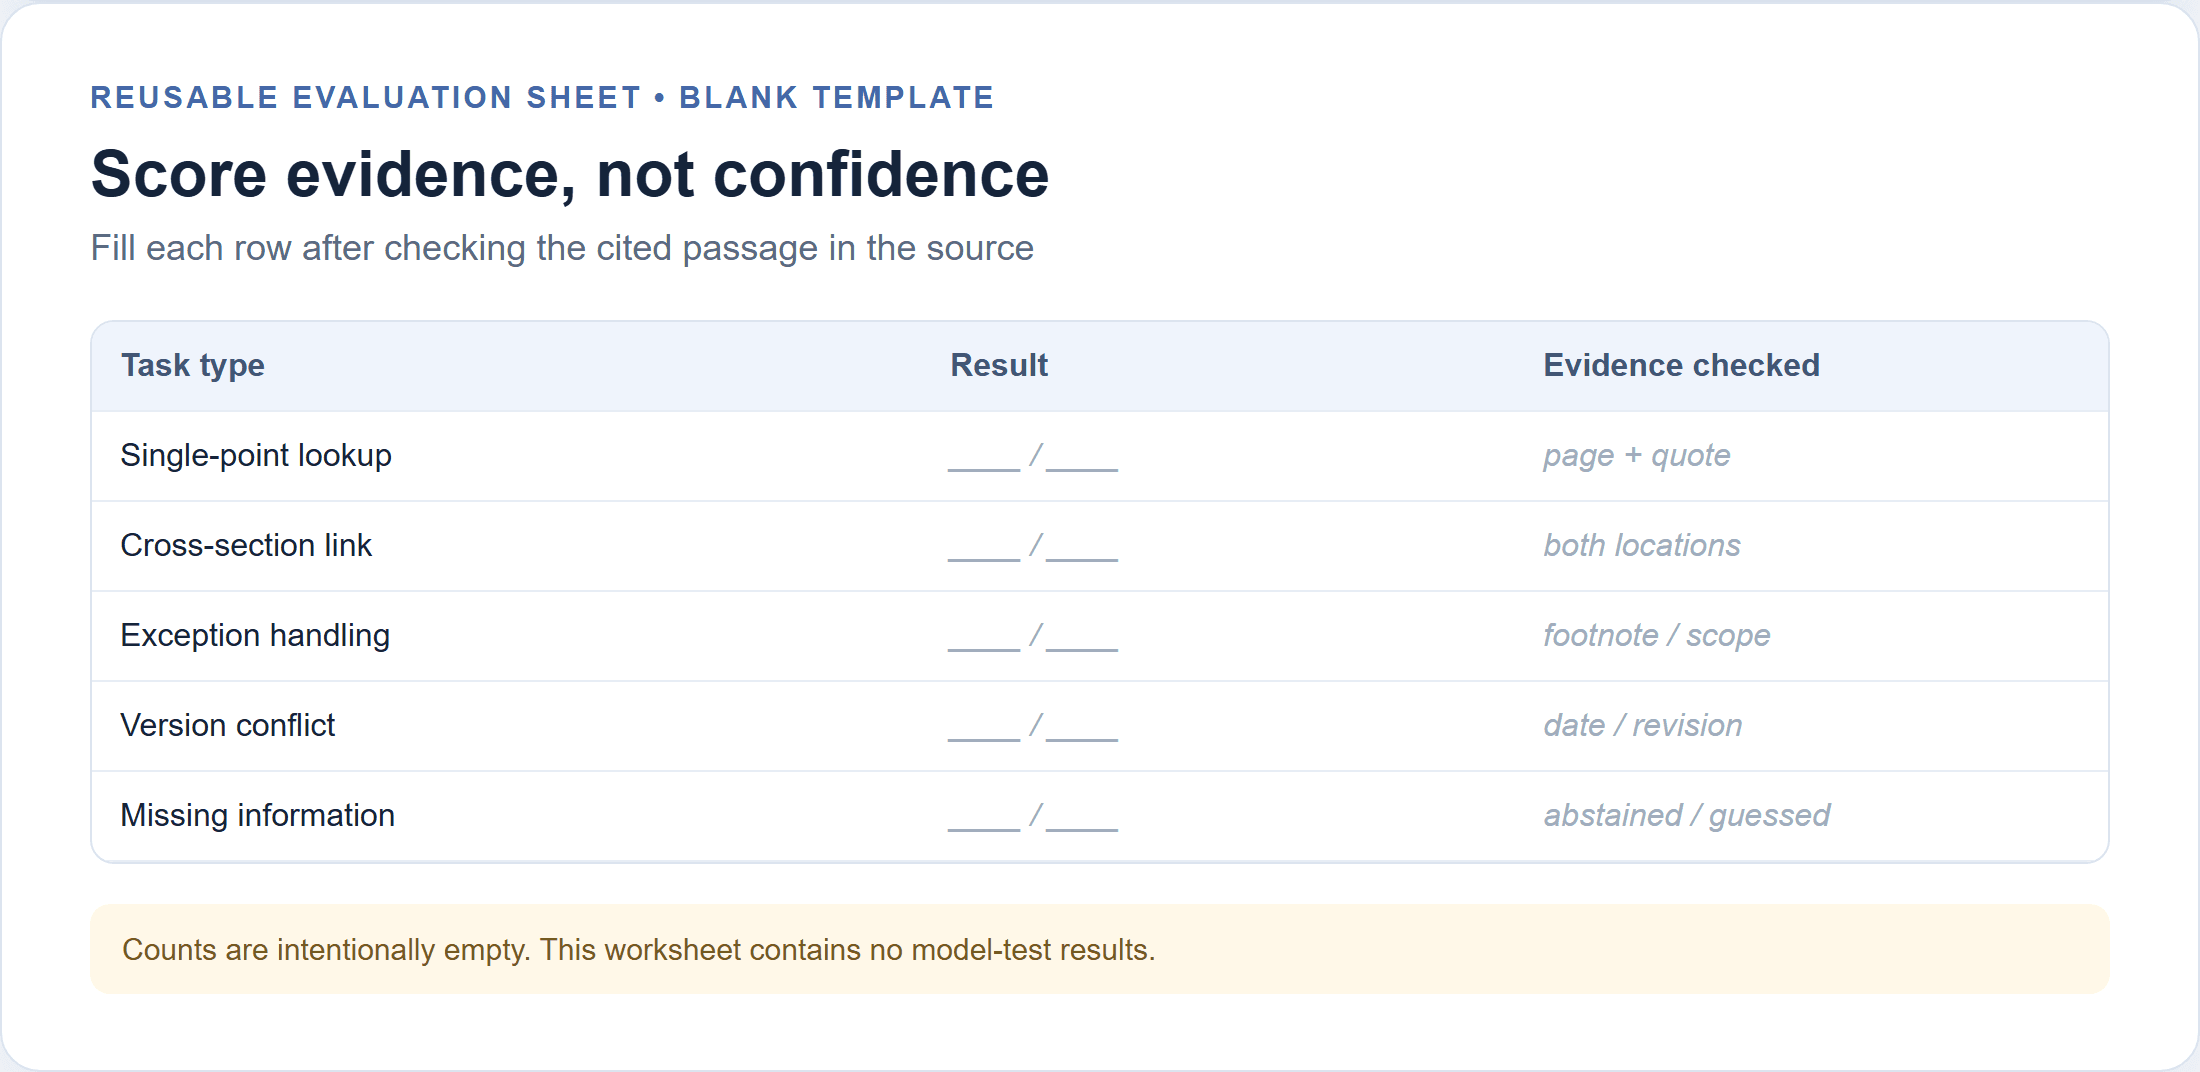
Đây là bảng chấm điểm trống, không phải bảng kết quả. Chỉ điền vào sau khi kiểm tra từng câu trả lời với tài liệu nguồn.
Chấm mỗi câu trả lời là đúng, một phần, sai, không được hỗ trợ, hoặc từ chối trả lời đúng cách. Đếm riêng các tuyên bố không được hỗ trợ với câu trả lời sai vì một phản hồi có thể đưa ra câu trả lời đúng ở tiêu đề và bịa ra một chi tiết. Kiểm tra xem mỗi trích dẫn có trỏ đến đoạn hỗ trợ cho tuyên bố không. Báo cáo số lượng câu hỏi và số lượng theo hạng mục cùng nhau. Một tỷ lệ phần trăm tổng thể che giấu việc mô hình bỏ sót chú thích cuối trang hay chỉ gặp khó khăn khi thông tin nằm rải rác ở nhiều mục.
Giữ nguyên tệp nguồn chính xác, bản trích xuất, lời nhắc, phản hồi thô và bảng chấm điểm. Chỉ công bố tài liệu bạn được phép chia sẻ, và che giấu tên hoặc chi tiết tài khoản bảo mật. Người đánh giá phải có thể lần theo từng câu trả lời đã chấm từ đầu ra của mô hình đến một trang trong nguồn đã lưu.
Những chỗ câu trả lời tài liệu dài thường thất bại
Nếu không có một lần chạy trên bản dựng hiện tại với một tài liệu đã nêu, sẽ là sai nếu tuyên bố rằng V4.1 Flash đã thể hiện một tỷ lệ lỗi hoặc kiểu thất bại cụ thể. Các hạng mục bên dưới là những thứ cần kiểm tra, không phải phát hiện đã đo lường về mô hình này.
Bắt đầu với việc mất phạm vi. Một đoạn thân bài có thể nêu một quy tắc trong khi chú thích cuối trang giới hạn nó ở một khu vực, khoảng ngày hoặc nhóm khách hàng. Hãy yêu cầu ngoại lệ một cách rõ ràng và kiểm tra xem đoạn được trích dẫn có bao gồm nó không. Chỉ trích dẫn từ đoạn chính có thể không đủ.
Tiếp theo, kiểm tra sự nhầm lẫn phiên bản. Báo cáo có thể lặp lại các giá trị tương tự trong một bản nháp và một mục đã sửa đổi. Hãy yêu cầu mô hình nêu ngày hoặc phiên bản gắn với từng giá trị thay vì chỉ hỏi “con số hiện tại”. Nếu nó âm thầm chọn một giá trị, hãy chấm phản hồi là chưa đầy đủ ngay cả khi nó chọn đúng.
Các câu hỏi liên mục mời gọi suy luận. Một mô hình có thể kết hợp hai dữ kiện chính xác thành một giải thích nhân quả mà tài liệu chưa từng đưa ra. Hãy yêu cầu nó ghi nhãn các tuyên bố trực tiếp tách biệt với suy luận. Sau đó so sánh suy luận với bằng chứng và quyết định xem nó có hợp lý cho tác vụ không.
Cuối cùng, kiểm tra việc từ chối trả lời. Bao gồm một câu hỏi mà câu trả lời không có. Một phỏng đoán tự tin là thất bại ngay cả khi nghe có vẻ hợp lý. Đối với hợp đồng, tuân thủ, tài liệu lâm sàng hoặc phân tích tài chính có hệ quả, hãy nhờ một người có chuyên môn kiểm tra văn bản gốc trước khi dùng một kết luận.
Quy trình xác minh để có câu trả lời an toàn hơn
Lời nhắc này giúp câu trả lời dễ kiểm toán hơn. Nó không thể bảo đảm tính đúng đắn hoặc thay thế việc xem xét nguồn. Dùng nó với một bản trích xuất giữ nguyên nhãn trang, sau đó đặt các câu hỏi tập trung thay vì yêu cầu tóm tắt chung một tệp lớn.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Với một báo cáo dài, hãy chia công việc theo tác vụ, không tự động theo số trang tùy ý. Trước tiên yêu cầu một bản đồ nguồn: tiêu đề mục, ngày, thuật ngữ đã định nghĩa và các bảng liên quan. Sau đó truy vấn một chủ đề cụ thể và yêu cầu các đoạn hỗ trợ cho nó. Với một kết luận liên mục, hãy cung cấp hoặc truy xuất cả hai đoạn trong cùng một lượt và yêu cầu mô hình giải thích mối liên hệ trong khi đánh dấu mọi suy luận.
Dùng vòng xác minh của con người:
- Kiểm tra trang được trích dẫn và trích dẫn trong tệp gốc.
- Xác nhận trích dẫn bao gồm các ngoại lệ lân cận và tiêu đề bảng.
- Đánh dấu mỗi tuyên bố là trực tiếp, được suy ra, không được hỗ trợ hoặc bị mâu thuẫn.
- Sửa lời nhắc hoặc chia nhỏ tác vụ nếu bản trích xuất bỏ sót cấu trúc quan trọng.
- Lưu yêu cầu và phản hồi thô để người đánh giá có thể tái tạo quyết định.
Khi bạn dùng một endpoint được lưu trữ, hãy ghi mức sử dụng token vào nhật ký chạy. Trang giá mô hình của Atlas Cloud hiện liệt kê DeepSeek V4.1 Flash ở mức $0.30 mỗi 1M token đầu vào, $1.20 mỗi 1M token đầu ra và $0.03 mỗi 1M token đọc bộ nhớ đệm, không có giảm giá được liệt kê. Kiểm tra danh sách hiện tại trước khi lập ngân sách. Tham chiếu giá này là dành cho Atlas Cloud, không phải giá API DeepSeek phổ quát.
Với các mức giá đã liệt kê đó, 100.000 token đầu vào không dùng bộ nhớ đệm và 3.000 token đầu ra tốn khoảng $0.033: $0.030 cho đầu vào cộng $0.0036 cho đầu ra.
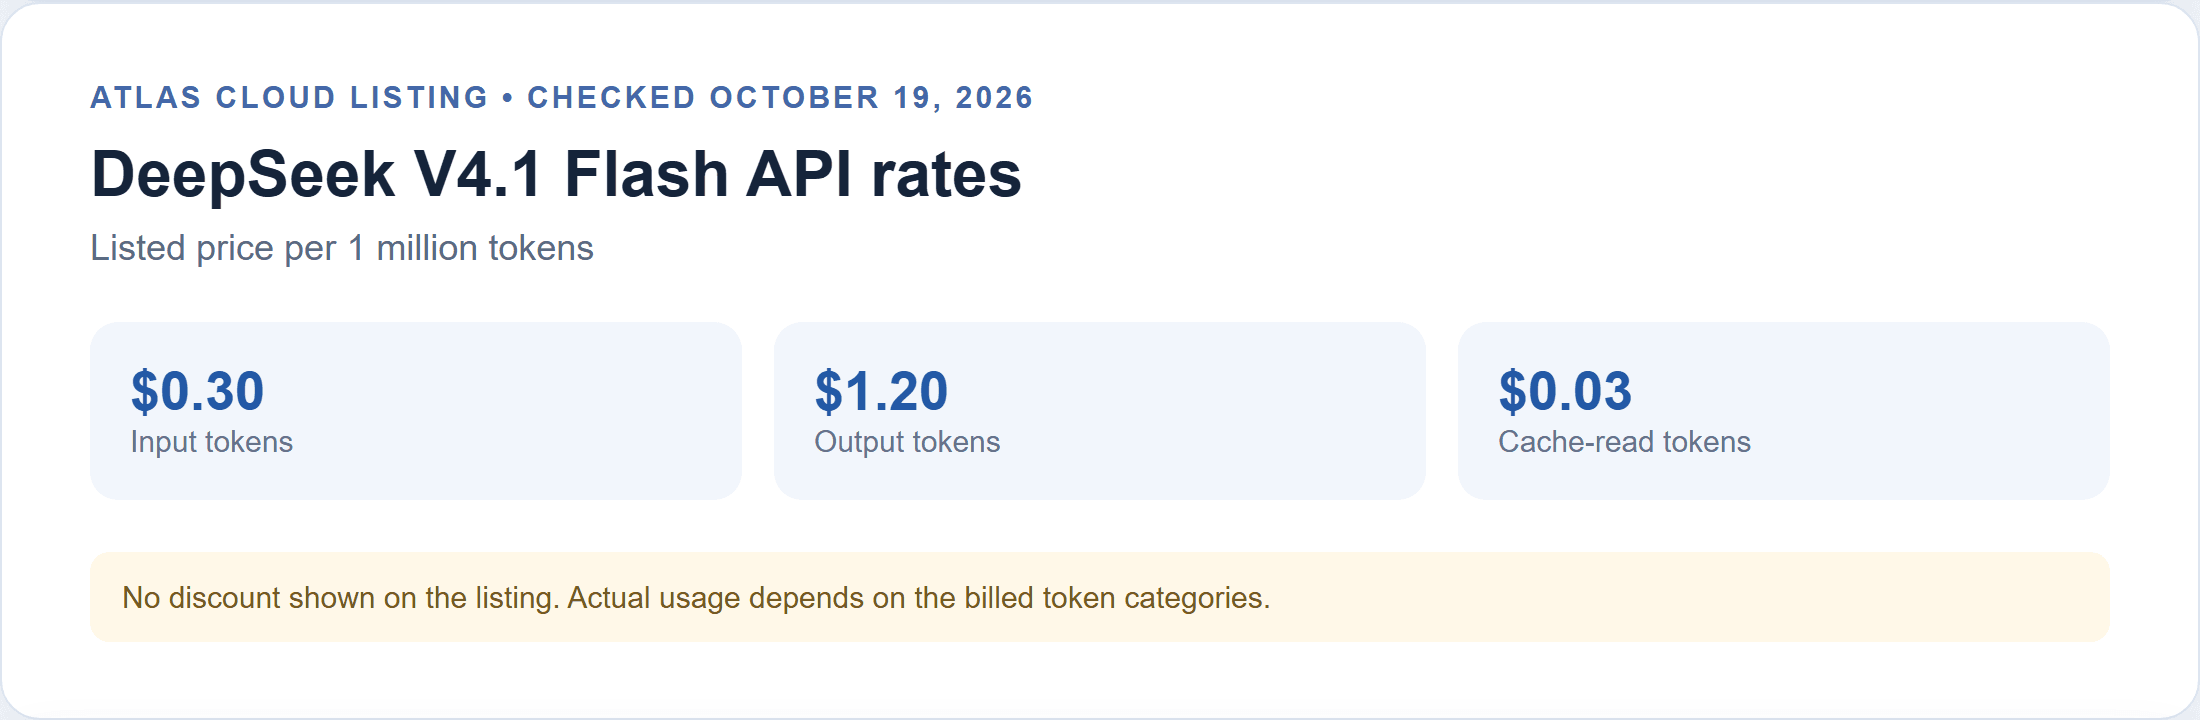
Giá Atlas Cloud được kiểm tra ngày 19 tháng 10 năm 2026; danh sách hiển thị không có giảm giá. Một đầu vào 1M token và câu trả lời 20.000 token sẽ tốn khoảng $0.324 ở cùng mức giá, trước khi xử lý bộ nhớ đệm hoặc các mục có thể tính phí khác. Đây là các ví dụ số học, không phải hóa đơn kiểm thử tài liệu đã đo lường. Đầu vào thực tế bao gồm lời nhắc và văn bản đã trích xuất; các lệnh gọi lặp lại làm tăng mức sử dụng. Dùng số token do nhà cung cấp trả về thay vì ước tính từ số trang.
Khi nào nên dùng DeepSeek V4.1 Flash cho tài liệu dài
Flash là một lượt xử lý đầu tiên hợp lý khi bạn cần định vị định nghĩa, thu thập ngày, tạo bản đồ mục hoặc phác thảo một bản tóm tắt mà một người sẽ kiểm tra. Những tác vụ đó có dấu vết bằng chứng rõ ràng và dễ chạy lại với các câu hỏi chặt chẽ hơn. Với công việc lặp lại, hãy giữ các câu hỏi đã biết đáp án và chạy lại chúng khi phiên bản mô hình, quy trình trích xuất hoặc lời nhắc thay đổi.
Thêm kiểm soát khi một câu hỏi kết hợp các mục ở xa nhau, phụ thuộc vào chú thích cuối trang hoặc so sánh các bản sửa đổi. Dùng trích dẫn như phương tiện điều hướng, không phải bằng chứng tự thân. Nếu một câu trả lời sẽ ảnh hưởng đến nghĩa vụ hợp đồng, vị thế tuân thủ, công bố tài chính hoặc một quyết định có tác động cao khác, hãy để một người đánh giá có chuyên môn xác minh từng tuyên bố trọng yếu trong nguồn.
Câu hỏi hữu ích là liệu mô hình này, trên phiên bản tài liệu và quy trình chính xác của bạn, có trả về câu trả lời kèm bằng chứng vượt qua được kiểm tra hay không. Đó là bài kiểm tra có thể xác lập độ chính xác phân tích tài liệu dài của DeepSeek V4.1 Flash cho trường hợp sử dụng của chính bạn.
Các câu hỏi thường gặp
Cửa sổ ngữ cảnh 1M token có nghĩa là mô hình có thể phân tích chính xác một tài liệu 1M token không?
Không. Nó mô tả dung lượng ngữ cảnh được hỗ trợ. Yêu cầu thực tế cũng bao gồm hướng dẫn và ngân sách đầu ra, trong khi việc trích xuất, giới hạn giao diện và độ khó của câu hỏi ảnh hưởng đến việc bằng chứng hữu ích có sẵn và được diễn giải đúng hay không.
LongBench-V2 có giống với độ chính xác hỏi đáp tài liệu không?
Không. Nó bao gồm một số hạng mục tác vụ ngữ cảnh dài và báo cáo hiệu suất trong một thiết lập cụ thể. Đó là tín hiệu so sánh, không phải bảo đảm cho một PDF, bản dựng API, lời nhắc hoặc lĩnh vực cụ thể.
Tôi nên dùng một lời nhắc hay chia một tài liệu dài thành các mục?
Dùng bản đồ nguồn và các câu hỏi tập trung khi cấu trúc quan trọng. Giữ các đoạn cần so sánh sẵn có cùng nhau cho bước tổng hợp, và giữ nguyên nhãn trang để bạn có thể xác minh phản hồi.
Tôi nên xác minh trích dẫn từ một bản tóm tắt do AI tạo như thế nào?
Mở từng trang được trích dẫn trong tệp gốc, kiểm tra trích dẫn và văn bản xung quanh, và xác nhận đoạn đó hỗ trợ cho tuyên bố cụ thể. Xác minh tiêu đề bảng và chú thích cuối trang cũng như câu được trích dẫn.
Token đầu vào và đầu ra ảnh hưởng đến chi phí như thế nào?
Token đầu vào bao gồm tài liệu, hướng dẫn và câu hỏi. Token đầu ra bao gồm câu trả lời. Lời nhắc dài hơn, nhiều lệnh gọi và các đoạn lặp lại làm tăng mức sử dụng; dùng số token được tính phí và bảng giá hiện tại của nhà cung cấp để ước tính.


