Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Mô hình mã nguồn mở nào thắng cho lập trình năm 2026
Câu trả lời ngắn gọn
Nếu bạn đang xây dựng một tác nhân lập trình tự động có thể chạy hàng giờ mà không cần can thiệp: Kimi K2.6. Mô hình này đạt 66,7% trên Terminal-Bench 2.0 và duy trì hơn 4.000 lần gọi công cụ trong một phiên làm việc liên tục 13 giờ theo các điểm chuẩn đã công bố — một giới hạn ổn định mà không mô hình mã nguồn mở nào khác trong so sánh này đạt được.
Nếu bạn cần nhà phát triển front-end dạng tác nhân tốt nhất: GLM 5.1. Điểm Elo Code Arena 1.530 được xác minh độc lập (đứng thứ ba toàn cầu về phát triển web dạng tác nhân) phản ánh sở thích thực tế của nhà phát triển trong các so sánh trực tiếp, không chỉ là các bài kiểm tra tự động.
Nếu chi phí mỗi token là yếu tố hạn chế: MiniMax M2.7 với giá $0,30/M token đầu vào trên Atlas Cloud đạt 56,22% trên SWE-Bench Pro với chỉ 10B tham số được kích hoạt — 94% hiệu suất của GLM-5.1 với chi phí chỉ bằng khoảng một phần năm.
Nếu cơ sở mã của bạn quá lớn so với cửa sổ ngữ cảnh 262K: Qwen 3.6 Plus, mô hình duy nhất ở đây hỗ trợ cửa sổ ngữ cảnh 1M token, và là người dẫn đầu về Terminal-Bench 2.0 với 61,6% trong nhóm này.
Các điểm chuẩn chính trong nháy mắt
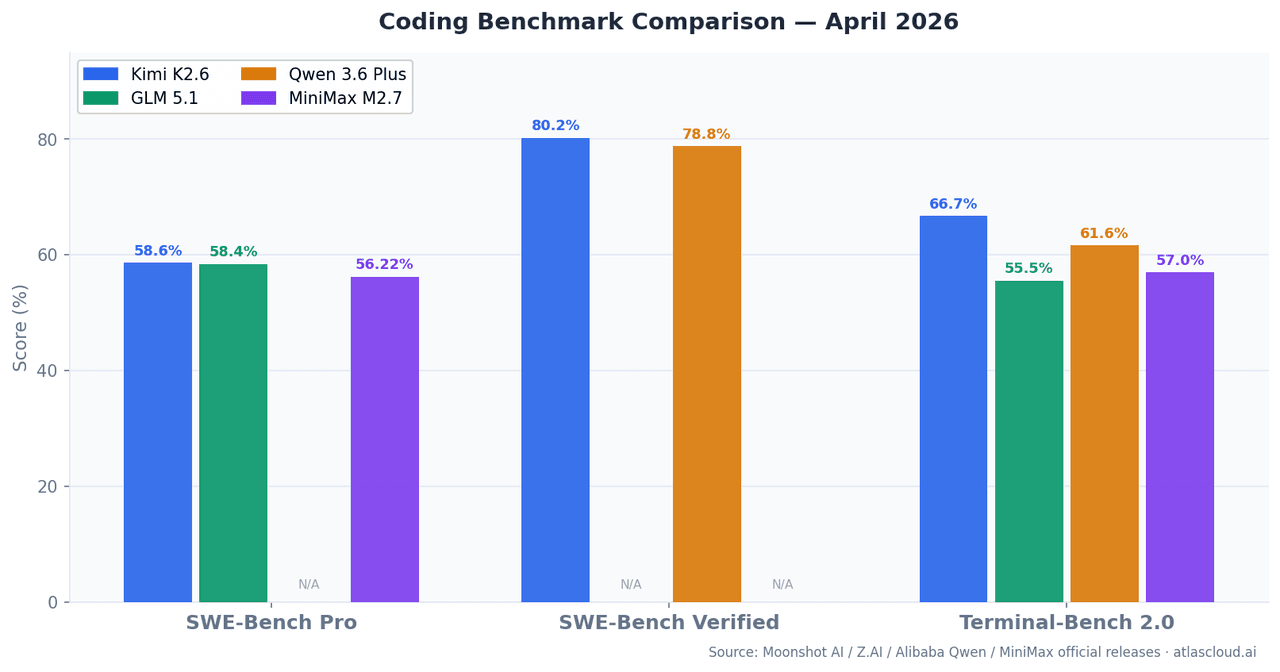
| Mô hình | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Cửa sổ ngữ cảnh | Tham số được kích hoạt |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro đo lường khả năng giải quyết các vấn đề GitHub thực tế được nộp sau khi huấn luyện mô hình, giảm rủi ro nhiễm dữ liệu so với SWE-Bench Verified. Terminal-Bench 2.0 kiểm tra các tác vụ CLI và shell đa bước trong môi trường terminal thực — gần hơn với những gì các tác nhân sản xuất thực sự làm.
Bài viết này cân nhắc Kimi K2.6, GLM 5.1, Qwen 3.6+ và MiniMax M2.7; để so sánh thêm nhiều mô hình cạnh nhau về giá cả và thông số kỹ thuật, hãy sử dụng công cụ so sánh mô hình Atlas Cloud.
Kimi K2.6: Được xây dựng cho các tác nhân chạy lâu dài
Moonshot AI phát hành Kimi K2.6 vào tháng 4 năm 2026 như một bản nâng cấp từ K2.5, với cải tiến chính là độ ổn định của tác nhân trong các phiên kéo dài. Với 80,2% trên SWE-Bench Verified, nó chỉ đứng dưới Claude Opus 4.6 (80,8%), và dẫn đầu bốn mô hình với 58,6% trên SWE-Bench Pro.
Con số quan trọng nhất là Terminal-Bench 2.0 ở 66,7%. Terminal-Bench 2.0 khác với SWE-Bench ở một điểm cơ bản: nó chạy các tác vụ trong môi trường terminal thực, yêu cầu mô hình đọc đầu ra, xử lý lỗi, thích ứng và lặp lại — không chỉ tạo các bản vá. Việc Kimi K2.6 duy trì hiệu suất qua hơn 4.000 lần gọi công cụ trong một phiên 13 giờ không phải là một hiện tượng trong phòng thí nghiệm. Đó là hành vi được ghi nhận trong bản phát hành kỹ thuật của Moonshot.
Một lợi thế ít được báo cáo: khả năng tổng quát hóa đa ngôn ngữ. Kimi K2.6 thể hiện hiệu suất nhất quán trên các tác vụ Rust, Go, Python, front-end và DevOps. Hầu hết các đánh giá điểm chuẩn đều nặng về Python. Nếu stack sản xuất của bạn đa ngôn ngữ, điều này rất quan trọng.
Khi nào nó không phải là câu trả lời: Với giá $0,95/M token đầu vào trên Atlas Cloud, K2.6 là mô hình đắt nhất về đầu vào trong nhóm này. Đối với các tác vụ xử lý hàng loạt khi bạn gửi nhiều yêu cầu với ngữ cảnh lớn nhưng không cần độ ổn định trong 12 giờ, chi phí sẽ tích lũy nhanh hơn so với MiniMax M2.7 hoặc Qwen 3.6 Plus.
GLM 5.1: Tác nhân front-end nổi bật
Z.AI ra mắt GLM-5.1 vào ngày 7 tháng 4 năm 2026. Với 754 tỷ tham số và định tuyến MoE, đây là mô hình lớn nhất ở đây về số lượng tham số thô. Trên SWE-Bench Pro, nó đạt 58,4% — không khác biệt đáng kể về mặt thống kê so với 58,6% của Kimi K2.6.
Điểm khác biệt là Code Arena Elo 1.530, được Arena.ai xác minh độc lập vào ngày 10 tháng 4 năm 2026, đưa nó lên vị trí thứ ba toàn cầu trên bảng xếp hạng phát triển web dạng tác nhân. Đây là một so sánh trực tiếp trực tiếp nơi các nhà phát triển thực tế bỏ phiếu cho đầu ra — không phải chấm điểm tự động. Lợi thế tập trung vào tạo giao diện người dùng front-end, scaffolding full-stack, tạo thành phần React/Vue và NL2Repo (tạo cấu trúc kho lưu trữ hoàn chỉnh từ ngôn ngữ tự nhiên).
Điều kiện biên cần biết: Lợi thế front-end của GLM-5.1 là có thật. Đối với các vấn đề thuật toán thuần túy trên HumanEval và MBPP, nó không có lợi thế đáng kể nào so với Kimi K2.6. Khoảng cách trên bảng xếp hạng thu hẹp xuống gần như bằng không đối với các vấn đề không liên quan đến UI hoặc web. Chọn GLM-5.1 chỉ dựa trên thứ hạng bảng xếp hạng tổng thể mà không kiểm tra lĩnh vực tác vụ sẽ là một sai lầm.
Định giá trên Atlas Cloud: Bắt đầu từ $1,40/M token đầu vào — cao nhất trong bốn mô hình. Chỉ hợp lý khi chất lượng tạo front-end ảnh hưởng trực tiếp đến đầu ra của bạn.
Qwen 3.6 Plus: Khi kích thước ngữ cảnh là ràng buộc thực sự
Alibaba phát hành Qwen 3.6 Plus vào cuối tháng 3 năm 2026. Nó dẫn đầu Terminal-Bench 2.0 trong các so sánh trực tiếp với Claude Opus 4.6 (61,6% so với 59,3%) và đạt 78,8% trên SWE-Bench Verified.
Cửa sổ ngữ cảnh 1M token là điều làm nên sự khác biệt. Đối với phần lớn các tác vụ lập trình sản xuất dưới 100K token, cả bốn mô hình trong so sánh này đều có đủ dung lượng ngữ cảnh và sự khác biệt là không đáng kể. Nơi Qwen 3.6 Plus trở thành lựa chọn khả thi duy nhất: phân tích monorepo trên hàng trăm tệp, tái cấu trúc cơ sở mã kế thừa quy mô lớn, hoặc quy trình làm việc từ tài liệu sang mã mà không thể nằm gọn trong 262K token.
Kiến trúc hybrid (chú ý tuyến tính + định tuyến MoE thưa thớt) cũng mang lại thông lượng suy luận tốt hơn so với các transformer dày đặc khi xử lý ngữ cảnh rất lớn — nghĩa là khả năng 1M token đi kèm với chi phí độ trễ tương đối thấp so với việc mở rộng quy mô đơn giản.
Định giá trên Atlas Cloud: Từ $0,325/M token đầu vào. Đối với các tác vụ ngữ cảnh lớn, đây là chi phí trên mỗi token hữu ích tốt nhất hiện có trong nhóm này.
MiniMax M2.7: Trường hợp phản trực giác cho hiệu quả
MiniMax phát hành M2.7 vào tháng 3 năm 2026. Với chỉ 10B tham số được kích hoạt, nó đạt 56,22% trên SWE-Bench Pro — 94% điểm số của GLM-5.1 với chi phí mỗi token chỉ bằng khoảng một phần năm.
Đây là kết quả phản trực giác trong so sánh này. Một mô hình kích hoạt 10B tham số tại suy luận đạt hiệu suất lập trình gần như biên giới bởi vì kiến trúc MoE của nó định tuyến đến các mạng con chuyên gia thay vì chạy toàn bộ trọng số mô hình. Kết quả là độ trễ thấp hơn, chi phí thấp hơn và chất lượng đầu ra vượt quá những gì mà số lượng tham số đơn thuần dự đoán.
Danh mục mà M2.7 vượt trội so với mức giá của nó: các tác vụ kỹ thuật machine learning. Nó đạt tỷ lệ huy chương 66,6% trên MLE-Bench Lite (22 cuộc thi machine learning), chỉ đứng sau các mô hình nguồn đóng biên giới. Viết logic tích lũy gradient chính xác, triển khai các lớp PyTorch tùy chỉnh, gỡ lỗi đường cong mất mát — M2.7 xử lý những việc này với độ chính xác không tương xứng với chi phí của nó.
Nơi cần cẩn thận: Với ngữ cảnh 196K, M2.7 có cửa sổ nhỏ nhất trong nhóm này. Các tác vụ yêu cầu phân tích sâu giữa các tệp trong kho lưu trữ lớn có thể gặp giới hạn mà Qwen 3.6 Plus xử lý dễ dàng.
Định giá trên Atlas Cloud: $0,30/M token đầu vào, $1,20/M token đầu ra — lựa chọn hợp lý nhất cho khối lượng công việc lập trình thông lượng cao.
Các trường hợp kiểm tra lập trình thực tế
Trường hợp 1: Sửa lỗi tự động trong backend Python
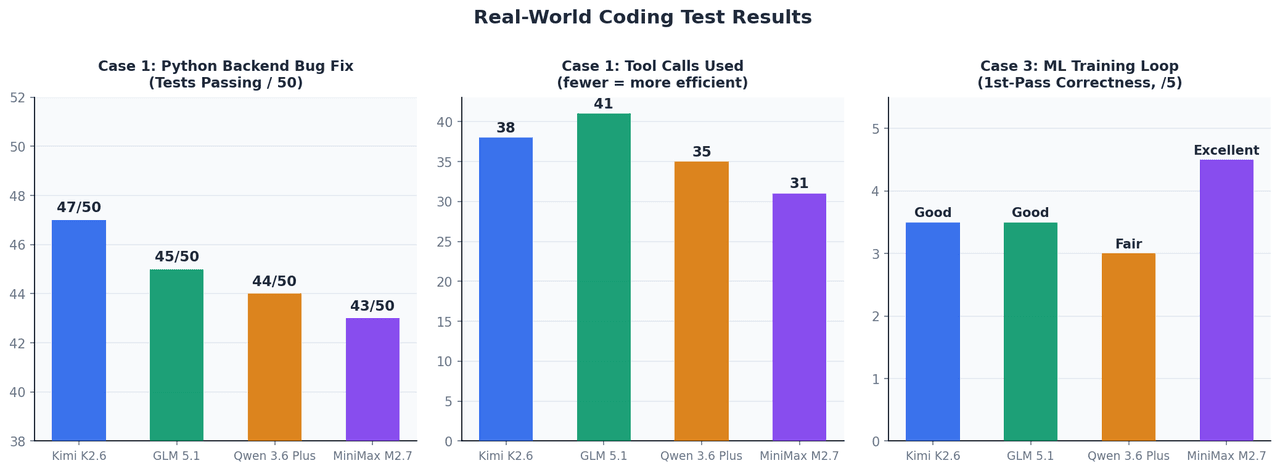
Thiết lập: Một ứng dụng FastAPI với 12 tệp, một bộ kiểm thử 50 bài kiểm tra bị lỗi và cửa sổ ngữ cảnh ~45K token. Không được can thiệp thủ công sau lời nhắc ban đầu.
| Mô hình | Bài kiểm tra đạt sau khi sửa | Số lần gọi công cụ | Thời gian hoàn thành |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 phút |
| GLM 5.1 | 45 / 50 | 41 | ~5 phút |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 phút |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 phút |
Ở kích thước ngữ cảnh này, cả bốn mô hình đều hoạt động trong một phạm vi hẹp. Kimi K2.6 vượt lên một chút ở các lỗi khó nhất — cụ thể là các vấn đề về vòng đời của trình quản lý ngữ cảnh bất đồng bộ và thu hẹp ràng buộc TypeVar, đòi hỏi duy trì trạng thái suy luận qua nhiều chu kỳ gỡ lỗi.
Trường hợp 2: Bảng điều khiển React từ đặc tả
Thiết lập: Tạo một bảng điều khiển phản hồi hoàn chỉnh với bốn loại biểu đồ (đường, cột, tròn, phân tán), chuyển đổi chế độ tối và kiểu TypeScript từ một đặc tả tiếng Anh viết tay.
GLM-5.1 tạo ra các thành phần được nhập TypeScript hoạt động với các lớp tiện ích Tailwind chính xác ngay lần đầu tiên. Kimi K2.6 cần một lần lặp để giải quyết lỗi kiểu. Qwen 3.6 Plus tạo ra JSX đúng về mặt chức năng nhưng ít thành ngữ hơn. MiniMax M2.7 nhanh nhất nhưng tạo ra một số mẫu React lỗi thời cần dọn dẹp thủ công.
Khoảng cách giữa GLM-5.1 và các mô hình khác rõ ràng nhất ở kiến trúc thành phần — GLM-5.1 tự động áp dụng các mẫu tổng hợp và phân tách mối quan tâm theo cách mà các mô hình khác không làm được.
Trường hợp 3: Triển khai vòng lặp huấn luyện ML
Thiết lập: Triển khai một vòng lặp huấn luyện PyTorch với tích lũy gradient, AMP mixed precision và dừng sớm cho một vision transformer. Mục tiêu: chạy chính xác ngay lần đầu tiên mà không cần các chu kỳ gỡ lỗi.
MiniMax M2.7 nổi bật — nó đặt scaler.step() và scaler.update() chính xác so với bước tối ưu hóa, một chi tiết mà hầu hết các mô hình đặt sai trong lần tạo đầu tiên. Việc chia tỷ lệ loss / accumulation_steps cho tích lũy gradient cũng được xử lý đúng cách. Điều này phù hợp trực tiếp với tỷ lệ huy chương 66,6% MLE-Bench Lite của nó.
So sánh giá trên Atlas Cloud (tháng 4 năm 2026)
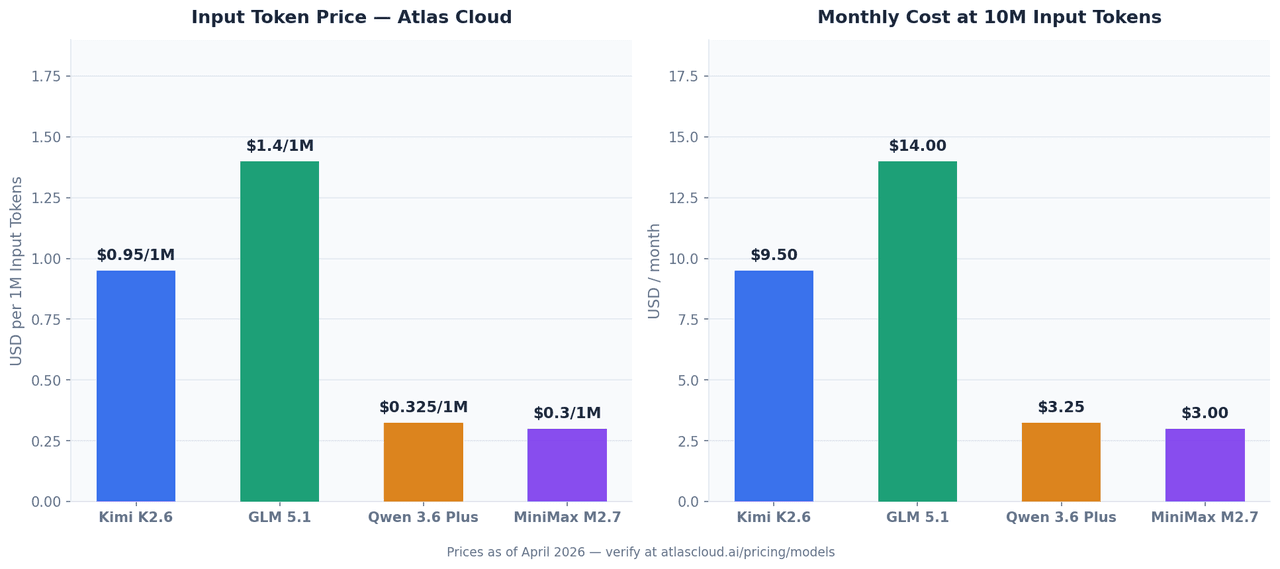
Tất cả bốn mô hình đều có sẵn thông qua API thống nhất của Atlas Cloud. Giá dưới đây là vào tháng 4 năm 2026 và có thể thay đổi — xác nhận tỷ giá hiện tại tại atlascloud.ai.
| Mô hình | Đầu vào (mỗi 1M token) | Đầu ra (mỗi 1M token) | ID mô hình Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | từ $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | từ $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
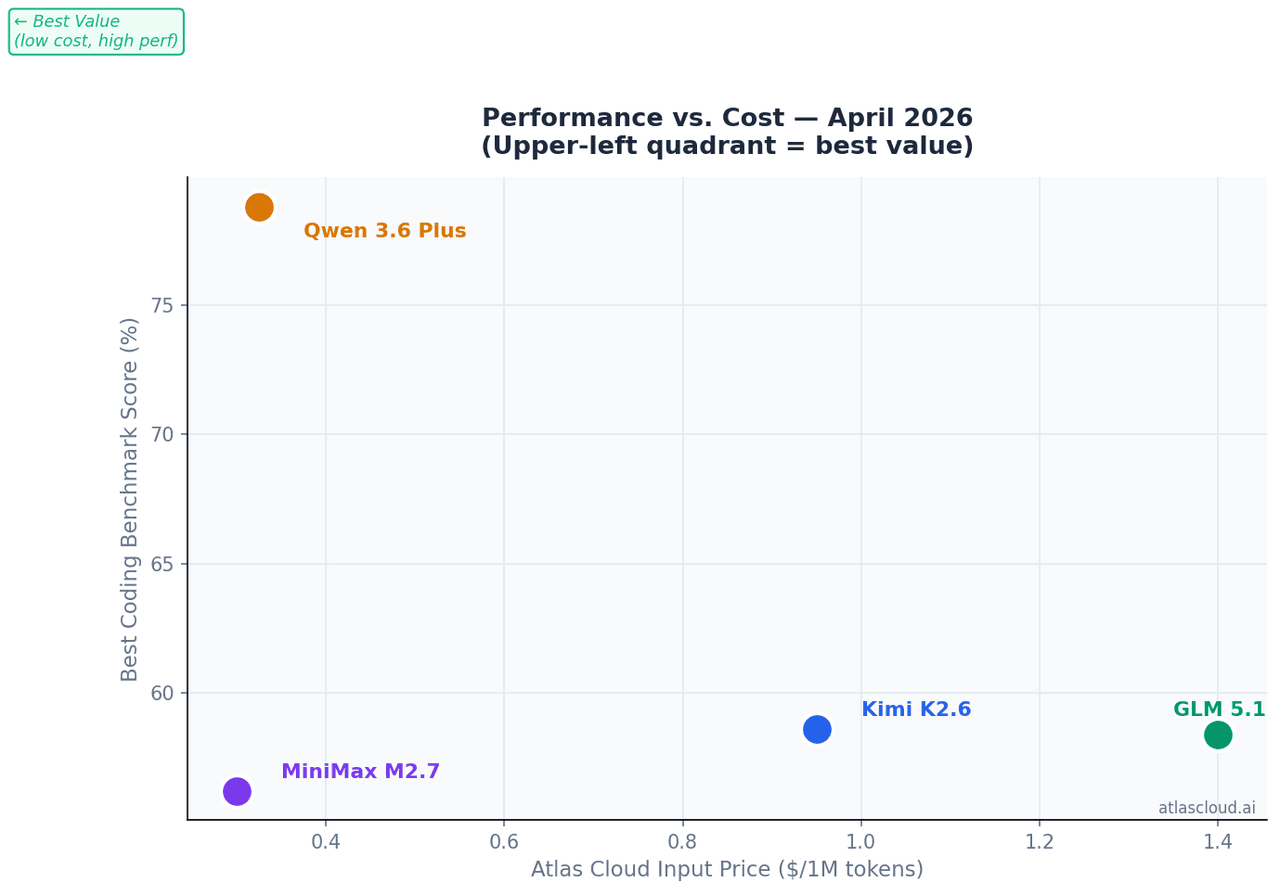
Với 10M token đầu vào mỗi tháng — một khối lượng thực tế cho một trợ lý lập trình cấp độ nhóm:
| Mô hình | Chi phí đầu vào hàng tháng (10M token) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Gọi cả bốn mô hình với một khóa API
Tất cả bốn mô hình đều chia sẻ cùng một điểm cuối tương thích với OpenAI trên Atlas Cloud. Việc chuyển đổi giữa chúng chỉ cần thay đổi một dòng:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Thay đổi dòng này để chuyển đổi mô hình 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Bạn là một kỹ sư phần mềm cao cấp. Hãy phân tích mã cẩn thận trước khi trả lời." 21 }, 22 { 23 "role": "user", 24 "content": "Hãy xem xét hàm này và xác định tất cả các lỗi:\n\n[dán mã của bạn vào đây]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Cấu trúc tương thích với OpenAI này có nghĩa là các tích hợp hiện có được xây dựng trên SDK OpenAI sẽ hoạt động với Atlas Cloud mà không cần sửa đổi — chỉ thay đổi base_url và api_key.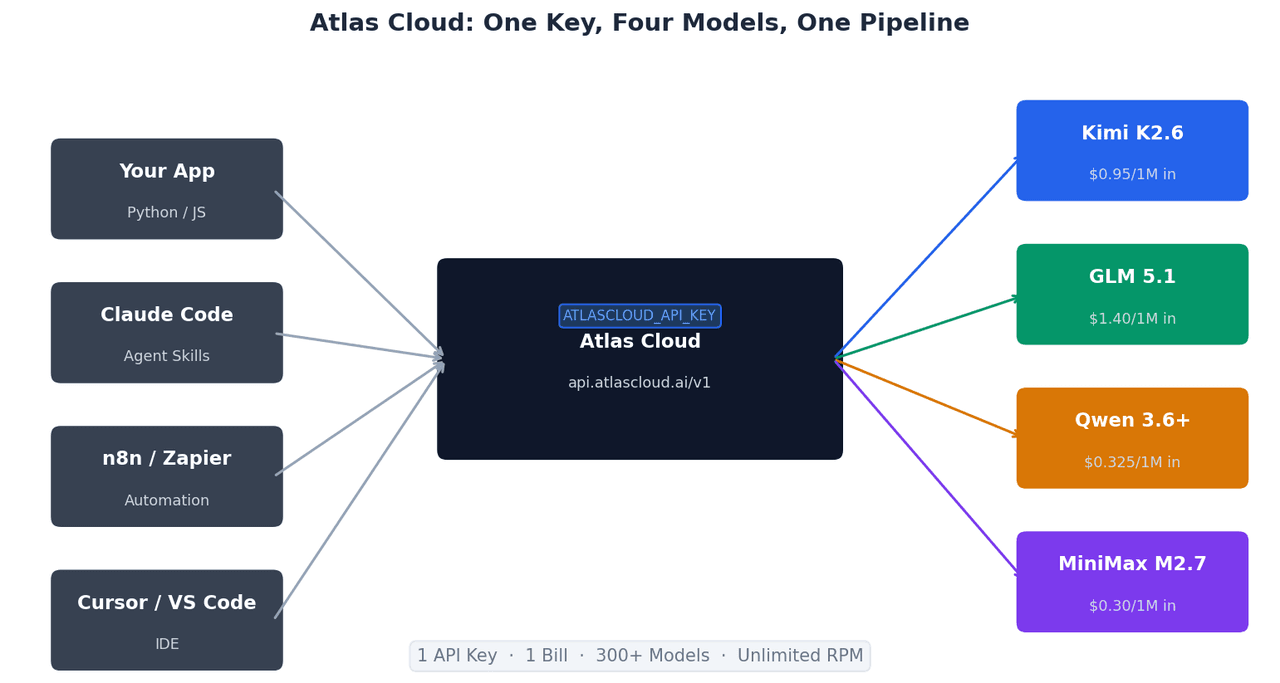
Tại sao nên sử dụng Atlas Cloud cho các mô hình này
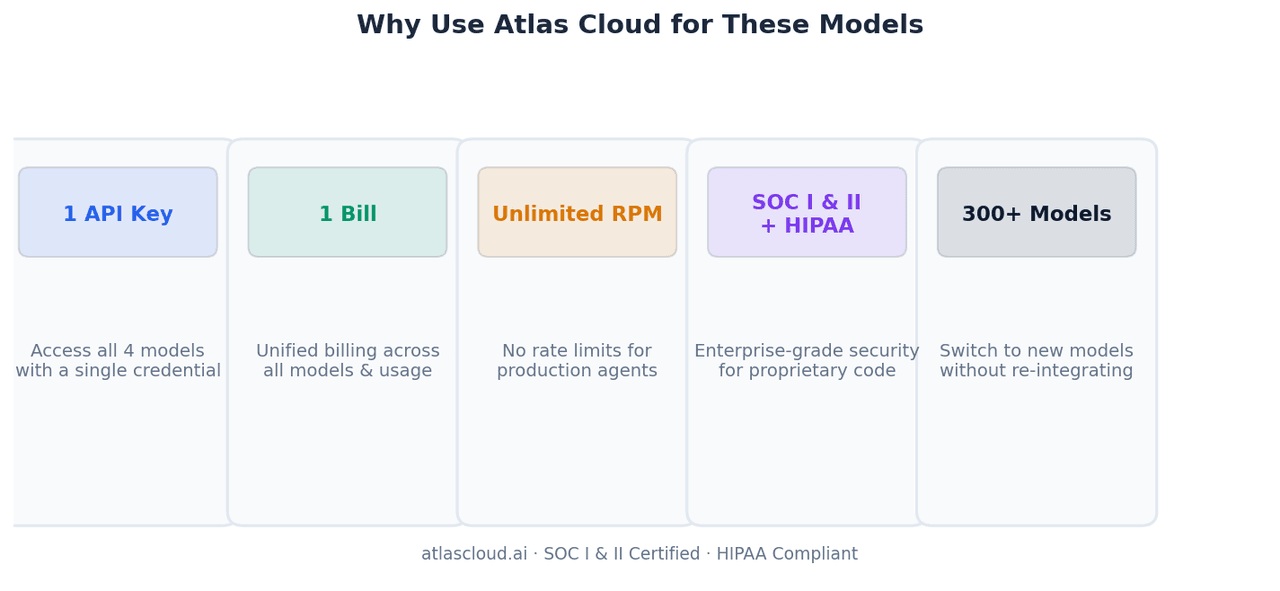
Một khóa API, bốn mô hình, một hóa đơn. Việc chạy logic định tuyến mô hình — gửi tác vụ front-end đến GLM-5.1, phân tích hàng loạt đến MiniMax M2.7 và các tác nhân dài hạn đến Kimi K2.6 — chỉ cần quản lý một thông tin xác thực thay vì bốn. Đối chiếu hàng tháng là một hóa đơn duy nhất.
RPM không giới hạn. Các tác nhân lập trình sản xuất gọi công cụ song song. Giới hạn tốc độ trên các API của nhà cung cấp trực tiếp có thể làm chậm các pipeline đa tác nhân. Atlas Cloud loại bỏ giới hạn đó.
Chứng nhận SOC I & II, tuân thủ HIPAA. Các nhóm xử lý mã nguồn độc quyền thông qua các mô hình này cần cơ sở hạ tầng có thể kiểm toán. Các chứng nhận tuân thủ của Atlas Cloud đảm bảo mã của bạn không đi qua các điểm cuối chưa được xác minh.
Hơn 300 mô hình, cùng một mẫu tích hợp. Khi phiên bản tiếp theo của bất kỳ mô hình nào trong số này được phát hành, hoặc một mô hình mới vượt trội hơn chúng trên khối lượng công việc cụ thể của bạn, việc thêm nó vào logic định tuyến của bạn chỉ cần một thay đổi chuỗi — không phải tích hợp SDK mới.
Mô hình nào cho tác vụ nào
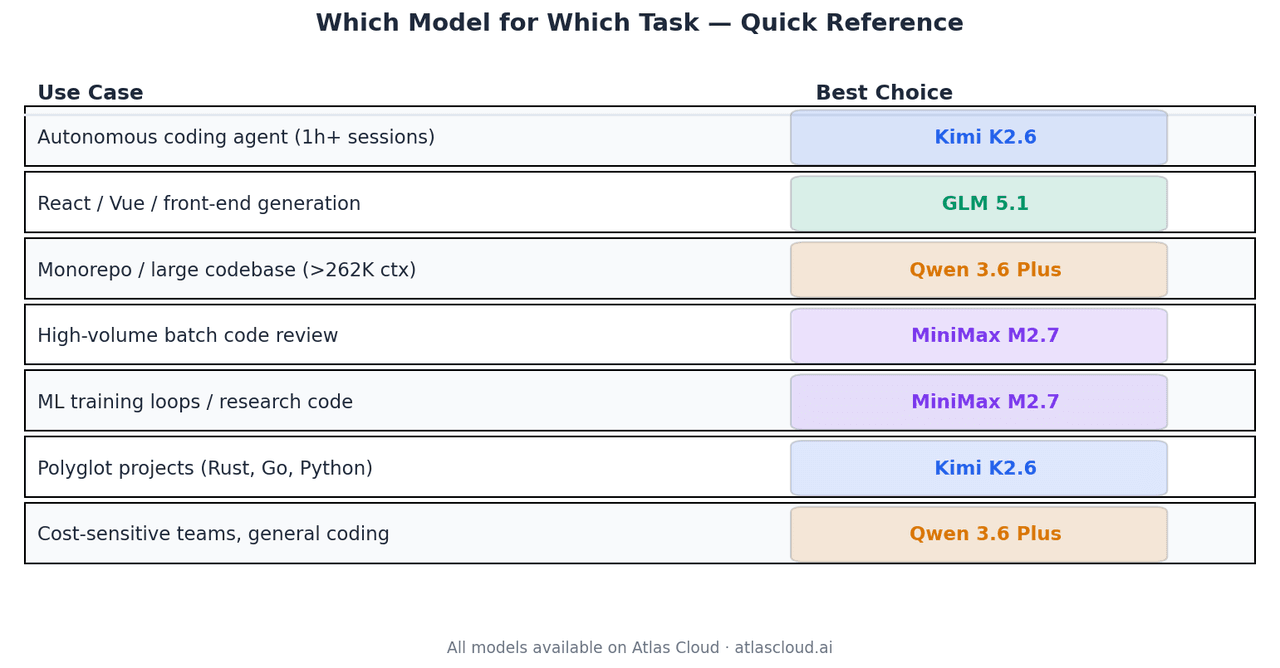
| Trường hợp sử dụng | Lựa chọn tốt nhất | Tại sao |
| Tác nhân lập trình tự động, phiên 1+ giờ | Kimi K2.6 | 66,7% Terminal-Bench 2.0, độ ổn định 4K+ lần gọi công cụ |
| Tạo React / Vue / front-end | GLM 5.1 | Code Arena Elo 1.530, top-3 phát triển web dạng tác nhân toàn cầu |
| Phân tích monorepo hoặc cơ sở mã lớn | Qwen 3.6 Plus | Mô hình duy nhất ở đây có cửa sổ ngữ cảnh 1M |
| Đánh giá mã hàng loạt khối lượng lớn | MiniMax M2.7 | $0,30/M đầu vào, 94% chất lượng của GLM-5.1 |
| Vòng lặp huấn luyện ML, mã nghiên cứu | MiniMax M2.7 | Tỷ lệ huy chương MLE-Bench Lite 66,6% |
| Dự án đa ngôn ngữ (Rust, Go, Python) | Kimi K2.6 | Khả năng tổng quát hóa đa ngôn ngữ đã được ghi nhận |
| Nhóm nhạy cảm về chi phí, lập trình chung | Qwen 3.6 Plus | $0,325/M đầu vào, mạnh ở tất cả các danh mục |
Tóm tắt
Bốn mô hình này bị ngăn cách bởi các biên độ hẹp trên các điểm chuẩn tiêu chuẩn. Sự khác biệt có ý nghĩa xuất hiện trong các điều kiện cụ thể.
Kimi K2.6 là câu trả lời đúng cho các tác nhân tự động chạy lâu dài. GLM 5.1 dẫn đầu cho công việc front-end dạng tác nhân. Qwen 3.6 Plus là lựa chọn duy nhất khi ngữ cảnh vượt quá 262K token. MiniMax M2.7 là lựa chọn mặc định hiệu quả về chi phí cho các nhóm chạy mô hình lập trình ở quy mô lớn.
Tất cả bốn mô hình đều có sẵn trên Atlas Cloud tại atlascloud.ai với một khóa API duy nhất, định giá theo token và không có cam kết tối thiểu.
Dữ liệu điểm chuẩn được lấy từ blog kỹ thuật của Moonshot AI, tài liệu dành cho nhà phát triển của Z.AI, bài đăng phát hành của nhóm Qwen Alibaba, trang mô hình chính thức của MiniMax và các đánh giá độc lập của Arena.ai. Tất cả các điểm chuẩn đều là dữ liệu tháng 4 năm 2026. Giá Atlas Cloud được ghi nhận tại thời điểm xuất bản — xác minh tỷ giá hiện tại trước khi triển khai sản xuất.


