Các pipeline agentic trong production thường xuyên gặp sự cố do vi phạm schema ngoài dự kiến. Ngay cả các LLM autoregressive hàng đầu cũng thất bại khi phân tích cú pháp JSON trong các lệnh gọi công cụ khối lượng lớn, buộc nhà phát triển phải xây dựng vòng lặp thử lại phức tạp và trình xử lý lỗi tùy chỉnh.
TypeSafe Jev giải quyết lỗ hổng cấu trúc này bằng cách từ bỏ hoàn toàn việc sinh tuần tự từng token. Hoạt động như một mô hình quyết định phi autoregressive, Jev tiếp nhận trạng thái ứng dụng và đánh giá các câu hỏi schema được khai báo trước trong một forward pass song song duy nhất. Vì các lựa chọn đầu ra có thể có được giới hạn chặt chẽ trước khi thực thi, Jev loại bỏ về mặt toán học JSON sai định dạng, tên công cụ không hợp lệ và văn bản ngoài schema.
Tóm tắt nhanh: TypeSafe Jev AI là gì? Các benchmark về hiệu năng & tốc độ
TypeSafe Jev AI là một mô hình quyết định phi autoregressive được xây dựng riêng cho phân loại dưới một giây, chấm điểm ý định và định tuyến microservice có cấu trúc. Khác với LLM autoregressive, Jev đánh giá các lựa chọn schema được khai báo trước trong một forward pass duy nhất.
- Không ảo giác ở cấp kiểu: Thay thế vòng lặp giải mã chuỗi bằng các primitive schema trạng thái có giới hạn, đạt tỷ lệ lỗi kiểu 0%.
- Thực thi dưới 500ms: Lấy mẫu song song phi autoregressive đạt độ trễ P95 70ms–500ms, nhanh hơn LLM tiêu chuẩn tới 200 lần.
- Token đầu ra miễn phí: Không sinh token tuần tự nghĩa là token đầu ra hoàn toàn miễn phí $0.042/1M token đầu vào.
- Phù hợp nhất cho: Định tuyến microservice, điều phối công cụ agentic, phân loại ticket và chặn ý định.
Suy nghĩ lại về ngăn xếp AI: Trực giác System 1 so với Lập luận System 2
Khi thiết kế phần mềm backend có khả năng mở rộng, việc buộc các kiểm tra điều kiện đơn giản đi qua một endpoint chat completion nặng nề tạo ra độ trễ hệ thống nghiêm trọng. Hầu hết microservice không cần văn xuôi sáng tạo hay sinh chuỗi suy luận nhiều bước; chúng cần lựa chọn tức thời, mang tính tất định trên các lựa chọn đã biết.
Áp dụng khung nhận thức Kahneman vào kiến trúc phần mềm
Đồng sáng lập TypeSafe, Diogo Almeida, người trước đây đồng sáng tạo Reinforcement Learning from Human Feedback tại OpenAI, đã giới thiệu một bước chuyển cấu trúc với TypeSafe Jev để giải quyết sự kém hiệu quả này. Lấy trực tiếp từ khung nhận thức Kahneman, nền tảng chia xử lý thành hai lớp vận hành riêng biệt trong kiến trúc ngăn xếp AI hiện đại:
- System 2 — Lập luận chậm, có chủ đích: Các LLM autoregressive tiêu chuẩn hoạt động qua sinh tuần tự từng token. Những mô hình này xuất sắc trong việc soạn tài liệu dài, xử lý lập luận mơ hồ và viết mã phức tạp.
- System 1 — Quyết định nhanh, trực giác: Một mô hình AI System One chuyên dụng được huấn luyện bằng Reinforcement Learning for Calibrated Decisions thay vì RLHF truyền thống. Nó được thiết kế riêng cho phân loại dưới một giây, chấm điểm ý định và định tuyến thực thi mà không có chi phí hội thoại.
Jev so với LLM về chi phí & kiến trúc: Mô hình quyết định so với mô hình chat
Thay thế các mô hình chat đa dụng bằng các mô hình quyết định có kiểu chuyên dụng tối ưu hóa căn bản quy trình microservice bằng cách tách đánh giá nhanh khỏi sinh sâu.
| Khía cạnh kiến trúc | LLM autoregressive (System 2) | TypeSafe Jev (System 1) |
| Tác vụ chính | Tổng hợp văn bản mở | Lựa chọn rời rạc và đánh giá schema |
| Độ trễ thực thi | 3.000ms đến 30.000ms+ | 70ms đến 500ms |
| Định dạng đầu ra | Luồng văn bản phi cấu trúc | Primitive schema được định kiểu chặt chẽ |
| Vòng lặp tính toán | Giải mã token tuần tự | Đánh giá một forward pass duy nhất |
| Mục tiêu huấn luyện | Sở thích con người (RLHF) | Độ tin cậy quyết định được hiệu chỉnh (RLCD) |
Việc giảm tải định tuyến, guardrail an toàn và điều phối hàm khỏi các mô hình chat tiêu chuẩn giải quyết các nút thắt hiệu năng vốn có của LLM autoregressive. Tích hợp một mô hình AI System One đảm bảo các engine lập luận nặng chỉ kích hoạt khi thực sự cần sinh mở.
Cách mô hình TypeSafe Jev đạt mức không ảo giác ở cấp kiểu
Ngay cả khi bật chế độ JSON nghiêm ngặt, các LLM tiên tiến vẫn thường trả về khóa ngoài schema hoặc giá trị enum bị ảo giác trong các lượt chạy production có độ đồng thời cao, khiến 0,5% đến 5% yêu cầu pipeline thất bại. Microservice production yêu cầu tính tất định kiểu tuyệt đối, nhưng các mô hình autoregressive vẫn dễ bị lỗi sinh chuỗi về bản chất.
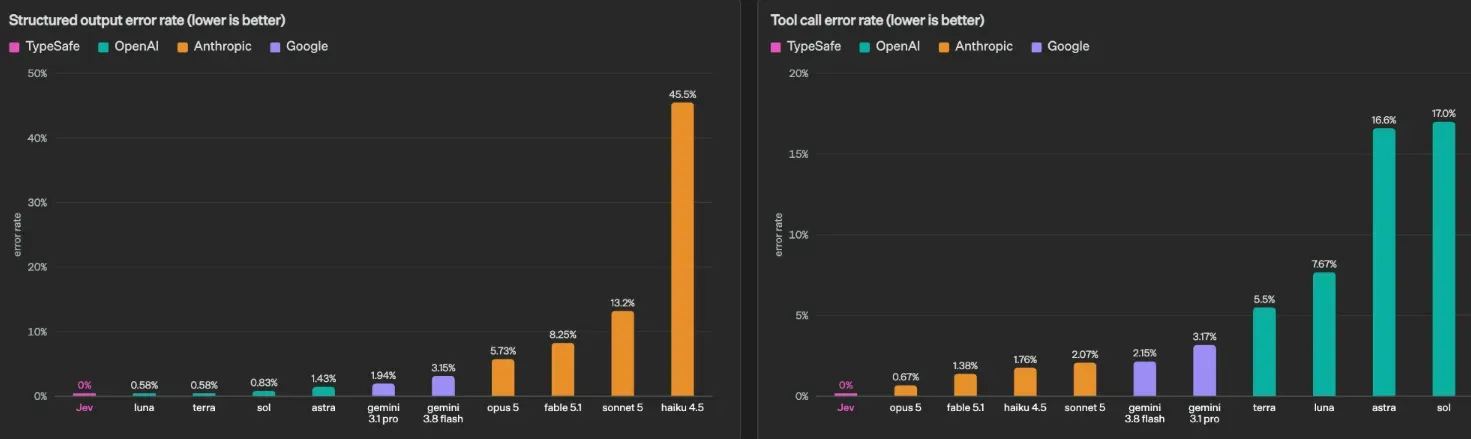
TypeSafe Jev giải quyết vấn đề này bằng cách thay thế vòng lặp giải mã chuỗi bằng kiến trúc trạng thái có giới hạn. Thay vì sinh văn bản tùy ý và cố ép nó vào cú pháp JSON, Jev đánh giá dữ liệu đầu vào dựa trên các ràng buộc schema được định trước trong một lượt duy nhất. Sự chuyển dịch cấu trúc này mang lại AI không ảo giác thực sự ở cấp kiểu, dẫn đến 0% lỗi kiểu trong các workflow tự động.
Ba primitive schema cốt lõi
Jev xử lý mọi câu hỏi đầu vào thông qua ba primitive rõ ràng:
- Primitive Choice: Chọn chính xác một tùy chọn từ danh sách định trước gồm tối đa 255 lựa chọn phân loại, trả về nhãn thắng cùng phân bố xác suất đầy đủ.
- Primitive Score: Đánh giá đầu vào theo thang số có thứ tự hoặc rubric mô tả, cung cấp xếp hạng cùng phân bố xác suất trên từng mức.
- Primitive Noul: Tính xác suất chính xác của điều kiện có/không dưới dạng số thực từ 0.0 đến 1.0, loại bỏ phần giải thích văn bản trung gian.
Vì mọi truy vấn ánh xạ chặt chẽ tới ba primitive này, engine thực thi không thể phát ra khóa không hợp lệ, tên công cụ ngoài danh sách hoặc payload sai định dạng.
An toàn kiểu trong đánh giá đầu ra có cấu trúc
Các mô hình chat truyền thống sinh cú pháp từng ký tự, tạo ra rủi ro phân tích cú pháp liên tục trong pipeline backend.
| Chỉ số đánh giá | Chế độ JSON autoregressive | TypeSafe Jev System One |
| Cưỡng chế kiểu đầu ra | Kiểm tra chuỗi sau sinh | Primitive gốc bị chặn bằng toán học |
| Tần suất lỗi kiểu | Thay đổi (tỷ lệ thất bại 0,5% đến 5%+) | 0% lỗi kiểu (bị chặn bởi schema) |
| Rủi ro enum không hợp lệ | Cao nếu không có vòng lặp thử lại tùy chỉnh | Bằng không (bất khả thi theo thiết kế) |
Giới hạn thực thi mô hình nghiêm ngặt trong một trạng thái có giới hạn đảm bảo đánh giá đầu ra có cấu trúc đáng tin cậy. Ứng dụng tiêu thụ đầu ra của Jev trực tiếp mà không cần viết trình xử lý ngoại lệ cho schema JSON hỏng.
Lưu ý về tính tất định kiểu so với xác suất: TypeSafe Jev đảm bảo 0% lỗi kiểu và khớp schema theo thiết kế, loại bỏ về mặt toán học cú pháp sai định dạng, khóa bị thiếu và giá trị enum ngoài danh sách. Tuy nhiên, như mọi mô hình quyết định, các lựa chọn đầu ra của nó vẫn mang tính xác suất. Với đầu vào vốn dĩ mơ hồ, nên dùng điểm tin cậy để chặn thực thi thay vì giả định độ chắc chắn ngữ nghĩa tuyệt đối.
Cách lấy mẫu song song phi autoregressive mang lại độ trễ dưới 500ms và đầu ra miễn phí
Việc dùng các endpoint chat tiêu chuẩn cho những thẻ phân loại đơn giản như {"category": "billing"} tạo ra độ trễ không cần thiết trong microservice production. Vì mô hình autoregressive phụ thuộc vào giải mã token tuần tự, các luồng backend vẫn bị chặn trong khi chờ vòng lặp sinh từng ký tự.
Cơ chế đánh giá một lượt
Các transformer truyền thống thực thi vòng lặp sinh autoregressive, trong đó mỗi token mới yêu cầu một lượt riêng qua ngăn xếp mạng. Sự phụ thuộc tuần tự này tạo ra độ trễ cao và làm tăng chi phí hạ tầng dựa trên khối lượng token được sinh.
TypeSafe Jev loại bỏ sinh tuần tự bằng cách sử dụng lấy mẫu song song phi autoregressive. Như đã nêu trong thông báo ra mắt TypeSafe, Jev tiếp nhận trạng thái ngữ cảnh và đánh giá tất cả lựa chọn schema được khai báo trước đồng thời trong một forward pass duy nhất.
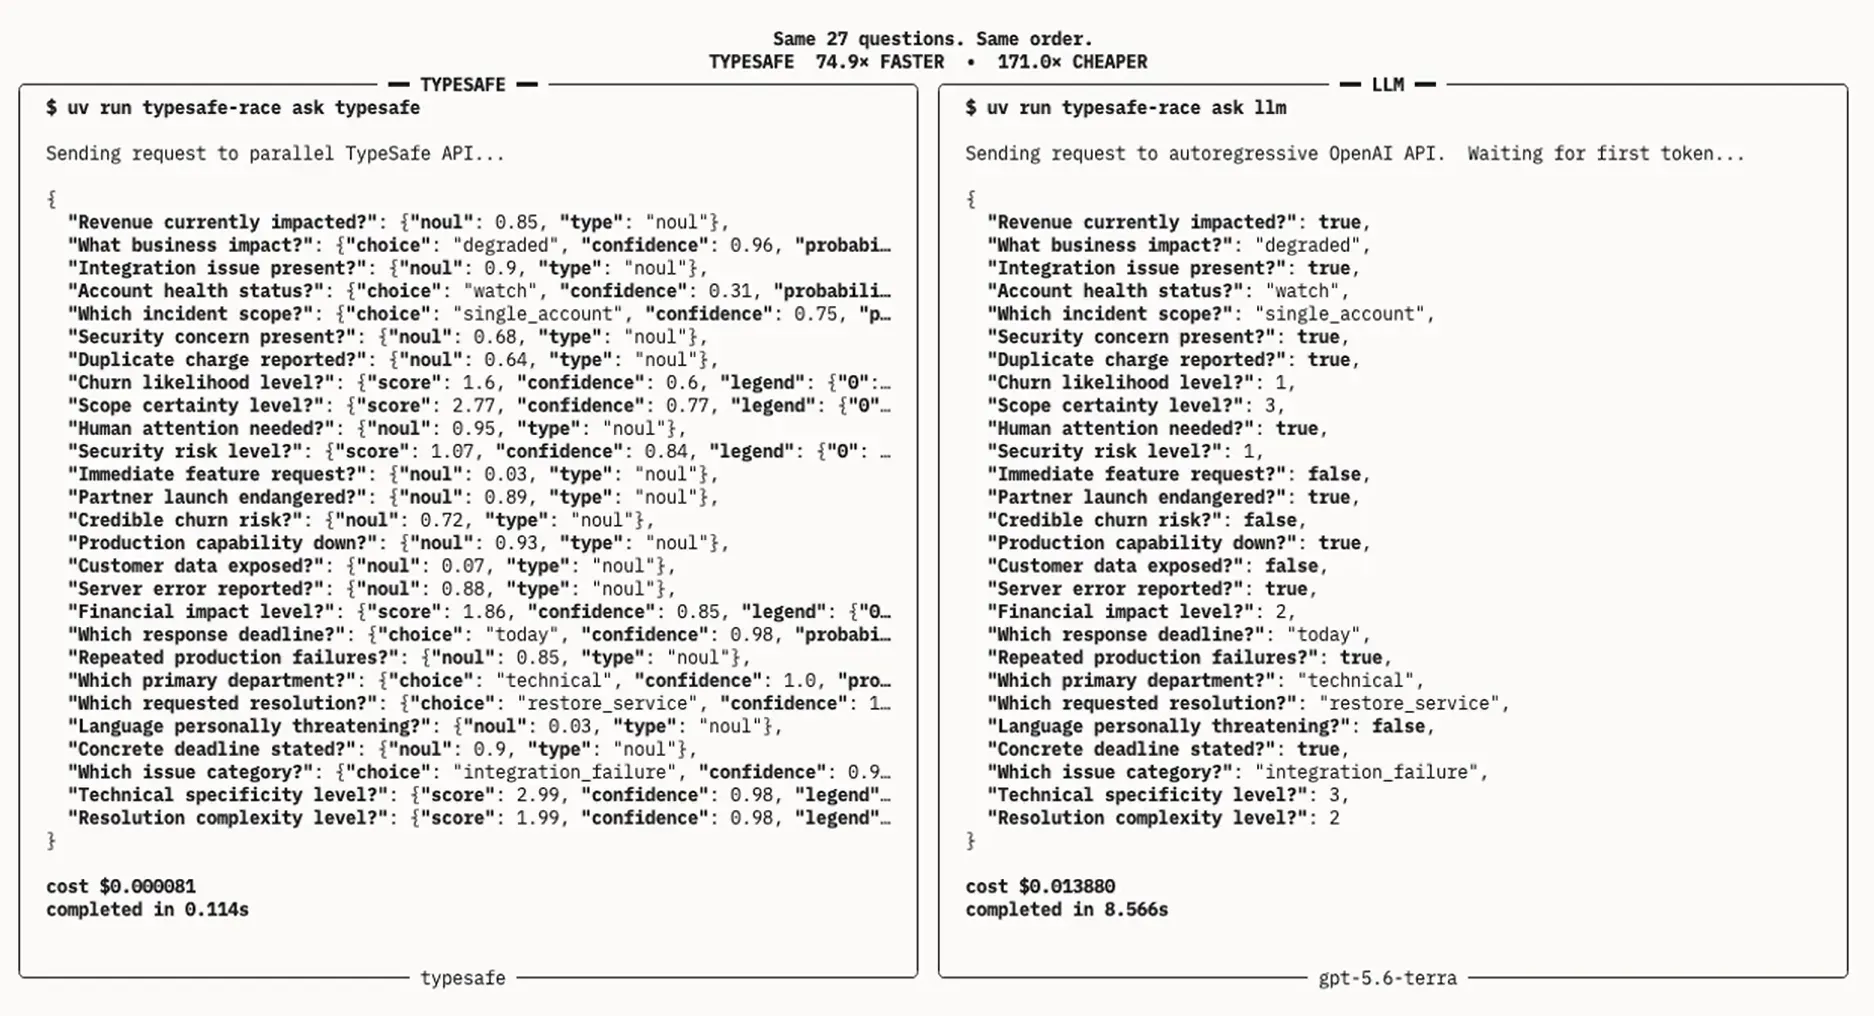
So sánh benchmark trên terminal chạy 27 câu hỏi đánh giá schema đồng thời trên TypeSafe Jev so với endpoint GPT 5.6 Terra
Vì mô hình tính phân bố xác suất trên các đầu ra được định trước thay vì sinh văn bản tự do, các vòng lặp giải mã đầu ra biến mất hoàn toàn. Sự chuyển dịch cấu trúc này mang lại ba lợi ích hiệu năng chính:
- **Token đầu ra miễn phí (quá rẻ để tính): **Vì Jev đánh giá các lựa chọn trong một forward pass duy nhất mà không sinh token tuần tự, việc đánh giá đầu ra gần như không tốn thêm tính toán, khiến token đầu ra thực tế miễn phí.
- Định giá dễ dự đoán: Xử lý ngữ cảnh có chi phí cố định $0.042 mỗi triệu token đầu vào. Đánh giá schema prompt tĩnh bằng Jev ngăn chặn hóa đơn API tăng theo cấp số nhân so với chi phí xử lý ngữ cảnh dài truyền thống gắn với các endpoint chat nặng.
- Thực thi dưới một giây: Các benchmark độ trễ TypeSafe Jev đã công bố cho thấy thời gian phản hồi P95 luôn trong khoảng 70ms đến 500ms, nhanh hơn tới 200 lần so với các mô hình chat tiên tiến.
Phân tích hiệu năng kiến trúc
| Chỉ số / Khía cạnh | LLM autoregressive truyền thống (System 2) | Engine TypeSafe Jev System One |
| Vòng lặp thực thi | Giải mã tuần tự từng token | Một lượt song song trên schema được khai báo trước |
| Kiểu đầu ra | Chuỗi văn bản phi cấu trúc / chuỗi JSON | Primitive quyết định có kiểu (Choice, Score, Noul) |
| Tỷ lệ lỗi schema | 0,58% đến 45%+ tùy mô hình/prompt | Tỷ lệ lỗi kiểu 0% (bị chặn bằng toán học) |
| Hồ sơ độ trễ P95 | 3.000ms đến 30.000ms+ | 70ms đến 500ms |
| Chi phí đầu ra | Thay đổi theo token ($15 đến $60 / MTok) | MIỄN PHÍ (quá rẻ để tính) Không sinh token đầu ra tuần tự |
| Lĩnh vực chính | Lập luận, viết bản nháp, tổng hợp mở | Phân loại, chọn công cụ, chặn theo độ tin cậy |
Vượt qua nút thắt băng thông bộ nhớ
Trong suy luận LLM tiêu chuẩn, băng thông bộ nhớ bão hòa khi trọng số mô hình được nạp lại vào logic bộ nhớ cho từng token. Bằng cách hoàn thành đánh giá quyết định trong một forward pass duy nhất, Jev né tránh hoàn toàn nút thắt bộ nhớ này, duy trì tốc độ phản hồi ổn định ngay cả dưới lưu lượng đồng thời cao.
Học tăng cường cho các quyết định được hiệu chỉnh và cổng tin cậy
Các mô hình chat tiêu chuẩn thường xuyên đưa ra phát biểu sai với độ tin cậy tự báo cáo 99% vì tinh chỉnh thông thường thưởng cho cách diễn đạt thuyết phục thay vì sự thật thống kê. Trong microservice production, một quyết định sai đầy tự tin dẫn trực tiếp đến bản ghi cơ sở dữ liệu bị hỏng, đối số công cụ bị lỗi và thời gian ngừng hệ thống ngoài dự kiến.
Căn chỉnh độ tin cậy của mô hình với độ chính xác thực nghiệm
Để giải quyết tình trạng quá tự tin mang tính cấu trúc này, TypeSafe đã giới thiệu Học tăng cường cho các quyết định được hiệu chỉnh. Khác với phương pháp RLHF truyền thống tối ưu hóa theo sở thích chủ quan của con người, RLCD huấn luyện các mô hình quyết định cụ thể để tạo ra xác suất được hiệu chỉnh.
Thông qua độ tin cậy căn chỉnh theo độ chính xác, đầu ra xác suất 0.90 từ Jev nghĩa là lựa chọn ứng viên đúng về mặt thực nghiệm 90% thời gian trên các tập kiểm thử. Hiệu chỉnh toán học này cho phép ra quyết định xác suất đáng tin cậy mà không yêu cầu nhà phát triển viết heuristic prompt phức tạp để ước lượng độ chắc chắn của đầu ra.
Triển khai định tuyến theo cổng tin cậy trong production
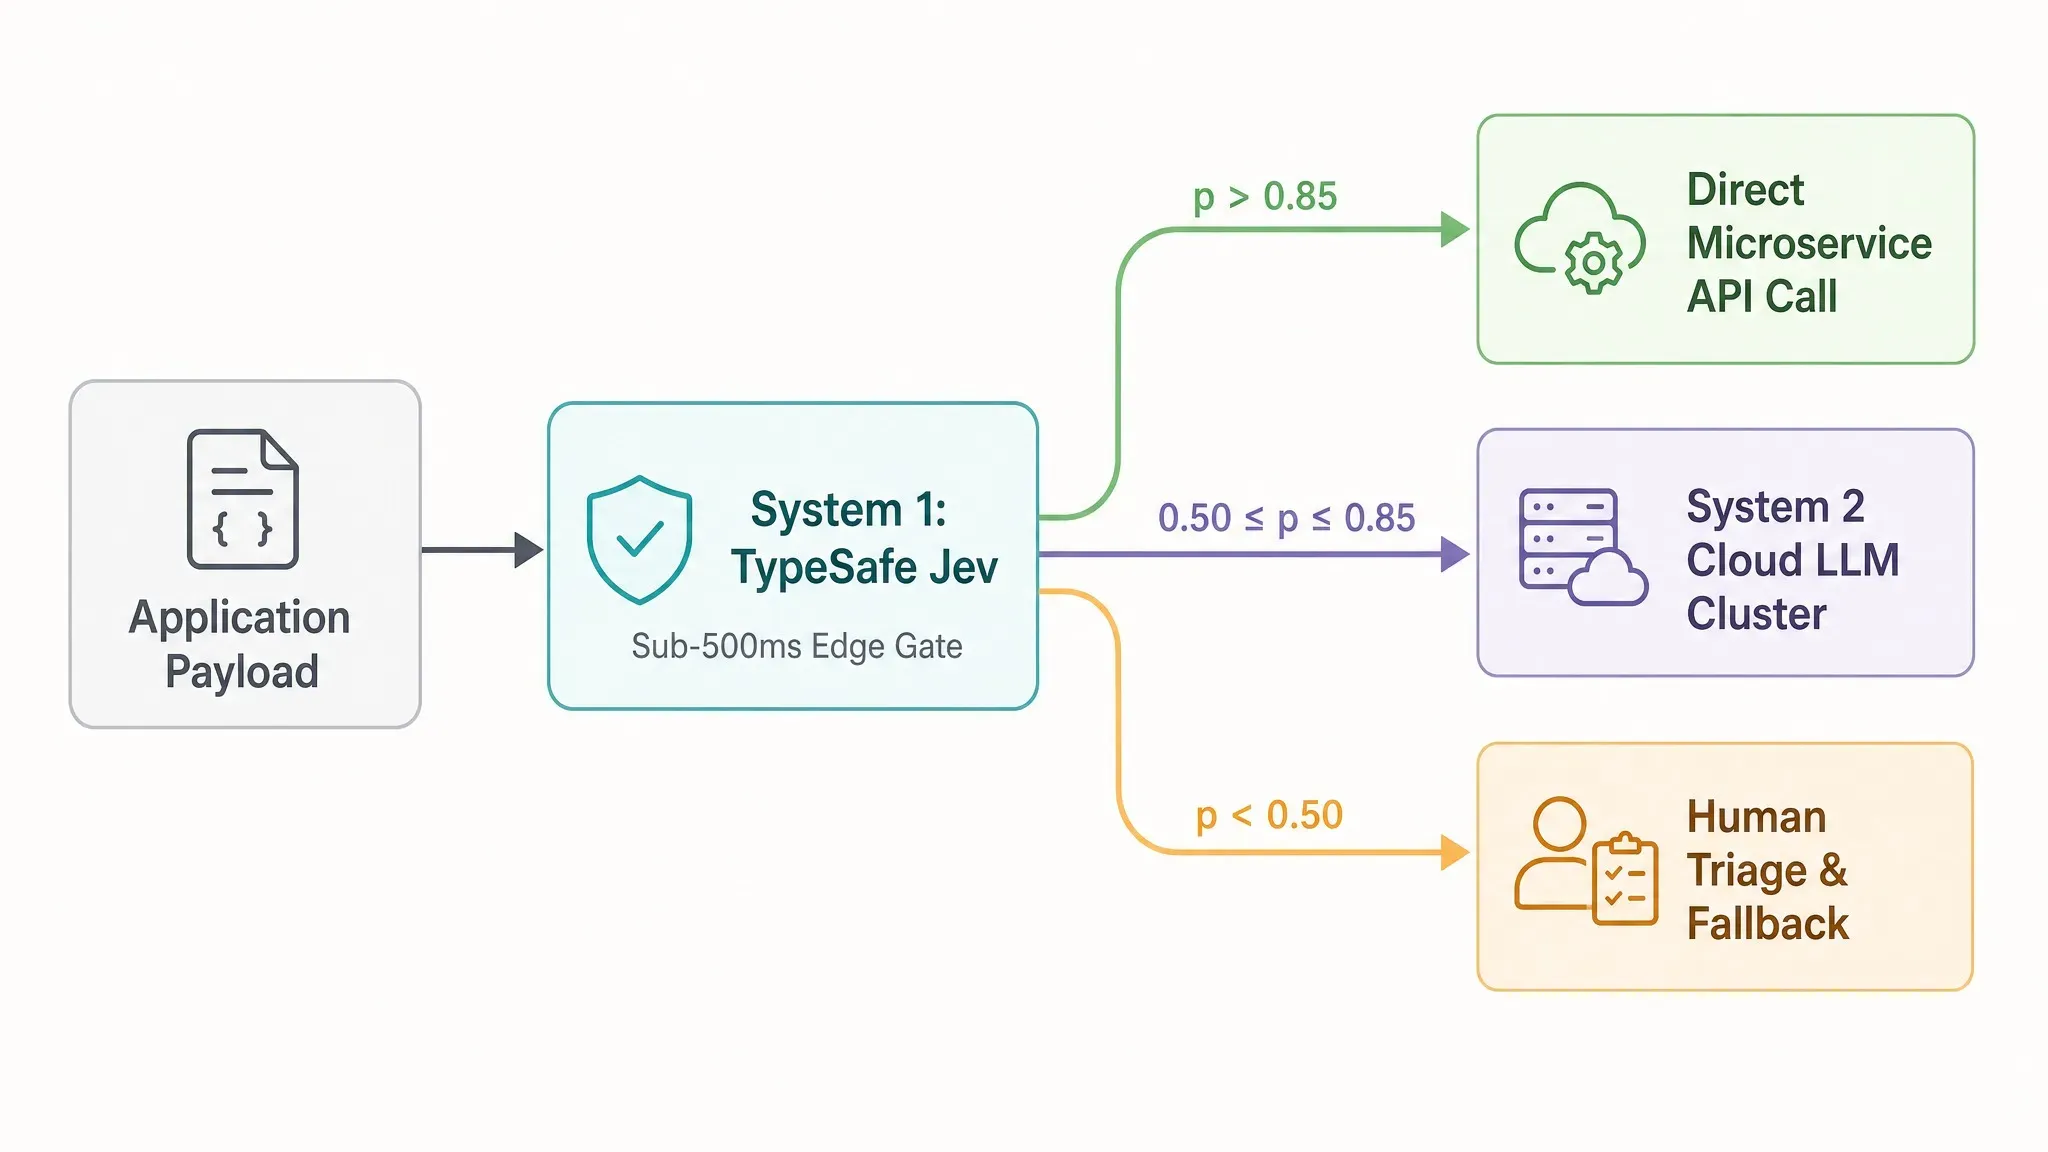
Kỹ sư có thể tận dụng các phân bố xác suất đã hiệu chỉnh này để cấu hình cổng quyết định dựa trên ngưỡng, ví dụ trong một thiết lập production điển hình:
p > 0.85(Thực thi đường nhanh): Thực thi ngay trong đường tốc độ cao, bỏ qua hoàn toàn các endpoint LLM chậm.0.50 ≤ p ≤ 0.85(Chuyển lên System 2): Chuyển các đầu ra sát ngưỡng cho LLM lập luận để xử lý các trường hợp biên mơ hồ.p < 0.50(Phân loại dự phòng): Kích hoạt mặc định an toàn hoặc đẩy yêu cầu vào hàng đợi đánh giá thủ công.
Với các trường hợp biên sát ngưỡng 0.50≤ p ≤ 0.85, định tuyến theo cổng tin cậy chuyển payload đến tầng lập luận doanh nghiệp. Sử dụng GPT 5.6 Terra trên Atlas Cloud cung cấp mục tiêu dự phòng tối ưu cho các yêu cầu được chuyển lên này, tận dụng cửa sổ ngữ cảnh 1.050K và mức giá token tiết kiệm $2/$12 để thực hiện phân tích sâu mà không làm tăng chi phí hạ tầng microservice.
Logprob thô từ LLM autoregressive nổi tiếng là không được hiệu chỉnh và thay đổi mỗi khi system prompt thay đổi. Bằng cách tích hợp RLCD trực tiếp vào quy trình huấn luyện cốt lõi, Jev đưa định tuyến theo cổng tin cậy vào production, cho phép các nhóm phần mềm tự động hóa an toàn các pipeline khối lượng lớn trong khi cô lập các trường hợp biên.
Mẫu thiết kế production: Pipeline AI tốc độ cao trong thực tế
Các AI agent production thường xuyên gặp sự cố khi LLM bịa ra chữ ký hàm không tồn tại như get_user_billing_v2() hoặc truyền kiểu tham số không hợp lệ đến một endpoint API nội bộ. Chuỗi nhiều kiểm tra điều kiện qua các endpoint chat completion tiêu chuẩn làm cộng dồn tổng độ trễ hệ thống, khiến microservice hướng khách hàng bị timeout.
Các mẫu kiến trúc cốt lõi cho microservice khối lượng lớn
Tích hợp engine quyết định dưới một giây vào pipeline AI production cho phép các nhóm phần mềm thay thế vòng lặp prompt không thể đoán trước bằng các mẫu thiết kế backend tất định:
- Chọn công cụ agentic: Khi chọn công cụ bên trong workflow agent tự động, Jev đánh giá các chữ ký hàm khả dụng dựa trên trạng thái ứng dụng hiện tại. Vì các hàm ứng viên được truyền dưới dạng lựa chọn rõ ràng trong schema yêu cầu, Jev không thể trả về tên hàm không xác định, loại bỏ lỗi runtime âm thầm trong quá trình chọn công cụ agentic. Việc lọc trước nhanh này đảm bảo payload schema hợp lệ trước khi chuyển hướng dẫn xuống các pipeline agent lập trình LLM tự trị.
- Đánh giá song song nhiều câu hỏi: Các endpoint chat tiêu chuẩn buộc ứng dụng đánh giá câu hỏi điều kiện tuần tự, nhân tổng độ trễ với số lượng kiểm tra được thực hiện. Jev cho phép đánh giá song song nhiều câu hỏi bằng cách đánh giá hàng chục câu hỏi schema trên một payload trạng thái duy nhất trong một forward pass song song. Chạy mười lăm kiểm tra phân loại rời rạc tốn cùng cửa sổ 100ms như chạy một kiểm tra.
- Tự động hóa phân loại ticket: Với microservice khối lượng lớn xử lý ticket khách hàng đến, Jev phân tích cảm xúc khách hàng, định tuyến ưu tiên kỹ thuật và kiểm tra điều kiện hoàn tiền đồng thời. Triển khai tự động hóa phân loại ticket với thời gian phản hồi dưới một giây ngăn xếp hàng tồn đọng trong các đợt lưu lượng tăng đột biến.
Triển khai các nút quyết định System One qua SDK
Nhà phát triển khởi tạo các nút quyết định độ trễ thấp bằng cách tích hợp typesafe-sdk chính thức vào microservice hiện có. Payload thực thi gửi trạng thái ứng dụng cùng các primitive schema được khai báo trước trực tiếp đến endpoint https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Các thiết lập gọi công cụ truyền thống mã hóa lại toàn bộ ngữ cảnh prompt cho mỗi lần đánh giá hàm. Bằng cách tách biểu diễn trạng thái khỏi câu hỏi quyết định, Jev thực thi pipeline phân loại nhiều nhánh trong hệ thống backend mà không nhân chi phí token ngữ cảnh, làm tăng hóa đơn API hay đánh đổi đảm bảo độ trễ P95.
Các giới hạn đã biết của TypeSafe Jev và đánh đổi kiến trúc (Những gì Jev không thể làm)
Triển khai một mô hình quyết định phi autoregressive với kỳ vọng nó viết email phản hồi lịch sự hoặc tính tổng các dòng trên hóa đơn chắc chắn sẽ làm hỏng mã production. Các nhóm kỹ thuật cố gắng thay thế hoàn toàn LLM đa dụng bằng mô hình System One sẽ nhanh chóng gặp giới hạn kiến trúc vật lý.
Phân tích ranh giới cấu trúc
Hiểu rõ các kiểu lỗi cụ thể của Jev là điều then chốt trước khi đưa Jev vào workflow microservice. Thiết kế một forward pass của Jev áp đặt ranh giới nghiêm ngặt trên một số tác vụ cốt lõi:
- Sinh văn bản mở: Jev không tạo ra văn bản hội thoại. Nó không thể viết bài luận, tóm tắt tài liệu hoặc tạo giải thích bằng ngôn ngữ tự nhiên cho các lựa chọn của mình.
- Giới hạn lập luận nhiều bước (multi-hop): Kiến trúc đánh giá các biểu diễn trạng thái tức thời. Các chuỗi logic tuần tự phức tạp hoặc giới hạn lập luận nhiều bước đòi hỏi phải chuyển tác vụ trở lại cho các LLM autoregressive truyền thống.
- Giới hạn số học: Jev không thể thực hiện tính toán hoặc đếm đáng tin cậy các mục bên trong chuỗi ngữ cảnh. Các giới hạn số học đòi hỏi phải giữ tính toán tài chính và thao tác mảng trong mã backend tiêu chuẩn.
- Diễn giải tiêu chí theo nghĩa đen: Mô hình tuân theo quy tắc prompt theo nghĩa đen mà không suy luận logic nghiệp vụ không được nêu. Các tùy chọn schema mơ hồ dẫn đến phân bố xác suất ngoài dự kiến.
- Context rot khi payload nặng: Truyền log khổng lồ, phi cấu trúc gây context rot, làm giảm độ chính xác đánh giá. Lọc nhiễu khỏi payload trạng thái đầu vào trước khi gửi yêu cầu vẫn là điều thiết yếu.
Ánh xạ kiến trúc: Năng lực System One so với System Two
| Tác vụ vận hành | TypeSafe Jev System One | LLM autoregressive System Two |
| Phân loại theo danh mục | Gốc (dưới 500ms) | Chậm (văn bản tuần tự) |
| Tổng hợp & soạn thảo văn bản | Bất khả thi (không có vòng lặp giải mã) | Gốc (sinh văn bản mở) |
| Tính toán toán học | Không hỗ trợ (giới hạn số học) | Thay đổi (yêu cầu thực thi mã) |
| Khả năng chống nhiễu | Dễ bị context rot trong trạng thái lớn | Khả năng phục hồi cửa sổ ngữ cảnh cao hơn |
Coi Jev như một nút quyết định dưới một giây thay vì engine lập luận phổ quát đảm bảo thiết kế hệ thống đúng đắn trên các microservice production.
Hạ tầng cloud tương lai: Điều phối các nút quyết định nhanh
Định tuyến mọi yêu cầu người dùng đến trực tiếp một mô hình lập luận 70 tỷ tham số đốt hàng nghìn đô la chu kỳ GPU lãng phí trong khi buộc người dùng chờ vài giây cho các kiểm tra bảo mật cơ bản và định tuyến payload. Các ngăn xếp microservice hiện đại không thể xem mọi payload HTTP đến như một bài toán lập luận mở.
Sự chuyển dịch sang kiến trúc AI lai
Môi trường cloud đang chuyển dịch khỏi các endpoint LLM nguyên khối sang kiến trúc AI lai tách rời. Trong mô hình mới nổi này, các orchestrator cloud đặt nút quyết định nhanh ở biên mạng để đánh giá payload đến tức thời.
Bằng cách xử lý định tuyến AI biên, xác minh schema và chấm điểm tin cậy trong cửa sổ thực thi dưới 500ms, các nút quyết định nhanh lọc lưu lượng trước khi chạm tới các cụm mô hình nặng hơn. Cấu trúc liên kết này tối ưu phân bổ tài nguyên trên ba lớp vận hành cloud riêng biệt:
- Guardrail biên và định tuyến: Các nút quyết định nhanh đánh giá ý định người dùng, làm sạch đầu vào và xác minh tuân thủ schema trong một forward pass duy nhất.
- Bàn giao trạng thái và điều phối: Các orchestrator cloud phân tích điểm tin cậy, thực thi ngay các yêu cầu có độ chắc chắn cao và chuyển tiếp các tác vụ lập luận phức tạp.
- Lập luận System 2 tập trung: Các cụm LLM nặng chỉ nhận payload có cấu trúc, đã lọc trước khi việc tổng hợp nhiều lượt hoặc sinh mở thực sự cần thiết.
Triển khai mô hình System One ở quy mô lớn
Khi các nền tảng cloud mở rộng khả năng lưu trữ, tích hợp triển khai TypeSafe Jev vào hạ tầng AI cung cấp một mẫu hiệu quả cho microservice biên. Chạy mô hình quyết định phi autoregressive gần người dùng cuối giúp giảm đáng kể thời gian khứ hồi và cắt chi phí tính toán cho các ứng dụng thông lượng cao.
Xây dựng pipeline với các lớp quyết định chuyên dụng đảm bảo mạng backend luôn phản hồi dưới tải nặng trong khi giữ các mô hình lập luận tiên tiến tập trung hoàn toàn vào những tác vụ cần tính toán sâu.


