Koden ser färdig ut. Sedan misslyckas testerna, rättningen ändrar ett gränssnitt och ännu en förfrågan börjar köras. Att välja bästa ai-api för kodning innebär att hitta en modell och en slutpunkt som slutför din typ av arbete inom en acceptabel budget.
Börja med Claude, GPT eller Gemini som referenskandidat. Jämför DeepSeek, Qwen och Kimi på samma uppgifter om du vill ha alternativa distributions- och utgiftsalternativ. Prioritera regressionstester vid felsökning. Granska diffen vid refaktorering. Verifiera hela verktygsloopen för en kodningsagent innan du jämför tokenpriser.
Frustrationen är mätbar. I 2025 års Stack Overflow Developer Survey uppgav 66 % av de svarande på frågan om frustrationer att de fått nästan korrekta AI-lösningar; 45 % uppgav att de ägnade mer tid åt att felsöka genererad kod. Detta är enkätsvar, inte en modellevaluering från 2026. (Stack Overflow Developer Survey, 2025)
Viktiga insikter
- Välj API och agent separat.
- Gör ett urval utifrån uppgift och nödvändiga slutpunktsfunktioner.
- Spara första svaren och bedöm dem mot fasta acceptanstester.
- Räkna med misslyckade försök och rättningar i din kostnadsberäkning.
Den här guiden ger en urvalslista, tre kopierbara utvärderingsuppgifter och ett kostnadsblad. Research kontrollerades den 21 september 2026. Modelltillgänglighet, dokumenterade funktioner och uppmätta resultat är separata evidenskategorier genomgående.
Bästa AI-API för kodning: Urvalslistan
Börja med två kandidater: en som passar din befintliga applikation och ett alternativ. Använd dessa sex familjer för att bygga det första paret.
Tabellen föreslår tester utan att göra anspråk på jämförande prestanda. Åtkomst beror på ditt konto, din region, din kvot och din slutpunkt; en dokumentationspost bekräftar inte att dina autentiseringsuppgifter kan anropa den.
| Specifik modell och ID | Åtkomstväg | Uppgift värd att utvärdera | Huvudsaklig beslutsgräns | Slutpunktsbevis | Priskontroll |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Begränsade ändringar i flera filer | Verifiera klient- och resonemangskontroller | Claude Platform-modellöversikt; kontoåtkomst ej testad | Ingen taxa angiven |
GPT-6 Astra, gpt-6-astra | OpenAI API | Kodningsuppgifter med flera villkor | Verifiera rutt och verktyg | OpenAI:s modelldokumentation; kontoåtkomst ej testad | Ingen taxa angiven |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Interaktiv generering och granskning | Verifiera latens och protokoll | Google AI-modellkatalog; kontoåtkomst ej testad | Ingen taxa angiven |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud modellrutt | Numeriska rättningar; kontextexperiment | Håll version 0813 separat | Exakt modellsida verifierad; körtidsfunktioner ej testade | 21 september 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud modellrutt | Refaktoreringar; fristående gränssnitt | Angiven version; inte den senaste | Exakt modellsida verifierad; körtidsfunktioner ej testade | 21 september 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud modellrutt | Samma tre uppgifter; CSV-gränssnitt | Verifiera utdata och slutförandegränser | Exakt modellsida verifierad; körtidsfunktioner ej testade | 21 september 2026 |
Claude, GPT och Gemini är användbara referenskandidater. Deras officiella modellkataloger identifierar versionerna ovan. Använd en leverantör du redan förstår som baslinje och testa sedan om ett alternativ minskar kostnaden per accepterad uppgift eller integrationsarbetet. Behandla inte en konsumentassistents beteende som motsvarande API-resultat.
OpenAI:s modellkatalog listar GPT-6 Astra tillsammans med GPT-5.6-familjen. Det fastställer en aktuell kandidat, inte en kodningsvinst över de andra raderna. Tabellen undviker medvetet att importera gamla modell-ID:n från odaterade jämförelsesidor. (OpenAI model directory, hämtad september 2026)
DeepSeek förtjänar en plats som en separat modellfamilj att undersöka. Testa om den åtgärdar den specifika buggen utan att utvidga ändringen. Välj en annan kandidat om den distribuerade rutten inte kan uppfylla ditt krävda svarsformat, verktygsbeteende eller latenstak, oavsett modellens allmänna rykte.
Utvärdera Qwen per version. Den namngivna distributionen 122B A10B ger en konkret prisreferens. Kör parsnings- och webbläsarkontrollerna innan du drar en slutsats om värdet. Kontextsiffror från andra Qwen-utgåvor kan inte tillskrivas denna modell.
Kimi är den genomarbetade konfigurationskandidaten. Dess offentliga sida identifierar modell-ID:t. Konfigurationsgranskning är möjlig; lyckad generering är fortfarande overifierad. Utvärdera dess färdiga utdata mot samma begränsningar som de andra kandidaterna.
Atlas Cloud ligger på åtkomstlagret i denna jämförelse. Det är inte en sjunde modell. Dess relevans är praktisk: du kan granska flera kandidatmodellsidor och jämföra deras integrationskrav innan du binder dig till ett arbetsflöde.
För öppna vikter, verifiera den exakta utgåvans licens och distributionsartefakt. Hostad inferens har separata servicetermer och driftkostnader; enbart modellfamiljen kan inte fastställa dessa.
Kodnings-API:er, modeller och agenter förklarade
En modell producerar innehåll som svar på indata. Ett API definierar hur din applikation skickar dessa indata och tar emot resultatet. En kodningsagent organiserar det omgivande arbetet: läser filer, anropar verktyg, tillämpar ändringar, kör tester och avgör om den ska fortsätta.
Dessa tre lager kan misslyckas oberoende av varandra. En modell kan föreslå en korrekt patch medan agenten skriver den till fel fil. Ett API kan returnera giltig JSON medan applikationen ignorerar ett verktygsanrop. En kapabel agent kan köra fast eftersom dess valda slutpunkt avvisar en parameter.
Anta att du skickar en hanterare och ber om en ID-parser. Ett enkelt API för kodgenerering returnerar text som innehåller kod. Ditt program måste fortfarande extrahera koden, placera den i en lämplig arbetsyta och köra testerna. Ett lyckat HTTP-svar fastställer leverans, inte korrekthet.
En agent kan automatisera dessa steg endast om du tillhandahåller verktygen och behörigheterna. Den behöver också ett stoppvillkor. Utan ett sådant kan den upprepade gånger redigera en redan acceptabel funktion, utvidga uppgiften eller lägga fler förfrågningar på att förbättra en irrelevant detalj.
Håll tre budgetposter separata:
- Verktygsprenumeration: applikationen, redigerarintegrationen eller agenttjänsten du använder.
- Inferensanvändning: förfrågningar till den valda modellslutpunkten, enligt dess faktureringsvillkor.
- Körmiljö: containrar, testkörare, lagring och annan infrastruktur.
Vissa produkter paketerar delar av denna stack. Andra förväntar sig att du tar med egna autentiseringsuppgifter. Kontrollera den specifika planen innan du antar att en redigerarprenumeration inkluderar godtycklig API-trafik från din egen applikation.
Protokollkompatibilitet har också en gräns. En tjänst som accepterar en välbekant messages-array kan ändå ha annat verktygsbeteende, andra streaminghändelser, andra kontextgränser eller andra resonemangskontroller. Att kopiera en bas-URL kan inte fastställa stöd för alla funktioner i en annan leverantörs ekosystem.
Kartlägg applikation, agent, slutpunkt, modell, verktyg och tester. Identifiera den fakturerbara komponenten och ansvarig operatör i varje steg innan du byter modell.
Bästa AI-API för kodning: 7 urvalskontroller
1. Funktionell korrekthet och regressionsbeteende. Skriv förväntade utdata innan du begär kod. En prisfunktion som hanterar vanliga heltal men accepterar null som noll bryter mot kontraktet. Kör både de nya kantfallen och befintliga projekttester; att ett nytt test passerar kan dölja en trasig anropare någon annanstans.
2. Ändringens omfattning. Jämför patchen med förfrågan. Att extrahera en ID-parser bör bevara URL:en, lyckat svar och felsvar. En oombedd ramverksmigrering lägger till granskningsarbete även när ersättningen kompilerar. Bestäm i förväg om orelaterade ändringar diskvalificerar svaret eller kräver en rättning.
3. Användbar kontext och utrymme för utdata. Din förfrågan innehåller instruktioner, relevanta filer, verktygsdefinitioner och tidigare konversation. Reservera tillräckligt utrymme även för svaret. Ett stort annonserat kontextfönster fastställer inte att modellen hittar den relevanta invarianten, eller att din slutpunkt accepterar samma maxvärde.
Testa kontextkvaliteten med ett beroende som spelar roll. Inkludera en anropare vars gränssnitt måste förbli stabilt och verifiera att modellen respekterar det. Mät trunkering separat: ett svar som slutar mitt i en funktion kan inte accepteras bara för att de inledande raderna såg lovande ut.
4. Verktygsanrop och strukturerad utdata. Verifiera den distribuerade rutten med ditt faktiska verktygsschema. Kontrollera argumenttyper, saknade fält, verktygsidentifierare och uppföljningssvaret efter ett verktygsresultat. En modell som skriver ett rimligt JSON-objekt har inte nödvändigtvis slutfört en inbyggd verktygsanropsrunda.
5. Tid till ett accepterat resultat. Registrera varaktigheten för hela försöket, inklusive rättningar och tester. För en interaktiv assistent spelar också tiden till första synliga text roll, men den kan inte ersätta slutförandetiden. En snabb första token följd av ett långt oanvändbart svar blockerar fortfarande utvecklaren.
6. Avgifter för indata, utdata, cache och omförsök. Läs de faktureringskategorier som din valda slutpunkt faktiskt rapporterar. Separera cacheläsningar från vanliga indata när det är tillämpligt. Spåra misslyckade förfrågningar och avbrutna loopar. Om leverantören inte visar den detalj du behöver, markera uppskattningens saknade antaganden explicit.
7. Integrations- och kodhanteringsvillkor. Bekräfta att din redigerare eller applikation stöder rutten, autentiseringsmetoden och felformatet. Granska leverantörens aktuella databehandlingsvillkor innan du skickar privat källkod. Öppna vikter beskriver ett val av modelldistribution; de fastställer inte hur en hostad tjänst behandlar dina förfrågningar.
Offentliga benchmarks kan hjälpa dig att välja kandidater, förutsatt att du läser deras villkor. SWE-bench Verified innehåller 500 mänskligt filtrerade instanser. Dess nuvarande sida beskriver också en Bash Only-vy som använder samma mini-SWE-agent-miljö. Dessa detaljer hjälper till att förklara vad som jämförs. (SWE-bench, hämtad september 2026)
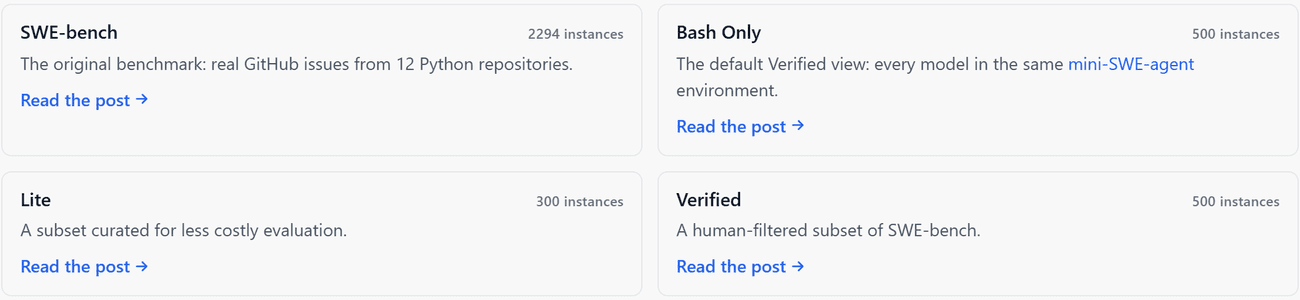 SWE-bench-sida som visar storleken på Verified-datasetet och den delade agentmiljön
Källbevis: den riktiga benchmark-sidan, tagen den 21 september 2026. Dataset och körningsvillkor hör ihop med varje prestandapåstående.
Benchmarkresultat beskriver en specifik uppsättning. Ditt språk, dina affärsregler, behörigheter och granskningsstandarder kan skilja sig. Fatta det slutliga beslutet utifrån arbete du kan granska.
Bästa AI-API för kodning: Kör tre praktiska kontroller
Dessa tre reproducerbara utvärderingsexempel blottlägger olika feltyper. Fastställ deras acceptansregler innan du begär utdata. Bedöm funktionen eller sidan mot dess kontrakt, oavsett förklaringens kvalitet.
För DeepSeek V4 Pro, Qwen3.5 122B A10B och Kimi K3 är det avsedda protokollet tre oberoende körningar per uppgift. Det innebär 27 initiala försök. Tillåt högst en återkopplingsrättning per försök, bevara det första svaret och rapportera initiala och rättade utfall separat.
Begär temperature noll endast där det stöds, och registrera den faktiskt accepterade inställningen. Använd ett begärt utdatatak på 4,096 tokens för A och B och 8,192 för C efter att ha kontrollerat slutpunktsgränserna. Standardvärden och kontroller som inte stöds måste registreras. Låg temperatur garanterar inte identiska svar.
Evidensstatus: åtkomst till testmiljön blockerades av en inloggningsskärm för Cloudflare Access. De 27 kandidatförsöken kunde inte köras. Följande bevis visar lokalt körd originalkod och en av artikeln framtagen CSV-referensfixtur, inte resultat från kandidatmodeller. Modellernas godkännandegrad, tokenanvändning och uppgiftskostnader är fortfarande omätta.
Uppgift A: åtgärda numeriskt prisval. Klistra in exakt denna prompt i en ny session:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
De fasta acceptansindata är [2,10,3], ["12","3"], en tom array, enbart ogiltiga värden, noll, negativa tal och strängar med enbart blanksteg. Avvisa tomma strängar efter trimning. Kontrollera att den ursprungliga arrayen har exakt samma element i samma ordning efter anropet.
Originalet använder JavaScripts standardsortering och muterar sin indata. Uppgiften kontrollerar därför två distinkta skyldigheter: välj rätt numeriskt minimum och undvik att ändra anroparens data. Testa konverteringsreglerna explicit eftersom en kort koercionsbaserad lösning av misstag kan acceptera booleaner eller null.
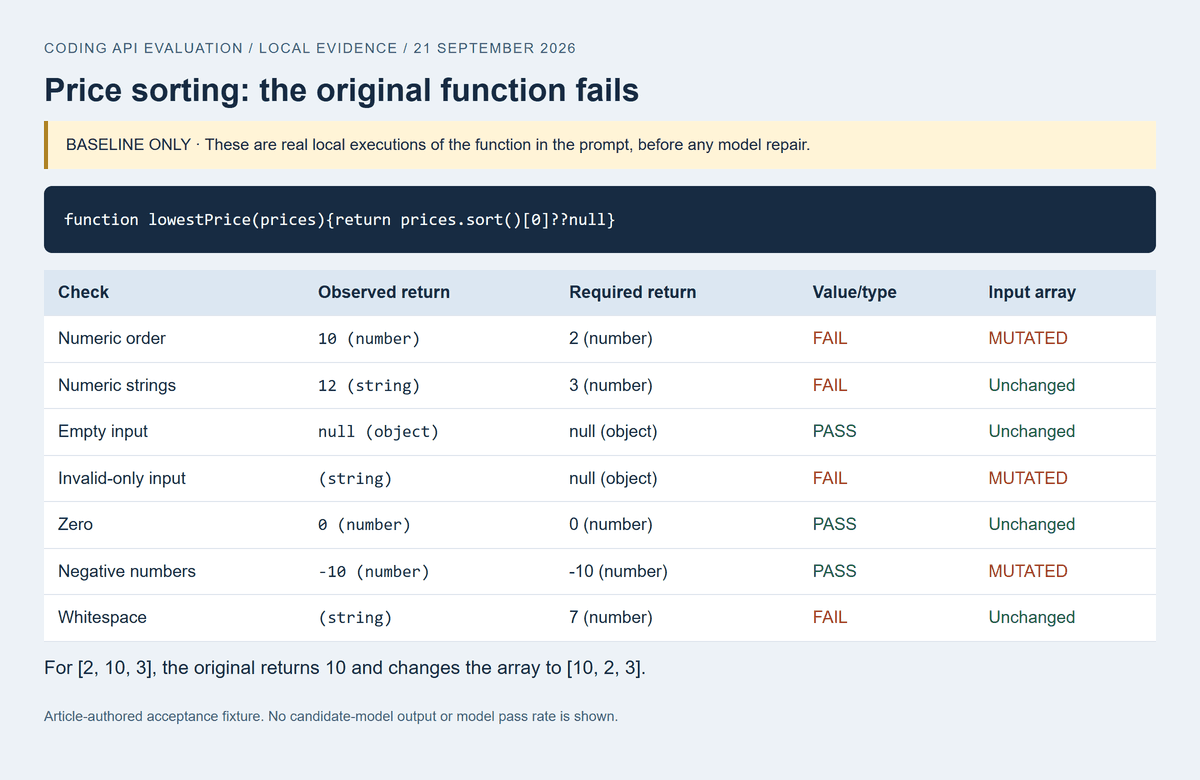 Lokal körning av den ursprungliga prisfunktionen som visar felaktig numerisk sortering och muterad indata
Körd baslinje: den ursprungliga funktionen returnerar 10 för [2,10,3] och ändrar arrayen till [10,2,3]. Numeriska strängar uppfyller inte heller returvärdeskontraktet. Ingen modellrättning visas.
Uppgift B: bevara ett gränssnitt under en liten refaktorering. Använd denna prompt oförändrad:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Acceptera "12" och "0012" som 12. Avvisa "1e2", "1.0", negativa tal, noll, blanksteg, icke-strängindata och värden utanför JavaScripts säkra heltalsintervall. Verifiera den registrerade sökvägen och båda svarskropparna. Ogiltig indata får inte nå findUser.
Denna uppgift testar om modellen förstår skillnaden mellan numerisk konvertering och den angivna stränggrammatiken. Granska diffen för orelaterade ändringar och anropa sedan hanteraren med stubbade request- och response-objekt. En korrekt hjälpfunktion parad med en oförändrad, tillåtande hanterare misslyckas fortfarande.
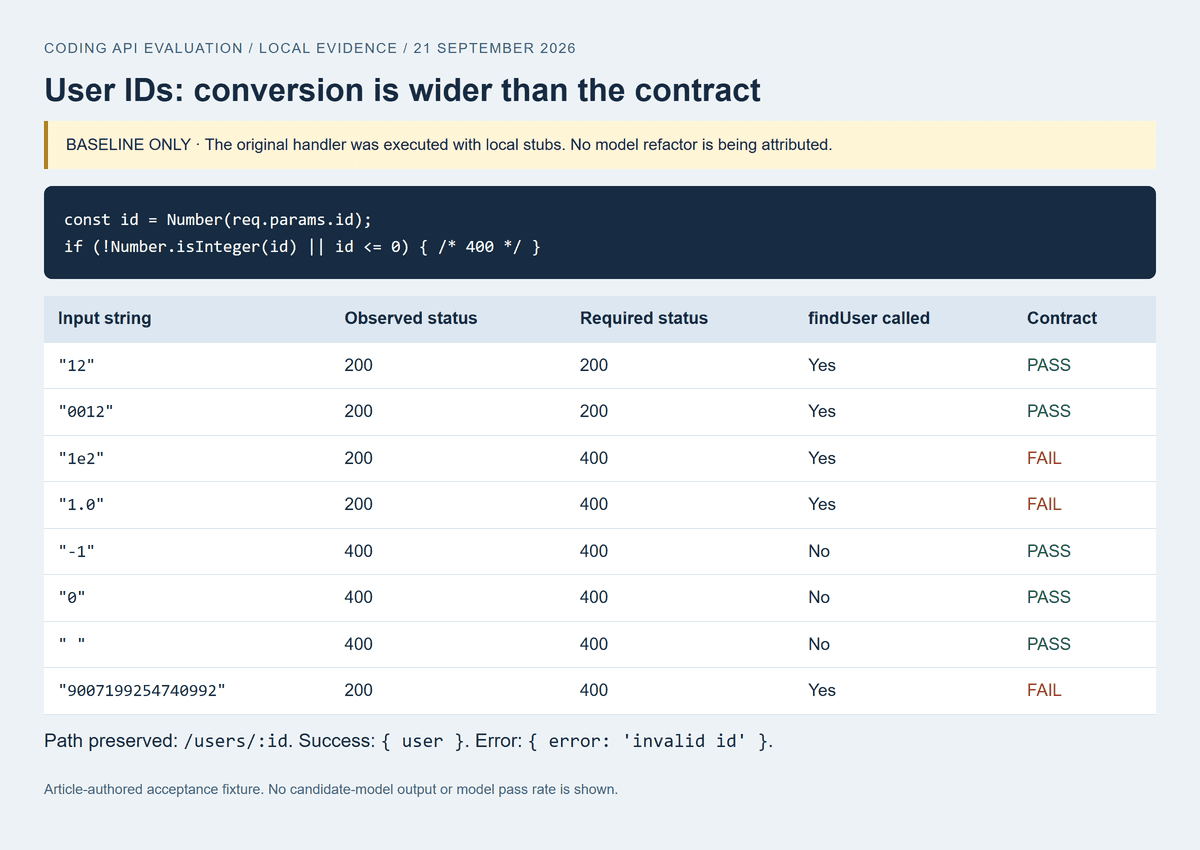 Testlogg för originalhanteraren som visar ogiltiga numeriska strängar accepterade med status 200
Körd baslinje: den ursprungliga hanteraren returnerar 200 för "1e2", "1.0" och "9007199254740992", trots att 400-svaret krävs. Lokala stubbar registrerade anropen; detta är inte en modellgenererad refaktorering.
Uppgift C: bygg en CSV-förhandsvisning som du kan använda. Skicka in:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Testa med dessa exakta poster, först med LF och sedan CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Förvänta dig två kolumner, tre datarader, Alices komma inuti en cell och Bobs escapade citattecken korrekt visat. Eves värde måste visas som literaltext, utan bildelement, händelsekörning eller nätverksbegäran. Lägg till en rad med tre fält och bekräfta att sidan rapporterar avvikelsen synligt.
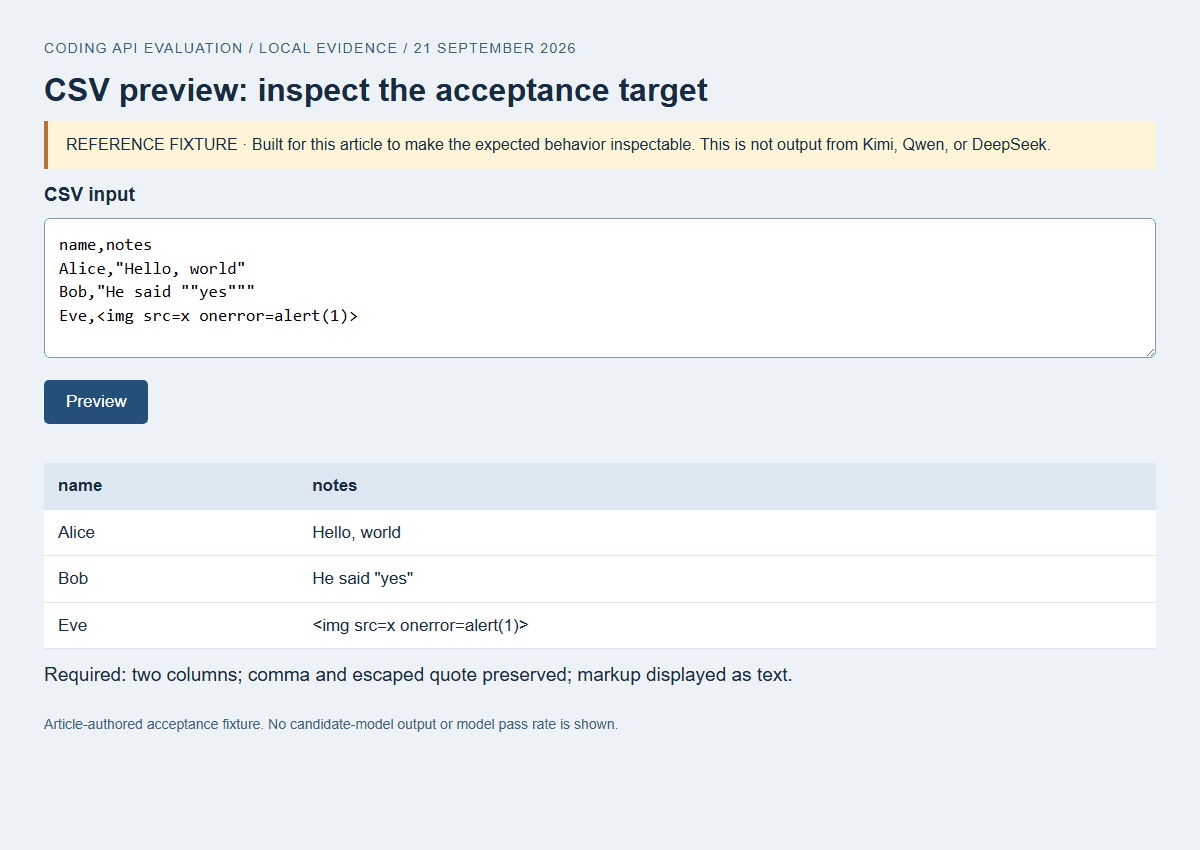 CSV-acceptansfixtur som visar citerade värden och krav på literal markup
Använd referensfixtur, byggd för denna artikel, inte genererad av en kandidatmodell. Webbläsarkontroller verifierade LF/CRLF-parsning, escapade citattecken, literal markup, synliga fältantalningsfel och inga HTTP-begäranden. Skärmbilden visar tillståndet med giltig indata efter att ha klickat på Preview\.
Spara råutdata, loggar, modell-ID, datum, parametrar, tidsmätning, rättningar och manuella redigeringar. Skicka misslyckade assertioner för en rättning utan att ändra förväntade utfall. Behåll avslag, trunkeringar och fel tillsammans med lyckade resultat.
Bästa AI-API för kodning med begränsad budget
Jämför tokenpriser tillsammans med slutförandekvalitet och användning. Upprepade indata kan dominera kostnaderna för kodgranskning; generering av hela filer kan öka utdataavgifterna. Upprepade rättningar ökar båda.
Atlas-katalogen och de exakta detaljsidorna visade dessa priser i USD per miljon tokens den 21 september 2026:
- DeepSeek V4 Pro: $1.68 indata och $3.38 utdata. Den separata listningen V4 Pro 0813 använder andra priser; ersätt inte med den.
- Qwen3.5 122B A10B: $0.30 indata och $2.40 utdata. Katalogen visade ordinarie priser på $0.40 och $3.20 med 25 % rabatt, i september 2026.
- Kimi K3: $3.00 indata och $15.00 utdata.
Detta är visade produktionspriser, inte fakturor från artikelns utvärdering. Cachespecifika priser och deras tillämplighet bekräftades inte. Kampanjrabatter för DeepSeek och Kimi bekräftades inte. En utebliven rabattobservation bevisar inte att inget erbjudande finns.
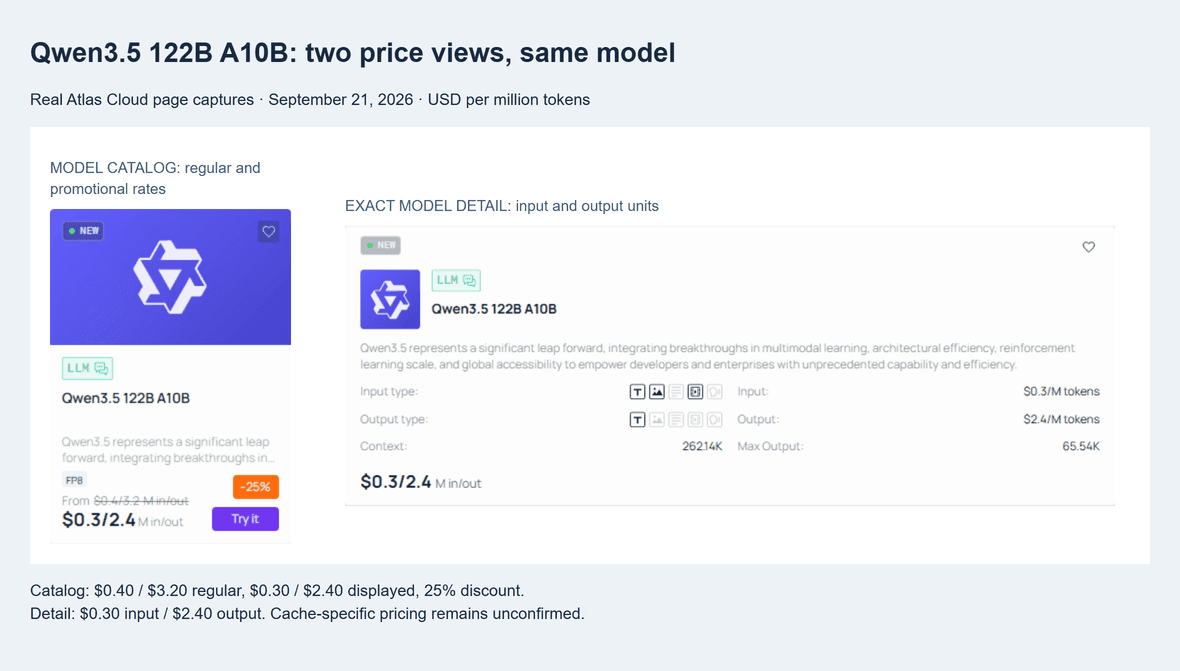 Katalograbatt för Qwen3.5 122B A10B bredvid modellens exakta detaljsida för indata- och utdatapriser
Korskontroll av Qwen-priser, 21 september 2026: katalogen visar 25 %-kampanjen; den exakta modelldetaljen bekräftar $0.30 indata och $2.40 utdata per miljon tokens. Cachespecifika priser är fortfarande obekräftade.
Beräkna modellens del av en uppgift som:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Debitera inte cachade tokens igen som vanliga indata om faktureringsposten behandlar dem separat. Kontrollera om resonemangsanvändning ingår i fakturerbar utdata. Om ingen uppgift lyckas, rapportera ”inget lyckat resultat”; att dividera med noll eller visa en nollkostnad för slutförande skulle vilseleda läsaren.
För ett transparent räkneexempel, anta 10 000 vanliga indata-tokens och 2 000 utdata-tokens till de visade Qwen-priserna. Den uppskattade modellavgiften är $0.0078, före eventuella andra tillämpliga poster. Detta är en hypotetisk förfrågan, inte observerad tokenanvändning eller en faktisk räkning.
En lika stor rättning skulle ge uppskattningen $0.0156. Faktiska rättningar innehåller annan kontext och utdata, så beräkna varje förfrågan utifrån dess registrerade användning.
| Uppgift | Modell | Första försök | Efter rättning | Tokenanvändning | Kostnadskälla | Total avgift | Total tid | Manuella ändringar |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 3 upprepningar vardera planerade | DeepSeek V4 Pro | Ej mätt | Ej mätt | Ej registrerad | Ingen användningspost | Okänd | Ej mätt | Inga utvärderade |
| A, B, C; 3 upprepningar vardera planerade | Qwen3.5 122B A10B | Ej mätt | Ej mätt | Ej registrerad | Ingen användningspost | Okänd | Ej mätt | Inga utvärderade |
| A, B, C; 3 upprepningar vardera planerade | Kimi K3 | Ej mätt | Ej mätt | Ej registrerad | Ingen användningspost | Okänd | Ej mätt | Inga utvärderade |
För ditt eget kalkylblad, expandera varje rad till en rad per modell och upprepning. Räkna en rättad framgång en gång i nämnaren för accepterade uppgifter. Inkludera misslyckade försök i täljaren och behåll separata kolumner för första försök och slutlig acceptans.
Spåra mänsklig granskning och infrastruktur separat. Att reda ut en onödig omskrivning kan sudda ut en inferensbesparing. Jämför kandidater som uppfyller både acceptanskraven och din budget för granskningstid.
Bästa AI-API för kodning med Atlas Cloud
Börja med Kimi K3-modellsidan, bekräfta ID:t och granska API- och Kod-vyerna. Håll den valda versionen bredvid testprotokollet.
Läs LLM-protokolldokumentationen innan du behandlar två rutter som utbytbara. Den identifierar Chat Completions som rutten med bred täckning och hänvisar användare till varje modells supported_apis. Samplingskontroller och verktygsfunktioner beror också på modellens annonserade stöd.
Det finns konkreta integrationsdetaljer värda att kontrollera här. Dokumentationen säger att översatta Anthropic-förfrågningar inte tillämpar cache_control, och leverantörshostade verktyg är otillgängliga på den översatta rutten. Dessa begränsningar spelar roll om din befintliga agent förutsätter inbyggd cachning eller ett hostat surfverktyg. Matcha klienten mot den faktiska rutten.
Följande Node.js-exempel illustrerar en textförfrågan. Det använder inbyggd fetch, en miljövariabel för autentiseringsuppgifter och det verifierade Kimi-modell-ID:t. Spara Uppgift A:s exakta prompt som task-a.txt. Ställ in miljövariabeln för bas-URL till Atlas API-basen som visas i dess dokumentation, som slutar på /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages bär uppgiften; model väljer distributionen; max_tokens begär ett utdatatak. Svarsläsaren kontrollerar efter vanlig slutförd text innan den returnerar kod. Timeouten begränsar den här exemplens väntetid; den fastställer inte att servern slutade bearbeta eller att ingen avgift uppstod.
Temperature utelämnas eftersom stöd per modell och faktiskt beteende behöver verifieras. Exemplet försöker inte igen automatiskt. Granska felklassen innan du lägger till en begränsad återförsökspolicy, och logga aldrig auktoriseringshuvudet. Denna publikationskod kördes inte med en API-nyckel under artikelproduktionen.
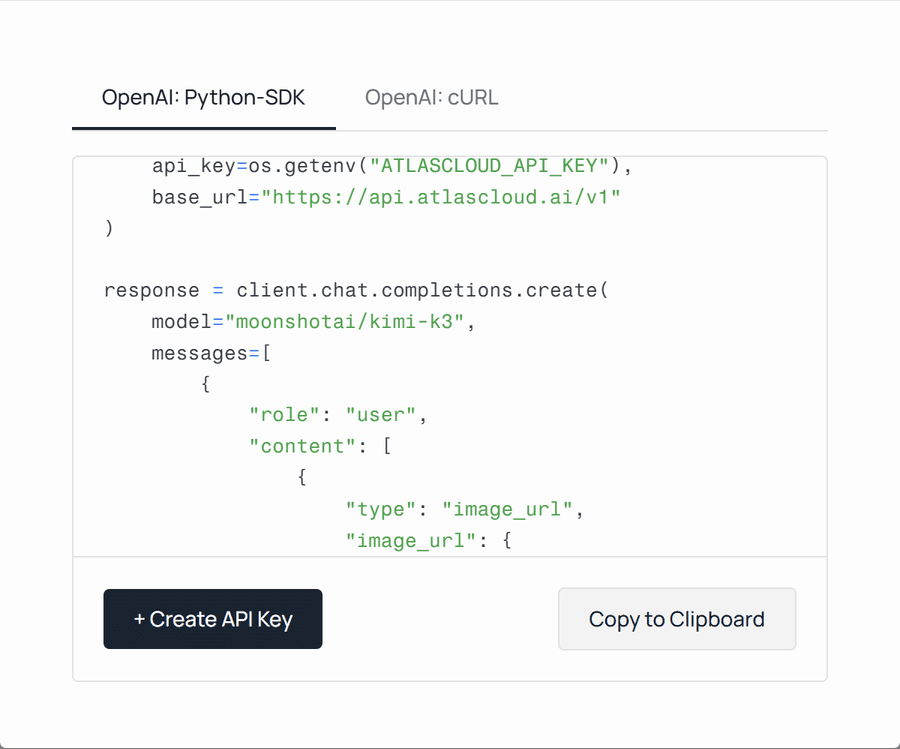 Offentligt kodexempel för Kimi K3 API som visar Atlas-slutpunkten och modellidentifieraren
Offentlig Kimi K3-dialog för Kod, tagen den 21 september 2026. Detta är konfigurationsbevis, inte en slutförd kodningskörning. Sidans exempel innehåller medieindata; artikelns exempel använder endast text.
Kör Uppgift A:s acceptanskontroller på varje returnerad funktion. Innan du byter till DeepSeek eller Qwen, verifiera dess protokoll och parametrar. Håll prompter och tester oförändrade medan du jämför utdata och användning; en delad förfrågningsform fastställer inte identiskt beteende.
Innan du använder ett kodnings-API i produktion
Kör genererad kod i en engångsgren eller isolerad arbetsyta först. För CSV-uppgiften, använd en lokal webbläsarkontext med nätverksbegäranden blockerade och ingen åtkomst till känsligt applikationstillstånd. För repository-uppgifter, ge processen endast de filer och kommandon som behövs för utvärderingen.
Definiera framgång utanför modellens svar. En agent som säger ”alla tester passerade” bör leda dig till en faktisk testlogg, exitkod och kontrollerad revision. Spara diffen tillsammans med det beviset. Annars kan en senare rättning ändra filerna efter den skenbara framgången och göra rapporten inaktuell.
Behandla timeouts och återförsök som applikationsbeteende du äger. Ange en tidsgräns för förfrågan och en total uppgiftsbudget. Separera fel som orsakas av autentiseringsuppgifter eller ogiltiga parametrar från tillfälliga transportfel. Att upprepa en ogiltig förfrågan slösar tid; att upprepa en förfrågan som utlöser bieffekter kan skapa dubbelarbete.
När agenten kan anropa verktyg, skilj på skrivskyddad granskning och skrivningar. Tilldela operationsidentifierare där din verktygsdesign stöder det, och bekräfta tillståndet innan du upprepar en osäker skrivning. En modellslutpunkts återförsökspolicy kan inte garantera idempotens för de verktyg som din applikation kör efteråt.
Skydda loggar lika medvetet som källfiler. Registrera modell-ID:n, tidsstämplar, status, tidsmätning och användning utan att rutinmässigt kopiera hemligheter eller hela privata repositories till telemetri. Förvara eventuella nödvändiga råutdatabevis på en lämpligt begränsad plats och fastställ hur länge teamet behöver behålla dem.
Kontrollera streaming med din riktiga klient. Den måste hantera partiella händelser, avslut, fel och användningsposter där sådana finns. Bekräfta hastighetsgränser för det faktiska kontot och distributionen. Ett tyst enanvändarexperiment kan inte fastställa hur samma rutt beter sig när ett team skickar förfrågningar samtidigt.
Använd denna korta checklista för release:
- Acceptanstester och befintliga regressioner passerar på den slutliga revisionen.
- Diffen håller sig inom den godkända uppgiftsgränsen.
- Timeout-, avbrotts- och återförsöksbeteende har testats.
- Verktygsanrop och strukturerade svar fungerar på den valda slutpunkten.
- Loggar utesluter autentiseringsuppgifter och onödig privat kod.
- Databehandlingsvillkor uppfyller teamets krav.
- En reservlösning har sin egen verifierade konfiguration och testprotokoll.
Privata repositories kräver ett tjänstespecifikt beslut. Granska aktuella villkor för lagring, träningsanvändning, åtkomst och avtal med den person som ansvarar för koden. Skicka endast godkänt material. Dra inte slutsatser om konfidentialitet utifrån att modellvikter är tillgängliga, eller utifrån ett protokoll som liknar ett du redan använder.
Bästa AI-API för kodning: Gör ditt slutliga val
Fatta beslutet i tre steg.
Först, eliminera kandidater som saknar en nödvändig funktion. Skriv ned de villkor som måste gälla: ett accepterat utdataformat, en fungerande verktygsloop, en lämplig databehandlingslösning eller en genomförbar svarstidsgräns. En kandidat som missar ett av dem behöver ett separat åtgärdsbeslut innan den hör hemma i den slutliga jämförelsen.
Sedan, jämför kostnad per accepterad uppgift och förfluten tid. Använd alla försök enligt samma rättningspolicy. Separera framgångar vid första försöket från rättade framgångar och visa saknade användningsposter. Om två modeller båda uppfyller kontraktet, jämför deras granskningsbörda såväl som modellavgifter. Dina utvecklare kommer att leva med de resulterande patcharna.
Till sist, behåll en reservlösning och definiera dess utlösare. Exempel är ett ihållande slutpunktsavbrott, upprepade misslyckanden med strukturerad utdata eller uppgiftskostnader som överstiger ett valt tak. Testa den alternativa konfigurationen i förväg. Att byta modell-ID under press kan införa ett andra integrationsproblem om dess kontroller eller svarsbeteende skiljer sig.
De tre små uppgifterna i den här guiden är en urvalsövning. Utöka sviten med representativt arbete från din egen kodbas innan du förlitar dig på en kandidat för breda ändringar. Håll några uppgifter utanför promptfinjusteringen så att du kan kontrollera om förbättringar överförs bortom de exempel du optimerade.
Det bästa ai-api:t för kodning är den kombination du kan förklara: den slutför det nödvändiga arbetet, visar kostnader du kan följa och passar hur din applikation körs. Ingen universell vinnare är nödvändig för att fatta det beslutet.
Öppna den aktuella modellkatalogen, välj två kandidater och spara deras exakta ID:n och inställningar. Använd sedan samma uppgift, samma tester och samma stoppregel för båda.
Vanliga frågor
Vilket är det bästa AI-API:t för kodning med liten budget?
Börja med en kandidat vars visade priser passar dina sannolika indata- och utdatavolymer och jämför sedan kostnaden per accepterad uppgift. Raderna för Qwen, DeepSeek och Kimi ger konkreta versioner att undersöka, utan att hävda en testad värdemässig vinnare. Begränsa antalet rättningsförsök, återanvänd relevant kontext medvetet och spåra misslyckade förfrågningar. Inkludera granskningstid separat så att en låg inferensräkning inte döljer en stor städningsbörda.
Är en kodningsprenumeration billigare än att betala för API-tokens?
Det beror på din arbetsbelastning och vad planen innehåller. En prenumeration kan passa interaktiv användning i sin stödda applikation, medan användningsbaserad fakturering kan passa en anpassad tjänst med variabel trafik. Kontrollera modellåtkomst, tak, samtidighet och om externa API-anrop överhuvudtaget ingår. Jämför samma mängd nyttigt arbete under en representativ period; ett månadspris och en tokenpris mäter olika saker.
Vad är skillnaden mellan en kodningsmodell och en kodningsagent?
Modellen genererar svar. Agenten hanterar loopen runt dessa svar, inklusive filåtkomst, verktygskörning, tester och stoppregler. Du kan anropa en kodningsmodell via ett API utan att bygga en agent, till exempel för att föreslå en funktion för mänsklig granskning. Om du vill ha autonoma redigeringar, utvärdera modellen tillsammans med agenten och de behörigheter den faktiskt kommer att använda.
Vilket AI-API bör jag använda för felsökning och refaktorering?
Gör ett urval av kandidater som passar dina slutpunkts- och kodhanteringskrav och använd sedan små buggar och begränsade refaktoreringar från ditt arbete. Uppgift A kontrollerar korrekthet och indatamutation; Uppgift B kontrollerar parsning och gränssnittsbevarande. Följ upp med representativa repository-tester.
Föredra den kandidat som uppfyller dina acceptansvillkor med hanterbar granskningsinsats, snarare än en som helt enkelt producerar den längsta förklaringen eller den mest omfattande omskrivningen.
Finns det ett gratis AI-API för kodning?
En provkredit, en applikation med en gratisnivå och nedladdningsbara modellvikter är olika erbjudanden. Inget av dem ger automatiskt din applikation obegränsad hostad inferens. Verifiera aktuell behörighet, utgång, kvoter och stödda modeller innan du budgeterar kring gratis åtkomst. Denna artikel hävdar inte att det finns en för närvarande tillgänglig gratis tilldelning.
Om du hostar vikter själv, räkna med beräknings- och driftkostnader även när nedladdning av vikterna inte kostar något.
Kan jag skicka privat repository-kod till ett kodnings-API?
Skicka endast kod som din organisation tillåter dig att dela enligt den specifika tjänstens tillämpliga villkor. Granska lagring, träningsanvändning, åtkomstkontroller och avtalskrav för den valda distributionen.
Ta bort autentiseringsuppgifter och orelaterade filer och kontrollera vad din agent automatiskt inkluderar i prompter och loggar. En öppenviktsmodell eller ett välbekant API-format fastställer inte i sig att en hostad tjänst uppfyller ditt teams konfidentialitetskrav.


