Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: 2026년 코딩용 오픈소스 모델 승자는?
요약
자율 코딩 에이전트를 몇 시간 동안 개입 없이 실행하려면: Kimi K2.6. Terminal-Bench 2.0에서 66.7%를 기록했으며, 공개된 벤치마크에서 13시간 연속 세션 동안 4,000회 이상의 툴 호출을 유지했습니다. 이 비교에서 다른 오픈 모델은 이 수준의 안정성에 도달하지 못합니다.
최고의 에이전트형 프론트엔드 개발자가 필요하다면: GLM 5.1. 독립적으로 검증된 Code Arena Elo 1,530(에이전트형 웹 개발 부문 세계 3위)은 자동화된 테스트 스위트가 아닌 실제 개발자 선호도를 반영합니다.
토큰당 비용이 제약이라면: MiniMax M2.7. Atlas Cloud에서 입력 토큰 100만 개당 $0.30, 활성화 파라미터는 10B에 불과하지만 SWE-Bench Pro에서 56.22%를 기록했습니다. GLM-5.1 성능의 약 94%를 약 5분의 1 비용으로 달성합니다.
코드베이스가 262K 컨텍스트 윈도우에 비해 너무 크다면: Qwen 3.6 Plus. 이 그룹에서 유일하게 100만 토큰 컨텍스트를 지원하며, Terminal-Bench 2.0에서 61.6%로 이 그룹 내 선두입니다.
주요 벤치마크 한눈에 보기
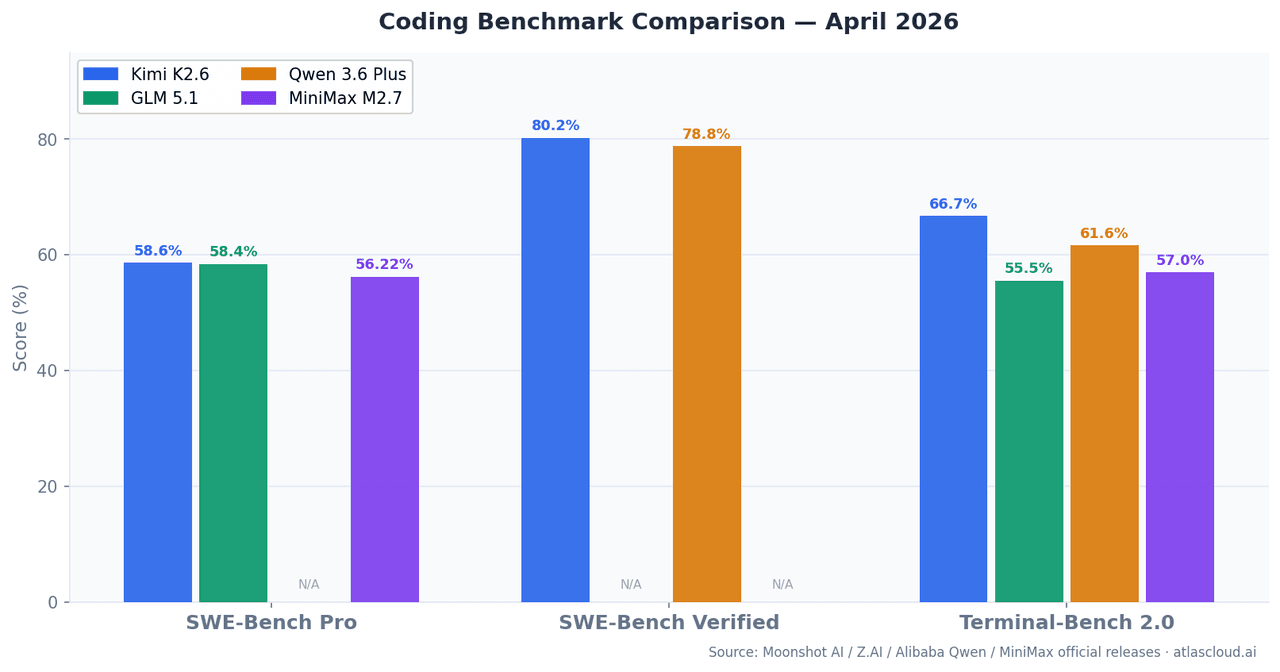
| 모델 | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | 컨텍스트 윈도우 | 활성화 파라미터 |
|---|---|---|---|---|---|
| Kimi K2.6 | 58.60% | 80.20% | 66.70% | 262K | — |
| GLM 5.1 | 58.40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78.80% | 61.60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56.22% | — | 57.00% | 196K | 10B |
SWE-Bench Pro는 훈련 종료 후 제출된 실제 GitHub 이슈를 해결하는 능력을 측정하여 SWE-Bench Verified보다 데이터 오염 위험을 줄입니다. Terminal-Bench 2.0은 실제 터미널 환경에서 다단계 CLI 및 셸 작업을 테스트하며, 프로덕션 에이전트가 실제로 수행하는 작업에 더 가깝습니다.
이 글에서는 Kimi K2.6, GLM 5.1, Qwen 3.6+ 및 MiniMax M2.7을 비교합니다. 더 많은 모델을 가격과 사양별로 한눈에 비교하려면 Atlas Cloud 모델 비교를 이용하세요.
Kimi K2.6: 장시간 실행 에이전트에 최적화
Moonshot AI는 2026년 4월 Kimi K2.6을 K2.5의 업그레이드 버전으로 출시했으며, 주요 개선 사항은 장시간 세션에서의 에이전트 안정성입니다. SWE-Bench Verified에서 80.2%로 Claude Opus 4.6(80.8%)에 바로 아래 있으며, SWE-Bench Pro에서 58.6%로 네 모델 중 선두입니다.
가장 중요한 수치는 Terminal-Bench 2.0 66.7% 입니다. Terminal-Bench 2.0은 SWE-Bench와 근본적으로 다릅니다. 실제 터미널 환경에서 작업을 실행하여 모델이 출력을 읽고, 오류를 처리하고, 적응하고, 반복해야 합니다. 패치 생성만 하는 것이 아닙니다. Kimi K2.6이 단일 13시간 세션에서 4,000회 이상의 툴 호출을 유지한 것은 실험실의 인공 결과가 아닙니다. Moonshot의 기술 릴리스에 문서화된 행동입니다.
덜 알려진 장점: 다국어 일반화. Kimi K2.6은 Rust, Go, Python, 프론트엔드 및 DevOps 작업 전반에서 일관된 성능을 보여줍니다. 대부분의 벤치마크 평가는 Python 중심입니다. 프로덕션 스택이 다중 언어라면 이 점이 중요합니다.
적합하지 않은 경우: Atlas Cloud에서 입력 토큰 100만 개당 $0.95로, 이 그룹에서 입력 측면에서 가장 비쌉니다. 대규모 컨텍스트로 많은 요청을 보내지만 12시간 세션 안정성이 필요하지 않은 배치 처리 작업의 경우 MiniMax M2.7이나 Qwen 3.6 Plus보다 비용이 더 빠르게 누적됩니다.
GLM 5.1: 에이전트형 프론트엔드의 강자
Z.AI는 2026년 4월 7일 GLM-5.1을 출시했습니다. 7540억 개의 파라미터와 MoE 라우팅을 갖춰 원시 파라미터 수 기준으로 이 그룹에서 가장 큰 모델입니다. SWE-Bench Pro에서 58.4%를 기록하여 Kimi K2.6의 58.6%와 통계적으로 유의미한 차이가 없습니다.
차별점은 Code Arena Elo 1,530입니다. 2026년 4월 10일 Arena.ai가 독립적으로 검증했으며, 에이전트형 웹 개발 리더보드에서 세계 3위입니다. 이는 자동화된 점수가 아닌 실제 개발자가 출력에 투표하는 라이브 1:1 비교입니다. 장점은 프론트엔드 UI 생성, 풀스택 스캐폴딩, React/Vue 컴포넌트 생성, NL2Repo(자연어로 완전한 저장소 구조 생성)에 집중되어 있습니다.
알아야 할 경계 조건: GLM-5.1의 프론트엔드 우위는 실제입니다. HumanEval 및 MBPP의 순수 알고리즘 문제에서는 Kimi K2.6에 비해 측정 가능한 이점이 없습니다. UI나 웹 중심이 아닌 문제에서는 리더보드 격차가 거의 0에 가까워집니다. 작업 영역을 확인하지 않고 리더보드 순위만으로 GLM-5.1을 선택하는 것은 실수입니다.
Atlas Cloud 가격: 입력 토큰 100만 개당 $1.40부터 시작하며 네 모델 중 가장 높습니다. 프론트엔드 생성 품질이 출력에 직접적인 영향을 미칠 때 정당화됩니다.
Qwen 3.6 Plus: 컨텍스트 크기가 실제 제약일 때
Alibaba는 2026년 3월 말 Qwen 3.6 Plus를 출시했습니다. Claude Opus 4.6과의 직접 비교에서 Terminal-Bench 2.0에서 선두(61.6% 대 59.3%)를 차지했으며, SWE-Bench Verified에서 78.8%를 기록했습니다.
100만 토큰 컨텍스트 윈도우가 차별점입니다. 대부분의 100K 토큰 미만 프로덕션 코딩 작업에서는 네 모델 모두 충분한 컨텍스트 용량을 가지고 있어 차이가 무의미합니다. Qwen 3.6 Plus가 유일한 실행 가능한 옵션이 되는 경우: 수백 개의 파일에 걸친 모노레포 분석, 대규모 레거시 코드베이스 리팩토링, 또는 262K 토큰에 맞출 수 없는 엔드투엔드 문서-코드 워크플로우입니다.
하이브리드 아키텍처(선형 어텐션 + 희소 MoE 라우팅)는 매우 큰 컨텍스트를 처리할 때 밀집 트랜스포머보다 더 나은 추론 처리량을 제공합니다. 즉, 100만 토큰 기능이 순진한 확장에 비해 상대적으로 낮은 지연 시간 비용으로 제공됩니다.
Atlas Cloud 가격: 입력 토큰 100만 개당 $0.325부터. 대규모 컨텍스트 작업의 경우 이 그룹에서 사용 가능한 최고의 비용 대비 유용 토큰 비율을 제공합니다.
MiniMax M2.7: 효율성의 반직관적 사례
MiniMax는 2026년 3월 M2.7을 출시했습니다. 활성화 파라미터가 10B에 불과하지만 SWE-Bench Pro에서 56.22%를 기록했습니다. GLM-5.1 점수의 약 94%를 토큰당 비용의 약 5분의 1로 달성합니다.
이 비교에서 반직관적인 결과입니다. 추론 시 10B 파라미터를 활성화하는 모델이 최첨단 코딩 성능에 근접하는 이유는 MoE 아키텍처가 전체 모델 가중치를 실행하지 않고 특화된 전문 하위 네트워크로 라우팅하기 때문입니다. 결과적으로 더 낮은 지연 시간, 더 낮은 비용, 그리고 파라미터 수만으로 예측되는 것보다 뛰어난 출력 품질을 제공합니다.
M2.7이 가격 대비 우위를 점하는 영역: 머신러닝 엔지니어링 작업. MLE-Bench Lite(22개 머신러닝 경진대회)에서 66.6% 메달 획득률을 기록했으며, 이는 프론티어 폐쇄 소스 모델에 이어 두 번째입니다. 올바른 그래디언트 누적 로직 작성, 커스텀 PyTorch 레이어 구현, 손실 곡선 디버깅 등에서 M2.7은 비용에 비해 정밀하게 처리합니다.
주의할 점: 196K 컨텍스트로 이 그룹에서 가장 작은 윈도우를 가집니다. 대규모 저장소의 깊은 교차 파일 분석이 필요한 작업은 Qwen 3.6 Plus가 문제없이 처리하는 한계에 부딪힐 수 있습니다.
Atlas Cloud 가격: 입력 토큰 100만 개당 $0.30, 출력 토큰 100만 개당 $1.20 — 고처리량 코딩 워크로드에 가장 저렴한 옵션입니다.
실제 코딩 테스트 사례
사례 1: Python 백엔드 자동 버그 수정
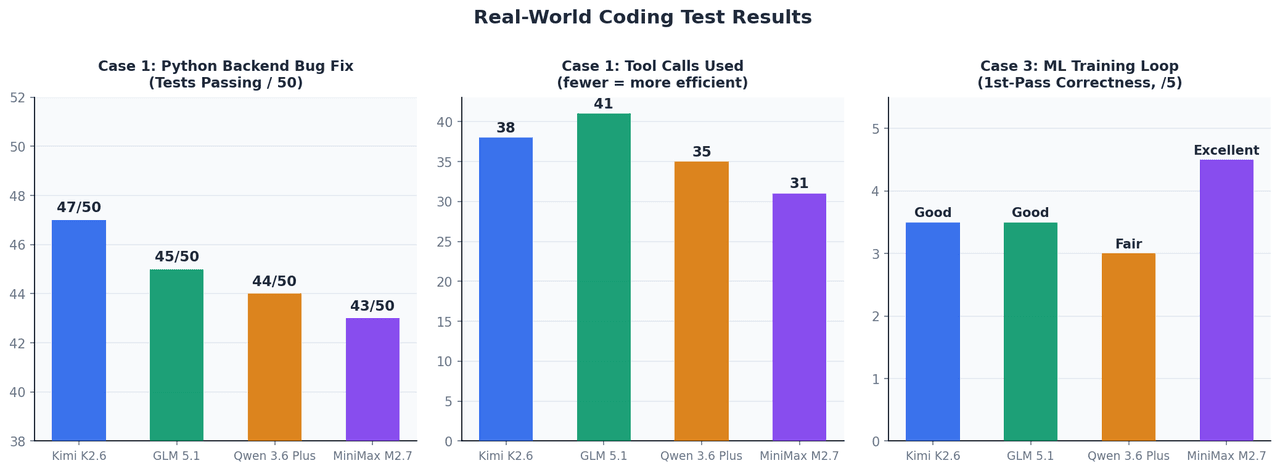
설정: 12개 파일로 구성된 FastAPI 애플리케이션, 50개 테스트로 구성된 실패하는 테스트 스위트, 약 45K 토큰 컨텍스트. 초기 프롬프트 후 수동 개입 불가.
| 모델 | 수정 후 통과 테스트 | 사용된 툴 호출 | 완료 시간 |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4분 |
| GLM 5.1 | 45 / 50 | 41 | ~5분 |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4분 |
| MiniMax M2.7 | 43 / 50 | 31 | ~3.5분 |
이 컨텍스트 크기에서는 네 모델 모두 좁은 범위 내에서 성능을 보입니다. Kimi K2.6은 가장 어려운 엣지 케이스 버그(특히 비동기 컨텍스트 관리자 수명 주기 문제 및 TypeVar 바운드 좁히기)에서 약간 앞서며, 여러 디버깅 주기에서 추론 상태를 유지해야 합니다.
사례 2: 명세서 기반 React 대시보드 생성
설정: 4가지 차트 유형(라인, 막대, 파이, 산점도), 다크 모드 전환, TypeScript 타입을 포함한 완전한 반응형 대시보드를 영어 명세서로 생성.
GLM-5.1은 첫 번째 패스에서 올바른 Tailwind 유틸리티 클래스가 포함된 작동하는 TypeScript 타입 컴포넌트를 생성했습니다. Kimi K2.6은 타입 오류를 해결하기 위해 한 번의 반복이 필요했습니다. Qwen 3.6 Plus는 기능적으로는 올바르지만 더 관용적이지 않은 JSX를 생성했습니다. MiniMax M2.7은 가장 빨랐지만 수동 정리가 필요한 일부 구식 React 패턴을 생성했습니다.
GLM-5.1과 다른 모델 간의 차이는 컴포넌트 아키텍처에서 가장 두드러졌습니다. GLM-5.1은 다른 모델이 하지 않는 방식으로 컴포지션 패턴을 자발적으로 적용하고 관심사를 분리했습니다.
사례 3: ML 학습 루프 구현
설정: 비전 트랜스포머를 위한 그래디언트 누적, AMP 혼합 정밀도, 조기 종료를 포함한 PyTorch 학습 루프 구현. 목표: 디버깅 주기 없이 첫 번째 시도에서 올바르게 실행.
MiniMax M2.7이 두드러졌습니다. scaler.step()과 scaler.update()를 옵티마이저 스텝에 상대적으로 올바르게 배치했으며, 이는 대부분의 모델이 첫 번째 생성에서 잘못 배치하는 세부 사항입니다. 그래디언트 누적 loss / accumulation_steps 스케일링도 적절히 처리되었습니다. 이는 M2.7의 66.6% MLE-Bench Lite 메달 획득률과 직접적으로 일치합니다.
Atlas Cloud 가격 비교 (2026년 4월)
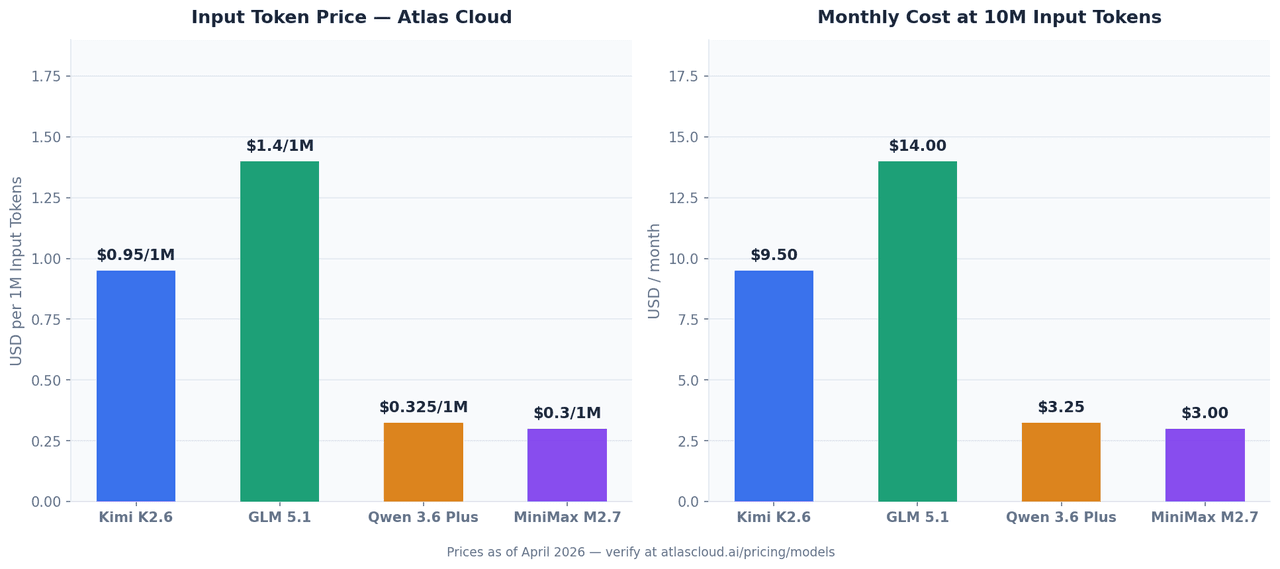
네 모델 모두 Atlas Cloud의 통합 API를 통해 사용 가능합니다. 아래 가격은 2026년 4월 기준이며 변경될 수 있습니다. 현재 요금은 atlascloud.ai에서 확인하세요.
| 모델 | 입력 (100만 토큰당) | 출력 (100만 토큰당) | Atlas Cloud 모델 ID |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | $1.40부터 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | $0.325부터 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
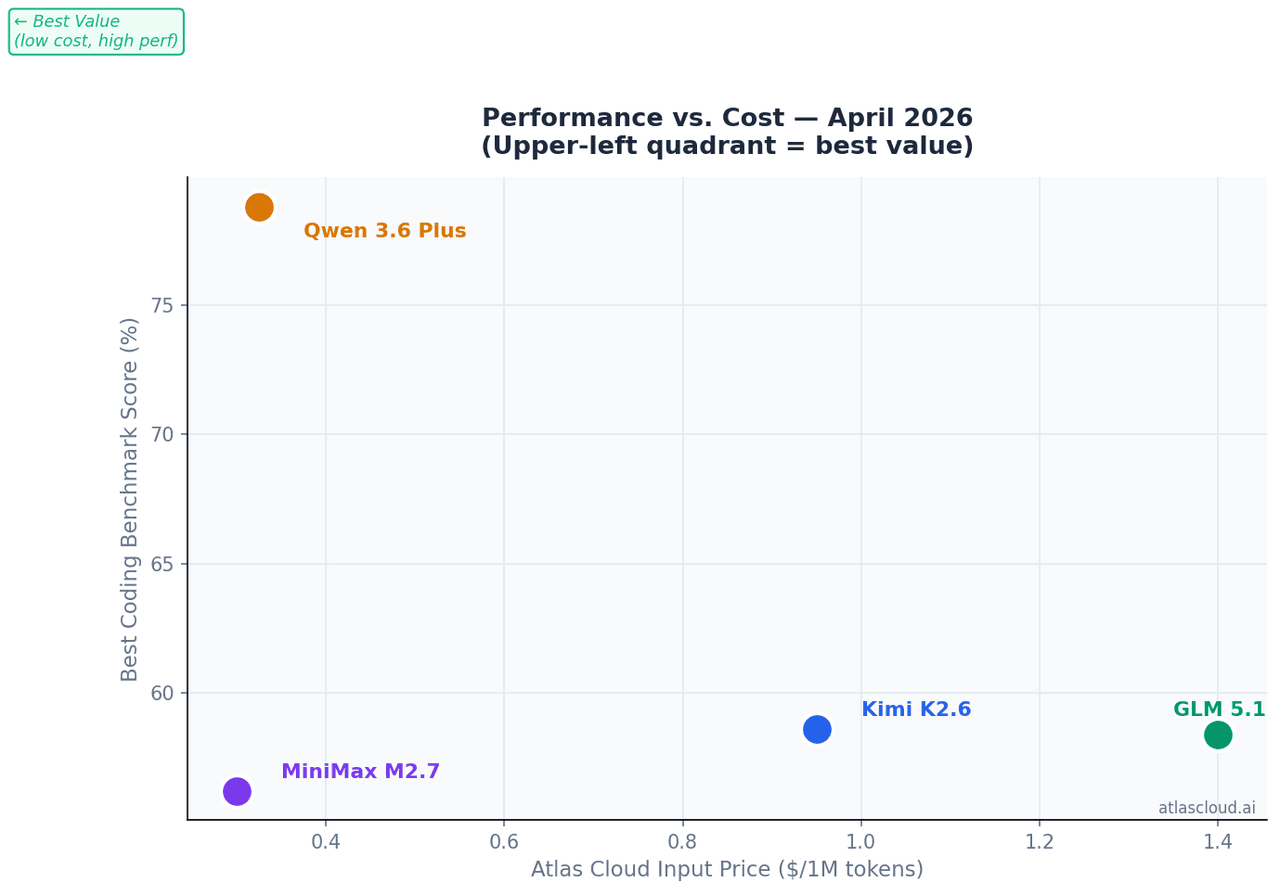
월 1,000만 입력 토큰 기준(팀 수준 코딩 어시스턴트의 현실적인 볼륨):
| 모델 | 월 입력 비용 (1,000만 토큰) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
하나의 API 키로 네 모델 모두 호출
네 모델 모두 Atlas Cloud에서 동일한 OpenAI 호환 엔드포인트를 공유합니다. 모델 전환은 한 줄만 변경하면 됩니다:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# 모델을 전환하려면 이 한 줄만 변경 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "당신은 시니어 소프트웨어 엔지니어입니다. 응답하기 전에 코드를 신중하게 분석하세요." 21 }, 22 { 23 "role": "user", 24 "content": "이 함수를 검토하고 모든 버그를 식별하세요:\n\n[여기에 코드 붙여넣기]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
이 OpenAI 호환 구조는 기존 OpenAI SDK 통합이 수정 없이 Atlas Cloud에서 작동함을 의미합니다. base_url과 api_key만 변경하면 됩니다.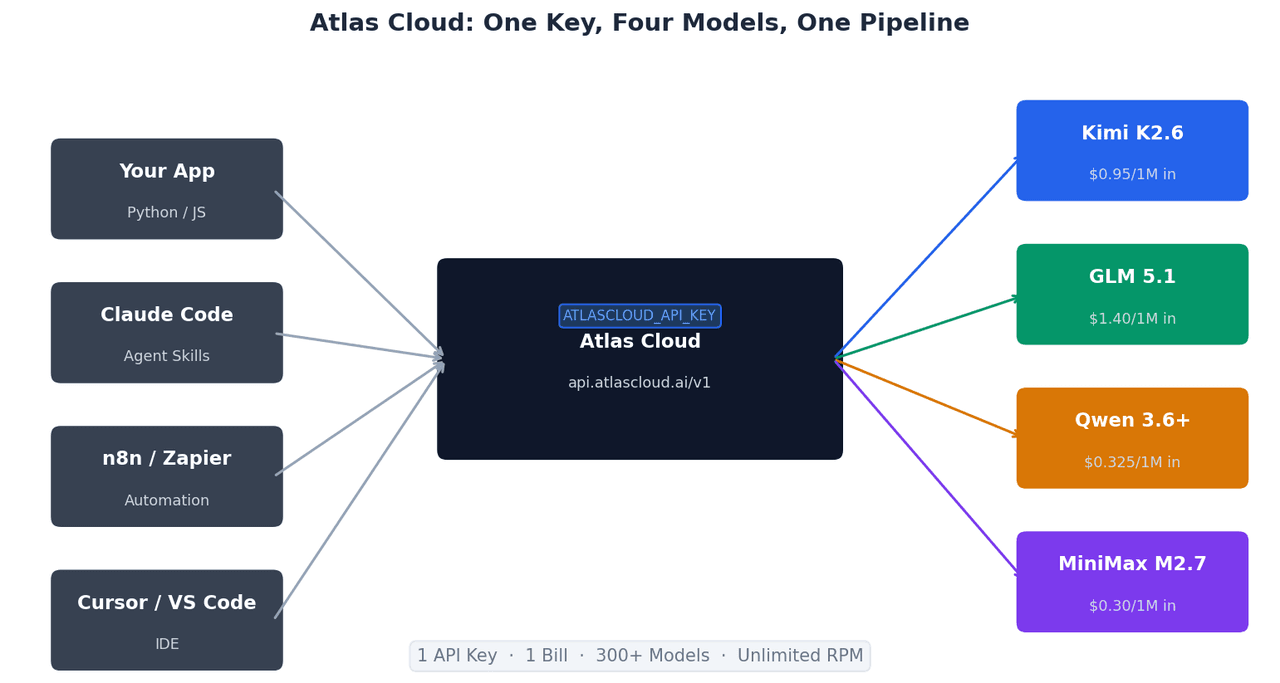
이러한 모델에 Atlas Cloud를 사용하는 이유
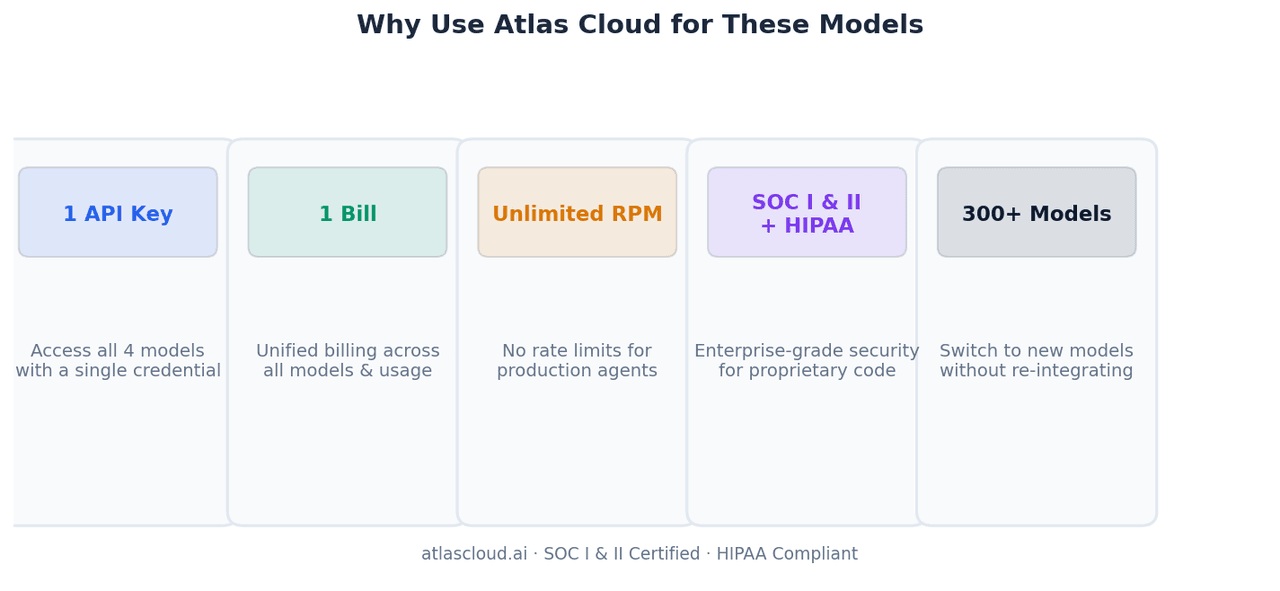
하나의 API 키, 네 개의 모델, 하나의 청구서. 모델 라우팅 로직(프론트엔드 작업은 GLM-5.1로, 배치 분석은 MiniMax M2.7로, 장기 에이전트는 Kimi K2.6으로)을 실행하려면 하나의 자격 증명만 관리하면 됩니다. 월별 정산은 단일 인보이스입니다.
무제한 RPM. 프로덕션 코딩 에이전트는 병렬 툴 호출을 실행합니다. 직접 공급업체 API의 속도 제한은 멀티 에이전트 파이프라인을 제한할 수 있습니다. Atlas Cloud는 그 한계를 제거합니다.
SOC I & II 인증, HIPAA 준수. 이러한 모델을 통해 독점 소스 코드를 처리하는 팀은 감사 가능한 인프라가 필요합니다. Atlas Cloud의 규정 준수 인증은 코드가 검증되지 않은 엔드포인트를 통해 라우팅되지 않음을 의미합니다.
300개 이상의 모델, 동일한 통합 패턴. 이러한 모델 중 하나의 새 버전이 출시되거나 특정 워크로드에서 더 나은 성능을 보이는 새 모델이 나오면 라우팅 로직에 추가하는 것은 문자열 하나만 변경하면 됩니다. 새 SDK 통합이 필요하지 않습니다.
작업별 모델 선택
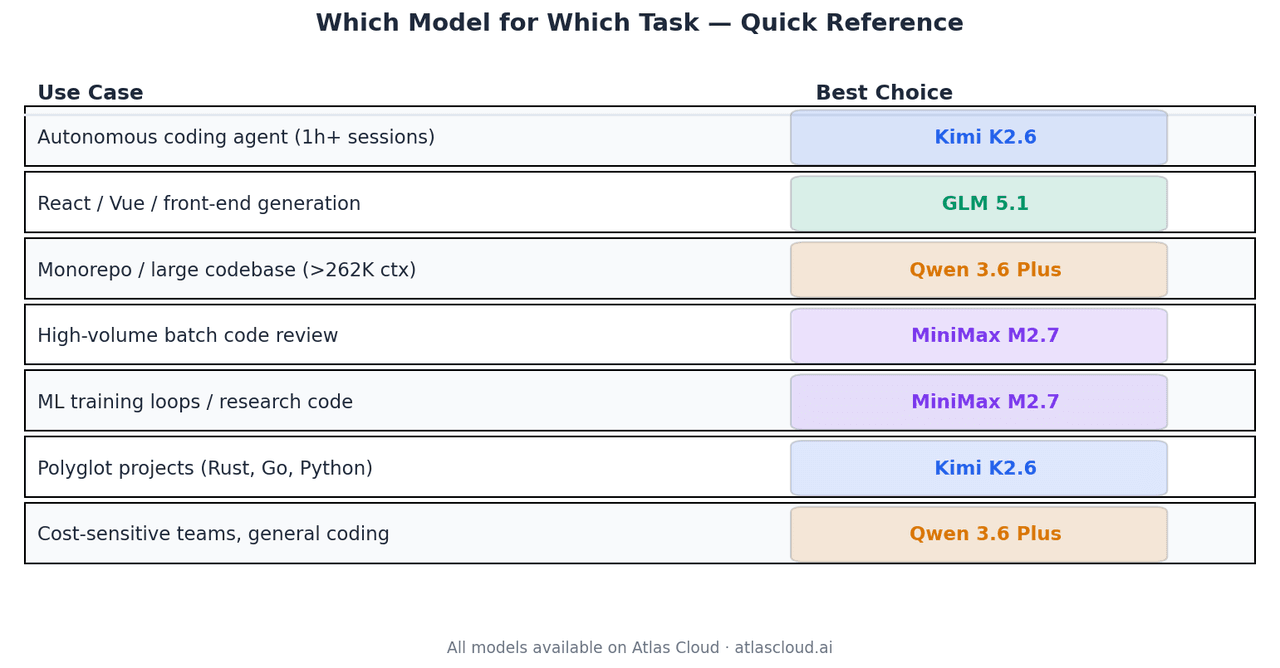
| 사용 사례 | 최적 선택 | 이유 |
| 자율 코딩 에이전트, 1시간 이상 세션 | Kimi K2.6 | 66.7% Terminal-Bench 2.0, 4K+ 툴 호출 안정성 |
| React / Vue / 프론트엔드 생성 | GLM 5.1 | Code Arena Elo 1,530, 에이전트형 웹 개발 세계 3위 |
| 모노레포 또는 대규모 코드베이스 분석 | Qwen 3.6 Plus | 이 그룹에서 유일한 1M 컨텍스트 윈도우 |
| 대용량 배치 코드 리뷰 | MiniMax M2.7 | $0.30/M 입력, GLM-5.1 품질의 94% |
| ML 학습 루프, 연구 코드 | MiniMax M2.7 | 66.6% MLE-Bench Lite 메달 획득률 |
| 다국어 프로젝트 (Rust, Go, Python) | Kimi K2.6 | 문서화된 다국어 일반화 |
| 비용에 민감한 팀, 일반 코딩 | Qwen 3.6 Plus | $0.325/M 입력, 모든 범주에서 강력 |
요약
이 네 모델은 표준 벤치마크에서 좁은 차이로 분리됩니다. 의미 있는 차이는 특정 조건에서 나타납니다.
Kimi K2.6은 자율 장기 실행 에이전트에 적합한 선택입니다. GLM 5.1은 프론트엔드 에이전트 작업에서 선두입니다. Qwen 3.6 Plus는 컨텍스트가 262K 토큰을 초과할 때 유일한 선택입니다. MiniMax M2.7은 대규모 코딩 모델을 실행하는 팀에게 비용 효율적인 기본값입니다.
네 모델 모두 Atlas Cloud에서 atlascloud.ai에서 단일 API 키로 사용 가능하며, 토큰당 과금과 최소 약정 없이 이용할 수 있습니다.
벤치마크 데이터 출처: Moonshot AI 기술 블로그, Z.AI 개발자 문서, Alibaba Qwen 팀 릴리스 게시물, MiniMax 공식 모델 페이지, Arena.ai 독립 평가. 모든 벤치마크는 2026년 4월 데이터입니다. Atlas Cloud 가격은 게시 시점 기준으로, 프로덕션 배포 전 현재 요금을 확인하세요.


