
MiniMax API
Como una suite líder de Large Language Models (LLMs) desarrollada por MiniMax AI, MiniMax está diseñada para redefinir la productividad en el mundo real mediante inteligencia artificial de vanguardia. El ecosistema incluye MiniMax M2.5, creado específicamente para entornos profesionales de alta eficiencia, y MiniMax M2.1, un modelo que ofrece capacidades de programación multilingüe significativamente mejoradas para dominar tareas técnicas complejas y a gran escala. Al lograr un rendimiento SOTA en programación, uso agéntico de herramientas, búsqueda inteligente y automatización de flujos de trabajo de oficina, MiniMax permite a los usuarios optimizar una amplia gama de operaciones de valor económico con una precisión y fiabilidad incomparables.
MiniMax ha sido desarrollado por MiniMax. Atlas Cloud (operado por Atlas Cloud AI LLC) proporciona acceso al modelo, pero no es su propietario. Todas las marcas comerciales pertenecen a sus respectivos titulares.
Explorar Modelos Líderes
Atlas Cloud le proporciona los últimos modelos creativos líderes en la industria.



Compara la línea de modelos de la API de MiniMax
Una visión clara de lo que acepta, produce y cuesta cada endpoint de MiniMax, abarcando texto, programación, flujos de trabajo agentic y generación de música.
| Modalidad | Descripción |
|---|---|
| MiniMax M3 API (Text) | ¿Necesitas un modelo agentic rápido? MiniMax M3 convierte prompts de texto en código, llamadas a herramientas y razonamiento a partir de un núcleo ligero de 10 billion activated parameter, diseñado para baja latencia y escalabilidad. El precio estándar es de $0.6 por millón de tokens de entrada y $2.4 por millón de tokens de salida, con un nivel independiente que se aplica cuando un prompt supera los 512K tokens. Encaja bien en sesiones de agentes largas y con mucho uso de herramientas, así como en el desarrollo de aplicaciones modernas. |
| MiniMax M2.7 (Text) | MiniMax M2.7 transforma instrucciones en lenguaje natural en código de producción y acciones agentic de varios pasos, usando el mismo diseño de 10 billion activated parameter para ofrecer alto rendimiento. El precio estándar es de $0.3 por millón de tokens de entrada y $1.2 por millón de tokens de salida, lo que mantiene económicas las ejecuciones agentic de gran tamaño. Elígelo cuando la capacidad fiable para programar y crear aplicaciones sea más importante que el tamaño bruto del modelo. |
| MiniMax M2.5 (Text) | Si tu carga de trabajo necesita razonamiento asequible y escalable, MiniMax M2.5 gestiona programación, orquestación agentic y desarrollo cotidiano de aplicaciones desde un motor compacto de 10 billion activated parameter. Su precio de lista es de $0.3 por millón de tokens de entrada y $1.2 por millón de tokens de salida, con entrada en caché a $0.03 por millón para reducir el coste del contexto repetido. Esto lo convierte en una opción predeterminada práctica para pipelines de alto volumen con reutilización de contexto. |
| MiniMax Music 2.6 API (Text to Music) | Describe un estilo y proporciona letras estructuradas con etiquetas como [Verse] y [Chorus], y MiniMax Music 2.6 devuelve una pista vocal o instrumental completa a partir de una única solicitud de generación. Los formatos de salida incluyen MP3, WAV y PCM con frecuencias de muestreo de hasta 44.1 kHz y bitrates de hasta 256 kbps; acepta prompts de hasta 2,000 caracteres y letras de hasta 3,500. Con un coste de $0.15 por generación, es adecuado para prototipos de bandas sonoras, jingles y música de fondo para apps y vídeo. |
Nuevas funciones de MiniMax + Showcase
La combinación de modelos avanzados con la plataforma acelerada por GPU de Atlas Cloud ofrece velocidad, escalabilidad y control creativo inigualables para la generación de imágenes y videos.
Codificación avanzada y planificación de agentes con MiniMax M2.5
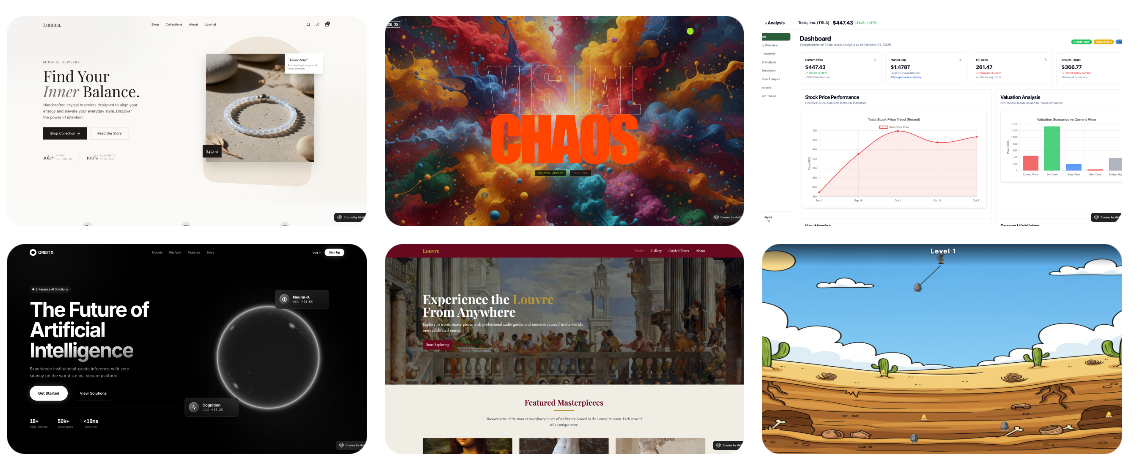
MiniMax M2.5 admite más de 10 lenguajes de programación, incluidos Rust, Go y Python, para facilitar un desarrollo full-stack integral en plataformas Web, móviles y de escritorio. Al integrar conocimientos sectoriales profundos para el formato profesional de documentos y el modelado financiero, permite transiciones fluidas desde el diseño de la arquitectura del sistema hasta las pruebas del entregable final. Es la solución definitiva para flujos de trabajo complejos de ingeniería de software y productividad de oficina de alto impacto.
Respuesta rápida y eficiencia en la toma de decisiones de tareas con MiniMax M2.5
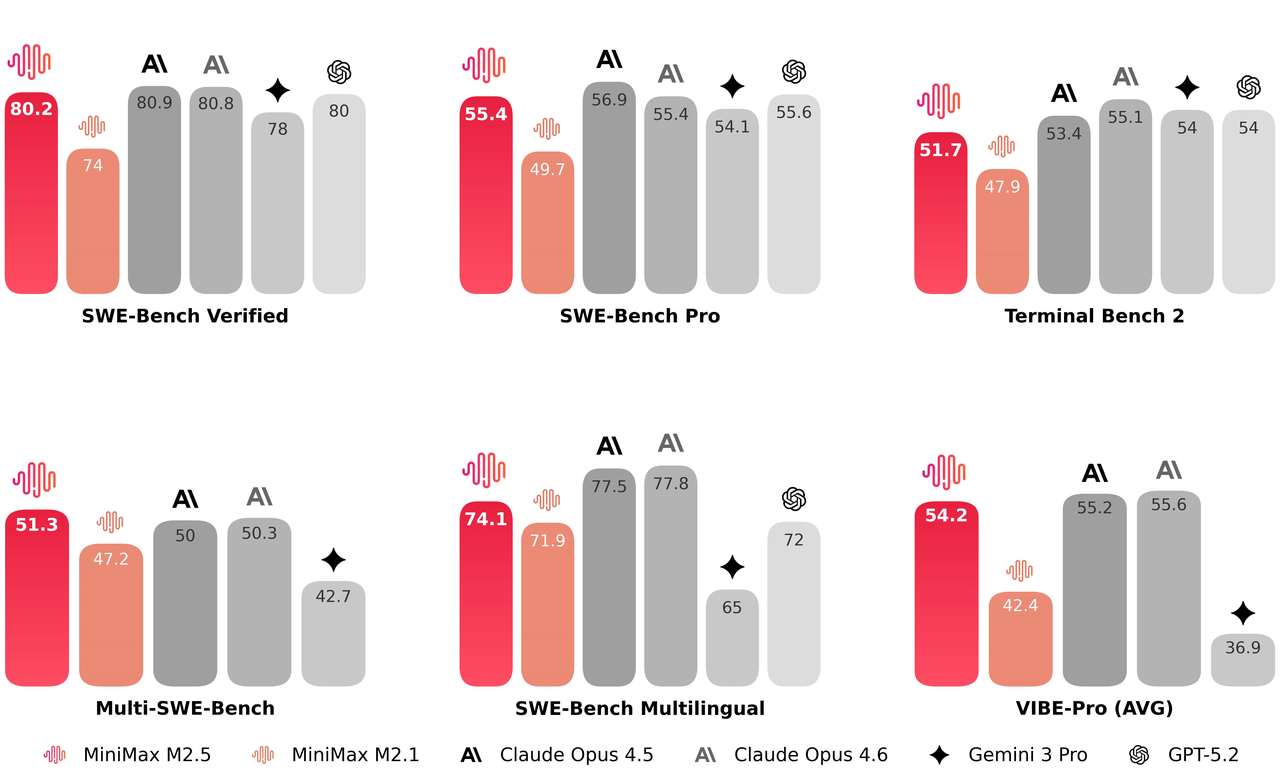
La arquitectura M2.5 logra un aumento de velocidad del 37% en la ejecución de extremo a extremo, reduciendo significativamente la duración de tareas complejas de 31.3 a 22.8 minutos en SWE-bench. Al optimizar la lógica de descomposición de tareas, el modelo requiere un 20% menos de tokens y rondas de búsqueda para alcanzar objetivos en benchmarks como BrowseComp. Ofrece una solución optimizada para la toma de decisiones de alta velocidad, al tiempo que elimina la sobrecarga computacional redundante.
Pensamiento intercalado que conserva su razonamiento
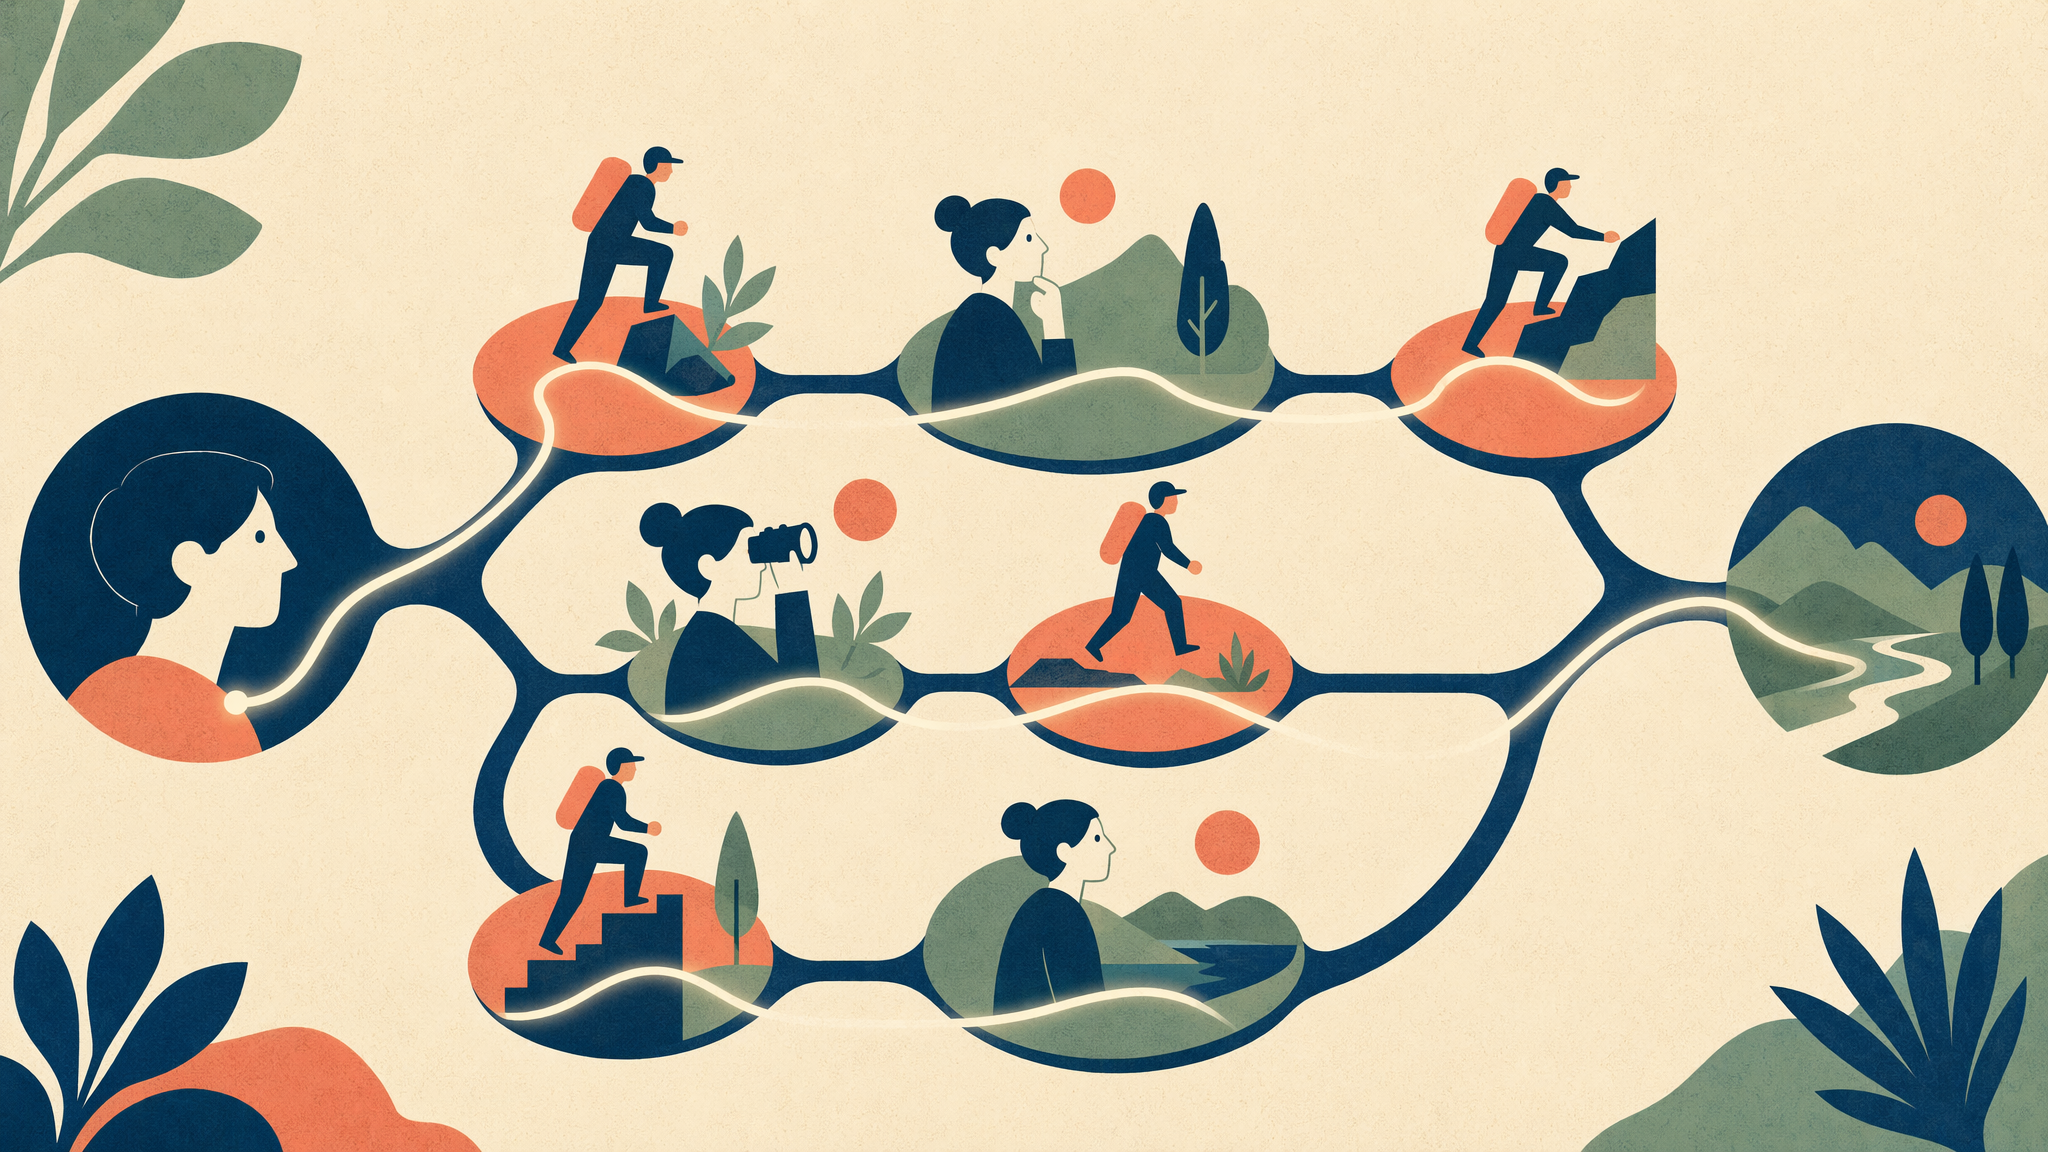
Los tokens de razonamiento se conservan entre turnos, de modo que el modelo retoma cada paso de una conversación de agente de varios turnos con su proceso de pensamiento anterior intacto. Este pensamiento intercalado le permite planificar, actuar, observar y refinar sin descartar la lógica que lo llevó hasta allí. El resultado es una toma de decisiones a largo plazo más estable, una ventaja decisiva cuando una sola tarea abarca muchas llamadas secuenciales a herramientas.
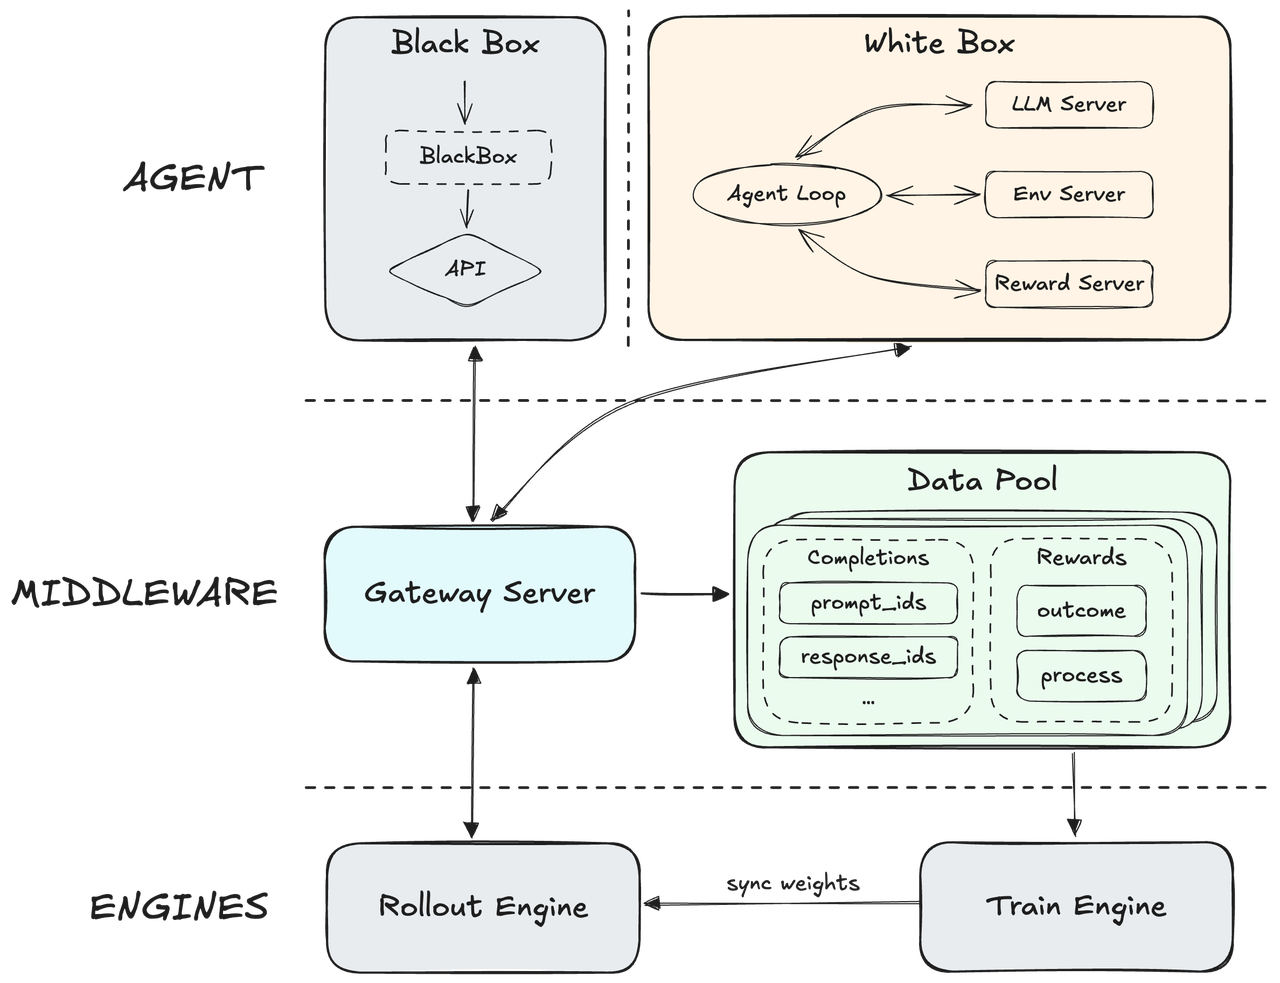
Arquitectura evolutiva mediante RL a gran escala con MiniMax M2.5
Construido sobre un framework Agent RL nativo, MiniMax desacopla su motor central del andamiaje de agentes para generalizarse en cientos de miles de entornos reales diversos. Incorpora un sofisticado mecanismo de recompensa de proceso que utiliza feedback de ejecución en tiempo real para refinar las rutas de razonamiento y garantizar una calidad de salida de élite. Esto crea un sistema altamente adaptativo capaz de mantener una precisión superior mientras maximiza la velocidad de respuesta operativa general.
Una ventana de contexto de 196K-Token en la MiniMax API
Cada solicitud a MiniMax M2.1 cuenta con una ventana de contexto de 196,608-token, lo bastante amplia como para contener monorepos extensos, cientos de páginas de especificaciones o transcripciones largas de agentes en una sola pasada. Como la visión completa permanece residente, el modelo rastrea dependencias entre archivos en lugar de perder el hilo a mitad de la tarea. Los equipos que trabajan con grandes bases de código y corpus de investigación densos obtienen una coherencia que los modelos de contexto corto no pueden igualar.
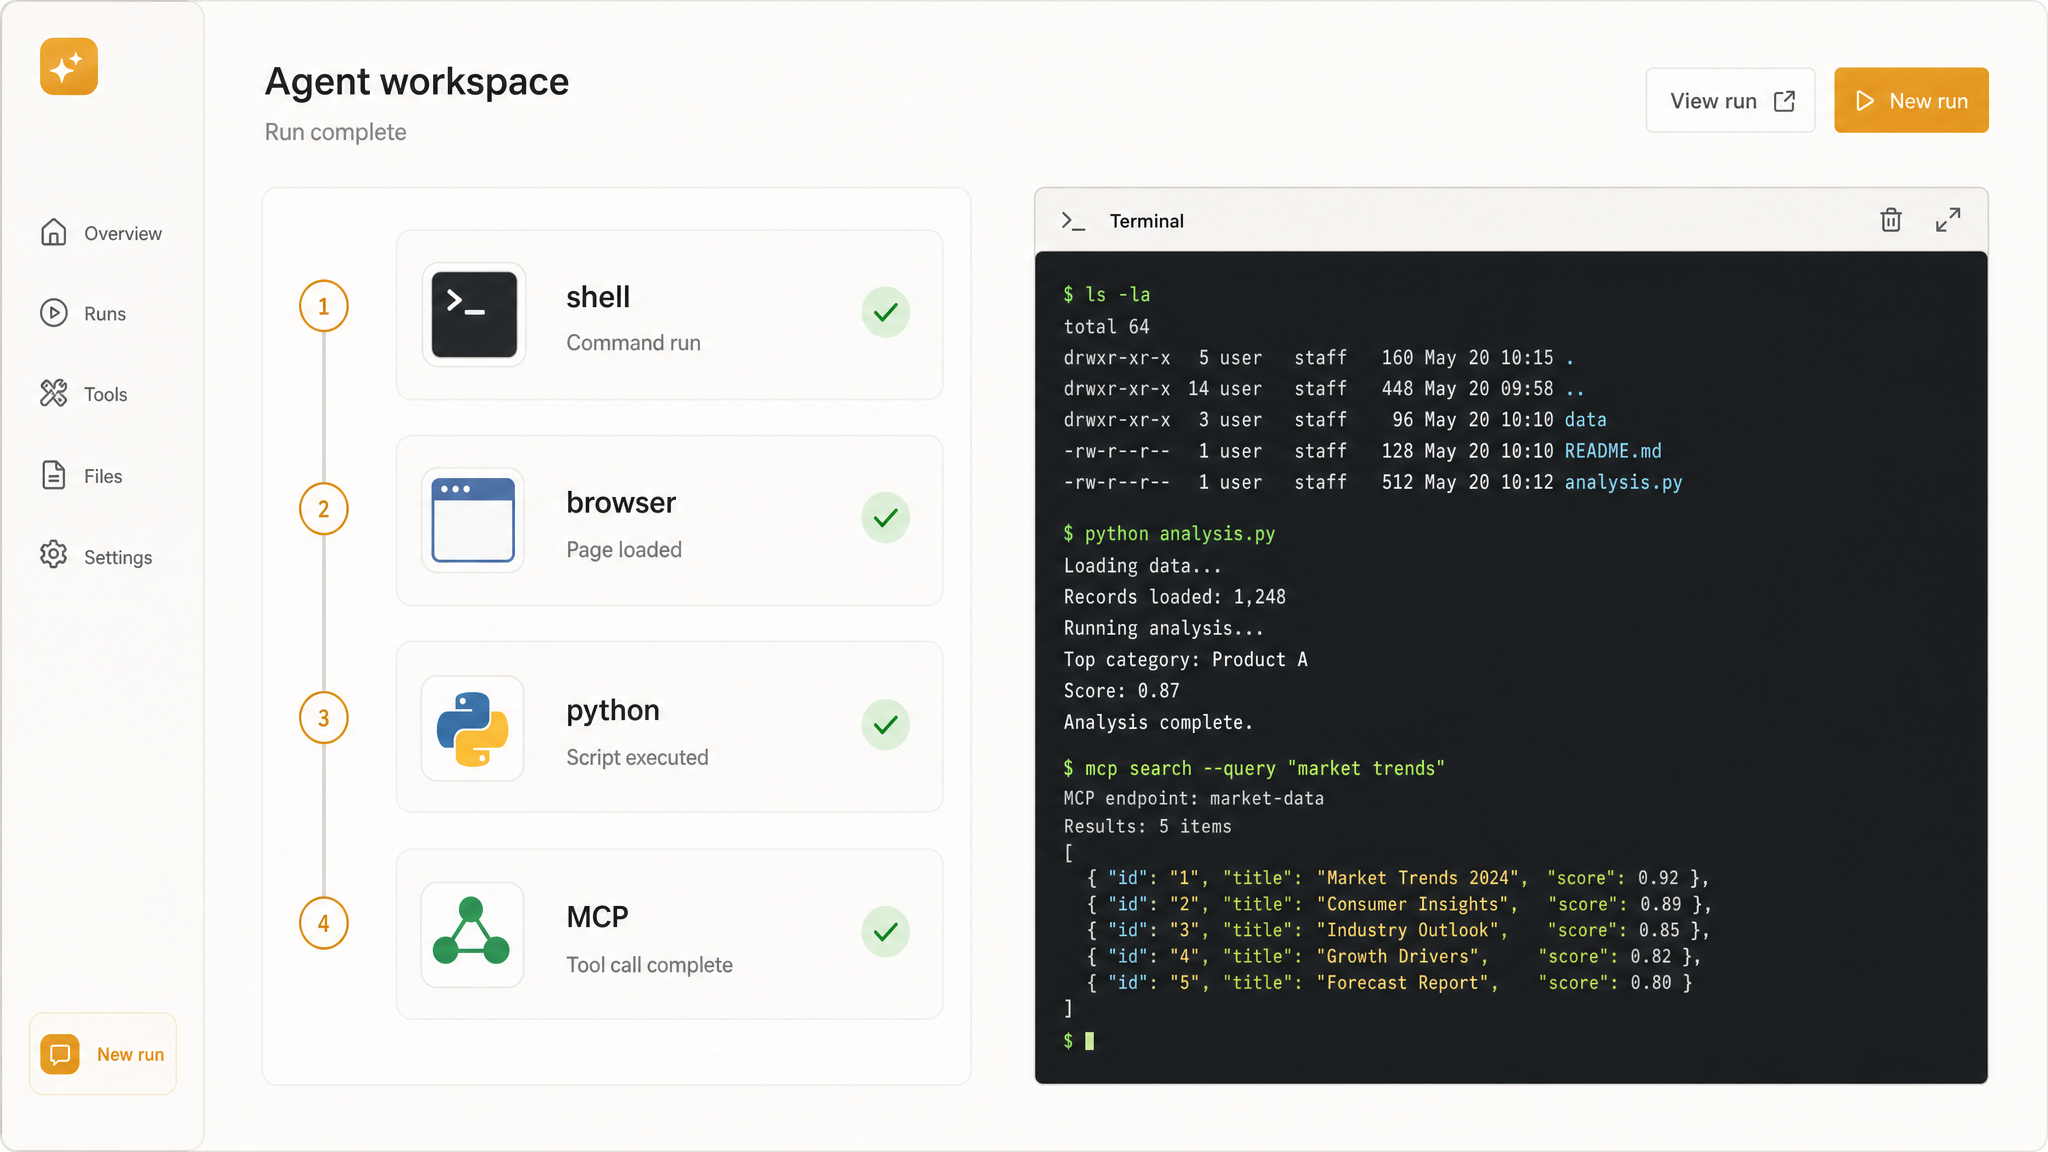
Orquesta Shell, Browser y Code con la MiniMax API
La llamada a funciones convierte a MiniMax M2.1 en un agente activo que orquesta comandos shell, sesiones de navegador, ejecución de Python y herramientas MCP en planes de largo alcance. Encadena decenas de pasos, lee el feedback de ejecución y se autocorrige en lugar de detenerse ante el primer resultado. Con una puntuación de 47.9 percent en Terminal-bench 2.0, se convierte en una base fiable para bucles autónomos de compilación, prueba y despliegue.
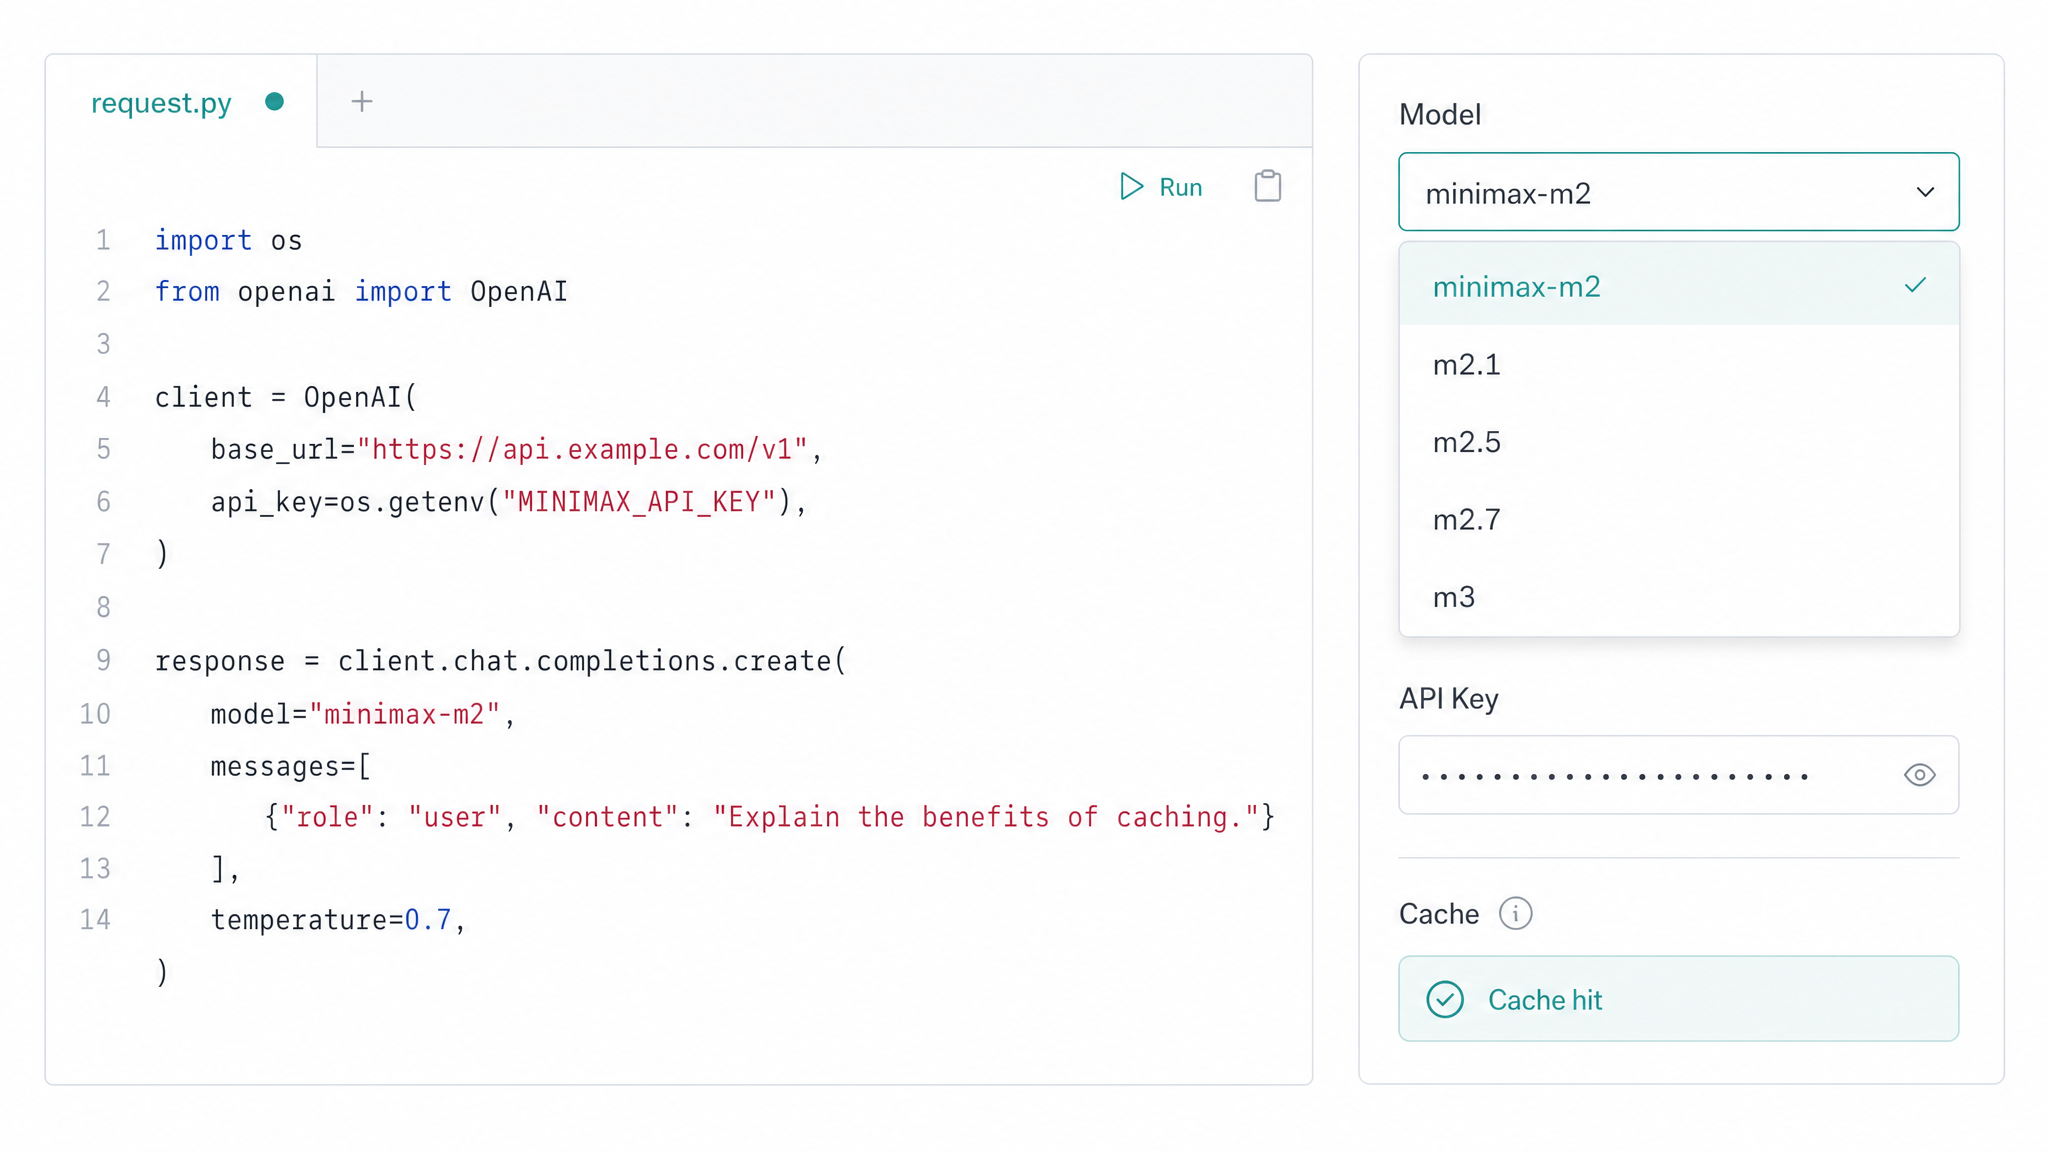
Una sola MiniMax API Key para todos los niveles de modelos
Una sola clave compatible con OpenAI desbloquea toda la línea MiniMax, desde M2 y M2.1 hasta M2.5, M2.7 y M3, junto con Anthropic SDK y acceso HTTP sin procesar. Cambia de nivel editando una única cadena de modelo, sin recablear tu stack. El almacenamiento en caché de prompts factura el contexto repetido a $0.03 per million tokens, por lo que los bucles de agentes iterativos y los prompts de sistema largos siguen siendo asequibles a escala.
Un prompt, tres modelos: el cara a cara de programación con MiniMax API
Envía el mismo prompt de creación a MiniMax API y a dos modelos rivales, y observa cómo cada uno convierte una única instrucción en una página web funcional de un solo archivo.
Una página HTML impecable, de un solo archivo y totalmente autónoma (solo CSS y JavaScript inline — absolutamente sin bibliotecas externas, CDNs, fuentes ni URLs de imágenes; cada textura construida exclusivamente con gradientes CSS, box-shadows e inset shadows) que renderice un BANCO DE TRABAJO DE COMPOSICIÓN TIPOGRÁFICA LETTERPRESS interactivo y skeuomórfico: llena el viewport con una cálida superficie de trabajo de madera de nogal (gradientes marrones en capas + veta sutil mediante repeating linear-gradients y punteado de sombras tipo ruido), iluminada por una única lámpara cálida de tungsteno desde la parte superior izquierda, de modo que las piezas de metal cepillado capten un suave brillo especular y cada objeto elevado proyecte una sombra larga y suave hacia la parte inferior derecha. Lado izquierdo: una caja tipográfica compartimentada (California job case) con celdas en cuadrícula que contienen diminutos tipos móviles de plomo en relieve (letras, números, puntuación), cada tipo como una pieza metálica biselada con un glifo elevado e invertido en espejo en su cara. Centro: un componedor / galera abierta donde se acumulan los tipos colocados. Proporciona un flujo completo y funcional de composición tipográfica: (1) el usuario escribe en el teclado físico O hace clic en glifos de la caja tipográfica, y por cada carácter un tipo de plomo se anima volando desde su celda y cae en el componedor con una nítida animación de asentamiento con microrebote y «clack»; (2) finos bloques espaciadores de plomo arrastrables entre tipos permiten al usuario ajustar el espaciado entre letras/kerning arrastrando, con redistribución del layout en vivo; (3) un rodillo entintador rotatorio (brayer) que el usuario arrastra sobre la forma bloqueada, dejando un brillo de tinta índigo intenso y lustroso (reflejo especular móvil animado) sobre las caras elevadas de los tipos; (4) una palanca de impresión abatible que el usuario presiona (clic sostenido o botón), que baja una hoja de papel verjurado color crema sobre la forma entintada y la estampa — el momento culminante es la palanca regresando por resorte mientras la línea recién impresa aparece en el papel con tipografía letterpress genuinamente hundida: cada letra presionada en el papel con una inset shadow que da una indentación física, tinta que sangra/se deshilacha ligeramente en la veta visible de las fibras del papel, y un tenue halo de impresión de la plancha alrededor del bloque. Paleta: predominan el umber tostado, el dorado latón cepillado y el crema cálido/blanco roto de papel de arroz, con tinta índigo intenso como ÚNICO acento frío. Incluye detalles táctiles: tornillos moleteados de latón, un cierre quoin, botones con tono de madera y estados presionado/activo realistas, y easing satisfactorio en cada transición (cubic-bezier elástico). Hazlo responsive (que escale con elegancia hasta ancho de tablet), mantén todo el estado en vanilla JS, y permite al usuario componer una breve línea completa de poesía, entintarla y tirar una impresión que pueda admirar visualmente — todo debe sentirse artesanal, pesado y ceremonial, con la física de la caída, el arrastre y la impresión transmitida mediante movimiento y sombra, sin ningún recurso externo.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Crea un único archivo HTML completo y autónomo que se abra directamente en cualquier navegador moderno sin dependencias externas — todo el CSS y JavaScript debe estar inline, y no se permiten bibliotecas externas, CDNs, fuentes ni URLs de imágenes (dibuja todo con Canvas 2D o SVG generado en código). Construye un "Banco de trabajo de tren de engranajes de latón" interactivo: un simulador mecánico de engranajes encajables renderizado sobre una mesa polvorienta de planos de ingeniería, donde el usuario ensambla un tren de engranajes funcional y observa cómo una rotación físicamente precisa se propaga por la cadena. Requisitos principales de interacción y simulación: - Renderiza el escenario principal como una superficie de dibujo técnico: una fina cuadrícula cian sobre papel azul de ingeniería profundo con una tenue película de polvo y viñeta, además de marcas de acotación y anotaciones de delineación a lo largo de los bordes. - Proporciona una bandeja/barra lateral de piezas a la izquierda con engranajes de varios tamaños distintos (diferentes números de dientes / módulos, p. ej., 12, 18, 24, 36, 48 dientes). El usuario arrastra un engranaje desde la bandeja al escenario; al soltarlo, se ajusta a la cuadrícula. - Cada engranaje debe dibujarse como una rueda dentada realista de estilo involuta en tonos de latón — cuerpo dorado cálido, borde envejecido con pátina de cobre, reflejo marfil, buje visible, radios y agujero central — con sombreado biselado sutil para que el metal se perciba como metal. - Implementa detección de engrane genuina: cuando dos engranajes colocados están a una distancia entre centros igual a la suma de sus radios primitivos (módulo × dientes / 2) dentro de una tolerancia, se acoplan automáticamente y quedan bloqueados en una cadena accionada; dibuja un indicador de engrane donde los dientes se interbloquean. Las cadenas pueden ramificarse a través de varios engranajes. - Coloca un volante de manivela en la parte inferior izquierda como origen visual y mecánico. El usuario gira la manivela (arrastrando para rotarla o manteniendo pulsado un botón); entonces toda la cadena engranada rota en secuencia. Calcula la velocidad angular y la dirección de cada engranaje descendente estrictamente a partir de la relación de engranajes (ω_out = ω_in × N_in / N_out, alternando la dirección en cada engrane), y anima los dientes para que permanezcan perfectamente sincronizados en fase en el punto de contacto, de modo que ningún diente se solape visualmente ni atraviese otro. - El engranaje final de la cadena mueve una aguja indicadora sobre un medidor circular numerado; la aguja debe mostrar una lectura real derivada de la relación acumulada de engranajes (muestra las RPM de salida calculadas y la relación total como texto en vivo). - Si el usuario intenta colocar engranajes cuya geometría de dientes no puede engranar (espaciado/módulo incompatible), esa unión debe atascarse: parpadear en rojo, detener la propagación más allá de la junta incorrecta y mostrar una pequeña advertencia de "tooth mismatch". - Añade un haz de luz: un rayo de cálida luz matinal inclinado desde una ventana superior a través del escenario, con motas de polvo animadas flotando en el haz y destellos especulares cálidos deslizándose por los dientes de los engranajes al girar, para que la máquina parezca estar despertando. Pulido visual y de UX: - Dirección artística: trazos retro de ingeniería dibujados a mano fusionados con metal fotorrealista — cuadrícula fina de plano técnico bajo latón, bronce envejecido, pátina verde-azulada y blanco marfil; iluminación lateral cálida con sombras largas y suaves para esculpir volumen y profundidad. - La composición debe presentar la manivela como punto de entrada, con la cadena de transmisión cruzando diagonalmente el encuadre. - Incluye un HUD despejado que muestre la velocidad de la manivela, la relación total de engranajes, las RPM de salida y el recuento de engranajes, además de pequeños controles para invertir la manivela, limpiar el escenario y ajustar la velocidad de la manivela con un slider. - Todo debe ser fluido (requestAnimationFrame), responsive al tamaño de la ventana y seguir funcionando de forma interactiva — arrastrar, ajustar a la cuadrícula, engranar y actualizar lecturas deben responder todos en tiempo real. Haz que se sienta táctil, preciso y vivo.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Desarrolle software de producción con la API de MiniMax
Desde compilaciones full-stack multilingües hasta agentes de oficina autónomos, la API de MiniMax convierte la profundidad de programación y el uso de herramientas a largo plazo de M2.1 en flujos de trabajo que su equipo entrega todos los días.

Desarrollo full-stack en varios lenguajes
MiniMax M2.1 escribe y revisa código de producción en Rust, Go, TypeScript, C++ y más, desde sistemas de bajo nivel hasta capas de aplicación. Los equipos que crean servicios políglotas confían en él para mantener la coherencia en todos los niveles.

Apps móviles nativas mediante la MiniMax API
Cuando las funcionalidades de Android y iOS deben lanzarse juntas, la MiniMax API genera Kotlin, Swift y Objective-C alineados con las convenciones de cada plataforma. Esto permite que equipos pequeños mantengan ambas tiendas sin dividir el esfuerzo de ingeniería.

Agentes autónomos de programación en la MiniMax API
Integra M2.1 en tu bucle de agente mediante function calling para planificar tareas de varios pasos, ejecutar herramientas y autocorregirse en horizontes largos. Los desarrolladores lo usan para crear asistentes que completan tickets reales, no solo fragmentos de código.

Empleados digitales para flujos de trabajo de oficina
Actuando como empleado digital, M2.1 ejecuta tareas de principio a fin en administración, finanzas, ciencia de datos y RR. HH. a partir de comandos en texto simple. Los equipos de operaciones lo implementan para despachar trabajo administrativo repetitivo a escala.

Razonamiento sobre toda la base de código con contexto de 196K
¿Necesitas refactorizar un repositorio desconocido? Con una ventana de contexto de 196.61K tokens, M2.1 lee cientos de archivos a la vez, rastrea dependencias y saca a la luz los cambios que una migración realmente requiere.

Interfaces web interactivas con la MiniMax API
Su sólida comprensión del diseño permite a la MiniMax API crear frontends web pulidos, interacciones complejas e incluso simulaciones de escenas científicas en 3D. Los equipos de producto lanzan dashboards y visualizaciones con gran cantidad de datos directamente desde un prompt.
Cómo se compara la API de MiniMax con otros LLMs de programación y agentes
Compare la API de MiniMax con modelos rivales de agentes y programación en Atlas Cloud, analizando en detalle la ventana de contexto, el límite de salida y los precios de tokens de pago por uso.
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
Cómo usar MiniMax en Atlas Cloud
Empieza en minutos — sigue estos sencillos pasos para integrar y desplegar modelos a través de la plataforma de Atlas Cloud.
Crea una cuenta en Atlas Cloud
Regístrate en atlascloud.ai y completa la verificación. Los nuevos usuarios reciben créditos gratuitos para explorar la plataforma y probar modelos.
Por Qué Usar MiniMax en Atlas Cloud
Combina modelos avanzados de MiniMax con la plataforma acelerada por GPU de Atlas Cloud, proporcionando rendimiento, escalabilidad y experiencia de desarrollo incomparables.
Rendimiento y Flexibilidad
Baja Latencia:
Inferencia optimizada por GPU para respuestas en tiempo real.
API Unificada:
Una sola integración para acceder a MiniMax, GPT, Gemini y DeepSeek.
Precios Transparentes:
Facturación por Token, soporta modo Serverless.
Empresa y Escala
Experiencia del Desarrollador:
SDK, análisis de datos, herramientas de ajuste fino y plantillas todo en uno.
Confiabilidad:
99.99% de disponibilidad, control de permisos RBAC, registros de cumplimiento.
Seguridad y Cumplimiento:
Certificación SOC 2 Type II, cumplimiento HIPAA, soberanía de datos en EE.UU.
Preguntas sobre la API de MiniMax, respondidas
La API de MiniMax ofrece a los desarrolladores acceso programático a la familia MiniMax de modelos de lenguaje grandes creada por MiniMax AI, una serie diseñada para programación, uso agéntico de herramientas y razonamiento a largo plazo. En Atlas Cloud accedes a estos modelos mediante un único endpoint compatible con OpenAI, con precios transparentes de pago por uso y acceso Day-0 a los nuevos lanzamientos.
Atlas Cloud aloja los modelos de texto de la serie M, incluidos MiniMax M2.5, MiniMax M2.7 y el modelo insignia MiniMax M3, junto con MiniMax Music 2.6 para generación de música a partir de texto. Todos los modelos comparten la misma autenticación y el mismo endpoint, así que cambiar entre ellos solo implica modificar un identificador de modelo en tu solicitud.
Estos modelos están optimizados para ingeniería de software de extremo a extremo, con capacidad para gestionar edición de varios archivos, bucles de compilar-ejecutar-corregir y reparaciones validadas por pruebas en muchos lenguajes de programación. También funcionan bien en entornos agénticos que requieren llamadas a funciones, planificación de varios pasos y recuperación ante errores de ejecución, lo que los convierte en una opción natural para agentes de programación autónomos y flujos de trabajo guiados por herramientas.
Como la API de MiniMax es compatible con OpenAI, puedes apuntar el SDK estándar de OpenAI a la URL base de Atlas Cloud, pasar tu clave y definir el campo model con la versión que quieras. Streaming, llamadas a funciones y salida estructurada en JSON funcionan todos mediante la misma interfaz, por lo que la mayoría de las integraciones existentes solo necesitan cambiar la URL base y la clave para empezar.
Las ventanas de contexto varían según la versión. MiniMax M2 admite aproximadamente 200K tokens, suficiente para cargar una base de código grande o documentación extensa en una sola solicitud, mientras que el M3 más reciente amplía esto a unos 1 million tokens. Usa el modelo con mayor contexto cuando tu tarea abarque muchos archivos o material de referencia largo.
La facturación es de pago por uso y se mide por token, sin necesidad de suscripción. Los modelos de texto de la serie M2 empiezan en $0.30 por millón de tokens de entrada y $1.20 por millón de tokens de salida, mientras que M3, de mayor capacidad, tiene un precio de $0.60 por millón de tokens de entrada y $2.40 por millón de tokens de salida; la entrada almacenada en caché se factura a una tarifa menor.
Sí. MiniMax ha publicado como open source los pesos de la serie M bajo una licencia MIT modificada que añade un requisito de atribución para despliegues comerciales muy grandes. Puedes autoalojar los pesos para evaluación y luego pasar a la API de Atlas Cloud cuando necesites infraestructura gestionada, disponibilidad constante y evitar el mantenimiento de GPU.
MiniMax busca ofrecer calidad de frontera en programación y agentes a una fracción del coste de modelos propietarios más grandes, usando un diseño mixture-of-experts que activa solo unos 10 billion de sus 230 billion parámetros por token. Si tu carga de trabajo es generación de código, refactorización o agentes que usan herramientas con un presupuesto ajustado, ofrece un sólido equilibrio entre capacidad, velocidad y precio. La posición en benchmarks cambia con cada lanzamiento, así que valida la versión actual con tus propias tareas antes de comprometerte.
Explorar Más Series
Seedance 2.5
¡La API de Seedance 2.5 ya está disponible en Atlas Cloud! Ofrece a los desarrolladores el modelo de video más reciente de ByteDance. Genera hasta 30 segundos de video nativo en una sola pasada a partir de texto, una sola imagen o hasta 50 referencias multimodales, con audio sincronizado y texto multilingüe en el encuadre. En Atlas Cloud puede acceder a él mediante una única clave, con consistencia del sujeto y físicas mejoradas que mantienen la coherencia en las tomas largas.

Wan 3.0
La API Wan 3.0 es la próxima generación de la familia de videos Wan de Alibaba, diseñada para llevar la generación de formato largo, el control de múltiples referencias y la calidad audiovisual a nuevas alturas. Atlas Cloud ya aloja Wan 2.7, 2.6 y 2.5, y Wan 3.0 se ejecuta con la misma clave unificada sin necesidad de configuración adicional. Empieza a construir hoy mismo. Desplázate hacia abajo hasta la galería para ver lo que Wan 3.0 puede crear.
MiniMax H3
MiniMax H3 es la familia de vídeo multimodal de MiniMax para la creación guiada por texto, imagen y referencias. En las rutas compatibles, conserva los sujetos del material de referencia, ofrece relaciones de aspecto flexibles y combina el sonido generado con los elementos visuales mediante H3 Developer, con perfiles de salida seleccionados según el endpoint. Atlas Cloud reúne toda la familia bajo una única clave compatible con OpenAI, con precios transparentes de pago por uso a partir de la tarifa estándar de $0.038 por segundo. Empieza a crear hoy mismo.
Seedream 5.0 Pro
La API de Seedream 5.0 Pro ofrece a los desarrolladores el modelo de edición de imágenes controlable de ByteDance en Atlas Cloud. Sitúa las ediciones con precisión mediante anclajes y coordenadas, separa las imágenes en capas editables, fusiona múltiples referencias y empareja colores y materiales exactos, con texto multilingüe a 2K y 3K. ¡En Atlas Cloud puede acceder a él mediante una sola clave!
Seedance 2.0
Seedance 2.0 es el modelo de vídeo para producción de ByteDance, diseñado para crear planos con precisión. Convierte prompts en vídeo, anima una imagen del primer fotograma con orientación opcional del último fotograma o da forma a los resultados mediante medios de referencia y búsqueda web opcional. Atlas Cloud reúne estos flujos de trabajo en una única API unificada, con precios transparentes de pago por uso y una sola clave compatible con OpenAI. Empieza a crear hoy mismo.
GPT Image 2.5
La familia gpt-image-2.5 de OpenAI ofrece a los desarrolladores la posibilidad de elegir entre Flare y Sunburst para flujos de trabajo de producción de imágenes. Renderiza con resoluciones arbitrarias de hasta 3840x2160 y elige entre cinco niveles de calidad, incluidos xhigh y max, para adaptarte a requisitos de salida específicos. Atlas Cloud proporciona inferencia REST lista para usar, sin arranques en frío y con precios estándar desde $0.004 por generación. Empieza a crear hoy mismo.
GPT Image 2
La API de GPT Image 2 ofrece a los desarrolladores acceso al último modelo de imágenes de OpenAI, el sucesor de GPT Image 1.5. Genera y edita imágenes con una representación de texto precisa en caracteres latinos y CJK, además de una sólida composición para carteles, maquetas e infografías. En Atlas Cloud, puede acceder a ella a través de una API unificada junto con más de 300 modelos, con créditos gratuitos, un tiempo de actividad del 99,99% y sin necesidad de verificación de organización de OpenAI.
Gemini Omni Flash
La API de gemini omni pone a disposición de los desarrolladores la familia Gemini Omni Flash nativamente multimodal de Google DeepMind, incluido Gemini Omni 1.1 Flash. Crea vídeos cinematográficos con audio nativo sincronizado, anima imágenes estáticas con un control preciso de los fotogramas inicial y final, o revisa metraje existente mediante ediciones guiadas por texto que conservan el contenido no modificado. Atlas Cloud proporciona una única clave compatible con OpenAI, acceso unificado y precios transparentes de pago por uso. Empieza a desarrollar hoy mismo.
Grok Imagine
La API Grok Imagine cubre los modelos de imagen, video y voz de xAI, desde Image 2.0 hasta Video 1.5 y xAI TTS v1. Genera imágenes de 1K o 2K en 14 relaciones de aspecto, expande una escena a 15 segundos de movimiento en 1080p, controla tomas con hasta 7 imágenes de referencia, o nárralas en 20 idiomas. Atlas Cloud ejecuta todos los modos en un endpoint, con precios de pago por uso desde $0.02 por imagen y $0.05 por segundo. Empieza a construir hoy.
Los modelos creativos más potentes de Google están todos disponibles en Atlas Cloud. Veo 3.1 ofrece generación de video cinematográfico, Nano Banana 2 impulsa la creación de imágenes de alta fidelidad y Gemini aporta inteligencia multimodal a cada flujo de trabajo. Acceda a la suite completa de modelos de Google a través de una sola API key con disponibilidad Day-0 y precios de pago por uso (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini lleva la generación de video multimodal de ByteDance a los flujos de trabajo donde la velocidad y el costo son más importantes. Ofrece las capacidades principales de Seedance 2.0 con un menor consumo de recursos: generación más rápida, menor costo por video y la misma integración de API que ya utiliza. Para los equipos que ejecutan pipelines de alto volumen o crean prototipos a escala, Mini es la opción predeterminada práctica.
ByteDance
Desde la generación de video cinematográfico hasta la creación de imágenes de alta fidelidad, los modelos más potentes de ByteDance están disponibles en Atlas Cloud. Ejecute Seedance y Seedream a gran escala con los precios de inferencia más bajos y cero gastos generales de infraestructura.
Artículos recomendados
Guías, tutoriales y novedades de producto para aprovechar al máximo Atlas Cloud.





