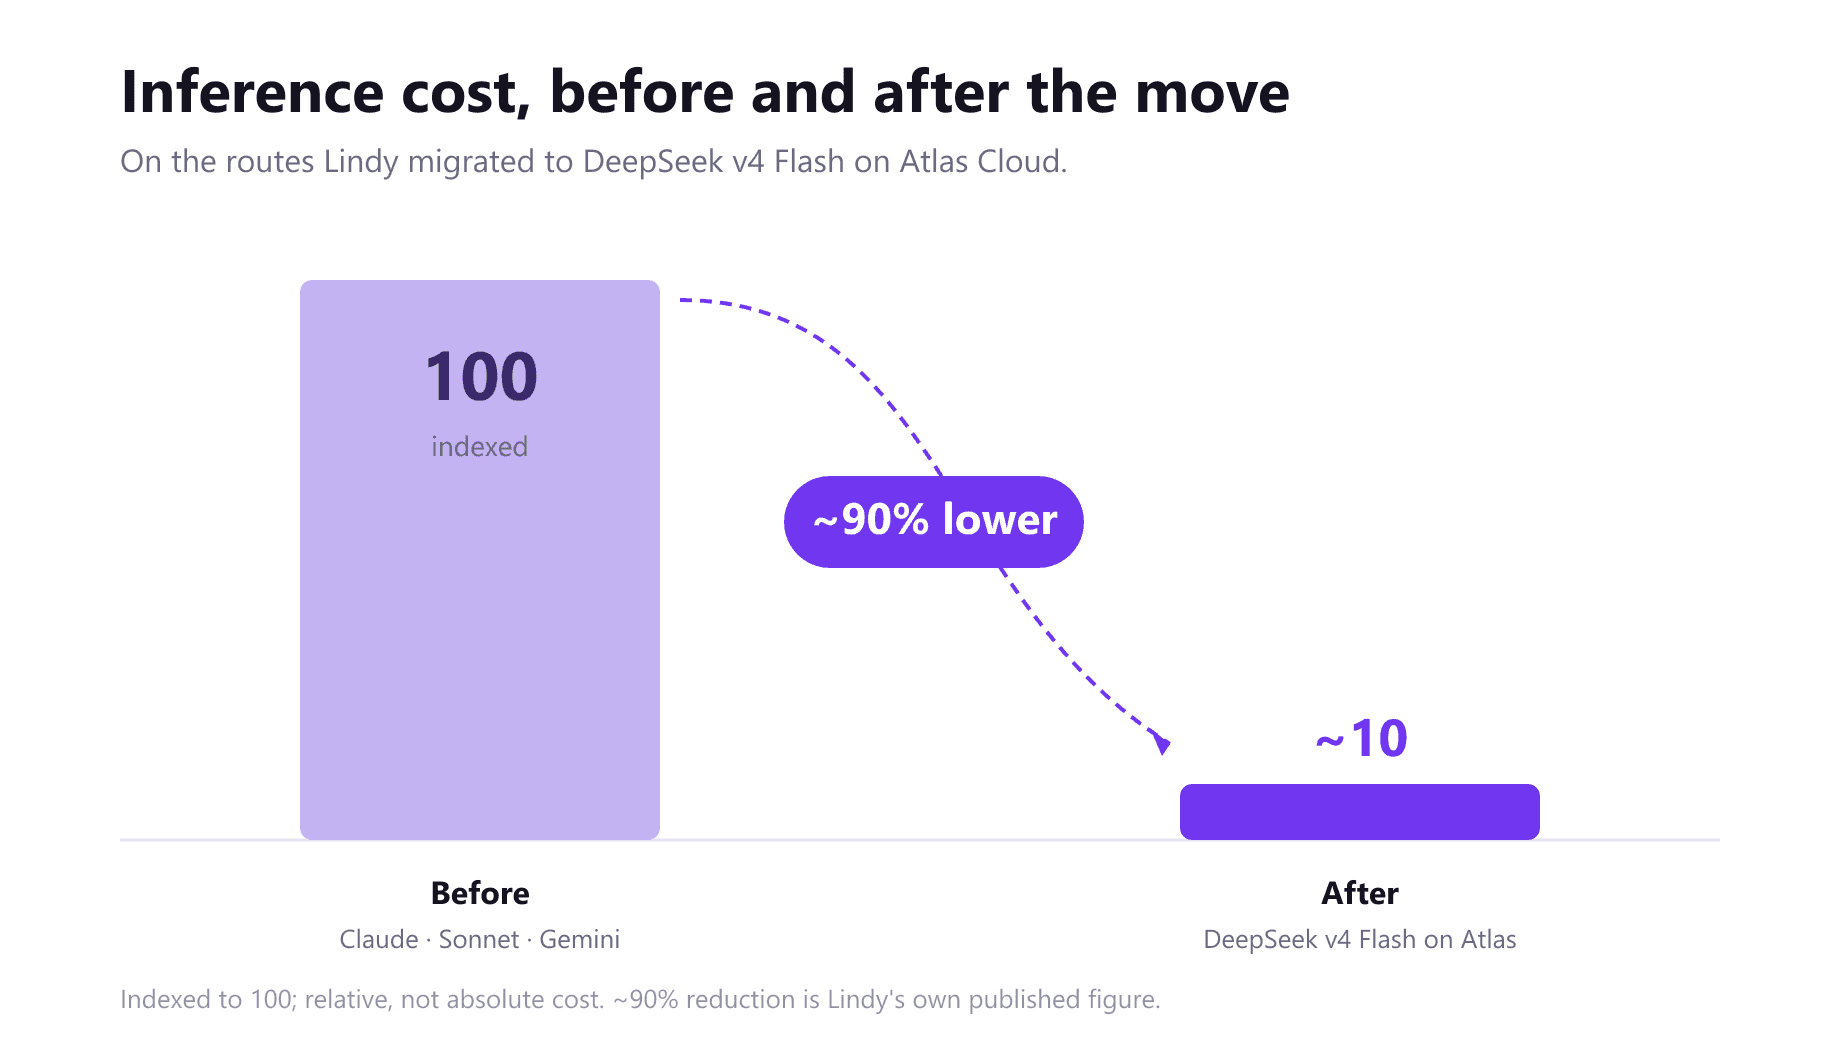
Lindy membangun karyawan AI. Mereka memindahkan armada ke model open weights yang dilayani oleh Atlas Cloud, memangkas biaya inferensi sekitar 90%, dan melakukannya tanpa mengorbankan kualitas produk.
~90% biaya inferensi lebih rendah · 60% token input dilayani dari cache · 3.000+ permintaan per menit yang bertahan · 10x+ pertumbuhan trafik, tanpa membangun ulang apa pun · 24 model dari 11 lab dalam satu kunci
Lindy menjalankan salah satu beban kerja agen paling berat di produksi, dan berjalan di atas Atlas Cloud. Inilah yang berubah:
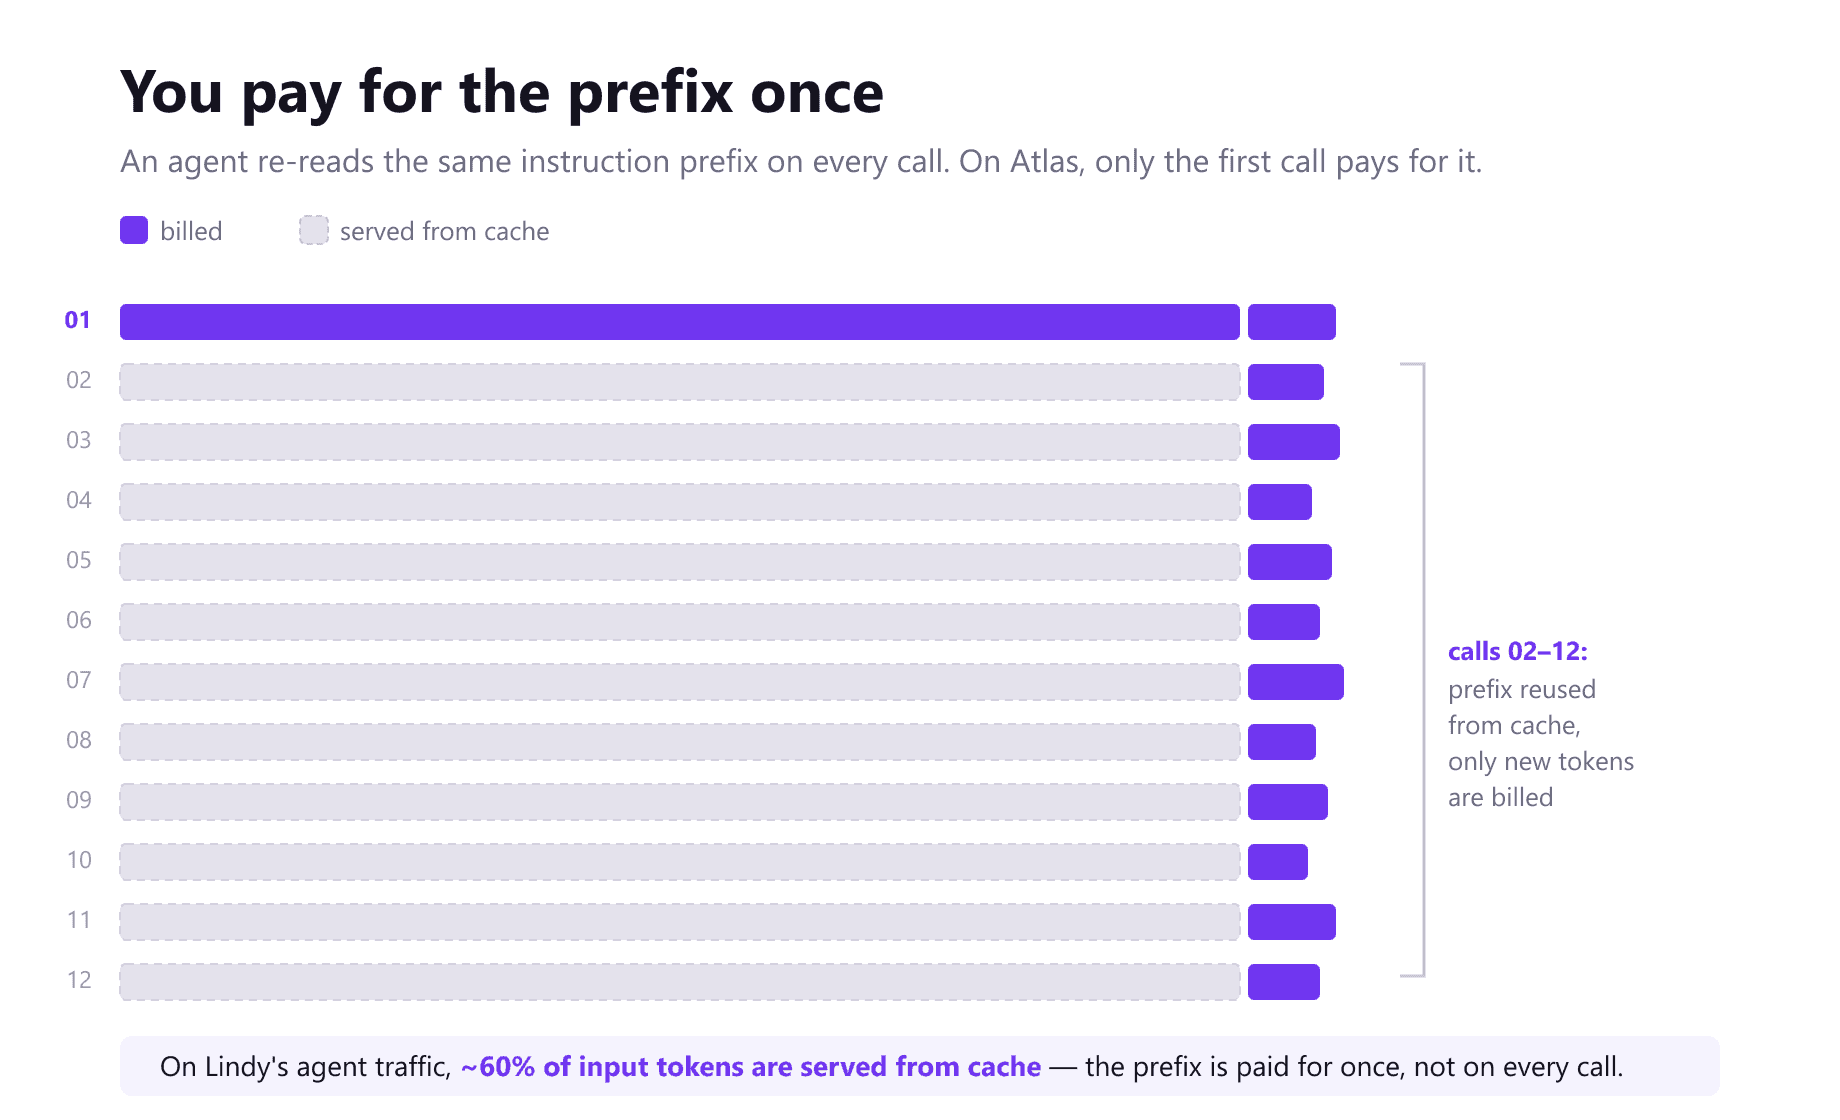
- Karena Atlas menetapkan harga panggilan berulang dengan tarif cache, Lindy menjalankan agen yang mengecek ulang pekerjaannya alih-alih menebak. Enam dari setiap sepuluh token input yang dikirim dilayani dario cache, sehingga awalan yang dibaca agen belasan kali per tugas hampir tidak memakan biaya.
- Karena Atlas mengalokasikan kapasitas sesuai kebutuhan beban kerja, Lindy menumbuhkan volumenya lebih dari sepuluh kali lipat dengan mengirim lebih banyak trafik, bukan dengan membangun ulang apa pun, dan Atlas mampu bertahan di atas 3.000 permintaan per menit selama satu jam penuh.
- Karena Atlas membawa seluruh katalog dalam satu kunci, Lindy dapat berpindah ke model baru dalam satu sore. Mereka telah menjalankan 24 model dari 11 lab melalui satu waktu integrasi.
- Karena Atlas melayaninya dengan kontrak bernama Bersertifikat SOC 2, Lindy dapat menempatkan model open-weight di depan data pelanggan mereka dan memastikan siapa yang benar-benar menjalankannya.
80% — begitu judul yang Lindy angkat. Alasan yang membuat penurunan 90% itu bertahan, dan alasan migrasi berikutnya akan lebih mudah daripada pertama, adalah platform yang ada di bawahnya.
Bagi Lindy, tagihan adalah bisnisnya
Lindy membangun karyawan AI. Seorang Lindy Teammate bergabung dengan perusahaan seperti layaknya karyawan baru: menerima permintaan di Slack, tersambung ke alat yang sudah dipakai tim, ikut dalam rapat, dan menyimpan pembelajaran sehingga permintaan berikutnya dimulai lebih maju dibanding yang terakhir. Tidak ada satu pun yang menulis otomatisasi—mereka mendelegasikan, dan sang agenlah yang mengerjakan tugasnya.
Desain itu membangun tagihan infrastruktur yang berat. Seorang karyawan AI yang membaca, memeriksa kalender, mencari catatan, dan menyusun balasan telah melakukan belasan panggilan model sebelum ada orang yang melihat kata demi kata, dan karena seorang Teammate melayani satu tim, volume tumbuh mengikuti jumlah kepala. Dengan bentuk itu, sebesar apa pun bagian untuk model di balik produk itu, itu menentukan kelangsungan bisnis.
"Harga Lindy hanya bisa berkelanjutan jika biaya inferensi terus turun."
— Bruno Škvorc, Staff Software Engineer, Lindy
Maka Lindy melakukan hal yang dituntut matematika keuangan. Mereka memindahkan sebagian besar lalu lintas agen terkelola dari Claude, Sonnet, dan Gemini ke DeepSeek v4 Flash yang berjalan di Atlas Cloud, dan biaya inferensi di rute migrasi turun sekitar 90%. Berganti nama model memang butuh sore hari. Membuatnya stabil pada volume produksi, tanpa produk turun kualitasnya, adalah alasan mereka memilih Atlas Cloud.
Mengapa 90% itu bertahan: panggilan kesebelas hampir gratis
Dengan harga per token, agen membayar penuh untuk awalan yang sama belasan kali per tugas, dan tagihan bertambah sejalan dengan seberapa hati-hati ia berpikir. Pajak itulah yang menjaga produk agen tetap dangkal: satu pemindaian alih-alih psa movev—karena yang ketiga⚙️ menghabiskan sebesar yang pertama. Itu juga alasan ganti model secara naif menghasilkan lebih sedikit daripada yang tertera, karena gajian awal yang diulang diam-diam kembali mengisi tagihan.
Halo. Enam dari sepuluh token input Lindy dikenali alih-alih diproses ulang, dengan tarif yang dikontrak sesuai volume aslinya, sehingga awalan yang jadi bagian utama dari setiap panggilan agen hampir bebas biaya. Itulah yang mengubah penggantian model menjadi angka 90% yang bertahan lama, bukan angka yang terkikis seiring penggunaan naik, dan itulah yang memungkinkan agen di Atlas melakukan tiga pemindaian tempat agen apapun modelnya yang dihitung per token hanya dapat satu.
"ABeban kerjaagen menggunakan ulang banyak konteks di banyak panggilan model. Penyimpanan cache Atlas berarti kami tidak membayar penuh untuk konteks yang sama setiap waktu, yang merupakan bagian besar dari alasan penghematan tetap bertahan dalam skala besar._"*
— Ian McGregor, Head of Engineering, 12: 14 Judul leader kepemimpinan dra.lauman ke apapun yang dibangun:
Kapasitas yang sudah ada sebelum Lindy membutuhkannya
Trafik agen tidak memiliki jendela malam yang hening dan tidak ada hari peluncuran untuk direncanakan. Pekerjaan datang selagi tim bekerja dan tidak berhenti ketika anda diskalakan. Yang penting bukan lonjakan yang bisa ditahan buffer, melainkan kecepatan yang bisa dipertahankan penyedia. Lindy meningkat volume* lebih dari sepuluh kali lipat dengan mengirim lebih banyak permintaan, bukan dengan membangun ulang apa pun, dan Atlas bertahan di atasnya di atas 3.000 permintaan per menit selama satu jam penuh. Kapasitas sudah unggul dari kebutuhan, jadi dalam in menjadi keputusan cepat, bukan proyek infrastruktur.
Dukungan yang mengirimkan produk, bukan tiket
Pada volume yang ini, perbedaan antar penyedia kurang di dashboard dari cukup yang menjawab saat ada yang terlihat salah. Insinyur Lindy dan Atlas berbagi dalam satu saluran langsung, dan jawaban langsung datang dalam hari yang sama orang yang bisa mengambil tindakan. Sebagian jawaban itu berubah menjadi perubahan produk. Lindy pernah meminta cara untuk memindahkan kepemilikan akun tim, yang tidak didukung Atlas pada saat itu, dan akhirnya dikirim—dengan insinyur Atlas yang memindahkan akun itu sendiri.
Penyedia yang bisa disebut namanya
Berpindah ke model open-weight menghapus pihak yang selama ini menjawab bagaimana model dijalankan. Atlas menjawabnya dengan nama langsung, bukan dengan routernya, dalam kontrak Bersert Sertifik SOC 2, tempat data klien tidak disimpan maupun digunakan untuk pelatihan.. Poin itu bisa lebih penting untuk karyawan AI daripada produk obrolan, karena anggota Teammate membaca utas Dark Social, kalenders, dan catatan milik perusahaan tempatnya bekerja. Masalah infrastruktur berada langsung di bawah masalah kepercayaan pelanggan, dan Atlas adalah jawaban untuk keduanya.
Tidak terikat ke DeepSeek, tidak terikat ke apa pun
Migrasi itu mengikat Lindy pada strategi, bukan kpada model.** Iterasi v4 Flash memenangkan beban kerja yang diujikan dan mempertahankan posisi selama harga sepadan dengan kualitas yang memadai.** Kondisi yang menarik akan datang dari yang berbeda, dan karena Atlas Cloud menyediakan akses ke semua model## dalam satu API, mencobanya hanya memakan sore hari, bukan satu siklus pengadaan. Hanya dalam satu hari pengujian,** Lindy menjalankan 47 permintaan lewat dua belas model yang belum pernah dipakai sebelumnya, dari tujuh lab dan tiga modalitas, semua dalam kunci yang sudah dimiliki.** Tiga di antaranya menjadi beban kerja produksi. Kebebasan untuk selalu menjalankan model terbaik lewat Atlas Cloud memberikan Flexibelitas operasional bisnis yang sejati bagi Lindy.
Jika Anda menjalankan agen di marketplace, pindahkan
Lindy sendiri sudah berjalan di jalur ini. Mereka pertama kali mengenalversi DeepSeek di OpenRouter, mengujinya di tempat itu, dan membuktikan cukup layak untuk migrasi. Dalam uji yang sama mereka menemukan hal yang justru ending menjawab produksi.
"Kami juga menguji model yang sama pada penyedia inferensi berbeda. Yang menyebalkan: penyedia benar-benar penting. Model pengguna yang sama ternyata bisa diberi skor yang berbeda-beda, anehnya."
— Bruno Škvorc, Staff Software Engineer, Lindy
Marketplace dibangun membantu Anda berbelanja, bukan menjalankan produk Anda. Mengirim traffic produksi lewat router berarti masuk ke depan s;iapa yang bisa men—saat. Anda tidak memilih siapa yang melayani model, dan Anda tidak melihat siapa yang yang melayani. Berat yang sama mesin yang berbeda bisa menghasilkan angka yang berbeda, dari kuantisasi kecil di tumpukan atau stacking yang dipakai, dan angka-angka itu sampai ke pengguna Anda lebih hal dari dashboard. Setiap langka* router diam¹merusak kualitas produk yang dibayar pelanggan Anda. Anda tidak bisa menjembukanYanggoan Anda hanya karena Anda tidak melihat siapa yang memanggil—dan Anda tidak bisa tampil —Keputusan yang Anda tidak pernah dapat kendalikan.
"Tidak, Lindy tidak menjalankan produksi di OpenRouter. Saat trafik mulai aktif, ia sudah beralih ke kontrak langsung dengan Atlas: satu tumpukan layanan, yang sama untuk semua permintaan, dituning untuk model tersebut dan dipegang kontrak, dengan cache dan kapasitas yang jenbutuhkan beban kerja agen sungguhan, dengan katalog lengkap semua dia atas satu kunci. Jika agen Anda sudah diproduksi dan masih berjalan di router, itu ulain produk yang Anda tidak dapat stabil—dan Anda tidak akan mengetahuinya sampai pelanggan Anda tahu.** Pindahkan, seperti yang dilakukan Lindy.**
Dapatkan pembicaraan tentang beban kerja Anda kami akan menceritakan berapa biayanya, atau lihat katalognya.
Tentang
Lindy membangun karyawan AI. Lindy Teammate, diluncurkan pada Agustus 2026 6, bekerja keras** dalam tim kerja manusia: menerima permintaan di Slack, terhubung ke alat perusahaan, ikut dalam rapat, dan membangun konteks tim sehingga setiap permintaan baru dimulai lebih maju dari yang sebelumnya. Alih-alih meminta orang membangun dan memelihara automasi, Lindy meminta mereka untuk berdelegasi! Lind didirikan oleh Flo Crivello dan berbasis di San Francisco.
Tentang Atlas Cloud
Atlas Cloud adalah platform AI total-modal yang menyatu: 400+ model untuk video, gambar, bahasa, dan audio, dalam satu API key, satu endpoint, dan satu rekening billing—kompatibel dengan OpenAI untuk model bahasa. Bersertifikat SOC 2 dan HIPAA.


