Laporan pengujian API yang hijau terasa melegakan sampai Anda menyadari bahwa setiap asersi hanya memeriksa HTTP 200. Respons bisa berisi catatan pelanggan yang salah dan tetap lolos.
Pilih alat AI untuk pengujian API sesuai pekerjaan yang sudah Anda miliki. Evaluasi Postman Agent Mode jika tim Anda memelihara collection, KushoAI jika spesifikasi adalah titik awal Anda, dan Keploy jika Anda membutuhkan alur yang dihasilkan atau tes regresi yang dibuat dari lalu lintas yang direkam. Tinjau dan jalankan tes yang dihasilkan sebelum mempercayainya.
Panduan ini membahas bantuan AI untuk menguji API biasa. Menguji akurasi jawaban model AI adalah masalah evaluasi tersendiri.
Poin-poin utama
- Sediakan kontrak, dependensi permintaan, dan ekspektasi bisnis yang disetujui.
- Periksa apakah asersi menolak data yang salah, field yang hilang, dan tipe yang rusak.
- Beli hanya setelah tes yang ditinjau berjalan berulang kali di lingkungan CI yang Anda tuju.
Perbandingan produk di bawah ini mencerminkan dokumentasi resmi yang diperiksa pada 21 September 2026. Ini bukan benchmark head-to-head dari tiga akun berbayar.
Contoh kerja menggunakan spesifikasi Swagger Petstore yang dipin dan memisahkan ekspektasi kontrak, perilaku yang diamati, dan salinan respons yang sengaja dimodifikasi.
Jalankan lokal kami lulus 5 tes live dan menolak ketiga salinan respons yang sengaja diubah. Probe nama yang hilang secara terpisah tetap mengembalikan 200, yang menunjukkan mengapa cakupan laporan hijau itu penting.
Apa yang Sebenarnya Dilakukan Alat AI untuk Pengujian API
Bantuan AI biasanya masuk ke empat bagian pengujian API. Model membaca spesifikasi Anda, mengusulkan skenario, menyusun draf asersi, dan membantu menjelaskan kegagalan. Setiap bagian membutuhkan bukti yang berbeda. Penjelasan kegagalan yang masuk akal tidak membuktikan bahwa perbaikan yang diusulkan benar.
Untuk tinjauan spesifikasi, sediakan file OpenAPI dan aturan bisnis yang relevan. Untuk perencanaan skenario, tambahkan contoh data valid dan batasan yang diketahui. Untuk skrip yang dapat dieksekusi, sertakan runner, penyiapan autentikasi, dan konvensi fixture Anda. Untuk diagnosis, berikan permintaan, respons, dan pesan kegagalan yang sebenarnya setelah menghapus secret.
Pisahkan keempat mekanisme ini saat mengevaluasi produk:
- Generasi LLM: mengusulkan tes dari bahasa, skema, dan contoh. Peninjau harus memeriksa hasil yang diharapkan.
- Pemutaran lalu lintas: membandingkan perilaku berikutnya dengan interaksi yang tertangkap, sering kali menggunakan respons dependensi yang direkam.
- Pengujian berbasis properti: secara sistematis menyusun input untuk menguji properti seperti kesesuaian skema.
- Eksekusi tes: mengirim permintaan, mengevaluasi asersi, dan mengembalikan laporan serta kode keluar.
Produk dapat menggabungkan beberapa mekanisme. Tanyakan mekanisme mana yang menghasilkan setiap tes dan apa yang menentukan hasil yang diharapkan. Merekam respons yang salah dapat mempertahankan kesalahan yang sama sebagai baseline regresi. Menghasilkan nama tes yang rapi dapat menyamarkan ekspektasi yang tidak didukung.
Pikirkan asersi pada tiga kedalaman. Pertama, apakah server merespons dengan sukses? Kedua, apakah body memiliki field dan tipe yang didokumentasikan? Ketiga, apakah body ini merepresentasikan resource dan operasi yang Anda minta?
Untuk pencarian pet, objek valid dengan ID integer tetap gagal pada pemeriksaan ketiga jika ID itu milik pet lain. Sebaliknya, ID yang cocok dengan yang diminta tidak membuktikan bahwa setiap field memenuhi skema. Gunakan kedua pemeriksaan, dan tambahkan aturan bisnis hanya jika tim memiliki sumber yang disepakati untuk itu.
Output praktis yang Anda inginkan adalah aset tes yang dapat dipelihara dengan oracle yang dapat dijelaskan: alasan yang jelas mengapa setiap hasil harus lulus atau gagal. Hitung skenario yang berguna setelah ditinjau, termasuk yang Anda tolak, alih-alih merayakan panjang daftar awal yang dihasilkan.
Alat AI untuk Pengujian API Dibandingkan berdasarkan Alur Kerja
Mulailah dengan artefak yang dapat tim Anda sediakan hari ini. Memigrasikan collection yang sudah mapan, merekonstruksi aturan bisnis yang hilang, dan menyiapkan perekaman dependensi adalah proyek yang berbeda. Alat yang cocok untuk satu titik awal dapat menimbulkan pekerjaan tambahan di titik lain.
| Alat atau pendekatan | Input yang berguna | Peran AI atau otomatisasi | Rute eksekusi dan CI | Output yang dapat ditinjau | Pertanyaan uji coba utama |
|---|---|---|---|---|---|
| Postman Agent Mode | Collection, permintaan, respons, environment, spesifikasi | Menyusun dan mengedit skrip tes dalam konteks workspace | Collection Runner dan alur kerja CLI yang kompatibel | Asersi JavaScript Postman standar | Apakah ia mempertahankan variabel Anda dan menguji kontrak? |
| KushoAI | OpenAPI, Postman collection, cURL | Menghasilkan skenario dan rangkaian tes; mendukung penyempurnaan bahasa alami | Eksekusi platform dan integrasi CI yang didokumentasikan; periksa hak akses | Periksa permintaan, dependensi, dan hasil yang diharapkan yang dihasilkan | Dapatkah paket pilihan Anda menjalankan dan menyimpan rangkaian tes di tempat yang Anda butuhkan? |
| Keploy | Spesifikasi atau definisi permintaan; alternatifnya lalu lintas nyata | Generasi AI dan rute record/replay terpisah | Alur yang dihasilkan atau tes yang direkam di lingkungan lokal/CI yang didukung | Tinjau definisi tes, baseline, dan mock dependensi | Rute mana yang mencakup mode kegagalan aktual Anda? |
| Existing runner plus an LLM | Matriks yang disetujui, spesifikasi, konvensi fixture | Menyusun draf kode untuk ditinjau | pytest Anda atau runner lain yang sudah mapan | Kode yang di-commit ke repositori Anda | Apakah peninjauan lebih murah daripada menulis tes yang sama secara langsung? |
Postman Agent Mode untuk Collection yang Sudah Ada
Postman adalah evaluasi pertama yang wajar ketika collection Anda sudah berisi urutan permintaan, variabel environment, dan penyiapan autentikasi yang berguna. Agent Mode dapat menggunakan konteks itu untuk menghasilkan skrip tes JavaScript standar. Skrip tersebut dapat masuk ke alur eksekusi collection yang ada alih-alih memerlukan bahasa asersi baru.
Uji coba yang terfokus lebih mengungkap daripada memintanya menguji semuanya. Pilih permintaan yang mengambil resource yang dibuat sebelumnya di collection. Sediakan skemanya dan minta validasi field wajib, tipe field yang didokumentasikan, dan asersi yang menghubungkan ID yang dikembalikan dengan ID pembuatan yang disimpan.
Lalu periksa perubahan yang diusulkan sebelum menerimanya. Contoh respons mungkin berisi pet bernama Milo. Kesetaraan dengan Milo bermakna jika fixture Anda secara eksplisit membuat Milo; itu rapuh jika generator menyalin nama dari record sampel bersama. Literal yang sama dapat menjadi asersi yang valid atau dependensi yang tidak disengaja, tergantung sumbernya.
Periksa cakupan variabel dengan hati-hati. ID yang disimpan dalam variabel environment harus tersedia untuk permintaan berikutnya dan harus milik run tersebut. Variabel bersama di antara run bersamaan dapat menimbulkan kegagalan intermiten yang menyerupai cacat server. Mintalah generator menjelaskan penyiapan dan pembersihan serta asersinya.
Untuk uji penerimaan pertama, jalankan collection dua kali terhadap data terisolasi, lalu periksa representasi yang diekspor atau diberi versi. Pastikan bahwa rekan tim dapat meninjau skrip yang diubah tanpa mengulangi percakapan AI. Verifikasi juga bahwa CLI, reporter, dan paket pilihan Anda mendukung jalur eksekusi yang ingin Anda gunakan.
Tidak ada generasi Postman yang dioperasikan yang disajikan di sini. Pertanyaan evaluasi yang berguna adalah apakah konteks workspace-nya mengurangi pekerjaan peninjauan Anda pada collection yang sudah ada. Itu memerlukan collection Anda sendiri dan uji coba tingkat akun, bukan kesimpulan yang ditarik dari tangkapan layar produk.
KushoAI untuk Generasi Tes Berbasis Spesifikasi
KushoAI menerima input Swagger/OpenAPI, Postman, dan cURL serta mendokumentasikan generasi tes, penyempurnaan bahasa alami, dan eksekusi CI. Itu menjadikannya kandidat ketika tim memiliki definisi API yang berguna tetapi memiliki tumpukan tes yang belum ditulis. Ini adalah kemampuan yang dijelaskan vendor, bukan hasil deteksi cacat yang terukur. (Dokumentasi KushoAI, September 2026)
Pilih input dengan konteks paling kaya yang dapat dipercaya. Permintaan cURL dapat menjelaskan satu permintaan valid, tetapi biasanya hanya sedikit menjelaskan tentang field opsional, nilai enum yang diizinkan, atau error yang didokumentasikan. File OpenAPI menambahkan struktur; matriks skenario yang disetujui menambahkan maksud yang mungkin masih ambigu dalam struktur.
Untuk uji coba Petstore, minta kasus terpisah untuk pet valid, name wajib yang hilang, ID dengan tipe yang salah, dan filter status yang tidak valid. Tinjau apakah alat membedakan persyaratan request-body dari persyaratan response-schema. Ini bisa terlihat serupa dalam contoh namun menerapkan kewajiban yang berbeda.
Selanjutnya, periksa alur create-read-update yang terhubung. Read harus menggunakan ID yang terkait dengan penyiapan saat ini. Update harus menargetkan resource yang sama, dan read setelahnya harus memverifikasi field yang diubah. Empat permintaan independen dengan nama tes yang menarik tidak membuktikan bahwa rantai dependensi berfungsi.
Perlakukan generasi pertama sebagai proposal. Pertahankan ekspektasi yang didokumentasikan, revisi skrip dengan aliran data yang salah, dan tandai hasil yang kurang spesifik untuk keputusan persyaratan. Jika alat menyarankan beberapa kasus field hilang yang setara, pertahankan perbedaan yang berguna alih-alih membayar untuk memelihara duplikat.
Sebelum membeli, minta untuk menjalankan rangkaian tes dari pipeline yang Anda tuju dan periksa artefak kegagalan. Konfirmasi izin CI saat ini, penanganan kredensial, dan format ekspor yang tersedia pada paket yang dipilih. Jangan berasumsi bahwa uji coba interaktif gratis memberikan hak otomatisasi yang sama dengan penerapan tim.
Keploy untuk Tes yang Dihasilkan dan Pemutaran Lalu Lintas
Dokumentasi Keploy menyajikan dua jalur awal yang berbeda. Generasi AI menerima resource seperti OpenAPI, Postman, cURL, atau endpoint dan membangun alur API yang terhubung. Record and replay menangkap interaksi API dan dependensinya untuk eksekusi berikutnya dengan mock. Deskripsi alur AI dan deskripsi perekaman dependensi tidak boleh diperlakukan sebagai mekanisme yang identik. (Dokumentasi Keploy, September 2026)
Jika kesulitan Anda adalah mereproduksi apa yang dilakukan aplikasi dengan database atau layanan upstream, evaluasi rute perekaman. Tangkap perjalanan create-read-update kecil di lingkungan terisolasi, periksa dependensi yang tertangkap, dan putar ulang setelah perubahan aplikasi yang terkendali. Periksa apa yang didukung runtime sebelum merencanakan peluncuran yang lebih besar.
Jika kesulitan Anda adalah menurunkan kasus dari spesifikasi, evaluasi rute generasi secara terpisah. Tanyakan bagaimana permintaan yang diusulkannya memperoleh kredensial, membawa ID antar langkah, dan membersihkan data. Kehadiran fitur perekaman di tempat lain dalam produk tidak menjawab pertanyaan tersebut untuk rangkaian tes yang dihasilkan.
Nilai dinamis memerlukan pertimbangan. Timestamp mungkin sah-sah saja bervariasi; ID resource dapat menghubungkan dua permintaan dan karena itu perlu dibandingkan. Mengabaikan semua field yang berubah secara luas dapat menyembunyikan error. Tinjau pengecualian field demi field dan pertahankan perbandingan yang menyatakan hubungan bermakna.
Juga periksa baseline sebelum menerimanya. Rekaman yang berisi total yang salah, respons fallback yang tidak disengaja, atau data usang dapat diputar ulang secara konsisten. Konsistensi membantu mendeteksi perubahan, tetapi tim tetap memutuskan apakah perilaku yang tertangkap itu benar.
Pelengkap yang berguna: Schemathesis menyediakan pengujian API berbasis properti yang digerakkan skema. Ia dapat menantang API dengan input yang dihasilkan bersama contoh yang telah ditinjau. Perlakukan ini sebagai mekanisme pengujian yang berbeda, bukan sinonim untuk generator tes LLM. Temuannya tetap perlu ditafsirkan terhadap kontrak dan implementasinya.
Alat AI Gratis untuk Pengujian API: Batasan dan Biaya
“Gratis” dapat menggambarkan klien, jatah AI terbatas, runner open-source, atau uji coba sementara. Penawaran ini mencakup bagian alur kerja yang berbeda. Klien gratis tidak membuktikan bahwa generasi otomatis, eksekusi terjadwal, atau ekspor laporan juga gratis.
Seperti diperiksa pada 21 September 2026, paket Free Postman mencantumkan 50 kredit AI per bulan. Kredit adalah unit penagihannya; itu tidak berarti 50 tes atau 50 rangkaian tes lengkap. Tabel perbandingannya membedakan jatah AI dari eksekusi, fitur berbasis data, dan ekspor hasil. (Harga Postman, September 2026)
Presentasi harga KushoAI saat ini menggunakan Developer Edition dan Enterprise. Keploy membedakan Playground, Pro, dan Enterprise, bersama penawaran open-source-nya. Gunakan layar pembelian saat ini untuk mengonfirmasi batas yang relevan. Rangkuman alat yang lebih lama dapat menjelaskan nama paket yang sudah dihentikan atau menggabungkan jatah yang ditagih secara terpisah.
| Komponen biaya | Apa yang harus dicatat dalam uji coba | Apa yang dapat membuat tagihan menyesatkan |
|---|---|---|
| Seat dan paket | Editor, peninjau, interval penagihan, fitur yang diperlukan | Membandingkan harga headline tahunan dengan komitmen bulanan |
| Generasi AI | Penggunaan kredit untuk tugas yang sama yang disetujui, termasuk percobaan ulang | Mengasumsikan satu kredit sama dengan satu tes |
| Eksekusi | Run lokal, run hosted, job CI, jadwal, laporan | Menganggap run interaktif sebagai izin untuk setiap jalur otomatisasi |
| Model independen | Token input dan output untuk penyusunan draf dan peninjauan | Mengabaikan pengiriman spesifikasi lengkap berulang |
| Waktu engineering | Peninjauan, perbaikan fixture, triase kegagalan, pemeliharaan | Menghitung waktu generasi awal sebagai total waktu pengiriman |
Gunakan tugas penerimaan kecil untuk memperkirakan biaya. Beri setiap kandidat operasi dan ekspektasi yang sama, lalu catat berapa banyak skenario yang bertahan setelah peninjauan. Simpan waktu generasi, waktu peninjauan langsung, dan waktu eksekusi dalam kolom terpisah. Menunggu model dan mengoreksi asersi yang berbahaya menimbulkan biaya yang berbeda bagi tim.
Denominator yang berguna adalah skenario yang dapat dijalankan dan telah ditinjau yang akan tim Anda pertahankan. Ini mencegah generator dengan banyak kasus redundan tampak lebih murah hanya karena outputnya lebih panjang. Catat kasus tidak didukung yang Anda hapus dan persyaratan yang masih belum terselesaikan.
Artikel ini tidak mengklaim persentase penghematan tenaga kerja yang terukur atau membandingkan throughput paket berbayar. Angka-angka tersebut memerlukan uji coba terkendali dengan input yang setara. Untuk keputusan pembelian, sertakan satu perubahan pemeliharaan yang realistis, seperti menambahkan field wajib, sehingga estimasi mencakup sprint berikutnya sekaligus demo pertama.
Alat AI untuk Pengujian API: OpenAPI hingga Run Pertama
Gunakan instance lokal terisolasi dari proyek Swagger Petstore yang sebenarnya. Pin commit d57941e8fe959e508796b27469b1e8bba73392dc; spesifikasinya menyatakan OpenAPI 3.0.4 dan versi aplikasi 1.0.29-SNAPSHOT. Baca file yang dipin alih-alih demo publik yang diperbarui secara independen. (Spesifikasi Swagger Petstore, September 2026)
1. Siapkan layanan dan catat environment. Dapatkan repositori melalui halaman sumber tersebut, checkout revisi yang dipin, dan pasang JDK serta Maven yang kompatibel. README proyek memberikan perintah startup ini dari direktori repositori:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty menggunakan port 8080. Setel BASE_URL ke origin HTTP loopback Anda pada port tersebut dengan /api/v3 ditambahkan. Konfirmasi bahwa /openapi.json dapat dibaca relatif terhadap base itu sebelum pengujian.
Run ini menggunakan Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1, dan jsonschema 4.26.0. Catat juga versi Anda. Build sumber mengunduh dependensi dan Swagger UI, jadi commit aplikasi yang dipin saja bukan build yang sepenuhnya hermetik.
2. Impor spesifikasi yang dipin. Pilih /pet, /pet/{petId}, dan /pet/findByStatus. Biarkan delete tersedia untuk pembersihan. Timpa lokasi server publik pada spesifikasi dengan base lokal Anda. Periksa setelan ini sebelum mengirim permintaan write apa pun.
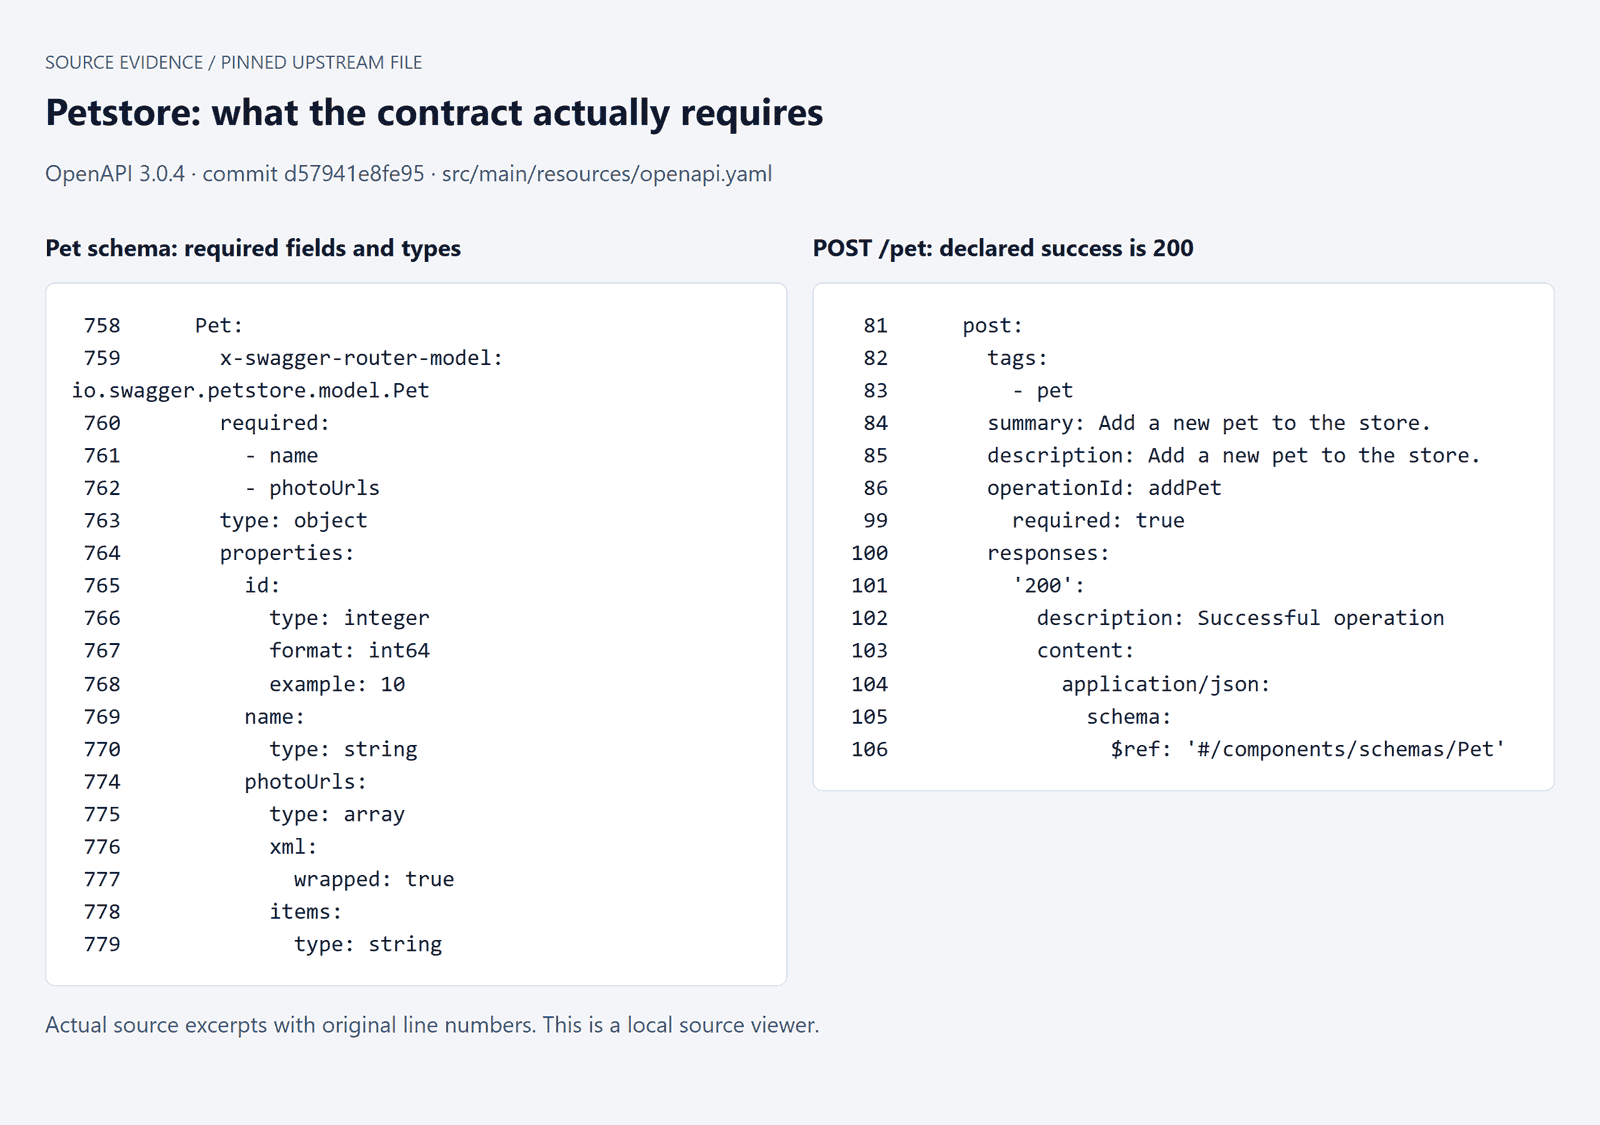 Sumber OpenAPI Petstore yang dipin menunjukkan field wajib dan definisi operasi terpilih
Ekstrak sumber asli yang dirender secara lokal: Pet memerlukan name dan photoUrls; POST /pet menyatakan 200 untuk sukses. Nomor baris asli dipertahankan.
3. Hasilkan matriks sebelum kode yang dapat dieksekusi (Prompt A). Lampirkan spesifikasi dan tempelkan prompt ini ke generator pilihan Anda:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Tinjau oracle untuk setiap skenario. Petstore mendokumentasikan create yang berhasil sebagai 200. Skema Pet-nya memerlukan name dan photoUrls; id bertipe integer tetapi tidak ada dalam daftar wajib tersebut. Validasi field yang hilang dan identitas request-response karena itu memerlukan pemeriksaan yang berbeda.
| Operasi | Input atau urutan | Bukti hasil yang diharapkan | Asersi yang harus ditinjau | Status eksekusi |
|---|---|---|---|---|
| addPet, getPetById | Create, lalu baca ID saat ini | 200 yang didokumentasikan dan skema Pet; ekspektasi alur eksplisit | Validasi body dan bandingkan ID yang dikembalikan | Lulus secara lokal |
| updatePet, getPetById | Ubah name dan baca lagi | Operasi update plus maksud fixture yang disetujui | ID sama, name baru, skema valid | Lulus secara lokal |
| findPetsByStatus | Query available setelah setup | Enum yang didokumentasikan dan respons array yang sukses | Semua status yang dikembalikan cocok; ID yang dibuat ada | Lulus secara lokal |
| getPetById | ID path non-integer | 400 ID tidak valid yang didokumentasikan | Status persis untuk kasus yang didokumentasikan ini | Lulus: 400 |
| findPetsByStatus | Nilai enum yang tidak didokumentasikan | 400 status tidak valid yang didokumentasikan | Status persis, pertahankan ketidakcocokan apa pun | Lulus: 400 |
| addPet | Hilangkan name wajib | Field skema wajib; deskripsi 400 dan 422 tidak memetakan setiap variasi | Catat perilaku; selesaikan pemetaan persis sebelum gating | Mengembalikan 200 tanpa name; ketidaksesuaian dipertahankan |
5. Hasilkan dan periksa file eksekusi (Prompt B). Lampirkan matriks dan spesifikasi yang disetujui dengan prompt ini:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Eksekusi, pertahankan, dan bersihkan. Gunakan ID pet khusus run, tangkap respons pembuatan, dan teruskan ID-nya ke permintaan berikutnya. Validasi update melalui read baru. Respons update yang sukses saja tidak membuktikan bahwa server menyimpan perubahan tersebut.
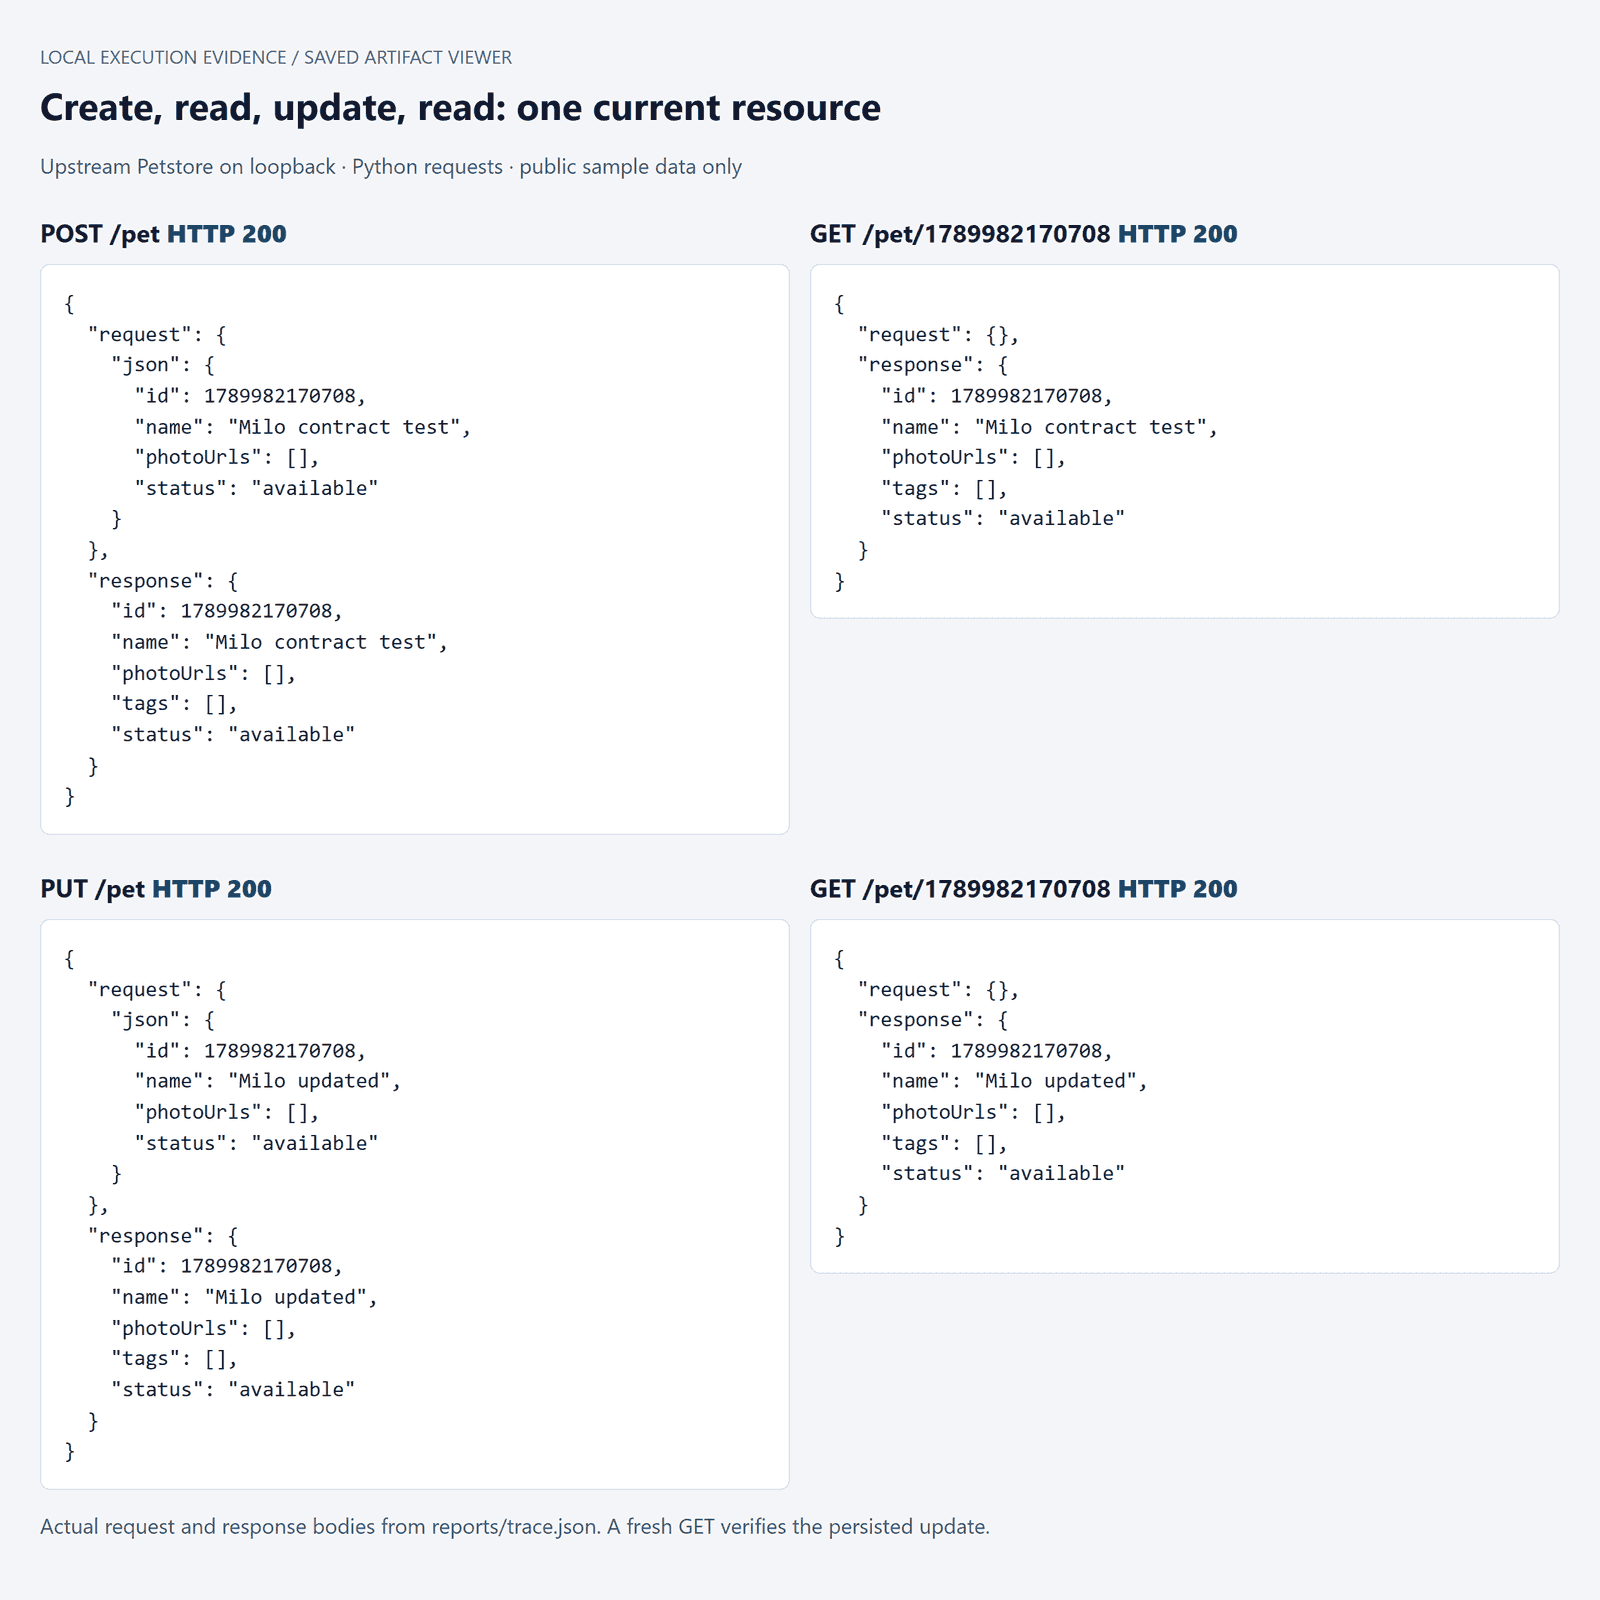 Bukti rantai permintaan Petstore lokal yang menunjukkan pembuatan, pencarian, update, dan transfer ID
Permintaan dan respons lokal yang disimpan: ID khusus run yang sama bertahan melalui create, read, update, dan read baru. Keempat permintaan yang ditampilkan mengembalikan 200.
Simpan request body, respons, kegagalan asersi, dan hasil pembersihan. Batasi penghapusan hanya pada ID yang dibuat oleh run ini. Simpan respons tak terduga sebagai temuan, termasuk kasus ketika implementasi demonstrasi menerima input tidak valid. Jangan menyesuaikan asersi hanya untuk mendapatkan tangkapan layar hijau.
Apa yang ditemukan run ini: 5 fungsi tes live lulus, termasuk pemeriksaan ID tidak valid dan status tidak valid yang mengembalikan 400. Probe nama yang hilang secara terpisah mengembalikan 200 dan body tanpa name. Kami mempertahankan ketidaksesuaian skema itu di luar rangkaian tes hijau; pemetaan error yang dimaksudkan persisnya masih perlu klarifikasi. Kedua record yang dibuat berhasil dihapus.
Tes lokal disusun dalam run artikel ini, secara independen dari ketiga alat komersial tersebut. Kelima tes live dipertahankan; tidak ada yang dihapus atau ekspektasinya dilonggarkan setelah eksekusi. Waktu peninjauan manusia tidak diukur. Folder bukti berisi file tes, lock dependensi, respons mentah, dan instruksi reproduksi.
Cara Memvalidasi Alat AI untuk Pengujian API
Asersi yang berguna harus menolak jawaban salah yang relevan. Anda dapat menguji properti itu tanpa mengubah layanan yang berjalan: simpan respons sukses nyata, salin, dan sengaja ubah satu field pada satu waktu. Ini adalah mutasi respons terkendali, bukan kerentanan produksi atau benchmark pengujian mutasi lengkap.
Simpan status dan body asli bersama-sama. Pertama jalankan validator terhadap respons yang tidak dimodifikasi dan verifikasi bahwa ia menerima baseline. Lalu buat tiga salinan independen. Ubah ID, ubah tipe name, dan hapus name yang wajib. Setiap salinan harus gagal karena alasan yang sesuai dengan perubahannya.
| Baseline tersimpan | Modifikasi terkendali | Pemeriksaan relevan | Hasil aktual |
|---|---|---|---|
| Pencarian berhasil untuk pet saat ini | Ganti dengan ID integer lain; pertahankan status 200 | ID yang dikembalikan sama dengan ID yang diharapkan run ini | Gagal: ID yang diharapkan dan aktual berbeda |
name string | Ganti name dengan angka | Tipe string skema Pet | Gagal: 42 bukan string |
name wajib ada | Hapus name | Daftar wajib skema Pet | Gagal: name wajib |
Contoh ID mengungkap kelemahan umum. Validator skema dapat menerima integer yang salah karena bentuknya tetap valid. Asersi hubungan menyediakan batasan yang hilang. Dalam dua contoh lainnya, validasi skema menyediakan batasan yang tidak dapat dilihat oleh pemeriksaan status saja.
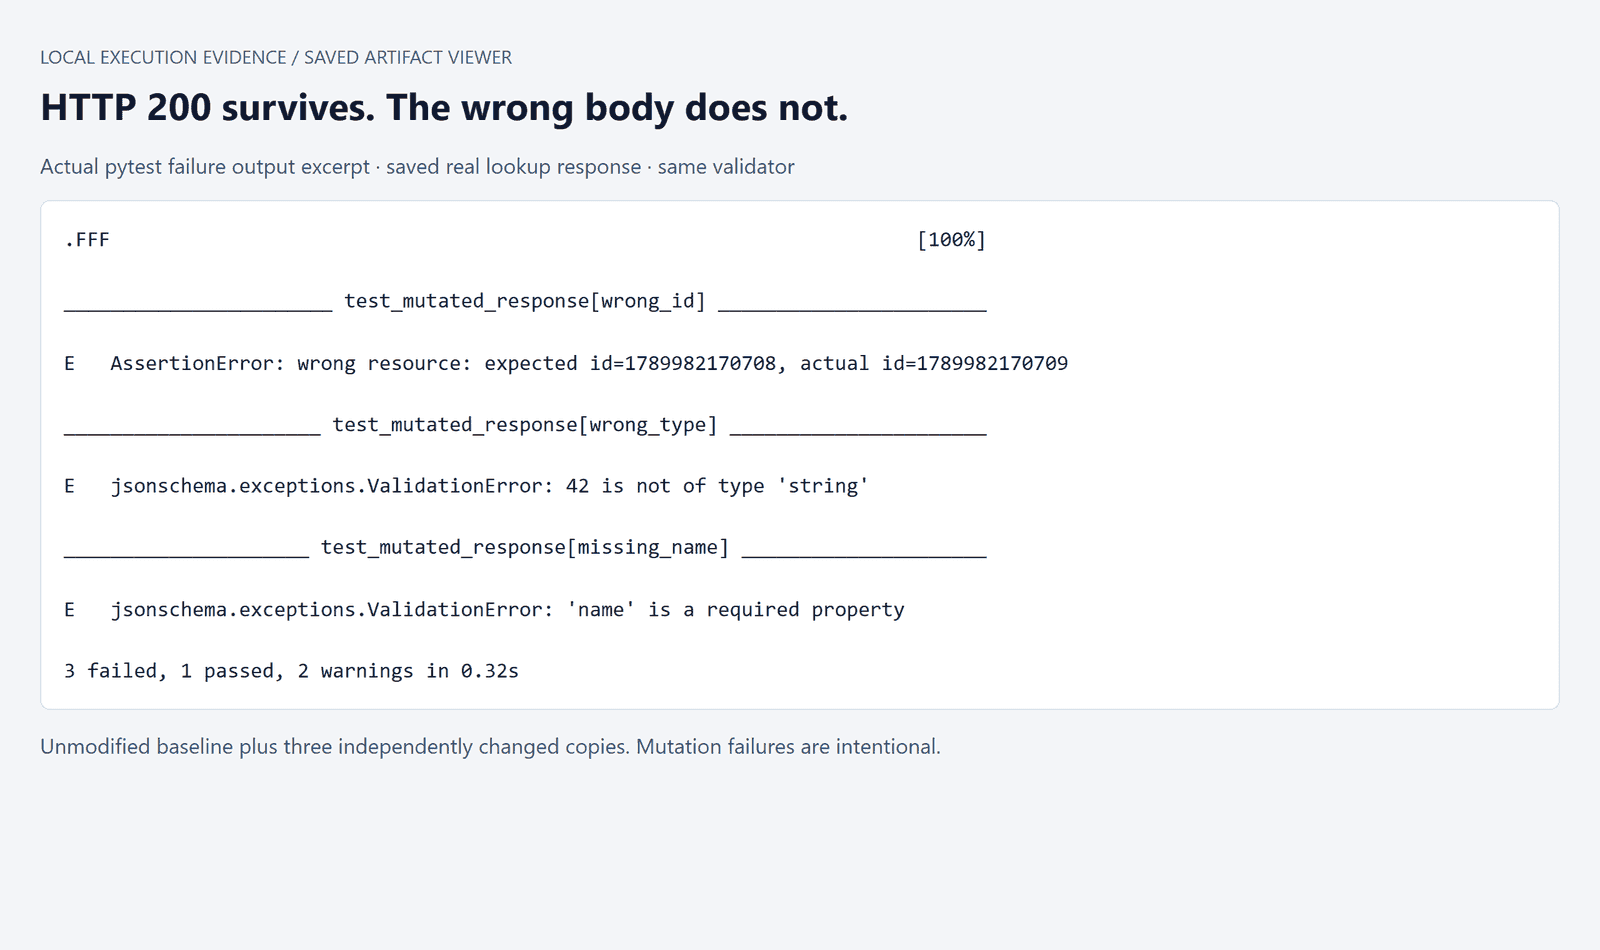 Output kegagalan asersi aktual untuk mutasi respons Petstore terkendali
Cuplikan kegagalan pytest aktual: respons asli lulus, dan ketiga mutasi independen gagal. Kegagalan ini sengaja diinduksi pada salinan yang disimpan.
Dalam run ini, baseline yang tidak diubah lulus dan 3 dari 3 salinan yang diubah gagal. Run mutasi mengembalikan kode keluar 1, mempertahankan sinyal kegagalan. Validator menerapkan batasan struktural yang relevan dari skema Pet dan pemeriksaan hubungan ID terpisah; demonstrasi kecil ini bukan validator kesesuaian OpenAPI yang lengkap.
Untuk audit yang dapat diulang, lampirkan file tes dan spesifikasi yang dipin ke Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Tinjau perubahan “self-healing” yang disarankan dengan sangat hati-hati. Mengganti 400 yang diharapkan dengan 200 dapat menyembunyikan regresi. Perubahan kontrak yang sah memerlukan referensi persyaratan dan perubahan tes yang ditinjau. Respons yang diamati adalah bukti untuk investigasi, bukan izin otomatis untuk mendefinisikan ulang kebenaran.
Pisahkan kategori kegagalan sebelum meminta AI memperbaikinya. Timeout dapat menunjukkan environment yang tidak tersedia. Kegagalan pencarian dapat berasal dari fixture yang rusak. Error impor termasuk dalam kode tes. Ketidakcocokan yang dapat direproduksi dengan kontrak yang disepakati mungkin termasuk dalam produk. Pertahankan konteks yang cukup untuk membedakannya.
Laporkan denominator secara jujur. Mendeteksi tiga perubahan respons yang dipilih membuktikan sensitivitas terhadap ketiga perubahan tersebut. Ini tidak membuktikan cakupan endpoint, cakupan kode, cakupan keamanan, atau tingkat deteksi cacat secara umum. Demikian pula, jumlah tes yang besar tidak banyak menjelaskan tentang skenario duplikat atau kekuatan asersinya.
Autentikasi dan otorisasi layak mendapat tes independen di aplikasi yang sesuai: kredensial hilang, kredensial kedaluwarsa, dan akses ke resource pengguna lain. Perilaku demonstrasi Petstore tidak dapat membuktikan bahwa kontrol akses produksi Anda berfungsi.
Alat AI untuk Pengujian API di CI/CD
Setelah peninjau menerima rangkaian tes, commit versi persis itu. Build harus mengeksekusi ekspektasi yang diketahui terhadap aplikasi kandidat. Menghasilkan ulang tes selama setiap build menambahkan komponen yang berubah dan membuat kegagalan lebih sulit direproduksi.
Pin runner, dependensi, fixture, dan spesifikasi. Simpan lock dependensi bersama tes dan pertahankan revisi aplikasi dalam laporan. Selesaikan secret dari environment CI, jangan masukkan ke file yang dihasilkan, dan periksa bahwa log kegagalan tidak mengeksposnya.
Dengan pytest, bentuk pelaporan dasarnya sederhana:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Sediakan BASE_URL melalui environment job. Mulai layanan lokal dalam siklus hidup job, tunggu hingga siap, lalu jalankan rangkaian tes. Selalu kumpulkan laporan dan log layanan, bahkan saat gagal. Akhiri dengan menghentikan layanan milik job dan membersihkan datanya; hindari perintah pembersihan seluruh proses pada agen bersama.
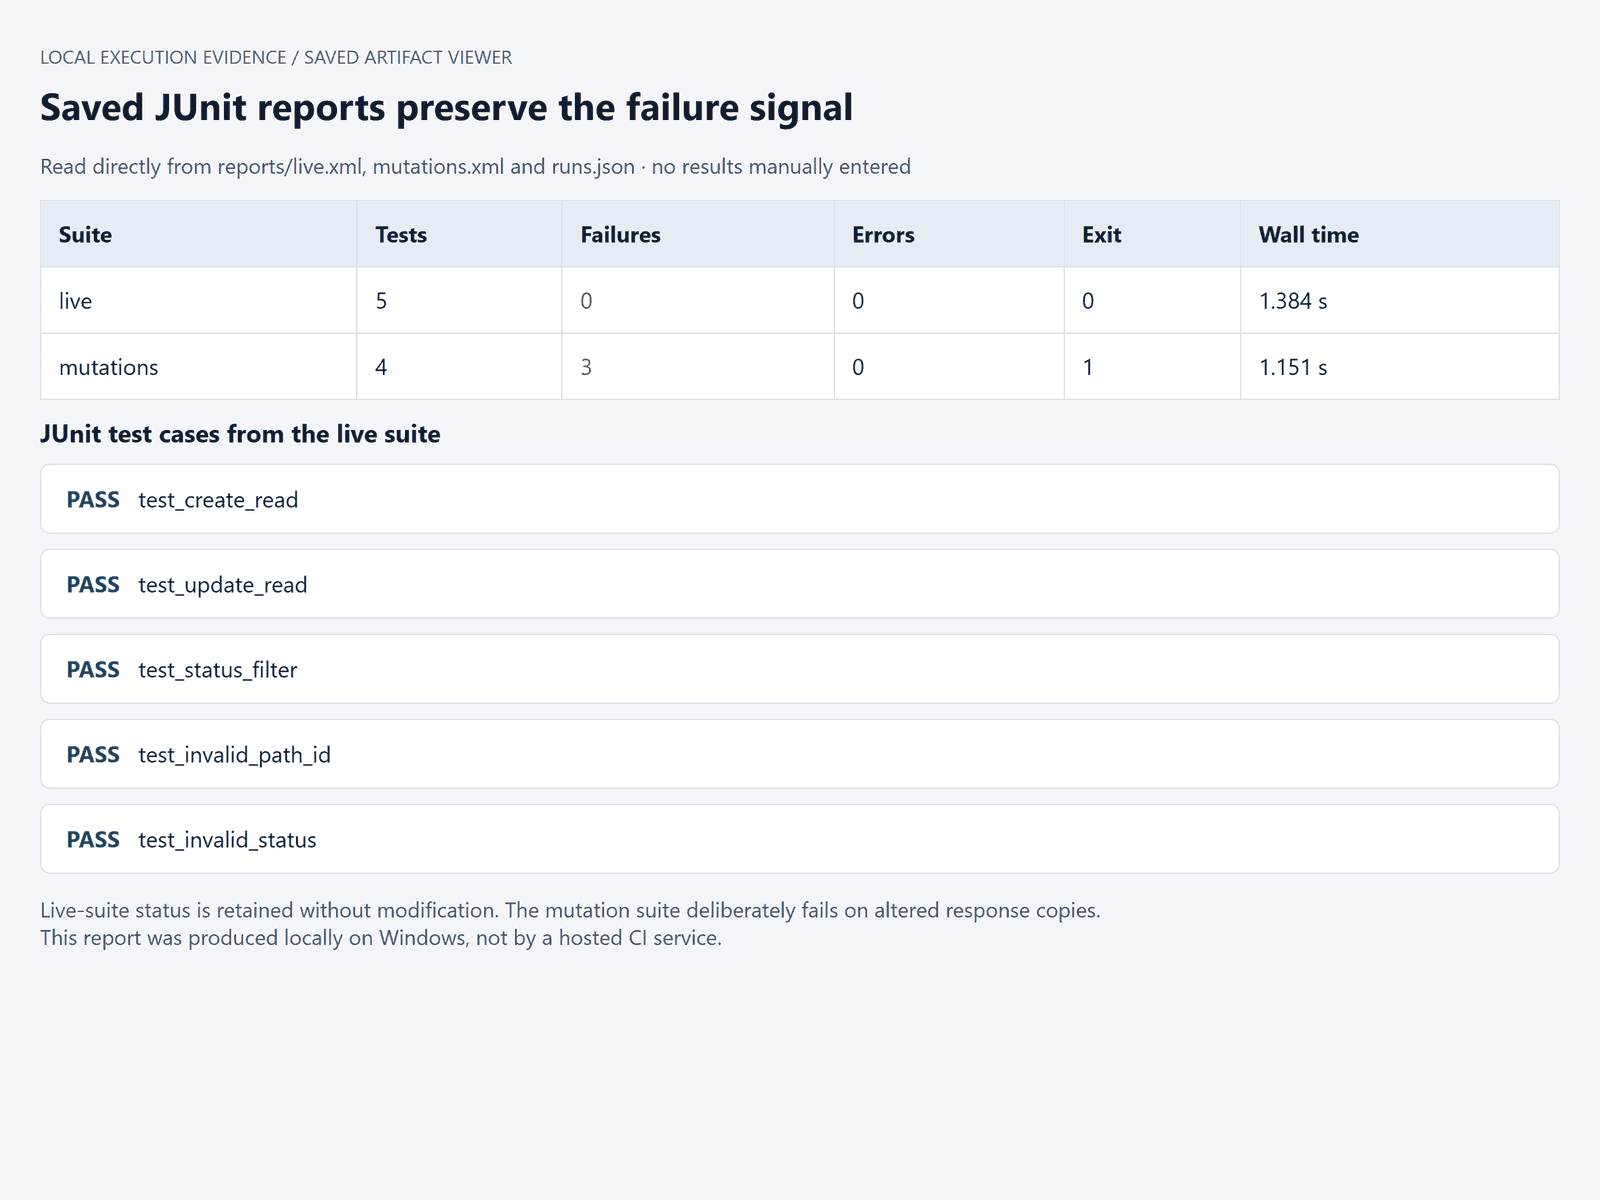 Laporan JUnit pytest lokal dengan live-contract dan hasil assertion-check terpisahsActual local
Hasil JUnit: 5 tes live lulus; rangkaian tes salinan terkendali berisi 1 baseline yang lulus dan 3 kegagalan yang disengaja. Tidak ada klaim run CI hosted.
Waktu wall yang diukur, termasuk startup proses Python, adalah 1,384 detik untuk rangkaian tes live dan 1,151 detik untuk rangkaian tes salinan terkendali. Ini tidak termasuk build/startup layanan, instalasi dependensi, penyusunan draf, dan peninjauan. File JUnit dan log tanpa ringkasan disimpan secara terpisah.
Uji jalur kegagalan sebelum mengandalkan gate. Asersi yang gagal harus menghasilkan kode keluar job yang gagal. Percobaan ulang harus dibatasi dan dibenarkan untuk transient infrastruktur yang diketahui; percobaan ulang berulang yang akhirnya menyembunyikan kegagalan produk membuat gate kurang informatif.
Tangani kegagalan pembersihan secara eksplisit. Biarkan kegagalan asersi utama tetap terlihat, catat resource mana yang tersisa, dan biarkan teardown melaporkan masalahnya sendiri. Job paralel memerlukan pengenal atau namespace terpisah. Tes yang lulus sendiri tetapi membaca data job lain belum siap untuk penggunaan tanpa pengawasan.
Jika Anda sudah memiliki pytest, Anda dapat memilih model penyusun draf secara terpisah. Atlas Cloud cocok untuk peran yang lebih sempit ini: lapisan model untuk alur kerja khusus yang eksekusi dan pelaporannya sudah ada. Ini tidak disajikan di sini sebagai platform pengujian API lengkap atau backend native untuk ketiga produk di atas.
Untuk evaluasi itu, buka DeepSeek V4.1 Flash, ID model deepseek-ai/deepseek-v4.1-flash, dan berikan spesifikasi publik yang sama serta matriks yang ditinjau yang digunakan secara lokal. Gunakan Prompt B, lalu simpan draf yang dikembalikan secara terpisah dari tes yang ditinjau. Bandingkan asumsinya dengan kontrak sebelum mengeksekusi apa pun.
Jika diekspos oleh antarmuka, temperature 0.2 adalah setelan awal untuk penyusunan draf, bukan jaminan determinisme. Periksa batas output yang tersedia terhadap ukuran rangkaian tes Anda. Konsultasikan katalog model saat ini untuk harga token alih-alih menyusun anggaran dari artikel lama.
Pembagian kerja tetap eksplisit: model mengusulkan kode, peninjau menyetujui ekspektasi, dan runner menghasilkan hasil. Gate akses lingkungan pengujian mencegah run Atlas yang selesai untuk artikel ini, jadi ini adalah resep evaluasi bukan hasil model yang terukur. Anda dapat mengevaluasi rute ini tanpa memigrasikan runner tes yang berfungsi atau menyerahkan tanggung jawab eksekusinya ke model chat.
Memilih Alat AI untuk Pengujian API untuk Tim Anda
Pilih evaluasi terkecil yang dapat mengubah keputusan Anda. Gunakan satu alur kerja terhubung, satu kasus negatif yang didokumentasikan, dan beberapa respons salah yang terkendali. Jaga agar input setara di antara kandidat. Pengalaman onboarding yang rapi tidak boleh lebih penting daripada tes yang tidak dapat mengidentifikasi resource yang salah.
Untuk alur kerja collection yang sudah mapan, mulailah dengan mengevaluasi fitur AI di workspace tersebut. Konfigurasi environment dan dependensi permintaan yang ada adalah konteks yang berharga. Ukur apakah perubahan yang dihasilkan menghemat upaya peninjauan tanpa memasukkan asumsi yang rapuh.
Untuk tim dengan spesifikasi yang solid dan tumpukan pekerjaan penulisan, evaluasi generasi berbasis spesifikasi. Perhatikan apa yang terjadi ketika spesifikasi tidak lengkap. Generator yang dengan jelas menandai ekspektasi yang hilang lebih mudah ditinjau daripada generator yang dengan percaya diri mengarangnya.
Untuk aplikasi yang kegagalannya bergantung pada perilaku upstream, evaluasi perekaman dan pemutaran ulang. Periksa baseline yang tertangkap dan dukungan dependensi sebelum berinvestasi dalam rekaman besar. Putuskan field dinamis mana yang boleh bervariasi dan hubungan mana yang harus tetap utuh.
Untuk tim dengan runner yang stabil, evaluasi model independen untuk penyusunan draf dan peninjauan. Anda mempertahankan format eksekusi yang sudah Anda kenal, tetapi Anda juga memiliki integrasi, desain fixture, dan pemeliharaannya. Sertakan kepemilikan itu dalam perhitungan biaya.
Sebelum membayar alat AI untuk pengujian API, syaratkan lima demonstrasi konkret:
- Rangkaian tes yang ditinjau berjalan terhadap lingkungan yang Anda tuju.
- Error terkendali yang relevan membuat asersi yang sesuai gagal.
- Tes dan laporan yang berguna dapat disimpan dalam format yang dapat diterima.
- Run berulang, termasuk eksekusi CI, mempertahankan isolasi dan sinyal kegagalan.
- Biaya generasi, eksekusi, dan pemeliharaan sesuai anggaran tim.
Tetapkan seseorang untuk memelihara rangkaian tes yang diterima. Perubahan spesifikasi harus memicu peninjauan asersi, fixture, dan konsumen yang terdampak. Simpan bukti kegagalan lama sampai perubahan dipahami. Itu membuat rilis berikutnya lebih mudah dinilai dan memberi tim alasan untuk mempercayai laporan hijau.
Pertanyaan yang Sering Diajukan
Alat AI mana yang harus saya gunakan untuk pengujian API?
Mulailah dengan input yang sudah Anda miliki. Evaluasi Postman Agent Mode untuk collection yang sudah mapan, KushoAI untuk generasi yang dipimpin spesifikasi, dan Keploy untuk rute alur yang dihasilkan serta perekamannya yang berbeda. Jika tim Anda sudah memelihara pytest atau runner lain, model penyusun draf terpisah mungkin cocok. Gunakan alur kerja kecil yang sama untuk mengevaluasi asersi, eksekusi, dan upaya peninjauan setiap kandidat.
Apakah ada alat AI gratis untuk pengujian API?
Ada klien gratis, alat pengujian open-source, dan jatah AI terbatas. Ini mencakup kebutuhan yang berbeda. Paket Free Postman mencantumkan 50 kredit AI bulanan per 21 September 2026; itu bukan jumlah tes. Periksa apakah fitur ekspor, otomatisasi, pelaporan, dan kolaborasi yang Anda butuhkan sudah termasuk sebelum menganggap uji coba interaktif sebagai solusi CI gratis.
Dapatkah AI menghasilkan tes API dari spesifikasi OpenAPI?
Ya, generator dapat menggunakan operasi, skema, parameter, dan definisi respons untuk mengusulkan tes. Spesifikasi mungkin masih menghilangkan aturan bisnis atau membuat pemetaan error ambigu. Sediakan ekspektasi yang disetujui dan tinjau hasilnya. Dalam contoh Petstore yang dipin, create yang berhasil didokumentasikan sebagai 200, yang menggambarkan mengapa konvensi REST yang familiar tidak dapat menggantikan kontrak sebenarnya.
Bagaimana saya tahu apakah asersi yang dihasilkan AI berguna?
Periksa tiga hal: batasan skema yang didokumentasikan, hubungan antara permintaan dan respons, serta sensitivitas terhadap data yang sengaja salah. Simpan respons nyata, ubah satu properti yang relevan, dan jalankan ulang validator yang sama. Simpan pesan kegagalan. Ini memberikan bukti sempit yang dapat direproduksi tentang asersi tersebut sambil membiarkan pertanyaan cakupan dan keamanan yang lebih luas terbuka untuk pengujian terpisah.
Dapatkah saya menjalankan tes API yang dihasilkan AI di CI/CD?
Ya, ketika format yang dihasilkan, runner, lingkungan, dan paket mendukung rute tersebut. Commit tes yang telah ditinjau, pasang dependensi yang dipin, gunakan fixture terisolasi, dan ekspor laporan terstruktur seperti JUnit. Verifikasi bahwa kegagalan mengembalikan kode keluar bukan nol. Run lokal yang sukses menyiapkan rangkaian tes untuk CI; itu tidak membuktikan bahwa pipeline hosted telah berjalan.
Dapatkah AI menggantikan pengujian API manual?
AI dapat mengurangi penyusunan draf yang repetitif dan membantu peninjau menemukan asersi yang lemah. Orang tetap memutuskan perilaku yang dimaksudkan, menyelidiki kegagalan yang ambigu, dan mengeksplorasi risiko di luar contoh yang disediakan. Gunakan alat AI untuk pengujian API untuk menghasilkan aset tes yang dapat ditinjau, lalu nilai berdasarkan bukti yang dapat direproduksi. Rangkaian tes yang lebih kecil yang menangkap kesalahan bermakna lebih mudah dipercaya daripada kumpulan pemeriksaan hijau yang tidak dijelaskan.


