Kode tampak sudah selesai. Lalu tes gagal, perbaikannya mengubah antarmuka, dan permintaan lain mulai berjalan. Memilih best ai api for coding berarti menemukan model dan endpoint yang menyelesaikan jenis pekerjaan Anda dalam anggaran yang dapat diterima.
Mulailah dengan Claude, GPT, atau Gemini sebagai kandidat referensi. Bandingkan DeepSeek, Qwen, dan Kimi pada tugas yang sama jika Anda menginginkan opsi deployment dan pengeluaran alternatif. Untuk debugging, prioritaskan tes regresi. Untuk refactoring, periksa diff. Untuk coding agent, verifikasi seluruh loop tool sebelum membandingkan harga token.
Frustrasinya terukur. Dalam Survei Pengembang Stack Overflow 2025, 66% responden pertanyaan tentang frustrasi melaporkan solusi AI yang hampir benar; 45% melaporkan menghabiskan lebih banyak waktu untuk men-debug kode yang dihasilkan. Ini adalah tanggapan survei, bukan evaluasi model 2026. (Stack Overflow Developer Survey, 2025)
Poin Penting
- Pilih API dan agent secara terpisah.
- Buat daftar pendek berdasarkan tugas dan fitur endpoint yang dibutuhkan.
- Simpan jawaban pertama dan nilai terhadap tes penerimaan tetap.
- Sertakan upaya gagal dan perbaikan dalam perhitungan biaya Anda.
Panduan ini menyediakan daftar pendek, tiga tugas evaluasi yang dapat disalin, dan lembar kerja biaya. Riset diperiksa pada 21 September 2026. Ketersediaan model, kapabilitas terdokumentasi, dan hasil terukur adalah kategori bukti yang terpisah di seluruh bagian.
Best AI API for Coding: Daftar Pendek
Mulailah dengan dua kandidat: satu yang cocok dengan aplikasi Anda yang ada dan satu alternatif. Gunakan enam keluarga ini untuk membangun pasangan awal tersebut.
Tabel ini mengusulkan pengujian, tanpa mengklaim kinerja komparatif. Akses bergantung pada akun, wilayah, kuota, dan endpoint Anda; pencantuman dokumentasi tidak mengonfirmasi bahwa kredensial Anda dapat memanggilnya.
| Model dan ID spesifik | Jalur akses | Tugas yang layak dievaluasi | Batas keputusan utama | Bukti endpoint | Pemeriksaan harga |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Perubahan multi-file terbatas | Verifikasi klien dan kontrol penalaran | Ikhtisar model Claude Platform; akses akun belum diuji | Tidak ada tarif dikutip |
GPT-6 Astra, gpt-6-astra | OpenAI API | Tugas coding multi-kondisi | Verifikasi rute dan tool | Dokumentasi model OpenAI; akses akun belum diuji | Tidak ada tarif dikutip |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Generasi dan tinjauan interaktif | Verifikasi latensi dan protokol | Direktori model Google AI; akses akun belum diuji | Tidak ada tarif dikutip |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud model route | Perbaikan numerik; eksperimen konteks | Pisahkan versi 0813 | Halaman model persis terverifikasi; fitur runtime belum diuji | 21 September 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud model route | Refactor; antarmuka mandiri | Versi yang ditentukan; bukan yang terbaru | Halaman model persis terverifikasi; fitur runtime belum diuji | 21 September 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud model route | Tiga tugas yang sama; antarmuka CSV | Verifikasi batas output dan penyelesaian | Halaman model persis terverifikasi; fitur runtime belum diuji | 21 September 2026 |
Claude, GPT, dan Gemini menyediakan kandidat referensi yang berguna. Direktori model resmi mereka mengidentifikasi versi di atas. Gunakan penyedia yang sudah Anda pahami sebagai baseline, lalu uji apakah alternatif mengurangi biaya tugas yang diterima atau pekerjaan integrasi. Jangan memperlakukan perilaku asisten konsumen sebagai hasil API yang sesuai.
Direktori model OpenAI mencantumkan GPT-6 Astra bersama keluarga GPT-5.6. Itu menetapkan kandidat saat ini, bukan kemenangan coding atas baris lainnya. Tabel ini sengaja menghindari mengimpor ID model lama dari halaman perbandingan tanpa tanggal. (Direktori model OpenAI, diakses September 2026)
DeepSeek mendapat tempat sebagai keluarga model terpisah untuk diselidiki. Uji apakah ia memperbaiki bug tertentu tanpa memperlebar perubahan. Pilih kandidat lain jika rute yang di-deploy tidak dapat memenuhi format respons, perilaku tool, atau batas latensi yang Anda butuhkan, terlepas dari reputasi umum model tersebut.
Evaluasi Qwen berdasarkan versi. Deployment 122B A10B yang disebutkan memberikan referensi harga yang konkret. Jalankan pemeriksaan parsing dan browser sebelum menarik kesimpulan nilai. Angka konteks dari rilis Qwen lain tidak dapat dikaitkan dengan model ini.
Kimi adalah kandidat konfigurasi yang sudah dikerjakan. Halaman publiknya mengidentifikasi ID model. Tinjauan konfigurasi dimungkinkan; generasi yang berhasil tetap belum terverifikasi. Evaluasi output yang selesai terhadap batasan yang sama dengan kandidat lainnya.
Atlas Cloud berada di lapisan akses dalam perbandingan ini. Ini bukan model ketujuh. Relevansinya praktis: Anda dapat memeriksa beberapa halaman model kandidat dan membandingkan persyaratan integrasinya sebelum berkomitmen pada alur kerja.
Untuk open weights, verifikasi lisensi rilis yang tepat dan artefak deployment. Hosted inference memiliki ketentuan layanan dan biaya operasional yang terpisah; keluarga model saja tidak dapat menetapkan hal ini.
Coding API, Model, dan Agent Dijelaskan
Model menghasilkan konten sebagai respons terhadap input. API mendefinisikan bagaimana aplikasi Anda mengirim input tersebut dan menerima hasilnya. Coding agent mengatur pekerjaan di sekitarnya: membaca file, memanggil tool, menerapkan edit, menjalankan tes, dan memutuskan apakah akan melanjutkan.
Ketiga lapisan tersebut dapat gagal secara independen. Model dapat mengusulkan patch yang benar sementara agent menulisnya ke file yang salah. API dapat mengembalikan JSON yang valid sementara aplikasi mengabaikan panggilan tool. Agent yang cakap dapat macet karena endpoint yang dipilihnya menolak parameter.
Misalkan Anda mengirim sebuah handler dan meminta parser ID. API generasi kode dasar mengembalikan teks berisi kode. Program Anda masih perlu mengekstrak kode itu, menempatkannya di workspace yang sesuai, dan menjalankan tes. Respons HTTP yang berhasil menetapkan pengiriman, bukan kebenaran.
Agent dapat mengotomatiskan langkah-langkah tersebut hanya jika Anda menyediakan tool dan izin. Ia juga memerlukan kondisi berhenti. Tanpanya, ia dapat berulang kali mengedit fungsi yang sudah dapat diterima, memperluas tugas, atau menghabiskan permintaan tambahan untuk mencoba meningkatkan detail yang tidak relevan.
Pisahkan tiga lini anggaran:
- Langganan tool: aplikasi, integrasi editor, atau layanan agent yang Anda gunakan.
- Penggunaan inferensi: permintaan ke endpoint model yang dipilih, berdasarkan ketentuan penagihannya.
- Lingkungan eksekusi: container, test runner, penyimpanan, dan infrastruktur lainnya.
Beberapa produk menggabungkan bagian dari stack ini. Yang lain mengharapkan Anda membawa kredensial terpisah. Periksa paket tertentu sebelum mengasumsikan langganan editor mencakup lalu lintas API arbitrer dari aplikasi Anda sendiri.
Kompatibilitas protokol juga memiliki batas. Layanan yang menerima array messages yang familier mungkin masih mengekspos perilaku tool, peristiwa streaming, batas konteks, atau kontrol penalaran yang berbeda. Menyalin base URL tidak dapat menetapkan dukungan untuk setiap fitur dalam ekosistem penyedia lain.
Petakan aplikasi, agent, endpoint, model, tool, dan tes. Identifikasi komponen yang dapat ditagih dan operator yang bertanggung jawab di setiap langkah sebelum mengubah model.
Best AI API for Coding: 7 Pemeriksaan Pemilihan
1. Kebenaran fungsional dan perilaku regresi. Tulis output yang diharapkan sebelum meminta kode. Fungsi harga yang menangani bilangan bulat biasa tetapi menerima null sebagai nol melanggar kontrak. Jalankan kasus tepi baru dan tes proyek yang ada; lulus satu tes baru dapat menyembunyikan pemanggil yang rusak di tempat lain.
2. Cakupan perubahan. Bandingkan patch dengan permintaan. Mengekstrak parser ID harus mempertahankan URL, respons sukses, dan respons error. Migrasi framework yang tidak diminta menambah pekerjaan tinjauan bahkan ketika penggantinya dapat dikompilasi. Putuskan sebelumnya apakah edit yang tidak terkait mendiskualifikasi jawaban atau memerlukan perbaikan.
3. Konteks yang berguna dan ruang output. Permintaan Anda mencakup instruksi, file yang relevan, definisi tool, dan percakapan sebelumnya. Sisakan cukup ruang untuk jawabannya juga. Jendela konteks besar yang diiklankan tidak menetapkan bahwa model akan menemukan invariant yang relevan, atau bahwa endpoint Anda menerima maksimum yang sama.
Uji kualitas konteks dengan dependensi yang penting. Sertakan pemanggil yang antarmukanya harus tetap stabil dan verifikasi bahwa model menghormatinya. Ukur pemotongan secara terpisah: respons yang berakhir di tengah fungsi tidak dapat diterima hanya karena baris pembukanya tampak menjanjikan.
4. Pemanggilan tool dan output terstruktur. Verifikasi rute yang di-deploy dengan skema tool Anda yang sebenarnya. Periksa tipe argumen, field yang hilang, pengidentifikasi tool, dan respons lanjutan setelah hasil tool. Model yang menulis objek JSON yang masuk akal belum tentu menyelesaikan round trip panggilan tool native.
5. Waktu hingga hasil yang diterima. Catat durasi seluruh upaya, termasuk perbaikan dan tes. Untuk asisten interaktif, waktu hingga teks pertama terlihat juga penting, tetapi tidak dapat menggantikan waktu penyelesaian. Token pertama yang cepat diikuti jawaban panjang yang tidak dapat digunakan tetap menghambat pengembang.
6. Biaya input, output, cache, dan retry. Baca kategori penagihan yang sebenarnya dilaporkan endpoint pilihan Anda. Pisahkan pembacaan cache dari input biasa bila berlaku. Lacak permintaan yang tidak berhasil dan loop yang dibatalkan. Jika penyedia tidak mengekspos detail yang Anda butuhkan, tandai asumsi yang hilang dari estimasi secara eksplisit.
7. Integrasi dan kondisi penanganan kode. Konfirmasi bahwa editor atau aplikasi Anda mendukung rute, metode autentikasi, dan format error. Tinjau ketentuan penanganan data penyedia saat ini sebelum mengirim kode sumber privat. Open weights menggambarkan pilihan distribusi model; ini tidak menetapkan bagaimana layanan yang dihosting memperlakukan permintaan Anda.
Benchmark publik dapat membantu Anda memilih kandidat, asalkan Anda membaca kondisinya. SWE-bench Verified berisi 500 instance yang difilter manusia. Halaman terkininya juga menggambarkan tampilan Bash Only yang menggunakan lingkungan mini-SWE-agent yang sama. Detail ini membantu menjelaskan apa yang sedang dibandingkan. (SWE-bench, diakses September 2026)
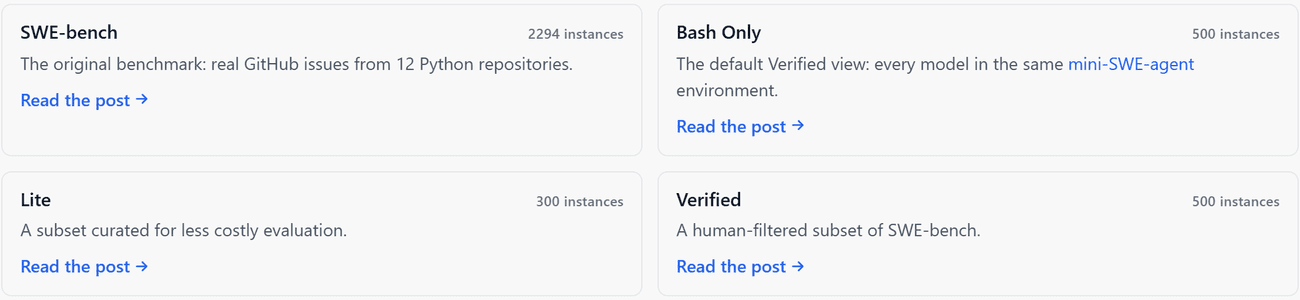 Halaman SWE-bench yang menampilkan ukuran dataset Verified dan lingkungan agent bersama
Sumber bukti: halaman benchmark nyata, diambil 21 September 2026. Dataset dan kondisi eksekusi harus disertakan di samping klaim kinerja apa pun.
Hasil benchmark menggambarkan pengaturan tertentu. Bahasa, aturan bisnis, izin, dan standar tinjauan Anda mungkin berbeda. Buat keputusan akhir berdasarkan pekerjaan yang dapat Anda periksa.
Best AI API for Coding: Jalankan Tiga Pemeriksaan Praktis
Ketiga contoh evaluasi yang dapat direproduksi ini mengekspos mode kegagalan yang berbeda. Tetapkan aturan penerimaannya sebelum meminta output. Nilai fungsi atau halaman terhadap kontraknya, terlepas dari kualitas penjelasan.
Untuk DeepSeek V4 Pro, Qwen3.5 122B A10B, dan Kimi K3, protokol yang dimaksudkan adalah tiga proses independen per tugas. Itu berarti 27 upaya awal. Izinkan paling banyak satu perbaikan umpan balik per upaya, pertahankan jawaban pertama, dan laporkan hasil awal dan yang diperbaiki secara terpisah.
Minta temperature nol hanya jika didukung, catat pengaturan yang benar-benar diterima. Gunakan batas output yang diminta sebesar 4.096 token untuk A dan B serta 8.192 untuk C setelah memeriksa batas endpoint. Default dan kontrol yang tidak didukung harus dicatat. Temperature rendah tidak menjamin jawaban yang identik.
Status bukti: akses lingkungan pengujian diblokir oleh layar login Cloudflare Access. 27 upaya kandidat tidak dapat dijalankan. Bukti berikut menunjukkan kode asli yang dijalankan secara lokal dan fixture referensi CSV yang ditulis untuk artikel ini, bukan hasil model kandidat. Tingkat kelulusan model, penggunaan token, dan biaya tugas tetap tidak terukur.
Tugas A: perbaiki pemilihan harga numerik. Tempel prompt persis ini ke sesi baru:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Input penerimaan tetapnya adalah [2,10,3], ["12","3"], array kosong, nilai yang semuanya tidak valid, nol, angka negatif, dan string yang hanya berisi spasi. Tolak string kosong setelah trimming. Periksa bahwa array asli memiliki elemen yang persis sama dalam urutan yang sama setelah pemanggilan.
Kode asli menggunakan pengurutan default JavaScript dan memutasi inputnya. Oleh karena itu tugas ini memeriksa dua kewajiban yang berbeda: memilih minimum numerik yang benar dan menghindari perubahan data pemanggil. Uji aturan konversi secara eksplisit karena solusi berbasis koersi yang singkat dapat secara tidak sengaja menerima boolean atau null.
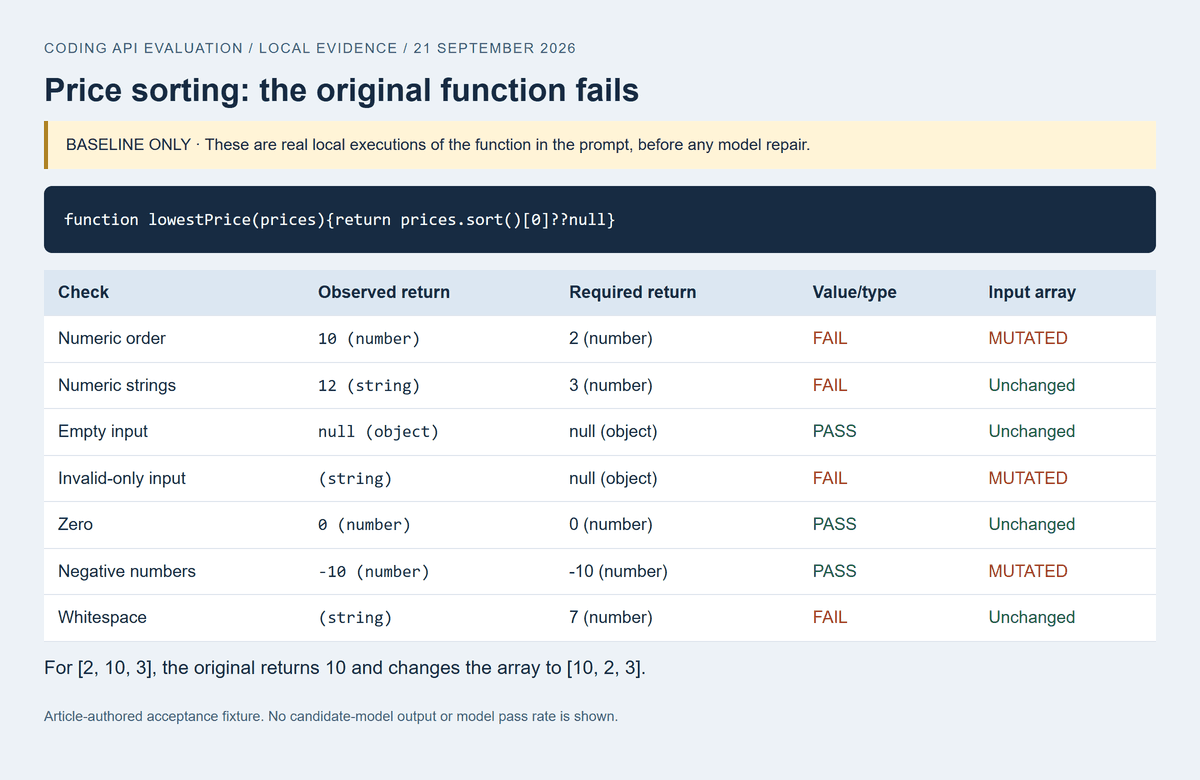 Eksekusi lokal fungsi harga asli yang menunjukkan pengurutan numerik yang salah dan input yang termutasi
Baseline yang dijalankan: fungsi asli mengembalikan 10 untuk [2,10,3] dan mengubah array menjadi [10,2,3]. String numerik juga gagal memenuhi kontrak nilai kembalian. Tidak ada perbaikan model yang ditampilkan.
Tugas B: pertahankan antarmuka selama refactor kecil. Gunakan prompt ini tanpa perubahan:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Terima "12" dan "0012" sebagai 12. Tolak "1e2", "1.0", negatif, nol, spasi, input non-string, dan nilai di luar rentang safe-integer JavaScript. Verifikasi path yang terdaftar dan kedua body respons. Input tidak valid tidak boleh sampai ke findUser.
Tugas ini menguji apakah model memahami perbedaan antara konversi numerik dan tata bahasa string yang ditentukan. Periksa diff untuk perubahan yang tidak terkait, lalu panggil handler dengan objek request dan response yang di-stub. Helper yang benar dipasangkan dengan handler permisif yang tidak berubah tetap gagal.
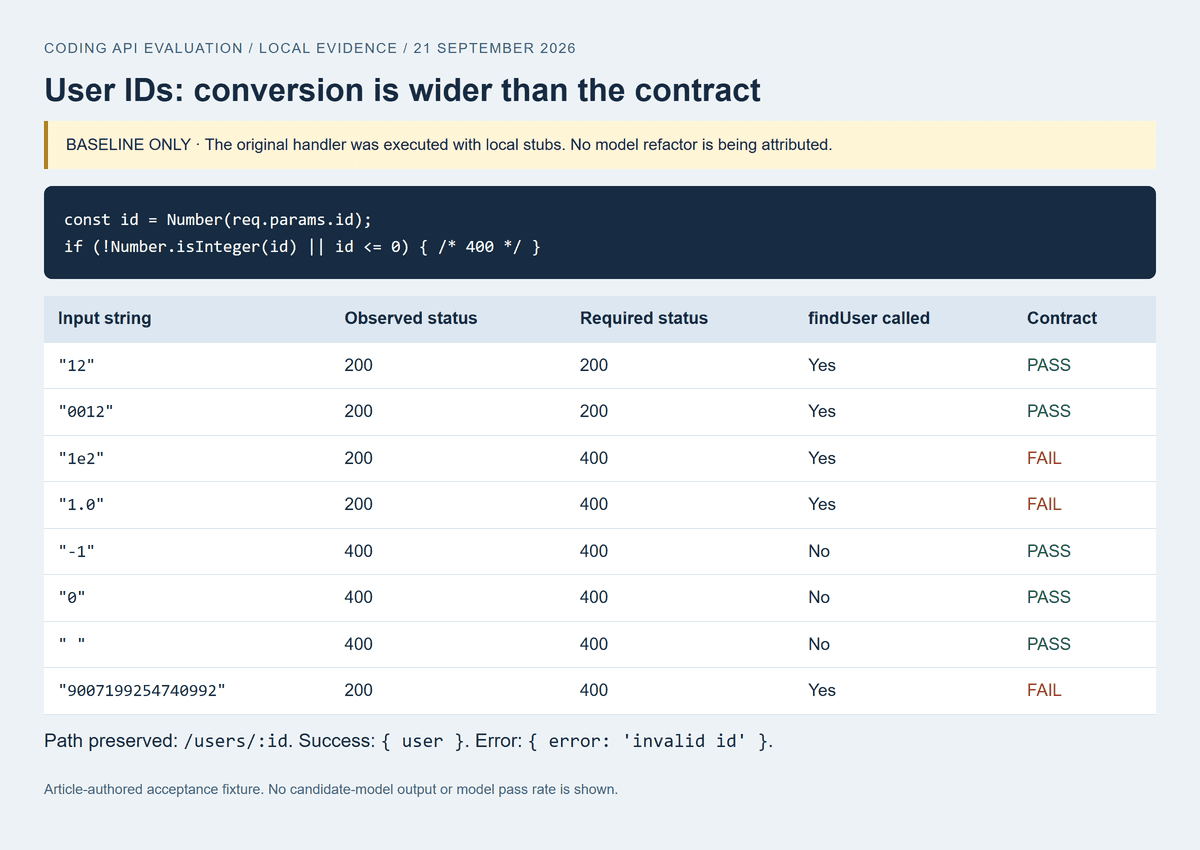 Log pengujian handler asli yang menunjukkan string numerik tidak valid diterima dengan status 200
Baseline yang dijalankan: handler asli mengembalikan 200 untuk "1e2", "1.0", dan "9007199254740992", meskipun respons yang diwajibkan adalah 400. Stub lokal mencatat panggilan; ini bukan refactor yang dihasilkan model.
Tugas C: bangun pratinjau CSV yang dapat Anda operasikan. Kirimkan:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Uji dengan record persis ini, pertama menggunakan LF lalu CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Harapkan dua kolom, tiga baris data, koma Alice di dalam satu sel, dan tanda kutip yang di-escape milik Bob ditampilkan dengan benar. Nilai Eve harus muncul sebagai teks literal, tanpa elemen gambar, eksekusi peristiwa, atau permintaan jaringan. Tambahkan baris dengan tiga field dan konfirmasi bahwa halaman melaporkan ketidakcocokan secara terlihat.
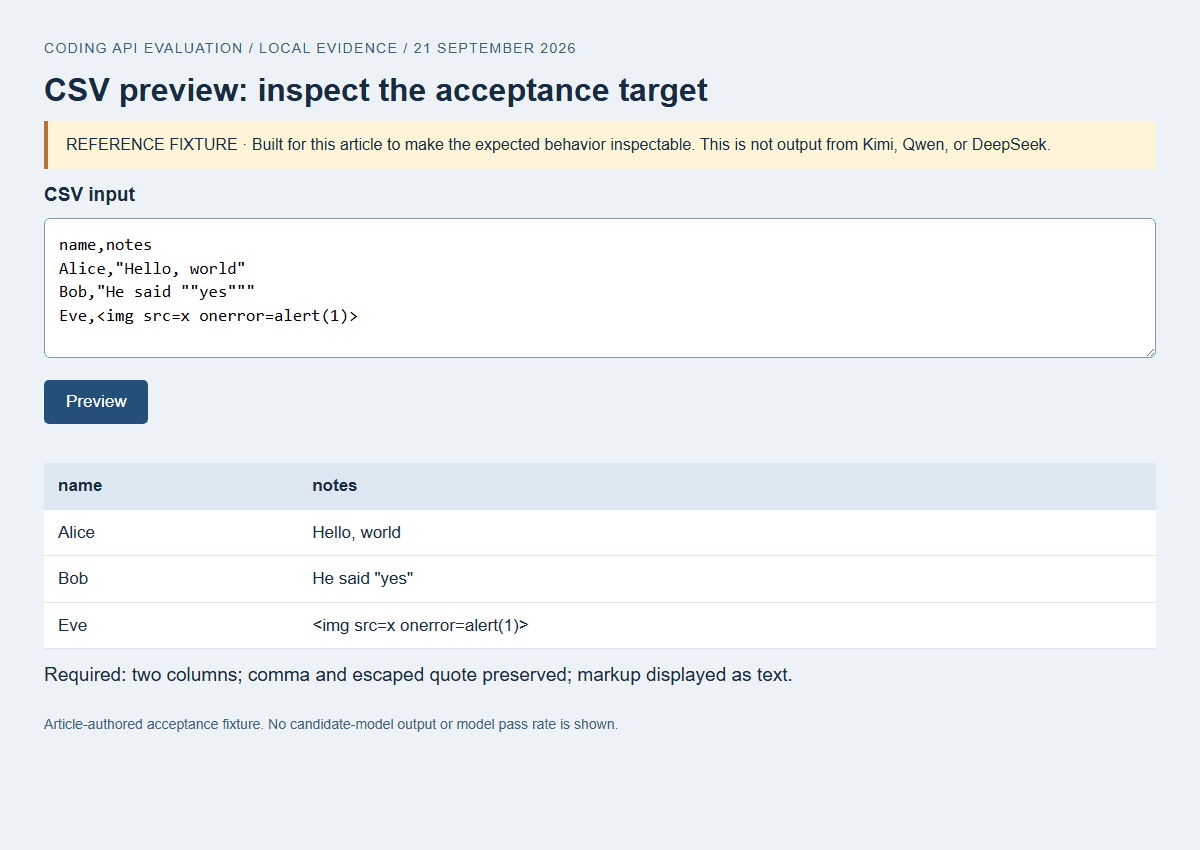 Fixture penerimaan CSV yang menunjukkan nilai yang dikutip dan persyaratan markup literal
Fixture referensi yang dioperasikan, dibuat untuk artikel ini, bukan dihasilkan oleh model kandidat. Pemeriksaan browser memverifikasi parsing LF/CRLF, tanda kutip yang di-escape, markup literal, error jumlah field yang terlihat, dan tidak ada permintaan HTTP. Tangkapan layar menunjukkan status input valid setelah mengklik Preview.
Simpan output mentah, log, ID model, tanggal, parameter, waktu, perbaikan, dan pengeditan manual. Kirim assertion yang gagal untuk perbaikan tanpa mengubah hasil yang diharapkan. Simpan penolakan, pemotongan, dan error bersama keberhasilan.
Best AI API for Coding dengan Anggaran
Bandingkan tarif token bersama kualitas penyelesaian dan penggunaan. Input berulang dapat mendominasi biaya code-review; generasi whole-file dapat meningkatkan biaya output. Perbaikan berulang menambah keduanya.
Katalog Atlas dan halaman detail persis menunjukkan tarif USD per juta token ini pada 21 September 2026:
- DeepSeek V4 Pro: $1.68 input dan $3.38 output. Pencantuman V4 Pro 0813 yang terpisah menggunakan tarif berbeda; jangan menggantikannya.
- Qwen3.5 122B A10B: $0.30 input dan $2.40 output. Katalog menampilkan tarif reguler $0.40 dan $3.20 dengan diskon 25%, per September 2026.
- Kimi K3: $3.00 input dan $15.00 output.
Ini adalah tarif produksi yang ditampilkan, bukan faktur dari evaluasi artikel. Tarif khusus cache dan penerapannya tidak dikonfirmasi. Diskon promosi untuk DeepSeek dan Kimi tidak dikonfirmasi. Tidak adanya observasi diskon tidak membuktikan bahwa tidak ada penawaran.
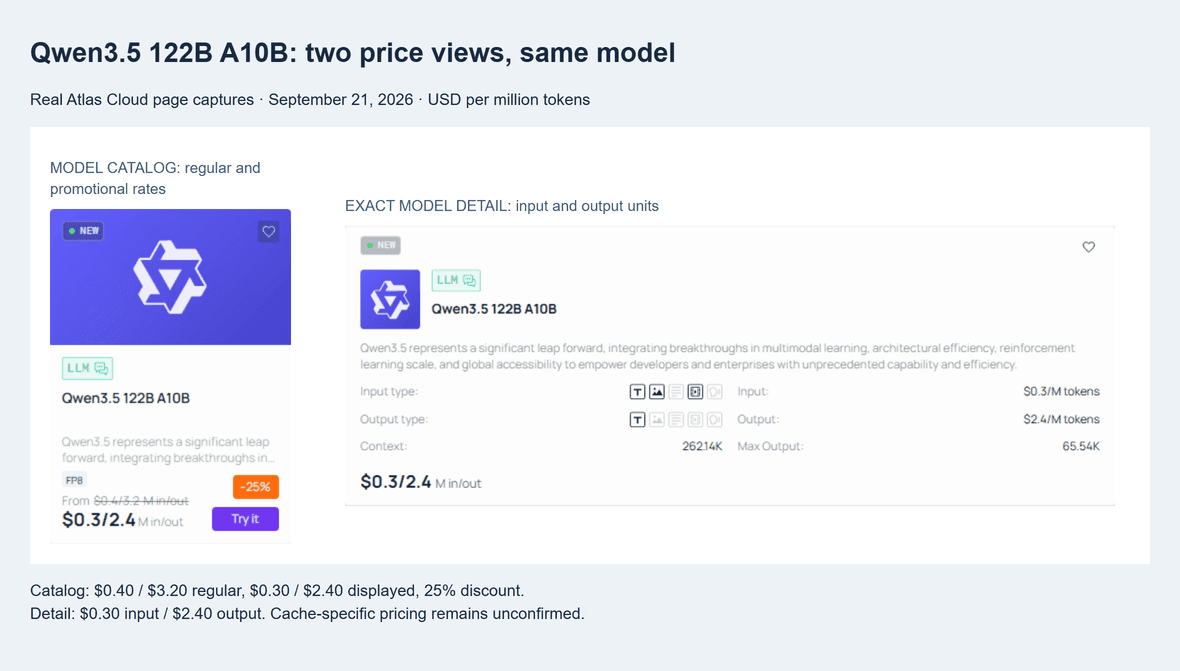 Tarif katalog Qwen3.5 122B A10B beserta tarif input dan output detail model persisnya
Pemeriksaan silang harga Qwen, 21 September 2026: katalog menunjukkan promosi 25%; detail model persis mengonfirmasi $0.30 input dan $2.40 output per juta token. Tarif khusus cache tetap belum dikonfirmasi.
Hitung porsi model dari suatu tugas sebagai:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Jangan menagih token yang di-cache lagi sebagai input biasa jika catatan penagihan memperlakukannya secara terpisah. Periksa apakah penggunaan penalaran termasuk dalam output yang dapat ditagih. Jika tidak ada tugas yang lulus, laporkan "tidak ada hasil yang berhasil"; membagi dengan nol atau menampilkan biaya penyelesaian nol akan menyesatkan pembaca.
Untuk contoh aritmetika yang transparan, asumsikan 10.000 token input biasa dan 2.000 token output pada tarif Qwen yang ditampilkan. Estimasi biaya model adalah $0.0078, sebelum item lain yang berlaku. Ini adalah permintaan hipotetis, bukan penggunaan token yang diamati atau tagihan aktual.
Satu perbaikan dengan ukuran yang sama akan membawa estimasi menjadi $0.0156. Perbaikan aktual mencakup konteks dan output yang berbeda, jadi hitung setiap permintaan dari penggunaan yang tercatat.
| Tugas | Model | Pass pertama | Setelah perbaikan | Penggunaan token | Sumber biaya | Total biaya | Total waktu | Perubahan manual |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 3 pengulangan masing-masing direncanakan | DeepSeek V4 Pro | Tidak terukur | Tidak terukur | Tidak tercatat | Tidak ada catatan penggunaan | Tidak diketahui | Tidak terukur | Tidak ada yang dievaluasi |
| A, B, C; 3 pengulangan masing-masing direncanakan | Qwen3.5 122B A10B | Tidak terukur | Tidak terukur | Tidak tercatat | Tidak ada catatan penggunaan | Tidak diketahui | Tidak terukur | Tidak ada yang dievaluasi |
| A, B, C; 3 pengulangan masing-masing direncanakan | Kimi K3 | Tidak terukur | Tidak terukur | Tidak tercatat | Tidak ada catatan penggunaan | Tidak diketahui | Tidak terukur | Tidak ada yang dievaluasi |
Untuk lembar kerja Anda sendiri, kembangkan setiap baris menjadi satu baris per model dan pengulangan. Hitung keberhasilan yang diperbaiki sekali dalam penyebut tugas yang diterima. Sertakan upaya yang tidak berhasil dalam pembilang, dan pertahankan kolom pass pertama dan penerimaan akhir secara terpisah.
Lacak tinjauan manusia dan infrastruktur secara terpisah. Mengurai penulisan ulang yang tidak perlu dapat menghapus penghematan inferensi. Bandingkan kandidat yang memenuhi persyaratan penerimaan dan anggaran waktu tinjauan Anda.
Best AI API for Coding dengan Atlas Cloud
Mulailah dengan halaman model Kimi K3, konfirmasi ID-nya, dan periksa tampilan API dan Code. Simpan versi yang dipilih di samping catatan pengujian.
Baca dokumentasi protokol LLM sebelum memperlakukan dua rute sebagai dapat dipertukarkan. Dokumentasi tersebut mengidentifikasi Chat Completions sebagai rute dengan cakupan luas dan mengarahkan pengguna ke supported_apis masing-masing model. Kontrol sampling dan fitur tool juga bergantung pada dukungan yang diiklankan model.
Ada detail integrasi konkret yang layak diperiksa di sini. Dokumentasi menyatakan bahwa permintaan Anthropic yang diterjemahkan tidak menerapkan cache_control, dan tool yang dihosting penyedia tidak tersedia pada rute yang diterjemahkan tersebut. Batasan ini penting jika agent Anda yang ada mengasumsikan caching native atau tool browsing yang dihosting. Cocokkan klien dengan rute yang sebenarnya.
Contoh Node.js berikut mengilustrasikan satu permintaan teks. Ia menggunakan fetch bawaan, variabel lingkungan untuk kredensial, dan ID model Kimi yang terverifikasi. Simpan prompt persis Tugas A sebagai task-a.txt. Tetapkan variabel lingkungan base URL ke base API Atlas yang ditunjukkan dalam dokumentasinya, yang berakhir dengan /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages membawa tugas; model memilih deployment; max_tokens meminta batas output. Pembaca respons memeriksa teks selesai biasa sebelum mengembalikan kode. Timeout membatasi penantian contoh ini; ini tidak menetapkan bahwa server berhenti memproses atau tidak ada biaya yang terjadi.
Temperature dihilangkan karena dukungan per-model dan perilaku yang dikomit perlu diverifikasi. Contoh ini tidak mencoba ulang secara otomatis. Tinjau kelas kegagalan sebelum menambahkan kebijakan retry yang terbatas, dan jangan pernah mencatat header otorisasi. Kode publikasi ini tidak dijalankan dengan kunci API selama produksi artikel.
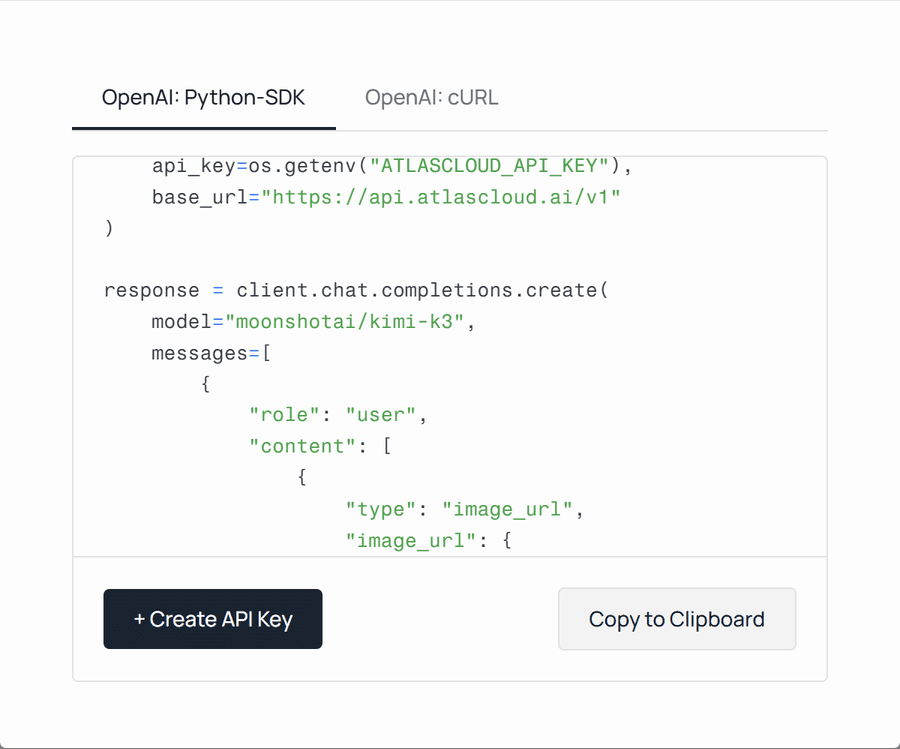 Contoh kode API Kimi K3 publik yang menunjukkan endpoint Atlas dan pengidentifikasi model
Dialog Code Kimi K3 publik, diambil 21 September 2026. Ini adalah bukti konfigurasi, bukan proses coding yang selesai. Sampel halaman mencakup input media; contoh artikel hanya menggunakan teks.
Jalankan pemeriksaan penerimaan Tugas A pada fungsi yang dikembalikan. Sebelum beralih ke DeepSeek atau Qwen, verifikasi protokol dan parameternya. Pertahankan prompt dan tes tanpa perubahan saat membandingkan output dan penggunaan; bentuk permintaan yang sama tidak menetapkan perilaku yang identik.
Sebelum Anda Menggunakan Coding API di Produksi
Jalankan kode yang dihasilkan di branch sekali pakai atau workspace terisolasi terlebih dahulu. Untuk tugas CSV, gunakan konteks browser lokal dengan permintaan jaringan diblokir dan tanpa akses ke status aplikasi yang sensitif. Untuk tugas repositori, berikan proses hanya file dan perintah yang diperlukan untuk evaluasi.
Tetapkan keberhasilan di luar respons model. Agent yang mengatakan "semua tes lulus" harus mengarahkan Anda ke log tes yang sebenarnya, kode keluar, dan revisi yang diperiksa. Simpan diff bersama bukti tersebut. Jika tidak, perbaikan selanjutnya dapat mengubah file setelah keberhasilan yang tampak dan membuat laporan menjadi usang.
Perlakukan timeout dan retry sebagai perilaku aplikasi yang Anda miliki. Tetapkan tenggat waktu permintaan dan anggaran tugas total. Pisahkan error yang disebabkan oleh kredensial atau parameter tidak valid dari kegagalan transportasi sementara. Mengulang permintaan yang tidak valid membuang waktu; mengulang permintaan yang memicu efek samping dapat menciptakan pekerjaan duplikat.
Ketika agent dapat memanggil tool, bedakan inspeksi hanya-baca dari penulisan. Tetapkan pengidentifikasi operasi di mana desain tool Anda mendukungnya, dan konfirmasi status sebelum mengulang penulisan yang tidak pasti. Kebijakan retry endpoint model tidak dapat menjamin idempotensi untuk tool yang dijalankan aplikasi Anda setelahnya.
Lindungi log seolah-olah itu file sumber. Catat ID model, stempel waktu, status, waktu, dan penggunaan tanpa secara rutin menyalin rahasia atau seluruh repositori privat ke dalam telemetri. Simpan bukti output mentah yang diperlukan di lokasi yang dibatasi dengan tepat, dan tetapkan berapa lama tim perlu menyimpannya.
Periksa streaming dengan klien Anda yang sebenarnya. Klien harus menangani peristiwa parsial, penghentian, error, dan catatan penggunaan jika tersedia. Konfirmasi batas laju untuk akun dan deployment yang sebenarnya. Eksperimen pengguna tunggal yang tenang tidak dapat menetapkan bagaimana rute yang sama berperilaku ketika tim mengirimkan permintaan sekaligus.
Gunakan daftar periksa rilis singkat ini:
- Tes penerimaan dan regresi yang ada lulus pada revisi akhir.
- Diff tetap dalam batas tugas yang disetujui.
- Perilaku timeout, pembatalan, dan retry telah diuji.
- Panggilan tool dan respons terstruktur bekerja pada endpoint yang dipilih.
- Log tidak menyertakan kredensial dan kode privat yang tidak perlu.
- Ketentuan penanganan data memenuhi persyaratan tim.
- Fallback memiliki konfigurasi dan catatan pengujian yang terverifikasi sendiri.
Repositori privat memerlukan keputusan khusus layanan. Tinjau retensi, penggunaan pelatihan, akses, dan ketentuan kontraktual saat ini dengan orang yang bertanggung jawab atas kode tersebut. Kirim hanya materi yang disetujui. Jangan menyimpulkan kerahasiaan dari ketersediaan bobot model, atau dari protokol yang menyerupai salah satu yang sudah Anda gunakan.
Best AI API for Coding: Buat Pilihan Akhir Anda
Buat keputusan dalam tiga langkah.
Pertama, eliminasi kandidat yang melewatkan kapabilitas yang dibutuhkan. Tuliskan kondisi yang harus dipenuhi: format output yang diterima, loop tool yang berfungsi, pengaturan penanganan data yang sesuai, atau tenggat waktu respons yang layak. Kandidat yang melewatkan salah satunya memerlukan keputusan remediasi terpisah sebelum masuk ke perbandingan akhir.
Kedua, bandingkan biaya tugas yang diterima dan waktu yang berlalu. Gunakan semua upaya di bawah kebijakan perbaikan yang sama. Pisahkan keberhasilan pass pertama dari keberhasilan yang diperbaiki, dan tunjukkan catatan penggunaan yang hilang. Jika dua model sama-sama memenuhi kontrak, bandingkan beban tinjauannya serta biaya model. Pengembang Anda akan hidup dengan patch yang dihasilkan.
Ketiga, pertahankan satu fallback dan tentukan pemicunya. Contohnya termasuk gangguan endpoint yang berkelanjutan, kegagalan output terstruktur yang berulang, atau biaya tugas yang melebihi batas yang dipilih. Uji konfigurasi alternatif terlebih dahulu. Mengganti ID model di bawah tekanan dapat menimbulkan masalah integrasi kedua jika kontrol atau perilaku responsnya berbeda.
Tiga tugas kecil dalam panduan ini adalah latihan penyaringan. Perluas suite dengan pekerjaan representatif dari basis kode Anda sendiri sebelum mengandalkan kandidat untuk perubahan yang luas. Simpan beberapa tugas di luar prompt tuning sehingga Anda dapat memeriksa apakah peningkatan tersebut bertransfer di luar contoh yang Anda optimalkan.
Best ai api for coding adalah kombinasi yang dapat Anda jelaskan: ia menyelesaikan pekerjaan yang dibutuhkan, mengekspos biaya yang dapat Anda lacak, dan cocok dengan cara aplikasi Anda berjalan. Tidak diperlukan pemenang universal untuk membuat keputusan itu.
Buka katalog model saat ini, pilih dua kandidat, dan simpan ID serta pengaturannya yang persis. Lalu gunakan tugas yang sama, tes yang sama, dan aturan berhenti yang sama untuk keduanya.
Pertanyaan yang Sering Diajukan
Apa AI API terbaik untuk coding dengan anggaran kecil?
Mulailah dengan kandidat yang tarifnya ditampilkan sesuai volume input dan output yang mungkin Anda miliki, lalu bandingkan biaya per tugas yang diterima. Baris Qwen, DeepSeek, dan Kimi menyediakan versi konkret untuk diselidiki, tanpa menyatakan pemenang nilai yang teruji. Batasi upaya perbaikan, gunakan kembali konteks yang relevan secara sengaja, dan lacak permintaan yang gagal. Sertakan waktu tinjauan secara terpisah agar tagihan inferensi yang rendah tidak menyembunyikan beban pembersihan yang besar.
Apakah langganan coding lebih murah daripada membayar token API?
Tergantung pada beban kerja Anda dan apa yang termasuk dalam paket. Langganan mungkin cocok untuk penggunaan interaktif di dalam aplikasi yang didukungnya, sementara penagihan penggunaan mungkin cocok untuk layanan kustom dengan lalu lintas yang bervariasi. Periksa akses model, batas, konkurensi, dan apakah panggilan API eksternal disertakan sama sekali. Bandingkan jumlah pekerjaan berguna yang sama selama periode representatif; harga bulanan dan tarif token mengukur hal yang berbeda.
Apa perbedaan antara model coding dan coding agent?
Model menghasilkan respons. Agent mengelola loop di sekitar respons tersebut, termasuk akses file, eksekusi tool, tes, dan aturan berhenti. Anda dapat memanggil model coding melalui API tanpa membangun agent, misalnya untuk menyarankan fungsi untuk tinjauan manusia. Jika Anda menginginkan pengeditan otonom, evaluasi model bersama agent dan izin yang akan benar-benar digunakannya.
AI API mana yang harus saya gunakan untuk debugging dan refactoring?
Buat daftar pendek kandidat yang sesuai dengan persyaratan endpoint dan penanganan kode Anda, lalu gunakan bug kecil dan refactor terbatas dari pekerjaan Anda. Tugas A memeriksa kebenaran dan mutasi input; Tugas B memeriksa parsing dan pemeliharaan antarmuka. Ikuti dengan tes repositori yang representatif.
Pilih kandidat yang memenuhi kondisi penerimaan Anda dengan upaya tinjauan yang dapat dikelola, bukan yang sekadar menghasilkan penjelasan terpanjang atau penulisan ulang paling luas.
Apakah ada AI API gratis untuk coding?
Kredit percobaan, aplikasi dengan tier gratis, dan bobot model yang dapat diunduh adalah penawaran yang berbeda. Tidak ada yang secara otomatis memberi aplikasi Anda inferensi yang dihosting tanpa batas. Verifikasi kelayakan saat ini, kedaluwarsa, kuota, dan model yang didukung sebelum menganggarkan berdasarkan akses gratis. Artikel ini tidak menyatakan adanya tunjangan gratis yang tersedia saat ini.
Jika Anda menghosting bobot sendiri, perhitungkan komputasi dan operasional meskipun mengunduh bobot tidak memerlukan biaya.
Bisakah saya mengirim kode repositori privat ke coding API?
Kirim hanya kode yang diizinkan organisasi Anda untuk dibagikan berdasarkan ketentuan yang berlaku dari layanan tertentu. Tinjau retensi, penggunaan pelatihan, kontrol akses, dan persyaratan kontraktual untuk deployment yang dipilih.
Hapus kredensial dan file yang tidak terkait, dan periksa apa yang secara otomatis disertakan agent Anda dalam prompt dan log. Model open-weight atau format API yang familier, dengan sendirinya, tidak menetapkan bahwa layanan yang dihosting memenuhi persyaratan kerahasiaan tim Anda.


