Avatar kursus yang hanya menggerakkan mulutnya dapat menahan perhatian untuk satu kalimat, lalu kehilangan pelajaran. Video instruktur kursus AI OmniHuman 2.0 memberi Anda cara untuk merencanakan ekspresi yang terlihat, gerakan yang bertujuan, dan arah kamera di sekitar penjelasan yang direkam. Contoh kontras warna di bawah ini menunjukkan adegan instruktur 30 detik yang lengkap dan, sama bermanfaatnya, masalah kontinuitas properti yang harus ditangkap sebelum menerbitkan pelajaran.
Poin-poin penting
- Input inti adalah gambar dan audio instruktur; prompt teks dapat memandu penampilan atau arah kamera.
- Anggap OmniHuman 2.0 sebagai tahap video presenter. Anda tetap memiliki pelajaran, slide, rekaman layar, pemeriksaan fakta, dan edit.
- Contoh kontras warna 30 detik menunjukkan perubahan gerakan dan sudut pandang yang berguna, plus kartu yang menghilang yang memerlukan tinjauan editorial.
- Tinjau sinkronisasi bibir, ekspresi, gerakan, stabilitas gambar, dan hak sebelum menerbitkan.
- Atlas Cloud mencantumkan $0.07 per detik dan menampilkan tarif diskon $0.056; konfirmasi tarif terkini sebelum menghasilkan.
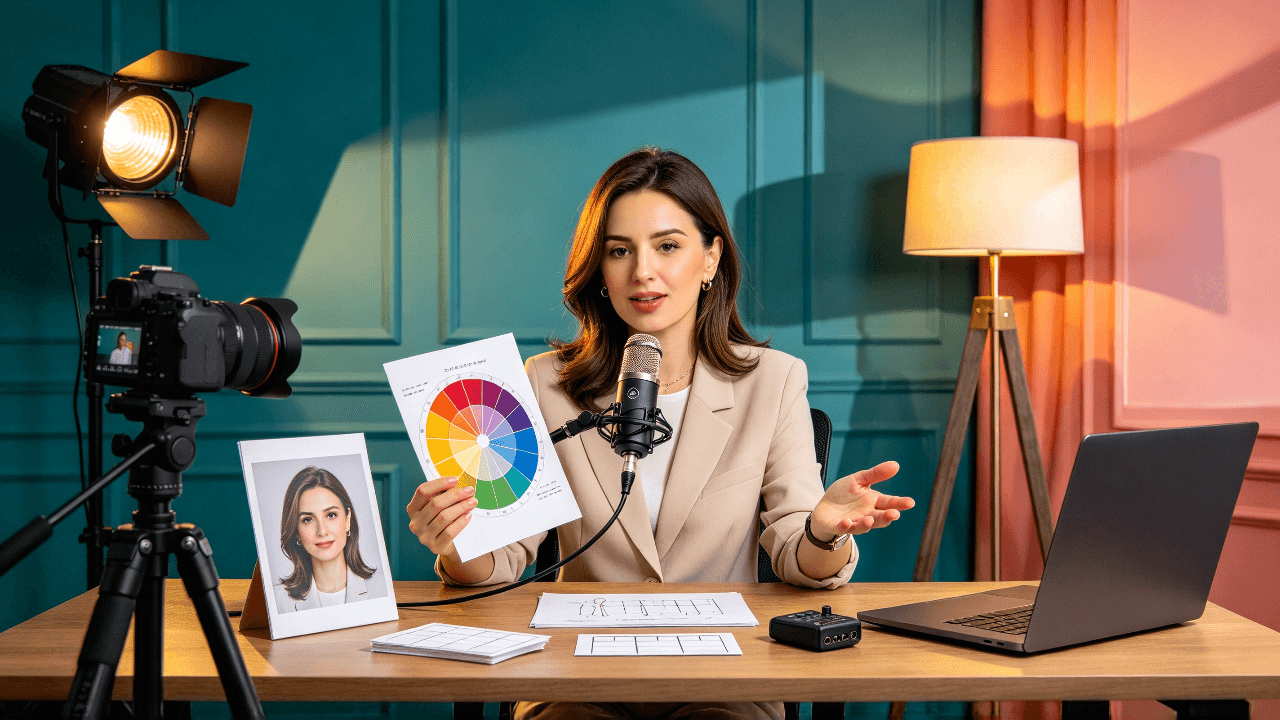
Adegan persiapan ilustratif: potret referensi, rekaman narasi, dan materi pelajaran adalah input yang harus direncanakan sebelum membuat video presenter.
Apa yang Dilakukan OmniHuman 2.0 untuk Video Instruktur Kursus
OmniHuman 2.0 mengubah gambar referensi dan trek audio menjadi video 720p dari karakter yang digambarkan sedang berbicara atau bernyanyi. Direktori model Atlas Cloud menjelaskan arahan teks opsional, gerakan dinamis, adegan multi-orang, pergerakan kamera, dan klip hingga lima menit. Ini adalah kemampuan yang terdaftar, bukan jaminan bahwa setiap prompt kursus akan menghasilkan pengambilan yang sesuai.
(Detail model Avatar Omni Human 2.0)
Pembagian tanggung jawab itu penting. Anda menyediakan konten instruksional dan rekaman suara. Model menghasilkan penampilan yang terlihat. Anda memutuskan di mana presenter membantu dan di mana diagram, slide, tangkapan perangkat lunak, atau demonstrasi jarak dekat lebih baik menjelaskan materi.
| Elemen produksi | Apa yang Anda siapkan atau lakukan | Apa yang disumbangkan model | Apa yang Anda tinjau |
|---|---|---|---|
| Gambar instruktur | Potret yang jelas dan diizinkan | Referensi identitas yang terlihat | Konsistensi wajah, pakaian, dan latar belakang |
| Narasi pelajaran | Rekaman yang diperiksa dengan tempo yang disengaja | Penampilan berbicara yang digerakkan audio | Waktu, pengucapan, dan jeda |
| Arahan | Catatan singkat tentang pembingkaian dan penyampaian | Penampilan yang dipandu prompt dan arah kamera | Apakah gerakan mendukung pelajaran |
| Visual pengajaran | Slide, rekaman layar, diagram, atau contoh | Tidak ada pengganti untuk materi ini | Apakah setiap konsep mudah diikuti |
| Pelajaran akhir | Editing, teks, dan tinjauan kualitas | Segmen video yang dihasilkan | Akurasi, aksesibilitas, dan izin |
Sebuah makalah penelitian OmniHuman awal menjelaskan animasi manusia yang dikondisikan audio, tetapi itu mencakup OmniHuman-1 dan tidak boleh dianggap sebagai tes performa versi 2.0. Untuk keputusan produksi kursus, andalkan daftar model saat ini untuk input dan batas output yang dinyatakan, lalu nilai sampel yang dibuat dengan materi Anda sendiri. (Makalah OmniHuman-1)
Apa yang Harus Disiapkan Sebelum Anda Menghasilkan Video Instruktur AI
Sampel yang meyakinkan tidak hanya bergantung pada mengunggah potret dan rekaman apa pun. Pilih materi yang memudahkan penilaian apakah hasilnya cocok untuk pelajaran nyata.
Pilih gambar instruktur yang jelas dan telah diizinkan
Gunakan potret menghadap depan atau sedikit menyamping dengan wajah yang terlihat jelas, bahu dalam bingkai, dan latar belakang yang tidak berantakan. Hindari wajah yang terlalu kecil, oklusi berat, bayangan dramatis, atau pemotongan yang tidak menyisakan ruang untuk gerakan kepala alami. Jika Anda menginginkan presenter yang sama di seluruh modul, simpan salinan gambar sumber yang disetujui dan gunakan kembali secara konsisten.
Gunakan gambar Anda sendiri atau konfirmasi bahwa orang tersebut telah memberikan izin untuk penggunaan video sintetis yang dimaksud. Ketersediaan potret secara online tidak berarti izin untuk menganimasikan atau menerbitkannya.
Rekam audio pelajaran yang terdengar alami di kamera
Rekam satu poin pengajaran yang koheren dengan tempo yang terukur. Paragraf pendek lebih mudah dievaluasi dan direvisi daripada seluruh kuliah. Sebelum merekam, periksa terminologi, nama, angka, dan klaim faktual pelajaran. Sisakan jeda alami antar ide, tetapi potong celah panjang dan kebisingan latar yang dapat mempersulit penilaian waktu.
Dengarkan sekali dengan teks pelajaran di depan Anda. Jika angka atau istilah teknis tidak jelas dalam rekaman, perbaiki audio sumber terlebih dahulu. Wajah yang dihasilkan tidak dapat memperbaiki penjelasan yang salah atau pengucapan yang ambigu.
Jaga agar pelajaran tetap berguna tanpa avatar
Tulis penjelasan agar tetap dapat dipahami saat dipasangkan dengan slide atau tangkapan layar. Gunakan presenter untuk konteks, transisi, dan penjelasan singkat. Gunakan rekaman layar untuk tindakan perangkat lunak, diagram berlabel untuk suatu proses, dan contoh yang dikerjakan untuk perhitungan. Lalu edit elemen-elemen tersebut bersama-sama di editor kursus Anda.
Siapkan paket sampel yang berisi potret, satu narasi lengkap, prompt arahan, dan slide atau tangkapan layar pendukung yang Anda harapkan untuk digunakan. Itu memberi Anda tes praktis dari rantai produksi daripada animasi wajah yang terisolasi.
Cara Membuat Video Instruktur Kursus OmniHuman 2.0
Tujuan dari generasi pertama adalah keputusan: apakah kombinasi presenter-dan-audio ini membantu pelajaran ini? Jaga agar tes tetap sempit sehingga hasil yang lemah mudah didiagnosis.
Mulai dengan satu segmen pelajaran pendek
Pilih pemikiran lengkap yang memperkenalkan konsep, memberikan satu contoh, dan berakhir pada langkah berikutnya yang jelas. Jangan potong kalimat menjadi dua untuk mencapai durasi target. Contoh yang disediakan di bawah ini berdurasi 30 detik, cukup lama untuk menunjukkan tindakan yang terlihat dan sudut pandang kamera yang berubah. Periksa durasi audio yang didukung sebenarnya dan aturan input saat ini di antarmuka model langsung sebelum mengunggah.
Unggah gambar dan narasi, lalu arahkan penampilan
Buka playground Avatar Omni Human 2.0 untuk memeriksa input saat ini. Siapkan gambar dan narasi sendiri; daftar model menjelaskan image-and-audio-to-video, bukan alur kerja text-to-speech. Jika Anda belum merekam suara, buat dan tinjau di alur kerja audio pilihan Anda sebelum langkah ini.
Untuk alur kerja ini, audio yang disediakan menentukan kata-kata yang diucapkan dan tempo. Prompt teks mengarahkan tindakan yang terlihat, ekspresi, dan pergerakan kamera. Tinjau hasil yang Anda hasilkan sendiri sebelum menggambarkan gerakan yang direncanakan sebagai output yang berhasil. Atlas Cloud mencantumkan output 720p dan klip hingga lima menit, tetapi kontrol langsung dan pekerjaan yang selesai adalah pemeriksaan akhir untuk proses Anda sendiri.
Tinjau klip sebelum membuat pelajaran lengkap
Tonton hasilnya sekali dengan suara, lalu sekali sambil mengikuti teks pelajaran. Catat momen tepat ketika gerakan mulut, jeda, atau gerakan terasa mengganggu. Jika masalah muncul pada frasa tertentu, perpendek atau rekam ulang kalimat itu dan hasilkan hanya segmen yang direvisi. Jika wajah tetap meyakinkan tetapi penjelasan membutuhkan diagram, pertahankan bidikan presenter dan tambahkan visual tersebut dalam edit.
Hanya setelah satu segmen lulus tinjauan, Anda boleh menggunakan kembali potret yang disetujui, gaya rekaman, dan struktur prompt pada bagian pelajaran berikutnya. Konsistensi berasal dari proses input yang dapat diulang; itu tidak berarti setiap segmen yang dihasilkan akan identik.
Contoh Terperinci: Pelajaran Kontras Warna 30 Detik
Pelajaran ini memiliki satu tugas visual: membuat pelajar melihat bagaimana pasangan koral-dan-teal yang cerah berubah ketika kuning yang lebih lembut masuk ke dalam susunan. Gambar instruktur yang disediakan, dua bingkai yang dipilih dari video yang telah selesai, dan klip lengkap memungkinkan Anda memeriksa tindakan pengajaran yang sebenarnya daripada menyimpulkannya dari prompt. Contoh ini mengilustrasikan desain adegan dan tinjauan editorial; uji alur kerja yang dijelaskan di atas dengan gambar dan audio Anda sendiri yang disetujui sebelum menarik kesimpulan tentang outputnya.
Mulai dengan komposisi yang mendukung pengajaran
Gambar input memiliki wajah yang jelas dan tangan yang terlihat, dengan tiga kartu matte di meja kerja. Koral, teal, dan kuning semuanya ada sebelum gerakan apa pun dimulai. Lengkungan teal studio, panel koral, dan kaca amber menciptakan latar yang berwarna-warni sambil membuat kartu tetap mudah dibedakan.
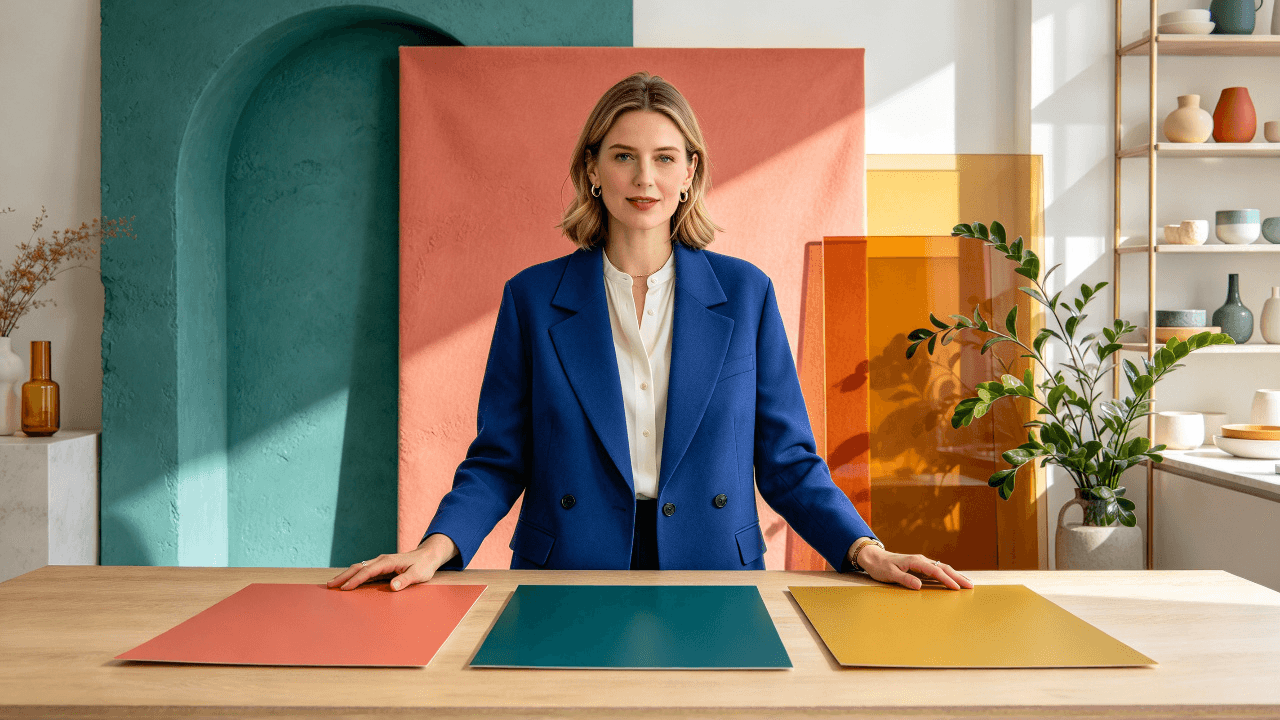
Gambar referensi yang disediakan membuat wajah, tangan, dan tiga perlengkapan pengajaran instruktur terlihat jelas sebelum animasi.
Perbandingan pertama dapat dibaca
Di awal klip, instruktur mengalihkan perhatiannya ke meja kerja dan meletakkan tangan di dekat batas koral-dan-teal. Kamera telah bergerak lebih dekat daripada di still referensi, tetapi wajahnya dan tiga warna asli tetap terlihat. Bingkai ini menunjukkan tindakan yang perlu diikuti pelajar: bandingkan dua warna yang berdekatan sebelum mengubah susunan.
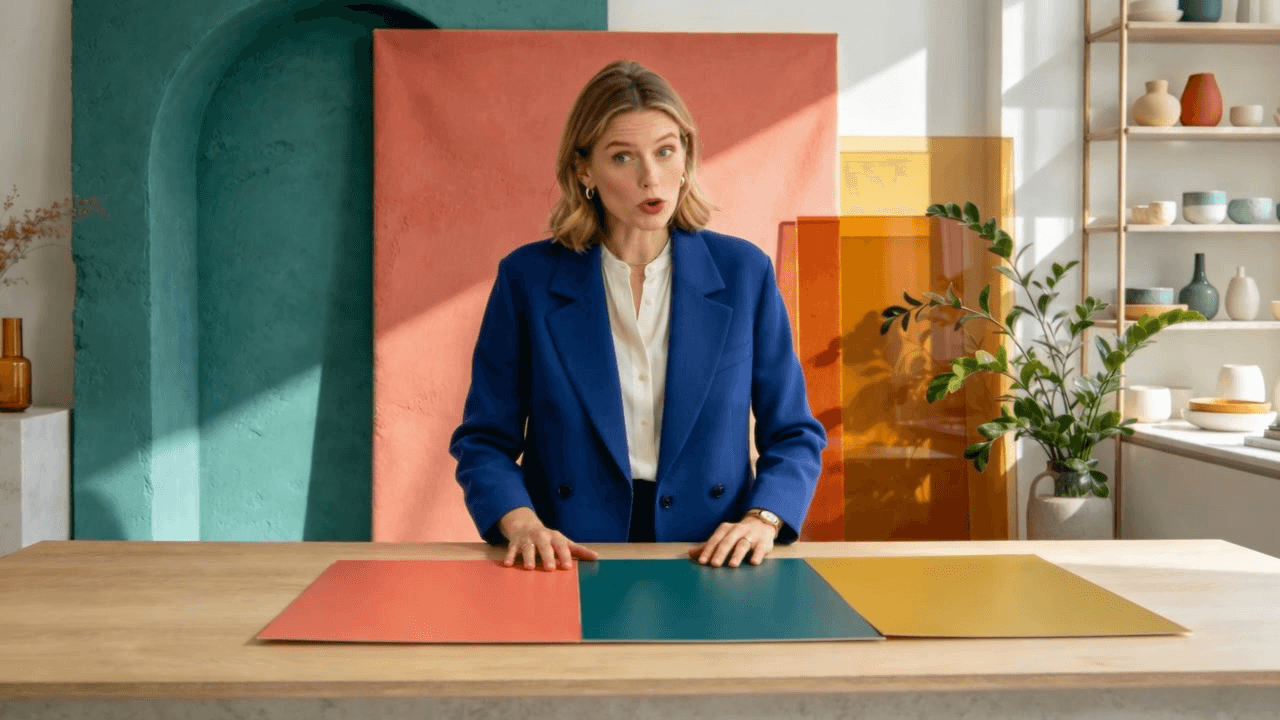
Bingkai nyata dari video yang disediakan: instruktur mengarahkan perhatian ke tepi koral-dan-teal sementara ketiga kartu masih terlihat.
Sudut pandang yang berubah mengungkap masalah kontinuitas
Kemudian, sudut pandang bergeser ke sisi lain meja dan instruktur mengisyaratkan ke arah kuning. Kartu teal tidak lagi terlihat. Itu berbeda dari susunan tiga kartu yang direncanakan, di mana kuning akan berada di antara koral dan teal. Bidikan yang lebih dekat dan ekspresi memberi variasi pada adegan, tetapi kartu yang hilang mengubah contoh pengajaran. Jika ini adalah pelajaran kursus final, perubahan properti akan memerlukan pengambilan lain atau edit yang membuat perbandingan yang dimaksud menjadi akurat.
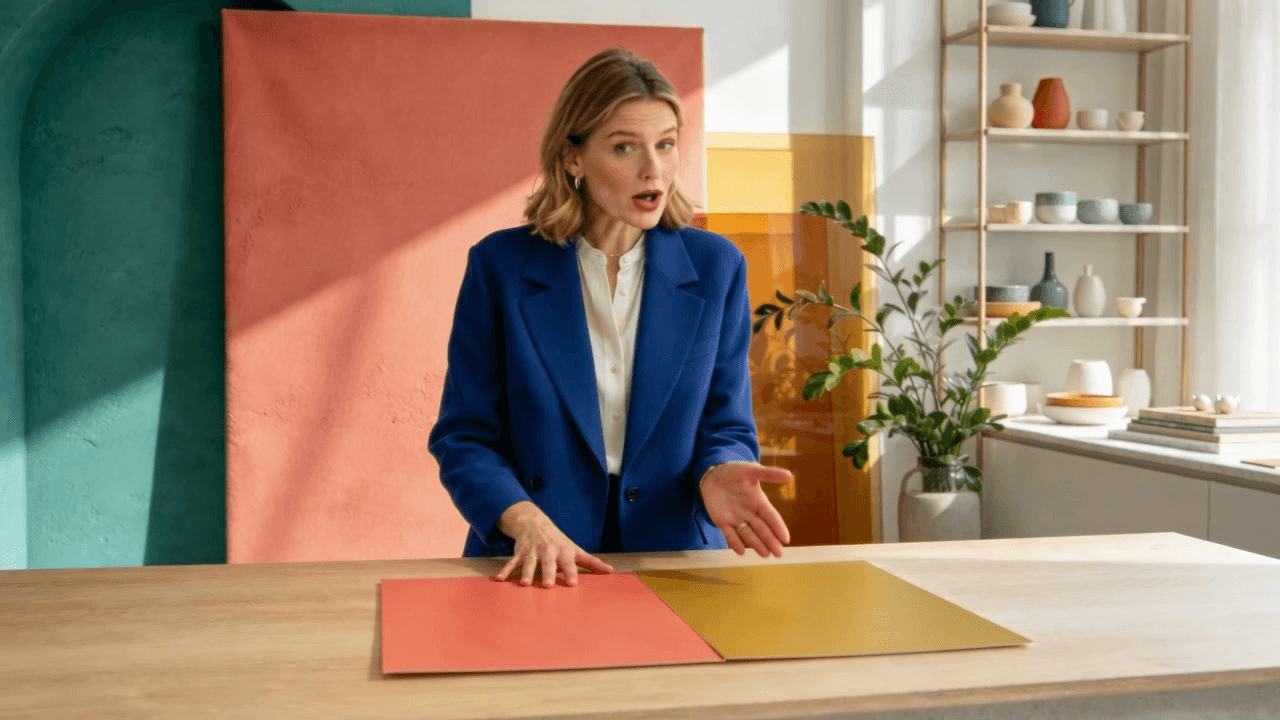
Bingkai selanjutnya dari klip yang sama: sudut kamera dan gerakan berubah, sementara kartu teal telah hilang dari susunan.
Tonton adegan lengkap dengan suara
Video yang disediakan berdurasi lebih dari 30 detik dan menyertakan trek audio. Tonton sebagai satu contoh berkelanjutan sehingga gerakan, ekspresi, pergerakan kamera, dan suara dapat dinilai bersama-sama. Dua still di atas adalah bukti dari momen yang berbeda, bukan kasus yang dihasilkan secara terpisah.
IDJntMvkPbk
Adegan ini berhasil memberi instruktur lebih banyak hal untuk dilakukan daripada menghadap kamera: dia menangani properti, mengubah pandangannya, dan ditampilkan dari lebih dari satu sudut pandang. Kartu teal yang menghilang adalah temuan tinjauan yang penting. Pertahankan pelajaran final hanya ketika contoh visual cocok dengan apa yang dimaksudkan untuk dipahami pelajar, dan verifikasi penjelasan lisan terhadap audio sebelum publikasi.
Cara Memeriksa Apakah Video Instruktur AI Sudah Siap
Gunakan proses tinjauan yang memeriksa penampilan yang dihasilkan dan pelajaran seperti yang akan dilihat pelajar:
- Waktu mulut: Apakah gerakan mulut secara umum mengikuti suku kata dan jeda utama? Putar ulang nama yang sulit dan jeda pendek.
- Ekspresi: Apakah wajah cocok untuk penjelasan yang tenang, atau bergeser ke senyum yang tidak terkait atau emosi yang berlebihan?
- Gerakan: Apakah tangan tetap menjauh dari wajah dan menghindari mengalihkan perhatian dari slide penting?
- Identitas dan adegan: Apakah fitur wajah, pakaian, dan latar belakang tetap stabil sepanjang klip?
- Akurasi audio: Apakah terminologi, nama, dan angka diucapkan dengan benar dalam rekaman yang disediakan?
- Kejelasan pengajaran: Apakah edit menyertakan slide, tangkapan layar, subtitle, atau contoh yang dikerjakan yang diperlukan pada momen yang tepat?
- Hak dan pengungkapan: Apakah Anda memiliki izin untuk gambar dan suara, dan apakah Anda telah memeriksa aturan pengungkapan dan kebijakan institusi untuk audiens dan pasar yang dimaksud?
Putuskan apakah akan menyimpan klip, merevisi audio atau gambar sumber, atau menggunakan voiceover dengan slide sebagai gantinya. Jangan pertahankan bidikan presenter hanya karena pembuatan memakan waktu. Rekaman layar yang jelas mungkin lebih baik mengajarkan langkah prosedural.
Biaya dan Penskalaan untuk Video Kursus
Per Oktober 2026, halaman model Atlas Cloud mencantumkan tarif standar $0.07 per detik dan menampilkan tarif diskon $0.056 per detik dengan diskon 20%. Perkiraan sederhana dari tarif yang terdaftar tersebut adalah:
| Durasi yang dihasilkan | Pada $0.07/detik | Pada $0.056/detik yang ditampilkan |
|---|---|---|
| 20 detik | $1.40 | $1.12 |
| 60 detik | $4.20 | $3.36 |
| 5 menit | $21.00 | $16.80 |
Ini adalah perhitungan tarif model, bukan penawaran untuk akun Anda atau jaminan biaya akhir. Diskon yang ditampilkan dapat berubah, dan pajak, ketentuan tingkat akun, atau biaya lain dapat memengaruhi checkout. Periksa kembali detail model dan layar konfirmasi sebenarnya sebelum produksi.
Sampel pendek membatasi biaya untuk memeriksa potret, suara, atau prompt baru. Untuk materi yang lebih panjang, bagi pelajaran pada batas pengajaran yang sebenarnya seperti konsep baru atau contoh yang dikerjakan. Jangan pisahkan kalimat atau hapus penjelasan yang diperlukan hanya untuk menyesuaikan batas generasi. Pada tarif standar yang terdaftar, output lima menit akan menjadi $21 sebelum diskon yang berlaku; bandingkan dengan segmen yang lebih pendek ditambah waktu editing dan putuskan format mana yang melayani pelajaran.
Privasi, Persetujuan, dan Kepercayaan Kursus
Sebelum menghasilkan, konfirmasi bahwa Anda dapat menggunakan potret dan suara instruktur untuk video sintetis dalam kursus, saluran distribusi, dan durasi yang dimaksud. Jika kontraktor, karyawan, dosen tamu, atau siswa muncul, dokumentasikan izin dan batasannya. Periksa persyaratan institusi Anda untuk media yang dihasilkan atau diubah AI dan aturan yang berlaku di pasar target Anda; artikel ini tidak menentukan kewajiban hukum.
Tinjau pelajaran yang sudah selesai seperti yang akan dilakukan instruktur. Perbaiki skrip dan rekaman, ungkapkan presentasi sintetis di mana audiens atau kebijakan Anda mengharapkannya, dan jaga agar manusia bertanggung jawab atas klaim kursus. Presenter yang rapi dapat membuat materi yang lemah atau tidak diperiksa terlihat berwibawa, jadi pemilik pelajaran harus menyetujui kata-kata dan edit akhir.
Untuk produksi pertama, buat satu segmen pendek, tinjau terhadap daftar periksa, dan perkirakan batch berikutnya menggunakan tarif per detik saat ini. Keputusan kecil itu memberi tahu Anda apakah video instruktur kursus AI OmniHuman 2.0 cocok dengan alur kerja kursus Anda.
Pertanyaan yang Sering Diajukan
Bisakah OmniHuman 2.0 membuat video kursus hanya dari teks?
Daftar tersebut menjelaskan alur kerja image-and-audio-to-video dengan arahan teks opsional. Ini tidak mencantumkan teks biasa sebagai pengganti audio narasi, jadi siapkan trek suara secara terpisah.
Bisakah saya menggunakan kembali gambar instruktur yang sama di beberapa pelajaran?
Anda dapat menyiapkan gambar yang disetujui yang sama untuk generasi terpisah. Menggunakannya kembali mendukung referensi visual yang konsisten, meskipun tidak menjamin ekspresi, pembingkaian, atau gerakan yang identik di setiap output. Tinjau setiap segmen sebelum menggabungkannya.
Apakah OmniHuman 2.0 menghasilkan suara pelajaran?
Alur kerja yang terdaftar mengambil trek audio sebagai input. Rekam atau produksi suara secara terpisah, periksa, dan unggah narasi yang sudah selesai.
Berapa biaya klip kursus OmniHuman 2.0 20 detik di Atlas Cloud?
Pada tarif standar yang terdaftar $0.07 per detik, 20 detik dihitung menjadi $1.40. Pada tarif $0.056 yang ditampilkan, dihitung menjadi $1.12. Konfirmasi harga saat ini dan biaya akhir sebelum menjalankan generasi.


