Kemungkinan besar Anda tidak memerlukan model Qwen terbesar. Bagi sebagian besar developer yang mencari model Qwen terbaik untuk coding lokal, jawaban praktisnya adalah Qwen3 Coder 30B A3B, biasanya melalui qwen3-coder:30b di Ollama atau GGUF yang dimuat di LM Studio.
Bagian yang membingungkan bukanlah apakah Qwen bisa coding. Melainkan Qwen mana yang dapat ditampung mesin Anda saat agen Anda membaca file, menulis patch, dan menjalankan pengujian tanpa mengubah perbaikan bug hari Selasa menjadi proyek perangkat keras.
Panduan ini memilih berdasarkan alur kerja nyata: tier memori Anda, agen Anda, jendela konteks Anda, dan siklus pengujian Anda. Gunakan Qwen lokal terlebih dahulu saat privasi penting. Gunakan sesi Qwen hosted saat repo terlalu besar, patch berisiko, atau laptop Anda jelas kepayahan.
Poin-poin penting
- Pilihan lokal praktis terbaik: Qwen3 Coder 30B.
- Tier perangkat keras terbaik: VRAM 24GB atau RAM 32GB+.
- Alur kerja terbaik: Ollama atau LM Studio plus Cline, Continue, atau Aider.
- Penyebab kegagalan terbesar: konteks buruk dan pengaturan agen yang lemah.
- Fallback terbaik: tinjauan Qwen hosted untuk satu patch yang berisiko.
Alur kerja perbaikan bug checkout Qwen lokal beranimasi
Contoh alur kerja beranimasi: mulai dari rencana pengujian checkout, minta Qwen lokal untuk perubahan jalur state React terkecil, lalu jalankan ulang pemeriksaan.
Mengapa Model Qwen Terbaik untuk Coding Lokal Menjadi Membingungkan pada 2026
Penamaan Qwen sekarang mencakup model chat kecil, model coder berkonteks panjang, varian MoE, dan opsi frontier hosted. Hasil pencarian bisa menyebut Qwen3 Coder 30B, Qwen3 Coder Next, Qwen3.6, 480B, GGUF, MLX, Q4, Q8, A3B, dan A35B dalam satu tarikan napas. Itu banyak sekali label sebelum Anda bahkan membuka VS Code.
Perbedaan yang berguna itu sederhana. Model coding lokal harus melakukan lebih dari sekadar menjawab pertanyaan kode. Model harus menahan konteks repositori, mengikuti panggilan alat, menulis diff minimal, dan pulih dari output pengujian. Qwen3 Coder 30B A3B menarik karena kartu modelnya mencantumkan total 30,5B parameter, 3,3B parameter yang diaktifkan, konteks native 262.144 token, lisensi Apache 2.0, dan perilaku instruct non-thinking (kartu model Hugging Face, diakses Agustus 2026).
Lini Qwen3 Coder kelas 480B adalah kelas mesin yang berbeda. Peluncuran resmi Qwen membingkai Qwen3 Coder di sekitar coding agentik, penggunaan browser, penggunaan alat, dan konteks native 256K dengan ekspansi hingga 1 juta melalui YaRN (Qwen Team, Juli 2025). Skala itu penting untuk setup hosted atau server, tetapi tidak membuat laptop 16GB Anda menjadi workstation 480B.
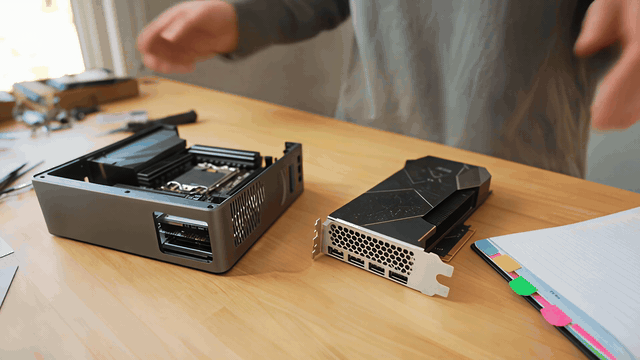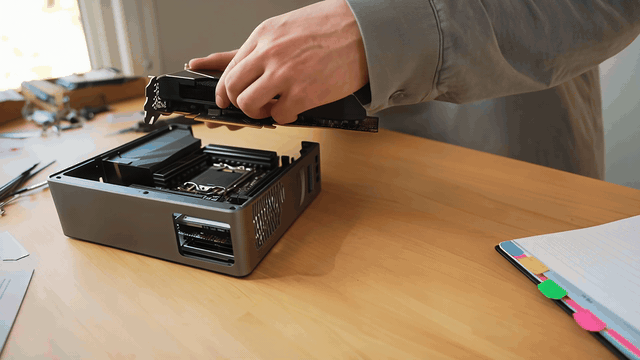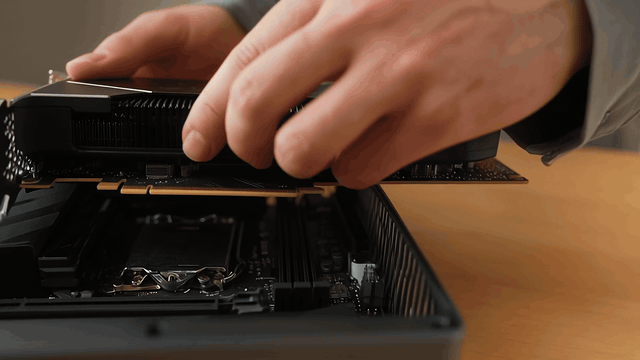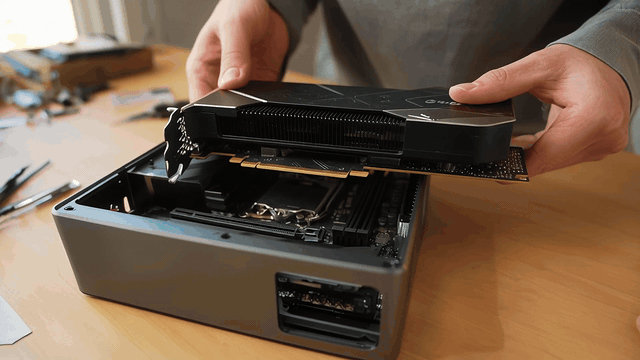
Alur kerja persiapan perangkat keras Qwen lokal beranimasi
Contoh alur kerja beranimasi: periksa perangkat keras lokal yang ringkas sebelum memuat Qwen, karena VRAM dan kapasitas konteks menentukan apakah sesi coding tetap dapat digunakan.
Model Qwen Terbaik untuk Coding Lokal berdasarkan Tier Perangkat Keras
Mulailah dari perangkat keras yang Anda miliki. Tag default qwen3-coder:30b di Ollama adalah artefak Q4_K_M sekitar 19GB dan dapat diluncurkan dengan ollama run qwen3-coder:30b (pustaka Ollama, diakses Agustus 2026). Ukuran itu membuatnya realistis untuk desktop serius, bukan laptop mungil.
Atlas Cloud cocok sebagai jalur verifikasi, bukan sebagai pengganti privasi lokal. Jika mesin Anda tidak dapat menampung model atau Anda ingin pendapat kedua tentang patch yang berisiko, jalankan prompt yang sama sekali melalui Atlas Cloud, lalu bawa tinjauannya kembali ke alur kerja lokal Anda.
| Tier perangkat keras | Pilihan Qwen praktis | Runtime | Penggunaan terbaik | Perhatian | Fallback hosted |
|---|---|---|---|---|---|
| 16GB VRAM / 32GB RAM | Qwen3 Coder 30B Q4 dengan offload | Ollama atau LM Studio | perbaikan bug kecil, pengujian, chat lokal | konteks panjang jadi lambat | Qwen3 Coder Next di Atlas |
| 24GB VRAM | Qwen3 Coder 30B Q4 atau Q5 | Cline, Continue, Aider | coding lokal sehari-hari | tuning konteks sebelum menyalahkan model | Qwen3 Coder Next |
| 64GB memori unified atau RAM | Qwen3 Coder 30B Q8, atau varian Qwen coder yang lebih besar | LM Studio, llama.cpp, vLLM | edit multi-file dan tinjauan repo | tekanan KV cache | Qwen3.6 35B A3B sebagai pembanding |
| 128GB+ | Qwen3 Coder Next atau eksperimen terkuantisasi yang lebih besar jika tersedia | llama.cpp, vLLM, SGLang | loop agen skala repo | waktu setup dan panas | Atlas untuk tinjauan A/B cepat |
| Tidak ada perangkat keras lokal yang cocok | Qwen hosted | Playground model Atlas atau API | tinjauan patch dan prompt panjang | ikuti kebijakan privasi kode | eksekusi hosted langsung |
Untuk fallback hosted, halaman Atlas live menunjukkan harga LLM ini selama pemeriksaan Agustus 2026: Qwen3 Coder Next pada konteks 262,14K, $0.18/M token input dan $1.35/M token output; Qwen3.6 35B A3B pada konteks 262,14K, dengan halaman detail menunjukkan $0.248/M token input dan $1.485/M token output plus penanda diskon 35%; dan Qwen3.6 Plus di daftar model pada konteks 1.000K, $0.325/M token input dan $1.95/M token output. Periksa penjelajah model Atlas live sebelum menganggarkan sesi panjang.
| Runtime | Cocok untuk | Gaya endpoint | Default yang baik | Perhatian |
|---|---|---|---|---|
| Ollama | start lokal tercepat | host Ollama lokal | qwen3-coder:30b | konteks harus diatur dengan sengaja |
| LM Studio | pengguna Mac dan GUI | server lokal kompatibel OpenAI | Q4/Q5 GGUF | muat konteks sebelum membuka agen |
| llama.cpp | kontrol kuantisasi lanjutan | flag server lokal | Q4_K_M atau Q8 | lebih banyak tuning manual |
| vLLM / SGLang | serving tim atau lab | server kompatibel OpenAI | BF16 atau FP8 jika didukung | kompleksitas perangkat keras dan setup |
Langkah 1: Instal dan Hubungkan Model Qwen Terbaik untuk Coding Lokal
Instal dengan Ollama. Ollama adalah rute tercepat yang dapat direproduksi. Tarik modelnya terlebih dahulu, lalu mulai chat lokal untuk memastikan model merespons sebelum melampirkannya ke agen.
plaintext1ollama pull qwen3-coder:30b 2ollama run qwen3-coder:30b
Prompt persis untuk ditempel:
plaintext1You are a local coding assistant. Reply with one sentence confirming that you can inspect code, propose patches, and explain test failures. Do not write code yet.
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Runtime | Ollama |
| Model | qwen3-coder:30b |
| Konteks | mulai 32K atau 64K |
| Temperature | 0.2 untuk perbaikan bug, 0.7 untuk diskusi desain |
| top_p / top_k | 0.8 / 20 |
| repetition_penalty | 1.05 |
Hubungkan agen coding.
Gunakan Cline, Continue, atau Aider. Cline adalah agen pertama yang baik karena panduan model lokalnya merekomendasikan Qwen3 Coder 30B, mencatat manfaat privasi tanpa biaya API, dan memperingatkan bahwa model yang lebih kecil dapat gagal dalam format penggunaan alat (dokumentasi Cline, diakses Agustus 2026).
Prompt persis untuk ditempel:
plaintext1Inspect this repository without editing files. Summarize the app structure, identify the test command, and tell me which files are likely involved in the failing checkout discount behavior.
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Provider | Ollama atau endpoint lokal kompatibel OpenAI |
| Base URL | localhost:11434 atau bentuk /v1 yang diperlukan alat |
| Model | qwen3-coder:30b |
| Konteks | 64K untuk repo sedang |
| Temperature | 0.2 |
| Izin | read-only terlebih dahulu |
| Opsi agen | compact prompt aktif, jika tersedia |
Langkah 2: Gunakan Model Qwen Terbaik untuk Coding Lokal pada Perbaikan Bug Tests-First
Jangan minta penjelasan yang bagus terlebih dahulu. Minta model membaca pengujian yang gagal, menambal jalur kode terkecil, dan melaporkan hasil pengujian yang tepat. Coding lokal membangun kepercayaan saat terminal membaik.
Prompt persis untuk ditempel:
plaintext1Fix the checkout discount bug using a tests-first workflow. 2 3Rules: 41. Read the failing test output before editing. 52. Identify the smallest code path that can cause the discount to apply twice after quantity changes. 63. Patch only the necessary files. 74. Do not change public component props. 85. After editing, run the relevant test command and report the exact result.
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Model | qwen3-coder:30b |
| Temperature | 0.2 |
| Konteks | 64K |
| Compact prompt | aktif |
| Izinkan alat | baca file, edit file, jalankan perintah pengujian |
Alur kerja perbaikan bug Qwen lokal tests-first beranimasi
Contoh alur kerja beranimasi: gunakan satu pengujian checkout yang gagal untuk membatasi edit, lakukan koreksi terkecil, dan selesaikan dengan memverifikasi hasilnya.
Langkah 3: Coba Refaktor Lintas File dengan Qwen3 Coder 30B
Setelah satu perbaikan bug berhasil, coba refaktor yang terkendali. Jaga tugas tetap sempit, pertahankan nama fungsi publik, dan wajibkan pengujian. Di sinilah banyak model lokal yang lebih kecil melenceng karena mereka harus menahan wrapper lama, tipe baru, dan dua call site di memori.
Prompt persis untuk ditempel:
plaintext1Refactor the billing API client into a typed service. 2 3Goal: 4- Create a BillingService with typed request and response objects. 5- Keep the existing public function names working through thin wrappers. 6- Update the two current call sites. 7- Add or update tests for the wrapper behavior. 8- Do not introduce a new dependency. 9- Show the final diff summary and test result.
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Model | qwen3-coder:30b |
| Temperature | 0.2 |
| Konteks | 96K jika repo memiliki banyak file terkait |
| Jika lambat | kurangi file yang disertakan dan berikan daftar file eksplisit |
Alur kerja perencanaan refaktor lintas file beranimasi
Contoh alur kerja beranimasi: petakan jalur service yang terdampak, pindahkan satu tanggung jawab yang terbatas, lalu jaga wrapper dan pengujian tetap selaras.
Langkah 4: Gunakan Fill-in-the-Middle Coding Qwen Lokal Hanya di Tempat yang Cocok
Fill-in-the-middle sangat baik untuk satu isi fungsi yang hilang atau celah penyelesaian editor. Bentuk ini tidak cocok untuk tugas repo penuh karena tidak membawa perencanaan, penggunaan alat, dan loop umpan balik yang sama.
Prompt persis untuk ditempel:
plaintext1Complete only the missing function body. Preserve the surrounding code style and do not add explanations. 2 3<|fim_prefix|> 4export function normalizeDiscountCode(input: string): string { 5<|fim_suffix|> 6} 7 8export function isValidDiscountCode(input: string): boolean { 9 return /^[A-Z0-9-]{4,24}$/.test(normalizeDiscountCode(input)); 10} 11<|fim_middle|>
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Temperature | 0.1 |
| Output maks | 300 token |
| Penggunaan | penyelesaian editor atau chat lokal langsung |
| Hindari | refaktor luas dan pekerjaan agen multi-file |
Langkah 5: Verifikasi Perubahan Coding Qwen Lokal dengan Atlas Cloud Qwen3 Coder Next
Qwen3 Coder Next adalah jalur tinjauan hosted dalam alur kerja ini. Berguna saat konteks lokal Anda terlalu sempit, mesin Anda terlalu lambat, atau patch cukup penting untuk mendapatkan tinjauan independen. Atlas Cloud adalah eksekusi cloud, jadi tempel diff terkecil yang berguna dan ikuti kebijakan perusahaan Anda.
Prompt persis untuk ditempel:
plaintext1Review this patch as a senior software engineer. 2 3Context: 4- The local model fixed a checkout discount bug and all current tests pass. 5- I want a second opinion before merging. 6 7Review checklist: 81. Look for missed edge cases. 92. Look for state-management regressions. 103. Look for test gaps. 114. Do not rewrite the whole patch. 125. Return only: blocking issues, non-blocking improvements, and one recommended extra test. 13 14Patch: 15[paste diff here]
Pengaturan yang dipilih:
| Pengaturan | Nilai |
|---|---|
| Model | qwen/qwen3-coder-next |
| Token maks | 2.000 hingga 4.000 |
| Temperature | 0.2 |
| Stream | opsional |
| Disiplin input | tempel diff minimal, bukan rahasia |
Alur kerja tinjauan patch final independen beranimasi
Contoh alur kerja beranimasi: tinjauan independen membaca patch dan catatan pengujian bersama-sama, lalu menunjukkan edge case yang tersisa sebelum rilis.
Variasi: Cline, Continue, Aider
Cline cocok untuk developer yang menginginkan agen VS Code untuk membaca file, mengedit, dan menjalankan perintah. Aktifkan compact prompt jika tersedia, jaga auto-approval tetap konservatif pada awalnya, dan mulai dengan satu pengujian yang gagal alih-alih permintaan fitur yang samar.
Continue cocok untuk developer yang menginginkan chat lokal, penyelesaian inline, dan konteks repo tanpa memberi model terlalu banyak kendali perintah. Ini setup harian yang baik saat Anda terutama membutuhkan pembacaan kode, edit kecil, dan jawaban cepat.
Aider cocok untuk edit yang digerakkan pengujian. Ini bekerja baik saat Anda dapat menyebutkan file dan perintah yang menentukan keberhasilan. Gaya itu juga memberi Anda cara yang adil untuk membandingkan 30B lokal dengan tinjauan Qwen hosted: diff sama, pengujian sama, standar penerimaan sama.
Gunakan LM Studio jika Anda lebih suka GUI dan ingin memeriksa kuantisasi, konteks, dan status server. Gunakan llama.cpp saat Anda ingin kontrol lebih ketat atas flag. Gunakan vLLM atau SGLang saat tim membutuhkan endpoint bersama dan memiliki perangkat keras yang cukup untuk membenarkan setup tersebut.
Biaya: Perangkat Keras Lokal vs Qwen Hosted
Qwen lokal tidak memiliki tagihan API per token, tetapi tidak gratis dalam arti praktis. Anda membayar dengan VRAM, RAM, listrik, waktu setup, proses konteks panjang yang lebih lambat, dan sesekali sore hari yang dihabiskan untuk menemukan pengaturan yang seharusnya sudah jelas.
Untuk sebagian besar setup coding lokal, Qwen3 Coder 30B Q4 adalah kompromi yang berguna. Model ini cukup besar untuk coding agentik, cukup kecil untuk muat di perangkat keras konsumen serius, dan terdokumentasi dengan baik di berbagai runtime lokal. Kelas 480B termasuk untuk memori kelas server atau jalur hosted.
| Skenario | Pilihan Qwen lokal | Penggunaan Atlas Cloud | Mengapa masuk akal |
|---|---|---|---|
| Proyek sampingan hobi | Qwen3 Coder 30B Q4 | tinjauan patch final saja | biaya berulang rendah, kualitas cukup |
| Repo sensitif privasi | lokal saja | tidak ada kecuali kebijakan mengizinkan | kode tetap di mesin |
| Laptop kurang bertenaga | model lokal lebih kecil untuk catatan | Qwen hosted untuk prompt berat | menghindari latensi lokal yang menyakitkan |
| Tim mengevaluasi Qwen | 30B lokal dan Qwen Next hosted | bandingkan prompt yang sama | memisahkan kualitas model dari batas perangkat keras |
Catatan privasi
Inferensi lokal adalah keunggulan privasi. Repo privat Anda dapat tetap di mesin Anda, dan agen Anda dapat menjalankan pengujian tanpa mengirim kode ke endpoint hosted.
Tinjauan hosted tetap berguna, tetapi perlakukan seperti alat kode cloud lainnya. Jangan tempel rahasia, kunci privat, data pelanggan, atau seluruh repositori proprietari. Tempel diff terkecil dan output pengujian yang relevan. Periksa juga lisensi checkpoint atau kuantisasi persis yang Anda unduh, bahkan ketika kartu model upstream mencantumkan Apache 2.0.
Jika Anda mengingat satu hal dari panduan ini, ingatlah ini: model qwen terbaik untuk coding lokal adalah model yang dapat menahan konteks repo Anda, mematuhi agen Anda, dan lulus pengujian Anda pada perangkat keras yang benar-benar Anda gunakan.
Pertanyaan yang Sering Diajukan
Apa model Qwen terbaik untuk coding lokal saat ini?
Bagi sebagian besar developer, Qwen3 Coder 30B A3B adalah pilihan lokal praktis. Model ini memiliki campuran terbaik dari ukuran, konteks, perilaku coding agentik, dan dukungan runtime lokal.
Bisakah Qwen3 Coder 30B berjalan di VRAM 16GB?
Model ini bisa cukup berjalan dengan kuantisasi dan offload, tetapi perkirakan adanya kompromi. GPU 24GB atau memori sistem 32GB+ memberi Anda setup yang lebih tenang, terutama setelah KV cache dan jendela konteks bertambah.
Apakah Qwen3 Coder Next lebih baik daripada Qwen3 Coder 30B untuk coding lokal?
Model ini mungkin lebih kuat untuk beberapa tugas tinjauan dan konteks panjang, tetapi kurang praktis untuk mesin lokal biasa. Perlakukan Qwen3 Coder Next sebagai opsi hosted atau workstation bermemori tinggi kecuali Anda memiliki perangkat keras untuk menjalankannya dengan nyaman.
Haruskah saya menggunakan Ollama, LM Studio, llama.cpp, Cline, Continue, atau Aider?
Gunakan Ollama untuk start command-line tercepat. Gunakan LM Studio untuk GUI. Gunakan llama.cpp untuk kontrol yang lebih mendalam. Gunakan Cline saat Anda menginginkan agen VS Code, Continue untuk chat dan penyelesaian, dan Aider untuk loop patch yang digerakkan pengujian.
Mengapa agen coding Qwen lokal saya gagal bahkan saat modelnya bagus?
Penyebab umumnya adalah konteks terlalu sedikit, temperature terlalu tinggi, harness penggunaan alat yang lemah, model lebih kecil dari yang diharapkan agen, atau prompt yang meminta refaktor menyeluruh sebelum model memetakan repo.
Kapan saya harus menggunakan Atlas Cloud alih-alih menjalankan Qwen secara lokal?
Gunakan Atlas Cloud saat mesin lokal Anda tidak dapat menampung model, saat Anda memerlukan pendapat kedua Qwen hosted, atau saat tim ingin membandingkan 30B lokal dengan endpoint Qwen yang lebih besar. Jauhkan kode sensitif kecuali kebijakan Anda mengizinkannya.


