

Arsip proyek setebal 900 halaman mudah diunggah. Pertanyaan yang lebih sulit adalah apakah model dapat menunjuk ke klausul, commit, atau titik data yang Anda butuhkan secara tepat. Kasus penggunaan jendela konteks 1M DeepSeek V4.1 Flash masuk akal ketika beberapa sumber terkait harus dipertimbangkan bersama, seperti basis kode, korpus riset, atau catatan proyek bertahun-tahun. Jendela yang lebih besar mengurangi kebutuhan untuk memecah materi tersebut di awal, sementara pemeriksaan bukti tetap menentukan apakah jawabannya dapat diandalkan.
Yang paling cocok adalah tinjauan kode lintas file, sintesis riset, perbandingan kebijakan, analisis umpan balik, linimasa proyek, dan catatan multimodal yang panjang. DeepSeek mencantumkan konteks 1M token, tetapi kapasitas itu bukan jaminan bahwa setiap detail akan diingat secara akurat. Periksa batas model dan API untuk rute Anda, lalu uji materi Anda sendiri sebelum mengandalkan hasilnya.
Poin-poin penting
- Gunakan jendela satu juta token ketika pertanyaan bergantung pada hubungan di antara banyak sumber yang relevan.
- Mintalah referensi file, bagian, atau halaman dan pisahkan bukti langsung dari inferensi.
- Mulailah dengan uji jawaban yang sudah diketahui dan perluas konteks hanya ketika itu meningkatkan hasil.
- Perkirakan biaya dari input, output, dan perlakuan cache, bukan hanya dari batas konteks.
Apa arti jendela konteks 1M token?
Jendela konteks adalah jumlah informasi yang dapat dipertimbangkan model dalam satu permintaan atau status percakapan, termasuk materi yang disediakan dan instruksi di sekitarnya. Halaman harga API DeepSeek saat ini mencantumkan DeepSeek-V4.1-Flash dengan panjang konteks 1M dan output maksimum 384K token. Itu adalah batas yang dinyatakan penyedia; aplikasi, endpoint, atau konfigurasi permintaan Anda dapat menerapkan batas yang lebih kecil. ( Dokumentasi API DeepSeek )
Token adalah potongan teks, bukan kata atau halaman. Arsip sumber yang berisi kode, tabel, markup, boilerplate berulang, dan pindaian dapat ditokenkan sangat berbeda dari prosa bersih dengan jumlah halaman yang sama. Untuk beban kerja nyata, perkirakan token dengan tokenizer atau pelaporan penggunaan untuk API yang akan Anda panggil. Sertakan instruksi sistem, nama file, metadata, teks pertanyaan, dan anggaran jawaban dalam perkiraan Anda.
Manfaat praktisnya adalah kesinambungan. Anda dapat bertanya tentang dependensi di beberapa modul atau kontradiksi antara kebijakan saat ini dan lampirannya tanpa harus menyusun ringkasan secara manual terlebih dahulu. Trade-off-nya adalah prompt yang sangat besar dapat berisi materi yang tidak relevan atau duplikat, memerlukan waktu pemrosesan lebih lama, dan tetap membuat pengambilan tepat menjadi lebih sulit. Anggap "muat dalam jendela" sebagai pemeriksaan kapasitas, lalu uji apakah model dapat menemukan fakta yang dibutuhkan tugas Anda.
Kasus penggunaan konteks 1M DeepSeek V4.1 Flash terbaik
Pertanyaan yang tepat bukanlah "Bisakah saya mengunggah semuanya?" Melainkan "Sumber mana yang harus dibandingkan untuk menjawab ini?" Gunakan konteks panjang ketika jawabannya bergantung pada tautan antar materi, dan tentukan bagaimana Anda akan memverifikasi jawaban itu sebelum mengirim arsip lengkap.
| Kasus penggunaan | Mengapa konteks panjang membantu | Apa yang harus disertakan | Apa yang harus diverifikasi |
|---|---|---|---|
| Tinjauan basis kode besar | Antarmuka dan konvensi mencakup modul | Sumber relevan, pengujian, catatan arsitektur | Jalur file, simbol, bukti pengujian |
| Sintesis riset | Metode dan temuan memerlukan perbandingan berdampingan | Makalah, laporan, keterbatasan | Sumber dan peringatan setiap klaim |
| Perbandingan kontrak atau kebijakan | Definisi dan pengecualian berulang di seluruh bagian | Versi saat ini dan sebelumnya, lampiran | Nomor klausul dan kata-kata persis |
| Analisis umpan balik | Tema muncul di banyak komentar | Umpan balik yang diidentifikasi dan aturan pengodean | Kutipan representatif dan metode penghitungan |
| Linimasa riwayat proyek | Keputusan berkembang di seluruh catatan rapat | Notulen, log keputusan, catatan rilis | Tanggal, pemilik, catatan yang bertentangan |
| Tinjauan insiden panjang | Log, tiket, dan postmortem menjelaskan tahapan berbeda | Rentang waktu relevan dan dokumen insiden | Stempel waktu, sumber peristiwa, ketidakpastian |
| Tinjauan dokumen multimodal | Bukti teks dan visual mungkin perlu dibaca bersama | Gambar yang didukung dan keterangan atau konteksnya | Apakah endpoint mendukung jenis media tersebut |
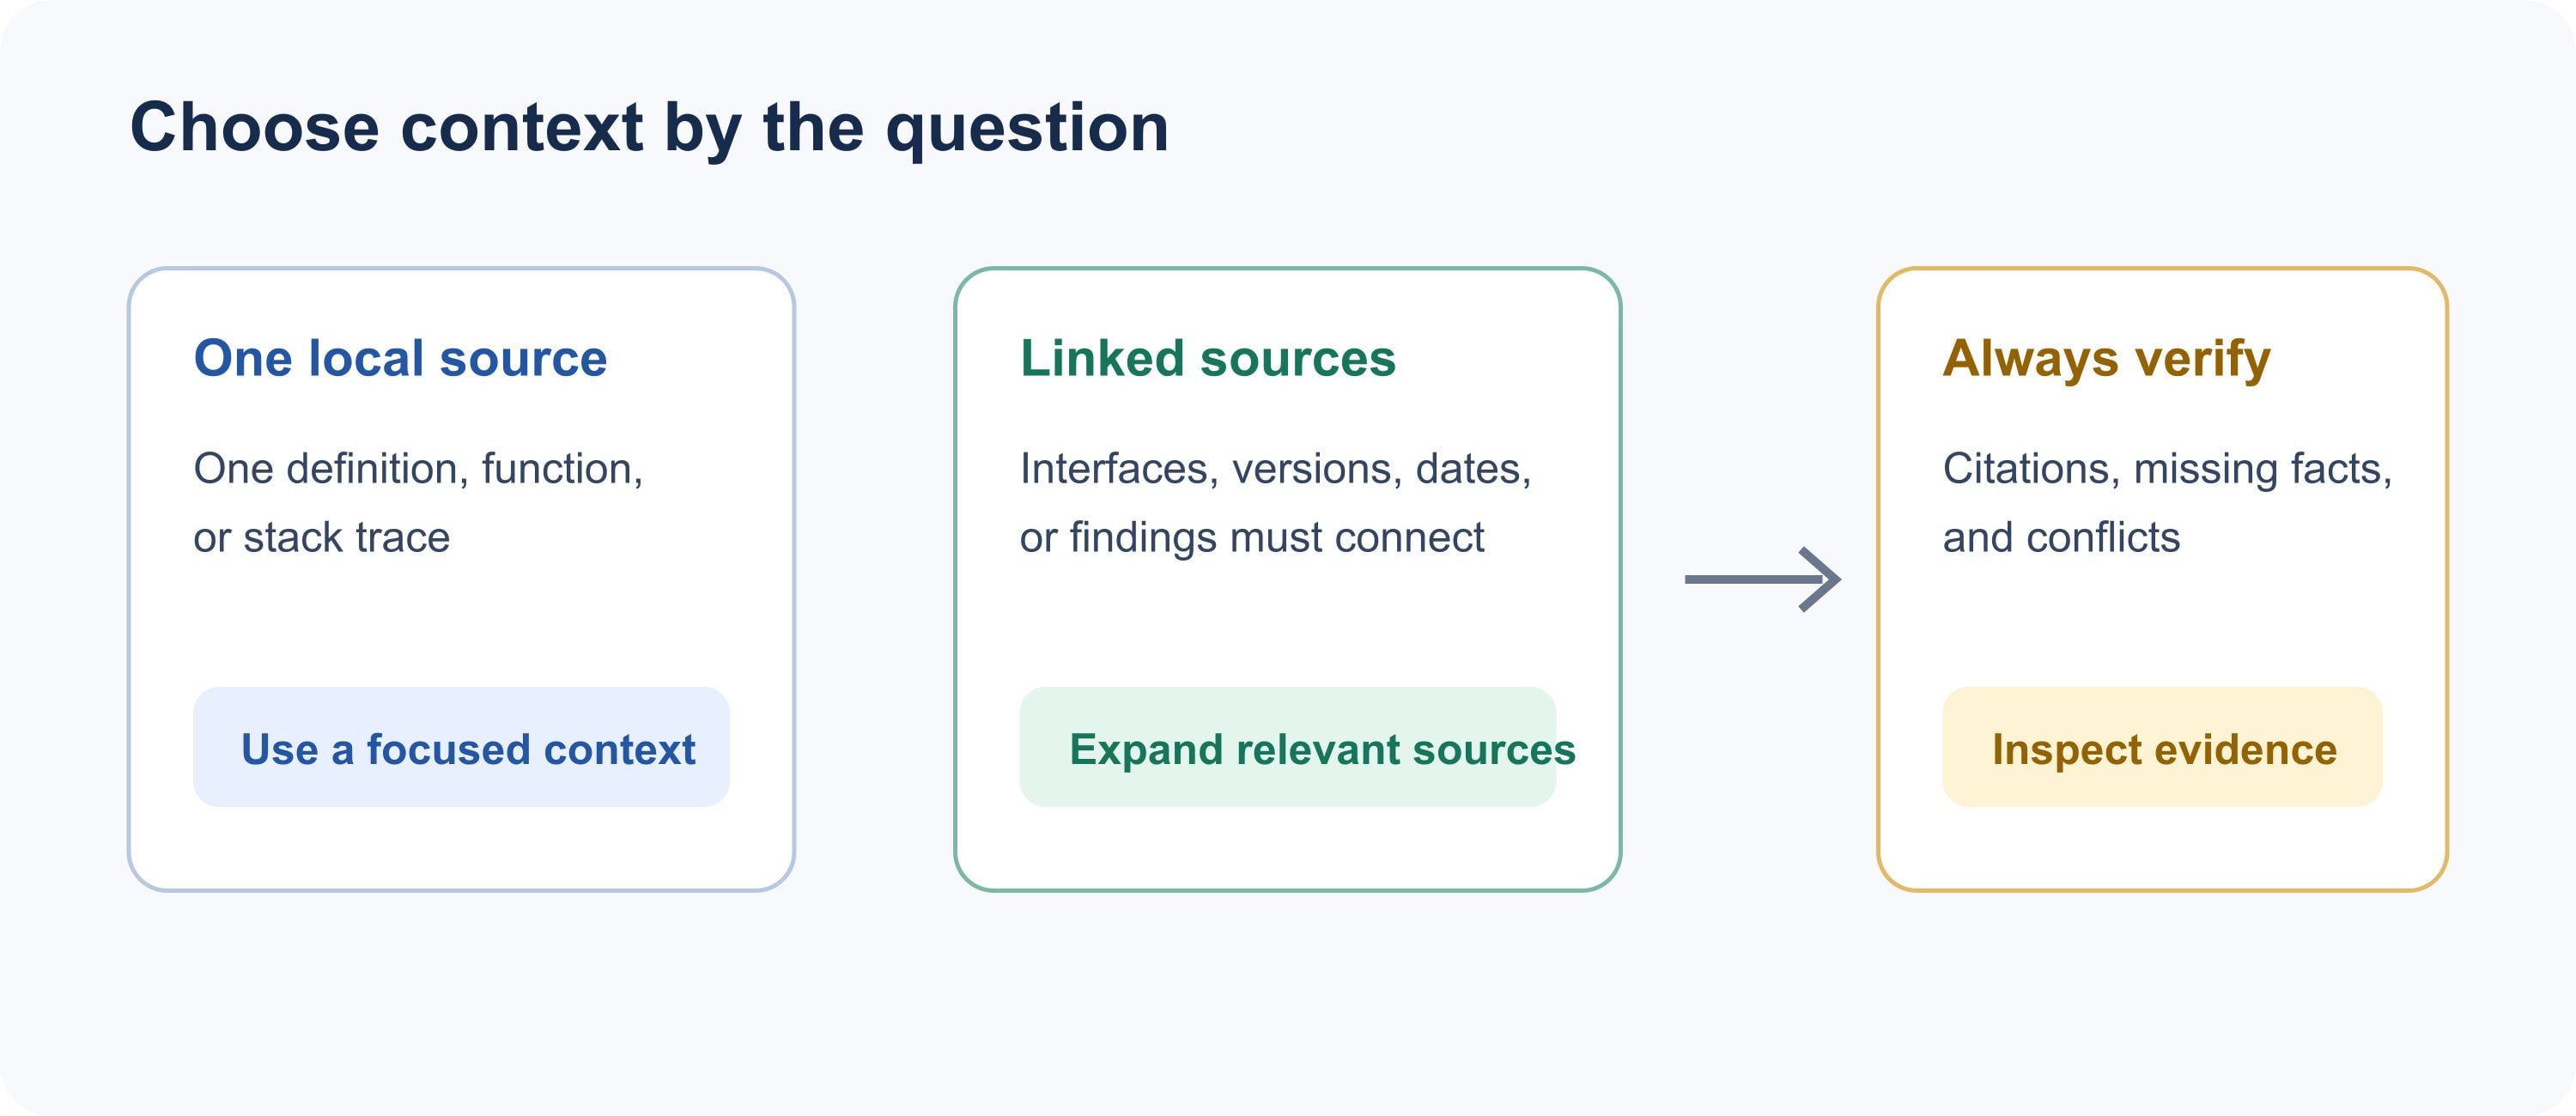
Gunakan konteks yang terfokus untuk pertanyaan lokal; perluas ketika sumber harus terhubung, lalu periksa buktinya.
Tinjau basis kode besar lintas file
Konteks satu juta token dapat membantu insinyur melacak struktur data dari batas API melalui logika layanan, penyimpanan, dan pengujian. Ini berguna untuk ringkasan arsitektur, menemukan modul yang kemungkinan terpengaruh, dan menyusun rencana refaktor yang menghormati konvensi yang didokumentasikan di beberapa tempat.
Berikan model snapshot repositori yang terbatas daripada dump disk yang tidak difilter. Sertakan file sumber yang relevan dengan perubahan, pengujian terdekat, manifes dependensi, dan catatan arsitektur. Kecualikan output build, dependensi vendor, bundel yang dihasilkan, dan salinan duplikat kecuali pertanyaannya berkaitan dengannya. Mintalah jalur file dan nama simbol untuk setiap dependensi yang diusulkan, plus perbedaan antara perilaku yang diamati dan asumsi.
Gunakan output sebagai rencana tinjauan. Konfirmasi setiap simbol yang dikutip ada, periksa baris yang dikutip, dan jalankan pemeriksaan proyek sendiri. Model tidak boleh mengklaim pengujian lulus kecuali alat benar-benar menjalankannya dan mengembalikan hasilnya. Untuk bug lokal di satu fungsi, konteks yang lebih kecil seringkali lebih cepat dan lebih mudah diaudit.
Sintesis riset lintas makalah dan laporan
Konteks panjang membantu ketika studi menggunakan metode, populasi, ukuran, atau definisi yang berbeda. Mintalah tabel perbandingan dengan satu baris per sumber dan kolom untuk pertanyaan riset, data, metode, hasil, keterbatasan, dan relevansi dengan pertanyaan Anda. Pertahankan klaim tingkat sumber yang melekat pada sumbernya daripada membiarkan ringkasan campuran menghapus perbedaan.
Misalnya, saat membandingkan evaluasi suatu alat, bedakan hasil benchmark dari studi lapangan dan dari interpretasi penulis. Mintalah model untuk menandai ukuran yang tidak kompatibel alih-alih memberi peringkat hasil yang tidak dapat dibandingkan. Lalu buka bagian sumber di balik klaim yang paling relevan untuk keputusan. Sintesis adalah peta bukti, bukan pengganti untuk memeriksa makalahnya.
Bandingkan kontrak, kebijakan, atau spesifikasi yang panjang
Kontrak dan kebijakan sering mendefinisikan suatu istilah sekali dan memenuhi syaratnya di tempat lain. Menyediakan versi operatif, amandemen, jadwal, dan draf lama yang relevan bersama-sama dapat membantu memunculkan definisi yang berubah, referensi silang, kondisi yang hilang, dan konflik yang tampak.
Minta bagian atau klausul yang tepat untuk setiap pengamatan dan kutipan singkat yang dapat ditemukan peninjau. Pisahkan perbedaan tekstual dari konsekuensi yang mungkin timbul. Model dapat membantu mengatur tinjauan, tetapi interpretasi hukum, keputusan kepatuhan, dan otoritas penandatanganan tetap berada pada orang yang berkualifikasi yang dapat memperhitungkan yurisdiksi dan konteks.
Analisis umpan balik pelanggan dalam skala besar
Kumpulan umpan balik yang besar dapat mengungkap permintaan dan keberatan yang berulang di seluruh saluran atau periode waktu. Berikan sampel yang ditentukan, hapus informasi pribadi yang tidak diperlukan, dan tentukan skema pengodean seperti "gesekan orientasi," "integrasi yang hilang," atau "kebingungan harga." Mintalah contoh representatif dan kontracontoh, bukan hanya daftar tema.
Jangan menyajikan persentase tema yang dihasilkan model sebagai statistik survei. Jika Anda memerlukan hitungan, tentukan unitnya (pesan, pelanggan, atau masalah), hapus duplikat catatan, terapkan aturan pelabelan yang konsisten, dan verifikasi hitungan dengan skrip yang dapat diulang atau sampel yang ditinjau manusia. Model berguna untuk mengusulkan kategori dan menemukan contoh; metode yang terdokumentasi mendukung klaim kuantitatif.
Bangun linimasa dari dokumen proyek
Untuk serah terima atau postmortem, bukti yang relevan mungkin tersebar di notulen rapat, catatan rilis, log keputusan, dan tiket. Mintalah tabel kronologis dengan tanggal, peristiwa, pemilik yang disebutkan jika ada, lokasi sumber, dan keyakinan atau ambiguitas. Instruksikan model untuk mempertahankan tanggal yang bertentangan daripada memilih satu secara diam-diam.
Linimasa yang berguna membantu rekan tim baru melihat apa yang diputuskan, kapan persyaratan berubah, dan dokumen mana yang mendukung setiap peristiwa. Verifikasi transisi kritis terhadap catatan sumber, terutama ketika catatan ditulis belakangan atau merangkum rapat daripada merekamnya secara langsung.
Tinjau catatan insiden panjang dan materi multimodal
Tinjauan insiden dapat memperoleh manfaat dari menyimpan peringatan, catatan operasional, tiket, dan postmortem dalam satu set bukti. Mintalah urutan peristiwa yang diamati dan secara eksplisit bedakan stempel waktu dalam log dari perkiraan belakangan dalam catatan naratif. Ini dapat membuat pemeriksaan pertama lebih koheren, sementara insinyur on-call tetap memeriksa sistem sumber sebelum mengambil tindakan.
Pengumuman resmi DeepSeek menyatakan V4.1-Flash aktif di API-nya dengan dukungan multimodal asli. Format gambar, metode permintaan, dan batasan yang tepat bergantung pada endpoint dan integrasi, jadi konfirmasi detail tersebut sebelum menganggap bahwa anggaran teks satu juta token juga menggambarkan penanganan gambar. ( Pengumuman DeepSeek V4.1-Flash )
Kapan satu juta token membantu, dan kapan menambah noise?
Konteks yang lebih banyak membantu ketika sumber perlu direferensikan silang. Perubahan kode yang melibatkan antarmuka bersama mungkin memerlukan beberapa modul dan pengujian. Perbandingan versi memerlukan kedua versi lengkap dan lampirannya. Linimasa proyek mungkin memerlukan catatan yang tersebar selama berbulan-bulan.
Bug lokal dengan stack trace yang jelas mungkin hanya memerlukan fungsi, pemanggilnya, dan pengujian yang relevan. Pertanyaan yang meminta satu definisi mungkin hanya memerlukan bagian otoritatif. Untuk tugas-tugas itu, menyertakan seluruh repositori menambah ruang pencarian dan dapat mengubur bagian yang berguna.
Sebelum memperluas prompt, hapus ekspor berulang, draf usang, folder yang tidak terkait, boilerplate, dan catatan di luar rentang waktu pertanyaan. Simpan manifes tentang apa yang Anda sertakan dan mengapa. Jika jawabannya berubah ketika Anda menambahkan banyak file yang tidak terkait, itu adalah sinyal untuk mempersempit kumpulan sumber dan menjalankan ulang pengujian.
Alur kerja praktis untuk jawaban konteks panjang yang andal
Gunakan protokol bukti yang konsisten agar jawaban yang fasih tidak disalahartikan sebagai jawaban yang terverifikasi. Pertama, beri label sumber dengan nama file yang stabil dan, jika memungkinkan, nomor halaman, judul, nomor baris, tanggal, atau pengenal versi. Pertahankan konteks di sekitarnya yang cukup untuk menafsirkan kutipan dengan benar.
Selanjutnya, nyatakan satu keputusan atau pertanyaan riset. Tentukan bentuk output dan lokasi yang harus dikutip model. Prompt yang dapat digunakan kembali adalah:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Untuk basis kode, tambahkan: "Sebutkan jalur repositori dan nama fungsi atau kelas. Sebelum mengusulkan perubahan, daftar file yang terpengaruh dan bukti pengujian yang mendukung proposal. Jangan katakan pengujian dijalankan kecuali hasilnya disertakan dalam bukti yang disediakan."
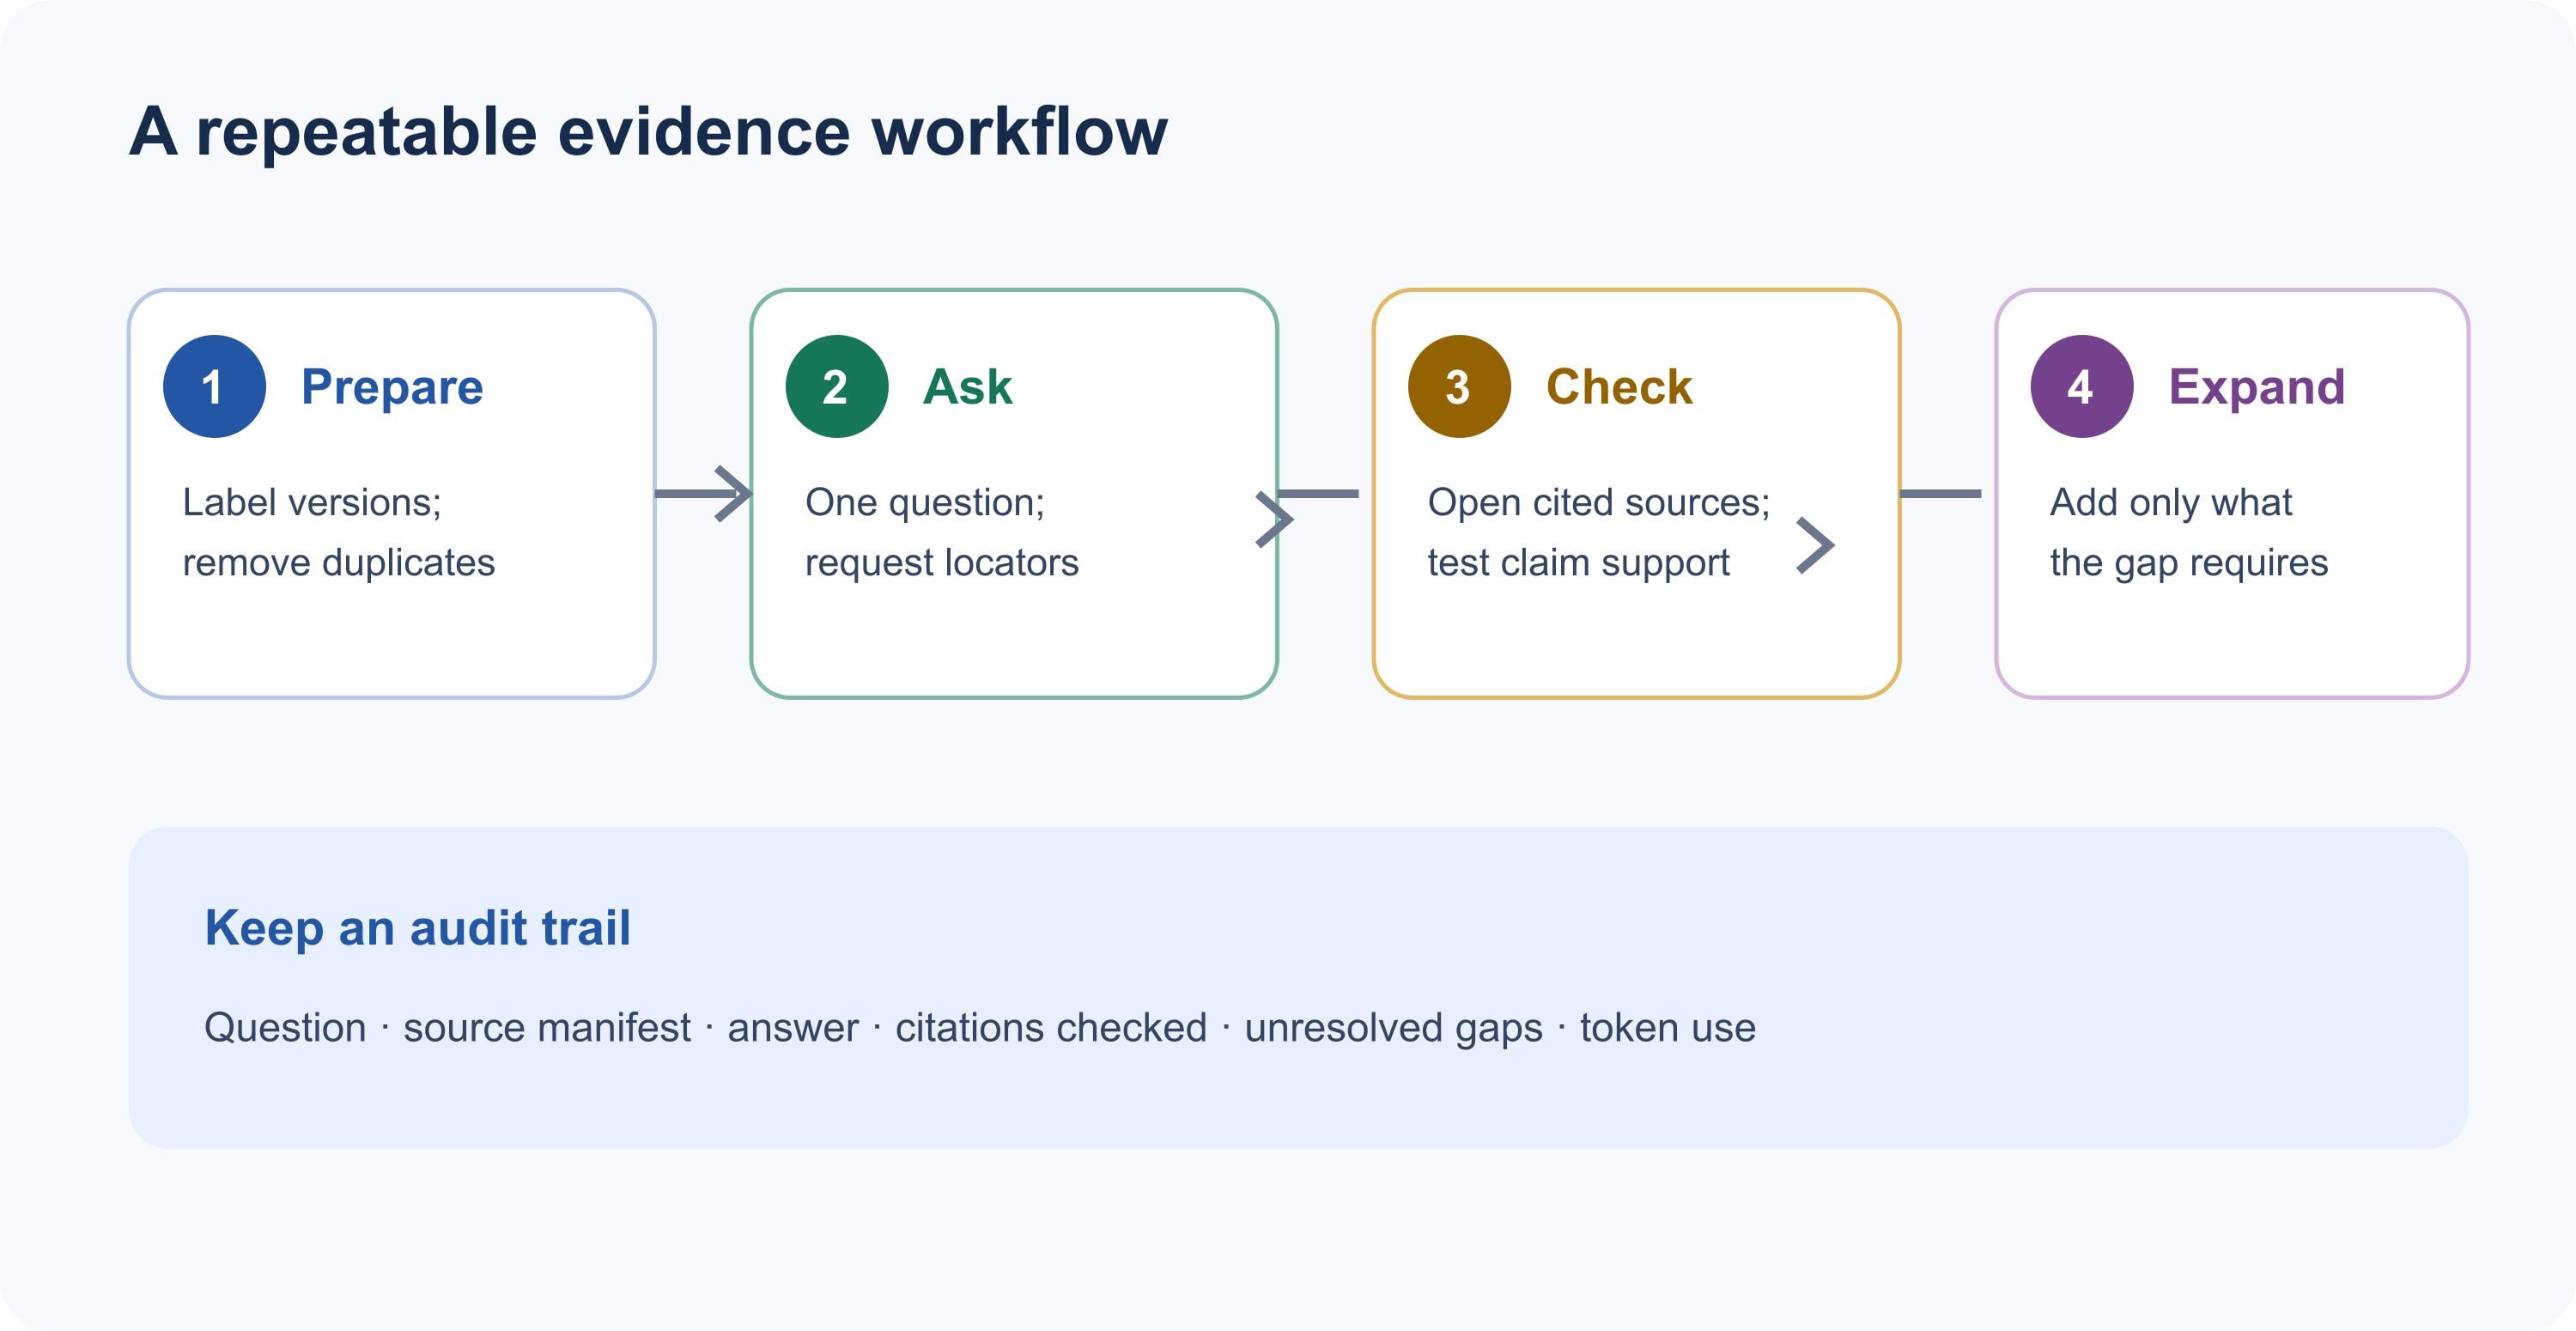
Siapkan sumber, ajukan pertanyaan terbatas, periksa kutipan, dan perluas hanya untuk menyelesaikan celah.
Lalu periksa jawabannya dalam tiga tahap. Periksa apakah setiap kutipan menunjuk ke lokasi yang nyata. Periksa apakah bagian yang dikutip mendukung klaim, bukan sekadar menyebutkan topik. Terakhir, tinjau kelalaian dan konflik dengan mengajukan pertanyaan lanjutan yang ditargetkan terhadap kumpulan sumber yang sama. Untuk keputusan berisiko tinggi, mintalah peninjau yang berkualifikasi membaca materi sumber secara langsung.
Peta bukti alur kerja konteks panjang
| Tahap | Tindakan | Pertahankan | Sinyal berhenti |
|---|---|---|---|
| 1. Persiapan | Beri label, hapus duplikat, dan tentukan cakupan sumber | Manifes sumber dan versi | Asal tidak diketahui atau duplikat usang |
| 2. Tanya | Tetapkan satu pertanyaan dan format bukti | Nama file dan pencari lokasi dalam jawaban | Permintaan luas tanpa target keputusan |
| 3. Periksa | Buka bagian yang dikutip dan bandingkan klaim | Klaim yang didukung dan celah eksplisit | Kutipan tidak mendukung klaim |
| 4. Perluas | Tambahkan hanya sumber yang diperlukan untuk tautan yang belum terselesaikan | Peningkatan pada pemeriksaan jawaban yang diketahui | Lebih banyak input tanpa bukti yang lebih baik |
Cara menguji apakah konteks 1M berguna untuk tugas Anda
Buat set evaluasi kecil sebelum memuat arsip lengkap. Tulis pertanyaan yang jawabannya sudah Anda ketahui dari materi sumber. Letakkan beberapa fakta di dekat awal, beberapa di tengah, dan beberapa di dekat akhir. Tambahkan setidaknya satu pertanyaan yang memerlukan penghubungan dua dokumen dan satu yang tidak dapat dijawab dari sumber yang disediakan.
Jalankan pertanyaan yang sama pada subset yang lebih kecil dan relevan terlebih dahulu, lalu tingkatkan konteks dalam langkah-langkah terukur. Catat kebenaran faktual, akurasi pencari lokasi, bukti yang terlewat, klaim yang tidak didukung, penolakan pada pertanyaan yang tidak dapat dijawab, latensi, dan penggunaan token. Jaga prompt dan pengaturan decoding tetap stabil agar perubahan dapat ditafsirkan. Ulangi pertanyaan jika output sangat bervariasi antar proses.
| Pemeriksaan | Apa yang ditunjukkan respons yang lulus | Apa yang harus dilakukan setelah kegagalan |
|---|---|---|
| Fakta yang diketahui di posisi awal, tengah, akhir | Pengambilan di seluruh rentang sumber | Periksa pengindeksan, label file, dan panjang prompt |
| Tautan lintas dokumen | Bukti dapat digabungkan di seluruh sumber | Mintalah kedua kutipan, lalu persempit pertanyaan tautan |
| Pertanyaan yang tidak dapat dijawab | Model dapat melaporkan bukti yang hilang | Perketat "gunakan hanya sumber yang disediakan" dan uji ulang |
| Audit kutipan | Pencari lokasi dan kutipan mendukung klaim | Perlakukan klaim sebagai belum terverifikasi sampai diperbaiki |
| Perbandingan konteks lebih besar | Materi tambahan meningkatkan tugas target | Hapus noise jika akurasi atau latensi memburuk |
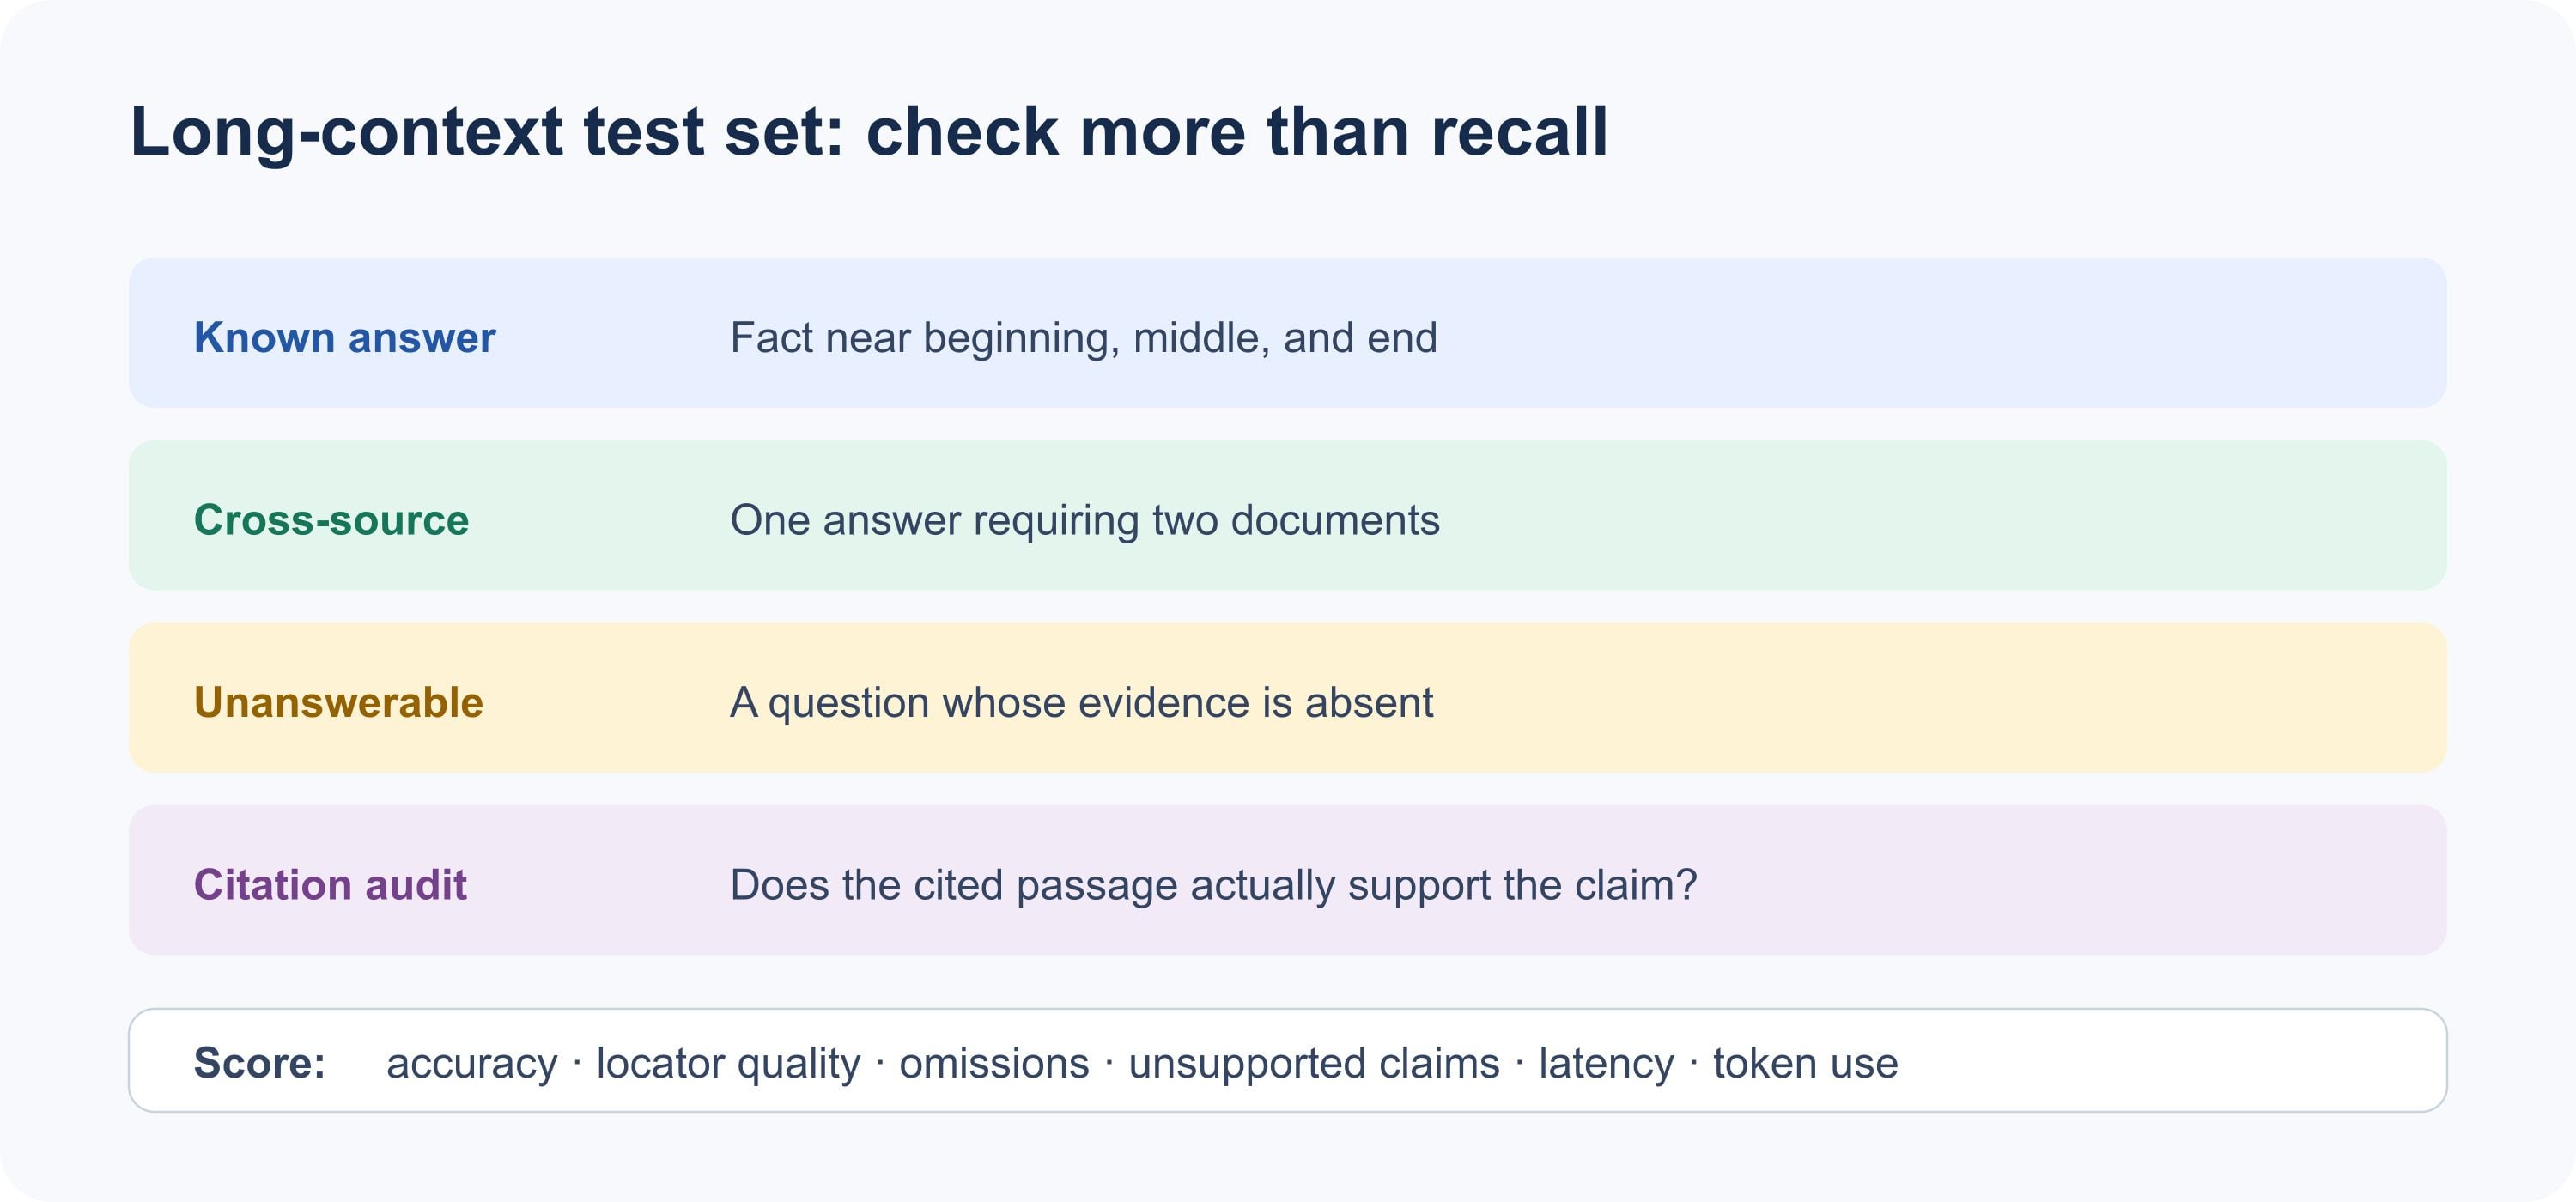
Skor pengambilan, dukungan kutipan, kelalaian, klaim yang tidak didukung, latensi, dan penggunaan token.
Laporan komunitas beragam dan bergantung pada tugas. Seorang pengguna Reddit membagikan peningkatan spesifik harness dalam argumen alat yang cacat pada ukuran konteks yang lebih besar, sementara komentator menggambarkan pekerjaan yang berhasil pada jumlah token yang lebih tinggi dalam pengaturan lain. Itu adalah alasan yang berguna untuk melakukan benchmark pada harness Anda sendiri, bukan bukti untuk ambang kegagalan universal. ( Diskusi konteks DeepSeek di Reddit )
Peningkatan skala yang masuk akal adalah: validasi prompt pada sampel kecil, tambahkan kelompok sumber yang diperlukan untuk pertanyaan lintas dokumen, lalu uji permintaan besar yang representatif. Pertahankan konteks terkecil yang menjawab pertanyaan sebenarnya dengan bukti yang dapat diandalkan. Ini juga membuat perbandingan latensi dan biaya lebih mudah ditafsirkan.
Harga dan akses API DeepSeek V4.1 Flash
Di Atlas Cloud, daftar model saat ini menampilkan DeepSeek V4.1 Flash dengan konteks 1M dan tarif $0.30 per juta token input, $1.20 per juta token output, dan $0.03 per juta token baca cache. Daftar tersebut tidak menunjukkan diskon untuk model ini. Ini adalah tarif Atlas Cloud, berbeda dari harga puncak dan non-puncak DeepSeek yang bergantung pada waktu. Periksa kembali katalog model Atlas Cloud dan halaman harga model sebelum mempublikasikan atau menganggarkan karena tarif dapat berubah.
Pada tarif yang terdaftar, permintaan dengan 100.000 token input yang tidak di-cache dan 2.000 token output biayanya sekitar $0.03 untuk input ditambah $0.0024 untuk output, atau total $0.0324 sebelum biaya lain yang berlaku. Jika input ditagih sebagai baca cache, 100.000 token yang di-cache akan menjadi $0.003. Contoh ini mengasumsikan jumlah token dan tarif tersebut; ini bukan penawaran untuk beban kerja tertentu. Kapasitas 1M penuh tidak dikenakan biaya hanya karena keberadaannya. Penagihan mengikuti penggunaan dan perlakuan cache.
Untuk tim yang menginginkan satu titik masuk API, halaman model DeepSeek V4.1 Flash menyediakan model dan detail pemanggilan. Bandingkan penggunaan token yang Anda ukur dan kebutuhan integrasi dengan endpoint resmi juga; nama model, batasan, dan harga dapat berbeda antar penyedia.
Pertanyaan yang Sering Diajukan
Apakah jendela konteks 1M token sama dengan 1M kata?
Tidak. Token dapat berupa bagian kata, tanda baca, fragmen kode, atau unit lain. Jumlah kata atau halaman yang muat bergantung pada materi dan tokenisasinya. Gunakan jumlah token yang diukur daripada konversi halaman tetap.
Apakah DeepSeek V4.1 Flash selalu menggunakan jendela konteks penuh?
Tidak. Satu juta token adalah spesifikasi konteks maksimum, bukan target untuk setiap permintaan. Prompt pendek menggunakan lebih sedikit, dan antarmuka atau rute API tertentu dapat memberlakukan batas yang lebih rendah. Periksa dokumentasi endpoint dan bidang penggunaan aktual.
Apakah konteks 1M cukup untuk seluruh basis kode?
Mungkin muat untuk beberapa basis kode berdasarkan jumlah token, tetapi itu tidak membuat setiap file relevan atau setiap jawaban dapat diandalkan. Sertakan file yang diperlukan untuk pertanyaan, verifikasi jalur dan simbol yang dikutip, dan uji perubahan dengan pemeriksaan nyata proyek.
Haruskah saya memasukkan setiap dokumen yang tersedia ke dalam satu prompt?
Hanya jika dokumen-dokumen tersebut berkaitan dengan pertanyaan yang sama. Mulailah dari manifes sumber, hapus duplikat dan materi yang tidak terkait, lalu tambahkan lebih banyak ketika uji lintas dokumen membutuhkannya. Kasus penggunaan jendela konteks 1M DeepSeek V4.1 Flash terbaik ditentukan oleh bukti yang harus dibandingkan, bukan oleh ukuran arsip.





