Dua tim dapat melaporkan ratusan token per detik untuk DeepSeek V4.1 Flash dan tetap mengukur hal yang berbeda. Satu bisa berarti kecepatan decode untuk satu permintaan; yang lain bisa berarti output agregat di puluhan permintaan bersamaan. Untuk meningkatkan optimasi throughput inferensi DeepSeek V4.1 Flash, pertama pilih metrik yang dibutuhkan layanan Anda, lalu benchmark campuran permintaan Anda sendiri, ubah satu variabel serving pada satu waktu, dan verifikasi latensi, kualitas, serta biaya secara bersamaan. Keluarga model ini kini mencakup pembaruan Flash-1017 17 Oktober, jadi catat checkpoint persisnya sebelum membandingkan hasil. Laporan publik menunjukkan jalur optimasi yang berguna, tetapi tidak ada yang menggantikan pengujian yang disesuaikan pada perangkat keras Anda.
Poin utama
- Token output agregat/detik mengukur kapasitas di seluruh permintaan; kecepatan decode per permintaan mengukur pengalaman pengguna individu.
- Reproduksi panjang prompt, batas output, konkurensi, status warm, dan target latensi Anda sebelum melakukan tuning.
- KV cache terkompresi dan bounded replay V4.1 Flash mengurangi tekanan memori, tetapi tidak menjamin percepatan end-to-end yang tetap.
- Bandingkan vLLM dan SGLang hanya dalam kondisi model, perangkat keras, beban kerja, dan pengukuran yang setara.
Apa Arti Throughput bagi DeepSeek V4.1 Flash?
Throughput adalah laju, tetapi pembilang dan batas pengujiannya penting. Untuk layanan inferensi, catat setidaknya lima pengukuran:
| Metrik | Apa yang diberitahukannya kepada Anda | Penggunaan umum |
|---|---|---|
| Token output agregat/detik | Token output yang dihasilkan semua permintaan aktif per detik | Perencanaan kapasitas dan efisiensi armada |
| Token decode per permintaan/detik | Kecepatan generasi yang dialami satu permintaan individual | Responsivitas interaktif selama generasi |
| Token prefill/detik | Token input yang diproses per detik | Prompt panjang dan beban kerja berat retrieval |
| Waktu ke token pertama (TTFT) | Waktu dari kedatangan permintaan hingga token output pertama | Keterlambatan start-up yang dirasakan |
| Latensi end-to-end, p50/p95 | Durasi total permintaan di seluruh distribusi traffic | Tujuan tingkat layanan dan perilaku ekor |
Sebuah server dapat menaikkan throughput agregat dengan melakukan batching lebih banyak sekuens sekaligus membuat setiap pengguna menunggu lebih lama di antara token. Sebaliknya, penyiapan yang di-tuning untuk konkurensi rendah dapat memberikan respons individual yang gesit tetapi membuat akselerator kurang terpakai. Tidak ada hasil yang secara universal lebih baik. Target yang tepat adalah titik pada kurva throughput-latensi yang memenuhi tujuan layanan produk Anda.
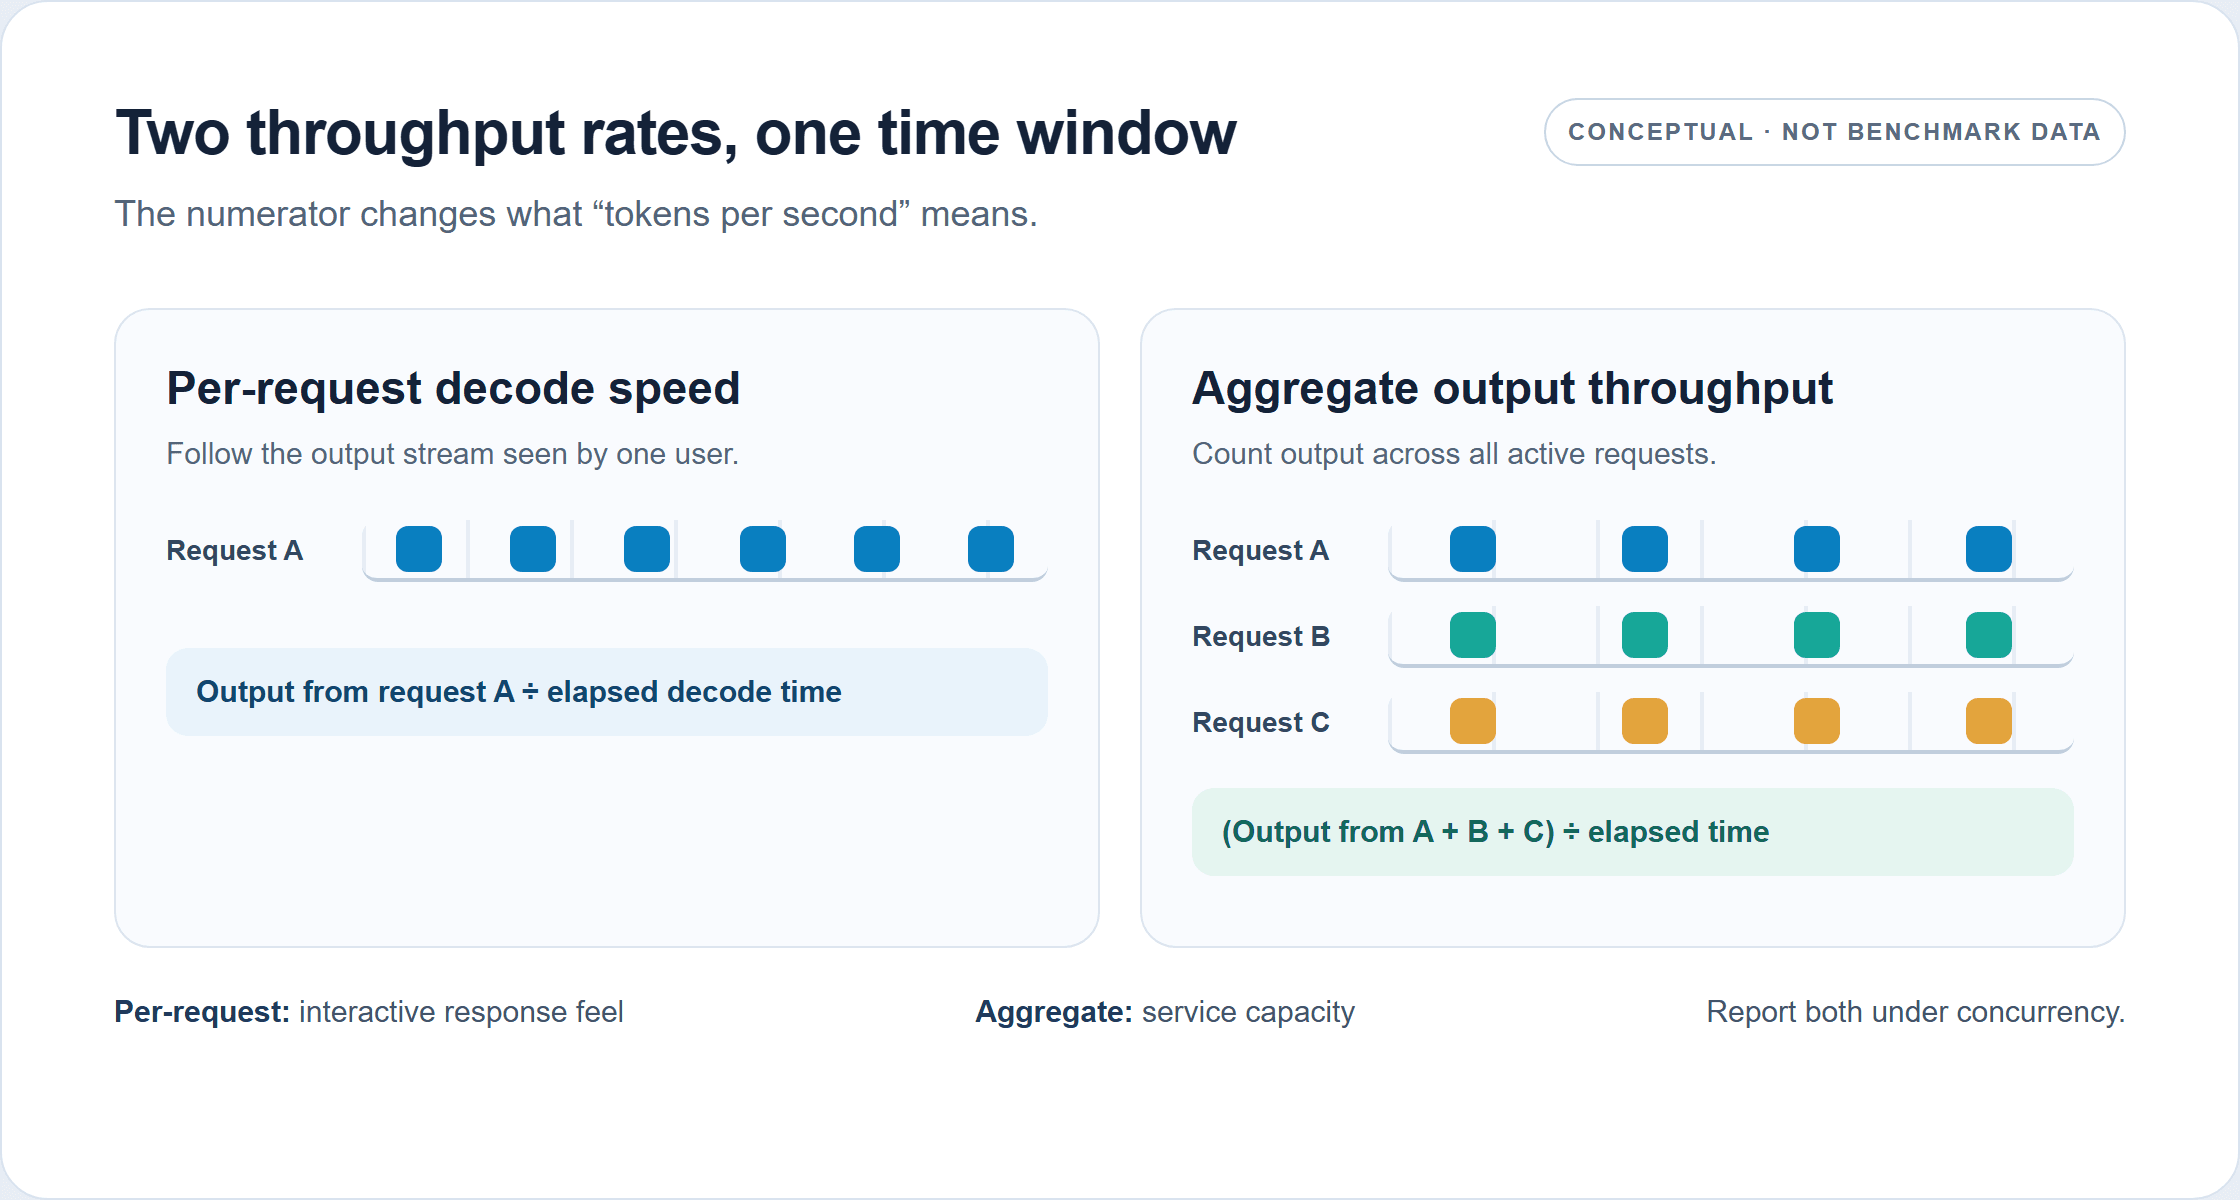
Kedua laju tersebut menghitung aliran output yang berbeda. Ini adalah diagram konseptual, bukan performa DeepSeek V4.1 Flash yang terukur.
Tentukan apakah throughput mencakup prefill, decode, atau keduanya. Nyatakan apakah Anda membaginya dengan jumlah GPU. Laporkan token output yang berhasil, bukan token maksimum yang diminta, dan ungkapkan pembatalan atau error. Tanpa detail tersebut, angka token/detik tidak dapat memberi tahu operator apakah angka itu memprediksi aplikasi mereka.
Bangun Baseline DeepSeek V4.1 Flash yang Dapat Direproduksi
Baseline yang berguna cukup menyerupai traffic produksi untuk mengungkap bottleneck-nya. Satu prompt pendek adalah proksi yang buruk untuk agen yang berulang kali mengirim riwayat percakapan besar, dan output tetap 1.024 token melewatkan beban kerja yang berhenti lebih awal atau sangat bervariasi.
Tetapkan Beban Kerja dan Jendela Pengukuran
Buat bucket permintaan dari traffic yang diamati. Untuk setiap bucket, pertahankan perkiraan panjang input, panjang output yang diharapkan, pola kedatangan, dan prefix bersama apa pun. Sertakan giliran tool atau reasoning jika merupakan bagian dari jalur permintaan nyata. Jaga prompt, pengaturan sampling, kondisi stop, dan batas output tetap sama antar proses.
Jalankan kasus konkurensi rendah dan konkurensi yang diharapkan layanan Anda saat puncak. Lalu tambahkan tingkat konkurensi perantara untuk mengungkap di mana throughput berhenti naik atau latensi melewati batasnya. Gunakan jendela pengukuran yang stabil setelah warm-up, ulangi setiap titik, dan laporkan median plus rentangnya. Burst singkat mungkin mengukur perilaku startup, bukan kapasitas layanan yang stabil.
Pisahkan pengukuran cold-start dari warm serving. Proses cold mencakup pemuatan model, graph capture, atau pengisian cache bergantung pada stack; proses warm menggambarkan sistem yang siap melayani. Untuk beban kerja prefix-caching, ukur traffic cache-hit dan cache-miss secara terpisah. Jangan menggabungkannya menjadi satu rata-rata kecuali campurannya cocok dengan produksi.
Simpan Catatan Benchmark
Simpan satu baris untuk setiap proses dengan field berikut: checkpoint atau revisi model; runtime dan commit; model dan jumlah GPU; interconnect; presisi dan kuantisasi; tata letak paralel tensor, expert, atau pipeline; distribusi token input dan output; konkurensi dan pola kedatangan permintaan; status warm atau cold; durasi proses; tingkat keberhasilan; throughput agregat; kecepatan decode per permintaan; TTFT; dan latensi end-to-end p50/p95.
Catatan ini lebih berguna daripada angka leaderboard karena membuat eksperimen berikutnya reproducible. Bekukan sebelum tuning. Jika beban kerja atau checkpoint berubah, mulai baseline baru alih-alih mengaitkan perbedaannya dengan flag serving.
Diagnosis Prefill, Decode, KV Cache, atau Scheduling
Gunakan gejala untuk memilih pengukuran berikutnya, bukan untuk menebak perbaikan. TTFT tinggi dengan kecepatan decode yang dapat diterima mengarah ke pemrosesan input, queueing, cache miss, atau overhead startup. Decode lambat pada konkurensi rendah menyarankan pemeriksaan kernel, bandwidth memori, komunikasi paralel, dan jalur eksekusi model. Throughput agregat yang mendatar saat konkurensi naik dapat menunjukkan tekanan memori, batas scheduler, overhead komunikasi, atau jalur komputasi yang jenuh. Degradasi konteks panjang menuntut pengukuran residensi cache, pekerjaan prefill, dan pergerakan host-to-device.
| Observasi | Pemeriksaan pertama |
|---|---|
| TTFT bertambah seiring panjang prompt | Laju prefill, waktu queue, tingkat cache-hit prefix, warm-up graph atau kompilasi |
| Kecepatan decode rendah bahkan pada konkurensi 1 | Jalur model runtime, dukungan kernel, presisi, utilisasi GPU, overhead komunikasi |
| Token agregat/detik mendatar saat konkurensi naik | Kapasitas KV-cache, batching scheduler, bandwidth memori, topologi paralel |
| Latensi p95 naik tajam sementara output agregat membaik | Ukuran batch, kebijakan queueing, campuran panjang permintaan, tujuan layanan |
| Prompt panjang mengusir permintaan aktif yang berguna | Residensi KV-cache, alokasi cache, distribusi konteks, traffic memori host |
V4.1 Flash memiliki fitur arsitektur yang dimaksudkan untuk meredakan sebagian tekanan ini. Laporan model menjelaskan CSA2 dengan penggunaan ulang cache lintas lapisan dan caching KV global FP4, yang memberikan jejak KV global yang dilaporkan sebesar 890 byte per token, sekitar seperempat dari jejak V4-Flash yang setara. SWA Bounded Replay menangani trade-off penyimpanan yang berbeda: alih-alih mempertahankan semua status sliding-window attention, deployment dapat merekonstruksi status yang hilang dengan memutar ulang jendela terbaru. DeepSeek melaporkan KV cache persisten mendekati seperdelapan jejak V4-Flash untuk desain ini, dengan sedikit komputasi ulang prefill tambahan. Ini adalah hasil arsitektur dan deployment, bukan janji throughput delapan kali lipat. (Laporan teknis DeepSeek, September 2026)
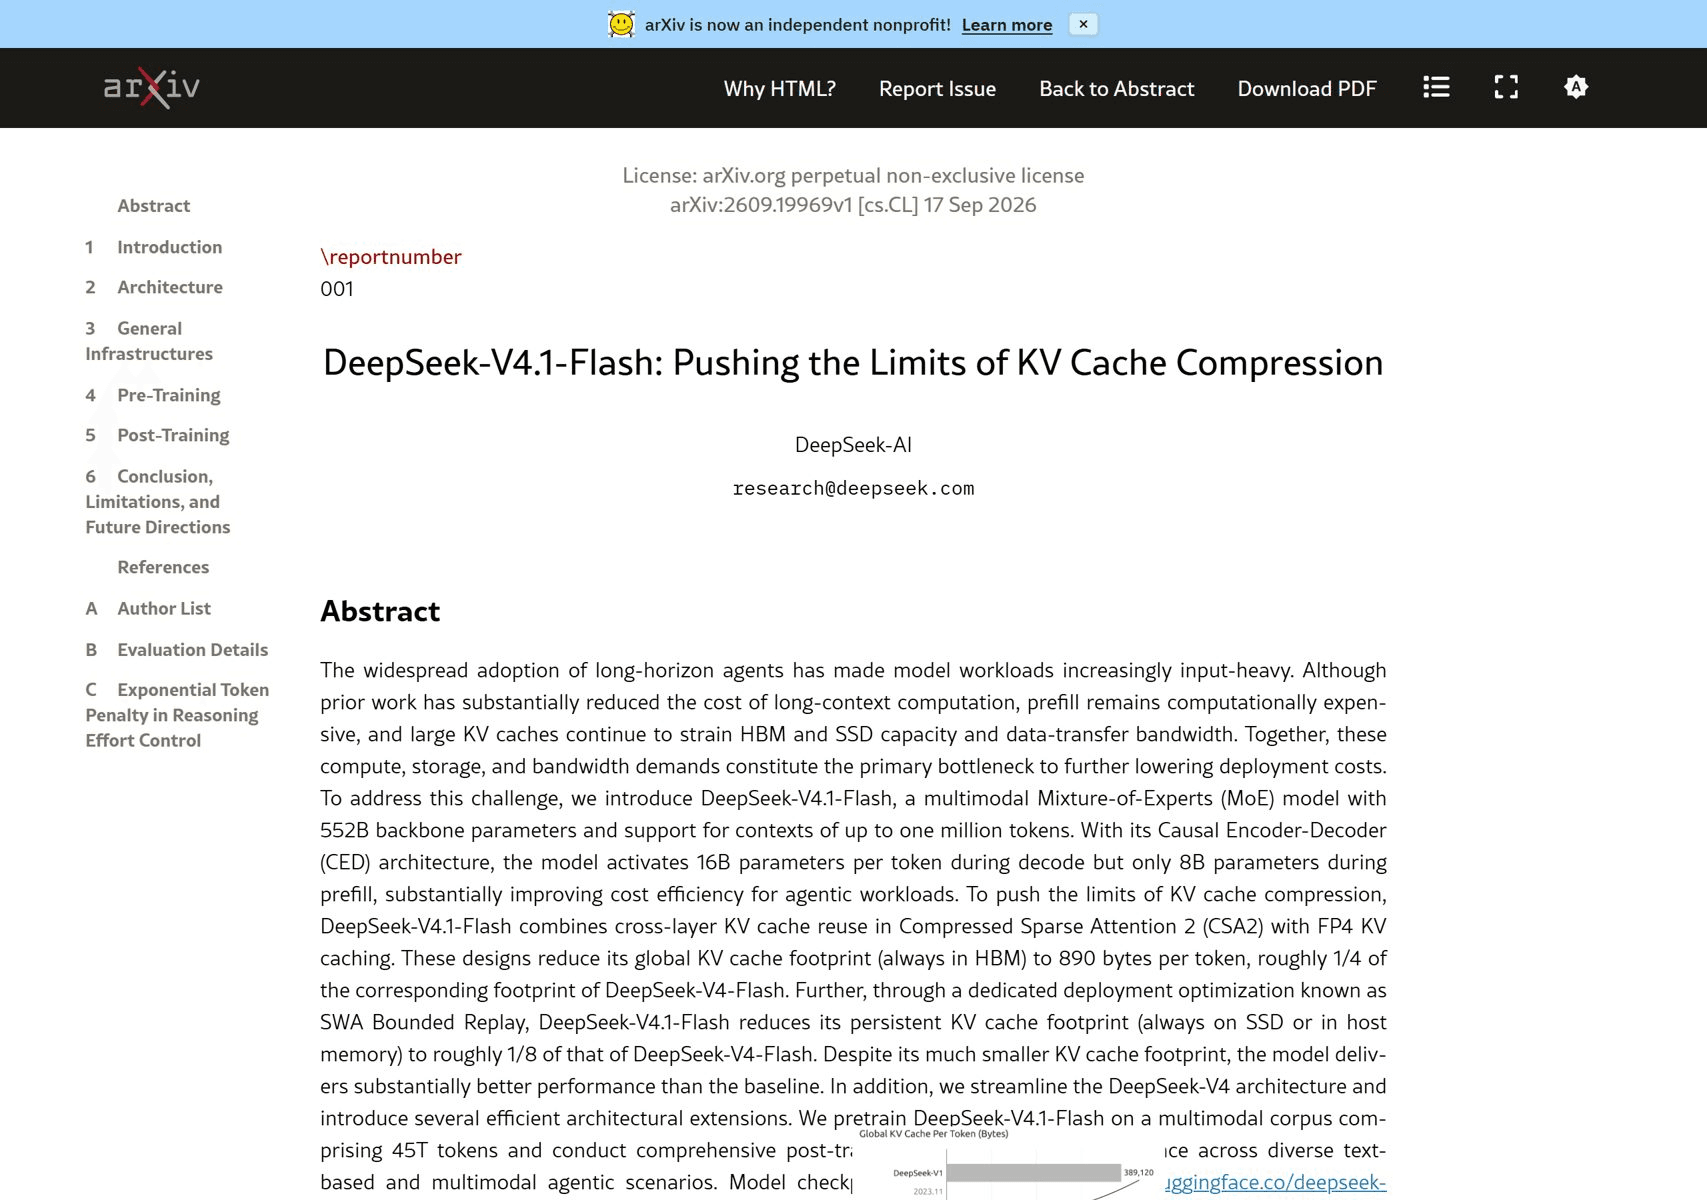
Gambar sumber menjelaskan kapasitas cache, bukan pengali throughput end-to-end untuk setiap deployment.
Ketika diagnosis tidak jelas, profil satu proses yang representatif dan periksa waktu queue, utilisasi GPU, penggunaan memori, dan timing per tahap. Ubah satu variabel, jalankan ulang beban kerja yang sama, dan periksa kebenaran output atau kualitas tugas. Ini mencegah percepatan yang tampak menyamarkan regresi pada layanan atau jawaban.
Tuning vLLM atau SGLang terhadap Target yang Sama
Pilih runtime yang jalur modelnya saat ini mendukung checkpoint dan perangkat keras yang ingin Anda deploy. Verifikasi rilis persis, kernel, perilaku graph, dan tata letak paralel. Model yang tercantum sebagai didukung tidak berarti setiap kuantisasi atau topologi dioptimalkan secara setara.
vLLM: validasi jalur model spesifik rilis
Laporan Oktober tim vLLM menjelaskan perkembangan pada benchmark AgentX mereka: peningkatan sekitar 1,9× pada hasil latensi rendah dan sekitar 5,3× throughput di bawah batasan 150 TPS dibandingkan baseline day-zero mereka. Pekerjaan tersebut mencakup SWA bounded replay dengan CUDA graphs dan integrasi kernel khusus model. Perlakukan nilai tersebut sebagai bukti bahwa stack berubah secara material seiring waktu pada benchmark itu, bukan sebagai pengali untuk diterapkan ke klaster lain. ( laporan engineering vLLM, Oktober 2026)
Untuk proses Anda, tetapkan rilis yang didukung dan konfigurasi yang sudah terbukti baik terlebih dahulu. Lalu ukur perilaku graph capture atau replay, batching, dan paralelisme secara individual. Pertahankan batasan latensi yang digunakan untuk memilih titik throughput lebih tinggi. Jika graph capture mengubah kebutuhan startup atau memori, sertakan biaya tersebut dalam keputusan deployment.
SGLang: cocokkan profil konkurensinya
Laporan tim SGLang memberikan contoh yang sangat jelas tentang mengapa konteks pengujian itu penting. Pada 8 GPU H200, proses optimasi mereka tanpa speculative decoding naik dari sekitar 76 menjadi 168 token/detik per pengguna pada konkurensi satu, dan dari sekitar 96 menjadi 221 token output/detik per GPU pada konkurensi 64. Proses itu menggunakan input tetap 8.192 token dan output 1.024 token. Hasil 4×GB300 terpisahnya menggunakan panjang prompt, pengaturan paralel, dan DSpark speculative decoding yang berbeda. Karena itu, laporan tersebut mendukung evaluasi optimasi SGLang pada traffic Anda, bukan memeringkatnya langsung terhadap angka AgentX vLLM. ( laporan optimasi LMSYS/SGLang, September 2026)
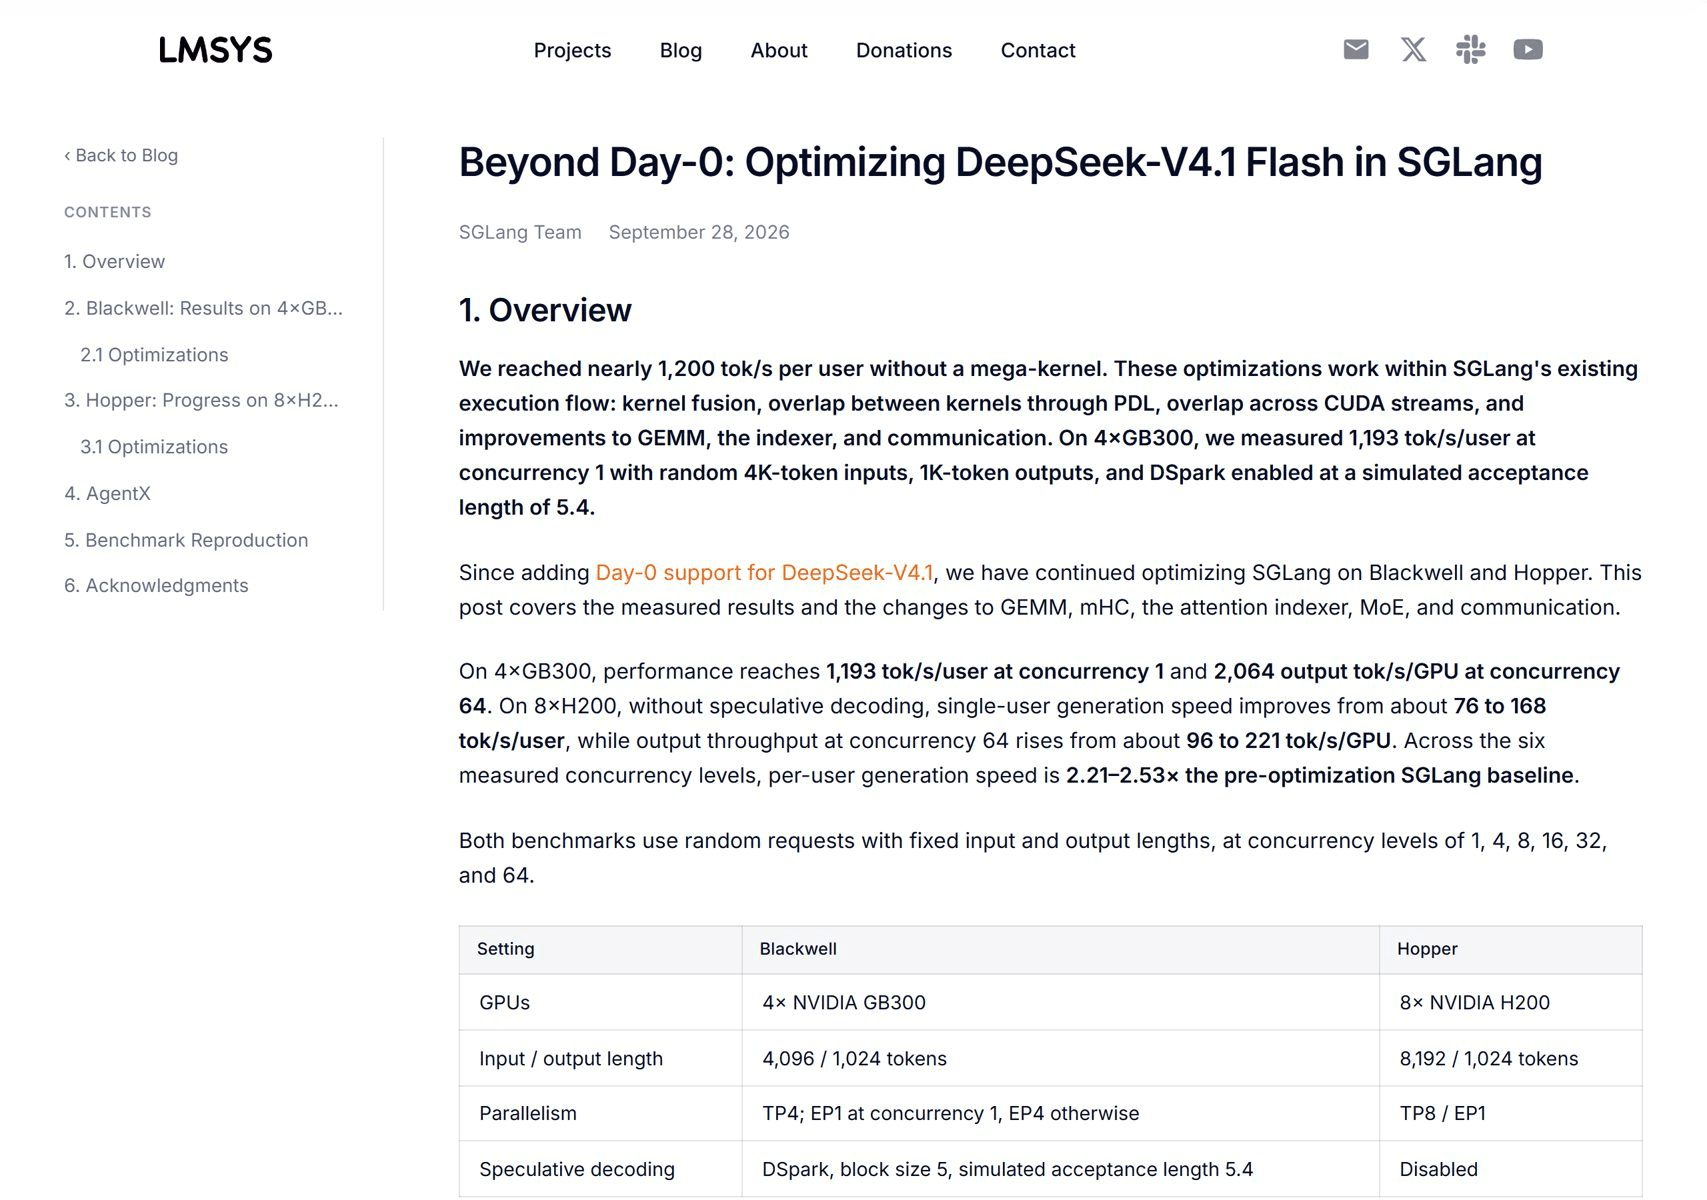
Laporan sumber menggunakan beban kerja dan perangkat keras yang berbeda; angkanya tidak boleh dibaca sebagai grafik head-to-head.
Mulai dengan satu runtime dan optimalkan jalur yang didukungnya. Hanya buat perbandingan runtime kedua jika Anda dapat menjaga checkpoint, alokasi GPU, distribusi prompt dan output, konkurensi, warm-up, dan tujuan layanan tetap konstan. Perbandingan itu memakan waktu engineering, jadi konfirmasi dulu bahwa stack saat ini benar-benar menjadi faktor pembatas.
Optimalkan Konkurensi dan Konteks Panjang Tanpa Melanggar SLO
Tingkatkan konkurensi secara bertahap dan catat output agregat, kecepatan decode per permintaan, TTFT, latensi p95, penggunaan memori, dan kegagalan pada setiap langkah. Pertahankan titik throughput tertinggi hanya jika latensi dan tingkat error-nya masih memenuhi tujuan layanan Anda. Jika permintaan mengantre sebelum generasi, batch yang lebih besar dapat meningkatkan utilisasi perangkat tetapi membuat produk terasa lebih lambat.
Untuk traffic konteks panjang, ukur distribusi konteks aktif dan tingkat cache hit. Jendela konteks maksimum yang dinyatakan tidak berarti setiap permintaan dapat dilayani secara bersamaan pada panjang itu. KV cache bersaing memperebutkan memori dengan bobot, aktivasi, graph pool, dan buffer runtime. Sisakan headroom untuk panjang permintaan yang bervariasi dan ukur eviction atau preemption di bawah traffic yang realistis.
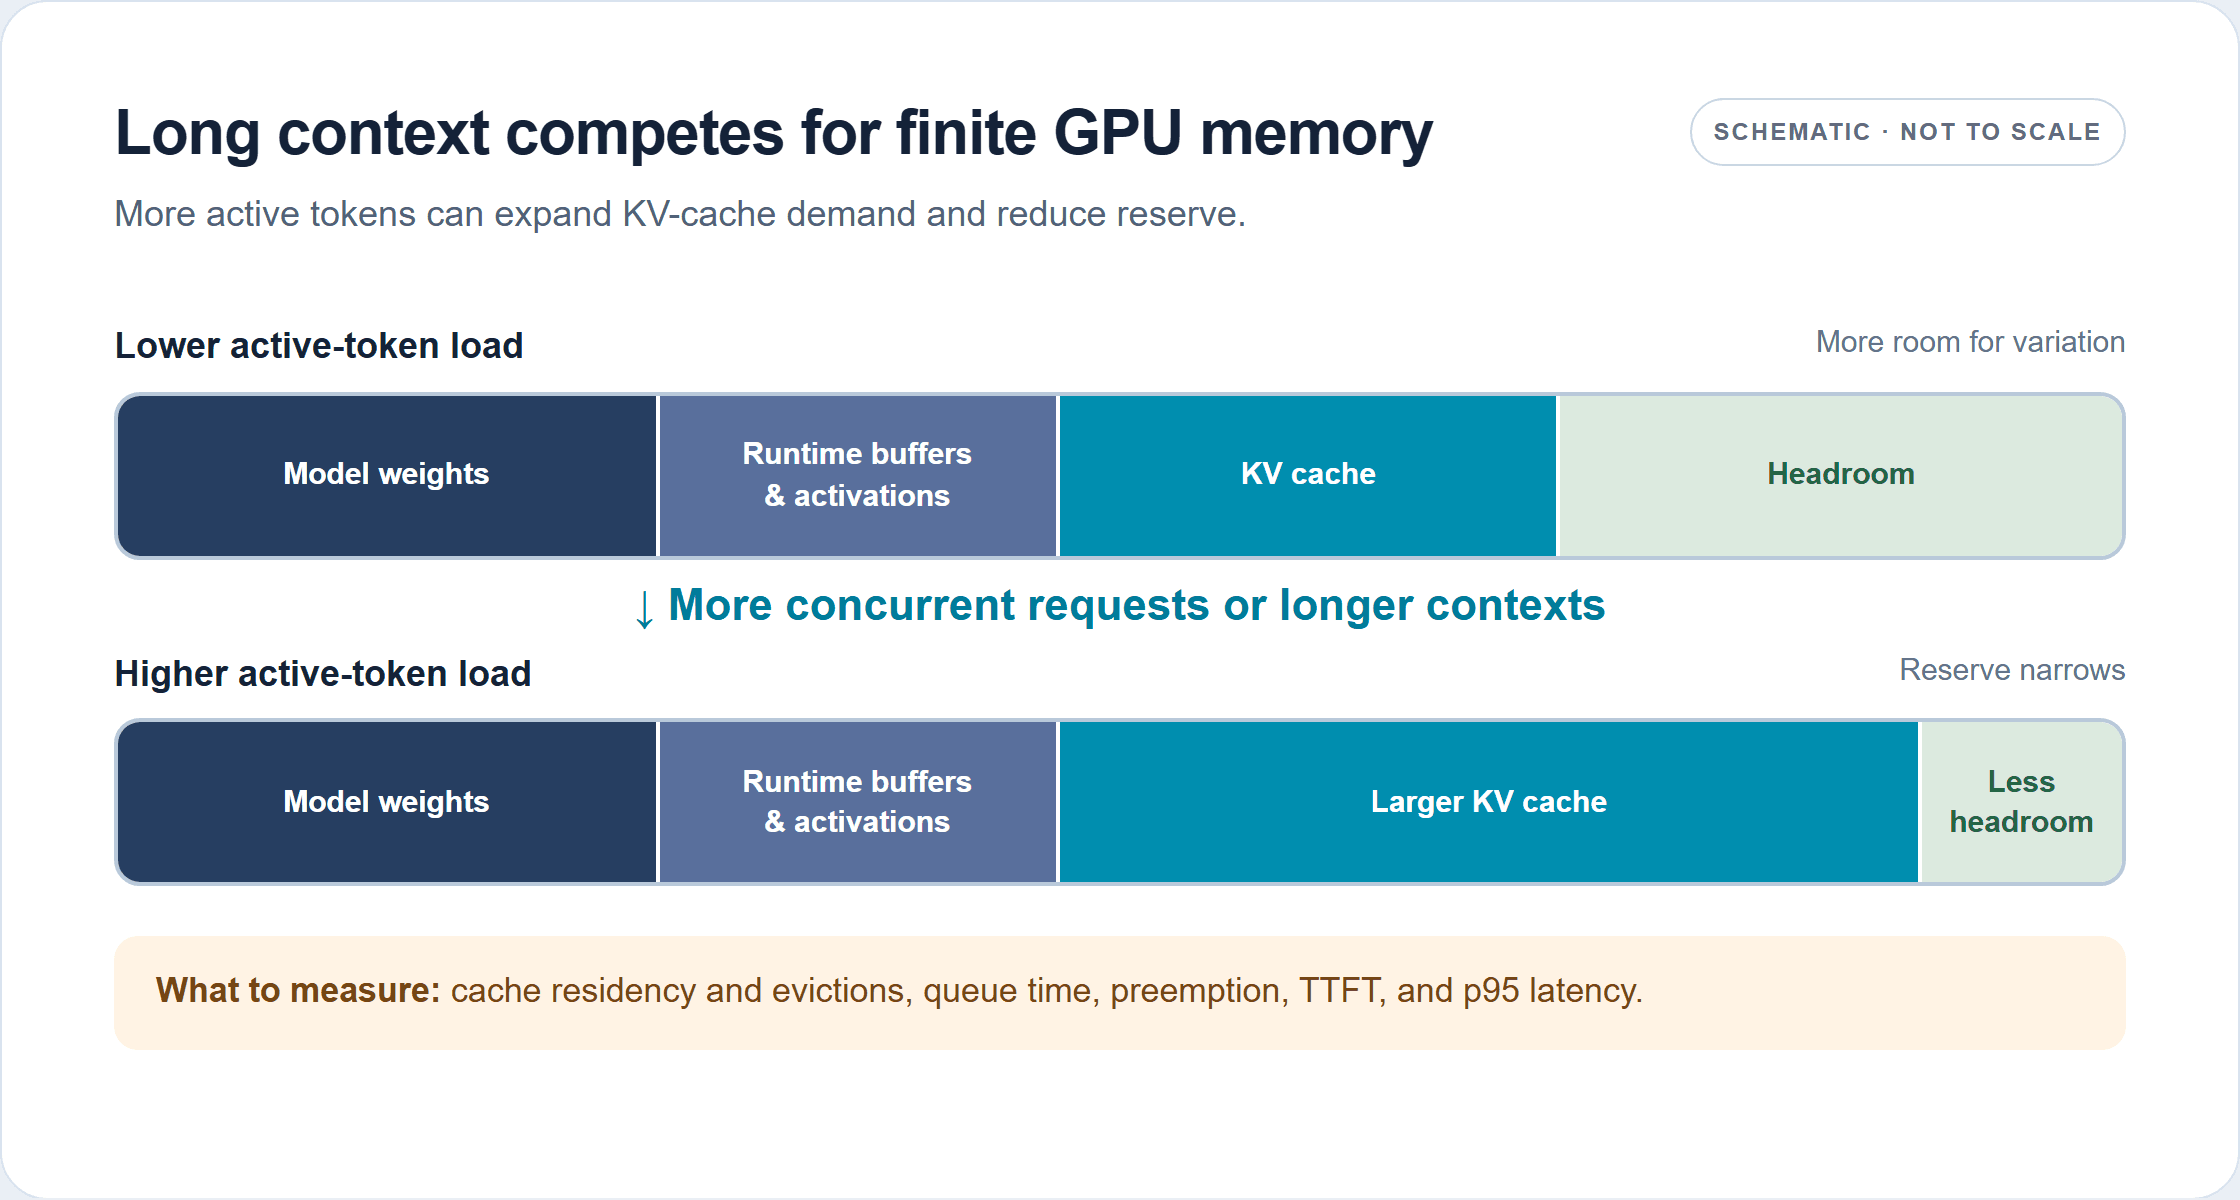
Konteks yang lebih panjang atau lebih banyak permintaan bersamaan dapat meningkatkan kebutuhan KV-cache. Blok memori bersifat skematis dan tidak berskala.
Perlakukan kuantisasi, presisi KV-cache, tensor parallelism, expert parallelism, dan disagregasi prefill/decode sebagai eksperimen terpisah. Semuanya dapat mengubah penggunaan memori, komunikasi, pemilihan kernel, kualitas output, dan latensi. Tata letak terbaik bergantung pada jenis GPU dan interconnect; menambah lebih banyak GPU dapat menaikkan biaya komunikasi atau membuat sebagian sumber daya menganggur. Verifikasi kualitas output persis dan mode kegagalan setelah mengubah presisi atau eksekusi model.
Urutan praktisnya sederhana: reproduksi baseline, identifikasi metrik yang tidak mencapai target, bentuk satu hipotesis bottleneck, ubah satu pengaturan, dan ulangi. Jika pengaturan tersebut meningkatkan satu metrik tetapi merugikan metrik lain, putuskan secara eksplisit apakah trade-off itu cocok untuk produk. Ini menjadikan optimasi keputusan yang terkendali alih-alih tumpukan flag.
Validasi Speculative Decoding dan Setiap Percepatan yang Diklaim
Speculative decoding dapat mengurangi pekerjaan model target serial ketika token draft diterima secara efisien dan runtime mengimplementasikan verifikasi dengan baik. Manfaatnya bergantung pada jalur draft, perilaku penerimaan, bentuk batch, perangkat keras, dan campuran prompt/output. Ini dapat membantu traffic yang terikat decode dan kurang bernilai ketika prefill, queueing, atau komunikasi mendominasi.
Jalankan uji A/B dengan speculation diaktifkan dan dinonaktifkan. Jaga checkpoint model, set prompt, batas token, pola kedatangan, konkurensi, warm-up, dan jendela pengukuran tetap sama. Catat token yang diterima per langkah verifikasi jika tersedia, bersama throughput agregat, kecepatan per permintaan, TTFT, latensi p95, penggunaan GPU, kegagalan, dan kualitas tugas. Panjang penerimaan yang disimulasikan dalam benchmark terbitan adalah kondisi pengujian, bukan nilai yang diasumsikan untuk prompt Anda.
Percepatan yang diklaim hanya berguna jika lolos tiga pemeriksaan: tujuan layanan yang sama, kualitas jawaban yang dapat diterima, dan perbandingan biaya yang adil. Laporkan konteks lengkap dengan angka apa pun yang Anda publikasikan. Hindari membandingkan jumlah GPU, panjang prompt, panjang output, mode presisi, revisi model, atau metrik yang berbeda seolah-olah itu eksperimen terkendali.
Self-Host atau Gunakan API DeepSeek V4.1 Flash Terkelola?
Self-hosting masuk akal ketika traffic cukup stabil untuk menjaga GPU tetap berguna, tim dapat mengoperasikan infrastruktur inferensi, dan kontrol atas perangkat keras atau eksekusi membenarkan pekerjaan operasionalnya. Sertakan biaya penuh akselerator, headroom kapasitas, daya, jaringan, penyimpanan, pemeliharaan, dan waktu engineering. Hasil puncak token/detik yang tinggi saja tidak membuktikan biaya lebih rendah per tugas yang berhasil.
API terkelola berguna ketika tim perlu memvalidasi permintaan produk dengan cepat, menghindari menjalankan armada serving, atau membandingkan baseline API dengan deployment-nya sendiri. Atlas Cloud mencantumkan DeepSeek V4.1 Flash di bawah ID model deepseek-ai/deepseek-v4.1-flash dengan API yang kompatibel dengan OpenAI. Halaman model DeepSeek V4.1 Flash saat ini menunjukkan $0.30 per juta token input, $1.20 per juta token output, dan $0.03 per juta token cache-read, tanpa diskon yang ditampilkan per Oktober 2026. Periksa daftar harga saat ini sebelum memperkirakan pengeluaran. Endpoint terkelola tidak menghilangkan kebutuhan untuk mengukur latensi permintaan atau ekonomi traffic Anda sendiri.
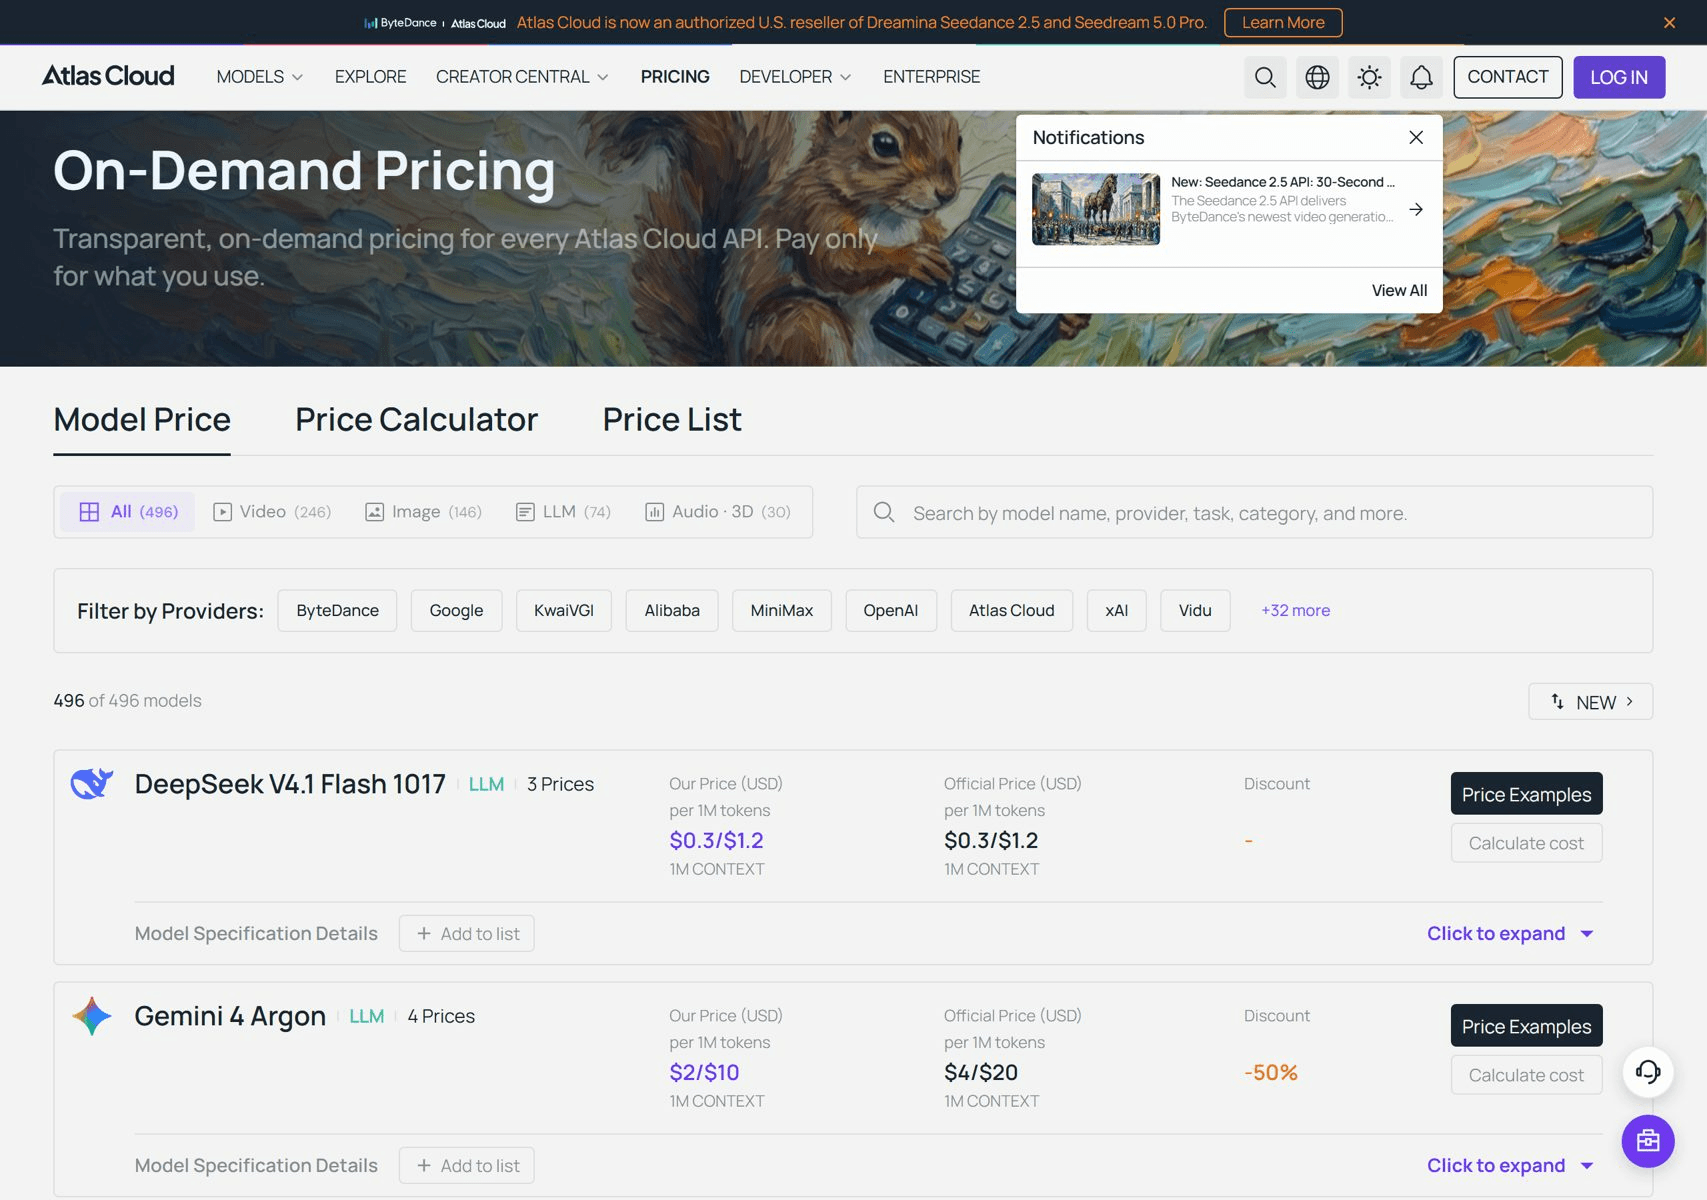
Listing tersebut mengidentifikasi opsi API terkelola; ini bukan benchmark serving.
Untuk keputusan deployment yang adil, putar ulang permintaan bisnis yang sama terhadap layanan self-hosted dan endpoint terkelola. Bandingkan biaya per tugas yang selesai, distribusi latensi, keandalan, dan waktu staf yang dibutuhkan untuk memelihara setiap opsi. Jika tujuan utama Anda adalah optimasi throughput inferensi DeepSeek V4.1 Flash, pertahankan beban kerja dan kriteria keberhasilan yang sama untuk kedua jalur.
Pertanyaan yang Sering Diajukan
Apa perbedaan antara throughput dan token per detik per pengguna?
Throughput agregat menghitung output di seluruh permintaan aktif. Token/detik per pengguna mengukur laju decode satu permintaan. Batching dapat meningkatkan yang pertama sekaligus mengurangi yang kedua, jadi laporkan keduanya untuk layanan interaktif.
Apakah menambah konkurensi selalu meningkatkan throughput?
Tidak. Output agregat dapat naik sampai komputasi atau memori jenuh, lalu mendatar. Queueing dan latensi ekor dapat terus memburuk setelah titik itu. Berhenti menambah konkurensi ketika tujuan layanan tidak terpenuhi.
Bisakah angka benchmark vLLM dan SGLang dibandingkan secara langsung?
Hanya jika revisi model, perangkat keras, panjang prompt dan output, konkurensi, status warm, batas pengukuran, dan batasan latensi cocok. Laporan terbitan menggunakan penyiapan yang berbeda, jadi laporan tersebut menunjukkan jalur optimasi, bukan pemenang runtime secara langsung.
Kapan saya harus menggunakan API terkelola alih-alih self-hosting?
Gunakan API terkelola ketika kecepatan integrasi dan pengurangan pekerjaan infrastruktur lebih penting daripada memiliki stack serving. Self-host ketika utilisasi, keahlian operasional, kontrol, dan kasus total biaya yang terukur membenarkan menjalankan GPU.





