Jendela konteks sejuta token memberi tahu berapa banyak teks yang boleh diterima model, bukan seberapa andal model akan menafsirkan setiap klausa. Untuk akurasi analisis dokumen panjang DeepSeek V4.1 Flash, bukti publiknya berguna tetapi tidak lengkap: kartu model DeepSeek melaporkan 45,2 exact match pada LongBench-V2 untuk model dasar V4.1 Flash dalam pengaturan 1-shot, sementara API sejak itu beralih ke build 1017 yang lebih baru. Benchmark tersebut adalah sinyal tentang satu pengaturan evaluasi, bukan tingkat kelulusan untuk kontrak, laporan tahunan, atau arsip riset Anda.
Jawaban praktisnya adalah gunakan Flash untuk pengambilan cepat dan sintesis awal, lalu wajibkan bukti tingkat halaman dan tinjauan manusia untuk keputusan yang penting. Tidak ada sumber publik yang dikutip di sini yang menyediakan evaluasi build saat ini yang dapat direproduksi di lima tugas dokumen berikut. Rencana pengujian ini adalah protokol yang siap dijalankan, bukan klaim bahwa pengujian tersebut sudah dilakukan.
Poin utama
- Keluarga model ini mendukung hingga 1M token, tetapi batas konteks bukan jaminan akurasi.
- Skor LongBench-V2 45,2 yang diterbitkan adalah untuk model dasar dan pengaturan benchmark 1-shot.
- API DeepSeek kini melayani V4.1-Flash-1017; catatan rilisnya tidak menerbitkan skor dokumen panjang baru.
- Minta lokasi bukti, periksa terhadap sumber, dan ukur kesalahan pada dokumen Anda sendiri.
Apa arti jendela 1M token untuk analisis dokumen
Kartu model DeepSeek menjelaskan V4.1 Flash sebagai model yang mendukung konteks hingga satu juta token. Dokumentasi API saat ini mengidentifikasi model yang dilayani sebagai DeepSeek-V4.1-Flash-1017 dan mencantumkan panjang konteks 1M. Itu adalah spesifikasi kapasitas. Spesifikasi tersebut tidak menetapkan seberapa sering model menemukan catatan kaki, memisahkan dua versi dokumen, atau mengakui bahwa fakta yang diminta tidak ada. (Kartu model DeepSeek)
Token bukan halaman. Jumlah halaman bervariasi bergantung pada tabel, catatan kaki, tata letak, bahasa, dan kualitas ekstraksi. PDF hasil pindai mungkin memerlukan OCR; tabel bisa kehilangan label barisnya saat dikonversi ke teks; header dan elemen berulang tiap halaman dapat menghabiskan konteks tanpa membantu pertanyaan. Prompt dan jawaban yang diminta juga menggunakan token. Jadi, batas atas nominal satu juta token tidak berarti setiap file sejuta token akan sampai secara utuh melalui setiap antarmuka chat atau klien API.
Sebelum pengujian, catat pengenal model yang tepat, klien, dan metode input. Periksa apakah seluruh teks hasil ekstraksi dikirim, apakah penyedia memotongnya, dan apakah permintaan mencapai versi model yang diharapkan. API DeepSeek saat ini menggunakan deepseek-flash untuk build Flash terbaru. Jika gateway atau SDK Anda menggunakan alias lain, catat alias itu dan verifikasi peruteannya. Tim yang menyiapkan panggilan hosted yang dapat diulang dapat memulai dari platform model Atlas Cloud, lalu membuka daftar API DeepSeek V4.1 Flash.
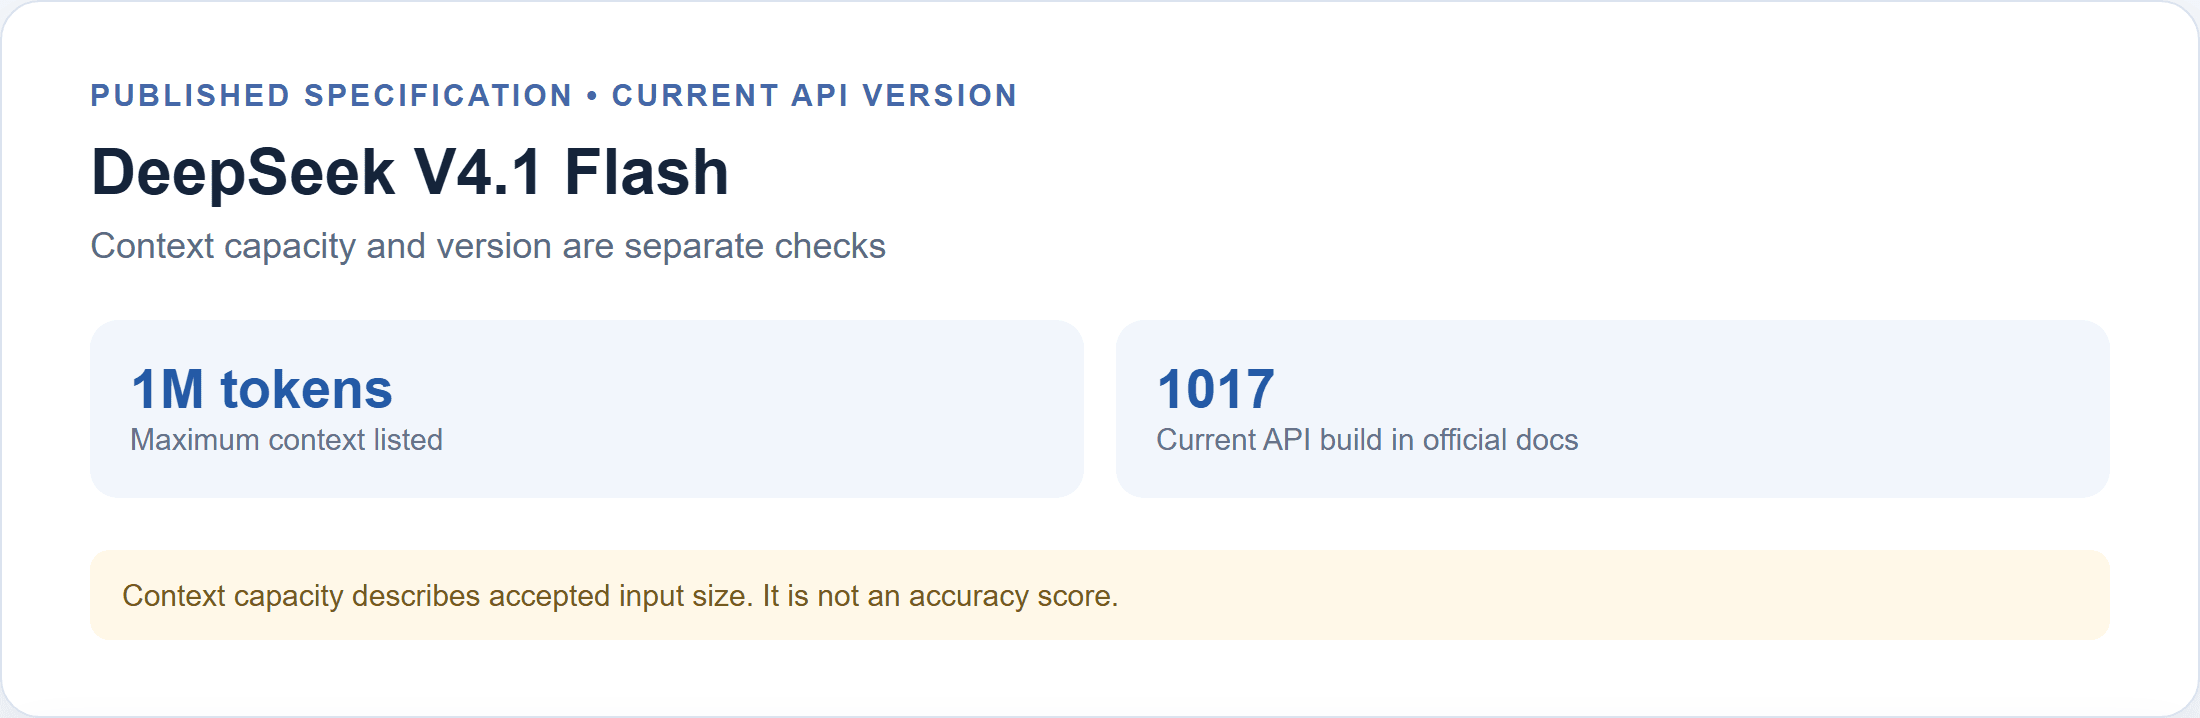
Spesifikasi yang diterbitkan memberikan maksimum konteks 1M; dokumentasi API saat ini mengidentifikasi build 1017.
Upload atau permintaan yang berhasil hanya menunjukkan bahwa sistem menerima input. Untuk memastikan bahwa detail relevan memengaruhi jawaban, minta lokasi yang tepat, ambil bagian tersebut, dan konfirmasi bahwa teks di sekitarnya mendukung klaim.
Apa yang ditunjukkan dan tidak ditunjukkan oleh skor LongBench-V2
Baris LongBench-V2 di kartu model melaporkan skor exact match dalam pengaturan 1-shot. Tabelnya memberi label hasil sebagai evaluasi model dasar dan menyatakan semua model dasar menggunakan kerangka evaluasi internal yang sama. Kartu itu juga menyatakan bahwa skor dalam rentang 0,3 dianggap setara. Nilainya adalah:
| Model dasar di kartu model | LongBench-V2 (EM) | Jumlah shot |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
Selisih 0,5 poin antara V4-Flash-Base dan V4.1-Flash-Base lebih besar daripada rentang kesetaraan 0,3 yang dinyatakan kartu model, tetapi tetap merupakan perbandingan benchmark yang sempit. Angka 45,2 bukan “akurasi 45,2% pada PDF panjang.” Itu adalah skor exact match untuk model dasar tertentu, set benchmark, pengaturan prompt, dan evaluator tertentu. Angka itu tidak secara langsung menilai model instruct/API hosted yang menjawab pertanyaan Anda dengan prompt berbeda.
LongBench-V2 berisi 503 soal pilihan ganda dalam enam kategori, termasuk tanya jawab dokumen tunggal dan multi-dokumen, dialog panjang, repositori kode, dan data terstruktur. Konteksnya berkisar dari 8.000 hingga 2 juta kata. Penulis benchmark melaporkan akurasi rata-rata 53,7% untuk ahli dalam batas 15 menit, dan 50,1% untuk model penjawab langsung terbaik dalam evaluasi yang mereka laporkan. Cakupannya yang luas menjadikannya uji stres yang berguna, tetapi angka agregat tidak dapat mendiagnosis operasi dokumen mana yang kuat atau lemah. (Makalah LongBench-V2)
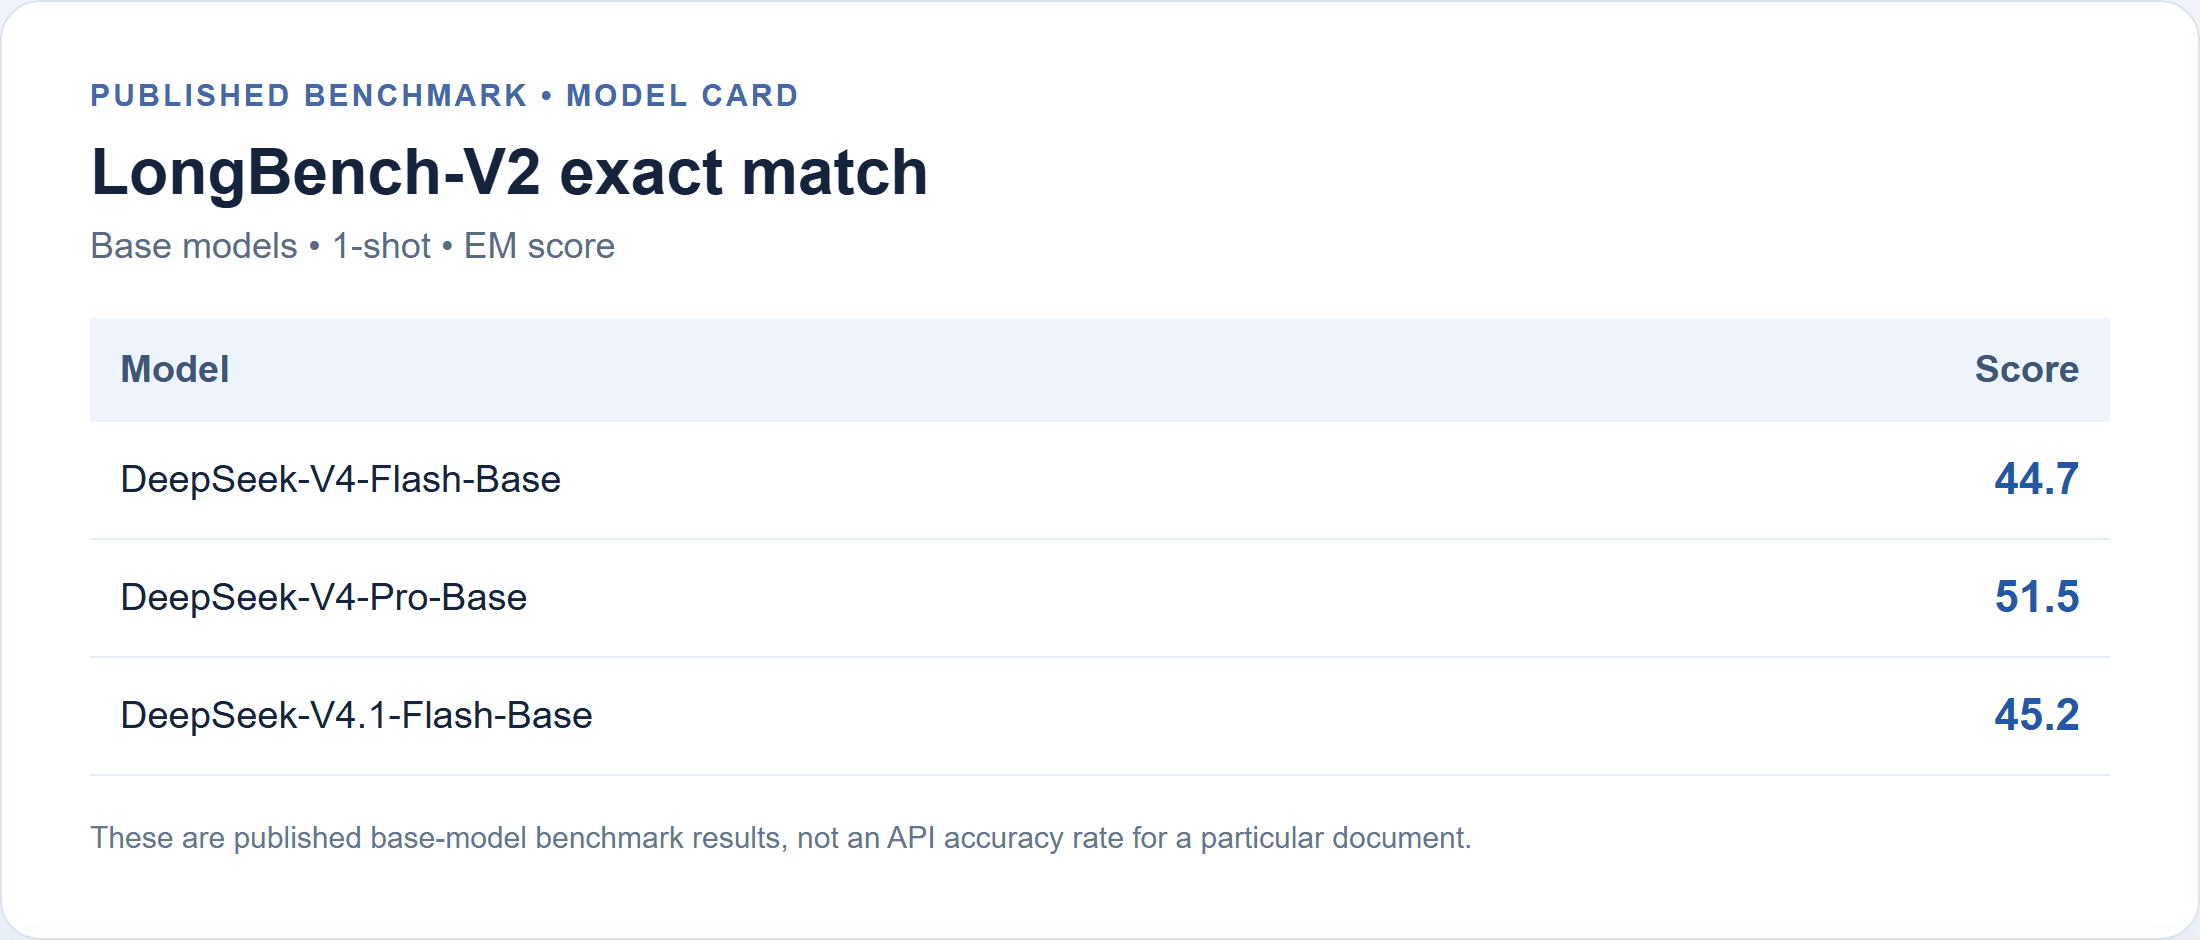
Baris yang diterbitkan adalah hasil model dasar, 1-shot. Itu bukan tingkat kelulusan API yang diukur.
Ada catatan versi. Catatan rilis DeepSeek 17 Oktober menyatakan API dan aplikasi web telah ditingkatkan ke V4.1-Flash-1017, dan nama model API tetap deepseek-flash. Catatan tersebut mencantumkan benchmark agen dan penalaran yang diperbarui, tetapi tidak melaporkan hasil LongBench-V2 baru. Jadi 45,2 tetap menjadi referensi terbitan yang berguna untuk model dasar V4.1 Flash, sementara akurasi build API saat ini pada pertanyaan dokumen panjang masih belum terukur dalam sumber-sumber tersebut. Jangan memindahkan keuntungan benchmark yang tidak terkait ke QA dokumen. (Pembaruan DeepSeek V4.1-Flash-1017)
Cara menjalankan uji akurasi dokumen panjang yang adil
Evaluasi yang berguna memerlukan sumber tetap, kunci jawaban, dan aturan penilaian. Mulailah dengan laporan tahunan atau laporan teknis publik yang versi dan struktur halamannya dapat dibagikan. Simpan PDF dan teks hasil ekstraksi, catat URL sumber dan tanggal pengambilan, dan catat apakah Anda menggunakan ekstraksi teks native atau OCR. Hindari memilih dokumen karena Anda sudah tahu model menanganinya dengan baik.
Sebelum memberi prompt ke model, tulis sendiri kunci jawaban dari sumber. Untuk setiap pertanyaan, catat jawaban yang diharapkan dan halaman atau bagian yang tepat. Ini mencegah respons yang meyakinkan menjadi standar penilaian. Buat pertanyaan cukup spesifik untuk dinilai, sekaligus mempertahankan ambiguitas yang benar-benar akan dihadapi pembaca.
Gunakan dokumen, set pertanyaan, pengenal model, prompt, pengaturan penalaran, dan format output yang sama untuk setiap eksekusi. Jika API mengekspos kontrol temperature atau penalaran, catat itu. Jalankan set lebih dari sekali jika Anda ingin memperkirakan variabilitas; satu eksekusi adalah sampel, bukan tingkat yang stabil. Jangan diam-diam memperbaiki output sebelum menilainya.
Set yang ringkas dapat mencakup lima peluang kegagalan yang berbeda:
| Tugas | Bentuk contoh pertanyaan | Yang perlu diverifikasi |
|---|---|---|
| Pencarian satu titik | “Tanggal berapa yang diberikan laporan untuk kebijakan yang direvisi?” | Nilai persis dan halaman yang dikutip |
| Kaitan lintas bagian | “Bagaimana risiko di Bagian 2 berhubungan dengan kontrol di Bagian 7?” | Kedua bagian dan apakah kaitannya dinyatakan atau disimpulkan |
| Penanganan pengecualian | “Siapa yang dikecualikan dari cakupan yang dinyatakan?” | Catatan kaki, cakupan, dan pembatas |
| Konflik versi | “Nilai mana yang berlaku setelah revisi, dan apa yang digantikannya?” | Tanggal, label versi, dan kedua lokasi |
| Informasi yang hilang | “Periode retensi apa yang ditentukan laporan untuk salinan vendor?” | Pengakuan jika dokumen tidak menyatakan apa pun |
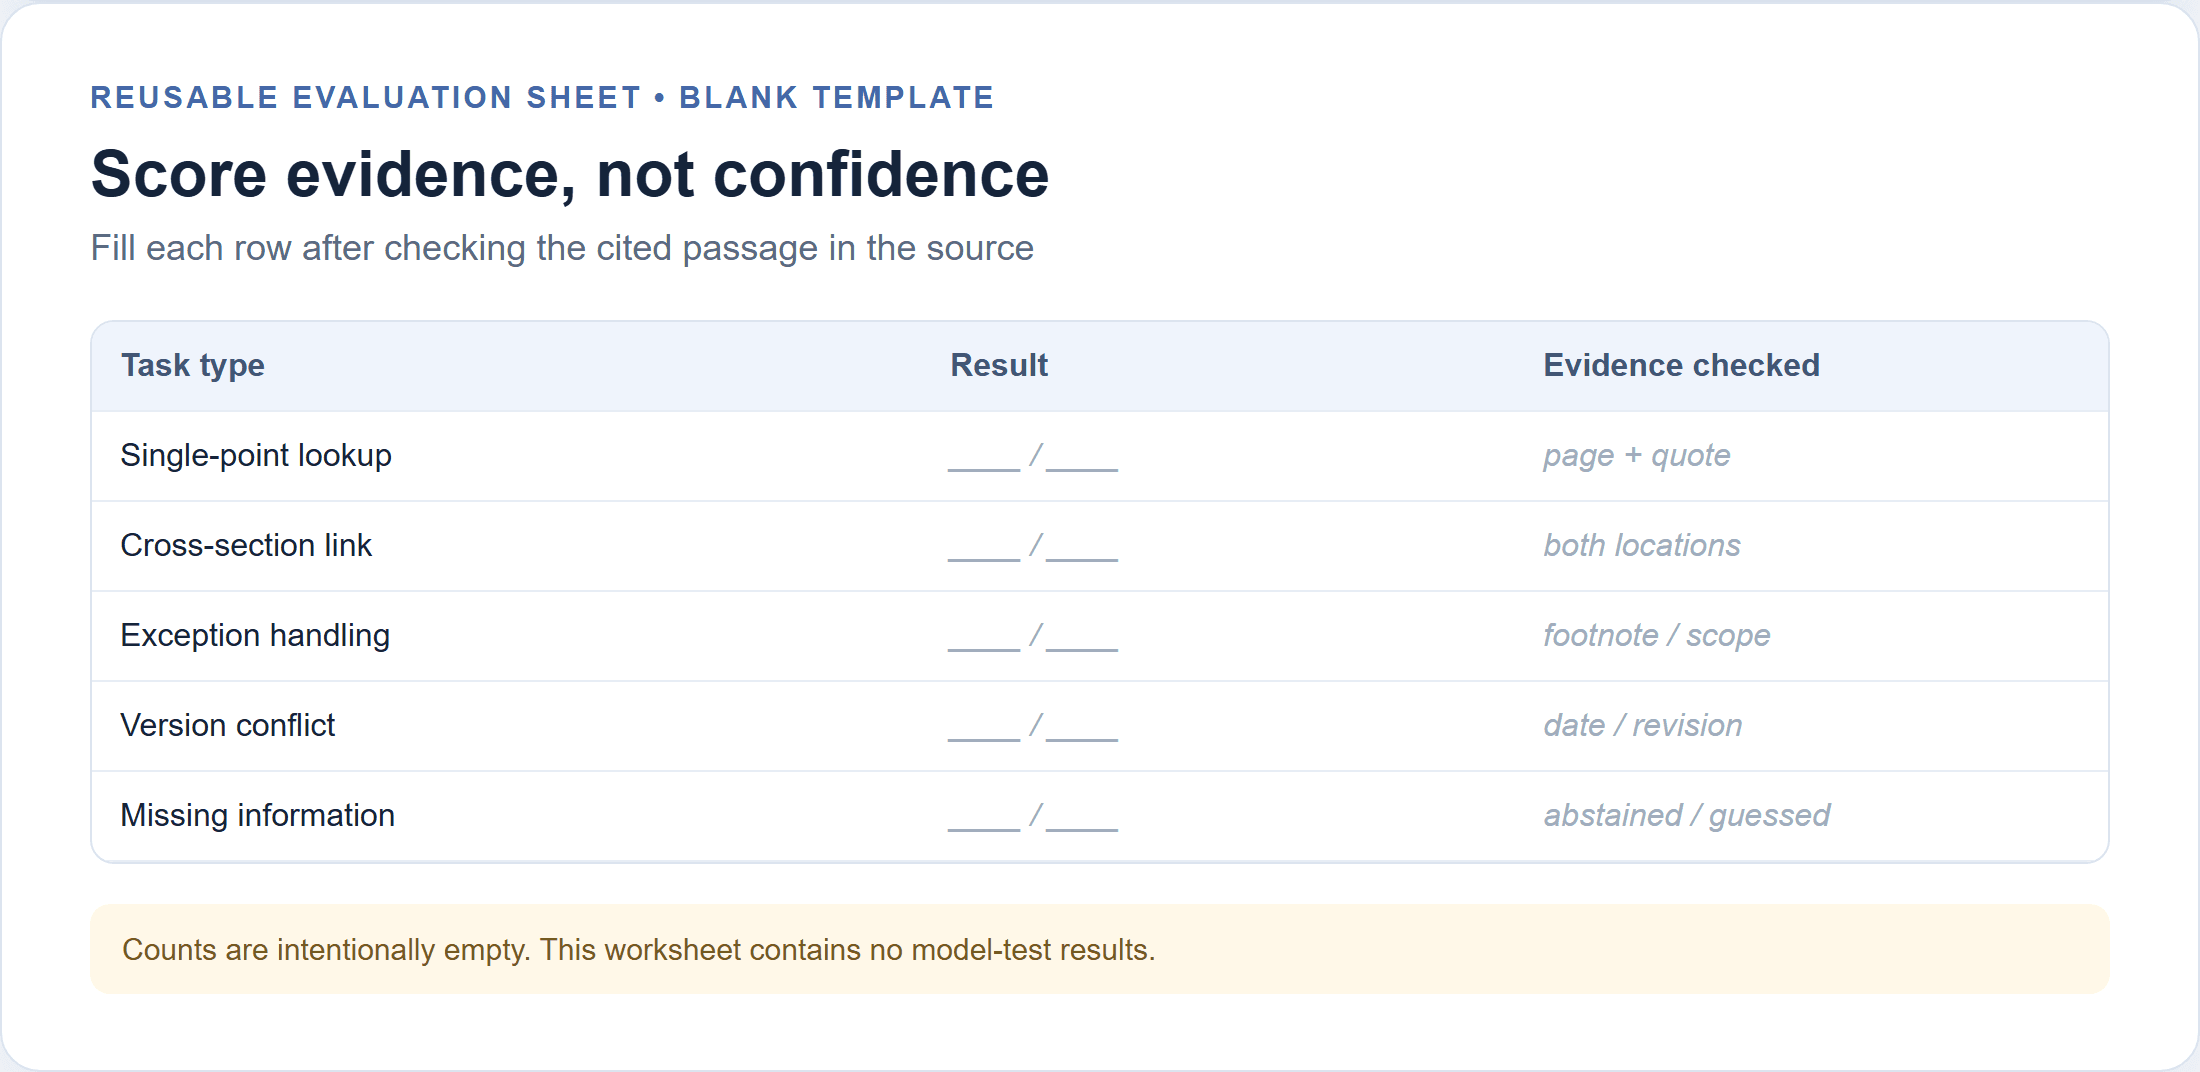
Ini adalah lembar penilaian kosong, bukan tabel hasil. Isi hanya setelah memeriksa setiap jawaban terhadap dokumen sumber.
Nilai setiap jawaban sebagai benar, sebagian, salah, tidak didukung, atau abstain dengan benar. Hitung klaim yang tidak didukung secara terpisah dari jawaban salah karena respons dapat memberikan jawaban utama yang benar dan mengarang detail. Periksa apakah setiap kutipan menunjuk ke bagian yang mendukung klaim. Laporkan jumlah pertanyaan dan jumlah kategori secara bersamaan. Persentase keseluruhan menyembunyikan apakah model melewatkan catatan kaki atau kesulitan hanya ketika informasi tersebar di berbagai bagian.
Pertahankan file sumber yang tepat, hasil ekstraksi, prompt, respons mentah, dan lembar penilaian. Publikasikan hanya materi yang Anda beri izin untuk dibagikan, dan samarkan nama atau detail akun yang bersifat rahasia. Peninjau harus dapat melacak setiap jawaban yang dinilai dari output model hingga halaman di sumber yang disimpan.
Di mana jawaban dokumen panjang cenderung gagal
Tanpa eksekusi build saat ini terhadap dokumen yang dinyatakan, akan keliru untuk mengklaim bahwa V4.1 Flash menunjukkan tingkat kesalahan atau pola kegagalan tertentu. Kategori di bawah ini adalah hal-hal yang perlu diperiksa, bukan temuan terukur tentang model ini.
Mulailah dengan hilangnya cakupan. Paragraf isi dapat menyatakan aturan sementara catatan kaki membatasinya pada wilayah, rentang tanggal, atau kelas pelanggan. Tanyakan pengecualiannya secara eksplisit dan periksa apakah bagian yang dikutip memuatnya. Kutipan dari paragraf utama saja mungkin tidak cukup.
Selanjutnya periksa kebingungan versi. Laporan dapat mengulang nilai serupa di bagian draf dan bagian revisi. Minta model menyebutkan tanggal atau versi yang terkait dengan setiap nilai alih-alih hanya meminta “angka saat ini.” Jika model memilih salah satunya secara diam-diam, nilai respons sebagai tidak lengkap meskipun kebetulan memilih dengan benar.
Pertanyaan lintas bagian memicu inferensi. Model dapat menggabungkan dua fakta akurat menjadi penjelasan kausal yang tidak pernah dibuat dokumen. Minta model melabeli pernyataan langsung secara terpisah dari inferensi. Lalu bandingkan inferensi dengan bukti dan putuskan apakah itu wajar untuk tugas tersebut.
Terakhir, uji abstensi. Sertakan pertanyaan yang jawabannya tidak ada. Tebakan yang percaya diri adalah kegagalan meskipun terdengar masuk akal. Untuk kontrak, kepatuhan, materi klinis, atau analisis keuangan yang berdampak besar, minta orang yang berkualifikasi memeriksa teks asli sebelum menggunakan kesimpulan.
Alur kerja verifikasi untuk jawaban yang lebih aman
Prompt ini membuat jawaban lebih mudah diaudit. Ini tidak dapat menjamin kebenaran atau menggantikan peninjauan sumber. Gunakan dengan ekstraksi yang mempertahankan label halaman, lalu ajukan pertanyaan terfokus alih-alih meminta ringkasan umum dari file yang sangat besar.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Untuk laporan panjang, bagi pekerjaan berdasarkan tugas, bukan otomatis berdasarkan jumlah halaman yang arbitrer. Pertama minta peta sumber: judul bagian, tanggal, istilah yang didefinisikan, dan tabel yang relevan. Lalu kueri topik tertentu dan minta bagian pendukungnya. Untuk kesimpulan lintas bagian, sediakan atau ambil kedua bagian dalam giliran yang sama dan minta model menjelaskan kaitannya sambil menandai inferensi apa pun.
Gunakan loop verifikasi manusia:
- Periksa halaman dan kutipan yang dikutip di file asli.
- Konfirmasi kutipan menyertakan pengecualian di sekitarnya dan header tabel.
- Tandai setiap klaim sebagai langsung, disimpulkan, tidak didukung, atau dibantah.
- Perbaiki prompt atau bagi tugas jika ekstraksi menghilangkan struktur penting.
- Simpan permintaan dan respons mentah agar peninjau dapat mereproduksi keputusan.
Saat Anda menggunakan endpoint hosted, sertakan penggunaan token di log eksekusi. Halaman harga model Atlas Cloud saat ini mencantumkan DeepSeek V4.1 Flash pada $0.30 per 1M token input, $1.20 per 1M token output, dan $0.03 per 1M token cache-read, tanpa diskon yang tercantum. Periksa daftar saat ini sebelum menyusun anggaran. Referensi harga ini untuk Atlas Cloud, bukan harga API DeepSeek yang universal.
Pada tarif yang tercantum tersebut, 100.000 token input tanpa cache dan 3.000 token output berbiaya sekitar $0.033: $0.030 untuk input ditambah $0.0036 untuk output.
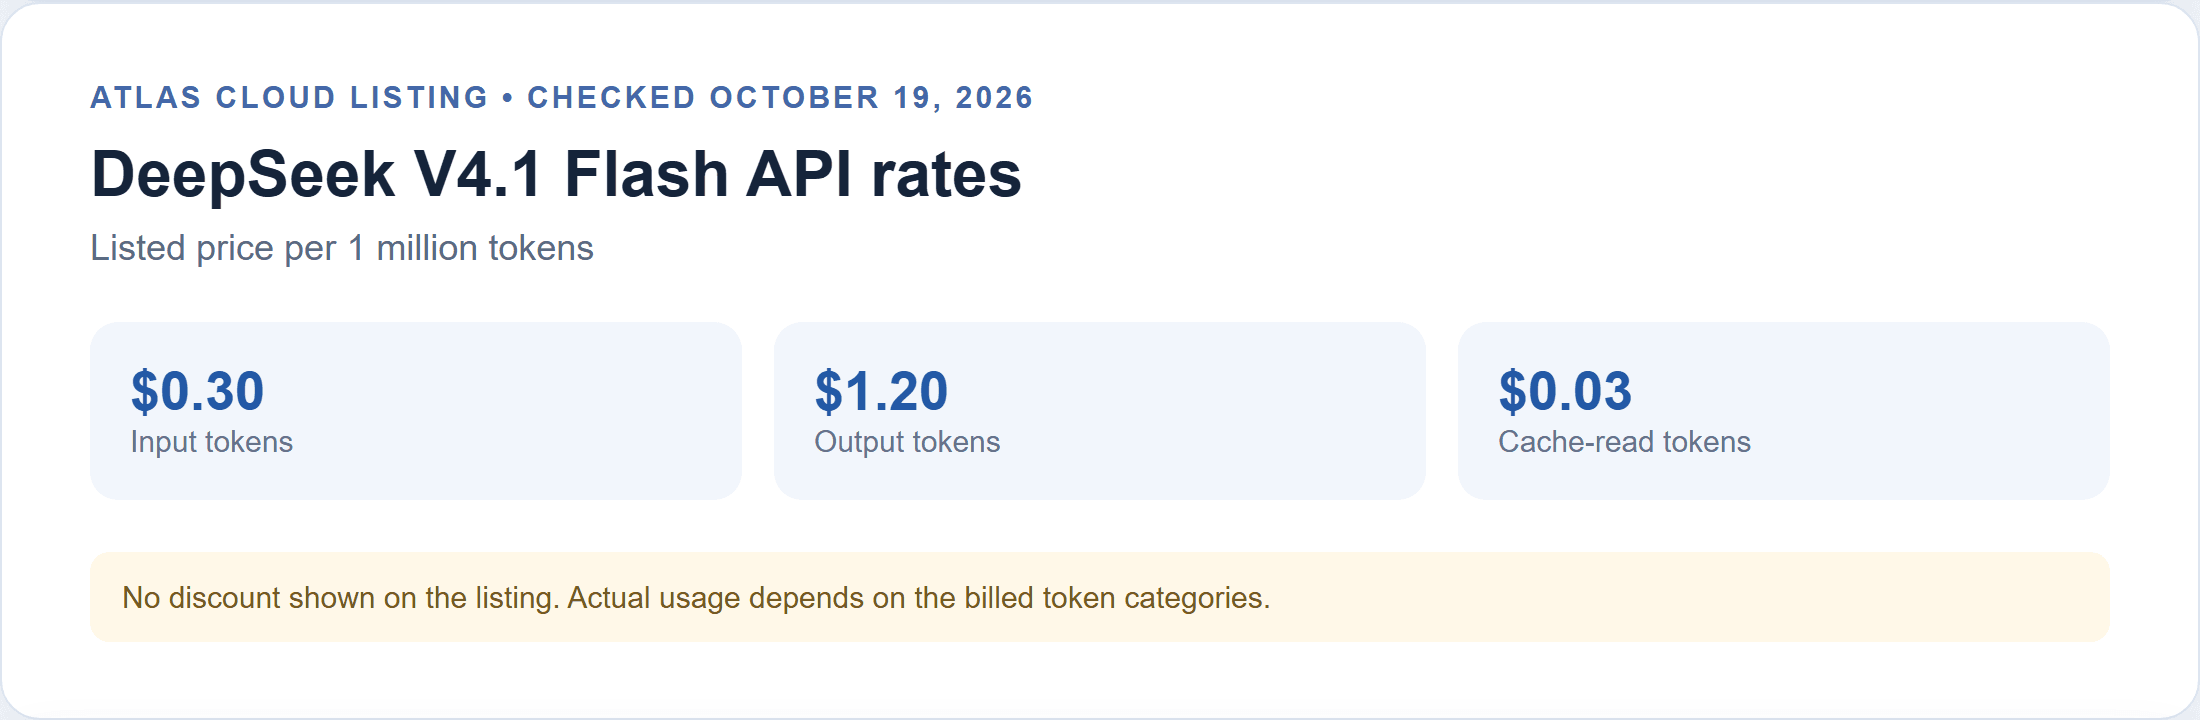
Harga Atlas Cloud diperiksa 19 Oktober 2026; daftar tersebut tidak menunjukkan diskon. Input 1M token dan jawaban 20.000 token akan berbiaya sekitar $0.324 pada tarif yang sama, sebelum perlakuan cache atau item tertagih lainnya. Ini adalah contoh aritmetika, bukan tagihan uji dokumen yang terukur. Input aktual mencakup prompt dan teks hasil ekstraksi; panggilan berulang menambah penggunaan. Gunakan jumlah token yang dikembalikan penyedia alih-alih memperkirakan dari jumlah halaman.
Kapan menggunakan DeepSeek V4.1 Flash untuk dokumen panjang
Flash adalah langkah pertama yang wajar ketika Anda perlu menemukan definisi, mengumpulkan tanggal, membuat peta bagian, atau menyusun draf ringkasan yang akan diperiksa orang. Tugas-tugas tersebut memiliki jejak bukti yang terlihat dan mudah dijalankan ulang dengan pertanyaan yang lebih ketat. Untuk pekerjaan berulang, simpan pertanyaan dengan jawaban yang diketahui dan jalankan ulang saat versi model, pipeline ekstraksi, atau prompt berubah.
Tambahkan kontrol ketika pertanyaan menggabungkan bagian yang berjauhan, bergantung pada catatan kaki, atau membandingkan revisi. Gunakan kutipan sebagai alat bantu navigasi, bukan bukti dengan sendirinya. Jika jawaban akan memengaruhi kewajiban kontrak, posisi kepatuhan, pengungkapan keuangan, atau keputusan berdampak tinggi lainnya, minta peninjau berkualifikasi memverifikasi setiap klaim material di sumber.
Pertanyaan yang berguna adalah apakah model ini, pada versi dokumen dan alur kerja persis Anda, mengembalikan jawaban dengan bukti yang bertahan saat diperiksa. Itulah pengujian yang dapat menetapkan akurasi analisis dokumen panjang DeepSeek V4.1 Flash untuk kasus penggunaan Anda sendiri.
Pertanyaan yang Sering Diajukan
Apakah jendela konteks 1M token berarti model dapat menganalisis dokumen 1M token secara akurat?
Tidak. Itu menjelaskan kapasitas konteks yang didukung. Permintaan aktual juga mencakup instruksi dan anggaran output, sementara ekstraksi, batas antarmuka, dan tingkat kesulitan pertanyaan memengaruhi apakah bukti yang berguna tersedia dan ditafsirkan dengan benar.
Apakah LongBench-V2 sama dengan akurasi tanya jawab dokumen?
Tidak. Ini mencakup beberapa kategori tugas konteks panjang dan melaporkan performa dalam pengaturan tertentu. Ini adalah sinyal perbandingan, bukan jaminan untuk PDF, build API, prompt, atau domain tertentu.
Haruskah saya menggunakan satu prompt atau membagi dokumen panjang menjadi beberapa bagian?
Gunakan peta sumber dan pertanyaan terfokus saat struktur itu penting. Jaga agar bagian yang harus dibandingkan tetap tersedia bersama untuk langkah sintesis, dan pertahankan label halaman agar Anda dapat memverifikasi respons.
Bagaimana saya harus memverifikasi kutipan dari ringkasan yang dihasilkan AI?
Buka setiap halaman yang dikutip di file asli, periksa kutipan dan teks di sekitarnya, dan konfirmasi bagian tersebut mendukung klaim spesifik. Verifikasi header tabel dan catatan kaki serta kalimat yang dikutip.
Bagaimana token input dan output memengaruhi biaya?
Token input mencakup dokumen, instruksi, dan pertanyaan. Token output mencakup jawaban. Prompt yang lebih panjang, panggilan berganda, dan bagian yang diulang meningkatkan penggunaan; gunakan jumlah token yang ditagih dan tabel harga penyedia saat ini untuk perkiraan.


