

Seorang pengembang melihat "1M token" dan bersiap mengirim seluruh repositori, riwayat isu, dan laporan desain yang panjang dalam satu permintaan. Detail penting dalam jendela konteks 1M gemini 4 Argon adalah bahwa 1.048.576 token dibagi bersama oleh input, penalaran, dan output. Ini bukan satu juta token input ditambah satu juta lagi untuk jawaban. Google mencantumkan batas keluaran sinkron default 65.536 token, sementara long decode dapat memperpanjang generasi hingga kapasitas bersama yang tersisa. Spesifikasi model Google menyediakan batasnya; panduan ini mengubahnya menjadi anggaran dan keputusan tentang konteks panjang, retrieval, dan chunking.
Poin-poin utama
- Konteks 1.048.576 token adalah anggaran gabungan input, penalaran, dan output.
- Output sinkron default dibatasi pada 65.536 token; long decode tidak menambah konteks lebih banyak.
- Gunakan konteks panjang saat hubungan di seluruh kumpulan sumber yang diketahui penting; gunakan retrieval atau chunking saat tidak.
Apa Arti Jendela Konteks 1M Gemini 4 Argon?
Anggaran 1.048.576 token dibagi bersama
Jendela konteks adalah batas token yang tersedia untuk suatu permintaan. Untuk Argon, Google mendokumentasikan total terpadu 1.048.576. Prompt, materi sumber yang dilampirkan, token penalaran, dan jawaban yang dihasilkan mengambil dari alokasi ini. Ini menggambarkan kapasitas, bukan janji bahwa setiap detail akan sama mudahnya untuk diambil atau dinalar.
Jika suatu permintaan berisi 900.000 token sumber, paling banyak 148.576 tersisa untuk penalaran dan output, sebelum pembatasan khusus antarmuka. Aplikasi yang mengasumsikan kemudian dapat meminta jawaban 200.000 token telah mengalokasikan lebih dari anggaran yang sama.
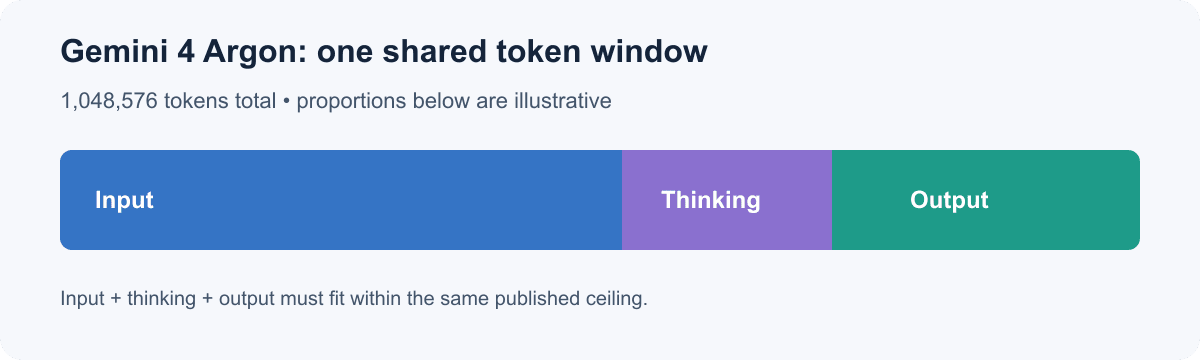
Jendela yang dipublikasikan adalah satu batas atas bersama. Ukuran segmen bersifat konseptual, bukan alokasi tetap.
Input, penalaran, dan output mengambil dari satu jendela
Persamaan perencanaan yang berguna adalah:
input tokens + thinking tokens + output tokens <= 1,048,576
Ini adalah pemeriksaan anggaran, bukan klaim bahwa pengembang dapat menetapkan jumlah token penalaran yang tepat untuk setiap panggilan. Google mencantumkan pengaturan penalaran rendah, sedang, dan tinggi; konsumsi internal dapat bervariasi menurut tugas dan pengaturan. Sisakan ruang untuk penalaran alih-alih memperlakukan sisa teoretis sebagai kapasitas jawaban yang dijamin.
Argon menerima input teks, gambar, video, audio, dan PDF, dengan output teks. Penghitungan media tidak setara dengan teks biasa, jadi jumlah file atau jumlah halaman tidak dapat memprediksi total token secara andal. Periksa metadata penggunaan dari permintaan yang representatif.
Jendela Konteks vs. Batas Output: Perbedaan Krusial
Batas output default
Halaman model mencantumkan output maksimum 65.536 token untuk generasi sinkron default, sekitar seperenam belas dari total jendela. Suatu permintaan dapat masuk dalam batas konteks keseluruhan dan tetap melebihi batas output yang aktif.
Untuk banyak aplikasi, default tersebut sudah memadai. Tinjauan repositori atau sintesis dokumen biasanya membutuhkan jawaban yang terfokus, bukan jawaban sepanjang kumpulan sumbernya. Output yang dibatasi lebih mudah ditinjau, disimpan, dan diteruskan ke langkah lain.
Apa yang diubah long decode
Long decode mendukung generasi yang jauh lebih panjang, hingga 1.048.576 token menurut spesifikasi model. Ini tidak memperluas total jendela. Jika prompt sudah menempati sebagian besarnya, kapasitas yang tersisa untuk penalaran dan output lebih sedikit. Jalur API, SDK, pengaturan permintaan, dan penanganan respons juga penting, jadi periksa panduan integrasi terkini sebelum mengandalkan respons panjang di produksi.
Gunakan long decode hanya ketika hasil yang diperlukan benar-benar membutuhkan materi yang dihasilkan secara ekstensif, seperti transformasi terstruktur besar yang dikembalikan dalam satu operasi. Jika jawaban dapat dipecah menjadi bagian-bagian yang tervalidasi, generasi bertahap dapat membuat hasil yang tidak lengkap lebih mudah dideteksi dan dipulihkan.
Cara Menganggarkan Token Input, Penalaran, dan Output
Mulailah dari hasil yang diperlukan, lalu perkirakan token sumber menggunakan jalur penghitungan model yang dipilih jika tersedia. Hitung juga instruksi, hasil alat, teks skema, dan riwayat percakapan. Sisakan margin untuk penalaran dan kesalahan estimasi alih-alih menghabiskan sisa teoretis.
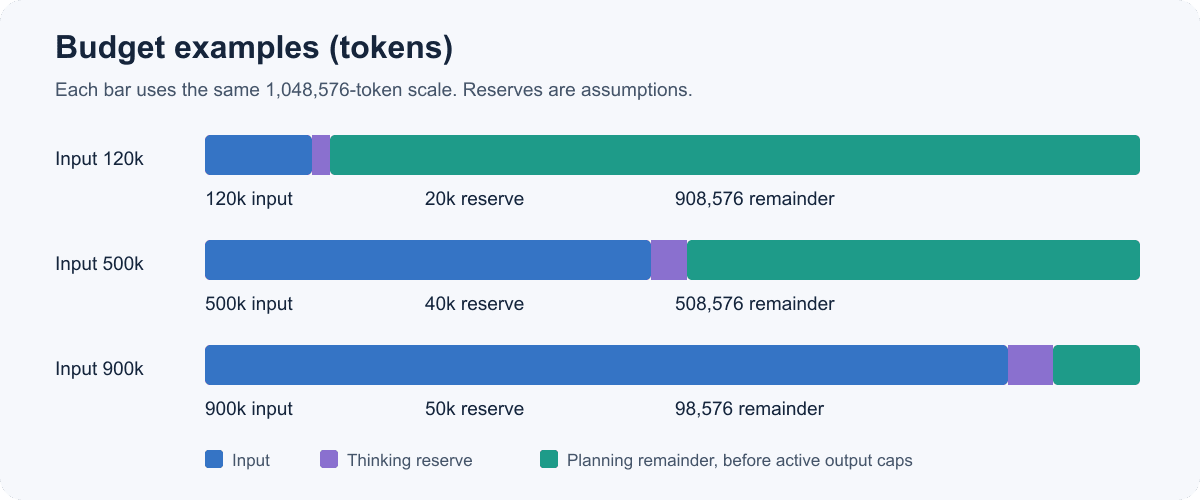
Angka-angka di bawah ini adalah contoh aritmetika, bukan konsumsi penalaran yang tetap. "Sisa perencanaan" adalah total setelah input yang diasumsikan dan cadangan penalaran yang disisihkan. Batas layanan yang sebenarnya tetap berlaku.
| Input yang diasumsikan | Cadangan penalaran | Sisa perencanaan untuk output | Contoh |
|---|---|---|---|
| 120.000 | 20.000 | 908.576 | Beberapa manual, sintesis ringkas |
| 500.000 | 40.000 | 508.576 | Tinjauan basis kode dengan referensi file |
| 900.000 | 50.000 | 98.576 | Perbandingan arsip dengan jawaban yang dibatasi |
Aritmetika ilustratif dari batas 1.048.576 token; cadangan adalah asumsi perencanaan.
Gunakan daftar periksa perencanaan permintaan ini:
- Input: perkiraan token sumber dan prompt.
- Penalaran: sisihkan kapasitas berdasarkan kompleksitas tugas dan pengaturan yang didukung.
- Output: pilih batas yang sesuai dengan hasil yang diperlukan.
- Periksa: jumlahkan ketiga angka dan sisakan ruang untuk kesalahan estimasi.
- Jalur: pastikan endpoint atau SDK yang dipilih mendukung panjang output dan perilaku kelanjutan.
Untuk tinjauan basis kode 500.000 token, tim mungkin menyisihkan 40.000 token untuk penalaran dan menargetkan jawaban 25.000 token. Rencana itu menggunakan 565.000 token di atas kertas dan menyisakan ruang untuk estimasi yang tidak sempurna atau instruksi tambahan. Tim tetap harus memverifikasi penggunaan aktual dan batas generasi yang dikonfigurasi. Cadangan adalah alat perencanaan, bukan prediksi penalaran privat.
Sebelum menjalankan batch, sampel lebih dari satu jenis permintaan. Halaman dokumentasi singkat, modul yang banyak kode, dan PDF dengan tabel dapat menghasilkan jumlah token berbeda meskipun ukuran filenya terlihat mirip. Hitung input yang representatif, lalu bandingkan estimasi dengan penggunaan yang dikembalikan oleh API. Jika pelaporan penalaran atau output aktual model berbeda dari asumsi Anda, perbarui cadangan dan batas sebelum menambah ukuran batch. Langkah kalibrasi kecil ini membantu menjaga alur kerja konteks panjang tetap berada dalam batas token dan anggarannya.
Apa yang Dapat Anda Muat dalam Satu Juta Token?
Dokumen, kode, dan materi multimodal
Satu juta token dapat membuat analisis sekali jalan masuk akal untuk sekumpulan manual, beberapa kontrak, pohon sumber yang besar, atau transkrip panjang dengan catatan. Google telah menggunakan ilustrasi kasar seperti sekitar 1.500 halaman teks atau 30.000 baris kode. Anggap ini sebagai contoh skala, bukan jaminan. Tata letak, kepadatan kode, bahasa, pemformatan, dan tokenisasi semuanya memengaruhi jumlahnya.
Untuk pekerjaan repositori, sertakan file build, kode yang dihasilkan, komentar, metadata dependensi, pengujian, dan konteks isu terkait dalam estimasi Anda. Lalu tanyakan apakah tugasnya membutuhkan semuanya. Tinjauan arsitektur lintas modul mungkin mendapat manfaat dari kumpulan sumber yang luas; pertanyaan tentang satu pesan error mungkin tidak.
Input multimodal juga mempersulit estimasi. Durasi video, pengambilan sampel frame, audio, resolusi, dan perlakuan API dapat memengaruhi penggunaan dan bukti yang dilihat model. Untuk pertanyaan sempit, sertakan hanya media yang relevan dan periksa penggunaan dari permintaan yang representatif sebelum meningkatkan skala.
Jumlah token bukan jumlah halaman
Token adalah unit pemrosesan model, bukan kata, karakter, halaman, atau baris. Pengidentifikasi, tabel, kode sumber, dan tulisan non-Inggris dapat ditokenisasi secara berbeda dari prosa biasa. Perkiraan halaman tidak dapat memberi tahu apakah kumpulan khusus Anda muat.
Kapasitas juga berbeda dari kualitas. Memuat kumpulan sumber tidak membuktikan model akan menemukan setiap pengecualian yang terkubur, mempertahankan setiap dependensi, atau menyelesaikan bagian yang bertentangan dengan benar. Spesifikasi menetapkan batas, bukan ingatan menyeluruh atau skor akurasi khusus tugas. Untuk kesimpulan yang berkonsekuensi, minta lokasi sumber dan validasi klaim penting terhadap sumber aslinya.
Kapan Jendela 1M Membantu, dan Kapan Tidak
Konteks panjang paling berguna ketika jawaban bergantung pada hubungan yang tersebar di seluruh materi yang mungkin tidak dapat diambil oleh kueri sederhana. Ini kurang menarik untuk pertanyaan sempit yang berulang pada korpus yang berubah, di mana retrieval dapat memilih kumpulan bukti yang lebih kecil. Ini adalah tradeoff alur kerja, bukan peringkat akurasi universal.
| Pendekatan | Pertimbangkan saat | Trade-off |
|---|---|---|
| Permintaan konteks panjang | Analisis sekali pakai membutuhkan hubungan di seluruh kumpulan sumber yang diketahui | Input besar dapat menaikkan biaya dan latensi; verifikasi cakupan |
| Retrieval | Pengguna mengajukan pertanyaan berulang di seluruh korpus yang berubah | Pengindeksan dan retrieval menentukan bukti mana yang mencapai model |
| Chunking | Dokumen dapat diproses sebagai unit atau tahap independen | Hubungan lintas chunk perlu direkonsiliasi |
| Hibrida | Anda memerlukan orientasi luas yang diikuti pemeriksaan bukti yang terfokus | Lebih banyak orkestrasi dan penanganan status |
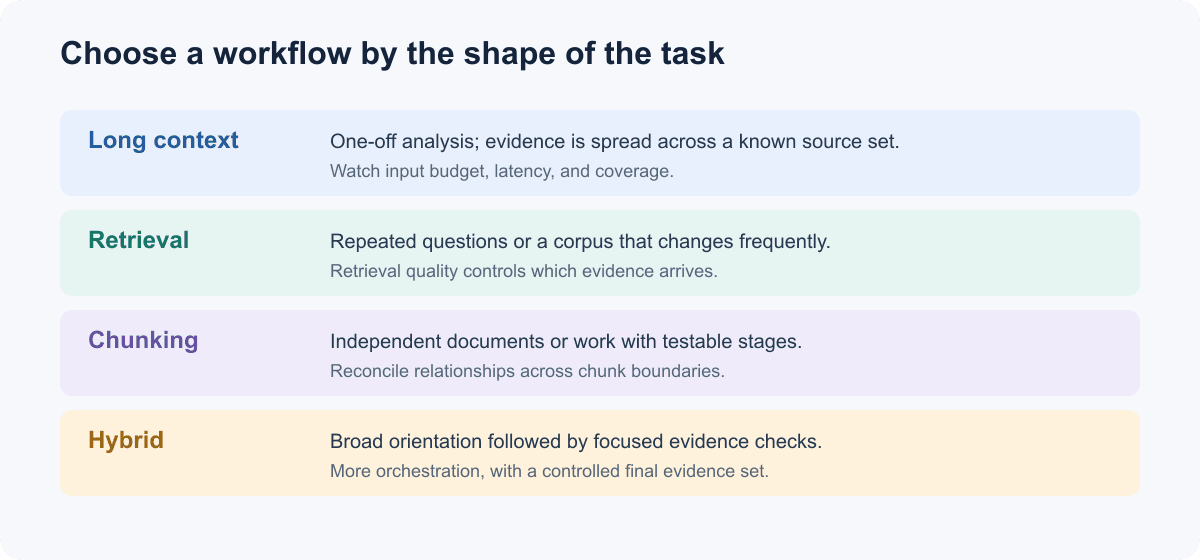 Pilih berdasarkan bentuk tugas dan pola kueri, lalu validasi pada input yang representatif.
Pertimbangkan konteks panjang untuk membandingkan kebijakan yang klausulnya saling memengaruhi, meninjau perubahan di banyak modul perangkat lunak, atau menyintesis dokumen di mana suatu detail dalam satu sumber mengubah interpretasi sumber lain. Retrieval cocok untuk pertanyaan dukungan yang berulang terhadap basis pengetahuan yang berkembang. Chunking berfungsi saat unit sumber independen atau setiap tahap memiliki output yang dapat diuji. Alur kerja hibrida dapat memetakan kumpulan terlebih dahulu, lalu mengambil dan memverifikasi bagian untuk jawaban akhir.
Evaluasi opsi terhadap pertanyaan representatif yang sama. Lacak apakah bukti yang diperlukan disertakan, apakah kutipan menunjuk ke bagian yang benar, penggunaan token, waktu respons, dan upaya pemulihan setelah jawaban yang tidak lengkap. Itu memberi tim Anda bukti untuk beban kerjanya alih-alih mengasumsikan jendela yang lebih besar otomatis meningkatkannya.
Menggunakan Gemini 4 Argon untuk Tugas Konteks Panjang
Pastikan ID model dan jalur permintaan
Google mencantumkan ID model Gemini API sebagai `gemini-4-argon`. Pastikan bahwa model diaktifkan untuk akun Anda dan bahwa surface API yang tepat mendukung fitur yang Anda butuhkan. Nama model yang sama tidak menjamin setiap proxy, SDK, konsol, atau klien mengekspos batas atau perilaku long-decode yang identik.
Sebelum produksi, verifikasi:
- ID model dan ketersediaan untuk akun atau wilayah Anda.
- Batas output sinkron dan bagaimana long decode diminta atau dikembalikan.
- Apakah SDK menangani kelanjutan, dan bagaimana SDK melaporkan respons parsial atau gagal.
- Pengaturan penalaran, alat, caching, dan modalitas yang didukung untuk API yang dipilih.
- Bidang penggunaan input dan output aktual dari permintaan.
Panduan konteks panjang Google menjelaskan anggaran terpadu. Panduan SDK dan API-nya dapat berubah, jadi sematkan versi SDK yang didukung, periksa contoh terkini, dan uji integrasi transport serta penanganan respons yang sama seperti yang direncanakan untuk produksi. Jangan menyalin nama parameter dari integrasi model lama tanpa memeriksa bahwa parameter tersebut masih berlaku.
Buat kontrak output lebih kecil daripada kumpulan sumber
Berikan model tugas dan bentuk respons yang dibatasi. Untuk audit repositori, minta temuan yang dikelompokkan berdasarkan tingkat keparahan dengan jalur file dan referensi baris, dan nyatakan apakah akan menyertakan hipotesis atau hanya cacat yang terkonfirmasi. Untuk perbandingan kontrak, sebutkan klausulnya dan minta pengidentifikasi bagian atau kutipan pendukung singkat. Ini lebih mudah ditinjau daripada "analisis semuanya." Untuk respons besar, rencanakan kelanjutan dan penyelesaian parsial. Pertahankan pengidentifikasi dan potongan respons saat SDK mengeksposnya, validasi output terstruktur sebelum penggunaan di hilir, dan coba ulang hanya bagian yang gagal jika memungkinkan. Ini adalah pengaman untuk diterapkan dan diverifikasi, bukan klaim bahwa setiap SDK menangani interupsi dengan cara yang identik.
Harga dan Akses: Apa yang Harus Diverifikasi Sebelum Menjalankan
Pengumuman Google saat ini mencantumkan tarif pengenalan sebesar $2 per juta token input dan $10 per juta token output hingga 30 November 2026, diikuti tarif yang dinyatakan sebesar $4 dan $20 per juta. Ini sensitif terhadap waktu: periksa ulang pengumuman resmi Gemini 4 Argon sebelum memublikasikan atau memperkirakan pengeluaran. Estimasi input dan output secara terpisah karena beban kerja yang berat prompt dan berat generasi memiliki profil biaya yang berbeda.
Ketersediaan Argon melalui Atlas Cloud tidak dikonfirmasi di halaman direktori yang diperiksa untuk artikel ini. Katalog model Gemini Atlas menunjukkan model Gemini dan detail akses yang saat ini terdaftar di sana; ini tidak membuktikan bahwa Argon tersedia. Konfirmasi halaman detail, protokol, dan harga khusus model sebelum merutekan permintaan atau membandingkan biaya.
Mulailah dengan permintaan yang representatif dan catat versi model dan SDK, penggunaan token, latensi, error, dan pemeriksaan kualitas khusus tugas. Tinjau kembali anggaran dan pilihan retrieval saat kumpulan sumber atau pola kueri berubah. Jendela konteks 1M Gemini 4 Argon berguna ketika luasnya memecahkan masalah lintas sumber yang nyata dan permintaan Anda memiliki anggaran yang jelas serta rencana verifikasi.
Pertanyaan yang Sering Diajukan
Apakah jendela 1M Gemini 4 Argon dibagi oleh input dan output?
Ya. Google mendefinisikan satu jendela 1.048.576 token yang dibagi bersama oleh input, penalaran, dan output. Jumlah yang tersisa untuk jawaban bergantung pada permintaan dan batas antarmuka yang berlaku.
Berapa batas output default Gemini 4 Argon?
Spesifikasi mencantumkan 65.536 token untuk output sinkron default. Long decode dapat mendukung generasi yang lebih besar, bergantung pada kapasitas bersama yang tersisa dan jalur API.
Dapatkah Gemini 4 Argon menghasilkan 1M token dalam satu respons?
Halaman model mencantumkan long decode hingga 1.048.576 token output, tetapi ini adalah kemampuan maksimum, bukan jaminan bahwa permintaan yang berisi input juga dapat mengembalikan satu juta token. Input dan penalaran menempati total jendela yang sama.
Apakah jendela konteks 1M berarti setiap detail akan diingat secara akurat?
Tidak. Ini menggambarkan anggaran token maksimum, bukan retrieval atau penalaran yang sempurna. Wajibkan referensi bukti dan uji kasus tepi yang diketahui dari materi Anda sendiri.
Apakah Gemini 4 Argon saat ini tersedia melalui Atlas Cloud?
Saya tidak dapat mengonfirmasi daftar model atau halaman detail khusus Argon di katalog Atlas Cloud yang diperiksa untuk artikel ini. Periksa direktori saat ini sebelum mengasumsikan dukungan; tautan katalog Gemini di atas saja tidak membuktikan ketersediaan Argon.


