

Unggahan video bisa berisi jawaban yang Anda butuhkan tetapi tetap salah dibaca. Gemini 4 Argon dapat menerima teks, gambar, video, audio, dan PDF sebagai input, lalu mengembalikan teks yang menganalisis atau menghubungkan detail di dalamnya. Kemampuan multimodal gemini 4 Argon paling berguna ketika tugas Anda adalah memeriksa materi yang sudah ada, bukan membuat media baru. Batas konteks terpadunya adalah 1.048.576 token, tetapi itu adalah batas kapasitas, bukan jaminan akurasi. Berikut adalah panduan tugas per tugas tentang apa yang dapat dianalisisnya, cara memverifikasi jawaban, dan di mana API saat ini serta Atlas Cloud cocok.
Poin penting
- Argon menerima input teks, gambar, video, audio, dan PDF; output yang didokumentasikan adalah teks.
- Konteks 1.048.576 token dibagi antara input dan output. Output sinkron default dibatasi pada 65.536 token.
- Pembuatan gambar, pembuatan audio, dan Live API tidak didukung oleh model Argon.
- Verifikasi klaim terhadap nomor halaman, stempel waktu, atau bukti yang terlihat sebelum menggunakannya dalam alur kerja.
Apa arti “multimodal” bagi Gemini 4 Argon
Untuk Gemini API, multimodal berarti Argon dapat menerima berbagai jenis materi sumber dalam satu permintaan dan bernalar atas materi tersebut bersama instruksi teks. Halaman model Gemini API saat ini mencantumkan input teks, gambar, video, audio, dan PDF, dengan teks sebagai output. Halaman itu juga mencantumkan output terstruktur, pemanggilan fungsi, eksekusi kode, pencarian file, dan grounding pencarian di antara kemampuan yang didukung. Alat-alat tersebut dapat membentuk alur kerja, tetapi tidak mengubah modalitas output menjadi gambar, trek audio, atau aliran percakapan langsung. (Google AI for Developers, Oktober 2026)
Angka token perlu dibaca dengan cermat. Google mencantumkan jendela konteks terpadu sebesar 1.048.576 token untuk input dan output gabungan. Permintaan sinkron normal memiliki output maksimum 65.536 token; long decode dapat mencapai hingga 1.048.576 dalam alur kelanjutan latar belakang yang didokumentasikan. Jika prompt dan konten terlampir Anda menghabiskan sebagian besar jendela bersama, ruang tersisa untuk penalaran dan teks jawaban menjadi lebih sedikit. Judul “konteks 1M” tidak berarti setiap permintaan satu juta token muat dalam satu respons biasa.
| Materi yang Anda berikan | Input yang didokumentasikan? | Output Argon | Tugas pertama yang berguna | Bukti yang harus diperiksa |
|---|---|---|---|---|
| Teks dan PDF | Ya | Teks | Ringkas laporan atau bandingkan klaim antar bagian | Halaman, judul, baris tabel, atau kutipan |
| Gambar | Ya | Teks | Baca bagan, identifikasi objek, atau bandingkan dua gambar | Label, nilai, lokasi, dan potongan gambar |
| Video | Ya | Teks | Jelaskan urutan peristiwa atau temukan momen dalam klip | Stempel waktu dan bingkai sebenarnya |
| Audio | Ya | Teks | Jawab pertanyaan tentang rekaman yang diunggah | Segmen audio, transkrip, pembicara, atau suara |
| Media yang dihasilkan | Tidak ada pembuatan gambar/audio yang dicantumkan | Teks | Kembalikan analisis tertulis atau hasil terstruktur | Skema dan dukungan sumber |
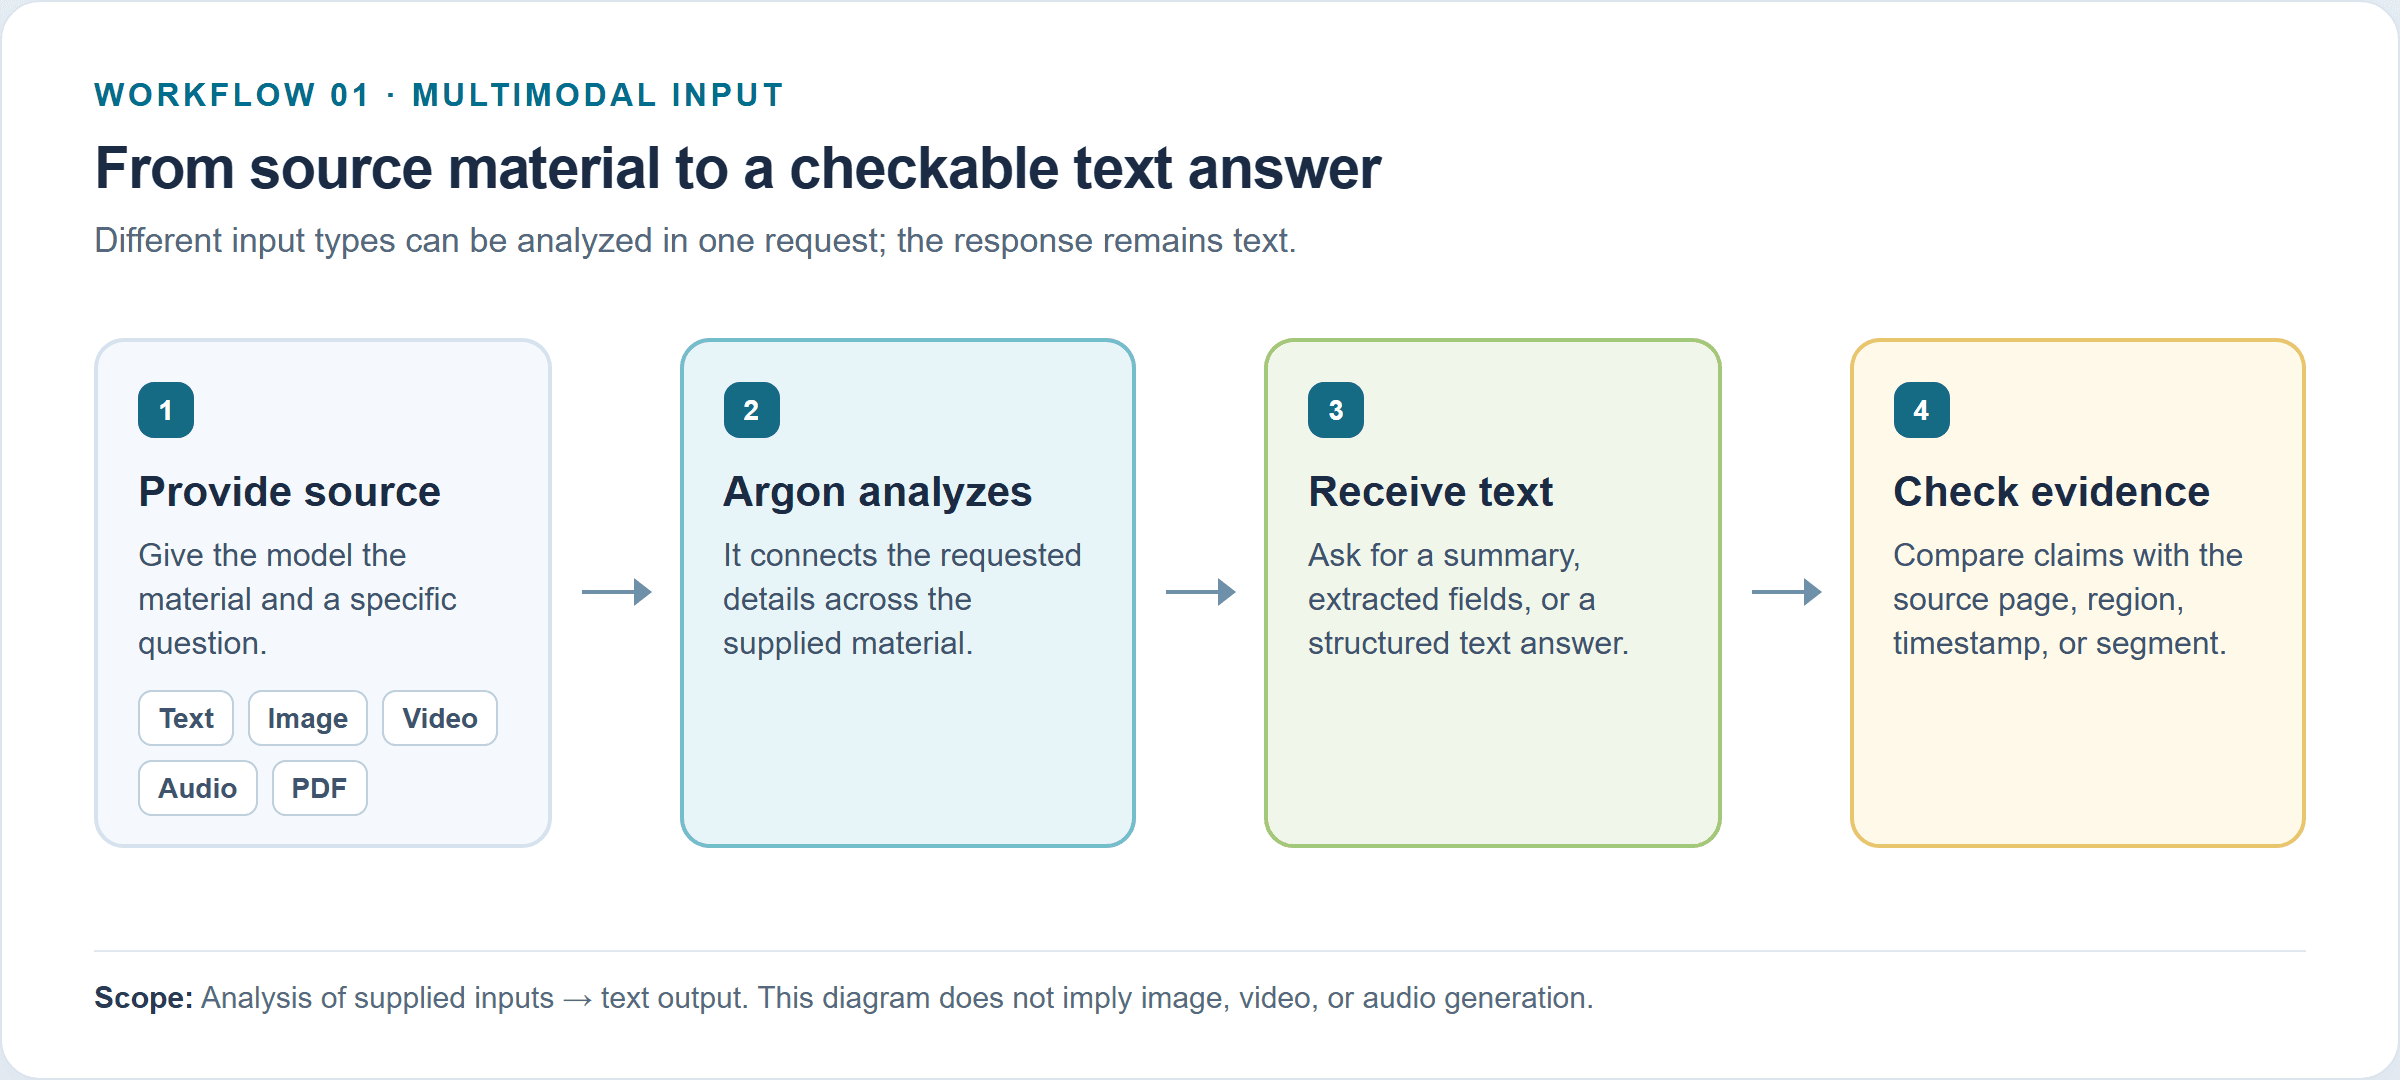 Ilustrasi alur kerja: teks, gambar, video, audio, atau PDF yang diberikan dianalisis menjadi jawaban teks, lalu diperiksa terhadap bukti sumber.
Aplikasi Gemini mungkin menawarkan fitur yang menyusun atau membuat media melalui model dan alat lain. Jangan menganggap fitur tingkat aplikasi tersebut sebagai kemampuan model API gemini-4-argon itu sendiri. Untuk keputusan implementasi, gunakan tabel kemampuan API dan ID model yang tepat, bukan label keluarga produk.
Apa yang dapat dianalisis Gemini 4 Argon dalam gambar, video, audio, dan PDF
Cara terbaik untuk memutuskan apakah Argon cocok adalah dengan menyebutkan bukti yang dibutuhkan tugas Anda. “Memahami video” terlalu luas. “Temukan setiap kali operator menempatkan komponen di baki, lalu sebutkan stempel waktunya” dapat diuji.
Gambar: periksa, bandingkan, dan ekstrak informasi visual
Permintaan gambar dapat meminta Argon mendeskripsikan pemandangan, membandingkan dua gambar yang diberikan, mengekstrak teks yang terlihat, menafsirkan bagan, atau mengembalikan temuan visual dalam format terstruktur. Ini adalah tugas analisis: outputnya berupa teks atau teks terstruktur. Ini dapat membantu tim dukungan menyortir foto produk, peneliti memindai gambar, atau operator mengekstrak label dari kumpulan gambar.
Pengujian independen menawarkan pemeriksaan realitas yang berguna, asalkan Anda memperlakukannya sebagai satu pengaturan tolok ukur, bukan ramalan untuk gambar Anda sendiri. Vision Evals Roboflow Oktober 2026 melaporkan Argon termasuk model teratas dalam tugas deteksi objek, OCR, dan penalaran visual yang diuji. Evaluasi OCR-nya memisahkan transkripsi persis dan subtugas terkait, dan artikelnya melaporkan titik lemah seperti teks kecil atau buram serta pembacaan visual yang lebih sulit. Pengaturan, gambar yang dipilih, prompt, dan penilaiannya mendefinisikan hasil tersebut; semua itu tidak menetapkan tingkat keberhasilan umum untuk setiap pemindaian atau bagan. (Roboflow, Oktober 2026)
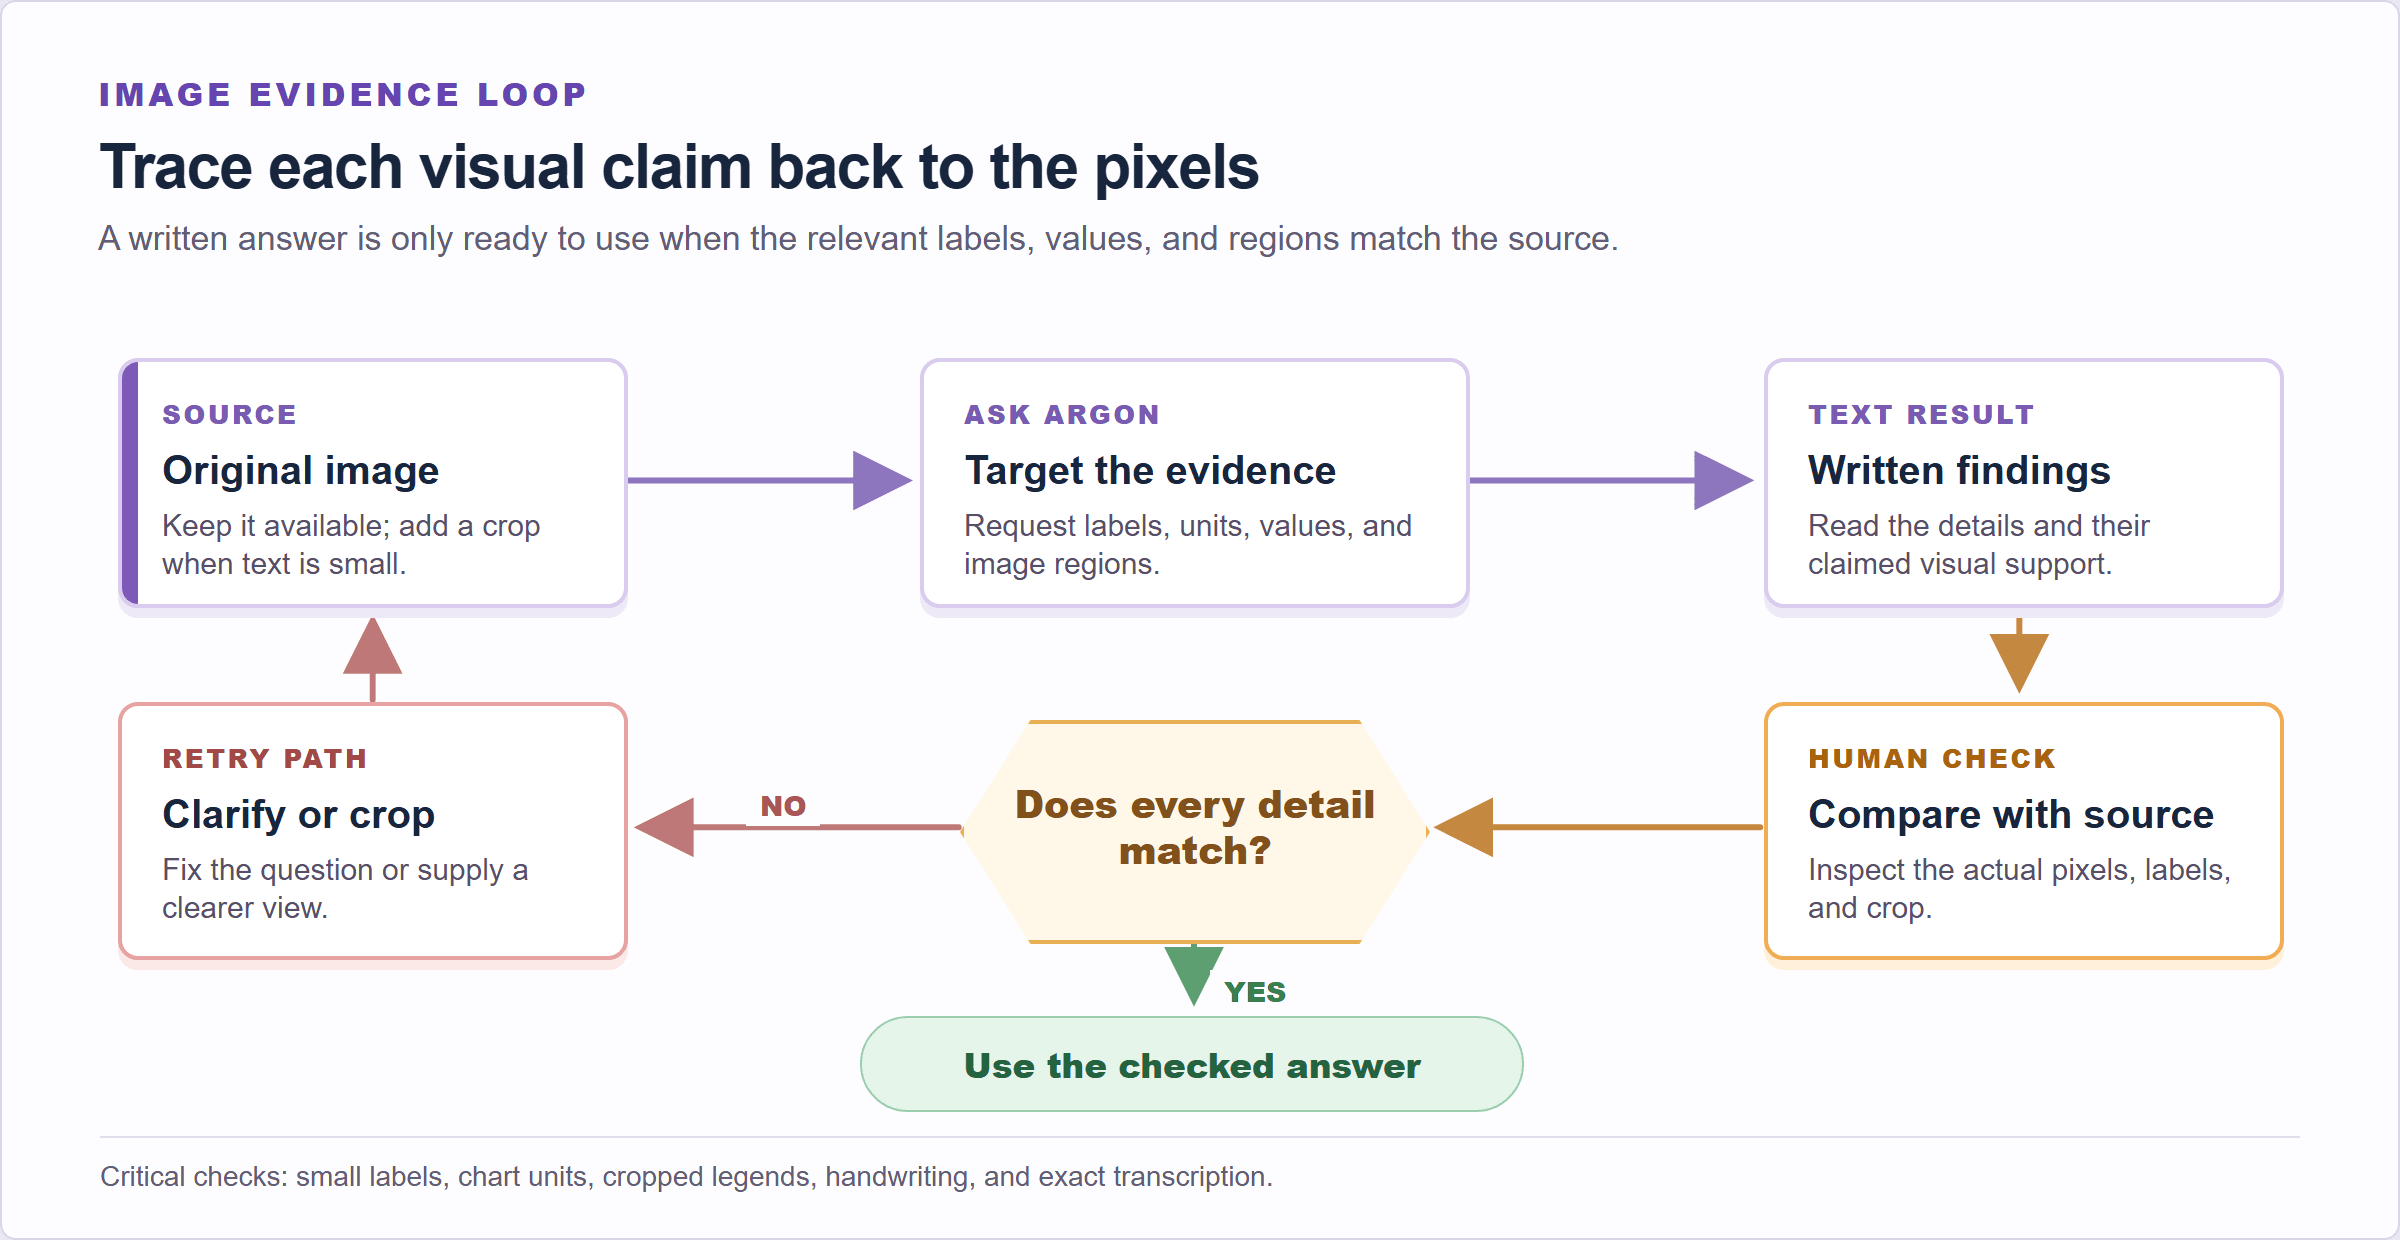 Ilustrasi alur kerja: minta detail gambar dan wilayah pendukungnya, lalu verifikasi setiap klaim terhadap gambar asli.
Untuk bagan, minta judul, sumbu, satuan, nilai yang relevan, dan wilayah gambar yang mendukung setiap nilai. Lalu bandingkan detail tersebut dengan sumbernya. Label kecil, tangkapan layar resolusi rendah, tulisan tangan, tanda yang tumpang tindih, atau legenda yang terpotong perlu ditinjau secara manual. Jika transkripsi persis penting, sertakan potongan yang jelas dan simpan aslinya agar peninjau dapat memeriksa setiap karakter.
Video: bernalar tentang peristiwa sepanjang waktu
Video menambahkan urutan dan waktu. Argon dapat menjawab pertanyaan tentang tindakan, perubahan, dan peristiwa di seluruh bingkai. API mendukung pemahaman video agentic, opsi yang dapat memeriksa linimasa secara dinamis; mode default yang didokumentasikan adalah statis. Periksa panduan video dan pengaturan permintaan untuk mode yang benar-benar digunakan integrasi Anda.
Pertanyaan produksi yang berguna mungkin: “Pada waktu berapa teknisi melepas filter, dan apa yang terjadi tepat sebelum dan sesudahnya?” Wajibkan stempel waktu, lalu periksa momen tersebut. Deskripsi yang fasih tanpa bukti yang selaras waktu tidak cukup untuk tinjauan insiden, pemeriksaan kualitas, atau data pelatihan.
Tim robotika Google menjelaskan alur kerja Argon yang menganalisis rekaman dari atas berdurasi 136 detik tentang robot dua lengan yang melipat kertas menjadi rubah origami. Sistem menghasilkan hierarki anotasi yang selaras waktu, dari tugas keseluruhan hingga subtugas dan tindakan tingkat kontak, dengan label kontrol kualitas di sekitar percobaan ulang. Ini adalah contoh konkret output analisis video berupa label dan struktur yang terikat pada rekaman. Artikel tersebut adalah contoh riset, bukan jaminan bahwa panggilan API umum akan mereproduksi alur robotika. (Google Developers Blog, Oktober 2026)
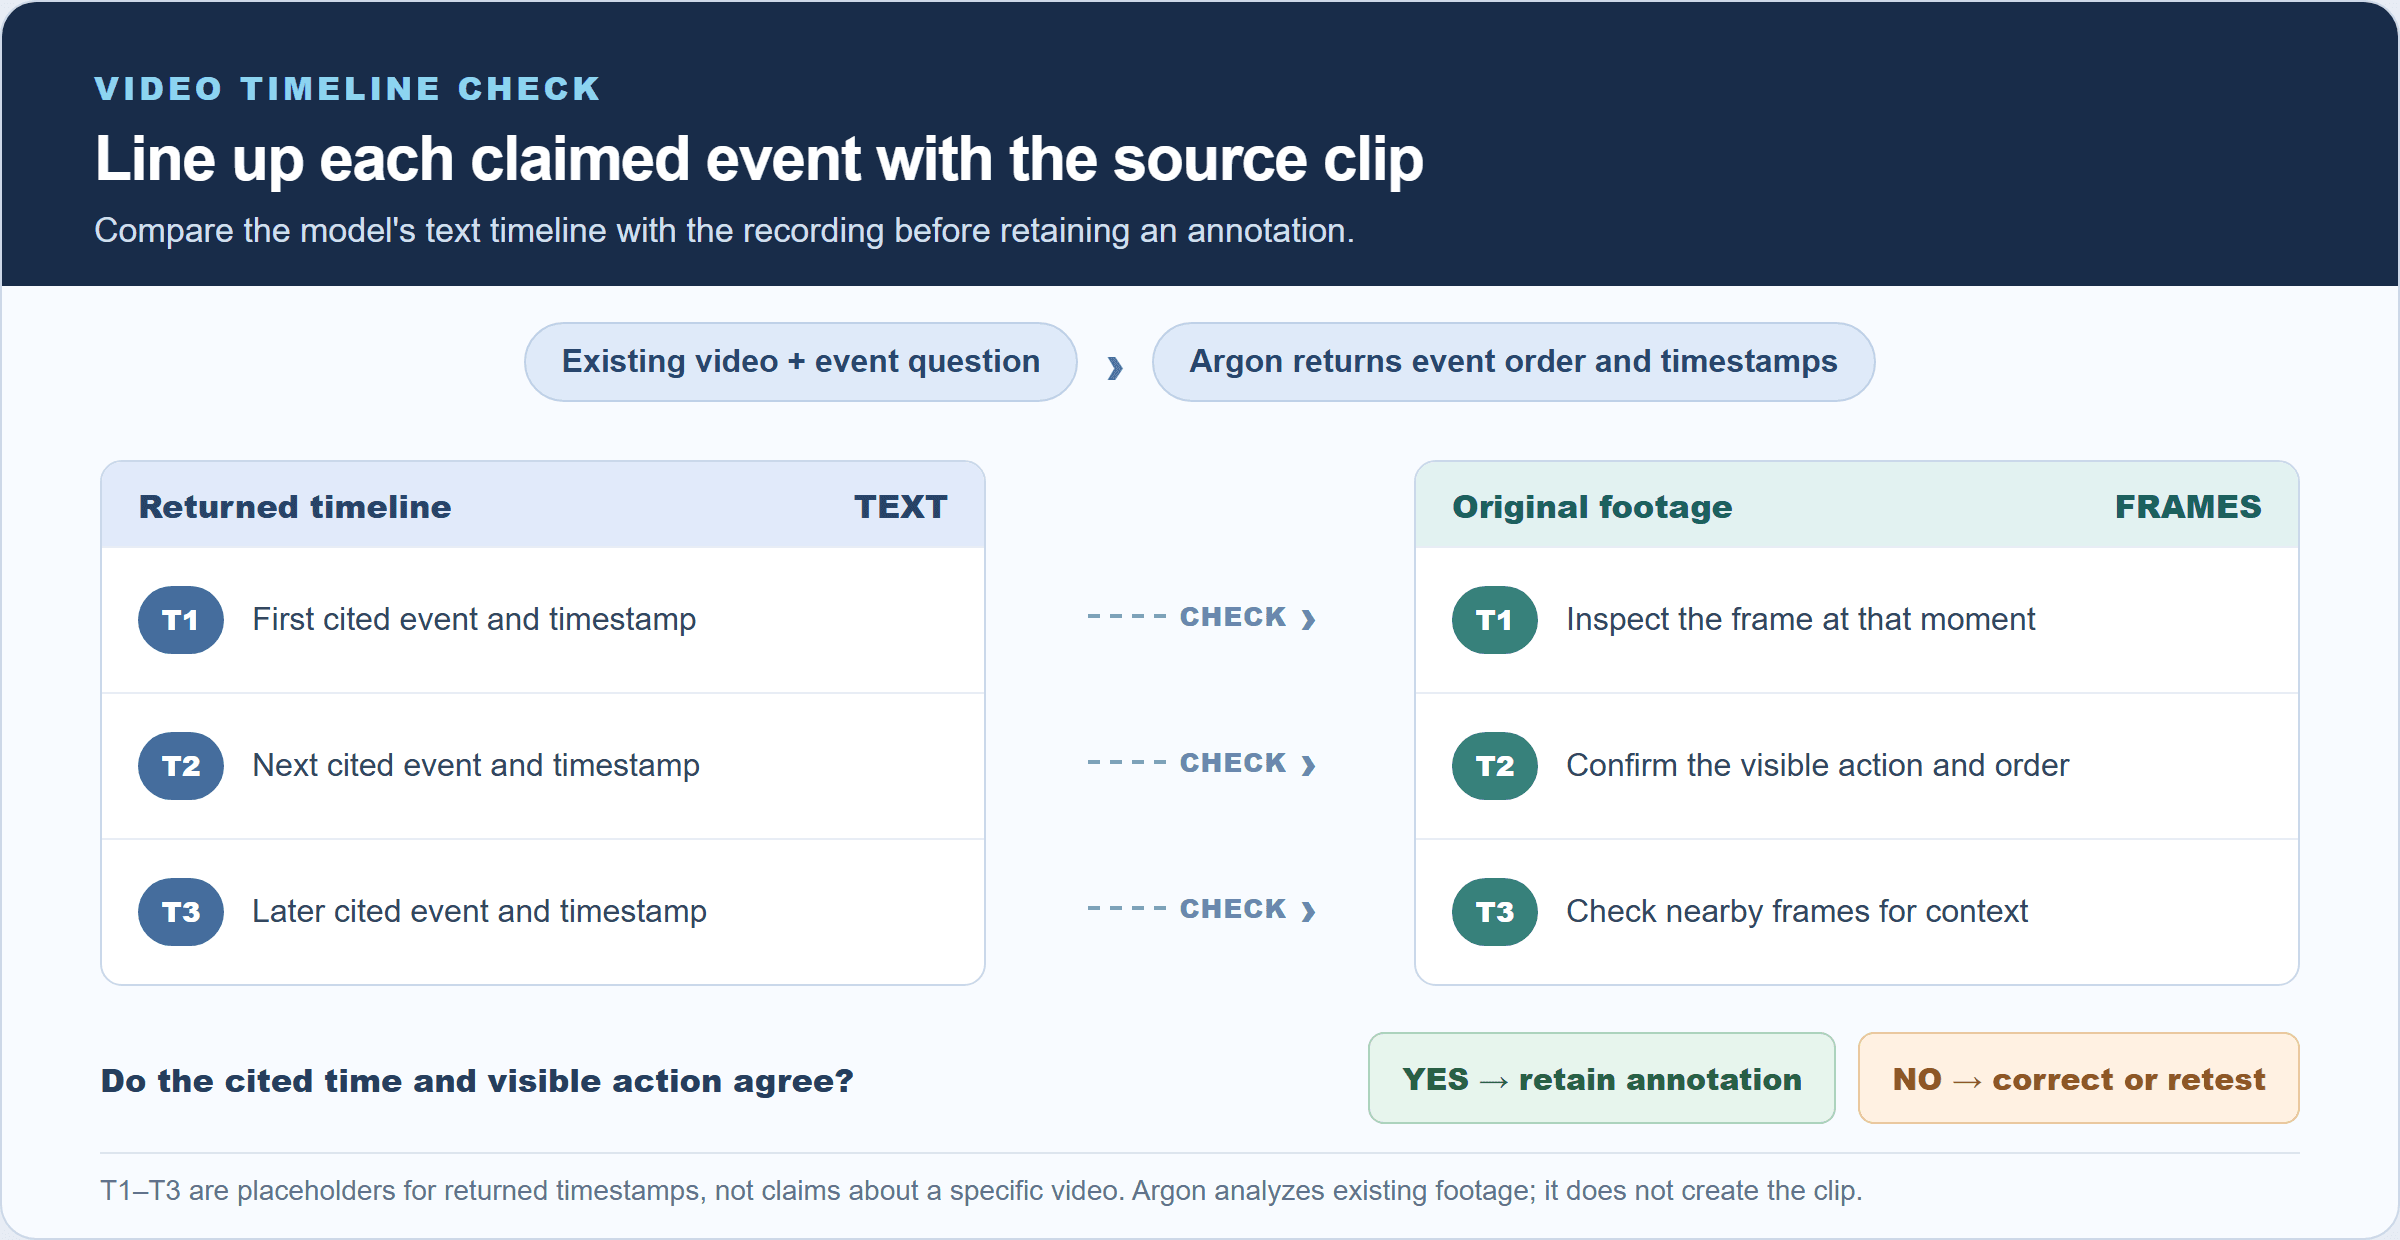 Ilustrasi alur kerja: minta urutan peristiwa dan stempel waktu, lalu verifikasi setiap momen yang dikutip terhadap rekaman asli.
Gerakan dapat mudah salah dibaca ketika kamera bergerak, tangan menutupi objek, atau dua tindakan terjadi berdekatan. Bandingkan sampel stempel waktu yang dikembalikan dengan rekaman asli. Jika jawaban memengaruhi keselamatan atau keputusan lulus/gagal, minta orang atau sistem visi yang dibangun khusus memverifikasi bingkai kritis.
Audio: analisis rekaman yang diberikan
Input audio memungkinkan Anda mengajukan pertanyaan yang berbasis pada rekaman, seperti apa yang dikatakan, suara mana yang muncul lebih dulu, atau apakah frasa tertentu muncul. Sebelum merancang integrasi, periksa dokumentasi input audio saat ini untuk format yang didukung, batasan durasi dan sampling, serta bentuk permintaan yang tepat. “Input audio didukung” saja tidak menentukan setiap perilaku transkripsi atau menjamin bahwa lampiran benar-benar diteruskan melalui klien Anda.
Buat set pengujian jawaban yang diketahui berukuran kecil dari rekaman yang Anda punya izin untuk memprosesnya. Sertakan ucapan bersih, pembicara yang tumpang tindih, kebisingan latar, keheningan, dan suara non-ucapan jika itu terjadi di produksi. Minta stempel waktu atau kutipan bukti singkat di tempat antarmuka mendukungnya. Verifikasi bahwa lampiran mencapai model, lalu bandingkan hasilnya dengan rekaman. Ini menangkap kesalahan model maupun kesalahan integrasi seperti bagian file yang terlewat atau encoding yang tidak didukung.
PDF dan dokumen campuran: hubungkan detail antar sumber
Dukungan PDF berharga ketika pertanyaan melintasi prosa, tabel, dan gambar. Peninjau dapat bertanya apakah ringkasan eksekutif laporan sesuai dengan tabel di bagian selanjutnya dokumen, atau mengekstrak klaim dan gambar pendukungnya. Beberapa dokumen dapat diberikan untuk perbandingan, tergantung batas token dan file permintaan.
Minta lokasi sumber untuk setiap klaim. Referensi halaman berguna, tetapi validasi karena penomoran halaman PDF bisa berbeda dari label halaman tercetak. Untuk tabel, minta label baris dan judul kolomnya beserta nilainya. Untuk diagram, minta model menyebutkan elemen visual yang digunakannya. Jika PDF dipindai, diputar, samar, atau bertata huruf padat, uji halaman perwakilan daripada mengasumsikan semua halaman diuraikan sama baiknya.
Skema output yang ringkas dapat mempermudah peninjauan: klaim, lokasi sumber, kutipan pendukung atau detail visual, dan keyakinan atau “tidak ditemukan.” Output terstruktur dapat menegakkan bentuk, tetapi objek JSON yang valid tetap dapat berisi pembacaan yang salah. Validasi format dan validasi faktual adalah pemeriksaan yang terpisah.
Cara menguji pemahaman multimodal Gemini 4 Argon
Gunakan evaluasi singkat sebelum menghubungkan model ke batch besar. Pilih sumber di mana manusia dapat menetapkan jawaban yang benar, dan tentukan apa yang dianggap sebagai hasil yang benar. Intinya adalah menguji seluruh jalur dari pemilihan file hingga respons model, bukan sekadar melihat apakah jawabannya terdengar masuk akal.
- Pilih satu laporan publik dengan bagan atau video pendek dengan peristiwa yang dapat diidentifikasi dengan jelas. Simpan kunci jawaban yang diperiksa manusia.
- Minta model hanya menggunakan materi terlampir dan lampirkan lokasi untuk setiap klaim.
- Bandingkan setiap klaim dengan sumbernya. Catat kelalaian, pembacaan yang salah, inferensi yang tidak didukung, dan lokasi yang tidak mengarah ke bukti.
- Ulangi dengan beberapa contoh yang menyerupai file aktual Anda, termasuk kasus sulit.
- Tetapkan ambang kelulusan berdasarkan biaya kesalahan. Arahkan hasil yang tidak pasti atau berdampak tinggi ke tinjauan manusia.
Anda dapat menyesuaikan prompt ini:
Analisis hanya materi terlampir. Jawab pertanyaan di bawah ini dalam tabel. Untuk setiap klaim, kutip nomor halaman, stempel waktu, atau bukti yang terlihat yang mendukungnya. Jika materi tidak berisi jawabannya, katakan “tidak ditemukan.” Jangan menyimpulkan fakta yang tidak ada.
Untuk gambar, ganti “nomor halaman, stempel waktu” dengan “wilayah gambar dan label yang terlihat.” Untuk PDF, minta halaman dan nama tabel atau bagian. Untuk audio, minta stempel waktu dan kata-kata atau suara yang mendukung jawaban. Perubahan kecil ini membuat output lebih mudah diaudit.
Lacak kesalahan berdasarkan jenisnya daripada menggunakan satu angka akurasi keseluruhan. Digit yang salah dalam bagan, peristiwa yang terlewat, dan kutipan ke halaman yang salah memiliki konsekuensi berbeda. Kerangka evaluasi ini mengubah daftar kemampuan yang mengesankan menjadi keputusan yang dapat diulang tentang apakah model dapat diandalkan untuk file Anda.
Batas Gemini 4 Argon: apa yang tidak dimaksud dengan dukungan multimodal
Dukungan input tidak berarti dukungan output yang sepadan. API saat ini mencantumkan pembuatan gambar, pembuatan audio, dan Live API sebagai tidak didukung untuk Argon. Jika tugasnya adalah membuat gambar baru, soundtrack, atau interaksi suara real-time, pilih model atau alat yang secara eksplisit mencantumkan output tersebut. Anda tetap dapat menggunakan Argon untuk menganalisis prompt, materi sumber, atau hasil yang dihasilkan.
Jendela satu juta token juga tidak menjamin daya ingat yang lengkap. Jendela itu dibagi antara permintaan dan respons, dan input yang panjang dapat meningkatkan latensi dan biaya. Model dapat melewatkan detail, menyimpulkan informasi yang tidak ada, atau mengembalikan stempel waktu yang salah sambil terdengar yakin. Long decode adalah jalur eksekusi API dengan persyaratan tambahan, bukan perilaku default untuk setiap klien.
Benchmark adalah bukti yang bersifat indikatif. Roboflow melaporkan hasil dari set data tugas dan pengaturan evaluasi tertentu, sedangkan kartu model Google merangkum kumpulan evaluasi internal dan publik yang lebih luas. Keduanya tidak menggantikan pengujian yang menggunakan kualitas kamera, tata letak dokumen, kosakata, bahasa, dan toleransi kesalahan Anda. Skor tinggi pada satu kategori tidak dapat membuktikan performa yang andal pada tugas yang berbeda.
Gunakan peninjau ketika jawaban memengaruhi keputusan keuangan, hukum, keselamatan, medis, atau ketenagakerjaan. Simpan input asli dan bukti yang dikembalikan bersama-sama agar seseorang dapat mengaudit kesimpulannya. Untuk alur kerja berulang, catat versi model, prompt, pengaturan yang relevan, pengenal sumber, dan hasil tinjauan. Catatan itu membantu membedakan perubahan model dari masalah file atau integrasi.
| Tugas | Uji pertama yang baik | Tinjau dengan cermat |
|---|---|---|
| Pembacaan bagan | Minta nilai berlabel dengan satuan sumbu | Font kecil, legenda padat, pembacaan visual perkiraan |
| OCR | Gunakan potongan bersih dengan transkripsi yang diketahui | Buram, tulisan tangan, rotasi, skrip campuran |
| Peristiwa video | Minta tindakan berstempel waktu secara berurutan | Oklusi, potongan cepat, penyebab yang disimpulkan |
| Tanya jawab audio | Ajukan pertanyaan yang diketahui tentang rekaman pendek | Kebisingan, beberapa pembicara, penanganan lampiran |
| Perbandingan PDF | Minta klaim, halaman, dan bagian pendukung | Halaman pindai, penomoran halaman tidak cocok, inferensi lintas halaman |
Akses, harga, dan di mana Atlas Cloud cocok
ID model API publik adalah gemini-4-argon; Google saat ini mencantumkan Gemini API dan AI Studio sebagai jalur akses. Pemberitahuan Google saat ini mencantumkan tarif perkenalan $2 per juta token input dan $10 per juta token output hingga 30 November 2026, lalu masing-masing $4 dan $20. Input yang di-cache memiliki ketentuan terpisah, jadi jangan memperkirakannya sebagai input biasa. (Google, Oktober 2026)
Daftar All Models Atlas Cloud saat ini tidak menampilkan Gemini 4 Argon saat diperiksa untuk artikel ini. Artinya, tidak ada halaman model Atlas Argon yang terverifikasi atau harga Atlas yang dapat dikutip di sini. Jangan menganggap daftar platform umum sebagai bukti ketersediaan. Jika tim Anda membandingkan penyedia atau membangun alur kerja model yang lebih luas, Atlas Cloud dapat menjadi tempat untuk menjelajahi model lain yang terdaftar, tetapi konfirmasikan halaman model yang tepat dan operasi yang didukung sebelum merencanakan dengan penyedia mana pun.
Pemeriksaan sumber juga memengaruhi rekomendasi: gunakan jalur resmi Google untuk menguji Argon hari ini, dan perlakukan Atlas Cloud sebagai opsi penemuan terpisah untuk model yang benar-benar terdaftar. Tidak ada klaim di sini bahwa Argon dihosting di Atlas Cloud.
Apakah Gemini 4 Argon tepat untuk tugas Anda?
Masukkan Argon ke daftar pendek ketika pekerjaan memerlukan penalaran lintas materi campuran, mengekstrak detail visual, mengikuti peristiwa melalui video, atau meninjau laporan panjang. Konteks bersama yang besar dan output teksnya dapat membantu mengonsolidasikan bukti ke dalam tabel atau hasil terstruktur. Langkah berikutnya adalah evaluasi kecil yang dapat diperiksa manusia menggunakan input perwakilan Anda sendiri.
Pilih model atau alat lain ketika hasil yang diperlukan adalah citra yang dihasilkan, audio yang dihasilkan, atau percakapan audio/video langsung. Untuk OCR atau keputusan operasional, bandingkan outputnya dengan alternatif yang dibangun khusus jika ketepatan, kecepatan, atau biaya yang dapat diprediksi lebih penting daripada penalaran yang luas.
Jika evaluasi melewati ambang khusus tugas Anda, uji coba dengan pencatatan dan tinjauan manusia sebelum menaikkan volume. Jika gagal, klasifikasikan kesalahan dan putuskan apakah input yang lebih jelas, prompt yang diubah, model yang berbeda, atau sistem OCR/transkripsi terpisah adalah perbaikan yang tepat. Pertanyaan yang berguna adalah apakah kemampuan multimodal Gemini 4 Argon memenuhi anggaran kesalahan Anda.
Pertanyaan yang Sering Diajukan
Dapatkah Gemini 4 Argon menganalisis video dan audio?
Ya. API-nya mencantumkan video dan audio sebagai input yang didukung. Pemahaman video dapat mengembalikan deskripsi atau analisis berstempel waktu; audio dapat diberikan untuk pertanyaan yang berbasis audio. Periksa format file dan dokumentasi permintaan saat ini, lalu verifikasi responsnya terhadap media asli.
Apakah Gemini 4 Argon menghasilkan gambar atau audio?
Tidak. Tabel kemampuan API saat ini menandai pembuatan gambar dan pembuatan audio sebagai tidak didukung untuk model ini. Modalitas output yang didokumentasikan adalah teks, bahkan ketika inputnya berisi gambar, audio, atau video.
Apa arti jendela konteks 1M token Gemini 4 Argon?
Batas 1.048.576 token dibagi oleh input dan output. Output sinkron default dibatasi pada 65.536 token. Google mendokumentasikan alur long decode terpisah untuk output yang lebih besar, hingga batas bersama, dengan eksekusi latar belakang dan langkah kelanjutan.
Berapa biaya akses API Gemini 4 Argon?
Per 16 Oktober 2026, Google mencantumkan $2 per juta token input dan $10 per juta token output hingga 30 November 2026. Tarif berikutnya yang dicantumkan adalah $4 dan $20. Periksa harga langsung dan ketentuan token yang di-cache sebelum memperkirakan proyek.


