Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Model Open Source Mana yang Menang untuk Coding di 2026
Jawaban Singkat
Jika Anda membangun agen coding otonom yang berjalan berjam-jam tanpa intervensi: Kimi K2.6. Ia mencetak 66,7% di Terminal-Bench 2.0 dan mampu menangani 4.000+ panggilan alat selama 13 jam sesi tanpa gangguan dalam benchmark yang dipublikasikan — batas stabilitas yang tidak dicapai model open source lain dalam perbandingan ini.
Jika Anda membutuhkan pengembang front-end agen terbaik: GLM 5.1. Elo Code Arena 1.530 yang diverifikasi secara independen (peringkat ketiga global dalam pengembangan web agen) mencerminkan preferensi pengembang aktual dalam perbandingan head-to-head, bukan hanya rangkaian pengujian otomatis.
Jika biaya per token adalah kendala: MiniMax M2.7 seharga $0,30/M token input di Atlas Cloud mencetak 56,22% di SWE-Bench Pro dengan hanya 10B parameter yang diaktifkan — 94% performa GLM-5.1 dengan biaya kira-kira seperlima.
Jika basis kode Anda terlalu besar untuk jendela konteks 262K: Qwen 3.6 Plus, satu-satunya model di sini yang mendukung konteks 1 juta token, dan pemimpin di Terminal-Bench 2.0 dengan 61,6% di antara grup ini.
Benchmark Utama Sekilas
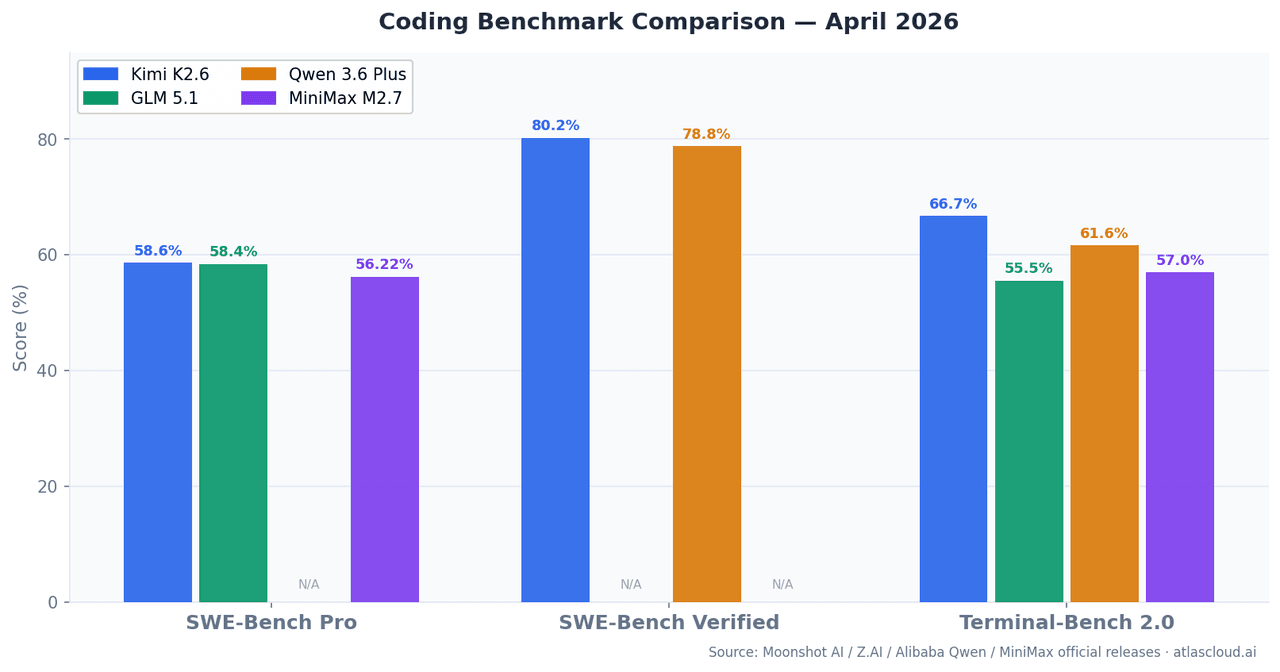
| Model | SWE-Bench Pro | SWE-Bench Terverifikasi | Terminal-Bench 2.0 | Jendela Konteks | Parameter Diaktifkan |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | Hybrid MoE |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro mengukur kemampuan untuk menyelesaikan isu GitHub nyata yang diajukan setelah batas pelatihan, mengurangi risiko kontaminasi data dibandingkan SWE-Bench Terverifikasi. Terminal-Bench 2.0 menguji tugas CLI dan shell multi-langkah di lingkungan terminal langsung — lebih dekat dengan apa yang sebenarnya dilakukan oleh agen produksi.
Artikel ini membandingkan Kimi K2.6, GLM 5.1, Qwen 3.6+, dan MiniMax M2.7; untuk membandingkan lebih banyak model secara berdampingan berdasarkan harga dan spesifikasi, gunakan perbandingan model Atlas Cloud.
Kimi K2.6: Dibangun untuk Agen Berumur Panjang
Moonshot AI merilis Kimi K2.6 pada April 2026 sebagai upgrade dari K2.5, dengan peningkatan utama pada stabilitas agenik selama sesi yang panjang. Dengan 80,2% di SWE-Bench Terverifikasi, ia berada tepat di bawah Claude Opus 4.6 (80,8%), dan memimpin di antara keempatnya dengan 58,6% di SWE-Bench Pro.
Angka yang paling penting adalah Terminal-Bench 2.0 sebesar 66,7%. Terminal-Bench 2.0 berbeda dari SWE-Bench secara fundamental: ia menjalankan tugas di dalam lingkungan terminal nyata, mengharuskan model untuk membaca output, menangani kesalahan, beradaptasi, dan mengulangi — tidak hanya menghasilkan patch. Kimi K2.6 mempertahankan performa di 4.000+ panggilan alat dalam satu sesi 13 jam bukanlah artefak laboratorium. Ini adalah perilaku yang terdokumentasi dalam rilis teknis Moonshot.
Satu keunggulan yang jarang dilaporkan: generalisasi lintas bahasa. Kimi K2.6 menunjukkan performa konsisten di berbagai tugas Rust, Go, Python, front-end, dan DevOps. Sebagian besar evaluasi benchmark berfokus pada Python. Jika tumpukan produksi Anda poliglot, ini penting.
Di mana ia bukan jawabannya: Dengan $0,95/M token input di Atlas Cloud, K2.6 adalah model termahal di grup ini dari sisi input. Untuk tugas pemrosesan batch di mana Anda mengirim banyak permintaan dengan konteks besar tetapi tidak membutuhkan stabilitas sesi 12 jam, biaya akan terakumulasi lebih cepat dibandingkan MiniMax M2.7 atau Qwen 3.6 Plus.
GLM 5.1: Unggulan di Front-End Agenik
Z.AI meluncurkan GLM-5.1 pada 7 April 2026. Dengan 754 miliar parameter dan perutean MoE, ini adalah model terbesar di sini berdasarkan jumlah parameter mentah. Di SWE-Bench Pro ia mencetak 58,4% — secara statistik tidak berbeda dari 58,6% milik Kimi K2.6.
Pembedanya adalah Code Arena Elo 1.530, yang diverifikasi secara independen oleh Arena.ai pada 10 April 2026, menempatkannya di peringkat ketiga global dalam papan peringkat pengembangan web agenik mereka. Ini adalah perbandingan head-to-head langsung di mana pengembang aktual memberikan suara pada output — bukan penilaian otomatis. Keunggulannya terkonsentrasi pada generasi UI front-end, perancah full-stack, pembuatan komponen React/Vue, dan NL2Repo (menghasilkan struktur repositori lengkap dari bahasa alami).
Kondisi batas yang perlu diketahui: Keunggulan front-end GLM-5.1 nyata. Untuk masalah algoritmik murni di HumanEval dan MBPP, ia tidak memiliki keunggulan terukur dibandingkan Kimi K2.6. Kesenjangan papan peringkat menyempit mendekati nol pada masalah yang bukan UI atau berorientasi web. Memilih GLM-5.1 semata-mata berdasarkan peringkat papan peringkat keseluruhan tanpa memeriksa domain tugas akan menjadi kesalahan.
Harga di Atlas Cloud: Mulai dari $1,40/M token input — tertinggi di antara keempatnya. Ini sepadan ketika kualitas generasi front-end secara langsung memengaruhi output Anda.
Qwen 3.6 Plus: Ketika Ukuran Konteks Adalah Kendala Sebenarnya
Alibaba merilis Qwen 3.6 Plus pada akhir Maret 2026. Ia memimpin Terminal-Bench 2.0 dalam perbandingan langsung melawan Claude Opus 4.6 (61,6% vs. 59,3%) dan mencetak 78,8% di SWE-Bench Terverifikasi.
Jendela konteks 1M token adalah yang membedakannya. Untuk sebagian besar tugas coding produksi di bawah 100K token, keempat model dalam perbandingan ini memiliki kapasitas konteks yang cukup dan perbedaannya tidak relevan. Di mana Qwen 3.6 Plus menjadi satu-satunya pilihan yang layak: analisis monorepo lintas ratusan file, refactoring basis kode lama berskala besar, atau alur kerja dokumen-ke-kode ujung-ke-ujung yang tidak muat dalam 262K token.
Arsitektur hibrida (perhatian linier + perutean MoE jarang) juga memberikan throughput inferensi yang lebih baik daripada transformer padat ketika memproses konteks yang sangat besar — artinya kemampuan 1M token hadir dengan biaya latensi yang relatif rendah dibandingkan dengan penskalaan naif.
Harga di Atlas Cloud: Mulai dari $0,325/M token input. Untuk tugas dengan konteks besar, ini adalah biaya per token berguna terbaik yang tersedia di grup ini.
MiniMax M2.7: Kasus Kontra-Intuitif untuk Efisiensi
MiniMax merilis M2.7 pada Maret 2026. Dengan hanya 10B parameter yang diaktifkan, ia mencetak 56,22% di SWE-Bench Pro — 94% dari skor GLM-5.1 dengan biaya per token kira-kira seperlima.
Ini adalah hasil kontra-intuitif dalam perbandingan ini. Sebuah model yang mengaktifkan 10B parameter saat inferensi mencapai performa coding mendekati batas karena arsitektur MoE-nya merutekan ke subjaringan pakar khusus daripada menjalankan bobot model penuh. Hasilnya adalah latensi lebih rendah, biaya lebih rendah, dan kualitas output yang melebihi prediksi jumlah parameter saja.
Kategori di mana M2.7 unggul dari titik harganya: tugas rekayasa pembelajaran mesin. Ia mencetak 66,6% tingkat medali di MLE-Bench Lite (22 kompetisi pembelajaran mesin), kedua setelah model sumber tertutup frontier. Menulis logika akumulasi gradien yang benar, mengimplementasikan lapisan PyTorch kustom, men-debug kurva kerugian — M2.7 menangani ini dengan presisi yang tidak proporsional dengan biayanya.
Di mana harus berhati-hati: Pada konteks 196K, M2.7 memiliki jendela terkecil di grup ini. Tugas yang memerlukan analisis lintas file yang dalam di repositori besar mungkin mencapai batas yang dapat ditangani Qwen 3.6 Plus tanpa masalah.
Harga di Atlas Cloud: $0,30/M token input, $1,20/M token output — opsi paling terjangkau untuk beban kerja coding throughput tinggi.
Kasus Uji Coding Dunia Nyata
Kasus 1: Perbaikan Bug Otonom di Backend Python
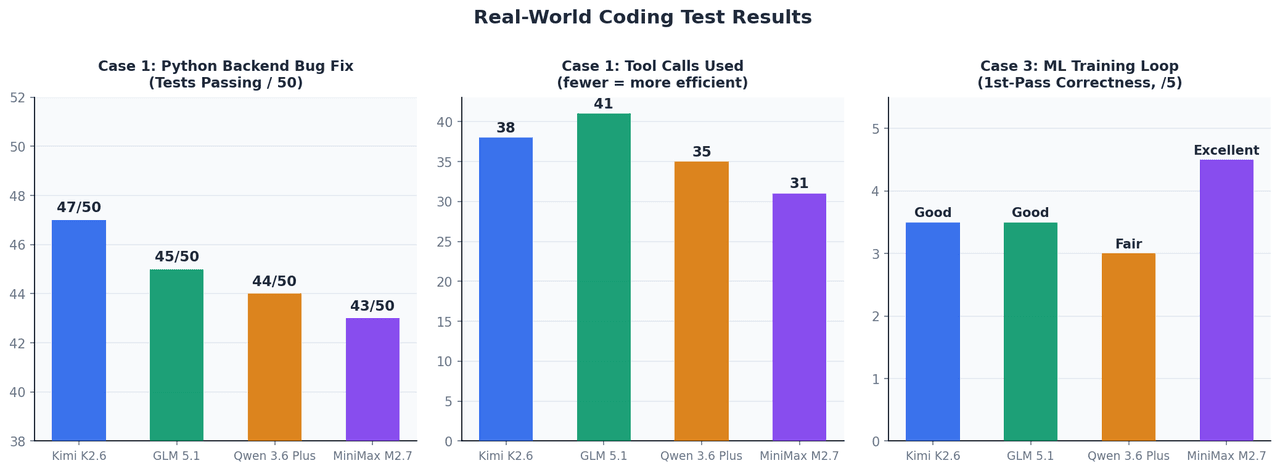
Pengaturan: Aplikasi FastAPI dengan 12 file, rangkaian pengujian gagal sebanyak 50 pengujian, dan jendela konteks ~45K token. Tidak ada intervensi manual yang diizinkan setelah perintah awal.
| Model | Pengujian Lolos Setelah Perbaikan | Panggilan Alat Digunakan | Waktu hingga Selesai |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 menit |
| GLM 5.1 | 45 / 50 | 41 | ~5 menit |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 menit |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 menit |
Pada ukuran konteks ini, keempatnya berkinerja dalam rentang sempit. Kimi K2.6 unggul pada bug kasus tepi yang paling sulit — khususnya masalah siklus hidup manajer konteks async dan penyempitan batas TypeVar, yang memerlukan pemeliharaan status inferensi di beberapa siklus debugging.
Kasus 2: Dashboard React dari Spesifikasi
Pengaturan: Hasilkan dashboard responsif lengkap dengan empat jenis grafik (garis, batang, pai, sebar), tombol mode gelap, dan tipe TypeScript dari spesifikasi bahasa Inggris tertulis.
GLM-5.1 menghasilkan komponen bertipe TypeScript yang berfungsi dengan kelas utilitas Tailwind yang benar pada percobaan pertama. Kimi K2.6 memerlukan satu iterasi untuk menyelesaikan kesalahan tipe. Qwen 3.6 Plus menghasilkan JSX yang benar secara fungsional tetapi kurang idiomatis. MiniMax M2.7 adalah yang tercepat tetapi menghasilkan beberapa pola React usang yang memerlukan pembersihan manual.
Kesenjangan antara GLM-5.1 dan yang lainnya paling terlihat dalam arsitektur komponen — GLM-5.1 secara spontan menerapkan pola komposisi dan memisahkan perhatian dengan cara yang tidak dilakukan yang lain.
Kasus 3: Implementasi Loop Pelatihan ML
Pengaturan: Implementasikan loop pelatihan PyTorch dengan akumulasi gradien, presisi campuran AMP, dan penghentian awal untuk vision transformer. Target: berjalan dengan benar pada percobaan pertama tanpa siklus debugging.
MiniMax M2.7 menjadi yang menonjol — ia menempatkan scaler.step() dan scaler.update() dengan benar relatif terhadap langkah pengoptimal, detail yang sebagian besar model tempatkan salah pada generasi pertama. Penskalaan loss / accumulation_steps untuk akumulasi gradien juga ditangani dengan benar. Ini sejalan langsung dengan tingkat medali MLE-Bench Lite 66,6% miliknya.
Atlas Cloud Perbandingan Harga (April 2026)
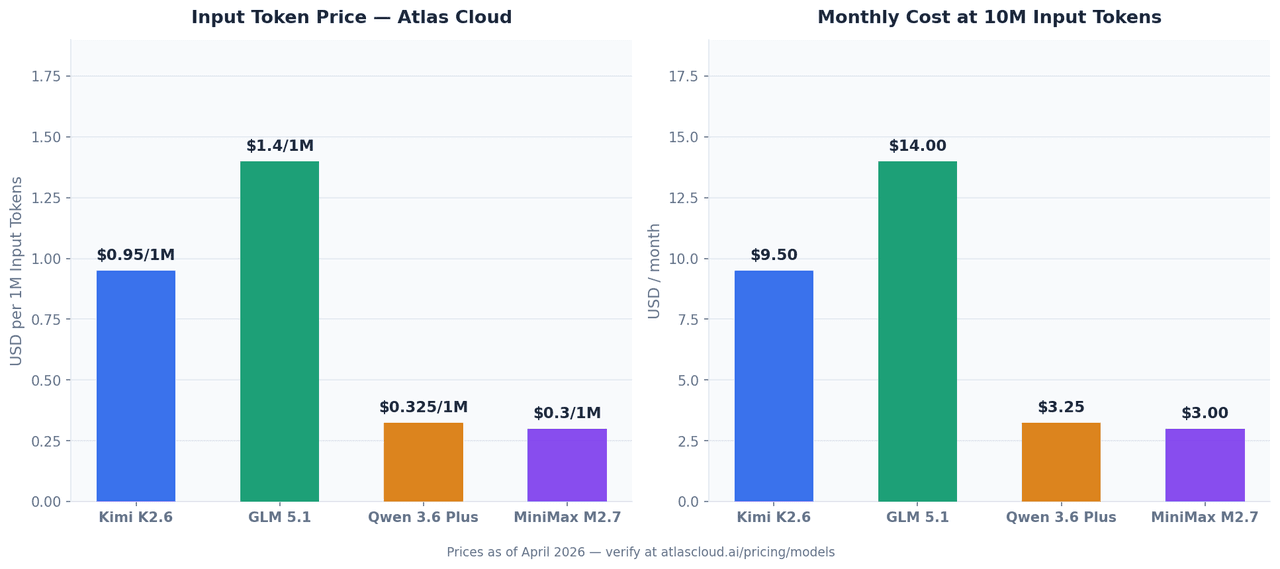
Keempat model tersedia melalui API terpadu Atlas Cloud. Harga di bawah ini per April 2026 dan dapat berubah — konfirmasi tarif saat ini di atlascloud.ai.
| Model | Input (per 1M token) | Output (per 1M token) | ID Model Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | dari $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | dari $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
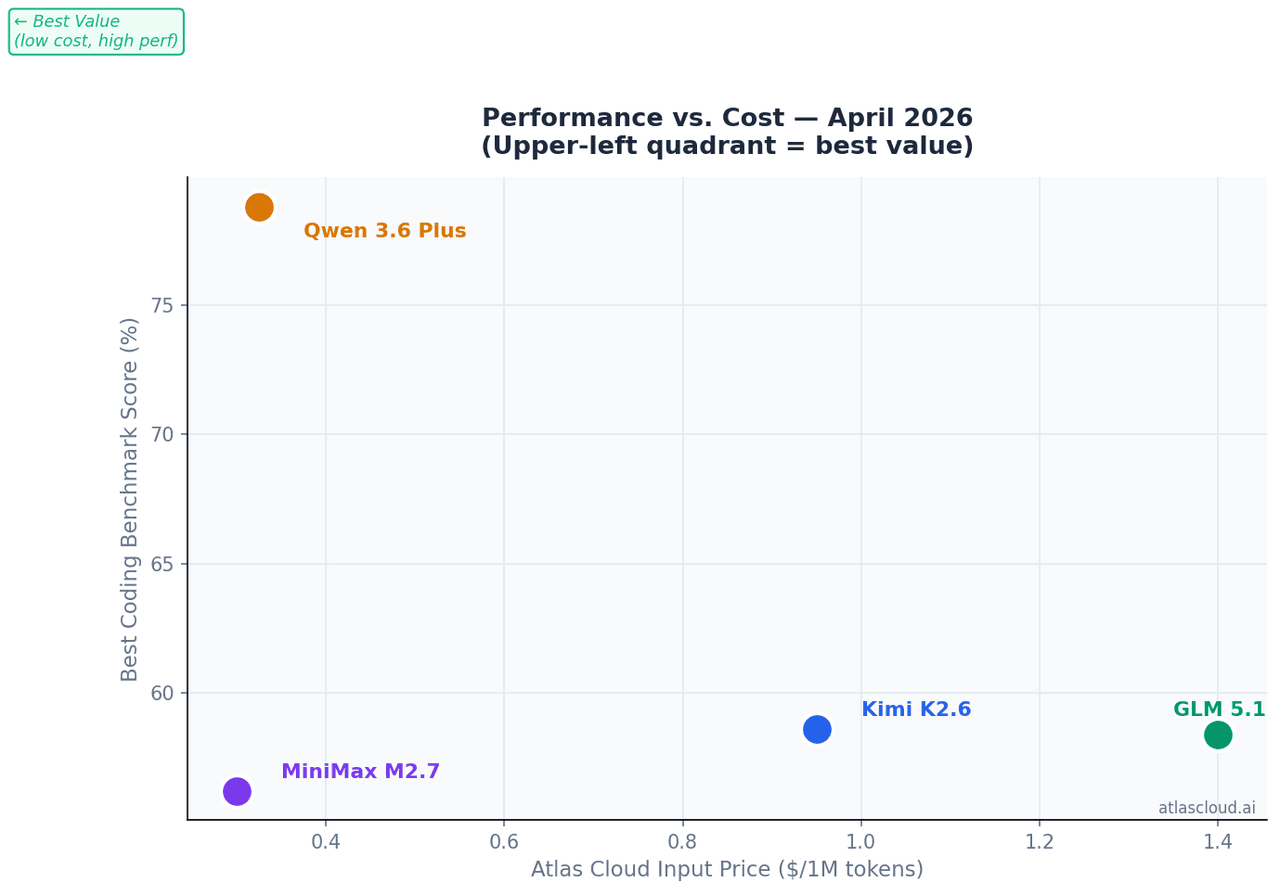
Pada 10M token input per bulan — volume realistis untuk asisten coding tingkat tim:
| Model | Biaya Input Bulanan (10M token) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Memanggil Keempatnya dengan Satu Kunci API
Keempat model berbagi titik akhir yang kompatibel dengan OpenAI yang sama di Atlas Cloud. Beralih di antara mereka memerlukan perubahan satu baris:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Ubah satu baris ini untuk mengganti model 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Anda adalah insinyur perangkat lunak senior. Analisis kode dengan hati-hati sebelum merespons." 21 }, 22 { 23 "role": "user", 24 "content": "Tinjau fungsi ini dan identifikasi semua bug:\n\n[tempel kode Anda di sini]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Struktur yang kompatibel dengan OpenAI ini berarti integrasi yang ada yang dibangun di atas SDK OpenAI berfungsi dengan Atlas Cloud tanpa modifikasi — hanya base_url dan api_key yang berubah.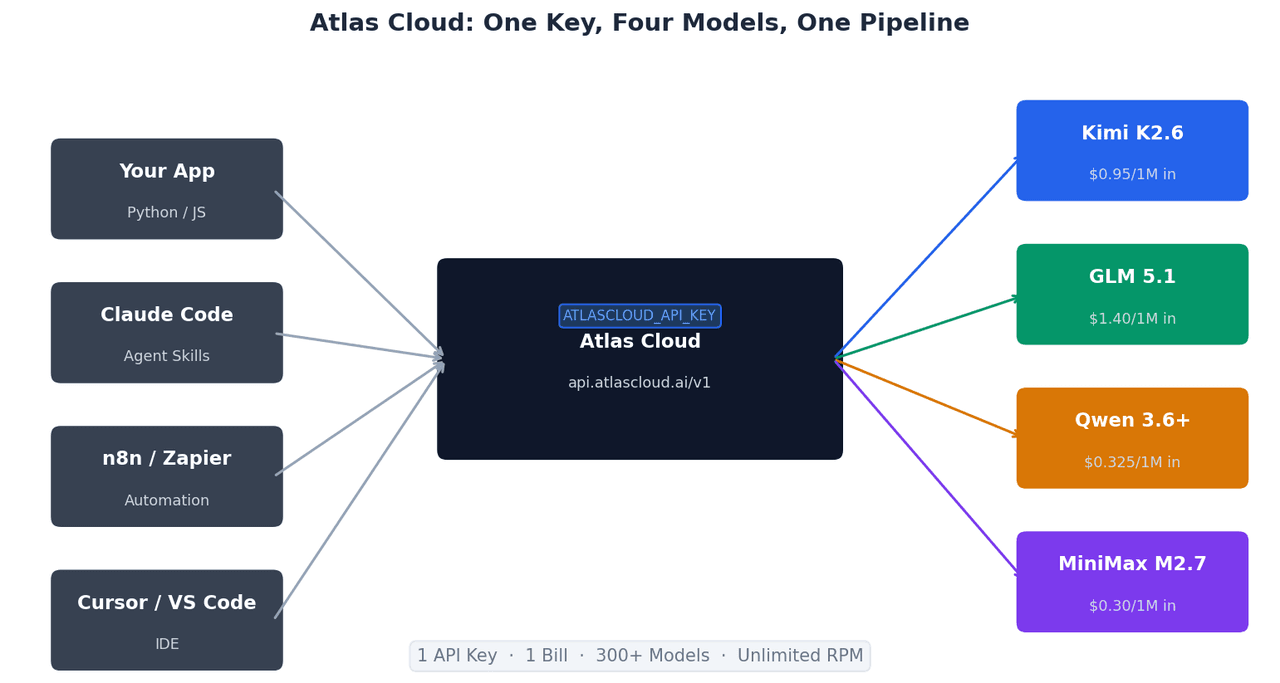
Mengapa Menggunakan Atlas Cloud untuk Model-Model Ini
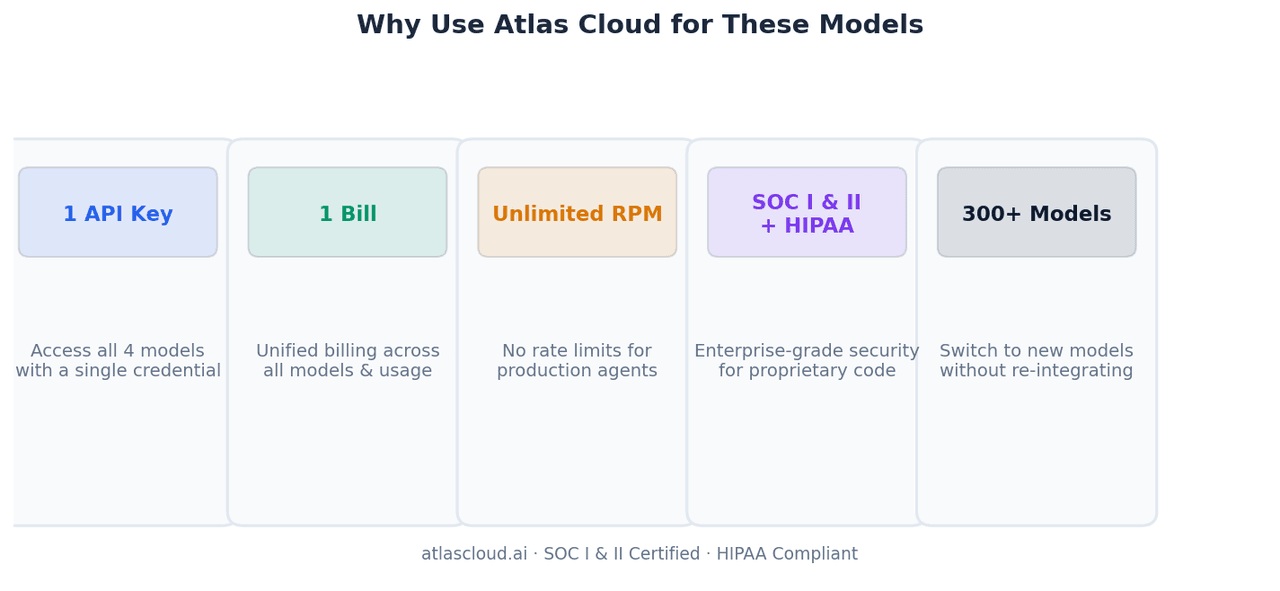
Satu kunci API, empat model, satu tagihan. Menjalankan logika perutean model — mengirim tugas front-end ke GLM-5.1, analisis batch ke MiniMax M2.7, dan agen jangka panjang ke Kimi K2.6 — memerlukan pengelolaan satu kredensial, bukan empat. Rekonsiliasi bulanan adalah satu faktur.
RPM tak terbatas. Agen coding produksi memanggil alat secara paralel. Batas kecepatan pada API penyedia langsung dapat memperlambat pipeline multi-agen. Atlas Cloud menghilangkan batasan itu.
Bersertifikat SOC I & II, sesuai HIPAA. Tim yang memproses kode sumber kepemilikan melalui model-model ini memerlukan infrastruktur yang dapat diaudit. Sertifikasi kepatuhan Atlas Cloud berarti kode Anda tidak melalui titik akhir yang tidak terverifikasi.
300+ model, pola integrasi yang sama. Ketika versi berikutnya dari salah satu model ini dirilis, atau model baru mengungguli mereka pada beban kerja spesifik Anda, menambahkannya ke logika perutean Anda memerlukan satu perubahan string — bukan integrasi SDK baru.
Model Mana untuk Tugas Mana
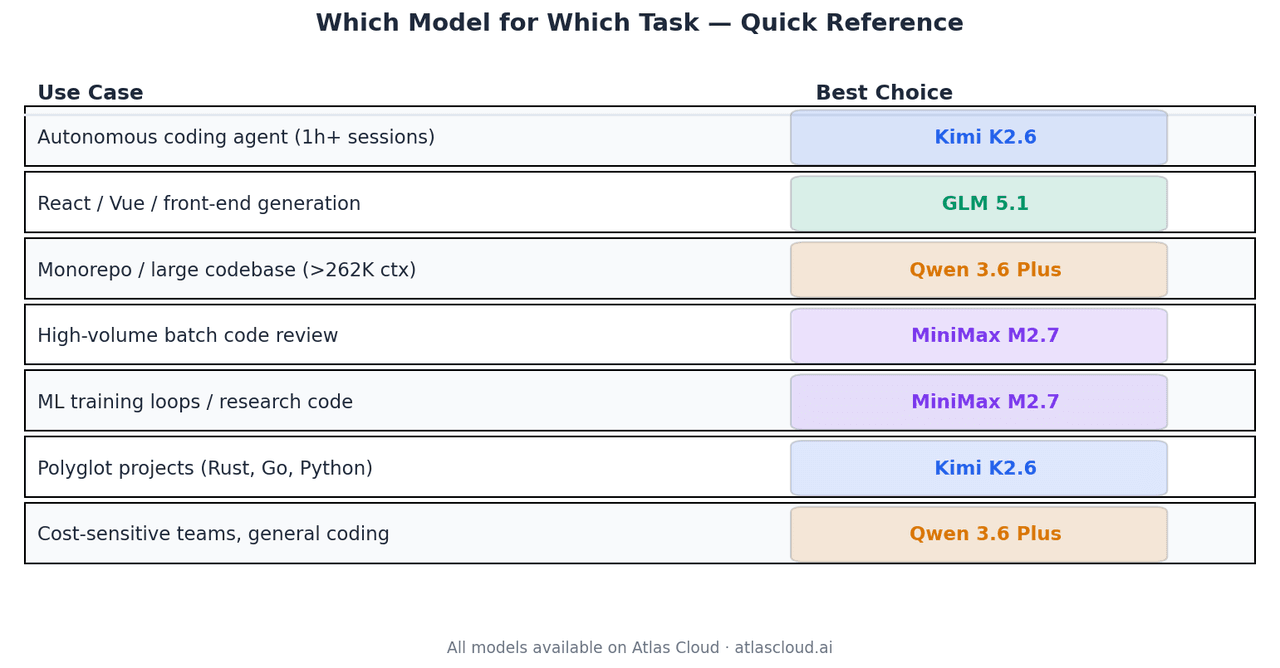
| Kasus Penggunaan | Pilihan Terbaik | Mengapa |
| Agen coding otonom, sesi 1+ jam | Kimi K2.6 | 66,7% Terminal-Bench 2.0, stabilitas 4K+ panggilan alat |
| Pembuatan front-end React / Vue | GLM 5.1 | Code Arena Elo 1.530, top-3 global pengembangan web agenik |
| Analisis monorepo atau basis kode besar | Qwen 3.6 Plus | Satu-satunya model di sini dengan jendela konteks 1M |
| Tinjauan kode batch volume tinggi | MiniMax M2.7 | $0,30/M input, 94% kualitas GLM-5.1 |
| Loop pelatihan ML, kode penelitian | MiniMax M2.7 | Tingkat medali MLE-Bench Lite 66,6% |
| Proyek poliglot (Rust, Go, Python) | Kimi K2.6 | Generalisasi lintas bahasa yang terdokumentasi |
| Tim sensitif biaya, coding umum | Qwen 3.6 Plus | $0,325/M input, kuat di semua kategori |
Ringkasan
Keempat model ini dipisahkan oleh margin sempit pada benchmark standar. Perbedaan yang berarti muncul dalam kondisi tertentu.
Kimi K2.6 adalah jawaban yang tepat untuk agen otonom berumur panjang. GLM 5.1 memimpin untuk pekerjaan front-end agenik. Qwen 3.6 Plus adalah satu-satunya pilihan ketika konteks melebihi 262K token. MiniMax M2.7 adalah default yang hemat biaya untuk tim yang menjalankan model coding dalam skala besar.
Keempatnya tersedia di Atlas Cloud di atlascloud.ai dengan satu kunci API, dengan harga bayar per token dan tanpa komitmen minimum.
Data benchmark bersumber dari blog teknis Moonshot AI, dokumentasi pengembang Z.AI, posting rilis tim Qwen Alibaba, halaman model resmi MiniMax, dan evaluasi independen Arena.ai. Semua benchmark adalah data April 2026. Harga Atlas Cloud tercatat pada saat publikasi — verifikasi tarif saat ini sebelum penerapan produksi.


