

Uji memori yang berguna lebih mirip pemeriksaan tanpa melihat catatan dengan satu koreksi dan beberapa gangguan, bukan seperti bertanya, “Apa yang kamu ingat tentang saya?” Untuk menjalankan muse wonder active memory test, berikan detail fiktif kepada Muse Wonder dalam satu percakapan, koreksi salah satunya, lalu minta fakta terkini yang relevan dalam percakapan baru. Catat apa yang ia ambil kembali, apa yang salah, dan apakah ia mengakui ketidakpastian.
Urutan di bawah ini memerlukan sekitar 10 menit untuk disiapkan dan dinilai. Itu bukan bukti memori lintas hari, akun, atau setiap permukaan produk Muse. Ini adalah pemeriksaan awal yang dapat diulang. Gunakan detail yang dibuat-buat, bukan informasi pribadi.
Poin-poin penting
- Uji pengambilan kembali, koreksi, ketahanan terhadap pengalih, ketidakpastian, dan ketertelusuran secara terpisah.
- Jalankan pengujian di permukaan produk yang ingin Anda gunakan, dengan pengaturan memorinya didokumentasikan.
- Permintaan API baru hanya menguji memori persisten jika aplikasi atau layanan menyediakannya.
- MemoryBench milik Meta adalah evaluasi internal yang jauh lebih panjang; pemeriksaan singkat ini tidak mereproduksinya.
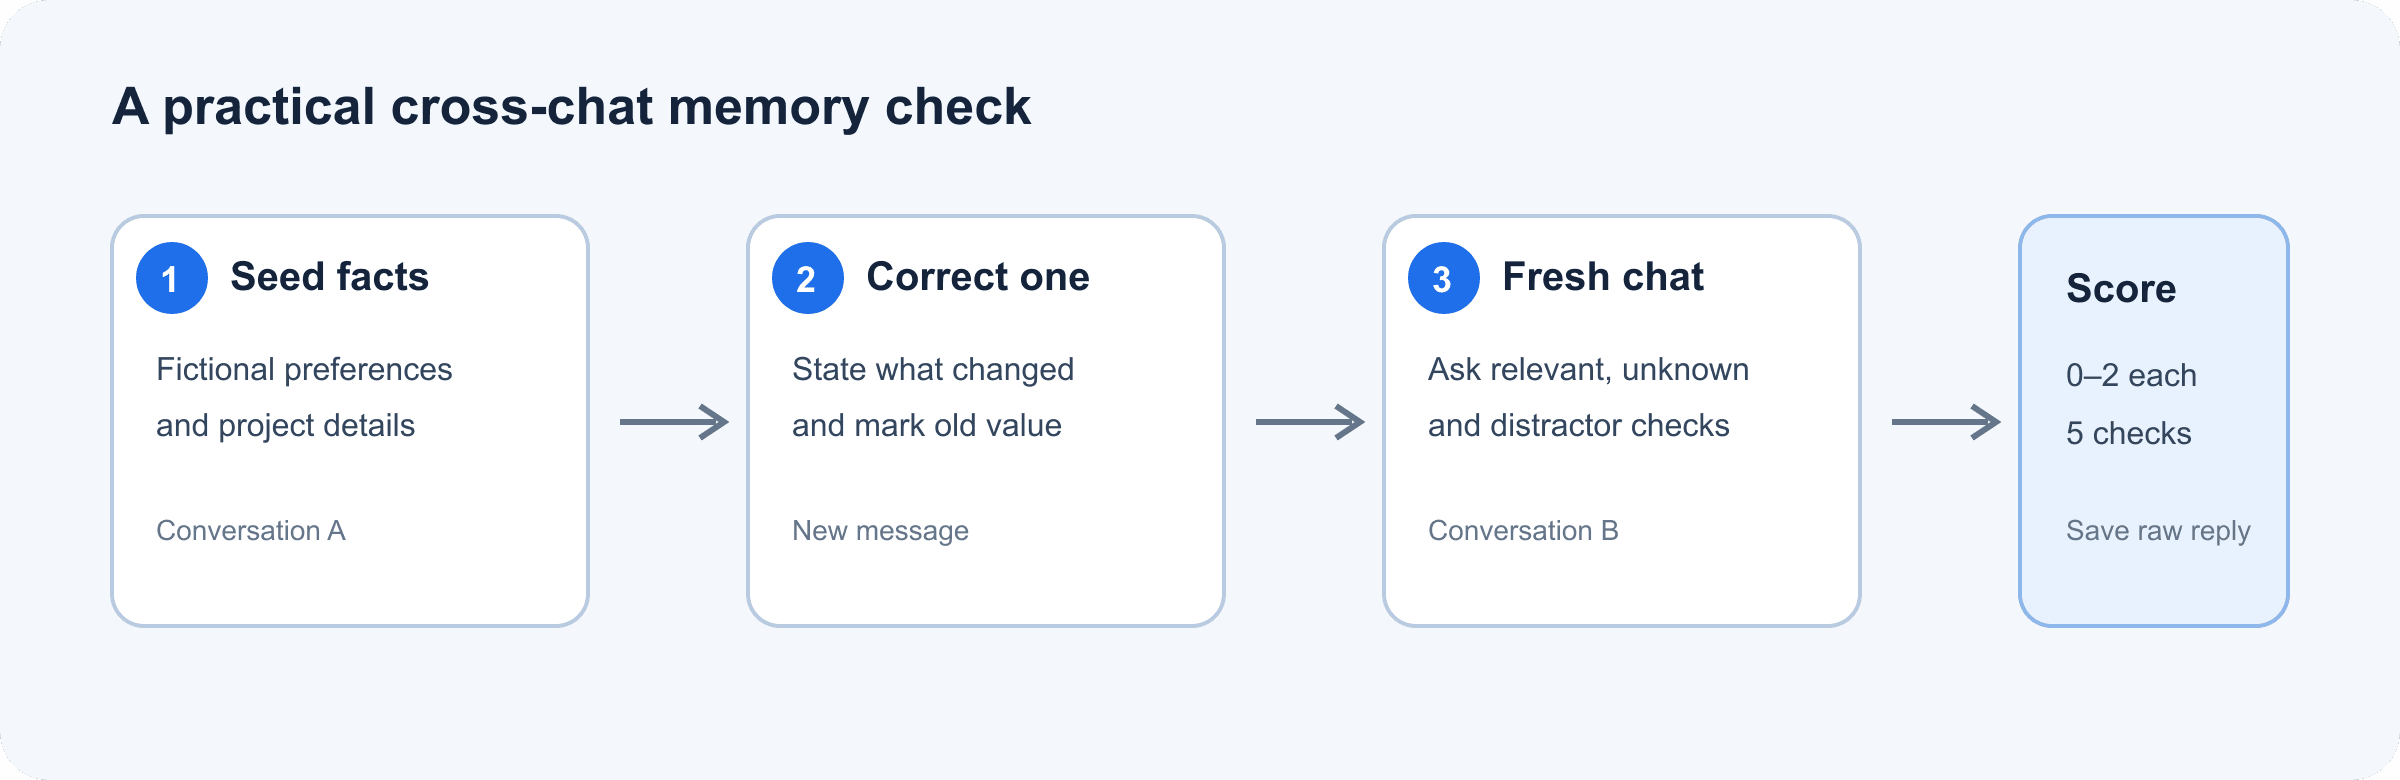
Alur uji Active Memory Muse Wonder dari detail fiktif melalui koreksi, pengambilan di obrolan baru, dan penilaian
Alur pengujian memisahkan fakta awal, koreksi eksplisit, dan pengambilan dalam percakapan baru.
Apa Tujuan Muse Wonder Active Memory
Meta mendeskripsikan Active Memory sebagai kemampuan membawa konteks penting tentang seseorang lintas percakapan dan mengambil detail saat detail itu relevan untuk tugas berikutnya. Active Focus merujuk pada kelanjutan pekerjaan menuju suatu tujuan, termasuk mencoba alternatif saat terhambat dan beradaptasi dengan informasi baru. Ide-ide itu terkait, tetapi menjawab pertanyaan yang berbeda: memori berkaitan dengan konteks apa yang diingat kembali; fokus berkaitan dengan bagaimana pekerjaan berlangsung.
Deskripsi itu adalah klaim kemampuan produk, bukan jaminan bahwa setiap antarmuka atau panggilan API otomatis berbagi riwayat pengguna. Meta menyatakan Muse Wonder tersedia melalui Model API dan Muse Code. Dokumentasi pengembangnya mencantumkan jendela konteks 1.048.576 token dan pengaturan penalaran yang didukung, tetapi jendela konteks adalah jumlah konteks yang dapat dimuat dalam satu permintaan, bukan bukti bahwa permintaan sebelumnya bertahan. Periksa riwayat atau memori apa yang sebenarnya disediakan oleh produk pilihan Anda.
Cara Menjalankan Uji Memori Muse Wonder
Gunakan satu akun dan varian model yang sama sepanjang satu pengujian. Untuk produk obrolan, aktifkan fitur memori yang ingin Anda evaluasi dan catat pengaturannya. Untuk integrasi API, catat apakah aplikasi Anda sendiri menyertakan giliran sebelumnya, profil tersimpan, atau catatan yang diambil dalam permintaan. Tanpa informasi itu, Anda tidak dapat mengatribusikan daya ingat hanya kepada model.
1. Berikan fakta yang relevan
Dalam percakapan pertama, tempelkan profil fiktif ini. Minta hanya konfirmasi, agar model tidak langsung mengubah fakta-fakta itu menjadi rencana.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Buka percakapan yang benar-benar baru di produk yang sama, lalu tanyakan:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Jawaban yang baik menggunakan preferensi untuk aktivitas luar ruang yang tenang. Jawaban itu tidak perlu menyebut anggaran atau makanan laut bercangkang karena tidak ada detail yang diperlukan untuk menyarankan aktivitas. Waspadai preferensi yang dikarang. Jika produk tidak dapat mengakses obrolan sebelumnya atau memori nonaktif, catat “memori tidak tersedia di permukaan ini” alih-alih menilai model seolah-olah ia telah menerima fakta-fakta itu.
2. Koreksi fakta yang sudah kedaluwarsa
Di utas pengujian lain, perkenalkan sebuah janji temu lalu ganti secara eksplisit. Simpan koreksi dalam pesan terpisah agar Anda dapat mengetahui apakah pembaruan yang lebih baru yang menang.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Tanyakan tentang itu di percakapan baru:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Lulus jika jawabannya Kamis pukul 10.00 dan menganggap Selasa sudah kedaluwarsa. Jawaban campuran atau penggunaan Selasa dengan percaya diri adalah kegagalan yang berarti, bahkan jika ia mengingat detail aslinya dengan sempurna.
3. Tambahkan pengalih dan uji apa yang tidak diketahui
Tambahkan dua atau tiga fakta fiktif yang tidak berbahaya ke percakapan awal, seperti warna proyek yang dibuat-buat atau nomor paket fiktif. Setelah jeda, mulai percakapan baru dan ajukan satu pertanyaan tentang preferensi yang relevan plus satu pertanyaan tentang fakta yang tidak pernah Anda berikan. Pisahkan pertanyaan-pertanyaannya agar setiap jawaban mudah dinilai.
Hasil yang kuat menggunakan preferensi yang relevan, tidak menyertakan detail yang tidak terkait, dan mengatakan bahwa ia tidak mengetahui fakta yang hilang. Untuk uji jeda yang lebih ketat, ulangi prompt yang sama keesokan harinya. Sepuluh menit dapat memeriksa batas obrolan baru, tetapi tidak dapat membuktikan retensi selama seminggu.
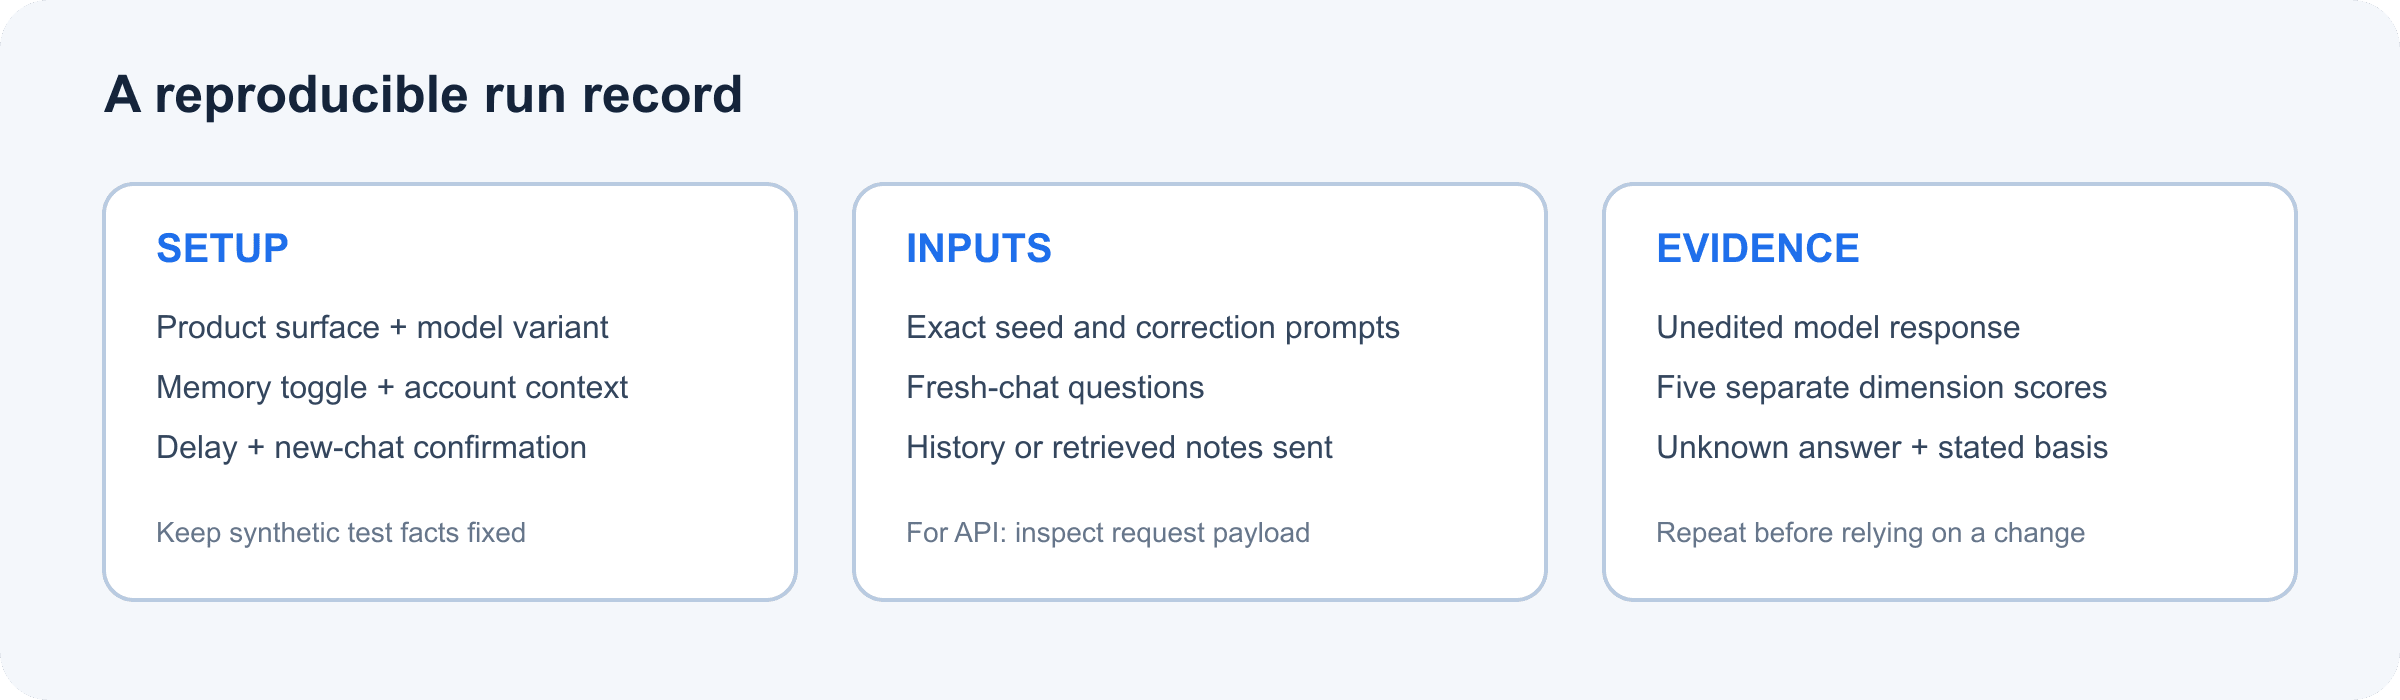
Kartu uji Active Memory Muse Wonder yang menunjukkan penyiapan, pertanyaan obrolan baru, dan bukti yang harus dicatat
Simpan prompt, permukaan produk, pengaturan memori, jeda, dan respons mentah bersama-sama agar peninjau lain dapat mereproduksi pemeriksaan.
Cara Menilai Uji Active Memory
Nilai setiap perilaku dari 0 hingga 2. Gunakan hasilnya untuk membandingkan pengujian dalam alur kerja Anda sendiri, bukan untuk memberi peringkat model secara universal.
| Dimensi | 0 poin | 1 poin | 2 poin |
|---|---|---|---|
| Pengambilan fakta relevan | Melewatkan atau mengarang fakta yang dibutuhkan | Sebagian benar | Memilih fakta yang tepat secara akurat |
| Penanganan koreksi | Menggunakan nilai lama | Samar atau mencampur keduanya | Menggunakan nilai terbaru dan mengidentifikasi nilai lama sebagai kedaluwarsa |
| Kontrol pengalih | Tertarik pada fakta yang tidak relevan | Menyertakan beberapa detail tidak relevan | Hanya menggunakan konteks yang relevan dengan pertanyaan |
| Ketidakpastian | Menebak dengan percaya diri | Berhati-hati tetapi tetap menebak | Dengan jelas mengatakan bahwa jawabannya tidak diberikan |
| Ketertelusuran | Tidak memberikan dasar | Menyebut hanya sebagian dasarnya | Secara singkat mencantumkan konteks yang dijadikannya dasar |
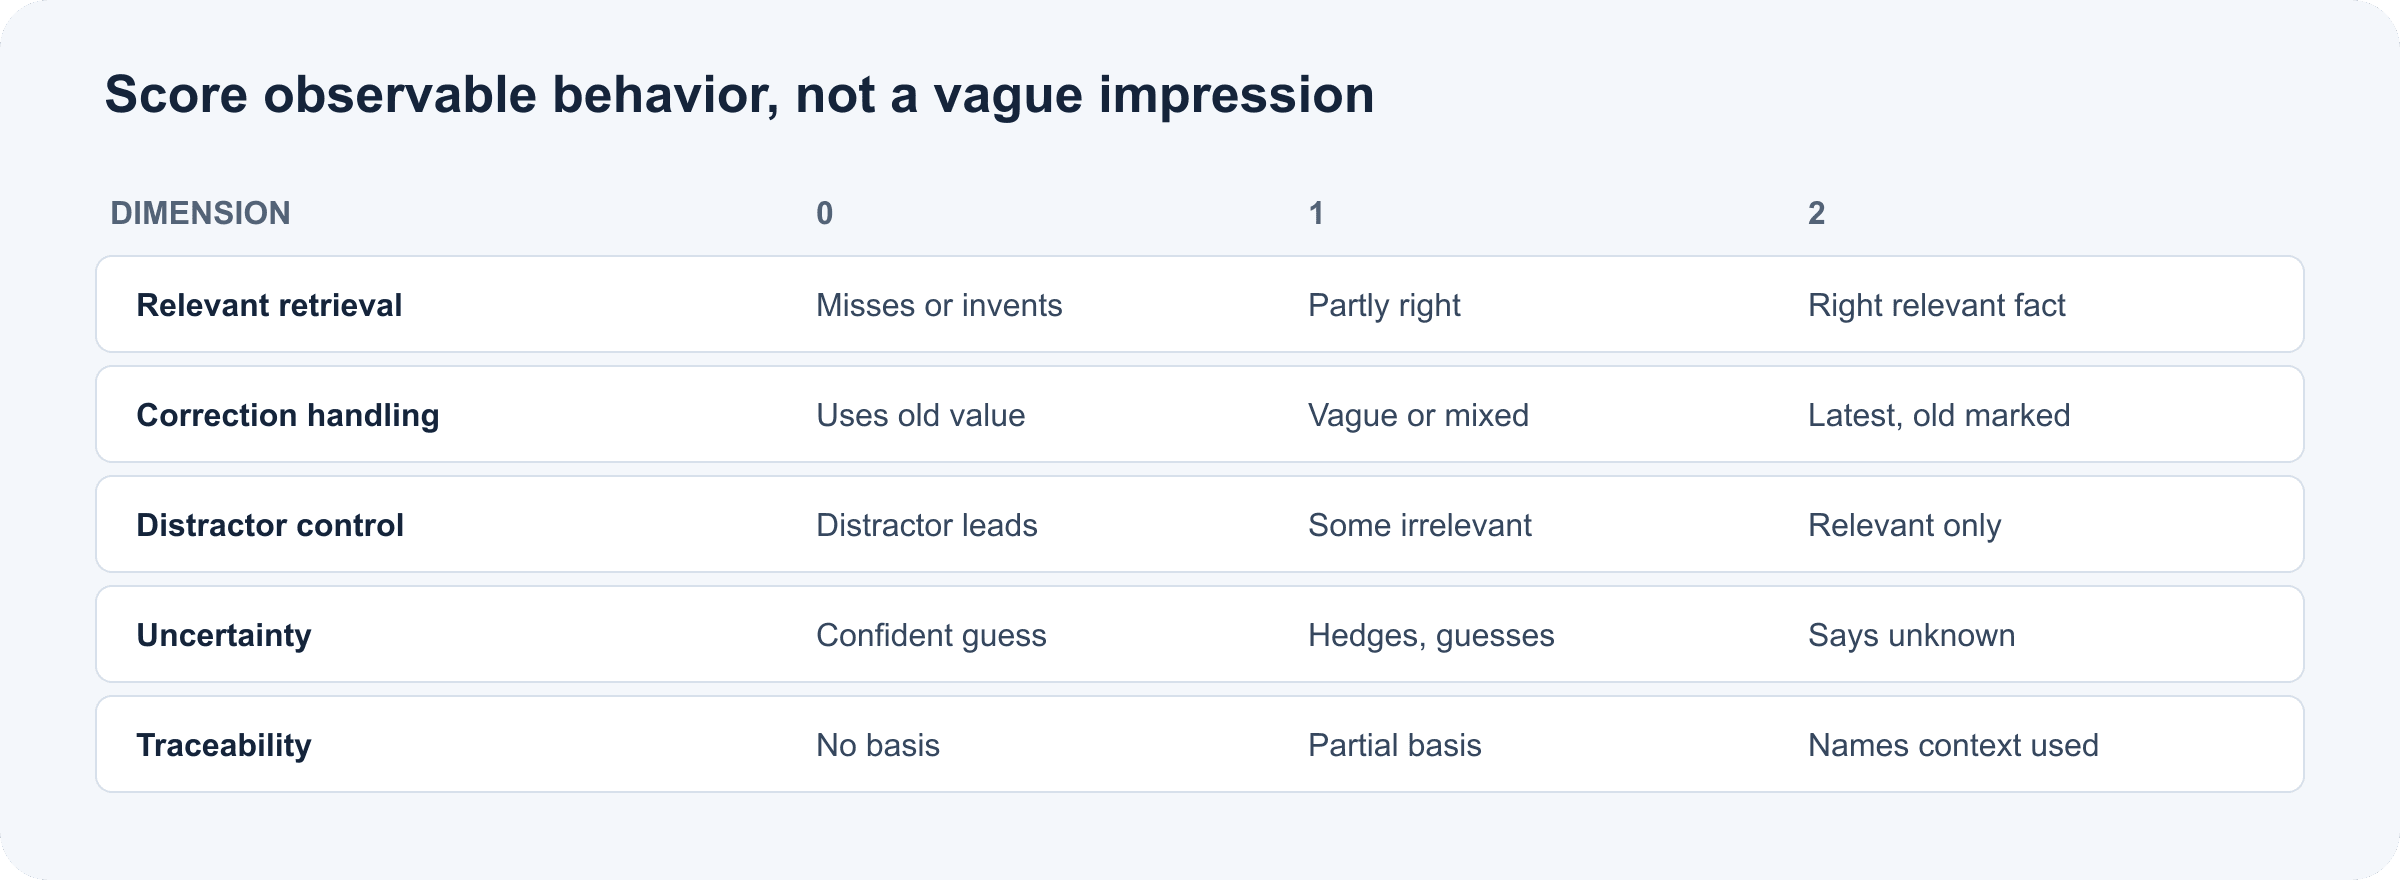
Lima dimensi penilaian Active Memory dari nol hingga dua poin, dengan kriteria lulus yang dapat diamati
Rubrik 0–2 mengubah kesan subjektif menjadi lima pemeriksaan yang dapat diamati.
Sepuluh poin adalah skor internal yang praktis, bukan ambang batas yang tervalidasi. Simpan skor tiap dimensi: total dapat menyembunyikan kegagalan koreksi yang serius di balik daya ingat yang baik di tempat lain. Simpan prompt persis dan output yang belum diedit, lalu ulangi pengujian sebelum mengubah keputusan penerapan Anda.
Apa yang Bisa dan Tidak Bisa Diberitahukan MemoryBench kepada Anda
Kartu model Meta mendeskripsikan MemoryBench sebagai evaluasi internal atas percakapan panjang dan kompleks berukuran 64K hingga 100K token. Tugasnya mencakup banyak fakta, percakapan pengalih, dan giliran yang disisipkan yang bertentangan dengan atau nantinya memperbarui detail target; juri LLM menilai jawaban berdasarkan kriteria berbobot yang spesifik per pertanyaan. Itu konteks yang berguna untuk memahami cakupan benchmark, tetapi tidak sama dengan pengaturan memori pribadi pengguna yang bekerja lintas obrolan.
Kartu model menjelaskan desain tugas; itu tidak mengubah latihan 10 menit ini menjadi replikasi. Skor yang dipublikasikan Meta adalah bukti tentang penyiapan evaluasi yang dilaporkan. Pengujian Anda menjawab pertanyaan operasional yang lebih sempit: apakah permukaan produk, konfigurasi, dan akun tertentu ini mengambil fakta yang dibutuhkan alur kerja Anda? Tidak ada satu pun yang dengan sendirinya membuktikan memori yang andal untuk setiap pengguna atau tugas.
Muse Wonder vs. Muse Wonder Full: Di Mana Menguji
Kedua varian tidak memiliki jalur akses yang identik. Dokumentasi developer Meta saat ini menyatakan Muse Wonder (muse-wonder-1.0) tersedia di Model API dan di Muse Code. Muse Wonder Full hanya tersedia di Muse Code pada paket Power Usage dan Maximum Usage. Menyetel upaya penalaran Muse Wonder ke “max” tidak mengalihkannya ke Wonder Full.
| Varian | Akses terdokumentasi | Apa yang harus dicatat |
|---|---|---|
| Muse Wonder | Model API dan Muse Code | ID model API atau permukaan Muse Code, plus apakah konteks sebelumnya disediakan |
| Muse Wonder Full | Muse Code pada paket Power Usage dan Maximum Usage | Paket, varian yang dipilih, dan pengaturan memori yang tersedia di permukaan tersebut |
Jalankan profil fiktif yang sama secara terpisah di setiap permukaan yang tersedia. Jangan membandingkan uji Muse Code yang dapat mengambil detail profil tersimpan dengan panggilan API stateless yang hanya menerima prompt saat ini. Itu akan membandingkan sistem yang berbeda, bukan sekadar dua varian model.
Privasi dan Pengujian yang Dapat Diulang
Gunakan preferensi, tanggal, dan detail proyek yang dibuat-buat. Sebelum mencoba data nyata, periksa kontrol memori produk, jalur penghapusan, informasi retensi, dan pengaturan penggunaan data. Dokumentasi API Meta menyatakan konten dalam mode Standard tidak digunakan untuk melatih model Meta; Muse Code juga menawarkan mode Contributor, yang aktif secara default dan dapat menggunakan konten untuk pelatihan kecuali dinonaktifkan. Periksa pengaturan dan ketentuan terkini untuk produk yang Anda gunakan alih-alih mengasumsikan semua permukaan menangani data dengan cara yang sama.
Untuk API, pisahkan model dari lapisan memori aplikasi Anda. Basis data, sistem pengambilan, atau riwayat prompt yang dikirim perangkat lunak Anda mungkin yang melakukan pengingatan. Catat apa yang diambil aplikasi dan apa yang diteruskannya ke setiap permintaan, sambil menjaga catatan pengujian tetap sintetis.
Tim dapat mengubah tiga putaran itu menjadi kumpulan evaluasi kecil yang diberi versi. Pertahankan profil fakta, koreksi, pengalih, varian model, pengaturan produk, jeda, dan respons mentah secara tetap. Jalankan ulang setelah konfigurasi atau model berubah dan tinjau kegagalan berdasarkan dimensi. Untuk tim yang sudah membandingkan model terkelola dalam harness yang dapat diulang, Atlas Cloud menyediakan katalog dan panduan API LLM terpadu. Anda dapat menelusuri direktori model untuk perbandingan terpisah. Direktori tersebut saat ini tidak mencantumkan Muse Wonder, dan menggunakan model lain di sana hanya akan menguji konteks yang secara eksplisit diberikan kepada model itu kecuali aplikasi Anda menambahkan lapisan memori.
Pertanyaan yang Sering Diajukan
Bagaimana cara menguji Active Memory Muse Wonder lintas obrolan?
Berikan fakta fiktif dalam satu percakapan, lalu tanyakan detail yang relevan di percakapan baru. Sertakan koreksi dan fakta yang hilang, serta catat permukaan produk dan pengaturan memori.
Apakah Muse Wonder mengingat koreksi atau hanya detail sebelumnya?
Deskripsi MemoryBench milik Meta mencakup giliran yang memperbarui atau bertentangan dengan detail sebelumnya. Uji koreksi Anda sendiri memeriksa apakah penyiapan produk saat ini mengikuti pembaruan; ulangi karena satu hasil tidak membuktikan perilaku yang konsisten.
Apakah uji riwayat obrolan ini sama dengan MemoryBench milik Meta?
Tidak. Meta mendeskripsikan MemoryBench sebagai benchmark konteks panjang internal yang menggunakan percakapan 64K hingga 100K token, pengalih, fakta yang bertentangan atau diperbarui, dan juri LLM. Pemeriksaan singkat ini adalah smoke test praktis, bukan replikasi.
Bisakah saya menguji Active Memory Muse Wonder melalui API?
Anda dapat menguji daya ingat model API terhadap konteks yang sampai ke permintaan. Untuk persistensi lintas permintaan, verifikasi apa yang disimpan dan dikirim oleh API atau aplikasi Anda. Ketersediaan jendela konteks yang besar tidak dengan sendirinya menunjukkan bahwa permintaan terpisah berbagi memori.
Bagaimana cara membedakan memori model dari memori yang disimpan aplikasi?
Periksa permintaan lengkap yang dikirim ke model. Jika aplikasi Anda menyisipkan profil, catatan yang diambil, atau percakapan sebelumnya, lapisan perangkat lunak itulah yang menyediakan memori. Bandingkan dengan pengujian terkontrol yang menghilangkannya, jika sesuai.
Apakah aman menggunakan informasi pribadi dalam uji Active Memory?
Gunakan informasi fiktif untuk pengujian. Jika nanti Anda mengevaluasi data nyata, tinjau dulu pengaturan memori, penghapusan, retensi, dan penggunaan data produk tersebut.
muse wonder active memory test paling berguna ketika mengungkap langkah mana yang gagal: akses ke konteks sebelumnya, pengambilan, koreksi, pemfilteran, atau ketidakpastian. Simpan pengujian mentah, lalu ulangi dengan penyiapan persis yang ingin Anda percayai.
Sumber: Pengumuman Muse Wonder dari Meta (12 Oktober 2026); Dokumentasi model Meta Model API (diakses 15 Oktober 2026); Kartu Model Muse Wonder (Oktober 2026).





