

Keunggulan benchmark bisa tampak meyakinkan sampai model yang sama melewatkan sebuah persyaratan pada eksekusi berikutnya. Uji keandalan Muse Wonder yang berguna mengajukan pertanyaan yang lebih sempit: apakah model menyelesaikan tugas Anda, sesuai standar Anda, secara berulang, dalam kondisi yang sama?
Bukti awal beragam karena pengujian mengukur hal yang berbeda. Satu set tugas pada hari peluncuran memberi Muse Wonder standar skor yang sangat tinggi setelah satu eksekusi per tugas. Evaluasi lain menemukan kekuatan dalam analisis riset sekaligus kelemahan dalam desain survei, klaim penjualan, dan tata letak slide. Tidak ada hasil yang membuktikan seberapa konsisten model akan menangani basis kode atau alur kerja agen Anda.
Poin utama
- Perlakukan benchmark peluncuran sebagai sinyal kemampuan, bukan jaminan produksi.
- Muse Wonder dan Muse Wonder Full adalah varian terpisah. Pisahkan hasilnya.
- Ukur tingkat lulus, keterulangan, penyelesaian, dan pemulihan sebagai hasil yang berbeda.
- Mulai dengan 10 hingga 20 tugas nyata, bekukan pengaturan, dan ulangi tugas penting setidaknya tiga kali.
- Pilih ambang batas berdasarkan biaya jawaban yang salah dan proses tinjauan manusia Anda.
Apakah Muse Wonder andal? Jawaban singkat
Bukti yang tersedia per 15 Oktober 2026 mendukung evaluasi per tugas, bukan putusan keandalan universal. Muse Wonder tampil baik pada beberapa pemeriksaan awal, sementara eksekusi lain mengungkap kesalahan atau pekerjaan presentasi yang masih perlu ditinjau. Studi-studi tersebut berbeda dalam prompt, pengaturan penalaran, penilai, ukuran sampel, dan jumlah percobaan.
(Meta, 12 Oktober 2026) mengatakan Muse Wonder dan Muse Wonder Full dibuat untuk tugas agen profesional dan personal, dengan fitur yang disebutnya Active Memory dan Active Focus. Itu adalah klaim produk tentang perilaku yang dimaksudkan. Klaim bahwa model dapat pulih dari kesalahan adalah alasan untuk menguji pemulihan di alur kerja Anda sendiri, bukan bukti bahwa model akan pulih secara andal.
Pisahkan Wonder standar dari Wonder Full. Meta mencantumkan Muse Wonder standar untuk Model API dan Muse Code-nya, sedangkan Full ditawarkan melalui langganan Muse Code. Menjalankan Wonder standar pada pengaturan penalaran yang lebih tinggi tidak membuatnya menjadi Full.
Untuk keputusan yang dapat Anda pertahankan, uji varian dan rute persis yang ingin Anda terapkan. Hitung tugas sebagai berhasil hanya jika memenuhi aturan penerimaan tertulis dan hasilnya dapat diperiksa.
Apa yang harus diukur oleh uji keandalan Muse Wonder
Akurasi dan konsistensi itu berbeda
Tingkat lulus mengukur berapa banyak percobaan yang memenuhi rubrik yang ditetapkan. Konsistensi mengukur apakah eksekusi berulang dari tugas yang sama menghasilkan hasil yang dapat diterima setiap kali. Model dapat memiliki tingkat lulus yang tinggi tetapi tetap bervariasi dengan cara yang penting bagi alur kerja Anda.
Lacak empat dimensi secara terpisah:
| Ukuran | Apa yang dicatat | Contoh pemeriksaan |
|---|---|---|
| Akurasi | Percobaan yang lulus rubrik | Apakah total yang diekstrak cocok dengan dokumen sumber? |
| Konsistensi | Apakah percobaan berulang lulus dan sepakat | Apakah tiga eksekusi mempertahankan batasan wajib yang sama? |
| Kualitas penyelesaian | Apakah setiap keluaran yang diminta ada | Apakah semua file, kutipan, dan kolom yang diminta disertakan? |
| Pemulihan | Apakah eksekusi dilanjutkan dengan benar setelah gangguan | Apakah ia melaporkan kegagalan alat, mencoba ulang dengan aman, lalu memverifikasi keadaan akhir? |
Respons yang terdengar lengkap belum tentu lengkap. Perubahan kode memerlukan pengujian; ringkasan riset memerlukan sumber yang dapat dilacak; eksekusi agen memerlukan bukti bahwa tindakan akhirnya benar-benar terjadi.
Pisahkan kegagalan model dari kegagalan alur kerja
Catat konteks yang cukup untuk membedakan kesalahan model dari masalah layanan atau alat. Minimal, catat varian dan versi model, pengaturan penalaran, prompt, konfigurasi alat, tanggal, waktu eksekusi, biaya token atau tugas, dan keluaran mentah.
Klasifikasikan kegagalan sebelum menilainya:
- Model: fakta salah, penalaran buruk, atau persyaratan terlewat.
- Alat: panggilan API gagal, argumen alat tidak valid, atau hasil salah dari sistem eksternal.
- Layanan: timeout, gangguan, atau endpoint tidak tersedia.
- Evaluasi: rubrik tidak jelas atau pemeriksaan yang tidak dapat membedakan pekerjaan yang dapat diterima dari yang tidak.
Jika Anda menggabungkan keempatnya menjadi satu tingkat kegagalan, Anda tidak akan tahu apa yang harus diperbaiki.
Apa yang ditunjukkan pengujian Muse Wonder saat ini
Perbandingan benchmark yang diterbitkan Meta adalah bukti vendor tentang performa benchmark. Itu tidak sama dengan evaluasi alur kerja yang dijalankan secara independen. Pengujian independen juga memiliki batas: set tugas publik yang kecil, satu percobaan, rute model tertentu, atau penilaian preferensi manusia hanya menjawab pertanyaan yang sempit.
Tabel di bawah memisahkan bukti berdasarkan sumber dan cakupan. Ini adalah panduan tentang apa yang dapat didukung setiap hasil, bukan skor gabungan.
| Sumber bukti | Apa yang diuji | Tanggal dan pengaturan | Apa yang dapat diberitahukannya kepada Anda | Batasan utama |
|---|---|---|---|---|
| Pengumuman Meta dan materi model | Benchmark kemampuan dan fitur agen yang dimaksudkan | Diumumkan 12 Oktober 2026; perbandingan yang dilaporkan vendor | Kemampuan mana yang ditekankan Meta dan varian mana yang dirilisnya | Pengujian vendor tidak menetapkan keterulangan di alur kerja Anda |
| (Spring Prompt, 13 Oktober 2026) | Survei, daftar produk, slide, perencanaan iklan, catur, dan pencarian visual | 13 Oktober; model API standar, umumnya penalaran sedang; tugas publik | Performa bervariasi menurut tugas; beberapa evaluasi mencakup eksekusi daftar produk berulang | Sebagian besar tugas adalah sampel kecil; banyak hasil berupa satu eksekusi per tugas; bukan pengujian coding atau Muse Code |
| (Quantslant, 12 Oktober 2026) | 23 tugas yang mencakup agen, coding, penulisan, penalaran, dan satu dokumen panjang | 12 Oktober; model standar melalui OpenRouter, penalaran rendah; satu eksekusi per tugas | Model lulus set tugas yang ditetapkan itu pada tingkat tinggi dalam pengaturan tersebut | Satu eksekusi tidak dapat mengukur konsistensi antar-eksekusi; hasil mendekati 100% perlu pemeriksaan tingkat tugas |
| Postingan komunitas | Reaksi individu terhadap coding, agen, dan benchmark | Postingan periode peluncuran; pengguna dan tugas yang memilih sendiri | Petunjuk berguna untuk pengujian berikutnya | Anekdot dan suara bukan tingkat lulus yang terukur |
Kontras sumbernya penting. Quantslant melaporkan 99,7% pada set 23 tugasnya, dengan satu eksekusi per tugas dan pengaturan penalaran rendah. Pihaknya juga mencatat satu unit test yang gagal dalam tugas coding number-to-words. Hasil itu adalah bukti tentang suite tertentu tersebut, bukan bukti bahwa 99,7% tugas sehari-hari akan lulus atau bahwa eksekusi berulang akan sepakat.
Spring Prompt melaporkan gambaran yang lebih beragam untuk Wonder standar pada default API tanggal 13 Oktober. Skor analisis risetnya adalah 93,6/100 pada sembilan tugas publik, sementara hanya tiga dari sembilan rencana survei yang lulus semua pemeriksaan. Untuk daftar produk, proporsi yang dinilai andal siap terbit pada tiga pengulangan adalah 66,1% untuk brief faktual dan 51,8% untuk brief penjualan. Lima dari enam dek slide memerlukan perbaikan tata letak, dan satu dinilai layak tampil. Ini adalah ukuran terpisah dengan penyebut terpisah, bukan bagian dari satu skor keseluruhan.
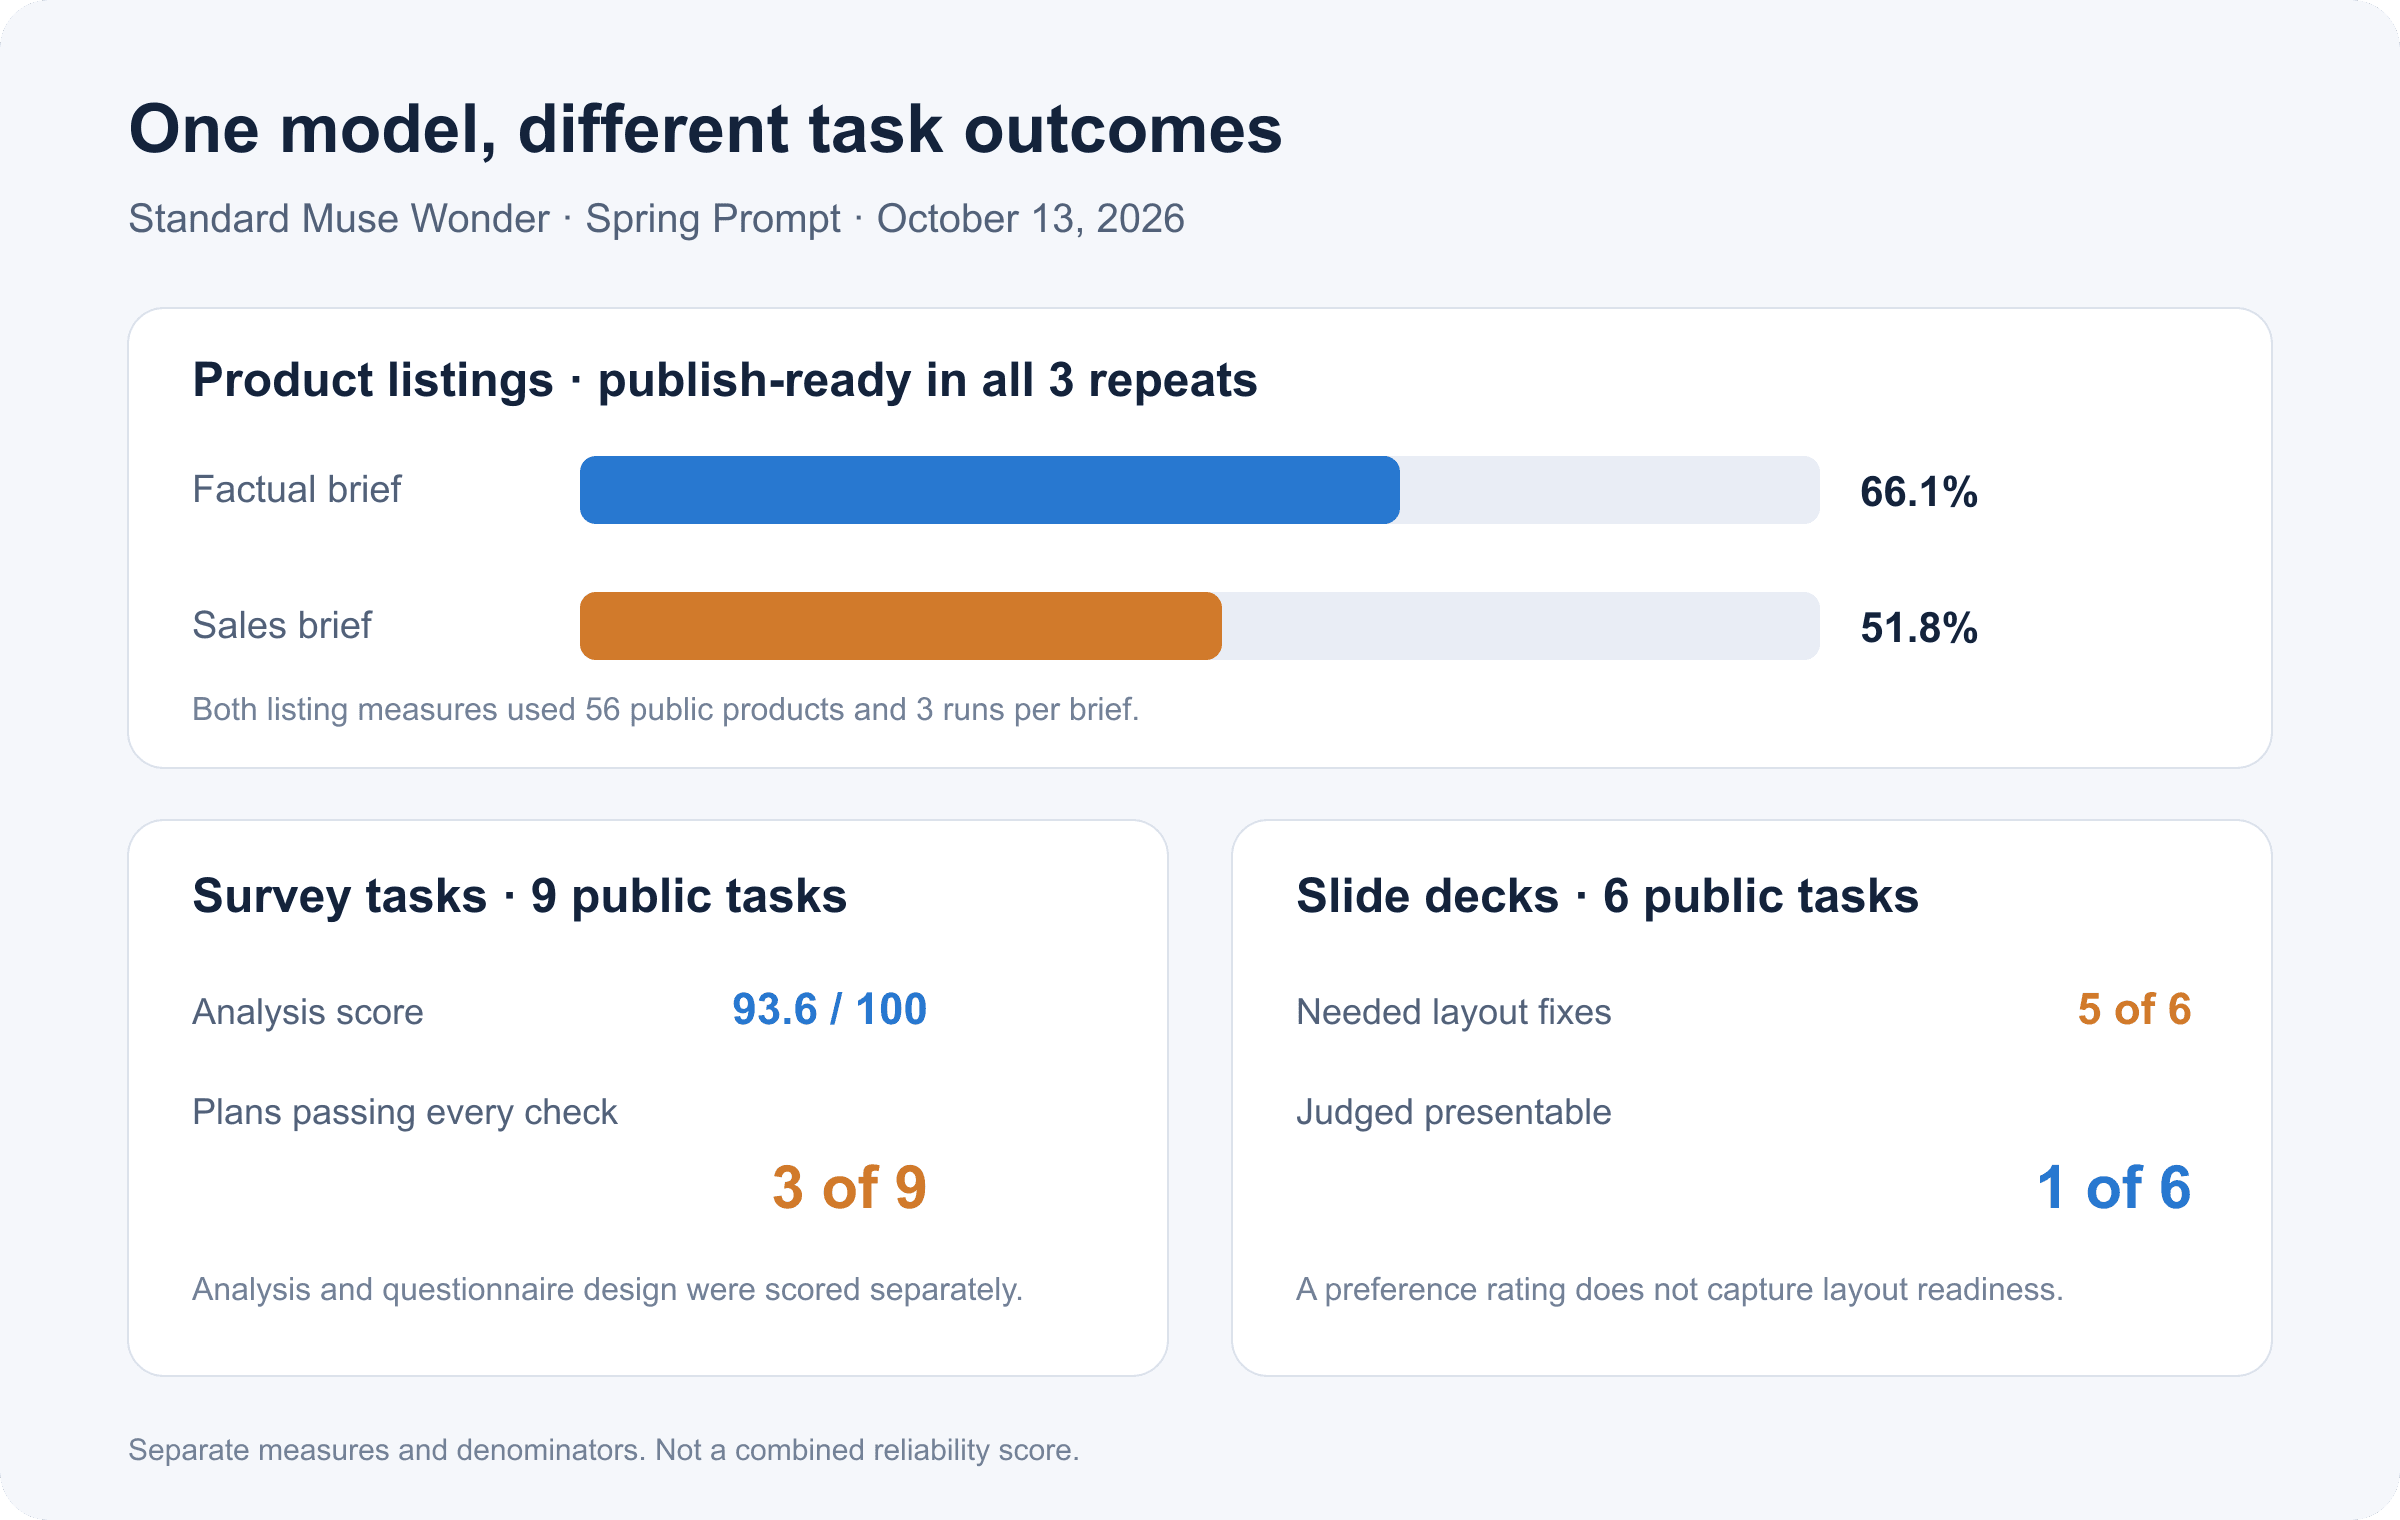
Hasil Muse Wonder standar Spring Prompt 13 Oktober 2026: tingkat lulus daftar produk yang diuji berulang, hasil analisis survei dan tinjauan dek
Hasil tugas independen dari satu evaluasi. Ukuran menggunakan penyebut berbeda dan ditampilkan terpisah, bukan digabungkan menjadi satu skor.
Pengujian Spring Prompt tidak mengukur coding, memori persisten, atau Muse Code. Karena itu, perbandingannya tidak dapat memastikan apakah Wonder andal untuk coding atau apakah Full berperforma lebih baik. Ini menunjukkan mengapa satu label luas menyembunyikan perbedaan tugas yang penting.
Artikel peluncuran Meta mengatakan Muse Wonder standar tersedia melalui Meta Model API dan Muse Code, sedangkan Wonder Full tersedia bagi pelanggan Muse Code. Artikel itu menjelaskan Active Memory dan Active Focus sebagai fitur untuk mempertahankan detail berguna dan melanjutkan pekerjaan melewati kesalahan. Deskripsi tersebut membantu menentukan kasus uji, tetapi artikel peluncuran bukan studi eksekusi berulang yang independen.
Untuk klaim coding dan pembuatan 3D yang dibahas di thread komunitas minggu peluncuran, perlakukan postingan sebagai hipotesis. Ubah keluhan spesifik menjadi tugas yang dapat direproduksi dan verifikasi keluarannya. Jangan mengubah komentar atau upvote menjadi tingkat keberhasilan.
Cara menjalankan uji keandalan Muse Wonder yang dapat diulang
1. Susun set tugas kecil dari pekerjaan nyata
Pilih 10 hingga 20 tugas yang benar-benar diharapkan tim Anda ditangani model. Bagi ke dalam kategori seperti coding, ekstraksi faktual, mengikuti instruksi, konteks panjang, dan penggunaan alat. Utamakan tugas dengan pengujian objektif, jawaban referensi, atau rubrik yang jelas.
Sertakan kasus tepi yang realistis: input hilang, persyaratan yang bertentangan, alat yang tidak tersedia, dan tugas yang seharusnya memicu pertanyaan klarifikasi. Jangan sertakan data sensitif atau teregulasi kecuali proses yang disetujui mengizinkannya.
2. Bekukan prompt, model, dan pengaturan
Tuliskan prompt dan instruksi sistem secara persis. Catat nama dan versi model, tingkat penalaran, alat, konteks yang diberikan, tanggal, dan batas waktu apa pun. Jangan membandingkan Wonder standar dengan Full seolah-olah keduanya model yang sama.
Prompt pengujian yang berguna dapat meminta model menunjukkan buktinya dan mengidentifikasi persyaratan yang tidak dapat diuji:
Baca spesifikasi dan implementasi terlampir. Kembalikan hanya: (1) setiap persyaratan yang ditandai LULUS, GAGAL, atau TIDAK DAPAT DIUJI; (2) bukti persis untuk setiap status; (3) persyaratan yang hilang, jika ada; (4) pengujian minimal yang dapat direproduksi untuk setiap GAGAL. Jangan klaim pengujian lulus kecuali Anda dapat menunjukkan keluarannya.
Ini adalah input evaluasi, bukan jaminan bahwa model akan mengikutinya. Nilai jawaban yang dihasilkan dan verifikasi setiap keluaran pengujian yang diklaim secara independen.
3. Ulangi tugas dan nilai setiap percobaan
Jalankan setiap tugas berdampak tinggi setidaknya tiga kali dengan pengaturan yang sama. Jika anggaran hanya memungkinkan satu percobaan, beri label hasilnya sebagai sampel awal, bukan hasil konsistensi. Simpan setiap respons mentah; jangan laporkan hanya yang terbaik.
Gunakan satu baris untuk setiap percobaan. Pertahankan aturan penerimaan tetap stabil di seluruh eksekusi.
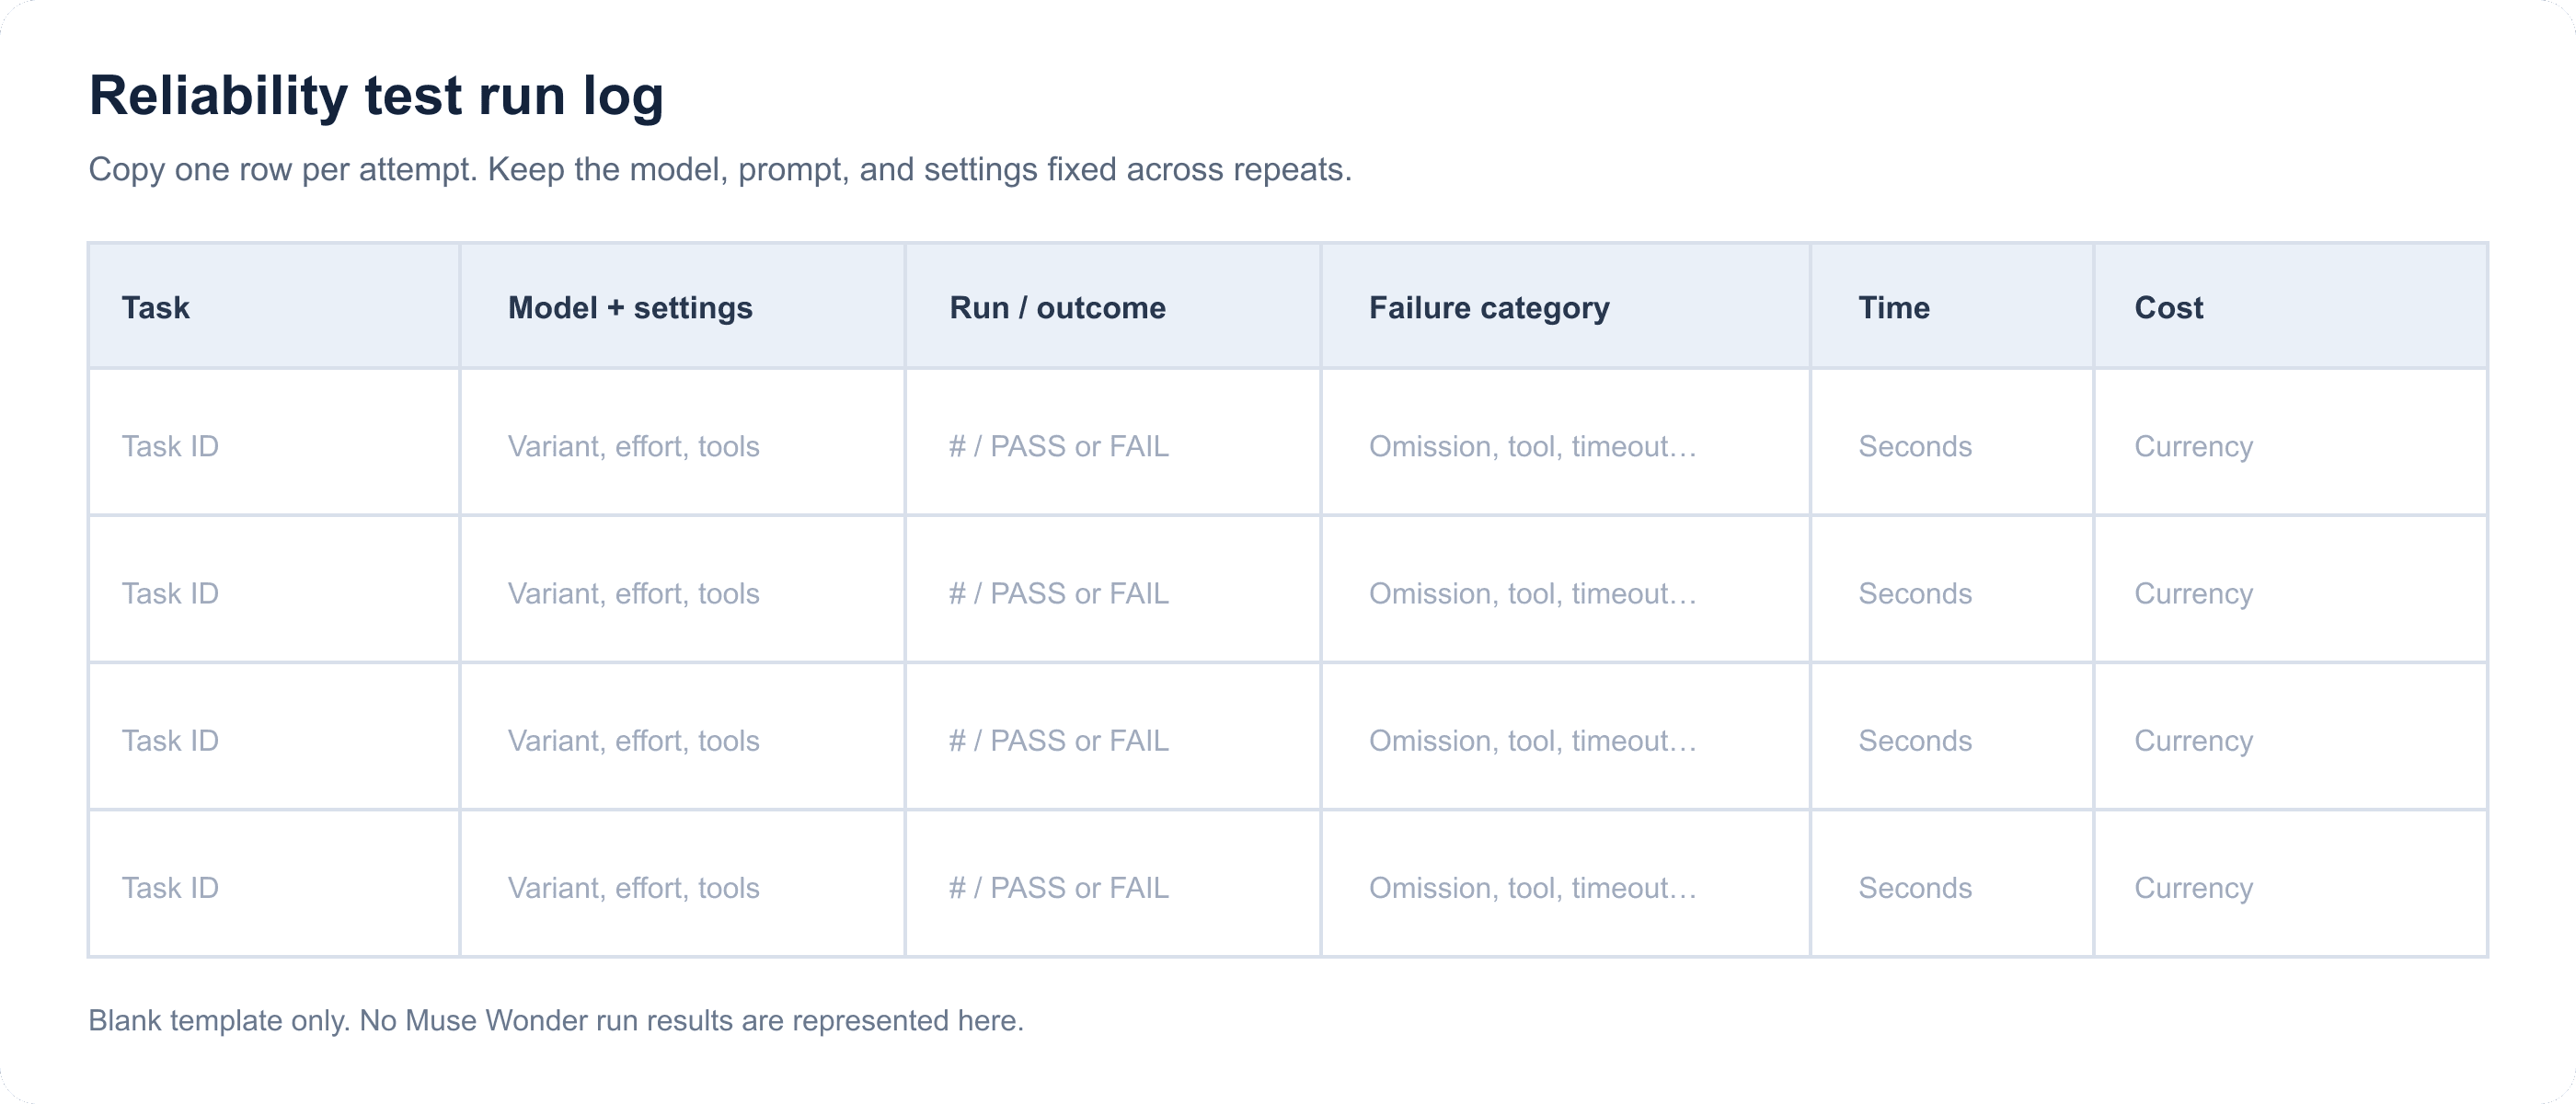
Log uji keandalan Muse Wonder kosong yang menunjukkan kolom untuk tugas, model, eksekusi, hasil, kesalahan, waktu, dan biaya
Templat catatan kosong yang dapat digunakan kembali. Isi satu baris per percobaan; templat ini tidak berisi hasil Muse Wonder yang diukur.
4. Simpan log kegagalan dan verifikasi pemulihan
Gunakan kategori spesifik: kesalahan faktual, penghilangan, pengujian kode gagal, kesalahan alat, timeout, klaim penyelesaian yang tidak didukung, atau ketidakcocokan format. Untuk pekerjaan bertahap, catat di mana eksekusi berhenti dan apakah percobaan ulang mengulangi tindakan yang sudah selesai atau memverifikasi keadaan akhir.
Agen yang mengatakan “selesai” tanpa bukti belum lulus pemeriksaan penyelesaian. Wajibkan hasil pengujian, file tersimpan, kutipan sumber, atau keadaan terverifikasi yang cocok dengan tugas.
5. Tetapkan ambang batas keputusan berdasarkan biaya kegagalan
Tidak ada batas tingkat lulus universal yang berguna. Draf yang diperiksa seseorang baris demi baris memiliki profil risiko yang berbeda dari migrasi database atau pembayaran otomatis.
Tetapkan ambang batas dari tiga faktor:
- Seberapa berbahaya atau mahal hasil yang salah?
- Dapatkah seseorang menangkap kesalahan sebelum memengaruhi siapa pun?
- Apakah alur kerja gagal dengan aman, dengan penghentian yang jelas dan jejak audit?
Untuk draf berisiko rendah, tinjauan mungkin cukup. Untuk perubahan kode, keuangan, hukum, kesehatan, atau tindakan yang memengaruhi pengguna, gunakan pengujian yang lebih kuat dan verifikasi independen. Jangan biarkan rata-rata tinggi menyembunyikan satu mode kegagalan yang parah.
Keandalan Muse Wonder berdasarkan jenis tugas
Coding dan pembuatan bertahap
Jalankan suite pengujian repositori yang sebenarnya dan periksa perilaku yang diminta. Nilai cakupan persyaratan, kegagalan regresi, dan apakah perubahan yang diklaim model cocok dengan file serta keluaran pengujian. Rekaman layar atau penjelasan yang meyakinkan bukan pengganti pemeriksaan yang dapat dieksekusi.
Suite Quantslant awal mencakup empat tugas coding dan melaporkan 15 dari 16 unit test lulus pada satu tugas number-to-words. Itu adalah sinyal kecil dari satu eksekusi. Spring Prompt secara eksplisit tidak menguji coding, jadi temuannya tidak boleh digunakan untuk menggeneralisasi keandalan agen coding.
Riset dan ekstraksi faktual
Gunakan paket sumber atau jawaban referensi yang dapat diperiksa peninjau Anda. Periksa setiap klaim faktual terhadap sumber primer, dan lacak kutipan yang dibuat-buat serta atribusi yang salah secara terpisah dari kualitas jawaban secara umum.
Analisis survei Spring Prompt merupakan kekuatan relatif dalam evaluasi kecilnya, tetapi desain pertanyaan survei lebih lemah. Skor analisis yang tinggi tidak boleh secara diam-diam mensertifikasi instrumen survei atau sumber di balik tugas riset baru.
Konteks panjang dan alur kerja agen
Periksa apakah model mempertahankan setiap batasan, menggunakan setiap alat dengan benar, dan memverifikasi keadaan akhir. Uji pemulihan gangguan secara sengaja: hentikan eksekusi setelah langkah yang diketahui, lalu lihat apakah ia melanjutkan dari checkpoint atau mengulangi efek samping.
Pengumuman Meta menjelaskan kemampuan memori dan pemulihan, tetapi evaluasi awal publik yang dikutip di sini tidak menetapkan konsistensi jangka panjang untuk memori persisten atau pemulihan agen. Ukur perilaku tersebut secara langsung sebelum mengandalkannya.
Muse Wonder vs. Muse Wonder Full: pisahkan bukti
Muse Wonder dan Muse Wonder Full adalah varian yang berbeda. Informasi peluncuran Meta menjelaskan rute akses yang terpisah, dan pengujian API independen terhadap Wonder standar tidak menjadi hasil Full hanya karena pengaturan penalaran berubah.
| Pertanyaan perbandingan | Apa yang didukung bukti yang tersedia |
|---|---|
| Apakah Full sama dengan Wonder standar pada penalaran maksimum? | Tidak. Perlakukan keduanya sebagai varian berbeda dan catat nama persisnya. |
| Apakah evaluasi API Spring Prompt yang dikutip menguji Full? | Tidak. Itu menguji Wonder standar; Full berada di luar perbandingan tersebut. |
| Dapatkah angka API standar yang dikutip memberi peringkat Full? | Tidak. Itu tidak menguji Full. |
| Apa yang akan membuat perbandingan yang adil? | Set tugas, rubrik penilaian, jendela tanggal, akses alat, dan pengaturan yang terdokumentasi yang sama, dengan pengulangan untuk kedua varian. |
Perbandingan yang adil dimulai dengan tugas berpasangan dan kondisi yang cocok. Jika rute akses memberlakukan prompt, alat, atau penagihan yang berbeda, dokumentasikan perbedaan tersebut dan sebut perbandingannya sebagai eksploratif.
Biaya, akses, dan tempat menguji Muse Wonder
Bandingkan biaya per tugas yang diterima, bukan hanya harga yang tercantum per token. Prompt panjang, percobaan ulang, token penalaran, panggilan alat, timeout, dan tinjauan manusia semuanya mengubah biaya hasil yang dapat digunakan. Quantslant melaporkan tarif token Wonder standar sebagai $4 per juta token input dan $20 per juta token output pada 12 Oktober 2026, dan eksekusi 23 tugasnya sendiri menghabiskan $0.64. Itu adalah satu rute dan beban kerja yang dilaporkan, bukan harga tugas universal.
Pengumuman peluncuran Meta saat ini mencantumkan Wonder standar melalui Meta Model API dan Muse Code, dan Full melalui langganan Muse Code. Konfirmasi akses, kelayakan regional, dan penagihan saat ini di antarmuka resmi sebelum menganggarkan.
Mulai dari Atlas Cloud untuk gambaran yang lebih luas tentang platform pengembangnya. Per 15 Oktober 2026, saya tidak dapat mengonfirmasi Muse Wonder di katalog model, jadi artikel ini tidak menyajikan Atlas Cloud sebagai rute eksekusi untuk model ini. Jika tim Anda membandingkan model lain yang sudah tercantum di sana, pustaka model Atlas Cloud dapat membantu Anda mengidentifikasi kandidat untuk dijalankan terhadap set tugas yang sama.
Hasil yang berguna dari uji keandalan Muse Wonder adalah keputusan penerapan yang terikat pada bukti: tugas mana yang lulus, seberapa sering lulus, berapa biayanya, dan tinjauan apa yang masih diperlukan.
Pertanyaan yang Sering Diajukan
Apakah Muse Wonder andal untuk coding?
Pengujian peluncuran awal hanya memberikan sampel coding yang kecil. Quantslant melaporkan empat tugas coding, dengan satu unit test meleset pada satu tugas, sementara Spring Prompt tidak menguji coding. Jalankan pengujian repositori pada tugas Anda sendiri dan ulangi tugas penting sebelum membuat keputusan alur kerja coding.
Bagaimana cara menguji keandalan Muse Wonder sendiri?
Gunakan set tugas nyata yang tetap, pertahankan pengaturan model dan prompt secara persis, tentukan kriteria lulus di muka, dan simpan setiap keluaran. Ulangi tugas penting dan verifikasi hasil dengan pengujian atau dokumen sumber.
Berapa kali saya harus mengulangi setiap tugas Muse Wonder?
Gunakan setidaknya tiga eksekusi untuk tugas berdampak tinggi sebagai pemeriksaan konsistensi awal. Tiga percobaan tetap merupakan sampel kecil, jadi perluas setnya ketika kesalahan mahal atau keluarannya bervariasi.
Apa perbedaan antara Muse Wonder dan Muse Wonder Full?
Keduanya adalah varian model terpisah dengan rute ketersediaan yang berbeda. Jangan perlakukan Wonder standar pada penalaran maksimum sebagai Full, atau memindahkan hasil di antara keduanya tanpa pengujian yang cocok.
Dapatkah saya memercayai skor benchmark Muse Wonder dari Meta?
Gunakan itu sebagai bukti kemampuan yang dilaporkan vendor dan baca pengaturan benchmark-nya. Itu tidak membuktikan performa yang konsisten di seluruh prompt, alat, dan eksekusi berulang Anda.
Apakah Muse Wonder tersedia di Atlas Cloud?
Saya tidak dapat memverifikasinya di katalog model Atlas Cloud per 15 Oktober 2026. Periksa katalog langsung sebelum memilih penyedia eksekusi.





