

Suara bisa terdengar seolah seseorang menahan tangis sementara wajah animasi tetap netral. Dengan OmniHuman 2.0 emotional voice and facial expression matching, perbaikan pertama sering kali adalah mendengarkan lebih saksama, bukan menambahkan lebih banyak kata sifat. Audio sudah membawa kata, waktu, dan penekanan vokal; prompt singkat harus mengarahkan penampilan yang terlihat yang mendukung isyarat tersebut.
Panduan ini memberi kreator cara yang dapat diulang untuk menyiapkan potret dan trek, menulis prompt yang terarah, dan meninjau hasil untuk ketidakcocokan yang berarti. Ini mencakup ucapan dan nyanyian, sekaligus memisahkan informasi terdokumentasi dari panduan pihak ketiga dan klaim produk yang belum terverifikasi.
Poin utama
- Perlakukan audio sebagai fondasi penampilan dan arahkan hanya tindakan yang terlihat, pembingkaian, dan detail adegan.
- Tandai ketukan emosional sebelum memberi prompt, lalu periksa momen yang sama dengan suara dimatikan dan dinyalakan.
- Ubah satu variabel per percobaan ulang; prompt tidak dapat memperbaiki setiap masalah audio sumber atau generasi.
Bagaimana OmniHuman 2.0 menghubungkan audio, ekspresi wajah, dan gerakan
Cara yang berguna untuk memikirkan model potret yang digerakkan audio adalah dengan memberi setiap input suatu tugas. Gambar menjadi jangkar subjek yang terlihat. Rekaman menyediakan ucapan atau lagu, termasuk waktu dan penyampaiannya. Arahan teks opsional dapat menggambarkan penampilan atau adegan. Perilaku dan kontrol yang tepat dapat bervariasi menurut implementasi produk, jadi jangan anggap riset OmniHuman umum atau instruksi studio pihak ketiga sebagai spesifikasi resmi OmniHuman 2.0.
Riset OmniHuman-1 yang asli menjelaskan animasi manusia yang dikondisikan pada kombinasi gambar, teks, audio, dan pose. Makalah itu menetapkan kerangka yang lebih luas dari keluarga riset ini, bukan antarmuka, batas, atau kualitas pasti OmniHuman 2.0 (ICCV 2025, makalah OmniHuman-1).
| Input | Kontribusi yang mungkin | Apa yang dapat Anda siapkan |
|---|---|---|
| Potret referensi | Penampilan subjek dan pose awal | Pilih wajah yang jelas dan pembingkaian yang sesuai dengan gerakan yang diinginkan |
| Audio yang diucapkan atau dinyanyikan | Kata, irama, jeda, energi vokal | Gunakan trek bersih dengan penyampaian yang disengaja dan potong keheningan yang tidak relevan |
| Prompt arahan opsional | Tindakan yang terlihat, pembingkaian, adegan, atau isyarat suasana | Berikan beberapa arahan konkret yang selaras dengan rekaman |
Sinkronisasi bibir dan penampilan emosional saling terkait, tetapi keduanya bukan pemeriksaan kualitas yang sama. Mulut dapat mengikuti suku kata sementara mata, kepala, atau gerakan terasa salah untuk dialog tersebut. Demikian pula, wajah mungkin tampak ekspresif sementara waktunya melenceng dari suara. Tinjau keduanya.
Panduan OmniHuman 2.0 pihak ketiga menjelaskan alur kerja gambar plus audio dengan arahan teks opsional, tetapi halaman-halaman itu bukan dokumentasi teknis BytePlus. Dokumentasi Atlas yang dapat diakses publik mencakup model Avatar Omni Human 1.5 miliknya sendiri, bukan OmniHuman 2.0. Karena itu, asumsi kerja yang paling aman bersifat praktis, bukan mutlak: biarkan audio menyarankan apa yang dibutuhkan penampilan, dan gunakan prompt untuk meminta pilihan visual yang dapat Anda periksa.
Pilih potret dan trek audio yang membuat emosi mudah dibaca
Model tidak dapat bertindak berdasarkan isyarat yang sulit dilihat atau didengar. Mulailah dengan input yang memberinya tugas yang adil dan sederhana, lalu pertahankan input itu tetap sama saat Anda menguji kata-kata prompt.
| Input awal | Mengapa ini dapat membantu | Komplikasi yang perlu diwaspadai |
|---|---|---|
| Wajah tajam dan tidak terhalang dengan pencahayaan merata | Membuat fitur wajah mudah dibaca | Bayangan kuat, rambut, tangan, atau properti dapat menutupi area penting |
| Pose awal netral atau sedikit ekspresif | Memberi ruang bagi penampilan untuk berubah | Ekspresi tetap yang kuat dapat bertentangan dengan suasana vokal yang berbeda |
| Satu suara latar depan yang jelas | Membuat ucapan dan jeda lebih mudah diikuti | Musik, kebisingan ruangan, atau pembicara yang tumpang tindih dapat menutupi isyarat |
| Frasa yang disengaja dengan jeda yang terdengar | Memberi Anda momen untuk dipetakan ke tindakan yang terlihat | Penyampaian datar mungkin menawarkan lebih sedikit perubahan emosional yang jelas |
| Lagu yang mengutamakan vokal dengan frasa yang jelas | Membuat kata yang dinyanyikan dan dinamika lebih mudah diidentifikasi | Bagian instrumental memberikan lebih sedikit isyarat vokal untuk gerakan mulut |
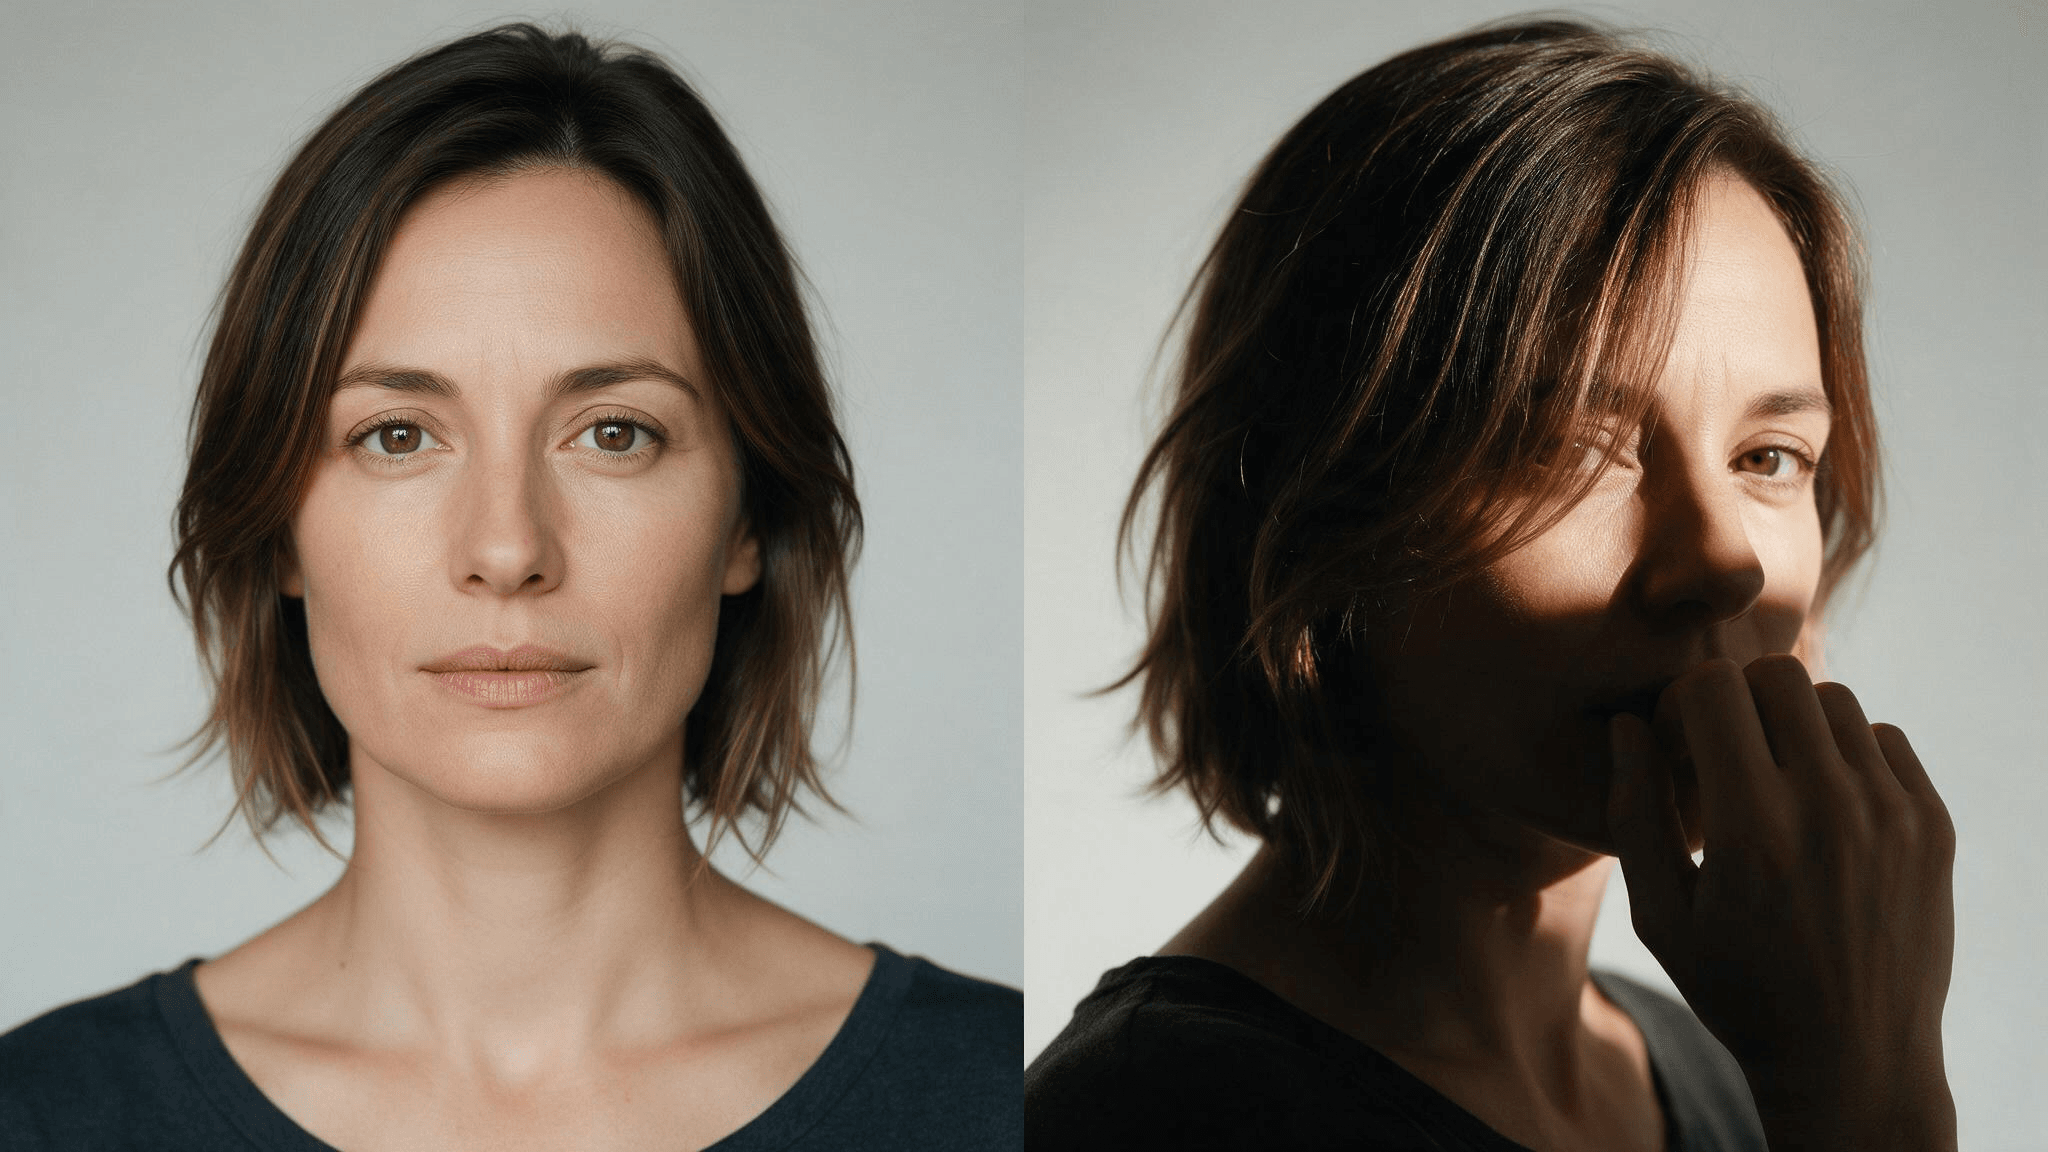 Perbandingan potret ilustratif: tampilan depan yang jelas membuat isyarat wajah lebih mudah diperiksa daripada tampilan yang berbayang dan sebagian terhalang. Ini bukan perbandingan keluaran model.
Ini adalah pemeriksaan produksi, bukan jaminan. Input yang baik tetap dapat menghasilkan take yang lemah, dan potret yang ekspresif secara visual tidak menjamin animasi yang koheren. Untuk pengujian pertama, gunakan satu potret, satu bagian audio pendek, dan satu prompt. Hindari mengubah crop, rekaman, dan arahan secara bersamaan; jika tidak, Anda tidak akan tahu penyesuaian mana yang membantu.
Untuk nyanyian, dengarkan akhir frasa, nada yang ditahan, dan perubahan intensitas. Prompt dapat mengarahkan kemiringan kepala atau gerakan tangan di sekitar ketukan musik, tetapi tidak boleh mengulang lirik yang sudah ada dalam rekaman. Untuk dialog yang diucapkan, tandai jeda dan kata yang ditekankan. Prompt yang meminta perubahan suasana hati besar selama kalimat tenang yang berkelanjutan dapat menciptakan penampilan yang terasa dipaksakan.
Kerangka prompt untuk mencocokkan suara dan ekspresi wajah
Jaga arahan cukup singkat untuk dievaluasi. Struktur yang praktis adalah:
Pembingkaian + pembicara dan penyampaian + emosi yang konsisten dengan trek + satu atau dua tindakan yang terlihat + arahan kamera opsional.
Misalnya, jika pembicara terdengar hangat dan tenang, Anda dapat menulis:
Media close-up statis. Wanita itu berbicara dengan hangat ke kamera, dimulai dengan tenang dan membiarkan senyum kecil muncul di baris terakhir. Dia mengangguk lembut satu kali setelah jeda. Jaga pembingkaian tetap stabil.
Ini adalah prompt ilustratif, bukan hasil OmniHuman 2.0 yang dilaporkan. Fitur bergunanya adalah setiap instruksi dipetakan ke sesuatu yang terlihat: bidikan tetap stabil, ekspresi berubah menjelang akhir, dan anggukan memiliki isyarat. Anda dapat membandingkan hasilnya dengan trek alih-alih menilai permintaan luas seperti “jadilah emosional.”
Panduan prompt pihak ketiga merekomendasikan arahan bahasa alami yang ringkas dan mencocokkan emosi yang diminta dengan suara. Perlakukan itu sebagai heuristik praktis, bukan jaminan atau aturan produk resmi (panduan prompt KreatorFlow).
Sebelum menggunakan prompt, periksa terhadap rekaman:
- Jika suara pelan dan tertahan, minta ekspresi halus alih-alih seringai lebar.
- Jika penyampaian menjadi lebih percaya diri, letakkan perubahan yang terlihat setelah pergeseran yang terdengar.
- Jika rekaman berisi tawa, jeda, atau desahan, putuskan apakah wajah harus bertahan, bereaksi, atau bergerak pada titik itu.
- Jika potret awal sudah menunjukkan ekspresi yang diinginkan, hindari mendeskripsikannya lagi kecuali Anda ingin ekspresi itu berubah.
Gunakan kata temporal seperti “pertama,” “lalu,” dan “akhirnya” hanya ketika audio memiliki ketukan yang jelas. Hindari menumpuk instruksi yang bertentangan seperti “pembingkaian statis” dan “kamera mengorbit,” atau “tenang” dan “geram.” Prompt adalah arahan untuk penampilan yang sudah ada, bukan pengganti trek suara.
Tiga pola prompt untuk ucapan, perubahan emosional, dan nyanyian
Pilih pola terkecil yang sesuai dengan audio Anda. Contoh-contoh ini adalah templat untuk disesuaikan, bukan klaim keluaran yang terverifikasi.
Penjelasan tenang
Media close-up stabil. Pembicara menjelaskan poin dengan tenang, dengan ekspresi terkendali dan satu gerakan penekanan kecil. Jaga kamera tetap diam.
Gunakan ini ketika trek terukur dan konsisten. Satu gerakan dapat membuat penekanan terlihat tanpa mengubah penjelasan lugas menjadi penampilan teatrikal.
Perubahan emosi
Close-up statis. Pembicara memulai dengan serius, lalu melembut menjadi senyum kecil setelah jeda sebelum kalimat terakhir. Jaga gerakan tetap tertahan.
Gunakan ini hanya ketika rekaman berisi jeda atau perubahan yang terdengar yang mendukung pergeseran tersebut. Jika tidak ada isyarat, transisinya mungkin terlihat sembarangan.
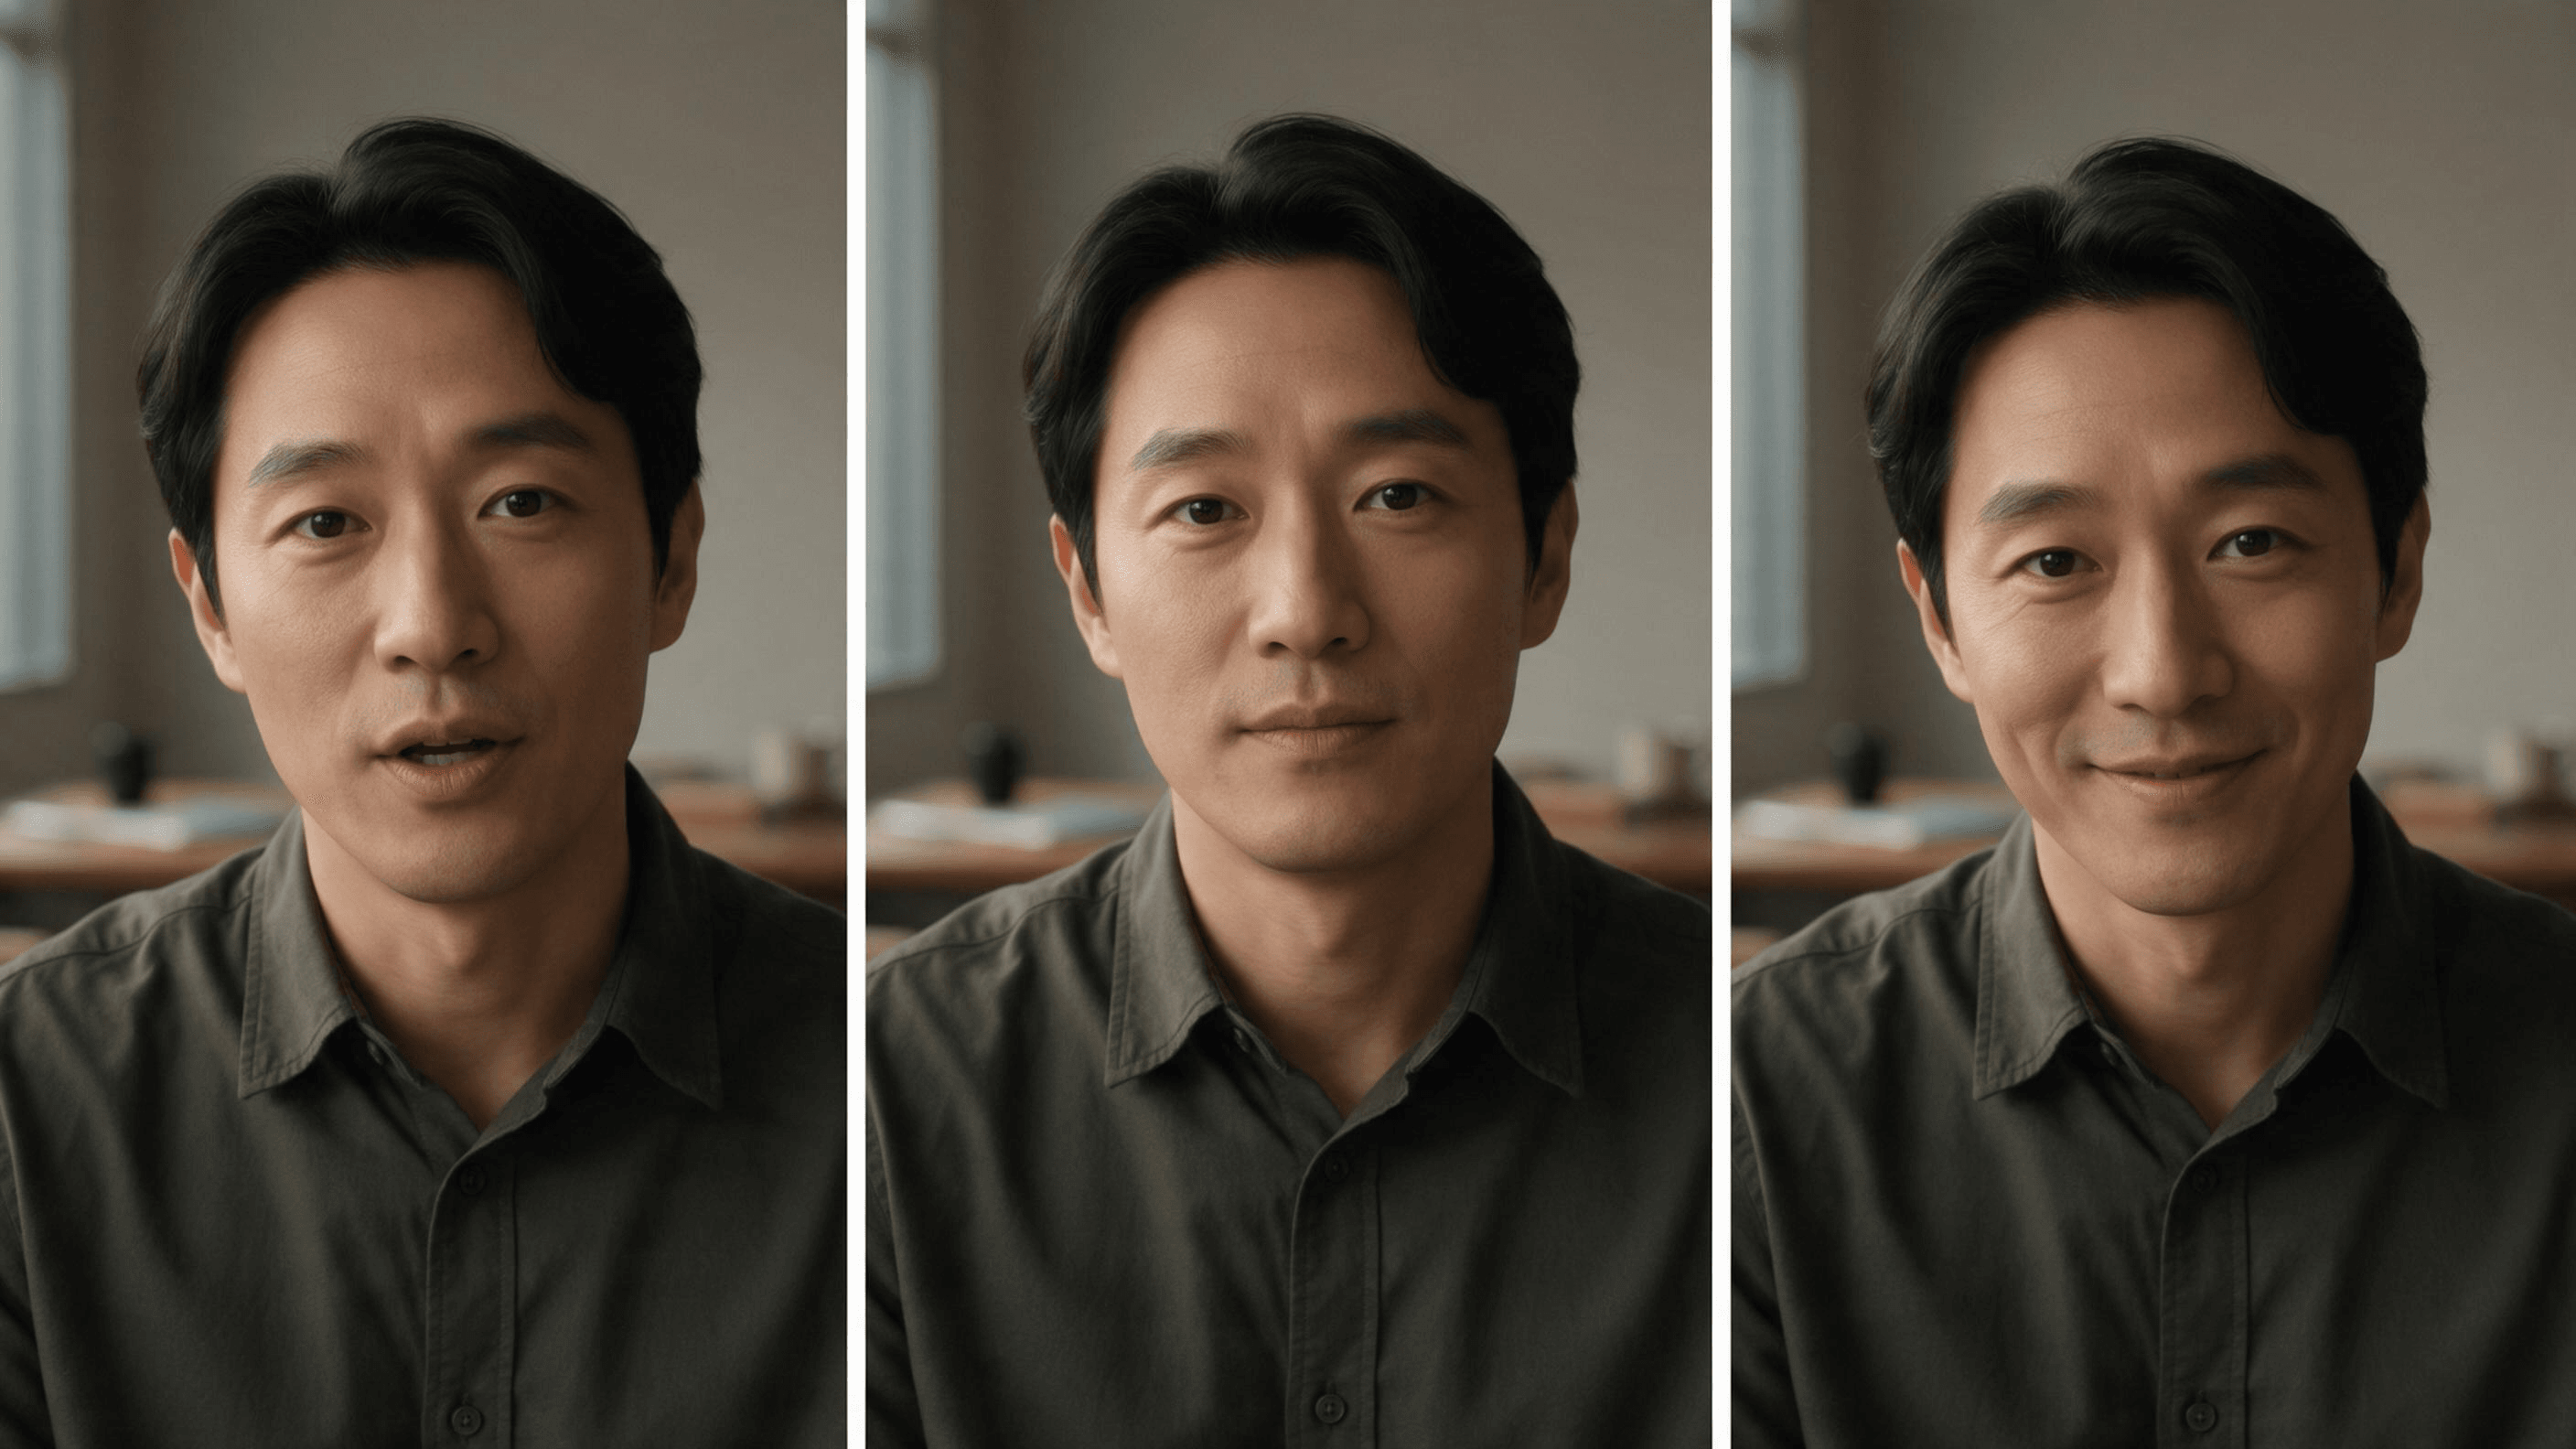 Papan cerita konseptual untuk prompt ucapan: penyampaian serius, jeda, lalu senyum tertahan. Ini adalah ketukan wajah yang direncanakan, bukan frame dari generasi OmniHuman 2.0.
Nyanyian
Media close-up. Penyanyi tampil dengan ekspresi fokus, menutup matanya sebentar pada nada yang ditahan, lalu menurunkan dagunya saat frasa berakhir. Jaga pembingkaian tetap stabil.
Arahkan penampilan di sekitar peristiwa musikal alih-alih mengulang lirik. Prompt dapat menyarankan tindakan yang terlihat; trek yang diberikan tetap menjadi sumber kata yang dinyanyikan dan waktunya.
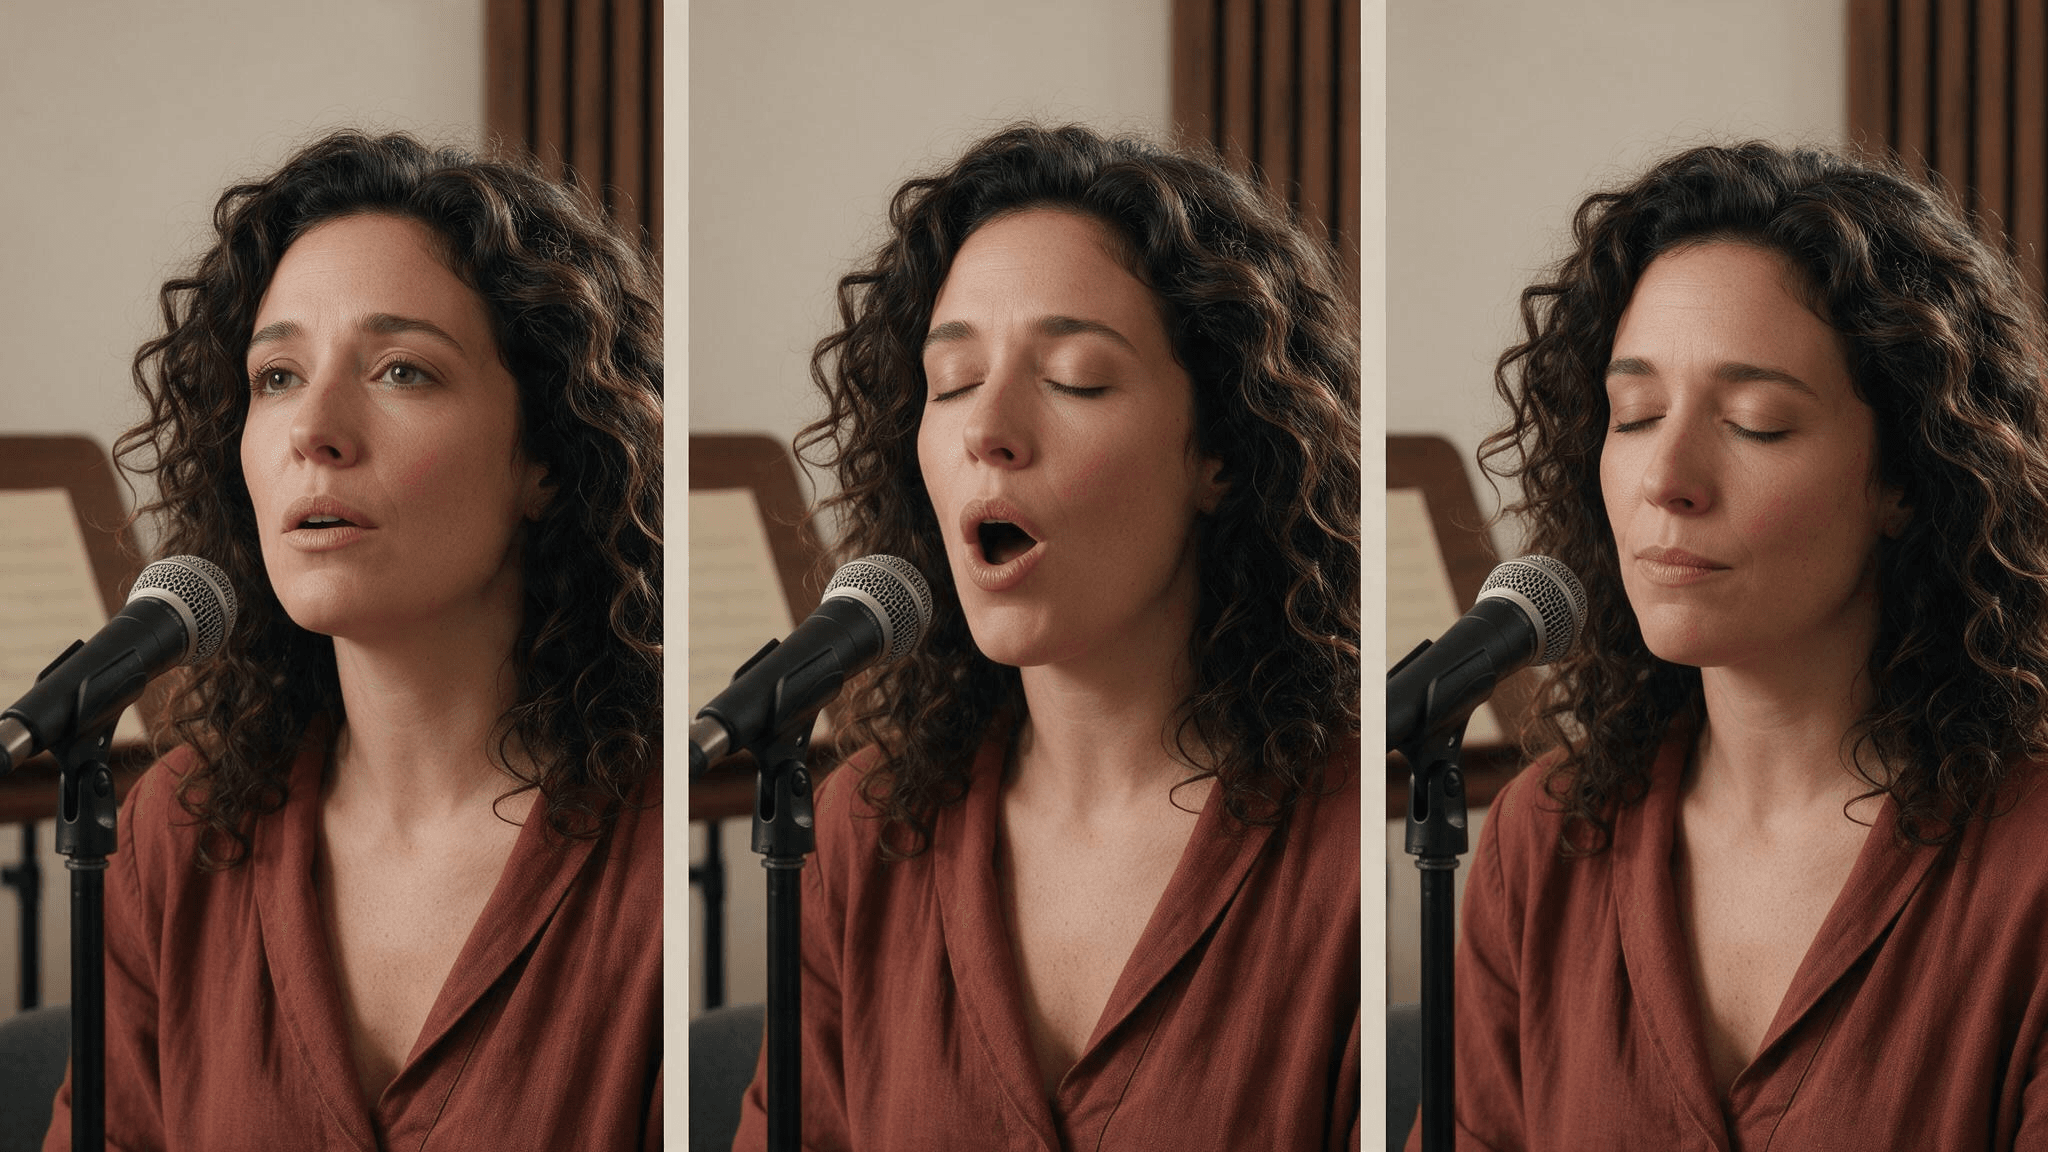 Papan cerita konseptual untuk prompt nyanyian: mulai frasa, tahan nada, lalu mengendap di akhir. Gambar diam tidak menunjukkan sinkronisasi audio.
Bandingkan “jadilah emosional dan sinematik” dengan “berbicara dengan hangat, lalu tersenyum setelah jeda.” Yang pertama membiarkan emosi, waktu, dan tindakan yang terlihat terbuka untuk interpretasi. Yang kedua memberi Anda satu momen spesifik untuk diperiksa. Jika hasilnya melewatkan momen itu, Anda memiliki pengujian berikutnya yang tertarget: pindahkan isyarat, lembutkan ekspresi, atau pilih suntingan audio yang berbeda.
Pemeriksaan tiga tahap untuk penyelarasan suara dan wajah
Metode peninjauan cepat dapat mengungkap apakah masalahnya ada pada audio, arahan visual, atau take yang dihasilkan. Gunakan stempel waktu yang sama pada ketiga tahap.
Loop tanpa suara di bawah ini memungkinkan Anda memeriksa bagian yang terlihat dari penampilan berbicara: gerakan mulut, tatapan, dan perubahan wajah. Gunakan klip asli dengan suara untuk pemeriksaan suara ke wajah.
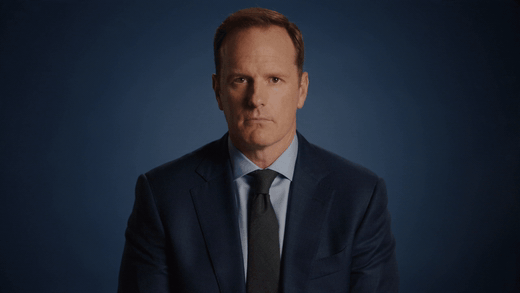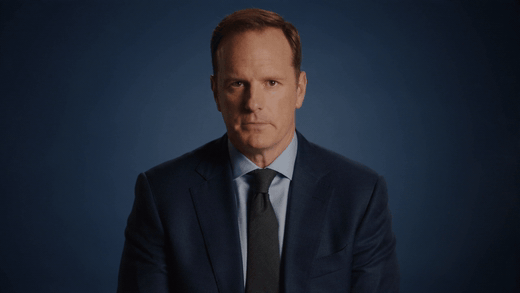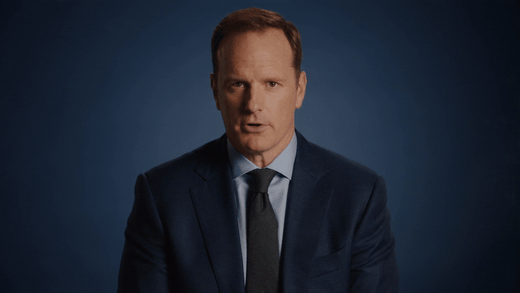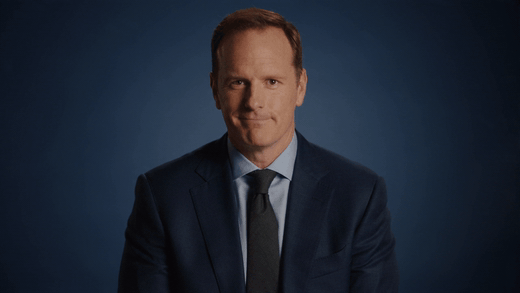
GIF tanpa suara yang dikonversi dari video avatar yang diberikan. Ini menunjukkan gerakan yang terlihat tetapi tidak dapat menetapkan sinkronisasi audio atau penampilan OmniHuman 2.0 dengan sendirinya.
- Dengarkan tanpa menonton. Tandai perubahan emosional, jeda, penekanan, tawa, bisikan, dan akhir frasa. Tuliskan apa yang dapat disimpulkan pendengar hanya dari suara.
- Tonton tanpa suara. Pada stempel waktu tersebut, catat wajah, tatapan, gerakan kepala, dan gestur. Catat apa yang tampaknya dikomunikasikan penampilan tanpa suara.
- Putar keduanya bersamaan. Tandai hanya ketidakcocokan yang mengubah makna atau mengalihkan perhatian dari dialog. Senyum kecil di bawah kalimat yang tertekan mungkin penting; kedipan kecil biasanya tidak.
Tabel tinjauan mengubah observasi tersebut menjadi satu tindakan berikutnya:
| Waktu | Isyarat suara | Isyarat terlihat | Cocok? | Pengujian berikutnya terkecil |
|---|---|---|---|---|
| 00:04 | Frasa pelan dan tegang | Senyum lebar | Tidak | Kurangi intensitas senyum yang diminta |
| 00:09 | Jeda sebelum kalimat yang menenangkan | Wajah tetap diam | Mungkin | Tambahkan satu anggukan halus setelah jeda |
| 00:13 | Tawa dalam rekaman | Ekspresi tetap serius | Tidak | Periksa apakah suntingan audio mempertahankan tawa dengan jelas |
Entri di atas adalah contoh hipotetis tentang cara menggunakan tabel, bukan observasi dari proses model. Catatan tinjauan Anda harus merujuk pada klip Anda sendiri. Ubah satu hal pada satu waktu: revisi prompt, sesuaikan suntingan audio, atau coba potret yang berbeda. Lalu ulangi pemeriksaan yang sama pada momen yang sama.
Jika ketidakcocokan tetap ada meskipun isyaratnya jelas dan arahannya terfokus, anggap itu sebagai keterbatasan generasi untuk take tersebut. Lebih banyak kata sifat dapat menambah gangguan tanpa menyelesaikan masalah waktu atau penampilan. Putuskan apakah input atau alur kerja lain layak diuji, atau apakah take itu sudah sesuai untuk konteks yang dimaksudkan.
Atasi masalah ekspresi datar atau tidak cocok
Gunakan gejala untuk memilih langkah berikutnya yang terkendali. Ini adalah hipotesis pemecahan masalah umum, bukan klaim cacat OmniHuman 2.0 yang terverifikasi.
| Apa yang Anda perhatikan | Kemungkinan penyebab | Satu pengujian berikutnya |
|---|---|---|
| Wajah tampak netral sepanjang klip | Suara memiliki sedikit kontras, atau arahan tidak memiliki isyarat yang terlihat | Gunakan bagian audio yang lebih ekspresif atau minta satu tindakan konkret pada ketukan yang jelas |
| Wajah berlebihan dalam kalimat halus | Prompt meminta emosi yang lebih kuat daripada yang didukung trek | Hapus tindakan tambahan dan turunkan intensitas emosional |
| Mulut tampak tidak sinkron | Rekaman memiliki noise, suara tumpang tindih, keheningan panjang, atau potongan yang sulit | Coba suntingan yang lebih bersih dengan waktu yang lebih ketat sebelum menulis ulang prompt |
| Pendengar tampak berbicara dalam gambar kelompok | Peran pembicara dan pendengar mungkin ambigu dalam alur kerja yang diuji | Identifikasi setiap orang berdasarkan posisi dan tentukan siapa yang berbicara, jika antarmuka mendukungnya |
| Identitas atau detail halus bergeser selama gerakan | Pembingkaian sumber atau gerakan yang diminta dapat membuat konsistensi lebih sulit dinilai | Sederhanakan gerakan dan bandingkan take yang lebih pendek dan lebih stabil |
Jangan mengasumsikan perbaikan hanya dengan prompt untuk masalah audio. Pertama periksa apakah kata-katanya jelas dan apakah keheningan atau suntingan mengganggu ritme. Jika semua itu baik, sederhanakan arahan visual. Percobaan ulang yang terfokus memberi Anda bukti yang lebih baik daripada menulis ulang setiap input sekaligus.
Apakah OmniHuman 2.0 tersedia di Atlas Cloud?
Halaman model publik Atlas Cloud saat ini mencantumkan Avatar Omni Human 1.5 dan mendokumentasikan input gambar, audio, serta prompt opsionalnya. Saya tidak menemukan OmniHuman 2.0 dalam daftar model Atlas selama pemeriksaan ini. Itu berarti model 2.0 yang tepat tidak boleh disajikan sebagai dapat dijalankan melalui Atlas Cloud.
Jika Anda ingin menjelajahi tugas avatar terkait yang digerakkan audio di Atlas, tinjau halaman model Avatar Omni Human 1.5 dan input terdokumentasinya. Dokumen tersebut menentukan gambar referensi, URL audio, dan prompt opsional; mereka menjelaskan audio hingga 60 detik dan merekomendasikan 15 detik atau kurang untuk kualitas terbaik. Itu adalah detail v1.5, bukan spesifikasi OmniHuman 2.0. Periksa katalog model Atlas saat ini untuk ketersediaan dan harga terkini sebelum memilih alur kerja. Saya tidak dapat mengonfirmasi harga publik terkini untuk model ini selama riset, jadi artikel ini tidak mencantumkan harga.
Periksa hak dan konteks sebelum memublikasikan
Sebelum membagikan orang yang dianimasikan, pastikan Anda memiliki izin untuk menggunakan potret dan suara untuk tujuan yang dimaksud. Tinjau juga hak musik, kemiripan, suara, dan distribusi untuk konteks spesifik. Persyaratan dapat berbeda menurut materi sumber dan penggunaan; daftar periksa ini adalah panduan praktis, bukan kesimpulan hukum.
Beri label pada media sintetis atau yang diedit ketika penonton secara wajar dapat salah mengiranya sebagai rekaman dokumenter atau pernyataan terkini orang nyata. Simpan catatan proyek tentang file sumber dan suntingan, terutama untuk pekerjaan klien atau kampanye. Penampilan yang selaras secara teknis tetap memerlukan konteks publikasi yang bertanggung jawab.
Untuk OmniHuman 2.0 emotional voice and facial expression matching, langkah berikutnya yang berguna adalah pengujian terkendali: pilih potret yang jelas, tandai ketukan emosional audio, tulis satu arahan singkat, dan tinjau stempel waktu yang sama dengan suara mati dan hidup. Jika Anda mempertimbangkan opsi yang dihosting Atlas, verifikasi model yang tepat dan harga terkini terlebih dahulu.
Pertanyaan yang Sering Diajukan
Apakah OmniHuman 2.0 menghasilkan suara?
Alur kerja yang dijelaskan oleh panduan pihak ketiga dimulai dengan audio yang diberikan dan menganimasikan potret mengikutinya. Jangan mengasumsikan model menghasilkan suara kecuali antarmuka produk spesifik mendokumentasikan kemampuan itu.
Dapatkah OmniHuman 2.0 menganimasikan nyanyian serta ucapan?
Panduan OmniHuman 2.0 pihak ketiga menjelaskan penggunaan audio yang diucapkan maupun dinyanyikan. Untuk pengujian nyanyian, gunakan bagian yang mengutamakan vokal dengan frasa yang jelas, lalu arahkan tindakan yang terlihat di sekitar nada yang ditahan atau akhir frasa.
Haruskah prompt mengulang dialog atau lirik?
Biasanya tidak. Rekaman sudah menyediakan kata-katanya. Gunakan prompt untuk arahan visual seperti ekspresi, gestur, pembingkaian, atau isyarat adegan, dan hindari menambahkan kata-kata yang bertentangan dengan trek.
Apa yang harus saya ubah terlebih dahulu jika ekspresinya terasa salah?
Gunakan pemeriksaan tiga tahap untuk menemukan ketidakcocokan. Jika audionya sendiri tidak jelas atau datar secara emosional, uji suntingan audio terlebih dahulu. Jika isyaratnya jelas tetapi wajah melewatkannya, sederhanakan dan atur ulang waktu satu arahan prompt.
Apakah OmniHuman 2.0 ada di Atlas Cloud?
Saya tidak menemukan OmniHuman 2.0 dalam katalog model publik Atlas Cloud selama riset ini. Atlas mendokumentasikan Avatar Omni Human 1.5 sebagai opsi terkait; verifikasi daftar terkini sebelum Anda memilihnya.





