

Anda meminta karakter untuk memberi gestur di seluruh bingkai, tetapi sumber Anda adalah close-up wajah. Tidak ada kalimat cerdas yang dapat memulihkan detail bahu, tangan, atau pakaian yang hilang secara pasti. Generasi gerakan seluruh tubuh OmniHuman 2.0 dari satu gambar paling baik dilakukan sebagai pilihan yang terkoordinasi: berikan model bingkai yang memuat bagian tubuh yang ingin Anda gerakkan, audio dengan isyarat performa yang jelas, dan prompt singkat yang menjelaskan satu tindakan.
OmniHuman adalah sistem pembuatan video manusia yang digerakkan audio. Alur kerja yang diiklankan menggabungkan gambar diam dan audio, dengan arahan teks opsional untuk gerakan atau perilaku kamera. Perlakukan "seluruh tubuh" sebagai jenis performa yang Anda inginkan, bukan jaminan bahwa setiap potret dapat menghasilkan figur lengkap yang stabil. Spesifikasi yang didokumentasikan secara publik yang dikutip di sini adalah untuk OmniHuman 1.5, jadi spesifikasi tersebut tidak boleh diasumsikan menjelaskan setiap antarmuka atau deployment OmniHuman 2.0.
Poin utama
- Gambar sumber menentukan area tubuh yang terlihat dan komposisi awal.
- Audio menyediakan waktu ucapan atau nyanyian; prompt menambahkan arahan visual.
- Cocokkan crop dengan gerakan, dan jaga tindakan yang diminta tetap di dalam bingkai yang terlihat.
- Periksa versi, batas input, dan harga di halaman produk resmi terkini sebelum berkomitmen.
Apa yang Dilakukan OmniHuman 2.0 untuk Gerakan Seluruh Tubuh
OmniHuman 2.0 disajikan sebagai cara berbasis gambar-dan-audio untuk membuat video performa manusia. Gambar diam menetapkan subjek dan tampilan awal. Audio memberi performa suara, ritme, dan referensi waktu. Teks opsional dapat menjelaskan adegan, gerakan, atau arahan kamera. Klip yang dihasilkan menggabungkan isyarat-isyarat ini menjadi hasil yang bergerak.
Itu membuat tugasnya lebih luas daripada membuat mulut diam bergerak. Take yang berguna dapat melibatkan gerakan bibir, ekspresi, gerakan kepala, postur, dan gestur tangan. Bagian-bagian itu perlu selaras dengan performa yang sama. Untuk explainer lisan, gestur telapak tangan terbuka kecil pada frasa penting mungkin terbaca lebih alami daripada gerakan lengan terus-menerus. Untuk bernyanyi, tubuh dapat mengikuti phrasing dan energi sepanjang trek.
Model tidak menerima rekaman 3D lengkap orang tersebut dari satu foto. Model harus menyimpulkan apa yang berada di luar crop dan bagaimana permukaan tersembunyi seharusnya terlihat saat subjek bergerak. Permintaan untuk tindakan seluruh tubuh karena itu membawa lebih banyak ketidakpastian ketika input hanya menampilkan wajah. Kontrol praktisnya adalah memilih gambar referensi di sekitar tindakan yang Anda butuhkan, lalu gunakan teks untuk memperbaiki apa yang sudah didukung secara visual.
Halaman proyek riset untuk OmniHuman 1.5 menjelaskan animasi berbasis audio dari satu gambar dan membahas kontrol gerakan dan prompt. Itu latar belakang yang berguna untuk keluarga model, tetapi bukan bukti bahwa prompt OmniHuman 2.0 tertentu akan menghasilkan gestur spesifik setiap saat (halaman proyek OmniHuman 1.5).
Sebelum memilih input, tentukan bidikan yang dimaksud dalam satu kalimat: "presenter setengah badan menekankan satu poin," "performer seluruh tubuh mengalihkan berat saat bernyanyi," atau "pembicara close-up menyampaikan kalimat dengan tenang." Bingkai dan audio kemudian dapat melayani satu tugas itu.
Pilih Gambar Sumber yang Menyisakan Ruang untuk Gerakan
Untuk gerakan seluruh tubuh, mulailah dengan gambar sumber terluas yang masih cocok dengan komposisi akhir. Jika hasilnya dimaksudkan sebagai video talking-head close-up, potret ketat mungkin sesuai. Jika penonton perlu melihat tangan menunjuk objek atau subjek mengalihkan beratnya, sertakan bagian-bagian itu di gambar sumber.
| Hasil yang dimaksud | Crop awal yang berguna | Gerakan wajar untuk diminta |
|---|---|---|
| Narasi close-up | Kepala dan bahu | Ekspresi, putaran kepala, gerakan bahu tertahan |
| Penjelasan produk | Setengah badan dengan tangan terlihat | Menunjuk singkat, mempresentasikan, atau penekanan telapak terbuka |
| Performa berdiri | Figur penuh dengan ruang di sekitar tubuh | Perubahan postur, peralihan berat, dan gerakan yang lebih besar |
Ini adalah pilihan produksi, bukan persyaratan BytePlus yang dipublikasikan atau jaminan keberhasilan. Untuk bingkai seluruh tubuh, sisakan sedikit ruang di sekitar tangan, siku, dan kaki. Tangan yang sudah menempel di tepi dapat terpotong begitu bergerak. Jaga wajah cukup jelas untuk dibaca, gunakan cahaya merata jika memungkinkan, dan hindari sumber dengan orang lain melintasi subjek. Latar belakang yang bersih juga membuat gerakan latar yang tidak diinginkan lebih mudah dikenali.
Gambar harus menyerupai bidikan yang ingin Anda publikasikan. Sumber potret yang ditempatkan ke output lanskap mungkin memerlukan lebih banyak latar belakang dan area tubuh yang diciptakan. Sumber berbingkai vertikal sering lebih mudah dinilai untuk karakter berdiri yang ditujukan untuk posting sosial vertikal. Ini adalah pedoman komposisi; periksa kontrol alat target saat ini untuk batas rasio aspek atau resolusi yang sebenarnya.
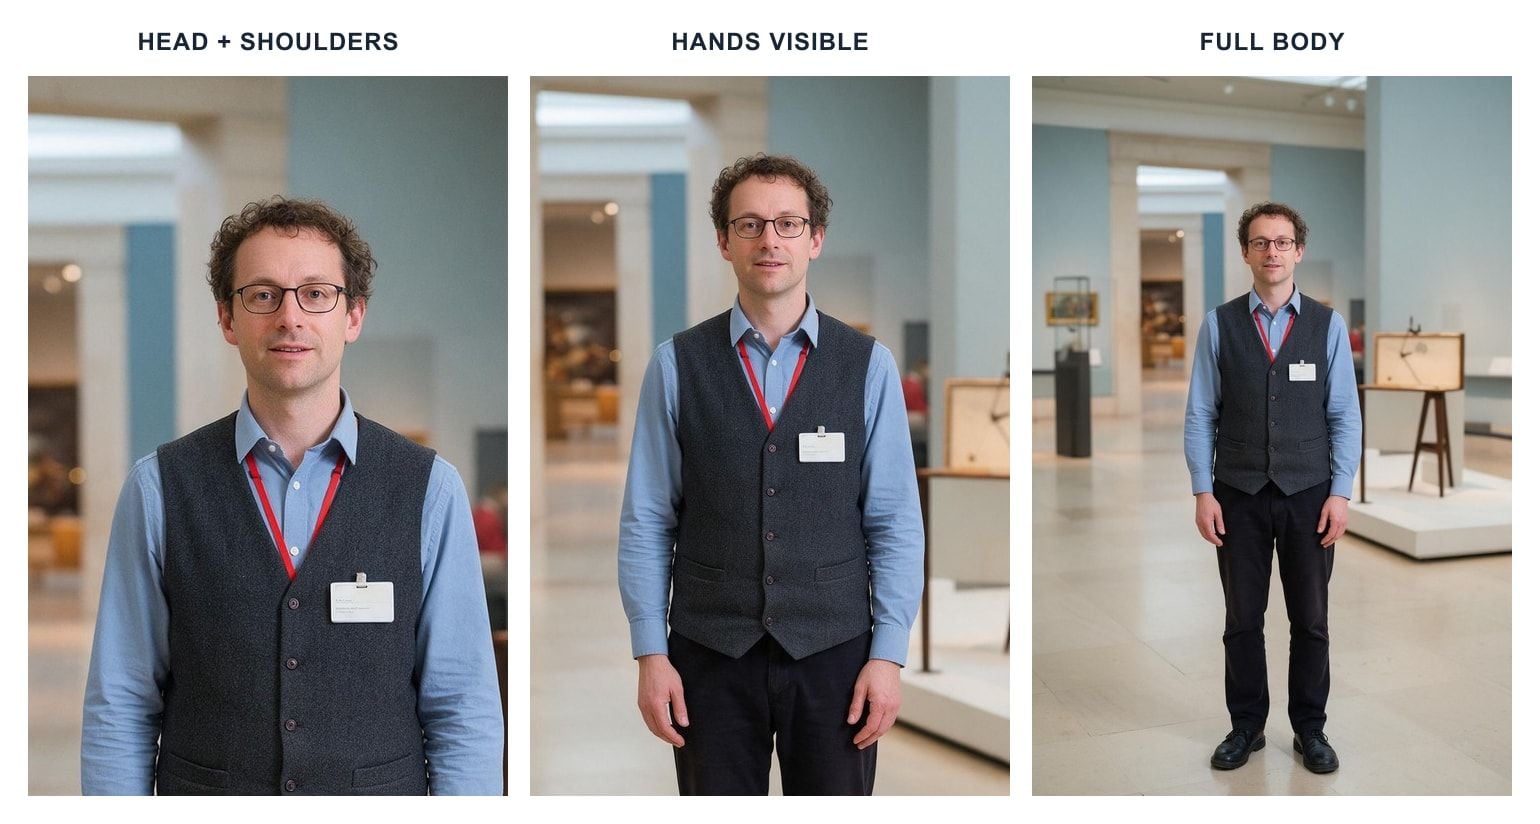
Foto sumber contoh yang sama pada tiga crop: bingkai close-up cocok untuk ekspresi wajah, tangan yang terlihat memberi presenter ruang untuk bergestur, dan figur penuh mendukung performa berdiri.
Tes keputusan sederhana membantu: tunjuk bagian tubuh yang harus bergerak di bidikan akhir. Jika bagian itu tidak ada di sumber, ubah gambarnya atau turunkan target gerakan. Misalnya, gunakan gambar setengah badan dengan tangan terlihat untuk presenter yang akan menekankan "tiga langkah praktis." Potret hanya wajah lebih cocok untuk sapaan singkat atau narasi close-up.
Bangun Performa Satu Gambar dari Audio dan Arahan
Anggap input sebagai tiga pekerjaan berbeda. Gambar menjawab siapa yang ada di layar dan bagaimana bidikan dimulai. Audio membawa kata-kata sebenarnya, jeda, dan energi vokal. Arahan teks meminta perilaku visual yang cocok dengan isyarat tersebut. Jaga input tetap selaras; suara tenang yang dipasangkan dengan "menari liar terus-menerus" memberi model arahan yang bertentangan dan dapat menghasilkan performa yang canggung.
Alur kerja awal yang berguna adalah:
- Pilih bidikan. Tentukan apakah penonton memerlukan wajah close-up, tangan terlihat, atau figur penuh. Pilih sumber dengan area tersebut di dalam bingkai.
- Siapkan audio representatif. Gunakan bagian pendek dari voiceover atau lagu asli, termasuk frasa tempat gerakan seharusnya terjadi. Tes harus mewakili ritme dan penyampaian akhir.
- Tambahkan satu ide gerakan. Jelaskan satu gestur dan di mana letaknya dalam performa. Jaga tindakan lain dan permintaan kamera tetap terkendali.
- Hasilkan dan tinjau. Periksa wajah, tangan, tubuh, latar belakang, dan pembingkaian keseluruhan. Ubah satu input pada satu waktu di percobaan berikutnya.
Untuk explainer produk, baris tes orisinal mungkin: "Kami akan membahas tiga langkah praktis, lalu Anda dapat memilih yang cocok untuk tim Anda." Rekam dengan jeda singkat sebelum frasa "tiga langkah praktis." Gunakan gambar setengah badan dengan kedua tangan terlihat. Itu memberi gerakan yang dimaksud isyarat semantik yang jelas dan rentang gerak yang terlihat.
Dokumentasi resmi BytePlus yang dapat diverifikasi di sini merujuk pada OmniHuman 1.5, bukan 2.0. Untuk 1.5, dokumentasi tersebut mencantumkan gambar dan audio sebagai input wajib, prompt opsional, bahasa prompt yang didukung, dan output 720p atau 1080p. Ringkasannya juga mencantumkan batas audio 60 detik dan merekomendasikan audio yang lebih pendek untuk kualitas. Detail ini membantu membedakan produk 1.5 yang didokumentasikan; verifikasi antarmuka 2.0 atau dokumentasi resmi sebelum menerapkan salah satunya ke 2.0 (dokumentasi pembuatan video BytePlus OmniHuman, diperbarui Oktober 2026).
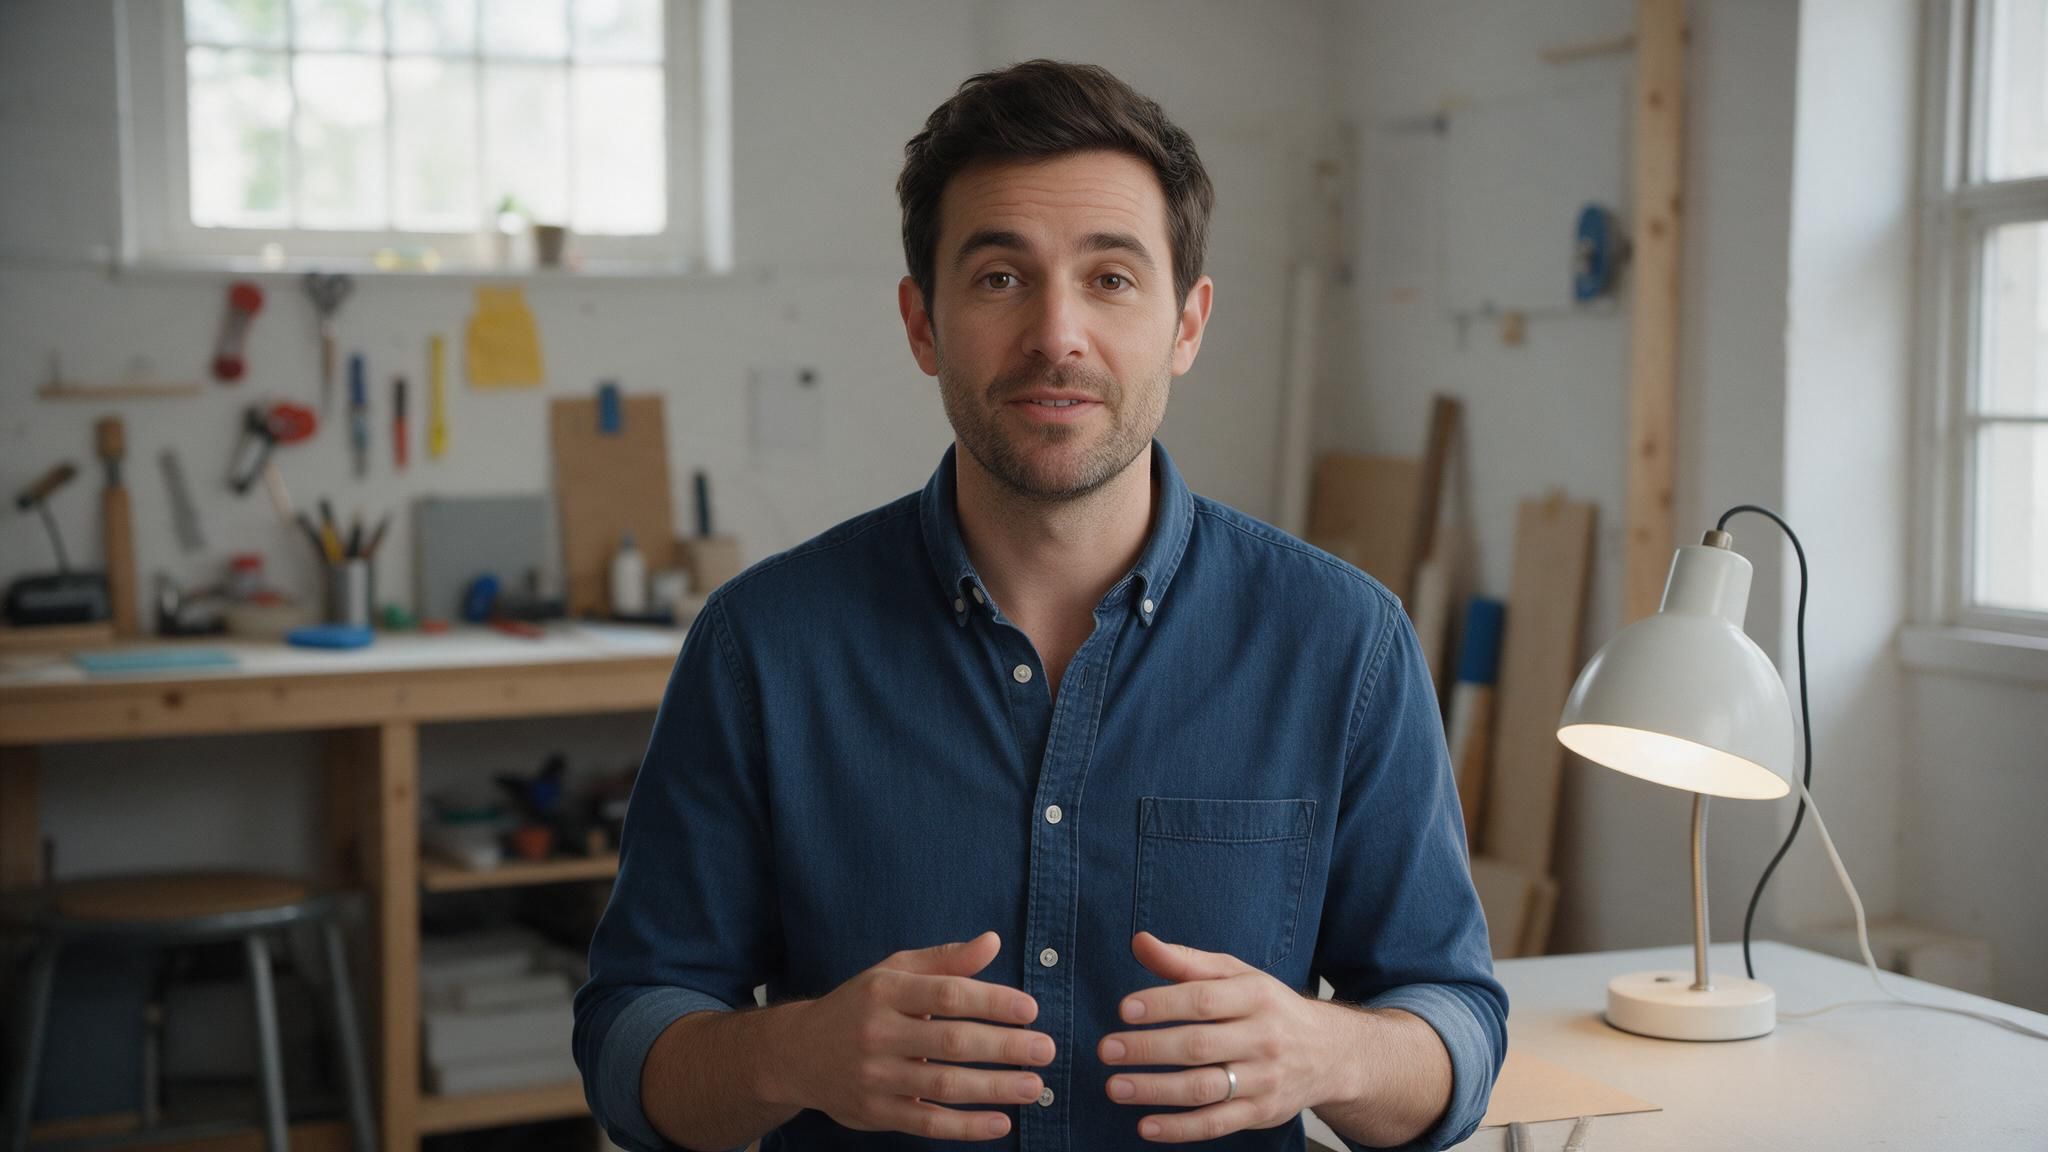
Contoh still sumber untuk explainer produk: wajah presenter, kedua tangan, dan lampu terlihat, sehingga gerakan tangan kecil yang berwaktu mudah dinilai. Ini adalah foto input, bukan output OmniHuman.
Gunakan satu sampel representatif sebelum menyiapkan rekaman panjang. Uji coba singkat membuat lebih cepat menyadari crop yang tidak cocok, frasa tanpa isyarat gerakan, atau prompt yang meminta terlalu banyak. Ini pilihan kontrol kualitas, bukan klaim tentang batas durasi 2.0 tertentu.
Tulis Prompt Gerakan dengan Isyarat yang Jelas
Prompt menjadi lebih mudah dievaluasi ketika menyebutkan tindakan, isyaratnya, ukuran atau kecepatannya, dan batasan pembingkaian apa pun. Instruksi luas seperti "buat orangnya natural dan ekspresif" menyisakan beberapa keputusan terbuka. Instruksi yang terfokus memberi tahu model tindakan visual apa yang penting dan kapan harus terjadi.
Coba contoh ini dengan baris sampel di atas:
Pembicara menyampaikan baris dengan nada tenang dan percaya diri. Jaga kamera tetap stabil. Saat pembicara mengatakan "tiga langkah praktis," angkat satu tangan sebentar untuk menekankan poin, lalu turunkan secara alami. Gunakan gerakan kecil dan santai yang tetap berada di dalam bingkai yang terlihat.
Frasa yang dikutip menghubungkan tindakan ke momen dalam audio. "Angkat satu tangan sebentar" memberi gestur yang terbatas, dan "tetap berada di dalam bingkai yang terlihat" menghindari meminta gerakan di luar crop. Ini adalah templat penulisan prompt, bukan perintah OmniHuman 2.0 yang teruji atau dijamin. Jika sistem tidak mengikuti kata atau waktu secara konsisten, pertahankan frasa sebagai isyarat luas dan nilai gerakan yang dirender alih-alih mengasumsikan koreografi yang akurat per bingkai.
Ubah hanya satu variabel utama di antara percobaan. Jika gerakan muncul terlalu awal, sesuaikan isyarat atau jeda audio. Jika gerakan tangan terlalu besar, kurangi amplitudo yang diminta. Jika lengan tidak stabil atau sebagian diciptakan, pilih sumber yang sudah menampilkan lengan. Mengubah gambar, audio, gerakan, dan arahan kamera sekaligus membuat sulit mempelajari perubahan mana yang membantu.
Hindari menumpuk permintaan yang tidak terkait: lambaian tangan, penunjukan, putaran, berjalan, orbit kamera, dan perubahan emosi semuanya dalam satu baris pendek. Masing-masing menambah tuntutan lain pada performa yang sama. Mulailah dengan satu gerakan yang bertujuan; tambahkan yang kedua hanya jika hasil pertama tetap terbaca dan adegan menuntutnya.
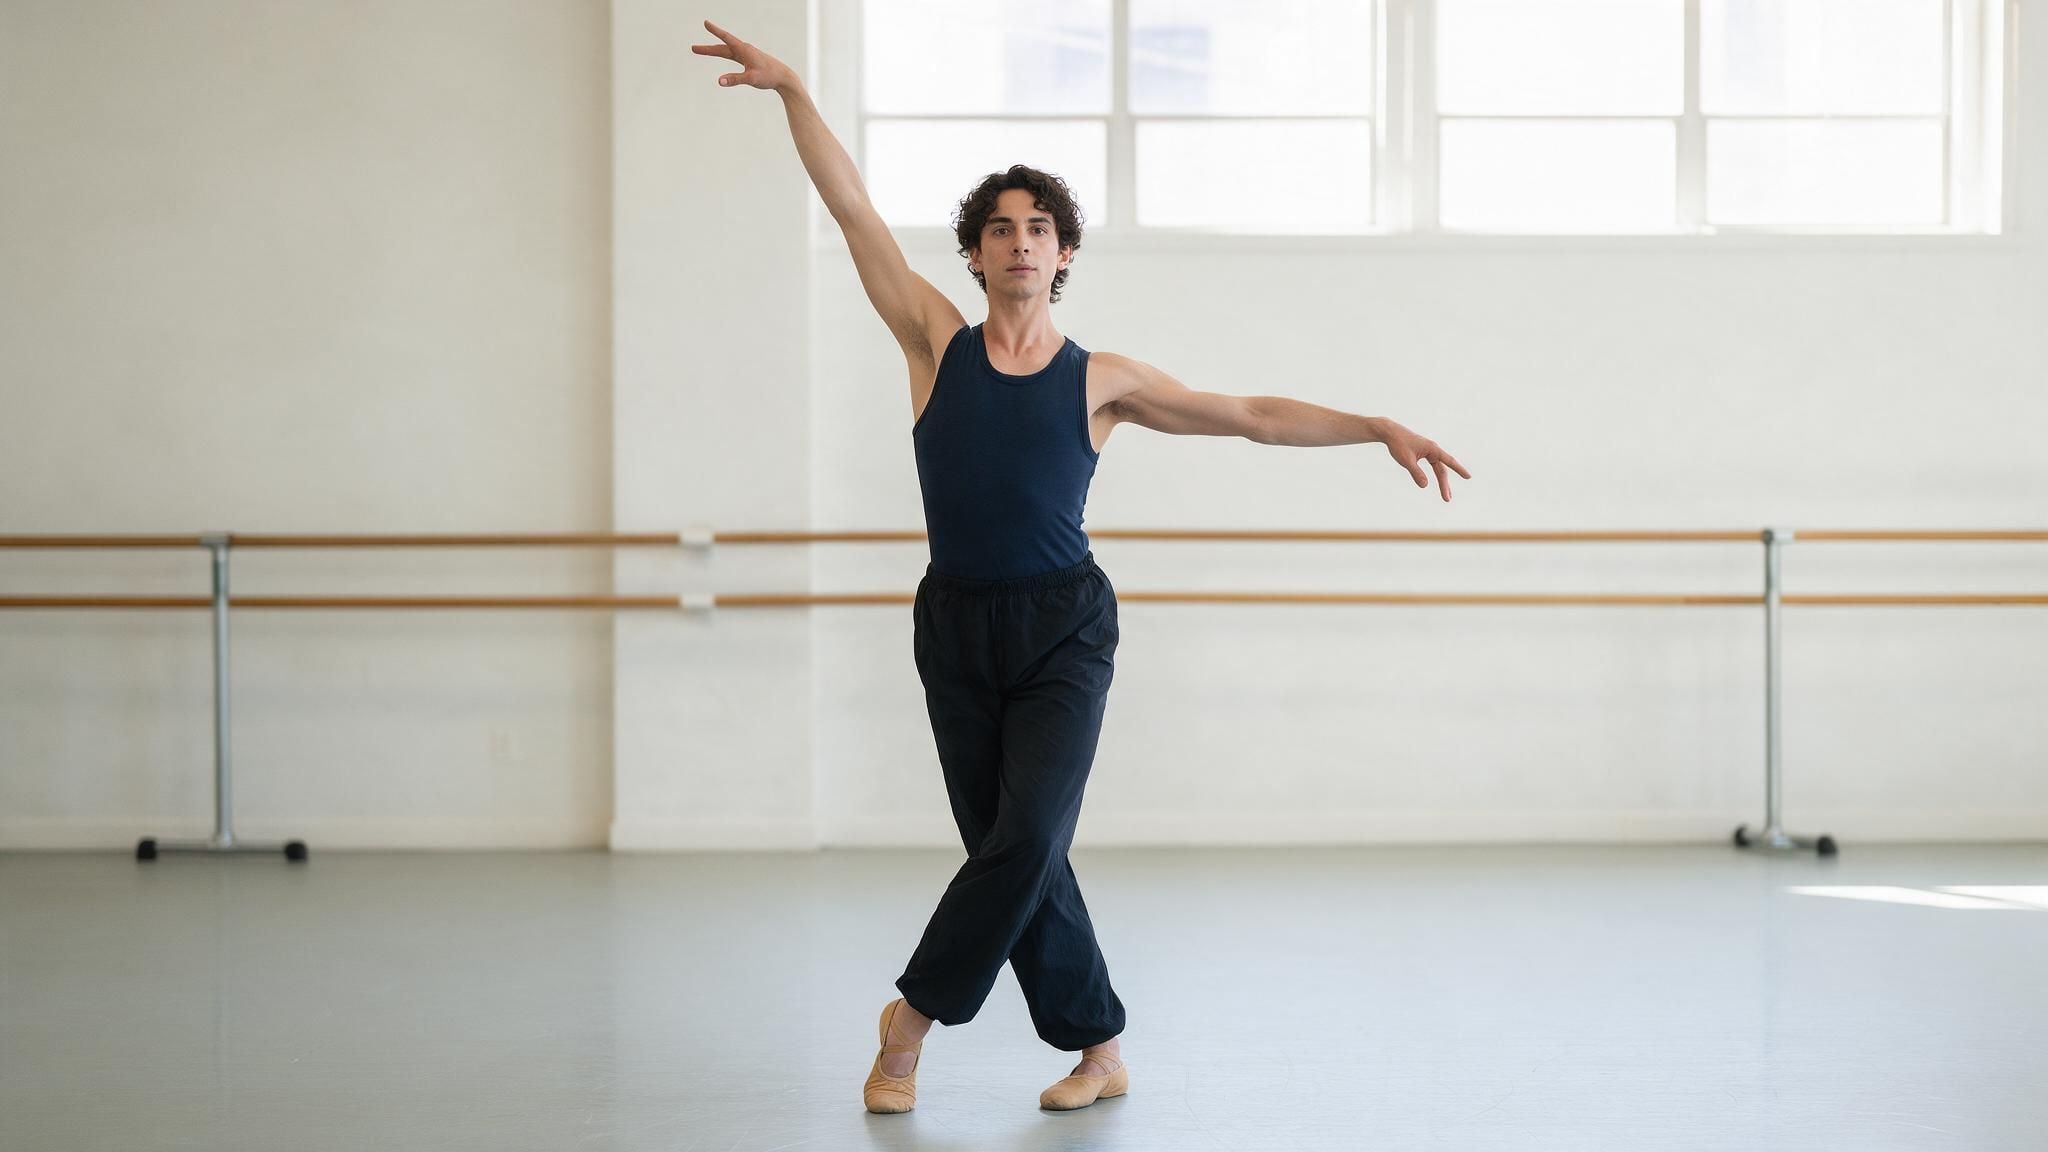
Contoh still sumber untuk pose seluruh tubuh yang terkoordinasi: lengan terangkat, lengan terentang, dan kaki melangkah tetap di dalam bingkai. Ini adalah gambar referensi untuk merencanakan gestur, bukan bingkai yang dihasilkan OmniHuman.
Tinjau Hasil Sebelum Anda Mempublikasikan
Tonton hasilnya sekali untuk performa keseluruhan, lalu sekali lagi untuk detail spesifik. Penontonan kedua berguna karena klip dapat terasa masuk akal pada kecepatan normal sambil mengungkap masalah tangan atau latar belakang saat diperiksa lebih dekat.
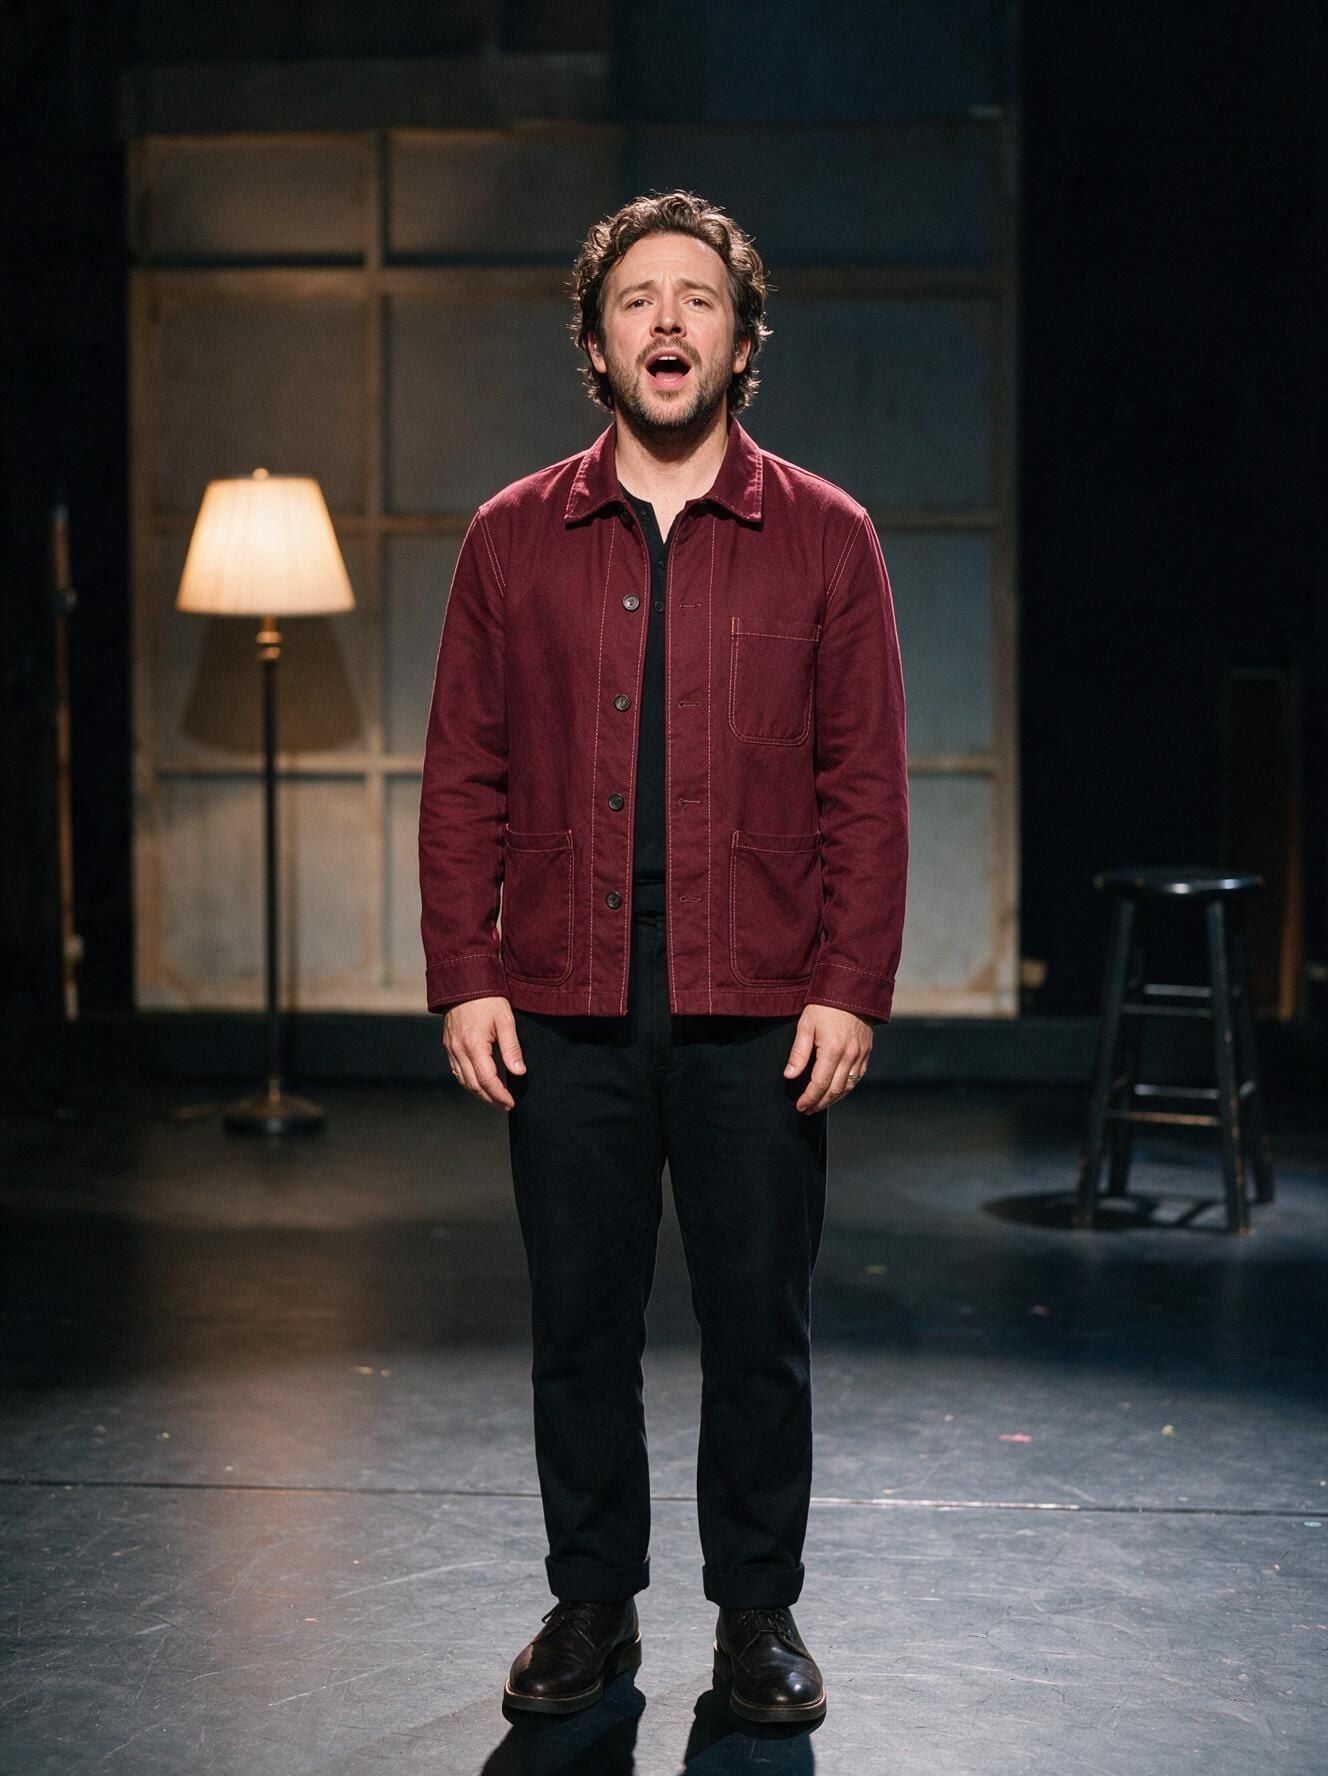
Contoh still sumber untuk performa berdiri: bandingkan take yang dihasilkan dengan wajah, tangan, jaket, sepatu, lampu, dan bangku yang terlihat saat memeriksa identitas dan konsistensi adegan. Ini adalah foto input, bukan bingkai yang dihasilkan.
Periksa lima area ini:
- Ucapan dan ekspresi: Apakah mulut secara garis besar mengikuti frasa yang diucapkan atau dinyanyikan? Apakah ekspresi cocok dengan penyampaian vokal?
- Waktu gerakan: Apakah gerakan muncul di dekat ide atau jeda yang dimaksud? Apakah berhenti saat penekanan berakhir?
- Tangan dan tubuh: Perhatikan jari yang menyatu sebentar, sendi yang bengkok, lengan baju yang berubah, atau proporsi tubuh yang bergeser antar bingkai.
- Identitas dan adegan: Apakah wajah tetap dapat dikenali? Apakah pakaian, objek latar belakang, dan pencahayaan tetap cukup konsisten?
- Pembingkaian penyampaian: Apakah tangan atau kaki terpotong? Apakah subjek tetap jelas dalam rasio aspek dan crop yang Anda butuhkan?
Ketika sesuatu gagal, kaitkan percobaan berikutnya dengan penyebab yang diamati. Ganti gambar ketika area tubuh yang dibutuhkan hilang atau crop tidak menyisakan ruang gerak. Ganti atau perpendek audio ketika frasa kunci terburu-buru, tidak jelas, atau tidak cocok secara emosional. Tulis ulang arahan ketika tindakan datang di momen yang salah atau terlalu luas. Jika klip untuk kampanye publik, pastikan juga Anda memiliki izin untuk menganimasikan gambar dan menggunakan rekaman suara, serta dapatkan persetujuan yang diperlukan untuk orang yang diwakilkan.
Hasil yang berguna belum tentu yang memiliki gerakan paling banyak. Untuk intro kursus atau penjelasan produk, gestur tertahan yang mempertahankan identitas dan menjaga subjek di dalam bingkai dapat berkomunikasi lebih baik daripada tindakan rumit yang menarik perhatian ke kesalahan visual. Simpan take yang mendukung pesan dan memenuhi format publikasi, lalu simpan gambar sumber, audio, prompt, dan output terpilih bersama-sama untuk revisi nanti.
Akses, Versi, dan Harga OmniHuman 2.0
BytePlus mencantumkan OmniHuman V2.0 dalam dokumentasi paket hemat model videonya. Itu mengonfirmasi nama versi muncul dalam materi BytePlus, tetapi tidak menetapkan playground 2.0 publik, batas input terperinci, atau endpoint Atlas Cloud (BytePlus AI Savings Plans). Periksa versi model yang tepat sebelum membangun alur kerja di sekitarnya. Nama "OmniHuman 2.0" tidak boleh diperlakukan sebagai dapat dipertukarkan dengan "OmniHuman 1.5." Dokumentasi BytePlus yang saat ini muncul untuk artikel ini diberi label OmniHuman 1.5. Dokumentasi itu mendokumentasikan skema input dan batasan layanannya sendiri, yang tidak boleh dibawa ke 2.0 tanpa sumber resmi yang cocok.
Pada saat diperiksa untuk artikel ini, direktori model publik Atlas Cloud menampilkan katalog model yang luas, tetapi tidak ada halaman detail OmniHuman 2.0 yang dapat diverifikasi di sana. Halaman model Avatar Omni Human spesifik Halaman model Avatar Omni Human mengidentifikasi penawaran 1.5 yang bersebelahan. Harga awalnya yang ditampilkan dilaporkan sebagai $0.12 per detik dalam materi resmi, tetapi harga dan diskon dapat berubah. Periksa ulang halaman detail dan direktori model Atlas Cloud sebelum membuat anggaran atau mempublikasikan. Jangan gunakan harga 1.5 sebagai perkiraan untuk 2.0.
Jika Anda memerlukan OmniHuman 2.0 secara khusus, konfirmasi rute akses resminya, persyaratan input terkini, dan harganya dengan BytePlus sebelum menyiapkan aset produksi. Jika Anda terbuka pada versi yang bersebelahan, direktori Atlas Cloud dapat membantu Anda memverifikasi model video dan avatar mana yang saat ini terdaftar tersedia dari satu katalog. Perlakukan itu sebagai pilihan produk terpisah: proses 1.5 tidak dapat memvalidasi prompt atau hasil 2.0.
Pertanyaan yang Sering Diajukan
Dapatkah OmniHuman 2.0 menghasilkan video seluruh tubuh dari gambar hanya wajah?
Gambar hanya wajah tidak menampilkan detail tubuh yang diperlukan untuk memandu performa seluruh tubuh. Sistem dapat menyimpulkan area yang hilang, tetapi penampilan dan gerakannya kurang langsung berlandaskan pada sumber. Untuk gestur tangan, gunakan sumber yang menampilkan tangan dan cukup lengan. Untuk tindakan berdiri, mulailah dengan gambar seluruh tubuh.
Apakah OmniHuman 2.0 memerlukan audio, atau dapatkah prompt teks menganimasikan gambar saja?
Alur kerja OmniHuman yang dijelaskan digerakkan oleh gambar dan audio, dengan arahan teks opsional. Jangan mengasumsikan animasi gambar hanya teks didukung oleh layanan 2.0 tepat yang akan Anda gunakan. Periksa halaman produk layanan tersebut saat ini untuk input yang diterima.
Berapa lama input audio OmniHuman 2.0 dapat digunakan?
Saya tidak dapat memverifikasi batas durasi audio 2.0 resmi saat ini. Ringkasan 1.5 yang dipublikasikan BytePlus menyatakan batas di bawah 60 detik dan merekomendasikan input yang lebih pendek untuk kualitas, tetapi itu spesifikasi 1.5. Konfirmasi batas 2.0 di titik akses resminya sebelum merekam atau mengunggah trek panjang.
Apakah OmniHuman 2.0 sudah tersedia di Atlas Cloud?
Tidak ada daftar publik OmniHuman 2.0 yang dapat diverifikasi di direktori Atlas Cloud saat artikel ini diperiksa. Halaman OmniHuman yang bersebelahan di Atlas Cloud adalah untuk 1.5. Periksa direktori lagi sebelum digunakan, karena ketersediaan katalog dapat berubah.
Sebelum memulai percobaan generasi gerakan seluruh tubuh OmniHuman 2.0 dari satu gambar berikutnya, buat satu keputusan terlebih dahulu: identifikasi area tubuh yang harus ditampilkan oleh bidikan akhir, lalu pilih sumber yang sudah memuatnya. Verifikasi versi tepat dan batas terkini di layanan yang akan Anda gunakan, dan uji satu bagian audio pendek yang representatif sebelum menyiapkan take produksi penuh.





