MiniMax merilis H3 pada hari Jumat. Dalam dua puluh empat jam, Seedance 2.5 sudah di tangan orang-orang, dan linimasa runtuh menjadi satu percakapan: tiga puluh detik, 4K asli, lima puluh input referensi. Posting peluncuran H3 tergeletak di bawahnya, dengan tenang, hampir tidak ada yang menjalankan tes nyata padanya.
Saya paham alasannya. Tiga puluh detik adalah angka yang bagus. Cocok untuk judul berita.
Tapi jika Anda benar-benar membuat drama pendek vertikal, Anda tahu hal yang merusak malam Anda bukanlah detik ketiga puluh. Itu adalah shot ke-4. Garis rahang pemeran pria bergeser setengah sentimeter, cravatnya kehilangan lipatan, dan penonton menggeser sebelum pancingan mendarat. Tidak ada yang beralih karena klipnya lima belas detik, bukan tiga puluh. Mereka beralih karena pria di close-up bukan pria yang sama dari wide shot.
Jadi saya melewatkan duel spesifikasi. Saya membuat satu lembar karakter dari berbagai sisi, satu papan lokasi enam panel, menulis satu prompt drama pendek gotik 15 detik, dan mengirim paket yang identik ke kedua sisi. Lalu saya menatap wajahnya.
Poin penting
- Hanya H3 yang bisa dipanggil hari ini — API Seedance 2.5 sudah keluar di ByteDance, tetapi masih halaman hari-0 di platform ini.
- Spesifikasi terpisah jelas: Seedance 2.5 = 30 detik dalam satu shot, 4K asli, hingga 50 referensi; H3 = 5–15 detik, 2K, audio stereo di setiap klip.
- Stabilitas karakter adalah masalah pengemasan — satu paket referensi yang baik, bukan model yang lebih besar, yang mempertahankan wajah.
- Keduanya menghasilkan audio asli; H3 juga menjepit suara dari hingga tiga referensi audio.
- Nilai piksel per bingkai, bukan detik — pada proses yang sama, H3 mengembalikan 1440p dibandingkan Seedance 720p.
Hasil Seedance 2.5 vs MiniMax H3, Sebelum Teori Apa Pun
Sebelum teori apa pun, inilah yang dihasilkan alur kerja. Ini adalah empat shot yang diambil dari klip vertikal 15 detik yang sudah jadi dan disusun. Ini adalah proses referensi H3 MiniMax sendiri yang dibangun persis dari lembar karakter dan papan lokasi yang akan Anda lihat di Langkah 1 dan Langkah 2, pada resolusi asli 1440x2560. Proses saya sendiri dari paket yang sama muncul kemudian, di tutorial, dengan status playground terlihat.
Dia mencapai pintu berukir, yang merupakan panel 4 dari papan lokasi, lalu pertikaian di koridor, lalu close-up ketat padanya, lalu two-shot. Garis rambutnya terpisah dengan cara yang sama di profil dan di close-up. Mahkota kepang setengahnya bertahan dalam close-up wajah penuh, yang persis di mana kebanyakan model diam-diam membangun ulang wajah. Korset renda krem mempertahankan garis leher dan manset lengan yang sama dari bingkai pertama hingga terakhir.
Itulah seluruh tes. Bukan tiga puluh detik. Empat shot dan garis rahang.
Mengapa Seedance 2.5 vs MiniMax H3 Rilis di Minggu yang Sama, dan Mengapa Sebagian Besar Tes Karakter Tidak Berguna
MiniMax merilis H3 pada 30 Juli, model video multimodal serba guna yang membaca teks, gambar, video, dan audio sebagai satu konteks dan mengembalikan klip 5 hingga 15 detik hingga 2K dengan suara stereo asli. Model ini juga dapat mengedit rekaman yang ada dan mentransfer gerakan dari satu klip ke klip lain, dan MiniMax mengatakan bobot akan menyusul dalam beberapa hari (Reuters, Juli 2026).
Seedance 2.5 mendarat di jendela yang sama dengan angka yang lebih keras: 30 detik dalam satu generasi, 4K asli, dan hingga 50 input referensi multimodal dalam satu pekerjaan (The Next Web, Juli 2026). API-nya sudah di tangan pengembang, dengan pengeditan lokal yang menggambar ulang bagian bingkai sambil mempertahankan performa, pencahayaan, dan perilaku kamera, referensi-ke-video yang menerima pelat layar hijau atau blokout model 3D putih, sebelas bahasa, dan mode video panjang eksperimental mencapai 180 detik (CineD, Juli 2026).
Kesenjangan perhatian adalah bagian yang menarik. Hampir setiap pos yang saya temukan adalah klip 2.5. Sementara itu, angka arena publik mengatakan hal lain: pada papan peringkat gambar-ke-video Artificial Analysis, Seedance 2.0 pada 720p memimpin dengan 1.196 Elo, Gemini Omni Flash mengikuti di 1.195, dan MiniMax H3 sudah ketiga di 1.185, empat hari setelah rilis. Seedance 2.5 belum memiliki peringkat di sana (Artificial Analysis, Juli 2026). Model dengan gosip paling sedikit adalah yang memiliki rasio skor terhadap perhatian tertinggi.
Sekarang bagian yang benar-benar menentukan keluaran Anda, karena hampir tidak ada hubungannya dengan logo mana yang Anda pilih.
Sebagian besar tes konsistensi karakter gagal sebelum model bahkan dilibatkan. Empat mode kegagalan, dan keempatnya ada di tangan Anda untuk diperbaiki:
| Mode kegagalan | Apa yang Anda lihat di keluaran | Perbaikannya |
|---|---|---|
| Referensi multi-sudut dikirim sebagai file terpisah | Wajah setiap shot "hampir benar" dan tidak ada dua yang cocok | Gabungkan tampilan menjadi satu gambar, lalu tetapkan peran dalam prompt ("pria di KIRI", "wanita di KANAN") |
| Menulis ulang deskripsi karakter per shot | Pakaian dan aksesori melenceng dari shot ke shot | Tulis blok identitas sekali dan gunakan kembali kata demi kata; hanya kamera dan aksi yang berubah per shot |
| Membiarkan pencahayaan bergerak mengikuti adegan | Wajah dibangun ulang secara struktural dalam cahaya baru | Buat papan lokasi terpisah yang mengunci arah cahaya, kabut, dan pantulan lantai, dan berikan sebagai referensi |
| Memperlakukan durasi maksimum sebagai metrik kualitas | Satu penyimpangan dalam 30 detik merusak semua 30 | Potong ke granularitas yang bisa Anda ulang, lalu bicarakan tentang panjangnya |
Ingin menjalankan Seedance 2.5 dan MiniMax H3 dengan prompt yang sama sendiri? Perbandingan model Atlas Cloud menjalankan keduanya secara berdampingan dalam satu proses — prompt dan pengaturan identik, dengan biaya diperkirakan sebelum Anda menghasilkan — sehingga Anda dapat menilai wajah, gerakan, dan teks di layar tanpa memesan dua tes terpisah.
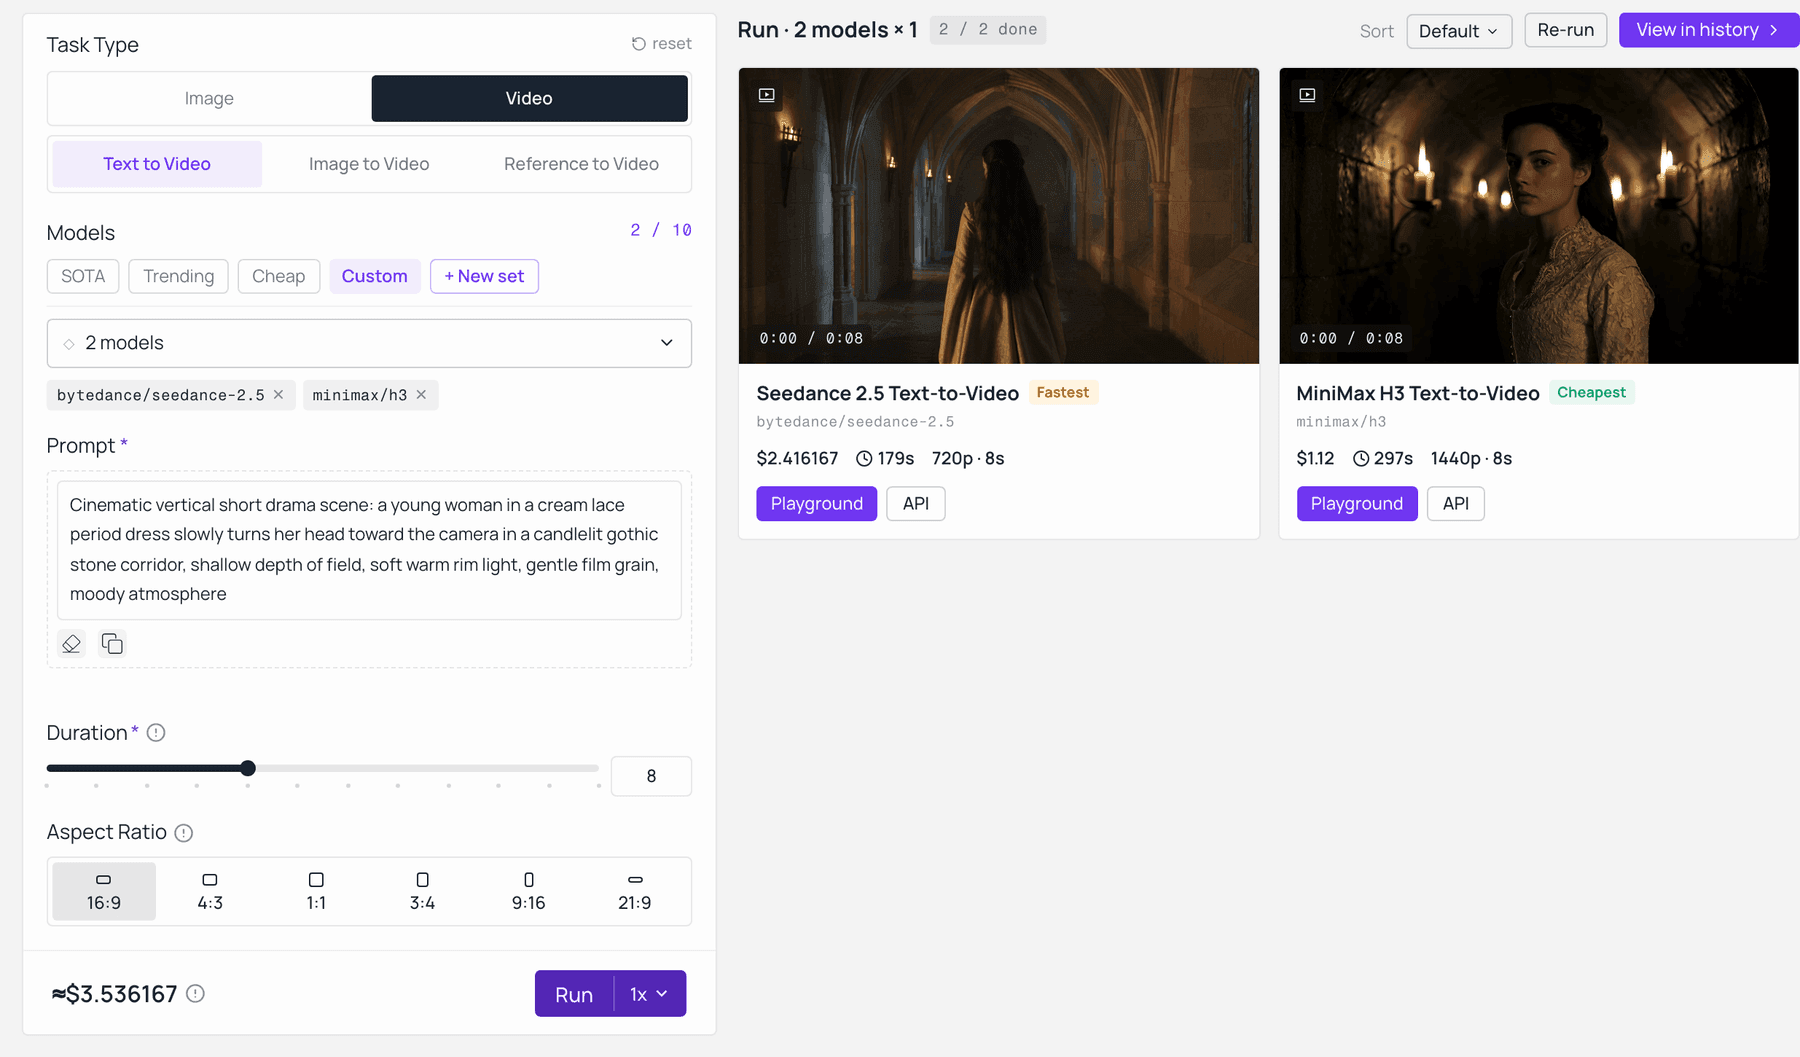
Seedance 2.5 dan MiniMax H3 pada prompt yang identik di perbandingan model Atlas Cloud. Seedance 2.5 mengembalikan 720p seharga $2,42; MiniMax H3 mengembalikan 1440p seharga $1,12, dan kedua harga diperkirakan sebelum proses. Diambil langsung dari model-explorer.
Baris pertama adalah yang paling sering salah dilakukan orang. Kirim enam gambar tampilan tunggal dan model memperlakukannya sebagai enam kandidat orang dan merata-ratakannya. Kirim satu komposit yang bersih dan model memperlakukannya sebagai satu orang yang dilihat dari tiga sisi. Piksel yang sama, hasil yang sama sekali berbeda.
Lembar Spesifikasi Seedance 2.5 vs MiniMax H3, dan Apa yang Sebenarnya Dapat Anda Panggil Hari Ini
Pisahkan kemampuan dari ketersediaan dan ketegangan menjadi jelas. Pada kemampuan mentah, Seedance 2.5 unggul dalam durasi, batas resolusi, jumlah referensi, dan granularitas pengeditan. Pada ketersediaan, H3 adalah yang memiliki tiga endpoint langsung di platform model serba guna minggu ini. Jika Anda melakukan perbandingan model video AI untuk perencanaan 2026, kolom kedua itu sama pentingnya dengan yang pertama.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (yang saya jalankan) | |
|---|---|---|---|
| Panjang maks, satu generasi | 5 hingga 15 s | hingga 30 s, tanpa penyambungan (mode beta hingga 180 s, eksperimental) | menu klip pendek, lihat halaman model |
| Resolusi | 2K asli, sisi pendek 1440p pada 16:9 hingga 9:16; tier 768p terdaftar akan datang | 4K asli, warna 10-bit | hingga 720p di endpoint ini |
| Frame rate | 24 fps | tidak dipublikasikan secara terpisah | tidak dipublikasikan secara terpisah |
| Input referensi | 9 gambar + 3 video + 3 audio, total 12 file | hingga 50 referensi multimodal | 9 gambar + 3 video + 3 audio |
| Audio asli | ya, setiap keluaran, stereo | ya, plus 11 bahasa subtitle dan suara | ya |
| Granularitas pengeditan | edit instruksi seluruh klip (tukar karakter, latar belakang, pencahayaan, dialog) | edit tingkat wilayah yang menggambar ulang bagian bingkai | edit instruksi seluruh klip |
| Batas prompt | 7.000 karakter | tidak dipublikasikan | tidak dipublikasikan |
| Bobot terbuka | diumumkan akan menyusul dalam beberapa hari setelah peluncuran | tidak diumumkan | tidak diumumkan |
| Artificial Analysis I2V Elo, 31 Jul 2026 | 1.185 (3rd) | belum dinilai | 1.196 (1st, entri Dreamina 720p) |
| Dapat dipanggil di platform yang saya uji | ya, 3 endpoint | belum, halaman Day-0 | ya |
Pengungkapan penuh tentang pengaturan pengujian. Seedance 2.5 tidak terbuka di platform saya saat saya menjalankan ini, jadi sisi Seedance adalah Seedance 2.0 Reference-to-Video, anggota keluarga yang sama yang saat ini dikirimkan dengan sistem referensi quad-modal yang sama. Di mana 2.5 akan mengubah jawabannya, saya akan menyatakannya. Halaman Seedance 2.5 adalah pemberitahuan Day-0 untuk saat ini.
Semua yang di bawah berjalan di satu tab browser, pada satu kunci, total tiga model:
| Langkah | Model | Apa yang dihasilkan | Pengaturan kunci | Apa yang menentukan biaya |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | lembar karakter dari berbagai sisi | kualitas tinggi, 16:9 | per gambar, bayar sesuai pemakaian, tarif saat ini di halaman model |
| 2 | model yang sama, proses kedua | papan lokasi dan pencahayaan enam panel | kualitas tinggi, 16:9 | per gambar, bayar sesuai pemakaian |
| 3 | MiniMax H3 Reference-to-Video | klip 9:16 dengan audio asli | 9:16, 2K, durasi 5 untuk tes dan 15 untuk potongan nyata | detik x resolusi, ditagih per detik |
| 4 | Seedance 2.0 Reference-to-Video | proses kontrol, input identik | 9:16, resolusi tertinggi tersedia, durasi yang sama | detik x resolusi, ditagih per detik |
| 5 | H3 Reference-to-Video, klip sebagai input | satu shot tetap tanpa mengulang semuanya | resolusi yang sama, durasi pendek | detik x resolusi, ditagih per detik |
H3 juga memiliki entri text-to-video dan image-to-video jika Anda menginginkan dasar teks murni atau kontrol bingkai pertama-dan-terakhir.
Satu hal lagi yang perlu diketahui sebelum Anda merencanakan batch: teks di layar. Urutan judul H3 15 detik ini mempertahankan kredit bahasa Inggris melalui delapan potongan keras tanpa satu kesalahan ejaan pun, yang merupakan salah satu hal tersulit untuk dijaga stabil dalam video yang dihasilkan.
Alur Kerja Drama Pendek Seedance 2.5 vs MiniMax H3, Langkah demi Langkah
Lima langkah. Salin prompt persis seperti yang ditulis, termasuk bagian yang jelek. Saya tidak membersihkannya untuk artikel dan Anda tidak boleh membersihkannya untuk model.
Langkah 1: Buat lembar karakter dengan GPT Image 2
Buat paket referensi sebelum Anda membuat video apa pun. Satu gambar, dua karakter, tiga tampilan masing-masing, latar belakang putih mulus, pencahayaan studio merata. Itu menghilangkan semua ambiguitas kecuali satu yang Anda pedulikan: seperti apa rupa orang ini.
plaintext1Lembar referensi karakter seluruh tubuh dengan latar belakang putih mulus, dua karakter berdampingan, total enam figur, pencahayaan studio netral merata, tanpa bayangan di lantai, tanpa teks, tanpa label, tanpa tanda air. 2 3SETENGAH KIRI, pemeran pria utama, tiga tampilan berurutan: depan, profil kanan, belakang. Akhir 20-an, kulit pucat, rambut sedang gelap bergelombang, garis rahang tajam. Mengenakan mantel rok beludru hitam sepanjang lantai dengan sulaman senada halus di kerah dan manset, rompi brokat hitam, cravat sutra hitam, celana hitam lurus, sepatu kulit hitam mengkilap. Lengan rileks di samping, ekspresi netral. 4 5SETENGAH KANAN, pemeran wanita utama, tiga tampilan berurutan: depan, profil kanan, belakang. Awal 20-an, kulit cerah, rambut panjang bergelombang cokelat kastanye dengan mahkota kepang setengah. Mengenakan gaun renda katun Victoria krem, lengan panjang dengan manset renda, korset pas dengan kancing kecil, rok panjang sepanjang pergelangan kaki, sepatu tumit rendah bertali pergelangan krem. Lengan rileks di samping, ekspresi netral. 6 7Realisme fotografis, skala konsisten di antara keenam figur, kaki sejajar pada garis dasar yang sama, fokus tajam dari ujung ke ujung.
Pengaturan: model OpenAI GPT Image 2 Text-to-Image, Kualitas tinggi, Rasio aspek 16:9, lainnya default.
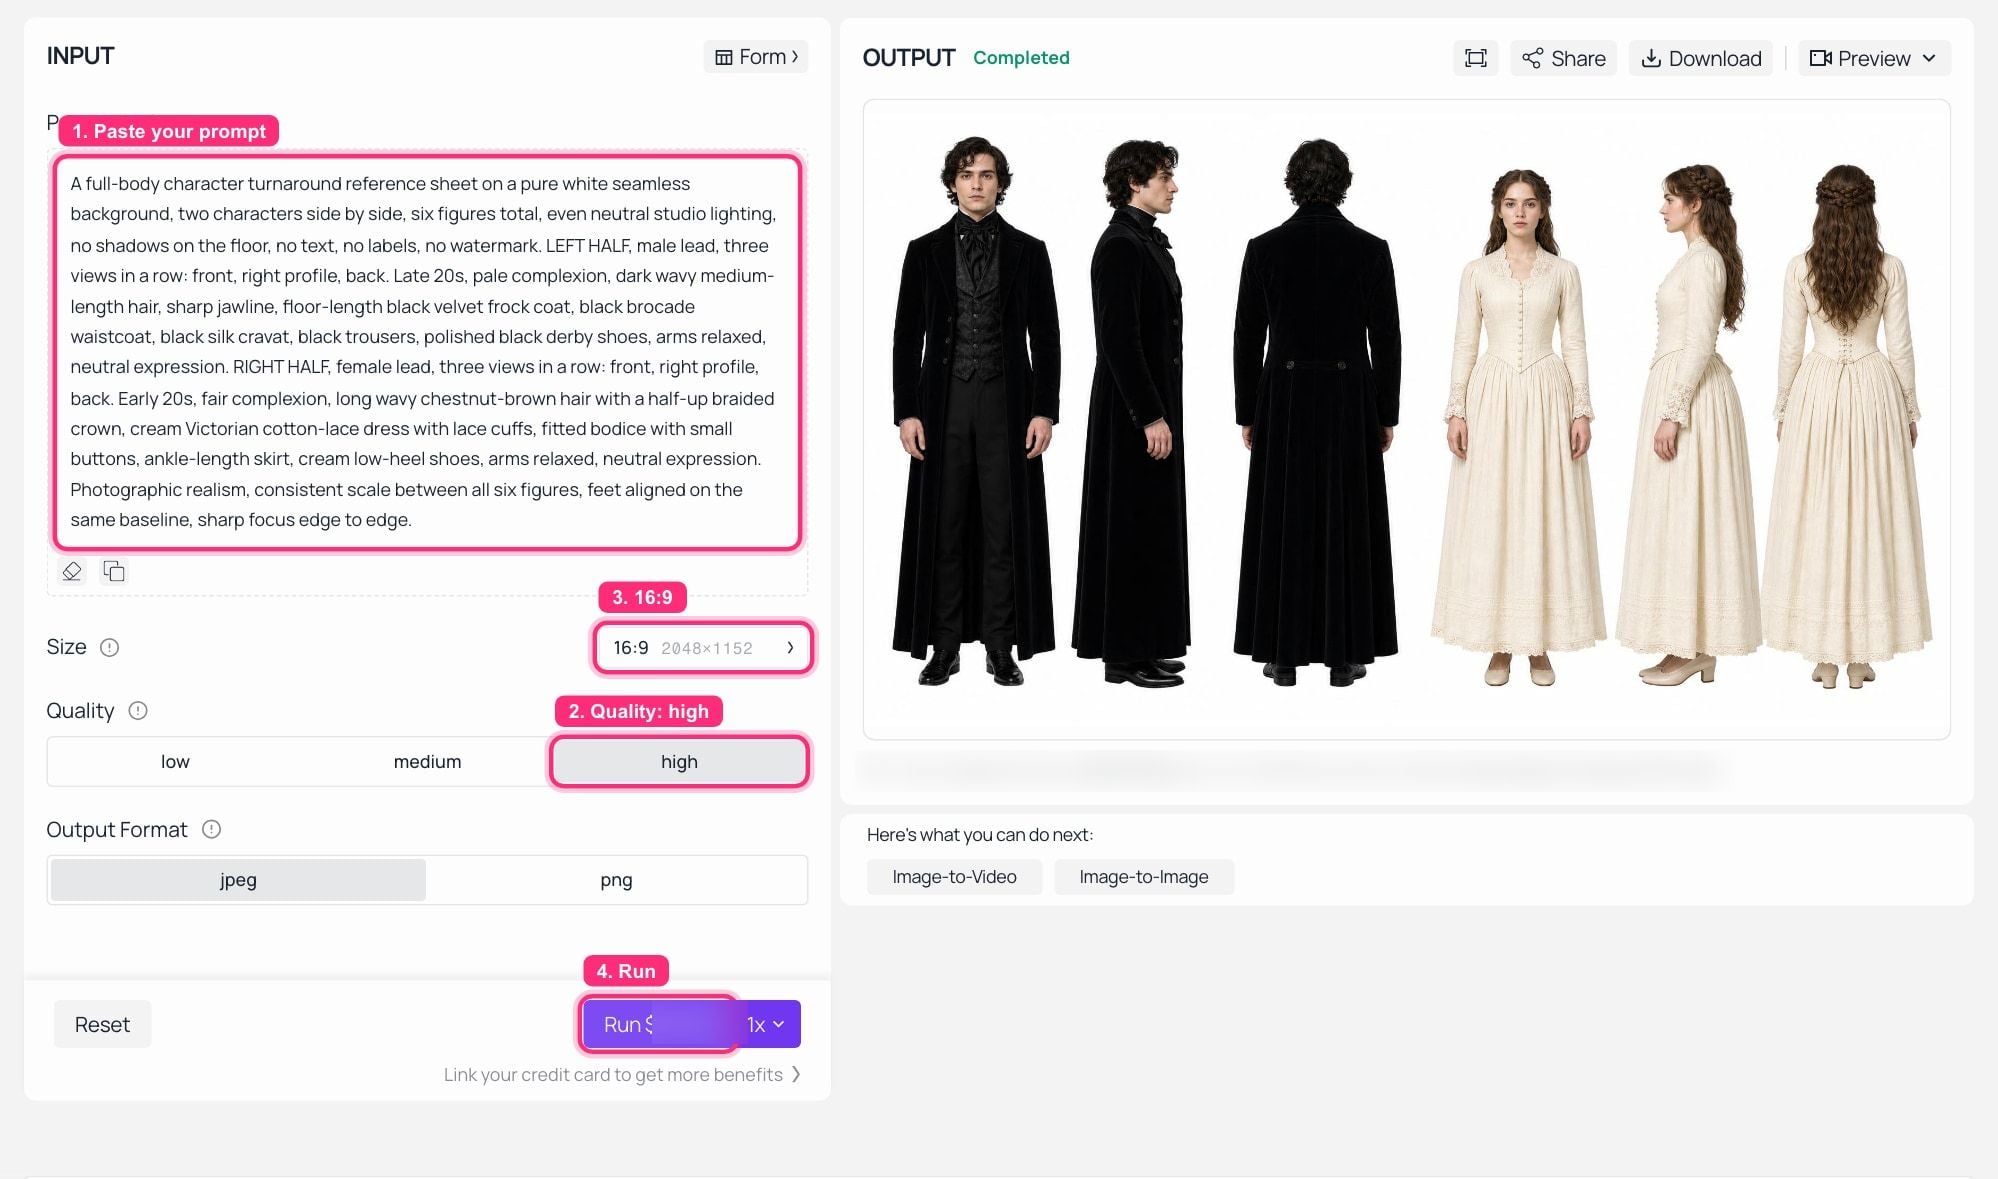 GPT Image 2 Text-to-Image di Atlas Cloud, proses selesai: prompt turnaround di kiri, enam figur di satu lembar putih di panel OUTPUT.
Ini adalah bentuk target. Enam figur, satu garis dasar, tidak ada apa pun di latar belakang yang perlu diperdebatkan:
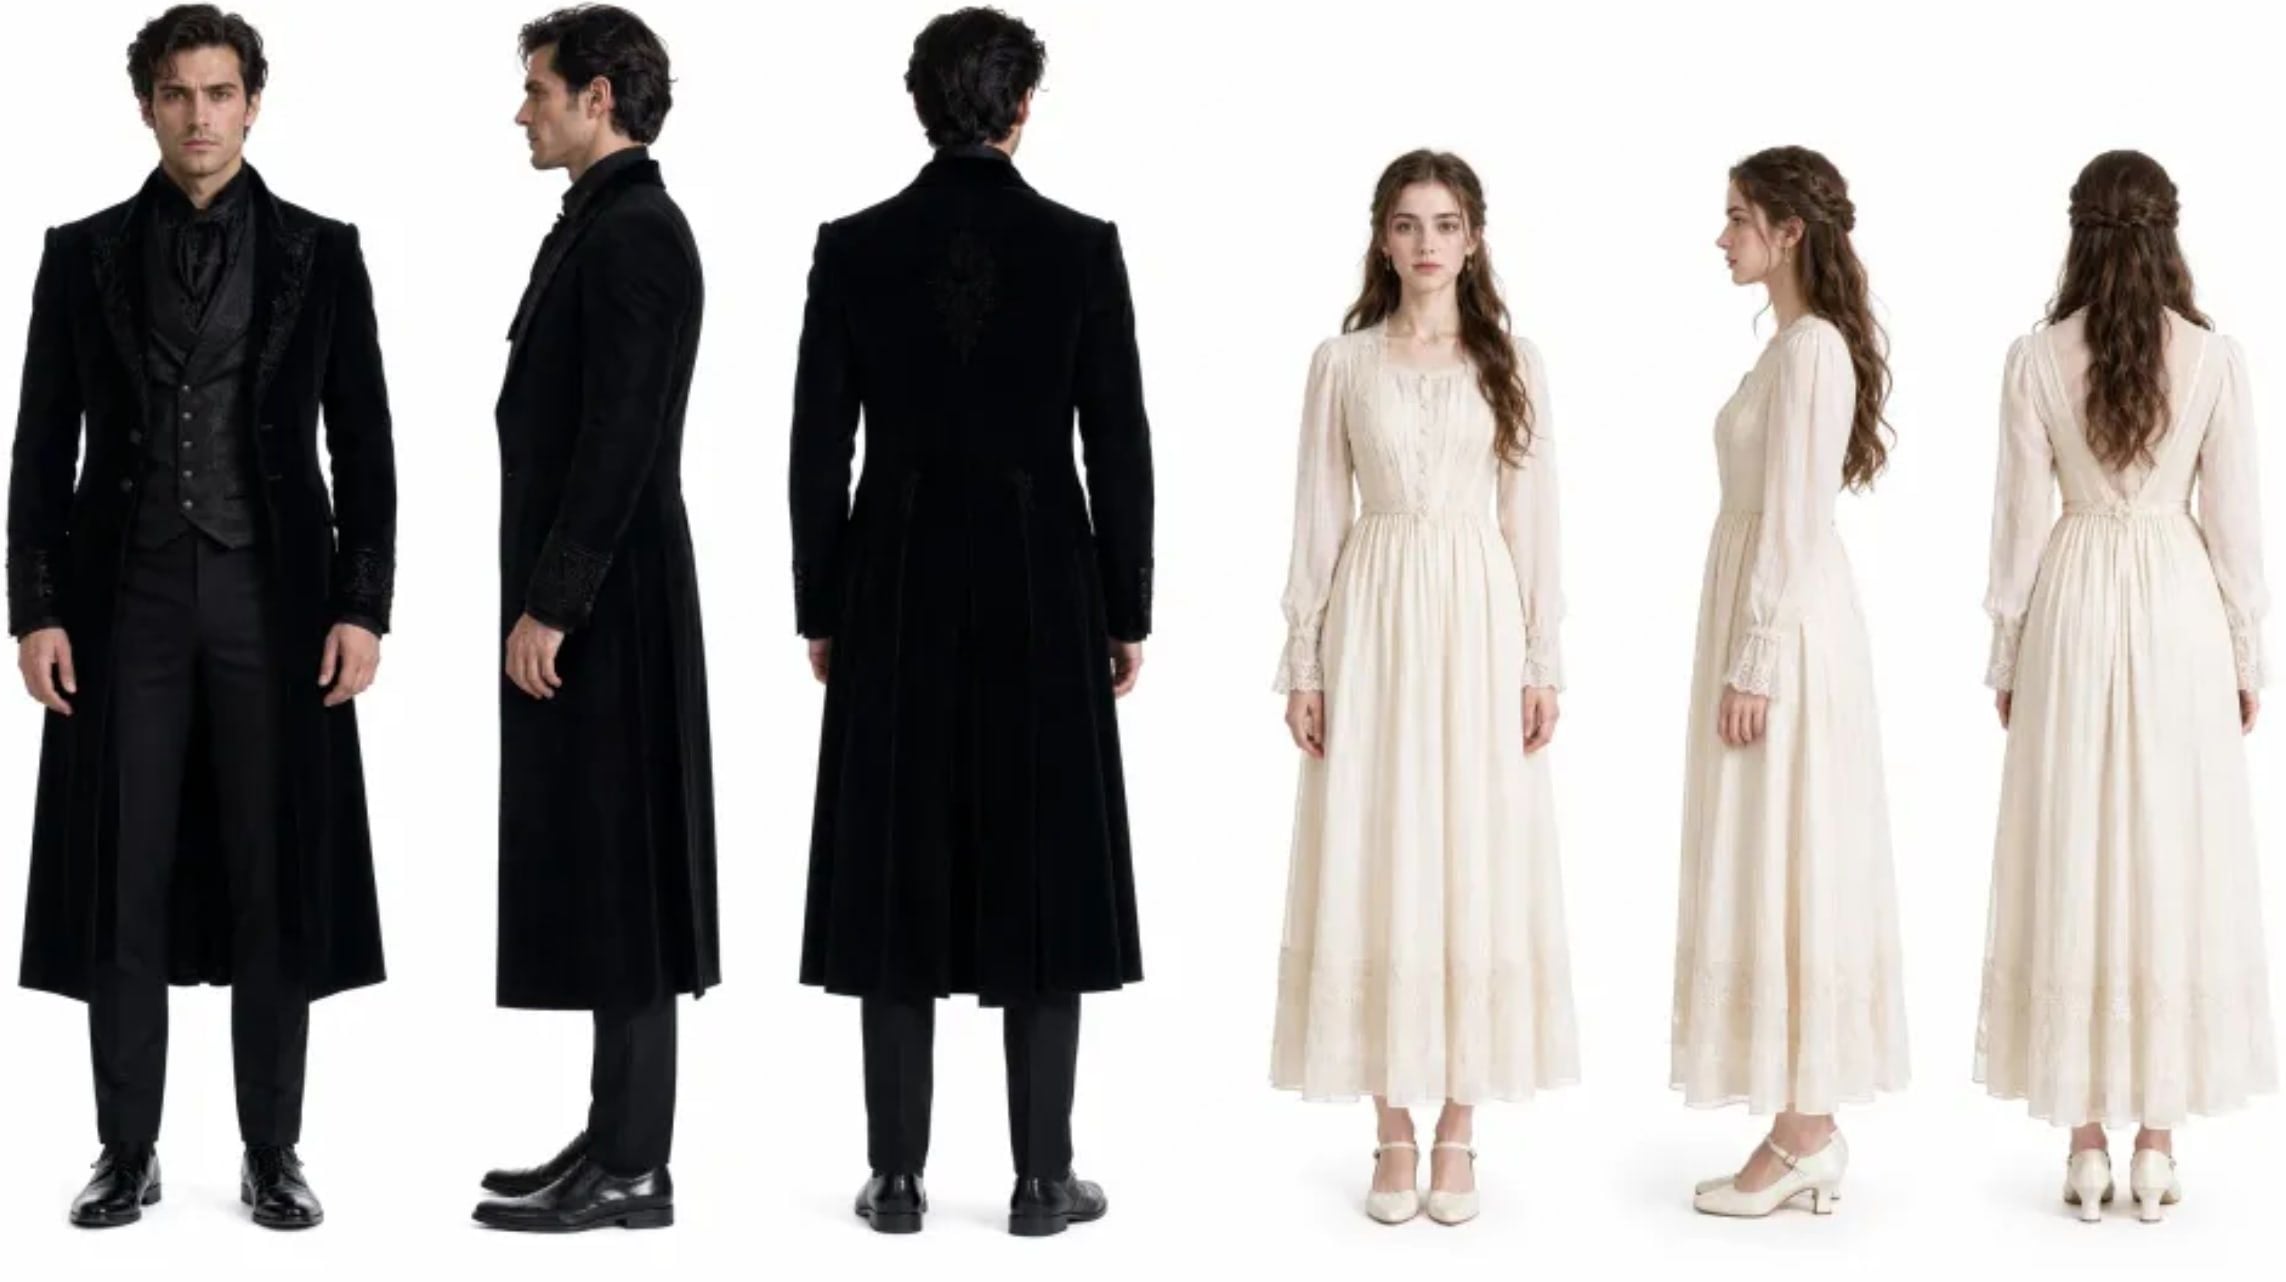 Paket referensi yang mendorong klip demo: pemeran pria utama dalam beludru hitam, pemeran wanita utama dalam renda Victoria krem, tiga tampilan masing-masing, satu file.
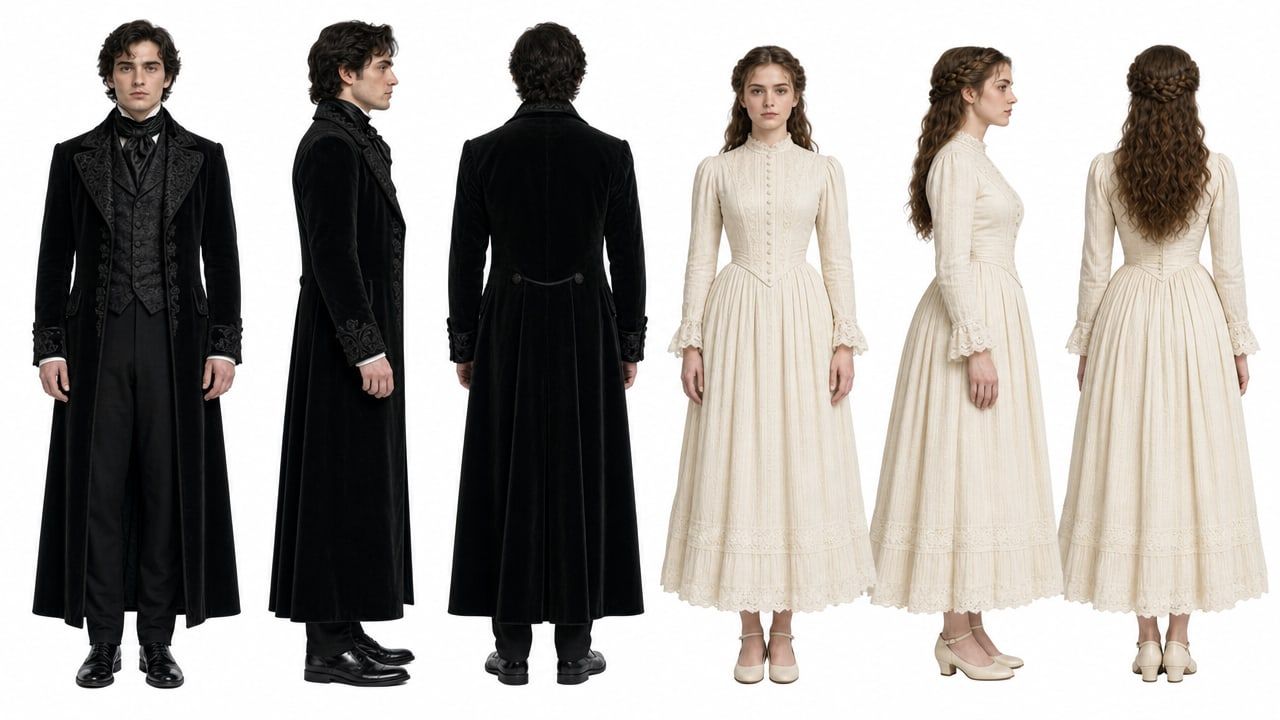 Proses GPT Image 2 saya sendiri dari prompt Langkah 1, untuk perbandingan dengan referensi di atas.
Langkah 2: Kunci lokasi dengan papan adegan enam panel
Anda memegang wajah. Cahaya masih akan mengkhianati Anda. Gambar referensi kedua menetapkan enam posisi kamera, arah cahaya bulan, seberapa banyak kabut di udara, dan seberapa basah lantai terbaca. Anda memberi tahu model bahwa film ini memiliki tepat satu pengaturan pencahayaan.
plaintext1Papan lokasi sinematik enam panel, 2 baris kali 3 kolom, garis tipis hitam di antara panel, setiap panel diberi keterangan dalam huruf kapital kecil putih elegan dengan spasi huruf di bagian bawah panel tersebut. Subjek: interior kastil gotik terbengkalai di malam hari. Cahaya bulan biru dingin, kabut rendah melayang, lantai batu basah reflektif, jendela kaca patri tinggi, tempat lilin besi dengan nyala api hangat kecil, hitam sangat jenuh, tirai beludru tebal. Tidak ada orang di panel mana pun. 2 3Panel 1, keterangan "TAMPILAN PEMBUKA LEBAR - KORIDOR": koridor panjang bertiang menghilang menuju jendela kaca patri yang diterangi. 4Panel 2, keterangan "SUDUT RENDAH - CAHAYA BULAN MELINTASI LANTAI": kamera rendah, seberkas cahaya bulan menyapu batu nisan basah. 5Panel 3, keterangan "KOMPOSISI PINTU & TANGGA": pintu melengkung membingkai tangga batu melengkung. 6Panel 4, keterangan "DETAIL DEKAT - PINTU UKIR": shot ketat dari pintu kayu berukir berat dengan gagang besi. 7Panel 5, keterangan "TAMPILAN SAMPING JENDELA - KABUT & TIRAI": jendela tinggi, kabut masuk, ujung tirai di latar depan. 8Panel 6, keterangan "BINGKAI POSTER AKHIR - AULA KOSONG": aula simetris kosong, karpet runner bermotif mengarah ke jendela. 9 10Fotografis, sinematik, butiran film, gradasi warna konsisten di keenam panel.
Pengaturan: model yang sama, Kualitas tinggi, Rasio aspek 16:9.
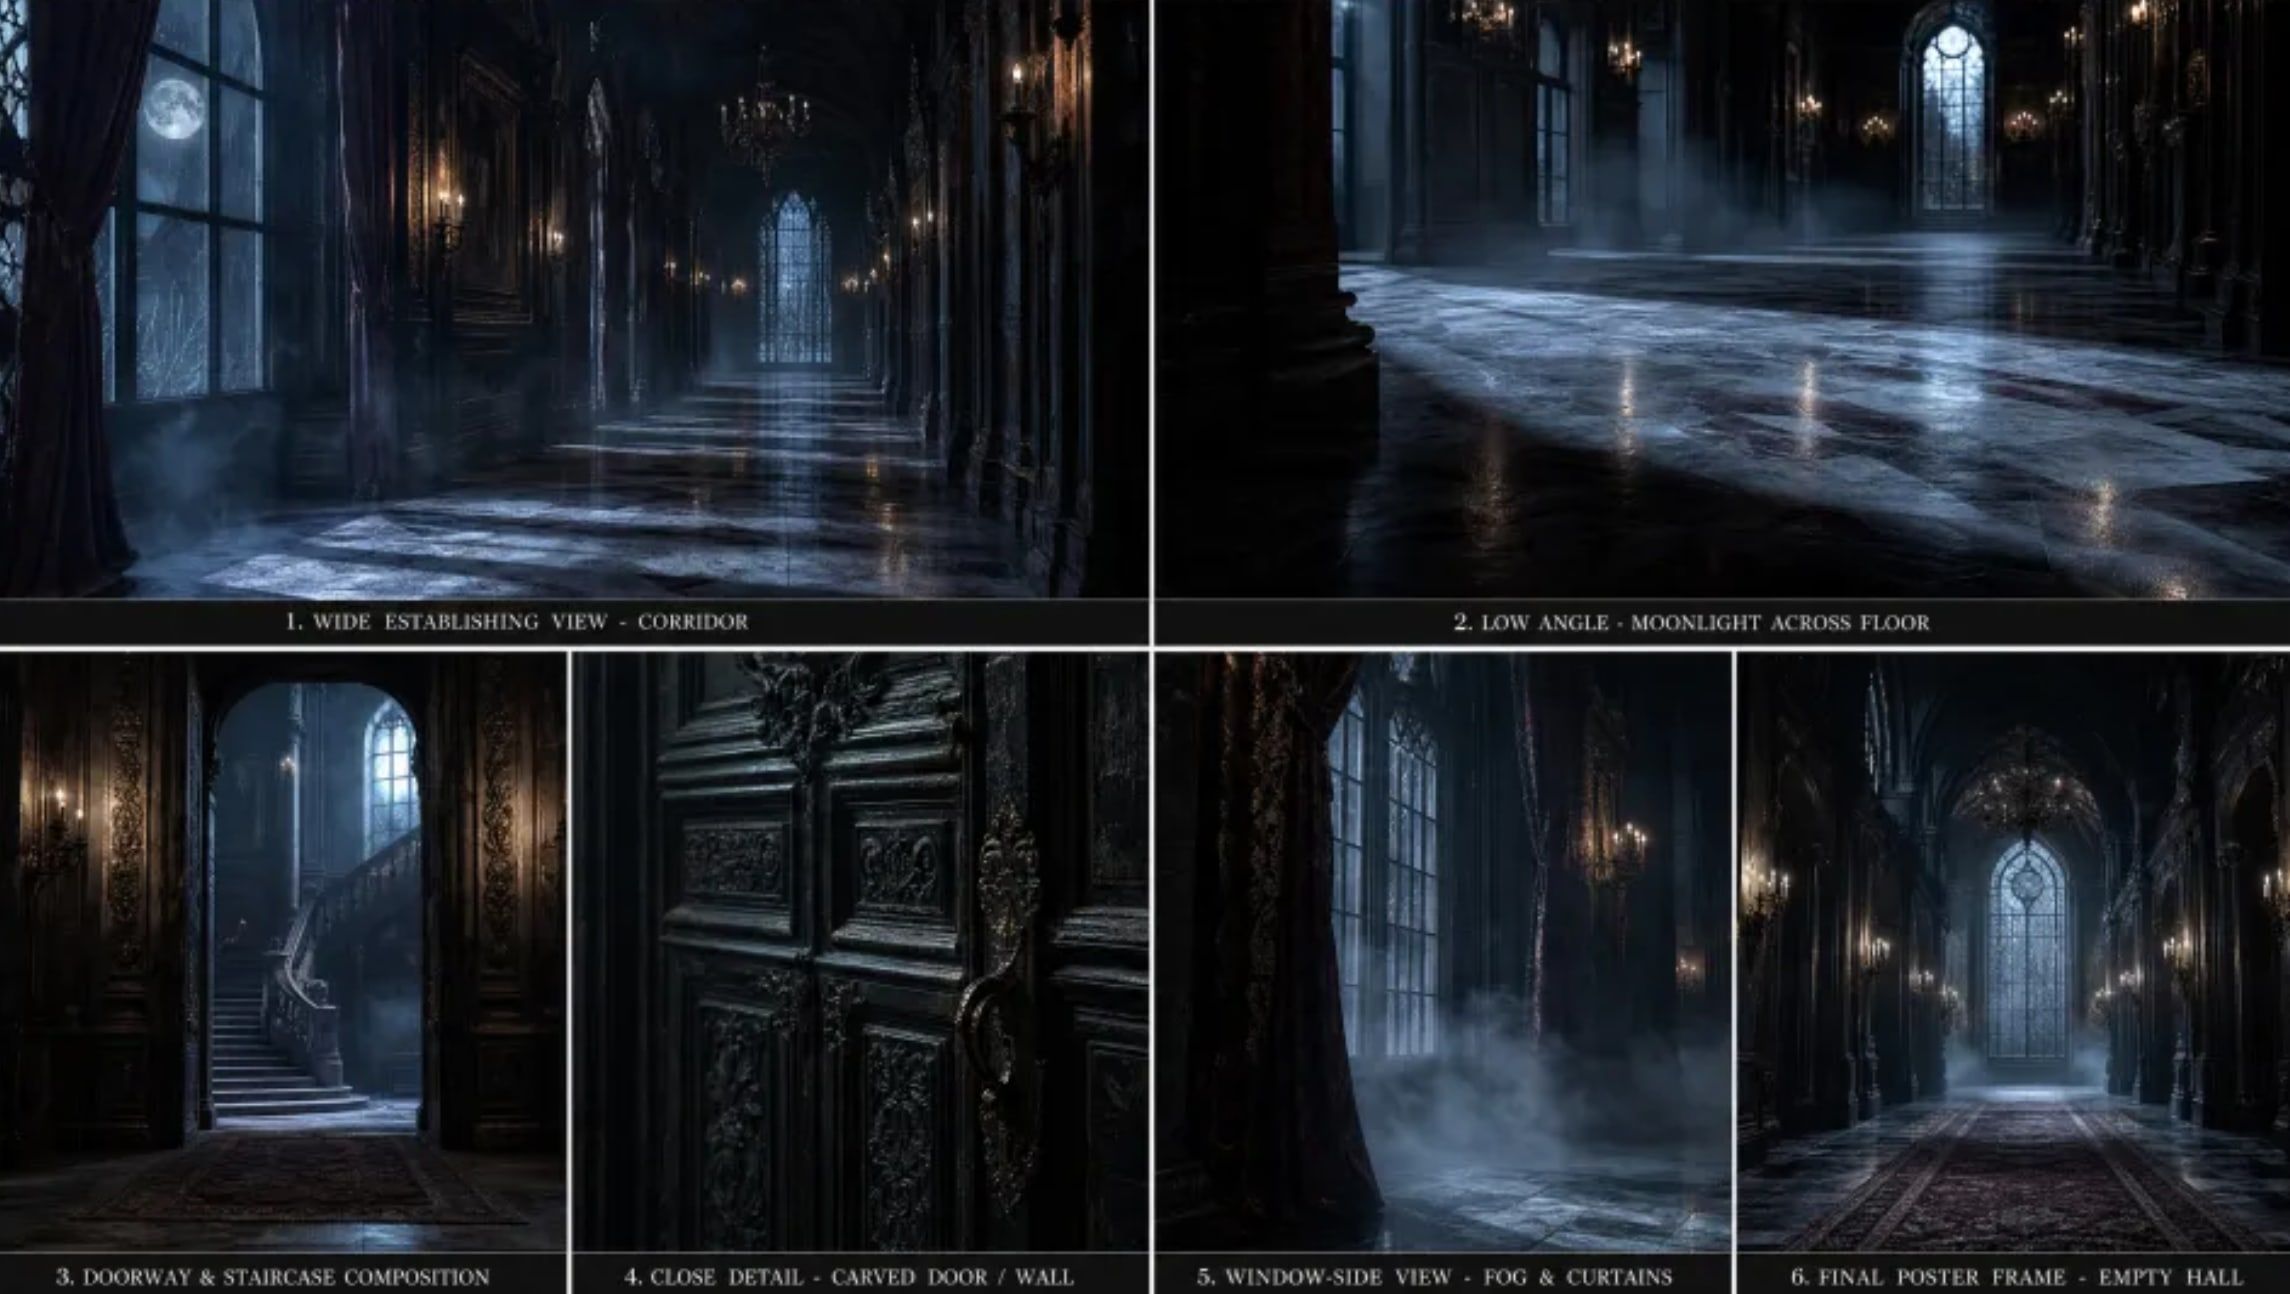 Papan lokasi yang mendorong klip demo: enam interior kastil gotik, satu gradasi warna, keterangan terbaca.
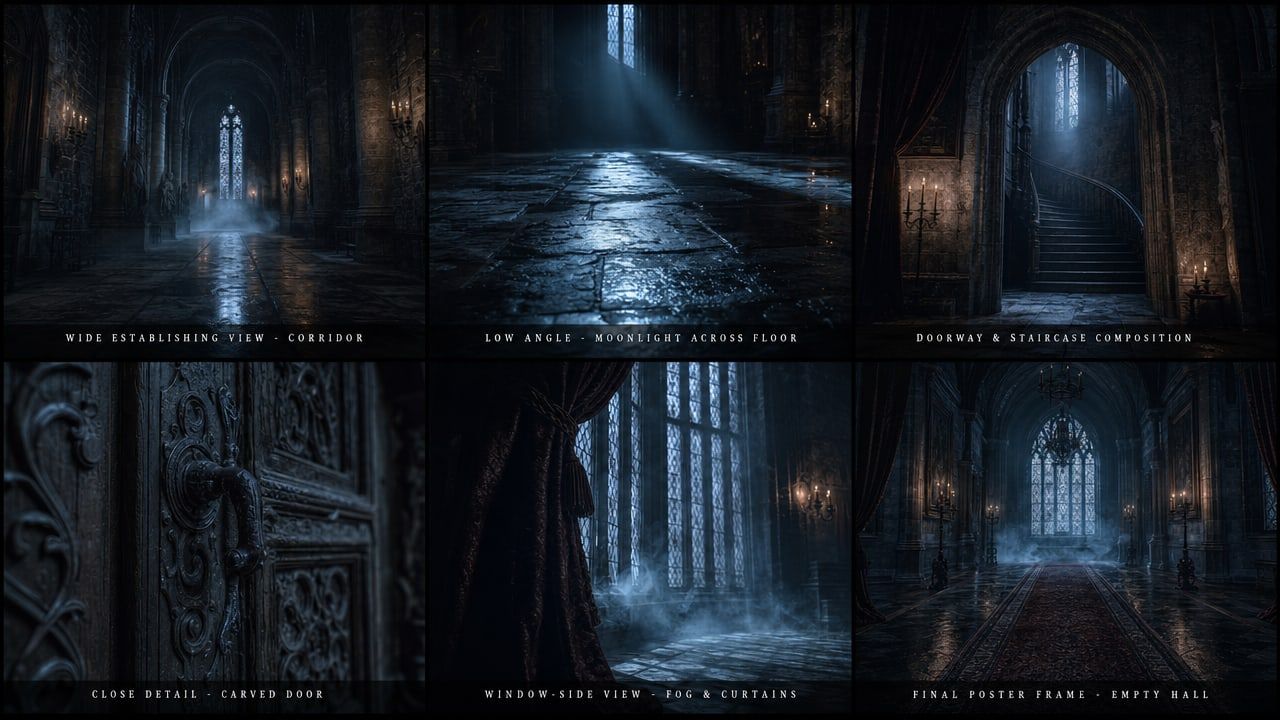 Proses GPT Image 2 saya sendiri dari prompt papan Langkah 2.
Langkah 3: Hasilkan shot dengan MiniMax H3 reference-to-video
Dua gambar referensi ditambah satu prompt yang membawa posisi kamera dan arah audio. Suara dihasilkan dalam proses yang sama, jadi tidak ada langkah suara atau musik terpisah. Jaga durasi tetap pendek saat Anda menyetel, lalu dorong ke 15 untuk potongan nyata.
plaintext1Gambar referensi 1 adalah lembar karakter: pria di KIRI adalah pemeran pria utama, wanita di KANAN adalah pemeran wanita utama. Pertahankan kedua identitas persis seperti yang ditunjukkan: garis rahangnya, rambut gelap bergelombang, mantel rok beludru hitam, rompi brokat hitam, dan cravat sutra hitam; rambut kepang setengah kastanye dan gaun renda Victoria kremnya. Gambar referensi 2 adalah papan lokasi dan pencahayaan: cocokkan cahaya bulan biru dinginnya, kabut melayang, lantai batu basah reflektif, dan nada hitam sangat jenuh. 2 39:16 vertikal, tampilan drama pendek aksi langsung premium, kedalaman bidang dangkal, kontras sinematik, tanpa subtitle, tanpa teks di layar, tanpa tanda air. 4 5Shot 1: Medium close-up, kamera perlahan mendorong masuk. Pemeran wanita utama berdiri di koridor yang diterangi cahaya bulan, napas pendek, mata terpaku pada sesuatu di luar bingkai kanan. Kabut bergerak melewatinya setinggi lutut. 6Shot 2: Potongan keras. Over-the-shoulder dari belakangnya, pemeran pria utama melangkah keluar dari lengkungan gelap ke dalam cahaya bulan, mantel menangkap cahaya, ekspresi dingin dan ingin tahu. 7Shot 3: Close-up ketat di wajahnya, setengah diterangi oleh jendela, lalu close-up yang cocok di wajahnya saat dia menolak untuk berpaling. 8 9Audio: dengungan bass rendah berkelanjutan, gema batu jauh, napasnya yang tidak stabil, satu langkah kaki berat saat dia melangkah ke dalam cahaya, satu dentingan string lembut di potongan terakhir.
Pengaturan: model MiniMax H3 Reference-to-Video, Resolusi 2K, Durasi 8 (default slider; dorong ke 15 untuk potongan nyata), Rasio Aspek adaptif, dan kedua file di Bahan Referensi. Panel menghitungnya sebagai 2 dari 9, jadi Anda memiliki banyak ruang untuk menambahkan pelat pakaian atau properti nanti.
Perlu dicatat apa yang terjadi dengan rasio. Saya membiarkan Rasio Aspek pada adaptif dan hanya menulis "9:16 vertikal" di dalam prompt. H3 tetap kembali vertikal, jadi ia membaca framing dari teks daripada membutuhkan kolom formulir.
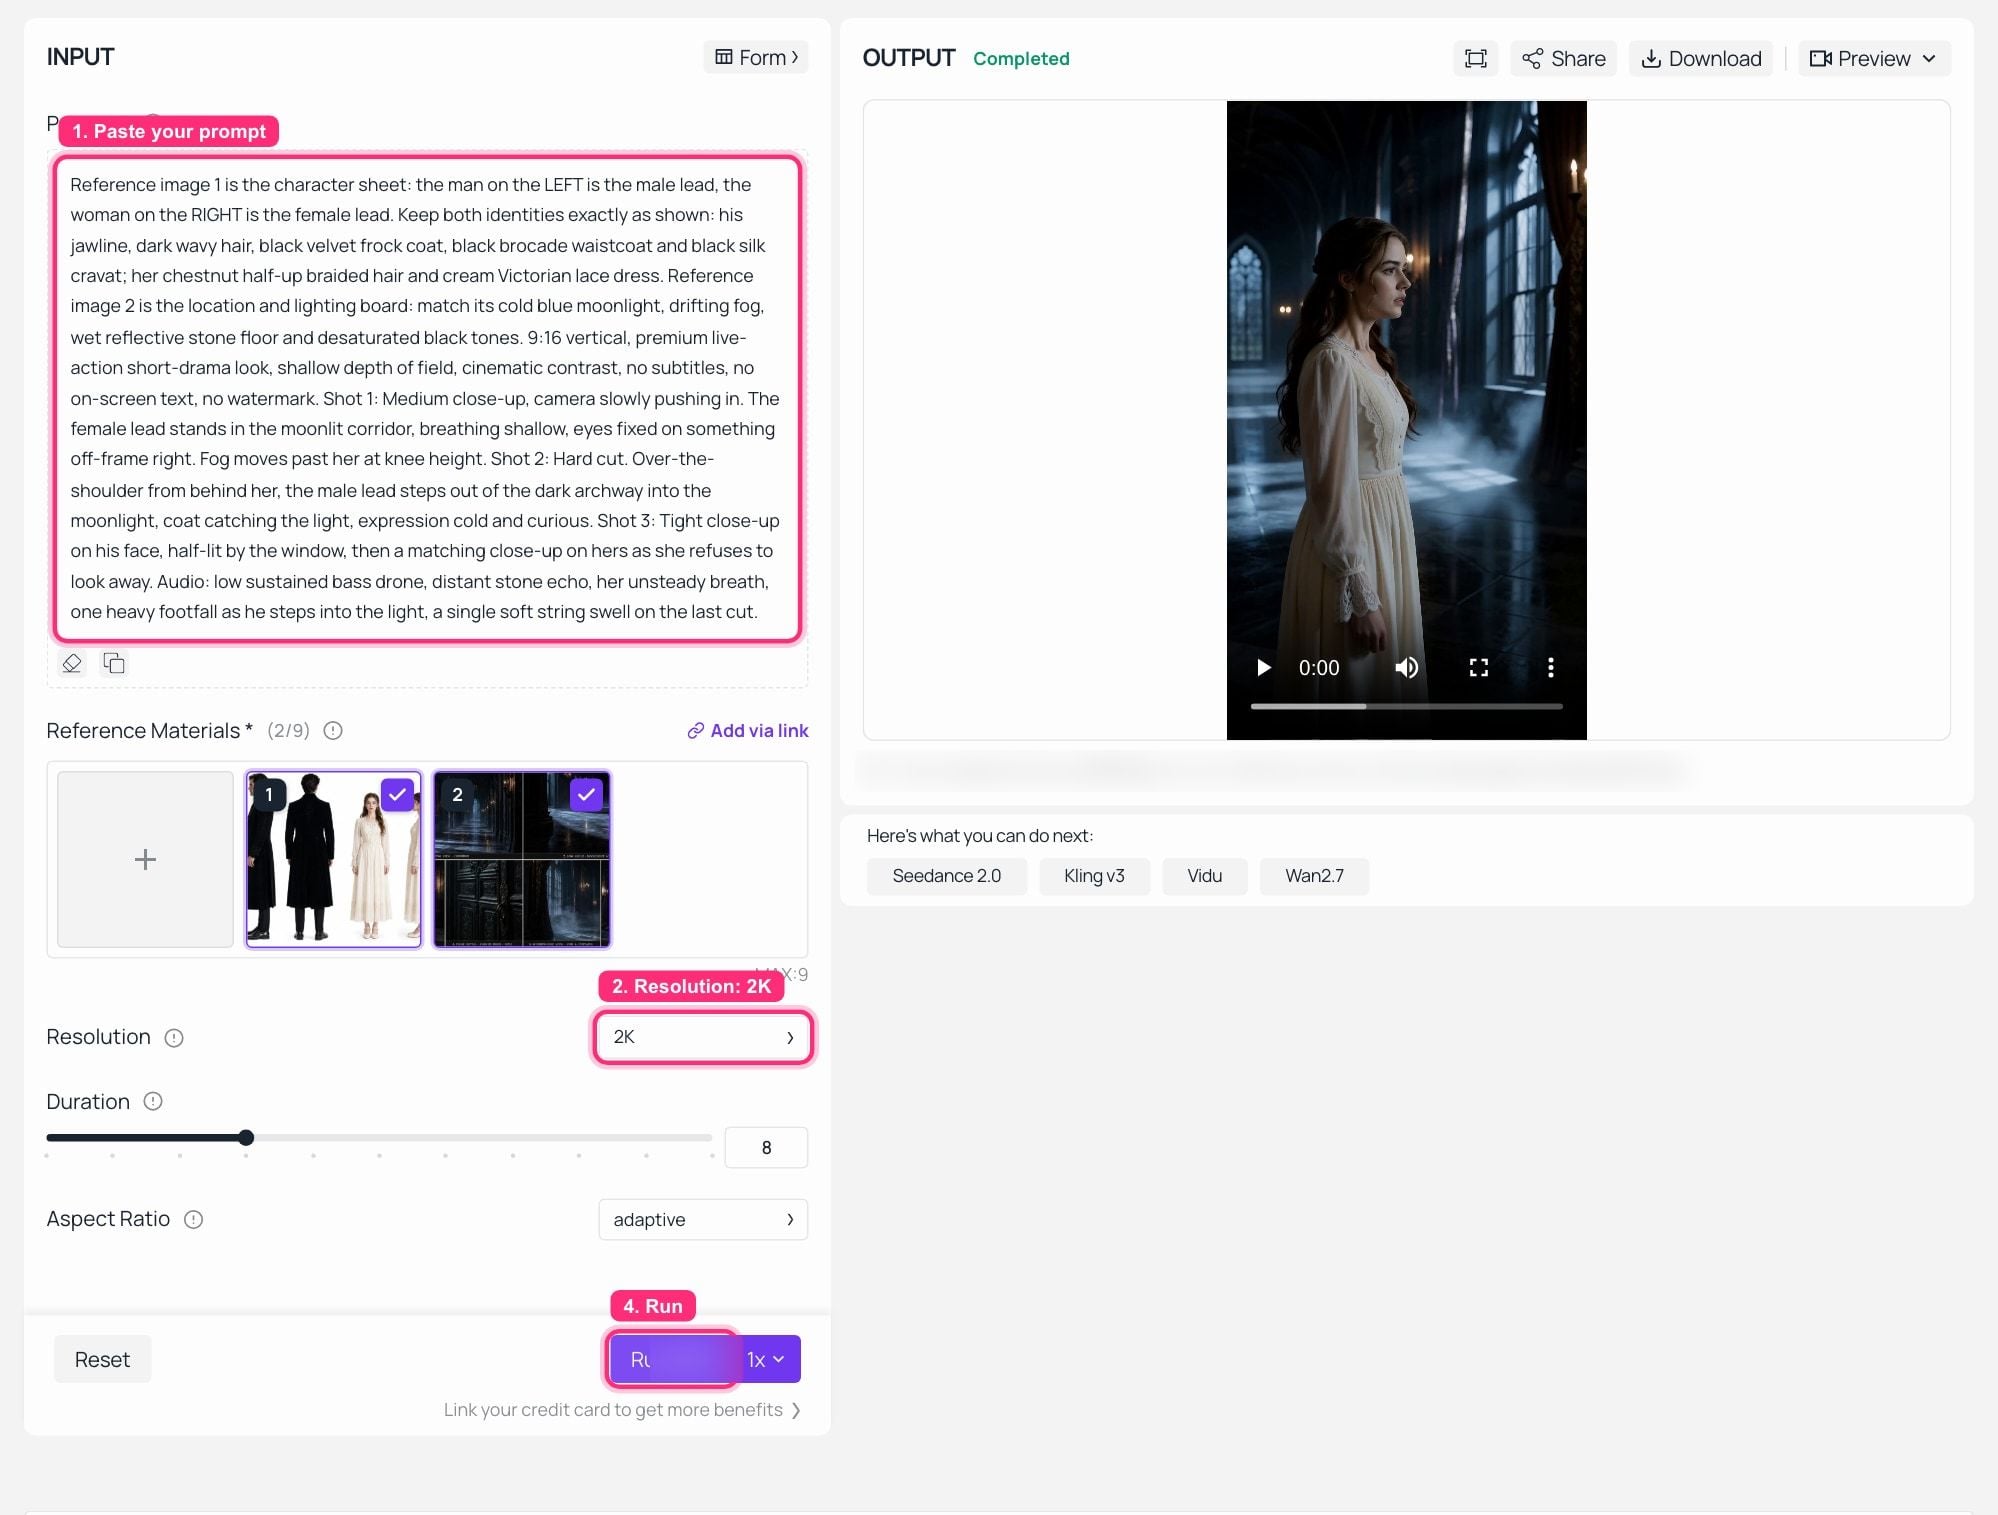 MiniMax H3 Reference-to-Video di Atlas Cloud, proses selesai: kedua file referensi dimuat sebagai 2 dari 9, resolusi 2K, dan klip vertikal yang dihasilkan diputar di panel OUTPUT.
Bingkai pertama adalah pemeran wanita utama dalam korset renda krem, berdiri di koridor dari panel papan 1, dengan kabut setinggi lutut dan cahaya bulan mengenai lantai basah persis di tempat papan meletakkannya. Kedua gambar referensi mendarat.
Langkah 4: Jalankan kontrol Seedance 2.5 vs MiniMax H3 dengan paket yang identik
Jangan ubah satu kata pun. Dua gambar referensi yang sama, prompt yang sama, model yang berbeda. Saya membiarkan default durasi masing-masing halaman sendiri daripada memaksakan kecocokan, dan saya katakan apa yang masing-masing kembalikan di bawah. Menulis ulang prompt "untuk" model lain adalah persis bagaimana perbandingan mulai berbohong.
plaintext1Prompt yang sama dengan Langkah 3, kata demi kata. Jangan menulis ulang untuk model lain.
Pengaturan: model Seedance 2.0 Reference-to-Video, Resolusi 720p, dua gambar referensi yang sama di Gambar Referensi (lagi 2 dari 9, dengan slot terpisah untuk hingga 3 video referensi dan 3 file audio referensi). Durasi dibiarkan pada default halaman, yang kembali sebagai klip 10 detik.
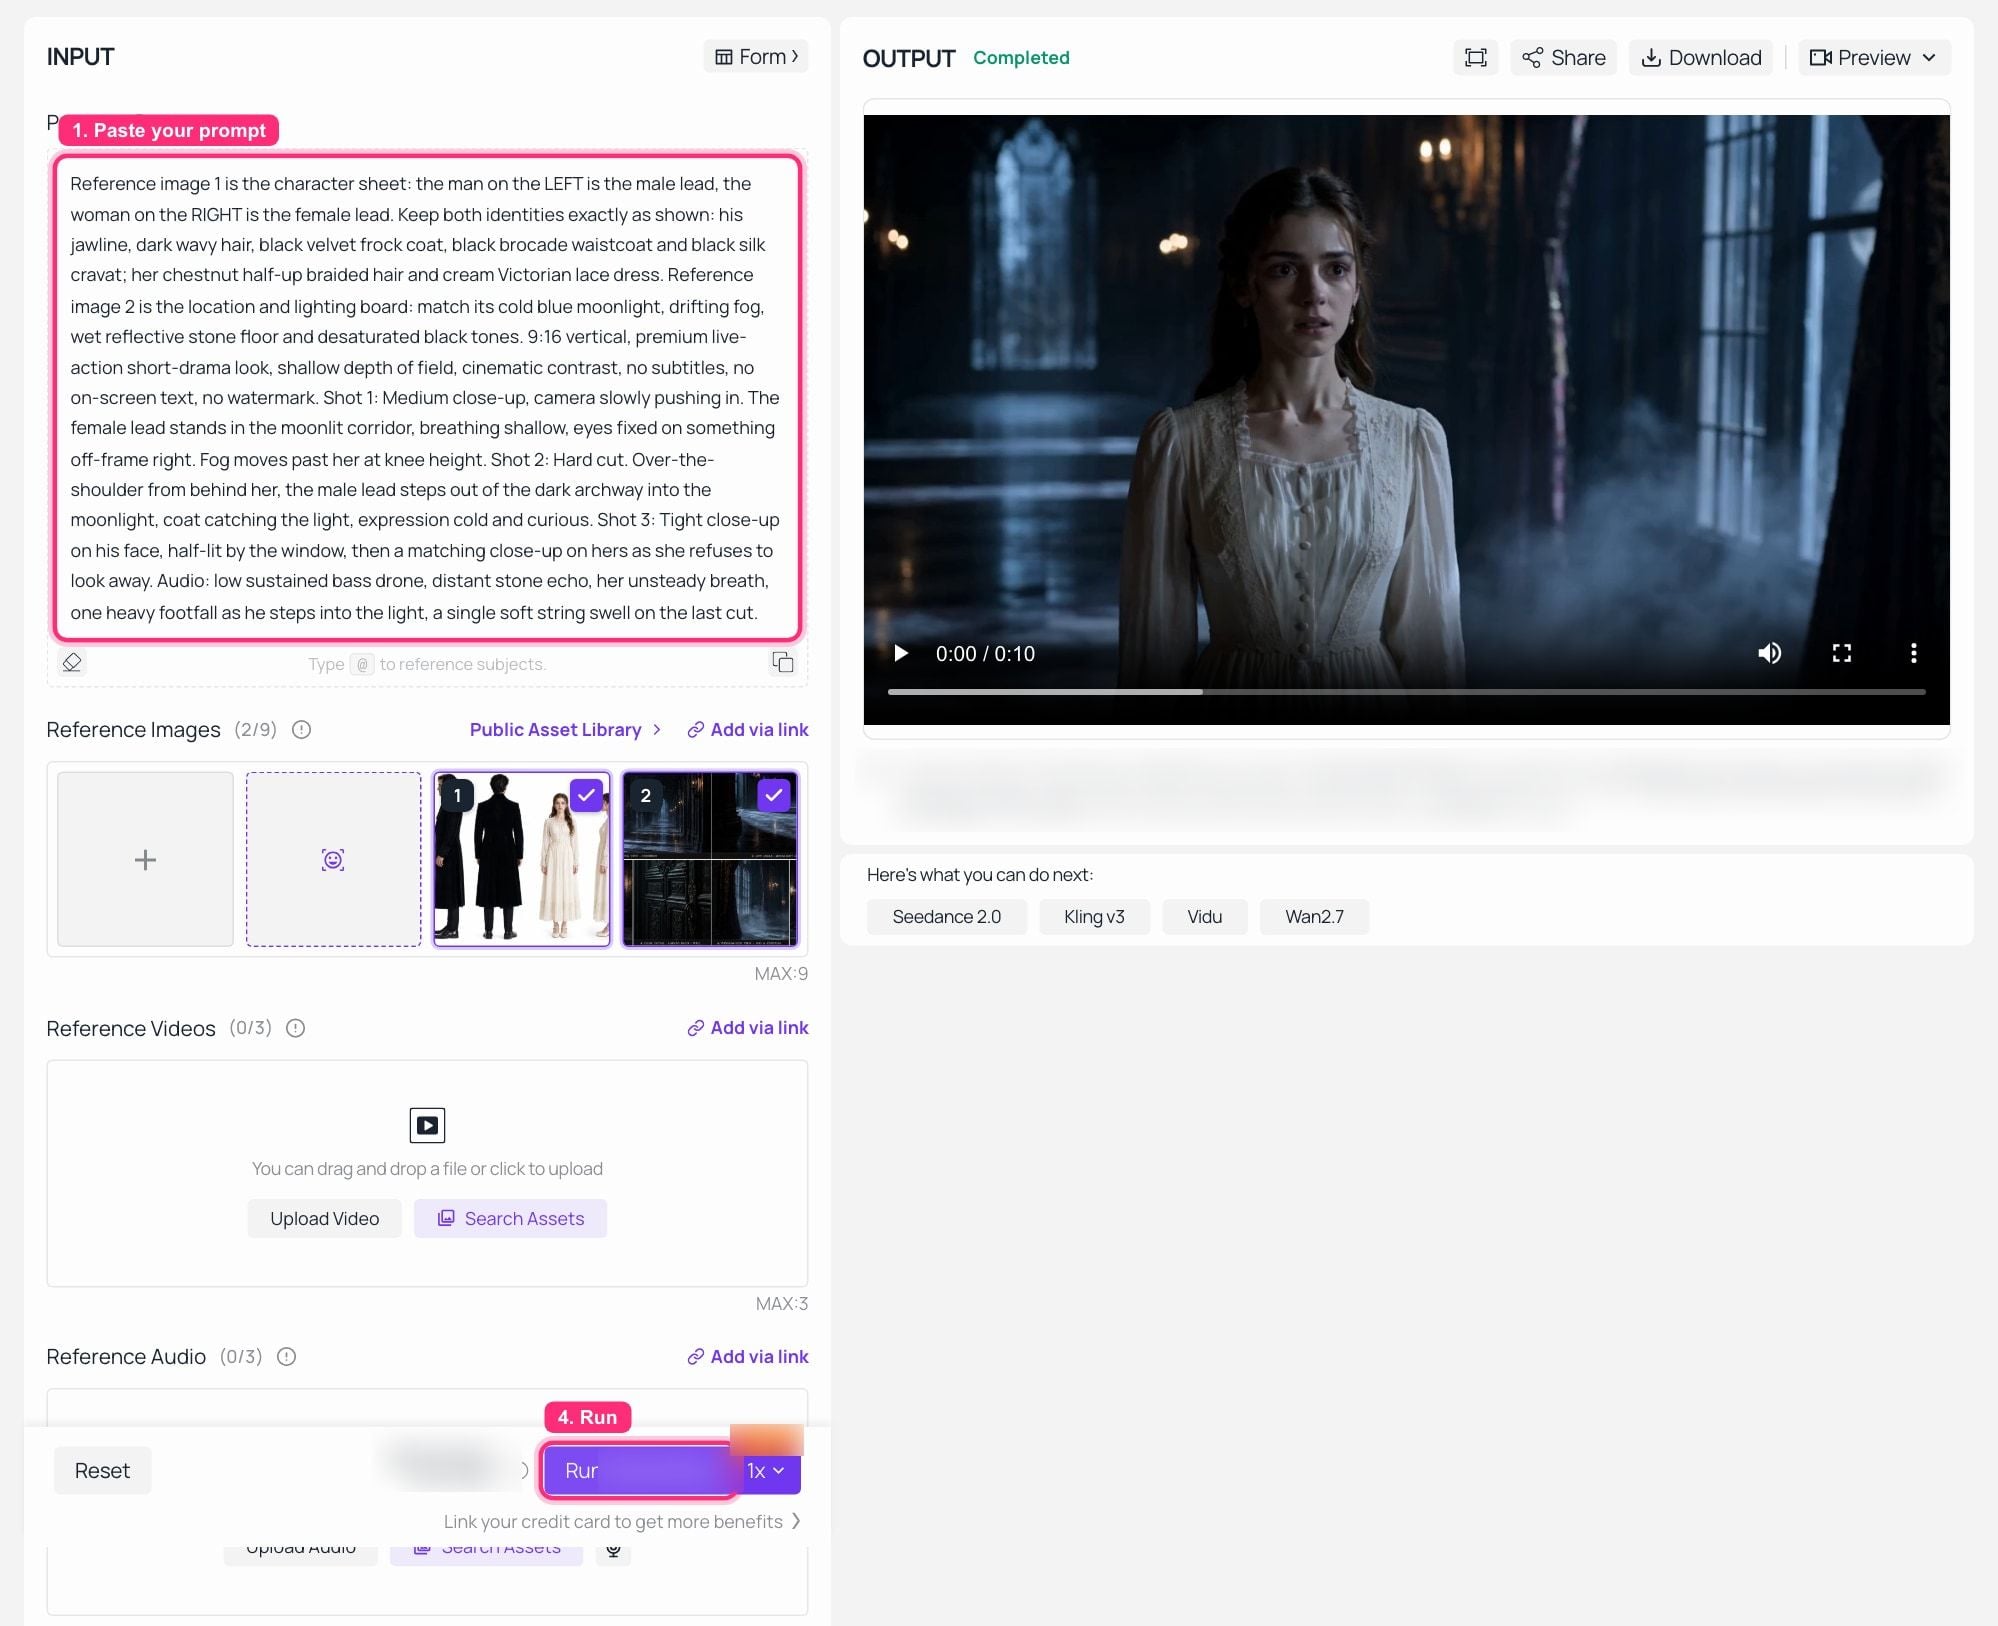 Seedance 2.0 Reference-to-Video di Atlas Cloud, proses selesai dengan paket referensi dan prompt yang identik dari Langkah 3, dan hasil 10 detik di panel OUTPUT.
Inilah yang sebenarnya ditunjukkan oleh kedua panel OUTPUT, dan saya melaporkannya secara datar daripada memilih pemenang.
Kedua proses mempertahankan karakter. Gaun renda krem yang sama dengan garis leher dan manset lengan yang sama, rambut kastanye yang sama, koridor kabut-dan-cahaya bulan yang sama diambil dari papan. Tidak satu pun yang menciptakan wanita yang berbeda. Paket referensi melakukan pekerjaan itu di kedua sisi, yang merupakan temuan yang paling saya pedulikan.
Perbedaannya adalah tentang bentuk, bukan wajah. Endpoint Seedance ini mengirimkan 720p; H3 mengirimkan 2K dari input yang identik. Dan perbedaan framing: H3 membaca "9:16 vertikal" langsung dari teks prompt dan mengembalikan vertikal, sementara proses Seedance kembali 16:9 karena halaman itu memiliki kontrol rasio aspek sendiri dan teks prompt saja tidak menimpanya. Jika Anda memotong untuk TikTok, perbedaan itu akan membuat Anda kehilangan satu proses pertama kali Anda lupa kolom formulir. Seedance 2.5 kemungkinan akan mengubah setengah resolusi ini dan menambahkan pengulangan ulang tingkat wilayah, dan saya tidak akan berpura-pura mengukurnya.
Langkah 5: Perbaiki satu shot tanpa mengulang seluruh klip
Biaya sebenarnya dari drama pendek bukanlah generasi pertama. Itu adalah revisi ketujuh. H3 menerima klip yang ada sebagai input dan mengedit sesuai instruksi, mempertahankan apa yang tidak Anda sebutkan. Tawaran Seedance 2.5 di sini lebih halus: menggambar ulang wilayah bingkai dan membiarkan performa, pencahayaan, dan kamera tetap sama.
plaintext1Menggunakan klip yang disediakan: pertahankan kedua karakter, pakaian mereka, gerakan kamera, dan ritme pemotongan persis seperti adanya. Ubah hanya lingkungan, ganti koridor batu yang diterangi cahaya bulan dengan ballroom kastil yang sama, jendela melengkung tinggi, lampu gantung menyala, dan cahaya lilin hangat, dan terangi ulang kedua karakter sehingga cahaya utama mereka berasal dari lampu gantung di kiri bingkai, bukan dari jendela. Tulis ulang satu-satunya baris ucapannya menjadi "Kamu tidak pernah tidur, kan." Pertahankan waktu performanya pada ketukan yang sama.
Pengaturan: MiniMax H3 Reference-to-Video dengan klip Langkah 3 sebagai input referensi, Durasi 5, Resolusi 2K.
Melampaui Tes Seedance 2.5 vs MiniMax H3: Empat Cara Mendorong Paket Referensi
Karakter yang sama, episode berikutnya. Simpan lembar Langkah 1 sebagai aset dan ubah hanya daftar shot dan blok cerita dalam prompt. Identitas berasal dari file, bukan dari ingatan Anda tentang bagaimana Anda merumuskannya Selasa lalu.
Jepit suaranya juga. H3 menerima hingga tiga referensi audio, masing-masing 2 hingga 15 detik, dan harus menyertai input gambar atau video. Berikan sampel suara dan karakter berbicara dengan timbre itu, sehingga Anda tidak perlu mengganti aktor suara antar episode.
Blok kamera sebelum Anda membayar untuk render. Referensi-ke-video Seedance 2.5 menerima blokout model 3D putih dan pelat layar hijau, sehingga Anda dapat mengunci framing pada geometri abu-abu dan baru kemudian berkomitmen pada tampilan akhir. Contoh ini berjalan di Seedance 2.1, anggota keluarga sebelumnya, tetapi bentuk alur kerjanya sama.
Lokalkan satu potongan master alih-alih memotret ulang. Penggantian tingkat wilayah menukar wajah, produk, atau bahasa lisan sementara kamera, waktu, dan durasi bibir tetap sama. Di sini satu potongan kecantikan master diganti peran dan disuarakan ulang untuk bahasa Spanyol, Korea, dan Hindi, dengan ruangan, framing, dan durasi bibir dipertahankan.
Dan karena seseorang akan bertanya seperti apa transfer gerakan ketika Anda berhenti bersikap masuk akal: tiga pria dalam setelan, digantikan oleh tiga kapibara fotorealistik, mengikuti jalur gerakan klip asli ketukan demi ketukan sampai mereka menumpuk menjadi piramida.
Ada juga versi polos dari semua ini, yang tidak diposting siapa pun: poster statis menjadi poster bergerak, dan tata letaknya bertahan.
 Poster sumber statis. Berikan ke referensi-ke-video dengan "pertahankan bingkai, palet, dan tata letak, animasikan tipenya" dan Anda mendapatkan versi bergerak dari desain yang sama.
Berapa Biaya Sebenarnya dari Film Pendek Seedance 2.5 vs MiniMax H3
Tidak ada angka di sini, karena angka bergerak dan strukturnya tidak. Kedua keluarga menagih per detik, bayar sesuai pemakaian, tanpa kursi dan tanpa langganan. Itu menyisakan tiga variabel: detik, tingkat resolusi, dan pengulangan ulang.
Yang ketiga adalah seluruh tagihan. Klip 15 detik yang berhasil pada percobaan pertama adalah satu kali biaya. Klip yang sama pada percobaan ketujuh adalah tujuh kali. Jadi langkah menghemat uang bukanlah memilih model per detik yang lebih murah, itu adalah mendapatkan paket referensi yang benar sebelum Anda menghasilkan apa pun. Dua panggilan gambar di Langkah 1 dan Langkah 2 adalah baris termurah di seluruh pipa dan yang menentukan berapa banyak panggilan video yang Anda buat. Pengembalian tertinggi atas pengeluaran di seluruh rantai, dengan jarak yang jauh.
Kemudian perbaiki insting per detik. Paket referensi yang sama, waktu proses yang sama: referensi-ke-video H3 mengembalikan 1440p, endpoint referensi-ke-video Seedance ini mengembalikan 720p. Per detik adalah unit yang salah. Piksel per bingkai, dan apakah Anda kemudian harus membayar untuk proses upscale terpisah, adalah unit yang tepat.
Audio juga termasuk dalam aritmetika. Kedua sisi menghasilkan suara tersinkronisasi asli dalam proses yang sama. Jika pipa Anda saat ini adalah model video plus TTS plus editor yang menyelaraskan trek, apa yang Anda hemat adalah dua panggilan API dan sore hari seseorang, dan penghematan itu tidak muncul di daftar harga mana pun.
Yang mana untuk pekerjaan yang mana:
| Pekerjaan | Pilih | Mengapa | Peringatan |
|---|---|---|---|
| Drama pendek vertikal, 9:16, TikTok atau ReelShort | MiniMax H3 | 1440p vertikal dengan stereo asli, dapat dipanggil sekarang, 15 detik adalah kait penuh | Anda memotong pada 15 detik, jadi rencanakan ketukan sesuai |
| Film merek 30 detik kontinu satu | Seedance 2.5 | generasi tunggal, tanpa penyambungan, 4K asli | periksa ketersediaan di platform Anda terlebih dahulu |
| Memperbaiki satu shot dalam potongan yang disetujui | Seedance 2.5 | gambar ulang tingkat wilayah membiarkan sisanya tetap sama | H3 pengeditan seluruh klip sudah cukup untuk sebagian besar hari ini |
| Potongan produk dan e-commerce | salah satu | keduanya mempertahankan teks di layar dan tanda merek dengan baik | verifikasi teks pada resolusi yang Anda kirim |
| Demo game atau antarmuka | MiniMax H3 | Stabilitas UI dan tipografi pada 2K kuat | batas 15 detik untuk satu proses |
| Versi multi-bahasa dari satu master | Seedance 2.5 | penggantian wilayah plus suara multi-bahasa | kualitas lokalisasi masih perlu pemeriksaan penutur asli |
| Pengiriman malam ini | MiniMax H3 | tiga endpoint langsung, plus semua Seedance 2.0 | Akses Seedance 2.5 bervariasi menurut platform |
Sebelum Anda mengirim. MiniMax mengatakan bobot H3 akan menyusul dalam beberapa hari setelah peluncuran, dan bobot terbuka tidak sama dengan lisensi komersial, jadi baca ketentuannya sebelum Anda host sendiri. Kebijakan tanda air dan penggunaan komersial juga berbeda antara aplikasi konsumen dan akses API di kedua sisi, dan saya tidak dapat mengonfirmasi salah satu dari halaman ketentuan utama saat menulis ini, jadi periksa ketentuan penyedia daripada mengambil kata-kata saya. Dan tidak ada dalam lisensi model apa pun yang mencakup kemiripan atau merek dagang. Jika orang sungguhan, merek sungguhan, atau kekayaan intelektual orang lain ada dalam paket referensi Anda, itu adalah pertanyaan hukum terpisah dan ketentuan model tidak akan menjawabnya.
Setiap model dalam tabel di atas berjalan pada kunci yang sama, dan halaman model membawa tarif saat ini plus kode salin-tempel, termasuk promosi apa pun yang mungkin berjalan di lini Seedance minggu ini.
Pertanyaan yang Sering Diajukan
Apakah Seedance 2.5 lebih baik dari MiniMax H3 untuk konsistensi karakter?
Di atas kertas seharusnya begitu, dengan hingga 50 referensi multimodal dibandingkan 12 file H3, ditambah pengulangan ulang tingkat wilayah. Tapi per 31 Juli 2026 belum ada tes publik berpasangan yang bisa saya tunjukkan, dan Seedance 2.5 belum memiliki peringkat arena. Dalam proses yang benar-benar bisa saya lakukan, variabel yang menentukan stabilitas identitas adalah struktur paket referensi, bukan generasi model: dengan satu lembar turnaround komposit ditambah satu papan pencahayaan, kedua sisi mempertahankan karakter. Dapatkan paket yang benar sebelum Anda menghabiskan waktu berbelanja model.
Bisakah saya menggunakan Seedance 2.5 sekarang, atau harus menunggu?
API-nya sudah langsung di ByteDance. Ketersediaan di platform model pihak ketiga tidak merata, dan di platform yang saya uji masih berupa pemberitahuan Day-0. Jika Anda membutuhkan keluaran malam ini, opsi yang dapat dipanggil adalah tiga endpoint MiniMax H3 dan seluruh lini Seedance 2.0 yang sedang dikirim.
Apakah MiniMax H3 benar-benar menghasilkan video 30 detik?
Tidak. Spesifikasinya adalah 5 hingga 15 detik per generasi pada 24fps. Lebih dari itu adalah ekstensi atau penyambungan, yang merupakan hal yang berbeda dengan risiko penyimpangan yang berbeda. Generasi tunggal 30 detik adalah milik Seedance 2.5. Jangan biarkan kedua klaim itu kabur.
Apakah kedua model menghasilkan audio, dan bisakah saya mempertahankan satu suara di seluruh episode?
Keduanya menghasilkan audio tersinkronisasi asli dalam proses yang sama, dan H3 mengeluarkan stereo pada setiap hasil. Untuk suara yang persisten, H3 menerima hingga tiga referensi audio masing-masing 2 hingga 15 detik, yang harus dikirimkan bersama input gambar atau video, bukan sendiri.
Berapa banyak gambar referensi yang sebenarnya harus saya kirim?
Lebih sedikit dari yang Anda kira, terstruktur lebih baik dari yang Anda kira. Satu komposit yang tersusun dengan baik umumnya lebih baik daripada enam potongan longgar, karena file terpisah mengundang model untuk merata-ratakannya menjadi orang yang tidak ada. Berikan dua pekerjaan yang jelas, identitas dan pencahayaan, dan jangan sertakan sampel gaya yang saling bertentangan.
Model mana yang harus saya gunakan untuk drama pendek vertikal ala TikTok atau ReelShort?
Pengiriman minggu ini, dalam 9:16, pada resolusi tinggi dengan suara sudah tercampur: MiniMax H3. Merencanakan adegan kontinu 30 detik di mana Anda berharap untuk mengulang ulang wilayah tunggal daripada seluruh klip: bangun untuk Seedance 2.5 dan periksa kapan platform Anda membukanya.


