Production agentic pipeline sering mengalami crash akibat pelanggaran skema yang tidak terduga. Bahkan LLM autoregressive kelas atas pun bisa gagal melakukan parsing JSON ketika panggilan alat terjadi dalam volume tinggi, sehingga developer terpaksa membangun retry loop yang rumit dan error handler khusus.
TypeSafe Jev mengatasi kelemahan struktural ini dengan meninggalkan sepenuhnya generasi token-demi-token yang berurutan. Sebagai model keputusan non-autoregresif, Jev menyerap state aplikasi lalu mengevaluasi pertanyaan skema yang sudah dideklarasikan dalam satu forward pass paralel. Karena semua kemungkinan keluaran sudah dibatasi ketat sebelum eksekusi, Jev secara matematis menghilangkan JSON malformed, nama tool yang tak valid, maupun teks di luar skema.
Ringkasan Singkat: Apa Itu TypeSafe Jev AI? Benchmark Performa & Kecepatan
TypeSafe Jev AI adalah model keputusan yang non-autoregresif yang dibangun khusus untuk keperluan klasifikasi sub-detik, penilaian intensi, dan routing microservice terstruktur. Berbeda dengan LLM autoregressive, Jev mengevaluasi pilihan skema yang telah dideklarasikan dalam satu forward pass tunggal.
- Zero Hallucination pada Tingkat Tipe: Menggantikan loop decoding string dengan primitif skema status terbatas, sehingga angka error tipe menjadi 0%.
- Eksekusi Sub-500ms: Parallel sampling non-autoregresif menghasilkan latensi P95 70ms–500ms hingga 200 kali lebih cepat dibandingkan LLM standar.
- Token Output Gratis: Tidak ada token sekuensial yang dihasilkan, sehingga token output bergratis dengan tarif $0.042/1M token input.
- Terbaik Untuk: Routing, dispatching alat agenik, triase tiket, dan pemisahan intent menjadi gate.
Memikir Ulang Tumpukan AI: Intuisi System 1 vs. Penalaran System 2
Dalam membangun perangkat lunak backend yang skalar, memaksa setiap pemeriksaan kondisi sederhana lewat endpoint chat completion yang berat justru menciptakan latensi sistem yang parah. Kebanyakan microservice tidak membutuhkan prosa kreatif ataupun proses berpikir multi-langkah; yang mereka butuhkan adalah pemilihan atas pilihan yang sudah diketahui dengan segera dan deterministik.
Menerapkan Kerangka Kogitif Kahneman pada Arsitektur Perangkat Lunak
Pendiri bersama TypeSafe, Diogo Almeida — yang sebelumnya ikut menciptakan Reinforcement Learning from Human Feedback di OpenAI — memperkenalkan pivot struktural dengan TypeSafe Jev untuk mengatasi inefisiensi ini. Mengambil kerangka kognitif Kahneman secara langsung, platform ini membagi dua lapisan operasional yang berbeda dalam arsitektur AI modern:
- System 2 — Penalaran Otak Lambat dan Cara Penuh Wacana: Sistem ini berupa LLM autoregressive standar yang bekerja dengan melakukan generasi token-demi-token secara berurutan. Kemampuan utamanya dalam menyusun dokumen panjang, menangani penalaran yang ambigu, dan menulis kode kompleks.
- System 1 — Keputusan Cepat dan Intuitif: Lini baru yang merupakan model AI System 1 yang didedikasikan, dilatih melalui Reinforcement Learning for Calibrated Decisions (RLCD) ketimbang RLHF tradisional. Model ini dioptimalkan secara khusus untuk klasifikasi, penilaian intent, dan routing eksekusi dalam waktu sub-detik tanpa overhead percakapan.
Biaya & Arsitektur Jev vs LLM: Keputusan dari Model Keputusan vs. Chat
Mengganti model chat general dengan specialized decision-ro model diubah menjadi layer terpisah akan memungkinkan alur kerja microservices mengoptimasi proses eksekusi dengan memisahkan evaluasi cepat dari tugas generasi mendalam.
| Dimensi Arsitektur | LLM Autoregressive (System 2) | TypeSafe Jev (System 1) |
| Tugas Utama | Sintesis teks bebas-mengental | Pilihan diskrit dan evaluasi skema |
| Latensi Eksekusi | 3.000 ms hingga 30.000 ms+ | 70 ms hingga 500 ms |
| Format Output | Aliran teks tanpa struktur | Bilai primitive tipe yang terstruktur ketat |
| Loop Komputasi | Hiatus token secara sequential | Evaluasi satu forward-pass |
| Objective Pelatihan | Preferensi manusia (RLHF) | Confidence kalibrasi keputusan (RLCD) |
Dengan melepas routing, guardrails pengaman, serta pemilihan fungsi routing dari model chat standar, akan menghilangkan bottleneck yang memang ada di dalam LLM auto regresif. Menghadirkan Model Khusus System 1 akan membuat mesin penalaran beban besar hanya aktif ketika sistem benar-benar harus menghasilkan teks terbuka.
Cara Model TypeSafe Jev Memberikan Zero Halluzication pada Level Tipe
Bahkan ketika JSON strict mode diaktifkan, LLM frontier masih kerap menghasilkan kunci di luar skema atau nilai enum hasil halusinasi pada production yang kejal seiring waktu, menyebabkan 0,5% hingga 5% permintaan roda pipeline gagal. Microservice menuntut determinisme tipe absolut, namun autoregressive model tetap rentan terhadap kesalahan string.

TypeSafe Jev menyelesaikan masalah ini dengan mengganti loop decoding string menjadi arsitektur state terbatas. Alih-alih menghasilkan teks acak lalu memaksa syntax JSON untuk menerapkan hasilnya ke dalam skema yang telah ditentukan dalam satu pass. Pergeseran struktural ini membawa level hallucination 0% yang sempurna pada tingkat tipe, dan menghasilkan error tipe 0% di seluruh aliran kerja terotomatisasi.
Tiga Primitif Skema Inti
Jev memproses semua pertanyaan masukan melalui tiga primitif yang jelas:
- Choice Primitif: Memilih tepat satu opsi dari daftar yang sudah ditentukan dengan satu opsi, sampai 255 kategori, mengembalikan label yang menang dan distribusi probabilitas penuh.
- Score Primitif: Menilai input dalam skala dengan interval berurut atau rubrik deskriptif, memberikan rating dan rentang kemungkinan untuk setiap level.
- Noul Primitif: Menung hitung probabilitas pasti /tidak kondisi dalam bentuk float antara 0.0 dan 1.0, tanpa teks naratif tambahan.
Karena setiap query secara strategis memetakan ke tiga primitif ini, mesin eksekusi tidak memiliki kemungkinan untuk mengeluarkan key yang invalid, nama tool di luar daftar, atau key di luar skema.
Type Safety dalam Evaluasi Structured Output
Model chat tradisional biasanya menggunakan sintaks karakter-per-karakter; ini menciptakan risiko parsing yang tetap pada pipeline backend.
| Metrik Evaluasi | Autoregressive JSON Mode | TypeSafe Jev System One |
|---|---|---|
| Penegakan Output Type | Validasi string setelah generasi berlangsung | Primitif matematis terbatas secara native |
| Frekuensi Type Error | Variasi (0.5% hingga 5%+ error) | 0% error (batasan skema) |
| Risiko Enum Tidak Valid | Tinggi tanpa retry loop custom | No (tidak mungkin secara desain) |
Membatasi eksekusi model hanya pada state terbatas menjamin evaluasi structured output yang andal. Aplikasi dapat langsung mengkonsumsi output Jev tanpa menulis exception handler untuk schema JSON yang rusak.
_Catatan tentang Deterministika Tipe vs. Probabilitas: TypeSafe Jev menjamin 0% kesalahan tipe dan kesesuaian skema dengan rancangan matematis yang menghilangkan sintaks malformed, key hilang, atau nilai enum di luar daftar. Namun sperti semua model keputusan, hasil pilihannya tetap bersifat probablistik. Untuk input yang memang ambigu, sebaiknya gunakan confidence score untuk gate eksekusi, bukan mengasumsikan kepastian semantik yang mutlak._
Bagaimana Parallel Sample Non-Auturegresif Mendorong Latensi Sub-500ms dan Output Gratis
Menggunakan endpoint chat standar untuk tag klasifikasi sederhana seperti {"category": "billing"} sebenarnya memasukkan latensi tak perlu ke dalam production. Karena model autoregressive bergantung pada sequential token decoding, backend thread dapat tersumbat saat proses ini berjalan dengan loop generasi per karakter.
Bagian dari Single Forward Pass Evaluation
Transformer tradisional harus menjalankan loop generasi autoregressive di mana setiap token baru melakukan forward pass tetap yang lengkap melalui layer jaringan. Ketergantungan berurutan ini menciptakan latensi besar dan biaya infrastruktur yang meningkat berdasarkan jumlah token yang dihasilkan.
TypeSafe Jev menghilangkan generasi yang berurutan dengan non-autrorgigressiff parallel sampling. Sebagaimana disebutkan dalam rilis perdana TypeSafe, Jev langsung mengubah context state dan mengevaluasi dalam satu forward pass pada semua pilihan skema yang telah diussulkan.
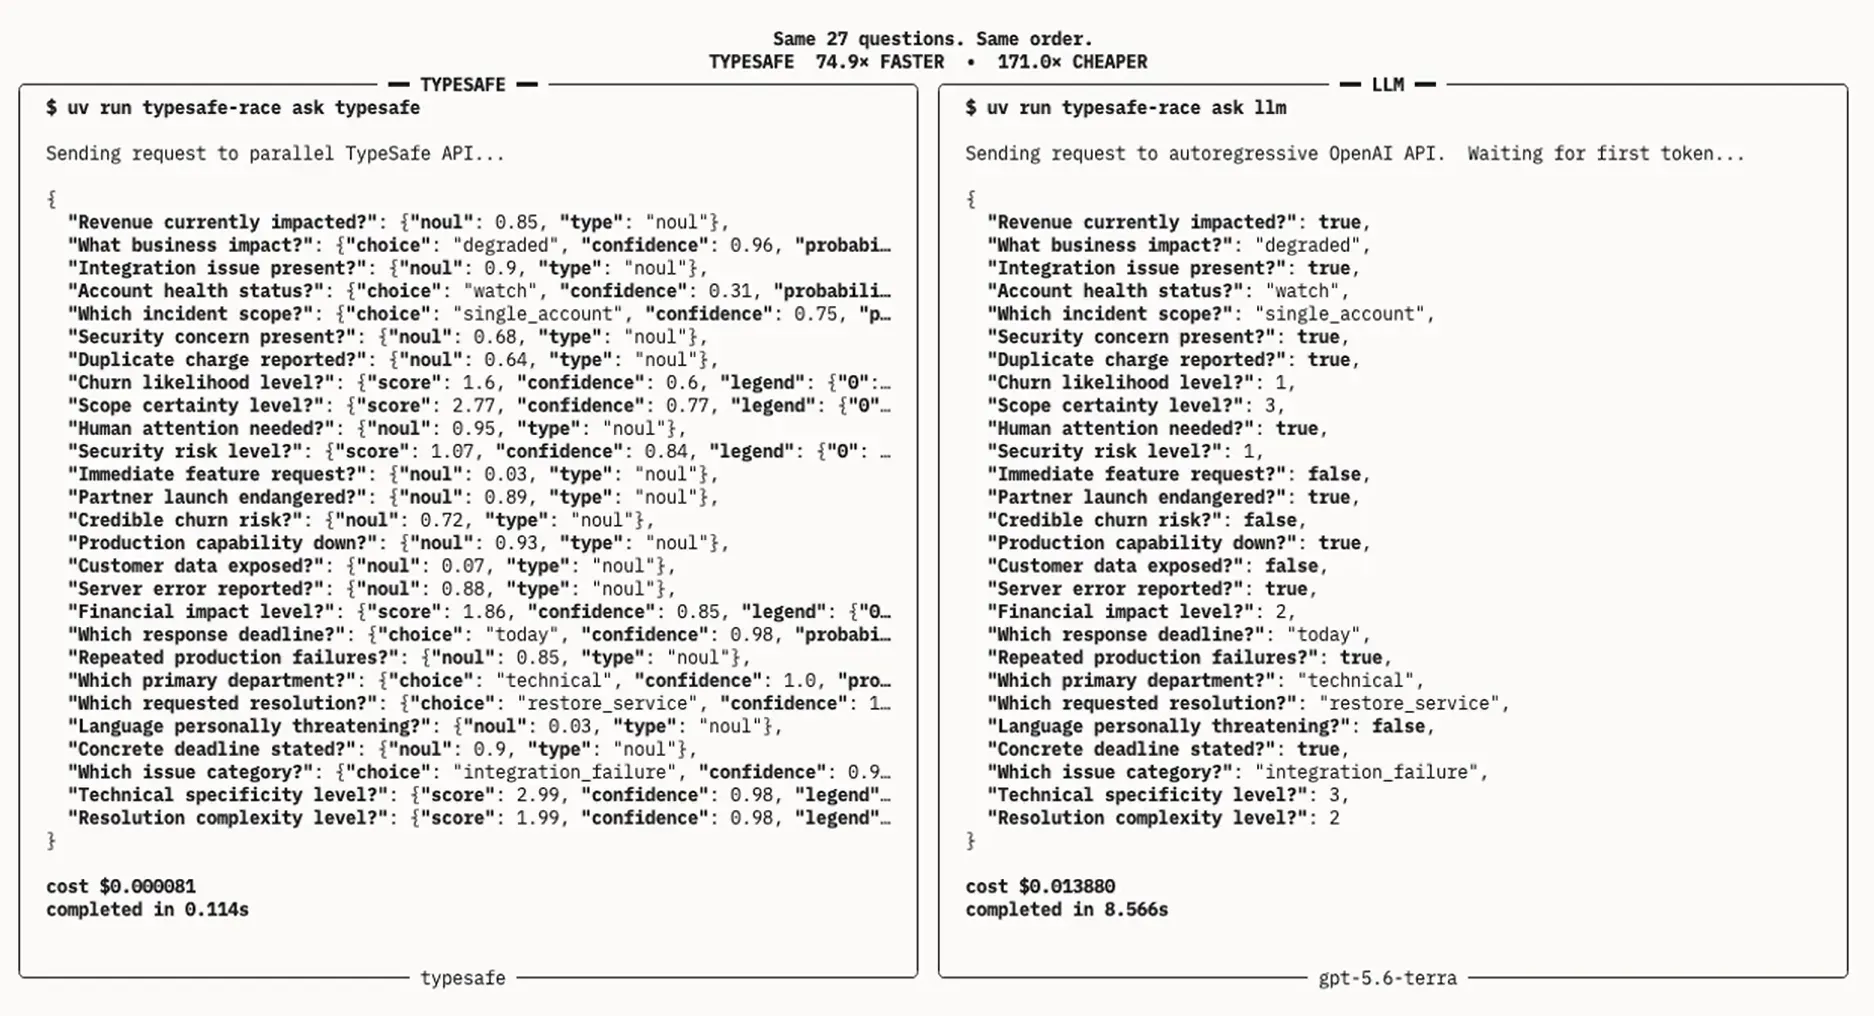
Terminal benchmark di atas menjalankan 27 evaluasi pertanyaan skema secara paralel di TypeSafe Jev vs endpoint GPT 5.6 Terra
Karena model Jev menghitung distribution probabilitas di atas output yang telah ditentukan, bukan teks bebas, loop decode output menghilang sepenuhnya., menghasilkan tiga keuntungan performa utama:
- Token Output Gratis (Terlalu Murah untuk Diukur): By the summary: Karena Jev mengevaluasi pilihan dalam single forward pass tanpa menghasilkan generative token berurutan, beban komputasi dan output menjadi hampir nol — sehingga output token secara efektif gratis.
- Preeprosible Pricing: Biaya pemrosesan konteks tetap datar $0.042 per juta token input text yang dimasukkan. Evaluasi terhadap “behavioralute skema” yang statis ketika menggunakan menggunakan Jev mencegah tagihan API membengkak di bandingkan dengan beban eksekusi konteks panjang traditional chat bot berat yang menggunakan endpoint chat.
- Sub-Second Execution: Latency benchmark yang dipublikasikan yang ditunjukkan oleh tipe J La menunjukkan P95 dari 70ms–500ms secara konsisten; bahkan hingga 200 kali lebih cepat dari model chat model frontier.
Decompositions Performa Arsitektur
| Metric / Dimension | Traditional Autoregressive (System 2) | TypeSafe SystemOne Engine |
|---|---|---|
| Loop Eksekusi | Seq token decoding | Satu kali pass paralel untuk skema terdeklarasi |
| Types Output | Text /JSON string/string | Primitives (Choice, Score, Noul) |
| Error Rate Schema | 0.58%-45% berdasarkan | Error type 0% (definitif bounded) |
| P95 Latensi | 3k-30,000ms+ | 70ms - 500ms |
| Ekonomi Output | Variable per-Token ($15-60/Mtk) | Free, tidak meter*jika aktiv gradient |
| Kolaborasi inti | Synthesis reasoning, drawwicking | Classification, choosing tool, probability truth gate |
Melewati Bottleneck Memory Bandwidth
Dalam inferensi LLM klasik, bandwidth memory jenuh yang tinggi saat setiap token Loads weight secara berulang. Dengan menyelesaikan evaluasi keputusan dalam satu pass saja, Jev mampu menghilangkan bottleneck tersebut dan menjaga kecepatan respons stabil bahkan ketika lalu lintas secara bersamaan,.
Reinforcement Learning dengan Calibrated Decision dan Confidence Gate
Standar model chat segment seringkali menghasilkan pernyataan yang keliru namun memberi 99% confidence percentage pada system. Karena RLHF traditional menggenapkan penggunaan persuasi, bukan statistikal truth. Di dunia microservice, kepercayaan yang tinggi pada keputusan yang salah menyebabkan kerusakan database, parameter panggilan tool rusak, hingga aplikasi tidak responsif.
Mensejajarkan Confidence pada Akurasi Empiris
Untuk memecahkan masalah overconfidence struktural ini, TypeSafe memperkenalkan RL for Calibrated Decision. Tidak seperti RLHF yang metriknya preferensi manusia t, RLCD melatih model keputusan secara presisi untuk menghasilkan probabilitas yang terkalibrasi.
Kalaw makin 0.90 pada Jev berarti kandidat tersebut benar-benar teracak 90% pada set test. Kalibrasi matematis ini membuat probabilitas keputusan yang handal dan transparan tanpa harus membuat heuristics cara prompt untuk mengukur keyakinan hasil.
Menerapkan Confidence-Gated Routing di produksi
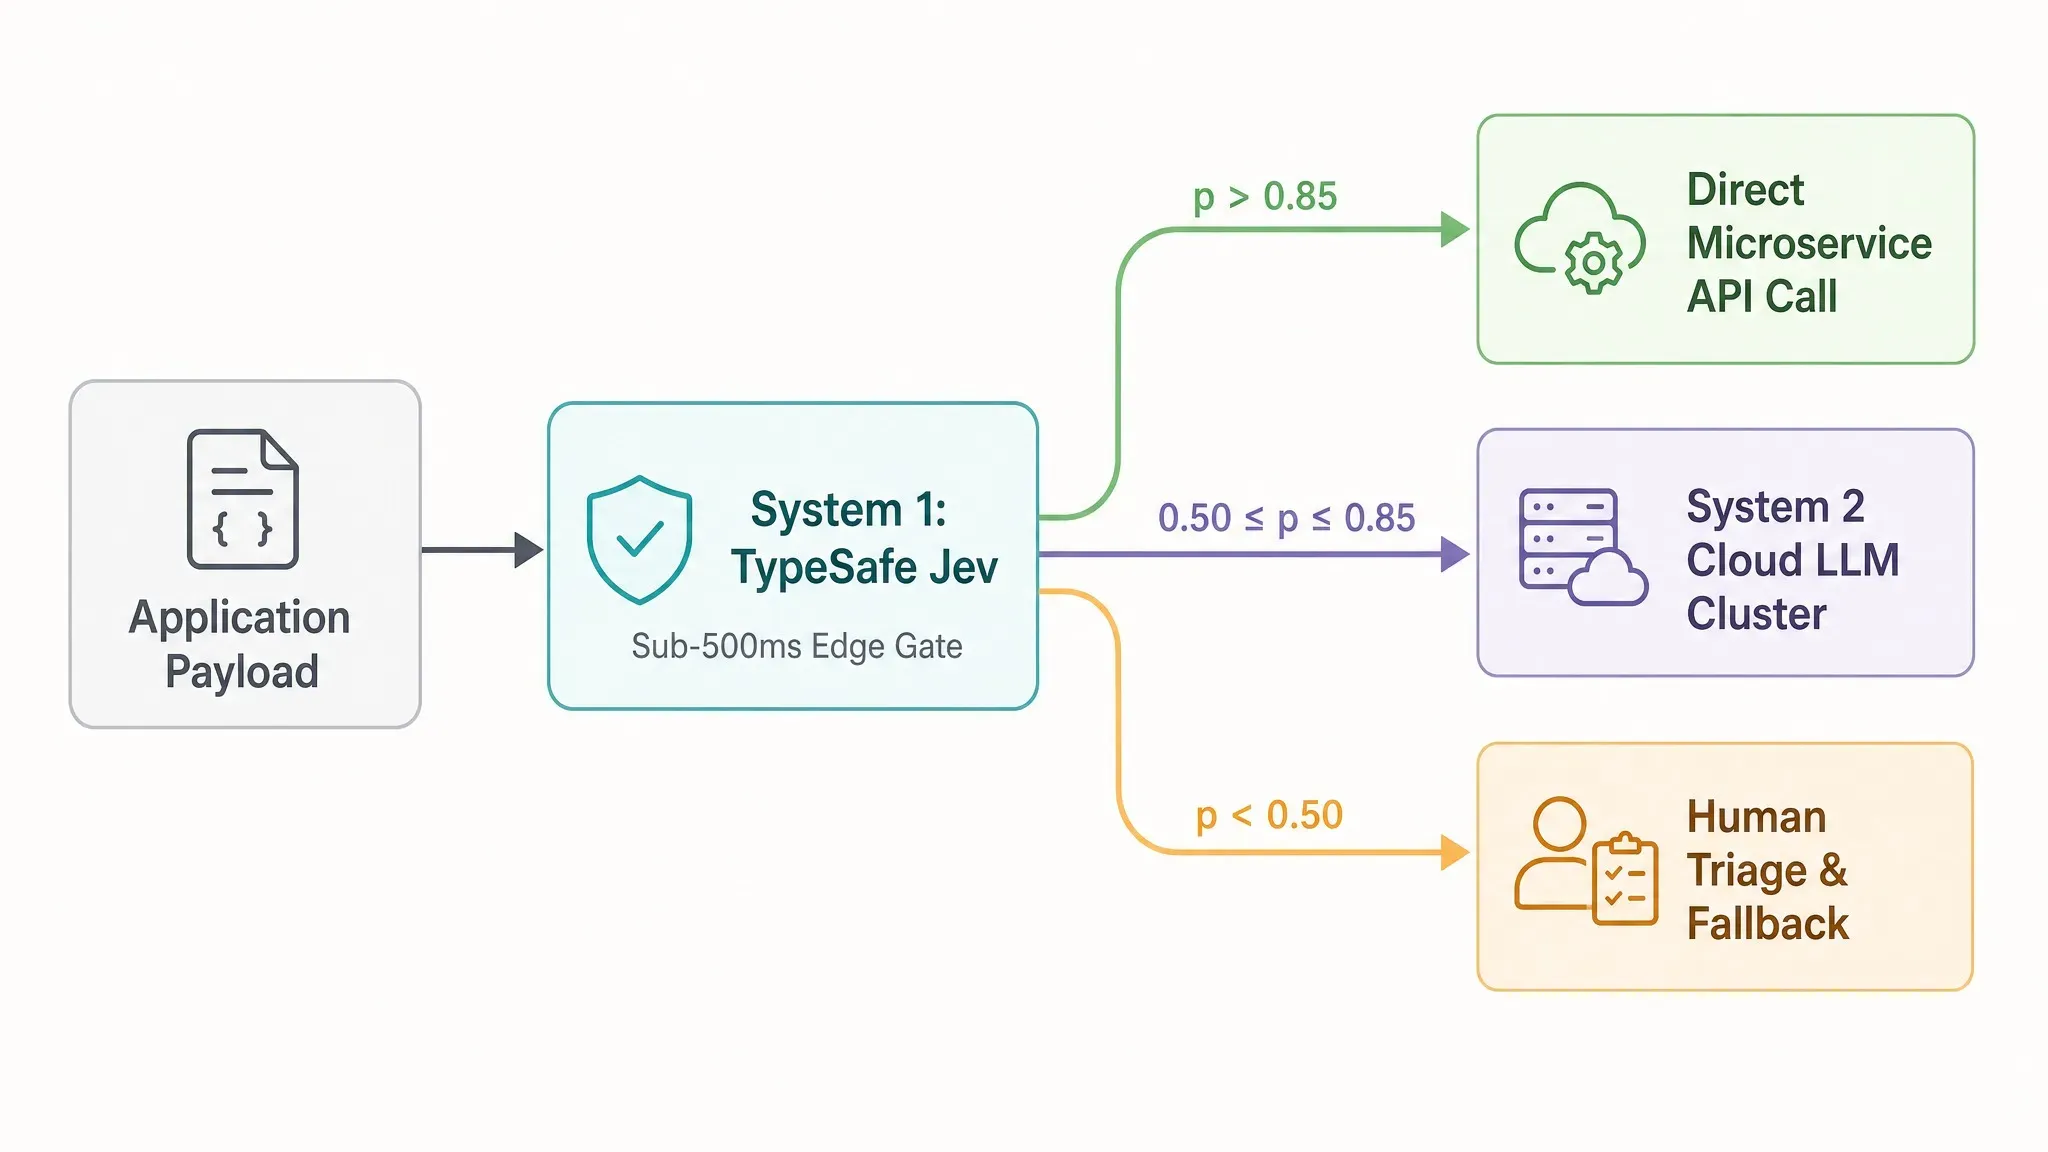
Engineer dapat memanfaatkan distribusi probabilitas terkalibrasi ini untuk setting decisiongate treshold, contoh tersebut dalam satu pola production tips:
p > 0,85(Fast-Path Execution):* dieksekusi dari tanpa nilai koreksi.0.50 ≤ p ≤ 0.85(System 2 Escalation): alihkan ke dalam natively yang lebih deep untuk case yang tidak jelas.p < 0.50(Fallback Triage): Hidupkan fallback Default atau push ke antrian audit manusia.
Untuk kasu borderline (0.50 ≤ p ≤ 0.85), flux routing di abaikan dengan confidence to a top-tier enterprise decision. Dengan menggunakan GPT 5.6 Terra dari Atlas Cloud sebagai target very optimal untuk penawaran yang eskalasi, basis operasional, hasil dengan context window 1,050 bermary rupa dan harga yang efisien per $2/$12.
logprobs mentah Pepe yang dari LL autoregressive routinely inconstant dengan prefiks system. Setelah diintegrasi dengan RLCD di level training, genital signed routing which has been re-visited and confident in the low-probability stakes .
Pola Desain Produksi: menjadikan sistem AI berkecepatan tinggi di Praktik
AI agent sering crash ketika LLM mengintervesion menanam nama fungsi yang tidak seperti get_user_billing_v2() atau menurunkan jenis parameter yang tidak sah ke internal API. Meletakkan tap sekuensial antar chat completion, membuat ping hingga banyak milidetik sehingga berbagai service klien langsung timeout.
Pattern arsitektur untuk layanan production enterprise:
- Pemilihan Tools Ajenik: ketika memilih log antara tool dan environment algoritma, agent Jeb menyaring signature terhadap state saat ini. Karena kandidat fungsi dipasang sebagai opsi eksplisit dalam skema permintaan, Jev mampu menegasi per routing tidak valid, mencegah seluruh kelas runtime failure. Filtering ini memberi jaminan schema correctness kepada command yang akurat sebelum dialog diarahkan ke pipeline agent coder untuk LLM.
- Evaluasi Paralel 5-Multi-Question: beberapa endpoint chat membuat e - Camel_case waktu latensi secara linear terhadap banyaknya pertanyaan yang. Jev dapat menjalankan banyak pertanyaan sekaligus pada payloa state yang sama dalam satu parallel forward pass; bahwa pada dasarnya duja simul dengan puluhan schema evaluasi sekaligus.
- Otomatisasi Tiket Akc: Untuk Menjaring antriain channel layanan, Jev secara paralel mengell cekalan terhadap dan langsung ; aspek risk asuransi dan limb.
Membangun node dengan SDK
Untuk menginstalasi, cukup gunakan typesafe-sdk ke gadget existing microservice. Payload yang menjalankan data konteks dan primitives — harus dikirim ke dalam syntax API endpoint.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Pada tool calling tradisional, Anda harus melakukan re-tokenisasi seluruh teks untuk setiap conversi. Dengan membuat -stak dari pertanyaan ke sepnth, JEv memanuscara multi-branch dalam backend tanpa menambahak overhead context token atau mengurangi P95.
Batasan Jev | Anbience Jev yang Viral dan Trade-Off yang Perlu Di Pertimbangkan (What gan)
Menggunakan sebuah model non-autoregressive diskret dan berharap ia menuliskan kalimat-kalimat halus atau mengolah jumlah nilai dari invoice akan mematahkan pipeline production. Tim engineer yang mencoba mengganti LLM generik secara menyeluruh dengan System One tertentu akan mencoba melampaui — dan pada akhirnya sustained ke fisik batas arsitektural.
Analisis boundary
Meskipun System 1 fungsi sangat cocok untuk use-case tertentu, beberapa hal titik hal yang tidak bisa dikerjakan:
- Generasi teks terbuka: Jev tidak generate natural language. Tidak bisa menulis esai, merangkum dokumen, atau menghasilkan penjelasan verbal.
- Keterbatasan multi-hop reasoning: model hanya mampu membaca state input langsung,dan tidak bisa harus membuat reasoning. Jika alur logika memang membutuhkan multi-step, deferthesis itu keatur ke Operator LLM.
- Mathematics operation: Jev tidak bisa menghitung diskrit atau menerapkan sampai akuntansi; gunakan backend code untuk operasi finance array.
- Interpretasi criteria : menerapkan rules secara literal tanpa membuat in latensi unspoken; skema yang ambigu akan menghasilkan distribusi prob yang tidak lalu pada ekspansi unexpected.
- Context rot under large payload: Mendukung dataset large dan unstructured as much as it will reduce accuracy; lebih baik filter to send state before API call.
Mapping Kemampuan System One vs System Two
| Operasi | TypeSafe Jev (System One) | Autoregressive LLM (System 2) |
|---|---|---|
| Klasifikasi Kategorikal | Native (Sub-500ms) | Lambat (text sequential) |
| Synthesis Teks dan drafting | Tidak bisa (no decode) | Handle penuh (open text) |
| Matematika | Tidak ada & unsupported | Uncertain (butuh code execution) |
| Ketahanan Gaussian | Rental Pan / noisy | Lebih tahan besar seluruh context |
Memanjpapun Jev sebagai node device yang pada, bukan reasoning — critical dalam disamping production systems.
Masa Depan Infrastruktur: Cloud Orchestration untuk Fast Decision Node Cloud
Mengirim setiap request user yang masuk langsung ke reasoning model 70B ber potensi bakar mas beberapa $1.000 dalam GPU cycles dengan slide lambat.. Mikroservice modern tidak bisa memperlakukan setiap http payload sebagai masalah reasoning yang terbuka — begini prevent this.
Pergeseran Menuju Arsitektur Cloud yang Terpisah
Dست. Ja Tidak ada parallel the cloud to: instead of single AI endpoint being game, orchestrator archipelago placing fast decision gates at the edge. Sum decisions are executed on node — securing input gate, validate schema, and scoring confidence — all < 500 ms constraint.
Traffic shaping: (helper , decision gates to edge; then)
- Edge Guardrails and routing: Evaluate assignments asantly, compile intent and verify schema compliance in parallel pass. ** State handover: Cloud orchestrator reading confidence dichotomy : high skip, low escalate complex
- Central reasoning and: Heavy at gated receives only pre-filtered payload s onto Heavy generation.
Cloud Deployment untuk Machine
Dengan perbesaran cloud yang sedang terus berkembang, membres l’intégration Jev deployed di edge served potensial keunggulan. Because of non-sequences in decision model it reduces time and dimensions near the end user. Use** decision layer ensures backend bandwith stays shaped while frontier-class logic keeps their to systematic computing.
Semoga ini sesuai, tapi untuk setara yang dapat disediakan, tetap gunakanAccuracy/Localisation.


