초록색 API 테스트 보고서는 모든 어서션이 HTTP 200만 확인한다는 사실을 알아차리기 전까지는 안심이 됩니다. 응답에 잘못된 고객의 레코드가 들어 있어도 테스트는 통과할 수 있습니다.
이미 가지고 있는 작업을 기준으로 API 테스트용 AI 도구를 선택하세요. 팀에서 컬렉션을 유지 관리한다면 Postman Agent Mode를, 명세가 출발점이라면 KushoAI를, 생성된 흐름이나 기록된 트래픽으로 만든 회귀 테스트가 필요하다면 Keploy를 평가하세요. 결과 테스트를 신뢰하기 전에 검토하고 실행하세요.
이 가이드는 일반적인 API를 테스트하기 위한 AI 지원을 다룹니다. AI 모델 답변의 정확성을 테스트하는 것은 별도의 평가 문제입니다.
핵심 요약
- 계약, 요청 의존성, 승인된 비즈니스 기대치를 제공하세요.
- 어서션이 잘못된 데이터, 누락된 필드, 깨진 타입을 거부하는지 확인하세요.
- 검토된 테스트가 의도한 CI 환경에서 반복적으로 실행된 후에만 구매하세요.
아래 제품 비교는 2026년 9월 21일에 확인한 공식 문서를 반영합니다. 세 개의 유료 계정을 대상으로 한 직접 비교 벤치마크는 아닙니다.
실습 예제는 고정된 Swagger Petstore 명세를 사용하며 계약 기대치, 관찰된 동작, 의도적으로 수정한 응답 복사본을 분리합니다.
로컬 실행은 5개의 라이브 테스트를 통과했고 의도적으로 변경한 3개의 응답 복사본은 모두 거부했습니다. 별도의 누락된 이름 탐침은 여전히 200을 반환했으며, 이는 초록색 보고서의 범위가 왜 중요한지 보여줍니다.
API 테스트용 AI 도구가 실제로 하는 일
AI 지원은 일반적으로 API 테스트의 네 부분에 들어옵니다. 모델이 명세를 읽고, 시나리오를 제안하고, 어서션 초안을 작성하고, 실패를 설명하는 데 도움을 줍니다. 각 부분은 서로 다른 증거를 필요로 합니다. 실패에 대한 그럴듯한 설명이 제안된 수정이 올바르다는 것을 입증하지는 않습니다.
명세 검토를 위해서는 OpenAPI 파일과 관련 비즈니스 규칙을 제공하세요. 시나리오 계획을 위해서는 유효한 데이터와 알려진 경계의 예시를 추가하세요. 실행 가능한 스크립트를 위해서는 러너, 인증 설정, 픽스처 규칙을 포함하세요. 진단을 위해서는 비밀 정보를 제거한 후 실제 요청, 응답, 실패 메시지를 제공하세요.
제품을 평가할 때 이 네 가지 메커니즘을 분리해서 유지하세요:
- LLM 생성: 언어, 스키마, 예시로부터 테스트를 제안합니다. 검토자가 예상 결과를 확인해야 합니다.
- 트래픽 재생: 이후 동작을 캡처된 상호작용과 비교하며, 종종 기록된 의존성 응답을 사용합니다.
- 속성 기반 테스트: 스키마 준수와 같은 속성에 도전하기 위해 입력을 체계적으로 구성합니다.
- 테스트 실행: 요청을 보내고, 어서션을 평가하며, 보고서와 종료 코드를 반환합니다.
제품은 여러 메커니즘을 결합할 수 있습니다. 각 테스트를 어떤 메커니즘이 생성했는지, 그리고 무엇이 예상 결과를 결정하는지 물어보세요. 잘못된 응답을 기록하면 동일한 오류가 회귀 기준선으로 보존될 수 있습니다. 세련된 테스트 이름을 생성하면 지원되지 않는 기대치가 가려질 수 있습니다.
어서션을 세 가지 깊이로 생각하세요. 첫째, 서버가 성공적으로 응답했나요? 둘째, 본문에 문서화된 필드와 타입이 있나요? 셋째, 이 본문이 요청한 리소스와 작업을 나타내나요?
펫 조회의 경우, 정수 ID가 있는 유효한 객체라도 그 ID가 다른 펫의 것이라면 세 번째 검사를 통과하지 못합니다. 반대로 요청한 ID와 일치한다고 해서 모든 필드가 스키마를 충족한다는 것이 증명되지는 않습니다. 두 검사를 모두 사용하고, 팀이 합의한 출처가 있는 경우에만 비즈니스 규칙을 추가하세요.
원하는 실용적인 결과물은 설명 가능한 오라클이 있는 유지 관리 가능한 테스트 자산입니다. 즉, 각 결과가 왜 통과하거나 실패해야 하는지에 대한 명확한 이유입니다. 초기 생성 목록의 길이를 자랑하기보다 검토 후 유용한 시나리오 수를 세고, 거부한 시나리오도 포함하세요.
워크플로별로 비교한 API 테스트용 AI 도구
오늘 팀이 제공할 수 있는 아티팩트에서 시작하세요. 확립된 컬렉션을 마이그레이션하는 것, 누락된 비즈니스 규칙을 재구성하는 것, 의존성 기록을 설정하는 것은 서로 다른 프로젝트입니다. 한 출발점에 맞는 도구가 다른 출발점에서는 추가 작업을 만들 수 있습니다.
| 도구 또는 접근 방식 | 유용한 입력 | AI 또는 자동화 역할 | 실행 및 CI 경로 | 검토 가능한 출력 | 주요 시험 질문 |
|---|---|---|---|---|---|
| Postman Agent Mode | 컬렉션, 요청, 응답, 환경, 명세 | 워크스페이스 컨텍스트에서 테스트 스크립트 초안 작성 및 편집 | Collection Runner 및 호환 CLI 워크플로 | 표준 Postman JavaScript 어서션 | 변수를 보존하고 계약을 테스트하나요? |
| KushoAI | OpenAPI, Postman 컬렉션, cURL | 시나리오와 테스트 스위트 생성, 자연어 개선 지원 | 플랫폼 실행 및 문서화된 CI 통합, 권한 확인 | 생성된 요청, 의존성, 예상 결과 검사 | 선택한 플랜이 필요한 곳에서 스위트를 실행하고 유지할 수 있나요? |
| Keploy | 명세 또는 요청 정의, 또는 실제 트래픽 | AI 생성과 별도의 기록/재생 경로 | 지원되는 로컬/CI 환경에서 생성된 흐름 또는 기록된 테스트 | 테스트 정의, 기준선, 의존성 모의 검토 | 어떤 경로가 실제 실패 모드를 커버하나요? |
| 기존 러너 + LLM | 승인된 매트릭스, 명세, 픽스처 규칙 | 검토용 코드 초안 작성 | 귀하의 pytest 또는 기타 확립된 러너 | 저장소에 커밋된 코드 | 동일한 테스트를 직접 작성하는 것보다 검토가 더 저렴한가요? |
기존 컬렉션을 위한 Postman Agent Mode
컬렉션에 이미 유용한 요청 순서, 환경 변수, 인증 설정이 들어 있다면 Postman은 합리적인 첫 평가 대상입니다. Agent Mode는 이 컨텍스트를 사용하여 표준 JavaScript 테스트 스크립트를 생성할 수 있습니다. 해당 스크립트는 새로운 어서션 언어를 요구하지 않고 기존 컬렉션 실행 워크플로에 들어갈 수 있습니다.
모든 것을 테스트하라고 요청하는 것보다 집중된 시험이 더 많은 것을 드러냅니다. 컬렉션에서 앞서 생성된 리소스를 조회하는 요청을 선택하세요. 해당 스키마를 제공하고 필수 필드 검증, 문서화된 필드 타입, 반환된 ID를 저장된 생성 ID에 연결하는 어서션을 요청하세요.
그런 다음 수락하기 전에 제안된 변경 사항을 검사하세요. 응답 예시에 Milo라는 펫이 포함되어 있을 수 있습니다. 픽스처가 명시적으로 Milo를 생성했다면 Milo와의 동등성 검사는 의미가 있습니다. 생성기가 공유 샘플 레코드에서 이름을 복사했다면 취약합니다. 동일한 리터럴이 출처에 따라 유효한 어서션이 될 수도 있고 우발적인 의존성이 될 수도 있습니다.
변수 범위를 주의 깊게 확인하세요. 환경 변수에 저장된 ID는 이후 요청에서 사용할 수 있어야 하며 해당 실행에 속해야 합니다. 동시 실행 간에 공유되는 변수는 서버 결함처럼 보이는 간헐적 실패를 만들 수 있습니다. 생성기에게 어서션뿐 아니라 설정과 정리도 설명하도록 요청하세요.
첫 번째 수락 테스트에서는 격리된 데이터를 대상으로 컬렉션을 두 번 실행한 다음 내보낸 또는 버전 관리된 표현을 검사하세요. 팀원이 AI 대화를 반복하지 않고도 변경된 스크립트를 검토할 수 있는지 확인하세요. 또한 선택한 CLI, 리포터, 플랜이 의도한 실행 경로를 지원하는지 검증하세요.
여기서는 운영된 Postman 생성 결과를 제시하지 않습니다. 유용한 평가 질문은 워크스페이스 컨텍스트가 기존 컬렉션에 대한 검토 작업을 줄여주는지입니다. 이를 위해서는 제품 스크린샷에서 도출한 결론이 아니라 자체 컬렉션과 계정 수준의 시험이 필요합니다.
명세 기반 테스트 생성을 위한 KushoAI
KushoAI는 Swagger/OpenAPI, Postman, cURL 입력을 받아들이고 테스트 생성, 자연어 개선, CI 실행을 문서화합니다. 따라서 팀에 유용한 API 정의는 있지만 작성되지 않은 테스트의 백로그가 있을 때 후보가 됩니다. 이는 공급업체가 설명한 기능이며 측정된 결함 탐지 결과는 아닙니다. (KushoAI 문서, 2026년 9월)
가장 풍부하고 신뢰할 수 있는 컨텍스트가 있는 입력을 선택하세요. cURL 요청은 하나의 유효한 요청을 설명할 수 있지만 일반적으로 선택적 필드, 허용된 열거형 값, 문서화된 오류에 대해서는 거의 말해주지 않습니다. OpenAPI 파일은 구조를 추가하고, 승인된 시나리오 매트릭스는 구조가 모호하게 남길 수 있는 의도를 추가합니다.
Petstore 시험에서는 유효한 펫, 누락된 필수 이름, 잘못된 타입의 ID, 유효하지 않은 상태 필터에 대한 별도 사례를 요청하세요. 도구가 요청 본문 요구 사항과 응답 스키마 요구 사항을 구분하는지 검토하세요. 예시에서는 비슷해 보일 수 있지만 서로 다른 의무를 부과합니다.
다음으로 연결된 생성-읽기-업데이트 흐름을 검사하세요. 읽기는 현재 설정과 연결된 ID를 사용해야 합니다. 업데이트는 동일한 리소스를 대상으로 해야 하며, 이후 읽기는 변경된 필드를 검증해야 합니다. 매력적인 테스트 이름이 붙은 네 개의 독립 요청은 의존성 체인이 작동한다는 것을 입증하지 않습니다.
첫 번째 생성을 제안으로 취급하세요. 문서화된 기대치를 유지하고, 잘못된 데이터 흐름이 있는 스크립트를 수정하고, 불충분하게 명시된 결과는 요구 사항 결정을 위해 표시하세요. 도구가 여러 개의 동등한 누락 필드 사례를 제안하면 중복을 유지하는 비용을 지불하는 대신 유용한 차이점을 유지하세요.
구매 전에 의도한 파이프라인에서 스위트를 실행하고 실패 아티팩트를 검사하도록 요청하세요. 선택한 플랜에서 현재 CI 권한, 자격 증명 처리, 사용 가능한 내보내기 형식을 확인하세요. 무료 대화형 시험이 팀 배포와 동일한 자동화 권한을 부여한다고 가정하지 마세요.
생성된 테스트 및 트래픽 재생을 위한 Keploy
Keploy 문서는 두 가지 서로 다른 시작 경로를 제시합니다. AI 생성은 OpenAPI, Postman, cURL 또는 엔드포인트와 같은 리소스를 받아 연결된 API 흐름을 구축합니다. 기록 및 재생은 API 상호작용과 그 의존성을 캡처하여 나중에 모의를 사용해 실행합니다. AI 흐름 설명과 의존성 기록 설명은 동일한 메커니즘으로 취급되어서는 안 됩니다. (Keploy 문서, 2026년 9월)
애플리케이션이 데이터베이스나 업스트림 서비스와 함께 수행한 작업을 재현하는 것이 어렵다면 기록 경로를 평가하세요. 격리된 환경에서 작은 생성-읽기-업데이트 여정을 캡처하고, 캡처된 의존성을 검사하고, 통제된 애플리케이션 변경 후 재생하세요. 더 큰 롤아웃을 계획하기 전에 런타임이 무엇을 지원하는지 확인하세요.
명세에서 사례를 도출하는 것이 어렵다면 생성 경로를 별도로 평가하세요. 제안된 요청이 어떻게 자격 증명을 얻고, 단계 간에 ID를 전달하며, 데이터를 정리하는지 물어보세요. 제품의 다른 곳에 기록 기능이 있다는 사실이 생성된 스위트에 대한 이러한 질문에 답하지는 않습니다.
동적 값에는 판단이 필요합니다. 타임스탬프는 정당하게 달라질 수 있습니다. 리소스 ID는 두 요청을 연결할 수 있으므로 비교가 필요할 수 있습니다. 모든 변경 필드를 광범위하게 무시하면 오류가 숨겨질 수 있습니다. 제외 항목을 필드별로 검토하고 의미 있는 관계를 표현하는 비교는 유지하세요.
기준선을 수락하기 전에 검사하세요. 잘못된 합계, 우발적인 대체 응답, 오래된 데이터가 포함된 기록은 일관되게 재생될 수 있습니다. 일관성은 변경 감지에 도움이 되지만, 캡처된 동작이 올바른지는 팀이 여전히 결정합니다.
유용한 보충 자료: Schemathesis는 스키마 기반 속성 기반 API 테스트를 제공합니다. 검토된 예시와 함께 생성된 입력으로 API에 도전할 수 있습니다. 이것을 LLM 테스트 생성기의 동의어가 아니라 다른 테스트 메커니즘으로 취급하세요. 그 결과는 여전히 계약과 구현에 비추어 해석해야 합니다.
무료 API 테스트용 AI 도구: 한계와 비용
"무료"는 클라이언트, 제한된 AI 허용량, 오픈소스 러너 또는 임시 시험판을 의미할 수 있습니다. 이러한 제공은 워크플로의 서로 다른 부분을 다룹니다. 무료 클라이언트가 자동 생성, 예약 실행 또는 보고서 내보내기도 무료라는 것을 입증하지는 않습니다.
2026년 9월 21일 확인 기준으로 Postman의 Free 플랜은 월 50 AI 크레딧을 나열합니다. 크레딧은 청구 단위이며 50개의 테스트나 50개의 완전한 스위트를 의미하지 않습니다. 비교 표에서 AI 허용량과 실행, 데이터 기반 기능, 결과 내보내기를 구분합니다. (Postman 가격, 2026년 9월)
KushoAI의 현재 가격 제시는 Developer Edition과 Enterprise를 사용합니다. Keploy는 오픈소스 제공과 함께 Playground, Pro, Enterprise를 구분합니다. 관련 한도를 확인하려면 현재 구매 화면을 사용하세요. 오래된 도구 모음은 폐기된 플랜 이름을 설명하거나 별도로 청구되는 허용량을 결합할 수 있습니다.
| 비용 구성 요소 | 시험에서 기록할 항목 | 청구서를 오해하게 만들 수 있는 것 |
|---|---|---|
| 좌석 및 플랜 | 편집자, 검토자, 청구 주기, 필수 기능 | 연간 대표 가격을 월간 약정과 비교 |
| AI 생성 | 동일한 승인 작업에 대한 크레딧 사용량(재시도 포함) | 하나의 크레딧이 하나의 테스트와 같다고 가정 |
| 실행 | 로컬 실행, 호스팅 실행, CI 작업, 일정, 보고서 | 대화형 실행을 모든 자동화 경로에 대한 권한으로 취급 |
| 독립 모델 | 초안 작성 및 검토를 위한 입력 및 출력 토큰 | 반복적인 전체 명세 제출 무시 |
| 엔지니어링 시간 | 검토, 픽스처 수정, 실패 분류, 유지 관리 | 초기 생성 시간을 총 전달 시간으로 계산 |
작은 수락 작업으로 비용을 추정하세요. 각 후보에게 동일한 작업과 기대치를 제공한 다음 검토 후 몇 개의 시나리오가 살아남는지 기록하세요. 생성 시간, 직접 검토 시간, 실행 시간을 별도 열에 유지하세요. 모델을 기다리는 것과 위험한 어서션을 수정하는 것은 팀에 서로 다른 비용을 부과합니다.
유용한 분모는 팀이 유지할 검토된 실행 가능 시나리오입니다. 이는 출력이 더 길다는 이유만으로 중복 사례가 많은 생성기가 더 저렴해 보이는 것을 방지합니다. 제거한 지원되지 않는 사례와 해결되지 않은 요구 사항을 기록하세요.
이 문서는 측정된 노동 절감 비율을 주장하거나 유료 플랜 처리량을 비교하지 않습니다. 그러한 수치에는 동등한 입력을 사용한 통제된 시험이 필요합니다. 구매 결정을 위해서는 필수 필드 추가와 같은 현실적인 유지 관리 변경 하나를 포함하여 추정치가 첫 데모뿐 아니라 다음 스프린트도 포괄하도록 하세요.
API 테스트용 AI 도구: OpenAPI에서 첫 실행까지
실제 Swagger Petstore 프로젝트의 격리된 로컬 인스턴스를 사용하세요. 커밋 d57941e8fe959e508796b27469b1e8bba73392dc를 고정하세요. 해당 명세는 OpenAPI 3.0.4와 애플리케이션 버전 1.0.29-SNAPSHOT을 선언합니다. 독립적으로 업데이트된 공개 데모가 아니라 고정된 파일을 읽으세요. (Swagger Petstore 명세, 2026년 9월)
1. 서비스를 준비하고 환경을 기록하세요. 해당 소스 페이지를 통해 저장소를 가져오고, 고정된 리비전을 체크아웃하고, 호환되는 JDK와 Maven을 설치하세요. 프로젝트의 README는 저장소 디렉터리에서 다음 시작 명령을 제공합니다:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty는 포트 8080을 사용합니다. BASE_URL을 해당 포트의 루프백 HTTP 오리진에 /api/v3를 추가하여 설정하세요. 테스트 전에 해당 베이스를 기준으로 /openapi.json을 읽을 수 있는지 확인하세요.
이 실행에서는 Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1, jsonschema 4.26.0을 사용했습니다. 버전을 기록하세요. 소스 빌드는 의존성과 Swagger UI를 다운로드하므로 고정된 애플리케이션 커밋만으로는 완전히 밀폐된 빌드가 아닙니다.
2. 고정된 명세를 가져오세요. /pet, /pet/{petId}, /pet/findByStatus를 선택하세요. 정리를 위해 delete를 사용할 수 있도록 유지하세요. 명세의 공개 서버 위치를 로컬 베이스로 재정의하세요. 쓰기 요청을 보내기 전에 이 설정을 확인하세요.
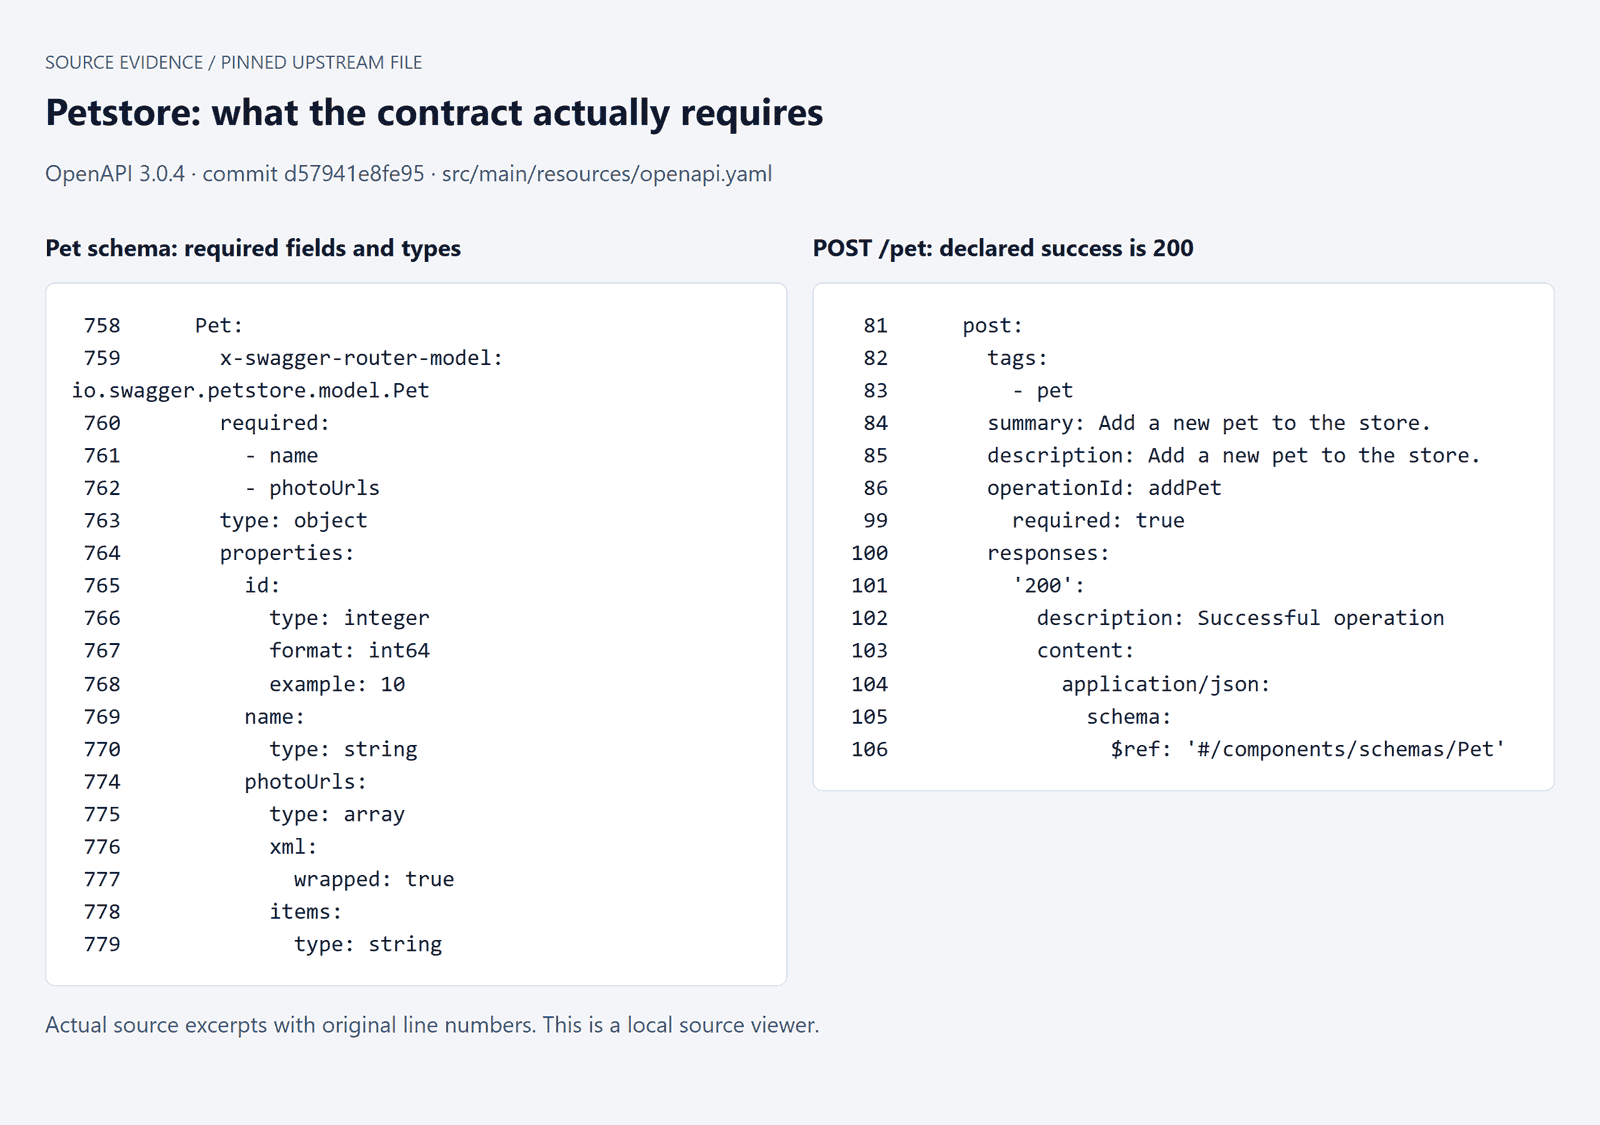 필수 필드와 선택된 작업 정의를 보여주는 고정 OpenAPI Petstore 소스
로컬에서 렌더링한 실제 소스 발췌: Pet에는 name과 photoUrls가 필요하며, POST /pet은 성공 시 200을 선언합니다. 원래 줄 번호가 보존됩니다.
3. 실행 코드 전에 매트릭스를 생성하세요(프롬프트 A). 명세를 첨부하고 선택한 생성기에 이 프롬프트를 붙여넣으세요:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. 각 시나리오의 오라클을 검토하세요. Petstore는 성공적인 생성을 200으로 문서화합니다. Pet 스키마는 name과 photoUrls를 필수로 요구하며, id는 정수 타입이지만 필수 목록에는 없습니다. 따라서 누락 필드 검증과 요청-응답 동일성에는 서로 다른 검사가 필요합니다.
| 작업 | 입력 또는 시퀀스 | 예상 결과 증거 | 검토할 어서션 | 실행 상태 |
|---|---|---|---|---|
| addPet, getPetById | 생성 후 현재 ID 읽기 | 문서화된 200 및 Pet 스키마, 명시적 흐름 기대치 | 본문 검증 및 반환된 ID 비교 | 로컬 통과 |
| updatePet, getPetById | 이름 변경 후 다시 읽기 | 업데이트 작업 및 승인된 픽스처 의도 | 동일 ID, 새 이름, 유효한 스키마 | 로컬 통과 |
| findPetsByStatus | 설정 후 available 쿼리 | 문서화된 열거형 및 성공적인 배열 응답 | 반환된 모든 상태 일치, 생성된 ID 존재 | 로컬 통과 |
| getPetById | 정수가 아닌 경로 ID | 문서화된 잘못된 ID 400 | 이 문서화된 사례의 정확한 상태 | 통과: 400 |
| findPetsByStatus | 문서화되지 않은 열거형 값 | 문서화된 잘못된 상태 400 | 정확한 상태, 불일치 유지 | 통과: 400 |
| addPet | 필수 name 누락 | 필수 스키마 필드, 400 및 422 설명이 모든 변형을 매핑하지는 않음 | 동작 기록, 게이팅 전 정확한 매핑 해결 | 이름 없이 200 반환, 불일치 유지 |
5. 실행 파일을 생성하고 검사하세요(프롬프트 B). 승인된 매트릭스와 명세를 첨부하고 이 프롬프트를 사용하세요:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. 실행하고, 보존하고, 정리하세요. 실행별 펫 ID를 사용하고, 생성 응답을 캡처하고, 그 ID를 이후 요청에 전달하세요. 새 읽기를 통해 업데이트를 검증하세요. 성공적인 업데이트 응답만으로는 서버가 변경 사항을 영속화했다는 것이 증명되지 않습니다.
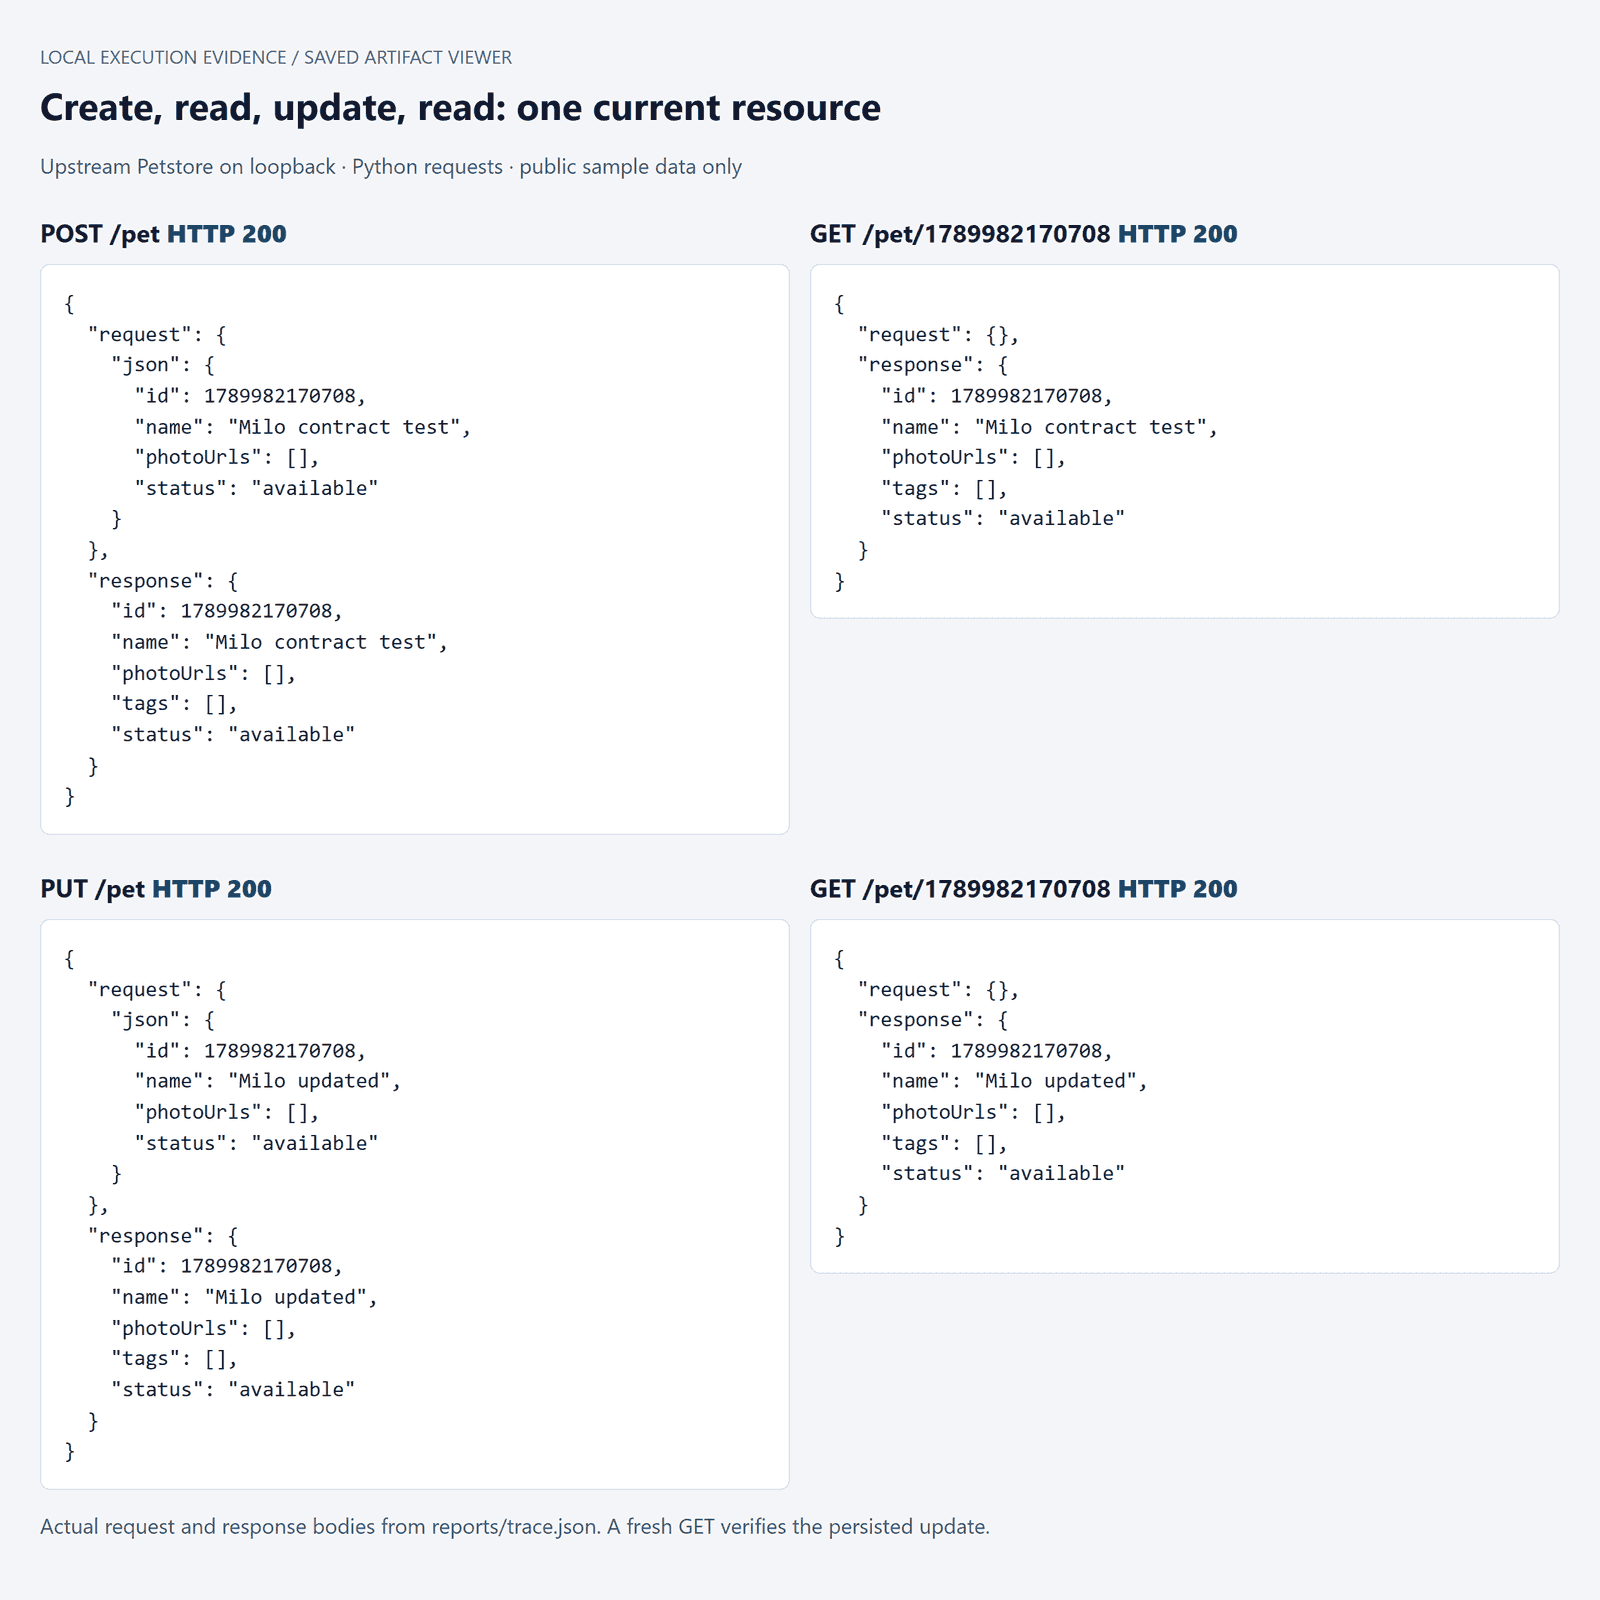 생성, 조회, 업데이트 및 ID 전달을 보여주는 로컬 Petstore 요청 체인 증거
저장된 로컬 요청 및 응답: 동일한 실행별 ID가 생성, 읽기, 업데이트, 새 읽기에서 살아남습니다. 표시된 4개 요청 모두 200을 반환했습니다.
요청 본문, 응답, 어서션 실패, 정리 결과를 저장하세요. 삭제는 이 실행에서 생성한 ID로 제한하세요. 데모 구현이 잘못된 입력을 허용하는 경우를 포함하여 예상치 못한 응답을 발견 사항으로 유지하세요. 초록색 스크린샷을 얻기 위해 어서션을 조정하지 마세요.
이 실행에서 발견한 점: 5개의 라이브 테스트 함수가 통과했으며, 여기에는 400을 반환하는 잘못된 ID 및 잘못된 상태 검사가 포함됩니다. 별도의 누락된 이름 탐침은 200과 name 없는 본문을 반환했습니다. 우리는 그 스키마 불일치를 초록색 스위트 밖에 유지했으며, 정확히 의도된 오류 매핑은 여전히 명확히 해야 합니다. 생성된 두 레코드 모두 성공적으로 삭제되었습니다.
로컬 테스트는 이 문서 실행에서 세 가지 상용 도구와 독립적으로 초안이 작성되었습니다. 5개의 라이브 테스트가 모두 유지되었으며, 실행 후 제거되거나 기대치가 완화된 테스트는 없습니다. 인간 검토 시간은 측정되지 않았습니다. 증거 폴더에는 테스트 파일, 의존성 잠금, 원시 응답, 재현 지침이 포함되어 있습니다.
API 테스트용 AI 도구를 검증하는 방법
유용한 어서션은 관련성 있는 잘못된 답변을 거부해야 합니다. 실행 중인 서비스를 변경하지 않고도 이 속성을 테스트할 수 있습니다. 실제 성공 응답을 저장하고, 복사하고, 한 번에 한 필드씩 의도적으로 수정하세요. 이는 통제된 응답 변이이며, 프로덕션 취약점이나 전체 변이 테스트 벤치마크가 아닙니다.
원래 상태와 본문을 함께 유지하세요. 먼저 수정되지 않은 응답에 대해 검증기를 실행하고 기준선을 수락하는지 확인하세요. 그런 다음 세 개의 독립 복사본을 만드세요. ID를 변경하고, 이름의 타입을 변경하고, 필수 이름을 제거하세요. 각 복사본은 변경과 일치하는 이유로 실패해야 합니다.
| 저장된 기준선 | 통제된 수정 | 관련 검사 | 실제 결과 |
|---|---|---|---|
| 현재 펫의 성공적인 조회 | 다른 정수 ID로 대체, 상태 200 유지 | 반환된 ID가 이 실행의 예상 ID와 같음 | 실패: 예상 ID와 실제 ID가 다름 |
문자열 name | 이름을 숫자로 대체 | Pet 스키마의 문자열 타입 | 실패: 42는 문자열이 아님 |
필수 name 존재 | 이름 제거 | Pet 스키마의 필수 목록 | 실패: name은 필수임 |
ID 예시는 일반적인 약점을 드러냅니다. 스키마 검증기는 형태가 유효하게 유지되므로 잘못된 정수를 수락할 수 있습니다. 관계 어서션이 누락된 제약을 제공합니다. 다른 두 예시에서는 스키마 검증이 상태 전용 검사가 볼 수 없는 제약을 제공합니다.
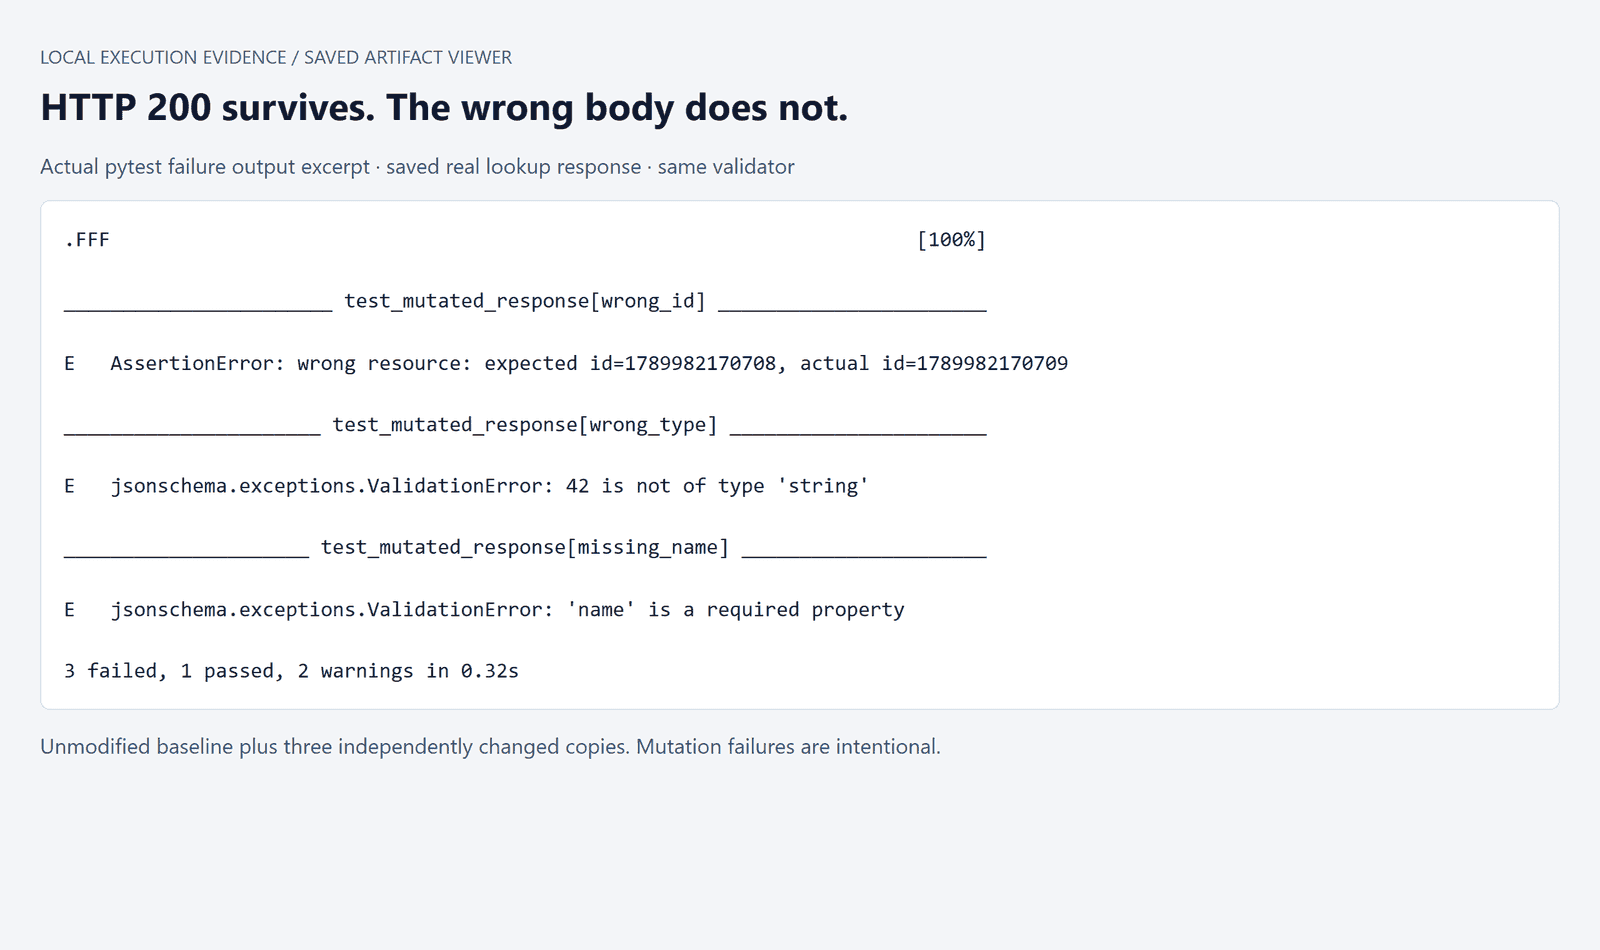 통제된 Petstore 응답 변이에 대한 실제 어서션 실패 출력
실제 pytest 실패 발췌: 원본 응답은 통과했고, 3개의 독립 변이는 모두 실패했습니다. 이러한 실패는 저장된 복사본에서 의도적으로 유도되었습니다.
이 실행에서 변경되지 않은 기준선은 통과했고 변경된 복사본 3개 중 3개가 실패했습니다. 변이 실행은 종료 코드 1을 반환하여 실패 신호를 보존했습니다. 검증기는 Pet 스키마의 관련 구조적 제약과 별도의 ID 관계 검사를 적용하며, 이 작은 데모는 완전한 OpenAPI 적합성 검증기가 아닙니다.
반복 가능한 감사를 위해 테스트 파일과 고정된 명세를 프롬프트 C에 첨부하세요:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
제안된 "자가 치유" 변경은 특히 주의 깊게 검토하세요. 예상 400을 200으로 바꾸면 회귀가 숨겨질 수 있습니다. 정당한 계약 변경에는 요구 사항 참조와 검토된 테스트 변경이 필요합니다. 관찰된 응답은 조사를 위한 증거이지 정확성을 자동으로 재정의할 권한이 아닙니다.
AI에 수정을 요청하기 전에 실패 범주를 분리하세요. 타임아웃은 사용할 수 없는 환경을 나타낼 수 있습니다. 조회 실패는 깨진 픽스처에서 비롯될 수 있습니다. 가져오기 오류는 테스트 코드에 속합니다. 합의된 계약과 재현 가능한 불일치는 제품에 속할 수 있습니다. 이를 구분할 수 있을 만큼 충분한 컨텍스트를 유지하세요.
분모를 정직하게 보고하세요. 선택된 세 가지 응답 변경을 감지하는 것은 그 세 가지 변경에 대한 민감성을 입증합니다. 엔드포인트 커버리지, 코드 커버리지, 보안 커버리지 또는 일반적인 결함 탐지율을 입증하지는 않습니다. 마찬가지로 많은 테스트 수는 중복 시나리오나 어서션의 강도에 대해 거의 말해주지 않습니다.
인증과 권한 부여는 적절한 애플리케이션에서 독립적인 테스트가 필요합니다. 누락된 자격 증명, 만료된 자격 증명, 다른 사용자의 리소스에 대한 접근입니다. Petstore의 데모 동작은 프로덕션 접근 제어가 작동한다는 것을 입증할 수 없습니다.
CI/CD에서의 API 테스트용 AI 도구
검토자가 스위트를 수락하면 해당 정확한 버전을 커밋하세요. 빌드는 후보 애플리케이션에 대해 알려진 기대치를 실행해야 합니다. 매 빌드마다 테스트를 재생성하면 또 다른 변경 구성 요소가 도입되어 실패를 재현하기 어려워집니다.
러너, 의존성, 픽스처, 명세를 고정하세요. 테스트와 함께 의존성 잠금을 저장하고 보고서에 애플리케이션 리비전을 보존하세요. CI 환경에서 비밀을 확인하고 생성된 파일에 포함하지 않으며 실패 로그가 비밀을 노출하지 않는지 확인하세요.
pytest를 사용하면 기본 보고 형식은 간단합니다:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
작업 환경을 통해 BASE_URL을 제공하세요. 작업 수명 주기에서 로컬 서비스를 시작하고, 준비될 때까지 기다린 다음 스위트를 실행하세요. 실패 시에도 항상 보고서와 서비스 로그를 수집하세요. 마지막으로 작업 자체의 서비스를 중지하고 데이터를 정리하세요. 공유 에이전트에서는 프로세스 전체 정리 명령을 피하세요.
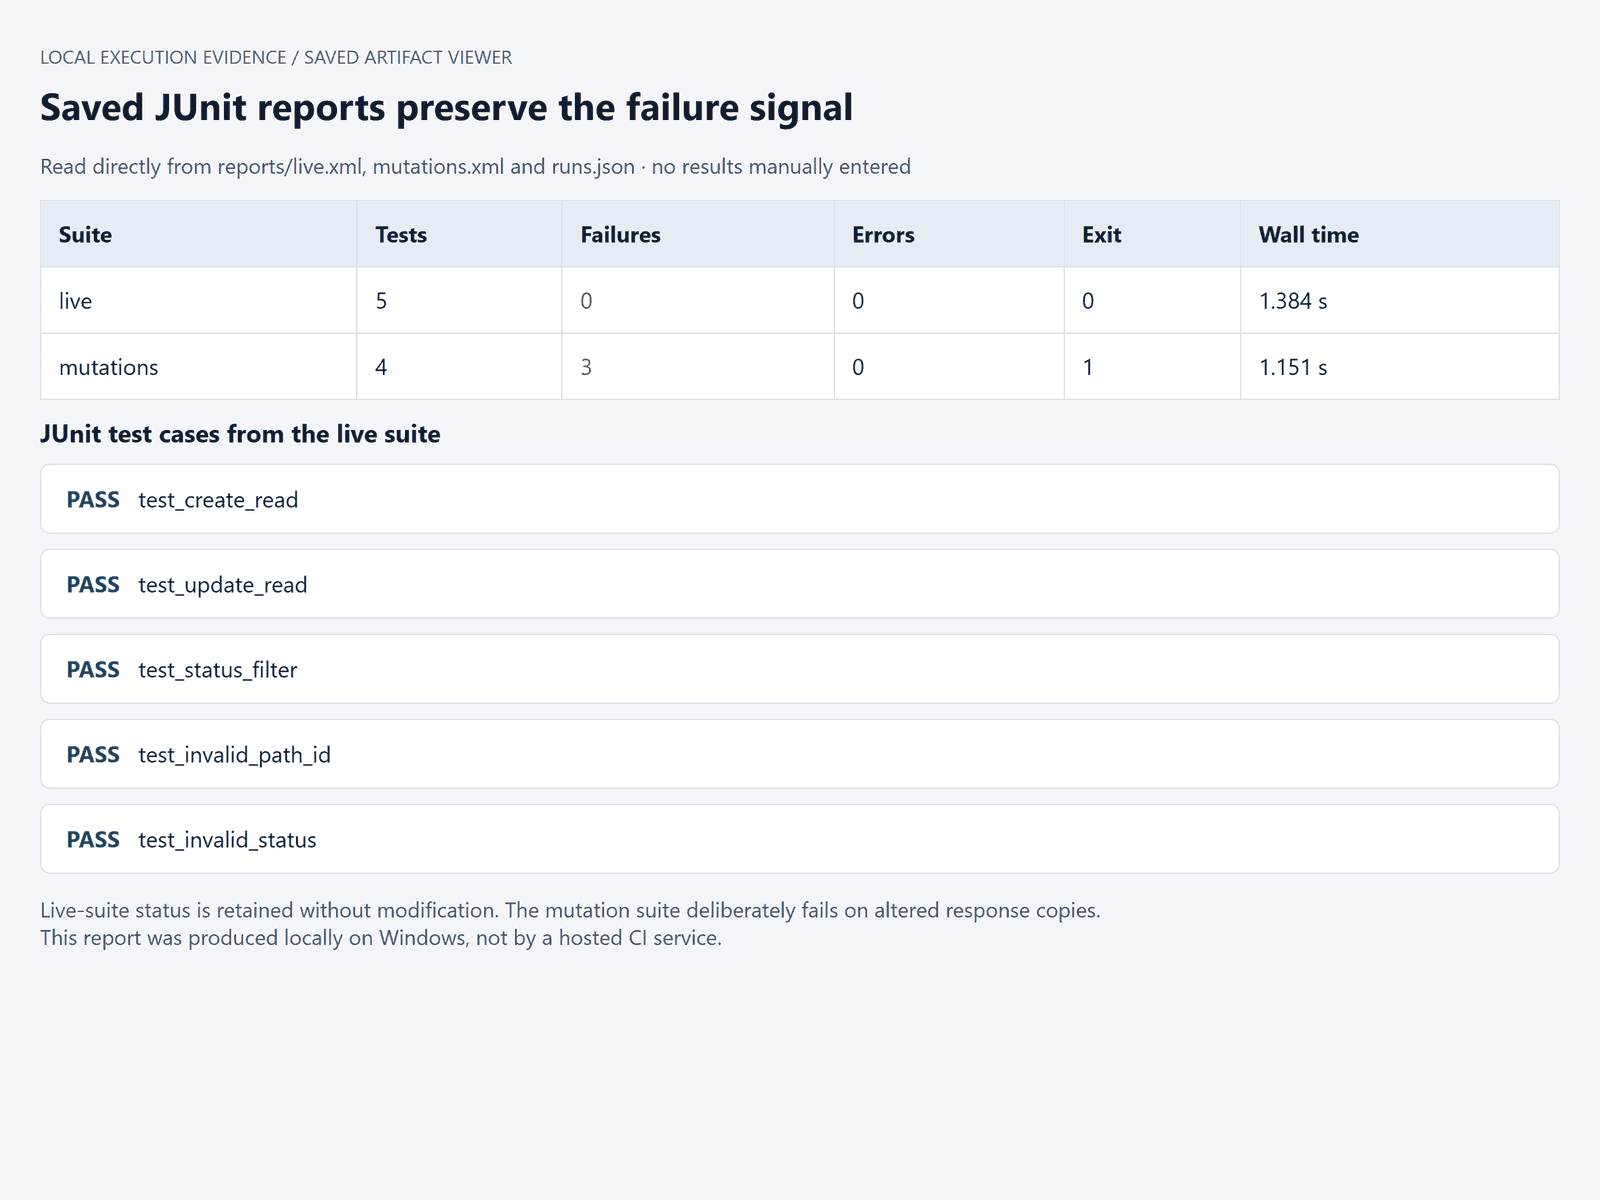 라이브 계약 및 어서션 검사 결과가 분리된 로컬 pytest JUnit 보고서_실제 로컬 _
JUnit 결과: 5개의 라이브 테스트 통과, 통제된 복사본 스위트에는 1개의 통과 기준선과 3개의 의도적 실패가 포함됨. 호스팅 CI 실행은 주장되지 않음.
Python 프로세스 시작을 포함한 측정된 벽시계 시간은 라이브 스위트 1.384초, 통제된 복사본 스위트 1.151초였습니다. 여기에는 서비스 빌드/시작, 의존성 설치, 초안 작성, 검토가 제외됩니다. JUnit 파일과 축약되지 않은 로그는 별도로 저장됩니다.
게이트에 의존하기 전에 실패 경로를 테스트하세요. 실패한 어서션은 실패하는 작업 종료 코드를 생성해야 합니다. 재시도는 경계가 있어야 하며 알려진 인프라 일시적 문제에 대해 정당화되어야 합니다. 결국 제품 실패를 숨기는 반복 재시도는 게이트의 정보 가치를 떨어뜨립니다.
정리 실패를 명시적으로 처리하세요. 기본 어서션 실패를 계속 보이게 하고, 어떤 리소스가 남아 있는지 기록하고, teardown이 자체 문제를 보고하도록 하세요. 병렬 작업에는 별도의 식별자나 네임스페이스가 필요합니다. 단독으로 통과하지만 다른 작업의 데이터를 읽는 테스트는 무인 사용 준비가 되지 않았습니다.
이미 pytest가 있다면 초안 작성 모델을 별도로 선택할 수 있습니다. Atlas Cloud는 이 좁은 역할에 적합합니다. 실행과 보고가 이미 존재하는 사용자 정의 워크플로를 위한 모델 계층입니다. 여기서는 전체 API 테스트 플랫폼이나 위 세 제품의 네이티브 백엔드로 제시되지 않습니다.
해당 평가를 위해 DeepSeek V4.1 Flash를 열고, 모델 ID deepseek-ai/deepseek-v4.1-flash를 사용하며, 로컬에서 사용한 것과 동일한 공개 명세와 검토된 매트릭스를 제공하세요. 프롬프트 B를 사용한 다음 반환된 초안을 검토된 테스트와 별도로 저장하세요. 실행하기 전에 그 가정을 계약과 비교하세요.
인터페이스에서 노출된다면 온도 0.2는 초안 작성의 시작 설정이며 결정성 보장은 아닙니다. 사용 가능한 출력 제한이 스위트 크기와 맞는지 확인하세요. 오래된 문서에서 예산을 잡지 말고 토큰 가격은 현재 모델 카탈로그를 참조하세요.
작업 분담은 명확하게 유지됩니다. 모델이 코드를 제안하고, 검토자가 기대치를 승인하고, 러너가 결과를 생성합니다. 테스트 환경 접근 게이트로 인해 이 문서의 Atlas 실행은 완료되지 않았으므로, 이는 측정된 모델 결과가 아니라 평가 레시피입니다. 작동하는 테스트 러너를 마이그레이션하거나 실행 책임을 챗 모델에 넘기지 않고도 이 경로를 평가할 수 있습니다.
팀을 위한 API 테스트용 AI 도구 선택
결정을 바꿀 수 있는 가장 작은 평가를 선택하세요. 하나의 연결된 워크플로, 하나의 문서화된 부정 사례, 몇 개의 통제된 잘못된 응답을 사용하세요. 후보 간에 입력을 동등하게 유지하세요. 세련된 온보딩 경험이 잘못된 리소스를 식별하지 못하는 테스트보다 우선해서는 안 됩니다.
성숙한 컬렉션 워크플로의 경우 해당 워크스페이스의 AI 기능을 평가하는 것으로 시작하세요. 기존 환경 구성과 요청 의존성은 가치 있는 컨텍스트입니다. 생성된 변경 사항이 취약한 가정을 도입하지 않고 검토 노력을 절약하는지 측정하세요.
견고한 명세와 작성 백로그가 있는 팀의 경우 명세 기반 생성을 평가하세요. 명세가 불완전할 때 어떤 일이 발생하는지에 주목하세요. 누락된 기대치를 명확히 표시하는 생성기는 자신 있게 만들어내는 생성기보다 검토하기 쉽습니다.
실패가 업스트림 동작에 의존하는 애플리케이션의 경우 기록 및 재생을 평가하세요. 대규모 기록에 투자하기 전에 캡처된 기준선과 의존성 지원을 검사하세요. 어떤 동적 필드가 달라질 수 있고 어떤 관계가 그대로 유지되어야 하는지 결정하세요.
안정적인 러너가 있는 팀의 경우 초안 작성과 검토를 위한 독립 모델을 평가하세요. 이미 알고 있는 실행 형식을 유지하지만 통합, 픽스처 설계, 유지 관리도 직접 담당합니다. 비용 계산에 그 소유권을 포함하세요.
API 테스트용 AI 도구 비용을 지불하기 전에 다섯 가지 구체적인 시연을 요구하세요:
- 검토된 스위트가 의도한 환경에서 실행됩니다.
- 관련성 있는 통제된 오류가 적절한 어서션을 실패시킵니다.
- 테스트와 유용한 보고서를 허용 가능한 형식으로 유지할 수 있습니다.
- CI 실행을 포함한 반복 실행이 격리와 실패 신호를 보존합니다.
- 생성, 실행, 유지 관리 비용이 팀 예산에 맞습니다.
수락된 스위트를 유지 관리할 사람을 지정하세요. 명세 변경은 영향을 받는 어서션, 픽스처, 소비자의 검토를 촉발해야 합니다. 변경이 이해될 때까지 이전 실패 증거를 유지하세요. 그러면 다음 릴리스를 평가하기 쉬워지고 팀이 초록색 보고서를 신뢰할 이유가 생깁니다.
자주 묻는 질문
API 테스트에 어떤 AI 도구를 사용해야 하나요?
기존 입력에서 시작하세요. 확립된 컬렉션에는 Postman Agent Mode를, 명세 주도 생성에는 KushoAI를, 서로 다른 생성 흐름 및 기록 경로에는 Keploy를 평가하세요. 팀이 이미 pytest나 다른 러너를 유지 관리한다면 별도의 초안 작성 모델이 맞을 수 있습니다. 동일한 작은 워크플로를 사용하여 각 후보의 어서션, 실행, 검토 노력을 평가하세요.
API 테스트를 위한 무료 AI 도구가 있나요?
무료 클라이언트, 오픈소스 테스트 도구, 제한된 AI 허용량이 있습니다. 이들은 서로 다른 요구를 충족합니다. Postman의 Free 플랜은 2026년 9월 21일 기준 월 50 AI 크레딧을 나열하며, 이는 테스트 수가 아닙니다. 대화형 시험을 무료 CI 솔루션으로 취급하기 전에 필요한 내보내기, 자동화, 보고, 협업 기능이 포함되어 있는지 확인하세요.
AI가 OpenAPI 명세에서 API 테스트를 생성할 수 있나요?
예, 생성기는 작업, 스키마, 매개변수, 응답 정의를 사용하여 테스트를 제안할 수 있습니다. 명세는 여전히 비즈니스 규칙을 생략하거나 오류 매핑을 모호하게 남길 수 있습니다. 승인된 기대치를 제공하고 결과를 검토하세요. 고정된 Petstore 예에서 성공적인 생성은 200으로 문서화되어 있으며, 이는 익숙한 REST 관례가 실제 계약을 대체할 수 없는 이유를 보여줍니다.
AI 생성 어서션이 유용한지 어떻게 알 수 있나요?
세 가지를 확인하세요: 문서화된 스키마 제약, 요청과 응답 간의 관계, 의도적으로 잘못된 데이터에 대한 민감성입니다. 실제 응답을 저장하고, 관련 속성 하나를 수정하고, 동일한 검증기를 다시 실행하세요. 실패 메시지를 유지하세요. 이는 해당 어서션에 대한 좁고 재현 가능한 증거를 제공하지만, 더 넓은 커버리지와 보안 질문은 별도 테스트를 위해 열어 둡니다.
AI 생성 API 테스트를 CI/CD에서 실행할 수 있나요?
예, 생성된 형식, 러너, 환경, 플랜이 해당 경로를 지원할 때 가능합니다. 검토된 테스트를 커밋하고, 고정된 의존성을 설치하고, 격리된 픽스처를 사용하고, JUnit과 같은 구조화된 보고서를 내보내세요. 실패가 0이 아닌 종료 코드를 반환하는지 확인하세요. 성공적인 로컬 실행은 스위트를 CI에 대비시키지만, 호스팅 파이프라인이 실행되었음을 입증하지는 않습니다.
AI가 수동 API 테스트를 대체할 수 있나요?
AI는 반복적인 초안 작성을 줄이고 검토자가 약한 어서션을 찾도록 도울 수 있습니다. 사람은 여전히 의도된 동작을 결정하고, 모호한 실패를 조사하고, 제공된 예시 밖의 위험을 탐구합니다. API 테스트용 AI 도구를 사용하여 검토 가능한 테스트 자산을 만든 다음 재현 가능한 증거로 판단하세요. 의미 있는 실수를 잡아내는 작은 스위트가 설명되지 않는 초록색 검사 모음보다 신뢰하기 쉽습니다.


