코드는 완성된 것처럼 보인다. 그러다 테스트가 실패하고, 수정이 인터페이스를 바꾸고, 또 다른 요청이 실행되기 시작한다. best ai api for coding을 선택한다는 것은 여러분의 작업 방식을 감당할 수 있는 예산 안에서 끝내주는 모델과 엔드포인트를 찾는 일이다.
먼저 Claude, GPT, Gemini를 기준 후보로 삼아 시작하라. 대안적인 배포 및 지출 옵션을 원한다면 DeepSeek, Qwen, Kimi를 동일한 작업에서 비교하라. 디버깅에는 회귀 테스트를 우선하라. 리팩터링에는 diff를 검사하라. 코딩 에이전트의 경우, 토큰 가격을 비교하기 전에 전체 도구 루프를 검증하라.
불만은 측정 가능하다. 2025 Stack Overflow 개발자 설문에서 불만 사항 질문에 응답한 사람 중 66%가 거의 정확한 AI 해결책을 받았다고 보고했고, 45%는 생성된 코드를 디버깅하는 데 더 많은 시간을 쓴다고 보고했다. 이는 설문 응답이며 2026년 모델 평가가 아니다. (Stack Overflow Developer Survey, 2025)
핵심 요약
- API와 에이전트를 별개로 선택하라.
- 작업과 필요한 엔드포인트 기능을 기준으로 후보를 추려라.
- 첫 번째 답변을 저장하고 고정된 수용 테스트로 평가하라.
- 실패한 시도와 수정도 비용 계산에 포함하라.
이 가이드는 후보 목록, 복사해서 쓸 수 있는 세 가지 평가 과제, 그리고 비용 워크시트를 제공한다. 리서치는 2026년 9월 21일에 확인했다. 모델 가용성, 문서화된 기능, 측정된 결과는 이 글 전체에서 서로 다른 증거 범주로 다룬다.
Best AI API for Coding: 후보 목록
두 개의 후보로 시작하라. 하나는 기존 애플리케이션에 맞는 것, 다른 하나는 대안이다. 이 여섯 개 제품군을 사용해 그 첫 조합을 구성하라.
이 표는 비교 성능을 주장하지 않고 테스트를 제안한다. 접근은 계정, 지역, 할당량, 엔드포인트에 따라 달라진다. 문서에 나열되어 있다고 해서 여러분의 자격 증명으로 호출할 수 있다는 뜻은 아니다.
| 특정 모델 및 ID | 접근 경로 | 평가할 가치가 있는 작업 | 주요 결정 경계 | 엔드포인트 근거 | 가격 확인 |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | 제약이 있는 다중 파일 변경 | 클라이언트 및 추론 제어 확인 | Claude Platform 모델 개요, 계정 접근 미검증 | 요율 미기재 |
GPT-6 Astra, gpt-6-astra | OpenAI API | 다중 조건 코딩 작업 | 라우트 및 도구 확인 | OpenAI 모델 문서, 계정 접근 미검증 | 요율 미기재 |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | 대화형 생성 및 검토 | 지연 시간 및 프로토콜 확인 | Google AI 모델 디렉터리, 계정 접근 미검증 | 요율 미기재 |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud 모델 라우트 | 수치 수정, 컨텍스트 실험 | 0813 버전을 별도로 유지 | 정확한 모델 페이지 확인, 런타임 기능 미검증 | 2026년 9월 21일 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud 모델 라우트 | 리팩터링, 자체 완결형 인터페이스 | 명시된 버전, 최신 버전 아님 | 정확한 모델 페이지 확인, 런타임 기능 미검증 | 2026년 9월 21일 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud 모델 라우트 | 동일한 세 가지 작업, CSV 인터페이스 | 출력 및 완료 한도 확인 | 정확한 모델 페이지 확인, 런타임 기능 미검증 | 2026년 9월 21일 |
Claude, GPT, Gemini는 유용한 기준 후보를 제공한다. 각사의 공식 모델 디렉터리에서 위 버전을 확인할 수 있다. 이미 잘 알고 있는 제공자를 기준선으로 삼고, 대안이 수용된 작업 비용이나 통합 작업량을 줄여 주는지 테스트하라. 소비자용 어시스턴트의 동작을 해당 API 결과로 간주하지 마라.
OpenAI의 모델 디렉터리에는 GPT-5.6 제품군과 함께 GPT-6 Astra가 나열되어 있다. 이는 현재 후보라는 사실을 확립할 뿐, 다른 행보다 코딩에서 우수하다는 뜻이 아니다. 이 표는 날짜 없는 비교 페이지에서 옛 모델 ID를 가져오는 것을 의도적으로 피한다. (OpenAI 모델 디렉터리, 2026년 9월 접속)
DeepSeek은 별도로 조사할 가치가 있는 모델 제품군이다. 변경 범위를 넓히지 않고 특정 버그를 고치는지 테스트하라. 모델의 일반적인 평판과 무관하게, 배포된 라우트가 요구하는 응답 형식, 도구 동작, 지연 시간 상한을 충족하지 못하면 다른 후보를 선택하라.
Qwen은 버전별로 평가하라. 명시된 122B A10B 배포는 구체적인 가격 기준을 제공한다. 가치 결론을 내리기 전에 파싱 및 브라우저 검사를 실행하라. 다른 Qwen 릴리스의 컨텍스트 수치를 이 모델에 적용할 수 없다.
Kimi는 실제 구성 검토 후보다. 공개 페이지에서 모델 ID를 확인할 수 있다. 구성 검토는 가능하지만 성공적인 생성은 아직 검증되지 않았다. 다른 후보와 동일한 제약 조건에 비추어 완성된 출력을 평가하라.
Atlas Cloud는 이 비교에서 접근 계층에 위치한다. 일곱 번째 모델이 아니다. 그 관련성은 실용적이다. 워크플로에 확정하기 전에 여러 후보 모델 페이지를 살펴보고 통합 요구 사항을 비교할 수 있다.
오픈 가중치의 경우 정확한 릴리스 라이선스와 배포 아티팩트를 확인하라. 호스팅 추론에는 별도의 서비스 약관과 운영 비용이 따른다. 모델 제품군만으로는 이를 확립할 수 없다.
Coding API, 모델, 에이전트 설명
모델은 입력에 대한 응답으로 콘텐츠를 생성한다. API는 애플리케이션이 그 입력을 보내고 결과를 받는 방식을 정의한다. 코딩 에이전트는 주변 작업을 조직한다. 파일 읽기, 도구 호출, 편집 적용, 테스트 실행, 계속할지 결정하기가 포함된다.
이 세 계층은 각각 독립적으로 실패할 수 있다. 모델이 올바른 패치를 제안했는데 에이전트가 잘못된 파일에 기록할 수 있다. API가 유효한 JSON을 반환했는데 애플리케이션이 도구 호출을 무시할 수 있다. 유능한 에이전트가 선택한 엔드포인트가 매개변수를 거부해서 멈출 수 있다.
핸들러를 보내고 ID 파서를 요청한다고 가정하자. 기본 코드 생성 API는 코드가 담긴 텍스트를 반환한다. 여러분의 프로그램은 여전히 그 코드를 추출하고, 적절한 작업 공간에 배치하고, 테스트를 실행해야 한다. 성공적인 HTTP 응답은 전달을 확인할 뿐, 정확성을 확인하지 않는다.
에이전트는 여러분이 도구와 권한을 제공할 때만 그 단계를 자동화할 수 있다. 종료 조건도 필요하다. 종료 조건이 없으면 이미 충분한 함수를 반복해서 편집하거나, 작업을 확장하거나, 관련 없는 세부 사항을 개선하려고 추가 요청을 소비할 수 있다.
세 가지 예산 항목을 분리해서 관리하라.
- 도구 구독: 사용하는 애플리케이션, 편집기 통합 또는 에이전트 서비스.
- 추론 사용량: 해당 청구 조건에 따라 선택한 모델 엔드포인트로 보내는 요청.
- 실행 환경: 컨테이너, 테스트 러너, 스토리지 및 기타 인프라.
일부 제품은 이 스택의 일부를 묶어 제공한다. 다른 제품은 별도의 자격 증명을 준비하도록 요구한다. 편집기 구독이 자체 애플리케이션의 임의 API 트래픽을 포함한다고 가정하기 전에 해당 요금제를 확인하라.
프로토콜 호환성에도 경계가 있다. 익숙한 messages 배열을 받아들이는 서비스라도 도구 동작, 스트리밍 이벤트, 컨텍스트 한도, 추론 제어가 다를 수 있다. 기본 URL을 복사한다고 해서 다른 제공자 생태계의 모든 기능을 지원한다는 것이 확립되지 않는다.
애플리케이션, 에이전트, 엔드포인트, 모델, 도구, 테스트를 매핑하라. 모델을 바꾸기 전에 각 단계에서 청구 대상 구성 요소와 책임 주체를 파악하라.
Best AI API for Coding: 7가지 선택 점검
1. 기능적 정확성과 회귀 동작. 코드를 요청하기 전에 기대 출력을 작성하라. 일반 정수는 처리하지만 null을 0으로 받아들이는 가격 함수는 계약을 위반한다. 새로운 엣지 케이스와 기존 프로젝트 테스트를 모두 실행하라. 새 테스트 하나를 통과하는 것이 다른 곳의 호출자 손상을 가릴 수 있다.
2. 변경 범위. 패치를 요청과 비교하라. ID 파서를 추출할 때 URL, 성공 응답, 오류 응답은 그대로 유지되어야 한다. 요청하지 않은 프레임워크 마이그레이션은 대체품이 컴파일되더라도 검토 작업을 추가한다. 관련 없는 편집이 답변을 탈락시킬지, 수정이 필요한지 미리 정하라.
3. 유용한 컨텍스트와 출력 여유. 요청에는 지침, 관련 파일, 도구 정의, 이전 대화가 포함된다. 답변을 위한 공간도 충분히 확보하라. 크게 광고된 컨텍스트 윈도우는 모델이 관련 불변 조건을 찾아낸다거나, 여러분의 엔드포인트가 같은 최대치를 받아들인다는 것을 확립하지 않는다.
중요한 의존성으로 컨텍스트 품질을 테스트하라. 인터페이스가 안정적으로 유지되어야 하는 호출자를 포함하고 모델이 이를 존중하는지 확인하라. 잘림은 별도로 측정하라. 함수 중간에서 끝난 응답은 시작 부분이 그럴듯해 보였다는 이유로 받아들일 수 없다.
4. 도구 호출과 구조화된 출력. 실제 도구 스키마로 배포된 라우트를 검증하라. 인수 유형, 누락된 필드, 도구 식별자, 도구 결과 이후의 후속 응답을 확인하라. 그럴듯한 JSON 객체를 작성하는 모델이 반드시 네이티브 도구 호출 왕복을 완료한 것은 아니다.
5. 수용된 결과까지의 시간. 수정과 테스트를 포함한 전체 시도의 소요 시간을 기록하라. 대화형 어시스턴트의 경우 첫 텍스트가 보이기까지의 시간도 중요하지만 완료 시간을 대체할 수는 없다. 빠른 첫 토큰 뒤에 길고 쓸모없는 답변이 이어지면 여전히 개발자를 막는다.
6. 입력, 출력, 캐시, 재시도 요금. 선택한 엔드포인트가 실제로 보고하는 청구 범주를 읽어라. 해당되는 경우 캐시 읽기를 일반 입력과 분리하라. 실패한 요청과 중단된 루프를 추적하라. 제공자가 필요한 세부 정보를 노출하지 않으면 추정치의 누락된 가정을 명시적으로 표시하라.
7. 통합 및 코드 처리 조건. 편집기나 애플리케이션이 해당 라우트, 인증 방식, 오류 형식을 지원하는지 확인하라. 비공개 소스를 보내기 전에 제공자의 현재 데이터 처리 약관을 검토하라. 오픈 가중치는 모델 배포 선택을 설명할 뿐, 호스팅 서비스가 여러분의 요청을 어떻게 처리하는지는 확립하지 않는다.
공개 벤치마크는 그 조건을 읽는다는 전제하에 후보 선택에 도움이 될 수 있다. SWE-bench Verified는 사람이 필터링한 500개의 인스턴스를 포함한다. 현재 페이지는 동일한 mini-SWE-agent 환경을 사용하는 Bash Only 뷰도 설명한다. 이 세부 정보는 무엇이 비교되는지 설명하는 데 도움이 된다. (SWE-bench, 2026년 9월 접속)
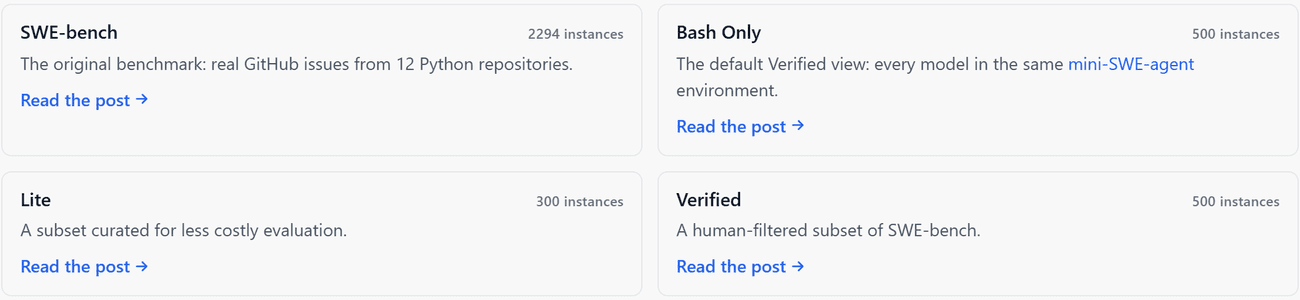 Verified 데이터셋 크기와 공유 에이전트 환경을 보여 주는 SWE-bench 페이지
출처 근거: 실제 벤치마크 페이지, 2026년 9월 21일 캡처. 데이터셋과 실행 조건은 모든 성능 주장 옆에 함께 있어야 한다.
벤치마크 결과는 특정 설정을 설명한다. 여러분의 언어, 비즈니스 규칙, 권한, 검토 기준은 다를 수 있다. 최종 결정은 여러분이 검사할 수 있는 작업을 기준으로 내려라.
Best AI API for Coding: 세 가지 실전 점검 실행
이 세 가지 재현 가능한 평가 예시는 서로 다른 실패 모드를 드러낸다. 출력을 요청하기 전에 수용 규칙을 확정하라. 설명 품질과 무관하게 함수나 페이지를 계약에 비추어 평가하라.
DeepSeek V4 Pro, Qwen3.5 122B A10B, Kimi K3의 경우 의도된 프로토콜은 과제당 세 번의 독립 실행이다. 즉 27번의 최초 시도를 뜻한다. 시도당 최대 한 번의 피드백 수정을 허용하고, 첫 번째 답변을 보존하고, 최초 결과와 수정 결과를 별도로 보고하라.
지원되는 경우에만 temperature를 0으로 요청하고, 실제로 수용된 설정을 기록하라. 엔드포인트 한도를 확인한 후 A와 B에는 4,096 토큰, C에는 8,192 토큰의 요청 출력 상한을 사용하라. 기본값과 지원되지 않는 제어는 기록해야 한다. 낮은 temperature가 동일한 답변을 보장하지는 않는다.
증거 상태: 테스트 환경 접근이 Cloudflare Access 로그인 화면으로 차단되었다. 27개의 후보 시도를 실행할 수 없었다. 다음 증거는 후보 모델 결과가 아니라 로컬에서 실행한 원본 코드와 이 글에서 작성한 CSV 참조 픽스처를 보여 준다. 모델 통과율, 토큰 사용량, 과제 비용은 측정되지 않은 상태로 남아 있다.
과제 A: 숫자 가격 선택 수정. 이 프롬프트를 그대로 새 세션에 붙여 넣어라.
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
고정된 수용 입력은 [2,10,3], ["12","3"], 빈 배열, 유효하지 않은 값만 있는 경우, 0, 음수, 공백만 있는 문자열이다. 트림 후 빈 문자열은 거부하라. 호출 후 원본 배열이 동일한 순서로 정확히 같은 요소를 가지고 있는지 확인하라.
원본은 JavaScript의 기본 정렬을 사용하고 입력을 변경한다. 따라서 이 과제는 두 가지 별개 의무를 점검한다. 올바른 숫자 최솟값을 선택하고 호출자의 데이터를 변경하지 않는 것이다. 짧은 강제 변환 기반 해결책이 실수로 불리언이나 null을 받아들일 수 있으므로 변환 규칙을 명시적으로 테스트하라.
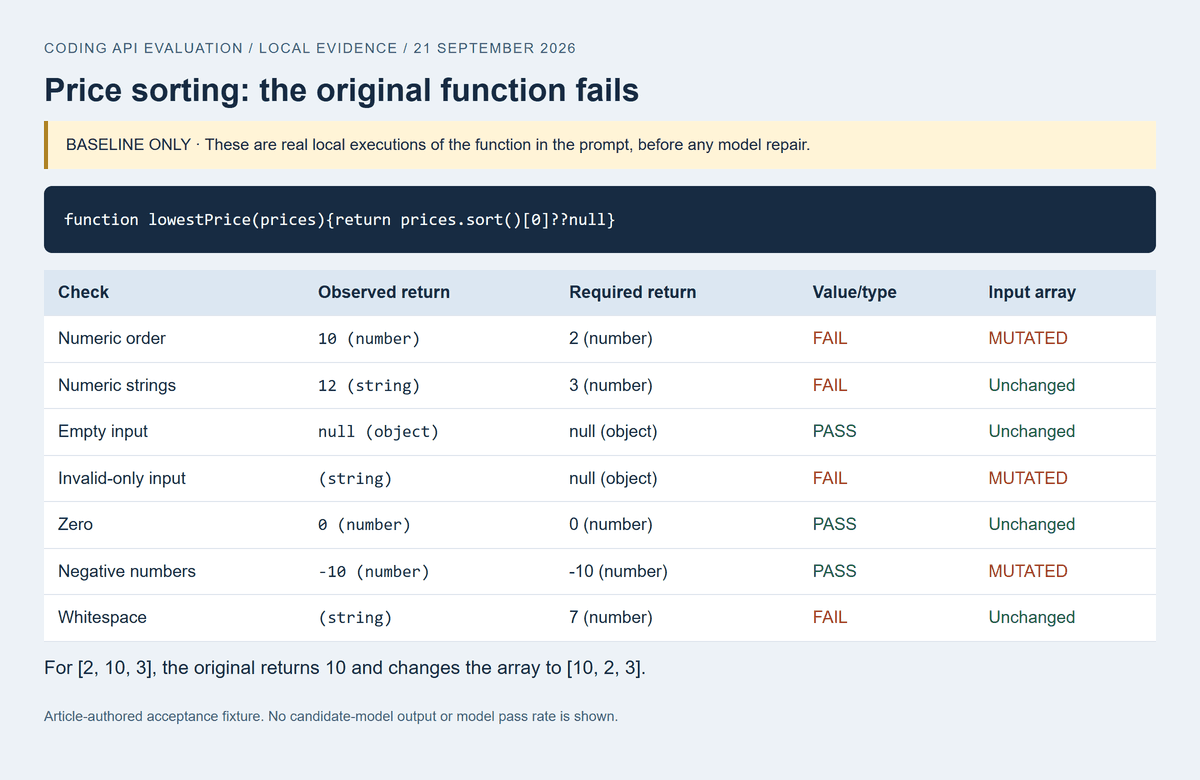 잘못된 숫자 정렬과 변경된 입력을 보여 주는 원본 가격 함수의 로컬 실행
실행된 기준선: 원본 함수는 [2,10,3]에 대해 10을 반환하고 배열을 [10,2,3]으로 변경한다. 숫자 문자열도 반환값 계약을 위반한다. 모델 수정은 표시되지 않았다.
과제 B: 소규모 리팩터링 중 인터페이스 보존. 이 프롬프트를 변경 없이 사용하라.
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
"12"와 "0012"를 12로 받아들여라. "1e2", "1.0", 음수, 0, 공백, 비문자열 입력, JavaScript의 안전 정수 범위를 넘는 값을 거부하라. 등록된 경로와 두 응답 본문을 확인하라. 유효하지 않은 입력은 findUser에 도달해서는 안 된다.
이 과제는 모델이 숫자 변환과 명시된 문자열 문법의 차이를 이해하는지 테스트한다. diff에서 관련 없는 변경을 검사한 다음, 스텁된 요청 및 응답 객체로 핸들러를 호출하라. 올바른 헬퍼가 변경되지 않은 관대한 핸들러와 짝을 이루면 여전히 실패한다.
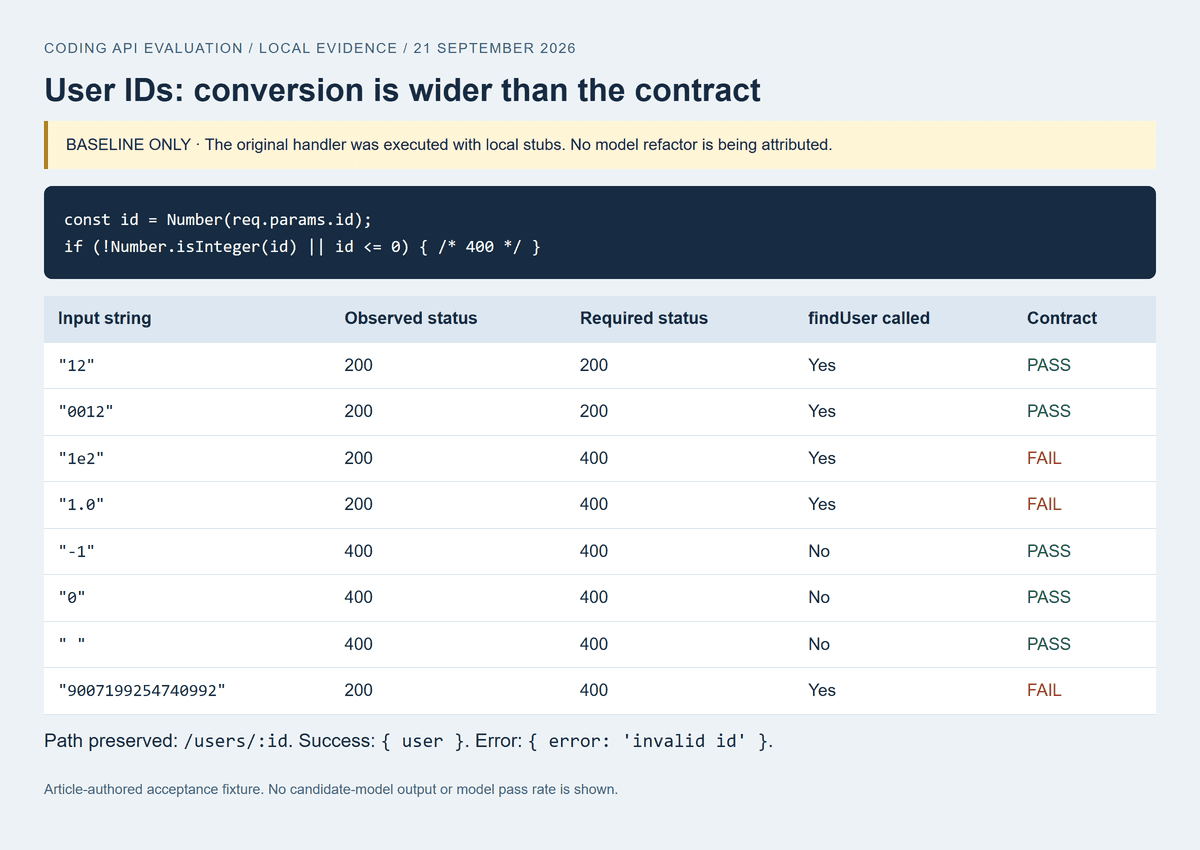 유효하지 않은 숫자 문자열이 200 상태로 수용되는 원본 핸들러 테스트 로그
실행된 기준선: 원본 핸들러는 요구된 400 응답에도 불구하고 "1e2", "1.0", "9007199254740992"에 대해 200을 반환한다. 로컬 스텁이 호출을 기록했으며, 이는 모델이 생성한 리팩터링이 아니다.
과제 C: 직접 조작할 수 있는 CSV 미리보기 만들기. 다음을 제출하라.
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
먼저 LF로, 그다음 CRLF로 이 정확한 레코드들을 사용해 테스트하라.
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
두 개의 열, 세 개의 데이터 행, Alice의 쉼표가 하나의 셀 안에 있는 것, Bob의 이스케이프된 따옴표가 올바르게 표시되는 것을 기대하라. Eve의 값은 이미지 요소, 이벤트 실행, 네트워크 요청 없이 리터럴 텍스트로 나타나야 한다. 필드가 세 개인 행을 추가하고 페이지가 불일치를 눈에 띄게 보고하는지 확인하라.
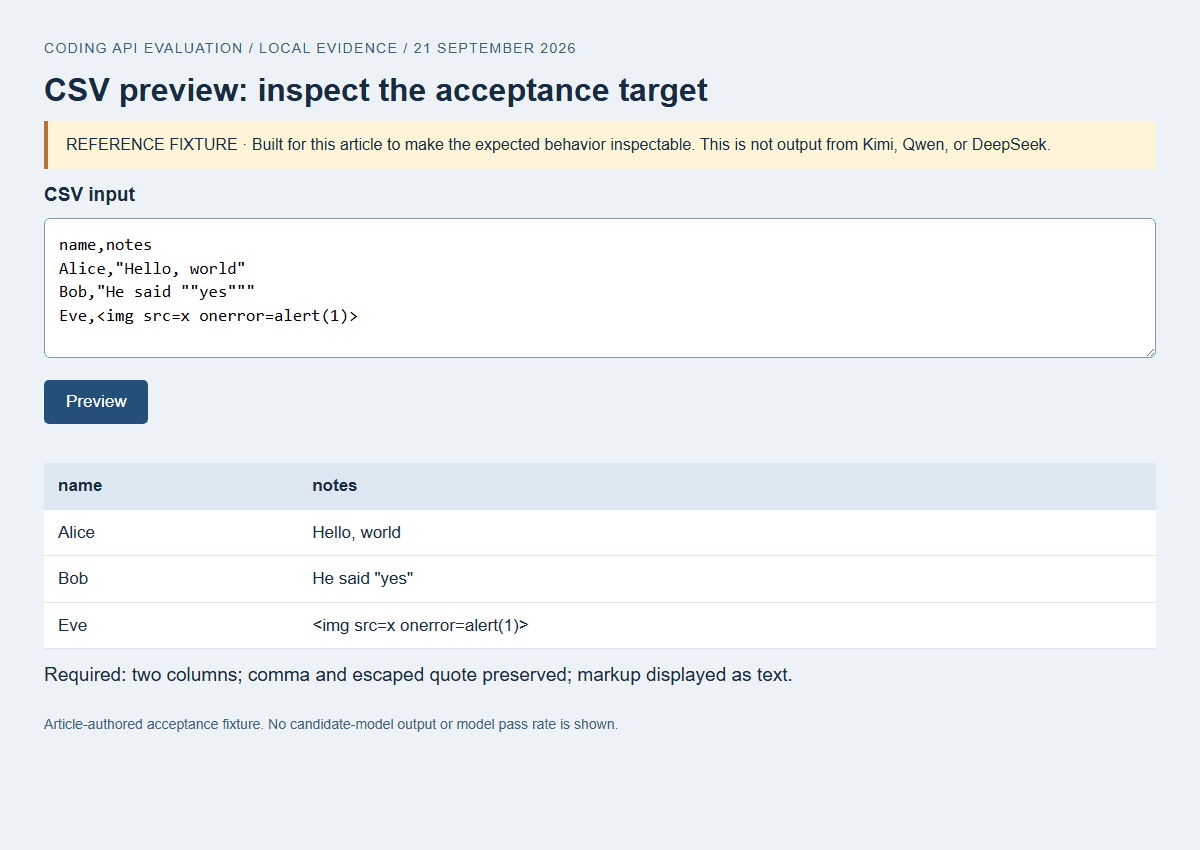 따옴표로 묶인 값과 리터럴 마크업 요구 사항을 보여 주는 CSV 수용 픽스처
이 글을 위해 제작한 직접 조작한 참조 픽스처이며, 후보 모델이 생성한 것이 아니다. 브라우저 검사로 LF/CRLF 파싱, 이스케이프된 따옴표, 리터럴 마크업, 눈에 보이는 필드 수 오류, HTTP 요청 없음을 확인했다. 스크린샷은 Preview를 클릭한 후의 유효 입력 상태를 보여 준다.
원시 출력, 로그, 모델 ID, 날짜, 매개변수, 타이밍, 수정, 수동 편집을 저장하라. 기대 결과를 바꾸지 않고 실패한 검증을 수정용으로 보내라. 거부, 잘림, 오류도 성공 사례와 함께 보관하라.
예산으로 하는 Best AI API for Coding
토큰 요율을 완성 품질 및 사용량과 함께 비교하라. 반복 입력은 코드 검토 비용을 지배할 수 있고, 전체 파일 생성은 출력 요금을 늘릴 수 있다. 반복 수정은 둘 다 추가한다.
Atlas 카탈로그와 정확한 상세 페이지는 2026년 9월 21일 기준으로 다음과 같은 백만 토큰당 USD 요율을 보여 주었다.
- DeepSeek V4 Pro: 입력 $1.68, 출력 $3.38. 별도의 V4 Pro 0813 목록은 다른 요율을 사용하므로 대체하지 마라.
- Qwen3.5 122B A10B: 입력 $0.30, 출력 $2.40. 2026년 9월 기준 카탈로그에는 25% 할인이 적용된 정가 $0.40와 $3.20이 표시되었다.
- Kimi K3: 입력 $3.00, 출력 $15.00.
이는 이 글의 평가에서 나온 청구서가 아니라 표시된 프로덕션 요율이다. 캐시 전용 요율과 그 적용 가능성은 확인되지 않았다. DeepSeek와 Kimi의 프로모션 할인도 확인되지 않았다. 할인 관찰이 없다고 해서 제안이 존재하지 않는다는 것이 증명되지는 않는다.
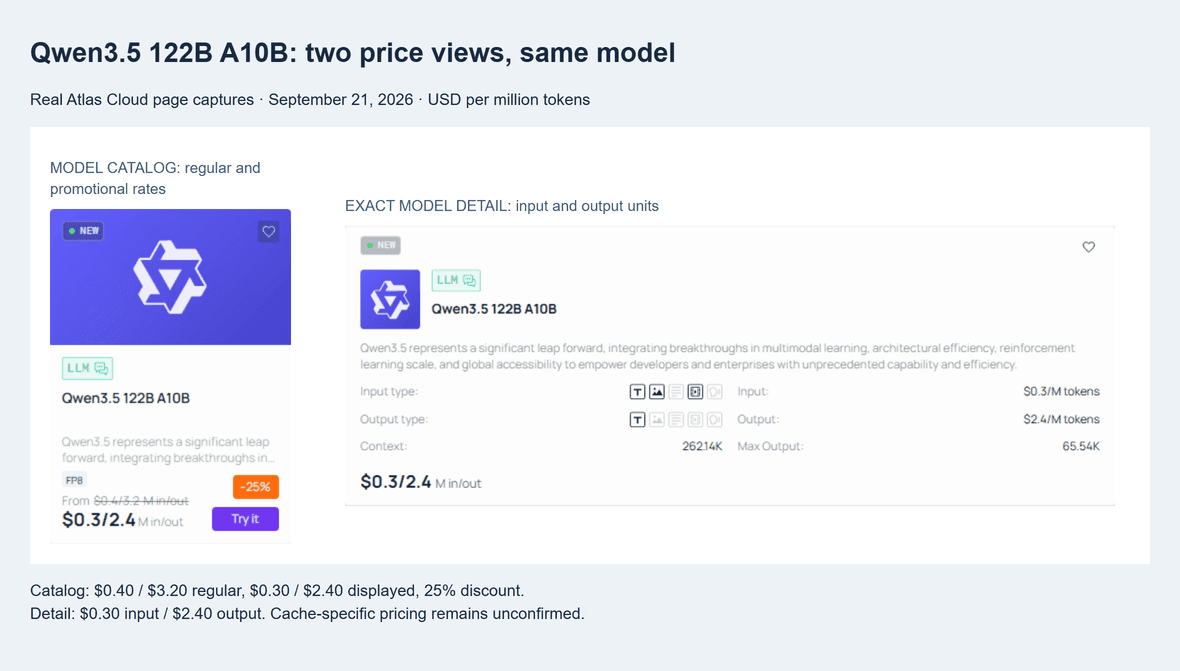 Qwen3.5 122B A10B 카탈로그 할인과 정확한 모델 상세의 입력 및 출력 요율
Qwen 가격 교차 확인, 2026년 9월 21일: 카탈로그에 25% 프로모션이 표시되고, 정확한 모델 상세가 백만 토큰당 입력 $0.30, 출력 $2.40을 확인해 준다. 캐시 전용 요율은 여전히 확인되지 않았다.
과제의 모델 부분 비용을 다음과 같이 계산하라.
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
청구 기록이 캐시된 토큰을 별도로 취급한다면 이를 일반 입력으로 다시 청구하지 마라. 추론 사용량이 청구 대상 출력에 포함되는지 확인하라. 통과한 과제가 없으면 "성공한 결과 없음"이라고 보고하라. 0으로 나누거나 완료 비용을 0으로 표시하면 독자를 오도하게 된다.
투명한 산술 예시로, 표시된 Qwen 요율에서 일반 입력 토큰 10,000개와 출력 토큰 2,000개를 가정하자. 추정 모델 요금은 다른 적용 항목을 제외하고 $0.0078이다. 이는 가정한 요청이며, 관찰된 토큰 사용량이나 실제 청구서가 아니다.
같은 크기의 수정 한 번이면 추정치는 $0.0156이 된다. 실제 수정에는 서로 다른 컨텍스트와 출력이 따르므로 각 요청을 기록된 사용량으로 계산하라.
| 과제 | 모델 | 1차 통과 | 수정 후 | 토큰 사용량 | 비용 출처 | 총 요금 | 총 시간 | 수동 변경 |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 각 3회 반복 계획 | DeepSeek V4 Pro | 미측정 | 미측정 | 미기록 | 사용량 기록 없음 | 알 수 없음 | 미측정 | 평가 없음 |
| A, B, C; 각 3회 반복 계획 | Qwen3.5 122B A10B | 미측정 | 미측정 | 미기록 | 사용량 기록 없음 | 알 수 없음 | 미측정 | 평가 없음 |
| A, B, C; 각 3회 반복 계획 | Kimi K3 | 미측정 | 미측정 | 미기록 | 사용량 기록 없음 | 알 수 없음 | 미측정 | 평가 없음 |
여러분의 워크시트에서는 각 행을 모델과 반복별로 한 행씩 확장하라. 수정 후 성공은 수용된 과제 분모에 한 번만 계산하라. 실패한 시도는 분자에 포함하고, 1차 통과와 최종 수용 열은 별도로 유지하라.
인간 검토와 인프라는 별도로 추적하라. 불필요한 재작성을 풀어내는 데 드는 비용이 추론 절감을 상쇄할 수 있다. 수용 요구 사항과 검토 시간 예산을 모두 충족하는 후보를 비교하라.
Atlas Cloud로 하는 Best AI API for Coding
Kimi K3 모델 페이지에서 시작해 ID를 확인하고 API 및 Code 뷰를 살펴보라. 선택한 버전을 테스트 기록 옆에 두어라.
두 라우트를 상호 교환 가능한 것으로 취급하기 전에 LLM 프로토콜 문서를 읽어라. 이 문서는 Chat Completions를 폭넓은 커버리지의 라우트로 식별하고 사용자에게 각 모델의 supported_apis를 안내한다. 샘플링 제어와 도구 기능도 모델이 광고하는 지원에 따라 달라진다.
여기서 확인할 만한 구체적인 통합 세부 사항이 있다. 문서에 따르면 변환된 Anthropic 요청에는 cache_control이 적용되지 않으며, 제공자가 호스팅하는 도구는 그 변환 라우트에서 사용할 수 없다. 기존 에이전트가 네이티브 캐싱이나 호스팅 브라우징 도구를 전제로 한다면 이러한 제약이 중요하다. 클라이언트를 실제 라우트에 맞춰라.
다음 Node.js 예시는 텍스트 요청 하나를 보여 준다. 내장 fetch, 자격 증명용 환경 변수, 검증된 Kimi 모델 ID를 사용한다. 과제 A의 정확한 프롬프트를 task-a.txt로 저장하라. 기본 URL 환경 변수를 문서에 나온 Atlas API 기본 주소(/v1로 끝남)로 설정하라.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages는 과제를 전달하고, model은 배포를 선택하며, max_tokens는 출력 상한을 요청한다. 응답 리더는 코드를 반환하기 전에 일반적으로 완료된 텍스트인지 확인한다. 타임아웃은 이 예시의 대기를 제한할 뿐, 서버가 처리를 중단했다거나 요금이 발생하지 않았다는 것을 확립하지 않는다.
Temperature는 모델별 지원과 확정된 동작을 검증해야 하므로 생략했다. 이 예시는 자동으로 재시도하지 않는다. 제한된 재시도 정책을 추가하기 전에 실패 클래스를 검토하고, 인증 헤더를 절대 기록하지 마라. 이 게시물의 코드는 기사 제작 중 API 키로 실행되지 않았다.
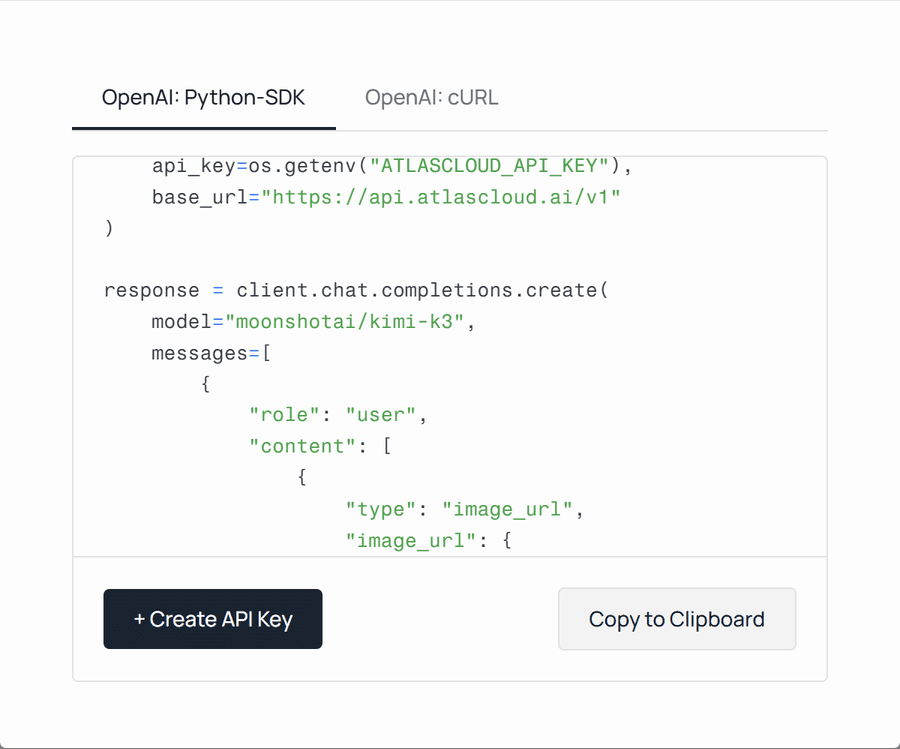 Atlas 엔드포인트와 모델 식별자를 보여 주는 공개 Kimi K3 API 코드 예시
공개 Kimi K3 Code 대화 상자, 2026년 9월 21일 캡처. 이는 구성 증거이며 완료된 코딩 실행이 아니다. 페이지의 샘플에는 미디어 입력이 포함되어 있지만, 이 글의 예시는 텍스트만 사용한다.
반환된 함수에 과제 A의 수용 검사를 실행하라. DeepSeek이나 Qwen으로 전환하기 전에 그 프로토콜과 매개변수를 검증하라. 출력과 사용량을 비교하는 동안 프롬프트와 테스트는 변경하지 마라. 요청 형태가 같다고 해서 동일한 동작이 확립되지는 않는다.
프로덕션에서 코딩 API를 사용하기 전에
생성된 코드를 먼저 일회용 브랜치나 격리된 작업 공간에서 실행하라. CSV 과제의 경우 네트워크 요청이 차단되고 민감한 애플리케이션 상태에 접근할 수 없는 로컬 브라우저 컨텍스트를 사용하라. 저장소 과제의 경우 평가에 필요한 파일과 명령만 프로세스에 제공하라.
성공 기준을 모델의 응답 외부에 정의하라. 에이전트가 "모든 테스트 통과"라고 말하면 실제 테스트 로그, 종료 코드, 확인된 리비전으로 이어져야 한다. 그 증거와 함께 diff를 저장하라. 그렇지 않으면 이후 수정이 표면적 성공 후에 파일을 바꾸고 보고서를 낡은 상태로 남길 수 있다.
타임아웃과 재시도를 여러분이 소유한 애플리케이션 동작으로 취급하라. 요청 마감 시간과 총 과제 예산을 설정하라. 자격 증명이나 잘못된 매개변수로 인한 오류와 일시적 전송 실패를 구분하라. 유효하지 않은 요청을 반복하는 것은 시간 낭비이고, 부작용을 일으키는 요청을 반복하면 중복 작업이 생길 수 있다.
에이전트가 도구를 호출할 수 있을 때 읽기 전용 검사와 쓰기를 구분하라. 도구 설계가 지원하는 경우 작업 식별자를 할당하고, 불확실한 쓰기를 반복하기 전에 상태를 확인하라. 모델 엔드포인트의 재시도 정책은 애플리케이션이 이후에 실행하는 도구의 멱등성을 보장할 수 없다.
소스 파일만큼이나 로그도 신중하게 보호하라. 비밀 정보나 전체 비공개 저장소를 일상적으로 텔레메트리에 복사하지 않고 모델 ID, 타임스탬프, 상태, 타이밍, 사용량을 기록하라. 필요한 원시 출력 증거는 적절히 제한된 위치에 보관하고, 팀이 얼마나 오래 보존해야 하는지 정하라.
실제 클라이언트로 스트리밍을 확인하라. 부분 이벤트, 종료, 오류, 가능한 경우 사용량 기록을 처리해야 한다. 실제 계정과 배포의 속도 제한을 확인하라. 조용한 단일 사용자 실험은 팀이 동시에 요청을 제출할 때 같은 라우트가 어떻게 동작하는지 확립할 수 없다.
이 간단한 릴리스 체크리스트를 사용하라.
- 최종 리비전에서 수용 테스트와 기존 회귀 테스트가 통과한다.
- diff가 승인된 과제 경계 안에 머문다.
- 타임아웃, 취소, 재시도 동작이 실행 검증되었다.
- 선택한 엔드포인트에서 도구 호출과 구조화된 응답이 작동한다.
- 로그에 자격 증명과 불필요한 비공개 코드가 포함되지 않는다.
- 데이터 처리 약관이 팀의 요구 사항을 충족한다.
- 폴백에는 자체적으로 검증된 구성과 테스트 기록이 있다.
비공개 저장소는 서비스별 결정이 필요하다. 코드 책임자와 함께 현재 보존, 학습 사용, 접근, 계약 조건을 검토하라. 승인된 자료만 보내라. 모델 가중치를 사용할 수 있다거나 이미 사용하는 것과 유사한 프로토콜이라는 이유로 기밀성을 추정하지 마라.
Best AI API for Coding: 최종 선택하기
세 단계로 결정하라.
첫째, 필수 기능을 충족하지 못하는 후보를 제거하라. 반드시 성립해야 하는 조건을 적어라. 수용되는 출력 형식, 작동하는 도구 루프, 적절한 데이터 처리 방식, 실행 가능한 응답 마감 시간 등이다. 하나라도 놓치는 후보는 최종 비교에 포함되기 전에 별도의 개선 결정이 필요하다.
둘째, 수용된 과제 비용과 소요 시간을 비교하라. 동일한 수정 정책 아래 모든 시도를 사용하라. 1차 통과 성공과 수정 후 성공을 분리하고, 누락된 사용량 기록을 표시하라. 두 모델이 모두 계약을 충족하면 모델 요금뿐 아니라 검토 부담도 비교하라. 여러분의 개발자들이 그 결과물인 패치와 함께 살아가게 된다.
셋째, 폴백 하나를 유지하고 그 발동 조건을 정의하라. 예로는 지속적인 엔드포인트 장애, 반복되는 구조화된 출력 실패, 정한 상한을 초과하는 과제 비용이 있다. 대체 구성을 미리 테스트하라. 압박 속에서 모델 ID를 바꾸면 그 제어나 응답 동작이 다를 경우 두 번째 통합 문제가 생길 수 있다.
이 가이드의 세 가지 작은 과제는 선별 연습이다. 광범위한 변경에 후보를 의존하기 전에 자체 코드베이스의 대표적인 작업으로 테스트 모음을 확장하라. 일부 과제는 프롬프트 튜닝 대상에서 제외해 두어, 개선 사항이 최적화한 예시 너머로 전이되는지 확인하라.
best ai api for coding은 여러분이 설명할 수 있는 조합이다. 필요한 작업을 완수하고, 추적할 수 있는 비용을 드러내며, 애플리케이션이 실행되는 방식에 맞는다. 그러한 결정을 내리는 데 보편적인 승자는 필요 없다.
현재 모델 카탈로그를 열고 두 후보를 선택한 뒤 정확한 ID와 설정을 저장하라. 그런 다음 두 후보에 동일한 과제, 동일한 테스트, 동일한 중단 규칙을 사용하라.
자주 묻는 질문
적은 예산으로 코딩에 가장 좋은 AI API는 무엇인가요?
예상 입력 및 출력 볼륨에 맞는 표시 요율을 가진 후보로 시작한 다음, 수용된 과제당 비용을 비교하세요. Qwen, DeepSeek, Kimi 행은 조사할 구체적인 버전을 제공하지만, 테스트된 가치 우승자를 주장하지는 않습니다. 수정 시도를 제한하고, 관련 컨텍스트를 의도적으로 재사용하고, 실패한 요청을 추적하세요. 검토 시간을 별도로 포함시켜 낮은 추론 청구서가 큰 정리 부담을 가리지 않도록 하세요.
코딩 구독이 API 토큰 결제보다 저렴한가요?
워크로드와 요금제에 무엇이 포함되는지에 따라 다릅니다. 구독은 지원되는 애플리케이션 내 대화형 사용에 적합할 수 있고, 사용량 청구는 트래픽이 변동하는 사용자 지정 서비스에 맞을 수 있습니다. 모델 접근, 상한, 동시성, 외부 API 호출 포함 여부를 확인하세요. 대표적인 기간 동안 동일한 양의 유용한 작업을 비교하세요. 월 정가와 토큰 요율은 서로 다른 것을 측정합니다.
코딩 모델과 코딩 에이전트의 차이는 무엇인가요?
모델은 응답을 생성합니다. 에이전트는 파일 접근, 도구 실행, 테스트, 중단 규칙을 포함해 그 응답 주변의 루프를 관리합니다. 사람이 검토할 함수를 제안받는 것처럼, 에이전트를 구축하지 않고도 API를 통해 코딩 모델을 호출할 수 있습니다. 자율적인 편집을 원한다면 실제로 사용할 에이전트와 권한을 함께 평가하세요.
디버깅과 리팩터링에는 어떤 AI API를 사용해야 하나요?
엔드포인트 및 코드 처리 요구 사항에 맞는 후보를 추린 다음, 실제 업무에서 나온 작은 버그와 제약된 리팩터링을 사용하세요. 과제 A는 정확성과 입력 변경을 점검하고, 과제 B는 파싱과 인터페이스 보존을 점검합니다. 그 뒤에 대표적인 저장소 테스트를 이어가세요.
가장 긴 설명이나 가장 광범위한 재작성을 만들어 내는 후보보다는, 감당 가능한 검토 노력으로 수용 조건을 충족하는 후보를 선호하세요.
코딩용 무료 AI API가 있나요?
체험 크레딧, 무료 등급이 있는 애플리케이션, 다운로드 가능한 모델 가중치는 서로 다른 제안입니다. 어느 것도 자동으로 여러분의 애플리케이션에 무제한 호스팅 추론을 제공하지 않습니다. 무료 접근을 전제로 예산을 세우기 전에 현재 자격, 만료, 할당량, 지원 모델을 확인하세요. 이 글은 현재 이용 가능한 무료 허용량을 주장하지 않습니다.
가중치를 직접 호스팅하는 경우, 가중치 다운로드가 무료라 하더라도 컴퓨팅과 운영 비용을 고려하세요.
비공개 저장소 코드를 코딩 API로 보내도 되나요?
선택한 서비스의 적용 약관에 따라 조직이 공유를 허용하는 코드만 보내세요. 선택한 배포의 보존, 학습 사용, 접근 제어, 계약 요구 사항을 검토하세요.
자격 증명과 관련 없는 파일을 제거하고, 에이전트가 프롬프트와 로그에 자동으로 포함하는 내용을 확인하세요. 오픈 가중치 모델이나 익숙한 API 형식만으로는 호스팅 서비스가 팀의 기밀성 요구 사항을 충족한다는 것이 확립되지 않습니다.


