

A 900-page project archive is easy to upload. The harder question is whether the model can point to the exact clause, commit, or data point you need. DeepSeek V4.1 Flash 1M 컨텍스트 창 활용 사례는 코드베이스, 연구 코퍼스, 수년간의 프로젝트 기록처럼 여러 관련 소스를 함께 고려해야 할 때 의미가 있습니다. 더 큰 창은 해당 자료를 미리 분할할 필요성을 줄여 주지만, 답변이 신뢰할 수 있는지는 여전히 근거 확인으로 판단합니다.
가장 적합한 사례는 파일 간 코드 리뷰, 연구 종합, 정책 비교, 피드백 분석, 프로젝트 타임라인, 긴 멀티모달 기록입니다. DeepSeek은 1M 토큰 컨텍스트를 제시하지만, 그 용량이 모든 세부 사항이 정확히 회상된다는 보장은 아닙니다. 사용하는 경로의 모델 및 API 한도를 확인한 다음, 결과에 의존하기 전에 자체 자료로 테스트하세요.
핵심 요점
- 질문이 여러 관련 소스 전반의 관계에 달려 있을 때 100만 토큰 창을 사용하세요.
- 파일, 섹션 또는 페이지 참조를 요청하고 직접 근거와 추론을 구분하세요.
- 알려진 정답 테스트로 시작하고 결과가 개선될 때만 컨텍스트를 확장하세요.
- 컨텍스트 한도만이 아니라 입력, 출력, 캐시 처리로 비용을 추정하세요.
1M 토큰 컨텍스트 창은 무엇을 의미하나요?
컨텍스트 창은 모델이 하나의 요청 또는 대화 상태에서 고려할 수 있는 정보량으로, 제공된 자료와 주변 지침을 포함합니다. DeepSeek의 현재 API 가격 페이지에는 DeepSeek-V4.1-Flash가 1M 컨텍스트 길이와 최대 384K 토큰 출력으로 표시되어 있습니다. 이는 제공자가 명시한 한도이며, 애플리케이션, 엔드포인트 또는 요청 구성이 더 작은 한도를 적용할 수 있습니다. ( DeepSeek API 문서 )
토큰은 단어나 페이지가 아니라 텍스트 조각입니다. 코드, 표, 마크업, 반복되는 상용구, 스캔본을 포함한 소스 아카이브는 같은 페이지 수의 깔끔한 산문과 토큰화 방식이 매우 다를 수 있습니다. 실제 작업량의 경우 호출할 API의 토크나이저 또는 사용량 리포트로 토큰을 추정하세요. 시스템 지침, 파일 이름, 메타데이터, 질문 텍스트, 답변 예산도 추정에 포함하세요.
실질적 이점은 연속성입니다. 요약을 수동으로 이어 붙이지 않고도 여러 모듈 간 의존성이나 현재 정책과 부속 문서 간의 모순에 대해 질문할 수 있습니다. 절충점은 매우 큰 프롬프트에 관련 없거나 중복된 자료가 포함될 수 있고, 처리 시간이 더 오래 걸리며, 정확한 검색을 여전히 더 어렵게 만들 수 있다는 것입니다. “창에 들어간다”를 용량 확인으로 취급한 다음, 모델이 작업에 필요한 사실을 찾을 수 있는지 테스트하세요.
최고의 DeepSeek V4.1 Flash 1M 컨텍스트 활용 사례
올바른 질문은 “모든 것을 업로드할 수 있나?”가 아닙니다. “이 질문에 답하려면 어떤 소스를 비교해야 하나?”입니다. 답변이 자료 간 연결에 달려 있을 때 긴 컨텍스트를 사용하고, 전체 아카이브를 보내기 전에 그 답을 어떻게 검증할지 정의하세요.
| 활용 사례 | 긴 컨텍스트가 도움이 되는 이유 | 포함할 항목 | 확인할 항목 |
|---|---|---|---|
| 대규모 코드베이스 리뷰 | 인터페이스와 규약이 여러 모듈에 걸쳐 있음 | 관련 소스, 테스트, 아키텍처 노트 | 파일 경로, 심볼, 테스트 근거 |
| 연구 종합 | 방법과 결과를 나란히 비교해야 함 | 논문, 보고서, 한계 | 각 주장의 출처와 유의사항 |
| 계약 또는 정책 비교 | 정의와 예외가 여러 섹션에 반복됨 | 현재 및 이전 버전, 부속 문서 | 조항 번호와 정확한 문구 |
| 피드백 분석 | 여러 댓글에 주제가 나타남 | 비식별화된 피드백과 코딩 규칙 | 대표 인용문과 집계 방법 |
| 프로젝트 이력 타임라인 | 회의 기록 전반에 걸쳐 결정이 진화함 | 회의록, 결정 로그, 릴리스 노트 | 날짜, 담당자, 상충하는 기록 |
| 긴 인시던트 리뷰 | 로그, 티켓, 포스트모템이 서로 다른 단계를 설명함 | 관련 시간 범위와 인시던트 문서 | 타임스탬프, 이벤트 출처, 불확실성 |
| 멀티모달 문서 리뷰 | 텍스트와 시각적 근거를 함께 읽어야 할 수 있음 | 지원되는 이미지와 해당 캡션 또는 컨텍스트 | 엔드포인트가 해당 미디어 유형을 지원하는지 여부 |
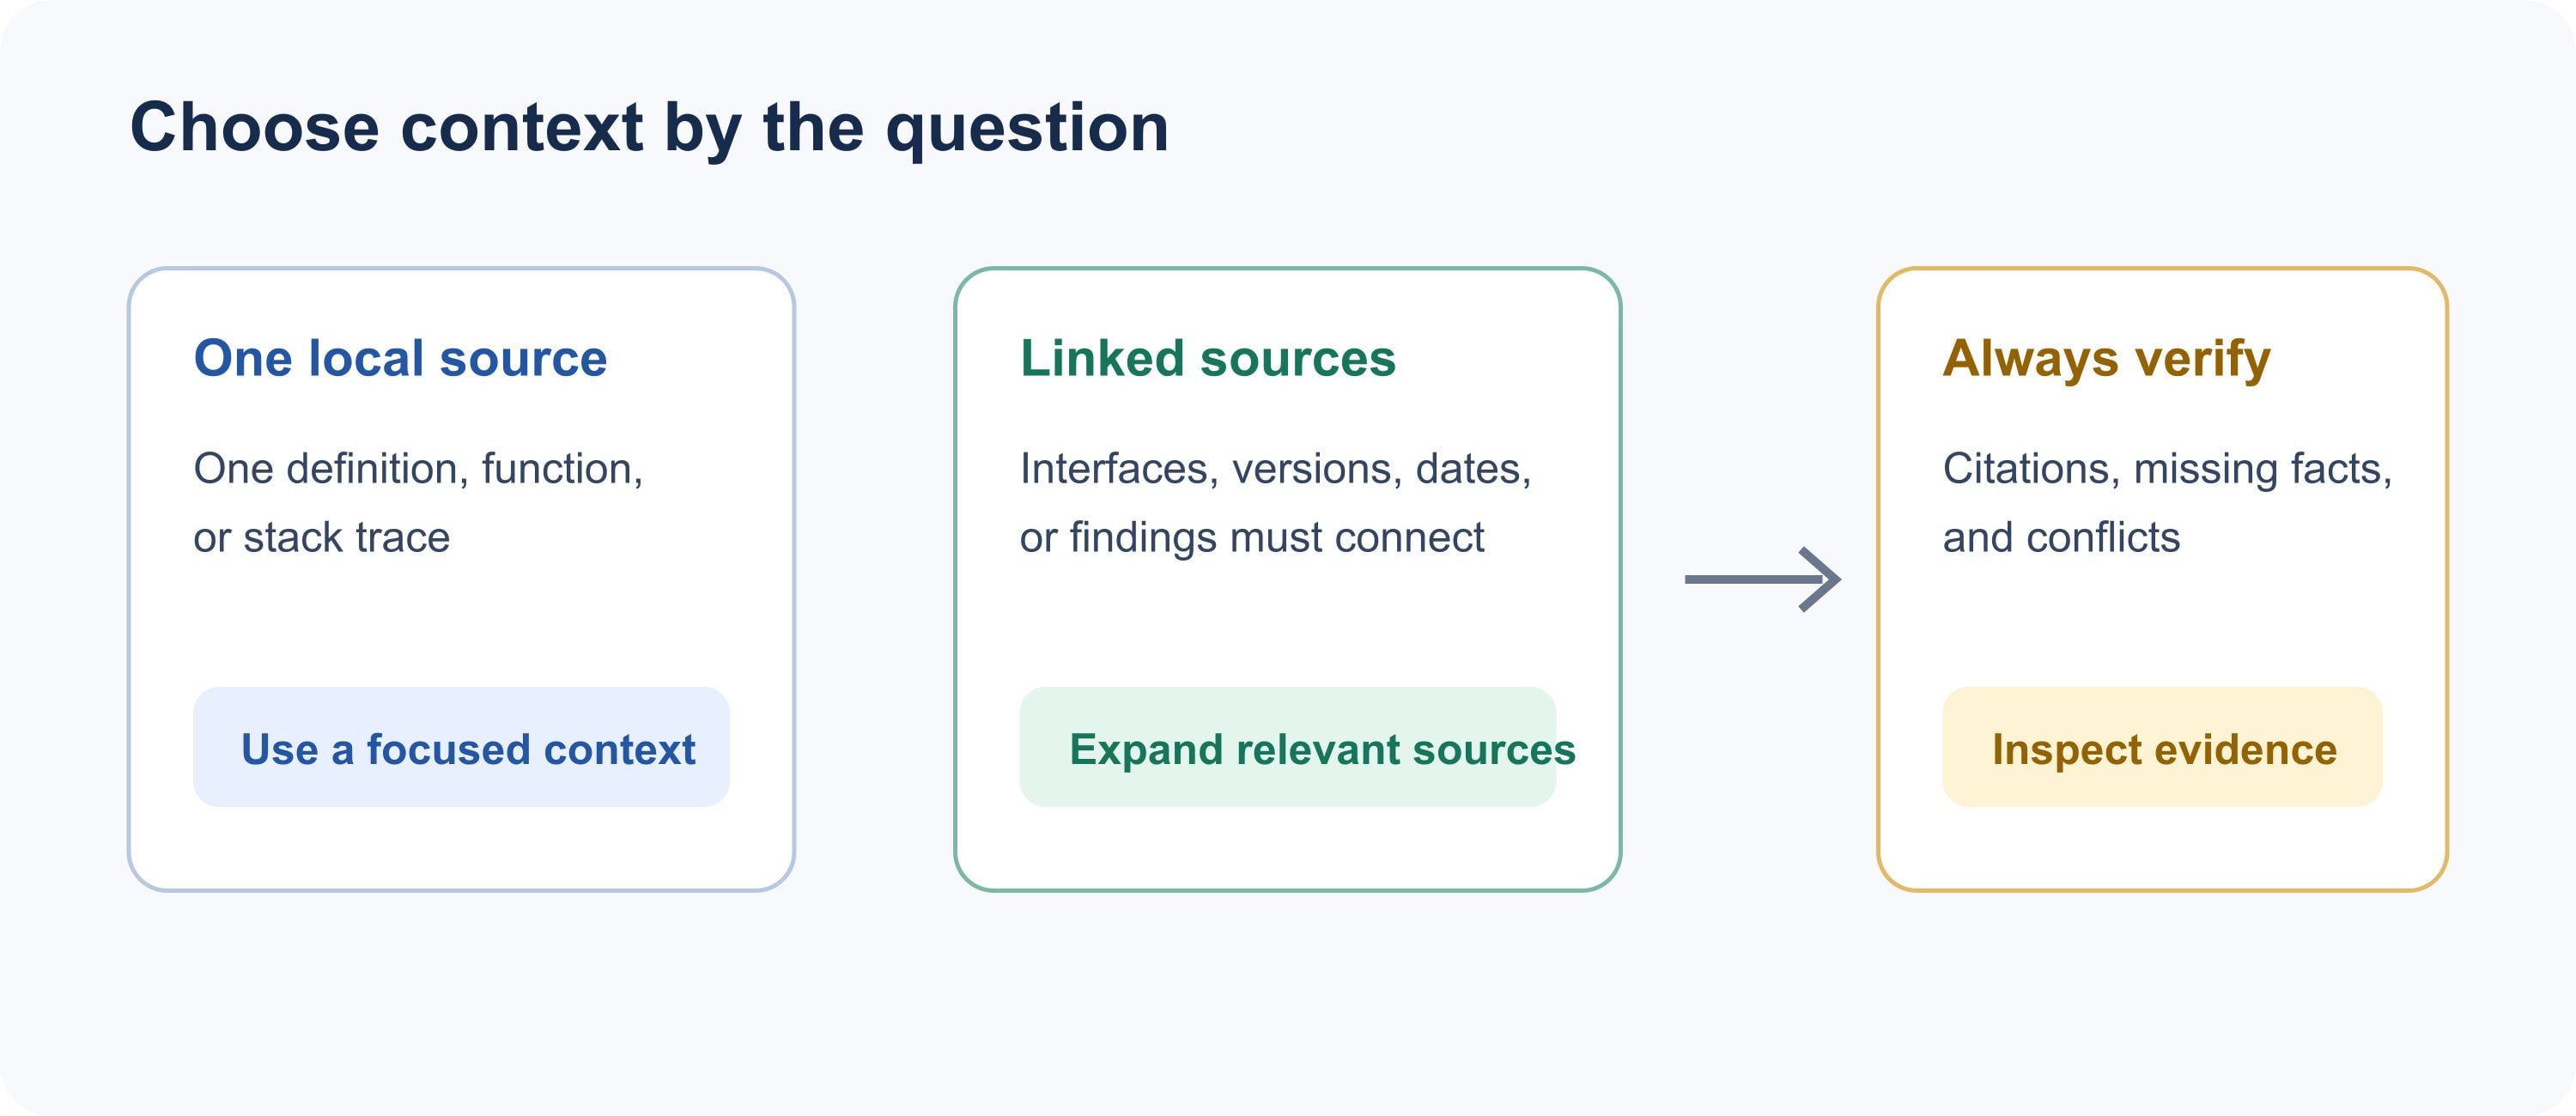
국소적 질문에는 집중된 컨텍스트를 사용하고, 소스를 연결해야 할 때 확장한 다음 근거를 검토하세요.
파일 전반에 걸쳐 대규모 코드베이스 리뷰하기
100만 토큰 컨텍스트는 엔지니어가 API 경계에서 서비스 로직, 스토리지, 테스트를 거쳐 데이터 구조를 추적하는 데 도움이 될 수 있습니다. 아키텍처 요약, 영향을 받을 가능성이 있는 모듈 찾기, 여러 곳에 문서화된 규약을 존중하는 리팩터링 계획 초안 작성에 유용합니다.
모델에는 필터링되지 않은 디스크 덤프가 아니라 범위가 정해진 리포지토리 스냅샷을 제공하세요. 변경과 관련된 소스 파일, 가장 가까운 테스트, 의존성 매니페스트, 아키텍처 노트를 포함하세요. 질문이 그것들과 관련된 경우가 아니라면 빌드 출력물, 벤더링된 의존성, 생성된 번들, 중복 사본은 제외하세요. 제안된 모든 의존성에 대해 파일 경로와 심볼 이름을 요청하고, 관찰된 동작과 가정을 구분하도록 하세요.
출력을 리뷰 계획으로 사용하세요. 인용된 각 심볼이 존재하는지 확인하고, 인용된 줄을 검사하고, 프로젝트의 검사를 직접 실행하세요. 도구가 실제로 테스트를 실행하고 결과를 반환하지 않은 한 모델이 테스트가 통과했다고 주장해서는 안 됩니다. 한 함수의 국소 버그라면 더 작은 컨텍스트가 종종 더 빠르고 감사하기 쉽습니다.
논문과 보고서 전반의 연구 종합하기
긴 컨텍스트는 연구가 서로 다른 방법, 모집단, 측정치, 정의를 사용할 때 도움이 됩니다. 출처별로 한 행을 두고 연구 질문, 데이터, 방법, 결과, 한계, 질문과의 관련성 열을 포함한 비교 표를 요청하세요. 혼합된 요약이 불일치를 지우도록 두지 말고, 출처 수준의 주장을 해당 출처에 연결해 두세요.
예를 들어, 한 도구의 평가를 비교할 때 벤치마크 결과와 현장 연구, 저자의 해석을 구분하세요. 비교할 수 없는 결과의 순위를 매기지 말고 호환되지 않는 측정치를 표시하도록 모델에 요청하세요. 그런 다음 가장 의사결정에 중요한 주장 뒤의 원문 구절을 펼쳐 보세요. 종합은 근거의 지도이지, 논문을 확인하는 일을 대체하지 않습니다.
긴 계약, 정책 또는 사양 비교하기
계약과 정책은 종종 용어를 한 번 정의하고 다른 곳에서 그 정의를 한정합니다. 유효 버전, 개정, 별표, 관련 이전 초안을 함께 제공하면 변경된 정의, 상호 참조, 누락된 조건, 명백한 충돌을 드러내는 데 도움이 될 수 있습니다.
각 관찰에 대해 정확한 섹션 또는 조항과 리뷰어가 찾을 수 있는 짧은 발췌를 요청하세요. 텍스트상 차이와 그로 인한 가능한 결과를 구분하세요. 모델은 리뷰를 정리하는 데 도움이 될 수 있지만, 법률 해석, 컴플라이언스 결정, 서명 권한은 관할권과 맥락을 고려할 수 있는 자격을 갖춘 사람에게 남아 있습니다.
대규모 고객 피드백 분석하기
대량의 피드백은 채널이나 기간 전반에 반복되는 요청과 반대 의견을 드러낼 수 있습니다. 정의된 샘플을 제공하고, 필요하지 않은 개인 정보를 제거하고, “온보딩 마찰,” “누락된 통합,” “가격 혼란”과 같은 코딩 체계를 지정하세요. 주제 목록만이 아니라 대표적인 예와 반례를 요청하세요.
모델이 생성한 주제 백분율을 설문 통계로 제시하지 마세요. 집계가 필요하면 단위(메시지, 고객, 이슈)를 정의하고, 기록을 중복 제거하고, 일관된 라벨링 규칙을 적용하고, 반복 가능한 스크립트나 사람이 검토한 샘플로 집계를 확인하세요. 모델은 범주를 제안하고 예를 찾는 데 유용하며, 문서화된 방법이 정량적 주장을 뒷받침합니다.
프로젝트 문서에서 타임라인 구축하기
인수인계나 포스트모템의 경우 관련 근거가 회의록, 릴리스 노트, 결정 로그, 티켓에 흩어져 있을 수 있습니다. 날짜, 이벤트, 명시된 경우 담당자 이름, 출처 위치, 신뢰도 또는 모호성을 포함한 연대순 표를 요청하세요. 모델에게 상충하는 날짜를 조용히 하나 고르지 말고 그대로 보존하도록 지시하세요.
유용한 타임라인은 새 팀원이 무엇이 결정되었고, 요구 사항이 언제 바뀌었으며, 각 이벤트를 어떤 문서가 뒷받침하는지 파악하는 데 도움이 됩니다. 중요한 전환은 원본 기록과 대조해 확인하세요. 특히 노트가 나중에 작성되었거나 회의를 직접 기록한 것이 아니라 요약한 경우 더욱 그렇습니다.
긴 인시던트 기록과 멀티모달 자료 검토하기
인시던트 리뷰는 경보, 운영 노트, 티켓, 포스트모템을 하나의 근거 세트에 유지하는 데서 이점을 얻을 수 있습니다. 관찰된 이벤트의 순서를 요청하고 로그의 타임스탬프와 서술형 노트의 나중 추정치를 명확히 구분하세요. 이렇게 하면 1차 검토가 더 일관될 수 있지만, 온콜 엔지니어는 조치를 취하기 전에 여전히 소스 시스템을 확인해야 합니다.
DeepSeek의 공식 발표에 따르면 V4.1-Flash는 네이티브 멀티모달 지원과 함께 자사 API에서 제공됩니다. 정확한 이미지 형식, 요청 방식, 한도는 엔드포인트와 통합 방식에 따라 다르므로, 100만 토큰 텍스트 예산이 이미지 처리까지 설명한다고 가정하기 전에 해당 세부 정보를 확인하세요. ( DeepSeek V4.1-Flash 발표 )
100만 토큰은 언제 도움이 되고, 언제 노이즈를 더하나요?
소스를 상호 참조해야 할 때 더 많은 컨텍스트가 도움이 됩니다. 공유 인터페이스를 포함하는 코드 변경에는 여러 모듈과 테스트가 필요할 수 있습니다. 버전 비교에는 두 전체 버전과 그 부속 문서가 모두 필요합니다. 프로젝트 타임라인에는 여러 달에 걸쳐 흩어진 기록이 필요할 수 있습니다.
명확한 스택 트레이스가 있는 국소 버그에는 함수, 그 호출자, 관련 테스트만 필요할 수 있습니다. 하나의 정의를 묻는 질문에는 권위 있는 섹션만 필요할 수 있습니다. 그러한 작업에 전체 리포지토리를 포함하면 검색 공간이 늘어나고 유용한 구절이 묻힐 수 있습니다.
프롬프트를 확장하기 전에 반복되는 내보내기, 오래된 초안, 관련 없는 폴더, 상용구, 질문의 시간 범위 밖 기록을 제거하세요. 무엇을 왜 포함했는지 매니페스트를 유지하세요. 관련 없는 파일을 대량으로 추가했을 때 답변이 달라지면, 소스 세트를 더 엄격하게 좁히고 테스트를 다시 실행하라는 신호입니다.
신뢰할 수 있는 긴 컨텍스트 답변을 위한 실용적인 워크플로
유창한 답변이 검증된 답변으로 오인되지 않도록 일관된 근거 프로토콜을 사용하세요. 먼저 소스에 안정적인 파일 이름을 라벨로 붙이고, 가능하면 페이지 번호, 제목, 줄 번호, 날짜 또는 버전 식별자를 붙이세요. 발췌를 올바르게 해석할 수 있을 만큼 주변 컨텍스트를 보존하세요.
다음으로 하나의 결정 또는 연구 질문을 명시하세요. 출력 형태와 모델이 인용해야 하는 위치를 지정하세요. 재사용 가능한 프롬프트는 다음과 같습니다:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
코드베이스의 경우 다음을 추가하세요: “리포지토리 경로와 함수 또는 클래스 이름을 인용하세요. 변경을 제안하기 전에 영향을 받는 파일과 제안을 뒷받침하는 테스트 근거를 나열하세요. 제공된 근거에 결과가 포함되어 있지 않다면 테스트가 실행되었다고 말하지 마세요.”
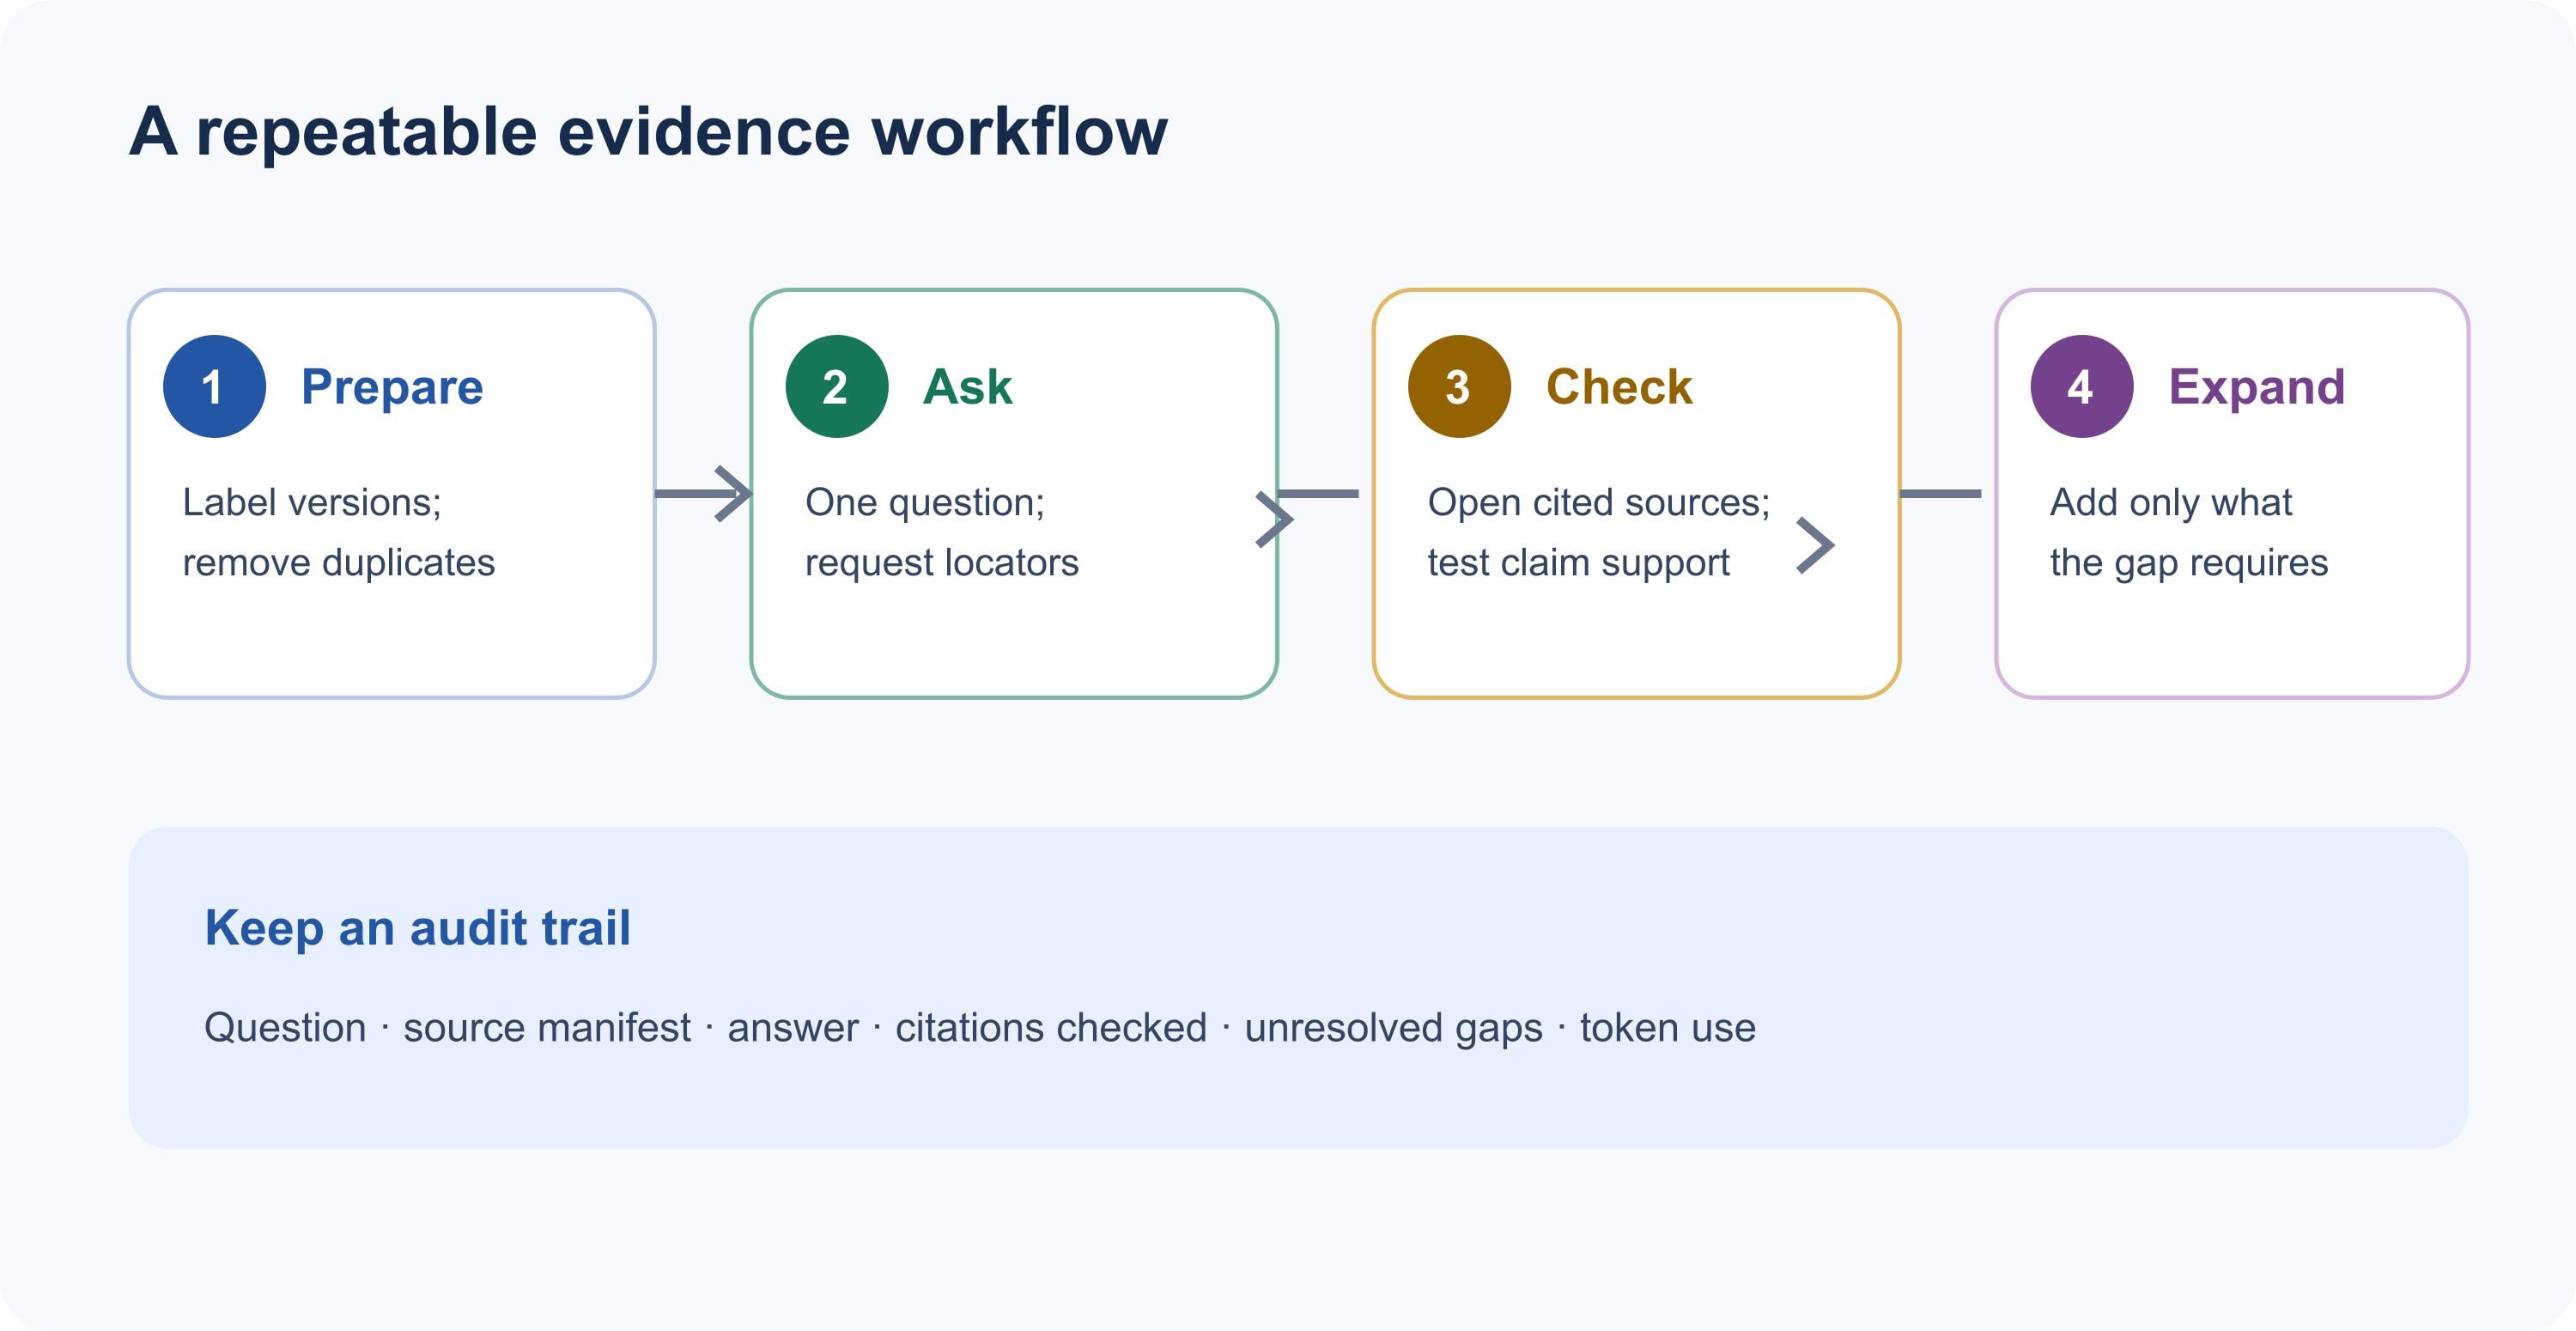
소스를 준비하고, 범위가 정해진 질문을 하고, 인용을 확인하고, 공백을 해결하기 위해서만 확장하세요.
그런 다음 세 단계로 답변을 검토하세요. 각 인용이 실제 위치를 가리키는지 확인하세요. 인용된 구절이 주제를 언급하는 데 그치지 않고 주장을 뒷받침하는지 확인하세요. 마지막으로 동일한 소스 세트에 대해 표적화된 후속 질문을 하여 누락과 충돌을 검토하세요. 중대한 결정의 경우 자격을 갖춘 리뷰어가 원본 자료를 직접 읽도록 하세요.
긴 컨텍스트 워크플로 근거 맵
| 단계 | 작업 | 유지할 것 | 중단 신호 |
|---|---|---|---|
| 1. 준비 | 소스에 라벨을 붙이고 중복 제거 및 범위 설정 | 소스 매니페스트와 버전 | 출처 불명 또는 오래된 중복 |
| 2. 질문 | 하나의 질문과 근거 형식 설정 | 답변의 파일 이름과 위치 표시자 | 의사결정 목표 없는 광범위한 요청 |
| 3. 확인 | 인용된 구절을 열고 주장 비교 | 뒷받침된 주장과 명시적 공백 | 인용이 주장을 뒷받침하지 않음 |
| 4. 확장 | 해결되지 않은 연결에 필요한 소스만 추가 | 알려진 정답 검사에서 개선 | 더 나은 근거 없이 입력만 증가 |
1M 컨텍스트가 작업에 유용한지 테스트하는 방법
전체 아카이브를 로드하기 전에 작은 평가 세트를 만드세요. 소스 자료에서 답을 이미 알고 있는 질문을 작성하세요. 일부 사실은 시작 부분에, 일부는 중간에, 일부는 끝 부분에 배치하세요. 두 문서를 연결해야 하는 질문을 최소 하나, 제공된 소스로 답할 수 없는 질문을 하나 추가하세요.
먼저 더 작은 관련 하위 집합에서 동일한 질문을 실행한 다음, 측정된 단계로 컨텍스트를 늘리세요. 사실 정확성, 위치 표시자 정확도, 놓친 근거, 뒷받침되지 않는 주장, 답할 수 없는 질문에 대한 거부, 지연 시간, 토큰 사용량을 기록하세요. 변경 사항을 해석할 수 있도록 프롬프트와 디코딩 설정을 안정적으로 유지하세요. 실행 간 출력이 크게 달라지면 질문을 반복하세요.
| 점검 항목 | 통과 응답이 보여주는 것 | 실패 후 할 일 |
|---|---|---|
| 초기, 중간, 후반 위치의 알려진 사실 | 소스 범위 전반의 검색 | 인덱싱, 파일 라벨, 프롬프트 길이 확인 |
| 문서 간 연결 | 소스 전반에서 근거를 결합할 수 있음 | 두 인용을 모두 요청한 다음 연결 질문을 좁히세요 |
| 답할 수 없는 질문 | 모델이 누락된 근거를 보고할 수 있음 | “제공된 소스만 사용”을 더 엄격히 하고 재테스트 |
| 인용 감사 | 위치 표시자와 발췌가 주장을 뒷받침함 | 수정될 때까지 해당 주장을 미검증으로 취급 |
| 더 큰 컨텍스트 비교 | 추가 자료가 목표 작업을 개선함 | 정확도나 지연 시간이 나빠지면 노이즈 제거 |
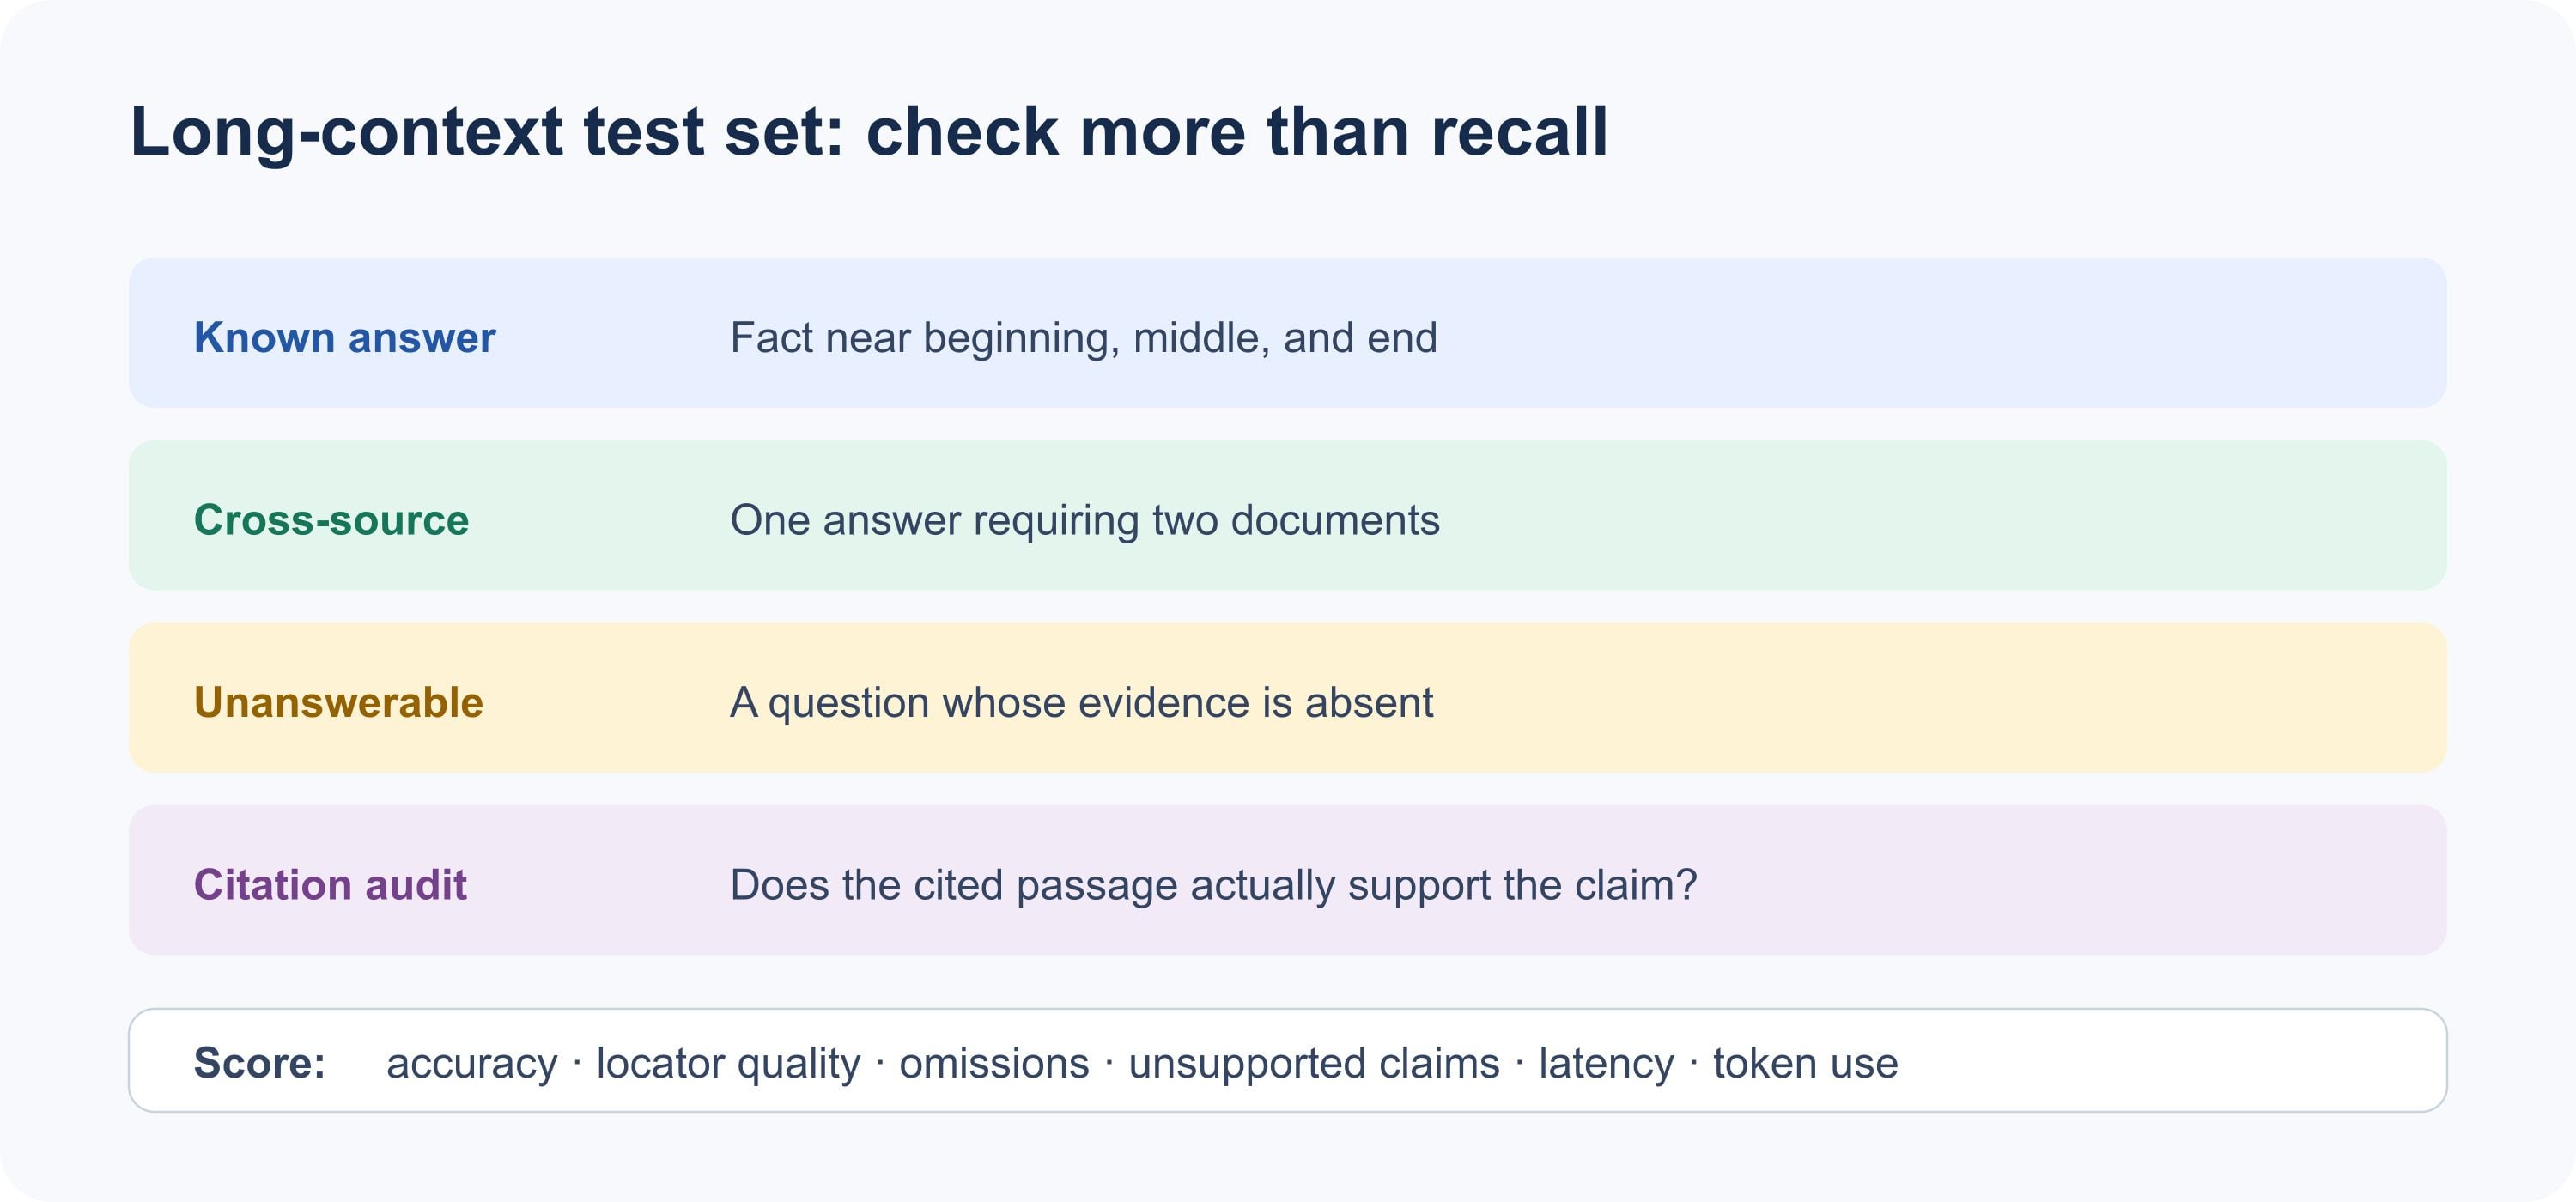
검색, 인용 지원, 누락, 뒷받침되지 않는 주장, 지연 시간, 토큰 사용을 점수화하세요.
커뮤니티 보고는 엇갈리고 작업에 따라 다릅니다. 한 Reddit 사용자는 더 큰 컨텍스트 크기에서 특정 하네스에서 잘못된 형식의 도구 인수가 증가했다고 공유했으며, 댓글 작성자들은 다른 설정에서 더 높은 토큰 수로 성공적인 작업을 설명했습니다. 이는 자체 하네스를 벤치마크할 유용한 이유이지, 보편적인 실패 임계값에 대한 근거가 아닙니다. ( Reddit의 DeepSeek 컨텍스트 논의 )
합리적인 확장은 다음과 같습니다: 작은 샘플에서 프롬프트를 검증하고, 문서 간 질문에 필요한 소스 그룹을 추가한 다음, 대표적인 대규모 요청을 테스트하세요. 신뢰할 수 있는 근거로 실제 질문에 답하는 가장 작은 컨텍스트를 유지하세요. 또한 지연 시간과 비용 비교를 해석하기 더 쉽게 만듭니다.
DeepSeek V4.1 Flash API 가격 및 액세스
Atlas Cloud의 모델 목록에는 현재 DeepSeek V4.1 Flash가 1M 컨텍스트와 100만 입력 토큰당 $0.30, 100만 출력 토큰당 $1.20, 100만 캐시 읽기 토큰당 $0.03의 요금으로 표시됩니다. 이 모델에 대한 할인은 표시되어 있지 않습니다. 이는 DeepSeek 자체의 시간대별 피크 및 비피크 가격과는 다른 Atlas Cloud 요금입니다. 요금이 변경될 수 있으므로 게시하거나 예산을 책정하기 전에 Atlas Cloud 모델 카탈로그와 모델 가격 페이지를 다시 확인하세요.
명시된 요금에서 캐시되지 않은 입력 토큰 100,000개와 출력 토큰 2,000개가 있는 요청은 입력에 약 $0.03, 출력에 $0.0024로, 기타 적용 가능한 요금 전 총 $0.0324입니다. 입력이 캐시 읽기로 청구되면 100,000 캐시 토큰은 대신 $0.003입니다. 이 예시는 해당 토큰 수와 요금을 가정한 것이며, 특정 워크로드에 대한 견적이 아닙니다. 전체 1M 용량이 존재한다는 이유만으로 청구되지 않습니다. 청구는 사용량과 캐시 처리를 따릅니다.
하나의 API 진입점을 원하는 팀을 위해 DeepSeek V4.1 Flash 모델 페이지에서 모델과 호출 세부 정보를 제공합니다. 측정된 토큰 사용량과 통합 요구 사항을 공식 엔드포인트와도 비교하세요. 모델 이름, 한도, 가격은 제공자마다 다를 수 있습니다.
자주 묻는 질문
1M 토큰 컨텍스트 창은 1M 단어와 같은가요?
아니요. 토큰은 단어의 일부, 구두점, 코드 조각 또는 기타 단위일 수 있습니다. 들어가는 단어나 페이지 수는 자료와 그 토큰화 방식에 따라 다릅니다. 고정된 페이지 환산보다 측정된 토큰 수를 사용하세요.
DeepSeek V4.1 Flash는 항상 전체 컨텍스트 창을 사용하나요?
아니요. 100만 토큰은 최대 컨텍스트 사양이지, 모든 요청의 목표가 아닙니다. 짧은 프롬프트는 더 적게 사용하며, 특정 인터페이스나 API 경로가 더 낮은 상한을 적용할 수 있습니다. 엔드포인트 문서와 실제 사용량 필드를 확인하세요.
1M 컨텍스트는 전체 코드베이스에 충분한가요?
토큰 수 기준으로 일부 코드베이스에 들어갈 수 있지만, 그렇다고 모든 파일이 관련 있거나 모든 답변이 신뢰할 수 있게 되는 것은 아닙니다. 질문에 필요한 파일을 포함하고, 인용된 경로와 심볼을 확인하고, 프로젝트의 실제 검사로 변경 사항을 테스트하세요.
사용 가능한 모든 문서를 하나의 프롬프트에 넣어야 하나요?
문서들이 같은 질문과 관련된 경우에만 그렇게 하세요. 소스 매니페스트에서 시작해 중복과 관련 없는 자료를 제거한 다음, 문서 간 테스트에 필요할 때 더 추가하세요. 최고의 DeepSeek V4.1 Flash 1M 컨텍스트 창 활용 사례는 아카이브의 크기가 아니라 비교해야 하는 근거에 의해 정의됩니다.





