백만 토큰 컨텍스트 창은 모델이 받아들일 수 있는 텍스트 양을 알려줄 뿐, 모든 조항을 얼마나 안정적으로 해석하는지는 알려주지 않습니다. DeepSeek V4.1 Flash 장문 문서 분석 정확도에 관해 공개된 증거는 유용하지만 불완전합니다. DeepSeek의 모델 카드는 1-shot 설정에서 V4.1 Flash 기본 모델의 LongBench-V2 정확 일치(exact match) 45.2를 보고하지만, API는 그 이후 더 새로운 1017 빌드로 이동했습니다. 그 벤치마크는 하나의 평가 설정에 관한 신호일 뿐, 귀하의 계약서, 연차 보고서, 연구 아카이브에 대한 통과율이 아닙니다.
실용적인 답은 빠른 검색과 1차 종합에는 Flash를 사용하고, 중요한 결정에는 페이지 수준의 근거와 사람의 검토를 요구하는 것입니다. 여기서 인용한 어떤 공개 자료도 아래 다섯 가지 문서 작업 전반에 걸친 재현 가능한 최신 빌드 평가를 제공하지 않습니다. 테스트 계획은 바로 실행할 수 있는 프로토콜이며, 그 실행이 이미 이루어졌다는 주장이 아닙니다.
핵심 요점
- 이 모델 제품군은 최대 1M 토큰을 지원하지만, 컨텍스트 한도가 정확도 보장은 아닙니다.
- 공개된 LongBench-V2 45.2 점수는 기본 모델 및 1-shot 벤치마크 설정에 대한 것입니다.
- DeepSeek API는 이제 V4.1-Flash-1017을 제공하며, 릴리스 노트에는 새로운 장문 문서 점수가 게시되어 있지 않습니다.
- 근거 위치를 요청하고, 원문과 대조해 확인하고, 자체 문서에서 오류를 측정하세요.
1M 토큰 창이 문서 분석에 의미하는 것
DeepSeek의 모델 카드는 V4.1 Flash가 최대 100만 토큰의 컨텍스트를 지원한다고 설명합니다. API 문서는 현재 제공되는 모델을 DeepSeek-V4.1-Flash-1017로 식별하고 1M 컨텍스트 길이를 명시합니다. 이는 용량 사양입니다. 모델이 각주를 얼마나 자주 찾아내는지, 두 문서 버전을 분리해 유지하는지, 또는 요청한 사실이 없음을 인정하는지는 입증하지 않습니다. (DeepSeek 모델 카드)
토큰은 페이지가 아닙니다. 페이지 수는 표, 각주, 레이아웃, 언어, 추출 품질에 따라 달라집니다. 스캔한 PDF는 OCR이 필요할 수 있고, 표는 텍스트로 변환될 때 행 레이블을 잃을 수 있으며, 머리글과 반복되는 페이지 요소는 질문에 도움이 되지 않으면서 컨텍스트를 소비할 수 있습니다. 프롬프트와 요청된 답변도 토큰을 사용합니다. 따라서 명목상 100만 토큰 상한이 모든 100만 토큰 파일이 모든 채팅 인터페이스나 API 클라이언트를 통해 온전히 도착한다는 뜻은 아닙니다.
테스트 전에 정확한 모델 식별자, 클라이언트, 입력 방식을 기록하세요. 추출된 전체 텍스트가 전송되었는지, 제공자가 이를 잘랐는지, 요청이 예상한 모델 버전에 도달했는지 확인하세요. 현재 DeepSeek API는 최신 Flash 빌드에 deepseek-flash를 사용합니다. 게이트웨이나 SDK가 다른 별칭을 사용한다면 그 별칭을 기록하고 라우팅을 검증하세요. 반복 가능한 호스팅 호출을 설정하는 팀은 Atlas Cloud의 모델 플랫폼에서 시작한 다음, DeepSeek V4.1 Flash API 목록을 열 수 있습니다.
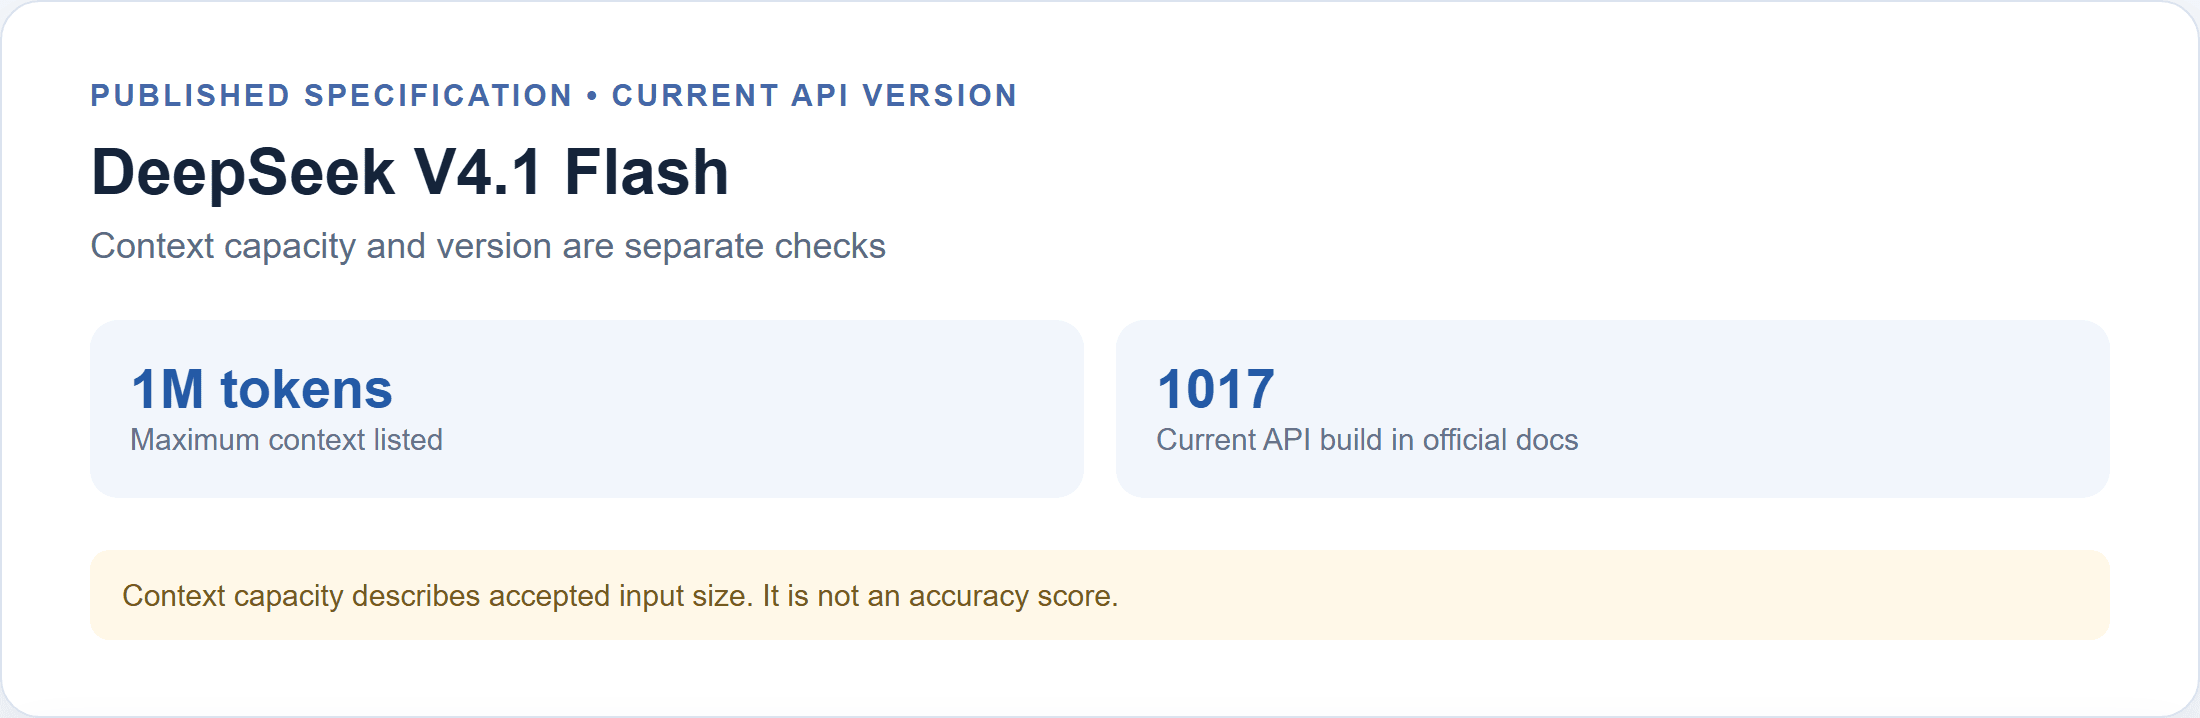
공개된 사양은 최대 1M 컨텍스트를 제시하며, 현재 API 문서는 1017 빌드를 식별합니다.
업로드나 요청이 성공했다는 것은 시스템이 입력을 받아들였다는 것만 보여줍니다. 관련 세부 정보가 답변에 영향을 주었음을 입증하려면 정확한 위치를 요청하고, 해당 구절을 검색한 뒤, 주변 텍스트가 그 주장을 뒷받침하는지 확인하세요.
LongBench-V2 점수가 보여주는 것과 보여주지 않는 것
모델 카드의 LongBench-V2 행은 1-shot 설정에서의 정확 일치 점수를 보고합니다. 표는 결과를 기본 모델 평가로 표시하며, 모든 기본 모델이 동일한 내부 평가 프레임워크를 사용한다고 밝힙니다. 또한 0.3 이내의 점수는 동등한 것으로 간주한다고 명시합니다. 값은 다음과 같습니다:
| 모델 카드의 기본 모델 | LongBench-V2 (EM) | 샷 |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
V4-Flash-Base와 V4.1-Flash-Base 사이의 0.5점 차이는 카드에 명시된 0.3 동등성 범위보다 크지만, 여전히 좁은 벤치마크 비교입니다. 45.2는 '긴 PDF에서 45.2% 정확도'가 아닙니다. 이는 특정 기본 모델, 벤치마크 세트, 프롬프트 설정, 평가자에 대한 정확 일치 점수입니다. 다른 프롬프트로 귀하의 질문에 답하는 호스팅 instruct/API 모델을 직접 점수화한 것이 아닙니다.
LongBench-V2는 단일 문서 및 다중 문서 질의응답, 긴 대화, 코드 저장소, 구조화 데이터를 포함한 여섯 범주에 걸쳐 503개의 객관식 질문을 담고 있습니다. 컨텍스트는 8,000단어에서 200만 단어에 이릅니다. 벤치마크 저자들은 15분 제한에서 전문가의 평균 정확도 53.7%, 보고된 평가에서 최고 직접 답변 모델의 50.1%를 보고합니다. 그 폭넓음은 유용한 스트레스 테스트가 되지만, 집계 숫자만으로는 어떤 문서 작업이 강하거나 약한지 진단할 수 없습니다. (LongBench-V2 논문)
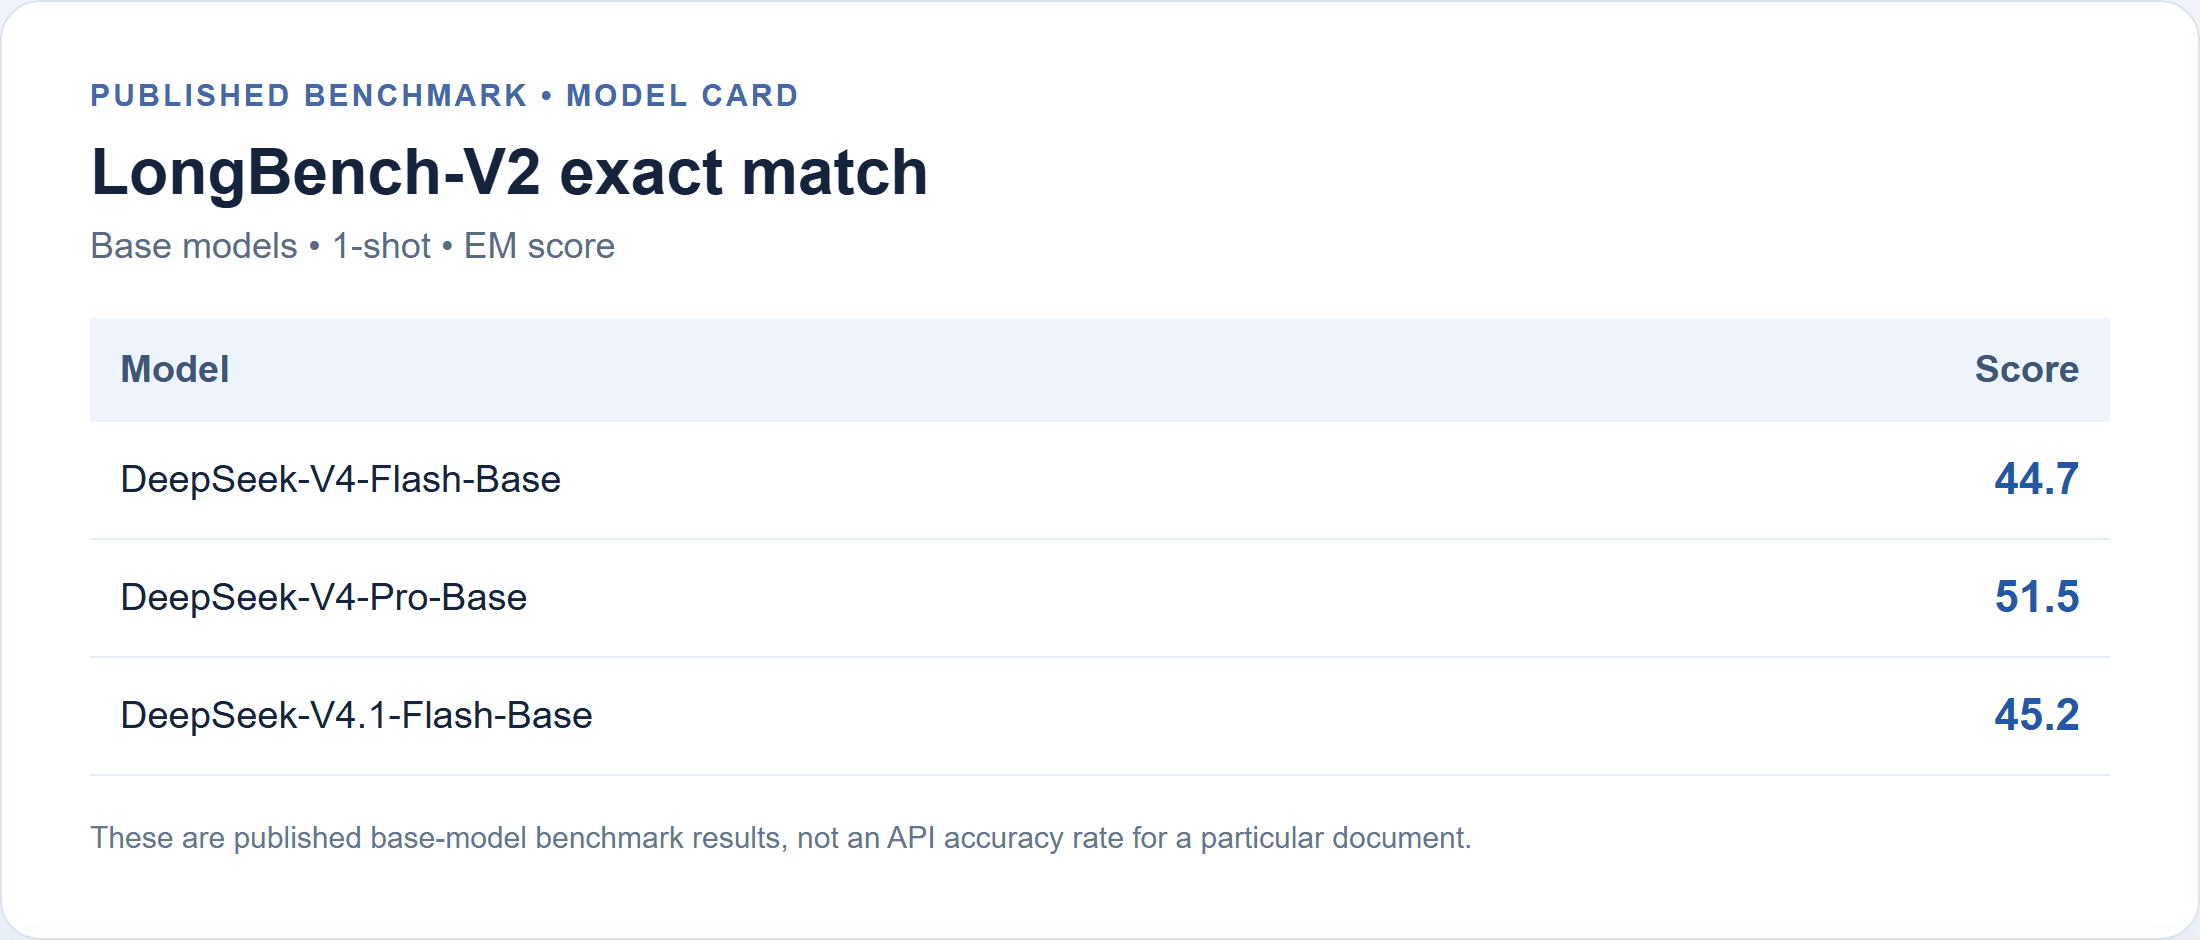
공개된 행은 기본 모델의 1-shot 결과입니다. 측정된 API 통과율이 아닙니다.
버전 관련 주의 사항이 있습니다. DeepSeek의 10월 17일 릴리스 노트에 따르면 API와 웹 앱이 V4.1-Flash-1017로 업그레이드되었고, API 모델 이름은 deepseek-flash로 유지됩니다. 노트에는 업데이트된 에이전트 및 추론 벤치마크가 나열되어 있지만, 새로운 LongBench-V2 결과는 보고하지 않습니다. 따라서 45.2는 V4.1 Flash 기본 모델에 대한 유용한 공개 참조로 남아 있지만, 장문 문서 질문에 대한 현재 API 빌드의 정확도는 해당 자료에서 정량화되지 않은 상태입니다. 관련 없는 벤치마크 향상을 문서 QA로 옮겨 적용하지 마세요. (DeepSeek V4.1-Flash-1017 업데이트)
공정한 장문 문서 정확도 테스트를 실행하는 방법
유용한 평가에는 고정된 출처, 정답 키, 채점 규칙이 필요합니다. 버전과 페이지 구조를 공유할 수 있는 공개 연차 보고서나 기술 보고서로 시작하세요. PDF와 추출된 텍스트를 저장하고, 출처 URL과 검색 날짜를 기록하며, 기본 텍스트 추출을 사용했는지 OCR을 사용했는지 메모하세요. 모델이 이미 잘 처리한다고 알고 있는 문서를 선택하는 것은 피하세요.
모델에 프롬프트를 넣기 전에 출처에서 정답 키를 직접 작성하세요. 각 질문에 대해 예상 답변과 정확한 페이지 또는 섹션을 기록하세요. 이렇게 하면 설득력 있는 응답이 채점 기준이 되는 것을 방지할 수 있습니다. 채점할 수 있을 만큼 구체적인 질문을 유지하되, 독자가 실제로 마주할 모호성은 보존하세요.
각 실행에 동일한 문서, 질문 세트, 모델 식별자, 프롬프트, 추론 설정, 출력 형식을 사용하세요. API가 temperature 또는 추론 제어를 노출한다면 기록하세요. 변동성을 추정하려면 세트를 두 번 이상 실행하세요. 한 번의 실행은 표본일 뿐 안정적인 비율이 아닙니다. 채점 전에 출력을 몰래 수정하지 마세요.
간결한 세트로 다섯 가지 서로 다른 실패 가능성을 다룰 수 있습니다:
| 작업 | 예시 질문 형태 | 확인할 것 |
|---|---|---|
| 단일 지점 조회 | “보고서는 개정된 정책에 대해 어떤 날짜를 제시하는가?” | 정확한 값과 인용된 페이지 |
| 섹션 간 연결 | “2장의 리스크는 7장의 통제와 어떻게 관련되는가?” | 두 구절 모두와 연결이 명시되었는지 추론되었는지 |
| 예외 처리 | “명시된 보장에서 누가 제외되는가?” | 각주, 범위, 한정어 |
| 버전 충돌 | “개정 후 어떤 값이 적용되며, 그것이 무엇을 대체했는가?” | 날짜, 버전 레이블, 두 위치 |
| 정보 누락 | “보고서는 공급업체 사본에 대해 어떤 보존 기간을 명시하는가?” | 문서가 아무 말도 하지 않을 경우 이를 인정하는지 |
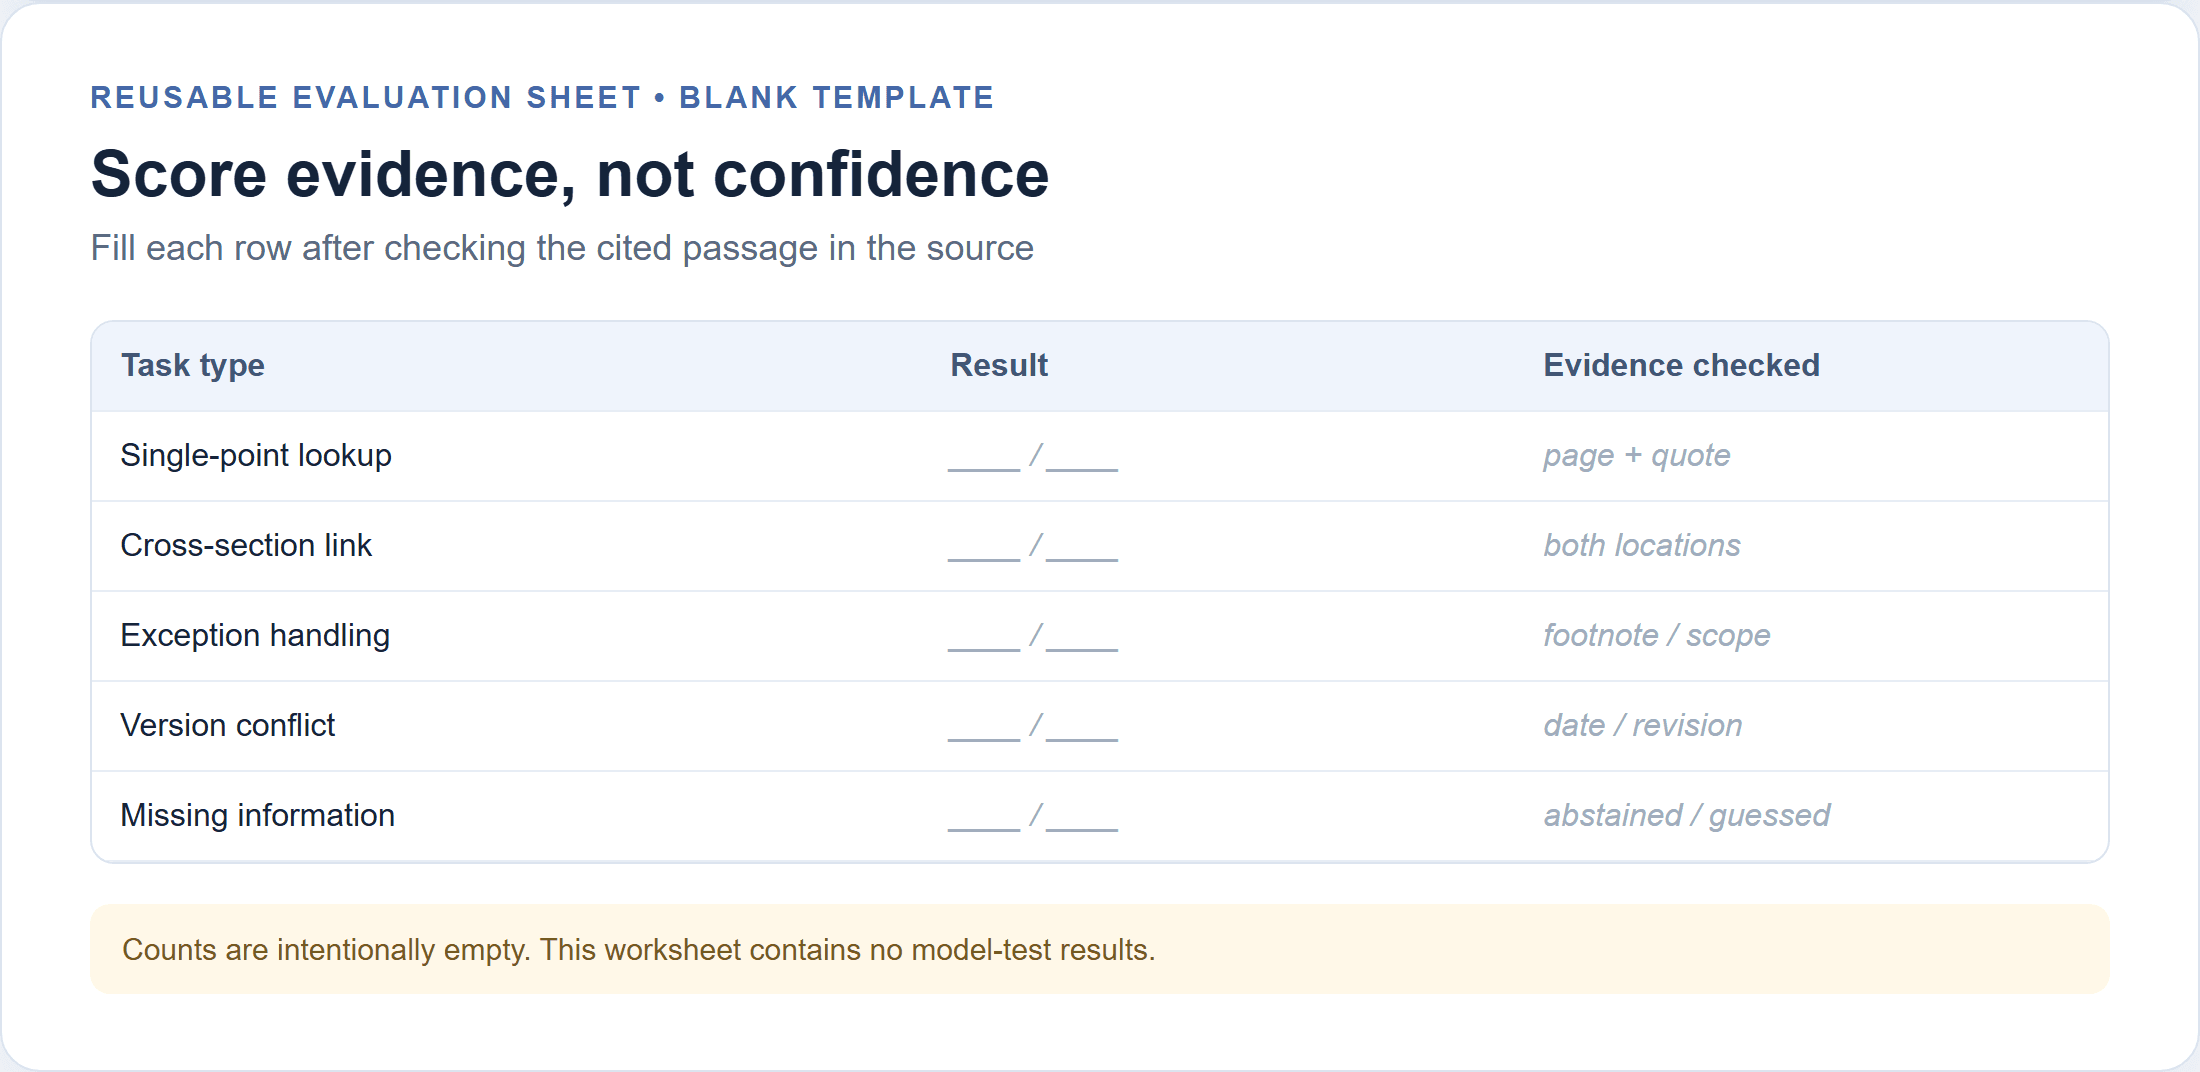
이것은 빈 채점 워크시트이며 결과 표가 아닙니다. 각 답변을 원본 문서와 대조해 확인한 뒤에만 채우세요.
각 답변을 정답, 부분 정답, 오답, 근거 없음, 올바르게 보류함으로 채점하세요. 근거 없는 주장은 오답과 별도로 세세요. 응답이 핵심 답변은 맞히고 세부 사항을 지어낼 수 있기 때문입니다. 각 인용이 그 주장을 뒷받침하는 구절을 가리키는지 확인하세요. 질문 수와 범주별 수를 함께 보고하세요. 전체 백분율은 모델이 각주를 놓쳤는지, 정보가 여러 섹션에 흩어져 있을 때만 어려움을 겪었는지를 숨깁니다.
정확한 원본 파일, 추출물, 프롬프트, 원시 응답, 채점 시트를 보존하세요. 공유 권한이 있는 자료만 게시하고, 기밀 이름이나 계정 세부 정보는 삭제하세요. 검토자는 모델 출력에서 저장된 출처의 페이지까지 모든 채점된 답변을 추적할 수 있어야 합니다.
장문 문서 답변이 실패하기 쉬운 지점
명시된 문서에 대해 최신 빌드 실행을 하지 않고 V4.1 Flash가 특정 오류율이나 실패 패턴을 보였다고 주장하는 것은 잘못입니다. 아래 범주는 점검할 항목이며, 이 모델에 대해 측정된 결과가 아닙니다.
범위 상실부터 시작하세요. 본문 단락이 규칙을 말하지만 각주가 이를 지역, 날짜 범위, 고객 등급으로 제한할 수 있습니다. 예외를 명시적으로 요청하고 인용된 구절이 이를 포함하는지 점검하세요. 본문 단락만의 인용은 불충분할 수 있습니다.
다음으로 버전 혼동을 확인하세요. 보고서는 초안과 개정 섹션에서 유사한 값을 반복할 수 있습니다. '현재 숫자'만 요청하지 말고 각 값에 연결된 날짜나 버전을 말하도록 모델에 요청하세요. 모델이 조용히 하나를 선택하면, 우연히 올바르게 선택했더라도 응답을 불완전으로 채점하세요.
섹션 간 질문은 추론을 유도합니다. 모델은 두 가지 정확한 사실을 문서가 결코 제시하지 않은 인과 설명으로 결합할 수 있습니다. 직접 진술과 추론을 별도로 표시하도록 요구하세요. 그런 다음 추론을 증거와 비교하고 그 작업에 합리적인지 판단하세요.
마지막으로 보류를 테스트하세요. 답이 없는 질문을 포함하세요. 확신에 찬 추측은 그럴듯하게 들리더라도 실패입니다. 계약, 컴플라이언스, 임상 자료 또는 중대한 재무 분석의 경우 결론을 사용하기 전에 자격을 갖춘 사람에게 원문을 확인하도록 요청하세요.
더 안전한 답변을 위한 검증 워크플로
이 프롬프트는 답변을 더 쉽게 감사할 수 있게 합니다. 정확성을 보장하거나 원문 검토를 대체할 수는 없습니다. 페이지 레이블을 보존하는 추출물과 함께 사용한 다음, 거대한 파일의 일반 요약을 요청하기보다 집중된 질문을 하세요.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
긴 보고서의 경우 임의의 페이지 수로 자동 분할하지 말고 작업별로 나누세요. 먼저 소스 맵을 요청하세요: 섹션 제목, 날짜, 정의된 용어, 관련 표. 그런 다음 특정 주제를 질의하고 그 뒷받침 구절을 요청하세요. 섹션 간 결론을 위해서는 두 구절을 같은 턴에 제공하거나 검색하고, 모델이 어떤 추론이든 표시하면서 연결을 설명하도록 요청하세요.
사람 검증 루프를 사용하세요:
- 원본 파일에서 인용된 페이지와 인용문을 확인하세요.
- 인용문이 인접한 예외와 표 머리글을 포함하는지 확인하세요.
- 각 주장을 직접, 추론, 근거 없음, 반박됨으로 표시하세요.
- 추출이 중요한 구조를 누락했다면 프롬프트를 수정하거나 작업을 분할하세요.
- 검토자가 결정을 재현할 수 있도록 원시 요청과 응답을 저장하세요.
호스팅 엔드포인트를 사용할 때는 실행 로그에 토큰 사용량을 포함하세요. Atlas Cloud의 모델 가격 페이지는 현재 DeepSeek V4.1 Flash를 1M 입력 토큰당 $0.30, 1M 출력 토큰당 $1.20, 1M 캐시 읽기 토큰당 $0.03으로 명시하며, 할인은 나열되어 있지 않습니다. 예산을 세우기 전에 현재 목록을 확인하세요. 이 가격 참조는 Atlas Cloud에 대한 것이며, 보편적인 DeepSeek API 가격이 아닙니다.
해당 명시 요율에서 100,000개의 비캐시 입력 토큰과 3,000개의 출력 토큰은 약 $0.033입니다: 입력에 $0.030, 출력에 $0.0036입니다.
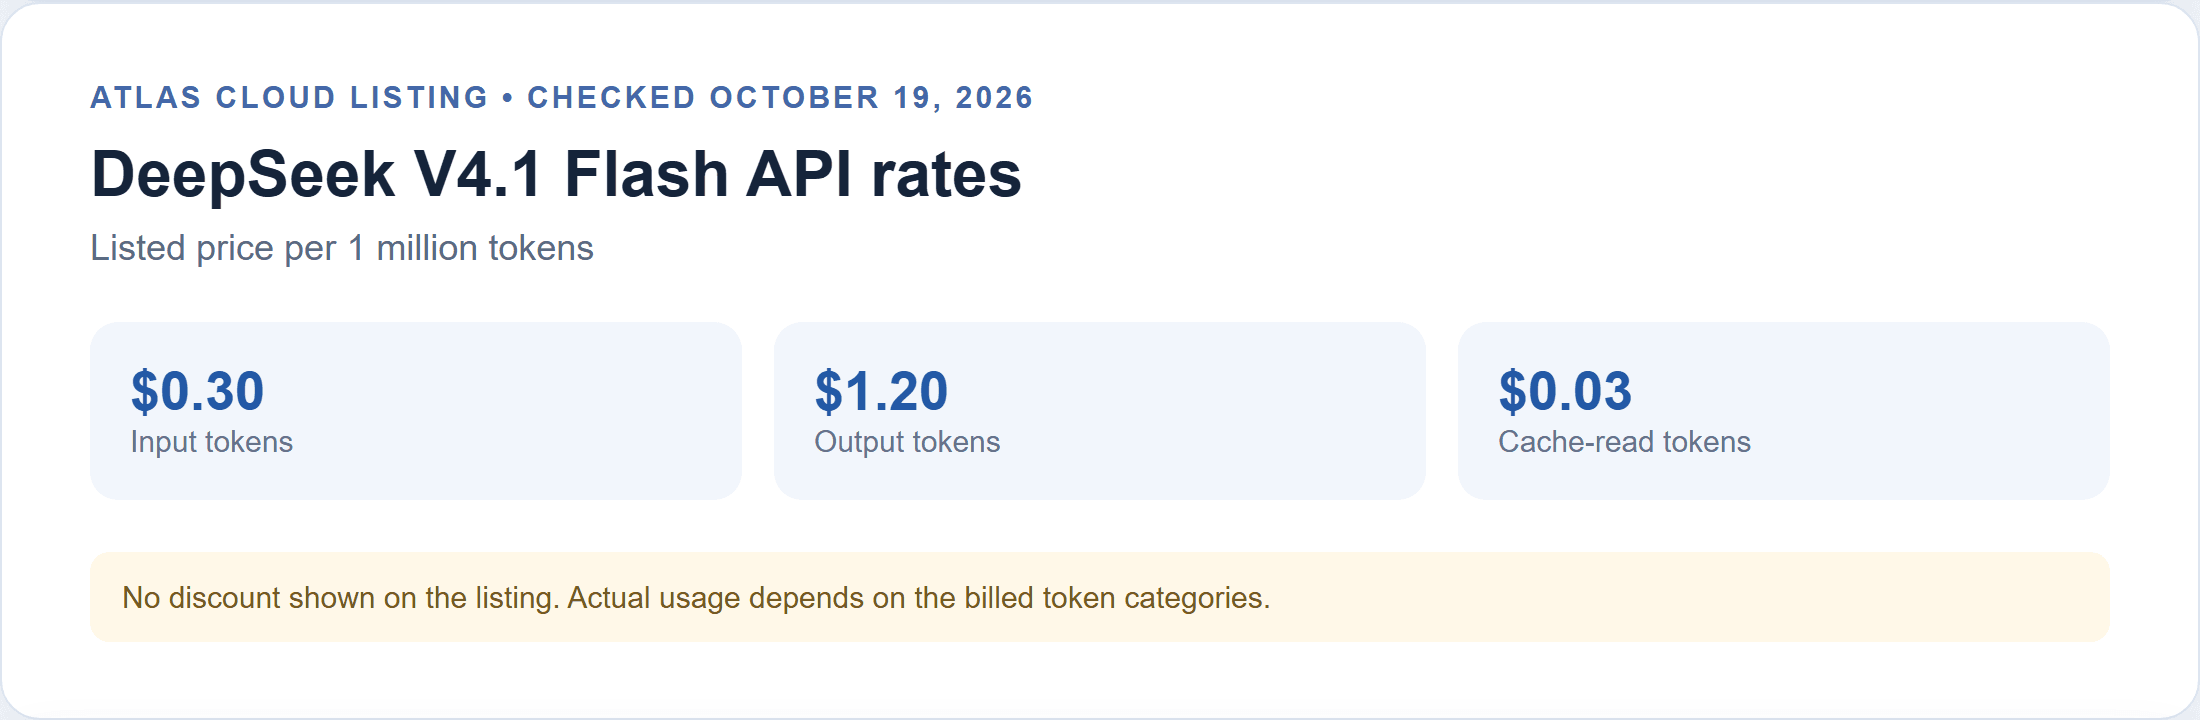
Atlas Cloud 가격은 2026년 10월 19일 확인 기준이며, 목록에는 할인이 표시되어 있지 않습니다. 동일한 요율에서 1M 토큰 입력과 20,000 토큰 답변은 캐시 처리나 기타 청구 항목을 제외하고 약 $0.324입니다. 이는 산술 예시이며 측정된 문서 테스트 청구서가 아닙니다. 실제 입력에는 프롬프트와 추출된 텍스트가 포함되며, 반복 호출은 사용량을 추가합니다. 페이지 수로 추정하지 말고 제공자가 반환한 토큰 수를 사용하세요.
장문 문서에 DeepSeek V4.1 Flash를 사용해야 할 때
Flash는 정의를 찾고, 날짜를 수집하고, 섹션 맵을 만들거나, 사람이 확인할 요약 초안을 작성해야 할 때 합리적인 1차 처리입니다. 이러한 작업은 근거 흔적이 눈에 보이고 더 엄격한 질문으로 쉽게 다시 실행할 수 있습니다. 반복 작업의 경우 알려진 정답 질문을 유지하고 모델 버전, 추출 파이프라인 또는 프롬프트가 바뀔 때 다시 실행하세요.
질문이 멀리 떨어진 섹션을 결합하거나, 각주에 의존하거나, 개정판을 비교할 때는 통제를 추가하세요. 인용은 탐색 보조 수단으로 사용하고, 그 자체로 증거로 삼지 마세요. 답변이 계약 의무, 컴플라이언스 입장, 재무 공시 또는 다른 중대한 결정에 영향을 줄 경우, 자격을 갖춘 검토자가 원문에서 각 중요한 주장을 검증하도록 하세요.
유용한 질문은 이 모델이 귀하의 문서 버전과 정확한 워크플로에서 검증을 견디는 근거와 함께 답변을 반환하는지입니다. 그것이 귀하의 사용 사례에 대해 DeepSeek V4.1 Flash 장문 문서 분석 정확도를 입증할 수 있는 테스트입니다.
자주 묻는 질문
1M 토큰 컨텍스트 창이 있으면 모델이 1M 토큰 문서를 정확하게 분석할 수 있나요?
아니요. 이는 지원되는 컨텍스트 용량을 설명합니다. 실제 요청에는 지침과 출력 예산도 포함되며, 추출, 인터페이스 한도, 질문 난이도가 유용한 근거를 사용할 수 있고 올바르게 해석되는지에 영향을 줍니다.
LongBench-V2는 문서 질의응답 정확도와 같은 것인가요?
아니요. 여러 장문 컨텍스트 작업 범주를 포함하며 특정 설정에서의 성능을 보고합니다. 이는 비교 신호일 뿐, 특정 PDF, API 빌드, 프롬프트 또는 도메인에 대한 보장이 아닙니다.
하나의 프롬프트를 사용해야 하나요, 아니면 긴 문서를 섹션으로 나눠야 하나요?
구조가 중요할 때는 소스 맵과 집중된 질문을 사용하세요. 비교해야 하는 구절은 종합 단계를 위해 함께 사용할 수 있게 유지하고, 응답을 검증할 수 있도록 페이지 레이블을 보존하세요.
AI 생성 요약의 인용을 어떻게 검증해야 하나요?
원본 파일에서 인용된 각 페이지를 열고, 인용문과 주변 텍스트를 확인하며, 그 구절이 특정 주장을 뒷받침하는지 확인하세요. 인용된 문장뿐 아니라 표 머리글과 각주도 검증하세요.
입력 및 출력 토큰은 비용에 어떻게 영향을 주나요?
입력 토큰은 문서, 지침, 질문을 포함합니다. 출력 토큰은 답변을 포함합니다. 더 긴 프롬프트, 여러 호출, 반복되는 구절은 사용량을 늘립니다. 추정에는 청구된 토큰 수와 현재 제공자 가격표를 사용하세요.





