두 사람이 등장하는 장면은 각 대사의 주인이 누구인지 보고 들을 수 있을 때 설득력이 생깁니다. Gemini Omni 1.2 Flash 다중 화자 대화를 쉽게 따라가려면 각 캐릭터에 고정된 시각적·청각적 정체성을 부여하고, 말하는 순서대로 짧은 대사를 쓰고, 완성된 영상을 눈과 귀로 검토하세요. Google의 2026년 11월 업데이트는 더 자연스러운 다중 화자 음성과 최대 15초 클립을 지원하지만, 프롬프트가 첫 렌더링에서 화자 할당을 완벽하게 보장할 수는 없습니다. 단순한 2인 대화로 시작하고, 기본 핸드오프를 판단할 수 있게 된 후에야 세 번째 턴이나 거리 앰비언스를 추가하세요.
주요 내용
- Gemini Omni 1.2 Flash는 대사를 포함한 네이티브 사운드가 있는 영상을 생성합니다. 오디오 전용 Gemini 텍스트 음성 변환 모델과는 다릅니다.
- 각 턴마다 이름이 지정된 화자, 정확히 인용된 대사, 명확한 위치, 침묵하는 청자를 사용하세요.
- 최대 15초 안에 일시 정지를 위한 여유를 두고, 클립과 대사를 하나하나 대조하세요.
- 렌더링 가격은 플랫폼의 최저 광고 요금이 아니라 선택한 길이와 해상도를 기준으로 책정하세요.
Gemini Omni 1.2 Flash에서 다중 화자 대화란 무엇인가?
이 모델은 생성된 오디오와 영상의 일부로 사람들이 말할 수 있는 짧은 장면을 만듭니다. 실용적인 테스트는 시청자가 대본을 읽지 않고도 각 대사를 누가 말하는지 알 수 있는지입니다. 말, 목소리, 보이는 사람, 입 움직임이 동시에 일치해야 합니다. 클립은 음소거 상태에서 설득력 있어 보일 수 있지만 그 테스트에서는 여전히 실패할 수 있습니다.
Google은 2026년 11월 5일 Gemini Omni 1.2 Flash를 발표했으며, 최대 15초의 생성 또는 편집 영상을 지원합니다. 더 유연한 대화, 더 명확한 립싱크, 뚜렷한 다중 화자 조건화를 설명합니다. 이는 기능 주장이지 모든 대본이 작성된 그대로 전달된다는 약속이 아닙니다 (Google의 2026년 11월 발표).
Google이 공개한 데모는 발표된 기능을 보여줍니다. 아래 제공된 세 가지 비디오 사례와는 별개입니다.
Gemini Omni 1.1 Flash에서 무엇이 바뀌었나요?
공식 비교에 따르면 1.2는 더 긴 상한을 가집니다: 10초가 아닌 15초입니다. 또한 음성, 립싱크, 참조 따르기, 대화형 편집의 개선을 언급합니다. 추가된 5초는 3턴 대화를 대본으로 만들기 더 그럴듯하게 하지만, 연출자가 일시 정지, 신체 반응, 장면 전환도 요구한다면 더 긴 길이가 더 많은 발화 시간을 만들어 주지는 않습니다.
가장 안전한 해석은 방향성입니다. 더 나은 조건화는 대화를 연출하기 쉽게 만들 수 있지만, 전달된 각 클립은 여전히 검사가 필요합니다. 제작자는 15초 제한을 대본 목표로 사용할 수 있습니다. 정확한 법률 문구나 정밀한 음성 일치를 약속하는 프로듀서는 생성된 출력을 검토를 통과할 때까지 초안으로 취급해야 합니다.
비디오 대화 vs 다중 화자 텍스트 음성 변환
Gemini 텍스트 음성 변환 모델은 텍스트를 받아 오디오를 반환합니다. 화자 설정과 음성 선택은 해당 오디오 워크플로에 속하며, Google은 이를 별도로 문서화합니다 (Google의 Gemini 텍스트 음성 변환 문서, 2026년 11월 접속). Gemini Omni 1.2 Flash의 텍스트-투-비디오 경로는 장면 프롬프트를 받아 네이티브 사운드가 있는 영상을 생성합니다. 텍스트 음성 변환 speech_config 예시는 Gemini Omni 1.2 Flash 비디오 제어가 아닙니다. 이 예시들은 텍스트로 음성 캐릭터를 설명하며, 녹음된 음성을 업로드, 복제 또는 선택한다고 주장하지 않습니다. 특정 배우의 음성이 필요한 경우, 촬영을 계획하기 전에 해당 접근 권한과 동의를 별도로 확인하세요.
결과물이 팟캐스트 대화나 고정된 보이스오버라면 텍스트 음성 변환을 사용하고 그 오디오에 맞춰 화면을 편집하세요. 생성된 장면에서 두 사람이 눈에 보이게 말하는 것이라면 Gemini Omni 1.2 Flash 비디오를 사용하고 실제 출력에서 정렬을 테스트하세요.
어디에서 실행할 수 있고, 클립 비용은 얼마인가요?
텍스트-투-비디오 경로 선택
Google은 자사의 크리에이티브 및 개발자 제품 전반에 Gemini Omni 1.2 Flash를 나열합니다. 재현 가능한 테스트를 위해 한 가지 경로를 사용하세요: Atlas Cloud에서 모델을 제공하며, Gemini Omni 1.2 Flash 텍스트-투-비디오 플레이그라운드에서 아래 프롬프트를 붙여넣을 수 있습니다. 경로 ID는 google/gemini-omni-1.2-flash/text-to-video입니다. 아래 프롬프트는 이미지, 모션 또는 음성 참조 없이 텍스트만 사용합니다.
프롬프트는 사무실의 경우 16:9로 12초, 카페의 경우 16:9로 15초, 거리 인터뷰의 경우 16:9로 12초를 요청합니다. 제공된 세 파일은 720p입니다. 실행을 누르기 전에 라이브 컨트롤과 선택한 값을 확인하세요. 제품 페이지에 광고된 설정이 특정 테스트 실행에서 이를 수용했다는 증거는 아닙니다. 각 출력과 함께 선택한 값과 견적을 저장하세요. 이렇게 하면 모든 렌더링이 유용한 증거가 됩니다: 출력을 검토할 때 프롬프트를 선택한 해상도 및 경로와 비교할 수 있습니다. 이 가이드는 텍스트-투-비디오 경로를 지정하므로, 이미지-투-비디오 또는 참조-투-비디오 경로의 결과는 별도로 식별해야 합니다.
제공된 비디오 파일에는 완료된 플레이그라운드 캡처, 선택한 설정 또는 제출 전 견적이 포함되어 있지 않습니다. 따라서 해당 경로와 구성은 확인되지 않은 상태로 남습니다.
| 경로 | 이 가이드의 입력 | 최적 용도 | 비용 확인 위치 |
|---|---|---|---|
| Google의 크리에이티브 제품 | 장면 프롬프트; 제품별로 컨트롤 다름 | Google 편집기에서 수동 제작 | 현재 요금제 또는 크레딧 화면 |
| Google API | 개발자 비디오 요청 | 애플리케이션 통합 | 정확한 해상도에 대한 Google 가격 |
| Atlas Cloud 텍스트-투-비디오 | 프롬프트, 길이, 화면 비율, 해상도 | 하나의 플레이그라운드에서 이러한 텍스트 전용 테스트 반복 | 선택한 구성의 제출 전 견적 |
렌더링 전에 가격 확인
Google은 API를 통해 720p의 경우 생성된 초당 $0.07을 인용하며, 이는 Gemini Omni 1.1 Flash보다 30% 낮습니다. 해당 인용 요율로 720p 12초는 기타 청구 작업 전 $0.84입니다. 이 계산은 제공된 파일에 대한 Atlas Cloud 견적이 아니며, 해당 경로와 청구는 확인되지 않았습니다. Flow 또는 다른 편집기의 크레딧은 해당 제품의 자체 규칙을 따릅니다.
Atlas Cloud는 모델 카탈로그에서 더 낮은 시작 초당 요율을 나열하지만, 최소값은 다른 해상도나 구성에 해당할 수 있습니다. 길이와 해상도를 선택한 후 라이브 견적을 읽으세요. 360p 초안은 프롬프트를 탐색하는 데 도움이 될 수 있지만, 나중의 1080p 렌더링을 프레임별로 미리 보는 것이 아니라 별도의 생성입니다.
15초 장면에 두 목소리 맞추기
각 화자에게 시각적·청각적 정체성 부여
검토자가 확인할 수 있는 설명을 작성하세요. "화자 A는 왼쪽에 네이비 셔츠를 입고 있다"가 "첫 번째 동료"보다 명확합니다. 중간 음역 대 낮은 음역과 같은 들리는 차이를 추가하세요. 프롬프트 전체에서 이름, 의상, 위치, 목소리를 일관되게 유지하세요. 이러한 기준점은 바뀐 대사를 더 쉽게 발견하게 합니다.
시각적 정체성은 오디오만으로 검토자를 속일 수 있기 때문에 중요합니다. 목소리는 다르지만 잘못된 입이 움직이면 클립에 립싱크 문제가 있습니다. 올바른 입이 움직이지만 A의 두 번째 턴에서 A의 목소리가 변하면 음성 드리프트가 있습니다. 카페 예시는 B 이후에 A를 다시 등장시켜 검토자가 A의 목소리가 일관되게 유지되는지 확인할 수 있게 합니다.
발화와 반응을 위한 시간 배분
의도한 속도로 대본을 소리 내어 읽어보세요. 각 핸드오프에서 자연스러운 일시 정지를 포함하고, 청자가 반응할 공간과 오프닝 샷이 두 얼굴을 확립할 공간을 남기세요. 수정된 사무실 대본은 12초에 5턴입니다. 카페는 15초에 8개의 짧은 턴으로, 여기서 가장 까다로운 타이밍 테스트입니다. 이는 예시 대본이지 보편적인 초당 단어 임계값이나 출력에 대한 약속이 아닙니다.
| 장면 예산 | 발화 순서 | 단어 외에 필요한 시간 |
|---|---|---|
| 12초 사무실 | A-B-A-B-A | 두 사람을 확립하고 4번의 핸드오프 맞추기 |
| 15초 카페 | 8개의 교대 턴 | 7번의 핸드오프, 여유 시간 거의 없음 |
| 12초 거리 | A-B-A-B-A | 거리 앰비언스 위에 4번의 핸드오프 |
긴 대사는 끝부분에서 서두르거나 누락하기 쉽습니다. 초안을 소리 내어 읽는 데 거의 15초가 걸린다면 생성 전에 줄이세요. 시나리오에 더 많은 대화가 필요하면 별도의 샷을 계획하고 연속성을 또 다른 제작 작업으로 확인하세요. 첫 시도에서는 말하는 동안 얼굴을 보이게 유지하세요. 빠른 컷과 가려진 입은 화자 할당을 판단하기 어렵게 만듭니다. 대사 순서가 중요하다면 두 사람과 함께 시간을 재며 테이블 리드를 하세요. 한 사람은 A를, 다른 사람은 B를 말하게 하고 세 번째 사람이 각 문장이 어디서 끝나는지 기록하게 하세요. 마지막 단어가 클립 한계에 닿는다면 렌더링 전에 절이나 반응 비트를 제거하세요. 짧은 대본은 검토자가 화면 밖으로 이어지려는 대사인지 추측하지 않고 전체 교환을 다시 재생할 수 있으므로 감사하기 더 쉽습니다.
Gemini Omni 1.2 Flash에 2인 화자 프롬프트하는 방법
유용한 프롬프트는 간결한 촬영 브리프처럼 읽힙니다: 설정과 카메라, 정체성, 정확한 대사, 그다음 사운드와 제외 규칙입니다. 이 순서는 검토자에게 체크리스트를 제공합니다. 이는 프롬프트 방법이지 문서화된 제어 보장이 아닙니다. 정체성 문단부터 대화 블록까지 캐릭터 레이블을 동일하게 유지하세요. 이후 턴에 대한 지침에서 같은 사람을 A와 "고객"으로 모두 지칭하는 것을 피하세요. 매핑이 이미 명확하지 않은 경우에는 특히 그렇습니다. 독자는 각 사람을 위한 두 개의 열을 그릴 수 있어야 하며, 요청된 모든 행동과 대사를 정확히 하나의 열에 배치할 수 있어야 합니다.
명시적 화자 레이블과 인용 대사 사용
턴당 한 줄로 Speaker A: 또는 Speaker B:와 인용된 단어를 사용하세요. 누가 침묵하는지 지정하세요. "출시 준비에 대한 토론"을 요청하면 즉흥성을 허용합니다. 정확한 대본은 누락되거나 다시 쓰인 단어를 즉시 표시할 수 있게 합니다.
다음은 복사할 첫 번째 프롬프트입니다. 두 성인을 하나의 연속 샷에 유지하여 시청자가 각 입을 검사할 수 있습니다.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
제공된 12초, 720p 사무실 렌더링. 두 사람 모두 보이며, 다섯 개의 발화 대사와 립싱크는 여전히 청취 검토가 필요합니다.
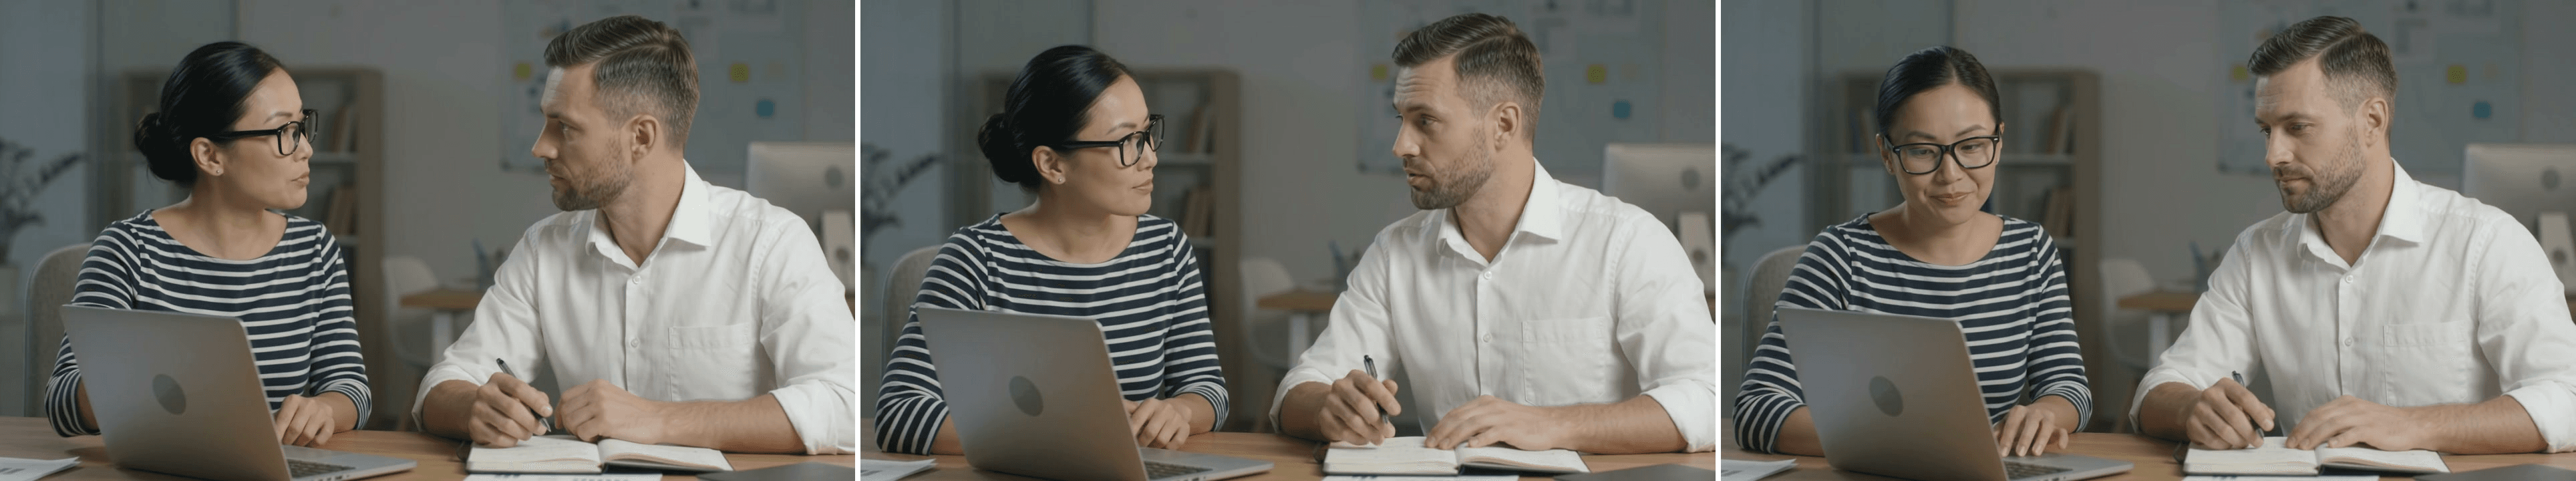 케이스 A 프레임, 왼쪽에서 오른쪽으로 (약 0:02, 0:05, 0:10): 여성이 동료를 바라본다; 남성이 답하는 듯 보이며 둘 다 프레임에 남아 있다; 두 사람은 다시 노트북과 공책으로 주의를 돌린다.
화자를 잃지 않고 카메라 제어
연속 중간 2샷은 진단적 선택입니다. 두 얼굴이 계속 보이므로 놓친 핸드오프가 편집 뒤에 숨을 수 없습니다. 모델은 여전히 프레이밍을 바꿀 수 있으므로 최종 파일을 검사해야 합니다.
핸드오프가 목적에 맞게 작동하면 두 얼굴을 보존하는 적당한 움직임을 시도하세요. 거리 프롬프트는 16:9 프레임에서 두 얼굴을 모두 보이게 유지하는 움직임을 요청하여 입 움직임을 판단하기 쉽게 합니다. 이것이 사무실 기준선을 먼저 확립해야 하는 이유입니다.
배경 오디오를 대화 아래로 유지
앰비언스와 그 우선순위를 지정하세요. 조용한 룸 톤은 사무실 클립에서 음성과 경쟁할 요소를 거의 없게 합니다. 부드러운 카페 소리는 맥락을 더하면서 대사를 테스트 가능하게 유지합니다. 거리 프롬프트는 행인 음성 없이 두 목소리 아래에 발소리와 먼 소리를 요청합니다.
부정 지침은 원치 않는 오디오를 줄일 수 있지만 여전히 요청일 뿐입니다. 제3의 목소리, 내레이션, 음악, 브랜드 오디오가 있는지 들으세요. 화면에서 자막과 로고도 확인하세요.
누가 언제 말하는지 보여주는 3가지 대화 장면
제공된 세 개의 비디오 파일은 의도된 사무실, 카페, 거리 장면을 보여줍니다. 시각적 내용은 여기에서 검사할 수 있지만, 파일이 어떤 경로나 설정으로 생성되었는지는 확립하지 못합니다. 아래 프롬프트는 재현 가능한 요청이지 출력이 모든 단어를 정확히 말했다는 주장이 아닙니다. 사무실은 5턴을 확인하고, 카페는 8개의 빠른 턴을 테스트하며, 거리는 환경음을 추가합니다.
| 사례 | 프롬프트 요청 | 제공된 파일 | 주요 확인 |
|---|---|---|---|
| A: 사무실 핸드오프 | 12초, 16:9, 5턴 | 12초, 16:9, 720p | 다섯 대사, 올바른 입 |
| B: 카페 교환 | 15초, 16:9, 8턴 | 15초, 16:9, 720p | 여덟 대사, 안정적인 목소리 |
| C: 거리 인터뷰 | 12초, 16:9, 5턴 | 12초, 16:9, 720p | 거리 가청도 및 화자 턴 |
5턴 사무실 핸드오프
위의 전체 프롬프트와 비디오를 사용하세요. 두 동료가 같은 샷에 남아 있으므로 요청된 다섯 턴 각각에 확인할 수 있는 보이는 사람이 있습니다. 각 들리는 대사를 텍스트와 대조하여 기록하고 활성 입을 검사하세요. 제공된 파일은 장면과 길이를 확립하지만, 그 단어와 립싱크는 독립적으로 확인되지 않았습니다.
한 클립에서 명확한 핸드오프는 그 클립에 대한 결론만 뒷받침하며, 모델 전체의 성공률을 의미하지는 않습니다. 첫 결과를 보관하여 수정본을 원본과 비교할 수 있게 하세요.
8턴 카페 교환
16:9로 15초를 요청하세요. 여덟 개의 짧은 턴은 반복되는 음성 소유권과 타이밍에 부담을 줍니다. 각 사람의 첫 대사와 마지막 대사를 비교한 다음, 어떤 대사가 겹치거나 사라지는지 확인하세요. 제공된 파일은 720p입니다.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
야외 Q&A
16:9로 12초를 요청하세요. 이는 약간의 카메라 움직임과 환경음을 추가합니다. 제공된 파일은 720p의 16:9이며 다섯 화자 턴과 거리 가청도를 검토할 수 있습니다.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
결합 재생: 0:00–0:15는 사례 B, 카페 교환; 0:15–0:27은 사례 C, 거리 인터뷰입니다. 두 소스 클립 모두 전체가 포함되어 있습니다.
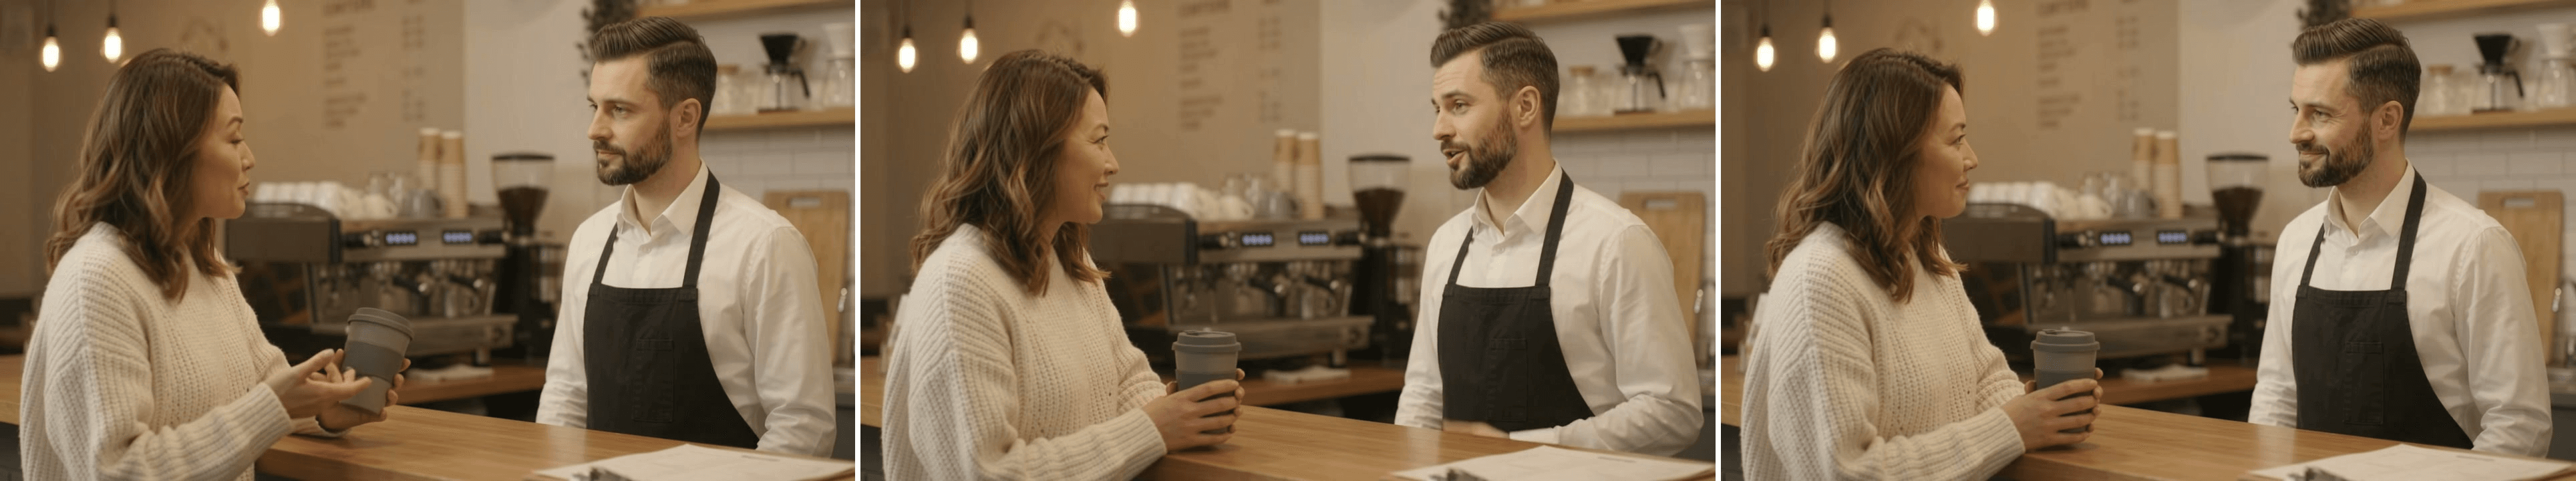 사례 B 프레임, 왼쪽에서 오른쪽으로 (결합 비디오의 약 0:02, 0:08, 0:13): 고객이 컵을 보여준다; 카페 직원이 답하는 듯 보인다; 마지막에 서로를 마주본다.
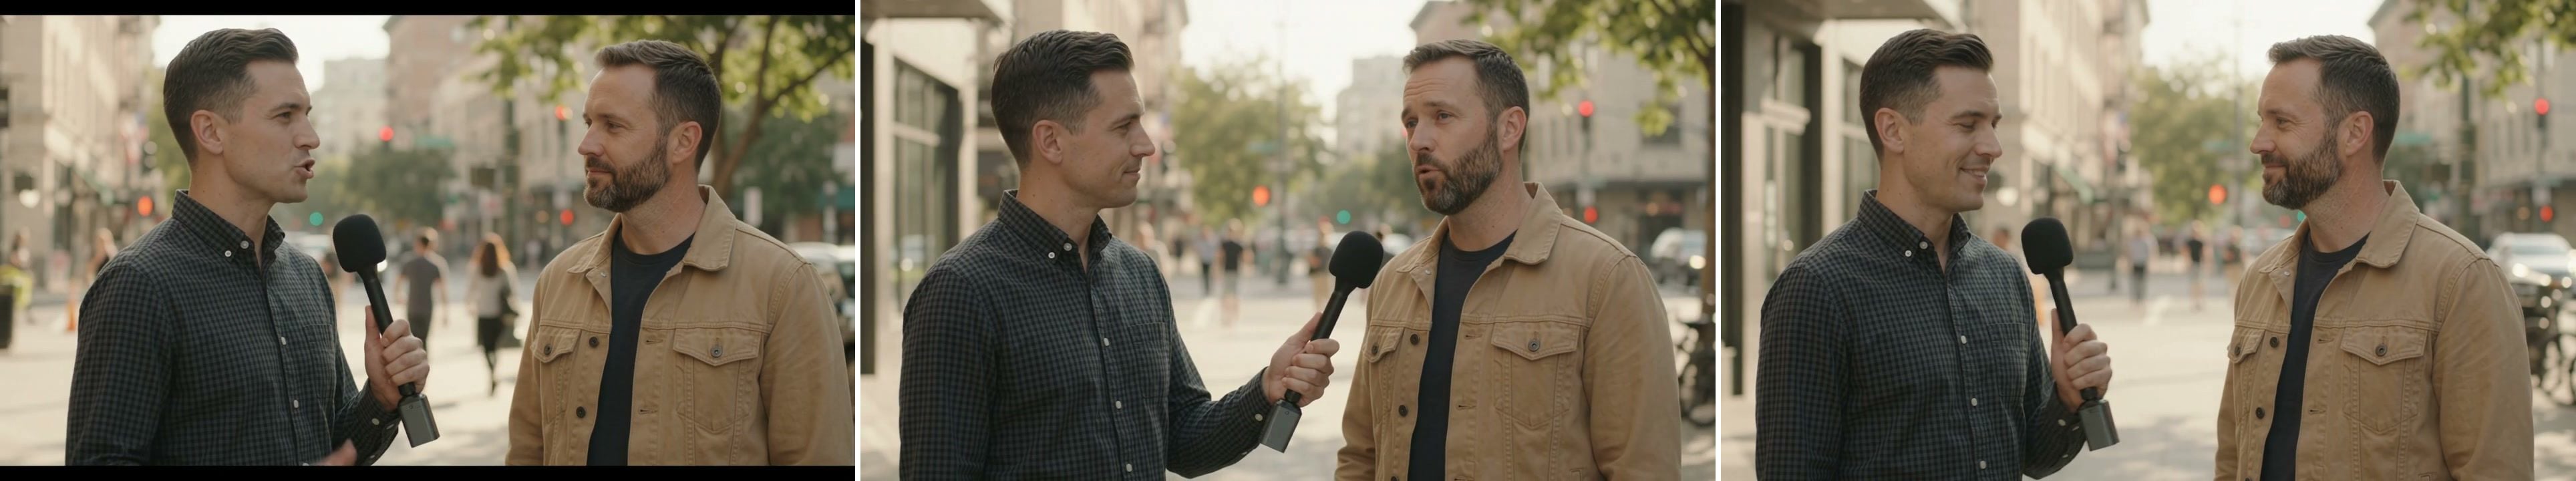
사례 C 프레임, 왼쪽에서 오른쪽으로 (결합 비디오의 약 0:16, 0:19, 0:26): 인터뷰어가 마이크를 잡는다; 그는 마이크를 인터뷰이 쪽으로 돌린다; 마지막에 둘이 서로를 마주본다.
게시 전 화자 순서, 립싱크, 음성 드리프트 확인
클립을 대사별로 검토
비디오를 다운로드하세요. 대본을 읽지 않고 한 번 재생하여 명백한 혼란을 찾은 다음, 프롬프트를 옆에 두고 다시 재생하세요. 각 턴에서 일시 정지하고 들리는 내용을 적으세요. 두 입을 모두 검사하고, 대본에 없는 발화를 기록하세요. 반복 가능한 검토를 위해 각 들리는 대사의 시작 및 종료 시간, 예상 화자, 들은 목소리, 움직인 보이는 입을 기록하세요. 얼굴이 가려지거나 소리가 단어를 가리면 "불분명"이라고 쓰세요. 장면의 나머지가 설득력 있어 보인다고 해서 불분명한 칸을 통과로 바꾸지 마세요. 프롬프트를 보지 않은 두 번째 청취자가 누가 말한다고 생각하는지 식별할 수 있습니다. 대중 시청자가 장면을 이해할지 결정하기 전에 그 판단을 대본과 비교하세요.
모든 대사에 대해 4가지를 확인하세요:
- 단어: 인용된 단어가 순서대로 말해졌으며, 누락된 끝이나 추가된 문장이 없었나요?
- 음성 소유자: 특히 A가 돌아왔을 때, 지명된 사람이 화자처럼 들렸나요?
- 보이는 타이밍: 청자가 침묵하는 동안 그 사람의 입이 움직였나요?
- 기타 콘텐츠: 클립에 내레이터, 행인, 자막, 로고 또는 음악이 추가되었나요?
오디오와 입 움직임이 대사별로 검토될 때까지 타임스탬프가 있는 품질 보증 타임라인은 보류 상태로 남습니다.
한 번에 하나의 제약 조건 수정
마지막 대사가 사라지면 대본을 줄이거나 15초 한도 내에서 더 많은 길이를 주세요. 잘못된 캐릭터가 말하면 시각적 위치를 반복하고 청자가 침묵한다고 지정하세요. 앰비언스가 단어를 덮으면 낮추거나 제거하세요. 컷이 활성 입을 가리면 연속 2샷으로 돌아가세요. 재시도마다 하나의 요인만 변경하여 다음 출력이 명확한 질문에 답하게 하세요.
이러한 편집 중 어느 것도 수정을 보장하지 않습니다. 렌더링에 수정이 필요하면 파일, 설정, 해결하려는 문제를 저장하세요. 그러면 프로듀서가 다른 렌더링이 비용을 감수할 가치가 있는지, 또는 녹음된 음성과 수동 편집이 필요한 정밀도를 제공할지 결정할 수 있습니다. 짧고 눈에 보이게 말하는 교환의 경우 사무실 프롬프트로 시작하고 대사별 확인 후에만 클립을 수락하세요. 이것이 Gemini Omni 1.2 Flash 다중 화자 대화의 표준입니다.
자주 묻는 질문
Gemini Omni 1.2 Flash가 별도 클립에서 동일한 목소리를 유지할 수 있나요?
하나의 생성된 클립 내에서 목소리가 인식 가능하게 유지되는 것은 별도의 생성 전반에 걸쳐 보존하는 것보다 좁은 요구 사항입니다. 이 텍스트 전용 예시는 첫 번째 경우를 테스트합니다. 이로부터 클립 간 음성 정체성을 약속하지 마세요. 하나의 반복 화자가 필요한 캠페인은 별도의 연속성 테스트를 실행해야 합니다.
Gemini Omni 1.2 Flash가 영어 이외의 언어로 대화를 생성할 수 있나요?
모델이 다른 언어를 생성할 수 있지만, 이 프롬프트는 영어입니다. 유창한 청취자와 함께 이름, 숫자, 현지화된 주장을 포함하여 대상 언어를 단어별로 검토하세요. 다른 제작자의 성공적인 언어 테스트는 그 테스트에 대한 증거이지 귀하의 대본에 대한 보장이 아닙니다.
각 대사를 올바른 화자에게 할당하려면 어떻게 하나요?
각 사람에게 시각적 위치와 목소리를 부여하고, 모든 인용 대사에 레이블을 지정하며, 다른 사람의 턴 동안 누가 침묵하는지 지정하세요. 생성된 비디오를 대사별로 검토하세요. 렌더링이 브리프를 충족하지 않으면 교환을 줄이거나 정확한 전달을 위해 통제된 오디오 워크플로를 사용하세요.
15초 Gemini Omni 1.2 Flash 클립에 몇 개의 대화 턴이 들어가나요?
카페 프롬프트는 15초에 8개의 짧은 턴을 요청하고, 사무실과 거리 프롬프트는 12초에 5턴을 요청합니다. 이는 대본 예시이지 보장된 한계가 아닙니다. 대사를 소리 내어 읽고, 일시 정지를 허용하며, 마지막 턴이 클립 끝에 닿으면 줄이세요.
Gemini Omni 1.2 Flash가 2인 화자 대화에 참조 이미지가 필요한가요?
이 세 가지 텍스트-투-비디오 프롬프트에서는 참조 이미지가 사용되지 않습니다. 각 화자의 위치, 의상, 목소리를 텍스트로 설명합니다. 프로젝트에 특정 얼굴이나 시각적 스타일이 필요하면 참조를 허용하는 경로를 테스트하고 그 출력을 별도로 검토하세요.


