엔터프라이즈 고객이 갱신 후 연간 플랜을 환불받을 수 있는지 묻습니다. 어시스턴트는 방대한 문서 세트를 검색한 뒤 명확하게 "예"라고 답합니다. 심지어 정책을 인용하기까지 합니다. 문제는 v4.1, 즉 보관 처리된 정책을 선택한 반면, 서명된 부속 합의와 v4.2는 다른 내용을 말한다는 점입니다.
그래서 gpt-6 astra knowledge base best practices는 증명에서 시작합니다. 모델에 권한 순서를 주고, 인가된 최신 증거만 검색하게 하며, 모든 실질 주장이 문서·버전·섹션을 가리키게 하십시오. 증거가 충돌하거나 소진되면 답변은 멈춰야 합니다.
GPT-6 Astra는 File Search와 1,050,000 토큰 컨텍스트 창, 최대 128,000 토큰 출력에서 작동할 수 있습니다. 용량은 조사를 돕습니다. 그러나 어떤 정책이 최신인지, 어떤 사용자가 볼 수 있는지, 인용이 인접한 주장을 실제로 뒷받침하는지는 결정하지 않습니다. ( OpenAI GPT-6 Astra 모델 페이지, 2026년 9월 )
권한 우선 지식 베이스 워크플로 애니메이션
8초 분량의 생성 워크플로 시각 자료: 서명된 오버라이드와 최신 정책은 증거 트레이에 남고, 보관 파일은 옆으로 이동하는 모습이 보입니다. 이는 라이브 제품 인터페이스나 원본 문서가 아니라 소스 거버넌스를 보여주는 일러스트입니다.
핵심 요점
- 업로드 전에 소스 권한을 승인하십시오.
- 검색 성과와 답변 충실성을 별도로 측정하십시오.
- 검색 전에 접근 권한, 상태, 날짜, 지역으로 필터링하십시오.
- 긴 컨텍스트는 기본 프롬프트가 아니라 조사 도구로 취급하십시오.
- 충돌과 누락 증거는 사람에게 에스컬레이션하십시오.
1M 토큰으로도 GPT-6 Astra 지식 베이스가 실패하는 이유
대부분의 실패는 답변 이전에 시작됩니다. Drive 내보내기는 서명된 부속 합의, 최신 정책, 오래된 FAQ, 초안을 모두 동등하게 검색 가능한 산문으로 취급합니다. 유능한 모델은 그 뒤섞인 자료를 매우 빠르게 설득력 있는 문단으로 바꿀 수 있습니다.
네 가지 점검이 일반적인 실패 유형을 잡아냅니다:
- 권한 표류: 최신 정책이나 고객 부속 합의보다 인기 있는 오래된 FAQ가 우선됨
- 인용 쇼: 답변에 출처 링크가 있지만, 인용된 구절이 주장을 뒷받침하지 못함
- 통제되지 않은 실험: 청크 크기, top-k, 컨텍스트 예산이 모두 함께 바뀌어 무엇이 개선됐는지 아무도 모름
- 접근 표류: 지역 예외, 제한된 초안, 비공개 메모가 잘못된 사용자에게 검색될 수 있음
평가를 논의하는 법률 RAG 실무자들은 "검색이 필요한 소스를 찾았는가"와 "답변이 그 소스를 충실히 적용했는가"를 분리하는 경향이 있습니다. 이 분리는 내부 지원 봇을 포함한 모든 릴리스 게이트에 있어야 합니다. ( r/Rag 법률 지식 베이스 토론, 2026년 9월 )
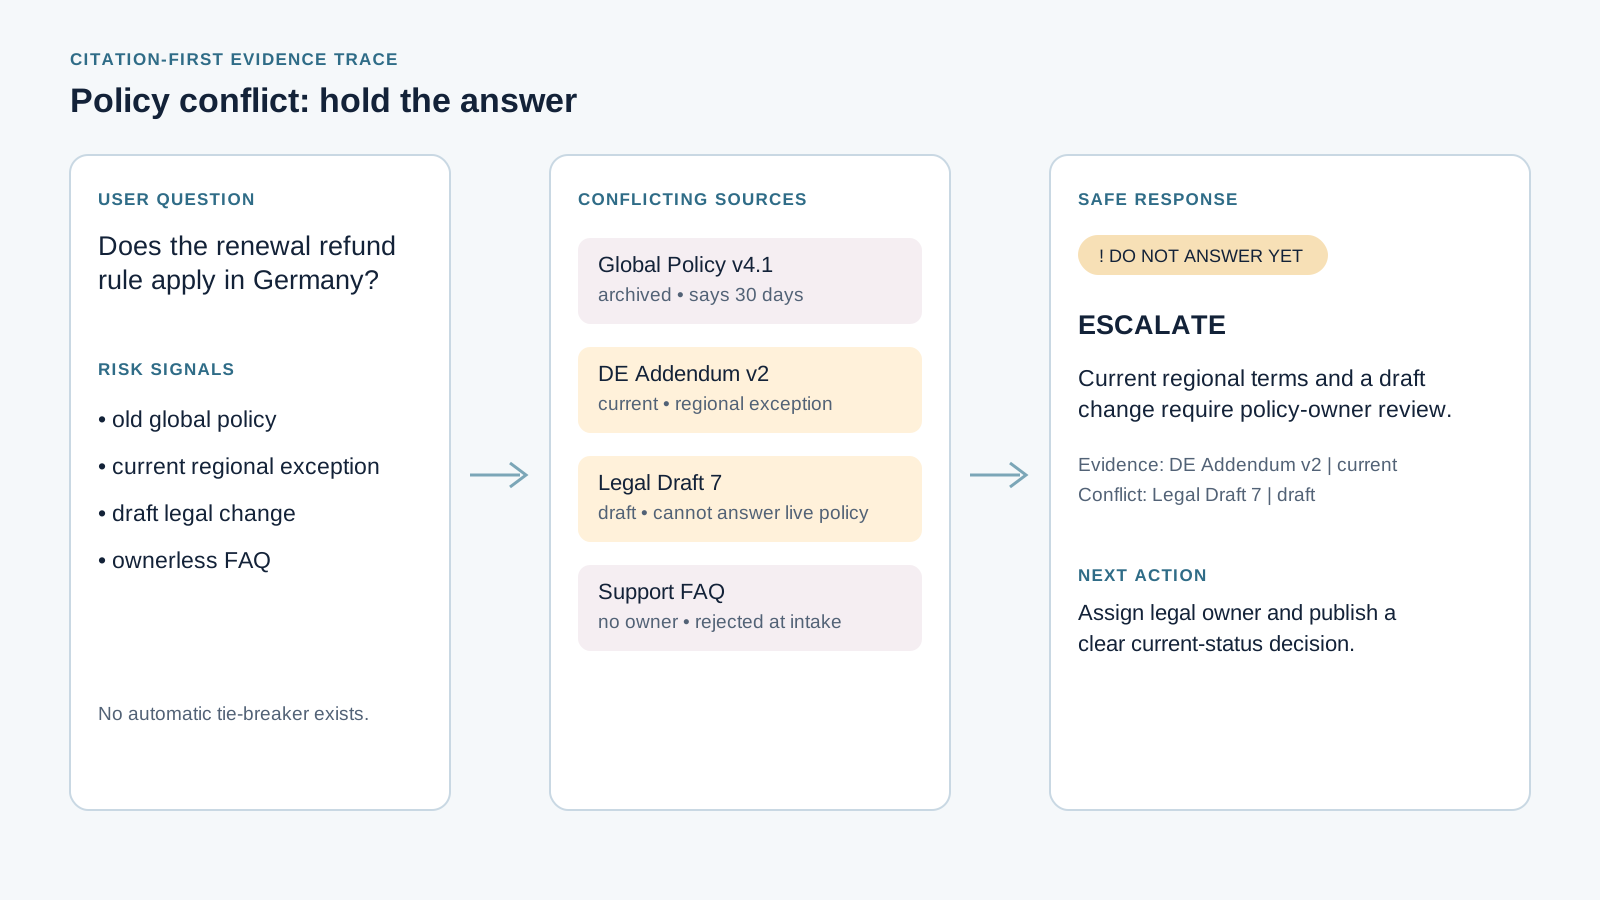
지식 베이스 버전 충돌 증거 추적과 답변 보류 결과
충돌도 유용한 출력입니다. 이 사례는 초안, 지역 예외, 오래된 정책, 소유자 없는 파일 중에서 조용히 하나를 고르는 대신 시스템이 "아직 답하지 말 것"을 반환해야 하는 이유를 보여줍니다.
GPT-6 Astra 지식 베이스 워크플로, 모델, 비용
파일럿에는 브라우저 탭 하나면 충분합니다. 소스를 목록화하고, 권한 매니페스트를 승인하고, 파일과 메타데이터를 정규화하고, 소규모 증거 세트를 검색한 다음 답변하고 평가합니다. 운영 목표는 영리한 채팅 데모가 아니라 검토 가능한 증거 추적입니다.
나머지 스택을 비교하는 팀을 위해 Atlas Cloud에서 현재 모델 옵션을 검토할 수 있습니다. 게시하는 날 직접 확인하기 전에는 카탈로그에 GPT-6 Astra가 있다고 가정하지 마십시오.
| 레이어 | 해결하는 작업 | 단독으로 해결하지 못하는 것 | 파일럿 규칙 |
|---|---|---|---|
| 긴 컨텍스트 | 대규모 조사 자료 읽기 | 권한, 사용 권한, 인용 뒷받침 | 예외 및 조사에 사용 |
| File Search | 소규모 출처 집합 검색 | 버전 거버넌스 | 검색 전 필터링 |
| 사용자 지정 검색 | 색인 및 순위 조정 | 답변 충실성 | 테스트에서 컨텍스트 예산 유지 |
| 인간 에스컬레이션 | 충돌 및 영향력 큰 판단 해결 | 일상적 규모 | 담당자와 응답 시간 정의 |
| 모델 또는 도구 | 작업 | 권장 설정 | 계획에 사용할 게시 가격 |
|---|---|---|---|
| GPT-6 Astra | 충돌 판단, 종합, 평가 | reasoning.effort: high | 입력 $10/MTok, 출력 $50/MTok |
| OpenAI File Search | 인가된 문서 검색 | 메타데이터 필터 및 인용 | 출시 전 도구 비용 확인 |
| 일상 모델 경로 | 태그 및 저위험 분류 | 먼저 벤치마크 | 가격을 하드코딩하지 말 것 |
| Atlas Cloud 모델 카탈로그 | 이후 모델 탐색 | 라이브 카탈로그 사용 | Astra 사용 가능 여부는 가정하지 않음 |
20~50개의 가치 높은 질문과 일부러 난해하게 구성된 문서 세트로 시작하십시오. 대체된 정책, 누락된 부속 합의, 지역 예외, 그리고 반드시 답변을 받지 말아야 할 질문을 한 개 이상 포함하십시오.
1단계: 권한 매니페스트 만들기
무엇을 업로드하기 전에, 인벤토리를 승인된 의사결정 레이어로 전환하십시오. 반환된 JSON은 KB_MANIFEST.md가 되기 전에 인간 소유자가 승인해야 합니다. 이는 폐기된 텍스트 위에 만들어진 완벽한 답변을 막는 첫 번째 가드레일입니다.
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
설정: 모델 gpt-6-astra, Responses API, reasoning.effort: high, 구조화된 JSON 출력. 초기 검토에는 제목, 소유자, 발효일, 지역, 상태, 접근 수준만 제공하십시오.
완료 기준: 모든 파일에 소유자, 날짜, 상태, 순위가 있고 Refund Policy v4.1이 v4.2에 의해 대체된 것으로 표시됩니다.
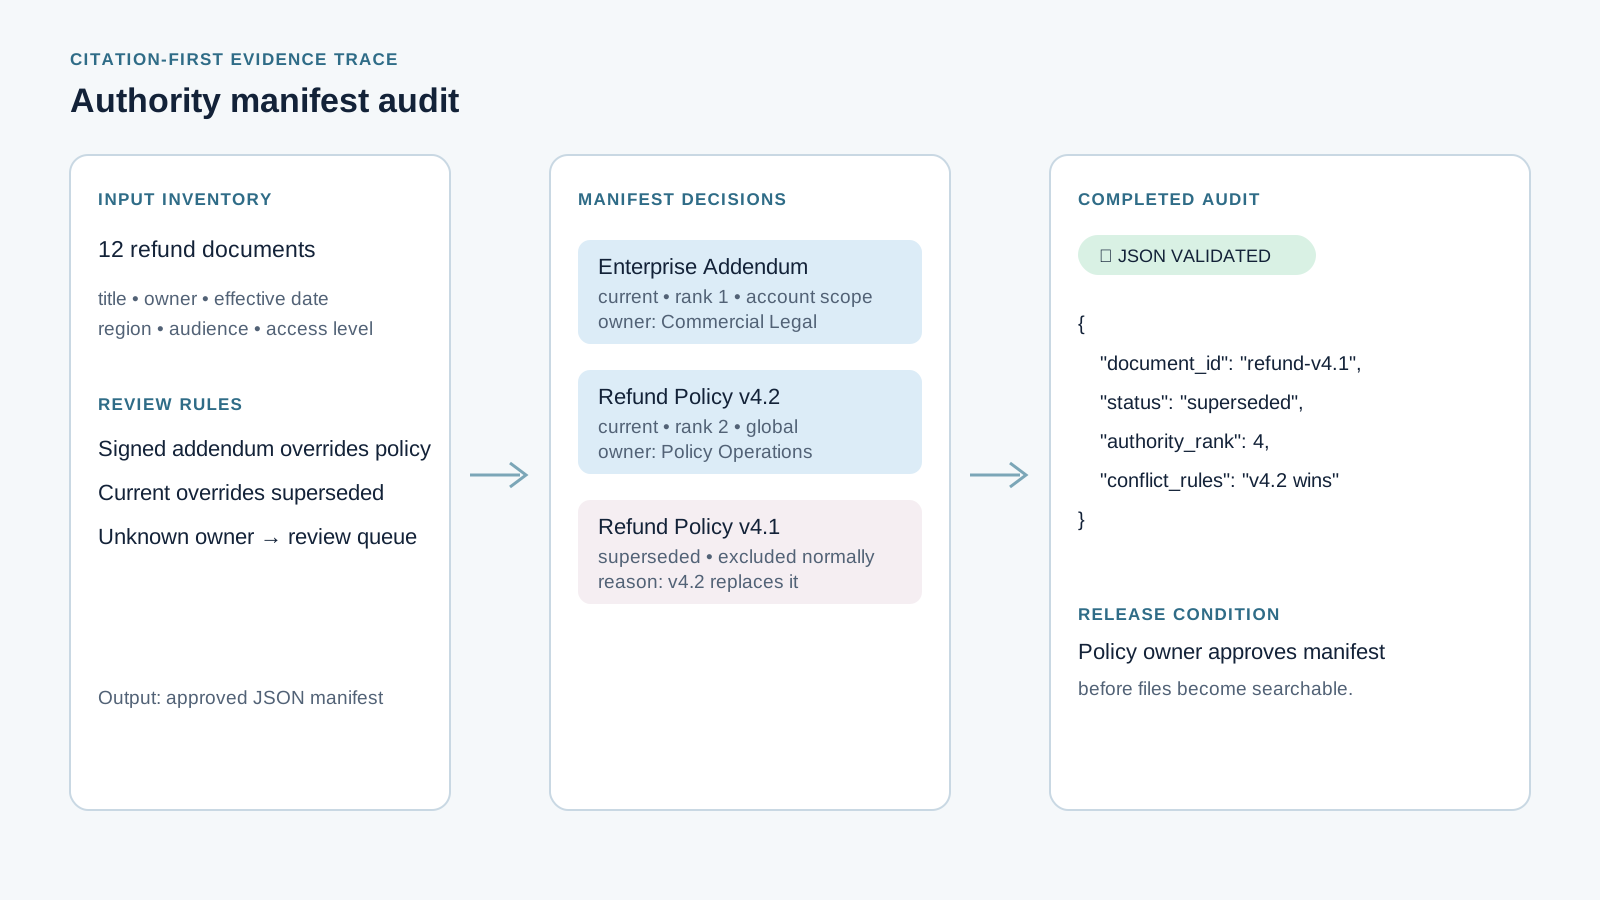
권한 매니페스트 감사 및 완료된 JSON 결정
환불 파일럿에 대한 완료된 권한 매니페스트 감사입니다. 감사 페이지에는 대체된 v4.1과 엔터프라이즈 오버라이드 규칙이 기록됩니다.
2단계: 검색할 GPT-6 Astra 지식 베이스 준비
승인된 소스를 정규화하십시오. 제목, 조건, 페이지 표시, 버전 데이터를 보존하십시오. 중복 바닥글, 내비게이션, OCR 잔여물을 제거하십시오. 소유자나 발효일이 없는 문서는 업로드하지 마십시오.
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
설정: 메타데이터로 document_id, version, effective_date, status, region, audience, authority_rank를 첨부하십시오. 검색 테스트는 전체 검색 컨텍스트 약 2,000 토큰으로 시작하십시오. 청크 전략 또는 검색 수 중 하나만 변경하고, 둘을 동시에 바꾸지 마십시오.
완료 기준: 보관 자료는 일반 쿼리에서 제외되고, 소유자 미상 파일은 검토 큐로 이동합니다.
다음 모션 사례는 분류 결정을 보여줍니다. 승인된 두 소스 폴더는 권한 트레이에 함께 남고, 모호한 초안은 별도의 검토 경로로 이동합니다. 이는 라이브 GPT-6 응답이나 제품 인터페이스가 아니라 워크플로 렌더링입니다.
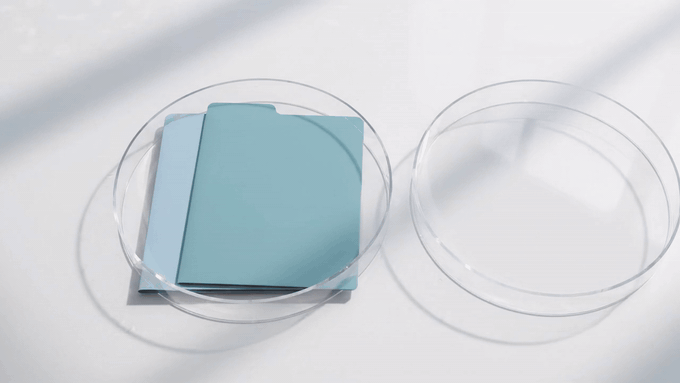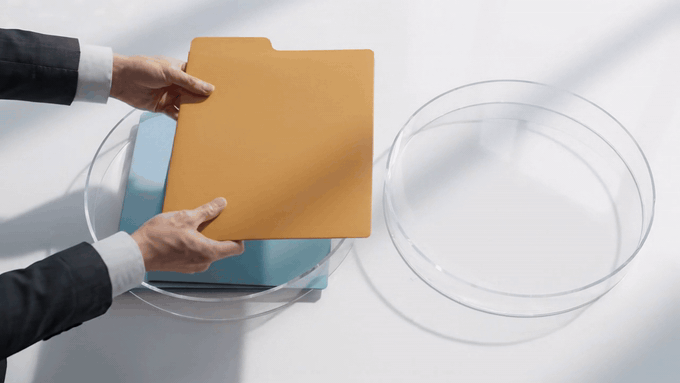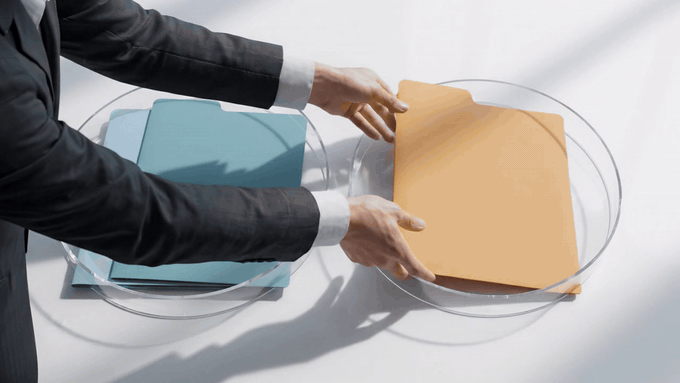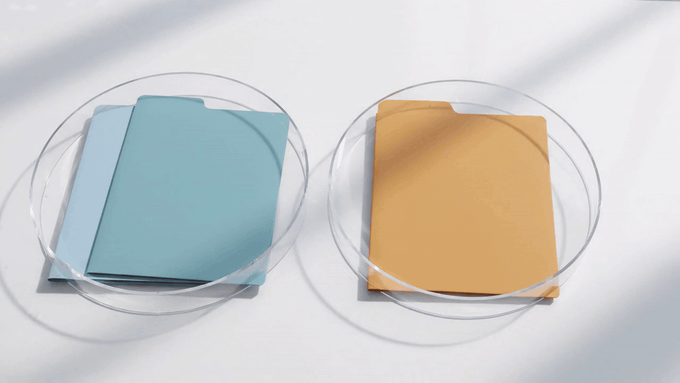
인간 검토로 이동하는 증거 핸드오프 애니메이션
8초 분량의 생성 워크플로 시각 자료: 승인된 소스 폴더는 함께 유지되고, 해결되지 않은 폴더는 인간 검토로 라우팅됩니다.
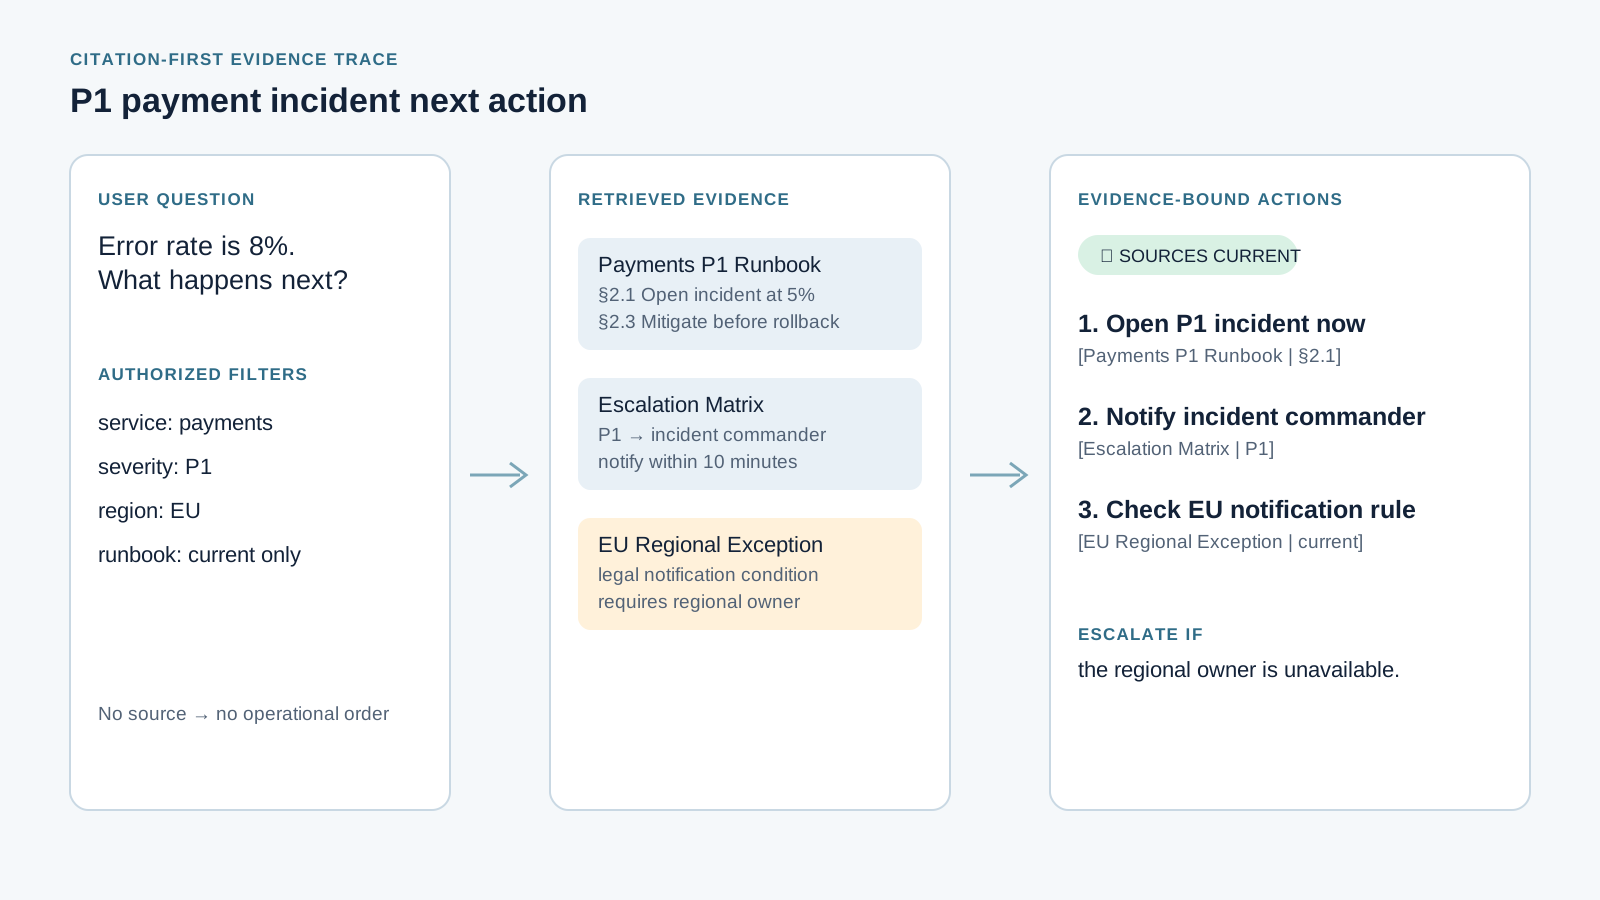
P1 결제 사고 증거 추적 및 에스컬레이션 조건
사례 2. 결제 오류 질문이 온콜 런북, 에스컬레이션 매트릭스, 지역 예외를 끌어옵니다. 답변은 즉흥적으로 복구 계획을 만들지 않고 사고 지휘관 트리거를 식별합니다.
3단계: 증거에 기반한 답변 요청
답변 생성을 검색되고 인가된 증거에 묶으십시오. 모델은 사실, 가정, 다음 조치를 분리해서 검토자가 시스템이 어디까지 아는지 알 수 있게 해야 합니다.
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
설정: reasoning.effort: high와 File Search를 사용하십시오. 검색 전에 현재 상태, 사용자 인가, 지역, 대상에 대한 필터를 적용하십시오. 도구 호출은 Responses API에 속하며, OpenAI의 현재 지침은 Astra 워크플로에 명확한 성공 조건과 도구 경계를 권장합니다. ( OpenAI 모델 지침, 2026년 9월 )
완료 기준: 답변이 현재 일반 정책과 서명된 엔터프라이즈 부속 합의를 인용하고, 보관된 v4.1을 규칙으로 사용하지 않으며, 부속 합의가 없으면 INSUFFICIENT_EVIDENCE를 반환합니다.
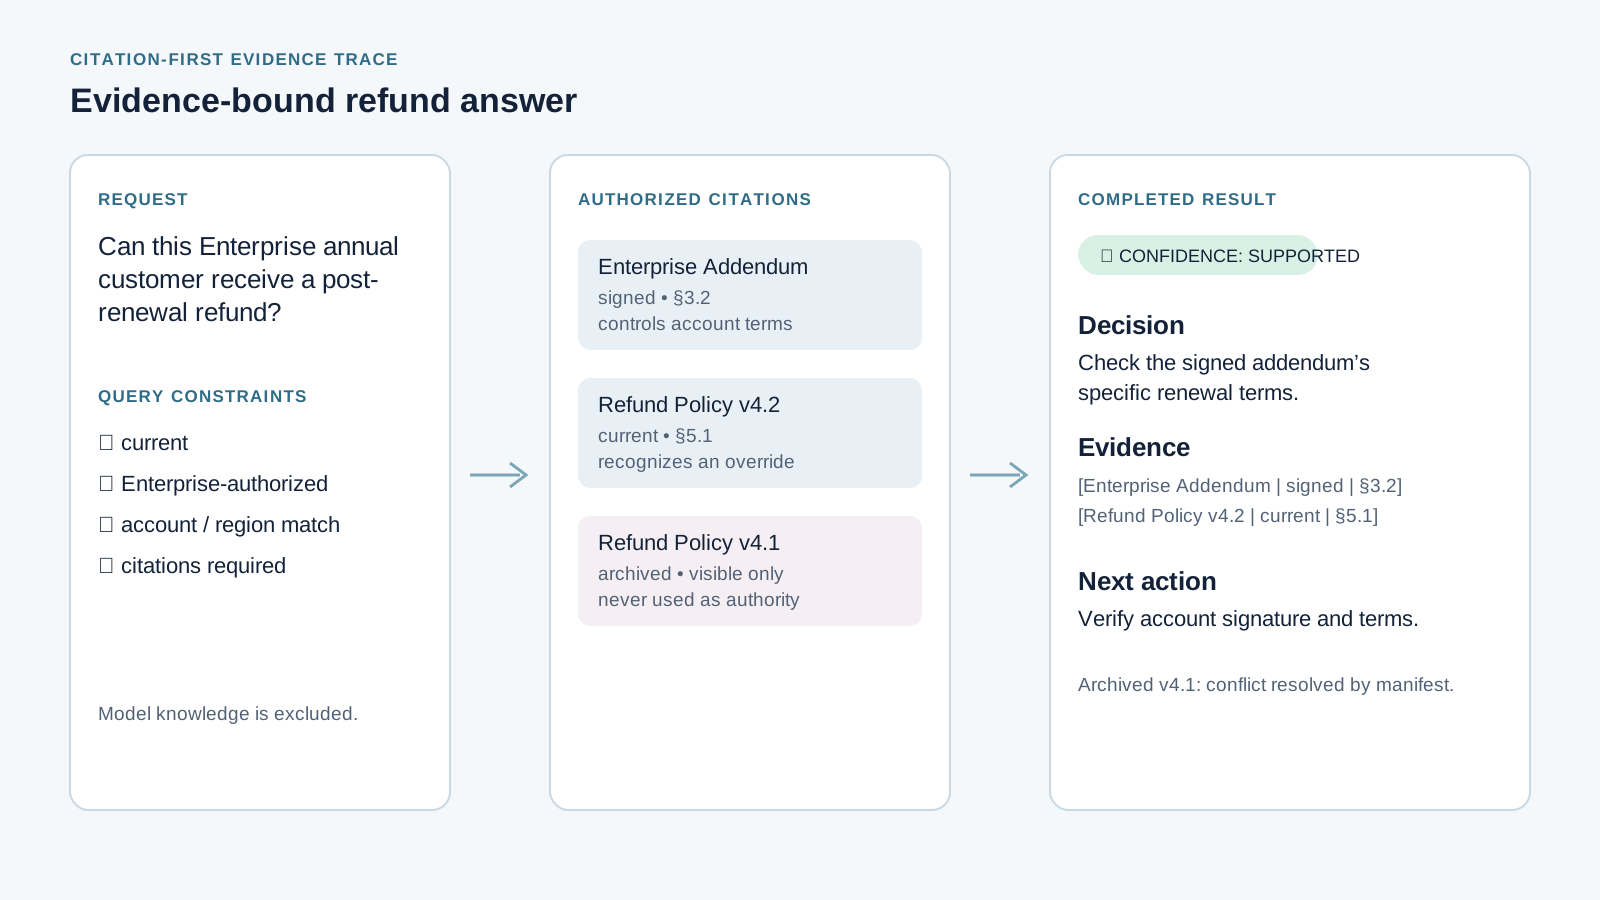
현재 정책 인용이 포함된 증거 기반 환불 답변
주요 완료 결과: v4.2와 서명된 부속 합의가 결정을 뒷받침하며, 보관된 문서는 해결된 충돌로만 표시됩니다.
4단계: 검색과 충실성을 분리 평가
답변이 문서를 인용하더라도 잘못된 조항을 적용할 수 있습니다. 검색 재현율과 주장 충실성을 별도로 점수화하십시오. 그러면 제품, 지원, 법무 담당자가 방어할 수 있는 릴리스 결정이 만들어집니다.
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
설정: 단순, 일반, 충돌, 무응답, 고위험 사례별로 4개씩 총 20개 질문으로 골든 세트를 만드십시오. 고위험 및 충돌 질문은 높은 추론 수준을 유지하십시오. 기준선을 통과한 후에는 저위험 작업에 대해서만 낮은 노력을 벤치마킹하십시오.
완료 기준: 세트에 올바른 문서를 검색했지만 잘못된 조항을 적용한 실패 사례와 올바른 답변 보류 사례가 포함됩니다. 인간 검토자는 뒷받침된 고위험 답변을 표본 추출합니다.
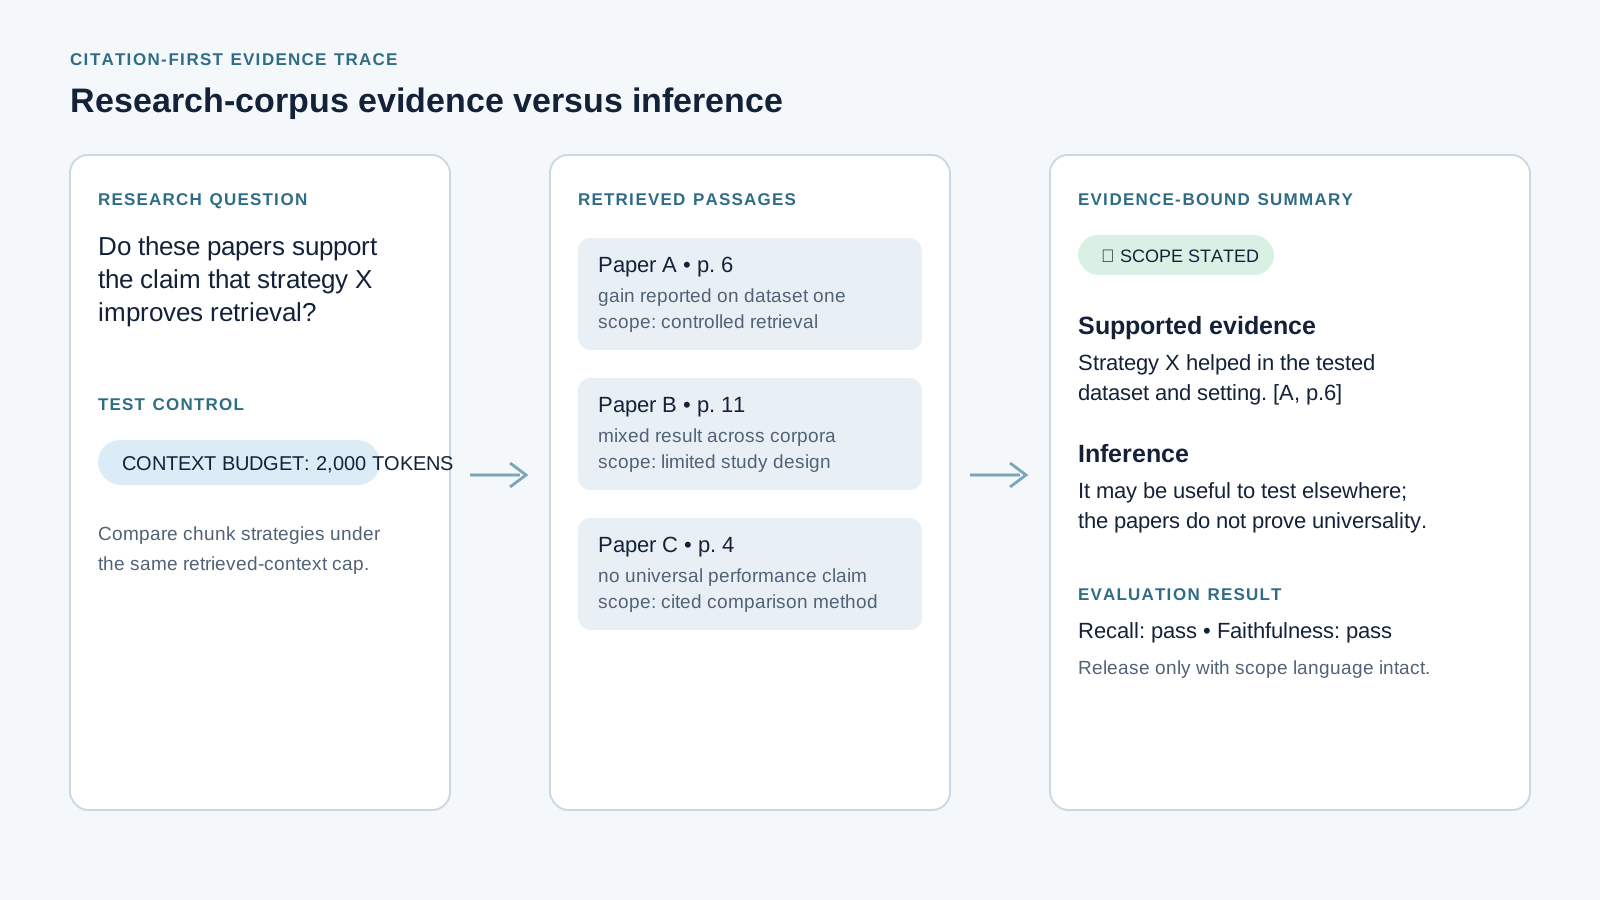
2,000 토큰 예산에서 지원과 추론을 비교하는 연구 코퍼스 증거 추적
사례 3. 연구 코퍼스 답변은 세 논문이 명시적으로 지지하는 내용과 추론을 분리합니다. 검색 비교는 컨텍스트 예산을 2,000 토큰으로 유지합니다.
증거를 잃지 않고 GPT-6 Astra 지식 베이스 확장
파일럿 패턴은 도메인에 따라 달라집니다. 증거 추적은 유지하되, 권한 소스와 거부 경계는 작업에 맞게 구체화하십시오.
| 파일럿 | 권한 소스 | 필수 메타데이터 | 거부 또는 에스컬레이션 시점 | 인간 릴리스 게이트 |
|---|---|---|---|---|
| 엔터프라이즈 환불 정책 | 서명된 부속 합의, 현재 정책 | 계정, 지역, 발효일, 상태 | 부속 합의 누락 또는 현재 소스 충돌 | 지원 및 정책 담당자 |
| P1 사고 런북 | 현재 런북 및 에스컬레이션 매트릭스 | 서비스, 심각도, 담당자, 최종 훈련 | 조치에 담당자 또는 현재 런북 부재 | 사고 지휘관 |
| 연구 코퍼스 | 인용된 논문 구절 | DOI, 페이지, 게시일, 방법 | 결론이 증거를 초과 | 주제 전문 검토자 |
코드 및 내부 규칙 라이브러리의 경우 AGENTS.md, 아키텍처 결정, 현재 배포 절차, 폐기된 스크립트에 명시적 순위를 부여하십시오. 연구의 경우 "증거"와 "추론"을 다른 필드로 반환하십시오. 고객 지원의 경우 제품, 지역, 발효일 필터가 신뢰성 작업의 대부분을 처리합니다.
비용 및 라우팅 체크리스트. 입력 20K 토큰, 출력 2K 토큰인 고위험 답변은 GPT-6 Astra 텍스트 토큰 기준 약 $0.30입니다: 20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000. 여기에는 File Search 및 기타 도구 비용이 제외되며, 출시 전에 현재 콘솔에서 확인해야 합니다. 272K 토큰을 초과하는 입력은 모델 가격이 더 높으므로 1M 토큰 프롬프트는 일상 경로가 되어서는 안 됩니다.
| 작업 위험 | 추론 노력 | 증거 규칙 | 인간 검토 |
|---|---|---|---|
| 태그 및 라우팅 | 낮추기 전에 벤치마크 | 메타데이터 전용 | 표본 추출 |
| 일반 지원 | 테스트 후 중간 또는 높음 | 현재 인용 소스 | 예외 큐 |
| 충돌, 정책, 사고 | 높음 | 모든 주장 소스 연결 | 필수 |
| 법률, 의료, 금융, 인사, 개인정보 | 높음 | 불완전하면 보류 | 조치 전 필수 |
비용 통제는 상류에서 시작하십시오. 오래되고 소유자 없는 파일을 제거하고, 검색 전에 메타데이터를 필터링하고, 가치 높은 질문을 먼저 테스트하고, 매니페스트·검색 구절·모델 버전·릴리스 결정을 보존하십시오. 이후 다중 모델 경로가 필요한 팀은 자체 파일럿 결과와 함께 현재 LLM API 문서를 검토할 수 있습니다.
규제 대상, 비공개, 고용, 건강, 금융, 생산 사고 콘텐츠의 경우 검색 전에 접근 필터링을 적용하고, 데이터 처리 및 보존 조건을 확인하고, 철회 경로를 유지하며, 불완전한 증거는 책임 있는 인간에게 라우팅하십시오. 그러한 맥락에서 유창한 응답은 결코 최종 조언이 아닙니다.
자주 묻는 질문
1M 토큰 컨텍스트 창이 RAG의 필요성을 없애나요?
아니요. 조사자가 더 큰 자료를 읽는 데는 도움이 될 수 있지만, 문서 권한, 사용자 접근 권한, 최신성, 인용 정확성, 릴리스 테스트를 확립하지는 못합니다. 일상적인 증거 선택에는 검색을 사용하고, 넓은 컨텍스트는 예외 조사용으로 남겨 두십시오.
GPT-6 Astra 지식 베이스에 절대 넣지 말아야 할 것은 무엇인가요?
소유자 없는 파일, 날짜 없는 정책, 명시적 초안 워크플로가 없는 초안, 요청자가 볼 권한이 없는 콘텐츠, 역사적 사용 규칙이 없는 보관 자료는 포함하지 마십시오. 그러한 파일은 검토로 보내거나 일반 검색 외부에 보관하십시오.
서로 충돌하는 최신 문서 두 개는 어떻게 처리해야 하나요?
ESCALATE를 반환하고, 충돌을 명명하고, 두 인용을 모두 보존하고, 담당자를 지정하십시오. 모델이 조용히 타이브레이커를 만들어서는 안 됩니다. 다음 릴리스 전에 매니페스트에 문서화된 규칙이 필요합니다.
GPT-6 Astra 지식 베이스에 가장 적합한 청크 크기는 무엇인가요?
보편적인 숫자는 없습니다. 의미 있는 정책 제목과 조건을 보존한 다음 동일한 컨텍스트 예산에서 전략을 비교하십시오. 고정된 top-k는 실제 검색 토큰 예산을 훨씬 크게 숨겨 실험 결과가 실제보다 좋아 보이게 만들 수 있습니다.
답변이 올바른 출처에 근거했음을 어떻게 입증하나요?
각 골든 질문의 기대 소스, 검색된 구절, 최종 원자적 주장, 그리고 재현율·인용 정확성·충실성·충돌 처리·보류에 대한 검토자 점수를 저장하십시오. 고위험 답변의 경우 뒷받침 링크 누락은 실패입니다.
GPT-6 Astra 지식 베이스 비용은 얼마인가요?
토큰 공식을 사용한 다음 현재 File Search 및 도구 비용을 더하십시오. 위 예시의 경우 입력 20K, 출력 2K는 모델 토큰 기준 약 $0.30입니다. 실제 절감은 오래된 자료를 제외하고 증거가 중요한 곳에서 높은 추론을 사용할 때 발생합니다. 이것이 gpt-6 astra knowledge base best practices의 지속 가능한 버전입니다.


