우리는 Grok Imagine Image와 GPT Image-2 모델을 구성 의미론, 사실적인 해부학, 다국어 텍스트 렌더링, 기하학적 변환, 로컬 편집, 다중 참조 융합을 포함한 6개의 동일한 모델 중립 프롬프트로 테스트했습니다.
두 모델 Grok Imagine Image와 GPT Image-2는 단일 Atlas Cloud API 키를 통해 사용할 수 있어, 이 정확한 벤치마크를 몇 분 안에 재현할 수 있습니다.
이 AI 이미지 모델 비교 벤치마크가 존재하는 이유
온라인에서 찾을 수 있는 모든 "AI 이미지 모델 비교"는 같은 함정에 빠집니다: 엄선된 프롬프트, 최고 5개 중 선택한 출력, 검증되지 않은 주장. 이 벤치마크는 Tier A 원칙을 기반으로 구축되었습니다: 모델 중립적 프롬프트, 모든 모델에 동일한 입력, 단일 시드 기본 출력 (엄선 없음), 각 카테고리당 한 문장으로 설명할 수 있는 채점 기준.
전체 벤치마크 실행의 6개 모델: Grok, GPT Image 2, Nano Banana 2, Nano Banana Pro, Wan 2.7, Seedream 5.0. 이 글은 Grok 대 GPT Image 2의 직접 비교에 초점을 맞춥니다. 개발자가 기본 이미지 모델을 선택할 때 가장 상업적으로 관련성이 높은 쌍이기 때문입니다.
Grok Imagine Image와 GPT-Image 2를 테스트한 방법: 6개 카테고리, 하나의 Tier A 규칙
모든 프롬프트는 단일하고 명확하게 명시된 능력 차원을 대상으로 합니다. 합격/불합격 기준은 모델 실행 전에 정의되었으며, 출력을 본 후에 정의되지 않았습니다.
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| 카테고리 | 테스트된 주요 차원 | 한 문장 합격/불합격 |
|---|---|---|
| Cat 1 · 구성 의미론 | 명령어 정렬 | 모델이 7개의 물체를 정확히 세고, 올바르게 배치했으며, 부정 목록을 준수했습니까? |
| Cat 2 · 사실적인 해부학 및 조명 | 시각적 품질 및 물리 | 5개의 손가락이 해부학적으로 올바르며, 얼굴에 초점성 빛 패턴이 나타납니까? |
| Cat 3 · 다국어 포스터 | 이미지 내 텍스트 렌더링 | 중국어 및 영어 문자가 누락된 획이나 환각 문자 없이 올바르게 렌더링되었습니까? |
| Cat 4 · 기하학적 변환 (I2I) | 편집 제어 가능성 + 정체성 | 45° 회전 후에도 동일 인물로 인식 가능하며 모든 의복 세부 정보가 유지됩니까? |
| Cat 5 · 로컬 편집 및 영역 보존 | 편집 정밀도 | 정확히 3개의 편집이 이루어졌으며, 다른 모든 것은 픽셀 수준에서 변경되지 않았습니까? |
| Cat 6 · 다중 참조 융합 | 교차 이미지 일관성 | 3개의 별도 참조 이미지의 정체성, 스타일, 장면이 하나의 일관된 이미지로 병합됩니까? |
직접 GPT Image 2와 Grok Imagine을 동일한 프롬프트로 테스트하고 싶으신가요? Atlas Cloud의 모델 비교는 한 번에 나란히 실행합니다 — 동일한 프롬프트, 생성 전에 가격 표시 — 프레임별로 비교할 수 있습니다.
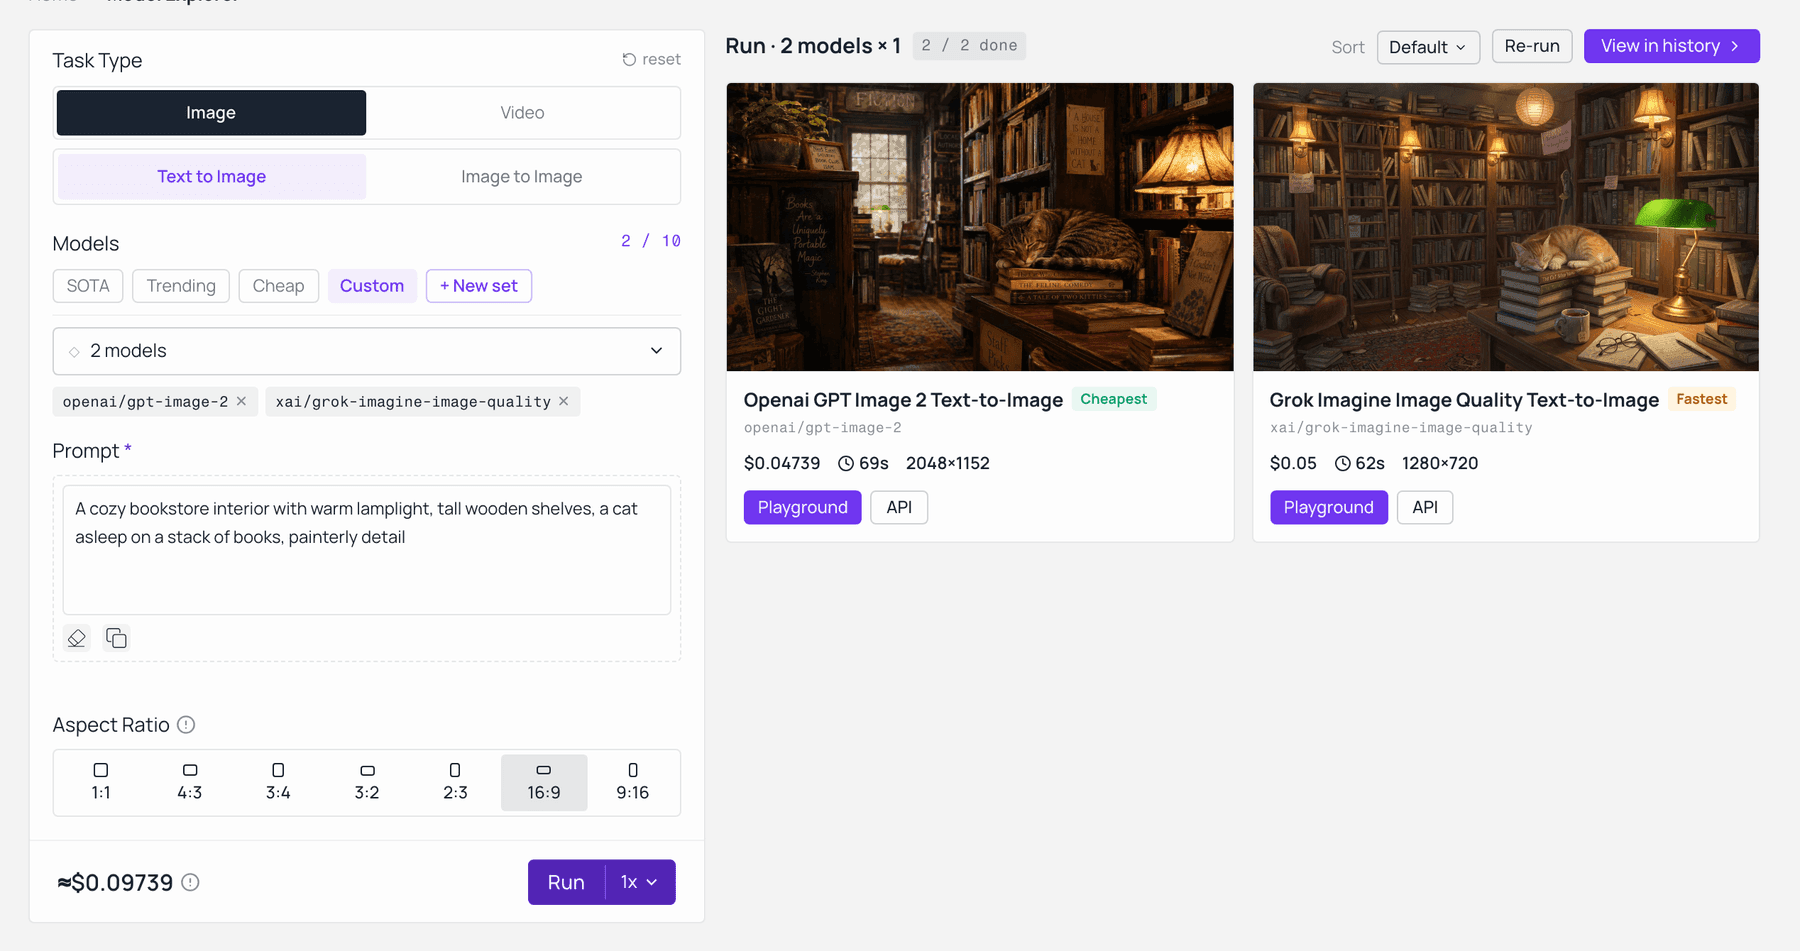
GPT Image 2와 Grok Imagine이 Atlas Cloud의 모델 비교에서 동일한 프롬프트로 실행 중 — 동일한 프롬프트, 생성 전에 가격 표시. 모델 탐색기에서 실시간 캡처.
Cat 1 · 구성 의미론 (T2I)
프롬프트:
나무 식탁 위를 위에서 내려다본 평면 사진으로, 정확히 7개의 세라믹 물체가 포함됨: 세 개의 동일한 흰색 찻잔이 중앙에 정삼각형으로 배열, 두 개의 검은색 그릇이 찻잔의 오른쪽에 위치, 하나의 빨간 사과가 왼쪽 검은색 그릇 안에 들어 있음, 하나의 빈 나무 숟가락이 오른쪽 검은색 그릇 위에 놓여 있고 손잡이가 프레임의 왼쪽 위 모서리를 향함. 커피잔 없음, 금속 물체 없음, 접시 없음, 유리 제품 없음. 왼쪽 위에서 오는 부드러운 확산 창문 빛, 오전 중반. 사실적인 사진, 스타일링 소품 없음.
이것은 의도적으로 적대적입니다. 개수 세기, 공간 언어("오른쪽에", "왼쪽에 있는"), 부정 절은 현재 모든 확산 기반 아키텍처의 알려진 실패 모드입니다.
점검 목록
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
| 1 | 총 물체 개수 | 정확히 7개의 세라믹 물체 |
| 2 | 세 개의 흰색 찻잔 | 정삼각형 배열 |
| 3 | 두 개의 검은색 그릇 | 찻잔의 오른쪽에 위치 |
| 4 | 빨간 사과 | 왼쪽 검은색 그릇 안에 있음 |
| 5 | 나무 숟가락 | 오른쪽 그릇 위에 놓여 있고, 손잡이가 왼쪽 위를 향함 |
| 6 | 부정 명령 준수 | 커피잔 없음 / 금속 없음 / 접시 없음 / 유리 제품 없음 |
| 7 | 광원 | 왼쪽 위에서 오는 부드러운 확산광, 모든 그림자 일관됨 |
| 8 | 사진 스타일 | 스타일링 클리셰 없음 (야자 잎, 양초 등) |
 Grok Imagine Image
 GPT-Image 2
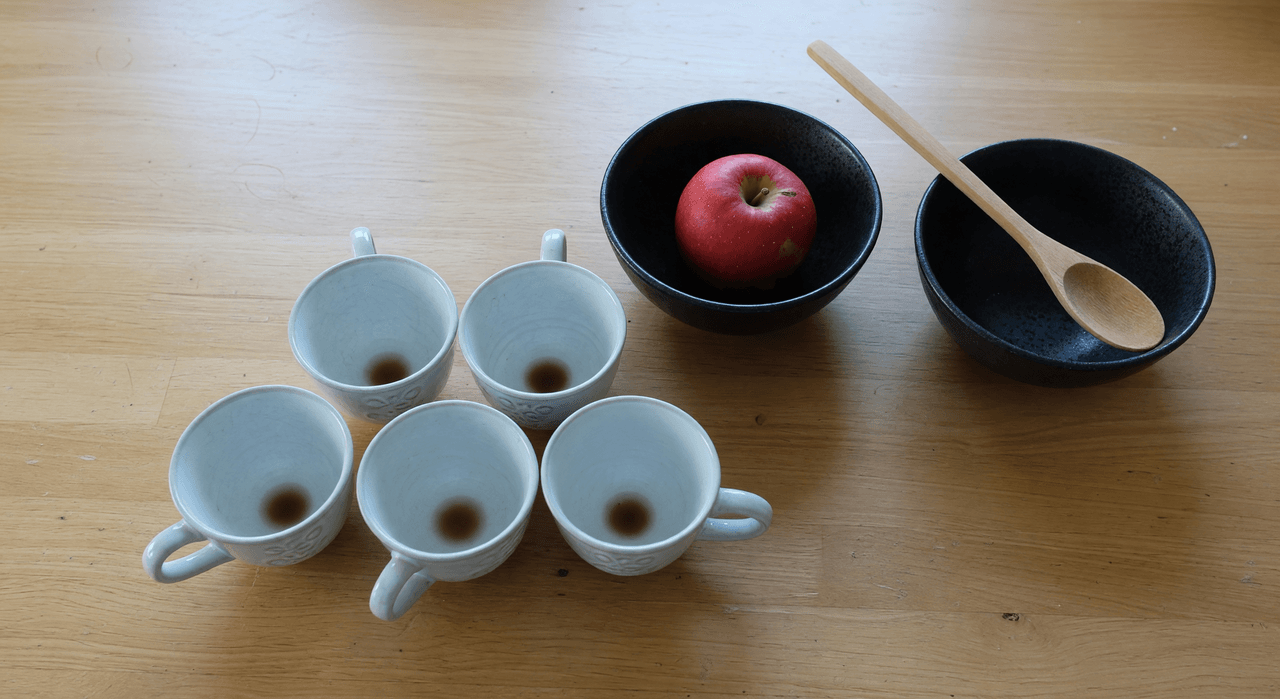
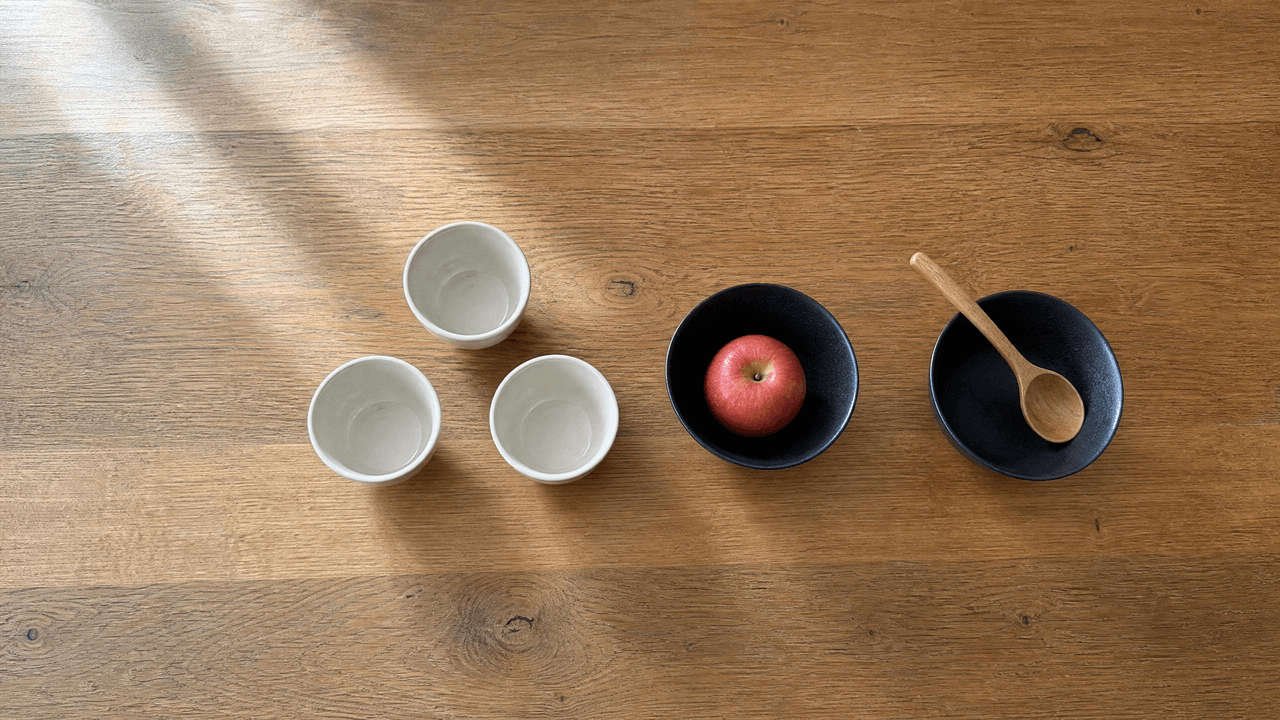
요구사항: 위에서 내려다본 평면 사진, 정확히 7개의 세라믹 그릇, 명확한 공간 관계: 세 개의 흰색 찻잔이 중앙에 정삼각형으로 배열, 두 개의 검은색 그릇이 찻잔 오른쪽, 빨간 사과가 왼쪽 검은색 그릇 안, 나무 숟가락이 오른쪽 검은색 그릇 위에 놓여 있고 손잡이가 왼쪽 위를 향함. 부정 명령: 커피잔, 금속 기구, 접시, 유리 제품 없음.
Grok Imagine 물체 개수: 눈에 보이는 찻잔 5개 (3개 아님), 정삼각형이 아닌 군집 배열. 두 개의 검은색 그릇은 존재하며, 빨간 사과가 그 중 하나 안에 올바르게 들어 있음. 나무 숟가락은 존재하고 오른쪽 그릇 위에 놓여 있으며, 손잡이 방향은 대략 왼쪽 위 — 이 기준은 통과. 부정 명령 준수: 커피잔 없음, 금속 없음, 접시 없음, 유리 제품 없음. 왼쪽 위에서 오는 광원과 일관된 그림자 통과. 스타일링 소품 없음.
GPT Image 2는 공간 구성 요소에 대한 명령어 수행에서 더 강력함을 보였지만, 두 모델 모두 모든 배치 제약 조건을 동시에 충족하는 완벽한 7개 물체 개수를 달성하지 못했습니다.
Cat 2 · 사실적인 해부학 및 조명 (T2I)
프롬프트:
30대 초반의 동아시아 여성 근접 촬영 초상화, 오른손에 반쯤 찬 레드 와인 크리스탈 와인잔을 들고 있음, 다섯 손가락과 엄지가 모두 보이며 손잡이와 잔 일부를 자연스럽게 감싸고 있음. 그녀는 황금 시간대에 서쪽을 향한 큰 창문 옆에 앉아 있음. 늦은 오후 햇빛이 와인을 통과하여 왼쪽 광대뼈와 턱선에 따뜻한 진홍색 초점성 패턴을 만듦. 왼손은 무릎 위에 펼쳐진 하드커버 책 위에 놓여 있음. 두 눈에 창문에서 오는 캐치라이트가 보임. 피부는 극도로 세밀한 모공, 가는 복숭아 솜털, 귓불과 코 다리의 서브서피스 스캐터링을 보여줌. 머리카락은 역광으로 림 라이트가 있음. 85mm 렌즈, f/2.0, 얕은 피사계 심도, 사진적 사실감.
이것은 역사적으로 생성 모델에 가장 어려운 단일 이미지 테스트입니다.
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
|---|---|---|
| 1 | 손 해부학 | 5개의 손가락 + 엄지, 손잡이와 잔을 자연스럽게 쥐고 있음 |
| 2 | 초점성 빛 | 와인에서 나온 따뜻한 진홍색 패턴이 광대뼈에 투영됨 |
| 3 | 캐치라이트 일관성 | 두 눈에서 동일한 위치와 모양 |
| 4 | 서브서피스 스캐터링 (SSS) | 역광일 때 귓불과 코 다리에서 보임 |
| 5 | 림 라이트 물리 | 방향이 광원 위치와 일치 |
| 6 | 피부 사실감 | "AI 플라스틱" 과도한 스무딩 없음; 모공과 복숭아 솜털이 보임 |
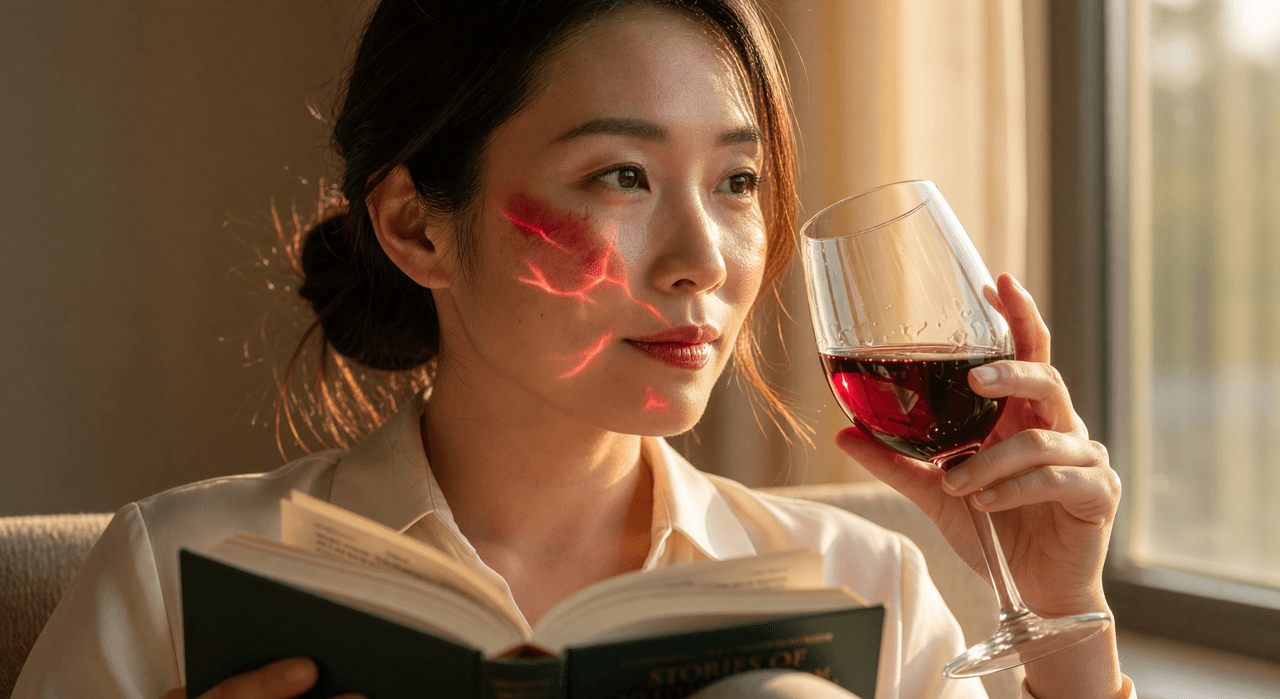 Grok Imagine Image
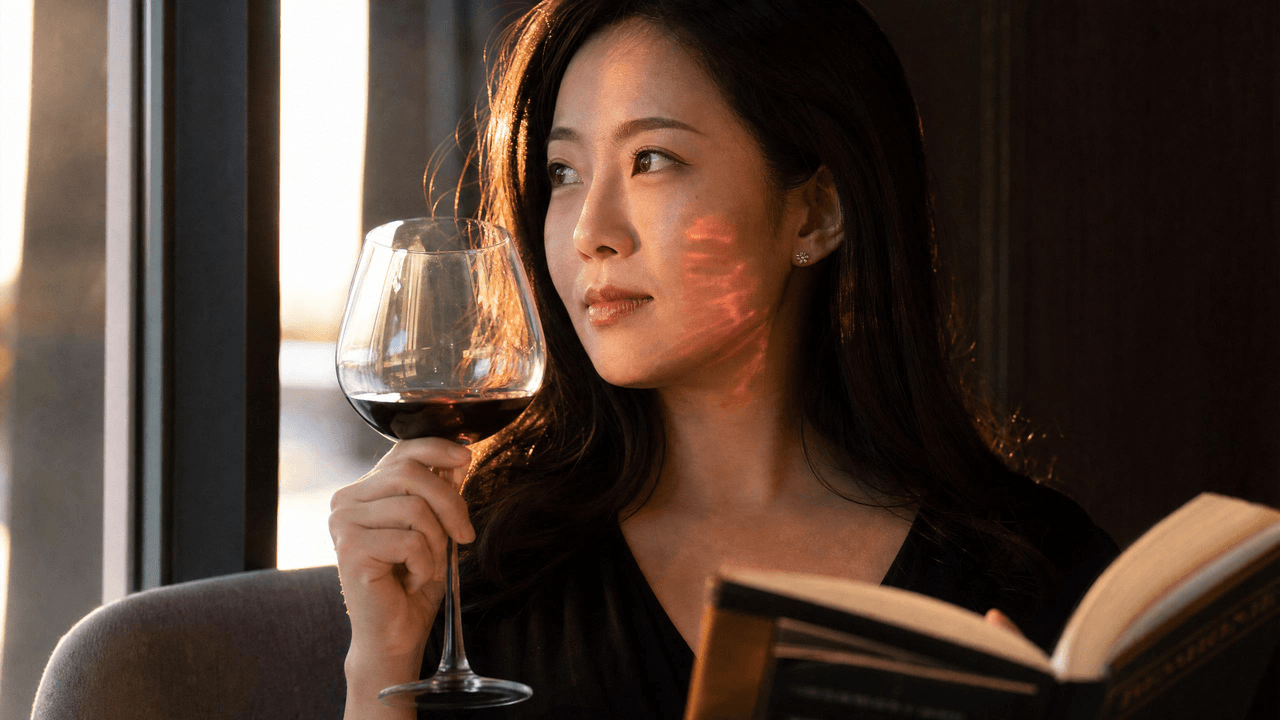 GPT-Image 2
Grok Imagine은 강점에서 뛰어난 성과를 보였습니다. 손 해부학이 정확했습니다 — 손가락 개수 정확, 손잡이와 잔 주변의 쥐는 자세가 자연스럽고, 손목 각도가 물리적으로 타당했습니다. 이 자체로 많은 모델이 실패하는 기준을 통과했습니다. 피부 질감은 진정한 모공 수준의 디테일과 가는 복숭아 솜털이 보였고 플라스틱 과도한 스무딩이 없었으며, 코 다리와 광대뼈의 서브서피스 스캐터링은 따뜻하고 빛이 투과되는 듯한 질감을 제공하여 사진적으로 사실적으로 읽혔습니다. 머리카락의 림 라이트는 창문 광원 방향과 일관되게 따랐습니다.
초점성 빛 투영은 Grok의 가장 약한 점이었습니다. 진홍색 빛 패턴이 얼굴에 나타났지만, 과도하게 크고 극적으로 스타일화된 빨간색 오버레이로 렌더링되었습니다 — 마치 컬러 그레이드 효과처럼 보였고, 햇빛이 와인을 통과할 때 물리적으로 생성되는 섬세하고 부드러운 가장자리의 빛 필라멘트와는 달랐습니다. 초점성 빛의 물리적 타당성은 정밀도 기준에 실패했습니다.
GPT Image 2는 그 반대의 트레이드오프를 보였습니다. 초점성 빛 렌더링은 눈에 띄게 더 물리적으로 정확했습니다 — 광대뼈의 따뜻한 진홍색 패턴이 더 작고 더 확산되었으며, 와인잔을 통과하는 빛의 공간 기하학을 올바른 각도로 따랐습니다. 이것이 Grok이 놓친 세부 사항입니다. 그러나 GPT Image 2는 다른 곳에서 대가를 치렀습니다: 손 해부학이 약간 덜 자연스러웠고, 손잡이 주변의 손가락 각도가 약간 뻣뻣함을 보였습니다. 피부 질감은 AI 초상화에서 흔히 볼 수 있는 더 매끄럽고 약간 평평한 품질에 가까웠으며, Grok에 비해 덜 보이는 SSS 온기와 약한 림 라이트 강도를 보였습니다.
Cat 3 · 다국어 포스터 (T2I)
프롬프트:
가상의 영화제를 위한 1960년대 스타일의 빈티지 여행 포스터, 중세기 상업 디자인 스타일로 그림. 포스터 상단, 큰 굵은 세리프 중국어 문자 "时光电影节" (1행), 그 아래 더 작은 중국어 문자 "第七届 · 上海 · 1965年5月" (2행). 중앙: 약간 곡선인 영화 스크린에 빔을 비추는 오래된 영화 프로젝터의 양식화된 그림. 중앙 하단: 샴페인 쿠페 잔에 영어 텍스트 "GRAND OPENING NIGHT"가 잔의 곡률을 따라 타원형 원근으로 감싸져 있음. 오른쪽 가장자리, 세로 텍스트 "presented by 时代影业 · TIMES PICTURES"가 위에서 아래로 쓰여 있음. 하단 스트립: 작은 영어 크레딧 텍스트 "music · HUANG ZHAN / cinematography · GU CHANGWEI / poster design · ZHANG GUANGYU"가 한 줄로. 색 팔레트: 크림색 오프 화이트 배경, 진한 진홍색, 겨자색 악센트. 약간의 오래된 종이 질감, 미세한 입자.
점검 목록
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
|---|---|---|
| 1 | 중국어 정확성 | "时光电影节"에서 누락된 획이나 환각 문자 없음 |
| 2 | 이중 언어 배치 | 중국어와 영어가 혼합되지 않음; 각각 올바른 영역에 나타남 |
| 3 | 잔 위의 곡선 텍스트 | 영어가 샴페인 쿠페의 타원형 원근을 따름 |
| 4 | 오른쪽 가장자리 세로 텍스트 | 위에서 아래로 읽을 수 있음 |
| 5 | 타이포그래피 계층 | 헤드라인, 부제목, 각주 간 명확한 구분 |
| 6 | 스타일 대 가독성 | 1960년대 미학 유지, 텍스트 명확성 희생하지 않음 |
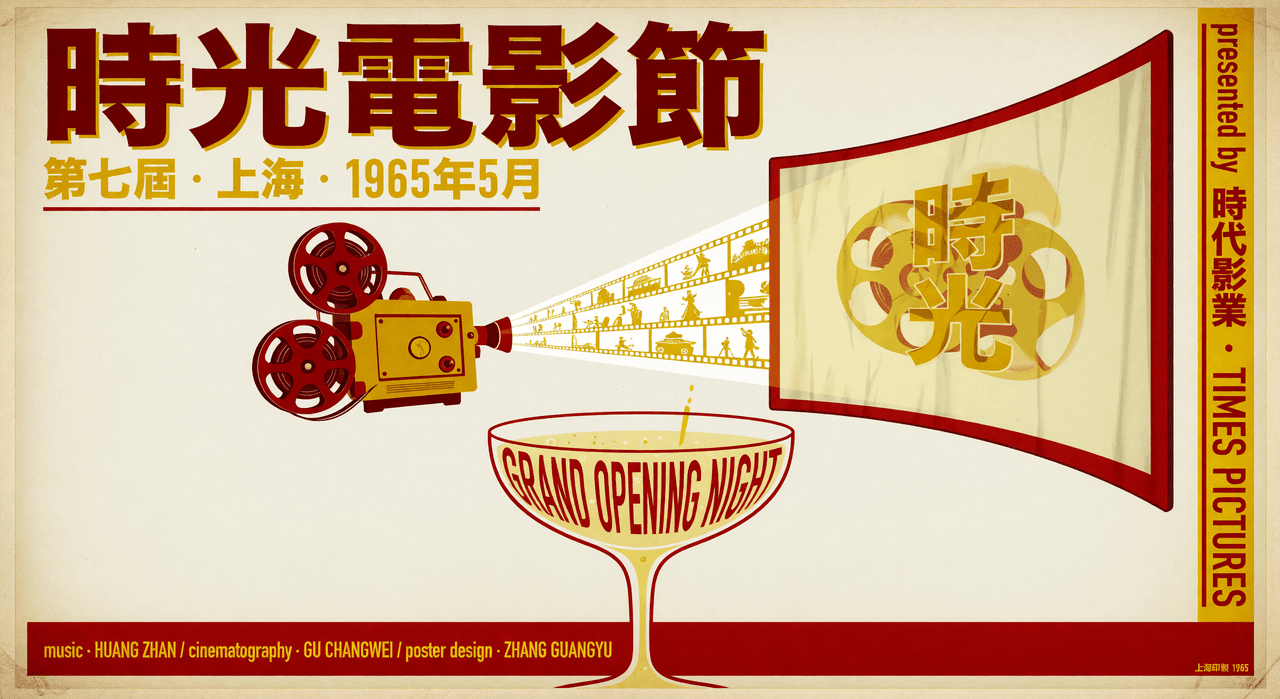 Grok Imagine Image
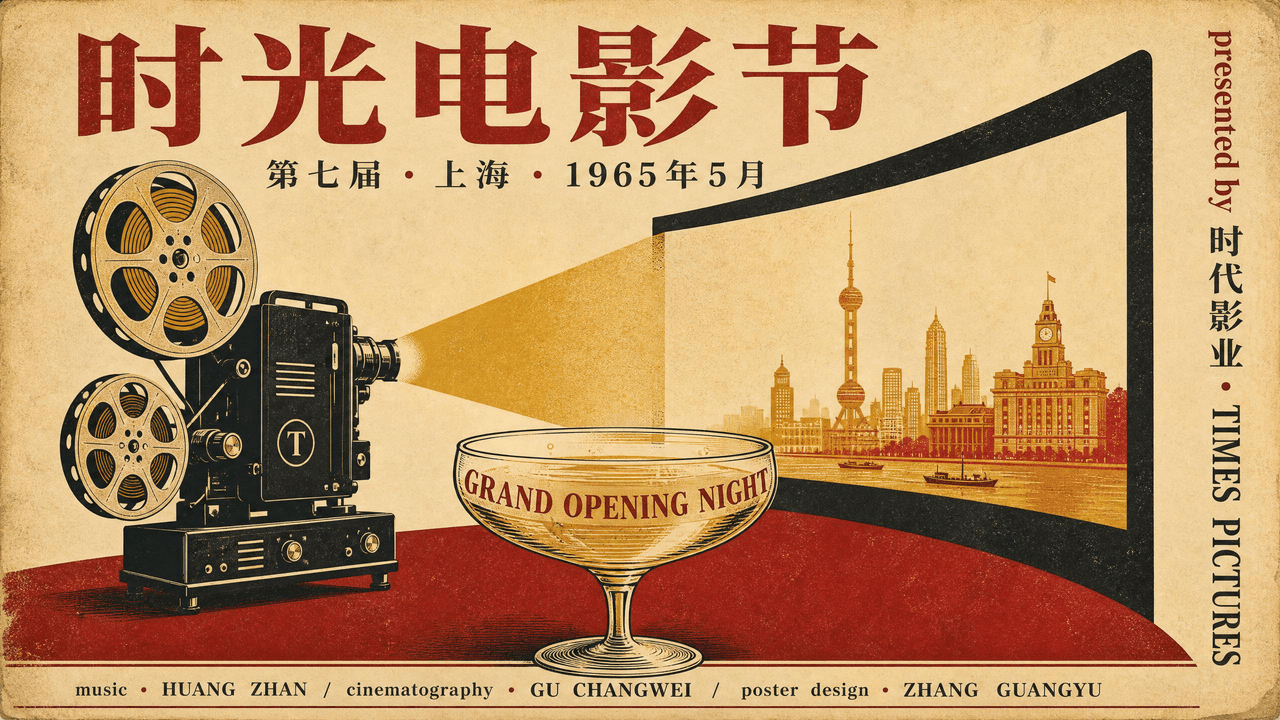 GPT-Image 2
Grok Imagine은 시각적으로 인상적이고 중세기 그림 에너지가 강한 포스터를 생성했습니다. 그러나 가장 중요한 텍스트 기준에 실패했습니다: 헤드라인은 "時光電影節"로 번체 중국어로 읽히며, 프롬프트에 지정된 간체 "时光电影节"가 아닙니다. 이는 문자 집합 준수 실패입니다 — 현지화나 출판 사용 사례에 중요한 차이입니다. 두 번째 줄 "第七屆 · 上海 · 1965年5月"도 마찬가지로 번체 문자를 사용했습니다. 구조적 측면에서 "GRAND OPENING NIGHT"가 샴페인 잔에 부분적인 곡선을 따라 나타났지만, 타원형 원근 준수는 근사치였습니다. 오른쪽 가장자리 세로 텍스트 "TIMES PICTURES"는 읽을 수 있었습니다. 하단 크레딧 줄이 존재하고 읽을 수 있었습니다. 색 팔레트 — 진홍색, 겨자색, 크림색 — 잘 실행되었습니다. 전체 레이아웃 에너지는 높았지만, 번체 대 간체 실패는 명시된 프롬프트에 대한 엄격한 실격 요인입니다.
GPT Image 2는 문자 집합 테스트를 깔끔하게 통과했습니다: 헤드라인 "时光电影节"과 부제목 "第七届 · 上海 · 1965年5月"가 간체 중국어로 올바르게 렌더링되었으며, 누락된 획이나 환각 문자가 없습니다 — Grok에 대한 직접적인 준수 승리입니다. 샴페인 쿠페 잔이 중앙 하단에 보이며 "GRAND OPENING NIGHT"가 잔의 곡률을 따라 설득력 있게 쓰여 있습니다. 오른쪽 가장자리 세로 텍스트 "时代影业 · TIMES PICTURES"가 위에서 아래로 쓰여 있고 완전히 읽을 수 있으며, 중국어와 영어가 혼합 오류 없이 동일한 세로 열에 올바르게 배치되었습니다. 하단 크레딧 줄 — "music · HUANG ZHAN / cinematography · GU CHANGWEI / poster design · ZHANG GUANGYU" — 한 줄로 존재하고 읽을 수 있습니다. 헤드라인, 부제목, 각주 간 타이포그래피 계층이 명확히 유지되었습니다. 오래된 종이 질감과 중세기 색 팔레트가 잘 구현되었습니다. 구성은 인식 가능한 상하이 스카이라인 실루엣을 중앙 그림으로 통합했으며, 이는 프롬프트에 명시되지 않았지만 기준을 깨지 않고 맥락적 정확성을 더합니다.
Cat 4 · 기하학적 변환 (I2I)
프롬프트는 모델이 전신 패션 룩북 피사체를 정확히 45° 왼쪽으로 회전시키고, 동일한 카메라 위치를 유지하도록 지시했습니다. 참조 이미지는 복잡한 겹쳐진 의상을 특징으로 했습니다: 긴 갈색 외투, 가죽 어깨 망토, 눈에 띄는 그라데이션(진한 갈색 → 은색 → 크림색)이 있는 모피 숄, 내장 초상화가 있는 원형 구리 가슴 배지, 검은색 가죽 건틀릿, 투톤 가죽 부츠. 이러한 세부 사항 중 어느 것도 프롬프트에 나열되지 않았습니다 — 모델은 정체성 이해만으로 이를 보존해야 했습니다.
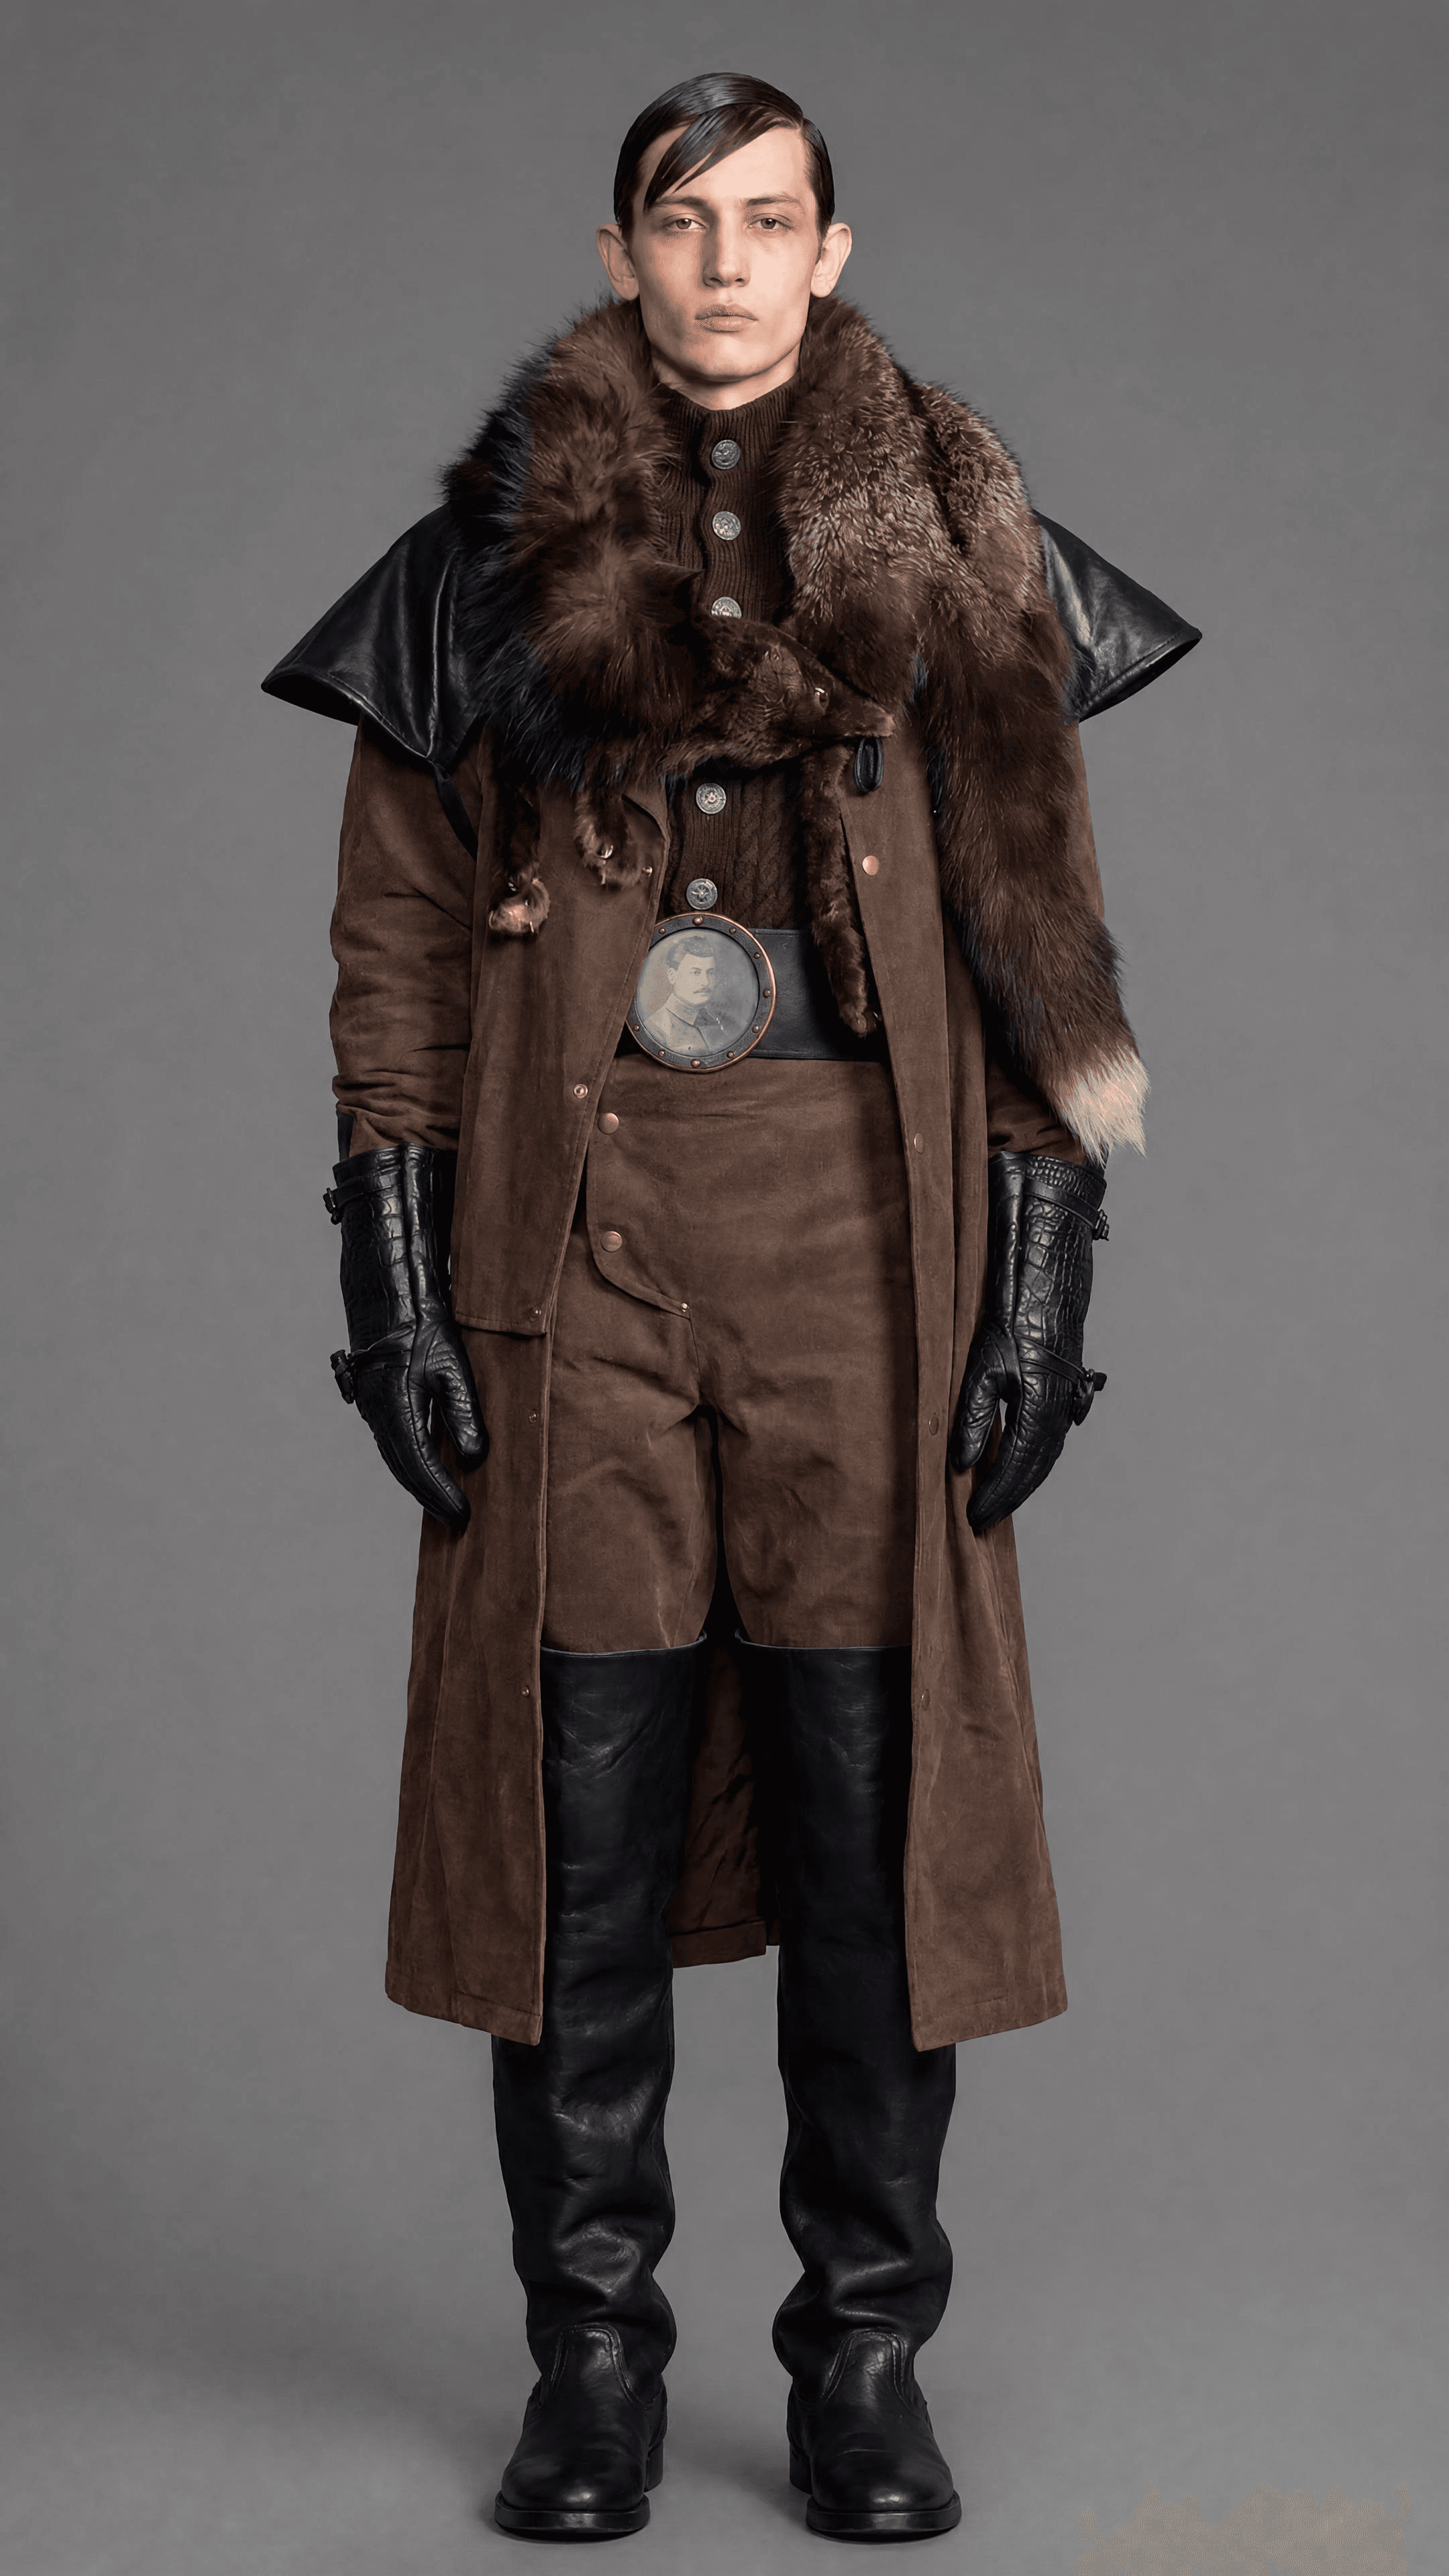
이것은 의도적인 능력 스트레스 테스트입니다. 지침은 의도적으로 짧아 모델에 자체 평가 기준을 제공하지 않도록 했습니다.
점검 목록
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
|---|---|---|
| 1 | 얼굴 정체성 | ArcFace 유사도 ≥ 0.5 (전신 스케일에 대해 완화) |
| 2 | 모피 숄 드러냄 | 이전에 숨겨진 오른쪽 은색 부분 |
| 3 | 가슴 배지 | 원형 구리 윤곽 + 내장 초상화 + 올바른 원근 타원 압축 |
| 4 | 코트 밑단 및 내부 레이어 | 회전 후 자연스러운 드레이프 방향; 내부 바지 노출 비율 적절 |
| 5 | 발 자세 | 왼쪽 앞 |
| 6 | 건틀릿 볼륨 | 손 위치 + 니트 질감이 회전 후에도 보임 |
| 7 | 부츠 색상 경계 | 갈색 상단과 검은색 하단의 명확한 구분 |
| 8 | 배경 일관성 | 순수 회색 스튜디오 배경 (DINO 영역 ≥ 0.95) |
| 9 | 출력 비율 | 전체 9:16 전신 프레임 유지, 초상화로 자르지 않음 |
| 10 | 시선 방향 | 회전을 따름 — 카메라를 계속 응시하지 않음 |
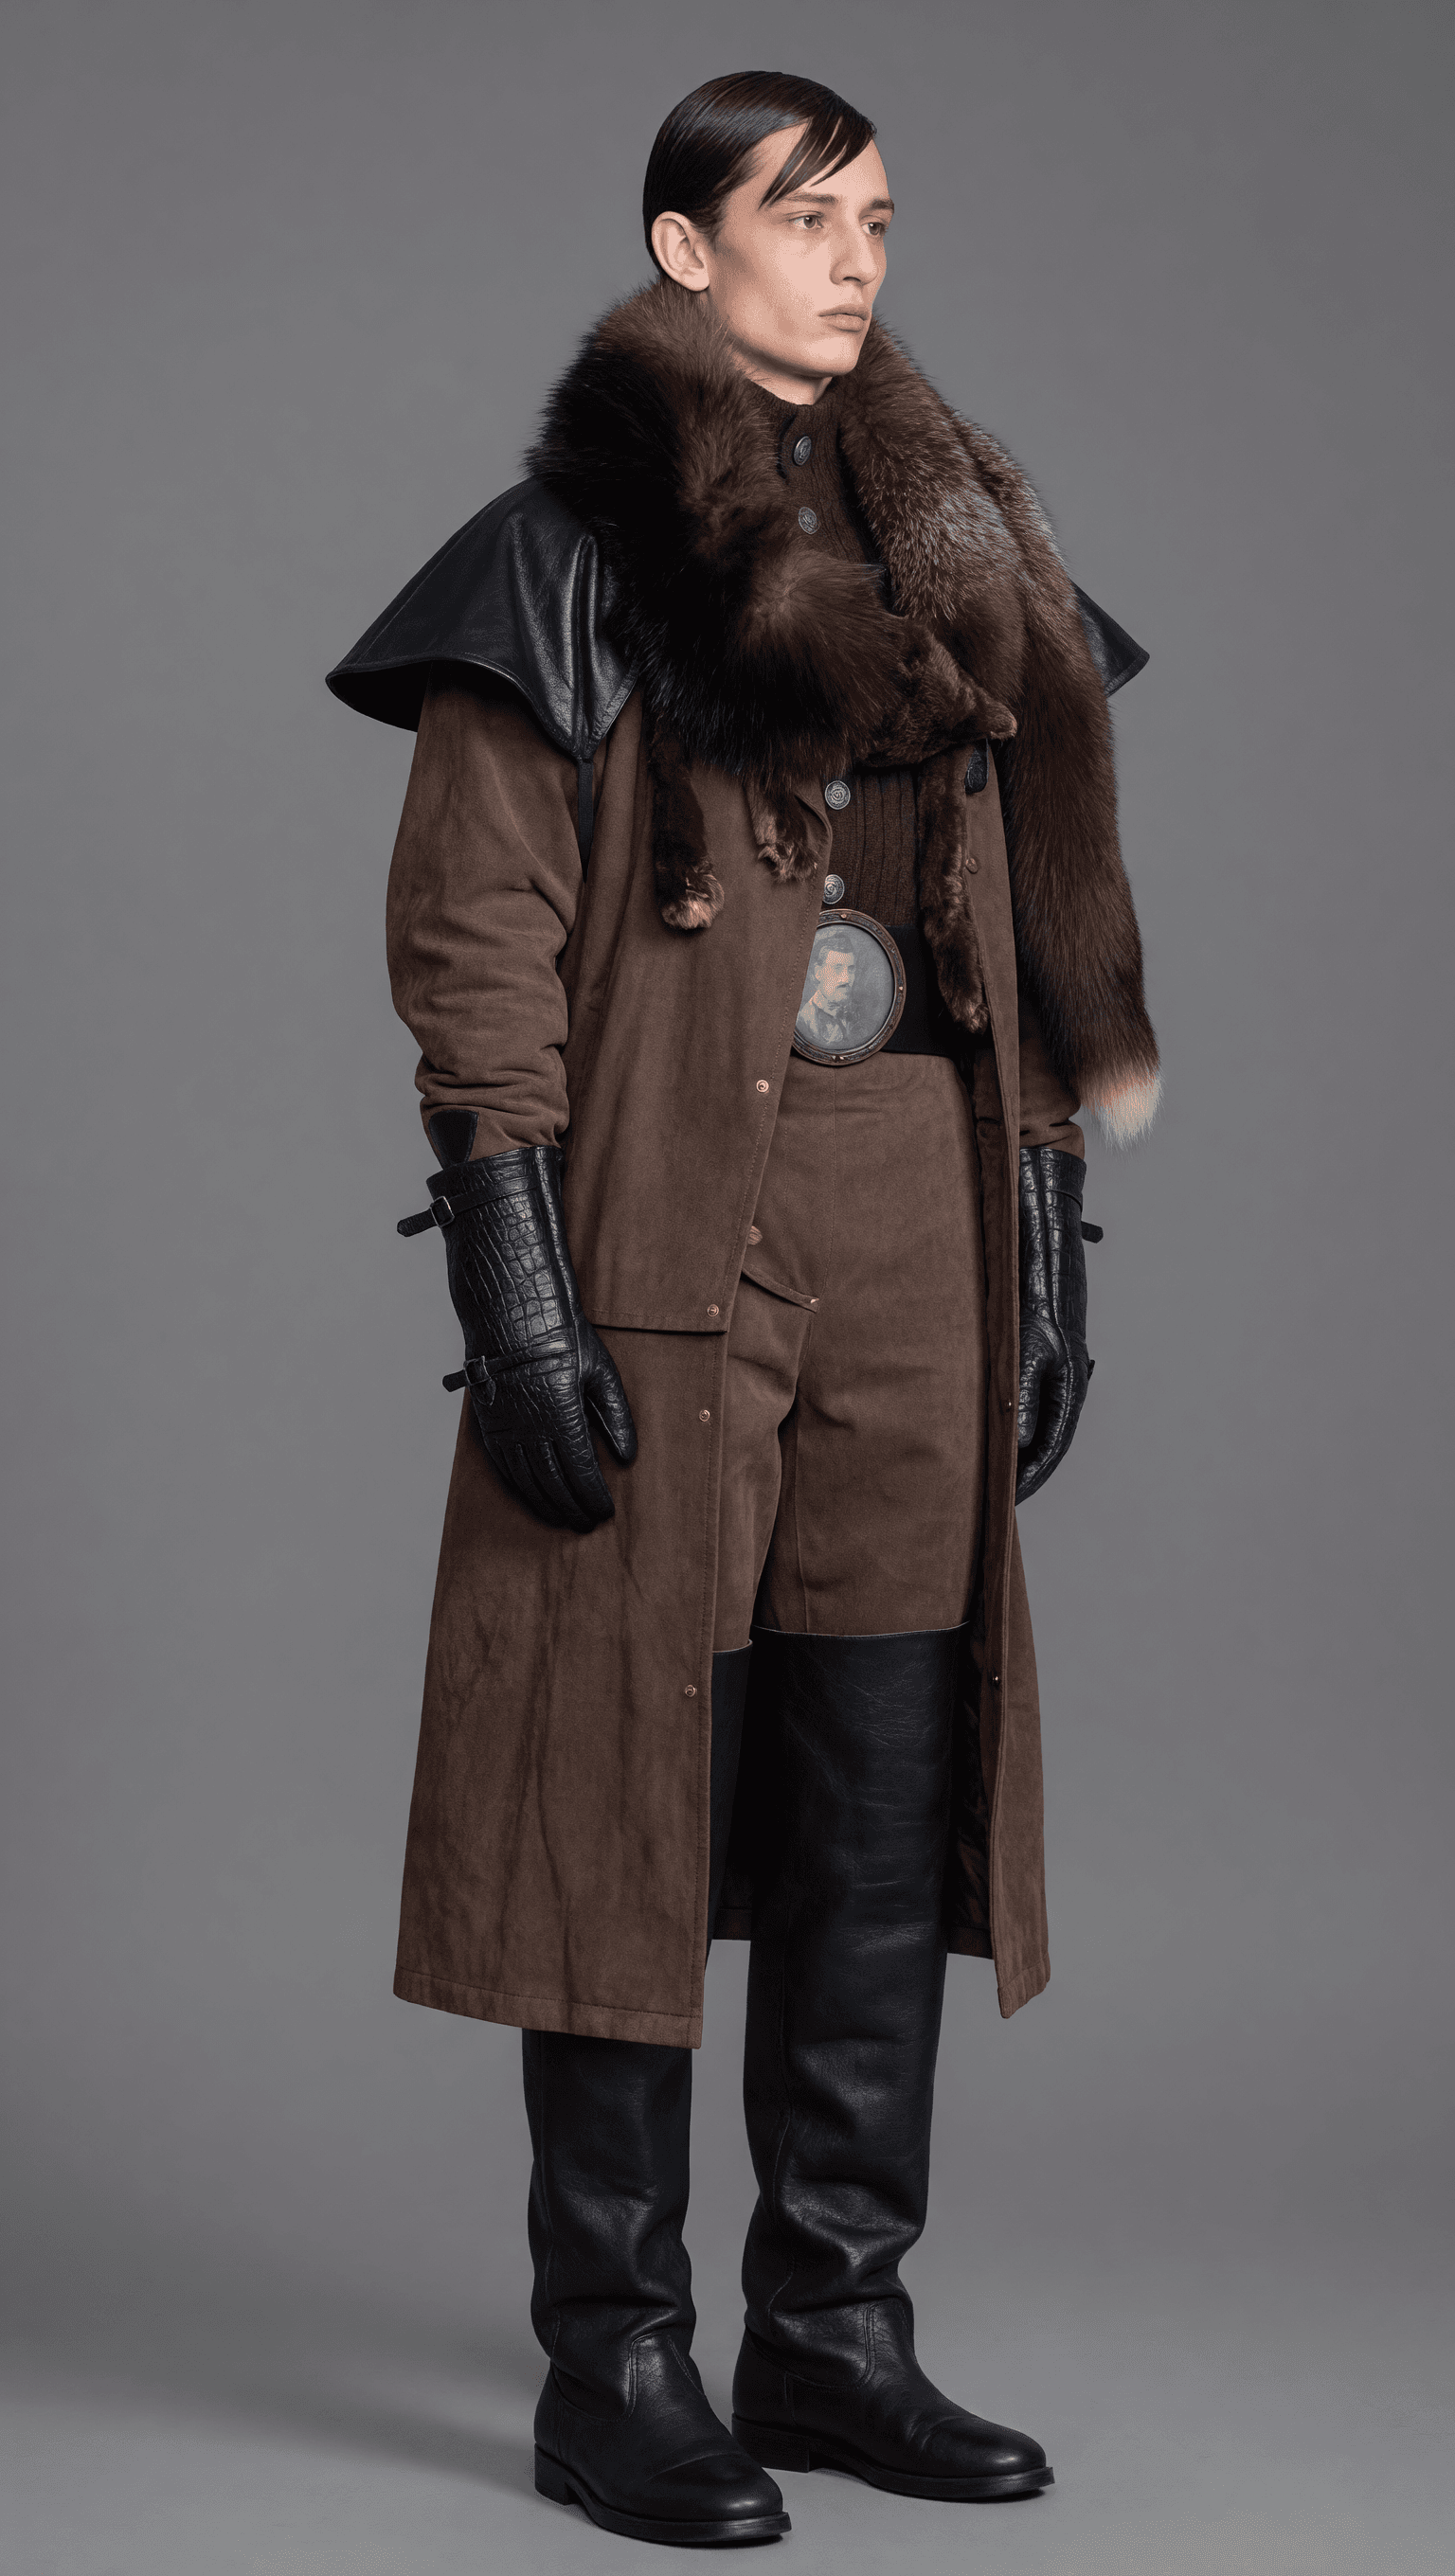 Grok Imagine Image
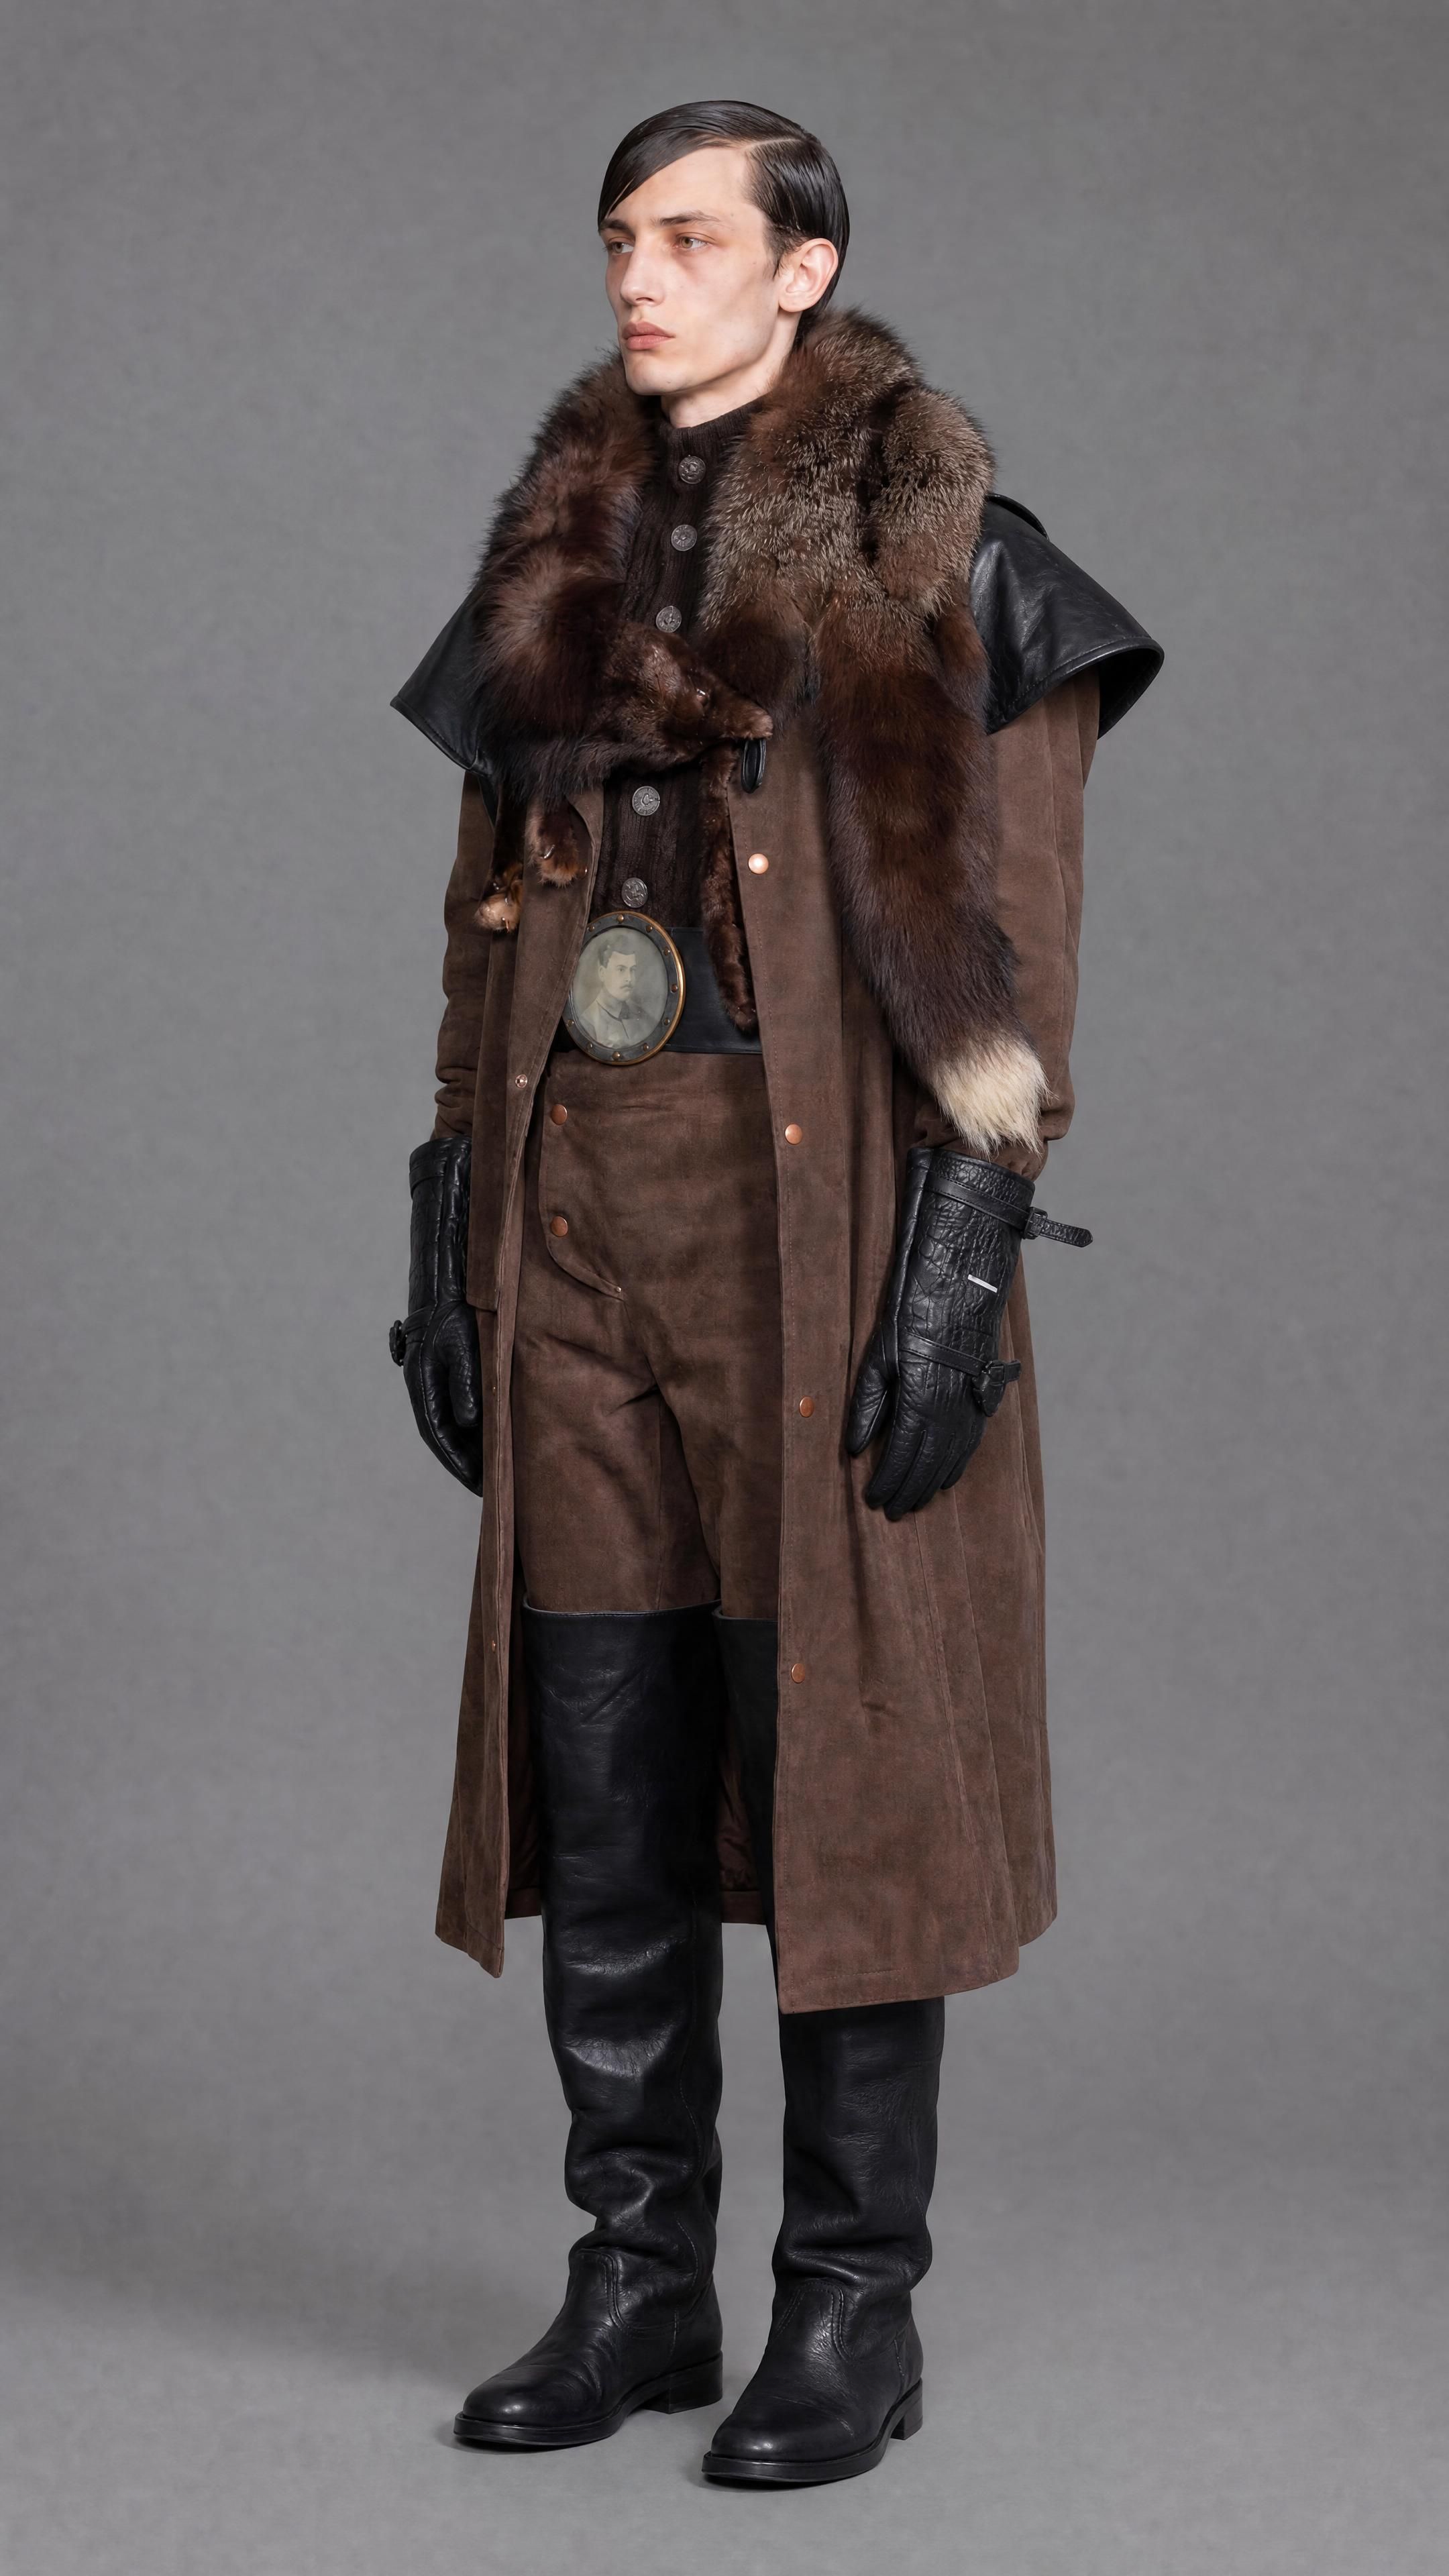 GPT-Image 2
Grok은 전신 이미지에 적합한 ArcFace 0.5 임계값 이상의 얼굴 정체성을 유지했습니다. 이전에 숨겨진 모피 숄의 오른쪽 부분이 45°에서 부분적으로 보였으며, 그라데이션 연속성이 합리적이었습니다. 가슴 배지 윤곽은 보존되었지만 내장 초상화 디테일은 압축을 보였습니다. 부츠 색상 경계와 건틀릿 질감은 유지되었습니다.
GPT Image 2는 전반적인 의복 레이어 일관성이 약간 더 강했지만, 얼굴 정체성 변화가 더 많이 발생했습니다 — 사용 사례에 따라 중요한 트레이드오프입니다.
Cat 5 · 로컬 편집 및 영역 보존 (I2I)
프롬프트는 거실 장면에 정확히 세 가지 편집을 요구했습니다: 소파에서 자고 있는 고양이 제거 (그리고 쿠션을 자연스럽게 복원), 뜨거운 차 한 잔을 얼음이 든 오렌지 주스 한 잔으로 교체, 접힌 검은색 테두리 안경을 커피 테이블 중간 책 위에 추가. 지침은 다른 모든 것을 변경하지 말라고 명시했습니다 — 소파 패브릭 패턴, 책 위치, 램프, 창문 뷰, 벽 색상, 바닥.
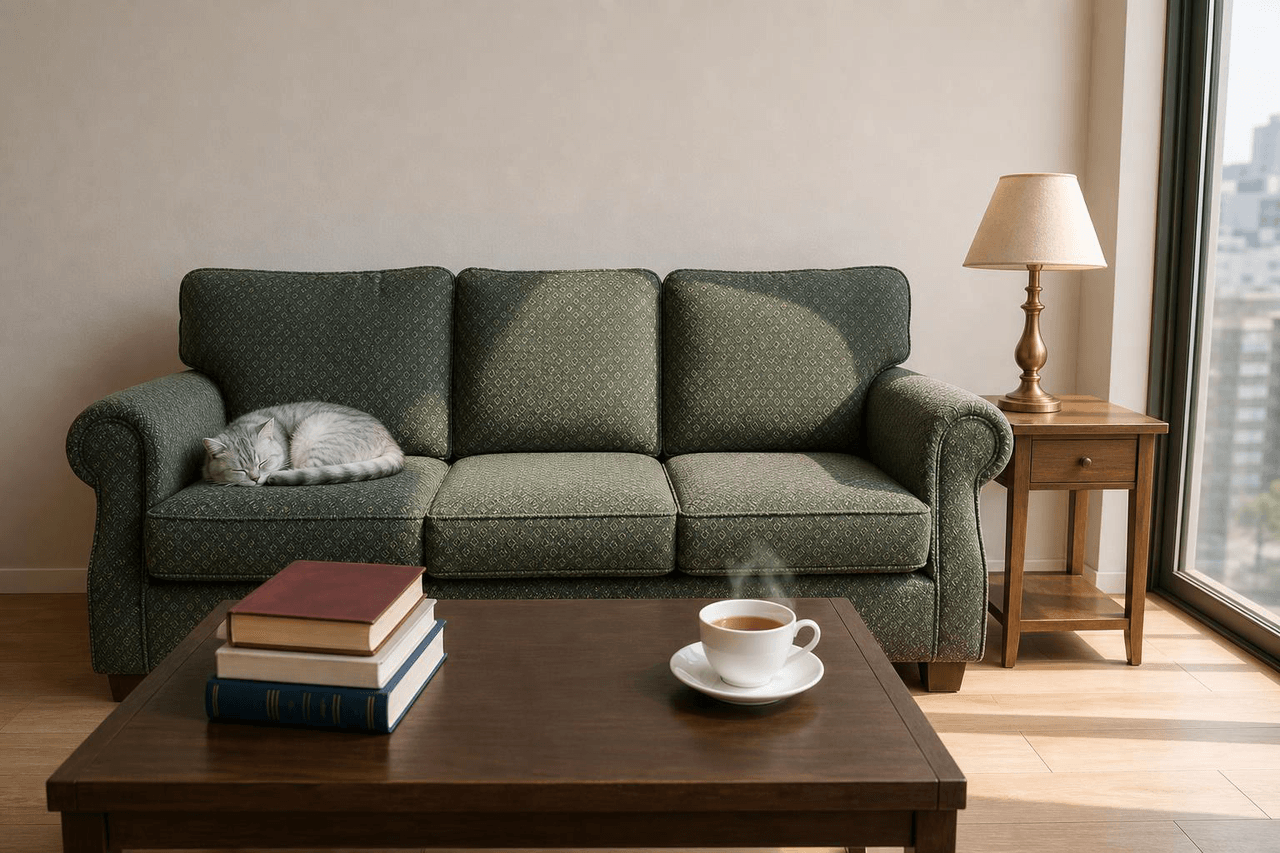
보존 테스트는 편집 테스트만큼 중요합니다. 로컬 변경을 수행하면서 전체 장면을 재해석하는 모델은 제품 사진 리터칭이나 반복 장면 개발에 사용할 수 없습니다.
점검 목록
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
|---|---|---|
| 1 | 3개 편집 모두 완료 | 고양이 제거, 차를 오렌지 주스로 교체, 안경 추가 |
| 2 | 쿠션 복원 | 고양이 모양의 움푹 들어간 자국이나 털 잔여물 없음 |
| 3 | 오렌지 주스 물리 | 유리 기하학, 얼음 굴절, 그림자 방향이 원래 컵의 조명과 일치 |
| 4 | 안경 배치 | 중간 책 위에 올바르게 위치 (맨 위나 맨 아래가 아님) |
| 5 | 소파 패브릭 | 다이아몬드 직조 패턴이 편집된 영역에서도 손상되지 않음 |
| 6 | 책 변경 없음 | 위치, 표지 (빨간색, 파란색, 흰색, 녹색) 및 순서 일치 |
| 7 | 램프 변경 없음 | 모양, 빛 상태 및 위치 보존 |
| 8 | 창문 뷰 변경 없음 | 도시 뷰가 흐릿하고 일관되게 유지됨 |
| 9 | 벽 및 바닥 변경 없음 | 오프 화이트 벽과 밝은 나무 바닥이 변경되지 않음 |
| 10 | 전체 조명 보존 | 단일 오른쪽 뒤 광원 방향이 변경되지 않음 |
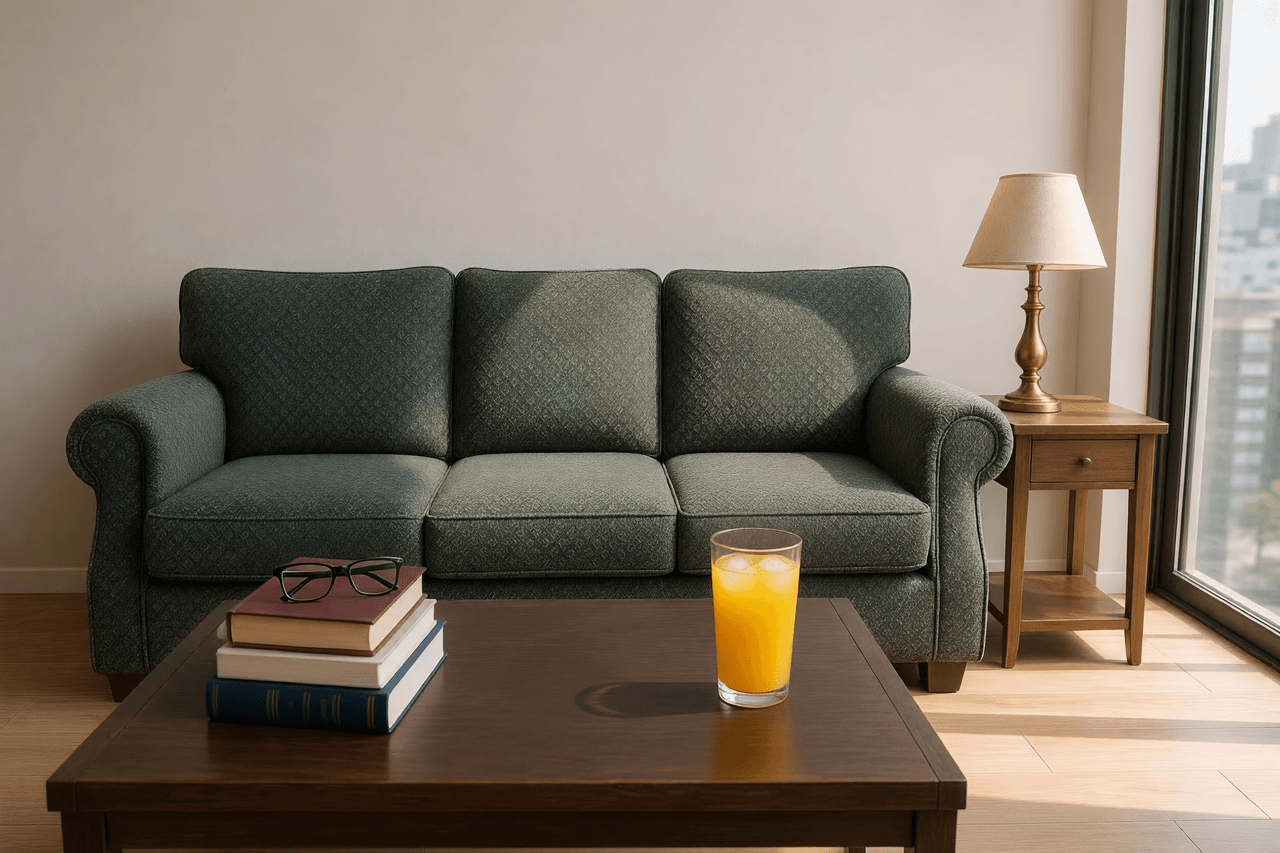 Grok Imagine Image
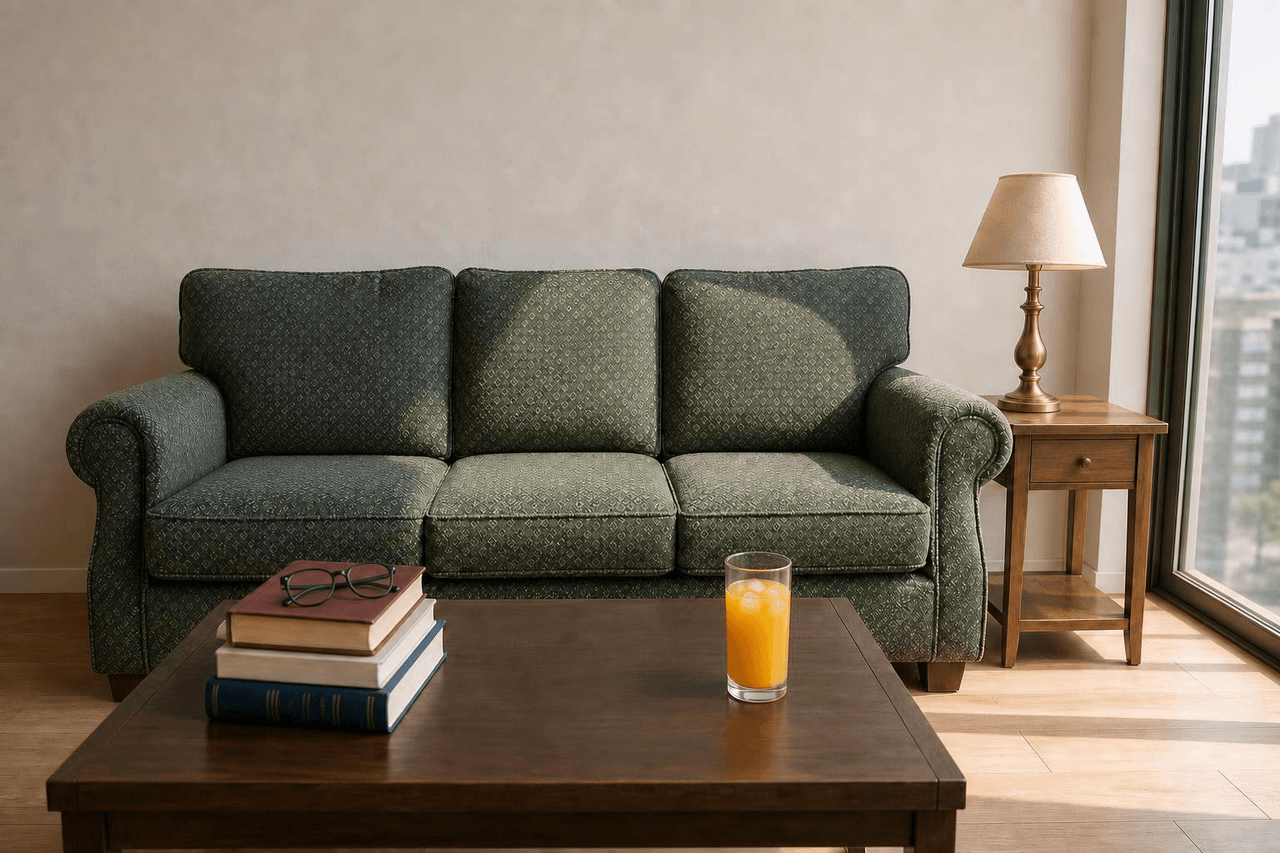 GPT-Image 2
Grok Imagine은 필요한 세 가지 편집을 모두 완료했습니다. 고양이는 제거되었고 소파 쿠션은 깨끗하게 복원되어 눈에 띄는 움푹 들어간 자국이나 털 잔여물이 없었습니다 — 편집된 영역의 패브릭 패턴이 잘 유지되었습니다. 오렌지 주스 잔이 올바른 위치에 나타났습니다. 그러나 오렌지 주스 잔의 하이라이트 패턴이 이 광원 방향과 일치하지 않아, 마치 독립적인 조명 모델로 합성된 것처럼 보이며 장면의 기존 조명에 통합되지 않은 것 같습니다. 잔의 바닥은 어두운 나무 커피 테이블 표면에 대해 충분한 접촉 그림자가 없어 미묘하지만 감지 가능한 떠 있는 효과를 만듭니다.
GPT Image 2도 세 가지 편집을 모두 완료했으며, 전반적인 장면 보존에서 더 강력함을 보였습니다. 고양이 제거는 동등하게 깨끗했습니다. 오렌지 주스 잔은 올바른 위치와 오른쪽 창문 광원에 맞는 그림자 방향으로 잘 렌더링되었습니다 — 잔의 기하학과 액체 불투명도가 Grok 버전보다 더 정교하게 읽혔습니다. 안경은 책 더미 위에 눈에 띄게 배치되었습니다. 결정적으로, 창문 뷰가 보존되었습니다 — 외부 도시가 흐릿하고 일관되게 보이며, 이는 Grok이 실패한 부분입니다. 소파 패브릭, 램프, 벽, 바닥 모두 유지되었습니다. 책은 위치와 색상이 일관되게 보입니다. 한 가지 주목할 만한 변화: 장면 전체가 원본보다 약간 더 밝고 대비가 이동된 것처럼 보여, 진정한 픽셀 수준 보존보다는 전역 조명 재해석을 시사합니다 — 미미하지만 감지 가능한 변화입니다.
Cat 6 · 다중 참조 융합 (I2I)
프롬프트는 세 가지 독립적인 참조를 결합했습니다: 초상화 정체성 (라틴계 여성, 호박색 눈, 짙은 갈색 곱슬머리), 수채화 일러스트레이션 스타일 (일본 시골 풍경, 눈에 보이는 붓질, 따뜻한 동화 같은 분위기), 장면 레이아웃 (유럽 조약돌 마을 광장, 일몰, 주철 램프 기둥, 석조 아치). 과제: 식별된 인물이 장면에 서 있는 단일 일관된 수채화 그림 생성 — 필터가 적용된 사진, 콜라주 아님.
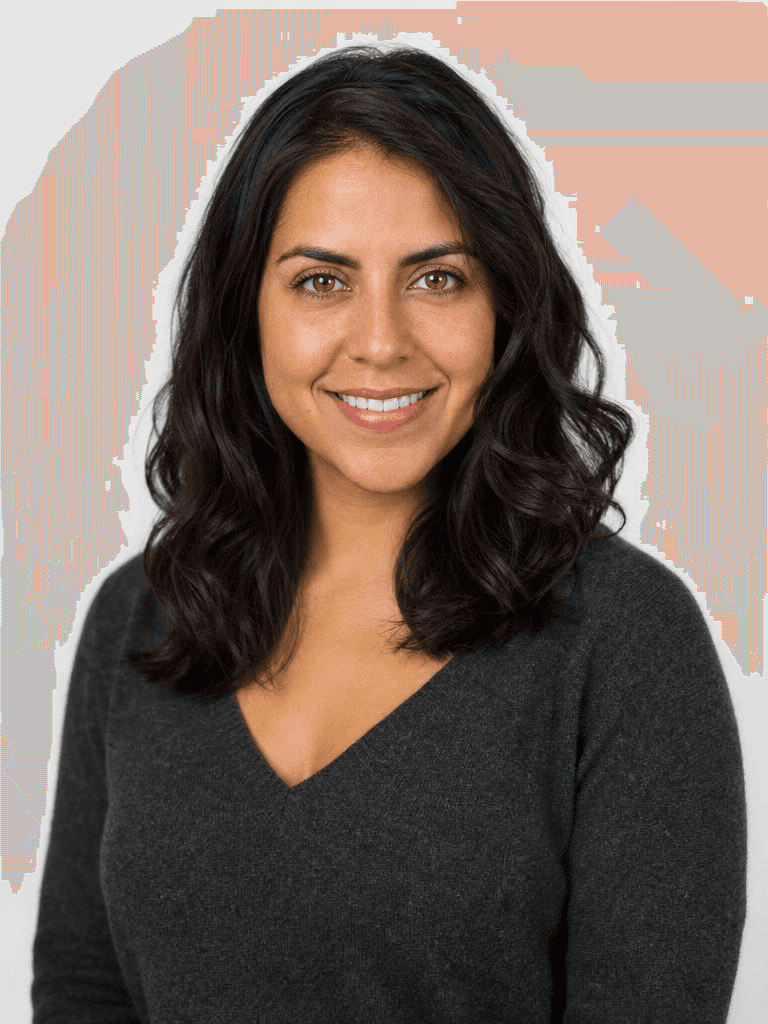
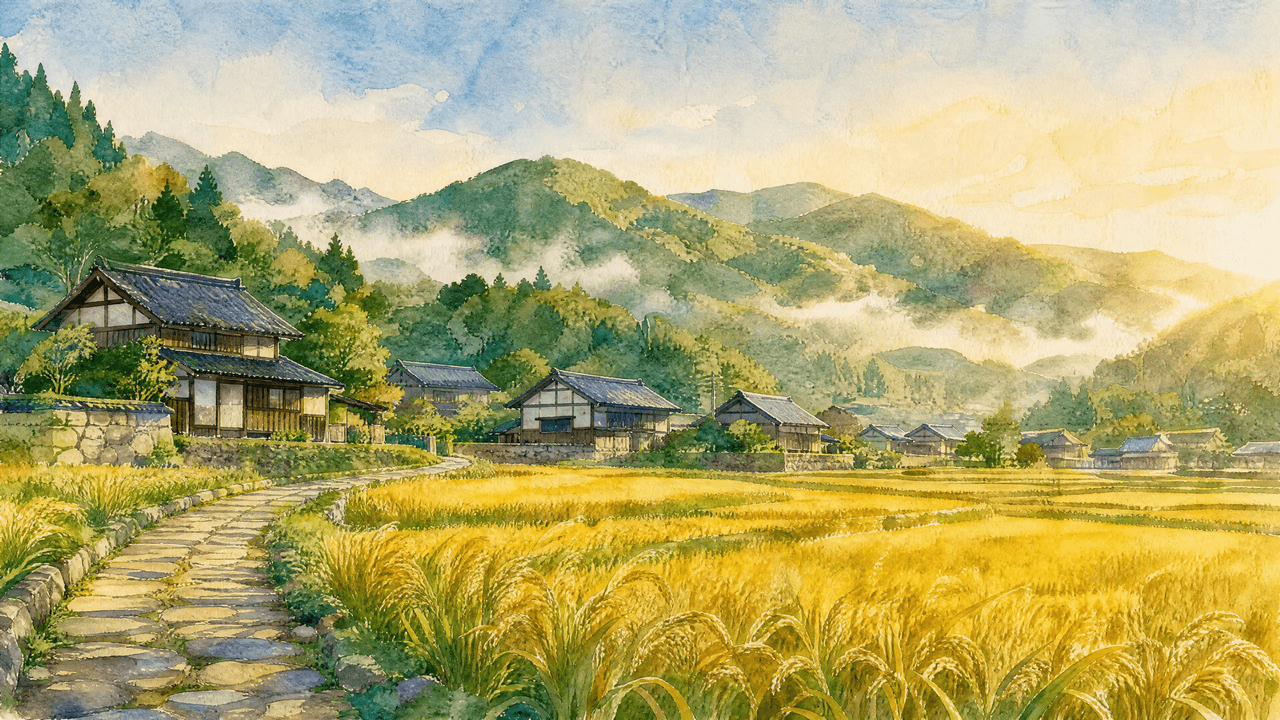
세 가지 참조 분리는 이 벤치마크에서 가장 어려운 테스트입니다. 대부분의 모델은 하나의 참조를 과도하게 가중하거나 스타일을 통한 렌더링을 달성하지 못합니다.
점검 목록
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | 기준 | 확인 |
|---|---|---|
| 1 | 세 가지 분리 | 정체성, 스타일, 장면 레이아웃이 모두 명확하게 표현됨 |
| 2 | 전체 스타일 전송 | 출력 전체가 수채화 — 사진 + 필터가 아님 |
| 3 | 스타일 후 정체성 유지 | 호박색 눈 + 얼굴 구조가 수채화 처리에서도 인식 가능 |
| 4 | 장면 구조 보존 | 조약돌, 램프 기둥, 아치 레이아웃이 손상되지 않음 |
| 5 | 자연스러운 의상 추가 | 여행용 코트와 배낭이 구성을 깨지 않고 추가됨 |
| 6 | 광원 방향 일관성 | 카메라 왼쪽의 일몰 빛이 조약돌과 인물에 보임 |
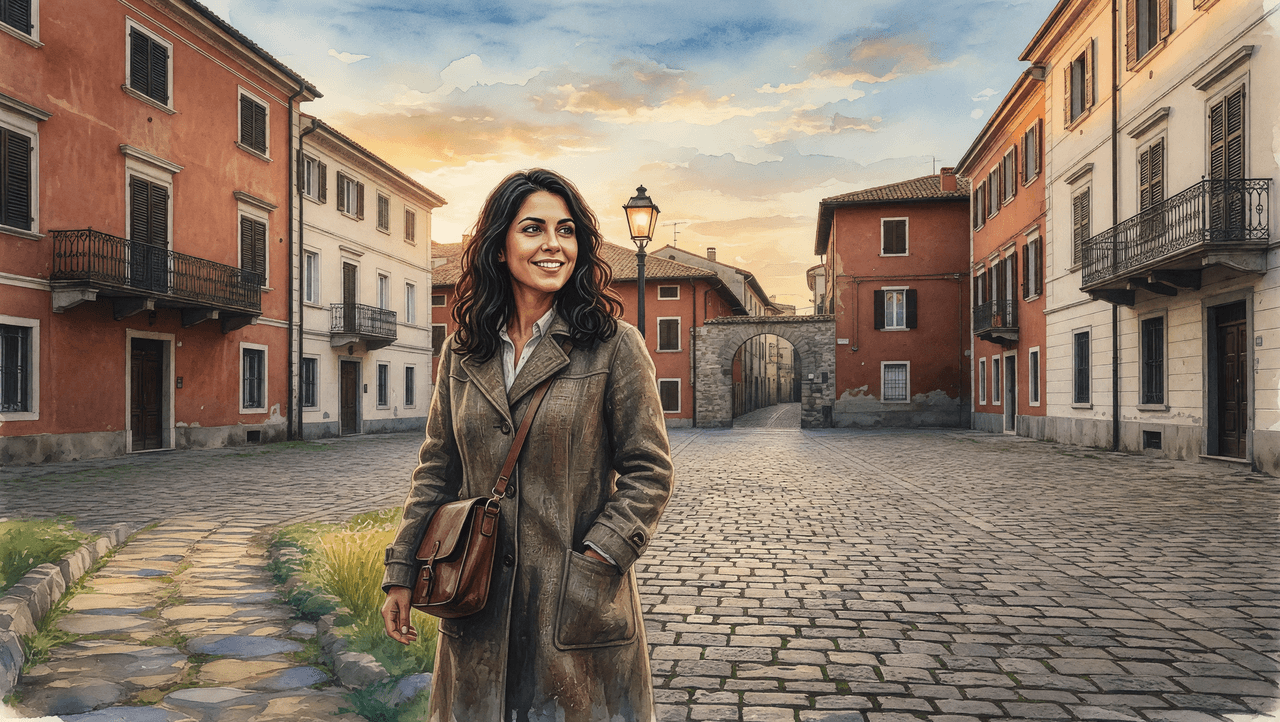 Grok Imagine Image
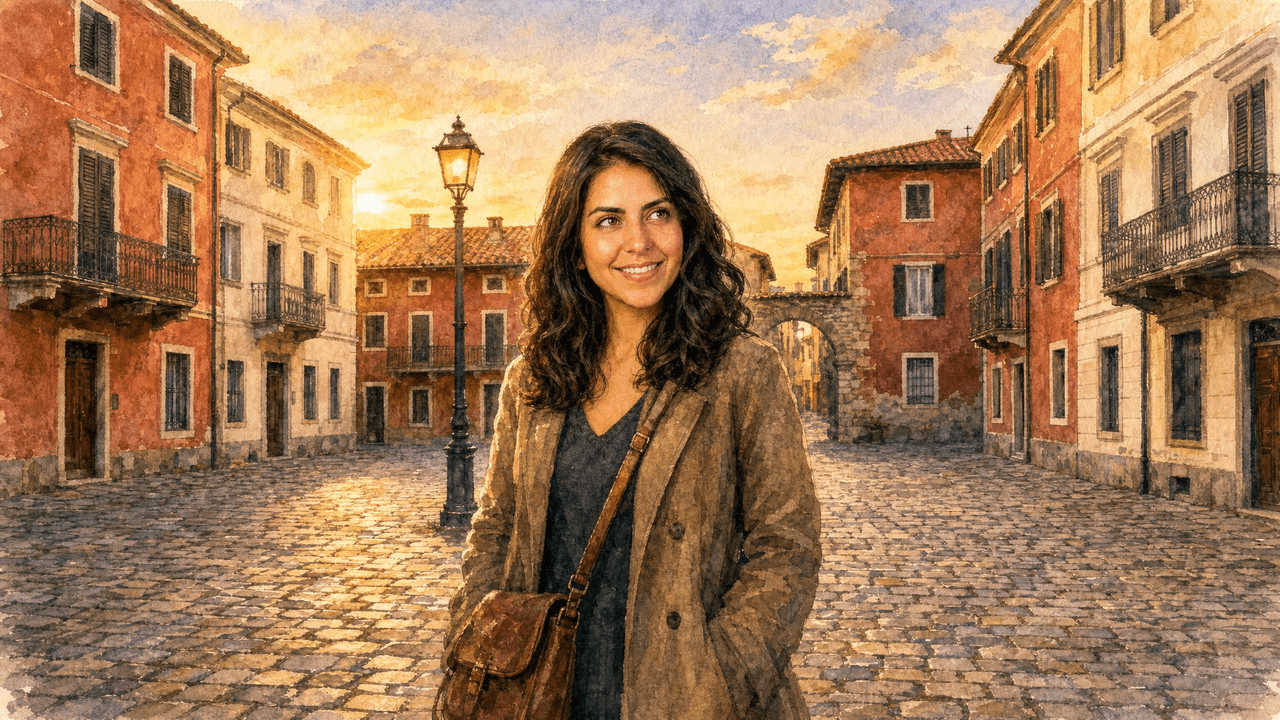 GPT-Image 2
Grok Imagine은 핵심 기준에 실패했습니다: 출력이 사진처럼 사실적이며 수채화가 아닙니다. 조약돌 광장과 인물은 전체 사진적 선명도를 유지하며 가벼운 회화적 질감 패스만 있을 뿐 — 참조 2의 정의적인 붓질, 색상 번짐, 손으로 그린 가장자리 품질이 전혀 없습니다. 장면 구조, 정체성, 의상, 광원 방향은 모두 통과합니다. 그러나 완전히 다른 매체를 렌더링하는 것은 부분적 감점이 아닌 카테고리 수준의 실격입니다.
GPT Image 2는 전체 프레임에 걸쳐 진정한 수채화 렌더링을 달성했습니다 — 건물, 조약돌, 하늘, 인물 모두 참조 2와 일관된 눈에 보이는 붓질과 부드러운 색상 번짐을 가지고 있습니다. 참조 3의 장면 구조는 손상되지 않았으며, 램프 기둥에 불이 켜져 있고 중간 지점에 석조 아치가 보입니다. 정체성은 스타일 변환을 통해 부분적으로 유지됩니다 — 곱슬거리는 어두운 머리와 얼굴 구조가 인식 가능하지만, 미세한 특징은 예상대로 추상화됩니다. 코트, 배낭, 광원 방향, 시선 모두 프롬프트를 따릅니다. 이것이 실제 작업을 완료한 유일한 출력입니다.
Atlas Cloud를 통해 Grok Imagine Image 및 GPT Image 2 모델 사용해보기
벤치마크는 재현 가능합니다. Grok Imagine과 GPT Image 2 모두 지금 Atlas Cloud를 통해 사용할 수 있습니다 — 모델당 청구 설정 없음, 대기자 명단 없음.
Atlas Cloud를 선택해야 하는 이유
- 하나의 API 키, 300개 이상의 모델. Grok, GPT Image 2, Flux, Wan, Seedream 및 풀의 다른 모든 모델을 단일 모델 필드 변경으로 전환하세요. 동일한 키, 동일한 엔드포인트, 동일한 청구 대시보드 — 6개 모델 벤치마크를 실행하든 프로덕션 이미지 파이프라인을 구축하든 상관없습니다.
- 전체 모달 커버리지. LLM, 텍스트-이미지, 이미지-이미지, 텍스트-비디오, 이미지-비디오 — 모두 하나의 플랫폼에서. 워크플로에 프롬프트 개선을 위한 언어 모델과 생성을 위한 이미지 모델이 모두 필요한 경우, 둘 다 동일한 API에 있습니다.
- 콜드 스타트 없음, 속도 제한 서프라이즈 없음. Atlas Cloud는 처리량에 최적화된 추론 인프라에서 실행됩니다. 한 번 호출하든 천 번 호출하든 일관된 지연 시간을 제공합니다.
- 비교 워크플로에 최적화. 이 벤치마크가 보여주는 정확한 사용 사례 — 여러 모델에 동일한 프롬프트를 실행하고 출력을 비교하는 것 — 은 Atlas Cloud 아키텍처가 설계된 것입니다. 하나의 키, 하나의 청구서, 전체 모델 폭.


