

how i become a millionaire in 30 days 클립은 챗봇에게 기적적인 지름길을 물었지만 가능한 가장 마법 같지 않은 답인 "Get a job."을 받는 농담입니다. 캐릭터의 상처받은 시선, 미친 듯한 타이핑, 두 번째 시도가 실제 이야기입니다. 아래에는 인간과 반려동물로 같은 설정이 어떻게 작동하는지 보여주는 두 가지 온라인 예시가 있습니다. 그런 다음 독창적인 캐릭터, 새로운 배경, 읽을 수 있는 대사, 그리고 충분히 오래 지속되어 웃음을 터뜨리는 반응을 갖춘 새롭고 더 긴 버전을 만들어 봅니다.
핵심 요약
- 알아볼 수 있는 순서는 희망찬 질문, 무뚝뚝한 답변, 불쾌한 침묵, 그리고 또 다른 시도입니다.
- 온라인 인간 및 반려동물 버전은 농담의 타이밍을 유지하면서 연기자를 바꿉니다.
- 우리의 독창적인 26초 놀이터 버전은 어린이 연기자를 사용하고 비디오 모델에게 전화 인터페이스를 그리게 하는 대신 편집에서 읽을 수 있는 대사를 추가합니다.
- "Get a job"을 챗봇이 답할 내용이나 실제 부의 계획에 대한 증거가 아니라 각본된 펀치라인으로 취급하세요.
온라인 버전에서는 무슨 일이 일어나나요?
첫 번째 온라인 예시는 농담을 일상적인 전화 대화에 가깝게 유지합니다. 한 사람이 완전한 자신감을 가지고 전화기를 들어 올리고, 답을 보기 위해 아래를 내려다보며, 갑자기 그 자신감을 잃습니다. 자세의 변화를 보세요. 설정은 전화기를 향해 말하지만, 결말은 시청자를 향해 밖으로 연기됩니다. 그 반응이 짧은 대사를 기억에 남게 만듭니다.
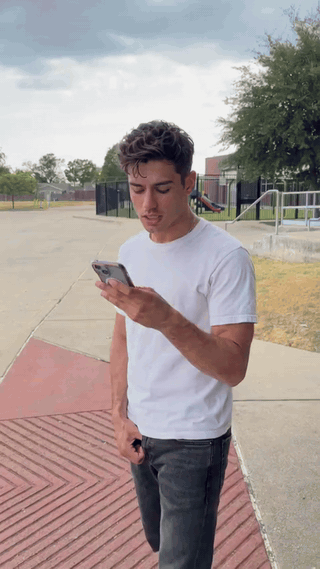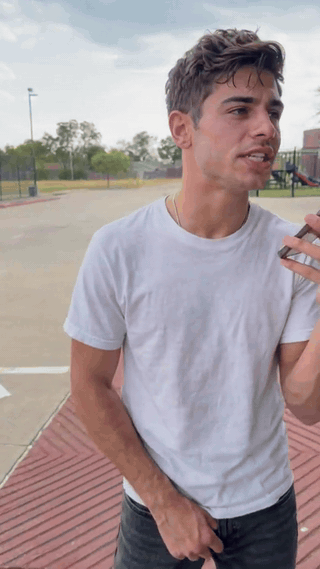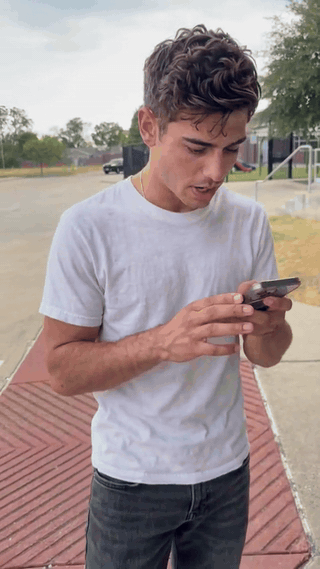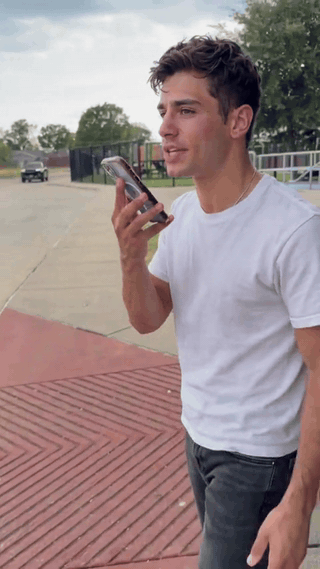
온라인 예시, 인간 버전. 핵심 시각적 박자는 희망찬 전달에서 눈에 보이는 불신으로의 전환입니다.
두 번째 온라인 예시는 반려동물을 같은 역할에 넣습니다. 직립 자세와 전화기 소품은 답이 오기 전에 야망을 터무니없게 만듭니다. 고개를 돌리고 카메라를 오래 바라보는 것이 인간 배우가 눈썹과 중얼거리는 항의로 할 일을 대신합니다. 이것은 의상 교체 이상입니다: 동물의 몸짓 언어가 펀치라인의 느낌을 바꾸면서 질문과 답변은 여전히 알아볼 수 있습니다.
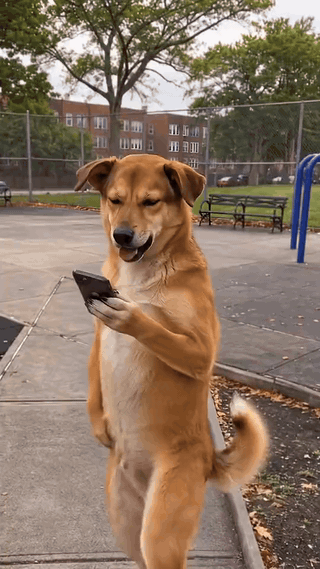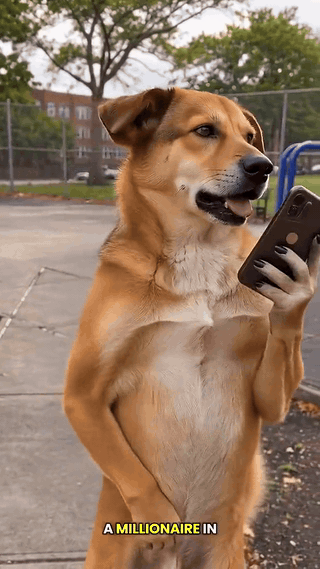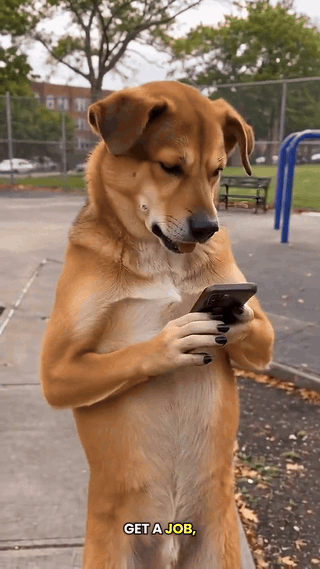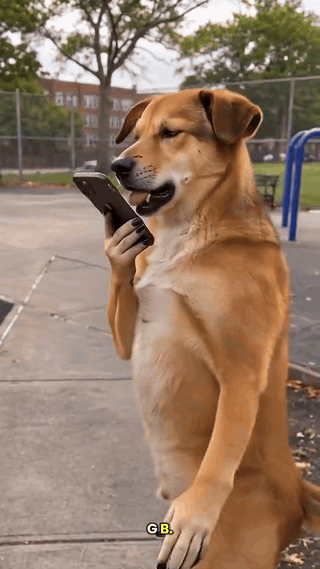
온라인 예시, 반려동물 버전. 연기는 직립 자세, 읽을 수 있는 전화기 제스처, 지연된 불쾌한 표정에 의존합니다.
이것들은 유포되는 비디오 형식의 예시이지, 특정 챗봇 응답을 입증하는 녹화물이 아닙니다. 코미디 스케치는 교환을 무대에 올릴 수 있고, AI 리메이크는 연기자를 생성할 수 있습니다. "how I become"이라는 구절은 검색되는 밈 라인의 일부이기 때문에 여기에 유지되지만, "how do I become"은 일반적인 영어입니다. 어느 구절도 비디오를 재정적 조언으로 만들지 않습니다.
알아볼 수 있게 만드는 네 가지 박자
| 박자 | 시청자가 보는 것 | 중요한 이유 |
|---|---|---|
| 질문 | 전화기가 비밀을 밝혀줄 수 있는 것처럼 들어 올려짐 | 캐릭터의 자신감이 과대한 기대를 설정합니다. |
| 답변 | "Get a job."이 나타나거나 소리 내어 읽힘 | 답변은 의도적으로 평범하고 짧습니다. |
| 반응 | 캐릭터가 얼어붙거나, 올려다보거나, 카메라를 응시함 | 침묵은 관객이 캐릭터와 함께 모욕을 발견하게 합니다. |
| 다시 질문 | 빠른 타이핑 또는 또 다른 음성 메시지 | 캐릭터는 평범한 답변을 거부하고 농담을 연장합니다. |
순서는 정확한 샷 길이보다 더 중요합니다. 시청자가 질문을 이해하기 전에 답변이 나오면 대비가 없습니다. 반응이 즉시 잘리면 펀치라인은 숨 쉴 공간이 없습니다. 캐릭터가 그냥 걸어가 버리면 클립은 이 형식을 특별하게 만드는 고집스러운 두 번째 시도를 잃게 됩니다.
자신만의 버전을 어떻게 만드나요?
농담의 구조로 시작한 다음, 연기, 배경, 결말을 바꾸세요. 다른 사람의 영상을 장면 하나하나 재생하면 결과를 구별하기 어렵게 만들고 대사에 대한 통제력이 떨어집니다. 우리의 시연에서는 한 명의 가상 아동을 햇볕이 잘 드는 놀이터에 배치합니다. 아이는 밝은 낙관주의로 백만장자 지름길을 요청하고, 무뚝뚝한 "Get a job." 답변을 맞닥뜨립니다. 그 조언은 아이에게 의도적으로 터무니없습니다; 기쁨에서 불신으로의 변화가 농담을 이끌어갑니다. 전화기 화면은 아이를 향하고 있으므로 모델은 앱 버튼이나 읽을 수 있는 메시지를 만들어낼 필요가 없습니다.
유용한 디자인 제약은 연기와 텍스트를 분리하는 것입니다. 비디오 모델은 사람이 전화기를 들고, 읽고, 움찔하고, 타이핑하는 것을 애니메이션할 수 있습니다. 움직이는 전화기에 정확한 채팅 텍스트를 렌더링하는 것은 덜 안정적입니다. 따라서 우리는 먼저 연기를 생성하고 나중에 깔끔한 편집 자막을 추가합니다. 자막은 농담의 각본된 대사를 보고합니다; 실제 ChatGPT 세션의 스크린샷으로 제시되지 않습니다.
1. 일관된 첫 프레임 만들기
아이의 얼굴, 양손, 전화기가 보이는 가로 16:9 이미지를 사용하세요. 허리 위 구도는 아이 뒤의 다채로운 미끄럼틀과 그네를 잃지 않으면서 표정이 변할 여지를 남깁니다. 자막을 위한 약간의 여백을 남겨두세요. 첫 프레임은 이미 충격받은 모습보다는 희망찬 모습이어야 합니다.
이 글에서는 첫 프레임을 Atlas Cloud의 Seedream v5.0 Pro로 생성합니다. 프롬프트는 의도적으로 구체적입니다:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
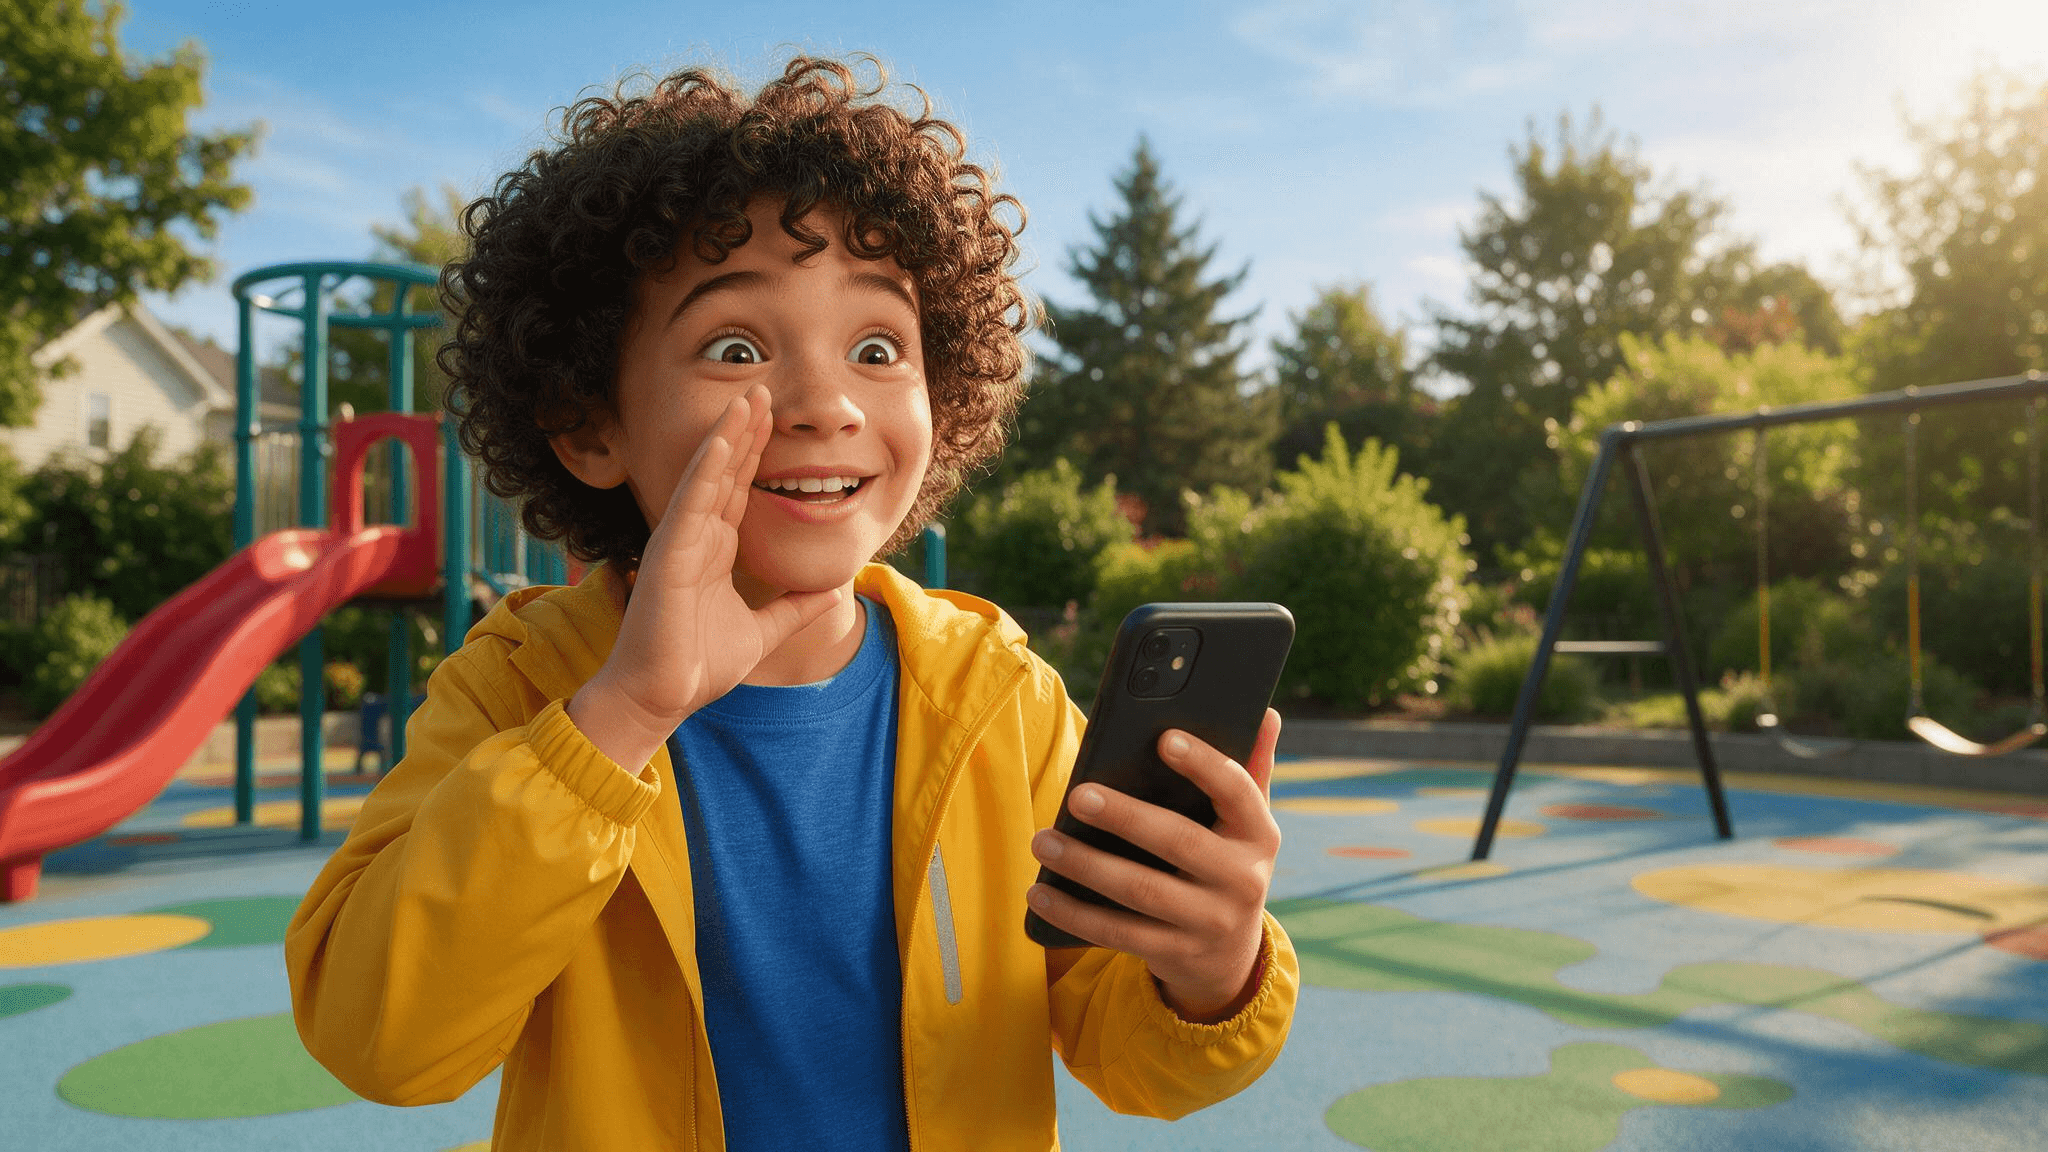
우리가 생성한 시작 프레임. 아이의 활짝 웃는 미소와 치켜올린 눈썹이 희망찬 시작을 확립합니다; 미끄럼틀과 그네는 새로운 배경을 확실하게 만듭니다.
2. 움직이는 초상화가 아닌 완전한 반응을 애니메이션하세요
첫 프레임을 Atlas Cloud의 Seedance 2.5 Image-to-Video의 이미지 입력으로 사용하세요. 목표를 26초, 가로 16:9, 사운드 포함으로 설정합니다. 프롬프트는 뚜렷한 표정 반응의 연속을 요구합니다. 모델에게 채팅 버블을 표시하거나 펀치라인을 철자하도록 요청하지 않습니다. 왜냐하면 그 정확한 단어들은 편집에서 추가되기 때문입니다.
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
전달된 클립은 감정 변화를 따라가기 쉽게 만듭니다: 아이는 웃음으로 시작해서, 첫 답변에 놀라 입을 벌리고, 눈살을 찌푸리고, 또 다른 질문을 타이핑하고, 마지막으로 짜증 섞인 어깨 으쓱을 합니다. 아래의 추가 스틸은 평범한 답변이 아이의 백만장자 계획을 뒤집는 순간을 포착합니다.
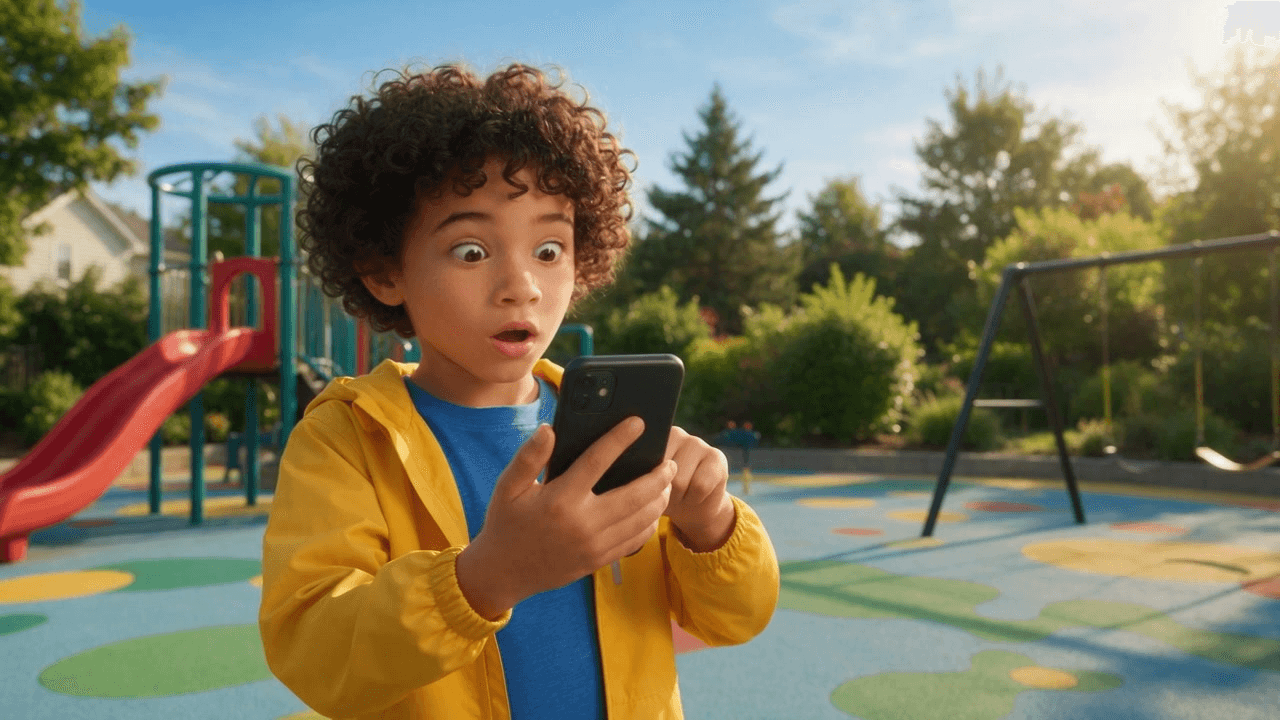
생성된 비디오의 약 6초 지점 프레임. 희망찬 첫 이미지와 비교하면, 커진 눈과 벌린 입이 펀치라인의 효과를 즉시 보이게 합니다.
3. 정확한 대사를 추가하고 소리 없이도 농담을 읽을 수 있게 하세요
짧은 대본이면 충분합니다. 아이가 전화기를 향해 말할 때 질문을 화면에 올리고, 아이가 답변을 읽을 때만 "Get a job."을 넣고, 항의 전에 한 박자를 두세요. 후속 질문에는 시작을 그대로 반복하기보다 새로운 질문을 사용하세요. 자막은 일관된 안전 영역에, 강한 대비로 위치해야 하며, 얼굴이나 손을 절대 가려서는 안 됩니다.
| 26초 컷에서의 순간 | 편집 자막 | 연기 신호 |
|---|---|---|
| 오프닝 | “How I become a millionaire in 30 days?” | 전화기를 향해 밝고 확신에 찬 전달. |
| 답변 | “Get a job.” | 눈이 화면으로 떨어짐; 미소가 사라짐. |
| 반응 | “Seriously?” | 타이핑 전에 놀라움이 눈살 찌푸림으로 바뀜. |
| 두 번째 시도 | “Okay, but what if I skip that part?” | 전화기가 다시 올라옴; 말투가 애원조로 바뀜. |
글은 한눈에 읽을 수 있을 만큼 짧게 유지하세요. 대사가 앱에 의해 생성되었음을 증명하기 위해 사실적인 채팅 스크린샷을 조작하지 마세요. 명확하게 디자인된 자막은 각본된 교환을 정직하게 전달하고 16:9 클립을 소리 없이도 이해할 수 있게 유지합니다. 원본 오디오는 비디오와 함께 유지됩니다; 표시된 네 줄은 편집 자막입니다.
4. 내보내기, 검사, 라벨 지정
소스 클립을 여러 기사 임베드로 자르지 말고 하나의 연속 MP4로 내보내세요. 내보낸 후 실제 지속 시간을 확인하세요. 요청한 26초는 파일이 실제로 20초보다 길고 추가 시간에 의미 있는 액션이 포함된 경우에만 중요합니다. 이 글에서는 최종 독창적 예시가 아래에 포스터 프레임과 함께 임베드되어 독자들이 완성된 시퀀스를 제자리에서 볼 수 있습니다.
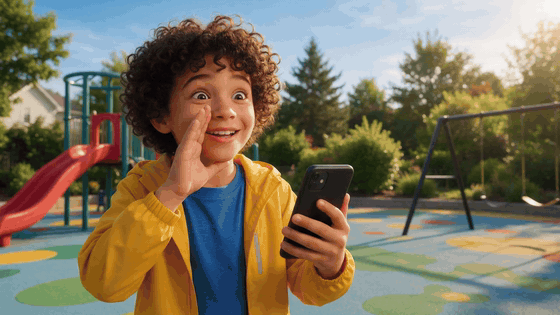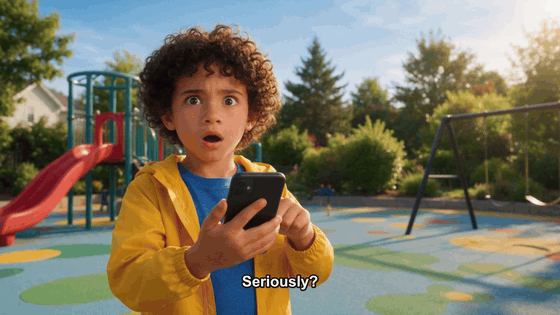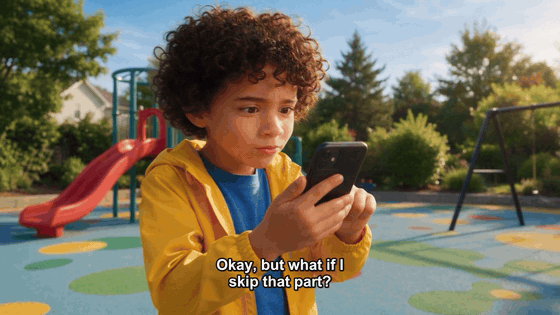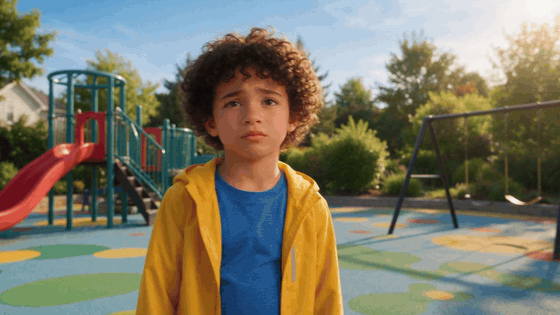
우리의 독창적인 예시: 놀이터의 아이가 질문하고, 무뚝뚝한 답변을 받고, 믿기지 않아 응시하고, 타이핑하고, 하나의 26초 가로 비디오에서 다시 시도합니다. 자막은 생성된 연기에 대한 편집 추가 사항입니다.
AI가 생성한 사실적인 장면을 게시하기 전에 해당되는 경우 플랫폼의 AI 콘텐츠 라벨을 사용하세요. TikTok의 AI 생성 콘텐츠 지침은 사실적인 AI 미디어에 대한 라벨링 도구와 요구 사항을 설명합니다. YouTube의 변경 또는 합성 콘텐츠 지침은 업로드 중 공개를 설명합니다. 자신의 초상, 가상 캐릭터, 또는 출연에 동의한 참가자를 사용하세요. 위의 두 온라인 GIF는 분석을 위한 예시입니다; 리메이크를 게시하려면 자신의 영상, 사운드, 권한이 필요합니다.
더 긴 컷에서 펀치라인이 먹히게 만드는 것은 무엇인가요?
26초 버전은 13초 밈을 두 개 복사한 것 이상이 필요합니다. 우리는 아이에게 눈에 띄는 전략 변화를 줍니다. 처음에는 전화기가 지름길 기계처럼 취급됩니다. 답변 후에 아이는 단순히 요구를 반복하지 않습니다: 눈살을 찌푸리고, 타이핑하고, 다시 공식화하고, 답변과 협상하려고 합니다. 그 전환이 마지막 박자를 채우기 위한 것이 아니라 새로운 농담으로 만듭니다.
소리 없이 읽을 수 있는지도 편집을 바꿉니다. 피드에서 시청자는 클립을 음소거 상태로 접할 수 있습니다. 자막은 올바른 순간에 질문과 답변을 드러내야 하며, 배우의 움직임이 감정을 공급합니다. 지연된 "Seriously?" 자막은 첫 번째 충격받은 프레임 동안 나타나서는 안 됩니다; 조용한 시선이 먼저 옵니다. 그 작은 멈춤에서 시청자가 얼굴을 읽습니다.
마지막으로, 설정을 진실하게 유지하세요. 비디오는 연출된 코미디 장면이고 대사는 각본된 개그입니다. 실제 챗봇 세션을 보여주거나 누구나 30일 안에 부자가 될 수 있다고 약속하지 않습니다. 다음 유용한 행동은 독창적인 연기자와 배경을 선택하고, 네 가지 박자를 스토리보드로 만들고, 누군가가 소리를 끈 상태에서 초안을 이해할 수 있는지 테스트하는 것입니다. 질문과 불쾌한 두 번째 시도를 모두 식별할 수 있다면 형식이 작동하는 것입니다.
자주 묻는 질문
챗봇이 정말로 "Get a job"이라고 답했나요?
그 문구는 코미디 형식의 펀치라인입니다. 그것을 보여주는 비디오는 실제 챗봇 교환의 증거가 아니며 항상 받게 될 응답도 아닙니다.
반려동물이나 친구와 함께 밈을 만들 수 있나요?
네, 적절한 사진과 등장하는 사람의 허가가 있다면 가능합니다. 반려동물 버전은 선명한 눈, 주둥이, 털 무늬가 필요합니다. 친구 버전은 선명한 얼굴과 대사를 말하는 모습으로 묘사되는 것에 대한 동의가 필요합니다.
왜 비디오 모델을 사용한 다음 자막을 따로 추가하나요?
모델은 움직임과 연기를 처리하고, 편집자는 정확한 텍스트를 처리합니다. 그 작업을 분리하면 엉망이 된 전화기 화면을 피하고 펀치라인의 타이밍을 통제할 수 있습니다.
여기 독창적인 예시가 20초를 초과하나요?
네. 전달된 MP4는 생성기에서 선택한 지속 시간에만 의존하지 않고 내보낸 후 검증됩니다. 추가 시간은 두 번째 시도와 최종 반응에 사용됩니다.





