최신 업데이트: Wan 3.0이 2026년 8월 24일부터 공식 출시되었습니다.
15초짜리 광고 하나를 위해 폴더를 만들었습니다. 캐릭터 스틸 두 장. 클라이언트가 보내온 브랜드 톤 영상. PDF로만 존재하는 브랜드북. 실제로 원하는 배우의 음성 샘플.
그런 다음 비디오 모델을 열었더니 이미지 하나를 요구하더군요.
그래서 누구나 하는 일을 했습니다. 폴더를 800단어짜리 프롬프트로 번역하고 기도했습니다. 3번째 샷에서 얼굴이 흔들렸습니다. 재킷 색이 바뀌었습니다. 목소리는 완전히 다른 사람이었습니다.
Wan 3.0의 옴니 레퍼런스는 비디오 모델이 처음으로 "좋아, 폴더를 나에게 줘"라고 말하는 순간입니다. 한 번의 호출에 최대 20개의 에셋, 다섯 가지 입력 유형에 걸쳐 있으며, 하나의 연속적인 30초 테이크로 유지됩니다.
이 글은 세 가지를 다루고 나머지는 생략합니다. 그 20개 에셋이 실제로 무엇인지 분석하고, Alibaba 자체 생성 클립을 증거로 사용하며, 오늘 실행할 수 있는 동등한 워크플로우를 제공합니다. Wan 3.0은 아직 Alibaba 자체 클라우드에서 퍼블릭 베타 단계이며 타사 플랫폼에서 호출할 수 없기 때문입니다.
핵심 요약
- Wan 3.0의 멀티모달 레퍼런스는 한 번의 호출로 최대 20개의 에셋(이미지, 비디오, 오디오, 문서, 라이브 웹페이지)을 받아들이고, 단일 30초 테이크 전체에서 일관성을 유지합니다.
- PDF, 슬라이드 데크 또는 URL을 프롬프트로 요약해야 하는 것이 아닌 창의적 입력으로 취급하는 최초의 주류 비디오 모델입니다.
- Wan 3.0은 2026년 8월 6일 Alibaba Cloud Model Studio 및 Qwen Cloud에서
wan3.0-video로 퍼블릭 베타에 진입했습니다. 가중치는 비공개입니다. 이미 Apache 2.0이라고 말하는 사람은 추측하는 것입니다. - 20개 에셋이라는 헤드라인이 실제로 앞서는 부분은 아닙니다. 지금 바로 호출할 수 있는 레퍼런스-투-비디오 모델은 이미 20개 이상의 에셋을 받아들입니다. 차이는 문서와 웹페이지에 있으며, 숫자에 있는 것이 아닙니다.
- Atlas Cloud의 무료 AI 광고 스킷 생성기를 사용하면 두 캐릭터, 레퍼런스 고정, 완전한 음성 형식을 무료로 테스트할 수 있습니다. 제품 사진 4장을 넣으면 15초짜리 음성 스킷이 출력되며, 카드는 필요 없습니다.
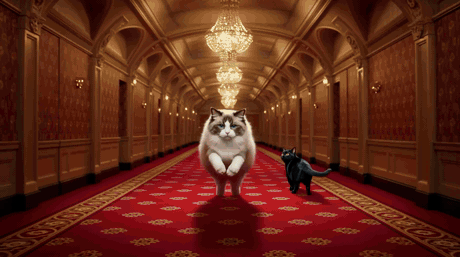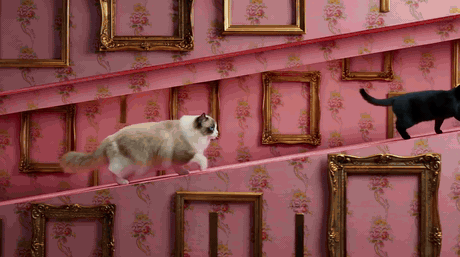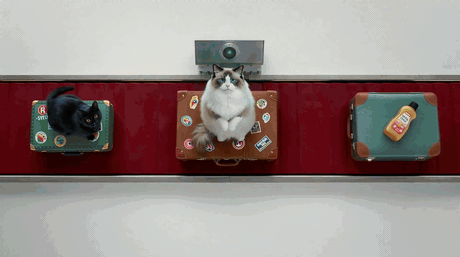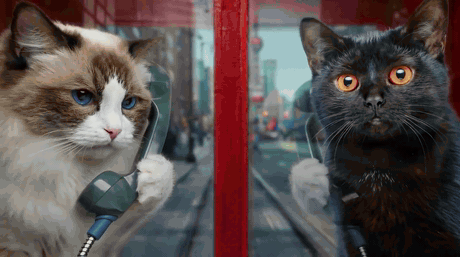
캐릭터 드리프트 없이 Wan 3.0이 다섯 개의 다른 세트를 쫓는 두 마리 고양이_두 개의 참조 이미지. 호텔 복도부터 세탁기 드럼, 빨간 전화 부스까지 완전히 다른 다섯 세트. 단 한 프레임의 드리프트도 없음. 출처: Alibaba 공식_ Wan 3.0 제작자 핸드북 , 2026년 8월. 이 글의 다른 모든 Wan 3.0 클립도 여기서 가져옴.
멀티 레퍼런스 비디오가 무너지는 이유와 Wan 3.0 멀티모달 레퍼런스가 바꾸는 것
비디오 모델은 클립 간에 메모리가 없습니다. 모든 생성은 처음부터 시작됩니다. 이것이 한 문장으로 말하는 전체 문제입니다.
따라서 스토리에 하나 이상의 샷이 필요해지는 순간 연결하는 작업이 필요합니다. 샷 1에서 마음에 드는 얼굴을 얻습니다. 샷 2에서 그 얼굴의 사촌을 얻습니다. 샷 3에서 조용히 재킷 색이 자주색에서 버건디로 바뀌고, 알아챌 때쯤이면 이미 11번의 렌더링 비용을 지불했습니다.
단일 이미지 레퍼런스는 도움이 되었지만, 항상 한 가지만 고정했습니다. 얼굴. 얼굴, 의상, 소품, 장소, 목소리를 동시에 고정할 수 없었습니다. 하나의 슬롯에 다섯 가지 작업이 있었기 때문입니다.
탈출구는 두 가지입니다. 모델에 더 많은 슬롯을 주거나, 처음부터 시작하지 않게 하는 것입니다. Wan 3.0은 두 가지를 동시에 수행하며, 이것이 두 가지 헤드라인 기능이 실제로 하나의 기능인 이유입니다. 네이티브 30초 테이크는 캐릭터가 드리프트할 컷이 없음을 의미합니다. 20개의 레퍼런스 에셋은 고정되어야 하는 모든 요소가 하나의 슬롯을 놓고 싸우는 대신 전용 슬롯을 갖게 함을 의미합니다.
아무것도 연결되지 않았을 때의 모습입니다. 30초, 하나의 연속 카메라, 쇼핑 카트에 탄 아이가 결국 빌보드 안에 박혔다가 그 아래에서 걸어 나옵니다.
한 번에 30초, 컷 없음, 사운드트랙도 같은 패스에서 생성됨. 출처: Alibaba 공식 Wan 3.0 제작자 핸드북.
Wan 3.0 멀티모달 레퍼런스 내에서 "20개 에셋"이 실제로 의미하는 것
20은 헤드라인 숫자입니다. 중요한 것은 20개가 모두 같은 종류의 것이 아니라는 점입니다. Wan 3.0의 옴니 레퍼런스는 다섯 가지 입력 유형을 다루며, 각각은 출력의 다른 축을 제어합니다.
이미지는 정체성을 제어합니다. 캐릭터 카드, 제품 샷, 장소 판. Wan 3.0은 이를 픽셀 수준의 일관성이라고 부르며, Alibaba의 자체 예시에서 얼굴을 넘어 의상까지 잠금이 확장됩니다. 겹겹의 회색 로브, 가죽 스트랩 조끼, 어두운 허리 감싸개가 세 곳에 걸친 16초간의 격투 장면에서 그대로 유지됩니다.
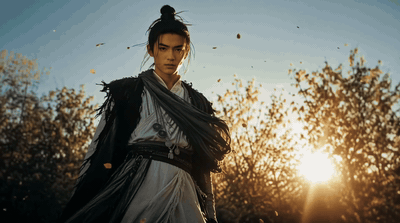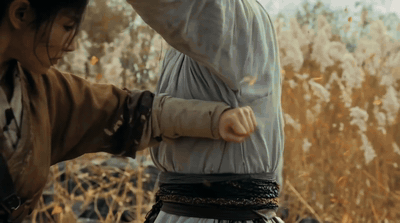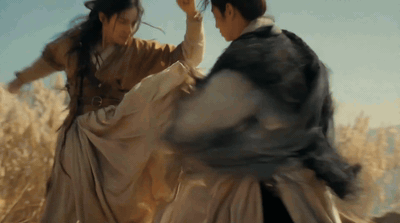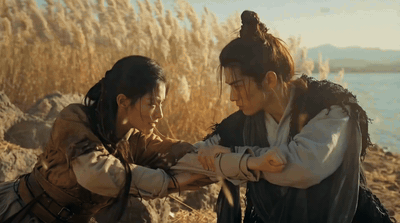
두 개의 캐릭터 카드가 프레임마다 의상 디테일을 유지하며 무협 격투 장면을 이끄는 모습
두 개의 캐릭터 카드와 갈대 둑의 장소 판 하나. 의상과 배경이 모든 동작을 통해 유지됨. 여기서는 무음 GIF로 표시됨; 전달된 파일은 44.1kHz 스테레오 믹스를 포함함. 출처: Alibaba 공식 Wan 3.0 제작자 핸드북.
오디오는 목소리를 제어합니다. 이것이 "멀티모달"을 단순한 마케팅 이상으로 만드는 부분입니다. 캐릭터당 음성 샘플을 첨부하고 프롬프트에 대사를 작성하면, 대화가 그 음색으로, 립싱크되어, 그림과 같은 패스로 반환됩니다. 두 사람, 두 개의 음성 레퍼런스, 하나의 체육관.
두 개의 주제 이미지와 두 개의 별도 음성 레퍼런스 클립, 대화가 그 두 목소리로 반환됨. 이번에는 소리를 켤 가치가 있음. 출처: Alibaba 공식 Wan 3.0 제작자 핸드북.
비디오는 타이밍을 제어합니다. 레퍼런스 비디오는 복사하기 위한 것이 아닙니다. 리듬을 기증하기 위한 것입니다: 비트가 얼마나 오래 지속되는지, 전환이 어떻게 움직이는지. 이 예시에서는 다섯 개의 키프레임이 주제를 제공하고, 레퍼런스 비디오가 그들 사이의 수평 카드-플립 리듬을 제공합니다.
레퍼런스 비디오의 페이싱으로 플립되는 다섯 개의 키프레임_다섯 개의_ 키프레임 이미지(주제용)와 하나의 레퍼런스 비디오(플립 리듬용). 출처: Alibaba 공식 Wan 3.0 제작자 핸드북.
문서와 웹페이지는 구조를 제어합니다. 이것이 진정으로 새로운 부분입니다. Wan 3.0은 문서 파일과 라이브 URL을 창의적 입력으로 받아들이며, 베타 보고에 따르면 허용되는 형식에 .doc, .xls, .ppt, .pdf 및 .txt가 포함됩니다(AlphaSignal, 2026년 8월). 동일한 로직이 이미 스토리보드 이미지에서도 작동합니다. 하나의 보드를 넣으면 보드 순서대로 여섯 개의 샷이 나옵니다.
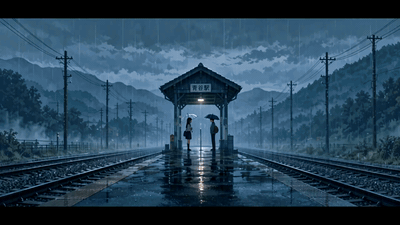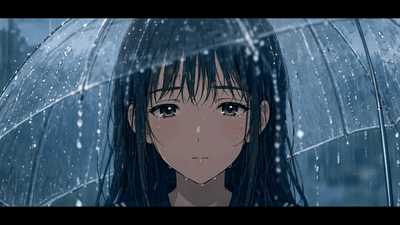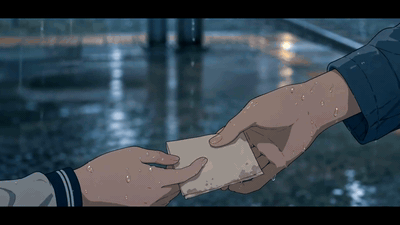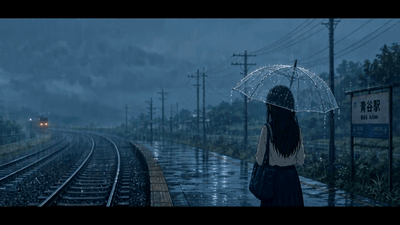
하나의 스토리보드 시트가 비오는 기차역 플랫폼의 여섯 개의 연속 샷으로 확장됨
하나의 스토리보드 시트를 레퍼런스로 사용하여 순서대로 생성된 여섯 개의 샷, 다섯 번째 샷에서 손에 쪽지를 건네는 부분까지 정확함. 출처: Alibaba 공식 Wan 3.0 제작자 핸드북.
첫 번째 및 마지막 프레임은 끝점을 제어합니다. 가장 오래된 방법으로, 여전히 지원되며, 샷의 경계를 정하는 가장 빠른 방법입니다.
다음은 이것이 현재 대부분의 사람들이 실제로 사용하는 버전과 어떻게 비교되는지 보여줍니다.
| Wan 2.7 레퍼런스-투-비디오 | Wan 3.0 옴니 레퍼런스 | |
|---|---|---|
| 레퍼런스 에셋 | 주제당 이미지 1개, 최대 3개 비디오, 1개 음성 클립 | 총 최대 20개 에셋 |
| 모달리티 | 이미지, 비디오, 오디오 | 이미지, 비디오, 오디오, 문서, 웹페이지 |
| 한 번의 패스 최대 길이 | 10초 | 30초 네이티브, 스마트 길이 지원 |
| 같은 패스의 오디오 | 예 | 예 |
| 비디오 편집 및 확장 | 노출되지 않음 | 명령 및 레퍼런스 기반 편집, 확장 지원 |
| 가용성 | 타사 API에서 사용 가능 | Alibaba Cloud Model Studio 및 Qwen Cloud 베타 |
문서에는 없지만 모두가 힘들게 배우는 규칙이 하나 있습니다. 하나의 레퍼런스, 하나의 작업. Image1은 얼굴과 의상을 고정합니다. Video1은 동작만 기증합니다. Audio1은 음색만 기증합니다. 단일 에셋에 두 가지 상충되는 작업을 할당하거나, 두 사람이 있는 레퍼런스 이미지를 업로드하면 모델이 추측해야 하며, 추측은 정확히 당신이 막으려고 했던 것입니다. Alibaba의 핸드북도 이것에 대해 직설적입니다. 레퍼런스 이미지당 하나의 주제.
오늘 실행할 수 있는 Wan 3.0 멀티모달 레퍼런스 워크플로우
먼저 직설적인 답변. Wan 3.0은 Alibaba 자체 클라우드에서 wan3.0-video 모델 ID로 퍼블릭 베타 중입니다(Alibaba Wan, 2026년 8월). 아직 타사 API 플랫폼(Atlas Cloud 포함)에는 도착하지 않았습니다. 지금 Wan 3.0 API 액세스를 판매하는 사람은 다른 것을 재판매하는 것입니다.
도착한 것은 워크플로우 형태입니다. 레퍼런스 팩 입력, 한 번의 호출, 사운드가 포함된 완성된 클립 출력. 이것은 브라우저 탭에서 호출할 수 있는 레퍼런스-투-비디오 모델에서 오늘 실행됩니다. 그리고 이들을 모두 정렬하면 20개 에셋 헤드라인이 다르게 보입니다.
| 모델 | 레퍼런스 에셋 | 모달리티 | 최대 길이 | 네이티브 오디오 | 초당 가격 |
|---|---|---|---|---|---|
| Wan 3.0 (Alibaba 베타, Atlas 미포함) | 총 20개 | 이미지, 비디오, 오디오, 문서, 웹페이지 | 30초 | 예 | 해상도별 $0.05 ~ $0.20로 보고됨 |
| Wan 2.7 레퍼런스-투-비디오 | 주제당 이미지 1개, 비디오 3개, 음성 클립 1개 | 이미지, 비디오, 오디오 | 10초 | 예 | $0.10 |
| Seedance 2.5 레퍼런스-투-비디오 | 50개 (이미지 30 / 비디오 10 / 오디오 10) | 이미지, 비디오, 오디오 | 30초 | 예 | $0.13 |
| MiniMax H3 레퍼런스-투-비디오 | 혼합, 명시된 상한 없음 | 이미지, 비디오, 오디오 | 15초 | 예 | $0.10 |
| Kling Video O3 Pro 레퍼런스-투-비디오 | 이미지 7개, 또는 이미지 4개 + 비디오 1개 | 이미지, 비디오 | 15초 | 예 | $0.10 |
| Vidu Q3-Mix 레퍼런스-투-비디오 | 이미지 4개 | 이미지 | 16초 | 예 | $0.11 |
| Veo 3.1 레퍼런스-투-비디오 | 이미지 3개 | 이미지 | 8초 | 선택 사항 | $0.20 |
가격은 2026년 8월 기준 Atlas Cloud 요금입니다. Wan 3.0의 수치는 Alibaba Cloud 베타에 대해 보고된 수치이며 Atlas 요금이 아닙니다. Alibaba는 아직 모델에 대한 공개 가격 페이지를 게시하지 않았으므로 해당 행은 잠정적인 것으로 간주하십시오.
해당 표를 두 번 읽으면 실제 이야기가 드러납니다. 20개 에셋 헤드라인은 Wan 3.0이 앞서는 부분이 아닙니다. Seedance 2.5는 이미 50개를 받아들이고 30초를 일치시키기 때문입니다. 그 목록에서 PDF를 받아들이는 다른 모델은 없습니다.
아래 워크스루의 데모는 Wan 2.7 레퍼런스-투-비디오에서 실행됩니다. 그 입력 형태가 옴니 레퍼런스와 가장 가깝기 때문입니다. 여러 주제 이미지, 선택적 레퍼런스 비디오, 음성 클립이 모두 프롬프트 내의 character1 및 character2 레이블에 매핑됩니다. 세 개의 모델, 하나의 브라우저 탭, 로컬 설치 없음.
현재 호스팅된 실행을 위해 Atlas Cloud의 Wan 3.0을 열고 워크플로우를 게시하기 전에 아래와 같은 프롬프트를 테스트하십시오.
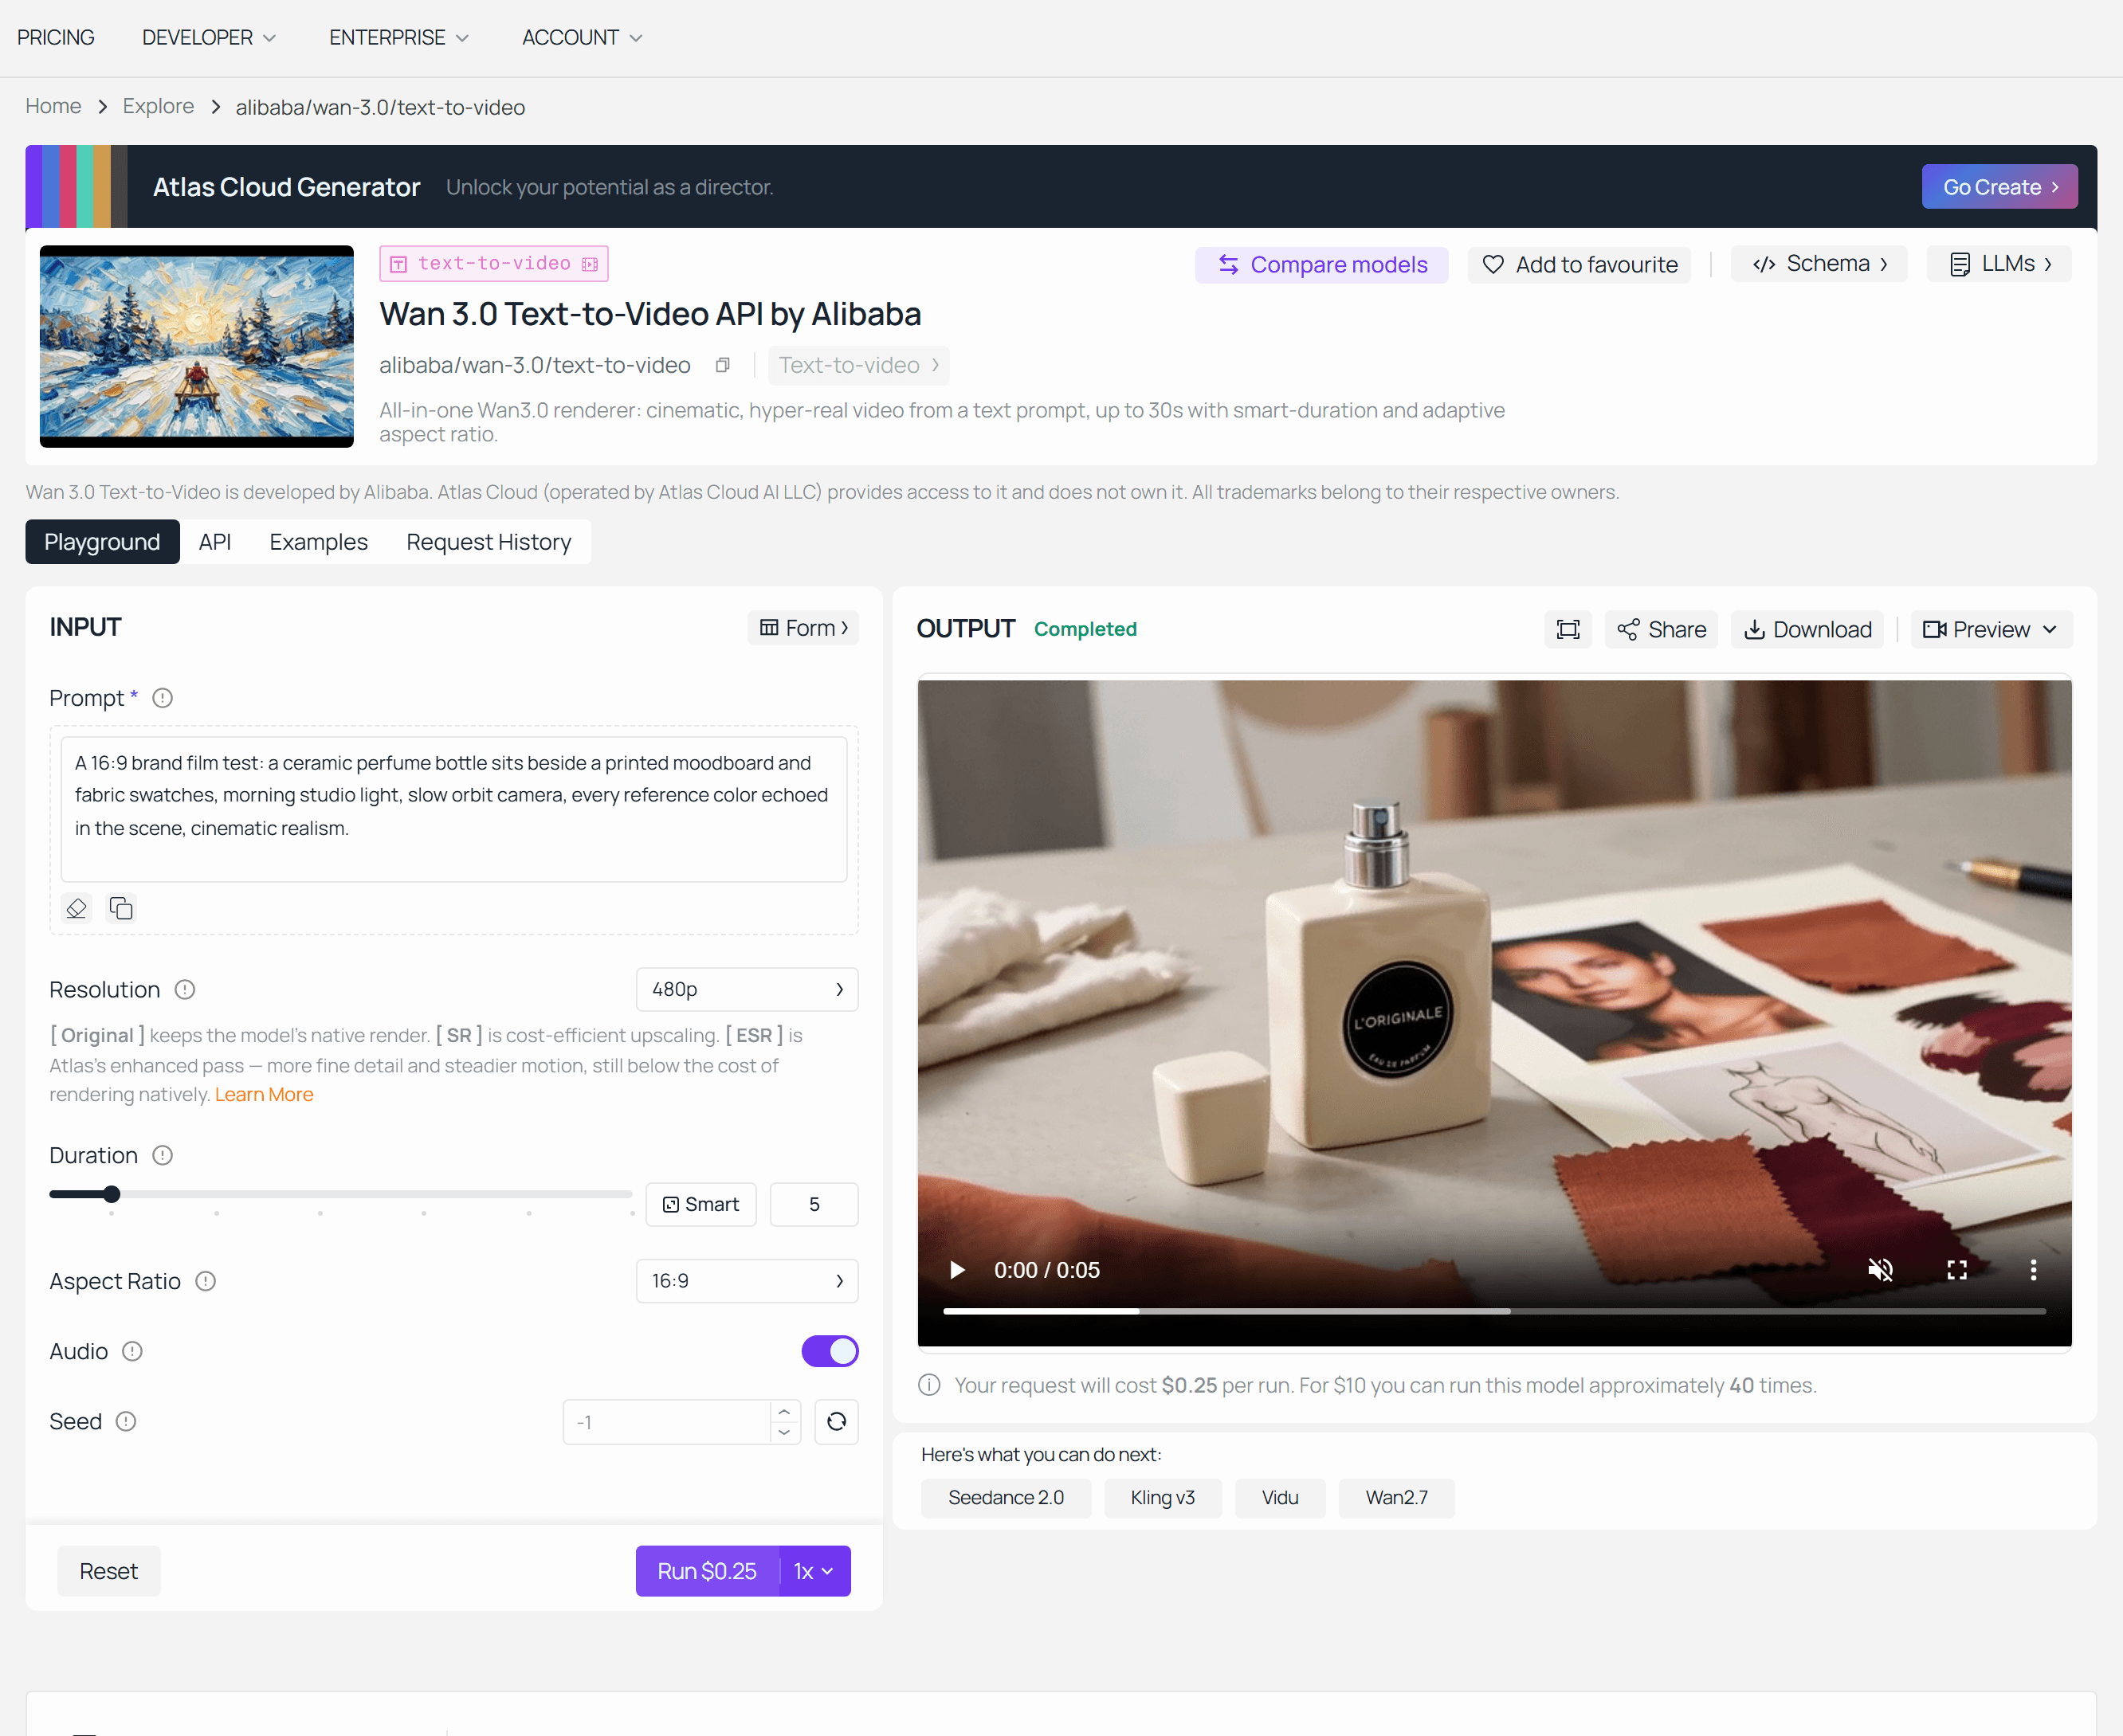
Wan 3.0 프롬프트-결과 스크린샷: 20개 레퍼런스 브랜드 핸드오프.
직접 만들어보기: 4단계로 완성하는 멀티모달 레퍼런스 장면
장면: 파스텔 호텔 프론트 데스크. 무표정한 컨시어지. 랙돌 고양이를 안고 있는 여행자. 컨시어지가 렌즈를 똑바로 응시하며 말합니다. "고양이는 예약이 있습니다. 당신은 없습니다."
이미지 두 개와 음성 클립 하나, 즉 두 가지 모달리티에 걸친 세 개의 레퍼런스 에셋. 이것이 정직하게 멀티모달(단순한 다중 이미지가 아닌)이라고 할 수 있는 가장 작은 구성입니다.
1단계. 레퍼런스 이미지 1 생성 – 고정해야 할 주제
레퍼런스 이미지에는 세 가지 작업만 있고 세 가지뿐입니다. 하나의 주제, 카메라를 향함, 깔끔한 배경. 나머지는 장식입니다. GPT Image 2를 quality high, size 16:9, n=1로 사용하십시오.
Plain1중년 호텔 컨시어지의 전신 스튜디오 초상화. 무표정한 표정, 평평한 더스티 핑크 벽을 배경으로 정중앙에 서 있음. 자주색 더블 브레스티드 벨호프 유니폼에 금색 파이핑과 황동 단추, 작은 둥근 약병 모자, 얇은 콧수염. 완벽하게 대칭적인 프레이밍, 균일한 부드러운 전면 조명, 벽에 그림자 없음, 35mm 필름 그레인, 음소거 파스텔 팔레트. 주제는 한 명만, 다른 사람 없음, 텍스트 없음, 로고 없음, 프레임 내 소품 없음.
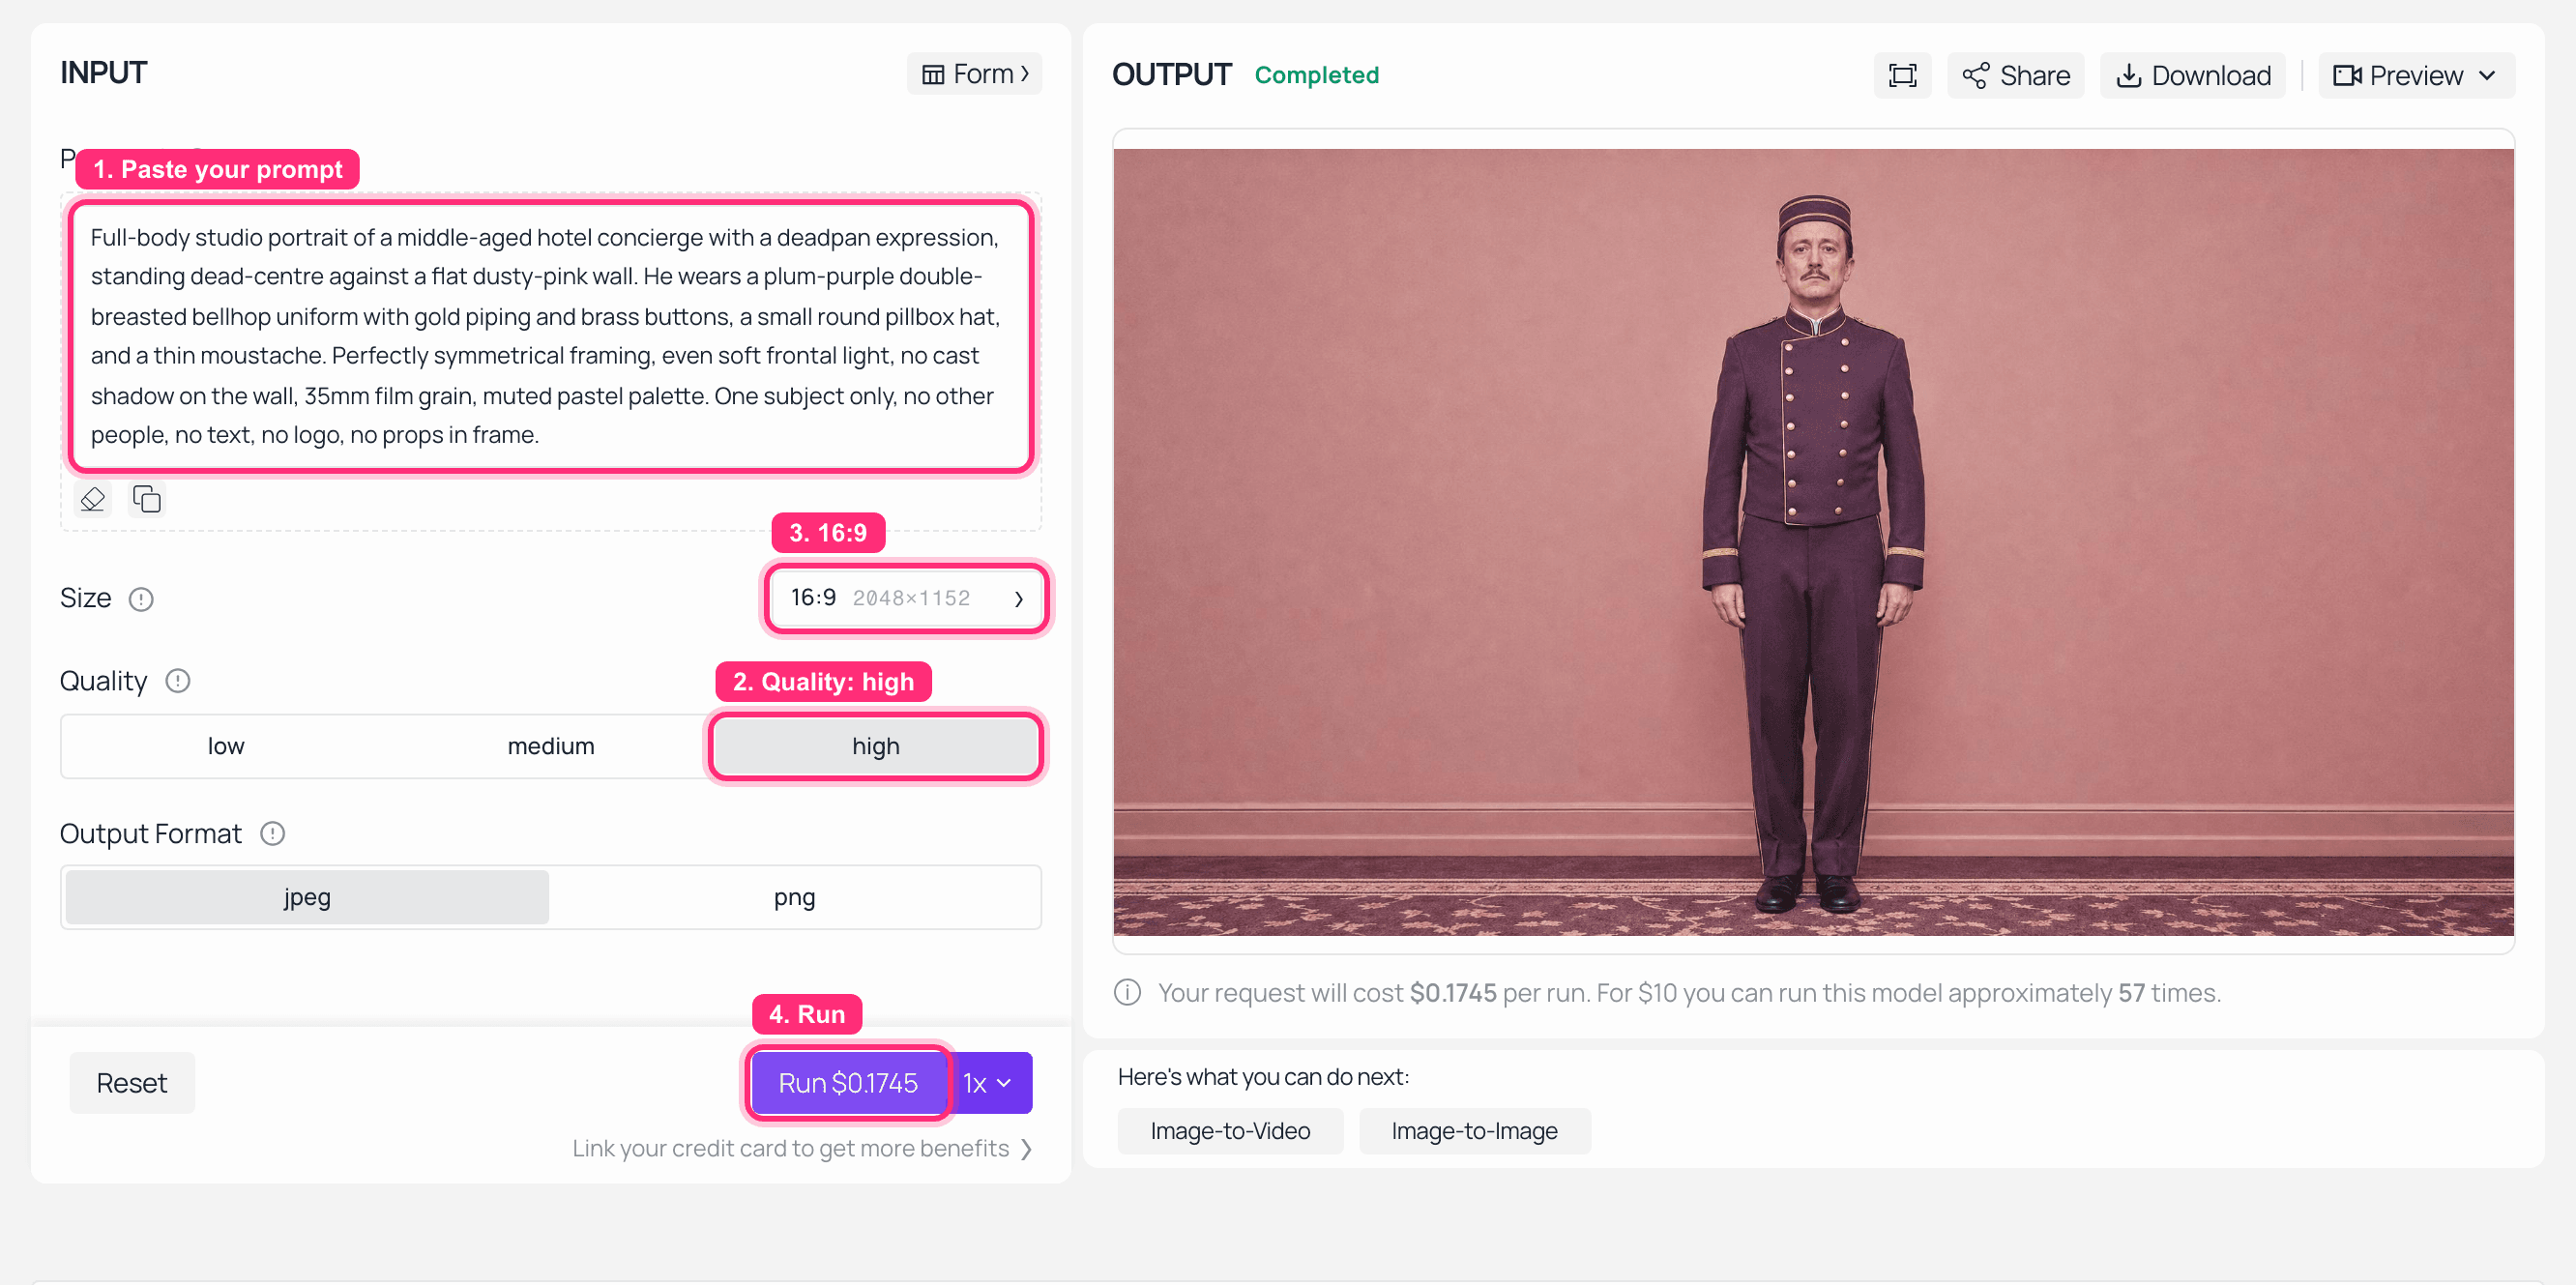
Atlas Cloud의 GPT Image 2 플레이그라운드, 출력 패널에 컨시어지 레퍼런스 초상화가 렌더링됨
Atlas Cloud의 GPT Image 2: quality high, 16:9, 한 명의 주제, 평평한 배경. 이 파일이 character1이 됨.
2단계. 레퍼런스 이미지 2 생성 – 두 번째 고정 주제
동일한 모델, 동일한 설정. 두 캐릭터 간의 색상 대비는 의도적입니다. 모델이 같은 프레임을 공유할 때 쉽게 구분할 수 있도록 하기 위함입니다.
Plain1젊은 여성 여행자의 전신 스튜디오 초상화. 푹신한 랙돌 고양이를 가슴에 안고, 평평한 머스타드 옐로우 벽을 배경으로 정중앙에 서 있음. 머스타드 울 코트, 빨간 베레모, 둥근 거북이 테 안경을 착용하고, 다른 손에는 작은 빈티지 가죽 여행 가방을 들고 있음. 완벽하게 대칭적인 프레이밍, 균일한 부드러운 전면 조명, 벽에 그림자 없음, 35mm 필름 그레인, 음소거 파스텔 팔레트. 주제는 한 명만, 다른 사람 없음, 텍스트 없음, 로고 없음.
3단계. 음성 레퍼런스 생성 – 실제 멀티모달 부분
음성 클립이 이 작업을 다중 이미지 작업에서 멀티모달 작업으로 바꿉니다. Wan 2.7의 오디오 슬롯은 짧은 샘플(약 1~10초)을 원하므로 대사를 짧게 유지하십시오. MiniMax Speech 2.6 HD를 사용하고 낮고 평평하며 방해받지 않는 남성 목소리를 선택하십시오.
Plain1Good evening. Checking in? Of course. Everyone is.
4단계. 한 번의 호출, 세 개의 레퍼런스, 하나의 완성된 클립
이제 전체 팩을 Wan 2.7 레퍼런스-투-비디오에 함께 넣습니다. 설정: resolution: 1080P, ratio: 16:9, duration: 10 (이 모델의 최대치), prompt_extend: false, seed: -1. images를 순서대로 로드합니다. 먼저 1단계를 로드하여 character1에 매핑한 다음 2단계를 character2로 로드하고 3단계 파일을 audio에 첨부합니다.
Plain1파스텔 호텔 로비 프론트 데스크의 대칭적이고 정중앙 와이드 샷. 더스티 핑크 벽과 그 뒤에 머스타드 옐로우 키 랙. character1은 데스크 뒤에 서 있는 컨시어지; character2는 데스크 앞에 서 있는 여행자, 여전히 랙돌 고양이를 안고 있음. 카메라가 완벽한 중앙 축을 따라 천천히 푸시 인하며 절대 기울지 않음. character1이 렌즈를 똑바로 응시하며 평평하게 말함: "The cat has a reservation. You do not." character2가 한 번 깜빡이고 천천히 고양이 쪽으로 고개를 돌린 다음 다시 데스크로 돌림. 고양이는 움직이지 않고 카메라를 똑바로 응시함. 35mm 필름 그레인, 균일한 부드러운 조명, 음소거 파스텔 팔레트, 카메라 흔들림 없음, 컷 없음.
네거티브 프롬프트:
Plain1handheld shake, jump cuts, subtitles, on-screen text, watermark, extra people, deformed hands, face morphing, colour shift, motion blur
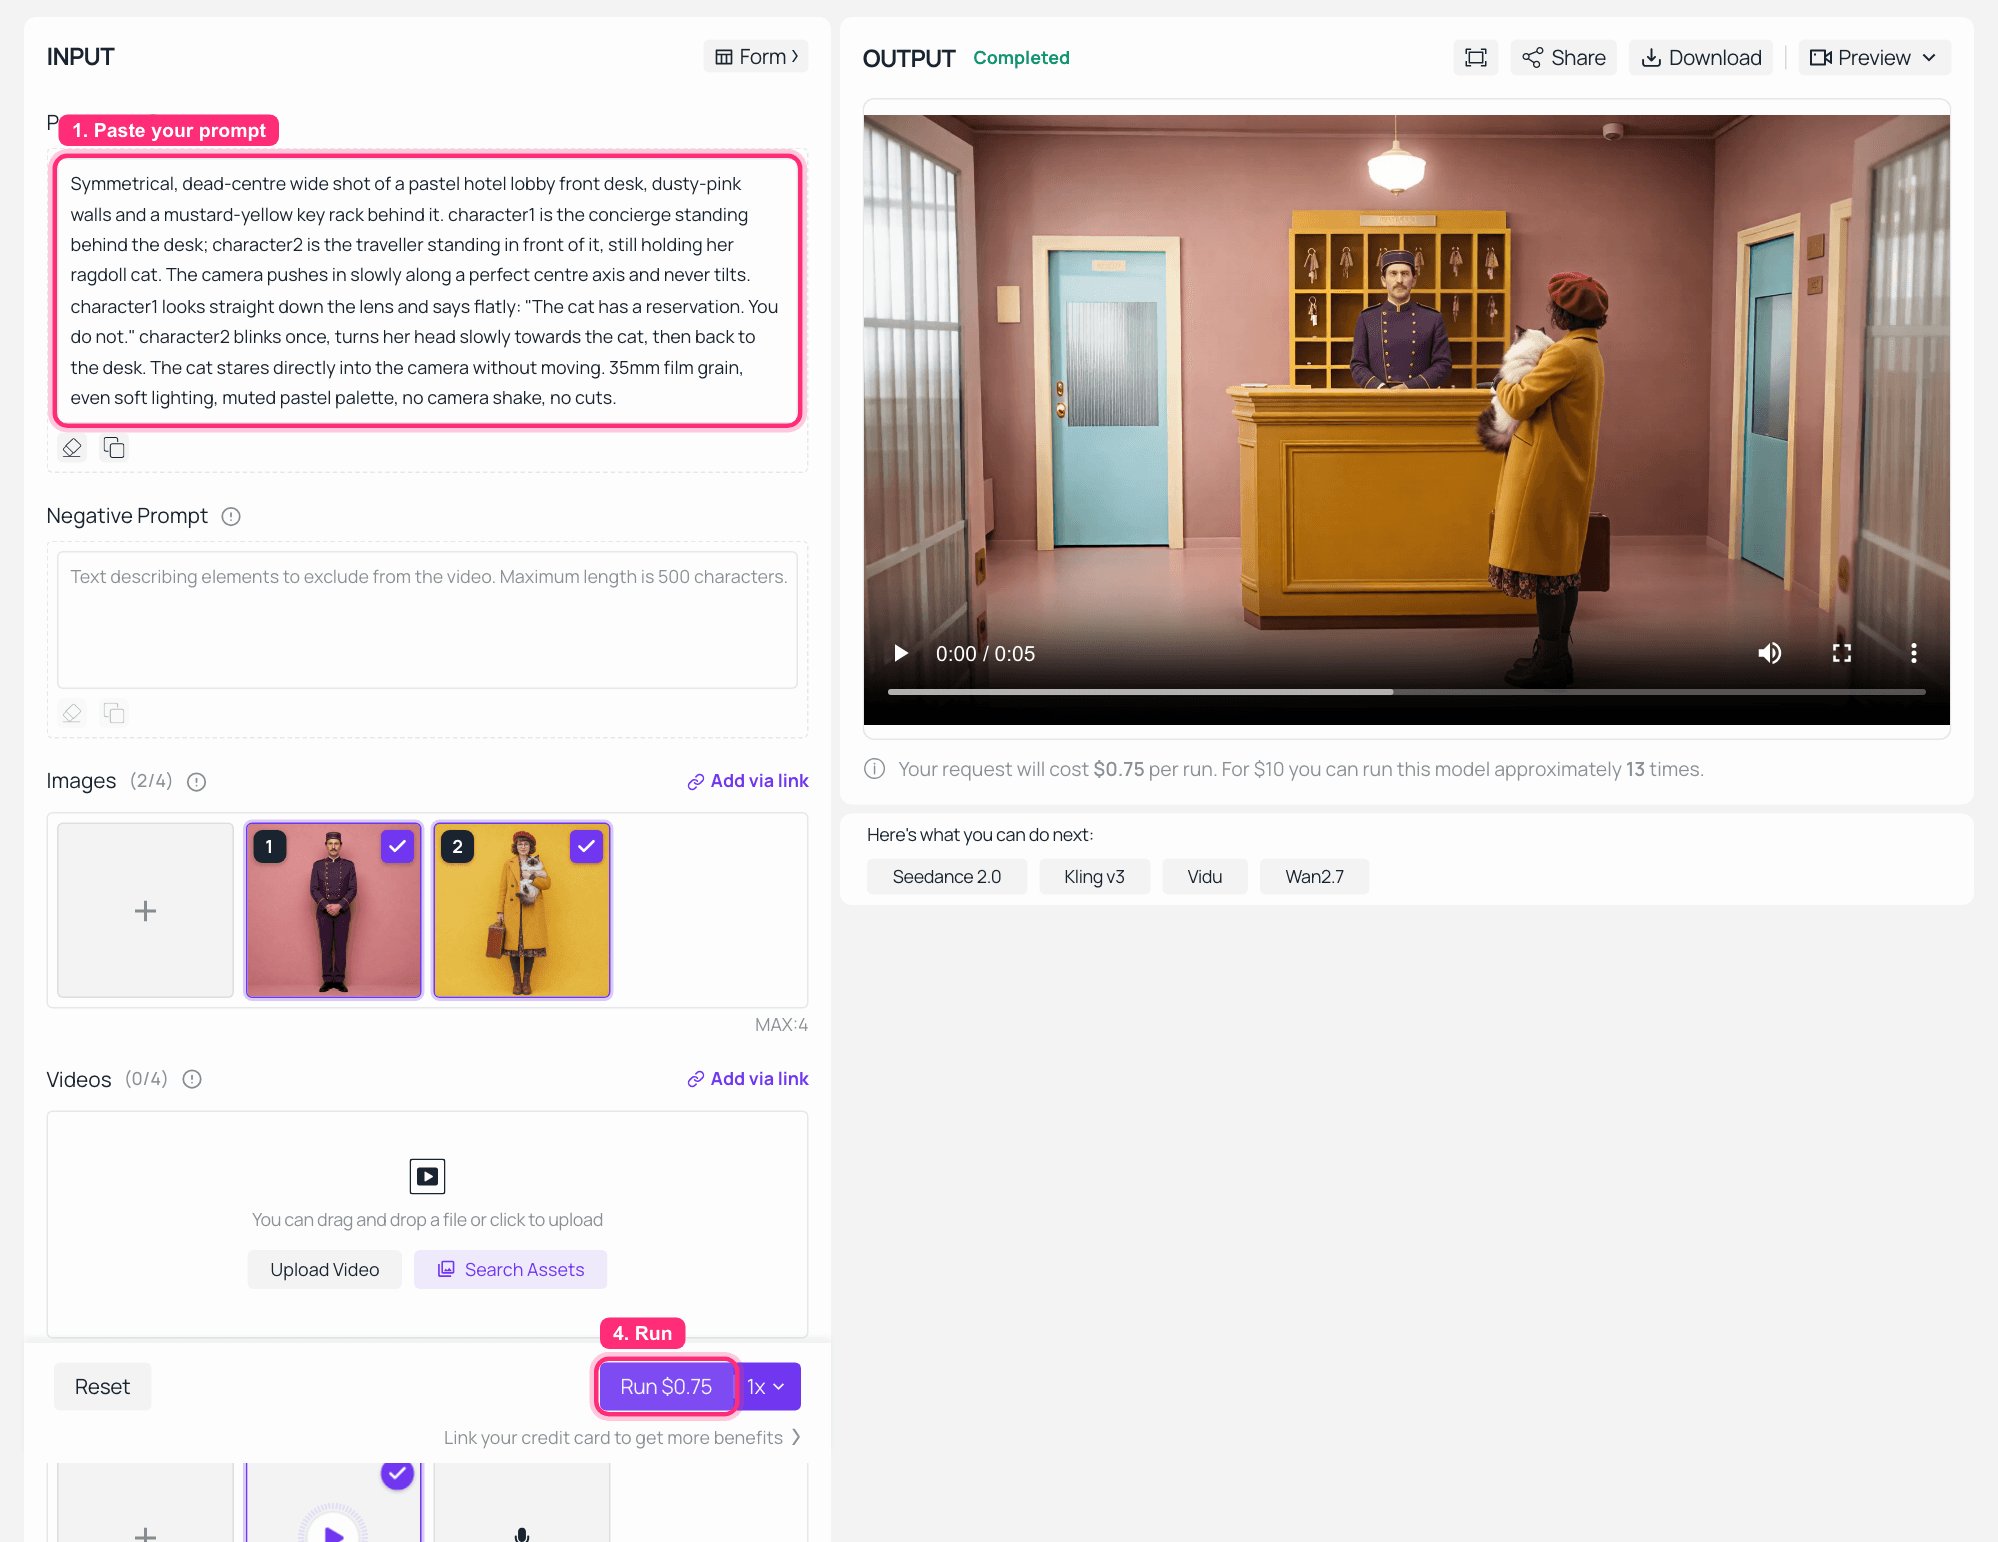
Atlas Cloud의 Wan 2.7 레퍼런스-투-비디오 플레이그라운드, 두 개의 레퍼런스 이미지와 하나의 오디오 파일이 로드되고 완성된 클립이 출력 패널에 표시됨
Atlas Cloud의 Wan 2.7 레퍼런스-투-비디오: 왼쪽에 두 개의 레퍼런스 이미지와 하나의 음성 클립, 오른쪽에 1080P 및 16:9로 재생되는 완성된 테이크. 이 캡처는 모델의 기본 길이로 실행됨; 아래 전체 버전을 보려면 10으로 설정.
완성된 클립. 두 얼굴 모두 유지되고, 두 의상 모두 유지되며, 대사가 3단계의 복제된 목소리로 전달됨. 따라서 이번에는 소리를 켜는 것이 좋음.
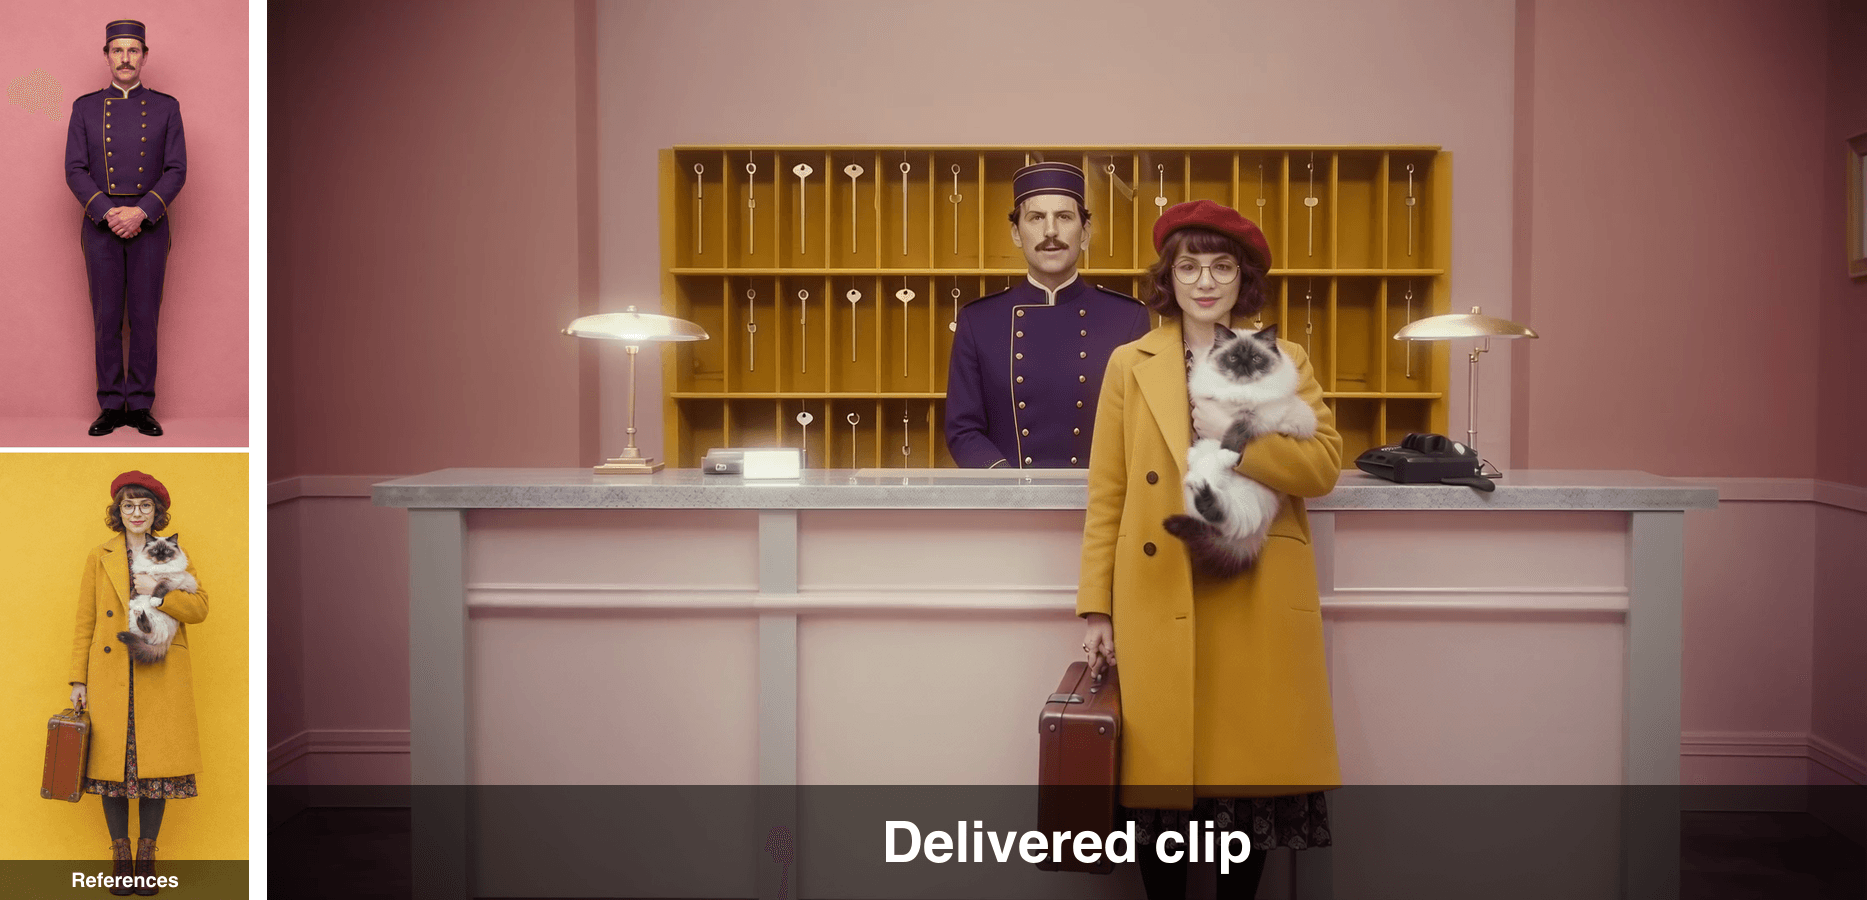
두 개의 레퍼런스 초상화와 완성된 클립의 한 프레임, 동일한 얼굴과 의상 표시
왼쪽의 레퍼런스, 오른쪽의 전달된 클립 프레임. 유니폼 파이핑, 베레모, 안경 및 고양이가 모두 전달됨.
Wan 3.0 멀티모달 레퍼런스 워크플로우 변형
30초로 확장. 동일한 레퍼런스 팩을 Seedance 2.5 레퍼런스-투-비디오에서 duration: 30으로 실행하면 베타를 기다리지 않고 Wan 3.0이 약속하는 길이를 얻을 수 있습니다. 최대 30개의 레퍼런스 이미지, 10개의 비디오 및 10개의 오디오 클립을 허용하므로 팩을 확장할 여지가 있습니다. 추가 20초는 프롬프트에서 분위기가 아닌 비트로 작성하십시오. 그렇지 않으면 모델이 채우기만 할 것입니다.
Atlas Cloud의 Seedance 2.5 레퍼런스-투-비디오 플레이그라운드, 길이가 30으로 설정되고 긴 테이크가 렌더링됨
Atlas Cloud의 Seedance 2.5 레퍼런스-투-비디오, 길이가 30으로 설정되고 동일한 두 개의 레퍼런스 초상화가 첨부됨, 생성 중간에 캡처됨. 프롬프트의 @image1 및 @image2 칩에 주목: 이것이 Seedance에 어떤 레퍼런스가 어떤 역할을 하는지 알리는 방법입니다. 실제로 제출될 작업의 길이를 반영하므로 Run 버튼의 견적 가격을 확인하십시오.
동일한 장면의 30초 버전, 동일한 레퍼런스 팩, 비트가 샷별로 작성됨.
동작 전용 레퍼런스 비디오 추가. 마음에 드는 페이싱의 클립을 첨부하고 프롬프트에 명시적으로 "절단 리듬만을 위해 레퍼런스 비디오를 따르고, 주제와 설정은 무시"와 같이 말하십시오. 이것이 위의 카드-플립 예시 뒤에 있는 트릭입니다.
긍정 프롬프트를 건드리기 전에 네거티브 프롬프트로 드리프트 수정. 얼굴 변형, 색상 이동 및 핸드헬드 흔들림이 레퍼런스 고정 샷을 망치는 세 가지이며, 일반적으로 설명을 피하는 것보다 억제하는 것이 더 저렴합니다.
멀티모달 레퍼런스 형식을 무료로 사용해보기
매개변수를 원하기 전에 이 형식을 원한다면, Atlas Cloud는 지난 주에 무료 AI 광고 스킷 생성기를 출시했습니다. 이 생성기는 동일한 체인을 실행하며 조정할 손잡이가 전혀 없습니다.
제품과 판매 포인트에 대해 한 줄을 작성하면, 후크, 갈등, 반전이 있는 두 캐릭터 코미디 스크립트를 작성한 다음 내장된 음성 대화와 음향 효과와 함께 15초 비디오를 렌더링합니다. 최대 4개의 실제 제품 사진을 레퍼런스로 첨부할 수 있으며, 광고는 스크립트부터 최종 프레임까지 모양, 색상, 라벨 및 로고를 유지합니다. 여섯 가지 스타일(재미있는 밈, 플롯 트위스트, 시트콤, 럭셔리, 하드 셀 등)이 함께 제공되며, 대화는 설명을 작성한 언어로 반환됩니다.
이것은 튜토리얼의 동일한 두 캐릭터 + 레퍼런스 이미지 + 음성 체인이며, 프롬프트 작성과 비용이 없습니다. 따라서 이 형식이 제품에 적합한지 비용을 들이기 전에 알아보는 좋은 방법입니다.
레퍼런스 스틸 더미가 제품 조각에 어떤 영향을 미치는지 감을 잡으려면, 이것이 Wan 3.0 자체 버전입니다. 이미지 5개 입력, 하나의 런치 릴 출력, 각 스틸이 편집의 한 비트를 고정합니다.
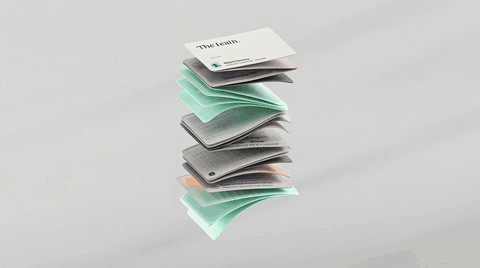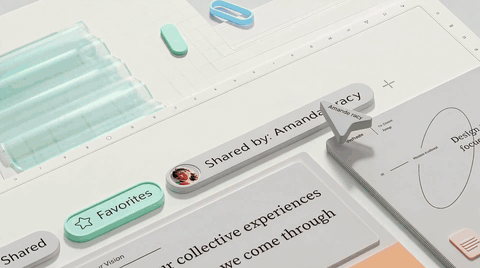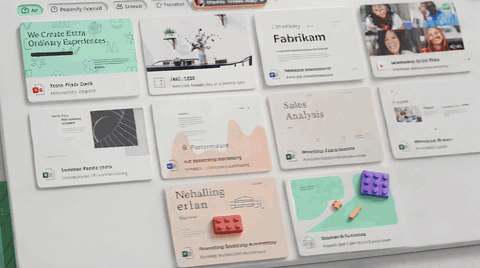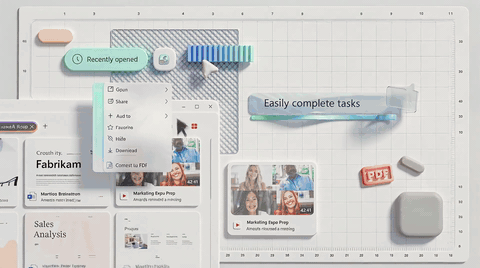
다섯 개의 레퍼런스 스틸이 Material Design 스타일 제품 런치 릴로 확장됨_다섯 개의 레퍼런스 이미지가 9초 제품 필름을 구동하며, 각각 하나의 비트를 고정하고 다음으로 넘김. 출처: Alibaba 공식 Wan 3.0 제작자 핸드북._
Wan 3.0 멀티모달 레퍼런스 클립 비용
| 단계 | 모델 | 단가 | 수량 | 비용 |
|---|---|---|---|---|
| 1 및 2, 레퍼런스 이미지 2개 | GPT Image 2 | 이미지당 $0.009 | 2 | $0.02 |
| 3, 음성 레퍼런스 | MiniMax Speech 2.6 HD | 1K 문자당 $0.08 | 49자 | $0.00 |
| 4, 1080P에서 10초 테이크 | Wan 2.7 레퍼런스-투-비디오 | 1080P에서 초당 $0.15 | 10초 | $1.50 |
| 튜토리얼 총계 | 약 $1.52 | |||
| 변형, 30초 | Seedance 2.5 레퍼런스-투-비디오 | 480P에서 초당 $0.134 | 30초 | 약 $4.02 |
| 무료 경로 | 무료 AI 광고 스킷 생성기 | 무료 | 1 클립, 15초 | $0 |
이는 2026년 8월에 확인된 플랫폼 자체 요금이며 종량제로 청구됩니다. 사람들이 예상보다 더 많이 움직이는 두 가지는 해상도입니다. 비교표의 초당 $0.10은 Wan 2.7의 기본 요금이며, 1080P는 $0.15로 청구되므로 위의 $1.50가 발생합니다. 두 번째는 Seedance가 픽셀 수로 가격을 책정하므로 나열된 $0.134/초는 480P 수치이며 720P 테이크는 단순한 곱셈보다 더 많은 비용이 듭니다. 참고로, 보고된 Wan 3.0 베타 요금(1080p에서 초당 $0.20)은 전체 30초 테이크에 약 $6이며, 이는 오늘 480P에서 Seedance 경로보다 더 비쌉니다.
이것을 사용할 때 참고 사항. Wan 3.0은 베타이며 이용 약관이 변경될 수 있으므로, 파이프라인을 구축하기 전에 다시 읽으십시오. 레퍼런스 이미지가 실제 사람인 경우, 먼저 허가를 받으십시오. 레퍼런스-투-비디오는 정확히 그것을 중요하게 만드는 기능이기 때문입니다. 이 기사의 예시 클립은 Alibaba가 공개 제작자 핸드북에서 생성한 자체 결과이며, 논평을 위해 여기에 재현되었습니다.
자주 묻는 질문
Wan 3.0의 멀티모달 레퍼런스는 실제로 몇 개의 레퍼런스를 받을 수 있나요?
단일 호출에서 최대 20개의 에셋을 받을 수 있으며, 이미지, 비디오, 오디오, 문서 및 웹페이지에서 가져옵니다. 실제 한계는 기술적 한계보다 낮습니다. 각 에셋에 정확히 하나의 작업을 할당하고, 이미지당 하나의 주제를 유지하면 대부분의 장면에서 20개보다 훨씬 적게 사용하게 됩니다.
Wan 3.0이 정말 PDF나 웹페이지를 비디오로 바꿀 수 있나요?
예, 그것이 진정으로 독특한 부분입니다. 텍스트, 이미지, 오디오 및 비디오와 함께 문서 파일 및 라이브 URL을 허용하며, 베타 보고에 따르면 .doc, .xls, .ppt, .pdf 및 .txt가 포함됩니다. 위 비교표의 다른 레퍼런스-투-비디오 모델 중 어느 것도 문서를 전혀 받아들이지 않습니다.
Wan 3.0은 오픈 소스인가요? ComfyUI에서 실행할 수 있나요?
아니요, 그리고 지금은 불가능합니다. Wan 3.0은 Alibaba 자체 클라우드에서 실행되는 비공개 베타입니다. 이전 Wan 세대는 공개적으로 출시되어 기대가 생겼지만, Alibaba는 3.0에 대한 가중치를 확인하지 않았습니다. Wan 3.0의 1.3B 또는 14B Apache 2.0 릴리스를 주장하는 페이지는 공식적으로 뒷받침되지 않습니다.
Wan 3.0을 타사 API를 통해 사용할 수 있나요?
아직은 아닙니다. Atlas Cloud도 포함됩니다. 오늘 호출할 수 있는 가장 가까운 것은 Wan 2.7 레퍼런스-투-비디오(입력 형태가 문서 및 웹페이지 모달리티를 제외하고 옴니 레퍼런스와 거의 정확히 일치함) 또는 전체 30초가 필요한 경우 Seedance 2.5 레퍼런스-투-비디오입니다.
레퍼런스 고정, 두 캐릭터 비디오를 테스트하는 가장 저렴한 방법은 무엇인가요?
위에 링크된 무료 AI 광고 스킷 생성기입니다. 제품 사진 4장을 넣으면 15초짜리 음성 두 캐릭터 클립이 출력되며, 매개변수와 비용이 없습니다. 제품과 형식이 유지되면 유료 체인을 조정하십시오.
레퍼런스 이미지를 사용해도 캐릭터가 계속 드리프트하는 이유는 무엇인가요?
세 가지 원인이 있으며, 빈도순으로 나열합니다. 하나의 레퍼런스가 두 가지 작업을 수행하고 있어 얼굴과 위치를 모두 고정하도록 요청받고 있습니다. 레퍼런스 이미지에 두 명 이상의 사람이나 복잡한 배경이 있어 모델이 어떤 부분을 잠글지 모릅니다. 또는 드리프트가 레퍼런스 실패가 아닌 렌더링 아티팩트인 경우, 다시 작성하기 전에 네거티브 프롬프트에 face morphing, colour shift를 넣으십시오.


