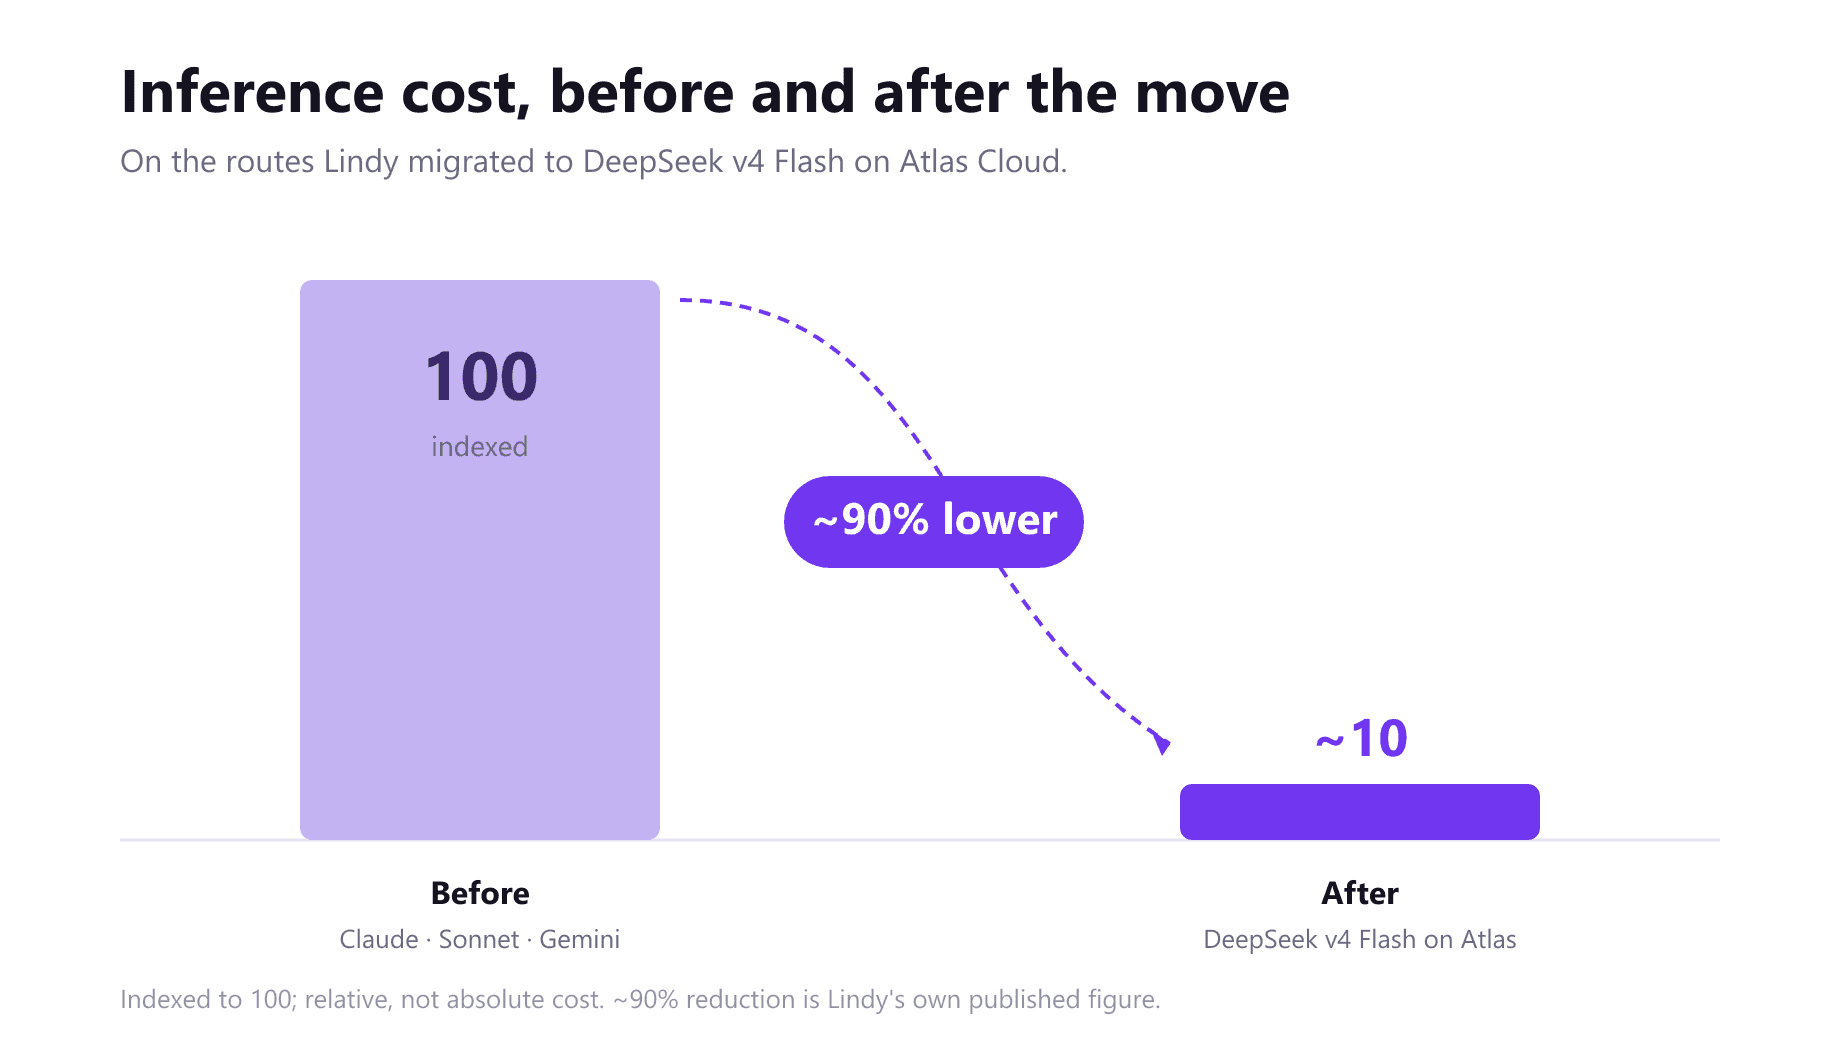
Lindy bouwde de AI-medewerker. Het verplaatste de vloot naar open-weight-modellen die worden geserveerd via Atlas Cloud_ en verlaagde daarmee de inferencekosten met ongeveer 90%, zonder een slechter product te leveren._
~90% lagere inferencekosten · 60% van de inputtokens uit cache · 3.000+ verzoeken per minuut volgehouden · 10x+ verkeersgroei, niets herbouwd · 24 modellen van 11 labs op één sleutel
Lindy draait een van de meest veeleisende agent-workloads in productie, en het draait op Atlas Cloud. Dit is wat dat veranderde:
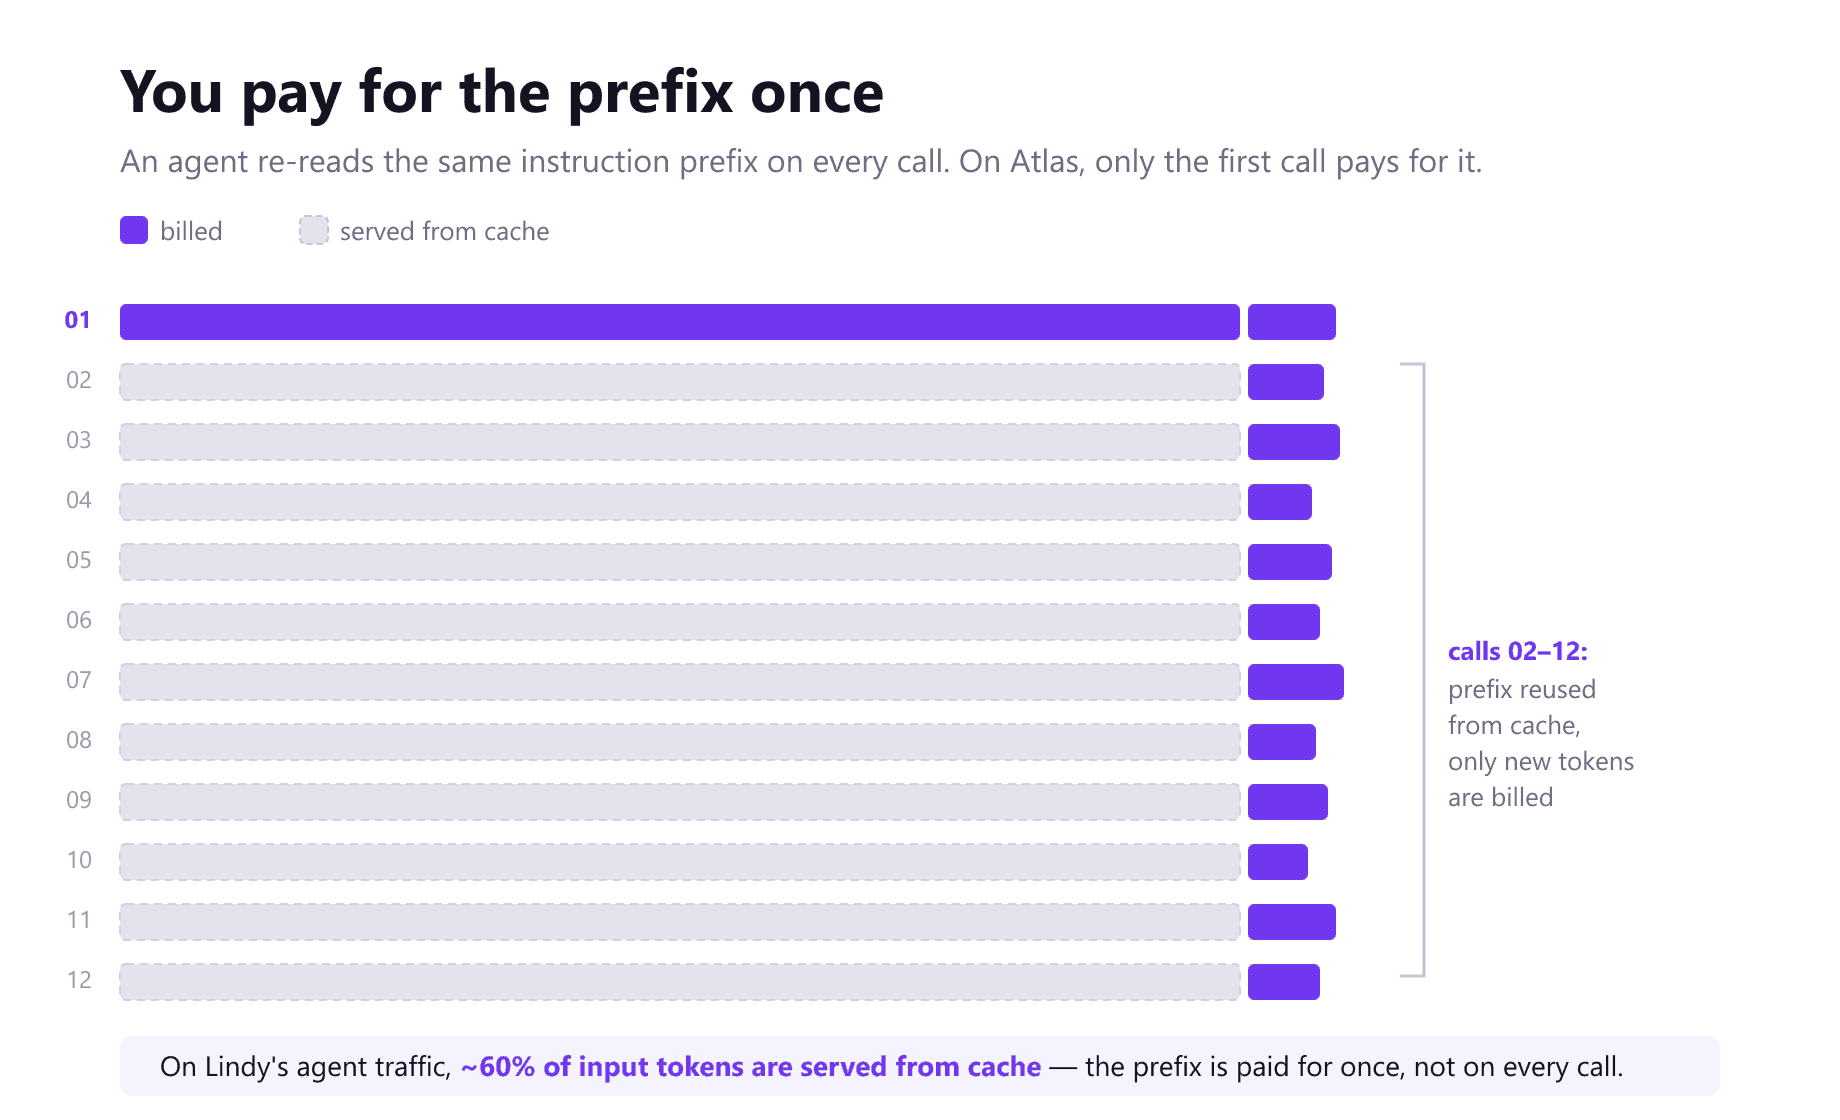
- Omdat Atlas de herhaalde oproep afrekent tegen cachetarief, laat Lindy agents draaien die hun werk controleren in plaats van te gokken. Zes van de tien inputtokens die het verstuurt, worden uit de cache geserveerd, waardoor het prefix dat een agent tien keer per taak herleest, bijna niets meer kost.
- Omdat Atlas de workload provisioneert, kon Lindy het volume meer dan vertienvoudigen door simpelweg meer verkeer te sturen, zonder iets te herbouwen; Atlas houdt het boven de 3.000 verzoeken per minuut, een uur lang na Elkaar.
- Omdat Atlas de hele catalogus op één sleutel draagt, kan Lindy in een middag overschakelen op een nieuw model. Inmiddels zijn 24 modellen van 11 labs door één integratie gelopen.
- Omdat Atlas het levert op een concreet, SOC 2-gecertificeerd contract, kan Lindy een open-weight-model voor de data van klanten zetten en verantwoordelijkheid nemen voor wie het draait.
De 90% is de headline van Lindy. De reden dat dat vasthoudt, en de reden dat de volgende migratie gemakkelijker zal zijn dan deze, is het platform eronder.
Voor Lindy is de rekening de business
Lindy bouwt AI-medewerkers. Een Lindy Teammate sluit zich aan bij een bedrijf zoals een nieuwe collega dat doet: hij neemt verzoeken aan in Slack, koppelt er de apparaat die het team al gebruikt, zit in vergaderingen en houdt bij wat hij leert zodat het volgende verzoek verder gaat dan het vorige. Niemand schrijft een automatie; ze delegeren, en de agent doet het werk.
Dat ontwerp legt een stevige infrastructuurrekening neer. Een AI-medewerker die een thread leest, een kalender bekijkt, een record opzoekt en een antwoord opstelt, heeft al een dozijn model-oproepen gedaan voordat iemand een woord ziet, en omdat een Teammate een heel team bedient, groeit het volume mee met elk personeelslid. Bij die vorm is de prijs van het achterliggende model bepalend voor het sociaals:
"De prijsstelling van Lindy werkt alleen als inference steeds goedkoper blijft."
— Bruno Škvorc, Staff Software Engineer, Lindy
Daarom deed Lindy wat de financië (business) voorschrijft. Het verplaatste het grootste deel van hun managed-agent- verkeer van Claude, Sonnet en Gemini naar DeepSeek v4 Flash op Atlas Cloud, en de inferencekosten op de gemigreerde routes daalden met ongeveer 90%. Het veranderen van de modelnaam duurde een middag. Het zou de gok wet te maken, op productie-volume, zonder dat je product er slechter op wordt, is waarom ze voor Atlas Cloud kozen.
Waarom de 90% standhoudt: die elfde oproep is bijna gratis
Als je per token alpha betaalt, rekent een agent voor hetzelfde prefix dertien keer per taak de volle prijs, en die rekening groeit naarmate het model "zorgvuldiger" denkt. Die omgevingsrijke belasting houdt het product gebou-dept: één doorgang in plaats van d, omdat de derde even duur is als de eerste. Het is ook de reden dat een onwetend modelwissel minder opbrengt dan het striptje het noemen zegt: het herhaalde prefix vult de rekening opnieuw en opnieuw.
Atlas haalt die belasting eruit op de zwaarste plek. Zes van de tien input-tokens van Lindy worden herkend and niet opnieuw verwerkt, tegen een tarief dat is afgestemd op hun werkelijke volume, dus het prefix dat in elke agent-call domineert blijft vrijwel gratis. Dat is waarom een modelwissel een duurzaam 90%-voordeel wordt en niet een getal dat uitdoegholt als het gebruik al.steeds stijgt, en daardoor kan een agent op Atlas drie doorgialen doen; waar dezelfde opent op kosten-basis er maar één kan doen.
"Agent-workloads hergebruiken veel context over heel vele model-calls. De caching van Atlas zorgt dat we voor diezelfde context niet elke keer de volle prijs betalen; een groot deel vanwaar dat de besparing urlijners op schaal is gebleven."
— Ian McGregor, Head of Engineering, Lindy
Capaciteit die er al was voordat Lindy erom vroeg
Bij agentverkeer is er geen rustig nachtvenster en geen geplande lunch dag. Het werk komt binnen terwijl de teams werken en stopt dat je schaalt. Waar het op aankomt is niet het piekmoment dat een buffer opvangt, maar de snelheid die een provider kan vasthouden. Lindy vertienvuldige het volume meer dan tienvoudig door meer verkeer te sturen, niet door iets te herbouwen, en Atlas hield meer dan 3.000 verzoeken per minuut vol- een uur = lang. Capaciteit zat voor de workload, dus schalen was een zakelijke keuze en nooit een infrastructuurproject.
Support die producten oplevert, geen tickets
Op dit volume is het verschil tussen providers minder het dashboard en meer wie reert antwoordt wanneer iets niet klopt. De engineers van Lindy en Atlas's inference-engineers zitten in hetzelfde kanaal, en de antwoorden komen dezelfde dag uit handen van mensen die er ook wat aan kunnen doen. Sommige worden zelfs productveranderingen: Lindy vroeg om overdracht van een teamaccount te kunnen doen; Atlas ondersteunde dat destijds, het verwdeeld, met de engineers van Atlas die zelf het account overhandigenen.
"Een provider die je kunt benoemen
Naadwerken voor een open-weight-model verdwijnt de partij die voorheen antwoord gaf op de vraag hoe het model zou moeten draaien. Een vraag die voorheen door het label van een lab werd beantwoord, wijst nu naar de provider: wie draait dit, onder welke guards, en wat gebeurt er met de data die passeert. Atlas beantwoordt dat bij naam, niet via een router, op een op naam contract, met SOC 2-plus-certificatie, met en data die én wordt opgeslagen noch gebruikt voor trainingen. Dat telt meer at voor een AI-werknemer dan voor een chatproduct, omdat hetzatt een Teammate de Slack-threads, agenda en archieven ziet van het bedrijf waar het voor zijn werkt. De infrastructuur-vraag ligt direct onder de klantentrouwe-vraag, en dat is bij Atlas beide op-gelost.
Not locked to DeepSeek, no lock when anything
De migratie verbond Lindy aan een strategie, niet aan een model. DeepSeek v4 Flash won de workloads waar hij werd getest en behoudt die plek zolang hij de best-prijs bij voldoende kwaliteit is. De volgende winnaar kan komen uit een ander lab met een andere license, en omdat Atlas Cloud-toegang geeft tot modellen met één API, testen kost je een middag en heb geen inkoopcyclus. Op één testdag stuurde Lindy 47 vrager in twaalf modellen die ze nooit eerder hadden gebruikt, over zeven afgelegen labs en der streams, alleen via de sleutel ze al had. Drie daarvan is productie. De vrijheid om altijd te beste model te draaien via de Atlas Cloud geeft Lindy echte operationele flxxxxibleerd.
Als agents op een marktplaats draait, verplaats ze dan
Lindy heeft wel-dit pad gelopen: zij leerde DeepSeek over de e-erken op genviste, kon daarvoor het model daar vallideren, en bewees dat het verplaatsing waard was. In dezelfde test zag op dat ze ook het ding dat bepaald heeft waar de productie zou draaien.
"We hebben hetzelfde model ook bij andere inference-providers en test_den. Vervelend genoeg maakte de provider uit. Hetzelfde nominale model kon extra scoren afhankelijk van heten die het."_
— Bruno Škvorc, Staff Software Engineer, Lindy
Een marktplaats die is ontworpenom je te laten winkelen is niet om erp je product te draaien. Als je productieverkeer via een router stuurt, gaat het naar wa.
Deze getupdate of quote?


