Een groen API-testrapport voelt geruststellend totdat je merkt dat elke assertion alleen HTTP 200 controleert. De respons kan het record van de verkeerde klant bevatten en toch slagen.
Kies AI-tools voor API-testen op basis van het werk dat je al hebt. Evalueer Postman Agent Mode als je team collections onderhoudt, KushoAI als een specificatie je startpunt is, en Keploy als je gegenereerde flows of regressietests wilt die zijn gebouwd op opgenomen verkeer. Beoordeel en voer de resulterende tests uit voordat je ze vertrouwt.
Deze gids behandelt AI-ondersteuning voor het testen van gewone API's. Het testen van de nauwkeurigheid van de antwoorden van een AI-model is een afzonderlijk evaluatieprobleem.
Belangrijkste conclusies
- Lever het contract, request-afhankelijkheden en goedgekeurde zakelijke verwachtingen aan.
- Controleer of assertions verkeerde gegevens, ontbrekende velden en gebroken typen afwijzen.
- Koop pas nadat de beoordeelde tests herhaaldelijk in je beoogde CI-omgeving draaien.
De productvergelijking hieronder weerspiegelt officiële documentatie die op 21 september 2026 is gecontroleerd. Het is geen head-to-head benchmark van drie betaalde accounts.
Het uitgewerkte voorbeeld gebruikt een vastgezette Swagger Petstore-specificatie en scheidt contractverwachtingen, waargenomen gedrag en opzettelijk gewijzigde responskopieën.
Onze lokale run slaagde voor 5 live tests en verwierp alle 3 opzettelijk gewijzigde responskopieën. Een afzonderlijke probe met ontbrekende naam gaf nog steeds 200 terug, wat laat zien waarom de scope van een groen rapport ertoe doet.
Wat AI-tools voor API-testen echt doen
AI-ondersteuning komt meestal op vier plekken in API-testen terecht. Een model leest je specificatie, stelt scenario's voor, schrijft assertions en helpt bij het verklaren van fouten. Elk onderdeel vereist ander bewijs. Een plausibele verklaring van een fout bewijst niet dat de voorgestelde oplossing correct is.
Geef voor specificatiebeoordeling het OpenAPI-bestand en de relevante bedrijfsregels mee. Voeg voor scenarioplanning voorbeelden van geldige gegevens en bekende grenzen toe. Neem voor uitvoerbare scripts je runner, authenticatie-instellingen en fixture-conventies op. Geef voor diagnose het werkelijke request, de respons en de foutmelding nadat je secrets hebt verwijderd.
Houd deze vier mechanismen gescheiden bij het evalueren van producten:
- LLM-generatie: stelt tests voor op basis van taal, schema's en voorbeelden. Een reviewer moet de verwachte uitkomsten controleren.
- Traffic replay: vergelijkt later gedrag met vastgelegde interacties, vaak met opgenomen dependency-responses.
- Property-based testing: construeert systematisch inputs om eigenschappen zoals schemaconformiteit uit te dagen.
- Testuitvoering: verstuurt requests, evalueert assertions en retourneert rapporten en exitcodes.
Een product kan verschillende mechanismen combineren. Vraag welk mechanisme elke test heeft geproduceerd en wat de verwachte uitkomst bepaalt. Het opnemen van een onjuiste respons kan dezelfde fout bewaren als regressiebasislijn. Het genereren van een gepolijste testnaam kan een niet-onderbouwde verwachting verbergen.
Denk aan assertions op drie niveaus. Ten eerste: reageerde de server succesvol? Ten tweede: heeft de body de gedocumenteerde velden en typen? Ten derde: vertegenwoordigt deze body de resource en operatie die je hebt aangevraagd?
Voor een pet-lookup faalt een geldig object met een integer-ID nog steeds bij de derde controle als dat ID bij een andere pet hoort. Omgekeerd bewijst het matchen van het aangevraagde ID niet dat elk veld aan het schema voldoet. Gebruik beide controles en voeg alleen bedrijfsregels toe waar het team een overeengekomen bron voor heeft.
De praktische output die je wilt, is een onderhoudbaar testasset met een uitlegbare oracle: een duidelijke reden waarom elk resultaat zou moeten slagen of falen. Tel nuttige scenario's na beoordeling, inclusief degenen die je afwijst, in plaats van de lengte van de initiële gegenereerde lijst te vieren.
AI-tools voor API-testen vergeleken per workflow
Begin met het artefact dat je team vandaag kan leveren. Een bestaande collection migreren, ontbrekende bedrijfsregels reconstrueren en dependency-recording opzetten zijn verschillende projecten. Een tool die bij het ene startpunt past, kan bij het andere extra werk opleveren.
| Tool of aanpak | Nuttige input | AI- of automatiseringsrol | Uitvoerings- en CI-route | Beoordeelbare output | Belangrijkste testvraag |
|---|---|---|---|---|---|
| Postman Agent Mode | Collections, requests, responses, environments, specificaties | Schrijft en bewerkt testscripts in workspacecontext | Collection Runner en compatibele CLI-workflow | Standaard Postman JavaScript-assertions | Behoudt het je variabelen en test het het contract? |
| KushoAI | OpenAPI, Postman-collection, cURL | Genereert scenario's en testsuites; ondersteunt natuurlijke-taalverfijning | Platformuitvoering en gedocumenteerde CI-integratie; controleer rechten | Inspecteer gegenereerde requests, dependencies en verwachte uitkomsten | Kan je gekozen plan de suite uitvoeren en bewaren waar je die nodig hebt? |
| Keploy | Specificaties of requestdefinities; als alternatief echt verkeer | AI-generatie en een afzonderlijke record/replay-route | Gegenereerde flows of opgenomen tests in ondersteunde lokale/CI-omgevingen | Beoordeel testdefinities, basislijnen en dependency-mocks | Welke route dekt je werkelijke faalmodi? |
| Bestaande runner plus een LLM | Goedgekeurde matrix, specificatie, fixture-conventies | Schrijft code ter beoordeling | Je pytest of een andere gevestigde runner | Code die in je repository is vastgelegd | Is beoordeling goedkoper dan dezelfde tests direct schrijven? |
Postman Agent Mode voor bestaande collections
Postman is een redelijke eerste evaluatie wanneer je collection al nuttige requestvolgorde, omgevingsvariabelen en authenticatie-instellingen bevat. Agent Mode kan die context gebruiken om standaard JavaScript-testscripts te genereren. Die scripts kunnen in de bestaande collection-uitvoeringsworkflow terechtkomen in plaats van een nieuwe assertion-taal te vereisen.
Een gerichte proef is onthullender dan vragen om alles te testen. Selecteer het request dat een eerder in de collection aangemaakte resource ophaalt. Lever het schema aan en vraag om validatie van verplichte velden, gedocumenteerde veldtypen en een assertion die het teruggegeven ID verbindt met het opgeslagen aanmaak-ID.
Inspecteer vervolgens de voorgestelde wijzigingen voordat je ze accepteert. Een responsvoorbeeld kan een pet bevatten die Milo heet. Gelijkheid met Milo is betekenisvol als je fixture Milo expliciet heeft aangemaakt; het is fragiel als de generator een naam uit een gedeeld voorbeeldrecord heeft gekopieerd. Dezelfde literal kan een geldige assertion of een toevallige dependency zijn, afhankelijk van de bron.
Controleer de scope van variabelen zorgvuldig. Een ID dat in een omgevingsvariabele is opgeslagen, moet beschikbaar zijn voor het latere request en moet bij die run horen. Gedeelde variabelen tussen gelijktijdige runs kunnen intermitterende fouten veroorzaken die op serverdefecten lijken. Vraag de generator om setup en cleanup uit te leggen, net als de assertions.
Voer voor de eerste acceptatietest de collection twee keer uit tegen geïsoleerde gegevens en inspecteer daarna de geëxporteerde of geversioneerde representatie. Bevestig dat een teamgenoot de gewijzigde scripts kan beoordelen zonder het AI-gesprek te herhalen. Controleer ook of je gekozen CLI, reporter en plan het beoogde uitvoeringspad ondersteunen.
Er wordt hier geen uitgevoerde Postman-generatie gepresenteerd. De nuttige evaluatievraag is of de workspacecontext je beoordelingswerk voor een bestaande collection vermindert. Dat vereist je eigen collection en een proef op accountniveau, niet een conclusie op basis van een productschermafbeelding.
KushoAI voor specificatiegebaseerde testgeneratie
KushoAI accepteert Swagger/OpenAPI-, Postman- en cURL-inputs en documenteert testgeneratie, natuurlijke-taalverfijning en CI-uitvoering. Dat maakt het een kandidaat wanneer een team nuttige API-definities heeft maar een backlog van ongeschreven tests. Dit zijn door de leverancier beschreven mogelijkheden, geen gemeten resultaten voor defectdetectie. (KushoAI-documentatie, september 2026)
Kies de input met de rijkste betrouwbare context. Een cURL-request kan één geldig request beschrijven, maar zegt meestal weinig over optionele velden, toegestane enumwaarden of gedocumenteerde fouten. Een OpenAPI-bestand voegt structuur toe; een goedgekeurde scenariomatrix voegt de intentie toe die de structuur mogelijk ambigu laat.
Vraag voor een Petstore-proef om afzonderlijke cases voor een geldige pet, een ontbrekende verplichte naam, een ID met het verkeerde type en een ongeldig statusfilter. Beoordeel of de tool request-bodyvereisten onderscheidt van responsschemavereisten. Deze kunnen in een voorbeeld op elkaar lijken terwijl ze verschillende verplichtingen opleggen.
Onderzoek vervolgens een verbonden create-read-update-flow. De read moet het ID gebruiken dat bij de huidige setup hoort. De update moet op dezelfde resource zijn gericht, en een latere read moet het gewijzigde veld verifiëren. Vier onafhankelijke requests met aantrekkelijke testnamen bewijzen niet dat de dependency-keten werkt.
Behandel de eerste generatie als een voorstel. Behoud gedocumenteerde verwachtingen, herzie scripts met onjuiste datastroom en markeer onderspecificieerde uitkomsten voor een requirementsbeslissing. Als de tool meerdere gelijkwaardige cases met ontbrekende velden voorstelt, behoud dan de nuttige onderscheidingen in plaats van te betalen voor het onderhouden van duplicaten.
Vraag vóór aankoop om de suite vanuit je beoogde pipeline uit te voeren en het failure-artefact te inspecteren. Bevestig de huidige CI-rechten, omgang met credentials en beschikbare exportformaten op het gekozen plan. Ga er niet van uit dat een gratis interactieve proef dezelfde automatiseringsrechten geeft als een teamimplementatie.
Keploy voor gegenereerde tests en traffic replay
De documentatie van Keploy presenteert twee verschillende startpaden. AI-generatie accepteert resources zoals OpenAPI, Postman, cURL of endpoints en bouwt verbonden API-flows. Record en replay legt API-interacties en hun dependencies vast voor latere uitvoering met mocks. De AI-flowbeschrijving en de dependency-recordingbeschrijving moeten niet als identieke mechanismen worden behandeld. (Keploy-documentatie, september 2026)
Als je moeilijkheid is om te reproduceren wat een applicatie deed met een database of upstream service, evalueer dan de opnameroute. Leg een kleine create-read-update-reis vast in een geïsoleerde omgeving, inspecteer de vastgelegde dependencies en replay na een gecontroleerde applicatiewijziging. Controleer wat de runtime ondersteunt voordat je een grotere uitrol plant.
Als je moeilijkheid is om cases uit een specificatie af te leiden, evalueer dan de generatieroute afzonderlijk. Vraag hoe de voorgestelde requests credentials verkrijgen, ID's tussen stappen doorgeven en gegevens opruimen. De aanwezigheid van opnamefuncties elders in het product beantwoordt die vragen niet voor een gegenereerde suite.
Dynamische waarden vragen om beoordeling. Een timestamp mag legitiem variëren; een resource-ID kan twee requests verbinden en moet daarom worden vergeleken. Breedweg elk veranderend veld negeren kan fouten verbergen. Beoordeel uitsluitingen veld voor veld en behoud vergelijkingen die betekenisvolle relaties uitdrukken.
Inspecteer ook de basislijn voordat je die accepteert. Een opname die een verkeerd totaal, een toevallige fallback-respons of verouderde gegevens bevat, kan consistent opnieuw worden afgespeeld. Consistentie helpt verandering te detecteren, maar het team beslist nog steeds of het vastgelegde gedrag correct was.
Een nuttige aanvulling: Schemathesis biedt schemagedreven property-based API-testen. Het kan een API uitdagen met gegenereerde inputs naast beoordeelde voorbeelden. Behandel het als een ander testmechanisme, niet als synoniem voor een LLM-testgenerator. De bevindingen moeten nog steeds worden geïnterpreteerd tegen het contract en de implementatie.
Gratis AI-tools voor API-testen: beperkingen en kosten
‘Gratis’ kan een client, een beperkte AI-toewijzing, een open-source runner of een tijdelijke proef beschrijven. Deze aanbiedingen dekken verschillende delen van de workflow. Een gratis client bewijst niet dat geautomatiseerde generatie, geplande uitvoering of rapportexport ook gratis is.
Zoals gecontroleerd op 21 september 2026 vermeldt het Free-plan van Postman 50 AI-credits per maand. Credits zijn de facturatie-eenheid; ze betekenen niet 50 tests of 50 volledige suites. De vergelijkingstabel onderscheidt AI-toewijzing van uitvoering, datagedreven functies en resultatexporten. (Postman-prijzen, september 2026)
De huidige prijspresentatie van KushoAI gebruikt Developer Edition en Enterprise. Keploy onderscheidt Playground, Pro en Enterprise, naast het open-sourceaanbod. Gebruik het huidige aankoopscherm om de relevante limieten te bevestigen. Oudere tooloverzichten kunnen uitgefaseerde plannamen beschrijven of toewijzingen combineren die afzonderlijk worden gefactureerd.
| Kostencomponent | Wat je in een proef moet vastleggen | Wat de rekening misleidend kan maken |
|---|---|---|
| Stoelen en plan | Editors, reviewers, facturatie-interval, vereiste functies | Jaarlijkse hoofdprijzen vergelijken met maandelijkse verplichtingen |
| AI-generatie | Creditgebruik voor dezelfde goedgekeurde taak, inclusief retries | Aannemen dat één credit gelijk is aan één test |
| Uitvoering | Lokale runs, gehoste runs, CI-jobs, planningen, rapporten | Interactieve runs behandelen als toestemming voor elk automatiseringspad |
| Onafhankelijk model | Input- en outputtokens voor schrijven en beoordelen | Herhaalde inzendingen van volledige specificaties negeren |
| Engineeringtijd | Beoordeling, herstel van fixtures, triage van fouten, onderhoud | Initiële generatietijd meetellen als totale oplevertijd |
Gebruik een kleine acceptatietaak om de kosten te schatten. Geef elke kandidaat dezelfde operaties en verwachtingen en leg vast hoeveel scenario's de beoordeling overleven. Houd generatietijd, handmatige beoordelingstijd en uitvoeringstijd in afzonderlijke kolommen. Wachten op een model en een gevaarlijke assertion corrigeren leggen verschillende kosten op aan het team.
Een nuttige noemer is beoordeelde, uitvoerbare scenario's die je team zou behouden. Het voorkomt dat een generator met veel redundante cases goedkoper lijkt simpelweg omdat de output langer is. Leg niet-onderbouwde cases die je hebt verwijderd en vereisten die onopgelost blijven vast.
Dit artikel claimt geen gemeten arbeidsbesparingspercentage en vergelijkt geen doorvoer van betaalde plannen. Die cijfers vereisen een gecontroleerde proef met gelijkwaardige inputs. Neem voor een aankoopbeslissing één realistische onderhoudswijziging op, zoals het toevoegen van een verplicht veld, zodat de schatting zowel de volgende sprint als de eerste demo dekt.
AI-tools voor API-testen: van OpenAPI naar een eerste run
Gebruik een geïsoleerde lokale instantie van het echte Swagger Petstore-project. Zet commit d57941e8fe959e508796b27469b1e8bba73392dc vast; de specificatie declareert OpenAPI 3.0.4 en applicatieversie 1.0.29-SNAPSHOT. Lees het vastgezette bestand in plaats van een onafhankelijk bijgewerkte publieke demo. (Swagger Petstore-specificatie, september 2026)
1. Bereid de service voor en leg de omgeving vast. Haal de repository via die bronpagina op, checkout de vastgezette revisie en installeer een compatibele JDK en Maven. De README van het project geeft dit opstartcommando vanuit de repositorymap:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty gebruikt poort 8080. Stel BASE_URL in op je loopback HTTP-origin op die poort met /api/v3 erachter. Bevestig dat /openapi.json leesbaar is relatief ten opzichte van die base voordat je test.
Deze run gebruikte Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 en jsonschema 4.26.0. Leg je eigen versies ook vast. De sourcebuild downloadt dependencies en Swagger UI, dus een vastgezette applicatiecommit alleen is geen volledig hermetische build.
2. Importeer de vastgezette specificatie. Selecteer /pet, /pet/{petId} en /pet/findByStatus. Houd delete beschikbaar voor cleanup. Overschrijf de publieke serverlocatie van de specificatie met je lokale base. Controleer deze instelling voordat je een write-request verstuurt.
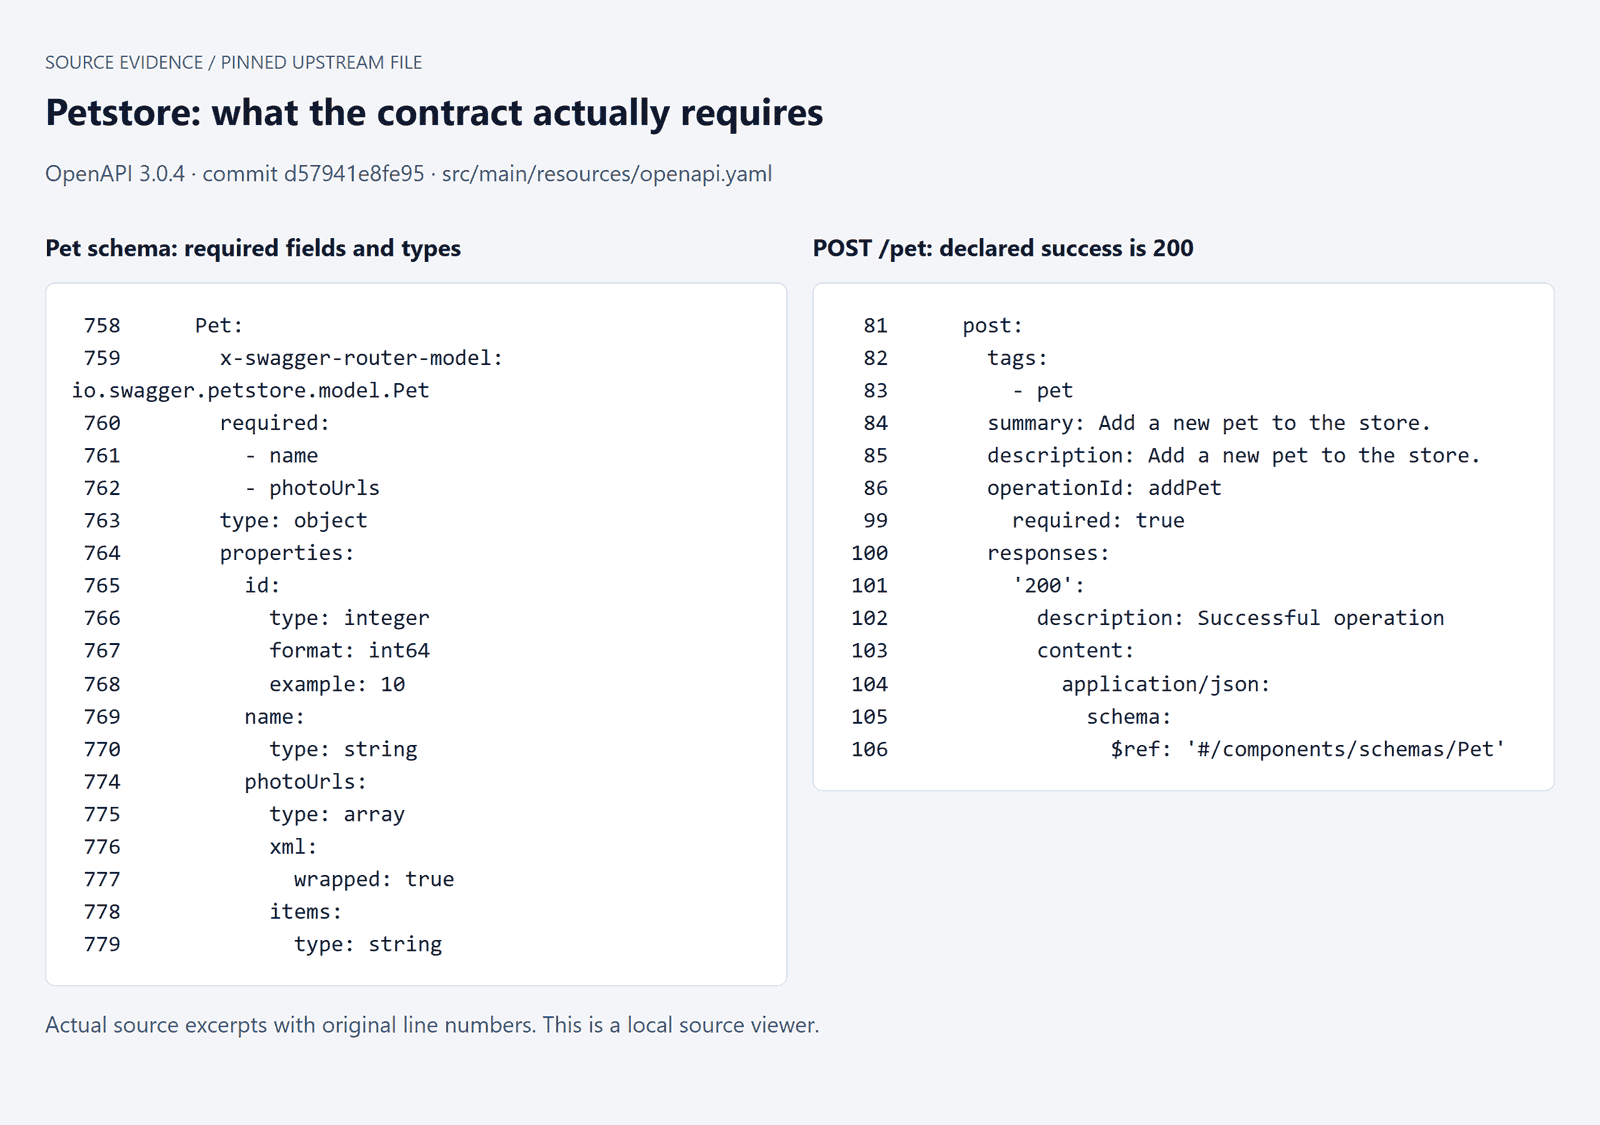 Vastgezette OpenAPI Petstore-bron met verplichte velden en geselecteerde operatiedefinities
Echte bronfragmenten lokaal gerenderd: Pet vereist name en photoUrls; POST /pet declareert 200 voor succes. Originele regelnummers blijven behouden.
3. Genereer een matrix voordat je uitvoerbare code schrijft (Prompt A). Voeg de specificatie toe en plak deze prompt in je gekozen generator:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Beoordeel de oracle voor elk scenario. Petstore documenteert een succesvolle create als 200. Het Pet-schema vereist name en photoUrls; id heeft een integer-type maar staat niet in die verplichte lijst. Validatie van ontbrekende velden en request-responsidentiteit vereisen daarom verschillende controles.
| Operatie | Input of volgorde | Bewijs voor verwachte uitkomst | Te beoordelen assertion | Uitvoeringsstatus |
|---|---|---|---|---|
| addPet, getPetById | Maak aan en lees dan huidig ID | Gedocumenteerde 200 en Pet-schema; expliciete flowverwachting | Valideer body en vergelijk teruggegeven ID | Lokaal geslaagd |
| updatePet, getPetById | Wijzig name en lees opnieuw | Update-operatie plus goedgekeurde fixture-intentie | Zelfde ID, nieuwe name, geldig schema | Lokaal geslaagd |
| findPetsByStatus | Query available na setup | Gedocumenteerde enum en succesvolle array-respons | Alle teruggegeven statussen komen overeen; aangemaakt ID is aanwezig | Lokaal geslaagd |
| getPetById | Niet-integer pad-ID | Gedocumenteerde invalid-ID 400 | Exacte status voor deze gedocumenteerde case | Geslaagd: 400 |
| findPetsByStatus | Ongedocumenteerde enumwaarde | Gedocumenteerde invalid-status 400 | Exacte status, behoud eventuele mismatch | Geslaagd: 400 |
| addPet | Laat verplichte name weg | Verplicht schemaveld; 400- en 422-beschrijvingen dekken niet elke variatie | Leg gedrag vast; los exacte mapping op vóór gating | Gaf 200 zonder name; discrepantie behouden |
5. Genereer en inspecteer het uitvoeringsbestand (Prompt B). Voeg de goedgekeurde matrix en specificatie toe met deze prompt:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Voer uit, bewaar en ruim op. Gebruik een runspecifiek pet-ID, leg de aanmaakrespons vast en geef het ID door aan latere requests. Valideer de update via een nieuwe read. Een succesvolle update-respons alleen bewijst niet dat de server de wijziging heeft opgeslagen.
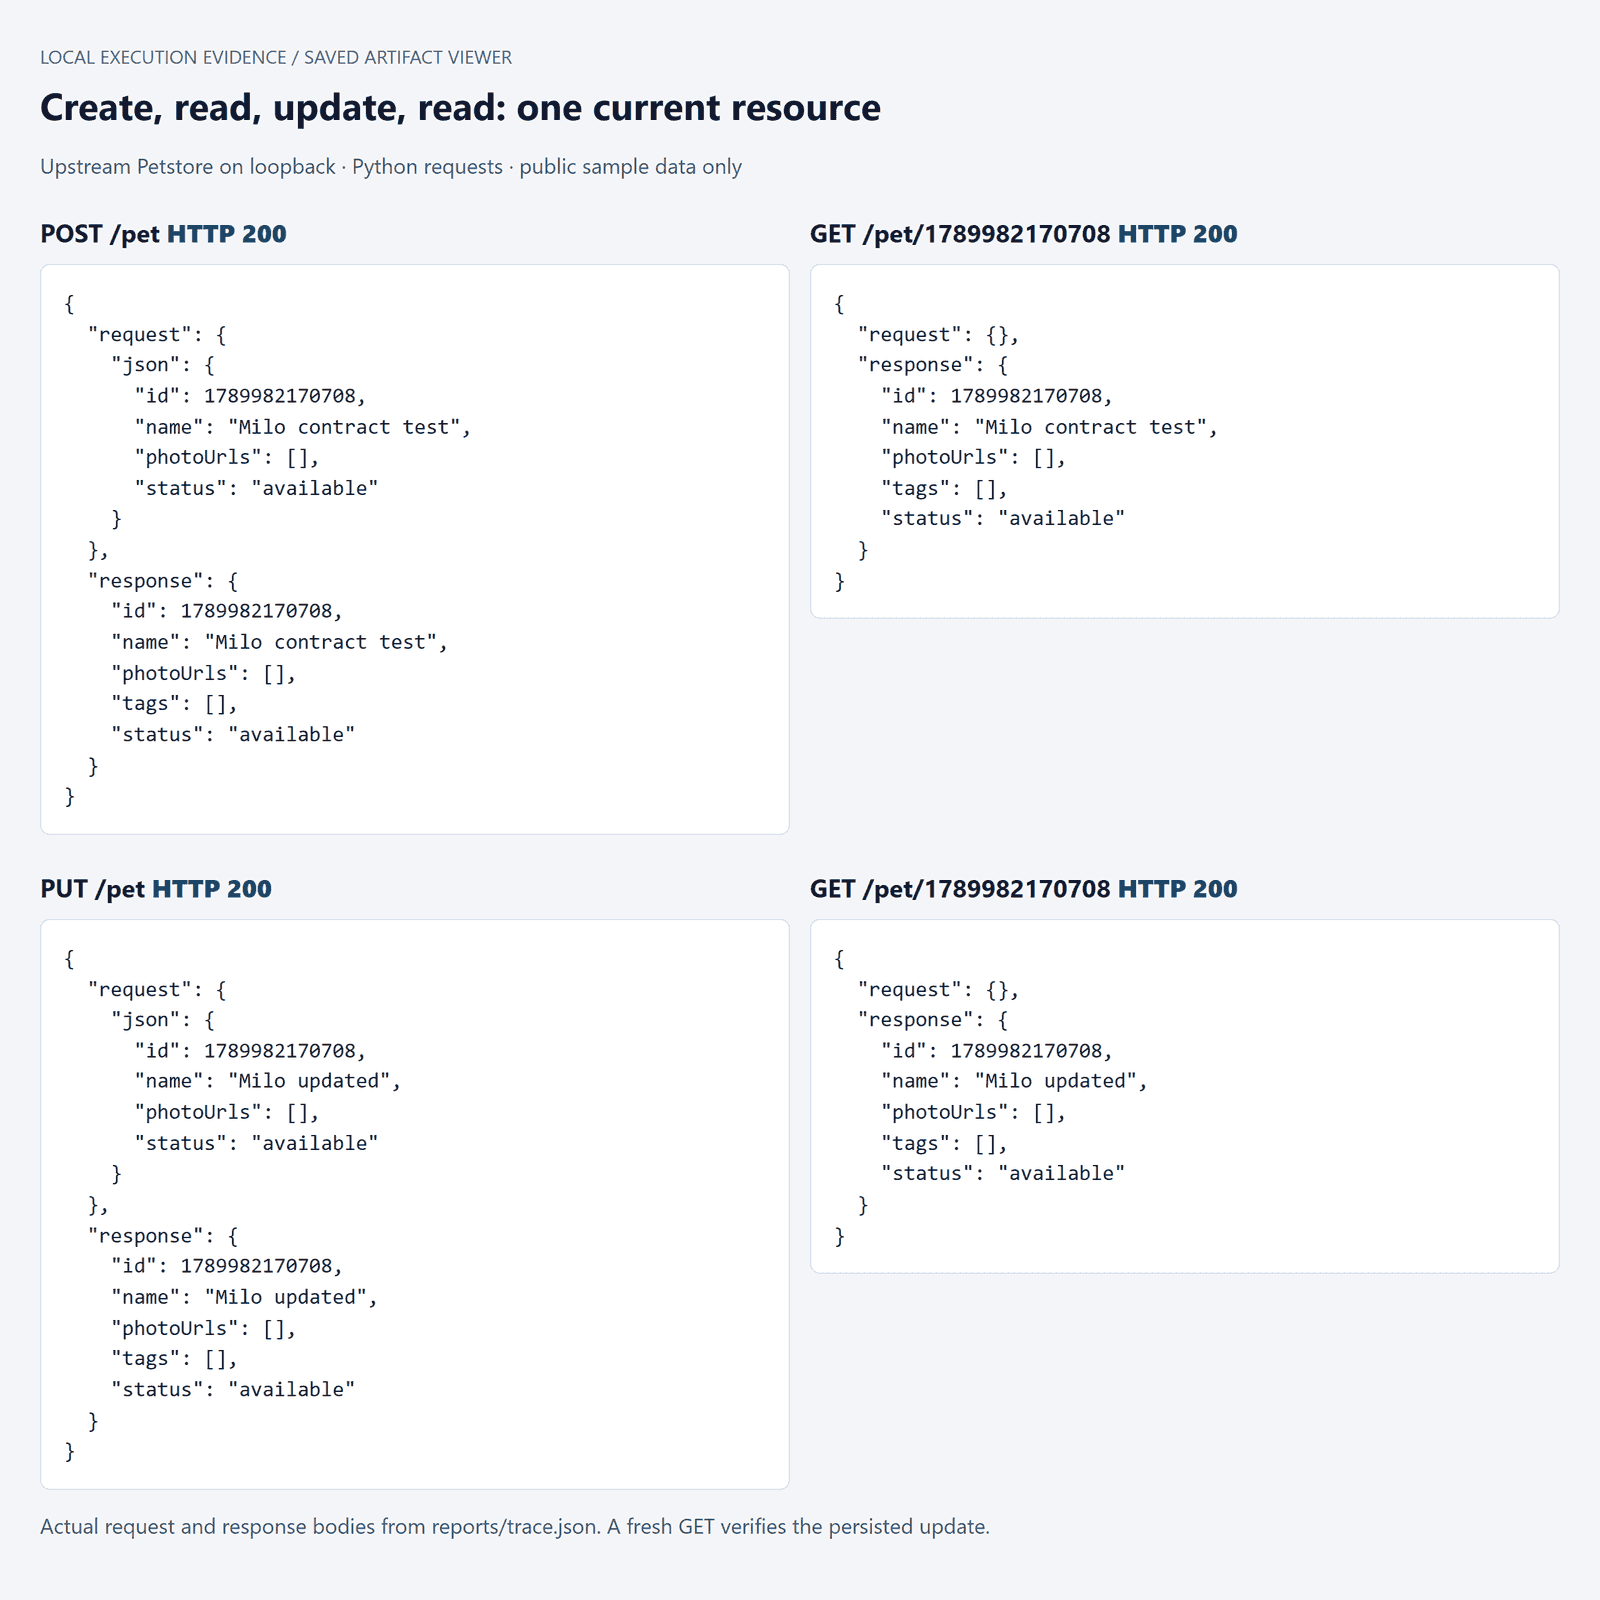 Lokaal bewijs van Petstore-requestketen met aanmaak, lookup, update en ID-overdracht
Opgeslagen lokale requests en responses: hetzelfde runspecifieke ID overleeft create, read, update en een nieuwe read. Alle 4 weergegeven requests gaven 200 terug.
Bewaar requestbodies, responses, assertion-fouten en de cleanup-uitkomst. Beperk verwijderen tot ID's die door deze run zijn aangemaakt. Bewaar onverwachte responses als bevindingen, inclusief gevallen waarin de demonstratie-implementatie ongeldige input accepteert. Pas assertions niet aan alleen om een groene schermafbeelding te krijgen.
Wat deze run vond: de 5 live testfuncties slaagden, inclusief invalid-ID- en invalid-statuscontroles die 400 teruggaven. De afzonderlijke probe met ontbrekende name gaf 200 terug en een body zonder name. We hebben die schemadiscrepantie buiten de groene suite behouden; de exact beoogde foutmapping moet nog worden opgehelderd. Beide aangemaakte records zijn succesvol verwijderd.
De lokale tests zijn in deze artikelsessie geschreven, onafhankelijk van de drie commerciële tools. Alle 5 live tests zijn behouden; geen enkele is verwijderd of heeft na uitvoering ruimere verwachtingen gekregen. Menselijke beoordelingstijd is niet gemeten. De bewijsmappen bevatten de testbestanden, dependency-lock, ruwe responses en reproductie-instructies.
AI-tools voor API-testen valideren
Een nuttige assertion moet een relevant fout antwoord afwijzen. Je kunt die eigenschap testen zonder de draaiende service te wijzigen: bewaar een echte succesvolle respons, kopieer die en wijzig opzettelijk één veld per keer. Dit zijn gecontroleerde responsmutaties, geen productie-kwetsbaarheden of een volledige mutation-testingbenchmark.
Houd de originele status en body bij elkaar. Voer eerst de validator uit tegen de ongewijzigde respons en verifieer dat die de basislijn accepteert. Maak daarna drie onafhankelijke kopieën. Wijzig het ID, wijzig het type van name en verwijder de verplichte name. Elke kopie moet falen om een reden die overeenkomt met de wijziging.
| Opgeslagen basislijn | Gecontroleerde wijziging | Relevante controle | Werkelijk resultaat |
|---|---|---|---|
| Succesvolle lookup van huidige pet | Vervang door een ander integer-ID; houd status 200 | Teruggegeven ID is gelijk aan het verwachte ID van deze run | Gefaald: verwacht en werkelijk ID verschillen |
String name | Vervang name door een getal | String-type van Pet-schema | Gefaald: 42 is geen string |
Verplichte name aanwezig | Verwijder name | Required-lijst van Pet-schema | Gefaald: name is verplicht |
Het ID-voorbeeld legt een veelvoorkomende zwakte bloot. Een schemavalidator kan het verkeerde integer accepteren omdat de vorm geldig blijft. De relatie-assertion levert de ontbrekende beperking. In de andere twee voorbeelden levert schemavalidatie beperkingen die een status-only check niet kan zien.
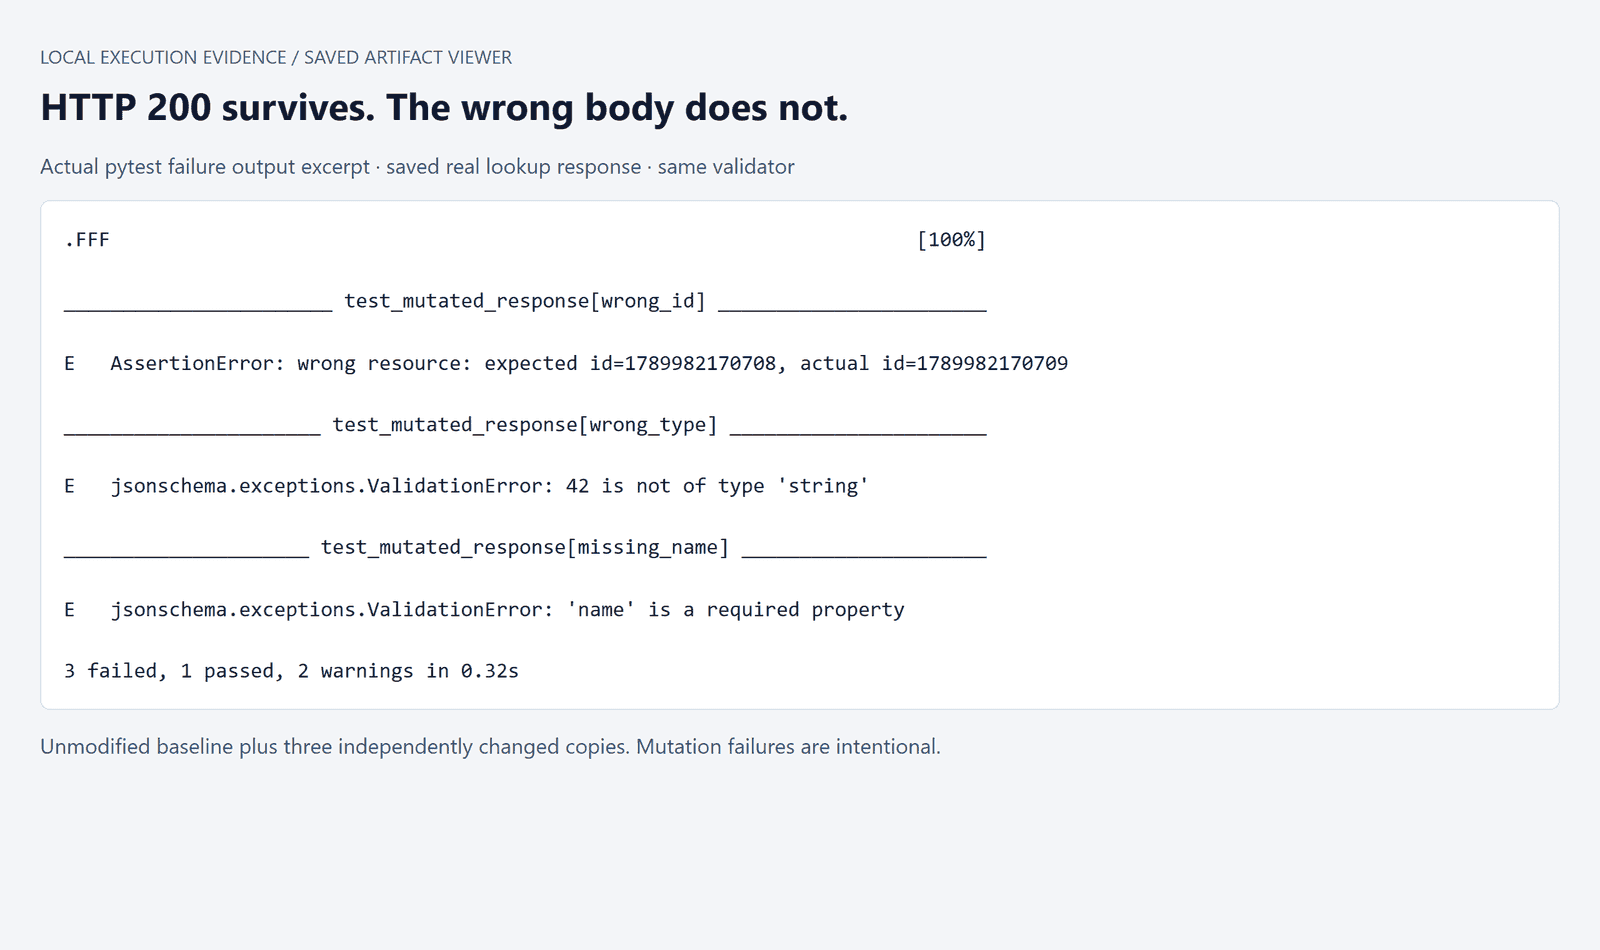 Werkelijke assertion-foutuitvoer voor gecontroleerde Petstore-responsmutaties
Werkelijke pytest-foutfragmenten: de originele respons slaagde en alle 3 onafhankelijke mutaties faalden. Deze fouten zijn opzettelijk veroorzaakt in opgeslagen kopieën.
In deze run slaagde de ongewijzigde basislijn en faalden 3 van 3 gewijzigde kopieën. De mutatierun gaf exitcode 1 terug, waarmee het faalsignaal behouden bleef. De validator past de relevante structurele beperkingen van het Pet-schema toe en een afzonderlijke ID-relatiecontrole; deze kleine demonstratie is geen volledige OpenAPI-conformiteitsvalidator.
Voor een herhaalbare audit voeg je het testbestand en de vastgezette specificatie toe aan Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Beoordeel voorgestelde ‘self-healing’-wijzigingen met extra zorg. Een verwachte 400 vervangen door 200 kan een regressie verbergen. Een legitieme contractwijziging vereist een requirementsreferentie en een beoordeelde testwijziging. De waargenomen respons is bewijs voor onderzoek, geen automatische toestemming om correctheid opnieuw te definiëren.
Scheid faalcategorieën voordat je AI om een oplossing vraagt. Een timeout kan wijzen op een niet-beschikbare omgeving. Een lookup-fout kan van een kapotte fixture komen. Een importfout hoort bij de testcode. Een reproduceerbare mismatch met het overeengekomen contract kan bij het product horen. Bewaar voldoende context om ze te onderscheiden.
Rapporteer de noemer eerlijk. Het detecteren van drie geselecteerde responswijzigingen bewijst gevoeligheid voor die drie wijzigingen. Het stelt geen endpointdekking, codedekking, securitydekking of een algemene defectdetectiesnelheid vast. Evenzo zegt een groot aantal tests weinig over dubbele scenario's of de kracht van hun assertions.
Authenticatie en autorisatie verdienen onafhankelijke tests in een geschikte applicatie: ontbrekende credentials, verlopen credentials en toegang tot resources van een andere gebruiker. Het demonstratiegedrag van Petstore kan niet bewijzen dat je productietoegangscontroles werken.
AI-tools voor API-testen in CI/CD
Zodra een reviewer de suite accepteert, commit je precies die versie. Een build moet bekende verwachtingen tegen de kandidaat-applicatie uitvoeren. Tests opnieuw genereren tijdens elke build introduceert nog een veranderende component en maakt fouten moeilijker te reproduceren.
Zet de runner, dependencies, fixtures en specificatie vast. Bewaar een dependency-lock naast de tests en bewaar de applicatierevisie in het rapport. Haal secrets uit de CI-omgeving, houd ze uit gegenereerde bestanden en controleer dat faallogs ze niet blootleggen.
Met pytest is de basisvorm voor rapportage eenvoudig:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Geef BASE_URL mee via de jobomgeving. Start de lokale service in de job-lifecycle, wacht tot die gereed is en voer daarna de suite uit. Verzamel altijd het rapport en het servicelog, zelfs bij falen. Rond af door de eigen service van de job te stoppen en de gegevens op te ruimen; vermijd procesbrede cleanup-commando's op gedeelde agents.
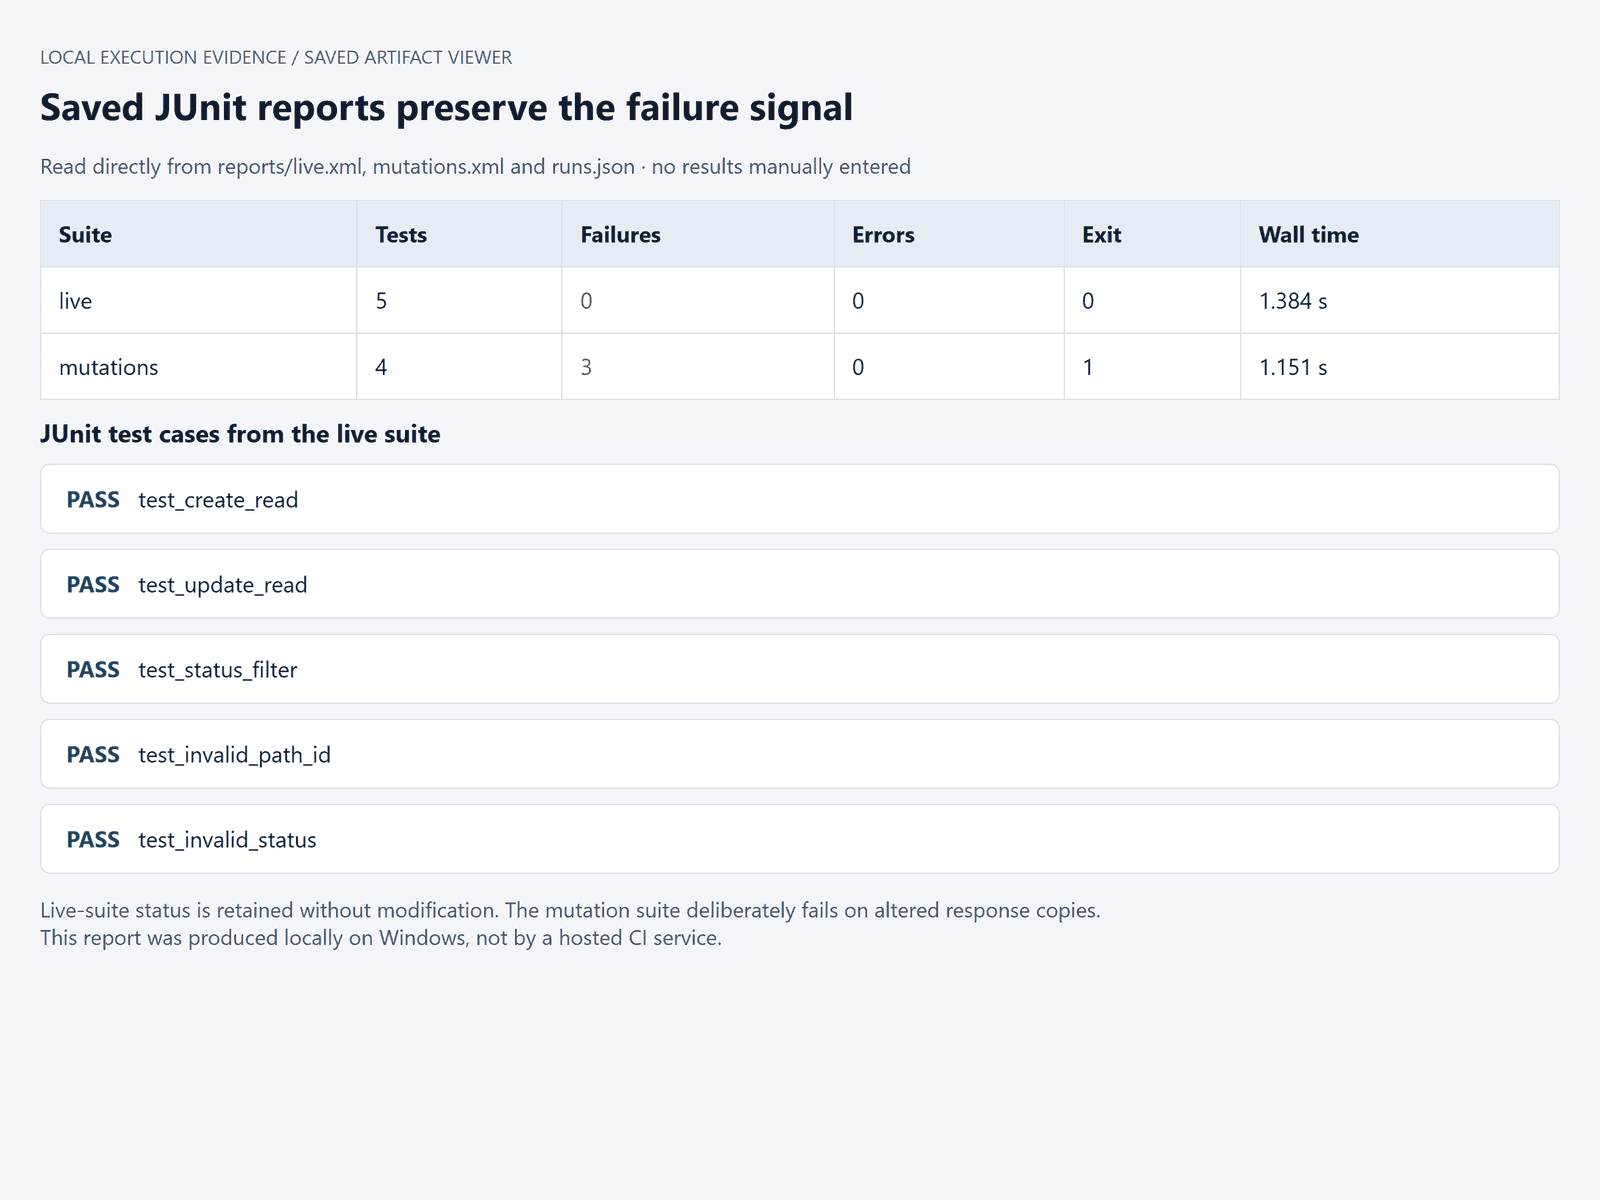 Lokaal pytest JUnit-rapport met afzonderlijke resultaten voor live-contract en assertion-checks_Actual local
JUnit-resultaten: 5 live tests geslaagd; de suite met gecontroleerde kopieën bevat 1 passerende basislijn en 3 opzettelijke fouten. Er wordt geen gehoste CI-run geclaimd.
De gemeten wall times, inclusief Python-processtart, waren 1,384 seconden voor de live-suite en 1,151 seconden voor de suite met gecontroleerde kopieën. Deze sluiten servicebuild/startup, dependency-installatie, schrijven en beoordeling uit. JUnit-bestanden en de onverkorte logs zijn afzonderlijk opgeslagen.
Test het faalpad voordat je op de gate vertrouwt. Een mislukte assertion moet een falende job-exitcode opleveren. Retries moeten begrensd en gerechtvaardigd zijn voor bekende infrastructurele transiënten; herhaalde retries die uiteindelijk een productfout verbergen, maken de gate minder informatief.
Behandel cleanup-fouten expliciet. Houd de primaire assertion-fout zichtbaar, leg vast welke resource achterblijft en laat teardown zijn eigen probleem rapporteren. Parallelle jobs hebben afzonderlijke identifiers of namespaces nodig. Een test die alleen slaagt maar gegevens van een andere job leest, is niet klaar voor onbeheerd gebruik.
Als je al pytest hebt, kun je het schrijfmodel afzonderlijk kiezen. Atlas Cloud past bij deze nauwere rol: een modellaag voor een aangepaste workflow waarvan uitvoering en rapportage al bestaan. Het wordt hier niet gepresenteerd als een volledig API-testplatform of een native backend voor de drie bovenstaande producten.
Open voor die evaluatie DeepSeek V4.1 Flash, model-ID deepseek-ai/deepseek-v4.1-flash, en lever dezelfde publieke specificatie en beoordeelde matrix aan die lokaal zijn gebruikt. Gebruik Prompt B en bewaar de geretourneerde draft afzonderlijk van de beoordeelde test. Vergelijk de aannames met het contract voordat je iets uitvoert.
Als de interface dit biedt, is een temperatuur van 0,2 een startinstelling voor het schrijven, geen determinismegarantie. Controleer de beschikbare outputlimiet tegen de grootte van je suite. Raadpleeg de huidige modelcatalogus voor tokenprijzen in plaats van te budgetteren op basis van een oud artikel.
De werkverdeling blijft expliciet: het model stelt code voor, een reviewer keurt verwachtingen goed en de runner produceert resultaten. De toegangspoort tot de testomgeving verhinderde een voltooide Atlas-run voor dit artikel, dus dit is een evaluatierecept in plaats van een gemeten modelresultaat. Je kunt deze route evalueren zonder een werkende test runner te migreren of de uitvoeringsverantwoordelijkheden aan een chatmodel over te dragen.
AI-tools voor API-testen kiezen voor je team
Kies de kleinste evaluatie die je beslissing kan veranderen. Gebruik één verbonden workflow, één gedocumenteerde negatieve case en een paar gecontroleerde foute responses. Houd inputs gelijkwaardig tussen kandidaten. Een gepolijste onboardingervaring mag niet zwaarder wegen dan een test die de verkeerde resource niet kan identificeren.
Begin voor een volwassen collection-workflow met het evalueren van de AI-functies in die workspace. Bestaande omgevingsconfiguratie en requestdependencies zijn waardevolle context. Meet of de gegenereerde wijzigingen beoordelingswerk besparen zonder fragiele aannames te introduceren.
Evalueer voor een team met een solide specificatie en een schrijfbacklog specificatiegebaseerde generatie. Let op wat er gebeurt wanneer de specificatie onvolledig is. Een generator die ontbrekende verwachtingen duidelijk markeert, is gemakkelijker te beoordelen dan een die ze zelfverzekerd verzint.
Evalueer voor een applicatie waarvan de fouten afhangen van upstreamgedrag opnemen en replay. Inspecteer vastgelegde basislijnen en dependency-ondersteuning voordat je in grote opnames investeert. Bepaal welke dynamische velden mogen variëren en welke relaties intact moeten blijven.
Evalueer voor een team met een stabiele runner een onafhankelijk model voor schrijven en beoordelen. Je behoudt het uitvoeringsformaat dat je al kent, maar je bent ook eigenaar van de integratie, het fixture-ontwerp en het onderhoud. Neem dat eigenaarschap mee in de kostenberekening.
Voordat je betaalt voor AI-tools voor API-testen, eis je vijf concrete demonstraties:
- De beoordeelde suite draait tegen je beoogde omgeving.
- Relevante gecontroleerde fouten laten de juiste assertions falen.
- Tests en nuttige rapporten kunnen in een acceptabel formaat worden bewaard.
- Herhaalde runs, inclusief CI-uitvoering, behouden isolatie en faalsignalen.
- Kosten voor generatie, uitvoering en onderhoud passen binnen het budget van het team.
Wijs iemand aan om de geaccepteerde suite te onderhouden. Een specificatiewijziging moet een beoordeling van getroffen assertions, fixtures en consumers activeren. Bewaar het oude faalbewijs totdat de wijziging is begrepen. Dat maakt de volgende release gemakkelijker te beoordelen en geeft het team een reden om een groen rapport te vertrouwen.
Veelgestelde vragen
Welke AI-tool moet ik gebruiken voor API-testen?
Begin met je bestaande inputs. Evalueer Postman Agent Mode voor gevestigde collections, KushoAI voor specificatiegeleide generatie en Keploy voor de aparte routes voor gegenereerde flows en opnemen. Als je team al pytest of een andere runner onderhoudt, past een afzonderlijk schrijfmodel misschien. Gebruik dezelfde kleine workflow om de assertions, uitvoering en beoordelingsinspanning van elke kandidaat te evalueren.
Zijn er gratis AI-tools voor API-testen?
Er zijn gratis clients, open-source testtools en beperkte AI-toewijzingen. Ze dekken verschillende behoeften. Het Free-plan van Postman vermeldt 50 maandelijkse AI-credits per 21 september 2026; dat is geen testaantal. Controleer of je vereiste export-, automatiserings-, rapportage- en samenwerkingsfuncties inbegrepen zijn voordat je een interactieve proef als gratis CI-oplossing behandelt.
Kan AI API-tests genereren uit een OpenAPI-specificatie?
Ja, een generator kan operaties, schema's, parameters en responsdefinities gebruiken om tests voor te stellen. De specificatie kan nog steeds bedrijfsregels weglaten of foutmappings ambigu laten. Lever goedgekeurde verwachtingen aan en beoordeel het resultaat. In het vastgezette Petstore-voorbeeld is een succesvolle create gedocumenteerd als 200, wat illustreert waarom bekende REST-conventies het werkelijke contract niet kunnen vervangen.
Hoe weet ik of door AI gegenereerde assertions nuttig zijn?
Controleer drie dingen: gedocumenteerde schemabeperkingen, relaties tussen requests en responses, en gevoeligheid voor opzettelijk onjuiste gegevens. Bewaar een echte respons, wijzig één relevante eigenschap en voer dezelfde validator opnieuw uit. Bewaar de foutmelding. Dit geeft smal, reproduceerbaar bewijs over die assertions, terwijl bredere dekkings- en securityvragen openblijven voor afzonderlijk testen.
Kan ik door AI gegenereerde API-tests in CI/CD uitvoeren?
Ja, wanneer het gegenereerde formaat, de runner, omgeving en het plan die route ondersteunen. Commit beoordeelde tests, installeer vastgezette dependencies, gebruik geïsoleerde fixtures en exporteer een gestructureerd rapport zoals JUnit. Verifieer dat fouten een niet-nul exitcode retourneren. Een succesvolle lokale run bereidt de suite voor op CI; het bewijst niet dat een gehoste pipeline heeft gedraaid.
Kan AI handmatig API-testen vervangen?
AI kan repetitief schrijven verminderen en reviewers helpen zwakke assertions te vinden. Mensen beslissen nog steeds over bedoeld gedrag, onderzoeken ambigue fouten en verkennen risico's buiten de aangeleverde voorbeelden. Gebruik AI-tools voor API-testen om beoordeelbare testassets te produceren en beoordeel ze vervolgens op reproduceerbaar bewijs. Een kleinere suite die betekenisvolle fouten vindt, is gemakkelijker te vertrouwen dan een onverklaarde verzameling groene checks.


