De code ziet er af uit. Dan falen de tests, de oplossing verandert een interface en er begint weer een nieuw verzoek te lopen. De beste ai-api voor coderen kiezen betekent een model en endpoint vinden die jouw soort werk binnen een acceptabel budget afronden.
Begin met Claude, GPT of Gemini als referentiekandidaat. Vergelijk DeepSeek, Qwen en Kimi op dezelfde taken als je alternatieve opties voor deployment en kosten wilt. Geef bij debuggen prioriteit aan regressietests. Inspecteer bij refactoring de diff. Verifieer bij een coding agent de volledige tool-loop voordat je tokenprijzen vergelijkt.
De frustratie is meetbaar. In de Stack Overflow Developer Survey van 2025 gaf 66% van de respondenten op de frustratievraag aan bijna-correcte AI-oplossingen te hebben gezien; 45% gaf aan meer tijd te besteden aan het debuggen van gegenereerde code. Dit zijn enquêteantwoorden, geen modelevaluatie uit 2026. (Stack Overflow Developer Survey, 2025)
Belangrijkste punten
- Kies de API en de agent afzonderlijk.
- Maak een shortlist op basis van taak en vereiste endpointfuncties.
- Bewaar eerste antwoorden en beoordeel ze aan de hand van vaste acceptatietests.
- Neem mislukte pogingen en reparaties mee in je kostenberekening.
Deze gids biedt een shortlist, drie overneembare evaluatietaken en een kostenwerkblad. Het onderzoek is gecontroleerd op 21 september 2026. Modelbeschikbaarheid, gedocumenteerde mogelijkheden en gemeten resultaten zijn door deze hele tekst heen afzonderlijke bewijscategorieën.
Beste AI-API voor coderen: de shortlist
Begin met twee kandidaten: één die past bij je bestaande applicatie en één alternatief. Gebruik deze zes families om dat eerste tweetal samen te stellen.
De tabel stelt tests voor, zonder aanspraak te maken op vergelijkende prestaties. Toegang hangt af van je account, regio, quota en endpoint; een vermelding in de documentatie bevestigt niet dat jouw inloggegevens het kunnen aanroepen.
| Specifiek model en ID | Toegangspad | Taak die het evalueren waard is | Belangrijkste beslissingsgrens | Endpointbewijs | Prijscontrole |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Beperkte wijzigingen in meerdere bestanden | Client en reasoning-besturing verifiëren | Overzicht van Claude Platform-modellen; accounttoegang niet getest | Geen tarief vermeld |
GPT-6 Astra, gpt-6-astra | OpenAI API | Codeertaken met meerdere voorwaarden | Route en tools verifiëren | OpenAI-modeldocumentatie; accounttoegang niet getest | Geen tarief vermeld |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Interactieve generatie en beoordeling | Latentie en protocol verifiëren | Google AI-modeldirectory; accounttoegang niet getest | Geen tarief vermeld |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud modelroute | Numerieke correcties; contextexperimenten | Houd versie 0813 apart | Exacte modelpagina geverifieerd; runtime-functies niet getest | 21 september 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud modelroute | Refactors; zelfstandige interfaces | Opgegeven versie; niet de nieuwste | Exacte modelpagina geverifieerd; runtime-functies niet getest | 21 september 2026 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud modelroute | Dezelfde drie taken; CSV-interface | Uitvoer en voltooiingslimieten verifiëren | Exacte modelpagina geverifieerd; runtime-functies niet getest | 21 september 2026 |
Claude, GPT en Gemini zijn nuttige referentiekandidaten. Hun officiële modeldirectory's vermelden de bovenstaande versies. Gebruik een provider die je al kent als uitgangspunt en test vervolgens of een alternatief de kosten per geaccepteerde taak of het integratiewerk vermindert. Behandel het gedrag van een consumentenassistent niet als het bijbehorende API-resultaat.
De modeldirectory van OpenAI vermeldt GPT-6 Astra naast de GPT-5.6-familie. Dat maakt het een actuele kandidaat, geen overwinning op codeergebied ten opzichte van de andere rijen. De tabel vermijdt bewust het overnemen van oude model-ID's uit niet-gedateerde vergelijkingspagina's. (OpenAI-modeldirectory, geraadpleegd september 2026)
DeepSeek verdient een plek als afzonderlijke modelfamilie om te onderzoeken. Test of het de specifieke bug oplost zonder de wijziging te verbreden. Kies een andere kandidaat als de ingezette route niet voldoet aan je vereiste responseformaat, toolgedrag of latentieplafond, ongeacht de algemene reputatie van het model.
Evalueer Qwen per versie. De genoemde 122B A10B-deployment biedt een concrete prijsreferentie. Voer de parsing- en browsercontroles uit voordat je een conclusie over de waarde trekt. Contextcijfers van andere Qwen-releases kunnen niet aan dit model worden toegewezen.
Kimi is de uitgewerkte configuratiekandidaat. De openbare pagina vermeldt de model-ID. Configuratiebeoordeling is mogelijk; succesvolle generatie blijft ongeverifieerd. Beoordeel de voltooide uitvoer aan dezelfde beperkingen als de andere kandidaten.
Atlas Cloud zit in deze vergelijking op de toegangslaag. Het is geen zevende model. De relevantie is praktisch: je kunt meerdere kandidaat-modelpagina's bekijken en hun integratievereisten vergelijken voordat je je aan een workflow vastlegt.
Verifieer bij open weights de exacte releaselicentie en het deployment-artefact. Gehoste inferentie heeft aparte servicevoorwaarden en operationele kosten; de modelfamilie alleen kan die niet vaststellen.
Coding-API's, modellen en agents uitgelegd
Een model produceert inhoud als reactie op invoer. Een API bepaalt hoe je applicatie die invoer verstuurt en het resultaat ontvangt. Een coding agent organiseert het omringende werk: bestanden lezen, tools aanroepen, bewerkingen toepassen, tests uitvoeren en beslissen of er moet worden doorgegaan.
Die drie lagen kunnen onafhankelijk van elkaar falen. Een model kan een correcte patch voorstellen terwijl de agent die naar het verkeerde bestand schrijft. Een API kan geldige JSON retourneren terwijl de applicatie een tool-aanroep negeert. Een capabele agent kan vastlopen omdat het gekozen endpoint een parameter weigert.
Stel dat je een handler verstuurt en om een ID-parser vraagt. Een eenvoudige codegeneratie-API retourneert tekst met daarin code. Je programma moet die code nog steeds extraheren, in een geschikte werkruimte plaatsen en de tests uitvoeren. Een geslaagd HTTP-antwoord bewijst levering, niet correctheid.
Een agent kan die stappen alleen automatiseren als je de tools en machtigingen levert. Hij heeft ook een stopvoorwaarde nodig. Zonder die voorwaarde kan hij een al acceptabele functie herhaaldelijk blijven aanpassen, de taak uitbreiden of extra verzoeken besteden aan het verbeteren van een irrelevant detail.
Houd drie budgetposten apart:
- Toolabonnement: de applicatie, editorintegratie of agentservice die je gebruikt.
- Inferentiegebruik: verzoeken aan het gekozen model-endpoint, onder de bijbehorende factureringsvoorwaarden.
- Uitvoeringsomgeving: containers, test-runners, opslag en andere infrastructuur.
Sommige producten bundelen delen van deze stack. Andere verwachten dat je aparte inloggegevens meeneemt. Controleer het specifieke abonnement voordat je aanneemt dat een editorabonnement willekeurig API-verkeer vanuit je eigen applicatie omvat.
Protocolcompatibiliteit heeft ook een grens. Een service die een bekende messages-array accepteert, kan nog steeds ander toolgedrag, andere streaming-events, contextlimieten of reasoning-besturing bieden. Het kopiëren van een basis-URL kan niet aantonen dat elke functie uit het ecosysteem van een andere provider wordt ondersteund.
Breng applicatie, agent, endpoint, model, tools en tests in kaart. Identificeer bij elke stap het factureerbare onderdeel en de verantwoordelijke beheerder voordat je van model wisselt.
Beste AI-API voor coderen: 7 selectiechecks
1. Functionele correctheid en regressiegedrag. Schrijf de verwachte uitvoer voordat je om code vraagt. Een prijsfunctie die gewone gehele getallen verwerkt maar null als nul accepteert, schendt het contract. Voer zowel de nieuwe randgevallen als de bestaande projecttests uit; het slagen voor één nieuwe test kan een kapotte aanroeper elders verbergen.
2. Omvang van de wijziging. Vergelijk de patch met het verzoek. Het extraheren van een ID-parser moet de URL, het succesantwoord en het foutantwoord behouden. Een ongevraagde frameworkmigratie voegt beoordelingswerk toe, zelfs wanneer de vervanging compileert. Beslis vooraf of niet-gerelateerde bewerkingen het antwoord diskwalificeren of een reparatie vereisen.
3. Nuttige context en ruimte voor uitvoer. Je verzoek bevat instructies, relevante bestanden, tooldefinities en eerdere gesprekken. Reserveer ook genoeg ruimte voor het antwoord. Een groot geadverteerd contextvenster bewijst niet dat het model de relevante invariant vindt, of dat je endpoint hetzelfde maximum accepteert.
Test contextkwaliteit met een afhankelijkheid die ertoe doet. Neem een aanroeper op waarvan de interface stabiel moet blijven en verifieer dat het model die respecteert. Meet afkapping apart: een antwoord dat midden in een functie eindigt, kan niet worden geaccepteerd omdat de eerste regels veelbelovend leken.
4. Tool calling en gestructureerde uitvoer. Verifieer de ingezette route met je werkelijke toolschema. Controleer argumenttypen, ontbrekende velden, tool-identificaties en het vervolgantwoord na een toolresultaat. Een model dat een plausibel JSON-object schrijft, heeft niet noodzakelijkerwijs een volledige native tool-call-roundtrip voltooid.
5. Tijd tot een geaccepteerd resultaat. Registreer de duur van de hele poging, inclusief reparaties en tests. Bij een interactieve assistent is de tijd tot de eerste zichtbare tekst ook belangrijk, maar die kan de voltooiingstijd niet vervangen. Een snel eerste token gevolgd door een lang onbruikbaar antwoord houdt de ontwikkelaar alsnog tegen.
6. Kosten voor invoer, uitvoer, cache en herhalingen. Lees de factureringscategorieën die je gekozen endpoint daadwerkelijk rapporteert. Scheid cache-leesacties van gewone invoer waar van toepassing. Houd mislukte verzoeken en afgebroken loops bij. Als de provider de details die je nodig hebt niet beschikbaar stelt, markeer dan expliciet de ontbrekende aannames in de schatting.
7. Voorwaarden voor integratie en omgang met code. Bevestig dat je editor of applicatie de route, authenticatiemethode en foutindeling ondersteunt. Bekijk de actuele voorwaarden voor gegevensverwerking van de provider voordat je privébroncode verstuurt. Open weights beschrijven een keuze voor modeldistributie; ze bewijzen niet hoe een gehoste service met je verzoeken omgaat.
Openbare benchmarks kunnen je helpen kandidaten te selecteren, mits je hun voorwaarden leest. SWE-bench Verified bevat 500 door mensen gefilterde instanties. De huidige pagina beschrijft ook een Bash Only-weergave met dezelfde mini-SWE-agent-omgeving. Deze details helpen verklaren wat er wordt vergeleken. (SWE-bench, geraadpleegd september 2026)
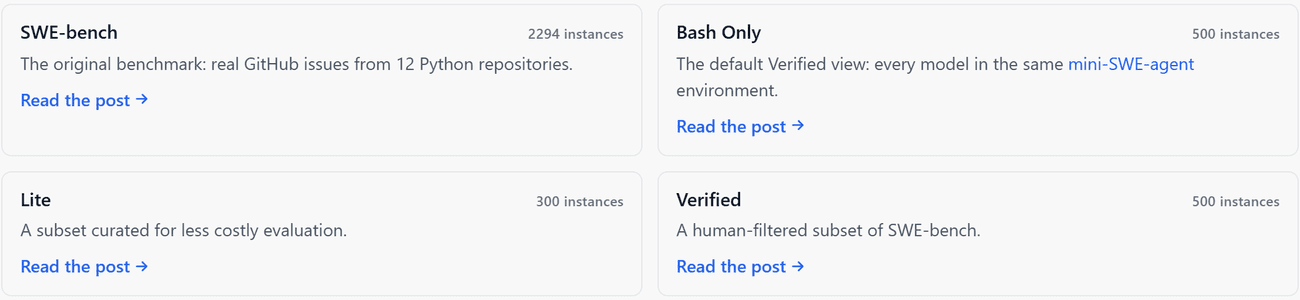 SWE-bench-pagina met de grootte van de Verified-dataset en de gedeelde agent-omgeving
Bronbewijs: de echte benchmarkpagina, vastgelegd op 21 september 2026. Dataset- en uitvoeringsvoorwaarden horen naast elke prestatieclaim te staan.
Benchmarkresultaten beschrijven een specifieke opzet. Jouw taal, bedrijfsregels, machtigingen en beoordelingsnormen kunnen afwijken. Neem de uiteindelijke beslissing op basis van werk dat je kunt inspecteren.
Beste AI-API voor coderen: voer drie praktische checks uit
Deze drie reproduceerbare evaluatievoorbeelden leggen verschillende faalwijzen bloot. Leg hun acceptatieregels vast voordat je om uitvoer vraagt. Beoordeel de functie of pagina aan de hand van het contract, ongeacht de kwaliteit van de uitleg.
Voor DeepSeek V4 Pro, Qwen3.5 122B A10B en Kimi K3 is het beoogde protocol drie onafhankelijke runs per taak. Dat betekent 27 eerste pogingen. Sta maximaal één feedbackreparatie per poging toe, bewaar het eerste antwoord en rapporteer de initiële en gerepareerde uitkomsten afzonderlijk.
Vraag alleen om temperature nul waar dit wordt ondersteund, en leg de daadwerkelijk geaccepteerde instelling vast. Gebruik een gevraagd uitvoerplafond van 4.096 tokens voor A en B en 8.192 voor C, na controle van de endpointlimieten. Standaardwaarden en niet-ondersteunde instellingen moeten worden vastgelegd. Een lage temperature garandeert geen identieke antwoorden.
Bewijsstatus: toegang tot de testomgeving werd geblokkeerd door een Cloudflare Access-inlogscherm. De 27 kandidaatpogingen konden niet worden uitgevoerd. Het volgende bewijs toont lokaal uitgevoerde originele code en een door de auteur gemaakte CSV-referentiefixture, geen resultaten van kandidaatmodellen. Slagingspercentages van modellen, tokengebruik en taakkosten blijven ongemeten.
Taak A: numerieke prijsselectie repareren. Plak deze exacte prompt in een nieuwe sessie:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
De vaste acceptatie-invoer is [2,10,3], ["12","3"], een lege array, alleen ongeldige waarden, nul, negatieve getallen en strings met alleen witruimte. Weiger lege strings na trimmen. Controleer dat de oorspronkelijke array na de aanroep exact dezelfde elementen in dezelfde volgorde bevat.
Het origineel gebruikt JavaScript's standaardsortering en muteert de invoer. De taak controleert dus twee verschillende verplichtingen: het juiste numerieke minimum selecteren en de gegevens van de aanroeper niet wijzigen. Test conversieregels expliciet, want een korte oplossing op basis van coercion kan per ongeluk booleans of null accepteren.
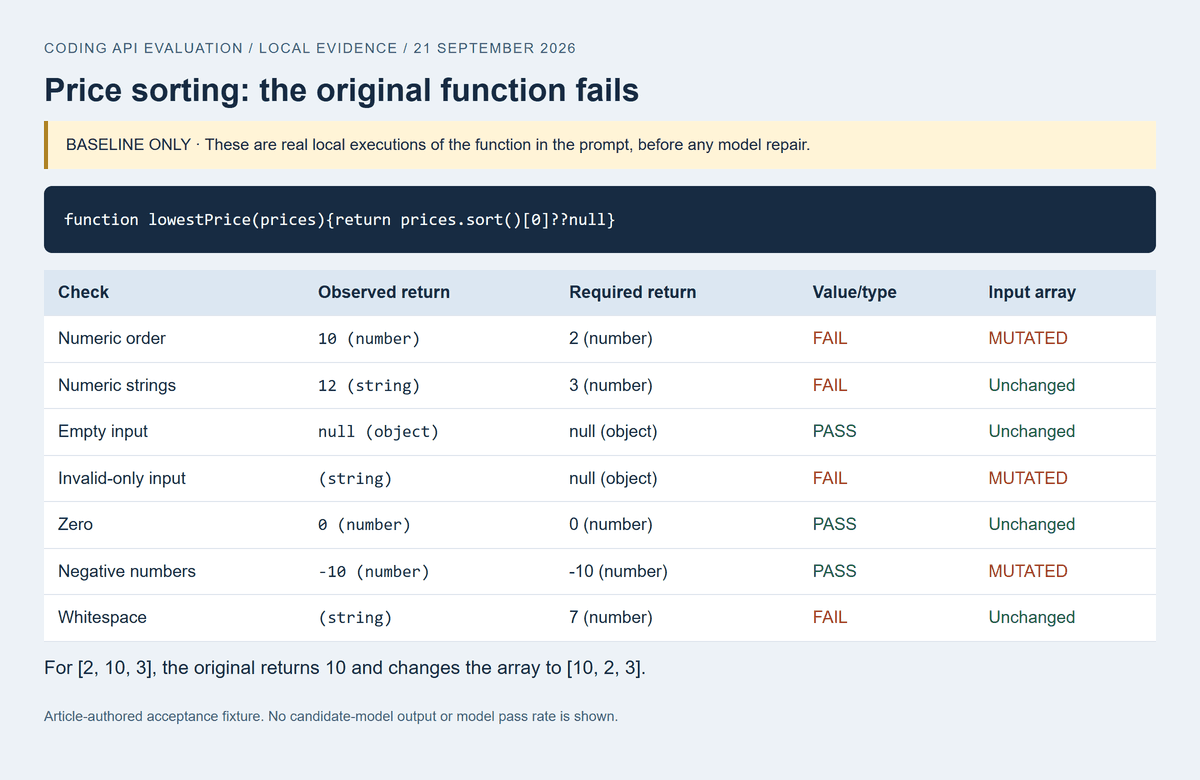 Lokale uitvoering van de originele prijsfunctie met onjuiste numerieke sortering en gemuteerde invoer
Uitgevoerde baseline: de originele functie retourneert 10 voor [2,10,3] en verandert de array in [10,2,3]. Numerieke strings voldoen ook niet aan het retourwaardecontract. Er is geen modelreparatie weergegeven.
Taak B: behoud een interface tijdens een kleine refactor. Gebruik deze prompt ongewijzigd:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Accepteer "12" en "0012" als 12. Weiger "1e2", "1.0", negatieven, nul, witruimte, niet-string-invoer en waarden buiten het veilige integergbereik van JavaScript. Verifieer het geregistreerde pad en beide responslichamen. Ongeldige invoer mag findUser niet bereiken.
Deze taak test of het model het verschil begrijpt tussen numerieke conversie en de gespecificeerde stringgrammatica. Inspecteer de diff op niet-gerelateerde wijzigingen en roep de handler vervolgens aan met gestubde request- en response-objecten. Een correcte helper gecombineerd met een ongewijzigde, permissieve handler faalt alsnog.
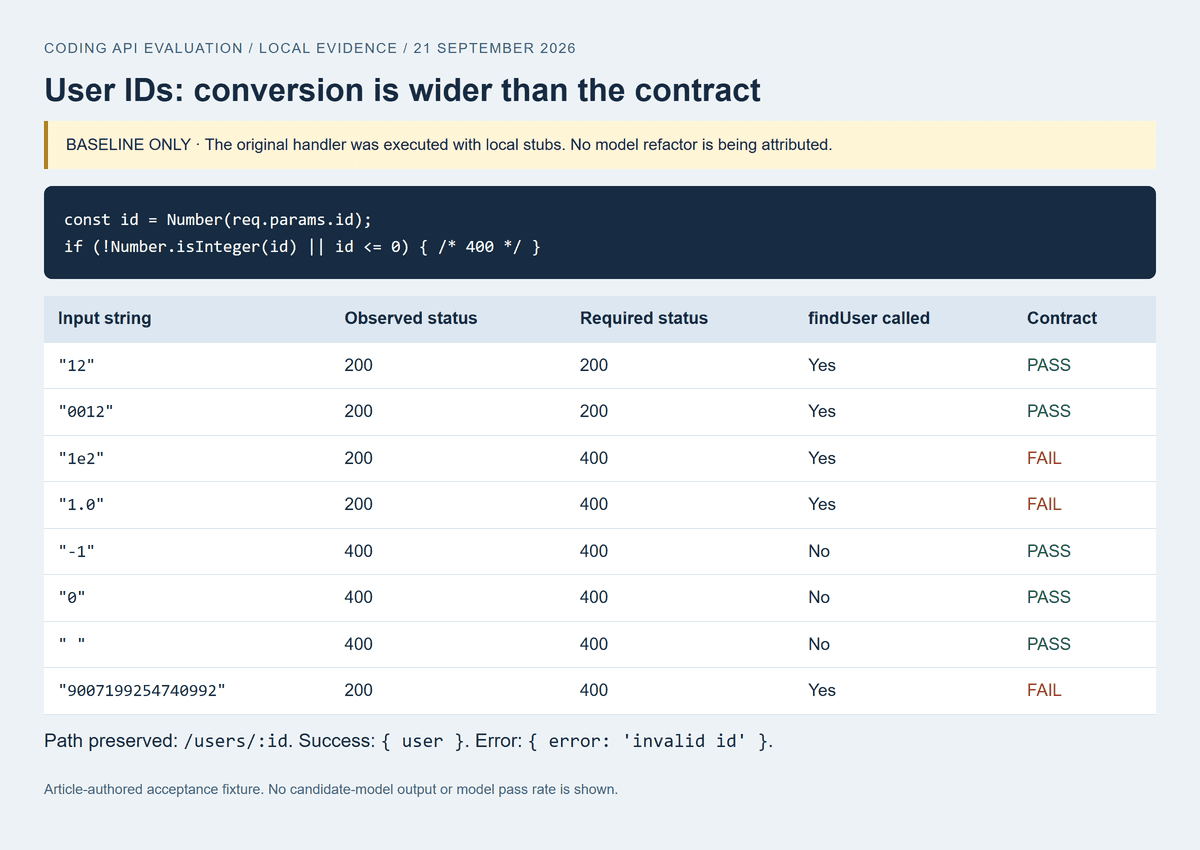 Testlog van de originele handler met ongeldige numerieke strings die met status 200 worden geaccepteerd
Uitgevoerde baseline: de originele handler retourneert 200 voor "1e2", "1.0" en "9007199254740992", ondanks het vereiste 400-antwoord. Lokale stubs registreerden de aanroepen; dit is geen door een model gegenereerde refactor.
Taak C: bouw een CSV-preview die je kunt bedienen. Dien in:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Test met deze exacte records, eerst met LF en daarna met CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Verwacht twee kolommen, drie gegevensrijen, Alice's komma binnen één cel en Bob's geëscapete aanhalingsteken correct weergegeven. Eve's waarde moet als letterlijke tekst verschijnen, zonder afbeeldingselement, uitvoering van events of netwerkverzoek. Voeg een rij met drie velden toe en bevestig dat de pagina de mismatch zichtbaar meldt.
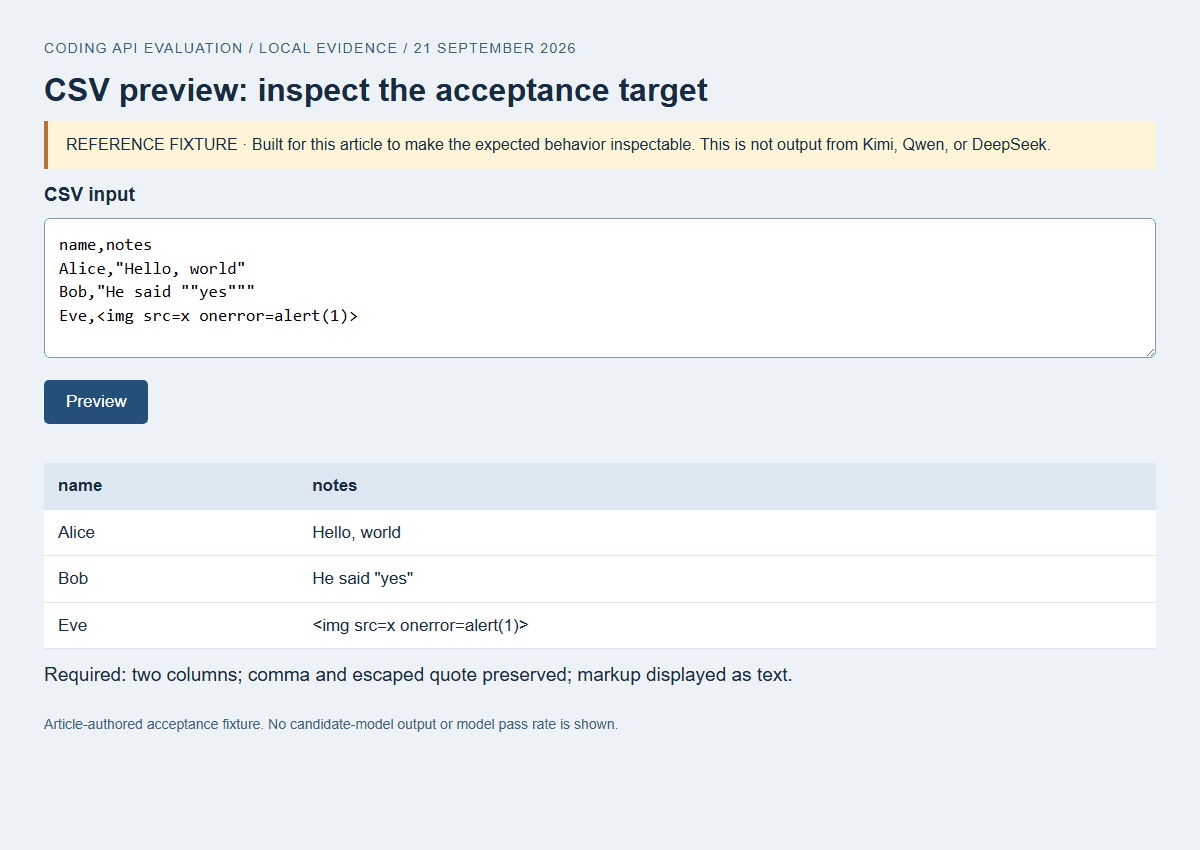 CSV-acceptatiefixture met gequote waarden en vereisten voor letterlijke markup
Bedreven referentiefixture, gemaakt voor dit artikel, niet gegenereerd door een kandidaatmodel. Browsercontroles verifieerden LF/CRLF-parsing, geëscapete aanhalingstekens, letterlijke markup, zichtbare fouten in veldaantallen en geen HTTP-verzoeken. De schermafbeelding toont de geldige-invoerstatus na het klikken op Preview.
Bewaar ruwe uitvoer, logs, model-ID, datum, parameters, timing, reparaties en handmatige aanpassingen. Stuur mislukte assertions voor een reparatie zonder de verwachte uitkomsten te wijzigen. Bewaar weigeringen, afkappingen en fouten naast successen.
Beste AI-API voor coderen met een budget
Vergelijk tokentarieven naast voltooiingskwaliteit en gebruik. Herhaalde invoer kan de kosten van codebeoordeling domineren; generatie van hele bestanden kan de uitvoerkosten verhogen. Herhaalde reparaties voegen beide toe.
De Atlas-catalogus en exacte detailpagina's toonden op 21 september 2026 deze tarieven in USD per miljoen tokens:
- DeepSeek V4 Pro: $1.68 invoer en $3.38 uitvoer. De afzonderlijke vermelding V4 Pro 0813 gebruikt andere tarieven; gebruik die niet als vervanging.
- Qwen3.5 122B A10B: $0.30 invoer en $2.40 uitvoer. De catalogus toonde reguliere tarieven van $0.40 en $3.20 met 25% korting, per september 2026.
- Kimi K3: $3.00 invoer en $15.00 uitvoer.
Dit zijn weergegeven productietarieven, geen facturen uit de evaluatie van dit artikel. Cachespecifieke tarieven en hun toepasbaarheid zijn niet bevestigd. Promotiekortingen voor DeepSeek en Kimi zijn niet bevestigd. Een ontbrekende kortingswaarneming bewijst niet dat er geen aanbieding bestaat.
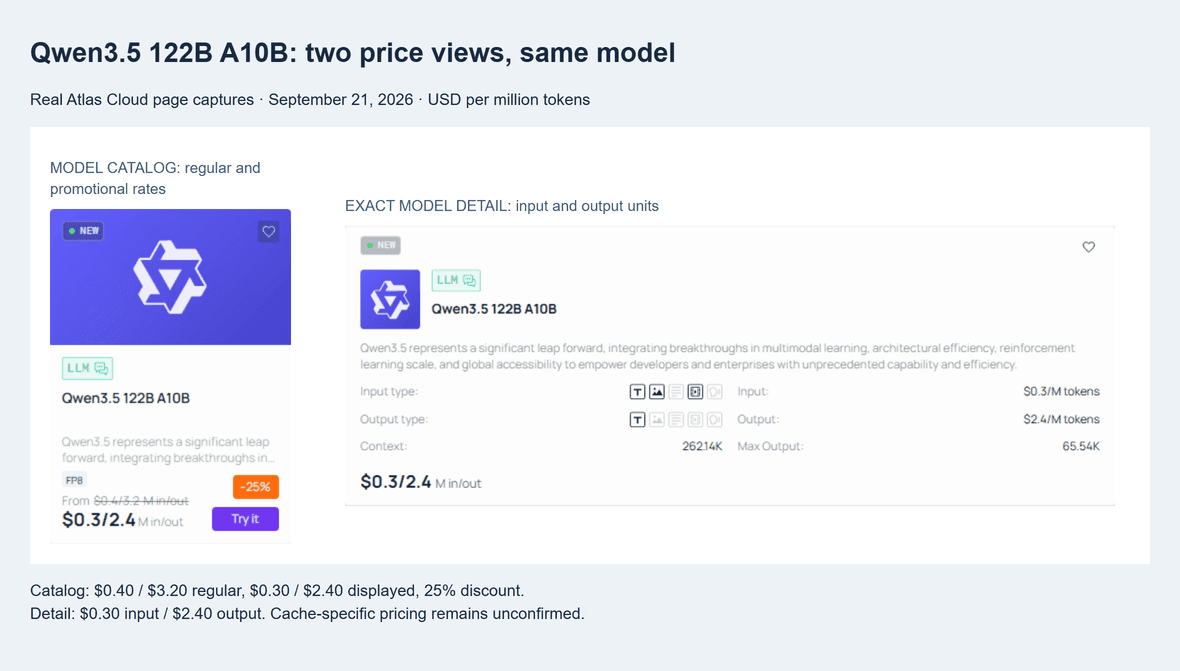 Kortingsvermelding voor Qwen3.5 122B A10B in de catalogus naast de exacte invoer- en uitvoertarieven op de modeldetailpagina
Prijscontrole Qwen, 21 september 2026: de catalogus toont de promotie van 25%; de exacte modeldetailpagina bevestigt $0.30 invoer en $2.40 uitvoer per miljoen tokens. Cachespecifieke tarieven blijven onbevestigd.
Bereken het modelgedeelte van een taak als:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Factureer gecachte tokens niet opnieuw als gewone invoer als het factureringsrecord ze apart behandelt. Controleer of reasoning-gebruik is inbegrepen in factureerbare uitvoer. Als geen enkele taak slaagt, meld dan 'geen succesvol resultaat'; delen door nul of een voltooiingskosten van nul weergeven zou de lezer misleiden.
Stel voor een transparant rekenvoorbeeld 10.000 gewone invoertokens en 2.000 uitvoertokens tegen de weergegeven Qwen-tarieven. De geschatte modelkosten zijn $0.0078, vóór andere toepasselijke posten. Dit is een hypothetisch verzoek, geen waargenomen tokengebruik of een werkelijke factuur.
Eén even grote reparatie zou de schatting op $0.0156 brengen. Werkelijke reparaties bevatten andere context en uitvoer, dus bereken elk verzoek op basis van het geregistreerde gebruik.
| Taak | Model | Eerste poging | Na reparatie | Tokengebruik | Kostenbron | Totale kosten | Totale tijd | Handmatige wijzigingen |
|---|---|---|---|---|---|---|---|---|
| A, B, C; elk 3 herhalingen gepland | DeepSeek V4 Pro | Niet gemeten | Niet gemeten | Niet geregistreerd | Geen gebruiksregistratie | Onbekend | Niet gemeten | Geen geëvalueerd |
| A, B, C; elk 3 herhalingen gepland | Qwen3.5 122B A10B | Niet gemeten | Niet gemeten | Niet geregistreerd | Geen gebruiksregistratie | Onbekend | Niet gemeten | Geen geëvalueerd |
| A, B, C; elk 3 herhalingen gepland | Kimi K3 | Niet gemeten | Niet gemeten | Niet geregistreerd | Geen gebruiksregistratie | Onbekend | Niet gemeten | Geen geëvalueerd |
Splits voor je eigen werkblad elke rij op in één rij per model en herhaling. Tel een gerepareerd succes één keer mee in de noemer van geaccepteerde taken. Neem mislukte pogingen op in de teller en houd aparte kolommen bij voor eerste poging en definitieve acceptatie.
Volg menselijke beoordeling en infrastructuur apart. Het ontwarren van een onnodige herschrijving kan een inferentiebesparing tenietdoen. Vergelijk kandidaten die zowel aan de acceptatievereisten als aan je budget voor beoordelingstijd voldoen.
Beste AI-API voor coderen met Atlas Cloud
Begin met de Kimi K3-modelpagina, bevestig de ID en bekijk de API- en Code-weergaven. Bewaar de gekozen versie naast het testrecord.
Lees de LLM-protocoldocumentatie voordat je twee routes als uitwisselbaar behandelt. Daarin wordt Chat Completions aangemerkt als de route met brede dekking en worden gebruikers doorverwezen naar de supported_apis van elk model. Sampling-instellingen en toolfuncties zijn ook afhankelijk van de geadverteerde ondersteuning van het model.
Er zijn hier concrete integratiedetails die het controleren waard zijn. De documentatie zegt dat vertaalde Anthropic-verzoeken geen cache_control toepassen en dat door de provider gehoste tools niet beschikbaar zijn op die vertaalde route. Die beperkingen zijn belangrijk als je bestaande agent uitgaat van native caching of een gehoste browsingtool. Stem de client af op de werkelijke route.
Het volgende Node.js-voorbeeld illustreert één tekstverzoek. Het gebruikt de ingebouwde fetch, een omgevingsvariabele voor inloggegevens en de geverifieerde Kimi-model-ID. Sla de exacte prompt van taak A op als task-a.txt. Stel de omgevingsvariabele voor de basis-URL in op de Atlas API-basis die in de documentatie wordt getoond en eindigt op /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages bevat de taak; model selecteert de deployment; max_tokens vraagt om een uitvoerplafond. De responslezer controleert op gewone voltooide tekst voordat code wordt geretourneerd. De timeout begrenst de wachttijd van dit voorbeeld; hij bewijst niet dat de server is gestopt met verwerken of dat er geen kosten zijn gemaakt.
Temperature is weggelaten omdat ondersteuning per model en vastgelegd gedrag verificatie vereisen. Het voorbeeld probeert niet automatisch opnieuw. Beoordeel de faalklasse voordat je een begrensd herhaalbeleid toevoegt en log nooit de autorisatieheader. Deze publicatiecode is tijdens de productie van het artikel niet met een API-sleutel uitgevoerd.
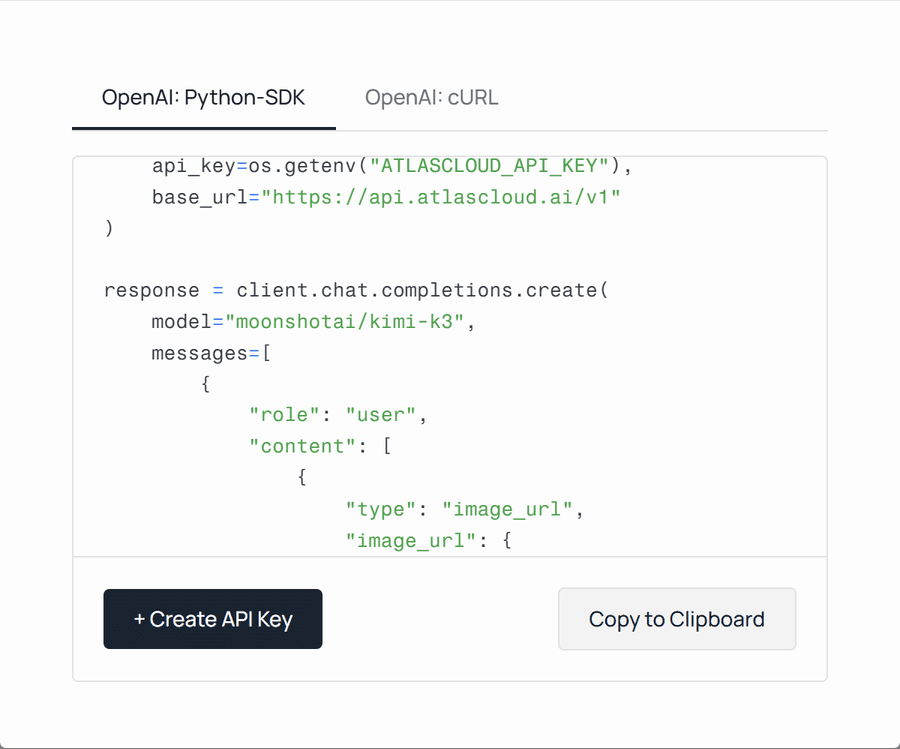 Openbaar codevoorbeeld van de Kimi K3-API met het Atlas-endpoint en de modelidentificatie
Openbare Kimi K3 Code-dialoog, vastgelegd op 21 september 2026. Dit is configuratiebewijs, geen voltooide codeerrun. Het voorbeeld op de pagina bevat media-invoer; het voorbeeld in het artikel gebruikt alleen tekst.
Voer de acceptatiechecks van taak A uit op elke geretourneerde functie. Verifieer het protocol en de parameters voordat je overstapt op DeepSeek of Qwen. Houd prompts en tests ongewijzigd terwijl je uitvoer en gebruik vergelijkt; een gedeelde verzoekvorm bewijst geen identiek gedrag.
Voordat je een coding-API in productie gebruikt
Voer gegenereerde code eerst uit in een wegwerp-branch of geïsoleerde werkruimte. Gebruik voor de CSV-taak een lokale browsercontext met geblokkeerde netwerkverzoeken en zonder toegang tot gevoelige applicatiestatus. Geef het proces voor repositorytaken alleen de bestanden en commando's die voor de evaluatie nodig zijn.
Definieer succes buiten het antwoord van het model. Als een agent zegt 'alle tests geslaagd', moet dat je leiden naar een echt testlog, een exitcode en een gecontroleerde revisie. Bewaar de diff samen met dat bewijs. Anders kan een latere reparatie de bestanden wijzigen na het ogenschijnlijke succes en het rapport verouderd achterlaten.
Behandel timeouts en herhalingen als applicatiegedrag dat je zelf beheert. Stel een deadline per verzoek en een totaal taakbudget in. Scheid fouten door inloggegevens of ongeldige parameters van tijdelijke transportstoringen. Een ongeldig verzoek herhalen kost tijd; een verzoek herhalen dat neveneffecten veroorzaakt, kan dubbel werk opleveren.
Maak, wanneer de agent tools kan aanroepen, onderscheid tussen alleen-lezen inspectie en schrijfacties. Wijs operatie-identificaties toe waar je toolontwerp dit ondersteunt en bevestig de status voordat je een onzekere schrijfactie herhaalt. Het herhaalbeleid van een model-endpoint kan geen idempotentie garanderen voor de tools die je applicatie daarna uitvoert.
Bescherm logs net zo bewust als bronbestanden. Registreer model-ID's, tijdstempels, status, timing en gebruik zonder routinematig geheimen of volledige privérepositories naar telemetrie te kopiëren. Bewaar vereist bewijs van ruwe uitvoer op een passend beperkte locatie en leg vast hoelang het team het moet bewaren.
Controleer streaming met je echte client. Die moet omgaan met gedeeltelijke events, beëindiging, fouten en gebruiksregistraties waar beschikbaar. Bevestig de snelheidslimieten voor het werkelijke account en de deployment. Een rustig experiment met één gebruiker kan niet vaststellen hoe dezelfde route zich gedraagt wanneer een team tegelijk verzoeken verstuurt.
Gebruik deze korte releasechecklist:
- Acceptatietests en bestaande regressies slagen op de definitieve revisie.
- De diff blijft binnen de goedgekeurde taakgrens.
- Timeout-, annulerings- en herhaalgedrag is getest.
- Tool-aanroepen en gestructureerde antwoorden werken op het gekozen endpoint.
- Logs bevatten geen inloggegevens en onnodige privécode.
- De voorwaarden voor gegevensverwerking voldoen aan de eisen van het team.
- Een fallback heeft zijn eigen geverifieerde configuratie en testrecord.
Privérepositories vereisen een servicespecifieke beslissing. Bespreek de actuele voorwaarden voor bewaring, gebruik voor training, toegang en contracten met de persoon die verantwoordelijk is voor de code. Verstuur alleen goedgekeurd materiaal. Leid vertrouwelijkheid niet af uit het feit dat modelgewichten beschikbaar zijn of dat een protocol lijkt op een protocol dat je al gebruikt.
Beste AI-API voor coderen: maak je definitieve keuze
Neem de beslissing in drie rondes.
Eerst: schrap kandidaten die een vereiste mogelijkheid missen. Schrijf de voorwaarden op waaraan moet worden voldaan: een geaccepteerd uitvoerformaat, een werkende tool-loop, een passende regeling voor gegevensverwerking of een haalbare reactiedeadline. Een kandidaat die er één mist, vereist een aparte herstelbeslissing voordat hij in de definitieve vergelijking thuishoort.
Ten tweede: vergelijk de kosten per geaccepteerde taak en de verstreken tijd. Gebruik alle pogingen onder hetzelfde reparatiebeleid. Scheid successen in de eerste poging van gerepareerde successen en toon ontbrekende gebruiksregistraties. Als twee modellen beide aan het contract voldoen, vergelijk dan hun beoordelingslast én de modelkosten. Je ontwikkelaars moeten met de resulterende patches leven.
Ten derde: houd één fallback aan en definieer de trigger. Voorbeelden zijn een aanhoudende endpointstoring, herhaalde fouten in gestructureerde uitvoer of taakkosten boven een gekozen plafond. Test de alternatieve configuratie vooraf. Het onder druk wisselen van een model-ID kan een tweede integratieprobleem introduceren als de instellingen of het responsgedrag afwijken.
De drie kleine taken in deze gids zijn een screeningsoefening. Breid de suite uit met representatief werk uit je eigen codebase voordat je op een kandidaat vertrouwt voor brede wijzigingen. Houd een paar taken buiten de prompt-tuning, zodat je kunt controleren of verbeteringen ook buiten de voorbeelden die je hebt geoptimaliseerd standhouden.
De beste ai-api voor coderen is de combinatie die je kunt uitleggen: hij voltooit het vereiste werk, toont kosten die je kunt volgen en past bij de manier waarop je applicatie draait. Er is geen universele winnaar nodig om die beslissing te nemen.
Open de actuele modelcatalogus, kies twee kandidaten en bewaar hun exacte ID's en instellingen. Gebruik vervolgens voor beide dezelfde taak, dezelfde tests en dezelfde stopregel.
Veelgestelde vragen
Wat is de beste AI-API voor coderen met een klein budget?
Begin met een kandidaat waarvan de weergegeven tarieven passen bij je waarschijnlijke invoer- en uitvoervolumes en vergelijk vervolgens de kosten per geaccepteerde taak. De rijen voor Qwen, DeepSeek en Kimi bieden concrete versies om te onderzoeken, zonder een geteste waardewinnaar te claimen. Beperk het aantal reparatiepogingen, hergebruik relevante context bewust en volg mislukte verzoeken. Neem beoordelingstijd apart mee, zodat een lage inferentiefactuur geen grote opruimlast verbergt.
Is een codeerabonnement goedkoper dan betalen voor API-tokens?
Dat hangt af van je workload en wat het abonnement omvat. Een abonnement kan geschikt zijn voor interactief gebruik binnen de ondersteunde applicatie, terwijl gebruiksfacturering kan passen bij een aangepaste service met variabel verkeer. Controleer modeltoegang, limieten, gelijktijdigheid en of externe API-aanroepen überhaupt zijn inbegrepen. Vergelijk dezelfde hoeveelheid nuttig werk over een representatieve periode; een maandelijkse prijs en een tokentarief meten verschillende dingen.
Wat is het verschil tussen een codeermodel en een coding agent?
Het model genereert antwoorden. De agent beheert de loop rond die antwoorden, inclusief bestandstoegang, tooluitvoering, tests en stopregels. Je kunt een codeermodel via een API aanroepen zonder een agent te bouwen, bijvoorbeeld om een functie voor menselijke beoordeling voor te stellen. Wil je autonome bewerkingen, evalueer dan het model samen met de agent en de machtigingen die daadwerkelijk worden gebruikt.
Welke AI-API moet ik gebruiken voor debuggen en refactoring?
Maak een shortlist van kandidaten die passen bij je endpoint- en codeverwerkingsvereisten en gebruik vervolgens kleine bugs en beperkte refactors uit je werk. Taak A controleert correctheid en inputmutatie; taak B controleert parsing en behoud van interfaces. Volg die op met representatieve repositorytests.
Geef de voorkeur aan de kandidaat die aan je acceptatievoorwaarden voldoet met beheersbare beoordelingsinspanning, in plaats van een die simpelweg de langste uitleg of meest uitgebreide herschrijving produceert.
Bestaat er een gratis AI-API voor coderen?
Een proeftegoed, een applicatie met een gratis laag en downloadbare modelgewichten zijn verschillende aanbiedingen. Geen daarvan geeft je applicatie automatisch onbeperkte gehoste inferentie. Verifieer de actuele geschiktheid, vervaldatum, quota en ondersteunde modellen voordat je op gratis toegang begroot. Dit artikel claimt geen momenteel beschikbare gratis tegoed.
Als je gewichten zelf host, reken dan op compute en beheer, zelfs wanneer het downloaden van de gewichten niets kost.
Mag ik privérepositorycode naar een coding-API sturen?
Verstuur alleen code die je organisatie je toestaat te delen onder de toepasselijke voorwaarden van de specifieke service. Bekijk bewaring, gebruik voor training, toegangscontroles en contractuele vereisten voor de gekozen deployment.
Verwijder inloggegevens en niet-gerelateerde bestanden en controleer wat je agent automatisch opneemt in prompts en logs. Een open-weight-model of een bekend API-formaat bewijst op zichzelf niet dat een gehoste service voldoet aan de vertrouwelijkheidseisen van je team.


