Je verzoek wordt succesvol geretourneerd. De applicatie heeft nog steeds geen bruikbare afbeelding. Misschien bevat de respons wel een taak-ID, of staat er op de voltooide afbeelding een extra object dat deze ongeschikt maakt voor de pagina.
Een generatieve AI-API voor ontwikkelaars laat je applicatie invoer naar een model sturen en gegenereerde content ontvangen. Kies er een op basis van je vereiste invoer, uitvoerformaat, wachttijd en acceptatiecriteria. Bouw vervolgens de taakverwerking en de controles die van een respons iets maken dat een gebruiker kan gebruiken.
Deze gids volgt een afbeeldingsworkflow van selectie tot oplevering. Je krijgt een taakselectietabel, bijpassende JavaScript- en Python-voorbeelden, 3 concrete beeldbrieven en een kostenwerkblad. Hetzelfde besluitvormingsproces geldt voor tekst en video, met andere protocollen en uitvoercontroles.
Belangrijkste punten
- Kies de taak en de acceptatiecriteria vóór het model.
- Bewaar asynchrone taak-ID's zodat onderbroken werk kan worden hervat.
- Meet de kosten per geaccepteerde output, inclusief afgewezen generaties.
- Test bestanden en bedrijfsbeperkingen voordat je een eindresultaat toont.
Generatieve AI-API voor ontwikkelaars: wat het doet
Een model voert de generatie uit. Een API bepaalt hoe je software dat werk aanvraagt. Een SDK verpakt de interface in taalspecifieke hulpmiddelen. Een gehost platform beheert de toegang tot modellen, terwijl jouw applicatie de gebruikerservaring, machtigingen en regels voor het accepteren van het resultaat levert.
Deze verschillen zijn belangrijk bij het lezen van een productpagina. Een chatapplicatie die afbeeldingen maakt, bewijst niet dat het ontwikkelaarseindpunt dezelfde invoer accepteert. Een SDK met een handige methode neemt niet weg dat je de onderliggende respons en faalstatus moet begrijpen.
Begin met de volgende taakkaart. De kolom Interactie beschrijft een te evalueren applicatieontwerp, niet een belofte dat elke provider die modus ondersteunt.
| Taak | Invoer | Vereiste capaciteit | Uitvoer | Te evalueren interactie | Acceptatiecriteria |
|---|---|---|---|---|---|
| Concept voor supportantwoord | Ticket en goedgekeurde helpcontent | Gefundeerde tekstgeneratie | Concepttekst | Synchroon of streaming | Beantwoordt het ticket; geen verzonnen beleid |
| Veldextractie uit documenten | Documenttekst of ondersteund bestand | Gestructureerde extractie | JSON-velden | Verzoek of wachtrijtaak | Geldig schema en bronbewijs |
| Redactionele illustratie | Schriftelijke beeldbrief | Tekst-naar-afbeelding | Afbeeldingsbestand | Asynchrone taak | Correcte objecten, lay-out, afmetingen |
| Afbeeldingsbewerking | Bronafbeelding en instructie | Bewerking op basis van afbeelding | Bewerkte afbeelding | Asynchrone taak | Gevraagde wijziging; behouden details |
| Videogeneratie | Prompt of ondersteunde referentie | Videogeneratie | Videobestand | Taak in wachtrij | Correcte duur, beweging, audio indien vereist |
| Antwoord met retrievalondersteuning | Vraag en opgehaalde passages | Retrieval plus generatie | Antwoord en referenties | Synchroon of streaming | Beweringen ondersteund door opgehaalde passages |
Een afbeelding genereren, een geüploade afbeelding analyseren en een bestaande afbeelding bewerken zijn afzonderlijke capaciteiten. Verifieer elk expliciet. Zo kan een video-eindpunt een startframe ondersteunen zonder willekeurige multi-image-referenties te ondersteunen.
Embeddings zetten invoer om in vectoren die bruikbaar zijn voor retrieval en gelijkenis. Ze kunnen helpen relevante documenten te vinden voordat een antwoord wordt gegenereerd. Ze produceren zelf niet het antwoord en tonen niet aan dat opgehaalde content de beweringen ondersteunt.
De praktische grens is invoer → verzoek → uitvoer → acceptatie door de applicatie. De laatste fase is jouw verantwoordelijkheid. Een gegenereerd factuurveld moet nog steeds worden gevalideerd; een afbeelding moet nog steeds worden gecontroleerd; een supportantwoord heeft nog steeds toestemming nodig om de belofte te doen die het bevat.
Protocolkeuzes verschillen ook. De referentie van Google onderscheidt standaardgeneratie, streaming en live-interactie. Zie dat als bewijs dat interactiemodi verschillen, in plaats van aan te nemen dat de ondersteuning elders identiek is. (Google Gemini API-referentie, geraadpleegd september 2026.)
Generatieve AI-API voor ontwikkelaars: hoe je kiest
Schrijf een korte acceptatiebrief voordat je catalogi vergelijkt. Voor een redactionele afbeeldingsfunctie kan die landschapsuitvoer, een begrensd aantal objecten, geen zichtbare branding en een stap voor menselijke beoordeling specificeren. Voor ticketclassificatie kan die een vaste labelset en een expliciete onzekere uitkomst specificeren.
Evalueer kandidaten in deze volgorde:
- Invoer en uitvoer. Controleer het exacte modeleindpunt op ondersteunde bestanden, invoerlimieten, uitvoerformaten en gedrag met referentieafbeeldingen. Een naam van een modelfamilie is te ruim om als contract te dienen.
- Taaknaleving. Probeer representatieve brieven, inclusief lastige. Tel beperkingsfouten apart van bestands- of netwerkfouten, zodat je weet wat er moet worden opgelost.
- Integratiegeschiktheid. Bevestig authenticatie, responsenveloppen, taakstatuswaarden en ondersteuning in clientbibliotheken. Reken het werk mee dat nodig is om deze aan te passen aan je bestaande backend.
- Wachttijd en gelijktijdigheid. Bepaal of gebruikers kunnen wegblijven en terugkomen. Test je verwachte werklast voordat je je vastlegt op een interactieve ervaring met een korte deadline.
- Duidelijkheid over facturatie. Stel de factureerbare eenheid vast en welke instellingen die veranderen. Controleer de afhandeling van fouten en terugbetalingen in plaats van aan te nemen dat elk ingediend verzoek dezelfde kosten oplevert.
- Databehoeften. Beoordeel invoerverwerking, bewaring, verwijdering en toepasselijke voorwaarden tegen de werkelijke data die je van plan bent te versturen. Documenteer onopgeloste vragen voordat je gevoelig materiaal gebruikt.
- Wijzigingsbeheer. Houd een regressieset bij en leg model-ID's, prompts en parameters vast. Plan hoe je gedrag opnieuw beoordeelt na een update of vervanging.
Institutionele richtlijnen laten zien waarom toegangs- en dataregels bij deze beslissing horen: Harvard beschrijft goedgekeurde toegangsroutes en beperkingen rond zijn AI-ontwikkelaarstools. Dat zijn de regelingen van Harvard, geen universele machtigingen voor jouw applicatie. (Harvard University Information Technology, geraadpleegd september 2026.)
| Toegangsroute | Geschikt team | Integratiewerk | Operationele verantwoordelijkheid | Belangrijkste beperking | Verifieer vóór keuze |
|---|---|---|---|---|---|
| Directe modelprovider | Team gericht op de capaciteiten van één provider | Providerspecifieke API, accounts, adapters | Jouw app en taken; inferentie bij de provider | Extra providers voegen afzonderlijke contracten toe | Eindpuntfuncties, regio's, quota, voorwaarden |
| Gehost platform voor meerdere modellen | Team dat meerdere ondersteunde modellen evalueert | Gedeelde toegang plus modelspecifieke validatie | Jouw app en taken; door platform gehoste inferentie | Gedeelde toegang standaardiseert niet elke parameter | Exacte modellen, schema's, facturatie, datapad |
| Zelf gehost open model | Team met infrastructuur- en model-servingvaardigheden | Inferentie implementeren, ontsluiten, beveiligen en onderhouden | Hardware, serving, schalen, monitoring, updates | Capaciteit en engineeringoverhead | Licentie, hardwaregeschiktheid, doorvoer, onderhoud |
Atlas Cloud is één gehoste optie om te evalueren wanneer meerdere modelcapaciteiten in dezelfde applicatie thuishoren. Dit artikel gebruikt de interface voor afbeeldingstaken als concreet voorbeeld. Je moet nog steeds de invoer en uitvoer van elk model valideren; alleen een model-ID wijzigen is onvoldoende.
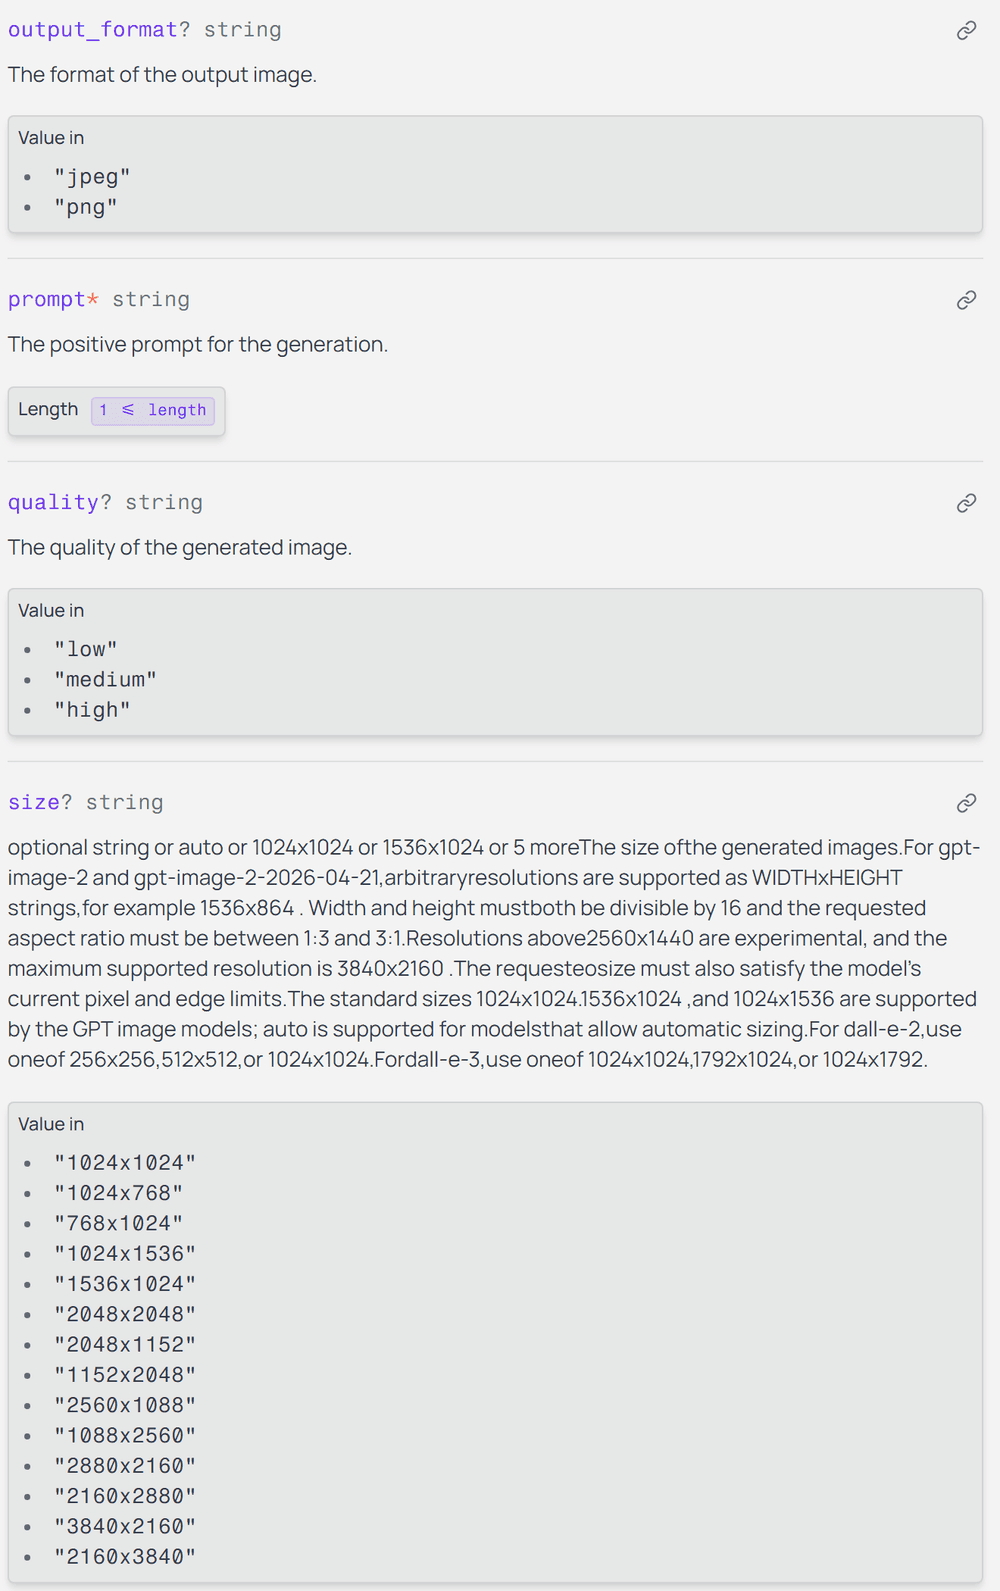
Officiële documentatie van het beeldeindpunt met uitvoerformaat, kwaliteit en beperkingen voor formaat
Modelspecifieke parameters maken deel uit van het integratiecontract. Lees hun toegestane waarden voordat je een requestbody hergebruikt.
Voor een klein SaaS-team is de nuttige vergelijking de totale inspanning om één geaccepteerd resultaat op te leveren. Reken adaptercode, supportonderzoek, beoordelingstijd en migratietests mee naast de inferentiekosten. Zo voorkom je dat een handig prototype een dure productieworkflow verbergt.
Generatieve AI-API voor ontwikkelaars: eerste verzoek
Het voorbeeld gebruikt GPT Image 2 Text-to-Image, met model-ID openai/gpt-image-2/text-to-image. De eindpuntdocumentatie vermeldt quality: high, size: 2048x1152 en output_format: png. Dit zijn de gevraagde instellingen voor de onderstaande voorbeelden.
1. Stel de prompt vast in de playground. Gebruik de onderstaande ontbijtbrief zonder een referentieafbeelding toe te voegen. Controleer de modelnaam en de vastgelegde instellingen voordat je op Run drukt. Een selectie die terugspringt wanneer je een veld verlaat, is niet de instelling die je hebt gevraagd.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Houd authenticatie op de server. Je frontend moet je eigen backend vragen om een taak te starten. Bewaar ATLAS_API_KEY in de serveromgeving. Neem deze nooit op in browser-JavaScript, afbeeldings-URL's of voor de client zichtbare logs. Stel ATLAS_API_HOST in op api.atlascloud.ai; dit is een hostnaam, zonder schema of pad.
3. Dien één keer in en bewaar het ID. De gedocumenteerde generatieroute is POST /api/v1/model/generateImage. Lees data.id en sla het op bij de taak van je applicatie. Als de respons op de inzending verloren gaat, onderzoek dit dan voordat je een nieuwe, mogelijk factureerbare taak aanmaakt.
4. Poll de opgeslagen taak. Bevraag GET /api/v1/model/prediction/{prediction_id}. De predictiedocumentatie beschrijft processing, completed en failed, met uitvoer-URL's in data.outputs. Bij een voltooide status moet je nog steeds controleren op een niet-lege uitvoerarray.
5. Download en valideer. Sla het bestand op onder jouw beheer, verifieer dat het decodeert en controleer het tegen de brief. Retourneer pas daarna een geaccepteerd resultaat aan de applicatie. Een download- of validatiefout moet aan de bestaande taak gekoppeld blijven.
De volgende code is samengesteld uit de officiële interfacedocumentatie. Deze wordt niet gepresenteerd als een live API-benchmark. De mediaworkflow van het artikel gebruikt de browsertest-playground, niet een API-sleutel.
Sla de exacte ontbijtprompt op als prompt.txt. Gebruik voor Node.js een omgeving met ingebouwde fetch, installeer sharp en sla dit op als generate.mjs. Voer het uit in een aparte werkmap. Voer slechts één van de twee taalvoorbeelden uit, tenzij je bewust twee taken wilt.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
Het kortere Python-equivalent gebruikt requests en Pillow, dezelfde prompt.txt en identieke instellingen. Het accepteert ook PREDICTION_ID om te hervatten. Deze scripts demonstreren één lokale taak; een uitgerolde service heeft persistente taakregistraties en begrensde downloads nodig.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
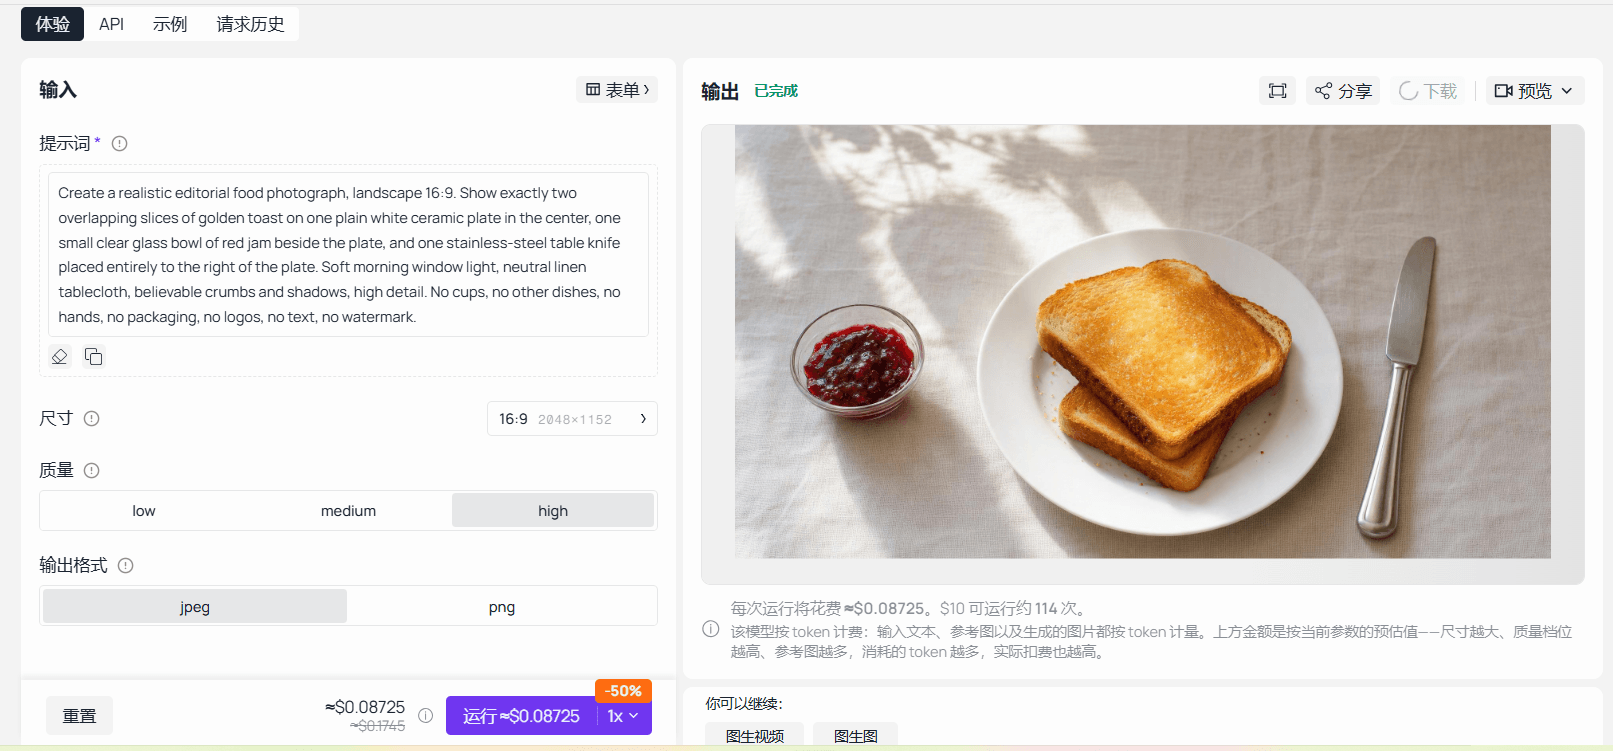 Voltooide GPT Image 2-playground met de ingediende ontbijtprompt en het voltooide resultaat
Een voltooide playground-run legt de ingediende prompt, uitvoergrootte, kwaliteitsinstelling en het gegenereerde resultaat samen vast.
Een pollingdeadline zorgt dat deze client stopt met wachten; het annuleert geen werk aan de serverzijde. Een verzoek dat al onderweg is, kan na het pollingvenster voltooien, dus dit is geen strikte end-to-end-latentiegarantie. Bewaar het ID en laat een worker het later controleren.
Generatieve AI-API voor ontwikkelaars: praktische toepassingen
De onderstaande 3 brieven testen verschillende vereisten. Het zijn onafhankelijke verzoeken, geen keten waarin het ene resultaat de volgende invoer wordt. Houd hetzelfde model en dezelfde gevraagde instellingen aan, zodat verschillen in de brieven makkelijk te begrijpen blijven.
A. Redactionele voedingsafbeelding: aantal en plaatsing. De ontbijtprompt test of de uitvoer 2 sneetjes toast, 1 bord, 1 jambakje en 1 mes bevat. Het mes moet rechts van het bord liggen en alle vereiste objecten moeten binnen het kader blijven.
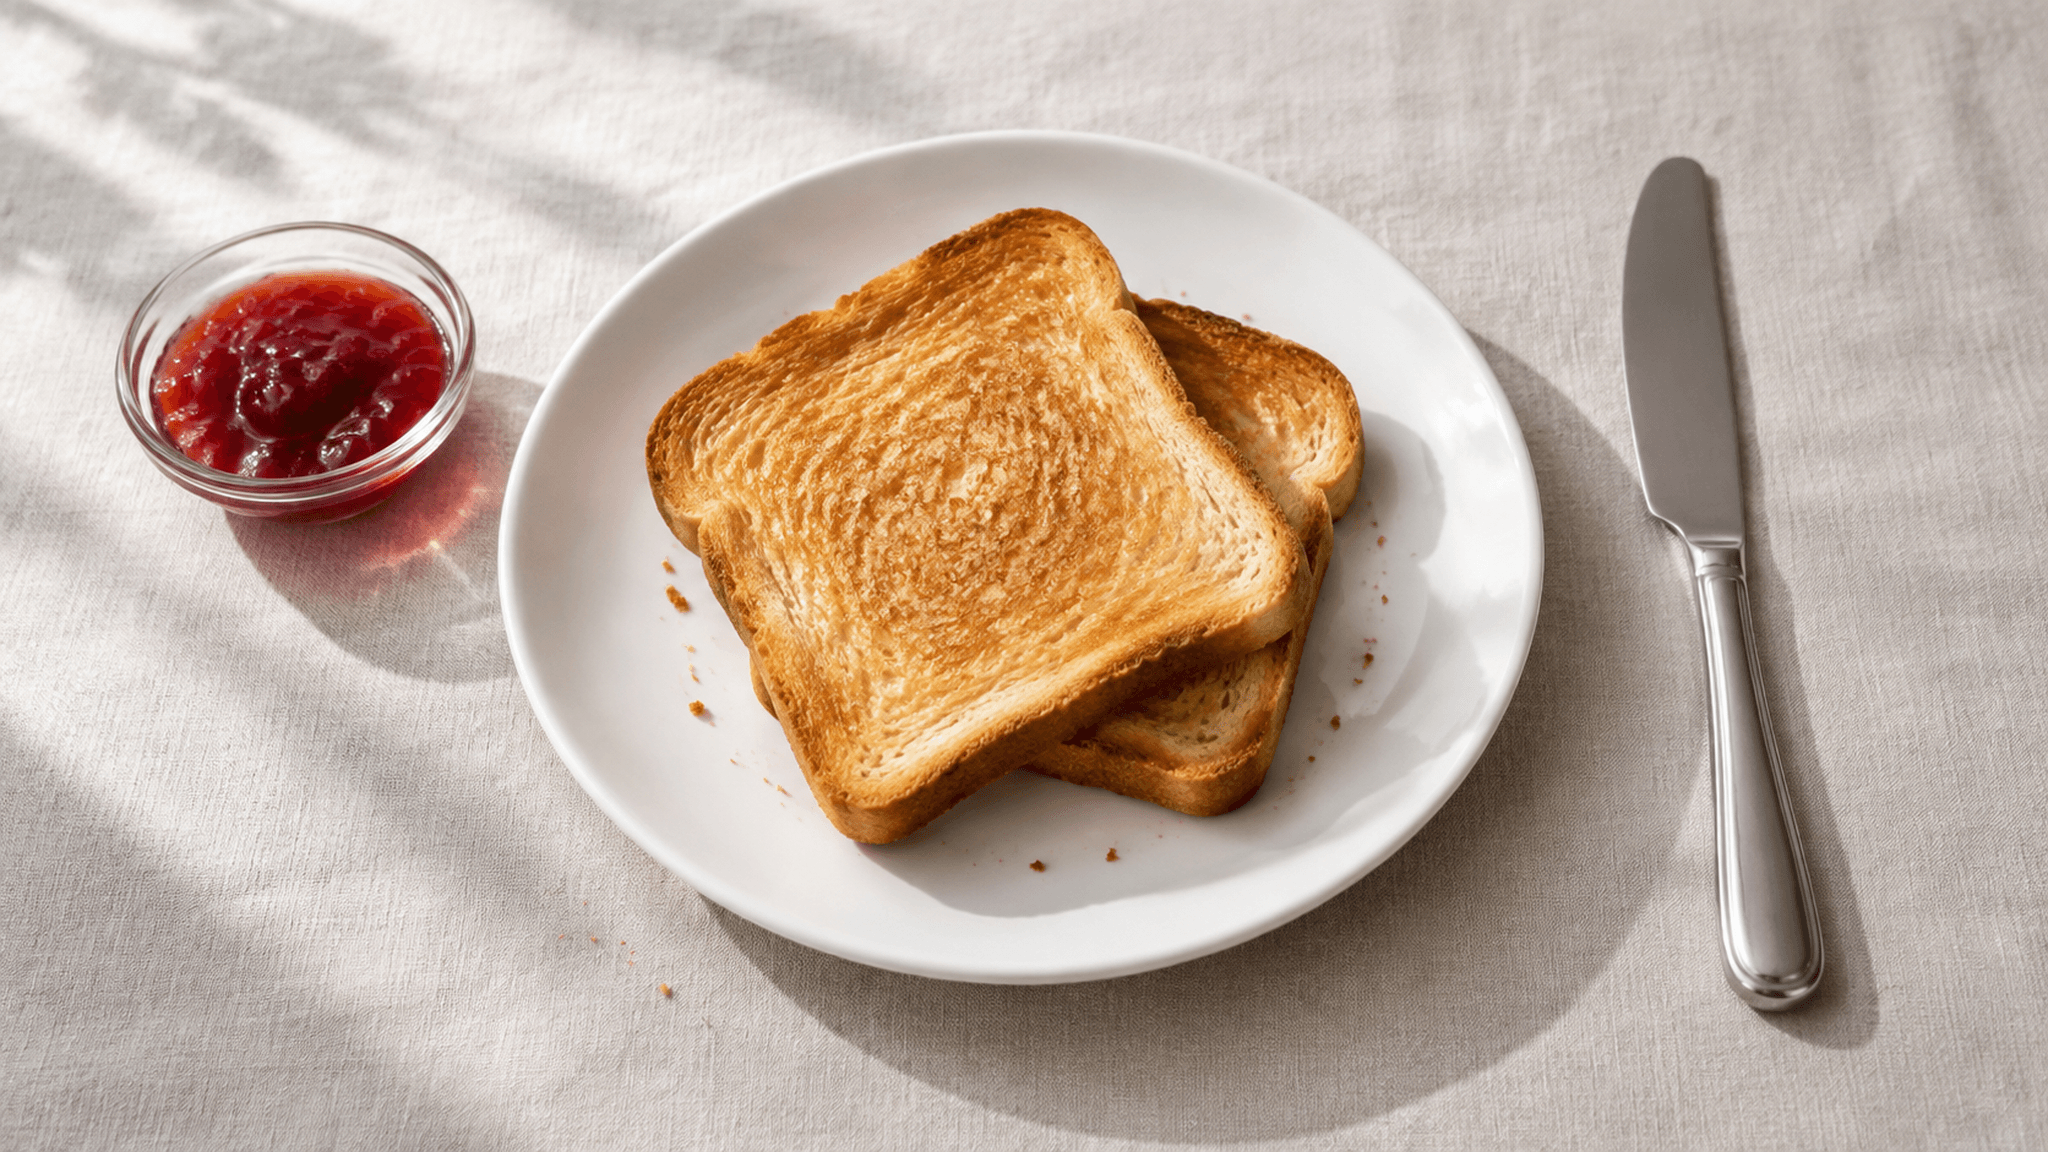
Ontbijtvoorbeeld van beeldgeneratie met controle op objectaantal en mesplaatsing_Het gegenereerde resultaat bevat het gevraagde bord, toast, jambakje en mes aan de rechterkant, gereed voor de plaatsingsbeoordeling hieronder._
Controleer overlappende sneetjes afzonderlijk. Een visueel overtuigend ontbijt kan nog steeds worden afgewezen als er een kopje op de achtergrond verschijnt of het mes op het bord terechtkomt. Als een resultaat wordt afgewezen, herzie dan de dubbelzinnige ruimtelijke instructie, wijzig één variabele en houd de afwijzingsreden vast. Vermijd herhaaldelijk vragen om een algemeen betere afbeelding.
B. Artikelomslag: bruikbare ruimte voor kop. Dit verzoek behandelt compositie als een lay-outafhankelijkheid. De pagina-editor heeft lege ruimte links nodig, terwijl de rechterkant het gereedschap en het potje bevat. Voeg de werkelijke titel later toe met HTML/CSS, zodat deze bewerkbaar en leesbaar blijft.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
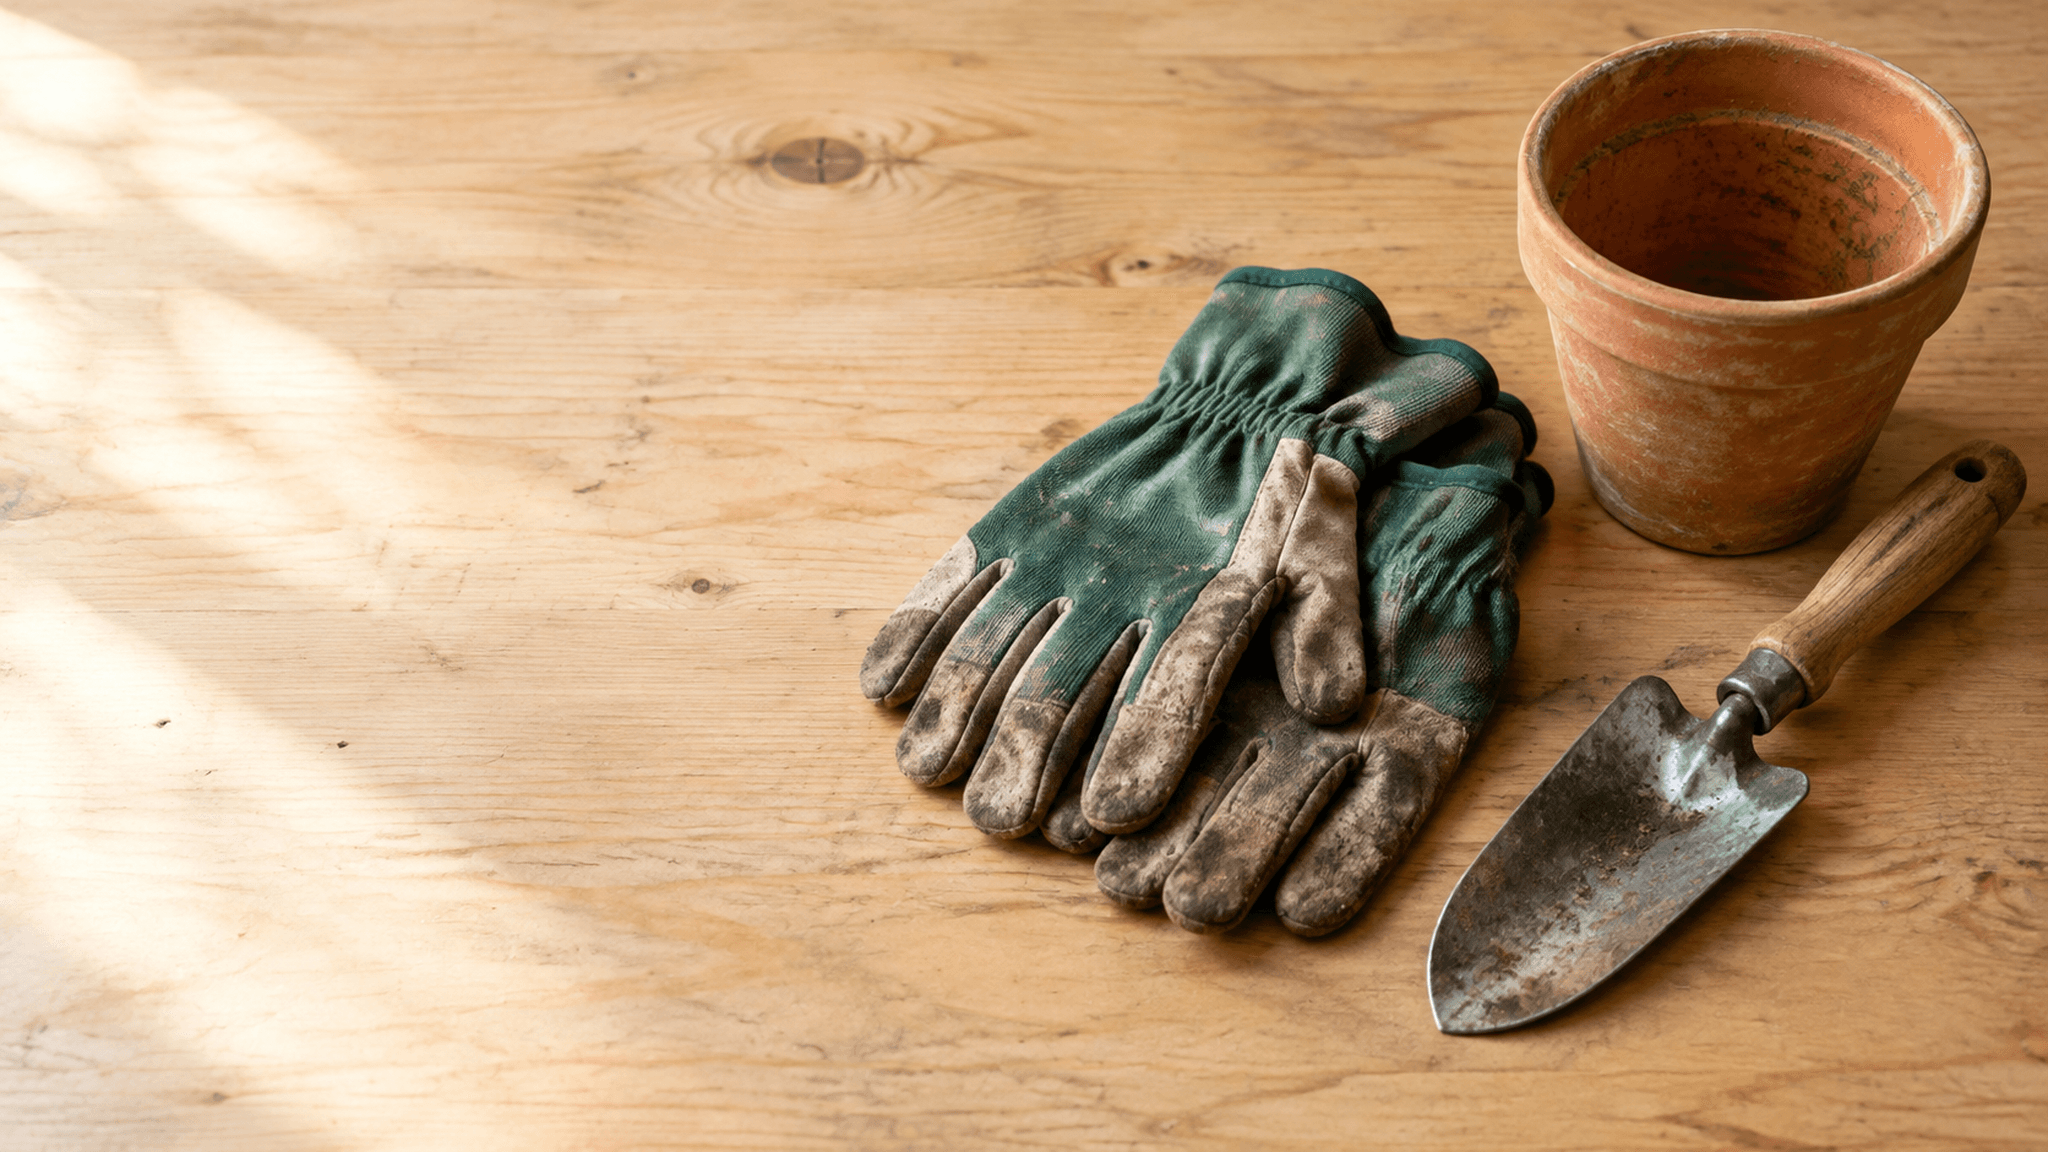 Voorbeeld van werkbankomslag met gevraagde ruimte voor een kop links en objecten rechts
Het resultaat behoudt bruikbare lege ruimte links en houdt de handschoenen, het potje en de troffel rechts.
Controleer het resultaat bij de beoogde publicatie-uitsnede. Een landschapsmaster kan zijn nuttige lege gebied verliezen wanneer een mobiele kaart centraal uitsnijdt. Als de compositie niet voldoet, geef dan strakkere objectgrenzen op of wijzig de uitsnede van de applicatie. Verberg de fout niet door tekst over de gevraagde onderwerpen te plaatsen.
C. Stofillustratie: detail en volgorde. Het volgende verzoek vraagt om 3 gevouwen stofstalen met onderscheidbare zichtbare texturen. Het test aantal, positie en of het resultaat een toelichtende illustratie ondersteunt op het formaat dat lezers zien.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
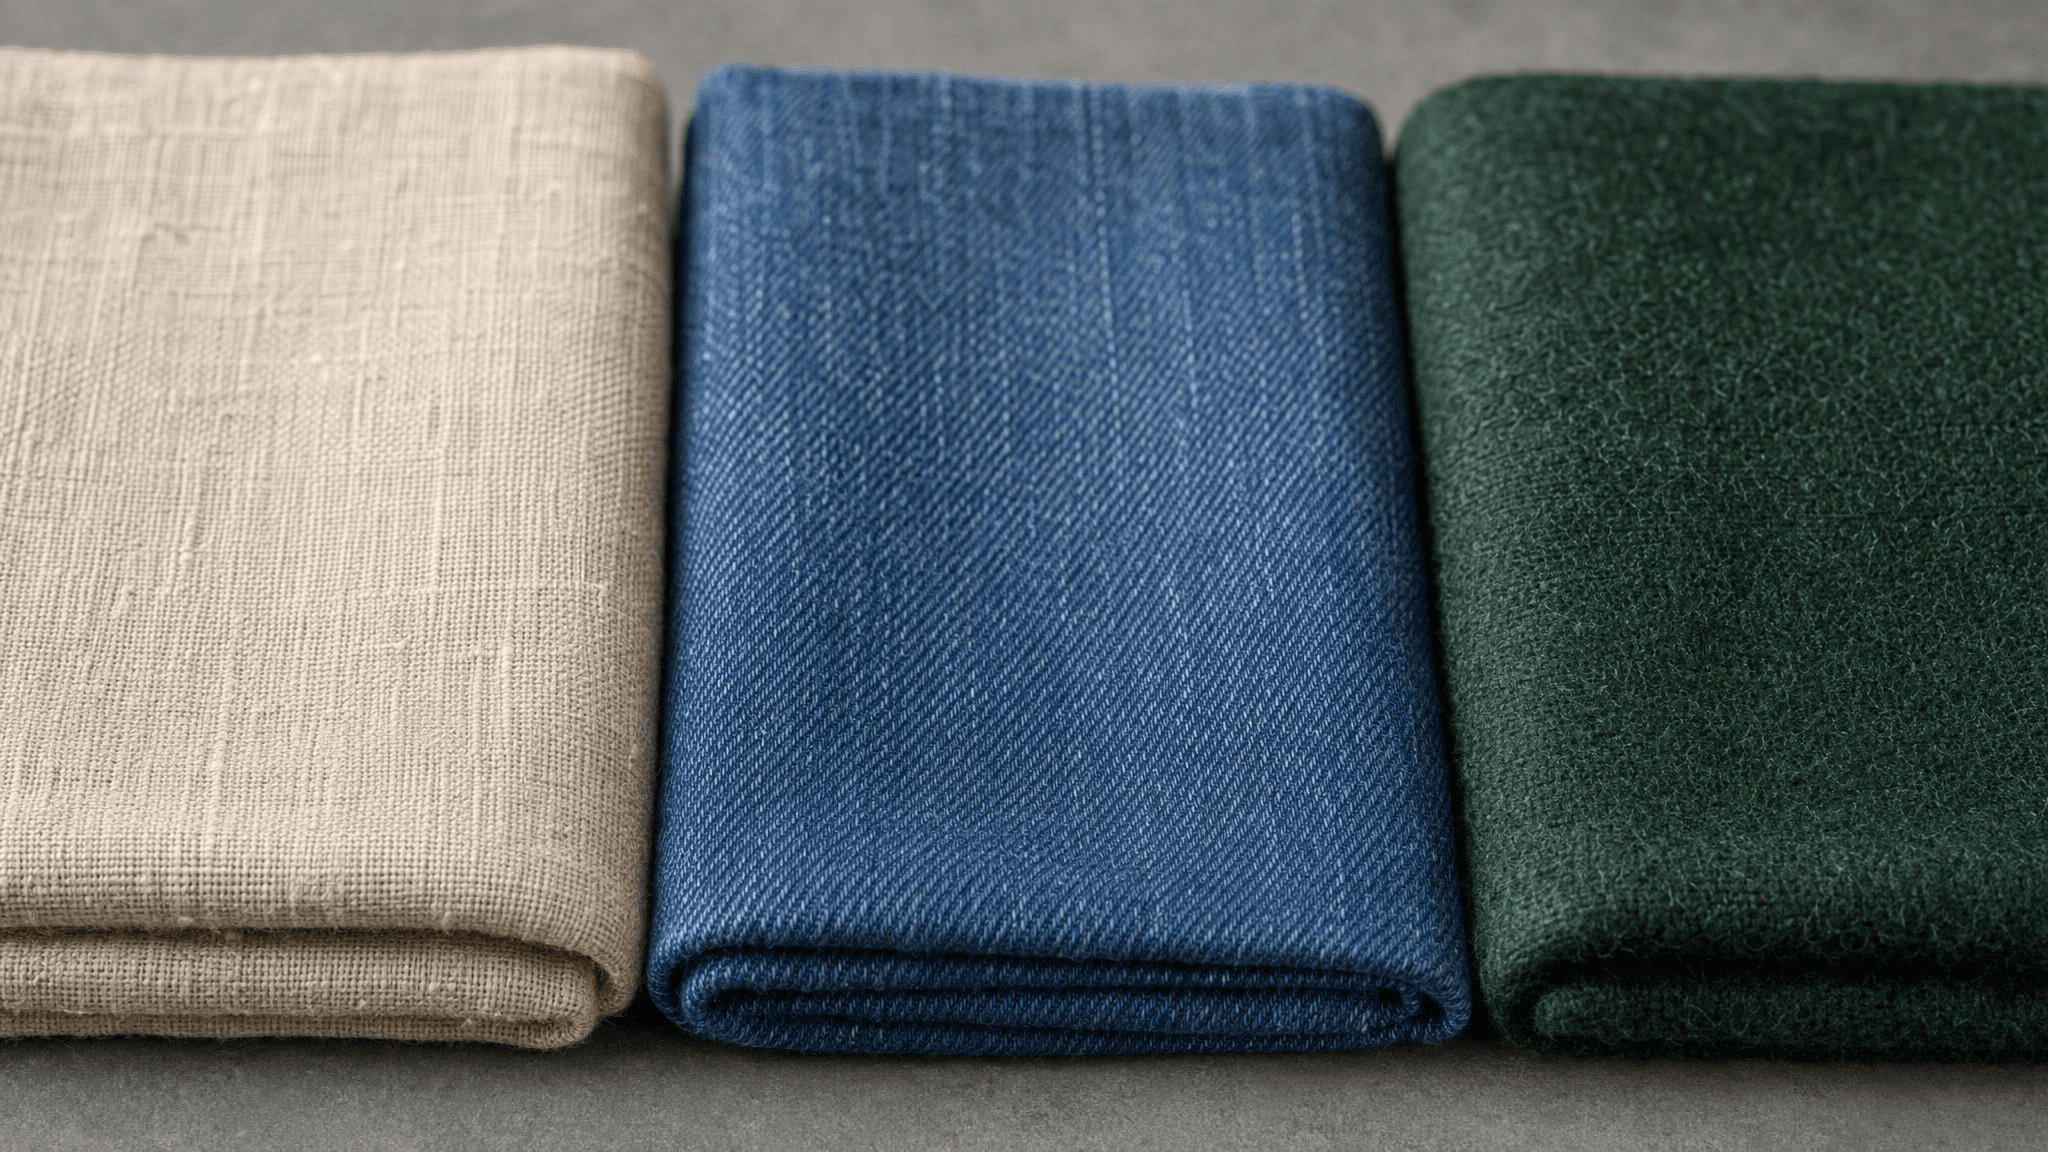 AI-gegenereerde stofillustratie met plaatsingscontroles van beige, blauwe en donkergroene stalen
De drie gevraagde stalen zijn visueel duidelijk te onderscheiden. Deze gegenereerde textuur is een illustratie, geen bewijs van de vezelsamenstelling van een echt product.
Als het middelste staal geen leesbare weving heeft, registreer dat probleem dan en pas de kadrering of de detailinstructie aan. Beschrijf gegenereerde textuur nooit als een gemeten eigenschap van een echt product.
Tekstfuncties hebben vergelijkbaar nauwkeurige controles nodig. Wijzig bij ticketclassificatie labels buiten de toegestane set en houd een onzekere route aan. Vereis bij documentextractie velden en bronfragmenten naast parseerbare JSON. Een syntactisch geldige respons kan nog steeds het verkeerde bedrag in het verkeerde veld plaatsen.
Generatieve AI-API voor ontwikkelaars: omgaan met fouten
Volg transportsucces, taakvoltooiing en zakelijke acceptatie afzonderlijk. Een geslaagde HTTP-respons kan een verwerkende taak bevatten. Een voltooide taak kan een kapotte download opleveren. Een leesbare afbeelding kan de brief schenden. Elk vraagt om een andere herstelactie.
Stel bewust 3 klokken in: een individuele HTTP-timeout, een pollinginterval en een algeheel wachtvenster. De voorbeelden gebruiken een API-verzoektimeout van 30 seconden, polling elke 2 seconden en een pollingvenster van 10 minuten. Dit zijn keuzes van de applicatie, niet de geadverteerde serviceprestaties.
| Symptoom | Mogelijke oorzaak | Controleer vervolgens | Aanpak voor opnieuw proberen |
|---|---|---|---|
| Parameterfout | Niet-ondersteund veld of waarde | Exact eindpuntschema en ingediende payload | Corrigeer eerst het verzoek |
| HTTP 401 | Authenticatieprobleem of verkeerde route | Sleutelconfiguratie en eindpuntpad | Geen ongewijzigde nieuwe poging |
| Onvoldoende saldo | Beschikbaar saldo of tegoed | Facturatiestatus van het account | Los eerst financiering of tegoed op |
| HTTP 429 | Snelheidslimiet bereikt | Gelijktijdigheid en verzoekfrequentie van account/model | Begrensde backoff met jitter |
| Taak meldt failed | Model-, invoer- of beleidsfout | Predictie-ID, foutcode, foutdetails | Onderzoek voordat je opnieuw genereert |
| Pollingtimeout | Clientdeadline of trage taak | Bestaande taakstatus | Hervat het bevragen van hetzelfde ID |
| Voltooid met lege uitvoer | Ontbrekend of onverwacht resultaat | Volledige gestructureerde taakrespons | Markeer voor onderzoek; geen blinde nieuwe inzending |
De huidige foutdocumentatie van het platform zegt dat LLM- en media-eindpunten geen Retry-After-headers of headers met resterende limiet geven. Gebruik een vertragingsbeleid aan de clientzijde; laat herstel niet afhangen van een header die deze routes niet retourneren. Andere API-families kunnen zich anders gedragen.
Houd automatische leesretries begrensd. Exponentiële vertragingen plus een beetje willekeurige jitter helpen voorkomen dat veel workers tegelijk opnieuw proberen. Verlaag de gelijktijdigheid als throttling aanhoudt. Herhaalde fouten moeten een waarneembaar incident worden in plaats van een eindeloze lus die achter een spinner verborgen zit.
Nieuwe pogingen bij inzending verdienen een strengere aanpak. Wanneer een verbinding sluit nadat je de body hebt verzonden, weet je mogelijk niet of de server een taak heeft aangemaakt. Leg een lokale intentie vast vóór inzending en onderzoek verzoekgeschiedenis of supporttraces wanneer er geen predictie-ID binnenkomt. Verzin geen idempotency-header tenzij het eindpunt die documenteert.
Zodra je een ID hebt, gebruik je het om te hervatten. Een downloadfout moet een nieuwe downloadpoging of statuscontrole uitlokken, niet een nieuw verzoek voor beeldgeneratie. De voorbeelden houden automatische retries bewust op polling-leesacties en stoppen bij een mislukte inzending.
Bewaar voor elke taak je applicatietaak-ID, predictie-ID, request-ID's, model, instellingen, tijdstempels en de uiteindelijke afhandeling. Bewaar prompts alleen volgens een passend databeleid. Zet nooit autorisatieheaders of gevoelige gebruikerscontent in algemene foutlogs.
Geef de frontend statussen die deze kan uitleggen: voorbereiden, verwerken, uitvoer controleren, gereed of aandacht nodig. Toon een hervatbare taak wanneer iemand de pagina opnieuw laadt. Schakel herhaald inzenden uit zolang dezelfde lokale taak in behandeling is, maar sta wel een bewust nieuw verzoek toe wanneer dat passend is.
Generatieve AI-API voor ontwikkelaars: werkelijke kosten
Een lage prijs per verzoek zegt niets over de kosten van een bruikbare functie. Je budget heeft het in rekening gebrachte bedrag nodig, het aantal geaccepteerde outputs en het ondersteunende werk dat nodig is om ze op te leveren.
Tekst-API's maken gewoonlijk onderscheid tussen invoer- en uitvoertokens. Lange context, opgehaalde passages, gespreksgeschiedenis en herhaalde antwoorden kunnen allemaal bijdragen aan het gebruik. Registreer de categorieën die het gekozen eindpunt daadwerkelijk factureert, in plaats van één tokenschatting op elke werklast toe te passen.
Inspecteer voor afbeeldingen de facturatie-eenheid en configuratie van het exacte model. Formaat en kwaliteit kunnen de facturatie per model anders beïnvloeden. Bij video kunnen duur, resolutie en modelkeuze de kosten veranderen. Maak van de vanaf-prijs in een catalogus geen offerte voor een specifieke configuratie.
De exacte prijs voor het geselecteerde beeldmodel bij hoge kwaliteit en 2048 × 1152 is tijdens het onderzoek voor dit artikel niet geverifieerd op zowel de catalogus- als de detailpagina. Er wordt hier geen actuele stukprijs of korting beweerd. Bevestig deze voordat je een betaalde productie-evaluatie uitvoert.
Gebruik 2 gerelateerde berekeningen:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Houd de observatieperiode consistent. Geef voor doorlopende opslag aan of de berekening de eerste maand, een bepaalde bewaartermijn of een toegerekende terugkerende kost dekt. Vermijd het vergelijken van het alleen-inferentiecijfer van het ene model met de volledig belaste kosten van een andere workflow.
Hypothetisch voorbeeld: je dient 100 verzoeken in en accepteert 80 outputs. Deel de werkelijke totale kosten voor die batch door 80. Als voor alle 100 verzoeken hetzelfde bedrag c in rekening werd gebracht, zouden de API-kosten per geaccepteerde output 1.25c zijn. Die voorwaarde is belangrijk: er wordt niet aangenomen dat elk mislukt verzoek wordt gefactureerd.
| Model | Instellingen | Inzendingen | Werkelijke kosten | Geaccepteerde outputs | API-kosten per geaccepteerde output | Meetdatum |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | Nog vast te leggen | Nog vast te leggen | Nog vast te leggen | Nog te berekenen | Nog vast te leggen |
| Zelfde model, volgende evaluatiebatch | Leg exacte instellingen vast | Nog vast te leggen | Nog vast te leggen | Nog vast te leggen | Nog te berekenen | Nog vast te leggen |
Gebruik dit als een werkblad, niet als een resultatentabel. De beelddemonstraties leveren geen representatief acceptatiepercentage of productiekosten op. Houd playground-quotes gescheiden van definitieve facturatieregistraties, zeker bij evaluatie in een testomgeving.
Wanneer het aantal geaccepteerde outputs nul is, rapporteer de batch dan als mislukt en toon de totale besteding. Een kosten-per-geaccepteerde-outputverhouding is in dat geval ongedefinieerd. Het verbergen van mislukte batches zou je budget beter laten lijken dan de applicatie presteert.
Beperk verspilling eerst: valideer invoer vóór inzending, bewaar taak-ID's, voorkom onbedoelde duplicaten en hergebruik geaccepteerde assets wanneer het product dat toestaat. Vergelijk daarna goedkopere instellingen met dezelfde brieven en controles. Een instelling die de prijsopgave verlaagt maar het afwijzingswerk verdubbelt, kan de kosten van de functie verhogen.
Test de uitvoer, niet alleen de respons
Schrijf acceptatiecriteria terwijl je de prompt opstelt. Zo voorkom je dat een overtuigende afbeelding je definitie van succes achteraf verandert. Houd harde vereisten gescheiden van optionele voorkeuren en leg vast waarom een beoordelaar een resultaat heeft afgewezen.
Automatiseer de controles met duidelijke mechanische antwoorden: geslaagde download, decodering van het bestand, formaat, afmetingen en limieten voor bestandsgrootte. Valideer voor JSON het schema, de vereiste velden, toegestane labels en typen. Een ontbrekend vereist veld mag niet stilletjes een verzonnen standaardwaarde worden.
Gebruik menselijke beoordeling voor vereisten die interpretatie nodig hebben. In het ontbijtvoorbeeld moet een beoordelaar overlappende sneetjes onderscheiden, het mes identificeren, de positie beoordelen en op extra objecten letten. Een geautomatiseerde visuele controle kan ondersteunen, maar evalueer de fouten ervan voordat je die zelfstandig resultaten laat goedkeuren.
De ontbijtbeoordeling moet de volgende onafhankelijke controles bevatten:
- Precies 2 sneetjes toast, 1 wit bord, 1 doorzichtig jambakje en 1 mes.
- Mes rechts van het bord; vereiste objecten volledig in beeld.
- Geen extra kopjes, borden, handen, verpakkingen of zichtbare branding.
- Leesbare PNG op de gevraagde afmetingen.
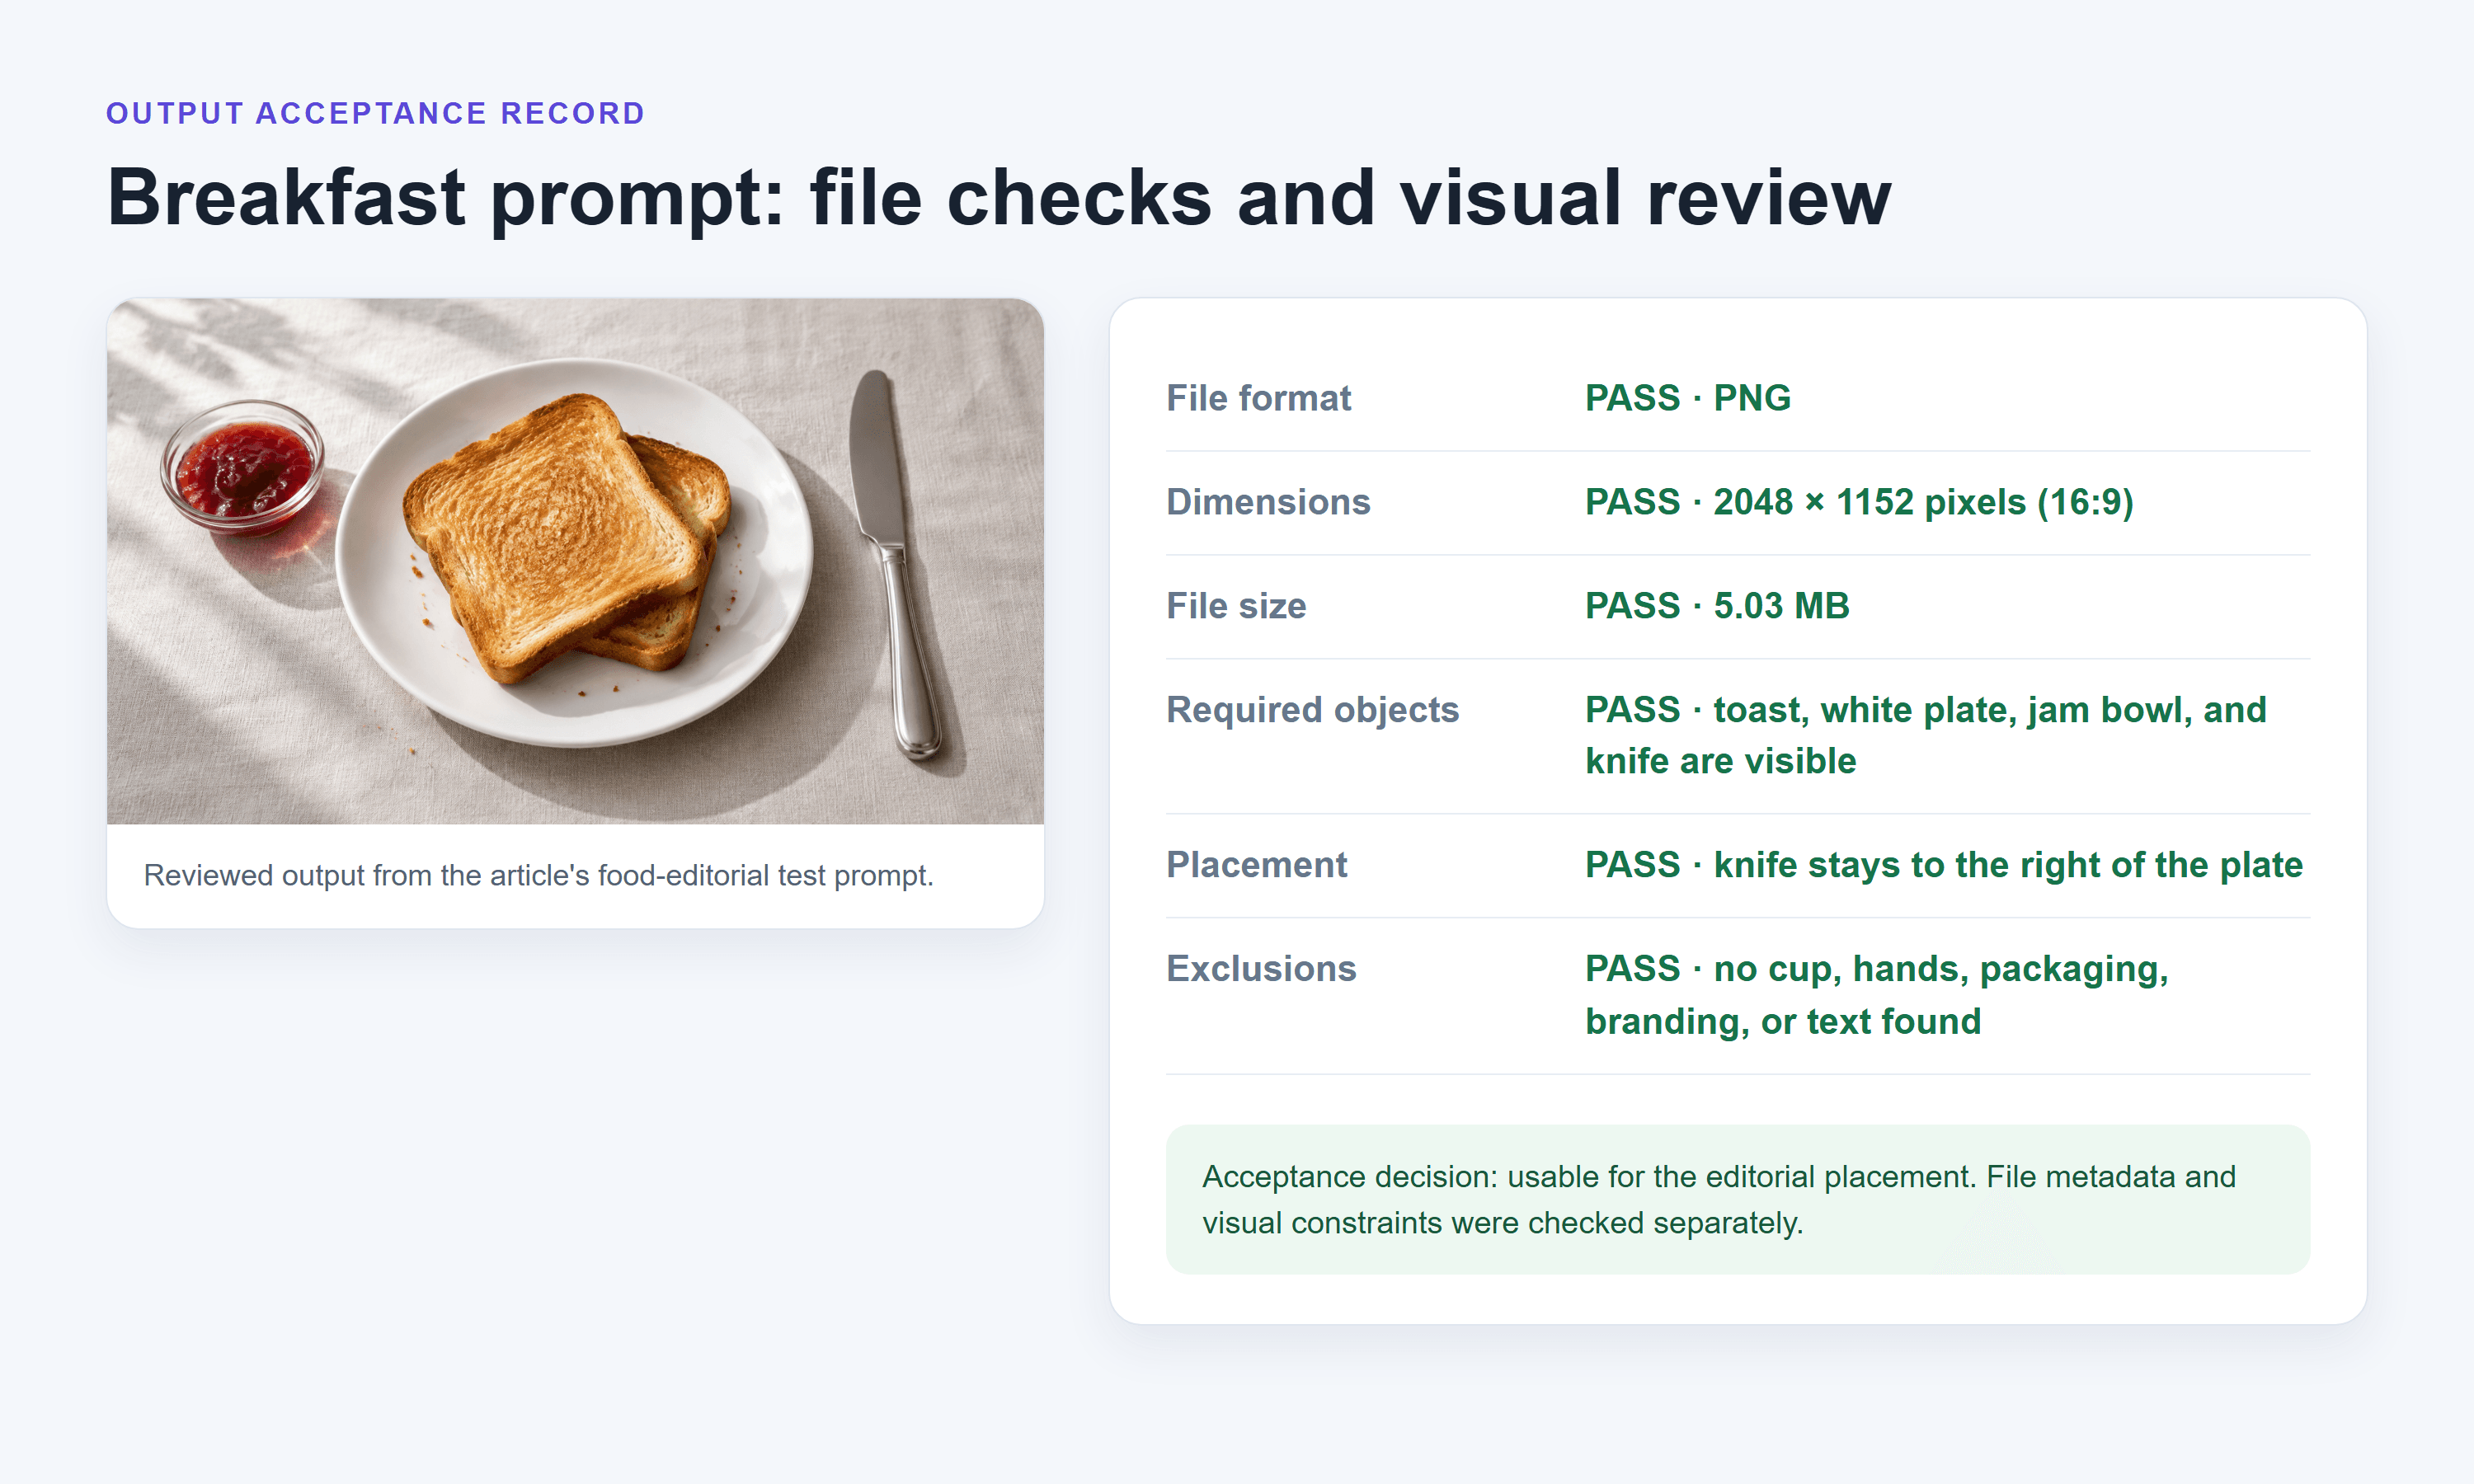 Validatieregistratie die controles van bestandsmetadata scheidt van visuele acceptatiecontroles
De registratie rapporteert de werkelijke afmetingen en grootte van het gegenereerde bestand apart van de visuele acceptatiecontroles.
Bouw een vaste regressieset op basis van de werkelijke functie: gewone verzoeken, drukke composities, tegenstrijdige instructies, lastige uitsnedes en relevante invoerlimieten. Versioneer de brieven en beoordelaarsregels. Herhaal ze bij het wijzigen van het model, de promptsjabloon of de uitvoerinstellingen.
Rapporteer technisch succes en het percentage geaccepteerde outputs afzonderlijk. Een leesbaar bestand met een extra object telt als een geslaagde oplevering én als een afwijzing van de content. Die uitkomsten samenvoegen tot één succescijfer verbergt wat je team moet oplossen.
Uit de ontwikkelaarsenquête van 2025 bleek 46% de nauwkeurigheid van AI-tools niet te vertrouwen en 33% die wel te vertrouwen; 3% meldde veel vertrouwen. Deze antwoorden gaan over AI-tools in ontwikkelworkflows, niet over een gemeten faalpercentage voor generatie-API's. (Stack Overflow Developer Survey, 2025.)
Evenzo kunnen 3 illustratieve runs geen algehele nauwkeurigheid of een bruikbare p95-latentie vaststellen. Verzamel een grotere, relevante steekproef over de omstandigheden die je in productie verwacht, en behoud uitschieters. Gebruik de demonstraties om de controles te ontwikkelen en gebruik systematische evaluatie om een released beslissing te nemen.
Een productiechecklist voordat je uitrolt
Het eerste werkende verzoek beslecht slechts een klein deel van de released beslissing. Je applicatie moet ook uitgaven beperken, onafgerond werk herstellen en uitleggen wat er is gebeurd wanneer er geen resultaat beschikbaar is.
Bescherm toegang. Houd inloggegevens op de backend, scheid omgevingen, beperk de toegang tot taakregistraties en plan sleutelrotatie. Autoriseer elk status- en downloadverzoek tegen de gebruiker die eigenaar is van die taak. Een niet te raden taak-ID vervangt geen machtigingscontroles.
Begrens invoer en resourcegebruik. Valideer promptlengte, uploadtype en -grootte, gevraagde uitvoerinstellingen en ondersteunde combinaties. Dwing voor gedownloade media toegestane bestemmingen, redirects, bytelimieten en decoderingslimieten af. De compacte scripts hierboven illustreren de levenscyclus; het zijn geen geharde openbare downloadservices.
Stel budgetten in vóór inzending. Definieer limieten per gebruiker en per taak, het maximum aantal gelijktijdige taken en wie duurdere instellingen mag aanvragen. Reserveer budget zolang werk in behandeling is, zodat gelijktijdige verzoeken niet allemaal dezelfde controle op resterend saldo kunnen passeren.
Bewaar status persistent. Schrijf de lokale taak voordat je de provider aanroept. Sla het geretourneerde predictie-ID onmiddellijk op en maak polling hervatbaar na een herstart van het proces. Als de inzendingsstatus onbekend is, gebruik dan een onderzoeksstatus in plaats van gebruikers te vertellen dat de taak zeker is mislukt.
Beheer het opgeleverde asset. Bepaal waar geaccepteerde bestanden staan, wie er toegang toe heeft en wanneer ze verlopen. Verifieer de levensduur van providerlinks en bewaartermijnen in plaats van oneindig afhankelijk te zijn van een tijdelijke uitvoer-URL. Neem het verwijderen van afgeleide bestanden op in de dataworkflow van de applicatie.
Maak falen begrijpelijk. Maak onderscheid tussen een vertraagde taak, een afgewezen resultaat en een servicefout. Bied een duidelijke route om bewust opnieuw te proberen of beoordeling aan te vragen. Bewaar de brief van de gebruiker, zodat herstel niet betekent dat het werk opnieuw moet worden opgebouwd.
Monitor wijzigingen. Volg voltooiing, acceptatie, kosten en wachttijd afzonderlijk. Voer de regressieset opnieuw uit na wijzigingen in model of parameters en houd de vorige configuratie beschikbaar waar dat haalbaar is. Redigeer gevoelige logs en wijs bewaartermijnen toe aan zowel content als operationele registraties.
Begin voor het evalueren van het voorbeeldplatform voor je eigen applicatie met de Atlas Cloud modelcatalogus en lees daarna de documentatie van het geselecteerde eindpunt en de predicties. Kies één taak, definieer acceptatie en leg vast wat de evaluatie daadwerkelijk oplevert voordat je de toegang uitbreidt.
Veelgestelde vragen
Welke generatieve AI-API moet ik kiezen voor mijn applicatie?
Kies op basis van de invoer, uitvoer, aanvaardbare wachttijd en beoordelingsvereisten van de functie. Voer dezelfde representatieve brieven uit tegen de kandidaten die je juridisch en operationeel mag gebruiken. Vergelijk kosten per geaccepteerde output en integratiewerk naast de capaciteiten. Deze 3 beeldvoorbeelden stellen geen universele keuze vast.
Zijn er gratis generatieve AI-API's voor ontwikkelaars?
Sommige services bieden proefversies of beperkt gratis gebruik, maar beschikbaarheid, geschiktheid, quota en toegestane gebruikswijzen veranderen. Verifieer de actuele voorwaarden voor het exacte eindpunt. Een gratis tegoed voor consumententools omvat niet noodzakelijk API-toegang. Zelf hosten kost ook hardware, elektriciteit en engineeringtijd, zelfs wanneer modelgewichten downloadbaar zijn.
Heb ik machine learning-ervaring nodig om een generatieve AI-API te gebruiken?
Je kunt beginnen met HTTP, JSON, authenticatie en gewone backend-ontwikkelvaardigheden. Het opleveren van een betrouwbare functie vereist daarnaast evaluatie- en operationeel werk. Je moet de beperkingen van het model goed genoeg begrijpen om acceptabele uitvoer te definiëren, zonder zelf per se een model te trainen.
Kan één API tekst, afbeeldingen en video verwerken?
Een platform kan alle 3 bieden, maar elke capaciteit kan andere eindpunten, parameters, uitvoertypen en wachtpatronen gebruiken. Verifieer elke interface afzonderlijk. Een gedeeld account of gedeelde inloggegevens maken een tekst-requestbody niet compatibel met een beeld- of videomodel.
Waarom retourneert mijn beeldverzoek een taak-ID in plaats van een afbeelding?
Het eindpunt dient werk asynchroon in. Bewaar het ID en bevraag de gedocumenteerde statusroute. Haal het bestand op wanneer de taak is voltooid en valideer het daarna. Als je client stopt met wachten, kan de taak aan de serverzijde nog steeds draaien; hervat die taak voordat je een nieuwe indient.
Hoe kan ik API-kosten verlagen zonder de workflow te verstoren?
Voorkom dubbele inzendingen, valideer invoer vroeg, hergebruik geaccepteerde assets waar passend en test goedkopere configuraties tegen ongewijzigde acceptatiecriteria. Meet werkelijke kosten per geaccepteerd resultaat. Een generatieve AI-API voor ontwikkelaars verdient zijn plek wanneer de omliggende applicatie bruikbaar werk kan opleveren tegen kosten die je kunt dragen.


