Een cursusavatar die alleen zijn mond beweegt, kan de aandacht voor één zin vasthouden en daarna de les verliezen. OmniHuman 2.0 AI-video's voor cursusinstructeurs bieden je een manier om zichtbare expressie, doelgerichte gebaren en cameravoering rond een opgenomen uitleg te plannen. Het kleurcontrastvoorbeeld hieronder toont een complete instructeursscène van 30 seconden en, net zo nuttig, een probleem met rekwisietcontinuïteit dat je moet oppikken voordat je een les publiceert.
Belangrijkste punten
- De kerninvoer is een afbeelding van de instructeur en audio; een tekstprompt kan de performance of cameravoering sturen.
- Zie OmniHuman 2.0 als de presentatorvideofase. Jij blijft eigenaar van de les, dia's, schermopnames, feitencontroles en montages.
- Het kleurcontrastvoorbeeld van 30 seconden toont nuttige gebaren en wisselingen van gezichtspunt, plus een verdwijnende kaart die redactionele beoordeling nodig heeft.
- Controleer lipsynchronisatie, expressie, gebaren, beeldstabiliteit en rechten voordat je publiceert.
- Atlas Cloud vermeldt $0.07 per seconde en toont een gereduceerd tarief van $0.056; bevestig het huidige tarief voordat je genereert.
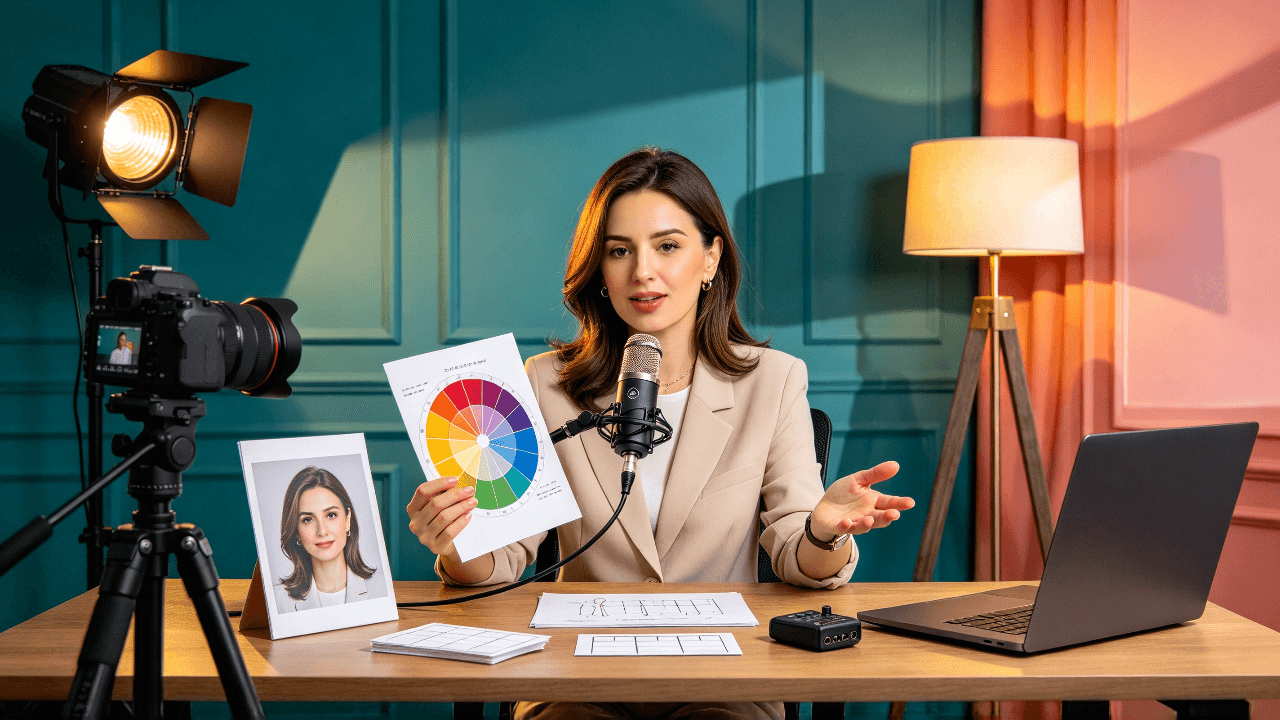
Illustratieve voorbereidingsscène: een referentieportret, een voice-overopname en lesmateriaal zijn de invoer die je plant voordat je een presentatorvideo maakt.
Wat OmniHuman 2.0 doet voor video's van cursusinstructeurs
OmniHuman 2.0 verandert een referentieafbeelding en een audiotrack in een 720p-video van het afgebeelde personage dat spreekt of zingt. Atlas Cloud modeldirectory beschrijft optionele tekststuring, dynamische gebaren, scènes met meerdere personen, camerabeweging en clips tot vijf minuten. Dit zijn vermelde mogelijkheden, geen garantie dat elke cursusprompt een geschikte take oplevert.
(Avatar Omni Human 2.0-modeldetails)
De taakverdeling is belangrijk. Jij levert de instructie-inhoud en de stemopname. Het model genereert de zichtbare performance. Jij bepaalt waar een presentator helpt en waar een diagram, dia, software-opname of close-updemonstratie de stof beter uitlegt.
| Productie-element | Wat je voorbereidt of doet | Wat het model bijdraagt | Wat je controleert |
|---|---|---|---|
| Instructeursafbeelding | Een duidelijke, toegestane portretfoto | De zichtbare identiteitsreferentie | Consistentie van gezicht, kleding en achtergrond |
| Lesvoice-over | Een gecontroleerde opname met bewust tempo | Audiogestuurde spreekperformance | Timing, uitspraak en pauzes |
| Sturing | Een beknopte aanwijzing over kadering en voordracht | Promptgestuurde performance en cameravoering | Of beweging de les ondersteunt |
| Lesvisuals | Dia's, schermopnamen, diagrammen of voorbeelden | Geen vervanging voor dit materiaal | Of elk concept gemakkelijk te volgen is |
| Definitieve les | Montage, ondertitels en kwaliteitscontrole | Een gegenereerd videosegment | Nauwkeurigheid, toegankelijkheid en rechten |
Een vroeg onderzoekspaper over OmniHuman beschrijft audio-geconditioneerde menselijke animatie, maar het gaat over OmniHuman-1 en mag niet worden gezien als een performancetest van versie 2.0. Voor een beslissing over cursusproductie vertrouw je op de huidige modellijst voor de vermelde invoer en uitvoerlimieten, en beoordeel je daarna een voorbeeld dat met je eigen materialen is gemaakt. (OmniHuman-1 paper)
Wat je moet voorbereiden voordat je een AI-instructeursvideo genereert
Een overtuigend voorbeeld hangt van meer af dan het uploaden van zomaar een portret en zomaar een opname. Kies materiaal waarmee je gemakkelijk kunt beoordelen of het resultaat bij een echte les past.
Kies een duidelijke instructeursafbeelding waarvoor toestemming is verleend
Gebruik een frontaal of licht gedraaid portret met een duidelijk zichtbaar gezicht, schouders in beeld en een rustige achtergrond. Vermijd een klein gezicht, sterke occlusie, dramatische schaduwen of een uitsnede die geen ruimte laat voor natuurlijke hoofdbewegingen. Als je dezelfde presentator in meerdere modules wilt, bewaar dan een kopie van de goedgekeurde bronafbeelding en gebruik die consistent opnieuw.
Gebruik je eigen afbeelding of bevestig dat de persoon toestemming heeft gegeven voor het beoogde gebruik in synthetische video. Dat een portret online beschikbaar is, betekent niet dat je het mag animeren of publiceren.
Neem lesaudio op die natuurlijk klinkt voor de camera
Neem één samenhangend onderwijspunt op in een rustig tempo. Een korte alinea is gemakkelijker te beoordelen en te herzien dan een hele lezing. Controleer voor het opnemen de terminologie, namen, cijfers en de feitelijke claims van de les. Laat natuurlijke pauzes tussen ideeën, maar knip lange gaten en achtergrondruis weg die de timing moeilijker te beoordelen maken.
Luister één keer met de lestekst voor je. Als een cijfer of technische term onduidelijk is in de opname, herstel dan eerst de bronaudio. Een gegenereerd gezicht kan een onjuiste uitleg of een dubbelzinnige uitspraak niet repareren.
Houd de les nuttig zonder de avatar
Schrijf de uitleg zo dat die begrijpelijk blijft in combinatie met een dia of schermopname. Gebruik de presentator voor context, overgangen en korte uitleg. Gebruik een schermopname voor een softwareactie, een gelabeld diagram voor een proces en een uitgewerkt voorbeeld voor een berekening. Monteer die elementen vervolgens samen in je cursuseditor.
Bereid een voorbeeldpakket voor met het portret, één volledige voice-over, een stuurprompt en de ondersteunende dia of schermopname die je verwacht te gebruiken. Dat geeft je een praktische test van de productieketen in plaats van een geïsoleerde gezichtsanimatie.
Hoe je een OmniHuman 2.0-video van een cursusinstructeur maakt
Het doel van de eerste generatieopdracht is een beslissing: helpt deze combinatie van presentator en audio deze les? Houd de test beperkt, zodat een zwak resultaat gemakkelijk te diagnosticeren is.
Begin met één kort lesfragment
Kies een complete gedachte die een concept introduceert, één voorbeeld geeft en eindigt met een duidelijke volgende stap. Hak geen zin in tweeën om een doeltijd te halen. Het meegeleverde voorbeeld hieronder duurt 30 seconden, lang genoeg om een zichtbare actie en een gewijzigd camerastandpunt te tonen. Controleer de daadwerkelijk ondersteunde audioduur en de huidige invoerregels in de live modelinterface voordat je uploadt.
Upload de afbeelding en voice-over en regisseer vervolgens de performance
Open de Avatar Omni Human 2.0-playground om de huidige invoer te bekijken. Bereid de afbeelding en voice-over zelf voor; de modellijst beschrijft beeld-en-audio-naar-video, niet een tekst-naar-spraakworkflow. Als je de stem nog niet hebt opgenomen, maak en beoordeel die dan in je favoriete audioworkflow voordat je deze stap uitvoert.
Voor deze workflow bepalen de aangeleverde audio de gesproken woorden en het tempo. De tekstprompt stuurt zichtbare acties, expressies en camerabewegingen aan. Beoordeel je eigen gegenereerde resultaat voordat je een geplande beweging als een geslaagde output beschrijft. Atlas Cloud vermeldt 720p-uitvoer en clips tot vijf minuten, maar de live bediening en de voltooide taak zijn de definitieve controle voor je eigen run.
Beoordeel de clip voordat je een volledige les maakt
Bekijk het resultaat één keer met geluid en daarna nog eens terwijl je de lestekst volgt. Noteer het exacte moment waarop een mondbeweging, pauze of gebaar afleidend voelt. Als het probleem bij een bepaalde zin optreedt, verkort of neem die zin opnieuw op en genereer alleen een herzien segment. Als het gezicht overtuigend blijft maar de uitleg diagrammen nodig heeft, behoud dan de presentatoropname en voeg die visuals in de montage toe.
Pas nadat één segment de beoordeling heeft doorstaan, moet je het goedgekeurde portret, de opnamestijl en de promptstructuur hergebruiken voor het volgende lesonderdeel. Consistentie komt voort uit een herhaalbaar invoerproces; het betekent niet dat elk gegenereerd segment identiek zal zijn.
Uitgewerkt voorbeeld: een les over kleurcontrast van 30 seconden
De les heeft één visuele taak: leerlingen laten zien hoe een felle koraal-en-tealcombinatie verandert wanneer een zachter geel in de compositie komt. Een meegeleverde instructeursafbeelding, twee frames uit de voltooide video en de volledige clip laten je de daadwerkelijke onderwijsactie inspecteren in plaats van die uit een prompt af te leiden. Het voorbeeld illustreert scèneontwerp en redactionele beoordeling; test de hierboven beschreven workflow met je eigen goedgekeurde afbeelding en audio voordat je een conclusie over de output trekt.
Begin met een compositie die het lesgeven ondersteunt
De invoerafbeelding heeft een duidelijk gezicht en zichtbare handen, met drie matte kaarten op de werktafel. Koraal, teal en geel zijn allemaal aanwezig voordat er beweging begint. De teal boog van de studio, het koraal paneel en het amberkleurige glas creëren een kleurrijke setting terwijl de kaarten gemakkelijk te onderscheiden blijven.
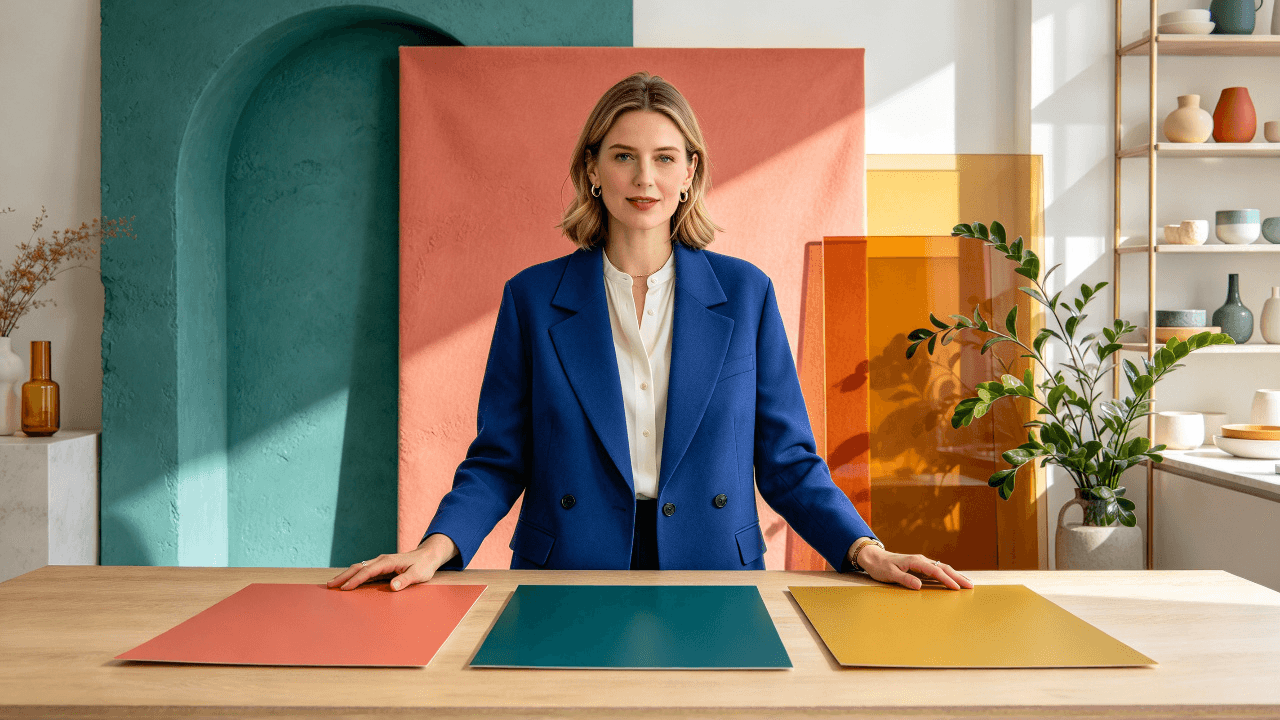
De meegeleverde referentieafbeelding laat het gezicht, de handen en drie didactische rekwisieten van de instructeur duidelijk zichtbaar voordat de animatie begint.
De eerste vergelijking is leesbaar
Vroeg in de clip richt de instructeur haar aandacht op de werktafel en legt ze een hand bij de grens tussen koraal en teal. De camera is dichterbij gekomen dan in het referentiebeeld, maar haar gezicht en de drie oorspronkelijke kleuren blijven zichtbaar. Dit frame toont de actie die de leerling moet volgen: vergelijk twee aangrenzende kleuren voordat je de opstelling verandert.
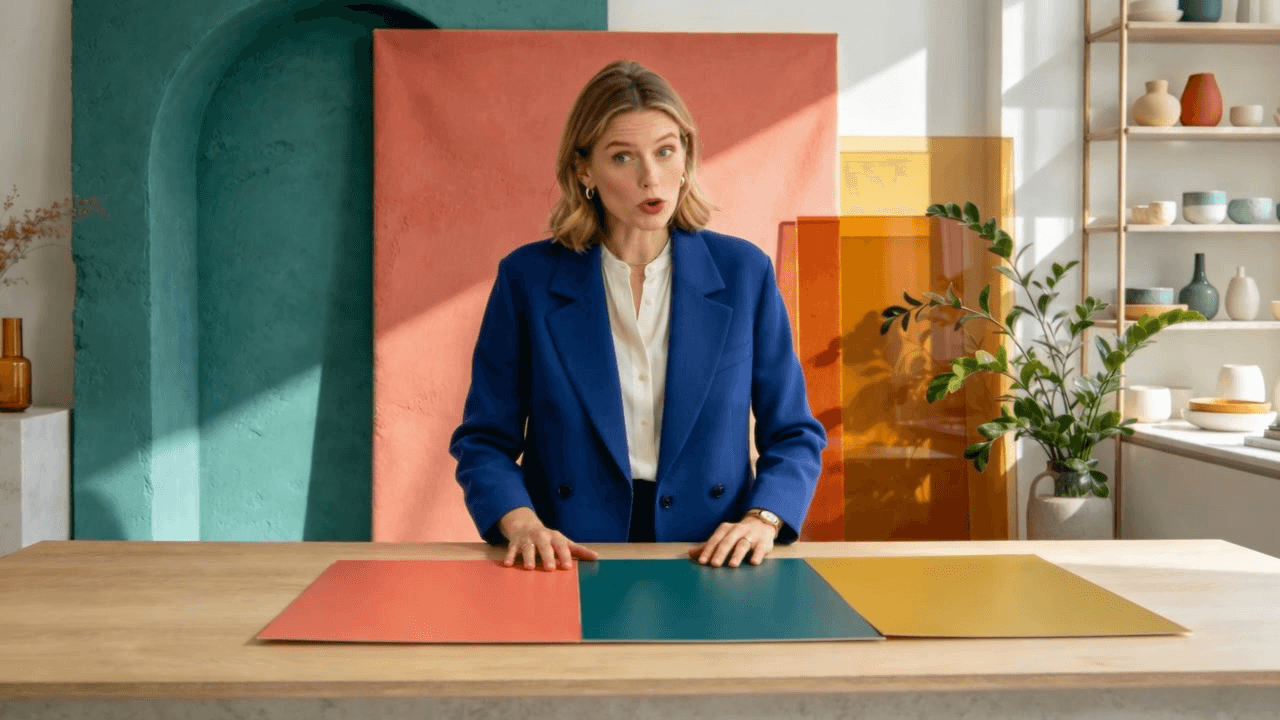
Een echt frame uit de meegeleverde video: de instructeur richt de aandacht op de koraal-tealrand terwijl alle drie de kaarten nog zichtbaar zijn.
Het gewijzigde gezichtspunt onthult een continuïteitsprobleem
Later verschuift het gezichtspunt naar de andere kant van de tafel en gebaart de instructeur naar geel. De teal kaart is niet meer zichtbaar. Dat wijkt af van de geplande opstelling met drie kaarten, waarbij geel tussen koraal en teal zou staan. De dichterbij genomen opname en expressie geven de scène variatie, maar de ontbrekende kaart verandert het lesvoorbeeld. Als dit een definitieve cursusles was, zou de rekwisietwijziging een nieuwe take of een montage nodig hebben die de beoogde vergelijking accuraat maakt.
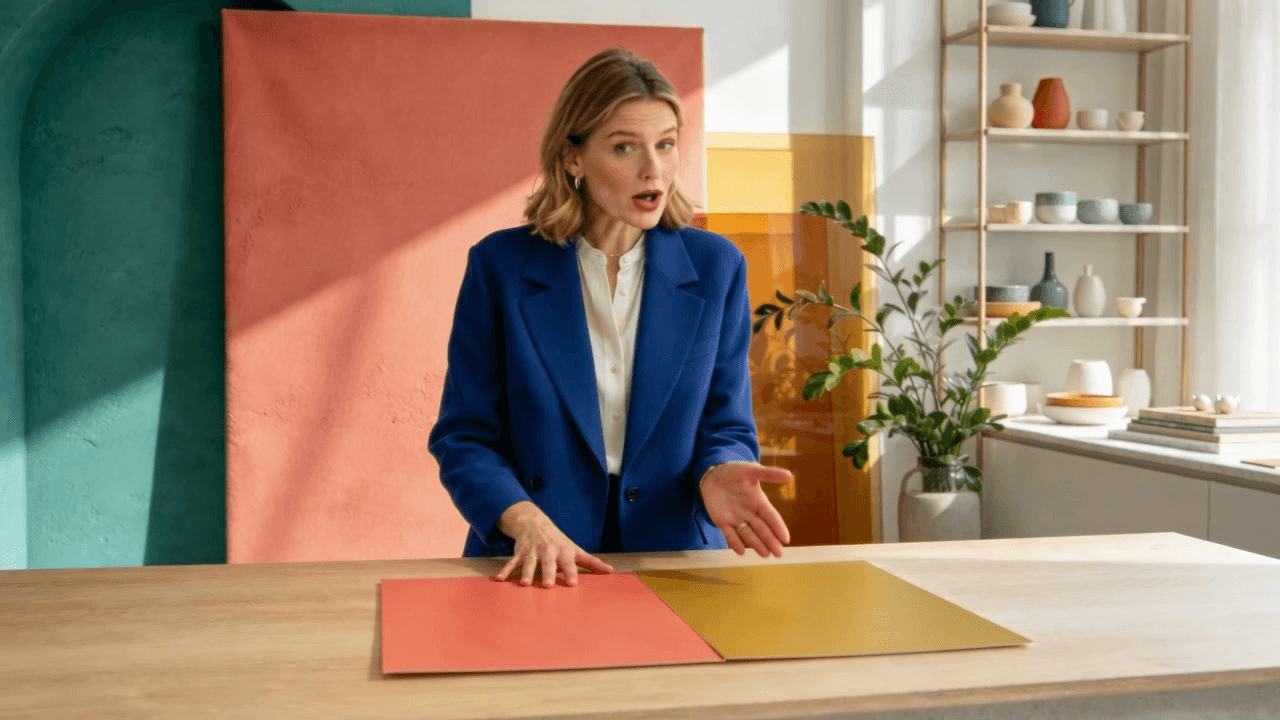
Een later frame uit dezelfde clip: de camerahoek en het gebaar veranderen, terwijl de teal kaart uit de opstelling is verdwenen.
Bekijk de volledige scène met geluid
De meegeleverde video duurt iets meer dan 30 seconden en bevat een audiotrack. Bekijk hem als één doorlopend voorbeeld, zodat de gebaren, expressie, camerabeweging en het geluid samen kunnen worden beoordeeld. De twee stilstaande beelden hierboven zijn bewijs van verschillende momenten, geen afzonderlijke gegenereerde cases.
IDJntMvkPbk
De scène slaagt erin de instructeur meer te laten doen dan naar de camera kijken: ze hanteert rekwisieten, verandert haar blik en wordt vanuit meer dan één gezichtspunt getoond. De verdwijnende teal kaart is de belangrijke bevinding uit de beoordeling. Behoud een definitieve les alleen wanneer het visuele voorbeeld overeenkomt met wat de leerling moet begrijpen, en verifieer de gesproken uitleg aan de hand van de audio voordat je publiceert.
Hoe je controleert of de AI-instructeursvideo klaar is
Gebruik een beoordelingsronde die zowel de gegenereerde performance als de les zoals leerlingen die zullen zien controleert:
- Mondtiming: Volgen mondbewegingen grofweg de belangrijkste lettergrepen en pauzes? Speel moeilijke namen en korte pauzes opnieuw af.
- Expressie: Past het gezicht bij een rustige uitleg, of verandert het in een niet-gerelateerde glimlach of overdreven emotie?
- Gebaren: Blijven handen uit de buurt van het gezicht en leiden ze niet af van een belangrijke dia?
- Identiteit en scène: Blijven gezichtskenmerken, kleding en achtergrond stabiel gedurende de clip?
- Audionauwkeurigheid: Worden terminologie, namen en cijfers correct uitgesproken in de meegeleverde opname?
- Didactische duidelijkheid: Bevat de montage de nodige dia, schermopname, ondertitel of uitgewerkt voorbeeld op het juiste moment?
- Rechten en openbaarmaking: Heb je toestemming voor de afbeelding en stem, en heb je de openbaarmakingsregels en het institutionele beleid voor het beoogde publiek en de markt gecontroleerd?
Besluit of je de clip behoudt, de bronaudio of -afbeelding herziet, of in plaats daarvan voice-over met dia's gebruikt. Behoud een presentatoropname niet alleen omdat de generatie tijd kostte. Een duidelijke schermopname kan een procedurele stap beter uitleggen.
Kosten en opschaling voor cursusvideo's
Per oktober 2026 vermeldt de Atlas Cloud-modelpagina een standaardtarief van $0.07 per seconde en toont een gereduceerd tarief van $0.056 per seconde met 20% korting. Eenvoudige schattingen op basis van die vermelde tarieven zijn:
| Gegenereerde duur | Bij $0.07/sec | Bij weergegeven $0.056/sec |
|---|---|---|
| 20 seconden | $1.40 | $1.12 |
| 60 seconden | $4.20 | $3.36 |
| 5 minuten | $21.00 | $16.80 |
Dit zijn berekeningen op basis van het modeltarief, geen offerte voor je account of garantie voor de uiteindelijke kosten. De weergegeven korting kan veranderen, en belastingen, voorwaarden op accountniveau of andere kosten kunnen het afrekenen beïnvloeden. Controleer de modeldetails en het werkelijke bevestigingsscherm opnieuw voordat je gaat produceren.
Een kort voorbeeld beperkt de kosten van het testen van een nieuw portret, een nieuwe stem of een nieuwe prompt. Voor langer materiaal verdeel je de les op echte didactische grenzen, zoals een nieuw concept of een uitgewerkt voorbeeld. Splits geen zin of verwijder geen noodzakelijke uitleg alleen om bij een generatielimiet te passen. Bij het vermelde standaardtarief zou een output van vijf minuten $21 kosten vóór eventuele korting; vergelijk dat met kortere segmenten plus montagetijd en beslis welk formaat de les het beste dient.
Privacy, toestemming en vertrouwen in de cursus
Bevestig vóór het genereren dat je het portret en de stem van de instructeur mag gebruiken voor synthetische video in de beoogde cursus, het distributiekanaal en de duur. Als een opdrachtnemer, werknemer, gastdocent of student voorkomt, documenteer dan de toestemming en eventuele beperkingen. Controleer de vereisten van je instelling voor AI-gegenereerde of gewijzigde media en de toepasselijke regels in je doelmarkten; dit artikel bepaalt geen juridische verplichtingen.
Beoordeel de afgeronde les zoals een instructeur dat zou doen. Corrigeer het script en de opname, maak synthetische presentatie bekend waar je publiek of beleid dat verwacht, en houd een mens verantwoordelijk voor de claims van de cursus. Een gepolijste presentator kan zwak of ongecontroleerd materiaal gezaghebbend laten lijken, dus de eigenaar van de les moet zowel de woorden als de definitieve montage goedkeuren.
Maak voor een eerste productie één kort segment, beoordeel het aan de hand van de checklist en schat de volgende batch in met het huidige tarief per seconde. Die kleine beslissing vertelt je of OmniHuman 2.0 AI-video's voor cursusinstructeurs thuishoren in je cursusworkflow.
Veelgestelde vragen
Kan OmniHuman 2.0 een cursusvideo maken op basis van alleen tekst?
De Atlas Cloud-vermelding beschrijft een beeld-en-audio-naar-video-workflow met optionele tekststuring. Er wordt niet vermeld dat platte tekst de voice-overaudio vervangt, dus bereid de stemtrack apart voor.
Kan ik dezelfde instructeursafbeelding hergebruiken in meerdere lessen?
Je kunt dezelfde goedgekeurde afbeelding voor afzonderlijke generaties voorbereiden. Hergebruik ervan ondersteunt een consistente visuele referentie, al garandeert het niet dat elke output identieke expressies, kadering of gebaren heeft. Beoordeel elk segment voordat je ze samenvoegt.
Genereert OmniHuman 2.0 de stem van de les?
De vermelde workflow gebruikt een audiotrack als invoer. Neem de stem apart op of produceer die, controleer hem en upload de afgeronde voice-over.
Hoeveel kost een cursusclip van 20 seconden met OmniHuman 2.0 op Atlas Cloud?
Bij het vermelde standaardtarief van $0.07 per seconde komt 20 seconden uit op $1.40. Bij het weergegeven tarief van $0.056 komt het uit op $1.12. Bevestig de actuele prijs en de uiteindelijke kosten voordat je een generatie uitvoert.


