Een AI-API voor batchgeneratie is nuttig wanneer elke uitvoer afzonderlijk kan worden gevonden, beoordeeld en opnieuw geprobeerd. Dat is belangrijker dan hoeveel prompts je tegelijk indient. Het kostbare moment is niet verzoek nummer 1.000. Het is wanneer taak 37 een time-out krijgt, taak 38 slaagt, twee bestanden dezelfde naam delen en niemand kan zeggen welke afbeelding veilig is om te publiceren.
Behandel een batch als een verzameling herstelbare assetstaken. Geef elke taak een duurzame zakelijke ID, sla de exacte invoer en modelinstellingen op, begrens gelijktijdigheid en probeer alleen het item opnieuw dat daadwerkelijk is mislukt. Deze gids gebruikt een personagecampagneworkflow met 8 assets, zodat een ontwikkelaar of growthteam een manifest kan omzetten in een gecontroleerde productierun.
Belangrijkste punten
- Een batchjob en parallelle verzoeken lossen verschillende latentie- en controleproblemen op.
- Stabiele asset-ID's en idempotentiesleutels maken gedeeltelijke uitval beheersbaar.
- Begin met 4 tot 8 visuele assets, beoordeel ze en breid daarna uit.
- Een succesvolle API-respons vereist nog steeds visuele en rechtenbeoordeling voordat je publiceert.
AI-API voor batchgeneratie: eerst het antwoord
Een AI-API voor batchgeneratie dient een set afzonderlijke generatietaken in bij een asynchrone wachtrij en retourneert de resultaten via statuscontroles, een voltooiingscallback of een downloadbaar uitvoerbestand. Elke taak heeft een identiteit nodig die buiten de modelprovider bestaat. De job-ID van de provider helpt bij de bedrijfsvoering, maar maya-ridgeline-001 is wat je redactionele of campagnesysteem maanden later in staat stelt de asset te identificeren.
Vermeng drie verwante ideeën niet. Een enkele prompt kan meerdere variaties aanvragen. Je eigen worker kan meerdere normale verzoeken tegelijk versturen. Een server-side batchjob is een door de provider beheerde verzameling die later wordt voltooid. Die laatste past vaak bij offline werk, terwijl gecontroleerde parallelle verzoeken passen bij een dashboard dat onmiddellijk voortgang nodig heeft.
De huidige Batch API-documentatie van OpenAI illustreert het asynchrone patroon: verzoeken worden verzameld in JSONL, ingediend als een job, gecontroleerd op voltooiing en opgehaald als resultaten. Het venster van 24 uur, afzonderlijke batchrate-limieten en limieten zijn specifiek voor die service, niet een belofte die elke beeldprovider doet (OpenAI Batch API-documentatie, september 2026). De huidige referentie van Gemini documenteert eveneens langdurige batchtaken, statuscontroles en webhookondersteuning voor zijn service (Gemini Batch API-referentie, september 2026).
| Beslispunt | Batch-API | Gecontroleerde parallelle verzoeken |
|---|---|---|
| Verwachte respons | Uitgestelde voltooiing | Elk verzoek retourneert zodra het klaar is |
| Het beste voor | Offline catalogus-, storyboard- en contentbibliotheekwerk | Interactieve tools en korte beoordelingslussen |
| Afhandeling van fouten | Lees resultaten per item nadat een job is voltooid | Behandel elk subverzoek zodra het afloopt |
| Kosten en limieten | Providerspecifieke batchregels kunnen afwijken van liveverkeer | Gebruikt de gewone verzoeklimieten van het account |
| Essentiële registratie | Asset-ID, verzoek-ID, resultaatstatus, uitvoerlocatie | Dezelfde velden, plus status van lopende poging |
Kies gecontroleerde parallelle verzoeken wanneer een beoordelaar snel de eerste bruikbare afbeelding moet zien. Kies een server-side batchjob wanneer het werk kan wachten en de provider een batchpad documenteert. Bewaar in beide gevallen asset_id, genormaliseerde invoer, referentiehash, model, pogingsteller en uitvoer-URL. Die gemeenschappelijke laag houdt de workflow overdraagbaar als het leveringsmechanisme verandert.
Waarom batchbeeldprojecten op schaal mislukken
Productiebatches mislukken meestal in stukjes. Een verzoek kan worden voltooid, een time-out krijgen, worden geweigerd of een uitvoer retourneren die technisch geldig maar visueel onbruikbaar is. Een applicatie die alleen een definitieve URL registreert, heeft de informatie weggegooid die nodig is om alles behalve het eenvoudigste succesgeval te herstellen.
De eerste fout is ontbrekende identiteit. Als het verzoek alleen een promptstring bevat, kan een uitvoer niet betrouwbaar worden teruggekoppeld aan een product, een campagnelocatie of een bronrij. Bestandsnamen die van de prompt zijn afgeleid, zijn fragiel omdat promptrevisies en herhaalde producten botsen. Gebruik een stabiele asset-ID uit het bedrijfsrecord en geef elke generatiepoging een eigen suffix.
De tweede fout is opnieuw proberen zonder idempotentie. Een netwerktime-out bewijst niet dat de provider geen werk heeft gedaan. Als een worker dezelfde asset onmiddellijk opnieuw indient met een nieuwe verzoekidentiteit, kan dat dubbele uitvoer en dubbele kosten opleveren. Een idempotentiesleutel laat de aanroeper in feite zeggen: "dit is nog steeds dezelfde aangevraagde asset." Of een specifiek eindpunt dat mechanisme ondersteunt, is afhankelijk van de provider, dus bevestig dit in de API-documentatie voordat je erop vertrouwt.
De derde fout is een blinde wachtrij van 40 of 60 prompts. Een afwijking in kleur, compositie of productidentiteit kan pas zichtbaar worden nadat de run is voltooid. Een recente creatorsdiscussie beschrijft het beoordelen van storyboardpagina's van ongeveer 7 tot 8 afbeeldingen voordat de volgende pagina wordt verzonden, specifiek om nauwkeurigheids- en consistentiefouten op te vangen (discussie over batchbeeldgeneratie, juni 2026). Dat is community-ervaring, geen benchmark, maar het is een verstandig operationeel controlepunt.
Gebruik een QC-regel voor kleine batches: voer 4 tot 8 assets uit, inspecteer ze, herstel de prompt of referentie indien nodig en ontgrendel daarna de volgende groep. Bewaar de oorspronkelijke prompt, promptversie, invoerreferentie, modelrevisie wanneer beschikbaar, kwaliteitsinstelling, beeldverhouding, tijdstempels, foutklasse en beoordelingsbeslissing. Een URL alleen kan niet beantwoorden waarom een asset bestaat of of deze opnieuw moet worden gebruikt.
Ontwerp een betrouwbare AI-API voor batchgeneratie
De implementatie kan klein zijn. Een manifest, een wachtrijworker, een alleen-toevoegen jobrecord en een beoordelaarsvriendelijke uitvoermap zijn genoeg om te beginnen. Het doel is niet een groot orkestratiesysteem. Het is een workflow waarin iemand kan antwoorden: wat is aangevraagd, wat is er gebeurd en wat moet er nu draaien?
Geef elke batch-uitvoer een duurzame assetidentiteit
Maak asset_id een zakelijke sleutel, geen provider-job-ID. Een nuttig taakrecord kan de onderstaande velden bevatten. Bewaar het in een database wanneer meerdere workers actief zijn, of in een geversioneerde CSV plus JSONL-log voor een kleiner team.
| Veld | Waarom het bestaat |
|---|---|
asset_id | Onveranderlijke identiteit voor de publiceerbare asset |
source_row | Koppelt terug aan het product-, campagne- of contentrecord |
prompt_version | Toont welke instructiesjabloon het resultaat heeft geproduceerd |
reference_hash | Bevestigt welke vergrendelde bronafbeelding is gebruikt |
model, aspect_ratio, quality | Maakt de run reproduceerbaar genoeg om te diagnosticeren |
attempt, idempotency_key, status | Scheidt een nieuwe poging van een subtaak van een nieuw verzoek |
output_url, review_status, failure_reason | Verbindt levering en menselijke acceptatie |
Bijvoorbeeld: maya-train-001 blijft de assetidentiteit. maya-train-001-a2 is poging 2. De idempotentiesleutel kan maya-train-001-v1 zijn, waarbij v1 de onveranderlijke aangevraagde specificatie identificeert. Als de briefing wezenlijk verandert, maak dan een nieuwe promptversie in plaats van het oude record te overschrijven.
Gebruik een batchwachtrij, geen onbeperkte lus
Stel vóór verzending een gelijktijdigheidsplafond, een limiet op het aantal assets, een financiële vangrail en een limiet op nieuwe pogingen in. Een praktische startconfiguratie is 4 lopende jobs, maximaal 2 generatiepogingen per job en niet meer dan 8 visuele taken vóór de volgende kwaliteitspoort. Dit zijn startwaarden, geen platformgaranties. Stel ze onder de gedocumenteerde limieten van je account in en pas ze aan na observatie van werkelijke voltooiingstijden en foutpercentages.
De worker moet één openstaande taak claimen, deze als submitted markeren, de provider-verzoek-ID opslaan en datzelfde record bijwerken wanneer een resultaat binnenkomt. Wanneer een budgetplafond wordt bereikt, stop dan met het claimen van werk. Wanneer de wachtrij voor beoordeling wordt gepauzeerd, laat reeds ingediend werk afronden, maar geef niet automatisch een volgende groep vrij.
Probeer alleen de mislukte subtaak opnieuw
Probeer failed, timed_out of providerspecifieke statussen die opnieuw kunnen worden geprobeerd één asset tegelijk opnieuw. Gebruik begrensde exponentiële backoff met jitter voor 429-responsen, tijdelijke 5xx-responsen en echte transporttime-outs. Sla de foutclassificatie en geplande nieuwe pogingstijd op. Herhaal niet automatisch een weigering op grond van contentbeleid, misvormde invoer, ontbrekende referentie of een visuele afwijzing door een menselijke beoordelaar.
Dien nooit een hele batch opnieuw in omdat één subtaak is mislukt. Archiveer succesvolle resultaten onmiddellijk en bewaar de koppeling van bron naar uitvoer. Als een batchjob verloopt met gedeeltelijke resultaten, neem dan de voltooide subtaken op, identificeer de niet-afgeronde asset-ID's en maak een nieuwe job met alleen die resterende records. Dit is het verschil tussen herstel en duplicatie.
Een kopieerbare batchbeeldworkflow met 8 assets
Het volgende voorbeeld is opzettelijk fictief: Maya, een volwassen reisfotograaf op een hooglandopdracht. Het maakt de operationele mechanica concreet zonder te suggereren dat een echt persoon de campagne onderschrijft. Vervang de velden door je eigen toegestane personage-, talentrelease- of campagnedata en behoud de structuur.
Stap 0: Maak het manifest voordat je genereert
Maak batch-manifest.csv voordat je een playground opent of een eindpunt aanroept. Het geeft de operator een duidelijk acceptatiedoel voor elke asset.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | canonieke personagereferentie | 16:9 | in behandeling |
| maya-ridgeline-001 | a | campagnebeeld van zonsopgang op de bergkam | 16:9 | in behandeling |
| maya-market-001 | a | redactioneel beeld van bergmarkt | 16:9 | in behandeling |
| maya-cabin-001 | a | redactioneel beeld van hutplanning | 16:9 | in behandeling |
| maya-lake-001 | a | beeld van veldnotities aan het meer | 16:9 | in behandeling |
| maya-forest-001 | b | campagnebeeld van bospad | 16:9 | in behandeling |
| maya-train-001 | b | redactioneel beeld van treinreis | 16:9 | in behandeling |
| maya-workbench-001 | b | beeld van voorbereiding van veldkit | 16:9 | in behandeling |
| maya-portrait-001 | b | campagnebeeld van close-upportret | 16:9 | in behandeling |
Genereer een deterministische idempotentiesleutel voor elk onveranderlijk verzoek, zoals maya-ridgeline-001-v1. De onderstaande vorm is bewust providerneutraal. Plaats het provider-eindpunt en de gedocumenteerde parameters in request; kopieer geen fictief privé-eindpunt naar productie.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Stap 1: Maak één canonieke personagereferentie
Genereer de masterafbeelding afzonderlijk. Het is het identiteitsanker voor elke latere scène, dus het verdient een korte beoordeling voordat een batch begint. Selecteer in de GPT Image 2-playground High quality en 16:9 en gebruik deze prompt:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Bewaar één afbeelding die duidelijk Maya's gezicht, haar, jas, camerariem en één volledig paar handen toont, zonder tekst of dubbele persoon. Sla deze op als maya-master-001.png, bereken een referentiehash en voeg diezelfde bron toe aan downstream-subtaken. Batch deze stap niet. Een zwakke masterreferentie vermenigvuldigt ambiguïteit in elke scène.
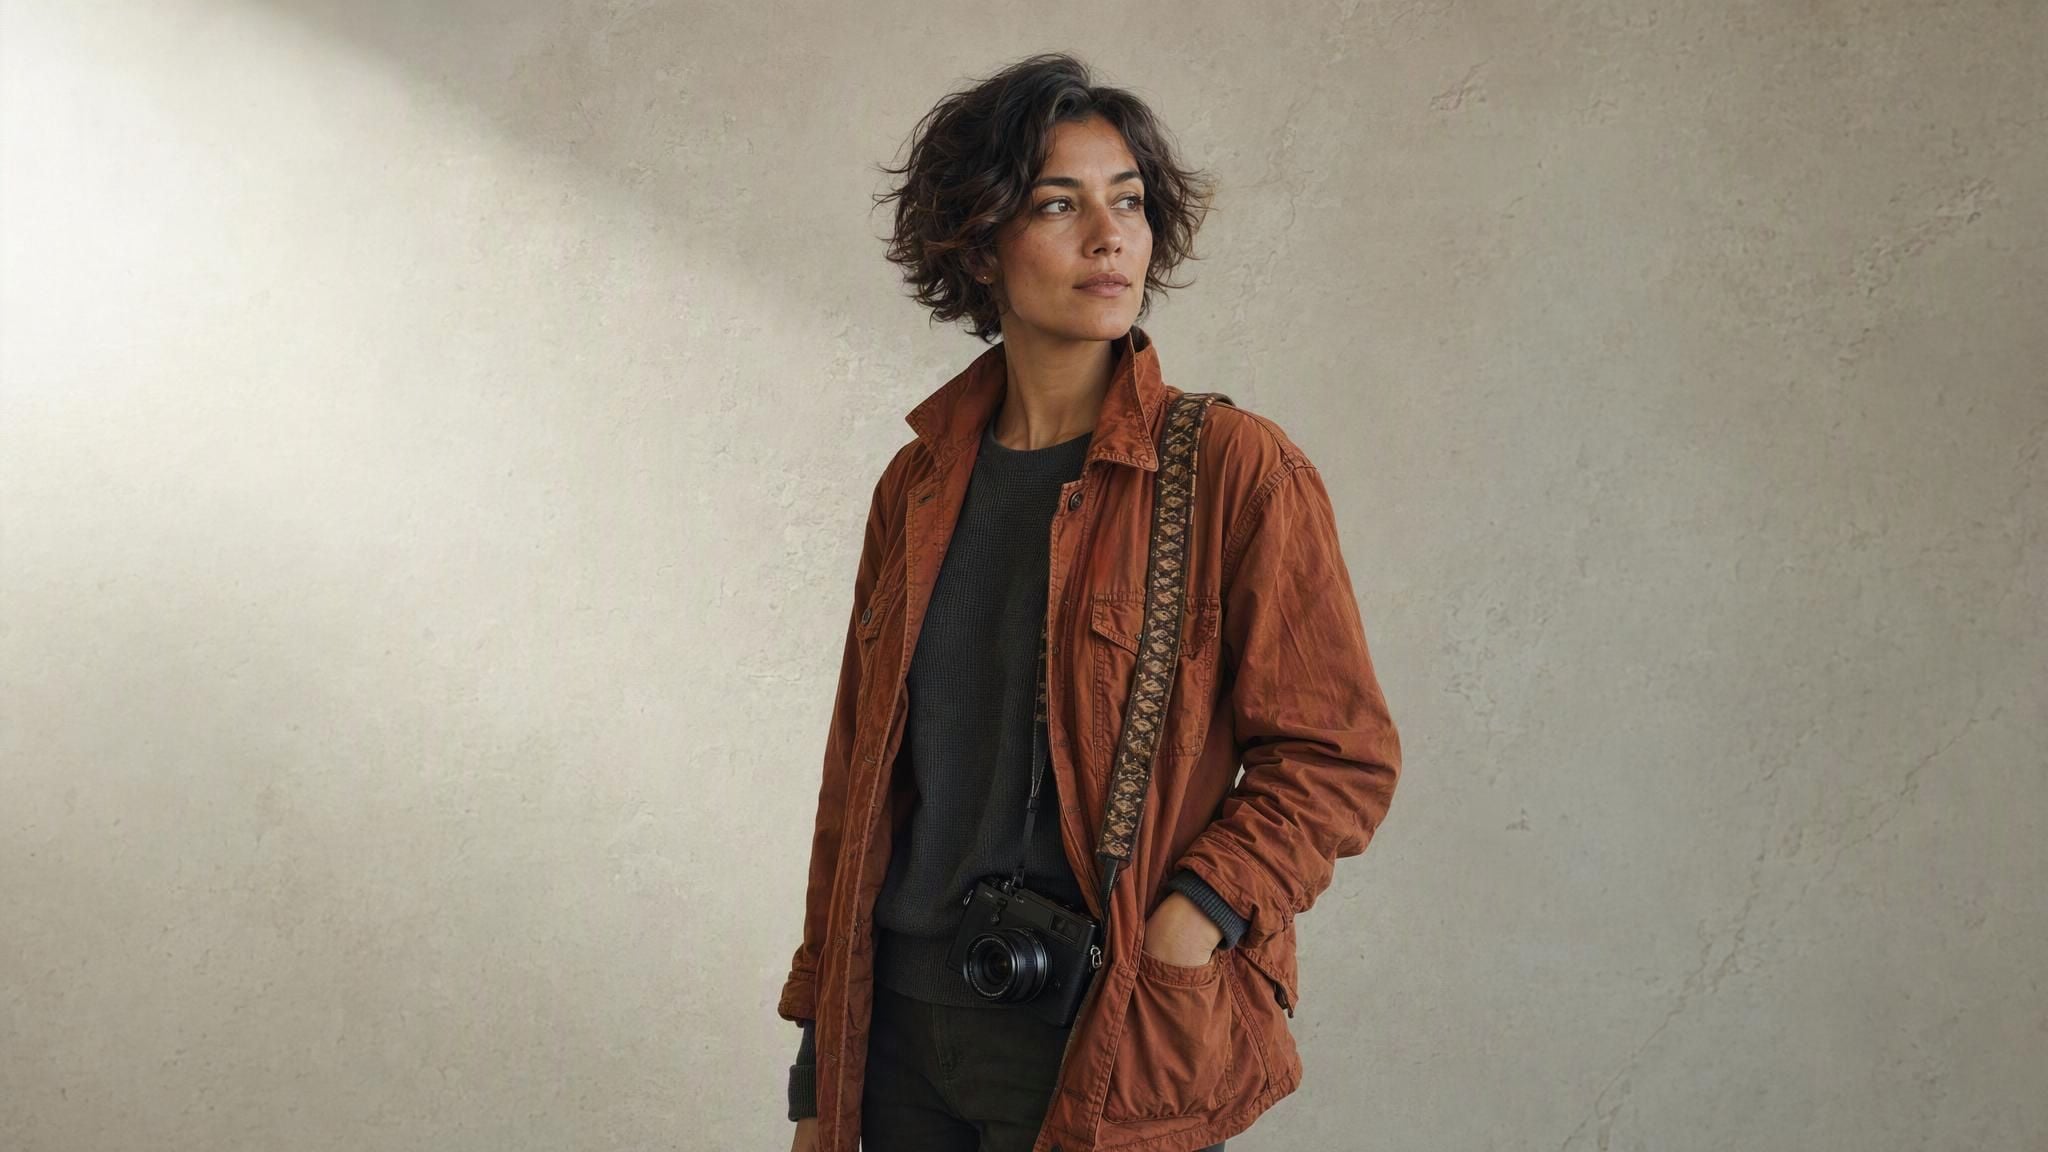
Functiedemo voor AI-API voor batchgeneratie: Maya's personagereferentieprompt naast het gegenereerde portret van de reisfotograaf
Een echte GPT Image 2-masterreferentie-run: de prompt vestigt de fictieve fotograaf wiens identiteit latere scènepjobs moeten behouden.
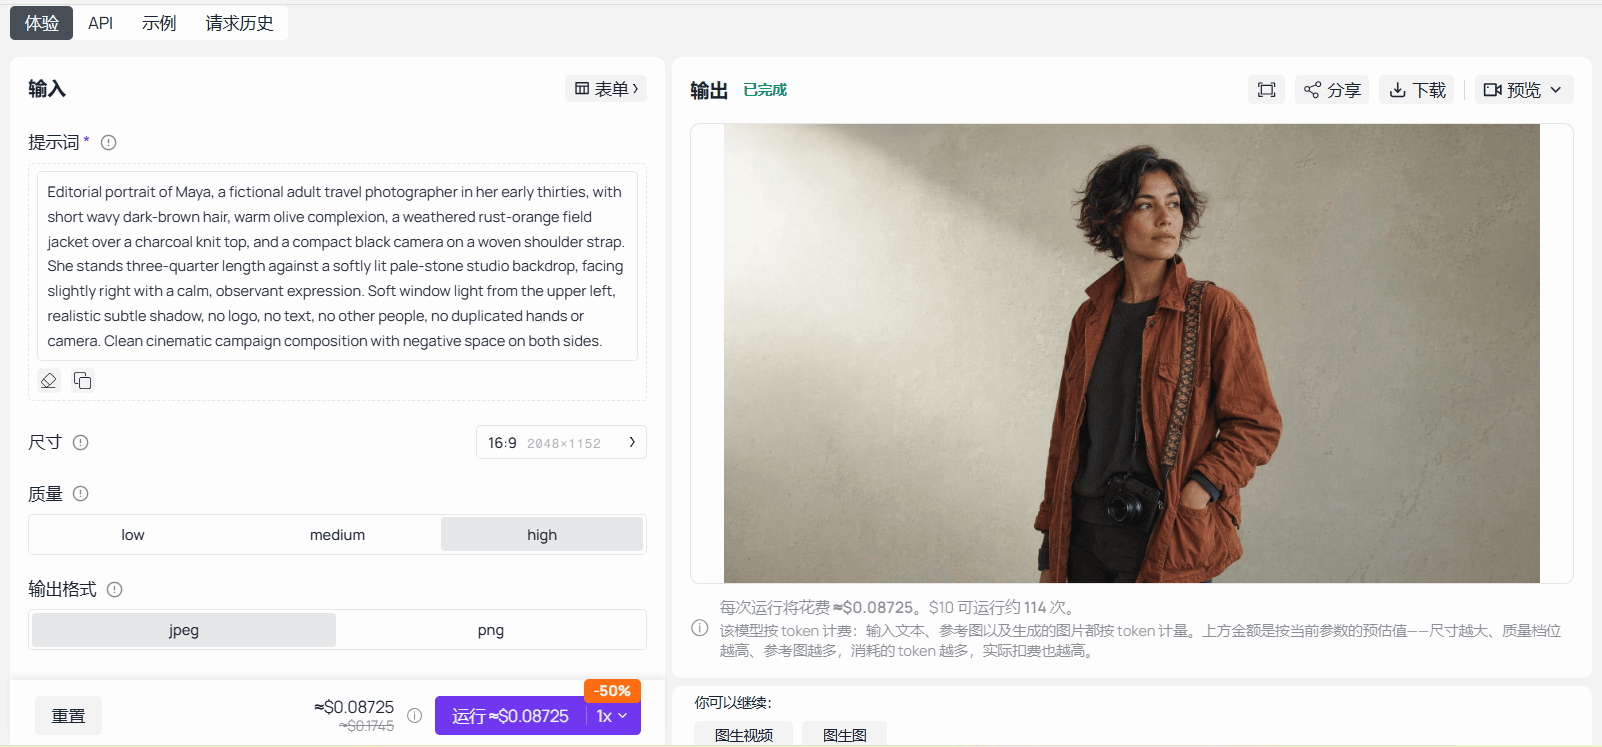
GPT Image 2-playground voltooid met High quality, een 16:9-instelling en Maya's masterportret
GPT Image 2 op Atlas Cloud met de personagereferentieprompt uit het artikel en het voltooide resultaat in het uitvoerpaneel.
Stap 2: Voer batch A uit als 4 gekoppelde personagescènes
Upload maya-master-001.png naar Seedream v4.7 Sequential. Houd de referentie, het promptsjabloon en de 16:9-verhouding constant. Gebruik deze prompt:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Gebruik de sequentiële of coherente batchmodus die de live pagina daadwerkelijk beschikbaar stelt. Accepteer alleen uitvoer die ondubbelzinnig kan worden gekoppeld aan maya-ridgeline-001 tot en met maya-lake-001. Als de playground één uitvoer per verzoek retourneert in plaats van 4 afzonderlijke subassets, dien dan hetzelfde vergrendelde sjabloon in als 4 subtaken. Behoud dezelfde referentiehash en parameters in plaats van te doen alsof de interface een functie heeft geretourneerd die er niet is.
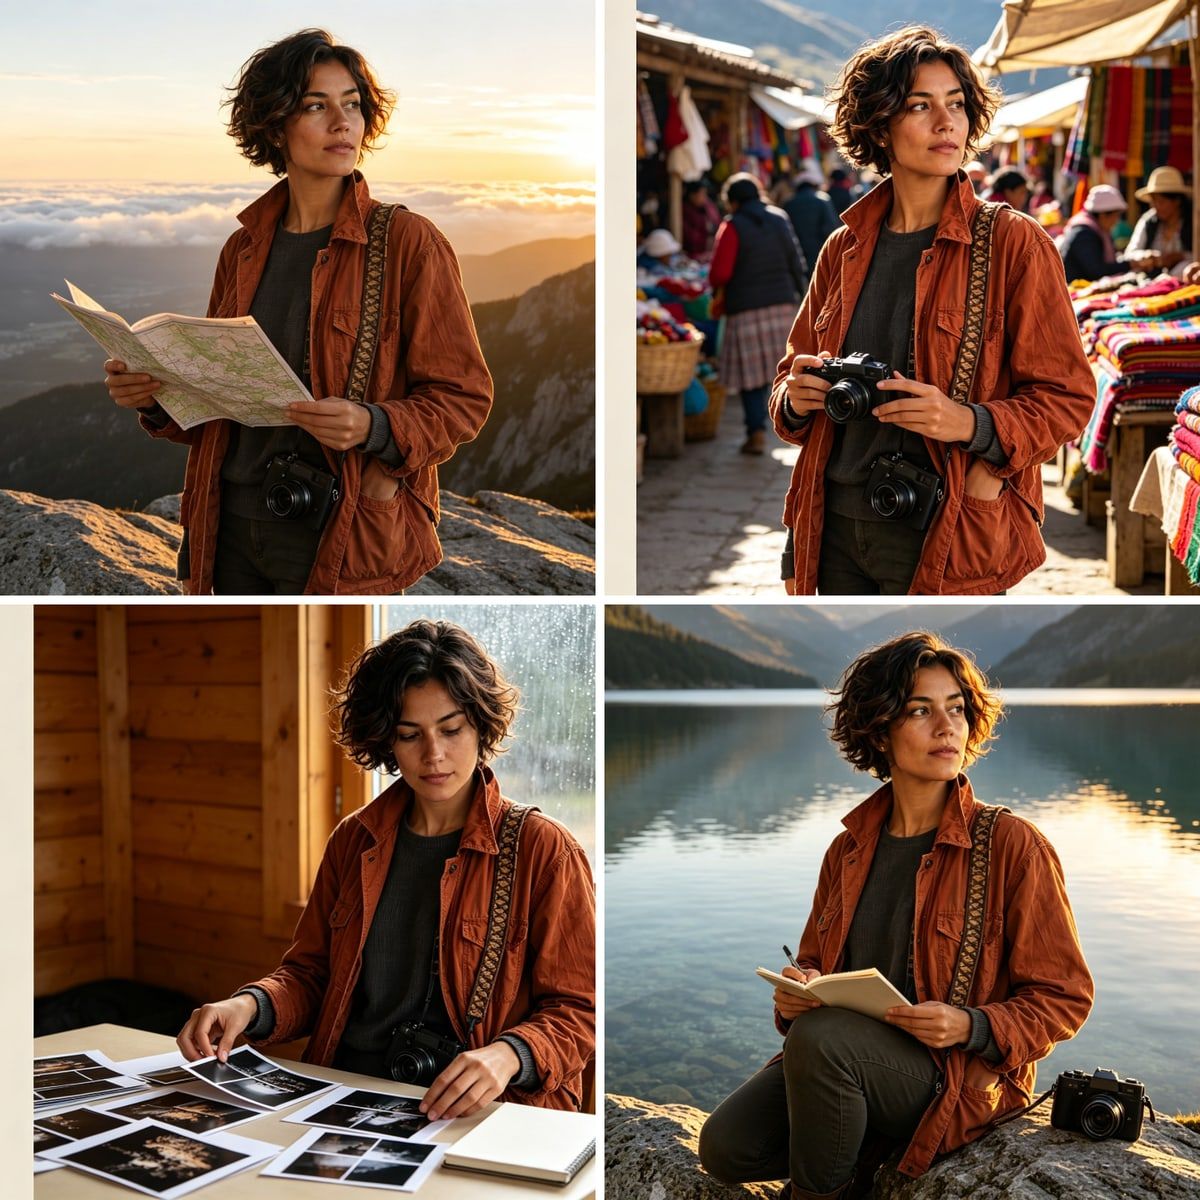
Vier echte Seedream v4.7 Sequential Maya-scène-uitvoeren in een raster, gekoppeld aan asset-ID's voor bergkam, markt, hut en meer
Het uitvoerraster van batch A met 4 scènes: elk frame blijft een afzonderlijk assetrecord, zelfs wanneer het model een coherente sequentie produceert.
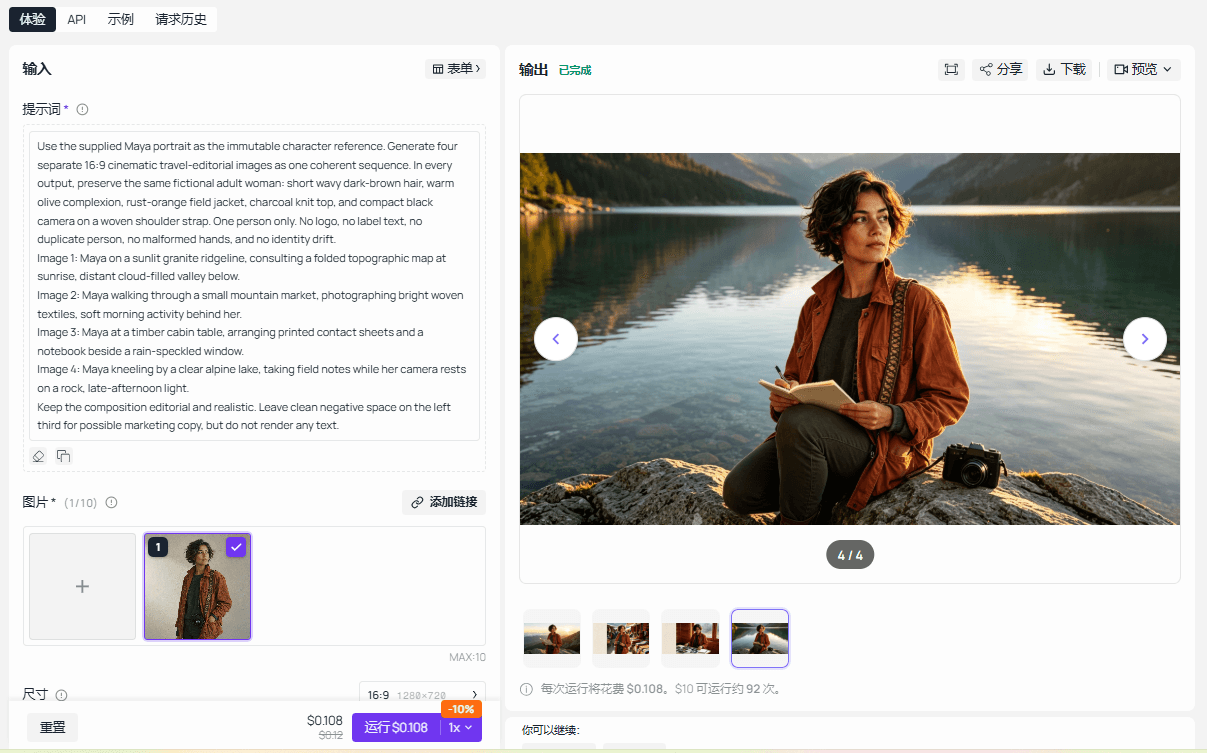
Seedream v4.7 Sequential-playground voltooid met de gekoppelde Maya-scèneprompt en de echte uitvoer
Seedream v4.7 Sequential op Atlas Cloud met de gekoppelde personage-scèneprompt uit het artikel en een voltooid resultaat.
Stap 3: Voer batch B uit en stop daarna voor kwaliteitscontrole
Hergebruik de goedgekeurde masterreferentie. Maak deze niet opnieuw en herschrijf de identiteitsregels niet. Dien de volgende 4 scènes in met een nieuw batchlabel en dezelfde acceptatiecontroles:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Stop na batch B. Beoordeel alle 8 scènerecords voordat je nog een campagnesequentie vrijgeeft. Deze pauze vangt de soorten afwijkingen op die wachtrijen verbergen: haar- of kledingwisselingen, een tweede persoon die verschijnt, niet-aangevraagde belettering, misvormde handen of een scène die niet langer bij het kanaal past. Bewaar de beoordelingsbeslissing naast de asset in plaats van in een niet-gevolgd chatbericht.
Stap 4: Pas een beslissing toe: publiceren, opnieuw proberen of afwijzen
Markeer een afbeelding als approved wanneer deze één Maya bevat, overeenkomt met de masterreferentie in gezicht, haar, kleding en camera, geen gebroken tekst of misvormde anatomie bevat en past bij de toegewezen scène. Markeer deze als retry wanneer Maya dubbel voorkomt, afwijkt, een noodzakelijk rekwisiet verliest of misvormde handen of belettering toont. Markeer deze als rejected wanneer de compositie niet kan dienen voor het beoogde kanaal of het personage niet langer herkenbaar is.
Behoud voor een nieuwe poging maya-train-001 als de zakelijke asset en maak poging maya-train-001-a2. Dien alleen die subtaak in met de oorspronkelijke idempotentiesleutspecificatie, alleen aangepast als de prompt doelbewust wordt geversioneerd. Voer de andere 7 assets niet opnieuw uit alleen omdat één scène reparatie nodig heeft.
Modellen kiezen voor batchgeneratie
Kies een model rond de werkeenheid, niet rond een leaderboard. Een schone masterreferentie en een coherente scènesequentie zijn verschillende taken. Een bewerking van één mislukte afbeelding is weer iets anders. Als een team die fasen via één OpenAI-compatibele integratie wil testen, biedt Atlas Cloud een natuurlijke plek om de twee modelpagina's die in dit voorbeeld worden gebruikt, te valideren.
| Taak | Model en werkmethode | Prijscontext om te verifiëren vóór het in de wachtrij plaatsen |
|---|---|---|
| Maak een schone personagemaster | GPT Image 2, één High-quality 16:9-run die het referentieanker wordt | GPT Image 2 Developer text-to-image staat vanaf ongeveer $0.004 per afbeelding tegenover $0.009 standaard, een weergegeven korting van 50% per september 2026 |
| Bouw een coherente scèneset | Seedream v4.7 Sequential, dezelfde referentie en hetzelfde vergrendelde promptschema in subtaken | De huidige catalogus vermeldt $0.03 per afbeelding; verifieer de live uitvoermodus en prijs vóór productie |
| Repareer één mislukte asset | GPT Image 2-bewerkingsmodus, beperkt tot de asset die de beoordeling niet haalde | Bevestig het bewerkingseindpunt, de uitvoergrootte, kwaliteit en huidige prijs voordat je doorgaat |
Prijzen veranderen per model, modus en geselecteerde instellingen. Gebruik de Atlas Cloud-modellencatalogus om beschikbaarheid, kortingen en de exacte modus opnieuw te controleren op de dag dat je werk in de wachtrij plaatst. Behandel de tabel als invoer voor een schatting, nooit als promotionele claim of kostengarantie.
Kwaliteitscontrole, kosten en rechten voordat je opschaalt
Voltooiing van generatie heeft 3 afzonderlijke betekenissen: de provider meldt succes, het bestand is correct gearchiveerd en een menselijke beoordelaar accepteert het voor publicatie. Maak alle 3 zichtbaar in je records. Een voltooide taak met een ontbrekend uitvoerbestand is een operationele fout. Een opgeslagen bestand met een dubbel personage is een creatieve fout. Geen van beide mag automatisch doorstromen naar publicatie.
Gebruik een checklist voor beoordelaars die eenvoudig genoeg is om op elke subasset toe te passen:
| Controle | Vraag voor de beoordelaar |
|---|---|
| Personage-identiteit | Komt Maya overeen met de goedgekeurde masterreferentie in gezicht, haar, kleding en camera? |
| Objectaantal | Is er precies het verwachte aantal sleutelobjecten? |
| Promptovereenkomst | Levert de scène het toegewezen gebruiksscenario? |
| Tekstartefacten | Is er ongewenste, misvormde of niet-ondersteunde tekst? |
| Verhouding en bestandsnaam | Komt het opgeslagen bestand overeen met het manifestrecord? |
| Rechtenbeoordeling | Zijn de referentie en beoogde claims toegestaan voor dit gebruik? |
Schat de kosten na de run met approved asset cost = total completed attempts cost / approved assets. Dit maakt de kosten van nieuwe pogingen en afgewezen resultaten zichtbaar zonder te doen alsof elke afbeelding dezelfde uiteindelijke kosten heeft. Stel een taakplafond, een batchplafond en een dagplafond in voordat je begint. Pauzeer verzending als een van die plafonds wordt bereikt.
Gebruik alleen referentieafbeeldingen die je bezit, in licentie hebt of anderszins zijn toegestaan. Controleer het huidige platformbeleid en de voorwaarden van het model vóór commercieel gebruik. Vraag het model niet om certificeringen, laboratoriumresultaten, veiligheidsbeloften, medische claims of niet-geverifieerde productspecificaties te verzinnen. Een gepolijste uitvoer maakt van een niet-ondersteunde claim nog geen publiceerbare claim.
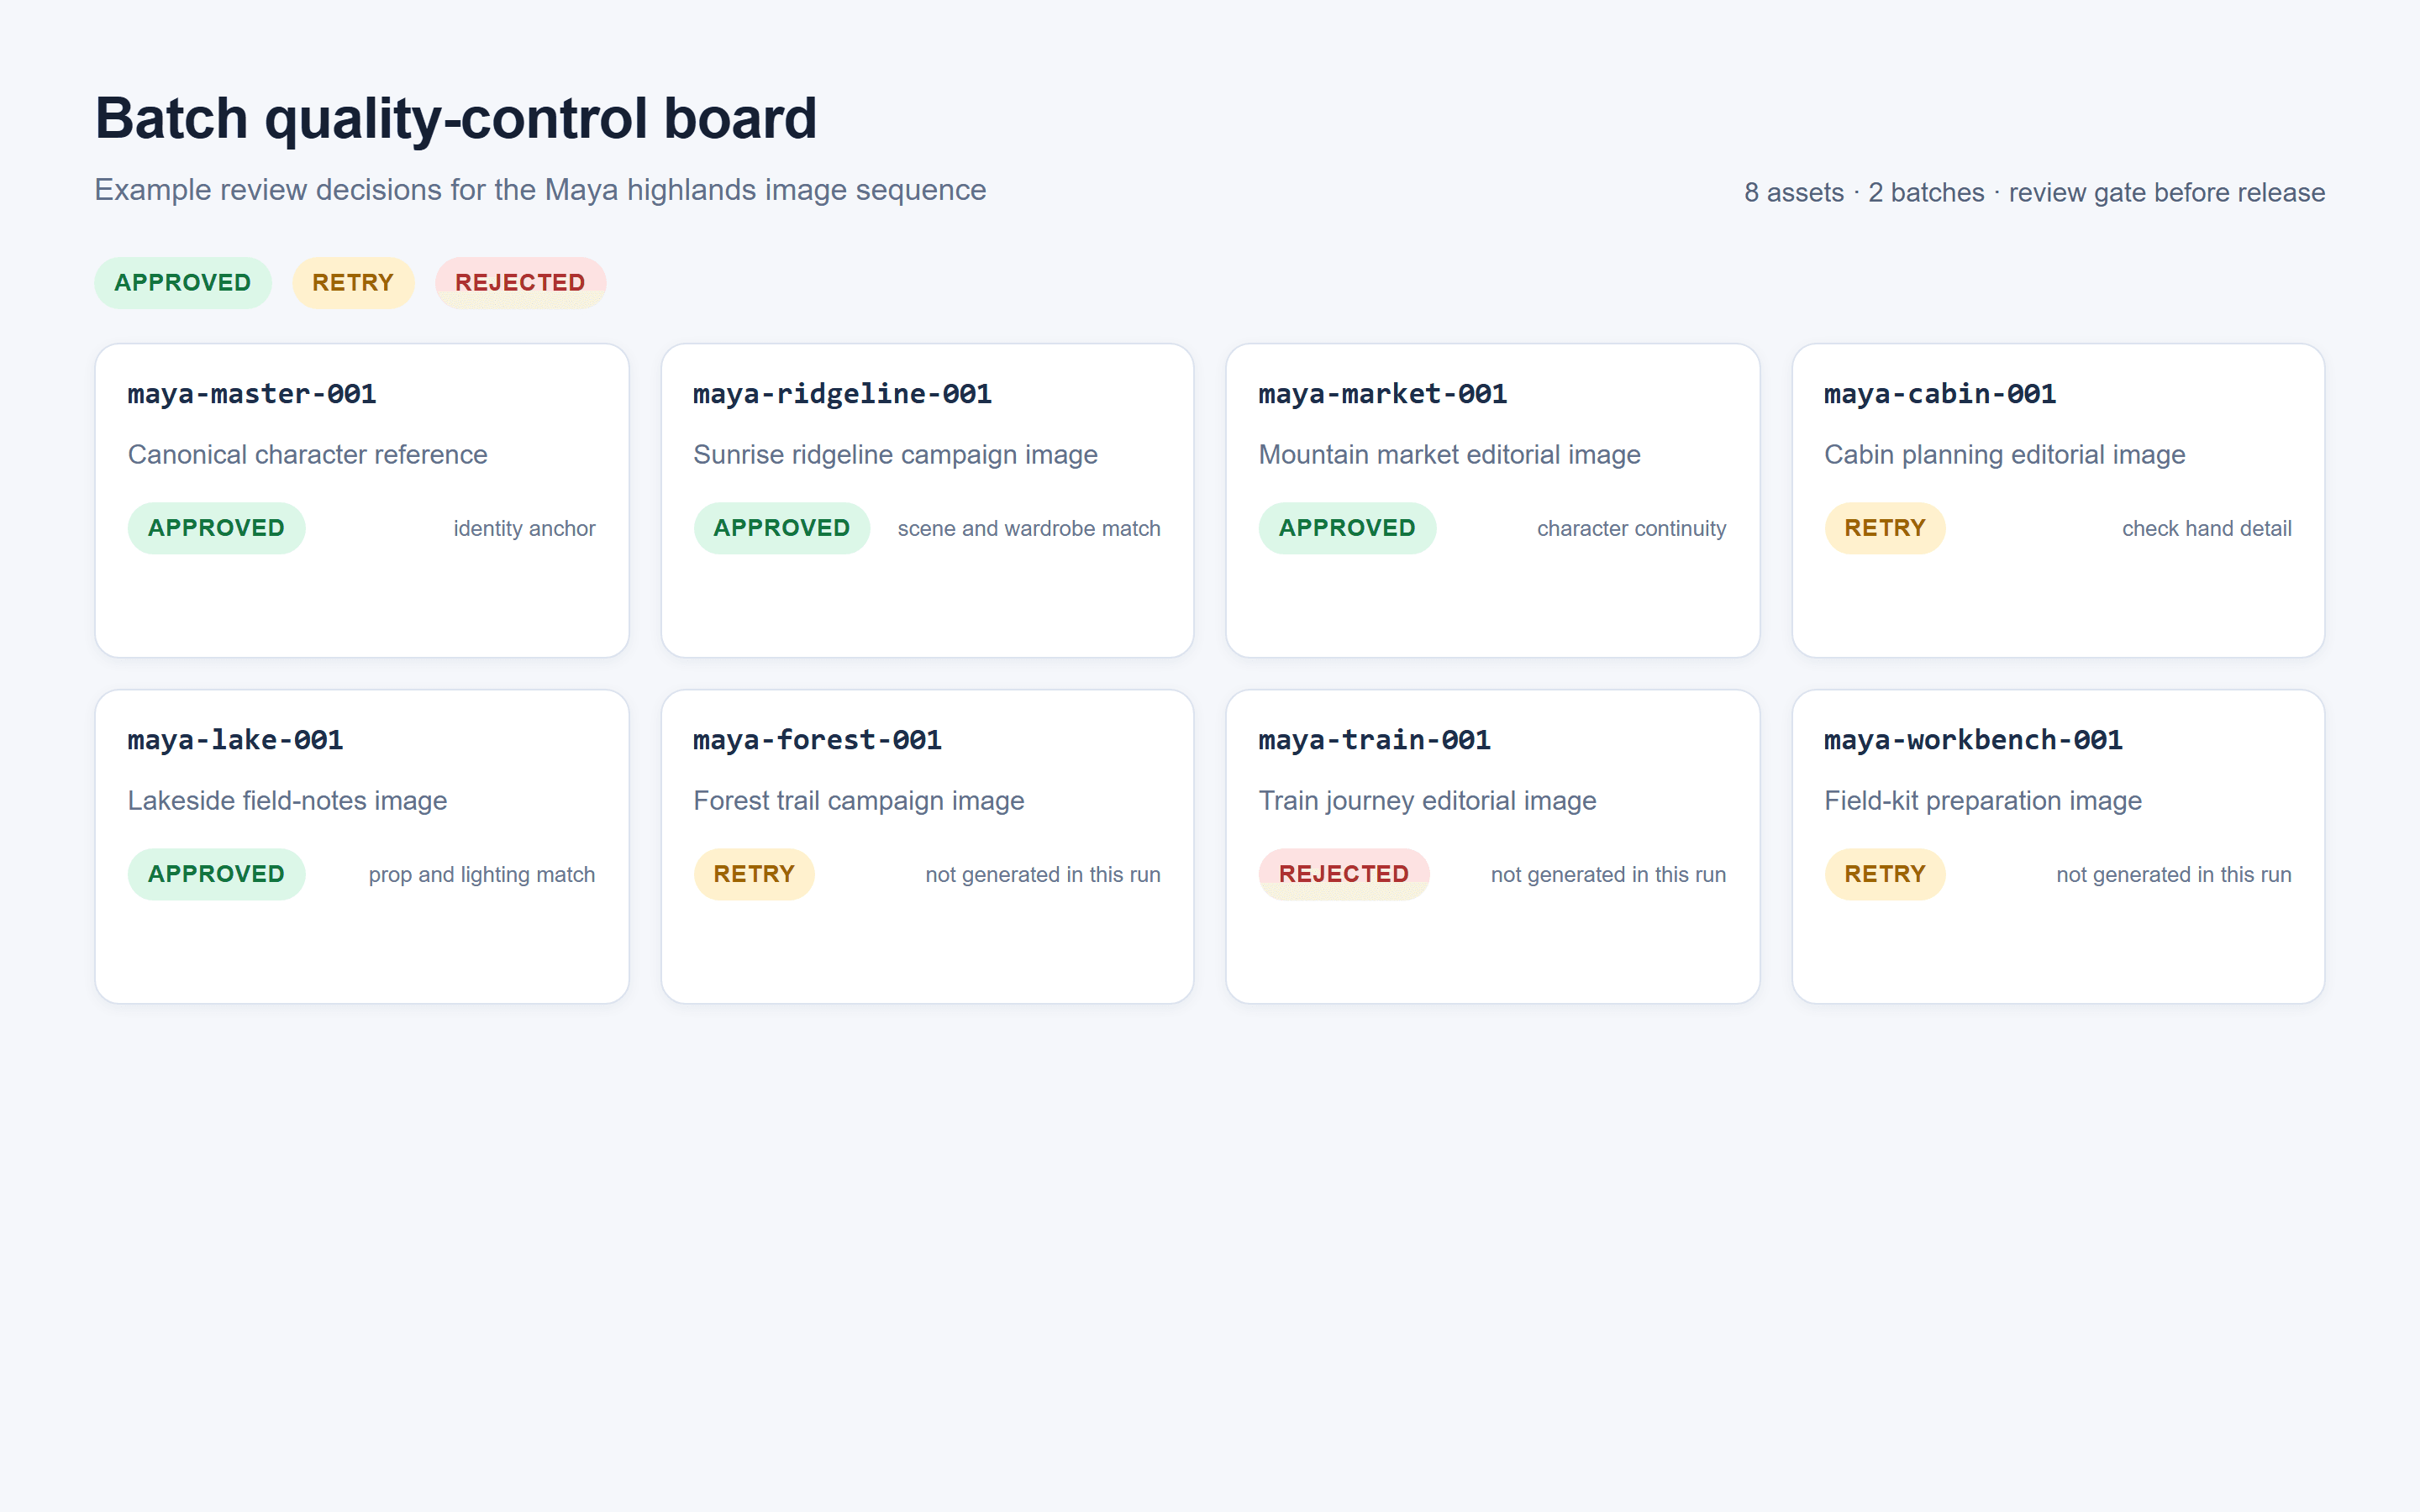
Door de browser weergegeven batchkwaliteitscontrolebord met 8 Maya-asset-ID's met de beoordelingsstatussen goedgekeurd, opnieuw proberen en afgewezen
Een door de browser weergegeven beoordelingsbord koppelt echte runbestanden terug aan hun 8 asset-ID's en maakt de beslissing publiceren, opnieuw proberen of afwijzen zichtbaar.
AI-API voor batchgeneratie: checklist voor productielancering
Voordat je van de oefening met 8 assets naar een live catalogus of contentbibliotheek gaat, bevestig je elk onderstaand item.
- Elke asset heeft een onveranderlijke
asset_id. - De prompt, referentiehash, model, verhouding en kwaliteit zijn vastgelegd.
- Elke inzending heeft een idempotentiesleutel waar de provider die ondersteunt.
- Gelijktijdigheid blijft onder de feitelijk gedocumenteerde limiet van het account.
- Er bestaan taak-, batch- en dagbudgetplafonds.
- 429-responsen, 5xx-responsen, time-outs en contentweigeringen volgen verschillende regels.
- Nieuwe pogingen hebben een hard maximum.
- Succesvolle resultaten worden onmiddellijk gearchiveerd en teruggekoppeld aan brongegevens.
- Een QC-poort voor kleine batches slaagt voordat de volgende groep wordt vrijgegeven.
- Een laatste steekproefbeoordeling controleert personage-identiteit, tekst, verhouding, bestandsnamen en rechten.
Deze checklist houdt een AI-API voor batchgeneratie nuttig wanneer het volume groeit. Hij laat ook een duidelijk auditspoor achter wanneer een redacteur vraagt waarom een bepaalde afbeelding is gegenereerd, geaccepteerd of opnieuw uitgevoerd.
FAQ: AI-API voor batchgeneratie
Wat is een AI-API voor batchgeneratie?
Het is een manier om veel onafhankelijke AI-taken in te dienen, de uitvoering ervan te volgen en resultaten later te verzamelen. Een goede implementatie houdt voor elke taak een duurzame zakelijke asset-ID bij, ongeacht of de provider een asynchrone batchjob of normale gelijktijdige verzoeken gebruikt.
Is een batch-API beter dan beeldverzoeken parallel verzenden?
Geen van beide is automatisch beter. Gebruik gecontroleerde parallelle verzoeken wanneer de workflow onmiddellijke voortgang nodig heeft. Gebruik een provider-batchjob voor niet-urgent volume wanneer de gedocumenteerde wachtrij-, doorlooptijd- en kostenregels bij je werk passen. Beide hebben per-asset logs en beoordeling nodig.
Hoeveel AI-afbeeldingen moet ik in één batch plaatsen?
Begin met 4 tot 8 visuele assets wanneer je een nieuw promptschema of personagereferentie valideert. Verhoog alleen nadat het team elk resultaat kan koppelen, afwijkingen snel kan opmerken en een mislukte subtaak kan herstellen zonder de groep opnieuw te starten. Providerlimieten kunnen veel meer toestaan, maar een operationeel nuttige batch is een batch die kan worden beoordeeld.
Hoe voorkomen idempotentiesleutels dubbele generatiekosten?
Ze identificeren een inzending als dezelfde beoogde bewerking na een nieuwe poging. Als het eindpunt idempotentie ondersteunt, kan de provider voorkomen dat een herhaalde netwerkaanroep als een volledig nieuwe generatie wordt behandeld. Bewaar de sleutel bij het assetrecord en bevestig de exacte semantiek in de documentatie van de provider.
Kan ik afbeeldingen batchen op basis van dezelfde personagereferentie?
Ja. Gebruik één goedgekeurde, toegestane referentieafbeelding; voeg de hash toe aan elke subtaak; vergrendel de identiteitsinstructies; en beoordeel een kleine scènegroep vóór opschaling. Referentieconsistentie vermindert ambiguïteit, maar vervangt visuele QC niet.
Moet ik een hele mislukte batch opnieuw proberen of alleen mislukte assets?
Probeer alleen de mislukte assets opnieuw. Archiveer successen eerst, classificeer de fout en maak een nieuw pogingsrecord voor de getroffen subtaak. Opnieuw indienen van de hele batch maakt dubbele assets en onnodige uitgaven waarschijnlijker.


