DeepSeek Harness maakte geen deel uit van die benchmark. Het werd twee dagen later uitgebracht. Dat betekent dat de nuttige vraag niet is "welke heeft gewonnen?". De nuttige vraag is hoe je dezelfde taak door beide tools kunt laten uitvoeren, op hetzelfde model, en de rekening kunt lezen zonder jezelf voor de gek te houden.
Belangrijkste conclusies
- De keuze van het harnas kan het tokenverbruik met ruwweg 7x doen schommelen bij vergelijkbare agenttaken.
- Meet DeepSeek Harness en OpenCode met hetzelfde model en dezelfde repo-status.
- Gebruik aparte API-sleutels voordat je er een kiest voor dagelijks werk.
Twee laptops die dezelfde codeertaak uitvoeren via twee agent-harnassen
De eerlijke opstelling: één model, één taak, twee terminals.
Wat de publieke benchmark ons vertelt
Composio voerde 30 complexe multi-app workflows uit via 8 agent-harnassen, allemaal met DeepSeek V4 Flash, een limiet van 900 seconden per taak en binaire programmatische beoordeling over 240 runs (Composio, augustus 2026). Hetzelfde model, verschillende harnassen.
| Harnas | Slagingspercentage | Mediane tijd | Gem. tokens per taak |
|---|---|---|---|
| Pi Agent | 66,7% | 132,2s | 559.000 |
| Prime Agent | 62,5% | 242,1s | 1.400.000 |
| OMP | 56,7% | 272,4s | 742.000 |
| Claude Code | 53,3% | 122,7s | 742.000 |
| Codex | 53,3% | 245,0s | 678.000 |
| DeepAgents | 53,3% | 187,1s | 665.000 |
| Hermes Agent | 50,0% | 175,5s | 192.000 |
| OpenCode | 46,7% | 129,7s | 692.000 |
De tokenkolom is belangrijker dan de ranglijst. De spreiding loopt van 192.000 tot 1.400.000 gemiddelde tokens per taak. Dat is hetzelfde model dat vergelijkbaar werk verricht via verschillende runtimes.
OpenCode geeft ons een basislijn met bron: 692.000 tokens per taak, 46,7% slagingspercentage en 129,7 seconden mediane tijd. DeepSeek Harness heeft geen publiek directvergelijkingscijfer uit deze benchmark omdat DeepSeek het op 13 augustus 2026 uitbracht, twee dagen nadat de benchmark was gepubliceerd.
Gebruik de tabel als waarschuwing, niet als oordeel. Het laat zien dat het harnas de kosten kan domineren. Het bewijst niet of DeepSeek Harness OpenCode verslaat op jouw repo.
Wat er verandert als je van harnas wisselt
Voordat je gaat testen, vergelijk je de twee tools op de onderdelen die een werkende ontwikkelaar raken: setup-oppervlak, volwassenheid, tokenzichtbaarheid en hoeveel van de agentloop je kunt vervangen.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Van | DeepSeek AI | Anomaly (oorspronkelijk SST) |
| Uitgebracht | 13 augustus 2026 | Eind 2025 |
| GitHub-sterren | ~143k | ~198k |
| Licentie | MIT | MIT |
| Taal | TypeScript | Go |
| Interface | Web-UI op 127.0.0.1:3080 | Terminal TUI |
| Status | Ontwikkelaarspreview, verwachte breaking changes | Volwassen, breed uitgerold |
| Architectuur | Vervangbare plugins voor modellen, tools, sessies, sandboxes, opslag, loops en UI | Vaste kern met build/plan-agents, MCP-ondersteuning en LSP-extensies |
| Config | $DSH_HOME/settings.yaml | opencode.json |
| Tokenboekhouding | Tokenmeter met contextdruk en uitsplitsingsprognoses | Per-sessie token- en kostentracking in de TUI |
| Het beste voor | Teams die de agentloop zelf willen aanpassen | Teams die een codeeragent willen die vandaag werkt |
OpenCode biedt je een stabiele codeeragent met uitbreidingspunten aan de randen. DeepSeek Harness biedt je een runtime waarin de loop zelf kan worden verwisseld. Die flexibiliteit helpt als je agentinfrastructuur bouwt. Het voegt risico toe als je een standaardtool nodig hebt voor productiecode deze week.
Beide tools kunnen hetzelfde OpenAI-compatibele eindpunt bereiken. Dat maakt een eerlijke test mogelijk: één model, één basis-URL, één taak en één startrepo-status.
Voor deze walkthrough draait DeepSeek V4 Flash via Atlas Cloud, dat een OpenAI-compatibel eindpunt blootstelt dat door beide tools wordt geaccepteerd. De deepseek-v4-flash-0731 vermelding toont $0,14 per miljoen invoertokens, $0,28 per miljoen uitvoertokens, een contextvenster van 1.048.576 tokens en maximaal 393.216 uitvoer per augustus 2026. Elke provider werkt als beide harnassen hetzelfde eindpunt en model-id gebruiken.
OpenCode publiceert ook geaggregeerde gebruiksgegevens. DeepSeek-modellen hebben 233 biljoen tokens verplaatst via OpenCode, waarbij V4 Flash 85,5% voor zijn rekening neemt en V4 Pro 14,5% (OpenCode, augustus 2026). Dat gebruikspatroon maakt V4 Flash een praktische standaard voor de vergelijking.
Stap 1: Richt beide tools op hetzelfde model
Maak één API-sleutel en één basis-URL, en voer beide tools dezelfde combinatie. Maak de sleutel aan in de Atlas Cloud-console en exporteer deze eenmalig:
plaintext1export ATLAS_API_KEY="your-api-key" 2
Controleer het eindpunt voordat je het aan een van de harnassen geeft:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
Die aanroep bewijst dat de route, sleutel en model-id werken voordat een harnas tools, herhalingen of gespreksreplay toevoegt.
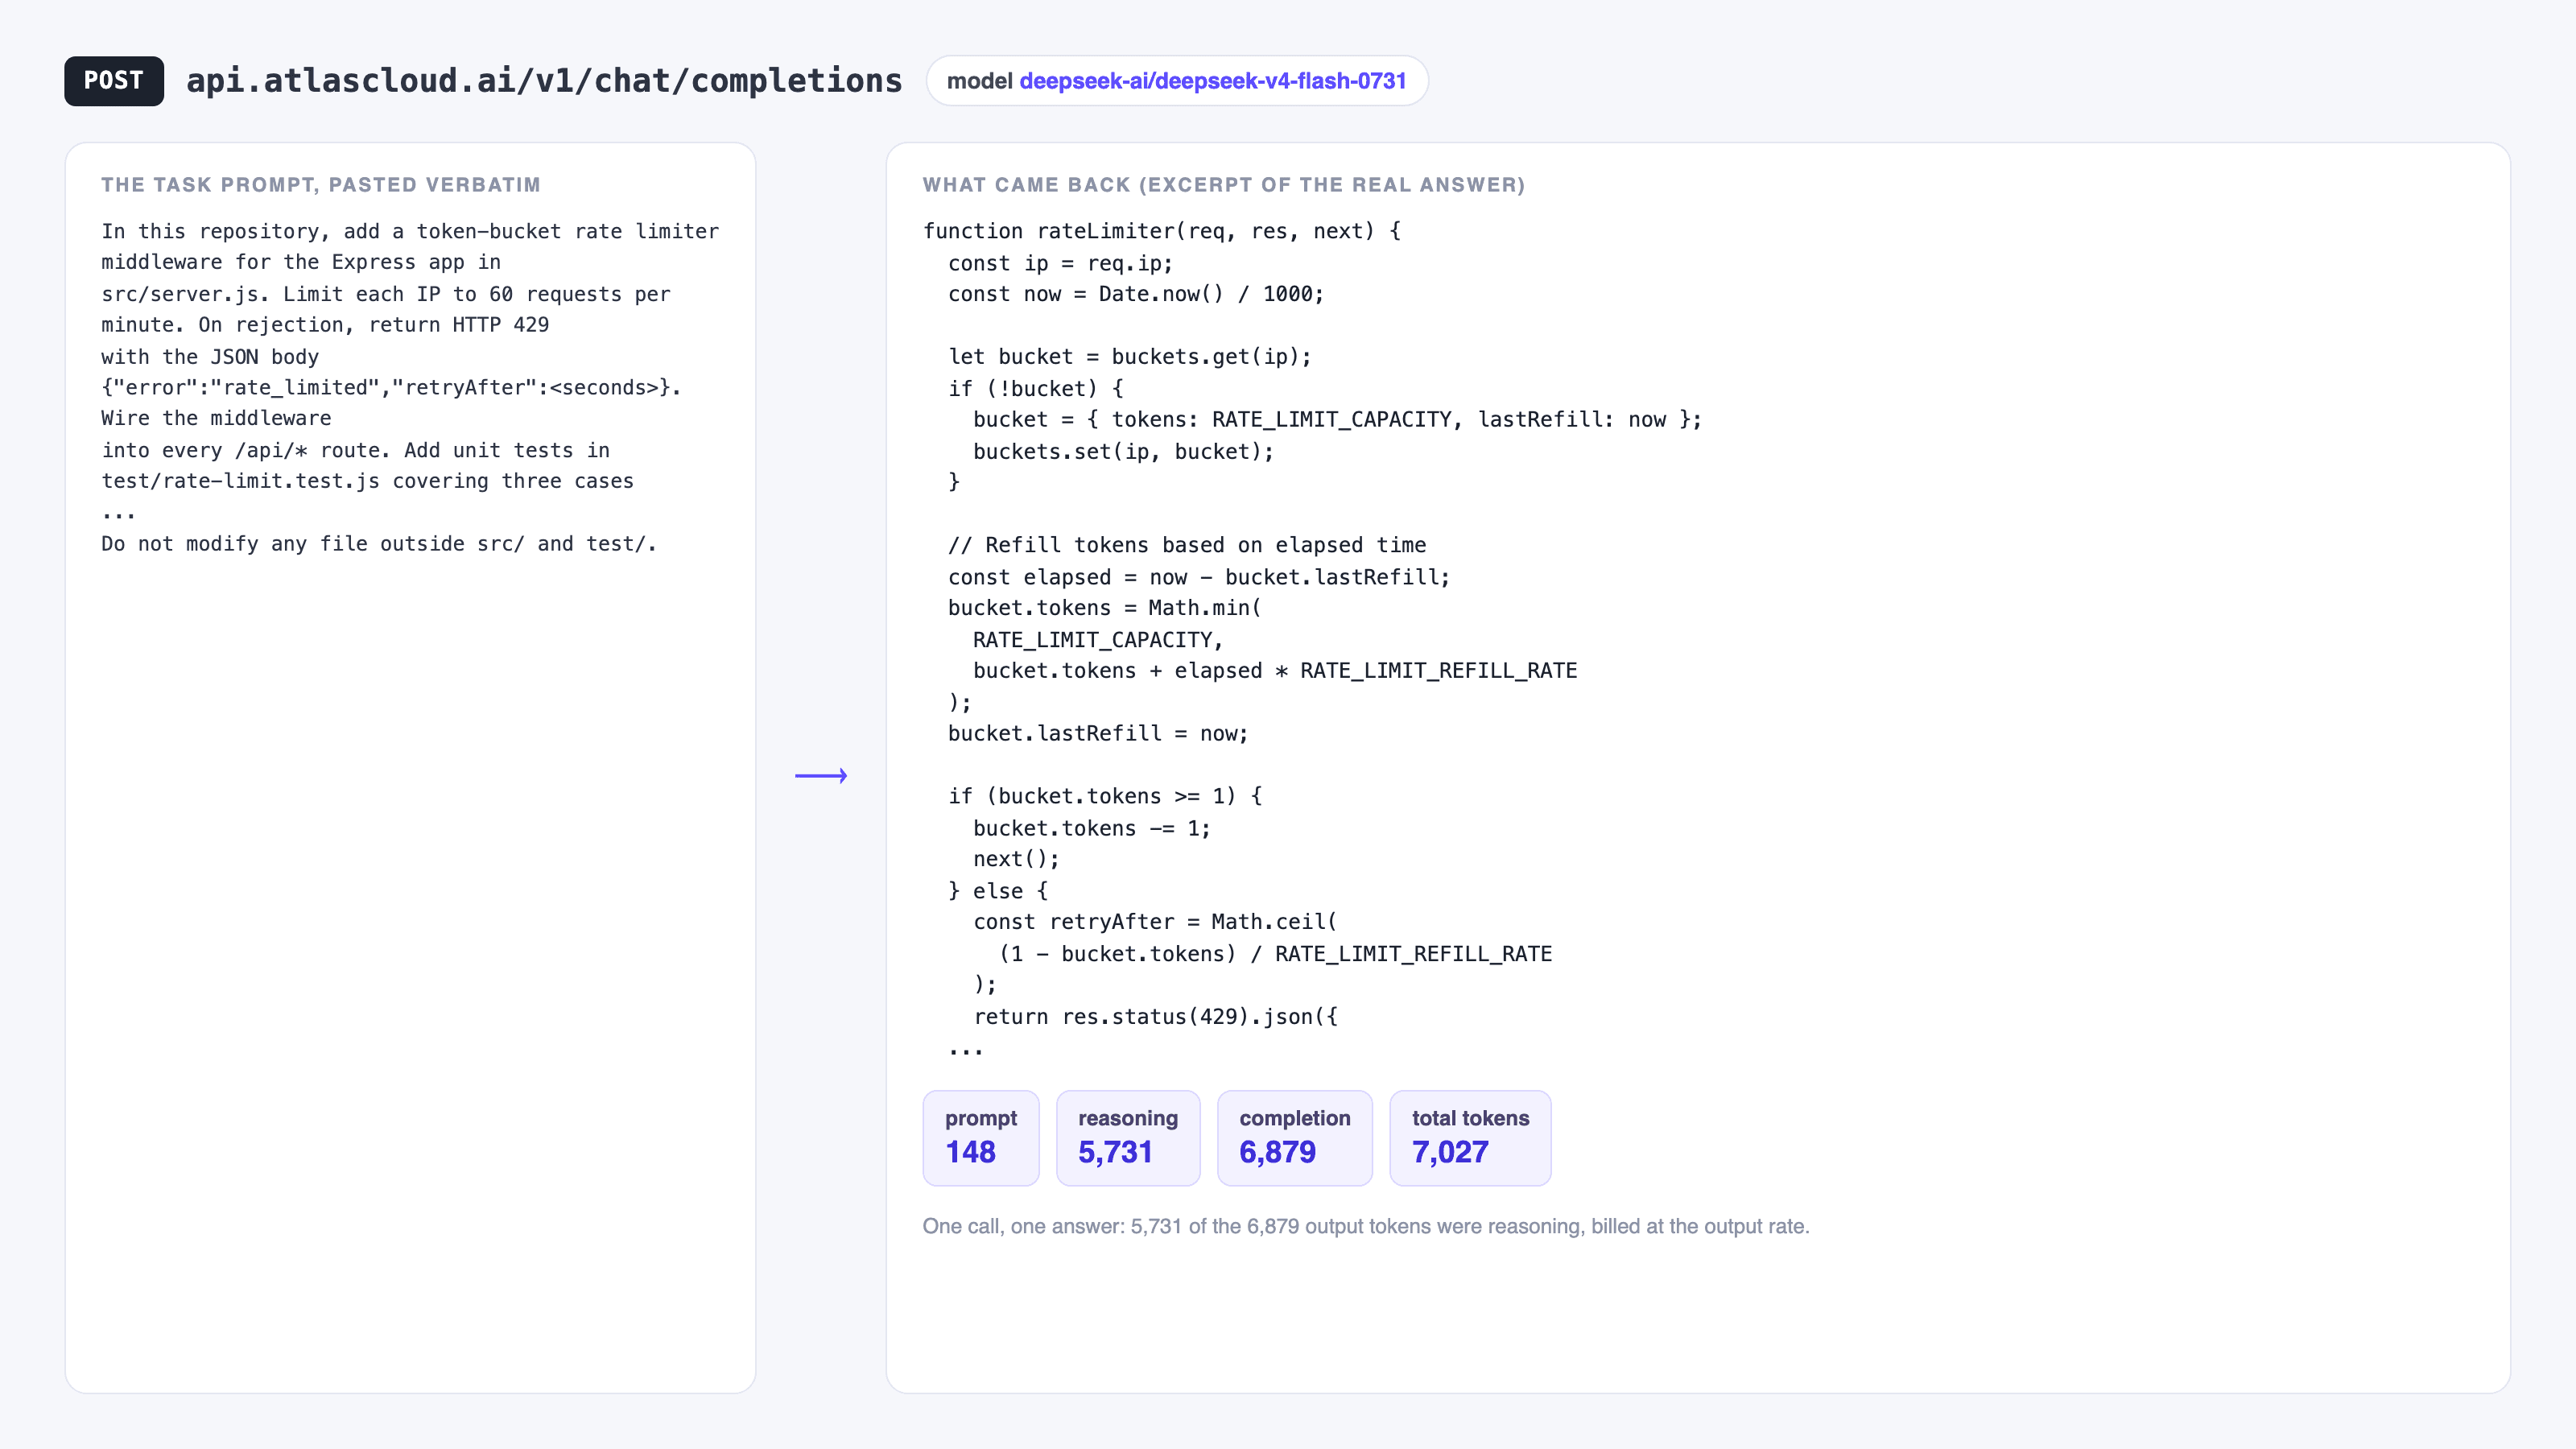
Codeerprompt, gegenereerde code en tokenstatistieken van één modelaanroep
Eén directe aanroep naar deepseek-ai/deepseek-v4-flash-0731: 148 prompttokens in, 6.879 uitvoertokens terug, inclusief 5.731 redeneertokens. Beschouw dat als de vloer voordat een harnas toolschema's en geschiedenis toevoegt.
DeepSeek Harness leest $DSH_HOME/settings.yaml, en aangepaste OpenAI-compatibele providers vallen onder de llm-pi-ai plugin (DeepSeek Harness docs, augustus 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Gebruik openai-completions voor dit eindpunt. De web-UI kan hetzelfde providerblok schrijven via Instellingen, Modellen, Aangepaste provider toevoegen, en sla de sleutel op in $DSH_HOME/.credentials.yaml.
OpenCode leest opencode.json in de projectroot of globale configuratiemap (OpenCode docs, augustus 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Gebruik @ai-sdk/openai-compatible, omdat dit eindpunt /v1/chat/completions bedient. Stel de echte context- en uitvoerlimieten in. OpenCode gebruikt ze wanneer het beslist wanneer te samenvatten, en verkeerde limieten kunnen de tokenvergelijking verstoren.
Stap 2: Voer dezelfde benchmarktaak uit in DeepSeek Harness
Kies een taak die groot genoeg is om meerdere toolaanroepen te vereisen en klein genoeg om te beoordelen. Gebruik dezelfde repo-status voor beide runs, dus commit of stash voordat je begint.
Plak deze exacte taak in beide tools:
plaintext1In this repository, add a token-bucket rate limiter middleware for the Express 2app in src/server.js. Limit each IP to 60 requests per minute. On rejection, 3return HTTP 429 with the JSON body {"error":"rate_limited","retryAfter":<seconds>}. 4Wire the middleware into every /api/* route. Add unit tests in 5test/rate-limit.test.js covering three cases: a request under the limit is 6allowed, a request over the limit is blocked with 429, and the counter resets 7after the window expires. Run the test suite and fix failures until it passes. 8Do not modify any file outside src/ and test/. 9
Start Harness vanuit je projectmap:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
De UI draait op http://127.0.0.1:3080. Selecteer de atlas provider en het deepseek-ai/deepseek-v4-flash-0731 model, plak de taak en laat het voltooien. Voeg geen hints toe nadat de run is gestart. Extra hulp voor één tool maakt de vergelijking ongeldig.
Wanneer Harness klaar is, open je de Trajectory-weergave. Dat sessierecord bevat de tokennummers.
Stap 3: Herhaal de run in OpenCode
Zet de repo terug naar de exacte startstatus. Het tweede harnas mag geen bestanden erven die het eerste al heeft gewijzigd.
plaintext1git checkout -- . && git clean -fd 2
Voer vervolgens OpenCode uit met hetzelfde model:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Plak dezelfde taakprompt uit Stap 2. Gebruik de standaard build agent. Laat het zonder hints voltooien.
Beoordeel beide runs met hetzelfde commando:
plaintext1npm test 2
Een run die de suite rood achterlaat, faalt, zelfs als de agentsamenvatting zelfverzekerd klinkt. Gebruik binaire beoordeling: geslaagd of mislukt.
Stap 4: Lees het tokenverbruik
Beide tools houden gebruik bij, maar geen enkele teller zou je definitieve factuurnummer moeten zijn.
DeepSeek Harness levert een tokenmeter die standaard is gemonteerd. Het stelt tokenUsage, contextPressure en contextBreakdown bloot in de Trajectory-weergave. contextBreakdown vertelt je of de rekening kwam van systeemprompt, toolschema's, bestandsleesacties of gespreksreplay. De meter schat ruwweg één token per vier tekens, dus gebruik het als een diagnostische weergave.
OpenCode houdt tokens en kosten per sessie bij en toont ze in de TUI-statusregel. De ingebouwde uitsplitsing is kleiner, dus teams die per-tool-attributie nodig hebben, inspecteren vaak de sessiedatabase met externe analyzers.
Gebruik provider-side cijfers voor de vergelijking:
| Wat te vergelijken | Waar het te krijgen |
|---|---|
| Totaal invoertokens | Providergebruikdashboard, per API-sleutel |
| Totaal uitvoertokens | Providergebruikdashboard, per API-sleutel |
| Aantal modelaanroepen | Harnas trajectweergave / OpenCode sessielogboek |
| Wandkloktijd | Stopwatch, start tot laatste bestandsschrijf |
| Geslaagd of mislukt | npm test exitcode |
Maak twee API-sleutels aan, harness-test en opencode-test, en gebruik elke sleutel voor één run. Het providerdashboard geeft je dan schone naast-elkaar-gebruik zonder twee interne schatters te reconciliëren.
Waarom de rekening beweegt
Tokenverbruik verandert om concrete redenen. Deze vijf zijn meestal belangrijker dan de modelprijs.
Gespreksreplay telt op. Agents sturen het groeiende gesprek opnieuw bij elke stap. Een taak van 40 stappen kost dichter bij de som van 40 groeiende prompts dan 40 identieke prompts. Harnassen die vroeg samenvatten, komen dichter bij de lage kant van de benchmarkspreiding.
Cachehits verlagen invoerkosten. DeepSeek V4 Flash cachehits kosten ongeveer $0,0028 per miljoen tokens tegenover $0,14 per miljoen bij een misser, ruwweg 98% goedkoper. Caching heeft een byte-voor-byte stabiel voorvoegsel nodig. Als een harnas systeemprompttekst tussen aanroepen door elkaar schudt, verandert het hits in missers.
Toolschema's rijden mee. Twintig verbonden MCP-servers betekenen twintig schemasets in de prompt, zelfs als de taak er twee gebruikt. Koppel tools los die je niet nodig hebt voordat je benchmarkt, anders meet je je toolsetup in plaats van het harnas.
Grote tooluitvoer vergiftigt context. Een cat van een bestand van 3.000 regels of een uitvoerige failing testlog blijft in het gesprek voor latere aanroepen. DeepSeek Harness kan grote toolresultaten snoeien voordat het samenvat. Zet dat aan wanneer de taak lawaaierige uitvoer produceert.
Herhalingen verbergen zich in het aantal aanroepen. Een harnas dat een failing testloop opnieuw probeert, besteedt elke keer tokens. Vergelijk modelaanroepen naast totale tokens, zodat je een herhalingslus kunt scheiden van een dure prompt.
Tegen het Atlas Cloud-tarief voor DeepSeek V4 Flash valt een taak van 692.000 tokens, overwegend invoer, in de lage enkelcijferige centen. Dat is klein voor één run en groot voor een team dat de hele dag agents draait. Blader door de volledige modelcatalogus als je de test op een tweede model wilt herhalen en modeleffecten van harnaseffecten wilt scheiden.
DeepSeek Harness is nog een ontwikkelaarspreview, en de README waarschuwt voor breaking changes. Benchmark het als je controle over de agentloop wilt. Standaardiseer er alleen op als je team churn kan absorberen. OpenCode is de stabielere keuze voor teams die vandaag een tool nodig hebben.
Veelgestelde vragen
Is DeepSeek Harness beter dan OpenCode?
Nog niet voor de meeste teams. OpenCode is volwassen, terminal-native, heeft ongeveer 198k sterren en een grote providercatalogus, en het werkt vandaag. DeepSeek Harness is nieuwer, in ontwikkelaarspreview en waarschuwt voor breaking changes. Kies Harness als je agentinterne aanpassingen wilt doen. Kies OpenCode als je een codeeragent voor dagelijks werk wilt.
Werkt DeepSeek Harness alleen met DeepSeek-modellen?
Nee. Het is model-agnostisch. Het levert catalogusproviders voor DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure en Codex, en je kunt elke aangepaste provider toevoegen die openai-completions, openai-responses of anthropic-messages spreekt in $DSH_HOME/settings.yaml. De configuratie uit Stap 1 wijst het naar een OpenAI-compatibel eindpunt zonder adaptercode.
Hoe controleer ik het tokenverbruik van DeepSeek Harness?
Gebruik de ingebouwde tokenmeter in de Trajectory-weergave. Het stelt tokenUsage, contextPressure en contextBreakdown bloot. Beschouw het als een schatting omdat het ruwweg één token per vier tekens gebruikt. Voor factuurnauwkeurigheid lees je het providergebruikdashboard, idealiter met een speciale API-sleutel voor elke run.
Welk harnas gebruikt minder tokens, DeepSeek Harness of OpenCode?
Geen publieke directe benchmark beantwoordt dat nog. De Composio-benchmark mat OpenCode op 692.000 gemiddelde tokens per taak, maar die liep voordat DeepSeek Harness werd uitgebracht. Voer de test uit Stap 2 tot en met Stap 4 uit op je eigen repo, omdat tokenverbruik afhangt van codebasegrootte, toolsetup en taakvorm.
Kan ik DeepSeek Harness en OpenCode tegen dezelfde API-sleutel laten draaien?
Ja, voor een casual test. Gebruik voor een schone meting twee aparte sleutels, één per harnas. Het providerdashboard schrijft dan elke token toe aan de juiste run.
Wat is het verschil tussen een agent en een harnas?
DeepSeek beschrijft een agent als Model plus Harnas. Het model redeneert. Het harnas verbindt het model met bestanden, shell-commando's, tools, sessies, goedkeuringen en de loop die de volgende actie bepaalt. Verander het harnas en hetzelfde model kan een ander aantal tokens besteden aan dezelfde taak.


