

Een projectarchief van 900 pagina's is eenvoudig te uploaden. De moeilijkere vraag is of het model de exacte clausule, commit of datapunt kan aanwijzen die je nodig hebt. DeepSeek V4.1 Flash gebruiksscenario's voor een 1M-contextvenster zijn zinvol wanneer verschillende gerelateerde bronnen samen moeten worden bekeken, zoals een codebase, een onderzoekscorpus of jaren aan projectgegevens. Het grotere venster vermindert de noodzaak om die materialen vooraf op te splitsen, terwijl bewijscontroles nog steeds bepalen of een antwoord betrouwbaar is.
De beste toepassingen zijn cross-file code review, onderzoekssynthese, beleidsvergelijking, feedbackanalyse, projecttijdlijnen en lange multimodale gegevens. DeepSeek vermeldt een context van 1M tokens, maar die capaciteit is geen garantie dat elk detail nauwkeurig wordt herinnerd. Controleer de model- en API-limieten voor jouw route en test je eigen materiaal voordat je op het resultaat vertrouwt.
Belangrijkste inzichten
- Gebruik een venster van een miljoen tokens wanneer de vraag afhangt van relaties tussen veel relevante bronnen.
- Vraag om bestands-, sectie- of paginareferenties en scheid direct bewijs van gevolgtrekkingen.
- Begin met een test met bekend antwoord en breid de context alleen uit wanneer dat het resultaat verbetert.
- Schat kosten in op basis van invoer, uitvoer en cachebehandeling, niet alleen op basis van de contextlimiet.
Wat betekent een contextvenster van 1M tokens?
Een contextvenster is de hoeveelheid informatie die een model in één verzoek of gespreksstatus kan beschouwen, inclusief aangeleverd materiaal en de omliggende instructies. De huidige API-prijspagina van DeepSeek vermeldt DeepSeek-V4.1-Flash met een contextlengte van 1M en een maximale uitvoer van 384K tokens. Dat is de door de provider opgegeven limiet; jouw applicatie, endpoint of verzoekconfiguratie kan een kleinere limiet opleggen. ( DeepSeek API-documentatie )
Tokens zijn stukjes tekst, geen woorden of pagina's. Een bronarchief met code, tabellen, markup, herhaalde boilerplate en scans kan heel anders tokenizen dan schone proza met hetzelfde aantal pagina's. Schat voor een echte workload tokens met de tokenizer of gebruiksrapportage van de API die je gaat aanroepen. Neem systeeminstructies, bestandsnamen, metadata, vraagtekst en het antwoordbudget op in je schatting.
Het praktische voordeel is continuïteit. Je kunt vragen naar afhankelijkheden tussen verschillende modules of tegenstrijdigheden tussen een actueel beleid en de bijlagen, zonder eerst handmatig samenvattingen aan elkaar te knopen. De afweging is dat een zeer grote prompt irrelevante of gedupliceerde inhoud kan bevatten, langer kan duren om te verwerken en exacte retrieval nog steeds moeilijker kan maken. Behandel "past in het venster" als een capaciteitscontrole en test daarna of het model de feiten kan vinden die je taak nodig heeft.
De beste gebruiksscenario's voor het 1M-contextvenster van DeepSeek V4.1 Flash
De juiste vraag is niet "Kan ik alles uploaden?" Maar "Welke bronnen moeten worden vergeleken om dit te beantwoorden?" Gebruik een lange context wanneer het antwoord afhangt van verbanden tussen materialen, en bepaal hoe je dat antwoord gaat verifiëren voordat je het volledige archief verstuurt.
| Gebruiksscenario | Waarom een lange context helpt | Wat op te nemen | Wat te verifiëren |
|---|---|---|---|
| Beoordeling van grote codebase | Interfaces en conventies beslaan meerdere modules | Relevante broncode, tests, architectuurnotities | Bestandspaden, symbolen, testbewijs |
| Onderzoekssynthese | Methoden en bevindingen moeten naast elkaar worden vergeleken | Papers, rapporten, beperkingen | Bron en kanttekeningen van elke claim |
| Vergelijking van contracten of beleid | Definities en uitzonderingen komen in meerdere secties terug | Huidige en eerdere versies, bijlagen | Clausulenummers en exacte formulering |
| Feedbackanalyse | Thema's komen in veel opmerkingen voor | Gede-identificeerde feedback en coderingsregels | Representatieve citaten en telmethode |
| Tijdlijn van projectgeschiedenis | Beslissingen ontwikkelen zich door vergaderverslagen | Notulen, beslissingslogs, release notes | Datums, eigenaren, conflicterende gegevens |
| Langdurige incidentreview | Logs, tickets en postmortems verklaren verschillende fasen | Relevant tijdsbereik en incidentdocumenten | Tijdstempel, gebeurtenisbron, onzekerheid |
| Multimodale documentbeoordeling | Tekst en visueel bewijs moeten mogelijk samen worden gelezen | Ondersteunde afbeeldingen en hun bijschriften of context | Of het endpoint het mediatype ondersteunt |
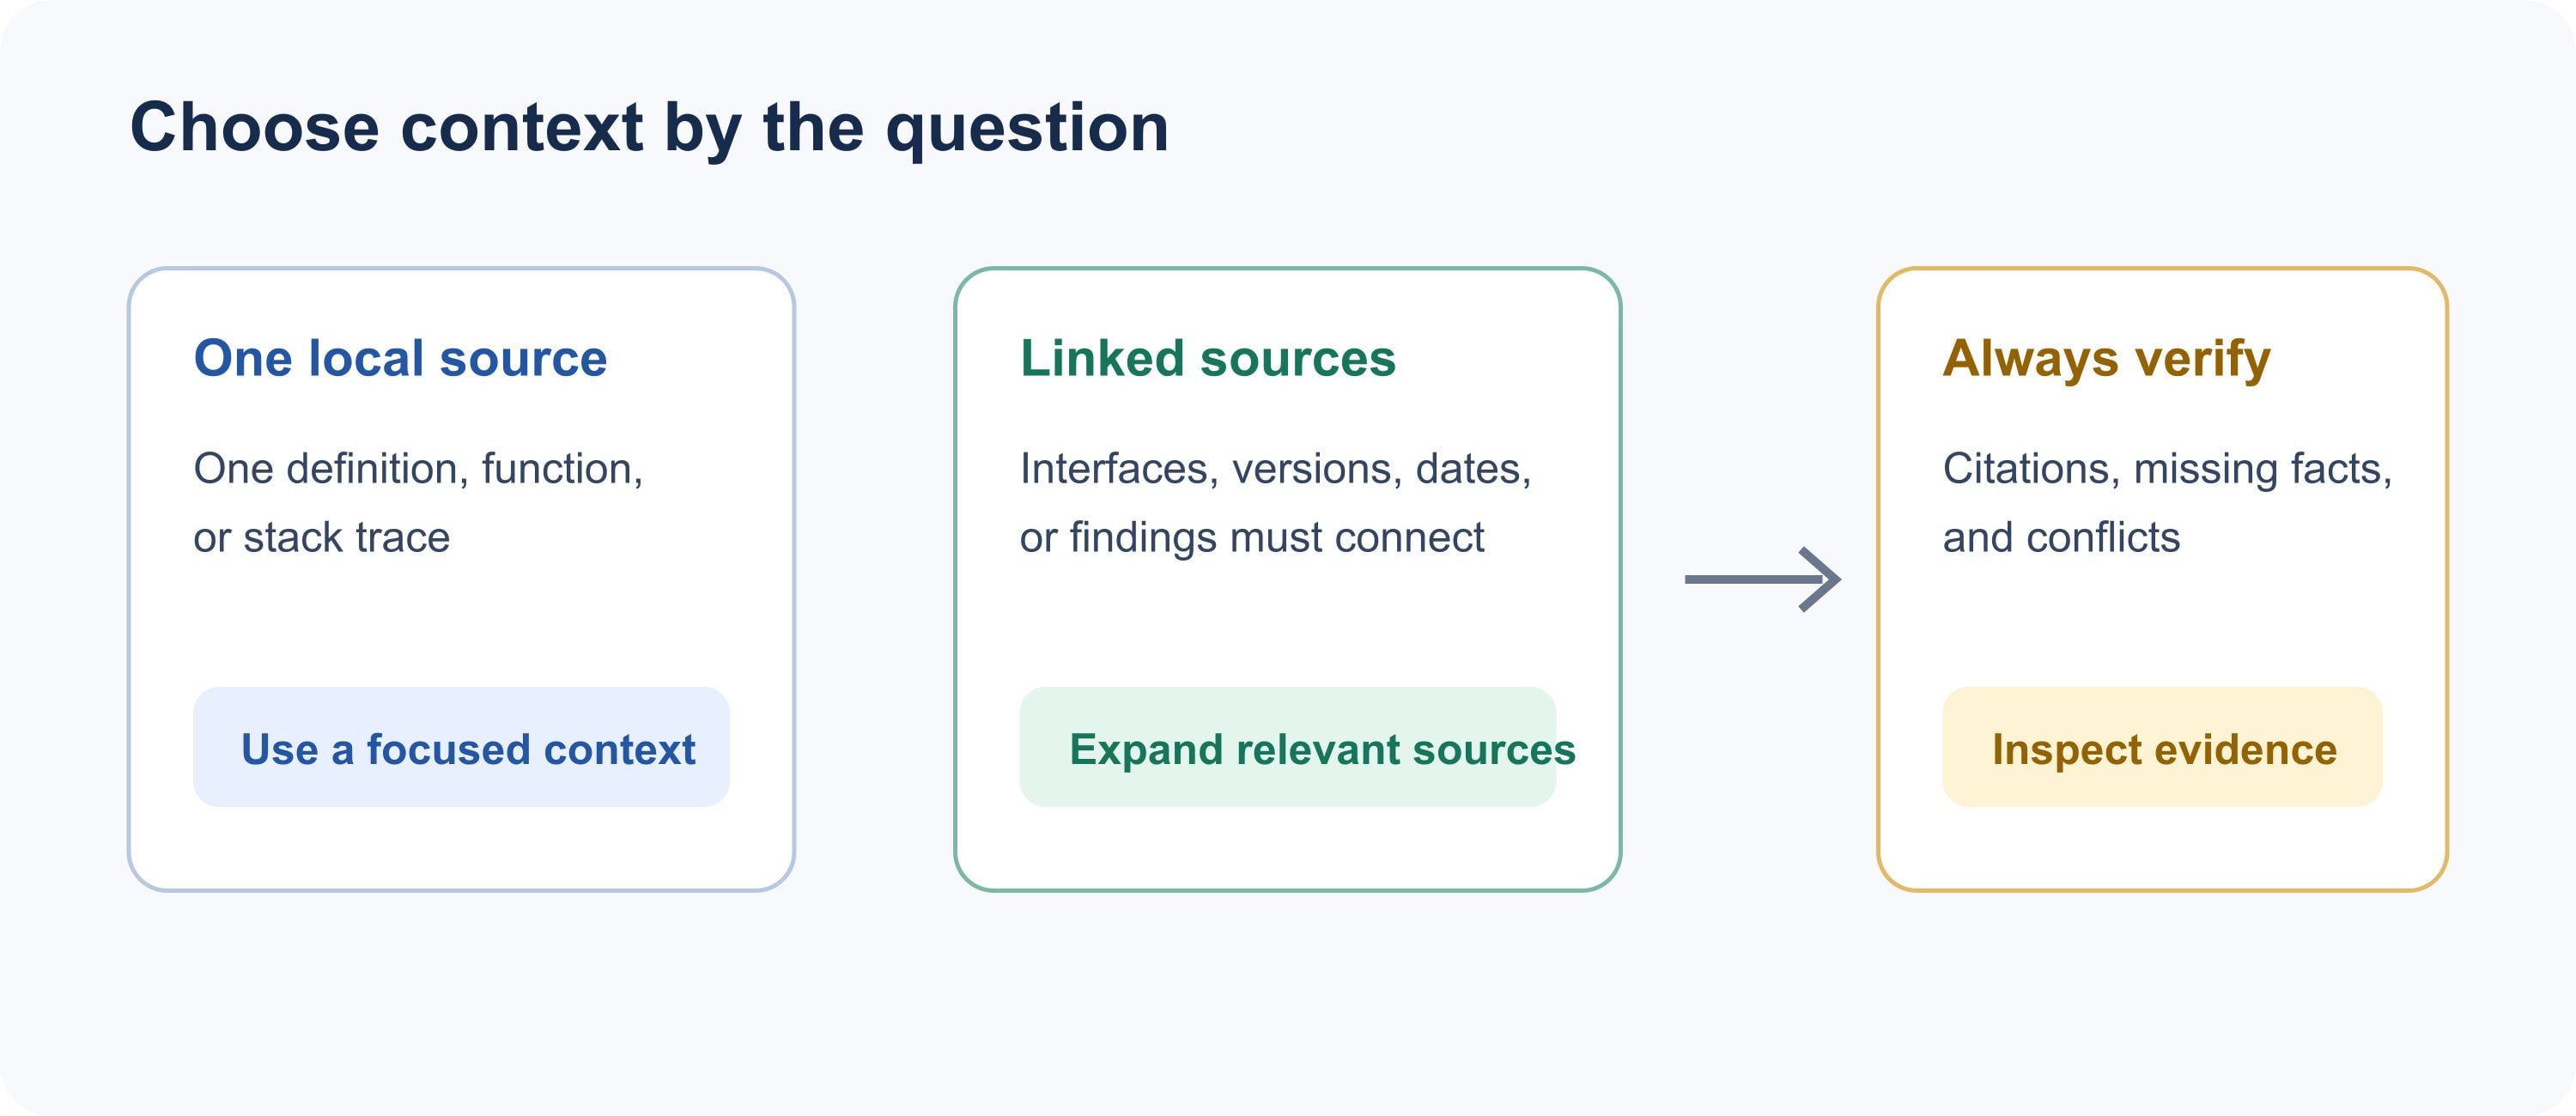
Gebruik een gerichte context voor een lokale vraag; breid uit wanneer bronnen met elkaar verbonden moeten worden en inspecteer vervolgens het bewijs.
Een grote codebase over meerdere bestanden beoordelen
Een context van een miljoen tokens kan een engineer helpen een datastructuur te volgen vanaf een API-grens via servicelogica, opslag en tests. Het is nuttig voor architectuursamenvattingen, het vinden van waarschijnlijk getroffen modules en het opstellen van een refactoringplan dat rekening houdt met conventies die op meerdere plaatsen zijn gedocumenteerd.
Geef het model een afgebakende repository-snapshot in plaats van een ongefilterde dump van de schijf. Neem bronbestanden op die relevant zijn voor de wijziging, de dichtstbijzijnde tests, dependency-manifests en architectuurnotities. Sluit buildoutputs, vendored dependencies, gegenereerde bundles en duplicaten uit, tenzij de vraag daarover gaat. Vraag om bestandspaden en symboolnamen voor elke voorgestelde afhankelijkheid, plus een onderscheid tussen waargenomen gedrag en een aanname.
Gebruik de uitvoer als een reviewplan. Controleer of elk genoemd symbool bestaat, inspecteer de genoemde regels en voer de checks van het project zelf uit. Het model mag niet beweren dat tests zijn geslaagd, tenzij een tool ze daadwerkelijk heeft uitgevoerd en het resultaat heeft teruggegeven. Voor een gelokaliseerde bug in één functie is een kleinere context vaak sneller en eenvoudiger te controleren.
Onderzoek synthetiseren over papers en rapporten
Een lange context helpt wanneer studies verschillende methoden, populaties, metingen of definities gebruiken. Vraag om een vergelijkingstabel met één rij per bron en kolommen voor onderzoeksvraag, data, methode, resultaat, beperkingen en relevantie voor jouw vraag. Houd claims op bronniveau gekoppeld aan hun bron in plaats van een samengevoegde samenvatting meningsverschillen te laten uitwissen.
Als je bijvoorbeeld evaluaties van een tool vergelijkt, onderscheid dan een benchmarkresultaat van een veldstudie en van de interpretatie van een auteur. Vraag het model om incompatibele metingen te markeren in plaats van resultaten te rangschikken die niet kunnen worden vergeleken. Open vervolgens de bronpassages achter de meest beslissingsrelevante claims. Een synthese is een kaart van bewijs, geen vervanging voor het controleren van de papers.
Lange contracten, beleidsregels of specificaties vergelijken
Contracten en beleidsregels definiëren een term vaak één keer en kwalificeren die elders. Het samen aanleveren van de geldende versie, amendementen, bijlagen en een relevant ouder concept kan helpen om gewijzigde definities, kruisverwijzingen, ontbrekende voorwaarden en schijnbare conflicten aan het licht te brengen.
Vraag voor elke observatie om de exacte sectie of clausule en een kort fragment dat een reviewer kan terugvinden. Scheid tekstuele verschillen van de mogelijke gevolgen ervan. Het model kan helpen een review te organiseren, maar juridische interpretatie, compliancebeslissingen en tekenbevoegdheid blijven bij gekwalificeerde mensen die rekening kunnen houden met jurisdictie en context.
Klantfeedback op schaal analyseren
Een grote hoeveelheid feedback kan terugkerende verzoeken en bezwaren over kanalen of tijdsperioden onthullen. Lever een afgebakende steekproef aan, verwijder persoonlijke informatie die niet nodig is en specificeer een coderingsschema zoals "onboardingfrictie", "ontbrekende integratie" of "prijsverwarring". Vraag om representatieve voorbeelden en tegenvoorbeelden, niet alleen een lijst met thema's.
Presenteer door het model gegenereerde themapercentages niet als enquêtestatistieken. Als je aantallen nodig hebt, definieer dan de eenheid (bericht, klant of issue), dedupliceer records, pas een consistente labelregel toe en verifieer het aantal met een herhaalbaar script of een door mensen beoordeelde steekproef. Het model is nuttig voor het voorstellen van categorieën en het vinden van voorbeelden; een gedocumenteerde methode ondersteunt kwantitatieve claims.
Een tijdlijn opbouwen uit projectdocumenten
Voor een overdracht of postmortem kan het relevante bewijs verspreid zijn over notulen, release notes, beslissingslogs en tickets. Vraag om een chronologische tabel met datum, gebeurtenis, genoemde eigenaar waar vermeld, bronlocatie en zekerheid of ambiguïteit. Instrueer het model om conflicterende datums te behouden in plaats van stilzwijgend één datum te kiezen.
Een nuttige tijdlijn helpt een nieuwe teamgenoot te zien wat is besloten, wanneer een vereiste is gewijzigd en welk document elke gebeurtenis ondersteunt. Verifieer kritieke overgangen aan de hand van het bronrecord, vooral wanneer een notitie later is geschreven of een vergadering samenvat in plaats van die rechtstreeks vast te leggen.
Lange incidentregistraties en multimodaal materiaal beoordelen
Incidentreview kan profiteren van het samenbrengen van alerts, operationele notities, tickets en de postmortem in één bewijsset. Vraag om een reeks waargenomen gebeurtenissen en onderscheid expliciet tijdstempels in logs van latere schattingen in narratieve notities. Dit kan de eerste ronde coherent maken, terwijl de on-call engineer nog steeds bronsystemen controleert voordat actie wordt ondernomen.
De officiële aankondiging van DeepSeek zegt dat V4.1-Flash live is op de API met native multimodale ondersteuning. De exacte afbeeldingsformaten, aanvraagmethoden en limieten hangen af van het endpoint en de integratie, dus bevestig die details voordat je aanneemt dat een tekstbudget van een miljoen tokens ook de beeldverwerking beschrijft. ( DeepSeek V4.1-Flash-aankondiging )
Wanneer helpt een miljoen tokens, en wanneer voegt het ruis toe?
Meer context helpt wanneer bronnen onderling moeten worden verwezen. Een codewijziging met een gedeelde interface kan meerdere modules en tests vereisen. Een versievergelijking heeft beide volledige versies en hun bijlagen nodig. Een projecttijdlijn kan gegevens nodig hebben die over maanden zijn verspreid.
Een lokale bug met een duidelijke stacktrace heeft mogelijk alleen de functie, de aanroepers en de relevante test nodig. Een vraag die om één definitie vraagt, heeft mogelijk alleen de gezaghebbende sectie nodig. Voor die taken voegt het opnemen van een volledige repository zoekruimte toe en kan de nuttige passage worden verborgen.
Voordat je de prompt uitbreidt, verwijder je herhaalde exports, verouderde concepten, niet-gerelateerde mappen, boilerplate en records buiten het tijdsbereik van de vraag. Houd een manifest bij van wat je hebt opgenomen en waarom. Als het antwoord verandert wanneer je een grote batch niet-gerelateerde bestanden toevoegt, is dat een signaal om de bronselectie aan te scherpen en de test opnieuw uit te voeren.
Een praktische workflow voor betrouwbare antwoorden met lange context
Gebruik een consistent bewijsprotocol zodat een vloeiend antwoord niet wordt aangezien voor een geverifieerd antwoord. Label eerst de bronnen met stabiele bestandsnamen en, waar mogelijk, paginanummers, koppen, regelnummers, datums of versie-identificatoren. Bewaar voldoende omringende context om fragmenten correct te interpreteren.
Formuleer vervolgens één beslissing of onderzoeksvraag. Specificeer de vorm van de uitvoer en de locaties die het model moet citeren. Een herbruikbare prompt is:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Voor een codebase voeg je toe: "Citeer repositorypaden en functie- of klassennamen. Noem voordat je een wijziging voorstelt de getroffen bestanden en het testbewijs dat het voorstel ondersteunt. Zeg niet dat een test is uitgevoerd, tenzij het resultaat in het aangeleverde bewijs is opgenomen."
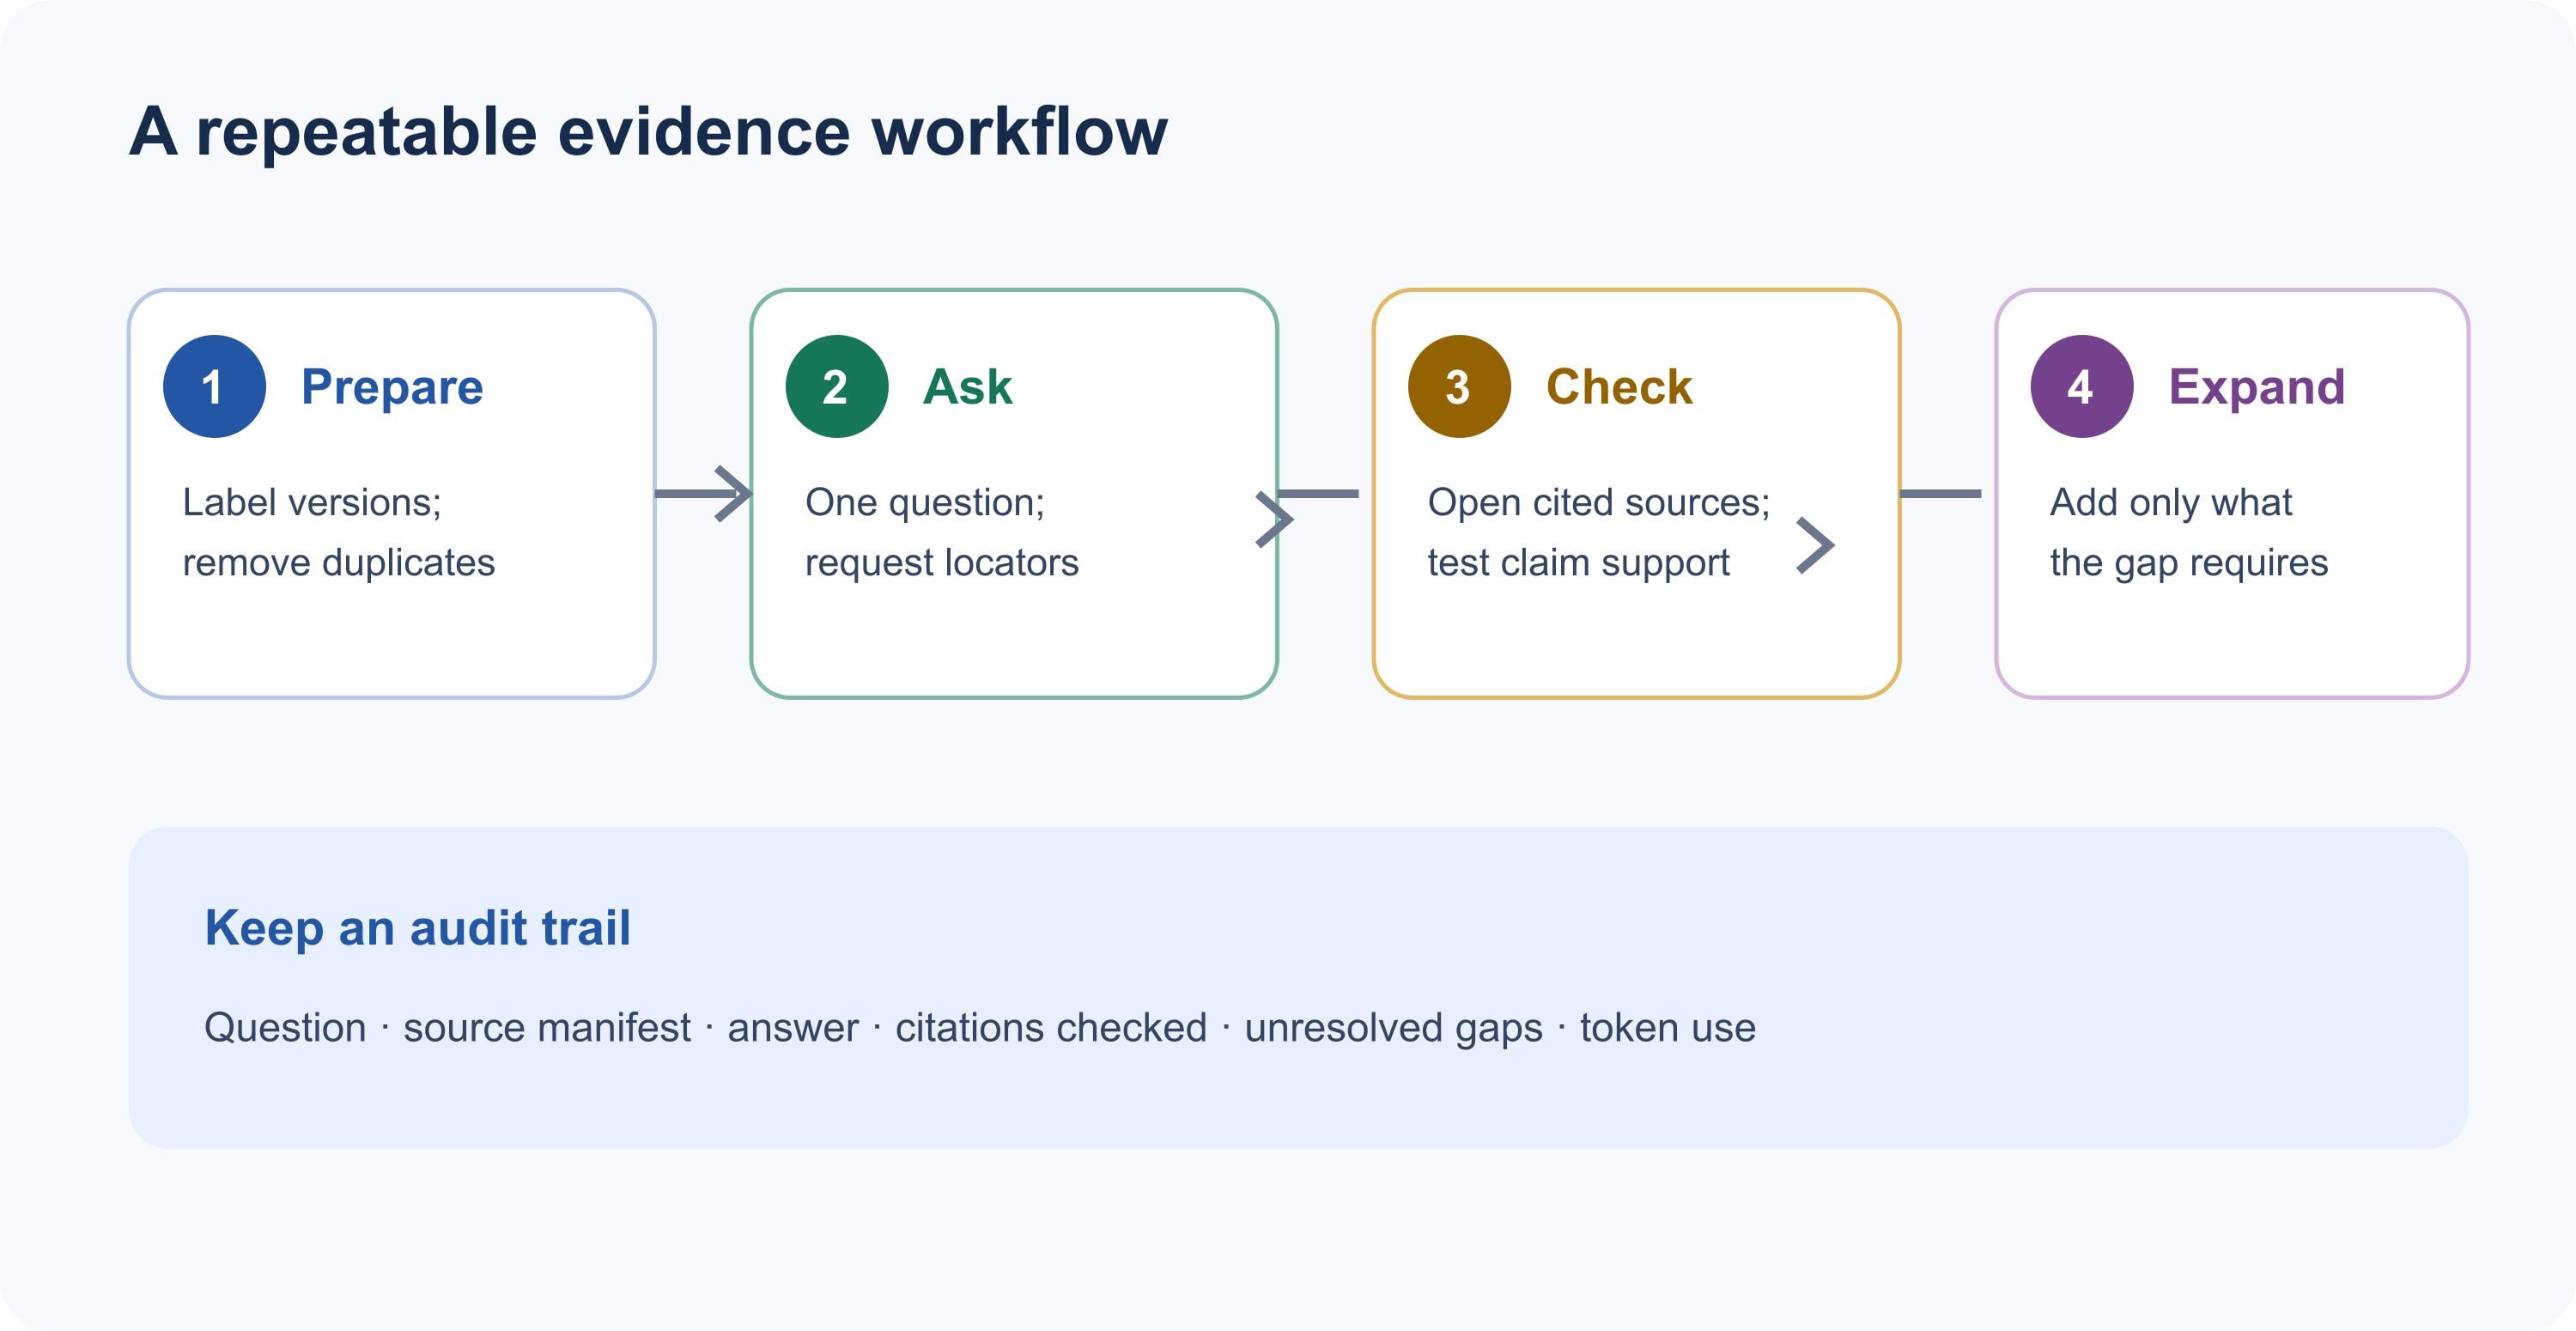
Bereid bronnen voor, stel een afgebakende vraag, controleer citaties en breid alleen uit om een hiaat op te lossen.
Inspecteer het antwoord daarna in drie rondes. Controleer of elke citatie naar een echte locatie verwijst. Controleer of de geciteerde passage de claim ondersteunt, in plaats van alleen het onderwerp te noemen. Beoordeel ten slotte weglatingen en conflicten door gerichte vervolgvragen te stellen tegen dezelfde bronselectie. Laat voor beslissingen met hoge inzet een gekwalificeerde reviewer de bron zelf rechtstreeks lezen.
Bewijskaart voor workflow met lange context
| Fase | Actie | Behouden | Stopsignaal |
|---|---|---|---|
| 1. Voorbereiden | Label, dedupliceer en bakende bronnen af | Bronmanifest en versies | Onbekende herkomst of verouderd duplicaat |
| 2. Vragen | Stel één vraag en een bewijsformaat in | Bestandsnamen en locators in het antwoord | Brede vraag zonder beslissingsdoel |
| 3. Controleren | Open geciteerde passages en vergelijk claims | Ondersteunde claims en expliciete hiaten | Citatie ondersteunt claim niet |
| 4. Uitbreiden | Voeg alleen bronnen toe die nodig zijn voor onopgeloste verbanden | Verbetering op checks met bekend antwoord | Meer invoer zonder beter bewijs |
Hoe je test of 1M-context nuttig is voor je taak
Maak een kleine evaluatieset voordat je het volledige archief laadt. Schrijf vragen waarvan je de antwoorden al kent uit het bronmateriaal. Zet sommige feiten bij het begin, sommige in het midden en sommige bij het einde. Voeg minstens één vraag toe die het verbinden van twee documenten vereist en één die niet kan worden beantwoord met de aangeleverde bronnen.
Voer dezelfde vragen eerst uit op een kleinere, relevante subset en vergroot de context daarna in afgemeten stappen. Registreer feitelijke correctheid, nauwkeurigheid van locators, gemist bewijs, niet-ondersteunde claims, weigering bij de onbeantwoordbare vraag, latentie en tokengebruik. Houd de prompt- en decoderingsinstellingen stabiel zodat wijzigingen interpreteerbaar zijn. Herhaal een vraag als de uitvoer materieel varieert tussen runs.
| Controle | Wat een geslaagd antwoord laat zien | Wat te doen na een fout |
|---|---|---|
| Bekend feit op vroege, middelste, late posities | Retrieval over de volledige bron | Controleer indexering, bestandslabels en promptlengte |
| Cross-documentverband | Bewijs kan over bronnen worden samengevoegd | Vraag om beide citaties en vernauw daarna de verbandvraag |
| Onbeantwoordbare vraag | Het model kan ontbrekend bewijs melden | Verscherp "gebruik alleen aangeleverde bronnen" en test opnieuw |
| Citatie-audit | Locator en fragment ondersteunen de claim | Behandel de claim als ongeverifieerd tot die is gecorrigeerd |
| Vergelijking met grotere context | Extra materiaal verbetert de doeltaak | Verwijder ruis als nauwkeurigheid of latentie verslechtert |
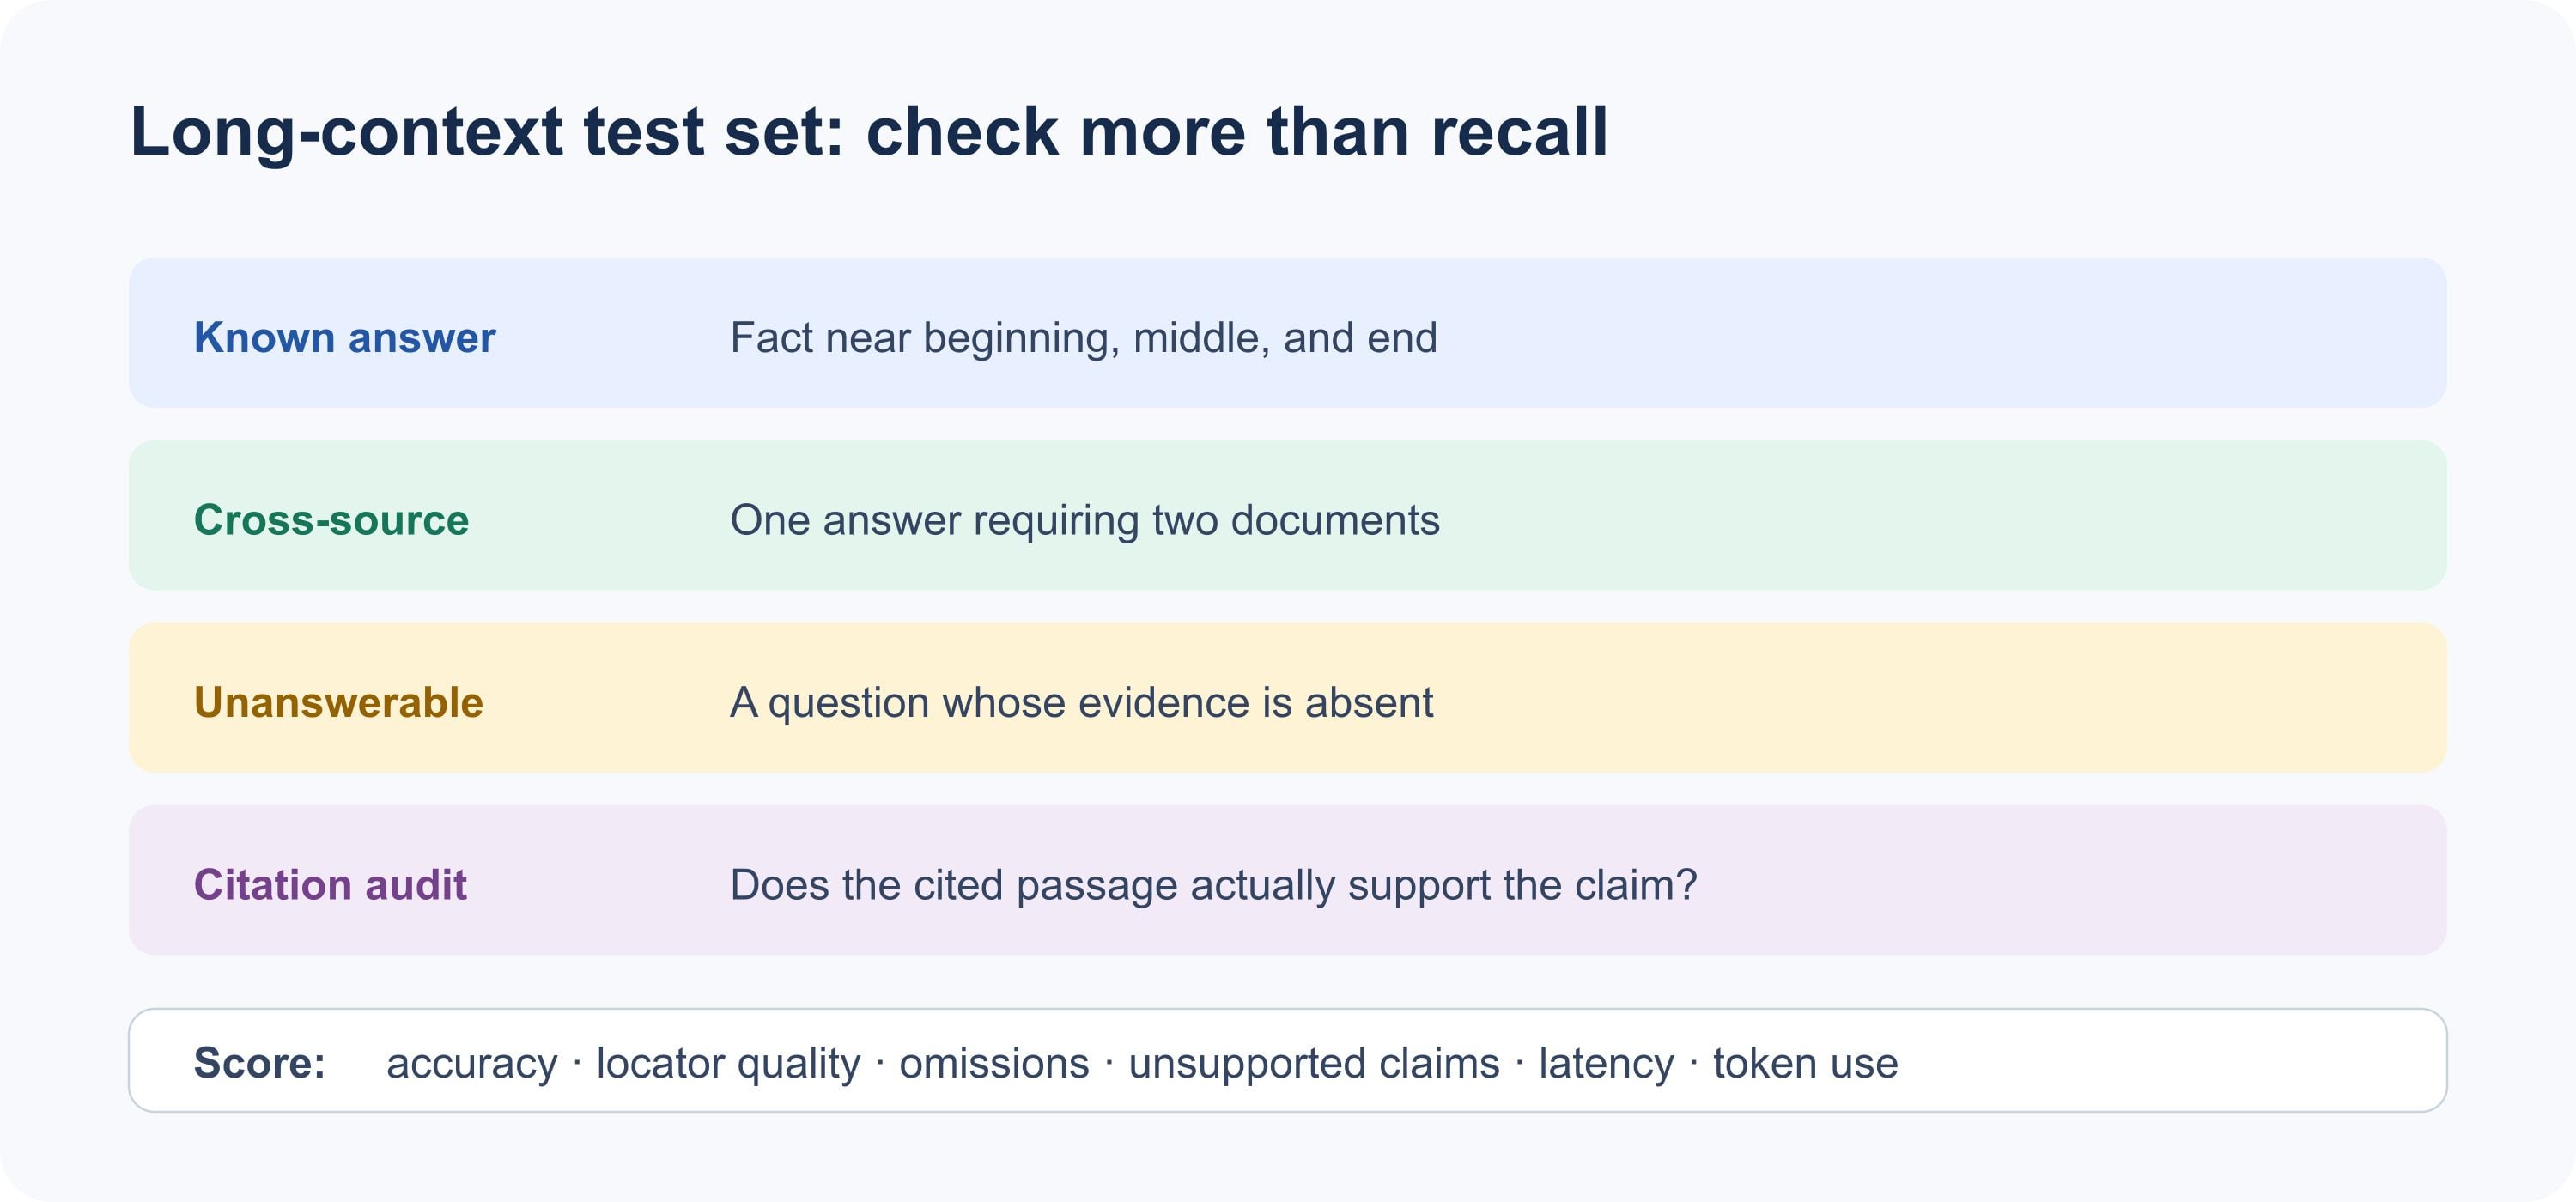
Scoor retrieval, citatieondersteuning, weglatingen, niet-ondersteunde claims, latentie en tokengebruik.
Communityrapporten zijn gemengd en taakafhankelijk. Eén Reddit-gebruiker deelde een harness-specifieke toename van misvormde toolargumenten bij grotere contextgroottes, terwijl commenters succesvol werk bij hogere tokenaantallen in andere setups beschreven. Dat is een goede reden om je eigen harness te benchmarken, geen bewijs voor een universele faaldrempel. ( DeepSeek-contextdiscussie op Reddit )
Een verstandige opschaling is: valideer de prompt op een kleine steekproef, voeg de brongroepen toe die nodig zijn voor cross-documentvragen en test daarna een representatief groot verzoek. Houd de kleinste context aan die de echte vraag beantwoordt met betrouwbaar bewijs. Dit maakt latentie- en kostenvergelijkingen ook eenvoudiger te interpreteren.
Prijzen en toegang voor DeepSeek V4.1 Flash API
Bij Atlas Cloud, toont de modellijst momenteel DeepSeek V4.1 Flash met een context van 1M en tarieven van $0.30 per miljoen invoertokens, $1.20 per miljoen uitvoertokens en $0.03 per miljoen cache-read-tokens. De vermelding toont geen korting voor dit model. Dit zijn tarieven van Atlas Cloud, verschillend van DeepSeek's eigen tijdsafhankelijke piek- en dalprijzen. Controleer de Atlas Cloud-modelcatalogus en modelprijzenpagina opnieuw voordat je publiceert of budgetteert, omdat tarieven kunnen veranderen.
Bij de vermelde tarieven kost een verzoek met 100.000 niet-gecachte invoertokens en 2.000 uitvoertokens ongeveer $0.03 voor invoer plus $0.0024 voor uitvoer, of $0.0324 in totaal vóór andere toepasselijke kosten. Als de invoer wordt gefactureerd als cache-reads, zouden 100.000 gecachte tokens in plaats daarvan $0.003 zijn. Het voorbeeld gaat uit van die tokenaantallen en tarieven; het is geen offerte voor een specifieke workload. De volledige capaciteit van 1M wordt niet in rekening gebracht alleen omdat die bestaat. Facturering volgt gebruik en cachebehandeling.
Voor teams die één API-toegangspunt willen, biedt de DeepSeek V4.1 Flash-modelpagina het model en de aanroepdetails. Vergelijk je gemeten tokengebruik en integratiebehoeften ook met het officiële endpoint; modelnamen, limieten en prijzen kunnen per provider verschillen.
Veelgestelde vragen
Is een contextvenster van 1M tokens hetzelfde als 1M woorden?
Nee. Tokens kunnen delen van woorden, leestekens, codefragmenten of andere eenheden zijn. Het aantal woorden of pagina's dat past, hangt af van het materiaal en de tokenisatie ervan. Gebruik gemeten tokenaantallen in plaats van een vaste paginaconversie.
Gebruikt DeepSeek V4.1 Flash altijd het volledige contextvenster?
Nee. Een miljoen tokens is een maximale contextspecificatie, geen doel voor elk verzoek. Een korte prompt gebruikt minder, en een bepaalde interface of API-route kan een lagere limiet opleggen. Controleer de endpointdocumentatie en de werkelijke gebruiksvelden.
Is 1M-context genoeg voor een volledige codebase?
Het kan qua tokenaantal in sommige codebases passen, maar dat maakt niet elk bestand relevant of elk antwoord betrouwbaar. Neem de bestanden op die nodig zijn voor de vraag, verifieer genoemde paden en symbolen en test wijzigingen met de echte checks van het project.
Moet ik elk beschikbaar document in één prompt stoppen?
Alleen als de documenten betrekking hebben op dezelfde vraag. Begin met een bronmanifest, verwijder duplicaten en niet-gerelateerd materiaal en voeg meer toe wanneer een cross-documenttest dat nodig heeft. De beste gebruiksscenario's voor het 1M-contextvenster van DeepSeek V4.1 Flash worden bepaald door bewijs dat moet worden vergeleken, niet door de omvang van het archief.





