Twee teams kunnen honderden tokens per seconde rapporteren voor DeepSeek V4.1 Flash en toch verschillende dingen meten. Het ene kan de decodeersnelheid voor één verzoek betekenen; het andere kan de totale uitvoer over tientallen gelijktijdige verzoeken betekenen. Om optimalisatie van DeepSeek V4.1 Flash inference-doorvoer te verbeteren, kies je eerst de metriek die je service nodig heeft, benchmark je vervolgens je eigen verzoekmix, wijzig je één serveervariabele per keer en verifieer je latentie, kwaliteit en kosten samen. De modelfamilie bevat nu de Flash-1017-update van 17 oktober, dus leg het exacte checkpoint vast voordat je resultaten vergelijkt. Openbare rapporten tonen nuttige optimalisatiepaden, maar geen daarvan vervangt een overeenkomstige test op je eigen hardware.
Belangrijkste conclusies
- Totale uitvoer-tokens/s meet capaciteit over verzoeken; decodeersnelheid per verzoek meet de ervaring van een individuele gebruiker.
- Reproduceer je promptlengtes, uitvoerlimieten, gelijktijdigheid, warme status en latentiedoel voordat je gaat tunen.
- De gecomprimeerde KV-cache en bounded replay van V4.1 Flash verminderen geheugendruk, maar garanderen geen vaste end-to-end versnelling.
- Vergelijk vLLM en SGLang alleen onder overeenkomstige model-, hardware-, workload- en meetcondities.
Wat betekent doorvoer voor DeepSeek V4.1 Flash?
Doorvoer is een snelheid, maar de teller en testgrens zijn belangrijk. Leg voor een inferentieservice ten minste vijf metingen vast:
| Metriek | Wat het je vertelt | Typisch gebruik |
|---|---|---|
| Totale uitvoer-tokens/s | Uitvoertokens geproduceerd door alle actieve verzoeken per seconde | Capaciteitsplanning en fleet-efficiëntie |
| Decodetokens/s per verzoek | Generatiesnelheid die een individueel verzoek ervaart | Interactieve responsiviteit tijdens generatie |
| Prefill-tokens/s | Invoertokens die per seconde worden verwerkt | Lange prompts en retrieval-intensieve workloads |
| Tijd tot eerste token (TTFT) | Tijd vanaf aankomst van verzoek tot eerste uitvoertoken | Ervaren opstartvertraging |
| End-to-end latentie, p50/p95 | Totale verzoekduur over de verkeersverdeling | Service-level objectives en staartgedrag |
Een server kan de totale doorvoer verhogen door meer sequenties te batchen, terwijl elke gebruiker langer tussen tokens moet wachten. Omgekeerd kan een opstelling die is afgestemd op lage gelijktijdigheid snelle individuele reacties leveren, terwijl accelerators onderbenut blijven. Geen van beide resultaten is universeel beter. Het juiste doel is een punt op de doorvoer-latentecurve dat voldoet aan de service-doelstelling van je product.
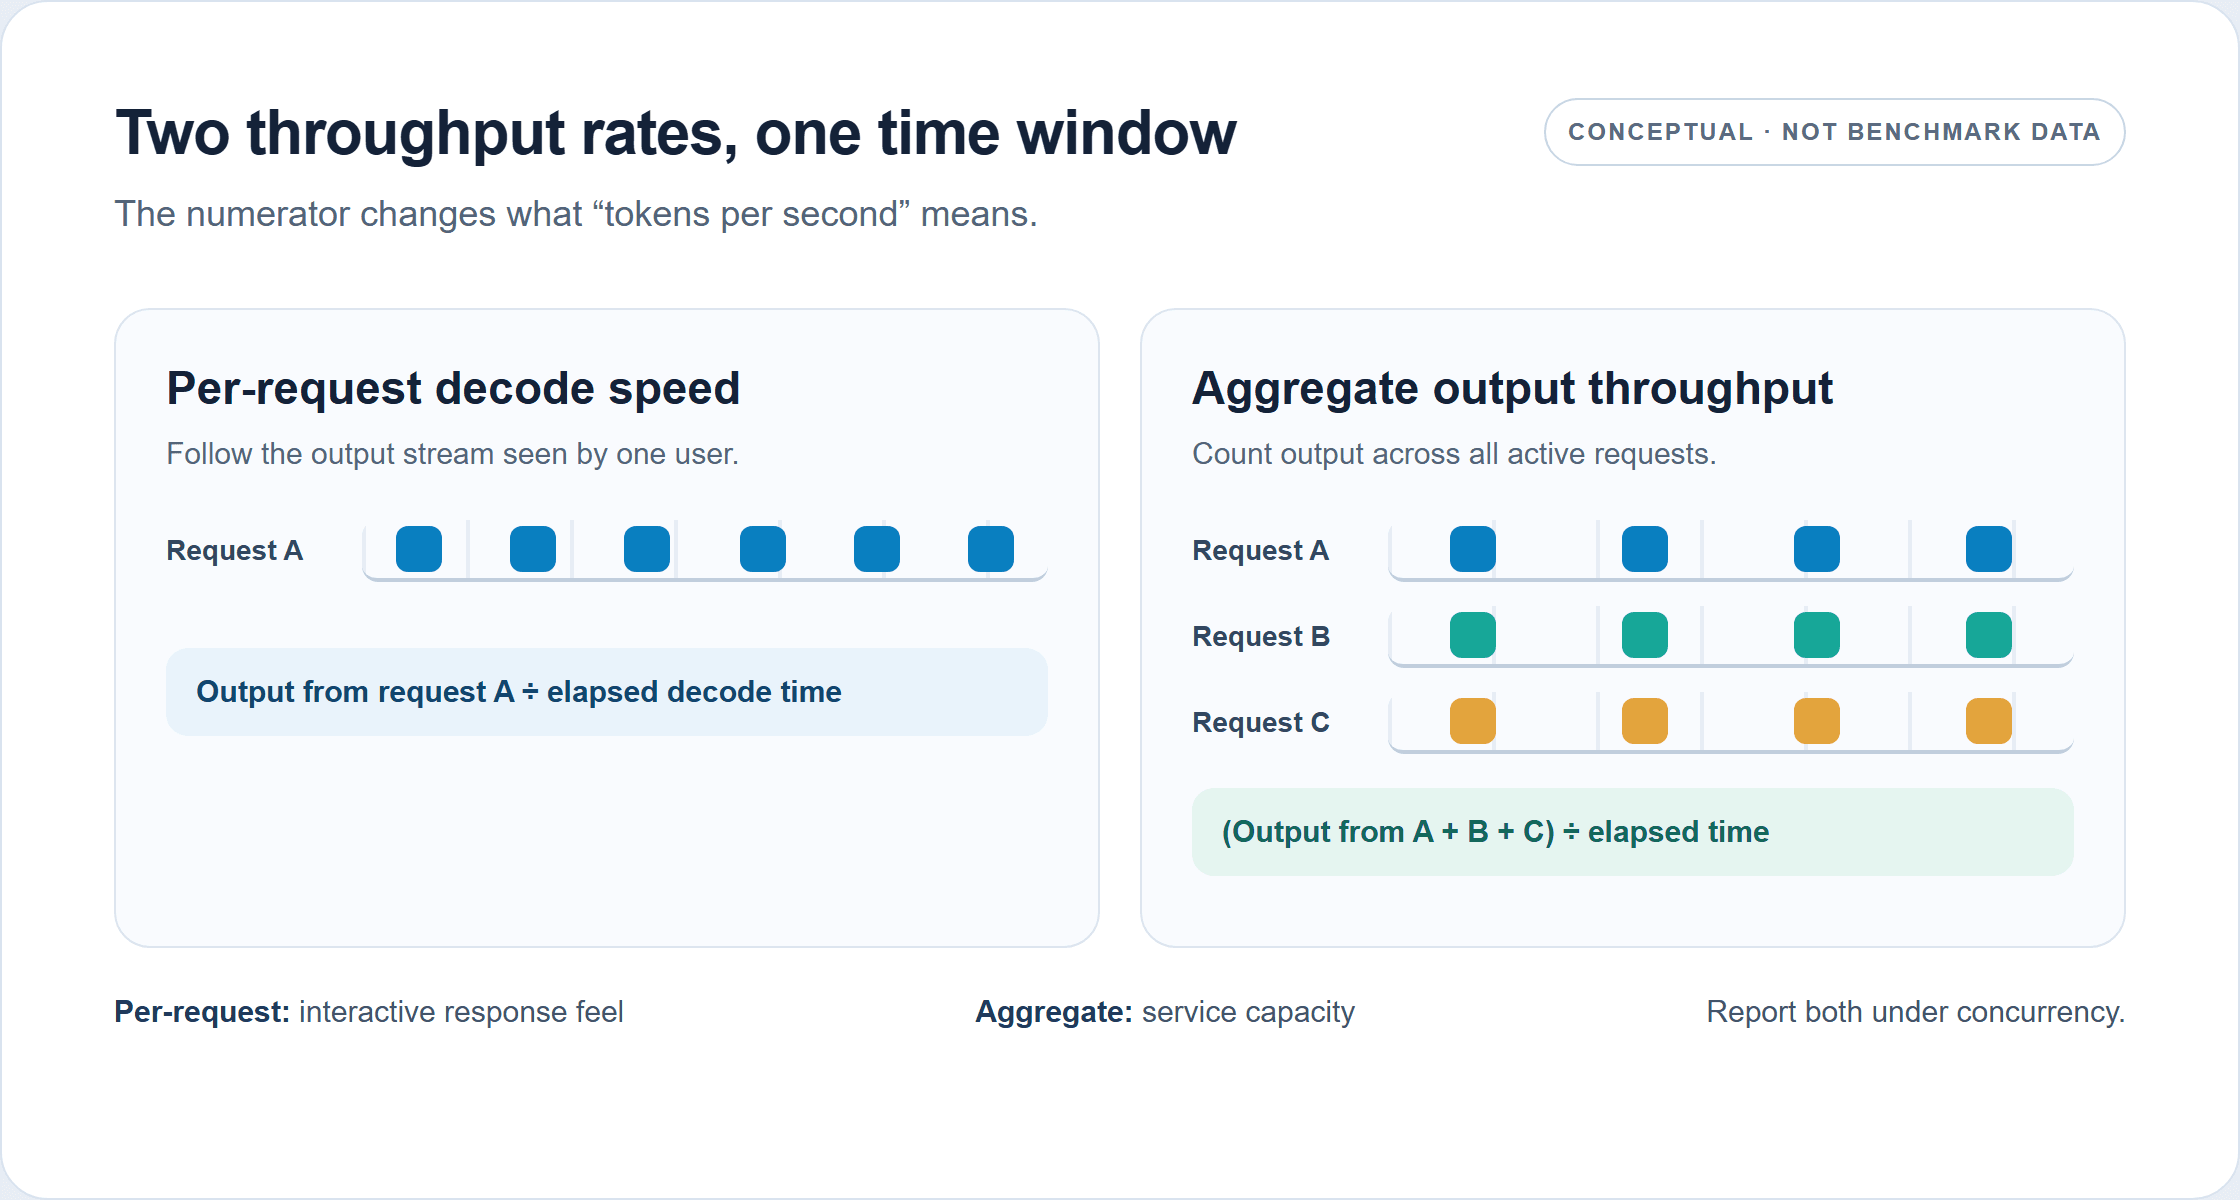
De twee snelheden tellen verschillende uitvoerstromen. Dit is een conceptueel diagram, geen gemeten DeepSeek V4.1 Flash-prestatie.
Geef aan of doorvoer prefill, decode of beide omvat. Vermeld of je door het aantal GPU's deelt. Rapporteer succesvolle uitvoertokens in plaats van aangevraagde maximale tokens, en vermeld annuleringen of fouten. Zonder die details kan een tokens/s-cijfer een operator niet vertellen of het hun applicatie voorspelt.
Bouw een reproduceerbare DeepSeek V4.1 Flash-baseline
Een nuttige baseline lijkt voldoende op productieverkeer om de bottleneck bloot te leggen. Een enkele korte prompt is een slechte proxy voor een agent die herhaaldelijk een grote gespreksgeschiedenis verstuurt, en een vaste uitvoer van 1.024 tokens mist workloads die vroeg stoppen of sterk variëren.
Zet de workload en het meetvenster vast
Maak verzoekbuckets op basis van waargenomen verkeer. Behoud voor elke bucket de geschatte invoerlengte, verwachte uitvoerlengte, aankomstpatroon en eventuele gedeelde prefixes. Neem tool- of reasoning-turns op als ze deel uitmaken van het echte verzoekpad. Houd prompts, sampling-instellingen, stopcondities en uitvoerlimieten vast tussen runs.
Draai zowel een geval met lage gelijktijdigheid als de gelijktijdigheid die je service op piek verwacht. Voeg daarna tussenliggende gelijktijdigheidsniveaus toe om te onthullen waar doorvoer stopt met stijgen of latentie zijn limiet overschrijdt. Gebruik een stabiel meetvenster na opwarming, herhaal elk punt en rapporteer de mediaan plus het bereik. Een korte burst kan opstartgedrag meten in plaats van stabiele servicecapaciteit.
Scheid cold-startmetingen van warme serving. Koude runs omvatten model laden, graph capture of cache-populatie, afhankelijk van de stack; warme runs beschrijven een systeem dat klaar is om te serveren. Meet voor een prefix-caching-workload cache-hit- en cache-miss-verkeer afzonderlijk. Combineer ze niet tot één gemiddelde, tenzij de mix overeenkomt met productie.
Houd een benchmarkregistratie bij
Sla voor elke run een rij op met deze velden: checkpoint of modelrevisie; runtime en commit; GPU-model en aantal; interconnect; precisie en kwantisatie; tensor-, expert- of pipeline-parallelle indeling; invoer- en uitvoertokenverdeling; gelijktijdigheid en aankomstpatroon van verzoeken; warme of koude status; runduur; slagingspercentage; totale doorvoer; decodeersnelheid per verzoek; TTFT; en end-to-end latentie p50/p95.
Deze registratie is nuttiger dan een leaderboardcijfer omdat ze het volgende experiment reproduceerbaar maakt. Bevries deze voordat je gaat tunen. Als de workload of het checkpoint verandert, start dan een nieuwe baseline in plaats van het verschil toe te schrijven aan een serveerflag.
Diagnoseer prefill, decode, KV-cache of scheduling
Gebruik symptomen om de volgende meting te kiezen, niet om een oplossing te raden. Hoge TTFT met acceptabele decodeersnelheid wijst op invoerverwerking, queuing, cachemissers of opstartoverhead. Trage decode bij lage gelijktijdigheid suggereert dat je kernels, geheugenbandbreedte, parallelle communicatie en het uitvoeringspad van het model moet onderzoeken. Totale doorvoer die afvlakt naarmate de gelijktijdigheid stijgt, kan wijzen op geheugendruk, schedulerlimieten, communicatieoverhead of een verzadigd rekenpad. Degradatie bij lange context vraagt om het meten van cacheresidentie, prefill-werk en host-naar-device-verkeer.
| Observatie | Eerste controles |
|---|---|
| TTFT groeit met promptlengte | Prefill-snelheid, wachttijd in wachtrij, prefix-cache-hitratio, graph- of compilatieopwarming |
| Decodeersnelheid is laag, zelfs bij gelijktijdigheid 1 | Runtime-modelpad, kernelondersteuning, precisie, GPU-benutting, communicatieoverhead |
| Totale tokens/s vlakt af naarmate gelijktijdigheid stijgt | KV-cachecapaciteit, scheduler-batching, geheugenbandbreedte, parallelle topologie |
| p95-latentie stijgt sterk terwijl totale uitvoer verbetert | Batchgrootte, queuingbeleid, mix van verzoeklengtes, service-doelstelling |
| Lange prompts verdringen nuttige actieve verzoeken | KV-cacheresidentie, cachetoewijzing, contextverdeling, host-geheugenverkeer |
V4.1 Flash heeft architectuurkenmerken die bedoeld zijn om sommige van deze druk te verlichten. Het modelrapport beschrijft CSA2 met cross-layer cache-hergebruik en FP4 global KV-caching, met een gerapporteerde wereldwijde KV-voetafdruk van 890 bytes per token, ongeveer een kwart van de overeenkomstige voetafdruk van V4-Flash. SWA Bounded Replay pakt een andere opslagafweging aan: in plaats van alle sliding-window attention-state te bewaren, kan een deployment ontbrekende state reconstrueren door het recente venster opnieuw af te spelen. DeepSeek rapporteert een persistente KV-cache van bijna een achtste van de voetafdruk van V4-Flash voor dit ontwerp, met een kleine hoeveelheid extra prefill-herberekening. Dit zijn architectuur- en deploymentresultaten, geen belofte van achtvoudige doorvoer. (DeepSeek technisch rapport, september 2026)
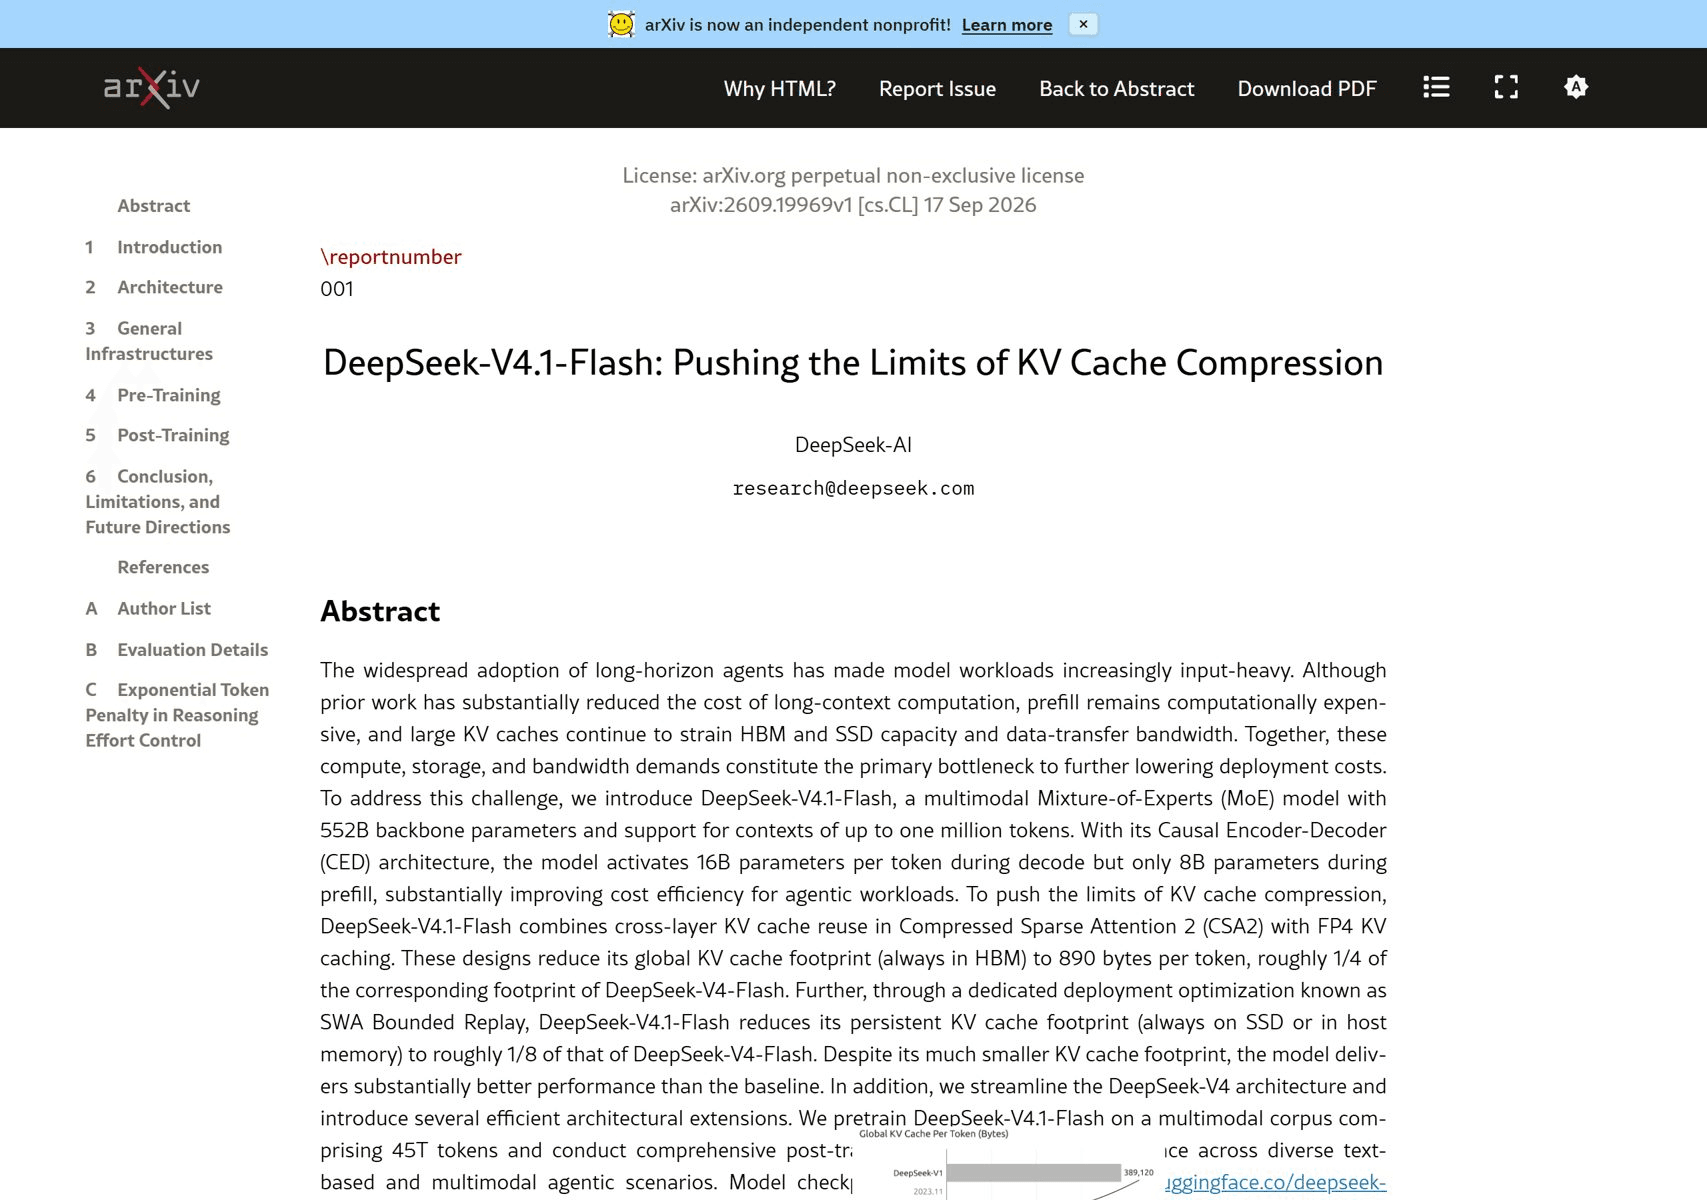
De bronfiguur beschrijft cachecapaciteit, niet een end-to-end doorvoervermenigvuldiger voor elke deployment.
Wanneer de diagnose onduidelijk is, profileer je één representatieve run en inspecteer je wachttijd in de wachtrij, GPU-benutting, geheugengebruik en timing per fase. Wijzig één variabele, voer dezelfde workload opnieuw uit en controleer de uitvoercorrectheid of taakkwaliteit. Zo voorkom je dat een schijnbare versnelling een regressie in service of antwoorden maskeert.
Stem vLLM of SGLang af op hetzelfde doel
Kies een runtime waarvan het huidige modelpad het checkpoint en de hardware ondersteunt die je wilt deployen. Verifieer de exacte release, kernels, graph-gedrag en parallelle indeling. Dat een model als ondersteund wordt vermeld, betekent niet dat elke kwantisatie of topologie even goed is geoptimaliseerd.
vLLM: valideer het releasespecifieke modelpad
Het oktoberrapport van het vLLM-team beschrijft een progressie op zijn AgentX-benchmark: ongeveer 1,9× verbetering in het resultaat met lage latentie en ongeveer 5,3× doorvoer onder een beperking van 150 TPS ten opzichte van zijn day-zero-baseline. Het werk omvatte SWA bounded replay met CUDA-graphs en modelspecifieke kernelintegratie. Behandel die waarden als bewijs dat de stack in de loop van de tijd materieel veranderde onder die benchmark, niet als vermenigvuldigers om op een ander cluster toe te passen. ( vLLM engineeringrapport, oktober 2026)
Stel voor je run eerst een ondersteunde release en een bekend goede configuratie vast. Meet daarna graph capture- of replay-gedrag, batching en parallellisme afzonderlijk. Behoud de latentiebeperking die is gebruikt om een punt met hogere doorvoer te selecteren. Als graph capture het opstart- of geheugenverbruik verandert, neem die kosten dan mee in de deploymentbeslissing.
SGLang: laat het gelijktijdigheidsprofiel overeenkomen
Het rapport van het SGLang-team geeft een ongewoon duidelijk voorbeeld van waarom testcontext ertoe doet. Op 8 H200-GPU's steeg de geoptimaliseerde run zonder speculative decoding van ongeveer 76 naar 168 tokens/s per gebruiker bij gelijktijdigheid één, en van ongeveer 96 naar 221 uitvoertokens/s per GPU bij gelijktijdigheid 64. Er werden vaste invoeren van 8.192 tokens en uitvoeren van 1.024 tokens gebruikt. De afzonderlijke 4×GB300-resultaten gebruikten andere promptlengtes, parallelle instellingen en DSpark speculative decoding. Het rapport ondersteunt daarom het evalueren van SGLang-optimalisaties op jouw verkeer, niet het direct rangschikken ervan tegen de vLLM AgentX-cijfers. ( LMSYS/SGLang optimalisatierapport, september 2026)
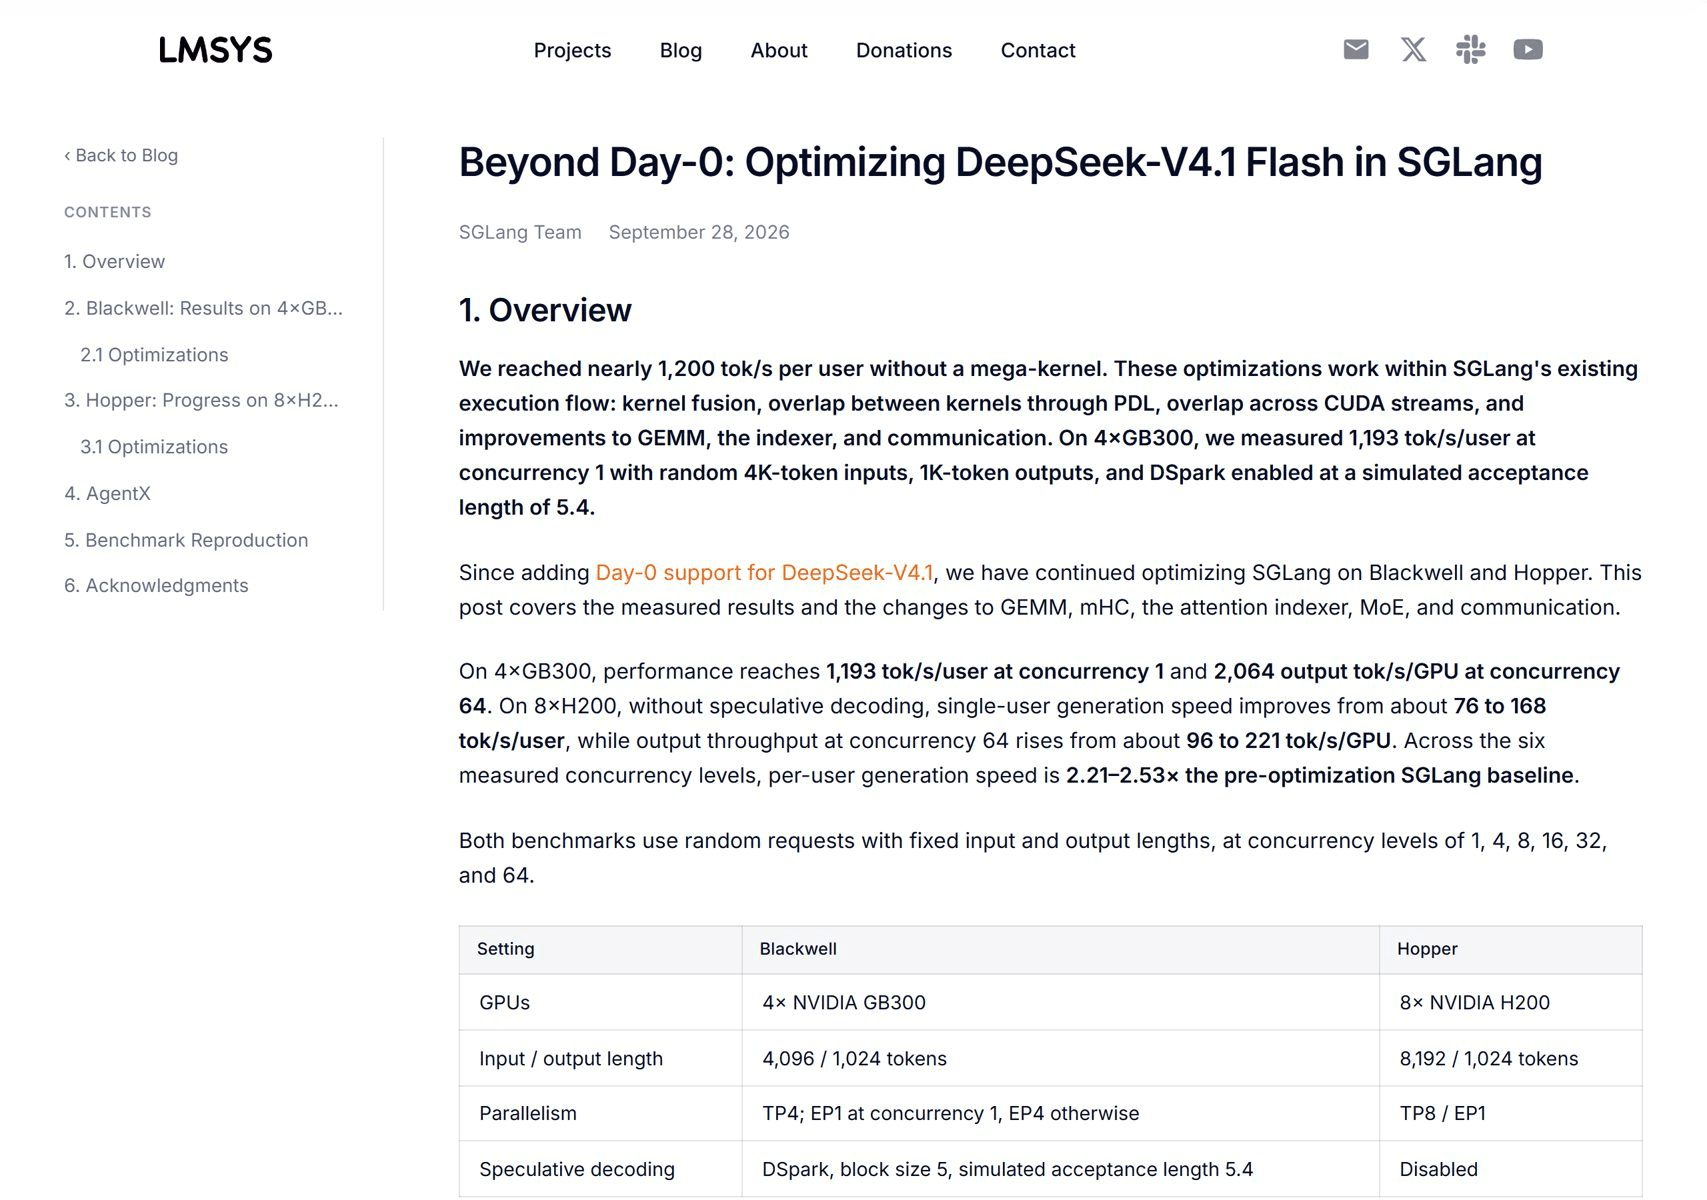
De bronrapporten gebruiken verschillende workloads en hardware; hun cijfers moeten niet worden gelezen als een head-to-head-grafiek.
Begin met één runtime en optimaliseer het ondersteunde pad. Bouw alleen een vergelijking met een tweede runtime als je checkpoint, GPU-toewijzing, prompt- en uitvoerverdelingen, gelijktijdigheid, opwarming en service-doelstelling constant kunt houden. Die vergelijking kost engineeringtijd, dus bevestig eerst dat de huidige stack daadwerkelijk de beperkende factor is.
Optimaliseer gelijktijdigheid en lange context zonder de SLO te doorbreken
Verhoog de gelijktijdigheid in stappen en leg bij elke stap totale uitvoer, decodeersnelheid per verzoek, TTFT, p95-latentie, geheugengebruik en fouten vast. Behoud alleen het punt met de hoogste doorvoer als de latentie en foutpercentages nog steeds voldoen aan je service-doelstelling. Als verzoeken in de wachtrij staan voordat generatie begint, kan een grotere batch de apparaatbenutting verbeteren terwijl het product trager aanvoelt.
Meet voor lange-contextverkeer de actieve contextverdeling en cache-hitratio. Een opgegeven maximaal contextvenster betekent niet dat elk verzoek gelijktijdig op die lengte kan worden bediend. KV-cache concurreert om geheugen met gewichten, activaties, graph-pools en runtime-buffers. Laat ruimte over voor variabele verzoeklengtes en meet evictie of preemptie onder realistisch verkeer.
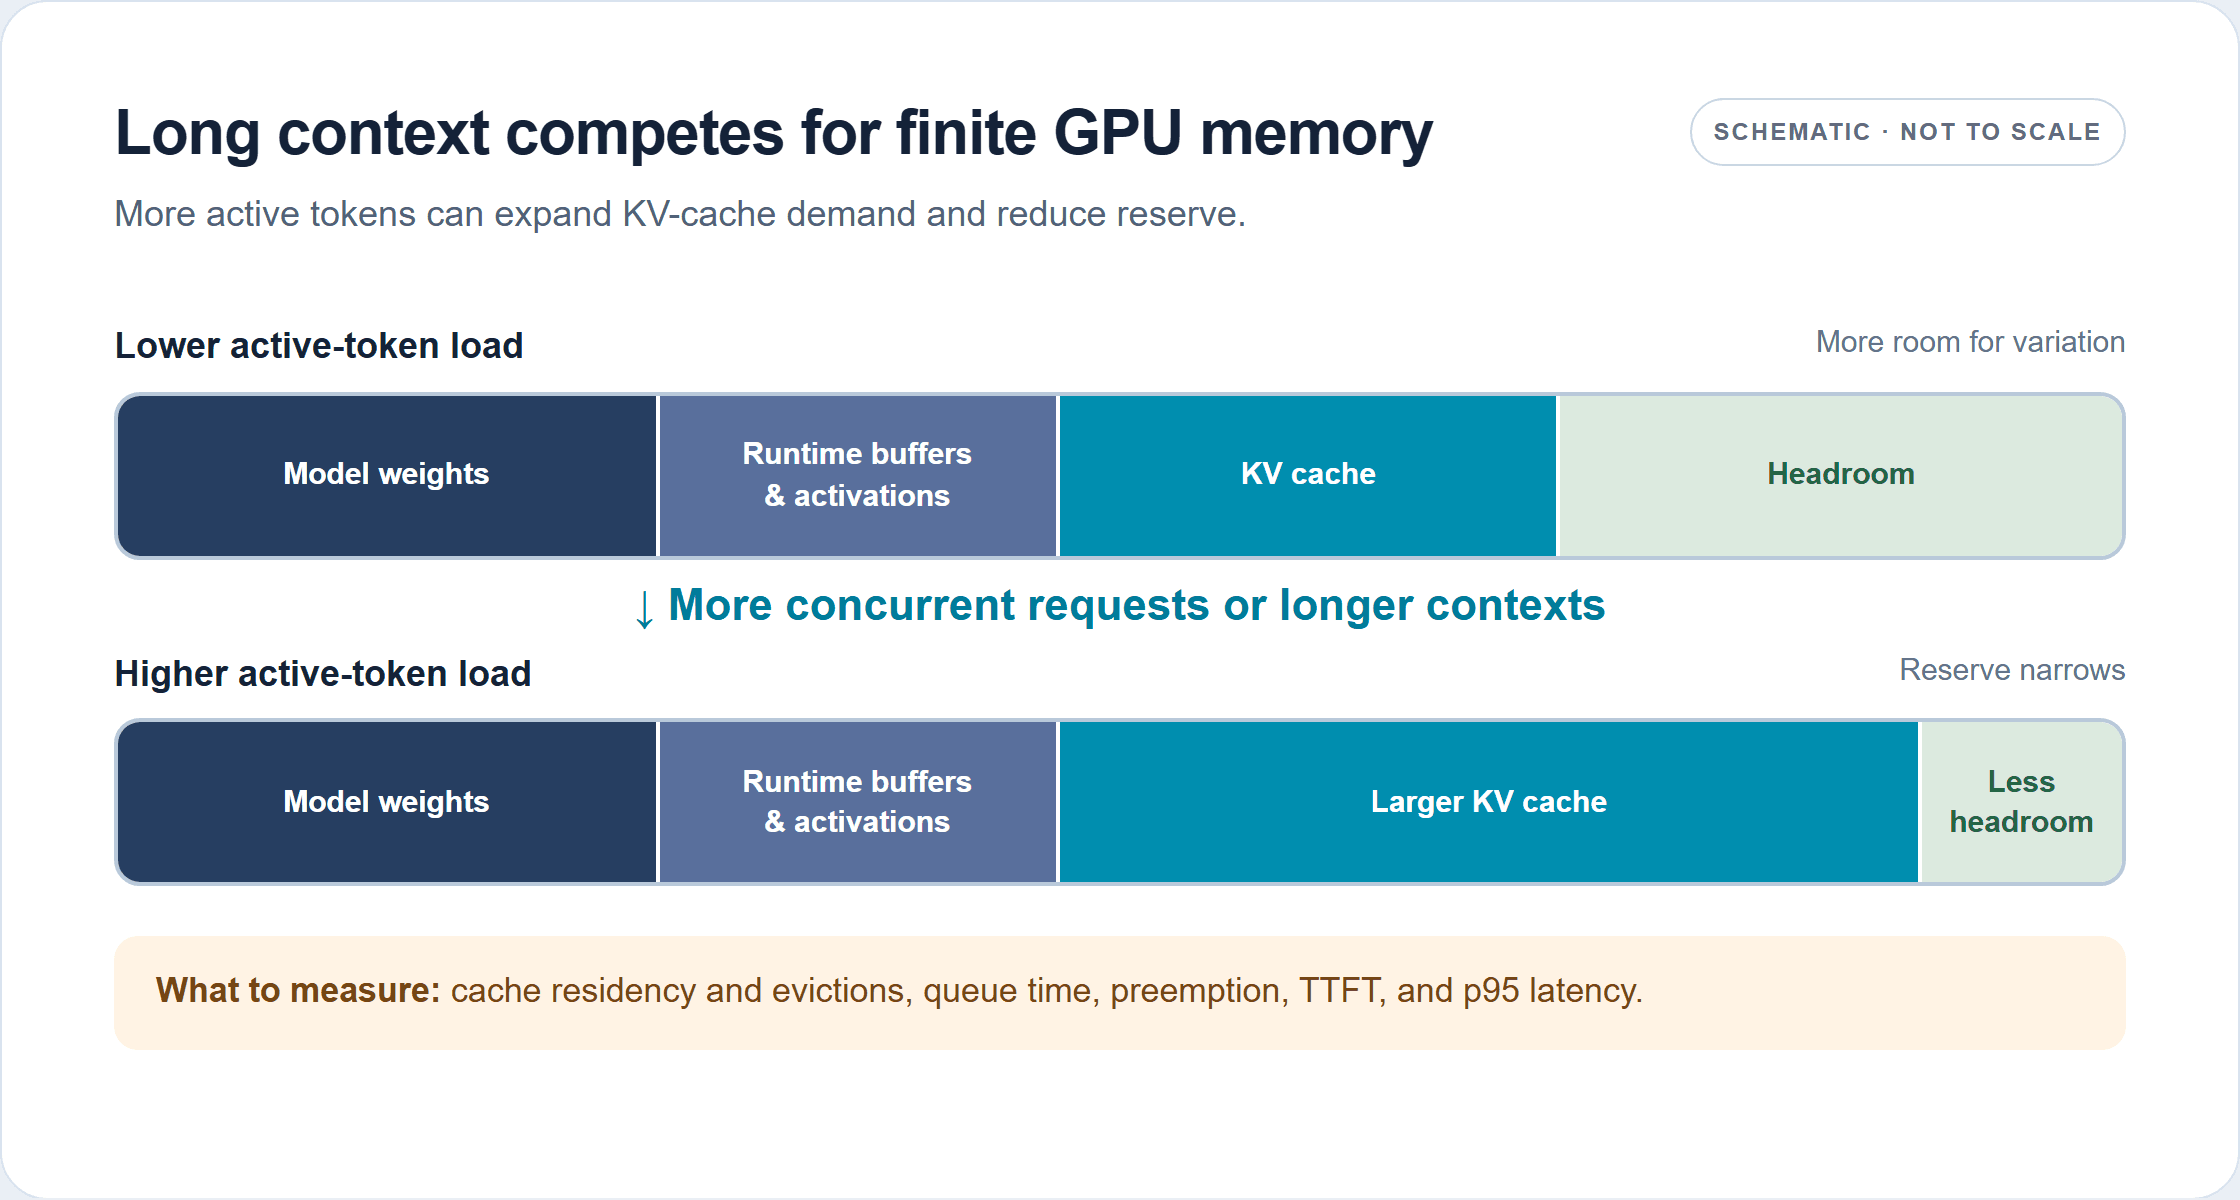
Langere contexten of meer gelijktijdige verzoeken kunnen de KV-cachevraag verhogen. De geheugenblokken zijn schematisch en niet op schaal.
Behandel kwantisatie, KV-cacheprecisie, tensorparallellisme, expertparallellisme en prefill/decode-disaggregatie als afzonderlijke experimenten. Ze kunnen geheugengebruik, communicatie, kernelselectie, uitvoerkwaliteit en latentie veranderen. De beste indeling hangt af van GPU-type en interconnect; meer GPU's toevoegen kan communicatiekosten verhogen of sommige resources onbenut laten. Verifieer de exacte uitvoerkwaliteit en faalmodi na het wijzigen van precisie of modeluitvoering.
De praktische volgorde is eenvoudig: reproduceer de baseline, identificeer de metriek die zijn doel mist, vorm één bottleneckhypothese, wijzig één instelling en herhaal. Als de instelling één metriek verbetert maar een andere schaadt, beslis dan expliciet of die afweging bij het product past. Zo wordt optimalisatie een gecontroleerde beslissing in plaats van een berg flags.
Valideer speculative decoding en elke beweerde versnelling
Speculative decoding kan serieel werk van het doelmodel verminderen wanneer drafttokens efficiënt worden geaccepteerd en de runtime verificatie goed implementeert. Het voordeel hangt af van het draftpad, acceptatiegedrag, de batchvorm, hardware en de prompt-/uitvoermix. Het kan decode-gebonden verkeer helpen en weinig waarde hebben wanneer prefill, queuing of communicatie domineert.
Voer een A/B-test uit met speculatie in- en uitgeschakeld. Houd het modelcheckpoint, de promptset, tokenlimiet, aankomstpatroon, gelijktijdigheid, opwarming en meetvenster vast. Registreer indien beschikbaar geaccepteerde tokens per verificatiestap, naast totale doorvoer, snelheid per verzoek, TTFT, p95-latentie, GPU-gebruik, fouten en taakkwaliteit. Een gesimuleerde acceptatielengte in een gepubliceerde benchmark is een testconditie, geen waarde om voor jouw prompts aan te nemen.
Een beweerde versnelling is alleen nuttig als deze drie controles doorstaat: dezelfde service-doelstelling, acceptabele antwoordkwaliteit en een eerlijke kostenvergelijking. Rapporteer de volledige context bij elk cijfer dat je publiceert. Vermijd het vergelijken van verschillende GPU-aantallen, promptlengtes, uitvoerlengtes, precisiemodi, modelrevisies of metrieken alsof het een gecontroleerd experiment was.
Zelf hosten of een managed DeepSeek V4.1 Flash-API gebruiken?
Zelf hosten is zinvol wanneer verkeer stabiel genoeg is om de GPU's nuttig te houden, het team inferentie-infrastructuur kan beheren en controle over hardware of uitvoering het operationele werk rechtvaardigt. Neem de volledige kosten op van accelerators, capaciteitsheadroom, stroom, netwerken, opslag, onderhoud en engineeringtijd. Een hoge piek van tokens/s op zich bewijst geen lagere kosten per succesvolle taak.
Een managed API is nuttig wanneer een team snel productvraag moet valideren, geen serving-fleet wil draaien of een API-baseline met de eigen deployment wil vergelijken. Atlas Cloud vermeldt DeepSeek V4.1 Flash onder model-ID deepseek-ai/deepseek-v4.1-flash met een OpenAI-compatibele API. De DeepSeek V4.1 Flash-modelpagina toont momenteel $0.30 per miljoen invoertokens, $1.20 per miljoen uitvoertokens en $0.03 per miljoen cache-read-tokens, zonder weergegeven korting per oktober 2026. Controleer de huidige prijslijst voordat je uitgaven schat. Een managed endpoint neemt niet weg dat je je eigen verzoeklatentie of verkeerseconomie moet meten.
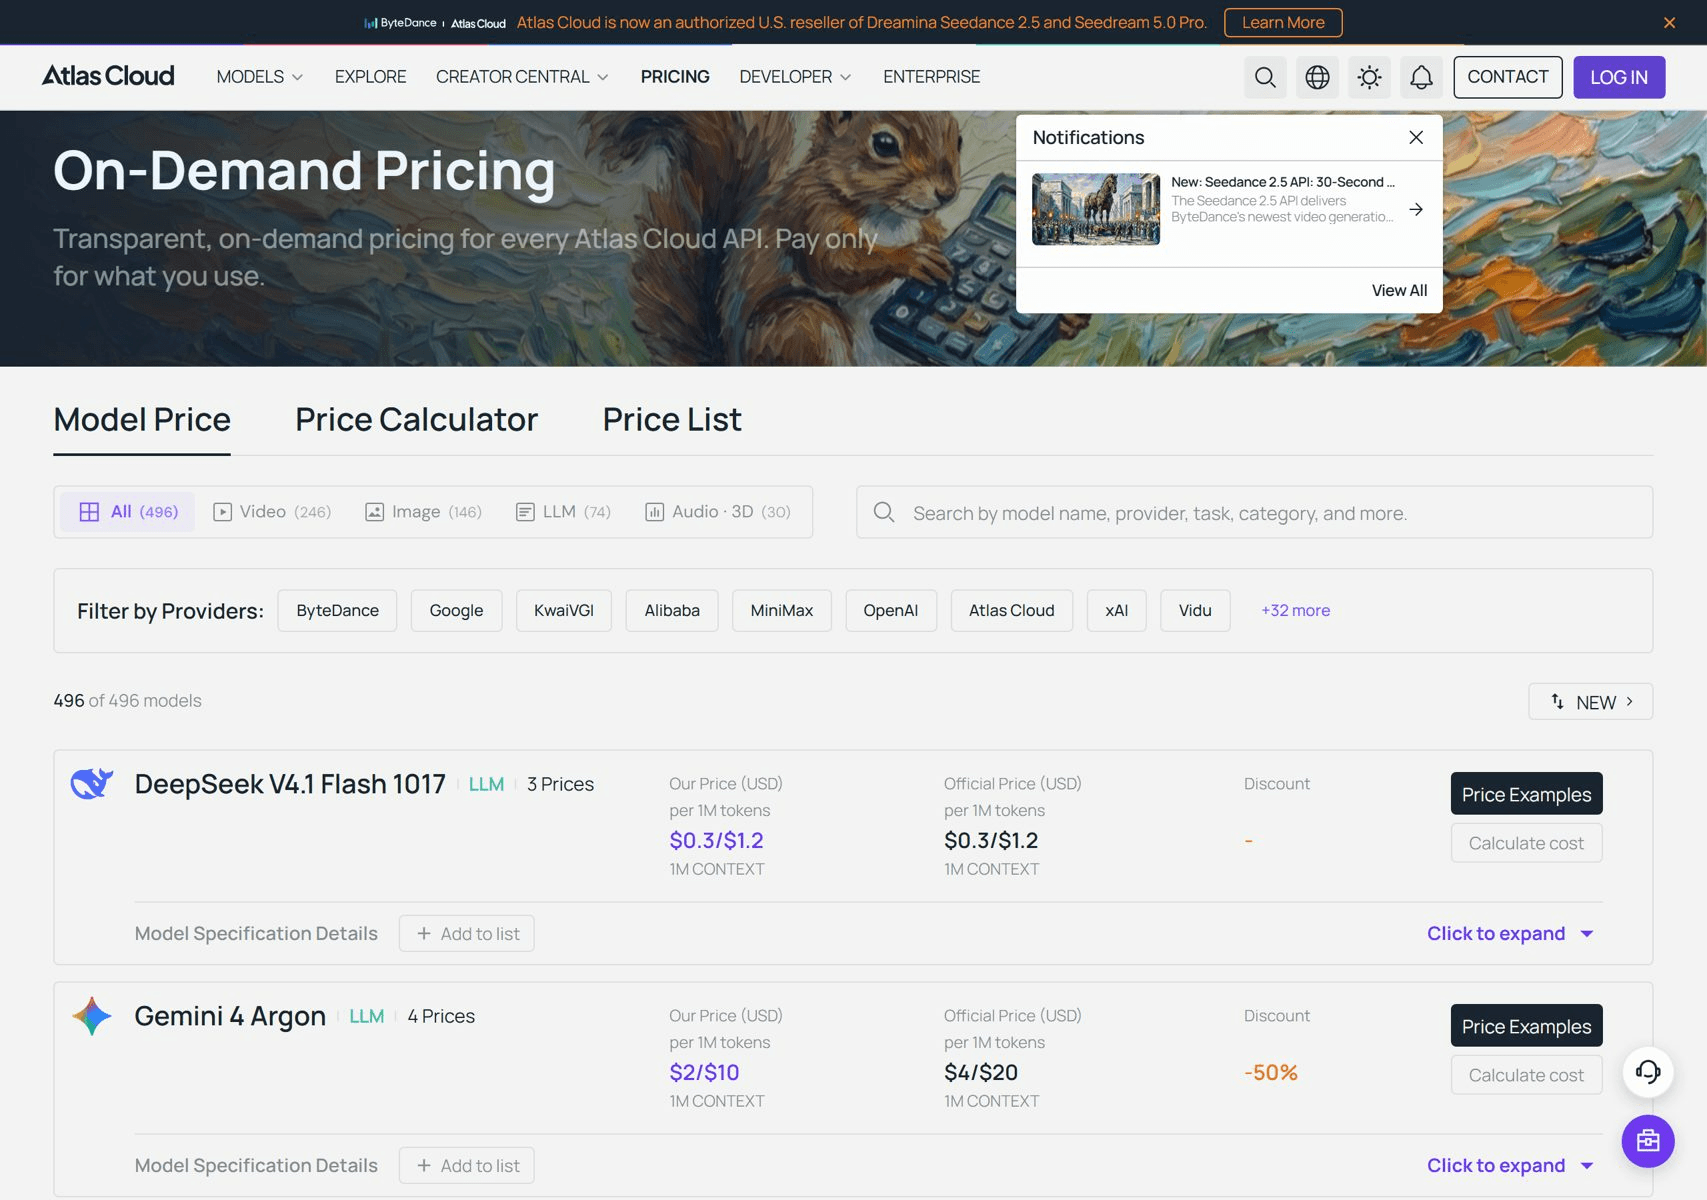
De vermelding identificeert een managed API-optie; het is geen serving-benchmark.
Voor een eerlijke deploymentbeslissing speel je dezelfde zakelijke verzoeken opnieuw af tegen de zelfgehoste service en het managed endpoint. Vergelijk kosten per voltooide taak, latentieverdeling, betrouwbaarheid en de personeelstijd die nodig is om elke optie te onderhouden. Als je primaire doel het optimaliseren van de inference-doorvoer van DeepSeek V4.1 Flash is, houd dan dezelfde workload en succescriteria aan voor beide paden.
Veelgestelde vragen
Wat is het verschil tussen doorvoer en tokens per seconde per gebruiker?
Totale doorvoer telt uitvoer over actieve verzoeken. Tokens/s per gebruiker meet de decodeersnelheid van één verzoek. Batching kan de eerste verhogen en de tweede verlagen, dus rapporteer beide voor interactieve services.
Verbetert het verhogen van gelijktijdigheid altijd de doorvoer?
Nee. Totale uitvoer kan stijgen tot rekenkracht of geheugen verzadigd raakt en daarna afvlakken. Queuing en staartlatentie kunnen daarna blijven verslechteren. Stop met het verhogen van gelijktijdigheid wanneer de service-doelstelling niet meer wordt gehaald.
Kunnen benchmarkcijfers van vLLM en SGLang direct worden vergeleken?
Alleen als de modelrevisie, hardware, prompt- en uitvoerlengtes, gelijktijdigheid, warme status, meetgrens en latentiebeperking overeenkomen. Gepubliceerde rapporten gebruiken verschillende opstellingen, dus ze tonen optimalisatiepaden in plaats van een directe runtimewinnaar.
Wanneer moet ik een managed API gebruiken in plaats van zelf hosten?
Gebruik een managed API wanneer snelheid van integratie en minder infrastructuurwerk belangrijker zijn dan eigenaarschap van de serving-stack. Host zelf wanneer benutting, operationele expertise, controle en een gemeten total-cost-case het draaien van de GPU's rechtvaardigen.





