Een contextvenster van een miljoen tokens vertelt je hoeveel tekst een model mag accepteren, niet hoe betrouwbaar het elke clausule interpreteert. Voor de nauwkeurigheid van DeepSeek V4.1 Flash bij de analyse van lange documenten is het openbare bewijs nuttig maar onvolledig: de modelkaart van DeepSeek meldt 45,2 exact match op LongBench-V2 voor het V4.1 Flash-basismodel in een 1-shot-opzet, terwijl de API sindsdien is overgestapt op een nieuwere 1017-build. Die benchmark is een signaal over één evaluatieopzet, niet een slagingspercentage voor jouw contract, jaarverslag of onderzoeksarchief.
Het praktische antwoord is om Flash te gebruiken voor snelle retrieval en een eerste synthese, en vervolgens paginaniveau-bewijs en menselijke beoordeling te vereisen voor beslissingen die ertoe doen. Geen enkele hier aangehaalde openbare bron biedt een reproduceerbare evaluatie van de huidige build voor de vijf documenttaken hieronder. Het testplan is een kant-en-klaar protocol, geen bewering dat die runs al hebben plaatsgevonden.
Belangrijkste punten
- De modelfamilie ondersteunt tot 1M tokens, maar een contextlimiet is geen garantie voor nauwkeurigheid.
- De gepubliceerde LongBench-V2-score van 45,2 is voor het basismodel en een 1-shot-benchmarkopzet.
- De API van DeepSeek serveert nu V4.1-Flash-1017; de release notes publiceren geen nieuwe long-document-score.
- Vraag naar bewijslocaties, controleer ze tegen de bron en meet fouten op je eigen documenten.
Wat het 1M-tokenvenster betekent voor documentanalyse
De modelkaart van DeepSeek beschrijft V4.1 Flash als ondersteunend voor contexten tot een miljoen tokens. De API-documentatie identificeert het geserveerde model momenteel als DeepSeek-V4.1-Flash-1017 en vermeldt een contextlengte van 1M. Dat zijn capaciteitsspecificaties. Ze tonen niet aan hoe vaak het model een voetnoot vindt, twee documentversies gescheiden houdt of toegeeft dat een gevraagd feit ontbreekt. (DeepSeek-modelkaart)
Een token is geen pagina. Het aantal pagina's varieert met tabellen, voetnoten, lay-out, taal en extractiekwaliteit. Een gescande PDF kan OCR nodig hebben; een tabel kan zijn rijlabels verliezen bij conversie naar tekst; kopteksten en terugkerende pagina-elementen kunnen context verbruiken zonder de vraag te helpen. De prompt en het gevraagde antwoord gebruiken ook tokens. Een nominaal plafond van een miljoen tokens betekent daarom niet dat elk bestand van een miljoen tokens intact aankomt via elke chatinterface of API-client.
Noteer vóór een test de exacte modelidentificatie, client en invoermethode. Controleer of de volledige geëxtraheerde tekst is verzonden, of de provider die heeft afgekapt en of het verzoek de verwachte modelversie heeft bereikt. De huidige DeepSeek-API gebruikt deepseek-flash voor de nieuwste Flash-build. Als je gateway of SDK een andere alias gebruikt, noteer die alias en verifieer de routering ervan. Teams die herhaalbare gehoste calls opzetten, kunnen beginnen bij het modelplatform van Atlas Cloud en vervolgens de DeepSeek V4.1 Flash API-vermelding openen.
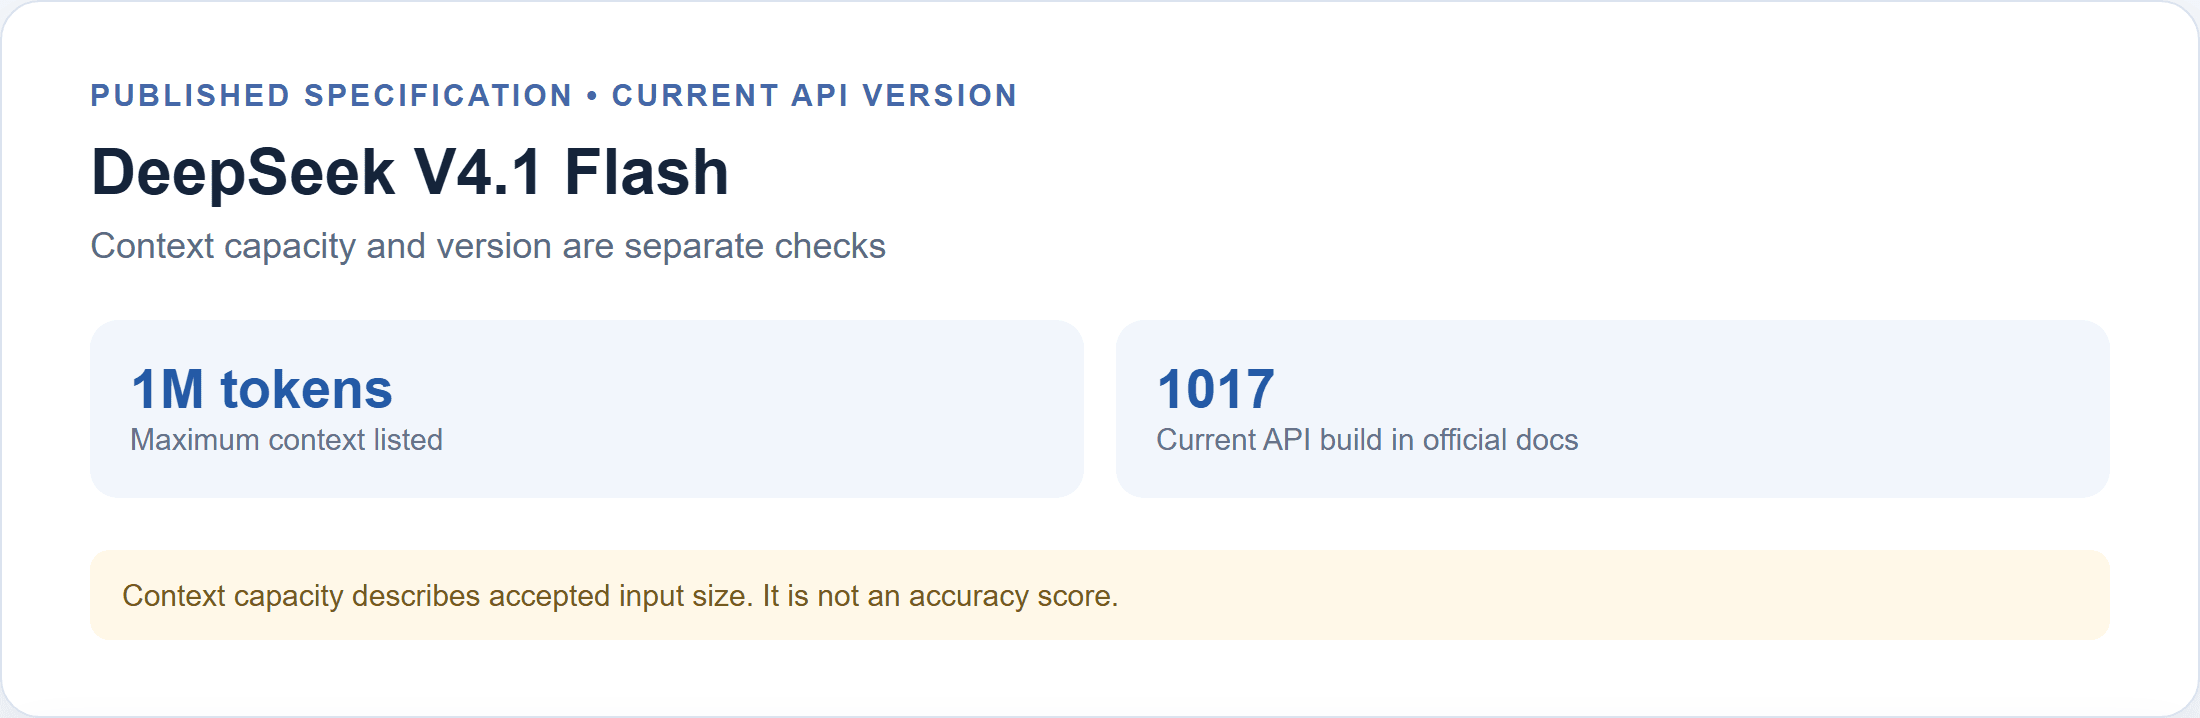
De gepubliceerde specificatie geeft een maximumcontext van 1M; de huidige API-documentatie identificeert de 1017-build.
Een geslaagde upload of verzoek toont alleen dat het systeem een invoer heeft geaccepteerd. Om vast te stellen dat een relevant detail het antwoord heeft beïnvloed, vraag je om een precieze locatie, haal je die passage op en controleer je of de omliggende tekst de bewering ondersteunt.
Wat de LongBench-V2-score wel en niet laat zien
De LongBench-V2-rij in de modelkaart rapporteert exact-match-scores in een 1-shot-instelling. De tabel labelt de resultaten als evaluaties van basismodellen en stelt dat alle basismodellen hetzelfde interne evaluatieraamwerk gebruiken. Er staat ook dat scores binnen 0,3 als gelijkwaardig worden beschouwd. De waarden zijn:
| Basismodel in de modelkaart | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
Het verschil van 0,5 punt tussen V4-Flash-Base en V4.1-Flash-Base is groter dan de in de kaart genoemde equivalentieband van 0,3, maar het blijft een smalle benchmarkvergelijking. De 45,2 is niet “45,2% nauwkeurigheid op lange pdf's.” Het is een exact-match-score voor een bepaald basismodel, benchmarkdataset, promptopzet en evaluator. Het beoordeelt niet rechtstreeks een gehost instruct/API-model dat je vragen met een andere prompt beantwoordt.
LongBench-V2 bevat 503 meerkeuzevragen in zes categorieën, waaronder vraagbeantwoording over één document en meerdere documenten, lange dialogen, coderepositories en gestructureerde data. De contexten variëren van 8.000 tot 2 miljoen woorden. De auteurs van de benchmark rapporteren een gemiddelde nauwkeurigheid van 53,7% voor experts binnen een limiet van 15 minuten, en 50,1% voor het beste direct-answering-model in hun gerapporteerde evaluatie. De breedte maakt het een nuttige stresstest, maar een geaggregeerd getal kan niet diagnosticeren welke documentbewerking sterk of zwak is. (LongBench-V2-paper)
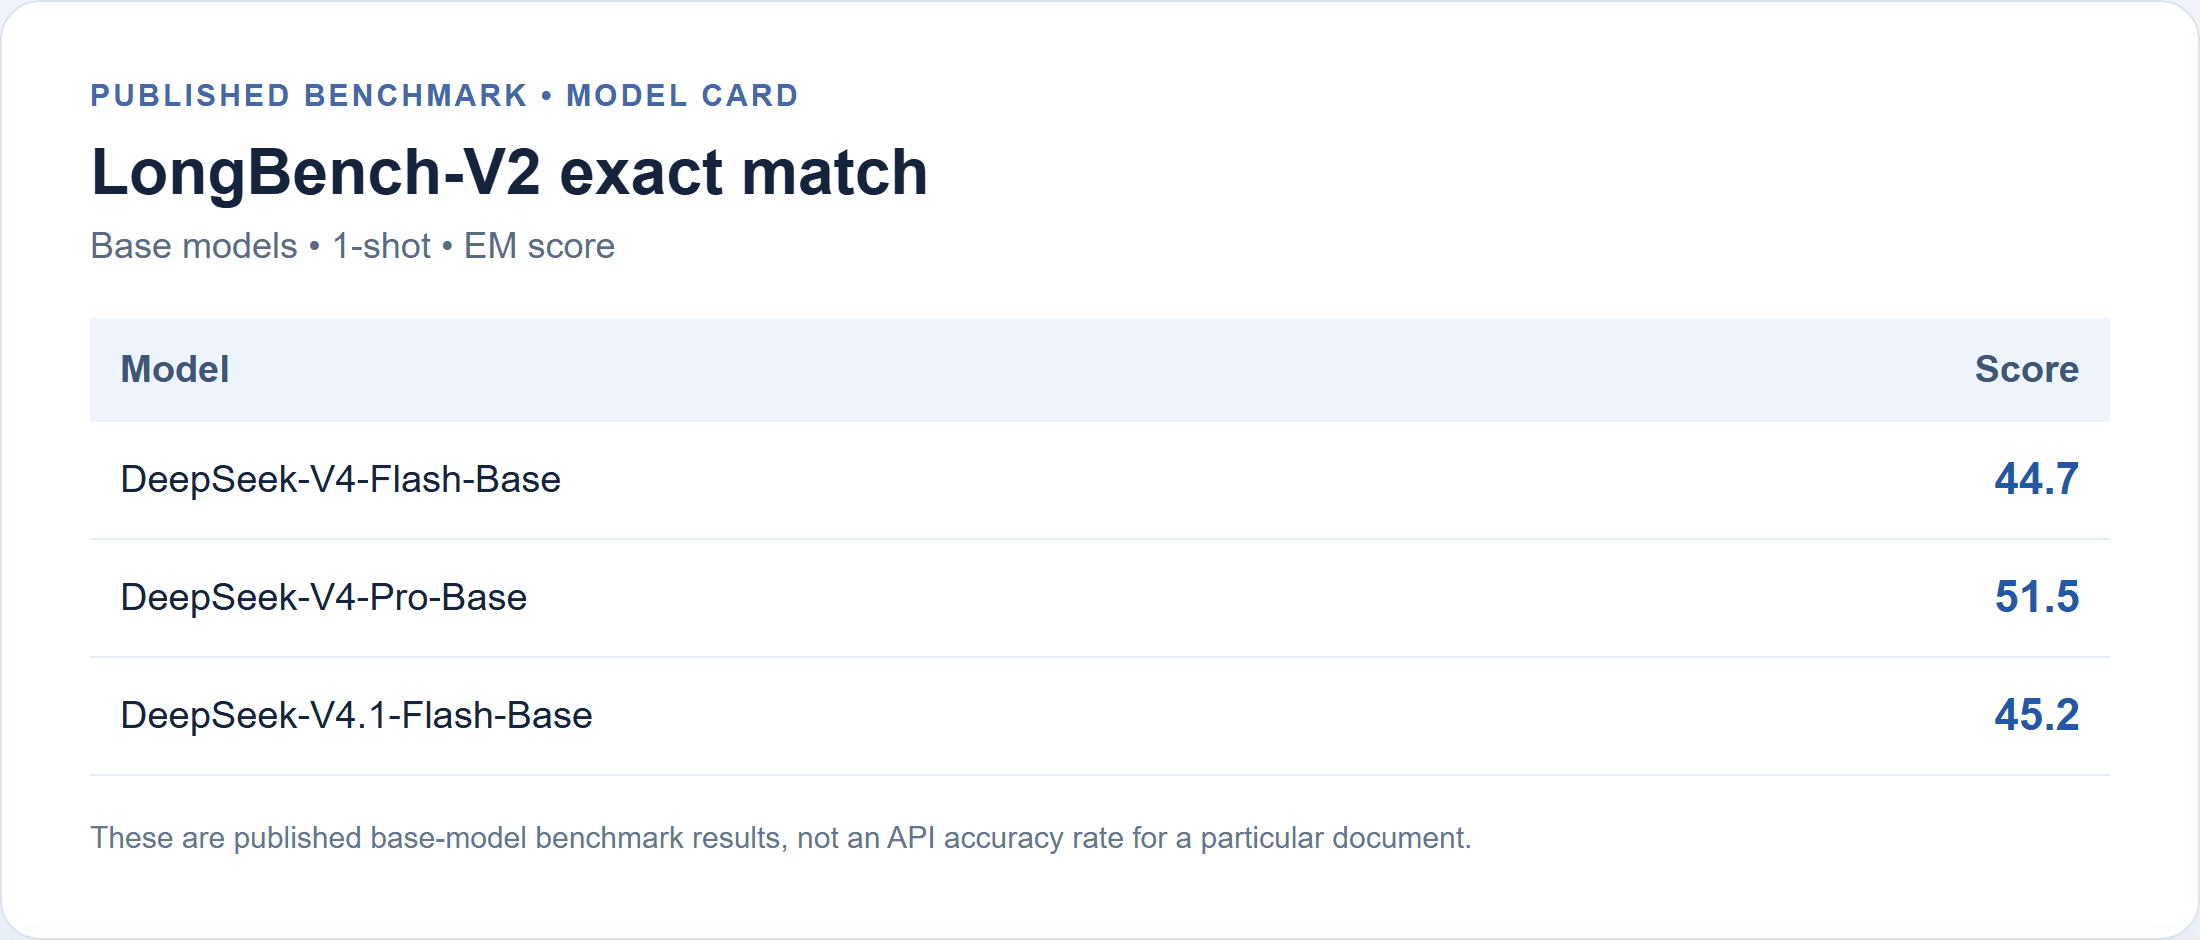
De gepubliceerde rij is een 1-shot-resultaat voor het basismodel. Het is geen gemeten slagingspercentage van de API.
Er is een versie-voorbehoud. In de release notes van DeepSeek van 17 oktober staat dat de API en webapp zijn geüpgraded naar V4.1-Flash-1017, en de API-modelnaam blijft deepseek-flash. De notes noemen bijgewerkte agent- en reasoning-benchmarks, maar rapporteren geen nieuw LongBench-V2-resultaat. Dus 45,2 blijft een nuttige gepubliceerde referentie voor het V4.1 Flash-basismodel, terwijl de nauwkeurigheid van de huidige API-build op vragen over lange documenten in die bronnen niet is gekwantificeerd. Draag niet-gerelateerde benchmarkwinst niet over naar document-QA. (DeepSeek V4.1-Flash-1017-update)
Hoe je een eerlijke nauwkeurigheidstest voor lange documenten uitvoert
Een nuttige evaluatie vereist een vaste bron, een antwoordsleutel en scoringsregels. Begin met een openbaar jaarverslag of technisch rapport waarvan de versie en paginastructuur kunnen worden gedeeld. Bewaar de PDF en de geëxtraheerde tekst, noteer de bron-URL en ophaaldatum, en vermeld of je native tekstextractie of OCR hebt gebruikt. Vermijd het kiezen van een document omdat je al weet dat het model er goed mee omgaat.
Schrijf de antwoordsleutel zelf vanuit de bron voordat je het model prompt. Noteer voor elke vraag het verwachte antwoord en de exacte pagina of sectie. Dit voorkomt dat een overtuigend antwoord de beoordelingsnorm wordt. Houd vragen specifiek genoeg om te scoren, maar behoud de ambiguïteit waarmee een lezer daadwerkelijk te maken krijgt.
Gebruik voor elke run hetzelfde document, dezelfde vragenset, modelidentificatie, prompt, reasoning-instelling en uitvoerindeling. Als de API temperatuur- of reasoning-instellingen beschikbaar stelt, noteer deze dan. Voer de set meer dan eens uit als je de variabiliteit wilt schatten; één run is een steekproef, geen stabiel percentage. Repareer de uitvoer niet stilzwijgend voordat je die scoort.
Een compacte set kan vijf verschillende faalkansen dekken:
| Taak | Voorbeeldvraag | Wat te verifiëren |
|---|---|---|
| Opzoeking van één punt | “Welke datum geeft het rapport voor het herziene beleid?” | Exacte waarde en geciteerde pagina |
| Verband tussen secties | “Hoe verhoudt het risico in sectie 2 zich tot de beheersmaatregel in sectie 7?” | Beide passages en of het verband wordt vermeld of afgeleid |
| Afhandeling van uitzonderingen | “Wie is uitgesloten van de vermelde dekking?” | Voetnoot, reikwijdte en kwalificaties |
| Versieconflict | “Welke waarde geldt na herziening, en wat verving die?” | Datums, versielabels en beide locaties |
| Ontbrekende informatie | “Welke bewaartermijn specificeert het rapport voor leverancierskopieën?” | Toegeving als het document niets zegt |
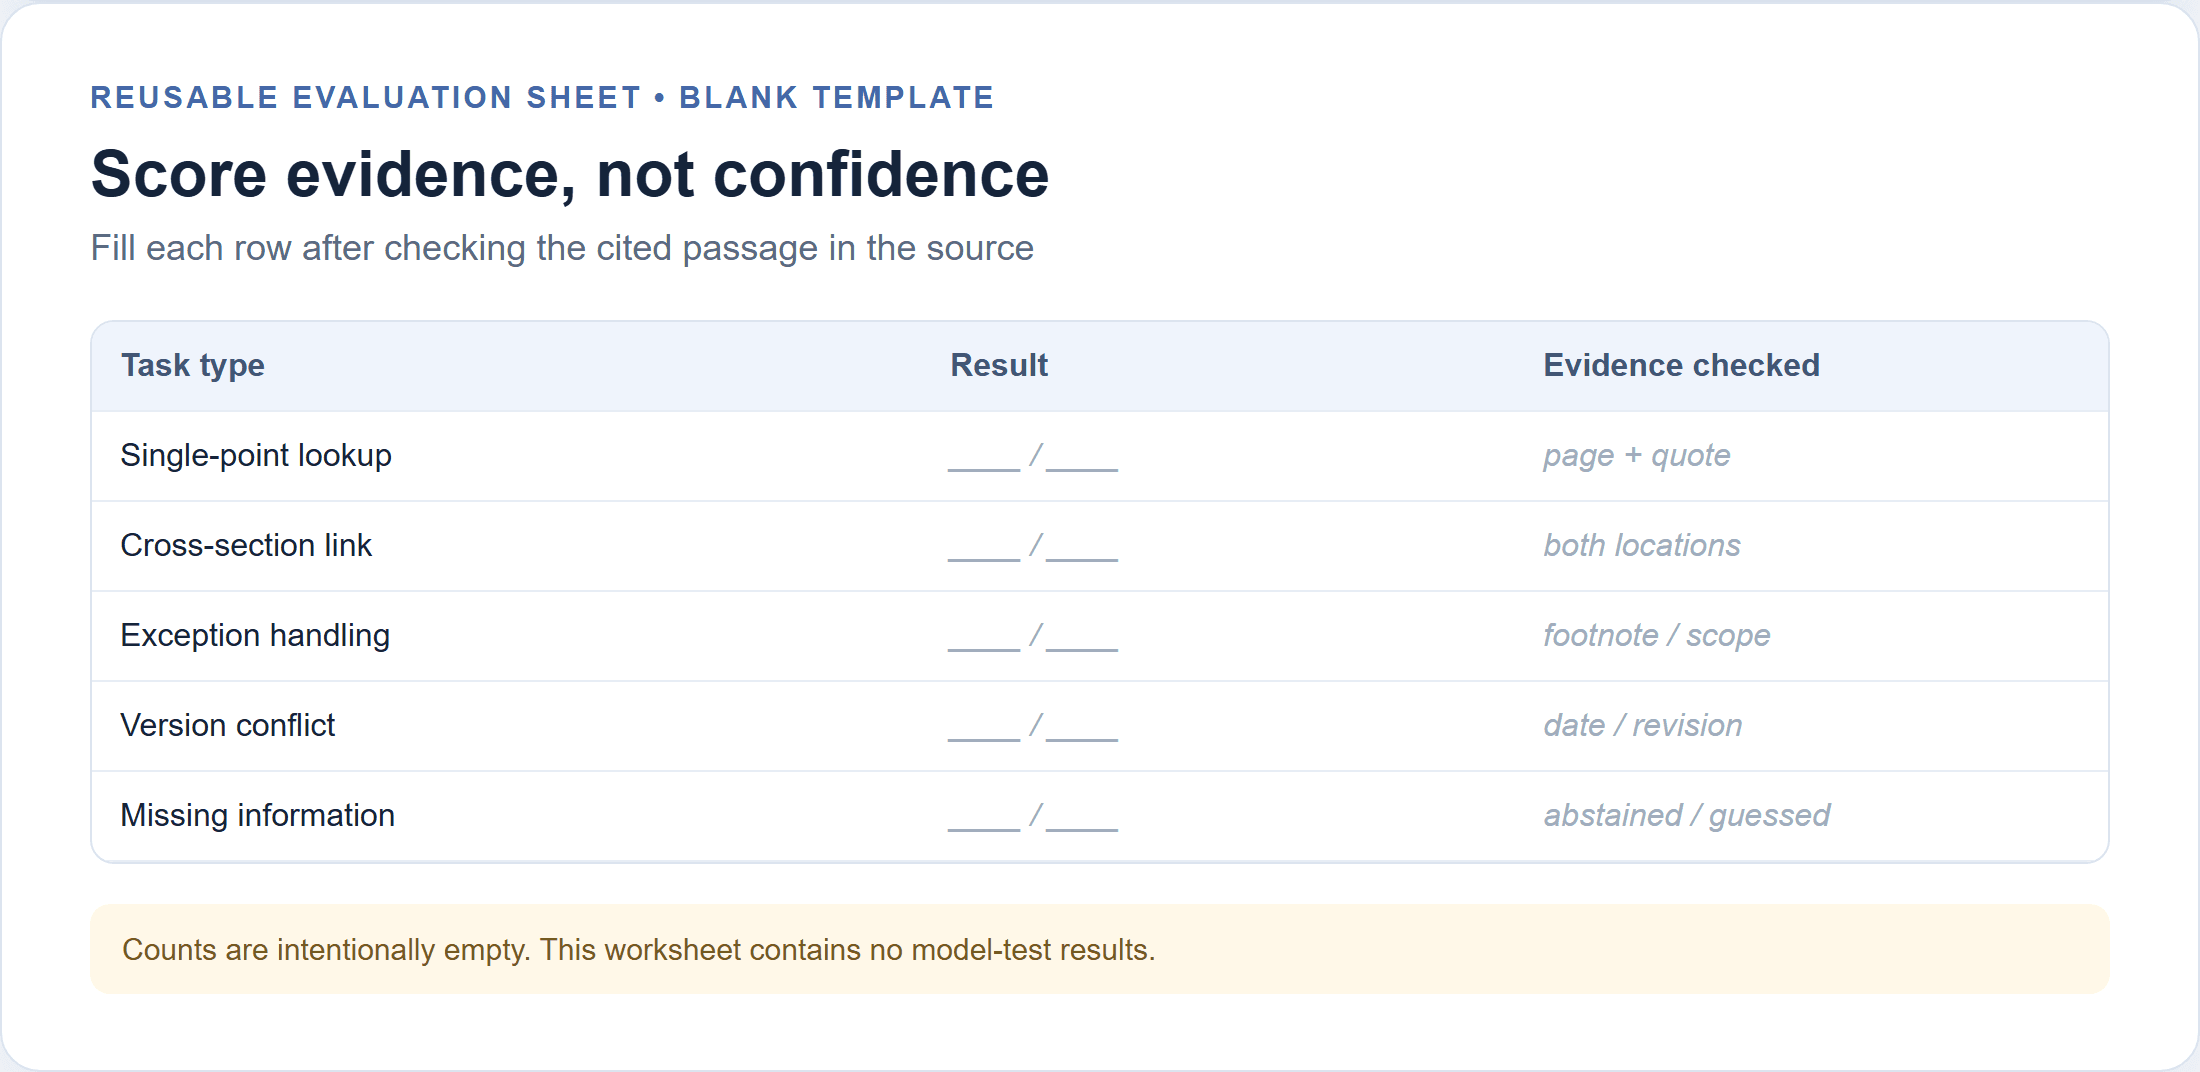
Dit is een blanco scoreformulier, geen resultatentabel. Vul het pas in nadat je elk antwoord tegen het brondocument hebt gecontroleerd.
Scoor elk antwoord als correct, gedeeltelijk, fout, niet ondersteund of correct afgezien van antwoord. Tel niet-ondersteunde claims apart van foute antwoorden, omdat een antwoord het juiste hoofdantwoord kan geven en een detail kan verzinnen. Controleer of elke verwijzing naar de passage wijst die de bewering ondersteunt. Rapporteer het aantal vragen en de aantallen per categorie samen. Een algemeen percentage verbergt of het model voetnoten heeft gemist of alleen moeite had wanneer informatie over secties was verspreid.
Bewaar het exacte bronbestand, de extractie, prompts, ruwe antwoorden en het scoreformulier. Publiceer alleen materiaal dat je mag delen, en redigeer vertrouwelijke namen of accountgegevens. Een beoordelaar moet elk gescoord antwoord kunnen herleiden van de modeluitvoer naar een pagina in de bewaarde bron.
Waar antwoorden over lange documenten vaak falen
Zonder een run met de huidige build tegen een gespecificeerd document zou het onjuist zijn om te beweren dat V4.1 Flash een bepaald foutpercentage of faalpatroon vertoonde. De onderstaande categorieën zijn dingen om te inspecteren, geen gemeten bevindingen over dit model.
Begin met verlies van reikwijdte. Een hoofdparagraaf kan een regel vermelden, terwijl een voetnoot die beperkt tot een regio, datumreeks of klantcategorie. Vraag expliciet naar de uitzondering en inspecteer of de geciteerde passage die bevat. Een citaat uit alleen de hoofdparagraaf kan onvoldoende zijn.
Controleer vervolgens versieverwarring. Rapporten kunnen vergelijkbare waarden herhalen in een concept en een herziene sectie. Vraag het model de datum of versie te noemen die aan elke waarde is gekoppeld, in plaats van alleen “het huidige nummer” op te vragen. Als het stilzwijgend één waarde kiest, scoor het antwoord dan als onvolledig, zelfs als het toevallig de juiste kiest.
Vragen over secties lokken gevolgtrekkingen uit. Een model kan twee accurate feiten combineren tot een causale verklaring die het document nooit geeft. Eis dat het directe uitspraken apart van gevolgtrekkingen labelt. Vergelijk de gevolgtrekking vervolgens met het bewijs en beslis of die redelijk is voor de taak.
Test ten slotte abstinentie. Neem een vraag op waarvan het antwoord ontbreekt. Een zelfverzekerde gok is een fout, zelfs als die aannemelijk klinkt. Vraag bij contracten, compliance, klinisch materiaal of ingrijpende financiële analyses een gekwalificeerd persoon om de originele tekst te controleren voordat je een conclusie gebruikt.
Een verificatieworkflow voor veiligere antwoorden
Deze prompt maakt antwoorden gemakkelijker te controleren. Het kan correctheid niet garanderen of bronbeoordeling vervangen. Gebruik hem met een extractie die paginalabels behoudt, en stel daarna gerichte vragen in plaats van een algemene samenvatting van een enorm bestand te vragen.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Splits het werk voor een lang rapport op per taak, niet automatisch per willekeurig paginaaantal. Vraag eerst om een bronkaart: sectietitels, datums, gedefinieerde termen en relevante tabellen. Query daarna een specifiek onderwerp en vraag de ondersteunende passages op. Geef of haal voor een conclusie over secties beide passages in dezelfde beurt op en vraag het model het verband uit te leggen en daarbij elke gevolgtrekking te markeren.
Gebruik een menselijke verificatielus:
- Controleer de geciteerde pagina en het citaat in het originele bestand.
- Bevestig dat het citaat naburige uitzonderingen en tabelkoppen bevat.
- Markeer elke claim als direct, afgeleid, niet ondersteund of tegengesproken.
- Repareer de prompt of splits de taak als de extractie belangrijke structuur heeft weggelaten.
- Bewaar het ruwe verzoek en antwoord zodat een beoordelaar de beslissing kan reproduceren.
Wanneer je een gehost endpoint gebruikt, neem dan tokengebruik op in het runlog. De prijzenpagina voor modellen van Atlas Cloud vermeldt momenteel DeepSeek V4.1 Flash tegen $0.30 per 1M invoertokens, $1.20 per 1M uitvoertokens en $0.03 per 1M cache-read-tokens, zonder vermelde korting. Controleer de huidige vermelding voordat je budgetteert. Deze prijsreferentie is voor Atlas Cloud, niet een universele DeepSeek API-prijs.
Bij die vermelde tarieven kosten 100.000 niet-gecachte invoertokens en 3.000 uitvoertokens ongeveer $0.033: $0.030 voor invoer plus $0.0036 voor uitvoer.
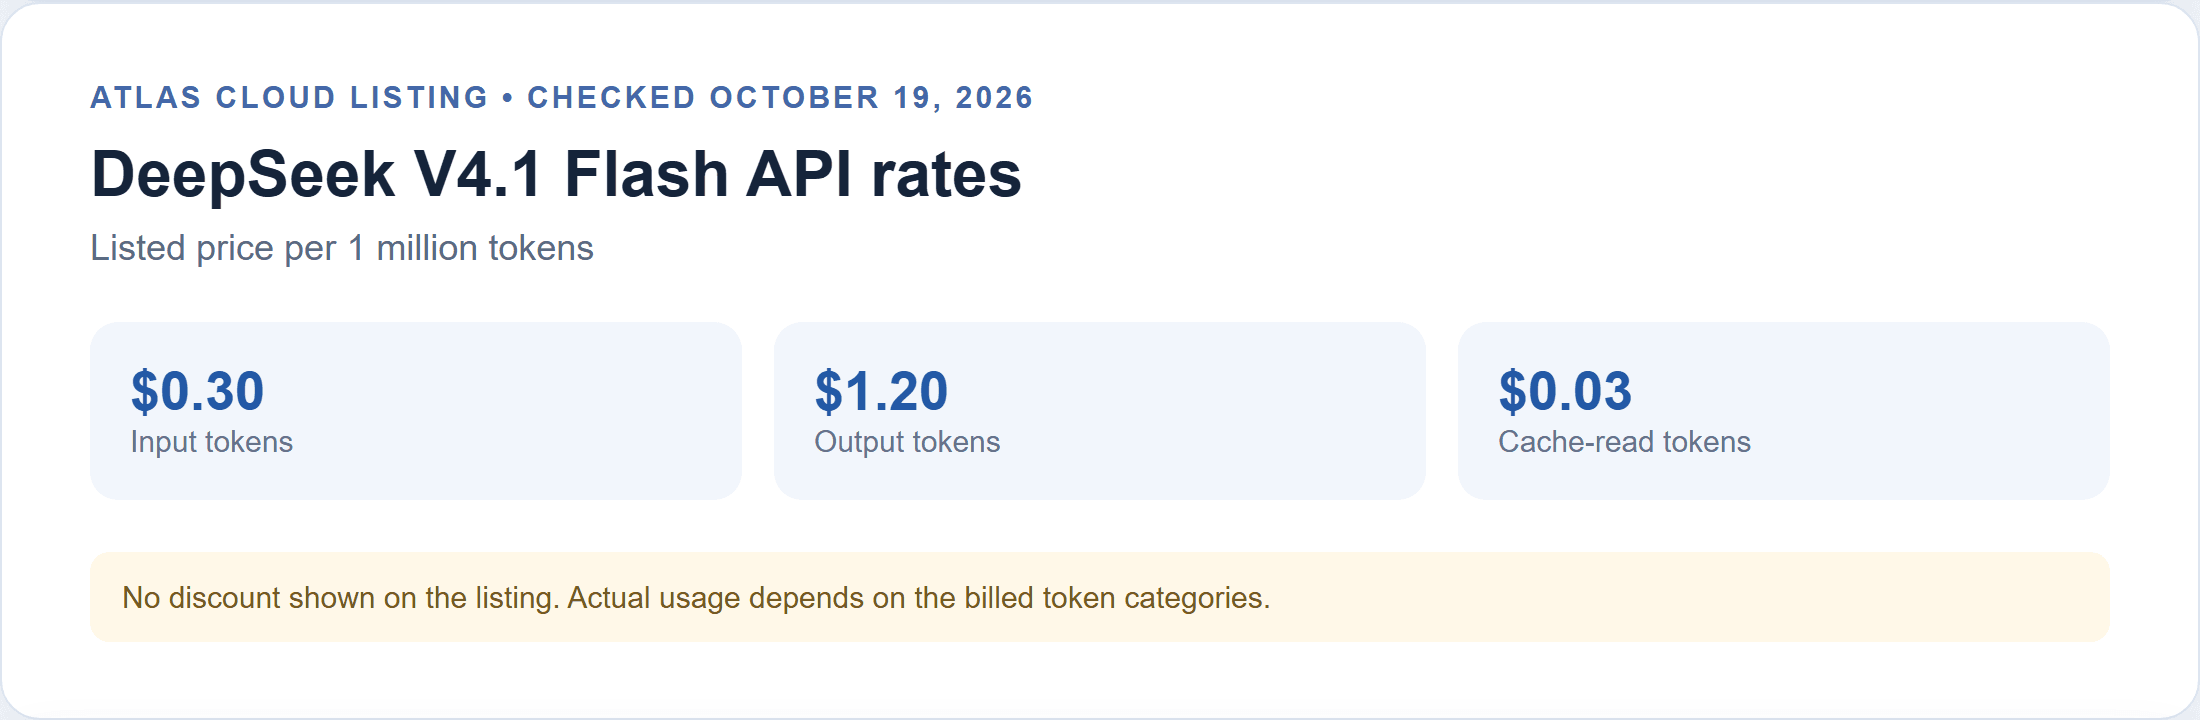
Atlas Cloud-prijzen gecontroleerd op 19 oktober 2026; de vermelding toont geen korting. Een invoer van 1M tokens en een antwoord van 20.000 tokens zouden tegen dezelfde tarieven ongeveer $0.324 kosten, vóór cachebehandeling of andere factureerbare posten. Dit zijn rekenvoorbeelden, geen gemeten documenttestrekeningen. De werkelijke invoer bevat de prompt en geëxtraheerde tekst; herhaalde calls voegen gebruik toe. Gebruik de door de provider geretourneerde tokenaantallen in plaats van te schatten op basis van paginaaantal.
Wanneer je DeepSeek V4.1 Flash voor lange documenten gebruikt
Flash is een redelijke eerste doorgang wanneer je definities moet vinden, datums moet verzamelen, een sectiekaart moet maken of een samenvatting moet opstellen die een persoon zal controleren. Die taken hebben zichtbare bewijssporen en zijn gemakkelijk opnieuw uit te voeren met scherpere vragen. Bewaar voor terugkerend werk vragen met bekende antwoorden en voer ze opnieuw uit wanneer de modelversie, extractiepijplijn of prompt verandert.
Voeg controles toe wanneer een vraag ver uiteenliggende secties combineert, afhankelijk is van een voetnoot of revisies vergelijkt. Gebruik verwijzingen als navigatiehulpmiddelen, niet als bewijs op zichzelf. Als een antwoord van invloed is op een contractuele verplichting, compliancepositie, financiële openbaarmaking of een andere beslissing met grote impact, laat een gekwalificeerde beoordelaar elke materiële claim in de bron verifiëren.
De nuttige vraag is of dit model, op jouw versie van het document en met jouw exacte workflow, antwoorden met bewijs retourneert die controle doorstaan. Dat is de test die de nauwkeurigheid van DeepSeek V4.1 Flash bij de analyse van lange documenten voor jouw eigen use case kan vaststellen.
Veelgestelde vragen
Betekent een contextvenster van 1M tokens dat een model een document van 1M tokens nauwkeurig kan analyseren?
Nee. Het beschrijft de ondersteunde contextcapaciteit. Het werkelijke verzoek bevat ook instructies en uitvoerbudget, terwijl extractie, interfacelimieten en vraagmoeilijkheid bepalen of nuttig bewijs beschikbaar is en correct wordt geïnterpreteerd.
Is LongBench-V2 hetzelfde als nauwkeurigheid bij documentvraagbeantwoording?
Nee. Het bevat verschillende langcontext-taakcategorieën en rapporteert prestaties onder een specifieke opzet. Het is een vergelijkingssignaal, geen garantie voor een bepaalde PDF, API-build, prompt of domein.
Moet ik één prompt gebruiken of een lang document in secties splitsen?
Gebruik een bronkaart en gerichte vragen wanneer structuur belangrijk is. Houd passages die moeten worden vergeleken samen beschikbaar voor de synthesestap, en behoud paginalabels zodat je het antwoord kunt verifiëren.
Hoe moet ik verwijzingen uit een door AI gegenereerde samenvatting verifiëren?
Open elke geciteerde pagina in het originele bestand, controleer het citaat en de omliggende tekst, en bevestig dat de passage de specifieke claim ondersteunt. Controleer tabelkoppen en voetnoten evenals de geciteerde zin.
Hoe beïnvloeden invoer- en uitvoertokens de kosten?
Invoertokens dekken het document, de instructies en de vraag. Uitvoertokens dekken het antwoord. Langere prompts, meerdere calls en herhaalde passages verhogen het gebruik; gebruik gefactureerde tokenaantallen en de actuele prijstabel van de provider voor schattingen.


