

Een ontwikkelaar ziet "1M tokens" en maakt zich klaar om een volledige repository, de issuegeschiedenis en een lang ontwerprapport in één verzoek te sturen. Het belangrijkste detail in het Gemini 4 Argon 1M-contextvenster is dat 1.048.576 tokens worden gedeeld door invoer, denken en uitvoer. Het zijn niet één miljoen invoertokens plus nog een miljoen voor het antwoord. Google vermeldt een standaardlimiet voor synchrone uitvoer van 65.536 tokens, terwijl long decode de generatie kan verlengen tot de resterende gedeelde capaciteit. Google's modelspecificatie levert de limieten; deze gids zet ze om in een budget en een beslissing over long context, retrieval en chunking.
Belangrijkste punten
- De context van 1.048.576 tokens is een gecombineerd budget voor invoer, denken en uitvoer.
- Standaard synchrone uitvoer is beperkt tot 65.536 tokens; long decode voegt geen extra context toe.
- Gebruik long context wanneer relaties binnen een bekende bronverzameling belangrijk zijn; gebruik retrieval of chunking wanneer dat niet zo is.
Wat betekent het 1M-contextvenster van Gemini 4 Argon?
Het budget van 1.048.576 tokens wordt gedeeld
Een contextvenster is de tokenlimiet die beschikbaar is voor een verzoek. Voor Argon documenteert Google een uniform totaal van 1.048.576. De prompt, bijgevoegd bronmateriaal, denktokens en het gegenereerde antwoord komen uit deze ruimte. Het beschrijft capaciteit, niet een belofte dat elk detail even gemakkelijk is op te halen of te beredeneren.
Als een verzoek 900.000 brontokens bevat, blijven er vóór interfacespecifieke beperkingen maximaal 148.576 over voor denken en uitvoer. Een applicatie die aanneemt daarna een antwoord van 200.000 tokens te kunnen aanvragen, heeft hetzelfde budget overschreden.
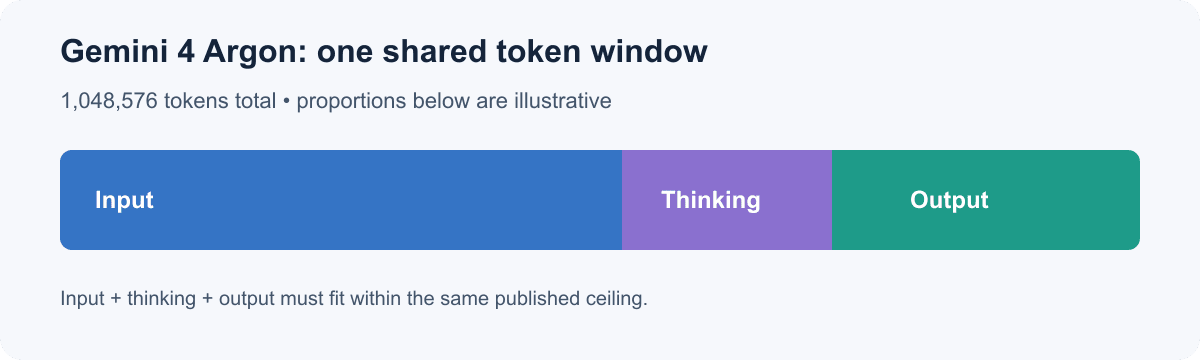
Het gepubliceerde venster is één gedeeld plafond. Segmentgroottes zijn conceptueel, geen vaste toewijzing.
Invoer, denken en uitvoer komen uit één venster
Een nuttige planningsvergelijking is:
input tokens + thinking tokens + output tokens <= 1,048,576
Dit is een budgetcontrole, geen bewering dat ontwikkelaars voor elke aanroep een exact aantal denktokens kunnen instellen. Google vermeldt denkinstellingen laag, gemiddeld en hoog; het interne verbruik kan per taak en instellingen variëren. Reserveer ruimte voor redeneren in plaats van de theoretische rest te behandelen als gegarandeerde antwoordcapaciteit.
Argon accepteert tekst-, afbeeldings-, video-, audio- en PDF-invoer, met tekstuitvoer. Het berekenen van media is niet gelijk aan platte tekst, dus een bestands- of paginatelling kan het totale aantal tokens niet betrouwbaar voorspellen. Inspecteer gebruiksmetadata van een representatief verzoek.
Contextvenster versus uitvoerlimiet: het cruciale verschil
De standaardlimiet voor uitvoer
De modelpagina vermeldt een maximale uitvoer van 65.536 tokens voor standaard synchrone generatie, ongeveer een zestiende van het totale venster. Een verzoek kan binnen de algehele contextlimiet passen en toch de actieve uitvoerlimiet overschrijden.
Voor veel applicaties is die standaard ruim voldoende. Een repository-review of documentsynthese heeft meestal een gericht antwoord nodig, niet een antwoord dat even lang is als de bronverzameling. Een begrensde uitvoer is gemakkelijker te beoordelen, op te slaan en door te geven aan een volgende stap.
Wat long decode verandert
Long decode ondersteunt veel langere generatie, tot 1.048.576 tokens volgens de modelspecificatie. Het vergroot het totale venster niet. Als de prompt al het grootste deel ervan inneemt, blijft er minder capaciteit over voor denken en uitvoer. Het API-pad, de SDK, aanvraaginstellingen en responsafhandeling zijn ook van belang, dus controleer de actuele integratierichtlijnen voordat je in productie op een lang antwoord vertrouwt.
Gebruik long decode alleen wanneer het eindproduct echt uitgebreid gegenereerd materiaal nodig heeft, zoals een grote gestructureerde transformatie die in één bewerking wordt geretourneerd. Als het antwoord kan worden opgesplitst in gevalideerde secties, kan gefaseerde generatie onvolledige resultaten gemakkelijker detecteerbaar en herstelbaar maken.
Hoe je invoer-, denk- en uitvoertokens budgetteert
Begin met het eindproduct en schat daarna brontokens met de telmethode van het gekozen model, waar beschikbaar. Tel ook instructies, resultaten van tools, schematekst en gespreksgeschiedenis mee. Reserveer een marge voor denken en schattingsfouten in plaats van de theoretische rest te besteden.
De onderstaande cijfers zijn rekenvoorbeelden, geen vast redeneerverbruik. "Planningsrestant" is het totaal na de veronderstelde invoer en gereserveerde denkruimte. De werkelijke servicelimieten blijven van toepassing.
| Veronderstelde invoer | Denkreserve | Planningsrestant voor uitvoer | Voorbeeld |
|---|---|---|---|
| 120.000 | 20.000 | 908.576 | Meerdere handleidingen, beknopte synthese |
| 500.000 | 40.000 | 508.576 | Codebase-review met bestandsreferenties |
| 900.000 | 50.000 | 98.576 | Archiefvergelijking met een begrensd antwoord |
Illustratieve berekening vanaf een plafond van 1.048.576 tokens; reserves zijn planningsaannames.
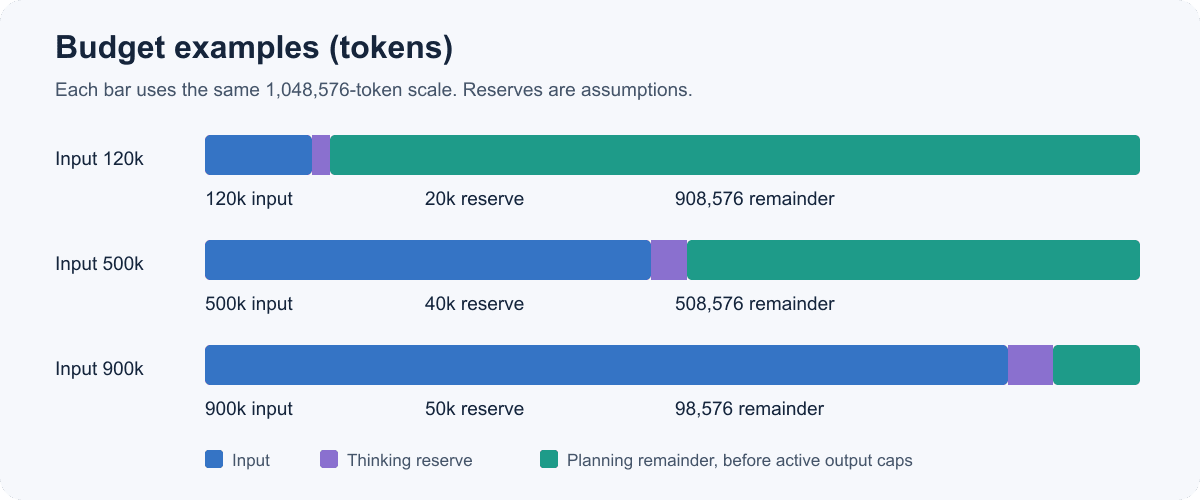
Gebruik deze checklist voor het plannen van verzoeken:
- Invoer: geschatte bron- en prompttokens.
- Denken: reserveer capaciteit op basis van taakcomplexiteit en ondersteunde instellingen.
- Uitvoer: kies een limiet die bij het eindproduct past.
- Controle: tel de drie bedragen op en laat ruimte voor schattingsfouten.
- Pad: bevestig dat het gekozen endpoint of de SDK de uitvoerlengte en continuatiegedrag ondersteunt.
Voor een codebase-review van 500.000 tokens kan een team 40.000 tokens reserveren voor denken en mikken op een antwoord van 25.000 tokens. Dat plan gebruikt op papier 565.000 tokens en laat ruimte voor onnauwkeurige schattingen of extra instructies. Het team moet nog steeds het werkelijke gebruik en de geconfigureerde generatielimieten verifiëren. De reserve is een planningsinstrument, geen voorspelling van interne redenering.
Bemonster vóór een batchrun meer dan één type verzoek. Een korte documentatiepagina, een codezware module en een PDF met tabellen kunnen verschillende tokenaantallen opleveren, zelfs als hun bestandsgroottes vergelijkbaar lijken. Tel representatieve invoeren en vergelijk schattingen met het door de API geretourneerde gebruik. Als de werkelijke rapportage van denken of uitvoer van het model afwijkt van je aannames, werk dan de reserve en limiet bij voordat je de batchgrootte vergroot. Deze kleine kalibratiestap helpt een long-context-workflow binnen zijn token- en budgetkader te houden.
Wat past er in een miljoen tokens?
Documenten, code en multimodaal materiaal
Een miljoen tokens kan een analyse in één doorgang aannemelijk maken voor een set handleidingen, meerdere contracten, een grote bronboom of een lang transcript met notities. Google heeft ruwe illustraties gebruikt zoals ongeveer 1.500 pagina's tekst of 30.000 regels code. Beschouw deze als schaalvoorbeelden, niet als garanties. Lay-out, codedichtheid, taal, opmaak en tokenisatie beïnvloeden allemaal de telling.
Neem voor repositorywerk buildbestanden, gegenereerde code, opmerkingen, afhankelijkheidsmetadata, tests en relevante issuecontext op in je schatting. Vraag je daarna af of de taak alles nodig heeft. Een cross-module-architectuurreview kan baat hebben bij een brede bronverzameling; een vraag over één foutmelding waarschijnlijk niet.
Multimodale invoer maakt schattingen ook ingewikkelder. De duur van een video, framebemonstering, audio, resolutie en API-behandeling kunnen het gebruik en het bewijs dat het model ziet beïnvloeden. Neem voor een smalle vraag alleen relevante media op en inspecteer het gebruik van een representatief verzoek voordat je opschaalt.
Tokenaantallen zijn geen paginatellingen
Een token is een verwerkingseenheid van het model, geen woord, teken, pagina of regel. Identifiers, tabellen, broncode en niet-Engelstalige tekst kunnen anders tokeniseren dan gewone prozatekst. Een paginaschatting kan je niet vertellen of jouw specifieke verzameling past.
Capaciteit is ook iets anders dan kwaliteit. Dat een bronverzameling past, bewijst niet dat het model elke verborgen uitzondering vindt, elke afhankelijkheid behoudt of tegenstrijdige passages correct oplost. De specificatie stelt een limiet vast, geen uitputtend terugvinden of een taakspecifieke nauwkeurigheidsscore. Vraag voor ingrijpende conclusies bronlocaties op en valideer belangrijke claims tegen de originelen.
Wanneer een 1M-venster helpt, en wanneer niet
Long context is het nuttigst wanneer een antwoord afhangt van relaties die verspreid zijn over materiaal dat een eenvoudige query mogelijk niet ophaalt. Het is minder overtuigend voor herhaalde smalle vragen over een veranderend corpus, waar retrieval een kleinere bewijsset kan selecteren. Dit zijn workflowafwegingen, geen universele nauwkeurigheidsrangschikking.
| Benadering | Overweeg het wanneer | Afweging |
|---|---|---|
| Long-context-verzoek | Een eenmalige analyse relaties nodig heeft binnen een bekende bronverzameling | Grote invoer kan kosten en latentie verhogen; verifieer de dekking |
| Retrieval | Gebruikers herhaalde vragen stellen over een veranderend corpus | Indexering en retrieval bepalen welk bewijs het model bereikt |
| Chunking | Documenten als onafhankelijke eenheden of fasen kunnen worden verwerkt | Relaties tussen chunks moeten worden afgestemd |
| Hybride | Je brede oriëntatie nodig hebt, gevolgd door gerichte bewijscontroles | Meer orchestratie en state-afhandeling |
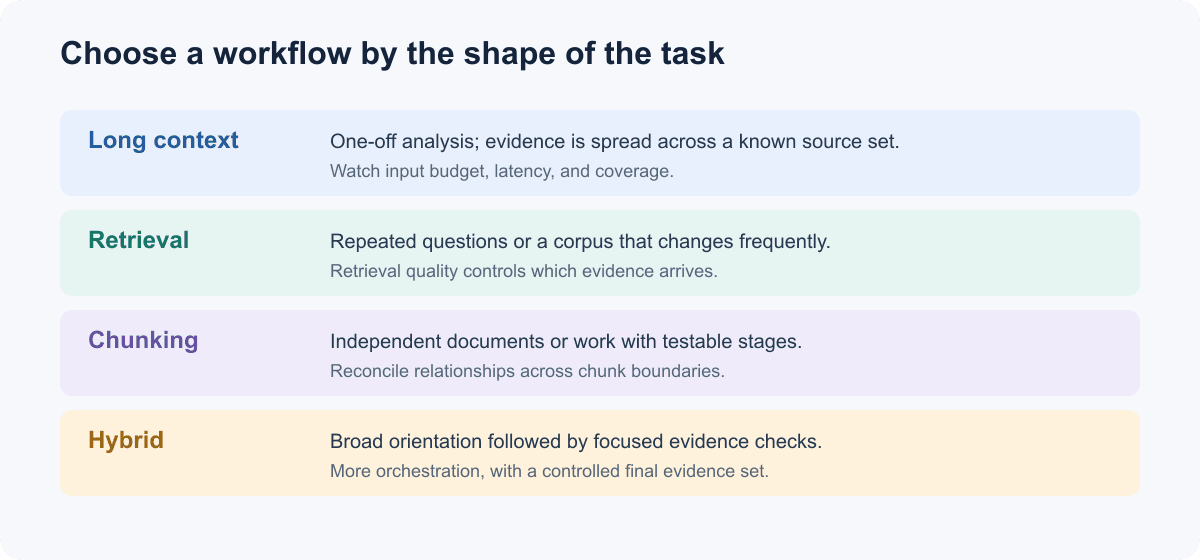
Kies op basis van de taakvorm en het querypatroon en valideer vervolgens op representatieve invoeren.
Overweeg long context voor het vergelijken van beleidsstukken waarvan de clausules elkaar beïnvloeden, het beoordelen van een wijziging over vele softwaremodules, of het synthetiseren van documenten waarbij een detail in de ene bron de interpretatie van de andere verandert. Retrieval past bij herhaalde supportvragen tegen een groeiende kennisbank. Chunking werkt wanneer broneenheden onafhankelijk zijn of elke fase een testbare uitvoer heeft. Een hybride workflow kan de verzameling eerst in kaart brengen en daarna passages ophalen en verifiëren voor een definitief antwoord.
Evalueer opties tegen dezelfde representatieve vragen. Houd bij of het vereiste bewijs is opgenomen, of citaties naar de juiste passages verwijzen, tokengebruik, responstijd en herstelinspanning na een onvolledig antwoord. Dat geeft je team bewijs voor zijn workload in plaats van aan te nemen dat een groter venster het automatisch verbetert.
Gemini 4 Argon gebruiken voor long-contexttaken
Bevestig de model-ID en het aanvraagpad
Google vermeldt de Gemini API-model-ID als gemini-4-argon. Bevestig dat deze is ingeschakeld voor je account en dat het exacte API-oppervlak de functies ondersteunt die je nodig hebt. Dezelfde modelnaam garandeert niet dat elke proxy, SDK, console of client identieke limieten of long-decodegedrag biedt.
Controleer vóór productie:
- De model-ID en beschikbaarheid voor je account of regio.
- De limiet voor synchrone uitvoer en hoe long decode wordt aangevraagd of geretourneerd.
- Of de SDK continuatie afhandelt en hoe deze gedeeltelijke of mislukte responses rapporteert.
- Ondersteunde denkinstellingen, tools, caching en modaliteiten voor de geselecteerde API.
- De werkelijke invoer- en uitvoerverbruikvelden van het verzoek.
Google's long-contextgids beschrijft het uniforme budget. De SDK- en API-richtlijnen kunnen veranderen, dus pin een ondersteunde SDK-versie, inspecteer het huidige voorbeeld en doe integratietests met hetzelfde transport en dezelfde responsafhandeling als gepland voor productie. Kopieer geen parameternamen uit een oudere modelintegratie zonder te controleren dat ze nog steeds van toepassing zijn.
Maak het uitvoercontract kleiner dan de bronverzameling
Geef het model een begrensde taak en responsvorm. Vraag voor een repository-audit om bevindingen gegroepeerd naar ernst, met bestandspaden en regelverwijzingen, en geef aan of hypothesen moeten worden opgenomen of alleen bevestigde defecten. Noem voor een contractvergelijking de clausules en vraag om sectie-identifiers of korte ondersteunende fragmenten. Dit is gemakkelijker te beoordelen dan "alles analyseren". Plan voor grote responses op continuatie en gedeeltelijke voltooiing. Bewaar identifiers en responschunks wanneer de SDK ze beschikbaar stelt, valideer gestructureerde uitvoer vóór downstreamgebruik en probeer indien mogelijk alleen een mislukt deel opnieuw. Dit zijn waarborgen om te implementeren en verifiëren, geen bewering dat elke SDK onderbrekingen identiek afhandelt.
Prijzen en toegang: wat je moet verifiëren voordat je begint
De aankondiging van Google vermeldt momenteel introductietarieven van $2 per miljoen invoertokens en $10 per miljoen uitvoertokens tot 30 november 2026, gevolgd door vastgestelde tarieven van $4 en $20 per miljoen. Dit is tijdsgevoelig: controleer de officiële aankondiging van Gemini 4 Argon opnieuw voordat je publiceert of uitgaven voorspelt. Schat invoer en uitvoer afzonderlijk, omdat promptzware en generatiezware workloads verschillende kostenprofielen hebben.
Beschikbaarheid van Argon via Atlas Cloud is niet bevestigd op de directorypagina's die voor dit artikel zijn gecontroleerd. De Atlas Gemini-modelcatalogus toont de Gemini-modellen en toegangsdetails die daar momenteel worden vermeld; dit bewijst niet dat Argon beschikbaar is. Bevestig een modelspecifieke detailpagina, protocol en prijs voordat je verzoeken routeert of kosten vergelijkt.
Begin met een representatief verzoek en registreer model- en SDK-versies, tokengebruik, latentie, fouten en taakspecifieke kwaliteitscontroles. Herzie het budget en de retrievalkeuze wanneer bronverzamelingen of querypatronen veranderen. Het Gemini 4 Argon 1M-contextvenster is nuttig wanneer zijn breedte een echt cross-sourceprobleem oplost en je verzoek een duidelijk budget en verificatieplan heeft.
Veelgestelde vragen
Wordt het 1M-venster van Gemini 4 Argon gedeeld door invoer en uitvoer?
Ja. Google definieert één venster van 1.048.576 tokens, gedeeld door invoer, denken en uitvoer. Hoeveel er voor een antwoord overblijft, hangt af van het verzoek en de geldende interfacelimieten.
Wat is de standaard uitvoerlimiet van Gemini 4 Argon?
De specificatie vermeldt 65.536 tokens voor standaard synchrone uitvoer. Long decode kan grotere generatie ondersteunen, afhankelijk van de resterende gedeelde capaciteit en het API-pad.
Kan Gemini 4 Argon 1M tokens in één antwoord genereren?
De modelpagina vermeldt long decode tot 1.048.576 uitvoertokens, maar dit is een bovengrens van de mogelijkheid, geen garantie dat een verzoek met invoer ook een miljoen tokens kan retourneren. Invoer en denken bezetten hetzelfde totale venster.
Betekent een 1M-contextvenster dat elk detail nauwkeurig wordt herinnerd?
Nee. Het beschrijft het maximale tokenbudget, niet perfecte retrieval of redenering. Vraag om bewijsreferenties en test bekende edge cases uit je eigen materiaal.
Is Gemini 4 Argon momenteel beschikbaar via Atlas Cloud?
Ik kon geen Argon-specifieke modellijst of detailpagina bevestigen in de Atlas Cloud-catalogus die voor dit artikel is gecontroleerd. Controleer de huidige directory voordat je ondersteuning aanneemt; de Gemini-cataloguslink hierboven bewijst op zichzelf niet dat Argon beschikbaar is.


