

Een video-upload kan het antwoord bevatten dat je nodig hebt en toch verkeerd worden gelezen. Gemini 4 Argon kan tekst, afbeeldingen, video, audio en PDF's als invoer aannemen en vervolgens tekst retourneren die details daarin analyseert of met elkaar verbindt. De multimodale mogelijkheden van Gemini 4 Argon zijn het nuttigst wanneer je taak is bestaand materiaal te inspecteren, niet nieuwe media te maken. De uniforme contextlimiet is 1.048.576 tokens, maar dat is een capaciteitslimiet, geen nauwkeurigheidsgarantie. Hieronder staat een taak-voor-taakgids over wat het kan analyseren, hoe je het antwoord verifieert en waar de huidige API en Atlas Cloud passen.
Belangrijkste punten
- Argon accepteert tekst, afbeeldingen, video, audio en PDF als invoer; de gedocumenteerde uitvoer is tekst.
- De context van 1.048.576 tokens wordt gedeeld door invoer en uitvoer. Standaard synchrone uitvoer is beperkt tot 65.536 tokens.
- Beeldgeneratie, audiogeneratie en Live API worden niet ondersteund door het Argon-model.
- Verifieer beweringen aan de hand van paginanummers, tijdstempels of zichtbaar bewijs voordat je ze in een workflow gebruikt.
Wat ‘multimodaal’ betekent voor Gemini 4 Argon
Voor de Gemini API betekent multimodaal dat Argon verschillende soorten bronmateriaal in één verzoek kan ontvangen en over dat materiaal kan redeneren naast tekstinstructies. De huidige Gemini API-modelpagina vermeldt tekst-, afbeeldings-, video-, audio- en PDF-invoer, met tekst als uitvoer. Ook worden gestructureerde uitvoer, functieaanroepen, code-uitvoering, bestandszoekopdracht en zoekgronding genoemd onder de ondersteunde mogelijkheden. Die hulpmiddelen kunnen een workflow vormgeven, maar ze veranderen de uitvoermodaliteit niet in een afbeelding, audiotrack of livegespreksstream. (Google AI for Developers, oktober 2026)
De tokencijfers moeten zorgvuldig worden gelezen. Google vermeldt een uniform contextvenster van 1.048.576 tokens voor invoer en uitvoer samen. Een normaal synchroon verzoek heeft een maximale uitvoer van 65.536 tokens; long decode kan tot 1.048.576 bereiken volgens de gedocumenteerde achtergrondcontinuatiestroom. Als je prompt en bijgevoegde inhoud het grootste deel van het gedeelde venster verbruiken, blijft er minder ruimte over voor redenering en antwoordtekst. De kop “1M context” betekent niet dat elk verzoek van een miljoen tokens in één gewoon antwoord past.
| Materiaal dat je aanlevert | Gedocumenteerde invoer? | Argon-uitvoer | Een nuttige eerste taak | Te controleren bewijs |
|---|---|---|---|---|
| Tekst en PDF | Ja | Tekst | Een rapport samenvatten of beweringen tussen secties vergelijken | Pagina, kop, tabelrij of geciteerde passage |
| Afbeelding | Ja | Tekst | Een grafiek lezen, objecten identificeren of twee afbeeldingen vergelijken | Labels, waarden, locaties en beeldbijsnijding |
| Video | Ja | Tekst | Gebeurtenisvolgorde beschrijven of een moment in een clip vinden | Tijdstempel en het daadwerkelijke frame |
| Audio | Ja | Tekst | Vragen beantwoorden over een geüploade opname | Audiosegment, transcript, spreker of geluid |
| Gegenereerde media | Geen beeld-/audiogeneratie vermeld | Tekst | Een schriftelijke analyse of gestructureerd resultaat retourneren | Schema en bronondersteuning |
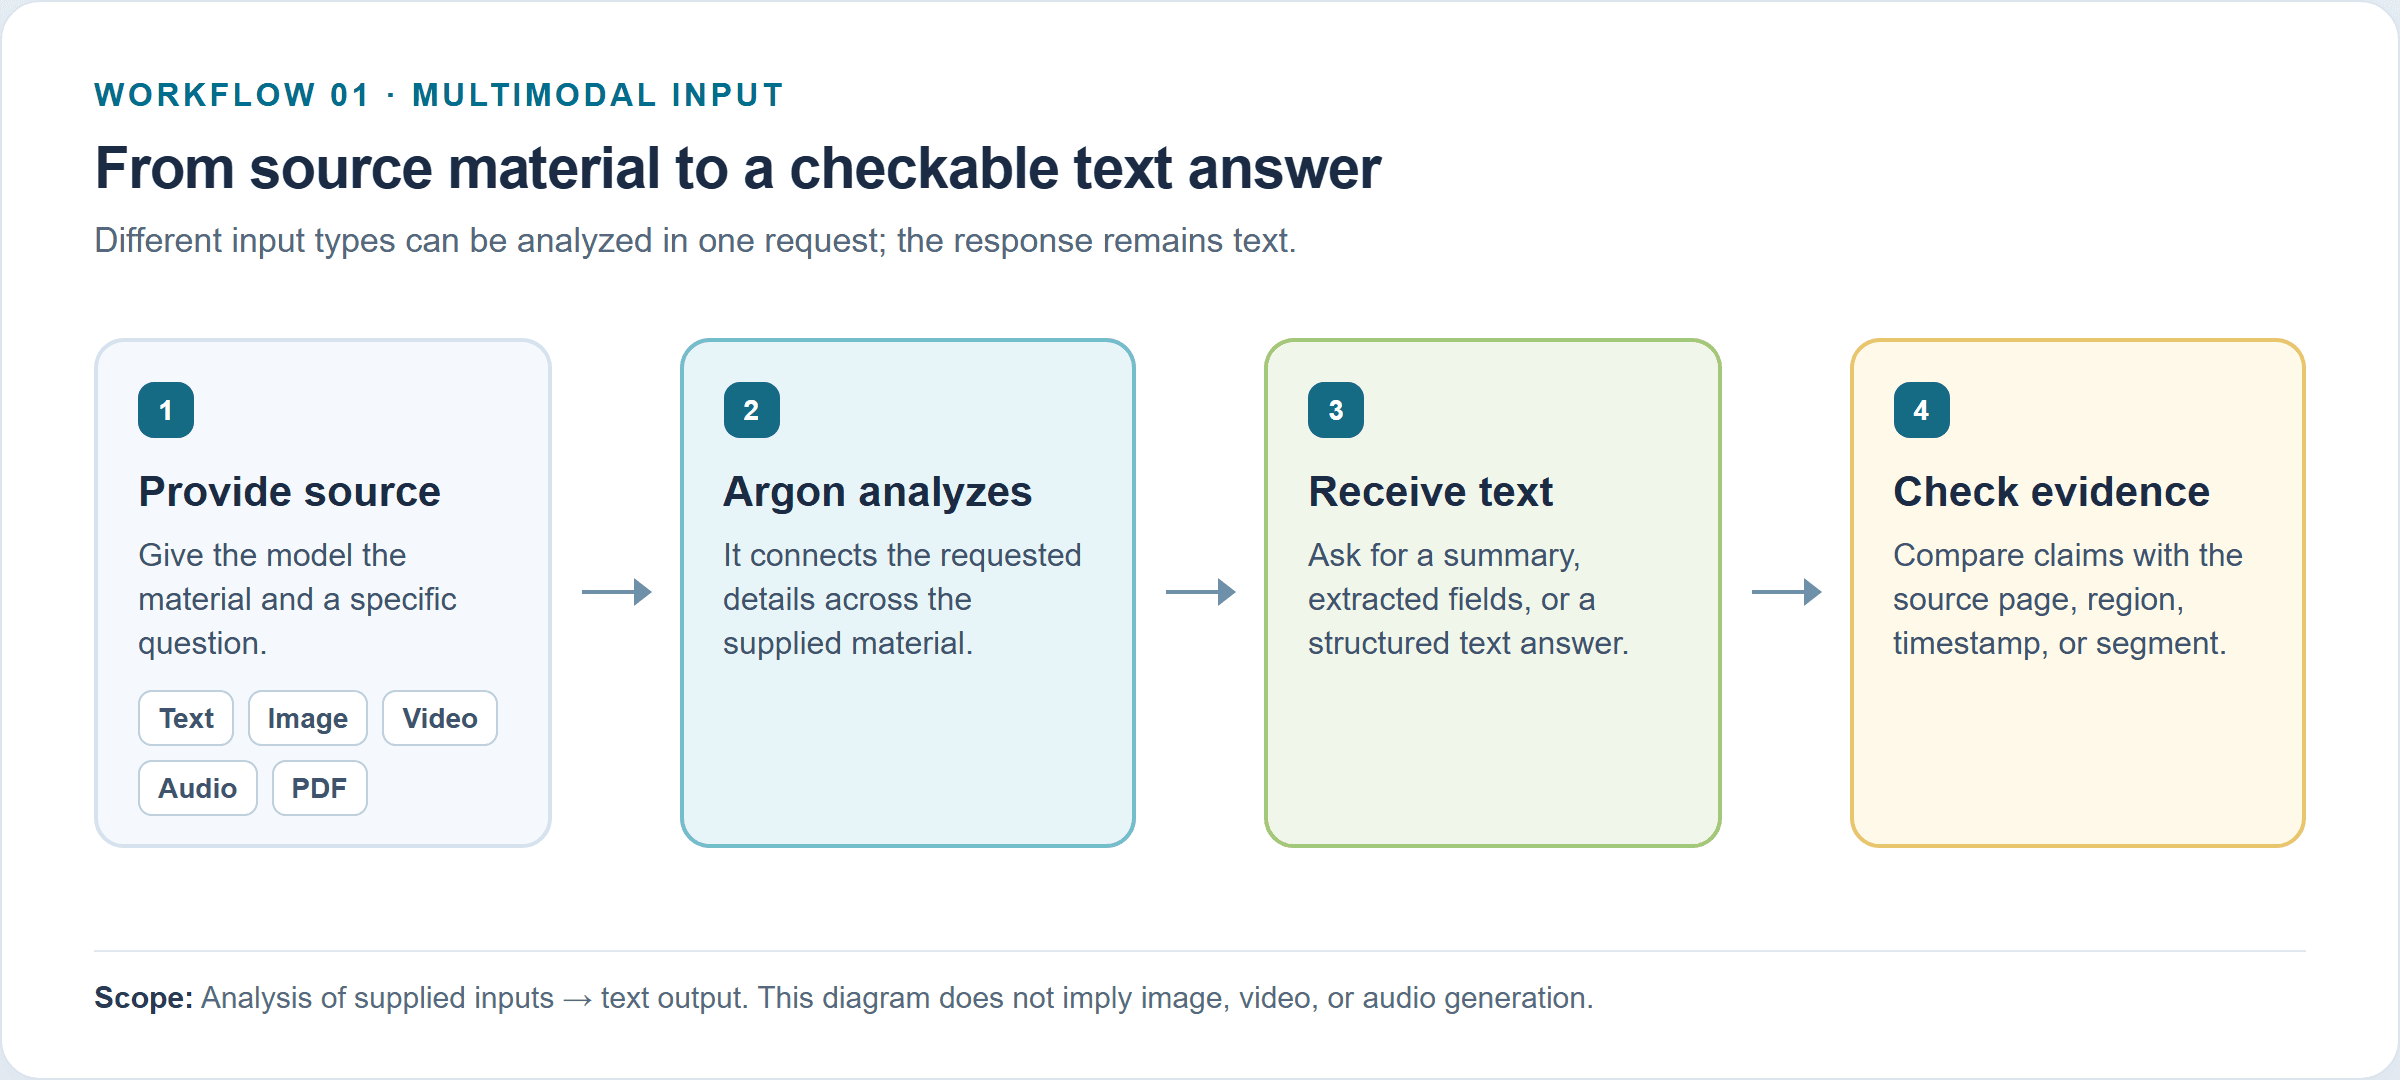 Workflowillustratie: aangeleverde tekst, afbeelding, video, audio of PDF wordt geanalyseerd tot een tekstantwoord en vervolgens gecontroleerd aan de hand van bronbewijs.
De Gemini-app kan functies bieden die media samenstellen of creëren via andere modellen en tools. Ga er niet van uit dat die functies op appniveau mogelijkheden zijn van het gemini-4-argon-API-model zelf. Gebruik voor een implementatiebeslissing de API-mogelijkhedentabel en de exacte model-ID in plaats van een productfamilielabel.
Wat Gemini 4 Argon kan analyseren in afbeeldingen, video, audio en PDF's
De beste manier om te bepalen of Argon past, is benoemen welk bewijs je taak nodig heeft. 'Een video begrijpen' is te breed. 'Vind elke keer dat de operator een onderdeel in de lade plaatst en citeer vervolgens de tijdstempel' is testbaar.
Afbeeldingen: inspecteren, vergelijken en visuele informatie extraheren
Bij een afbeeldingsverzoek kan Argon worden gevraagd een scène te beschrijven, twee aangeleverde afbeeldingen te vergelijken, zichtbare tekst te extraheren, een grafiek te interpreteren of visuele bevindingen in een gestructureerd formaat te retourneren. Dit zijn analysetaken: de uitvoer is tekst of gestructureerde tekst. Ze kunnen een supportteam helpen productfoto's te triageren, een onderzoeker figuren te scannen of een operator labels uit een afbeeldingsset te extraheren.
Onafhankelijke tests bieden een nuttige realiteitscheck, mits je ze behandelt als één benchmarkopzet en niet als een voorspelling voor je eigen afbeeldingen. Roboflow's Vision Evals van oktober 2026 noemt Argon bij de beste modellen in de geteste taken voor objectdetectie, OCR en visueel redeneren. De OCR-evaluatie splitst exacte transcriptie en gerelateerde subtaken, en het artikel meldt zwakke plekken zoals kleine of wazige tekst en moeilijkere visuele interpretaties. De opzet, geselecteerde afbeeldingen, prompts en scoring bepalen die resultaten; ze stellen geen algemeen slagingspercentage vast voor elke scan of grafiek. (Roboflow, oktober 2026)
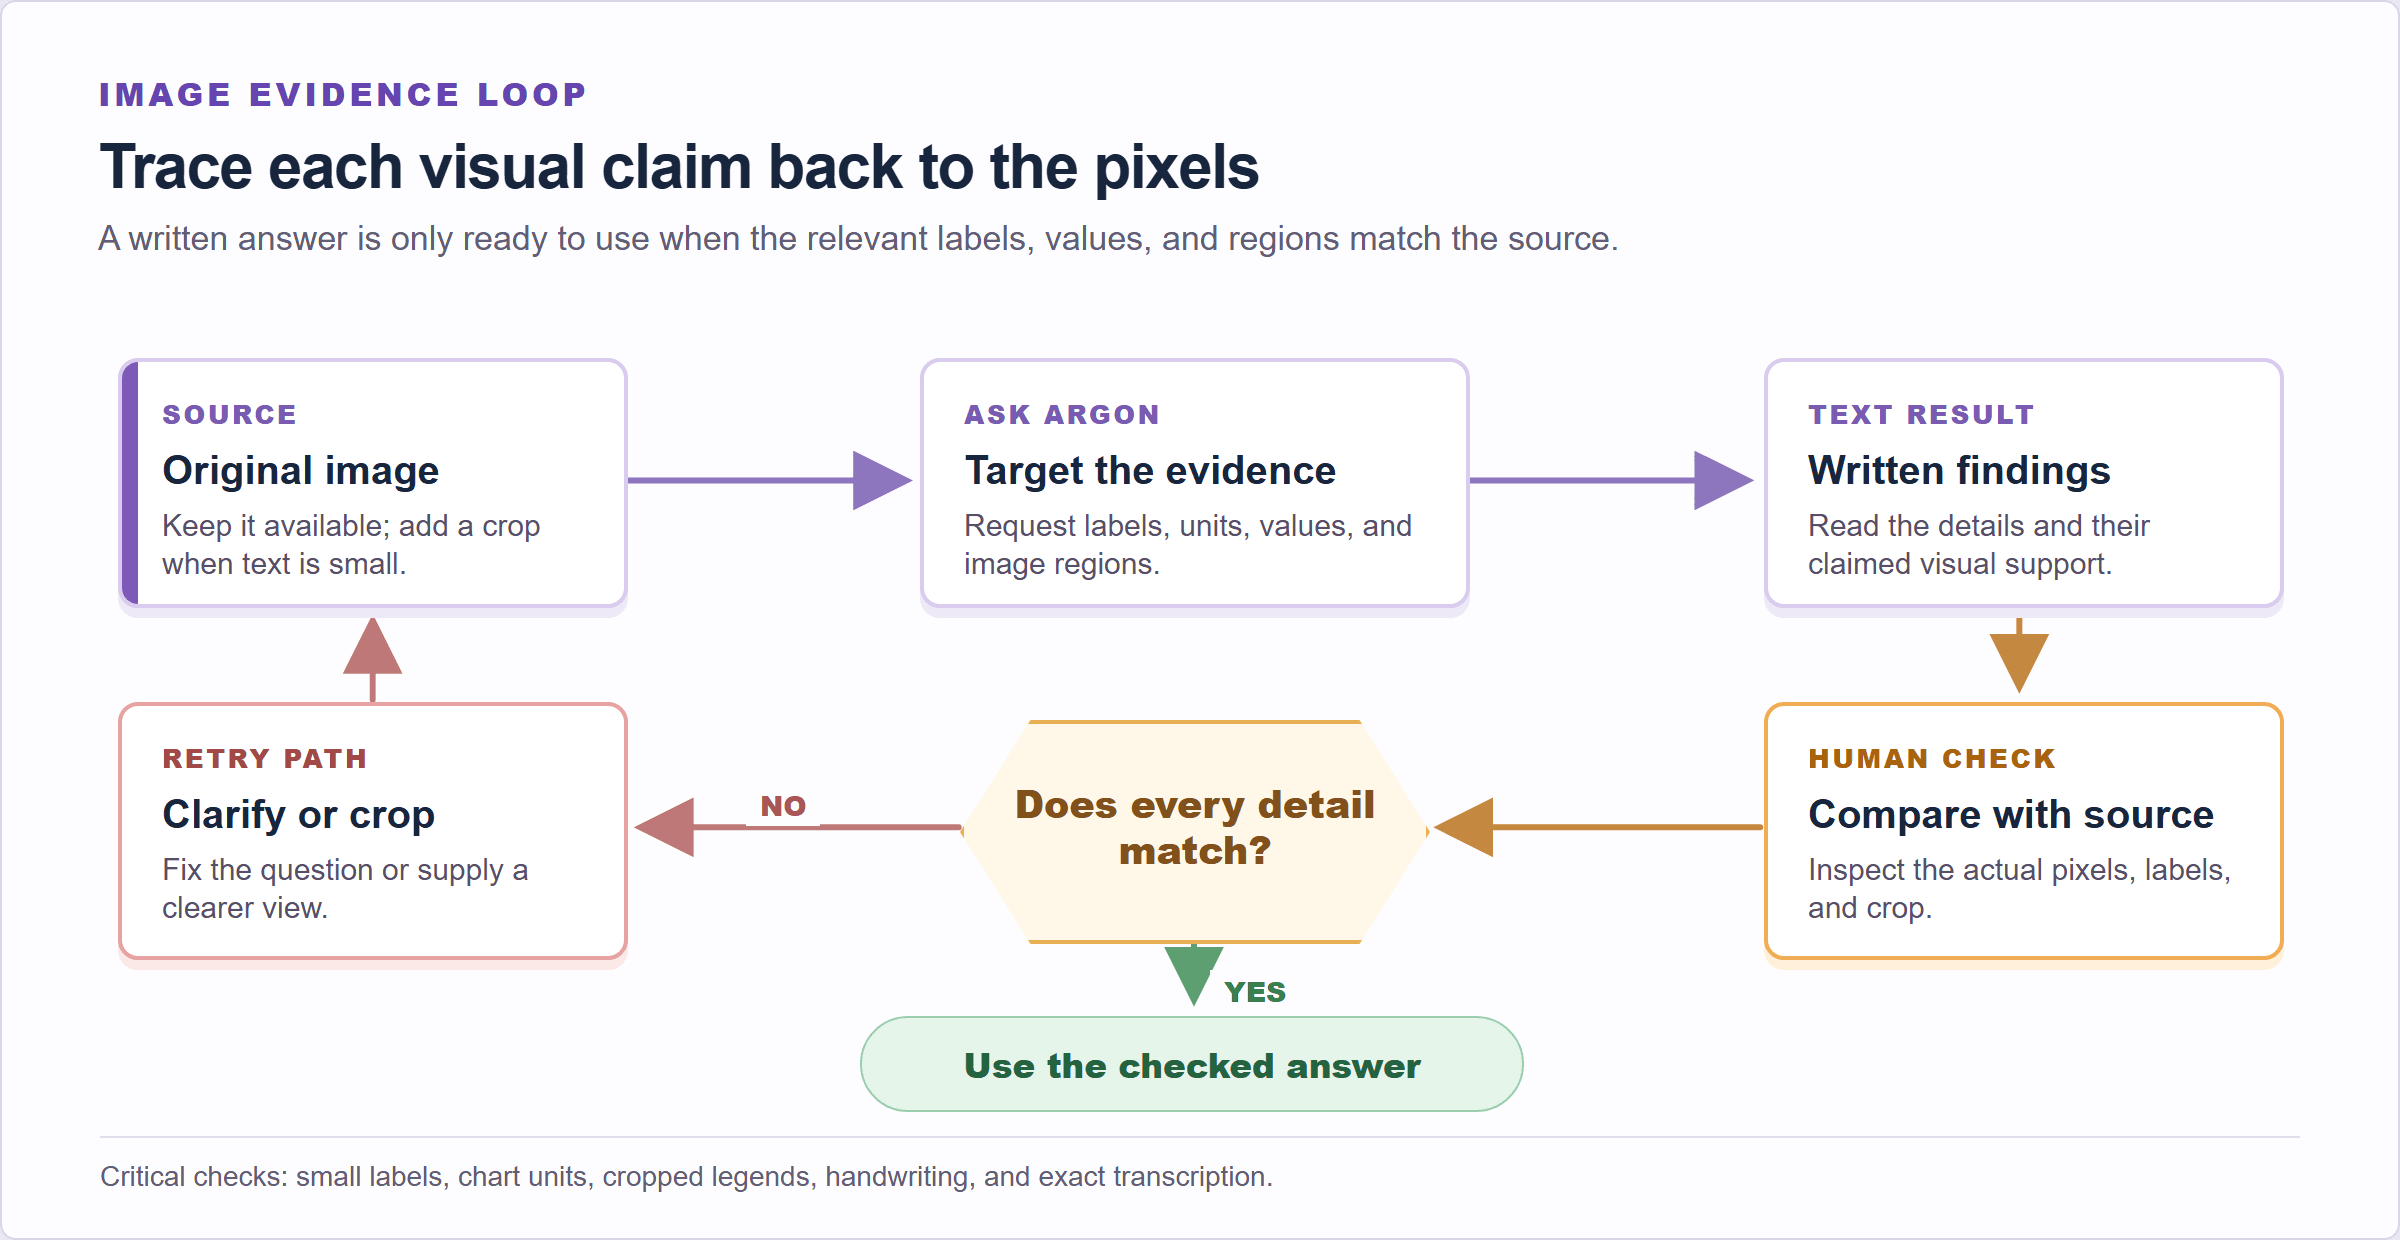 Workflowillustratie: vraag om beelddetails en de ondersteunende regio's ervan en verifieer elke bewering aan de hand van de originele afbeelding.
Vraag bij een grafiek om de titel, assen, eenheden, relevante waarden en het beeldgebied dat elke waarde ondersteunt. Vergelijk die details vervolgens met de bron. Kleine labels, screenshots met lage resolutie, handschrift, overlappende markeringen of een bijgesneden legenda verdienen handmatige controle. Als exacte transcriptie belangrijk is, voeg dan een duidelijke uitsnede toe en bewaar het origineel zodat een reviewer elk teken kan controleren.
Video: redeneren over gebeurtenissen in de tijd
Video voegt ordening en tijd toe. Argon kan vragen beantwoorden over acties, veranderingen en gebeurtenissen in frames. De API ondersteunt agentisch videobegrip, een optie die de tijdlijn dynamisch kan inspecteren; de gedocumenteerde standaardmodus is statisch. Controleer de videogids en aanvraaginstellingen voor de modus die je integratie daadwerkelijk gebruikt.
Een nuttige productievraag kan zijn: 'Hoe laat verwijdert de technicus het filter, en wat gebeurt er direct voor en na?' Vraag om tijdstempels en inspecteer die momenten vervolgens. Een vloeiende beschrijving zonder tijdsgebonden bewijs is niet genoeg voor incidentonderzoek, kwaliteitscontroles of trainingsdata.
Het roboticateam van Google beschrijft een Argon-workflow die een overheadopname van 136 seconden analyseert van een tweearmige robot die papier tot een origamivos vouwt. Het systeem produceert een hiërarchie van tijdsgebonden annotaties, van de algemene taak tot subtaken en acties op contactniveau, met kwaliteitscontrolelabels rond nieuwe pogingen. Dit is een concreet voorbeeld van videoanalyse-uitvoer die bestaat uit labels en structuur die aan beeldmateriaal zijn gekoppeld. Het artikel is een onderzoeksvoorbeeld, geen garantie dat een algemene API-aanroep een roboticapijplijn zal reproduceren. (Google Developers Blog, oktober 2026)
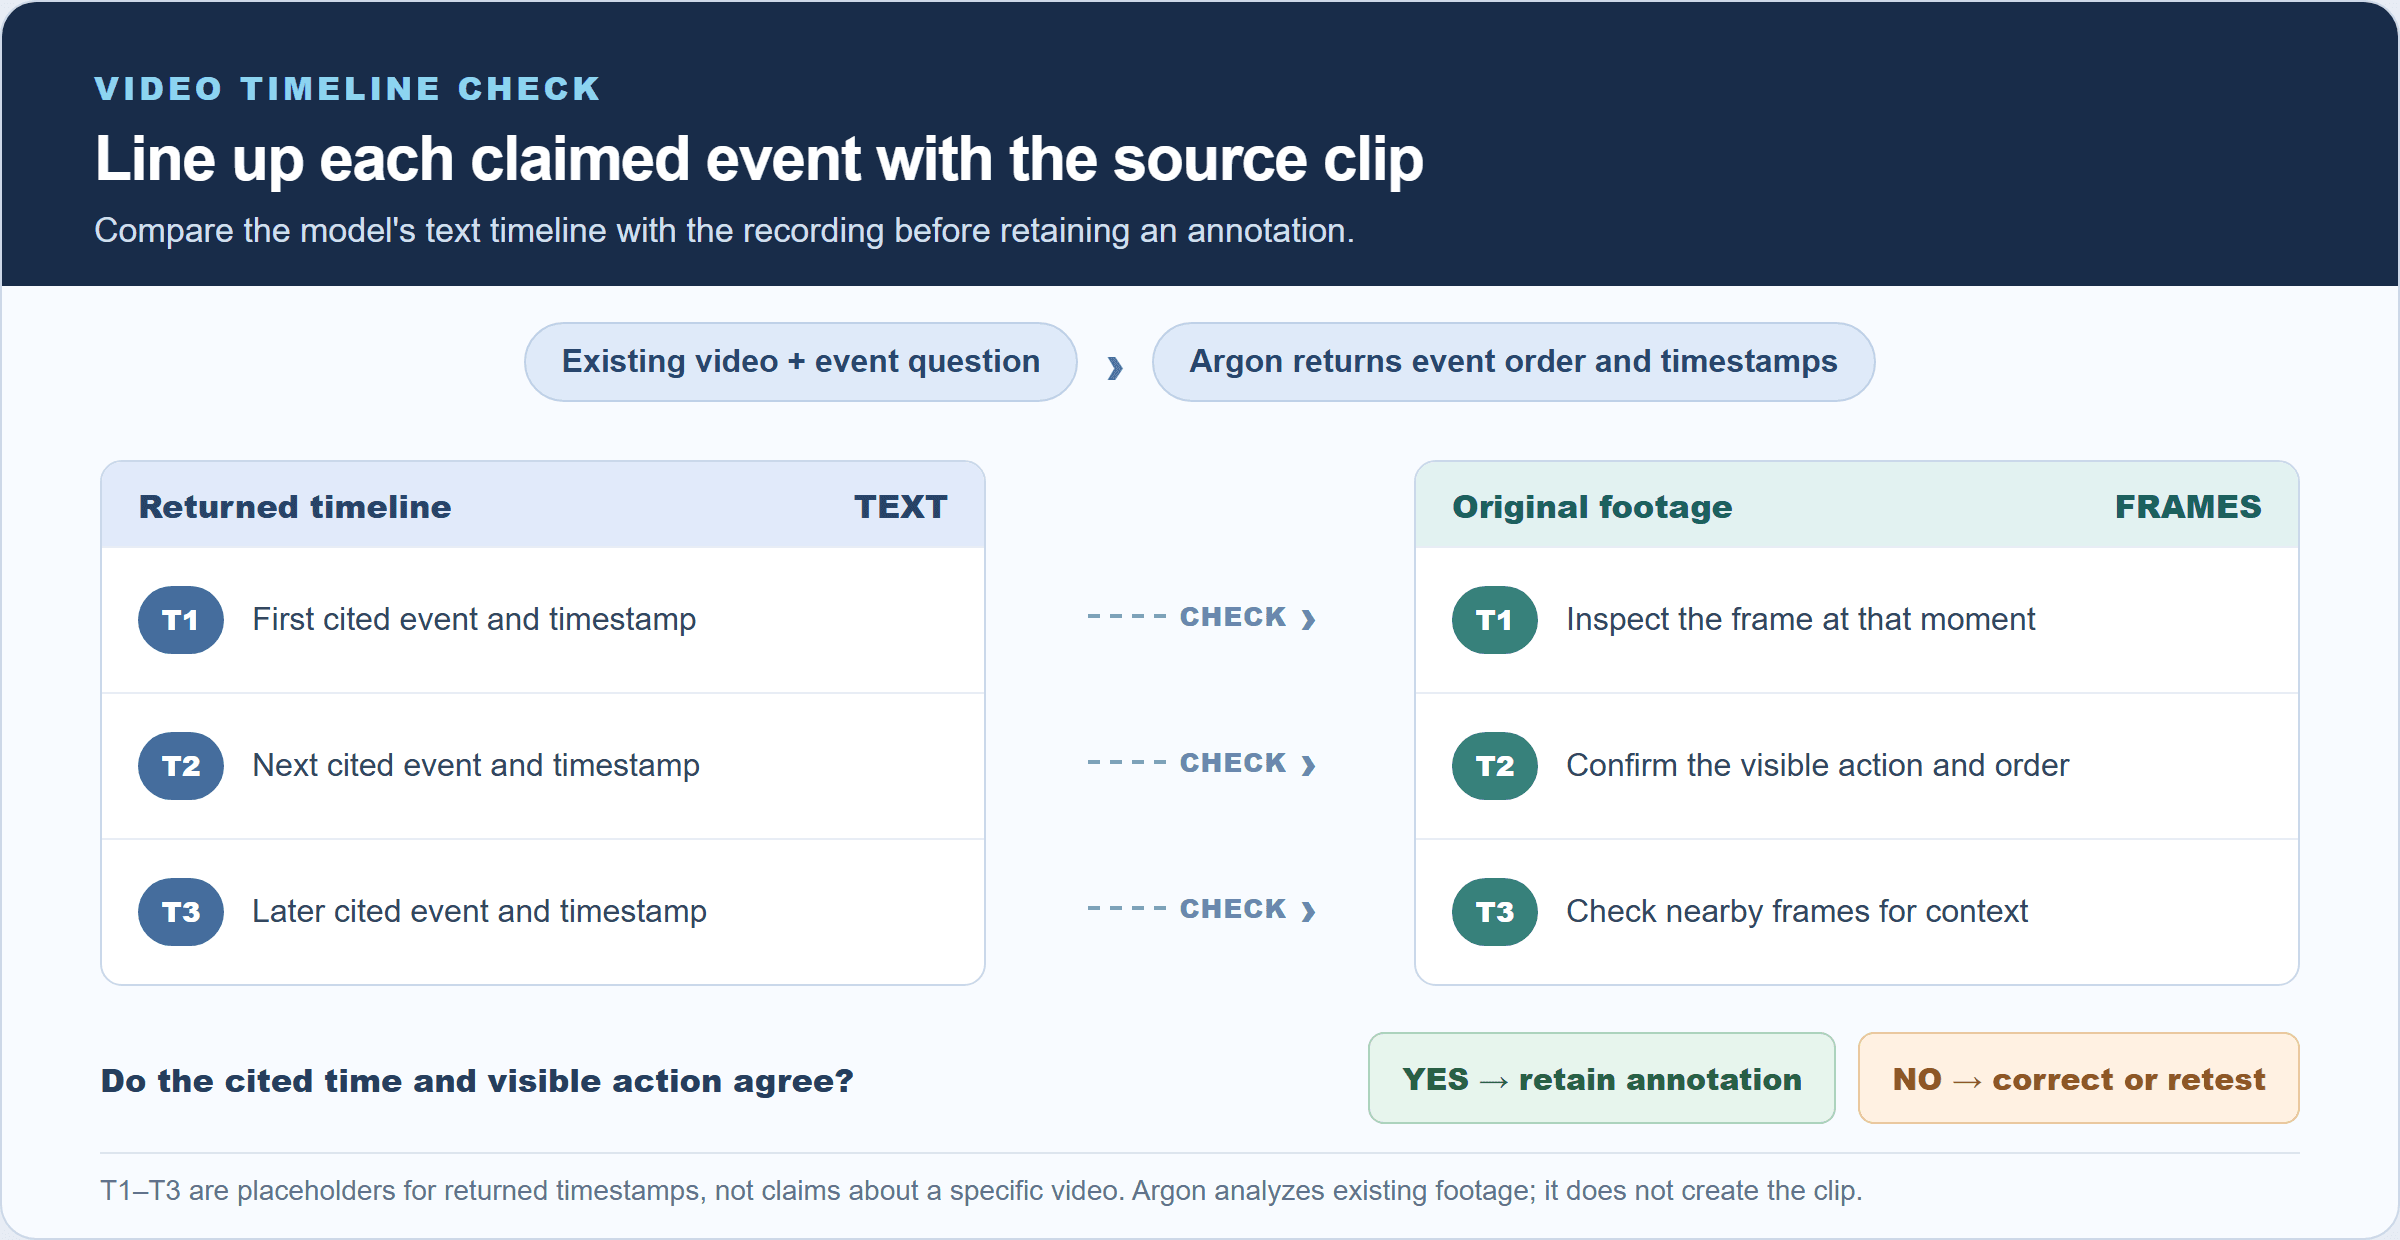 Workflowillustratie: vraag om gebeurtenisvolgorde en tijdstempels en verifieer elk geciteerd moment aan de hand van de originele opname.
Beweging kan gemakkelijk verkeerd worden gelezen wanneer de camera beweegt, handen een object verbergen of twee acties dicht bij elkaar plaatsvinden. Controleer de geretourneerde tijdstempels steekproefsgewijs tegen de originele beelden. Als een antwoord van invloed is op veiligheid of een slaag-/zakbeslissing, laat dan een persoon of een speciaal daarvoor gebouwd visionsysteem de kritieke frames verifiëren.
Audio: aangeleverde opnamen analyseren
Met audio-invoer kun je vragen stellen die op een opname zijn gebaseerd, zoals wat er werd gezegd, welk geluid eerst kwam of een bepaalde zin voorkomt. Controleer voordat je een integratie ontwerpt de huidige documentatie voor audio-invoer op ondersteunde formaten, duur- en bemonsteringsbeperkingen en de exacte vorm van het verzoek. 'Audio-invoer ondersteund' alleen specificeert niet elk transcriptiegedrag en garandeert niet dat een bijlage daadwerkelijk via je client is doorgegeven.
Bouw een kleine testset met bekende antwoorden op basis van opnamen die je mag verwerken. Neem heldere spraak, overlappende sprekers, achtergrondgeluid, stilte en niet-spraakgeluiden op als die in productie voorkomen. Vraag om tijdstempels of een kort bewijscitaat waar de interface dat ondersteunt. Verifieer dat de bijlage het model heeft bereikt en vergelijk het resultaat vervolgens met de opname. Zo worden zowel modelfouten als integratiefouten zoals weggelaten bestandsdelen of niet-ondersteunde codering opgevangen.
PDF's en gemengde documenten: details tussen bronnen verbinden
PDF-ondersteuning is waardevol wanneer een vraag door proza, tabellen en figuren heen loopt. Een reviewer zou kunnen vragen of de managementsamenvatting van een rapport overeenkomt met een tabel later in het document, of een bewering en de ondersteunende figuur erbij extraheren. Meerdere documenten kunnen worden aangeleverd voor vergelijking, afhankelijk van de token- en bestandslimieten van het verzoek.
Vraag bij elke bewering om een bronlocatie. Paginaverwijzingen zijn nuttig, maar valideer ze, want de paginanummering van een pdf kan afwijken van het gedrukte paginalabel. Vraag bij een tabel om het rijlabel en de kolomkop, evenals de waarde. Vraag het model bij een diagram het visuele element te benoemen dat het heeft gebruikt. Als een pdf gescand, geroteerd, vaag of dicht gezet is, test dan representatieve pagina's in plaats van aan te nemen dat alle pagina's even goed zijn geparseerd.
Een compact uitvoerschema kan de beoordeling gemakkelijker maken: bewering, bronlocatie, ondersteunend fragment of visueel detail, en vertrouwen of 'niet gevonden'. Gestructureerde uitvoer kan een vorm afdwingen, maar een geldig JSON-object kan nog steeds een verkeerde lezing bevatten. Formaatvalidatie en feitelijke validatie zijn afzonderlijke controles.
Hoe je het multimodale begrip van Gemini 4 Argon test
Gebruik een korte evaluatie voordat je het model op een grote batch aansluit. Kies een bron waar een mens het juiste antwoord kan vaststellen en definieer wat als een correct resultaat telt. Het doel is het hele traject van bestandsselectie tot modelantwoord te testen, niet alleen te kijken of het antwoord plausibel klinkt.
- Kies één openbaar rapport met een grafiek of een korte video met duidelijk identificeerbare gebeurtenissen. Houd een door mensen gecontroleerde antwoordsleutel aan.
- Vraag het model alleen het bijgevoegde materiaal te gebruiken en aan elke bewering een locatie te koppelen.
- Vergelijk elke bewering met de bron. Noteer weglatingen, verkeerde lezingen, niet-ondersteunde gevolgtrekkingen en locaties die niet naar bewijs herleidbaar zijn.
- Herhaal dit met verschillende voorbeelden die op je werkelijke bestanden lijken, inclusief moeilijke gevallen.
- Stel een slagingsdrempel in op basis van de kosten van een fout. Stuur onzekere of impactvolle resultaten naar menselijke beoordeling.
Je kunt deze prompt aanpassen:
Analyseer alleen het bijgevoegde materiaal. Beantwoord de onderstaande vragen in een tabel. Citeer voor elke bewering het paginanummer, de tijdstempel of het zichtbare bewijs dat deze ondersteunt. Als het materiaal het antwoord niet bevat, zeg dan 'niet gevonden'. Leid geen ontbrekende feiten af.
Vervang bij een afbeelding 'paginanummer, tijdstempel' door 'beeldgebied en zichtbaar label'. Vraag bij een pdf om de pagina en de tabel- of sectienaam. Vraag bij audio om een tijdstempel en de woorden of het geluid dat het antwoord ondersteunt. Deze kleine wijzigingen maken de uitvoer gemakkelijker te controleren.
Volg fouten per type in plaats van één algemeen nauwkeurigheidscijfer te gebruiken. Een verkeerd cijfer in een grafiek, een gemiste gebeurtenis en een verwijzing naar de verkeerde pagina hebben verschillende gevolgen. Dit evaluatiekader verandert een indrukwekkende mogelijkhedenlijst in een herhaalbare beslissing over of het model betrouwbaar is voor jouw bestanden.
Beperkingen van Gemini 4 Argon: wat multimodale ondersteuning niet betekent
Ondersteuning voor invoer impliceert geen overeenkomstige ondersteuning voor uitvoer. De API vermeldt momenteel beeldgeneratie, audiogeneratie en Live API als niet ondersteund voor Argon. Als de taak is om een nieuwe afbeelding, soundtrack of realtime spraakinteractie te maken, kies dan een model of tool die die uitvoer expliciet vermeldt. Je kunt Argon nog steeds gebruiken om de prompt, het bronmateriaal of het gegenereerde resultaat te analyseren.
Een venster van een miljoen tokens garandeert ook geen volledige recall. Het wordt gedeeld door het verzoek en het antwoord, en lange invoer kan de latentie en kosten verhogen. Het model kan een detail over het hoofd zien, informatie afleiden die afwezig is of een onjuiste tijdstempel retourneren terwijl het zeker klinkt. Long decode is een API-uitvoeringspad met aanvullende vereisten, niet het standaardgedrag voor elke client.
Benchmarks zijn directioneel bewijs. Roboflow rapporteert resultaten van specifieke taakdatasets en evaluatie-instellingen, terwijl de modelkaart van Google een bredere set interne en openbare evaluaties samenvat. Geen van beide vervangt een test met jouw camerakwaliteit, documentindelingen, vocabulaire, talen en fouttolerantie. Een hoge score in één categorie kan geen betrouwbare prestatie bij een andere taak bewijzen.
Gebruik een reviewer wanneer het antwoord invloed heeft op een financiële, juridische, veiligheids-, medische of werkgelegenheidsbeslissing. Bewaar de oorspronkelijke invoer en het geretourneerde bewijs samen, zodat een persoon de conclusie kan controleren. Log voor terugkerende workflows de modelversie, prompt, relevante instellingen, bron-ID en beoordelingsresultaat. Dat record helpt een modelwijziging te onderscheiden van een bestands- of integratieprobleem.
| Taak | Goede eerste test | Nauwkeurig controleren |
|---|---|---|
| Grafiek lezen | Vraag om gelabelde waarden met aseenheden | Kleine lettertypen, dichte legenda's, benaderende visuele waarden |
| OCR | Gebruik een schone uitsnede met een bekende transcriptie | Onscherpte, handschrift, rotatie, gemengde schriften |
| Videogebeurtenissen | Vraag om van tijdstempels voorziene acties in volgorde | Occlusie, snelle cuts, afgeleide oorzaken |
| Audio Q&A | Stel een bekende vraag over een korte opname | Ruis, meerdere sprekers, omgang met bijlagen |
| PDF-vergelijking | Vraag om bewering, pagina en ondersteunende passage | Gescande pagina's, afwijkende paginanummering, gevolgtrekking over pagina's heen |
Toegang, prijzen en waar Atlas Cloud past
De openbare API-model-ID is gemini-4-argon; Google vermeldt momenteel Gemini API en AI Studio als toegangsroutes. De huidige kennisgeving van Google vermeldt een introductietarief van $2 per miljoen invoertokens en $10 per miljoen uitvoertokens tot en met 30 november 2026, daarna respectievelijk $4 en $20. Cached input heeft afzonderlijke voorwaarden, dus schat dit niet in als gewone invoer. (Google, oktober 2026)
De huidige All Models-vermelding van Atlas Cloud toonde Gemini 4 Argon niet toen dit voor dit artikel werd gecontroleerd. Dat betekent dat er geen geverifieerde Atlas Argon-modelpagina of Atlas-prijs is om hier te vermelden. Behandel een algemene platformvermelding niet als bewijs van beschikbaarheid. Als je team providers vergelijkt of een bredere modelworkflow bouwt, kan Atlas Cloud een plek zijn om andere vermelde modellen te bekijken, maar bevestig de exacte modelpagina en ondersteunde bewerkingen voordat je rond een provider plant.
De broncontrole beïnvloedt ook de aanbeveling: gebruik vandaag de officiële route van Google om Argon te testen, en behandel Atlas Cloud als een afzonderlijke ontdekkingsoptie voor modellen die daadwerkelijk worden vermeld. Hier wordt niet beweerd dat Argon op Atlas Cloud wordt gehost.
Is Gemini 4 Argon geschikt voor jouw taak?
Zet Argon op een shortlist wanneer de taak redeneren over gemengd materiaal, het extraheren van visuele details, het volgen van gebeurtenissen in een video of het beoordelen van een lang rapport vereist. De grote gedeelde context en tekstuitvoer kunnen helpen bewijs te consolideren in een tabel of gestructureerd resultaat. De volgende stap is een kleine, door mensen controleerbare evaluatie met je eigen representatieve invoer.
Kies een ander model of een andere tool wanneer het vereiste resultaat gegenereerde beelden, gegenereerde audio of een live audio-/videogesprek is. Vergelijk voor OCR of operationele beslissingen de uitvoer met een speciaal daarvoor gebouwd alternatief als exactheid, snelheid of voorspelbare kosten belangrijker zijn dan brede redenering.
Als de evaluatie je taakspecifieke drempel haalt, doe dan een pilot met logging en menselijke beoordeling voordat je het volume verhoogt. Als het niet lukt, classificeer de fouten en bepaal of duidelijkere invoer, een gewijzigde prompt, een ander model of een apart OCR-/transcriptiesysteem de juiste oplossing is. De nuttige vraag is of de multimodale mogelijkheden van Gemini 4 Argon binnen je foutbudget passen.
Veelgestelde vragen
Kan Gemini 4 Argon video's en audio analyseren?
Ja. De API vermeldt zowel video als audio als ondersteunde invoer. Videobegrip kan beschrijvingen of van tijdstempels voorziene analyses retourneren; audio kan worden aangeleverd voor audiogebaseerde vragen. Controleer de huidige documentatie over bestandsindeling en verzoek en verifieer het antwoord vervolgens aan de hand van de originele media.
Genereert Gemini 4 Argon afbeeldingen of audio?
Nee. De huidige API-mogelijkhedentabel markeert beeldgeneratie en audiogeneratie als niet ondersteund voor dit model. De gedocumenteerde uitvoermodaliteit is tekst, zelfs wanneer de invoer afbeeldingen, audio of video bevat.
Wat betekent het contextvenster van 1M tokens van Gemini 4 Argon?
De limiet van 1.048.576 tokens wordt gedeeld door invoer en uitvoer. Standaard synchrone uitvoer is beperkt tot 65.536 tokens. Google documenteert een afzonderlijke long-decode-stroom voor grotere uitvoer, tot aan de gedeelde limiet, met achtergronduitvoering en vervolgstappen.
Hoeveel kost toegang tot de Gemini 4 Argon API?
Met ingang van 16 oktober 2026 vermeldt Google $2 per miljoen invoertokens en $10 per miljoen uitvoertokens tot en met 30 november 2026. De vermelde daaropvolgende tarieven zijn $4 en $20. Controleer de actuele prijzen en de voorwaarden voor cached tokens voordat je een project begroot.


